英文题目:Tone-Tune Correspondence in Chinese Musicals: A Quantitative Study
会议身份:
conference:speechprosody:2026:conference-paper-id:zhang26i_speechprosody
✅ 来源为官方会议 PDF;表格与 Figure 按原文证据绑定。PDF 公式以原页区域图片展示,未冒称作者原始 TeX。
标签:#统计分析 #韵律 #音乐 #语音 #音乐理解
评分:4.9/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 0.7/1.5 | 清晰度 0.6/1 | 影响力 0.7/1.5 | 开源 0.0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:后50% | 文档类型:应用研究
👥 作者与机构
- Ruizhuo Zhang:机构信息未能从会议 PDF 纯文本可靠映射
- Jiangping Kong:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
中国原创音乐剧需使旋律走向与汉语声调轮廓相随否则倒字损害可懂度,本文输入为演唱录音与对应朗读录音,输出为逐音节声调与曲调是否相随判定及全曲依从率,难点在于演唱与朗读时长差异大且前后音节协同影响感知。方法链先按换气与旋律终止划分音乐短语并对齐朗读短语以保留表演韵律,再用ProsodyPro在每音节内等间隔提取基频F0并归一化以消除时长差异。接着分别计算单音节F0轮廓相关与纳入前后邻音节的三音节F0轮廓相关,统计正相关占比得到依从率并按声调与边界位置分层。相对Kong2021年古代吟诵以相关大于0.5为相随,本文以大于0即算相随,机制差异在于音乐剧曲谱严格只要不反向即保证可懂度,实际意义是放宽阈值聚焦倒字检测。在《身世》语料评测设置下,三音节相关方法的依从率指标为71%,高于单音节相关方法的依从率指标68%。分层显示轻声与短语边界更高且实际调值为214的Tone3在三音节下占优,说明创作优先保留拱形轮廓并在关键韵律位置强化对齐。该结论适用边界受限于关山作词三宝作曲姚旭演唱的两首录音共871音节,尚未验证跨作曲家跨演唱者与跨剧目的外推性。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,目标是什么,本文要保留哪些信息?
这篇解读的输入是论文正文提供的全部事实,不引入外部听感评价。目标读者是刚进入语音与音乐交叉方向的研究生,需要能核对每一步做了什么,并在实验室里把方法复述出来。必须保留的信息包括研究对象、对照基准、计算口径和关键数字,不能用笼统的高低代替。论文研究的对象是中国原创音乐剧中的唱词可懂度问题。中文每个字自带声调,也就是口语中相对固定的音高升降。
当这个字被唱出来时,乐谱规定的旋律音高会与字调音高叠加。如果旋律上行而字调本该下降,听众就可能听错字,进而跟不上剧情。论文把这种冲突称为倒字,把和谐对应称为依字行腔。作者要回答的不是某首歌好不好听,而是在复杂的音乐结构下,创作者是否系统地保留了字调走向。
字调 × 旋律: 字调指每个汉字在口语中固定的音高升降模式,负责区分词义,分工是提供语言学基准;旋律指歌唱中由乐谱决定的音高走向,分工是承载音乐表达;两者组合为依字行腔原则,即让旋律走向尽量跟随字调高低模式,搭配理由是汉语是声调语言,若二者走向相反就会出现倒字而听不清,组合意义是把艺术选择变成可检验的声学一致性问题。
为此作者选择了量化路线,而不是请专家逐字打分。做法是找同一批唱词的两种实现,一种是唱,一种是说,然后比较二者基频轮廓是否同向。说提供语言学真相,唱提供音乐实现。如果大量字的说唱轮廓同向,就报告依字率高。本文的输出是一套可复现的流程说明,包括选了哪两段唱段、说了什么话由谁录、怎么切分乐句、怎么取基频点、怎么算相关、怎么计数。读者读完应该能说出阈值是什么,单音节与三音节的区别在哪里,以及哪些数字支持了韵律影响判断,哪些地方原文没有给出不确定度或显著性检验。
同类问题在戏曲和流行歌里已经怎么研究?
在进入音乐剧之前,有必要先看同输入同目标的已有路线。论文回顾指出,京剧方面有李和林的研究,昆曲方面有韩以及董等人的研究,沪剧方面有陆的研究,古诗词艺术歌曲吟诵方面有刘、李等人以及孔的研究,粤语和越南语流行歌曲方面有何以及柯比与拉德的研究。这些工作的共同点是都关心声调与旋律是否一致,差别在于材料形态不同。地方戏和吟诵相对自由,流行歌则受固定节拍与商业编曲约束更强。
论文明确指出,针对当代戏剧形态的中国原创音乐剧,深入的定量分析仍是空白。这一定位决定了本文不是重复验证某个声学工具,而是把孔在 2021 年提出的依字率方法迁移到音乐性更强、有严格乐谱的音乐剧材料上。理解这一点很重要,否则会误以为本文发明了相关计算本身。实际上相关计算沿用已有思路,创新在于材料、口径调整与韵律分组比较。
已有路线多用定性描述,例如听辨是否倒字。定性方法的优点是贴近听感,缺点是标准不统一,难以跨作品比较。孔的方法把是否跟随变成基频轮廓相关系数的计数问题,提供了可操作的阈值。本文继承了这一思想,但把阈值从大于 0.5 放宽到大于 0。理由在方法节交代:音乐剧旋律起伏大,只要不出现方向相反的倒字即可保证基本可懂。这个放宽是全文理解的关键,所有百分率都建立在大于 0 的口径上,不能与古汉语吟诵的大于 0.5 直接比大小。
要测的到底是哪个对应关系?
论文要测的是歌唱实现与口语实现之间的轮廓一致性,而不是旋律音符与教科书调值之间的抽象一致。这一点初学者容易混淆。教科书调值是 55、35、214、51 这样的五度标度,实际口语会发生连读变化,例如两个三声连读时前字变二声。论文在比较四声时明确使用实际调值分组,也就是按连读后的真实轮廓归组,而不是按字典声调归组。这意味着测量目标是语流中的真实实现。
对每个字,输入是两段基频序列,一段来自唱,一段来自说。输出是一个相关系数,正数表示走向大致同向,负数表示反向。最后把全篇正相关的字数除以总字数得到依字率。
任务的难点在于时长不同。唱的一个字可能拖很长,说的一个字很短,直接比较点数不等。论文用等间隔取点解决,每个音节取同样多个点,保留 2 位小数。另一个难点是语境影响。孤立看一个字可能是降调,放在句中受前后字影响会变形。
因此论文同时计算单音节相关和三音节相关。三音节把前后邻字拼进来,句首只拼后字,句尾只拼前字,逐句步长为一滑动。这个设计让结果可以回答:到底是孤立字保住了,还是连贯语流保住了。
从一段唱到一个百分比的全景流程是什么?
沿着一个样本走完全程有助于建立整体感。假设目标是飞天第一句秋字。第一步是准备材料。唱来自音乐平台下载的高质量音频,再用音频修复插件提取人声。说来自 1 位 27 岁女性普通话母语者,普通话水平测试 1 级乙等,要求在安静环境用标准普通话清晰中等语速朗读同样歌词,用耳机话筒经录音软件以 16 位、44100 赫兹录制。
第二步是切分乐句。乐句定义为演唱与语义都完整的单位,切分依据首先是演唱者的换气、旋律终止或结构停顿,其次是意群与分句,冲突时优先音乐标准。说的切分与唱的边界保持一致,保证逐字对齐。第三步是提基频。用熊子瑜开发的韵律分析脚本在每个音节内等间隔取点,解决时长不等问题。
第四步是算相关。对每个字分别算单音节相关系数和三音节相关系数。第五步是计数。统计相关系数大于 0 的字数,除以总字数乘以 100%。
这个流程里没有训练神经网络,也没有学习参数。所有计算都是确定性的信号处理加计数。需要冻结或更新的模型权重不存在,梯度路径也不存在。唯一的人工选择是乐句边界判定与阈值选择。阈值选择已有明确交代,即大于 0 算跟随。
乐句边界判定依赖研究者对换气与终止的听辨,原文没有报告多人一致性,这是复现时需要留意的缺项。整个流程的监督来源是口语录音,它被当作语言学真相。如果口语录制者本身带口音或朗读腔,就会系统性影响所有相关值。
基频如何取点,单音节与三音节如何搭配?
基频提取是后续一切比较的基础。论文的做法是在每个音节内部等间隔取固定数量的点,唱与说取同样的点数。这样无论唱腔拖多长,说得多快,每个字都变成等长向量。向量长度在正文证据中没有明确写出具体数字,只说明等间隔提取并保留 2 位小数。复现时需要去查所用脚本的默认设置,并在报告中写明自己用的点数,否则他人无法逐点对齐。
取点后做相关分析。单音节相关比较的是目标字自身的说唱向量。如果两条轮廓大体一致,即使绝对音高不同,也算有相关性。例如说在 200 赫兹附近平直,唱在 400 赫兹附近平直,只要都是平的,相关就是正的。这解释了为什么唱比说整体高很多仍能得到正相关。
单音节相关 × 三音节相关: 单音节相关只比较目标字自身在说与唱中的基频轮廓,分工是检验孤立字调是否被保留;三音节相关把目标字前后相邻字的基频也拼在一起比较,分工是检验连读语流中的实际调形;搭配理由是口语感知本就受前后字影响,组合意义是区分孤立保调与语流保调,后者更接近听众听到的连贯效果。
三音节相关把语境拼进来。设目标字为第 i 个字,正常情况比较的是说与唱各自的第 i 减 1、第 i、第 i 加 13 个向量首尾相接后的长向量。句首无前字则只拼后字,句尾无后字则只拼前字。逐句计算,步长为一。这一步的语言学动机是声调在语流中受前后影响,听众感知的也是连贯轮廓。论文发现三音节依字率系统性高于单音节,支持了语流保调的解释。
基频 × 归一化: 基频指声带振动频率在听感上对应的音高轨迹,分工是提供可测量的比较对象;归一化指在每个音节内等间隔取同样多个基频点,分工是消除说与唱时长不同带来的点数不等;搭配理由是只有点数对齐才能做相关计算,组合意义是让不同时长的说唱样本能在同一形状空间里比走向。
计算脚本由梁昌伟博士编写,原文只交代了作者与用途,没有公开代码链接。本次资源状态显示没有可验证的公开代码,因此不能声称代码已公开。复现者需要自己用常见相关函数实现,注意处理缺测点与清音段,并在报告中说明缺测如何插值或剔除,因为这会直接改变正负号。
没有训练阶段时,实际计算与调用是什么?
本研究没有训练阶段,没有训练集与验证集的划分,没有优化器与轮次,也没有可更新的声学模型。把无训练理解为结果天然确定是不对的。不确定性仍然存在,只是来源不同。一是人声提取环节。原唱带伴奏,用插件分离人声,不同参数会残留不同伴奏,低频伴奏可能污染基频跟踪。
二是基频跟踪本身的倍频与半频错误,需要检查并校正。三是乐句切分的人工判断。四是口语基准的说话人选择。本文只用了 1 位女性说话人读全部唱词,没有多说话人平均,也没有男性对照。因此说基准带有一定的个人音域与朗读风格。
实际调用的外部工具包括音乐平台音频、音频处理软件中的人声提取插件、录音软件、韵律分析脚本和相关计算脚本。除说话人年龄、性别、普通话等级、采样率与位深有明确记录外,录音房间混响、话筒型号与距离、基频算法上下限均未报告。复现时应固定这些条件并记录,否则跨实验室的百分率难以直接比较。推理或计算成本方面,原文没有报告运行时间与硬件配置。由于只是数百个音节的相关计算,常规笔记本即可完成,不构成部署瓶颈。
选了哪两段材料,对照条件是否一致?
材料选择控制了词曲班底与演唱者,以减少风格混杂。两段选段是身世与飞天,词作者均为关山,曲作者均为三宝,分别来自音乐剧倪小倩与宁采臣和飞天。身世用的是 2014 年原声带官方录音室版本,飞天用的是 2021 年飞天音乐会官方音频。两段演唱者为同一位音乐剧女演员姚旭。口语对照由同一位普通话母语者录制,保证说基准一致。
这种设计的好处是曲风差异更可能来自作品而非换人,坏处是结论难以推广到男声、其他作曲家或其他演唱风格。下载自音乐平台的音频质量较高,但经过压缩,复现时应说明是否使用无损格式。
切分结果是飞天 352 个音节切成 43 个乐句,身世 519 个音节切成 37 个乐句,合计 871 个音节、80 个乐句。平均每句长度不同,飞天偏短,身世偏长,这会影响边界字占比。评价指标只有一个,即依字率,方向是越高表示说唱走向一致的字越多。阈值统一为大于 0,单音节与三音节分别计数。分组比较包括轻声与非轻声、句边界与句中、四声之间。
分组时样本量差异很大,例如三声只有 75 个,非轻声有 776 个,因此百分比的稳定性不同。原文没有报告置信区间或显著性检验,阅读时应把小样本分组的百分率当作描述性结果,而不是因果断言。
总体与分句的依字率给出了什么证据?
先看总体数字提出的问题:在统一大于 0 的口径下,两部作品的说唱一致性是否达到可观水平,且三音节是否高于单音节。公平条件是同一批音节、同一说基准、同一取点流程,只改变是否拼入邻字。指标方向是依字率越高越一致。下表整理了两段各自的总字数、乐句数与两种口径的依字率,以及合并总量。这是理解全文的主表,后续所有分组都可以看作对这个总体的拆解。
| 条件 | 音节总数 | 乐句数 | 单音节依字率 | 三音节依字率 |
|---|---|---|---|---|
| 飞天选段 | 352 | 43 | 60% | 64% |
| 身世选段 | 519 | 37 | 68% | 71% |
| 两段合并 | 871 | 80 | 65% | 68% |
| — | — | — | — | — |
表后需要同时讲收益与代价。收益是总体超过 65%,且多数乐句超过 50%,报告显示创作者在复杂音乐结构下仍保留了较高的一致性。两个选段都呈现三音节高于单音节,合并为 68% 对 65%。论文据此提出有限解释,认为这是为听者感知做的韵律调整,创作时融入的是自然语流而非孤立调值。代价与反例同样明确。
飞天第一乐句秋天有野兽出现共 8 字,单音节 5 字正相关为 63%,三音节 4 字正相关为 50%,是全文少见的三音节低于单音节且恰在 50% 的例子。第二乐句 9 字中 8 字正相关,两种口径均为 89%。身世第一乐句 15 字中 13 字正相关,两种口径均为 87%。身世第二乐句 16 字中单音节 9 字正相关为 56%,三音节 15 字正相关为 94%,落差极大。这说明总体趋势不等于每句都成立,乐句长度与旋律写法会改变两种口径的差距。
下面这张图是理解绝对音高与走向分离的关键证据。导读如下:该图来自论文图 1,左为飞天首字秋的说唱基频,右为飞天第一乐句的说唱基频,横轴为等间隔采样点,纵轴为赫兹,蓝色为说,橙色为唱。请按焦点顺序观察两条线的相对位置与起伏是否同向。
看图路径: 1. 先看左右两幅图的纵轴基频与横轴采样点,确认橙色为唱蓝色为说;2. 再看左图秋字两条近乎水平的直线差距,判断绝对音高差与走向一致并存;3. 最后看右图第一乐句两条曲线的起伏位置,数一数波峰波谷是否大致同向
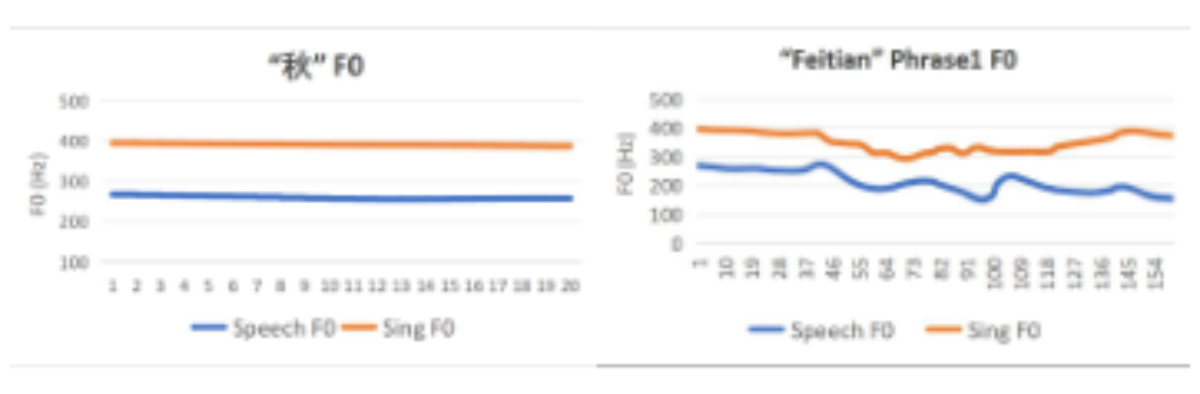
论文图 2。原论文 Figure 2:“F0 contour graphs of the first syllable “秋” and the”。
图中可见左幅秋字两条线近乎水平,唱在约 400 赫兹,说在约 260 赫兹,绝对高度差大但都是平调,符合阴平的高平特征,因此单音节相关为正。右幅第一乐句两条线都有多次起伏,唱整体高于说,但在约 40 至 70 点附近同向下降,在约 100 点附近同向回升,说明拼成长序列后仍保留同向趋势。这解释了为什么绝对音高可以牺牲而走向必须保留。像素不能精确读出每点数值,不应硬写某点赫兹。教学要点是:相关算的是形状同向,不是音高相等。
轻声与边界位置是否改变了依字率?
在总体之后,论文问了第二个问题:韵律结构是否调节依字率。比较对象是轻声对非轻声、边界字对句中字。公平条件是同一阈值与同一取点流程,指标方向仍是越高越一致。下表把样本量与两种口径并置,最后一列给出原文的分组含义,便于核对小样本的稳定性。
| 分组 | 类别 | 样本量 | 单音节依字率 | 三音节依字率 |
|---|---|---|---|---|
| 声调轻重 | 轻声 | 95 | 66% | 71% |
| 声调轻重 | 非轻声 | 776 | 64% | 68% |
| 乐句位置 | 边界字 | 160 | 68% | 73% |
| 乐句位置 | 句中字 | 711 | 64% | 67% |
| 四声类别 | 第一声 55 | 165 | 61% | 66% |
| 四声类别 | 第二声 35 | 204 | 66% | 66% |
| 四声类别 | 第三声 214 | 75 | 65% | 72% |
| 四声类别 | 第四声 51 | 260 | 64% | 70% |
轻声 × 乐句边界: 轻声指短促低平弱化的音节,分工是检验弱音节是否更容易顺应旋律;乐句边界指每句开头与结尾的字,分工是检验结构关键位置是否更守调;搭配理由是二者都属于语言韵律结构而非单个声调类别,组合意义是判断依字率高低是否被韵律位置调节,而不只是被四声类别决定。
表后解释需要区分报告与推测。报告显示轻声在两种口径下分别以 66% 对 64%、71% 对 68% 高于非轻声。边界字以 68% 对 64%、73% 对 67% 高于句中字。论文给出的有限解释是轻声短弱低平,基频模式简单,容易与简化的旋律处理同向,从而表现出抗干扰与兼容性;边界位置在语言学上更关键,创作者在这些位置更守调,句中则给音乐留出灵活性。
这些解释得到数据支持,但属于事后解释,没有做因果干预,因此只能说支持,不能说证明。未胜出项也要点名:非轻声与句中字并未低到不可懂,仍在 64% 上下,说明旋律自由并没有造成大面积倒字。未评测边界包括多字词重音、儿化与方言变体,原文均未分组。
四声拆开看,谁的轮廓最被优先保留?
如果把总量按实际调值拆成 4 组,问题就变成哪种轮廓最难丢。比较条件是按连读后的实际调值归组,样本量分别为 55 调 165 字、35 调 204 字、214 调 75 字、51 调 260 字。单音节排序为第二声 66% 大于第三声 65% 大于第四声 64% 大于第一声 61%。三音节排序为第三声 72% 大于第四声 70% 大于第一声与第二声并列 66%。两种口径都显示第三声靠前,尤其在三音节达到最高 72%。
论文据此认为创作者优先保留了三声的曲折轮廓。这是一个有教学价值的对照,因为三声样本最少,只有 75 字,百分比波动最大,但它在三音节下领先第 2 名 2 个百分点,在单音节下也居第二。
三声 × 动态变化趋势: 三声指 214 的曲折调,分工是提供 4 个声调里最复杂的先降后升轮廓;动态变化趋势指轮廓的升降走向而非绝对音高值,分工是解释创作者在冲突时优先保留什么;搭配理由是复杂轮廓一旦丢失最难靠上下文补回,组合意义是揭示对齐机制可能是牺牲绝对音高但保住升降走向。
机制上可以这样理解:三声先降后升,形状最复杂,一旦写成单向滑音就最容易被听错,因此旋律更倾向于给它留出转折空间。论文把机制概括为牺牲绝对音高、保住动态变化趋势。秋字的例子已经展示了绝对音高差不影响正相关。需要提醒的是,这不是消融实验,没有拿掉三声重写旋律的对照,也没有听辨误判率来证明难易。原文也没有报告四声分组的统计检验,因此排序应视为描述性发现。若复现时换了说话人或换了取点数,61% 到 66% 之间的微小差距很可能翻转,只有三声在三音节下的领先值得重点复核。
哪些结论有边界,哪些数字不能直接比?
首先是口径边界。全文依字率基于大于 0,而孔 2021 年古汉语吟诵基于大于 0.5。两个阈值下的百分率不能直接比大小。本文选择宽口径的理由是音乐剧只要不倒字即可保证基本可懂,这个理由是艺术判断,不是声学证明。复现时应同时报告大于 0 与大于 0.5 两种计数,才能与前人对话。
其次是材料边界。两段材料词曲班底相同、演唱者相同、语言均为普通话女声,作曲家风格、性别音域、录音版本年代都可能影响结果。飞天 60% 与 64% 明显低于身世 68% 与 71%,说明作品间差异本身就很大,用两段推导全部中国音乐剧会过度推广。再次是基准边界。口语基准只有 1 位说话人,没有多说话人平均,没有听辨实验验证正相关是否真等于听得清。
相关是形状相似,不是可懂度本身。最后是报告缺项。基频每音节取点数、缺测处理、乐句切分一致性、显著性检验、运行环境均未完整报告。本次也没有可验证的公开代码与数据,不能声称已公开或当前可用。阅读时应把结论限定为在这两段材料与这位说话人基准下,三音节高于单音节、边界高于句中、轻声高于非轻声、三声在三音节下最高。
要复现这套方法,先做什么,后补什么?
复现的第一步是重建可核对的材料包。准备唱的无损或已知压缩版本并记录来源与版本年份,记录人声分离工具与参数。按原文口径请普通话母语者朗读全部歌词,记录年龄、性别、普通话等级、录音软件、话筒、采样率与位深,尽量用安静环境与中等语速。建议至少增加 1 位说话人做稳健性检查,但主结果仍用单说话人以对齐原文。第二步是切分与对齐。
按换气、终止、结构停顿优先切音乐句,再对齐说的边界,保留每句起止时间与字级对齐表。遇到冲突优先音乐标准,并记录难以判定的边界。第三步是提基频与对齐点数。选定基频算法与上下限,每个音节等间隔取固定点数,记录点数与缺测处理。建议先复现飞天第一句与身世前两句的单句依字率,再扩展到全篇。
第四步是计算与计数。实现单音节与三音节相关,句首句尾按原文规则只拼一侧,逐句步长为一滑动,阈值大于 0 计数,同时加算大于 0.5 以便与前人比较。
还需补的验证包括多人切分一致性、多说话人基准、基频算法更换后的稳定性,以及听辨实验。听辨可以抽取正相关与负相关的字,在去语境与有语境两种条件下测辨认率,才能把形状相似与听得清连接起来。若要检验三声优先的说法,可单独抽取 75 个三声字,比较不同旋律写法下的相关分布,而不是只看排序。所有新增验证都应保留原文口径的主结果,不用新口径替换旧数字。
何时值得借用这套方法,核心判断是什么?
当你的任务也是声调语言的歌唱可懂度,且手头只有录音而无乐谱时,这套说唱轮廓相关加计数的方法值得借用。它不需要乐谱转调,不需要逐音符对齐,只需要字级对齐的说唱基频。它适合做作品间比较与创作复盘,例如比较不同作曲家、不同演唱者或同一唱段不同版本的守调程度。它的代价是只能回答走向是否同向,不能回答音乐好坏,也不能定位哪个音符写错了。若需要指导改谱,还需把字级相关回溯到音符级,原文没有做这一步。
核心判断可以概括为 3 条。第一,总体依字率超过 65% 且多数乐句超过 50%,报告显示这两段创作在追求音乐性的同时保留了语言韵律。第二,三音节高于单音节、边界高于句中、轻声高于非轻声,共同支持语流与位置调节守调程度,创作保的是连贯实现而非孤立调值。第三,三声在三音节下达到 72% 居首,支持牺牲绝对音高、保住升降走向的机制解释。这些判断都限定在两段女声普通话材料与大于 0 口径下。换材料、换说话人、换阈值都需要重算,不能直接沿用百分率做跨研究排名。
📐 原文公式与排版
以下展示论文原页中的数学表达区域,保留原始上下标、分式和符号排版。区域序号仅用于本文导航,不是论文公式编号。
另有 2 个候选区域因边界不明确或图片数量、尺寸限制未展开;请查看完整论文中的原始排版。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses