英文题目:Where Do I Go?: A Game-Based Exploration of Failure and Playfulness as Musical Expression.
会议身份:
conference:nime:2026:conference-paper-id:nime2026_82
✅ 来源为官方会议 PDF;表格与 Figure 按原文证据绑定。PDF 公式以原页区域图片展示,未冒称作者原始 TeX。
标签:#游戏音频 #软件工具 #信号处理 #音乐 #音乐生成
评分:5.2/10 | 创新 1.3/2 | 技术严谨 1.0/1.5 | 实验充分 0.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.9/1.5
排名:后50% | 文档类型:应用研究
👥 作者与机构
- Zeynep Özcan:机构信息未能从会议 PDF 纯文本可靠映射
- Mya Gordon:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
Where Do I Go?以冒名顶替现象为框架,输入为表演者足部连续位移与观众口头报点0-24,输出为投影网格进程、自适应声音景观与离网击钹宣告,难点在于将自我怀疑外化为可演奏规则并维持观众可参与性。先由Python接收鞋载惯性传感器的足部位姿流,负责步态校准与位置修正,输出离散化5×5格点坐标。再由Processing接收该格点坐标,负责三关推进、故障激活与成就和信心双指标更新,输出状态变化与视觉计时。最后由Max接收该状态变化,负责多层合成与故障纹理混合生成声音,其按总时长回传的关卡切换信号又进入下一轮Python校准形成闭环。与已有音乐游戏不同,该作在第一二关故意让成功更新提升成就却扰动信心,在末关跳房子中才使二者同步上升,从而把冒名顶替循环机制化为可听矛盾。在足部追踪评测条件下,逐步运动追踪的错误率为1%以下,低于水平定位的错误率为24%以下。结论适用边界受限于单次舞台演示与特定硬件排练环境,向户外复演与跨群体对话的外推尚未验证,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://www.python.org — 链接可访问(HTTP 200)
- 第三方资源:https://processing.org — 链接可访问(HTTP 200)
- 第三方资源:https://cycling74.com/products/max — 链接可访问(HTTP 200)
- 第三方资源:https://www.imuwear.com — 链接可访问(HTTP 200) 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么:为什么要用冒充者现象做音乐表演?
这篇论文的输入不是一段音频数据集,也不是一个要刷分的识别任务,而是一个长期困扰高成就创作者的心理体验。白话来说,冒充者现象就是明明有证据证明自己能行,当事人仍然觉得自己是骗子,担心早晚被揭穿。论文把英文 Impostor Phenomenon 简写为 IP,后文统一用冒充者现象指代它。作者关心的是这种体验在表演现场如何被外部化,而不是在问卷里如何被测量。
目标因此是建造一个可演奏的系统,让观众亲手参与制造那种自我怀疑。表演者站在台上玩一个网格游戏,观众实时喊话指挥她去哪里,系统用故障来捣乱,再用声音把每 1 次成功与心虚放大。必须保留的关键信息是,这不是追求零失误的炫技,而是把失误当作材料。开场表演者会先做简短口头导览并提供节目单注释,告诉观众可以喊格子编号,也可以喊出看到的故障位置。
输出是一场 3 段式互动演出加 1 篇技术说明。演出结束时不产生分类标签或分数排名,产生的是观众与表演者共同经历的权力与游戏协商。复述时要记住 3 个固定元素:5 乘 5 网格与零到二十四编号、可被踩中或错过的故障、屏幕上同时显示的成就与自信两条进度。这三者缺一不可,否则冒充者现象就退化成普通游戏。
相关路线如何把失败从 bug 变成特征?
第一条路线是把失败当作创作方法的音乐与艺术传统。白话来说,就是故意让电路短路、让数字文件破损,从破损里找新声音。论文引用了后数字美学的代表性论述,即故障不是需要修复的缺陷,而是媒介本身的声音。电路弯折和故障艺术都被点名,意思是把误用硬件与暴露压缩错误当作正当手法。本作继承这一点,把故障 tile 设计成视觉与声音同时爆发的表达事件,而不是扣分惩罚。
第二条路线是游戏设计对自我怀疑的建模。论文提到两款独立游戏作为计分逻辑的参照。一款要求玩家根据对自己技术的判断来选择 1 次面对多少敌人,把自信直接写进规则。另一款用依赖链让失败提高后续失败概率,模拟自我怀疑滚雪球。本作借用的是第二种直觉:错过故障会按自信比例放大冒充者偏置,让观众看到犹豫如何累积。
第三条路线是参与式剧场与新乐器界面传统。巴西戏剧家奥古斯托·波瓦的被压迫者剧场提出观演者概念,观众不再只是看,而是上台改写剧情。通量艺术与行为艺术进一步模糊艺术家、观众与环境的边界。新乐器界面领域也有大量游戏化界面打破演奏者与听众分工。本作的不同在于不把参与当作热闹的加分项,而是让参与本身制造评价压力,再让表演者在第二关开始抵抗指令,从而把社区支持与竞争性同伴压力的差异演出来。
要解决的矛盾是什么:成功为什么不能带来确信?
论文要形式化的问题可以沿一个样本走一遍。假设观众喊出十二号格,表演者从起点走向该格,途中某个故障正好激活。如果她在故障熄灭前踩上去,系统登记 1 次成功更新,成就上升,同时播放反转镲片采样,她还要走出网格敲一下真镲。按常识这应该皆大欢喜,但在第一关规则里,成就上升的同时自信反而下降。这就是要研究的核心矛盾:任务成功与自我确信脱钩。
输入是观众口头指令与足部位置,中间表示是离散格子索引与故障激活状态,组件是计分器与声音引擎,目标是让脱钩过程可感,输出是移动轨迹、双进度条与不断变密的音乐纹理。教学例子是第一关的人形光标状态:表演者完全服从,越服从越成功,越成功肢体越困惑。这明确标为对规则的举例,不是实验测量值。
与常见新乐器任务的区别在于,这里没有音高准确率或延迟指标,评价的是叙事是否成立。作者引用心理学家宝琳·克兰斯的冒充者循环:接到成就任务、焦虑执行、成功后归因于外部、继续自我怀疑。游戏把这个循环写成三关:外部指导与自我怀疑、混乱与抵抗、游戏与自我接纳。复述时必须先讲这个循环,再讲具体关卡,否则计分规则看起来像随意涨落。
三关游戏全景:谁指挥、谁走路、谁加分?
整个作品可以看成一张权力转移表。第一关表演者从第一个格出发,不断问观众我该去哪里,观众喊编号,她照做。故障 tile 是预先设定位置与主题,但激活时间与持续时长随机。她踩中就触发视听断裂,然后离网敲镲。第二关故障更频繁,表演者语气变得不确定与沮丧,开始忽略或质疑观众。第三关 5 乘 5 网格消失,变成跳房子图案,表演者不再提问也不再听指挥,自由移动并保持沉默,象征从外部验证转向内部自主。
下表把三关的动作、观众角色与计分变化并置,阅读时先看纵向的权力转移,再看横向的成就与自信是否同步,这是理解后文技术选型的总图。表前的问题是:在什么条件下成功更新会同时推高两条进度,又在什么条件下只推高成就?公平条件是同一套踩中、错过与离网事件定义贯穿三关,指标方向是成就记录事件成功,自信记录自我评价,两者升降含义不同。
看图路径: 1. 先读最左列三关名称,确认从外部指导到混乱抵抗再到游戏接纳的顺序;2. 再横向对照每行表演者动作与观众角色如何从指挥变为观察;3. 最后看最右列故障数量与计分规则何时从脱钩变为同步
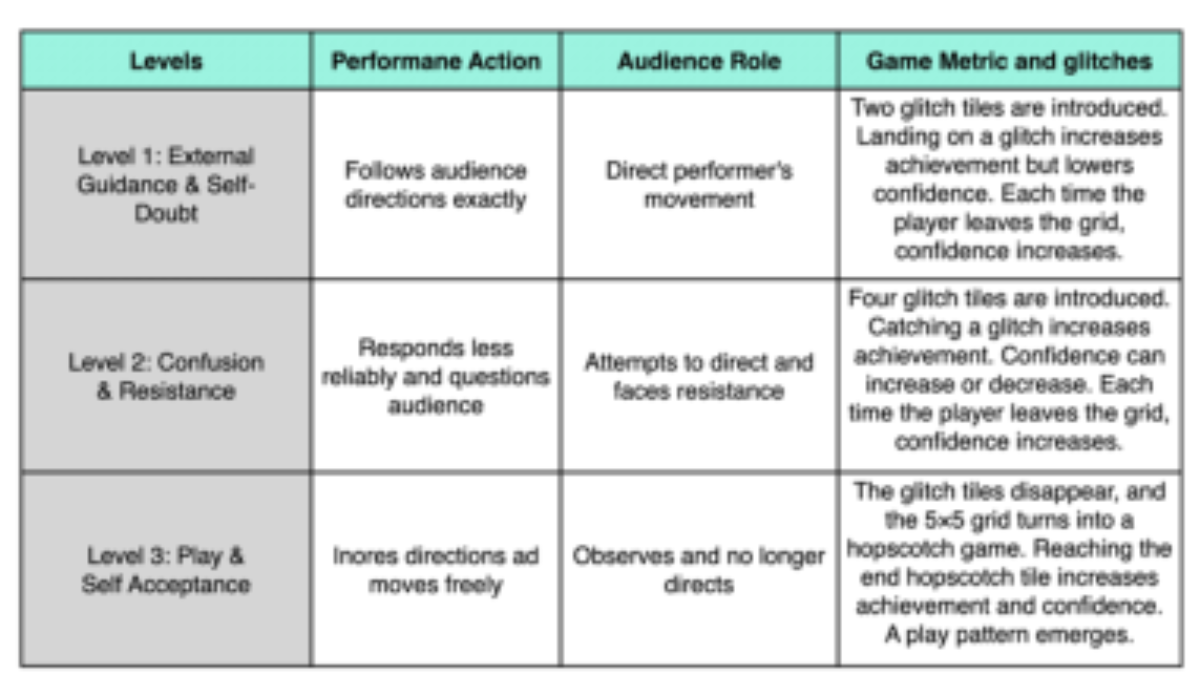
论文图 2。原论文 Figure 2:“Table shows three levels of the performance game system, detailing performer actions, audience roles, and game metrics or glitches at each stage.”。
上图即论文中的关卡对照表,像素可读出第一关引入两个故障 tile、第二关引入 4 个故障 tile、第三关故障消失并转为跳房子。第一关抓住故障加成就但降自信,离网则加自信。第二关抓住仍加成就,但自信可升可降。第三关到达跳房子终点同时加成就与自信。注意原图英文有拼写粘连,但行列含义完整,复述时以正文对脱钩与同步的定义为准,不要把拼写问题当成规则差异。
成就与自信如何脱钩又重逢?
计分器的关键是两条进度各有自己的更新规则。白话来说,成就是记功劳的账本,自信是记心情的账本。原文明确说,在第一关与第二关,成就更新主要与抓住激活故障绑定,抓住加成就,错过扣成就。离网状态则加自信,鼓励表演者 playful 地离开被评价的任务空间。每一关再通过离散游戏事件更新分数,离开网格也算一种事件。
冒充者现象 × 成就与自信双计分: 冒充者现象负责提供戏剧矛盾,即明明有能力却持续感到欺诈与不配;成就与自信双计分负责把这种矛盾变成可操作的游戏状态,前者记录抓住故障等事件成功,后者独立涨落。两者搭配的理由是单一条分数只能表达输赢,无法表达成功了反而更心虚,组合后新增的作用是让表演者与观众同时看到物质成功与自我评价的脱钩过程。
第一关故意解耦:成功更新让成就上升但自信下降,建立核心矛盾。第二关保留脱钩但让关系不稳定:成功仍加成就,自信可能升也可能降。第三关改用另一套规则:没有可抓的故障,只有一个成功条件即到达二十二号格即跳房子终点,此时成功更新同时推高成就与自信,象征开始把成功内化为确信。更一般地说,第三关成功更新让两条进度同向移动。
跳房子图案 × 自我接纳: 跳房子图案负责在第三关替换严格的 5 乘 5 网格,把任务空间从工作式格子变成游乐场式路径;自我接纳负责提供心理叙事终点,即不再追问观众而自主移动。搭配理由是如果一直保留故障追逐,表演无法收束,组合后新增的作用是以到达特定终点格同时提升成就与自信来象征内化成功,与前两关的脱钩形成对照。
为避免把表格当成装饰,下面用可核对的原文数字把规则收拢成一张五列对照表。阅读重点不是背诵加减号,而是记住事件到双计分的映射在三关里是不同的函数。第一关的反直觉下降是设计意图,不是程序错误。第二关的随机涨落对应原文所说的波动。第三关的同步上升对应自我接纳的叙事收束。
下面这张表提出的核心比较是:同样是抓住或到达目标格,三关的双计分走向有何不同?公平条件是抓住都指在激活期内踩中对应格,错过都指在熄灭前未踩中。成就方向是越高表示事件成功越多,自信方向是越高表示自我评价越稳,但两者不可互相换算。
| 关卡与网格 | 触发事件 | 成就变化 | 自信变化 | 可复述条件 |
|---|---|---|---|---|
| 第一关 5×5 网格 0-24 编号 | 踩中激活故障 | 上升 | 下降 | 在激活期内踩中预设故障格 |
| 第一关与第二关通用 | 错过激活故障 | 下降 | 按关卡规则波动 | 故障熄灭前未踩中 |
| 第一关与第二关通用 | 离开网格敲镲 | 不变 | 上升 | 走出网格并敲击物理镲片 |
| 第二关 5×5 网格 | 踩中激活故障 | 上升 | 可能上升或下降 | 故障更频繁且表演者部分抵抗指令 |
| 第三关 跳房子 到达 Cell 22 | 到达终点格 Cell 22 | 上升 | 上升 | 无故障可抓,沿跳房子路径自由移动 |
表后需要解释主要收益与代价。收益是脱钩让冒充者循环变得可见,观众能同时看到功劳账本与心情账本反向走。代价是规则必须口头讲清,否则观众会误以为计分器坏了。未胜出项是第二关的自信波动,它故意不给出稳定正反馈,因此不能当作激励设计的范本。未评测边界是观众喊错格或同时喊多个格时的仲裁机制,原文未规定,复现时需自行记录处理方式。
声音引擎如何让移动长成音乐?
声音引擎的输入是网格位置与故障状态,输出是实时合成的音乐与两种成就宣告。白话来说,自适应声音引擎就是会看游戏脸色的乐队,表演者走到哪里、故障亮了多久,它就换配器。玩家在网格上的移动激活不同合成器音色,成就越高织体越密。每个故障 tile 要么加入新动机,要么打断当前纹理,引擎按激活故障的持续时间动态调整混音,哪个故障被触发,哪层声音就更突出。
故障美学 × 自适应声音引擎: 故障美学负责把系统失灵定义为表达材料而非需要消除的噪声,主张失败即功能;自适应声音引擎负责把网格移动、成就增长与故障激活转成实时分层合成。搭配理由是如果故障只停留在视觉上,音乐就无法随不确定性生长,组合后新增的作用是每 1 次踩中或错过故障都同时改变混音比例与动机密度,让错误直接可听。
分关处理很具体。第一关保持稀疏织体,鼓励观众开口指挥。第二关把 5 乘 5 网格当作 5 步进、5 层步进音序器,表演者走过即开关步进,结果是更密更连续的推进感。第三关把预录的人声问句我该去哪里当作主要声音材料,表演者越自主,引擎越减少外部互动,突出即使成就累积、自信回升,冒充者念头仍在场。到第三关人声慢慢淡出,象征从怀疑转向确信。
宣告设计有两层。系统在抓住故障瞬间立即播放一段短的预录反转镲片,表演者随后离开网格敲一下舞台上的真镲,在表演空间内宣告成就。离网因此既是游戏规则也是隐喻: relief 与确信不来自任务内表现,而来自中断、重构或外化。预录人声在第一关由真人现场提问以建立直接联系,第二三关则用录音与现场叠放,制造不确定性与外部压力。
下面是数据流总览的导读。主路径从脚到声音再到观众提示形成闭环,任一环节的时序都会改变音乐密度,理解这张图才能理解为何校准与关卡切换必须做成演出的一部分。
看图路径: 1. 先沿表演者到 Python 再到 Processing 的主路径追踪脚部位置数据流;2. 再看 Processing 与 Max 之间格子状态与关卡推进的双向箭头;3. 最后确认观众与游戏之间的虚线提示回路在哪里闭合
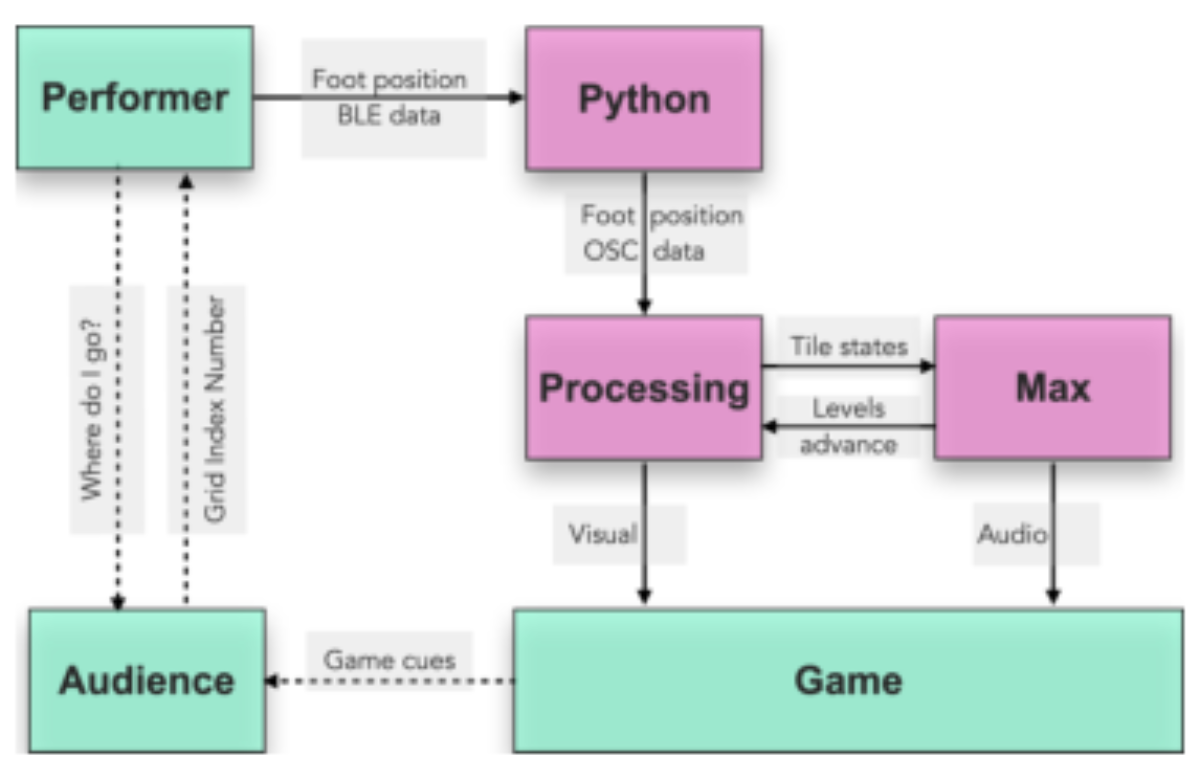
论文图 4。原论文 Figure 4:“The diagram shows the data flow in an interactive game-piece system where a performer’s movements are tracked and processed by software, influencing the game and involving the…”。
上图显示表演者脚部位置经低功耗蓝牙送入 Python,校准后经开放声音控制协议送入 Processing,Processing 把坐标离散为格子索引并更新游戏状态,再把每格状态送往 Max 做音频与时机控制,Max 按总时长回送关卡推进信号。Processing 同时输出视觉给游戏画面,游戏画面再给出提示引导观众喊号。虚线表示口头问答与提示,实线表示数据流。复述时要分清实线是机器传输,虚线是人口头交互,不能混为一类延迟。
位置与视觉如何从脚步变成格子?
追踪硬件选用的是可穿戴足部追踪设备,型号写为 RT-BLE-001r3。白话来说,它就是绑在鞋上的小盒子,内含惯性传感器与板载计算机,通过低功耗蓝牙向附近设备广播透明协议数据。论文给出的尺寸与重量是理解佩戴负担的关键,右图舞台照片也显示它固定在鞋带处。Processing 收到校准后坐标,主循环把连续坐标离散为格子索引,再按关卡施加故障、更新玩家状态,并持续把每格状态回送给音频引擎。
观众参与 × 网格移动规则: 观众参与负责提供外部指令与验证压力,观众喊出格子编号决定表演者去向;网格移动规则负责把口头指令离散化为可行走的格子索引与离网判定。搭配理由是只有口头互动而无空间约束,权力关系无法被记录,组合后新增的作用是服从、抵抗与自由移动都变成位置轨迹与计分事件,成为可复述的表演数据。
足部追踪 × 开放声音控制协议: 足部追踪负责连续采集脚部位置与朝向,解决表演者在舞台上自由走动时的定位问题;开放声音控制协议负责在不同软件之间传递校准后坐标、格子状态与关卡切换信号。搭配理由是传感与游戏逻辑、声音合成写在不同环境中,必须解耦,组合后新增的作用是形成表演者到声音再到观众提示的闭环,任一环节延迟或丢包都会直接影响游戏反馈。
视觉侧由类来管理网格布局、成就与自信,格子可按游戏状态显示随机颜色与覆盖层。表演者移动直接决定触发哪些视觉与计分事件。关卡切换由 Max 按设定总时长经开放声音控制协议通知 Processing,Processing 等到开始或结束信号后先显示短暂关卡标题再进入游玩。这种设计把时间控制权交给声音侧,保证音乐结构与游戏结构同拍。
校准算法值得单独走一遍。Python 在演出前经低功耗蓝牙连接设备并做短暂校准,采集使用者前后走时的若干位置样本,取最远距离样本用反正切求出前进方向角,再构造绕垂直轴的旋转矩阵作用于后续所有位置向量。目的是纠正每个人自然的足前进角差异,让向前移动按行走方向度量,而不是按传感器贴歪的角度度量。原文明确说采集 15 个位置样本,这是复现时必须保留的数字。
没有神经网络训练时,什么在更新、什么被冻结?
本研究没有训练神经网络,也没有梯度、损失函数或权重更新,因此 training 一节的任务是讲清真实的计算过程,而不是硬套训练话术。未训练的包括任何音频分类器、姿态估计器与生成模型。系统调用的是既有惯性解算与 3 段现成环境:Python 做传感接入与位置纠正,Processing 做游戏逻辑与视觉,Max 做自适应合成。参数冻结的是传感器内惯性解算,监督来源是表演者脚步与观众口令,重置时机是每关过渡时回到起点做前后 stepping 重新估计前进角。
构造流程按时间展开更易复述。演出前连接蓝牙并采集 15 个样本求前进角。演出中 Python 持续纠正足前进角并经开放声音控制协议流式转发。Processing 每帧离散化为零到二十四索引,查故障激活表,更新成就与自信,输出视觉并回送每格状态。Max 根据格子状态与关卡推进信号调整分层合成与混音,同时处理反转镲片与人声问句的触发与淡出。关卡推进按总时长触发,不是按分数阈值触发,这一点决定了表演时长可控。
必须指出的缺项是,原文未报告坐标平滑窗口、离散化网格原点与尺度标定方法、故障随机激活的具体分布与种子、开放声音控制协议地址与发送频率。未报告不等于随意,复现时应把这些记为待补参数,并在演出记录中固定下来。由于没有学习,系统输出不是确定性求解,同样一段观众喊话因故障随机 timing 与表演者步态差异会产生不同音乐,冻结参数不能保证每次演出相同。
演出与传感条件:舞台、硬件与可运行链路是什么?
实验条件在这里就是演出条件。空间上表演者可在舞台自由走动,不限于固定站位,当前配置用一面镲作为舞台提示物,成功穿越故障并离网后由表演者敲击宣告。未来设想包括户外用编钟替代镲,以及探索其他声音图标与宣告方式。时间上 Max 按设定总时长控制关卡切换,Processing 等信号切关,这意味着复现必须先定总时长再排练。交互上观众口头喊目标格,表演者据此选择移动,全程分数与自信被监视并显示,给所有人清晰反馈。
硬件链路的导读如下。左图用硬币做尺寸参照说明模块之小,中图显示模块如何绑在鞋上,右图显示舞台上投影网格、表演者站位与镲的位置关系。三图连起来回答的是佩戴是否影响动作、视线是否能同时看到人与网格。
看图路径: 1. 先看左图白色小模块与硬币的尺寸对照,确认佩戴体积;2. 再看中图模块固定在跑鞋鞋带处的位置与舞台胶带网格;3. 最后看右图表演者站在投影网格前的站位与背后镲片的摆放
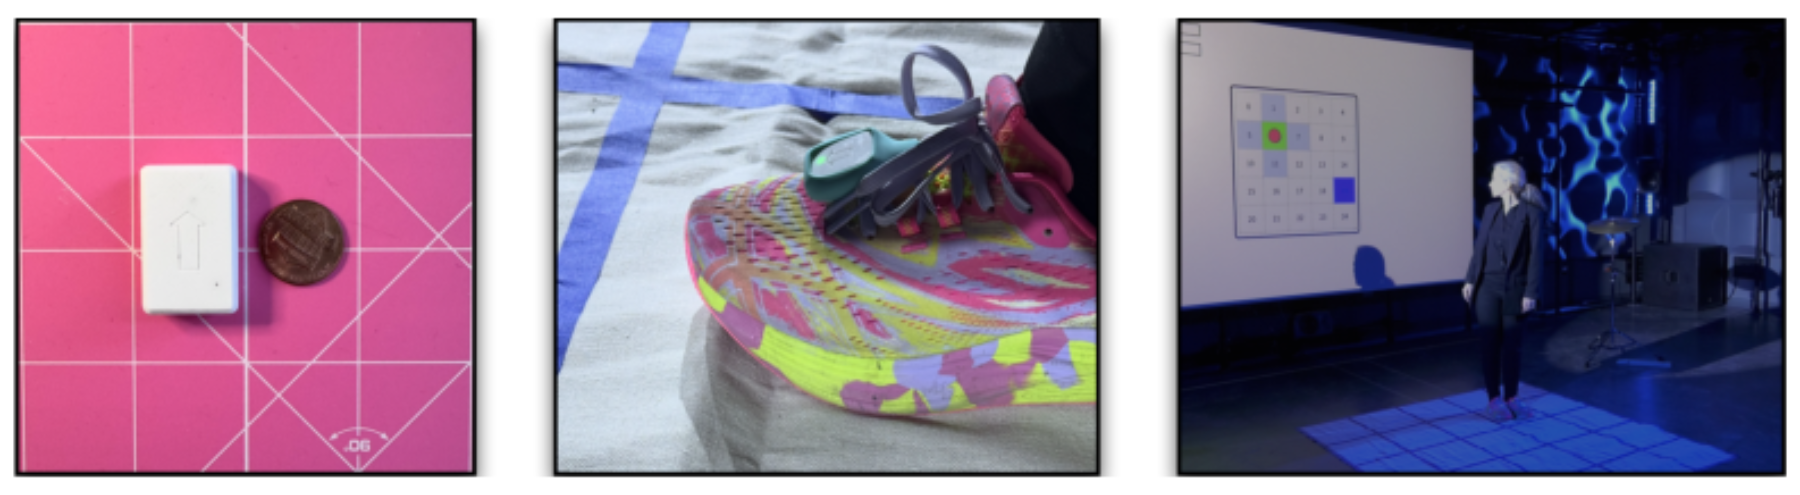
论文图 3。原论文 Figure 3:“Left panel shows the battery and microcontroller with a quarter for size reference.”。
上图实际像素与图注存在差异需要明确标注。图注写左中右为电池与微控制器、包裹成模块、嵌入球体并有开口,但本次收到的像素左图是白色小盒与硬币在粉色切割垫上,中图是绑在彩色跑鞋鞋带上的绿色小模块,右图是表演者站在投影网格与蓝色舞台灯光前。解读以像素可见内容为准:体积约硬币大小量级、佩戴位置在鞋面、投影网格与真人同框。这是一个原文图注与像素不一致的冲突点,复述时不应编造球体,只能说当前可用像素显示的是鞋载形态。
下面把传感器关键规格收成五列表,阅读问题是:这套追踪能否支撑慢走与慢跑幅度的舞台移动并撑完整场?条件是同一设备在演出与临床步态分析中通用,指标方向是误差越小越好、续航越长越好、频率越高越跟脚。
| 设备与形态 | 采样与速度 | 精度指标 | 供电指标 | 数据链路 |
|---|---|---|---|---|
| 30 × 20 × 8 mm, 6 gm 鞋载模块 | 高达 100 Hz, 支持约 3 m/s 慢跑速度 | 步间误差低于 1%, 水平定位误差低于 24% | 续航超 12 小时, 1.5 小时充满 | 低功耗蓝牙实时广播位置与朝向 |
| 惯性加板载计算独立运行 | 连续步进追踪 | 适用于 5×5 网格离散 | 允许不间断演出 | 透明协议送至附近蓝牙设备 |
| 需纠正足前进角 | Python 采集 15 个位置样本求前进角 | 按行走方向而非传感器朝向度量 | 每关回起点做前后 stepping | 经开放声音控制协议转发至 Processing |
表后解释收益与代价。收益是自包含抗干扰、适配多种场地,且精度足以把脚步离散到 25 个格。代价是每关过渡必须回起点做短暂前后 stepping 以重校准,原文说已将其排练成表演动作让观众不易察觉,但仍是中断。未评测边界包括多人同时佩戴、金属舞台干扰、大范围户外定位漂移,原文未给数据,复现时不应承诺同样精度。资源状态方面,论文正文给出 Python、Processing、Max 与设备厂商官网链接,本次核验显示 4 个链接当前可用,但可用仅表示链接可达,不代表代码开箱可运行。
现场看到了什么:三幅画面证明了哪种变化?
本作是艺术实践而非对照实验,因此结果是系统行为与舞台现象的报告,不是准确率提升。直接报告的是三关行为差异:第一关严格跟随,第二关部分抵抗,第三关自由移动。支持的判断是双计分成功地把脱钩演出来了,观众能看到成就涨而自信跌,以及离网敲镲后自信回升。有限解释是这种可见性可能引发关于自我怀疑的对话,原文引用了同伴支持研究,但并未在本演出中测量观众心理量表,因此只能写可能与待验证。
三联快照的导读如下。左幅马赛克式故障背景对应不稳定期,中幅清晰网格与大字母故障覆盖对应可读的解谜期,右幅暖色云状背景与白色跳房子对应自由游戏期。每幅顶部都有绿色成就条与蓝色自信条,表演者剪影与红色位置点标出当前格。
看图路径: 1. 先比较三幅画面顶部成就与自信进度条的长度与百分比变化;2. 再看中幅五乘五网格上的编号格与彩色故障覆盖的分布;3. 最后看右幅跳房子白色路径与背景暖色故障纹理的替换关系
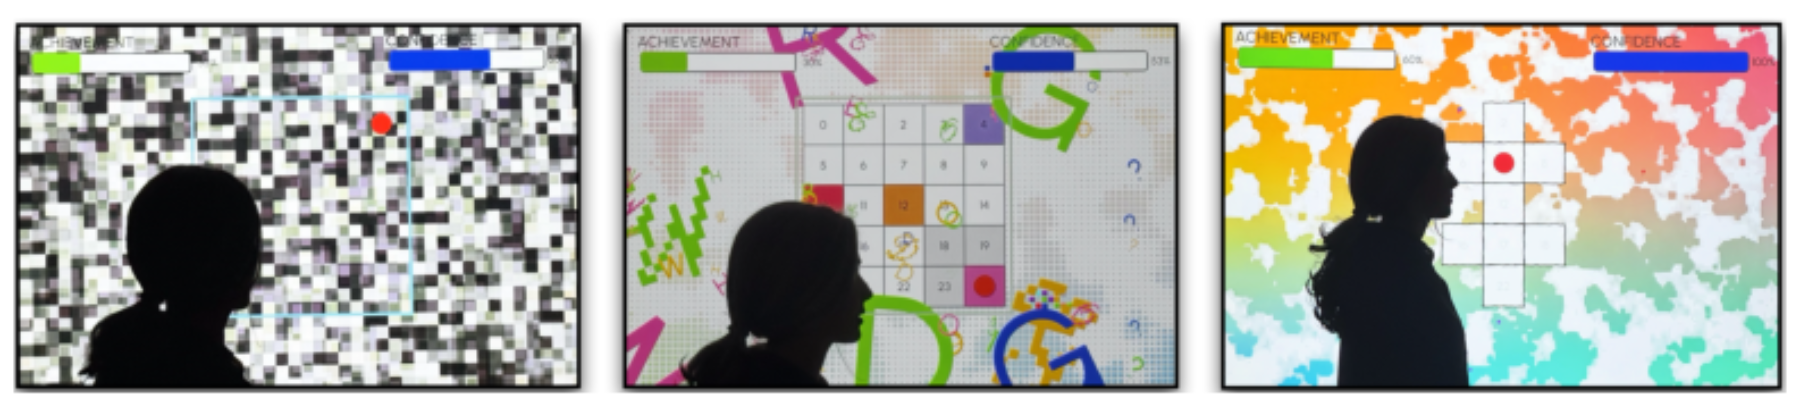
论文图 1。原论文 Figure 1:“A three-panel snapshot shows the player moving through glitch-tile puzzles in Level 2 and a hopscotch pattern in Level 3, with Achievement and Confidence meters tracking progress.”。
上图可见内容支持三点。第一,双进度条始终同框,说明评价是双通道的。第二,中幅网格编号与多色故障块同框,说明故障是预设位置加随机激活,而非全屏噪声。第三,右幅跳房子白色连通块替换了网格,红色圆点仍标记位置,说明追踪在第三关继续工作,只是成功条件变了。像素不能精确辨认百分比数字时不要硬写,复述以走向为准:左到右成就总体累积,自信先抑后扬。
为把行为与声音对应起来,再用一张五列总表收拢可核对的演出事实。比较问题是:同一套移动输入在三关如何产生不同音乐与宣告?公平条件是同一表演者、同一追踪链路、同一 Max 混音框架。音乐密度方向是第一关稀疏、第二关变密、第三关转向人声材料处理。
| 关卡 | 表演者与观众关系 | 网格与成功条件 | 声音纹理 | 宣告与人声 |
|---|---|---|---|---|
| 第一关 外部指导 | 完全跟随喊号,人形光标 | 5×5 网格,踩中激活故障,0-24 编号 | 稀疏,鼓励互动 | 抓中播反转镲片再敲真镲,现场问我该去哪里 |
| 第二关 混乱抵抗 | 部分抵抗并质疑,自信波动 | 5×5 网格,故障更频繁,随机激活 | 5 步进 5 层音序器,开关步进变密连续 | 录音问句与现场叠放,突出外部压力 |
| 第三关 游戏接纳 | 自由移动不再提问,观众观察 | 跳房子,到达 Cell 22 同时加成就与自信 | 处理预录问句为主,减少外部互动 | 人声渐淡,象征转向确信 |
表后补充代价与反例。代价是第二关密度上升可能掩盖个体故障动机,观众听感是推进而非点状事件。反例是如果表演者始终不抵抗,第三关的自主叙事就不成立,因此抵抗不是失误而是剧本要求。未胜出项是第一关的稀疏织体,它在音乐丰富性上不如第二关,但它是建立指令关系所必需的,不能因不够热闹而删去。
如果拿掉某个机制,叙事还成立吗?
原文没有做消融实验,本节按证据讲反证推理,不补写拿掉后必然怎样。第一个可讨论的是双计分。若把自信条拿掉只留成就,冒充者循环的脱钩就无法被看见,观众只能看到抓故障得分,第一关的核心矛盾消失。这个判断来自原文对第一关故意解耦的陈述,属于支持性解释,不是测量结论。
第二个是故障随机性。若故障位置与时间全固定,表演变成背板跑位,观众喊号的意义下降,不确定性带来的创造力也就无从谈起。原文说故障位置与主题预设、激活时间与持续时长随机,这种半固定半随机的安排理由是既保证可排练,又保留意外。若改为全随机,则排练与声音设计难以对齐,但原文未测试该边界,应标为待验证。
第 3 个是离网加自信。若取消离开网格加自信,敲镲就退化为音效,无法表达靠中断与外化获得 relief 的理论点。原文明确把离网写成核心游戏规则,并与冒充者文献中靠中断重构获得确信的观点对齐。复现时若场地不允许离网走动,必须设计等价的中断动作并记录,否则第三关的同步上升会显得突兀。
当前局限:哪些结论还不能下?
实践局限首先是校准中断。每关过渡表演者必须回到起始网格位置做短暂后退与前进 routine 以保证追踪准确。原文承认这是技术准确性所需,但已将其内置为表演并排练到观众不易察觉。复述时不能承诺零打断,只能说打断被编舞化了。户外、金属舞台、多人干扰下的精度原文未报告,不能外推。
证据局限是缺少定量评估。没有观众规模、喊话次数、抓中率、错过率、双进度数值序列,也没有前后测问卷或访谈编码。伦理部分提到有匿名调查正在进行以讨论学术场景中的成就、失败与冒充者现象,但本次论文未给出结果。因此关于缓解自我怀疑、增强社区联结的说法只能写成意图与可能,不能写成已显示有效。
概念局限是失败的自由不平等。讨论部分引用失败简历的例子指出,已获终身教职的教授公开失败是勇敢教学,学生与早期研究者公开失败可能被视为能力不足。作者承认不是每个人都有同样的失败自由,新乐器领域提供的是一个可开始对话的空间,而非保证安全的空间。这一段是理解作品伦理分寸的关键,复述时要保留:鼓励脆弱不等于要求所有人以同样方式脆弱。
复现先做什么:按什么顺序搭起可运行链路?
第一步先搭最小可玩闭环,不要一开始就做三关。准备一台可跑 Python、Processing 与 Max 的电脑,一个鞋载追踪器,一块投影或大屏,一个镲。Python 负责蓝牙接入与足前进角纠正,Processing 负责把坐标离散为零到二十四索引并显示网格与双进度条,Max 负责按格子状态发声并按总时长切关。三者经开放声音控制协议互联,先用固定故障激活表调通,再加入随机时长。
第二步固定演出脚本。开场口头导览加节目单注释必须保留,告诉观众喊编号规则与故障喊法。第一关练习完全跟随,第二关练习延迟跟随与质疑语气,第三关练习沉默自由移动与跳房子路径。每关过渡练习回起点前后 stepping,把校准做成走位而不是暂停调试。敲镲时机固定为抓中后离网,系统反转镲片与真镲先后关系不要颠倒。
第三步记录待补参数以便他人复跑。包括网格原点与尺度、平滑方法、故障激活分布与种子、开放声音控制协议地址与频率、总时长与每关时长、观众喊话仲裁规则。原文未给出这些,复现报告应如实写未沿用原文值而是自定值。还需补的验证是抓中率与双进度序列的日志,以及观众访谈或问卷,否则无法判断脱钩是否被观众感知。代码层面原文致谢提到设备方 Python 代码开源使定制成为可能,但不等于本作全套工程已公开,复现前应先确认可获得的代码范围与权重无关,本作无模型权重可下载。
何时值得尝试这种把心虚变成游戏的方法?
当你的研究问题本身就是评价压力、自我怀疑或失败利用,而不是音质或准确率时,这套方法值得尝试。它把抽象心理转成可走、可听、可被观众干预的规则,适合新乐器、音乐剧场与参与式工作坊。反之,如果目标是稳定触发、低延迟乐器演奏,就不应照搬脱钩计分与随机故障,因为它们故意制造不稳定。
一句话收束:用观众指挥、故障捣乱与双进度条,作品让成功与确信分开走了一段,再在跳房子里重逢。对研究生而言,可带走的不是一段旋律,而是一个可复述的构造:15 个样本求前进角、3 段软件各司其职、抓中错过离网 3 类事件驱动双计分、稀疏到密集再到人声处理的音乐弧线。补上日志与观众评估后,这个框架才能从 1 次动人的演出变成可比较的研究。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses