英文题目:Integration of Freesound content in creative applications and sound interfaces: a survey of use cases.
会议身份:
conference:nime:2026:conference-paper-id:nime2026_37
✅ 来源为官方会议 PDF;表格与 Figure 按原文证据绑定。PDF 公式以原页区域图片展示,未冒称作者原始 TeX。
标签:#文献综述方法 #音乐 #音频交互 #音频检索
评分:5.9/10 | 创新 1.3/2 | 技术严谨 1.0/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 1.0/1.5 | 开源 0.0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:综述
👥 作者与机构
- Panagiota Anastasopoulou:机构信息未能从会议 PDF 纯文本可靠映射
- Frederic Font:机构信息未能从会议 PDF 纯文本可靠映射
- Xavier Serra:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
本文以分散的创意应用与声音界面为输入,输出其集成Freesound异构声音库的方式分类与利用格局,难点在于系统形态、交互模态与元数据质量差异大,难以统一比较可达性与探索深度的权衡。方法链分三步:先以Freesound Labs条目、应用程序接口日志与GitHub文档检索汇聚60个符合创意交互标准的系统,再沿中心性、交互性、检索过滤、输入模态与操控类型五轴编码各系统的检索与操控行为,最后汇总分布并结合Web与应用程序接口周查询日志解读基础设施利用不足。编码输出直接进入分布汇总,使生成式集成与探索式集成得以在同一分析框架下比较。与既有孤立案例介绍相比,关键差异在于区分用户可控过滤与预置后台查询,并以共享分析轴揭示趋同的窄交互模型,其意义在于指明未被利用的相似检索与内容描述符能力。在60个系统组成的调查语料任务下,声学检索的应用数量指标为6个,低于相似检索的应用数量指标7个。该结论的适用边界在于样本依赖公开文档与可识别的接口客户端,闭源商用工作站与无密钥调用系统覆盖受限,向全部创意生态外推尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://github.com/overtone/overtone — 链接可访问(HTTP 200)
- 第三方资源:https://github.com/iwkse/freesound — 链接可访问(HTTP 200)
- 第三方资源:https://github.com/charlesneimog/py4pd-freesound — 链接可访问(HTTP 200)
- 第三方资源:https://playground.mlalabs.xyz/ — 链接可访问(HTTP 200)
- 第三方资源:https://hathor.uno — 链接可访问(HTTP 200)
- 第三方资源:https://five23.github.io/plexure.js/index.html — 链接可访问(HTTP 200) 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
研究对象是什么:从网页声库到可编程的声音基础设施?
这篇论文的研究对象不是某一个乐器或某一个模型,而是围绕 Freesound 这个大型社区声音库长出来的创意应用群。白话说,Freesound 是一个用户上传、按知识共享许可开放的声音仓库,论文报告其规模超过 720,000 条声音、注册用户超过 16,000,000。对刚入门的研究生而言,关键是把 Freesound 理解为双重存在:一是浏览器里可搜可听可下载的网站,二是可被程序调用的应用程序编程接口,英文名是 Application Programming Interface,缩写 API。网站解决人找声音的问题,接口解决程序替人找声音、把声音嵌进别的工具的问题。
论文要回答的是,当声音从网页下载变成被鼓机、插件、硬件采样器和网页乐器实时调用时,设计者到底用了 Freesound 的哪些能力,又留下了哪些没用的能力。输入是论文收集到的 60 个创意应用与声音界面,目标是给出可复述的分类与趋势判断,输出是一组分析轴、分布统计和设计启示。必须保留的信息包括数据来源构成、每条分析轴的定义、检索与过滤的使用比例,以及作者明确指出的未充分利用之处。
本解读只讲论文实际调查的任务,不把通用音频检索教学例子当作论文结论,凡属帮助理解的例子都会标明是例子。
与哪些路线相关:普通搜索工具为何被排除?
与本研究路线最接近的有 4 类。第一类是普通检索工具,例如论文点名的 MuSST 和 CCMusicSearch,它们解决按关键词找到文件的问题,但不支持把声音作为创作材料去触发、编排或变换。第二类是以视频或游戏为中心的集成,例如 Blender 插件和奖励电路类应用,声音是配角而非创作主材料。第 3 类是只用固定精选声音包的非交互作品或小型库封装,例如简单封装库和纯离线数据集复用,它们不考察与线上声库的持续交互。
第 4 类是档案与数据集建设,例如海滩声音档案和 Freesound 衍生数据集,它们服务保存与训练而非实时创作。论文把范围限定为以声音为中心、支持创造性参与的系统,英文可表述为 creative applications and sound interfaces。这一限定直接决定了后文的纳入标准:如果一个系统不能检索、处理、探索或以演奏方式使用声音,即使它调用了接口,也不在本次统计之内。
理解这一点才能明白为什么论文一方面说接口每周约有 1,000,000 次搜索请求,另一方面强调其中很大一部分来自训练数据批量下载,不属于本研究的创意交互范畴。
核心矛盾是什么:中央地位为何不等于深度探索?
论文提出的核心矛盾是,Freesound 在很多应用中处于中央位置,但用户对声库的探索能力仍然很浅。白话说,很多工具离不开 Freesound 提供声音,却只给用户留了一个关键词输入框。作者用两个独立维度拆开这个问题。第一个维度是中心性,英文 centrality,指声库在工作流中有多重要:是可有可无的补充,还是主要声音来源,还是整个界面的概念核心。第二个维度是交互性,英文 interactivity,指用户能否主动检索、过滤、导航并得到即时反馈。
论文的判断是,高中心性加高交互性才最有利于用户驱动的探索,而调查显示前者常见、后者稀缺。造成这种局面的原因不只在观念,也在约束:硬件、现场演出和低延迟场景难以承担反复查询;网页宿主希望降低认知负荷;声音质量、标签完整度和授权差异带来摩擦。于是大量系统收敛到文本搜索加少量过滤的最小可用模式。
这就引出后文的方法全景:必须同时记录用了什么检索、给了什么过滤、允许什么输入、拿到声音后做了什么操作,才能判断探索是真丰富还是假丰富。
方法全景:如何从 60 个应用中读出设计模式?
论文的方法不是训练模型,而是 1 次系统性比较调查。整体动作可分为 4 步。第一步是建库:从 Freesound Labs 当时收录的 56 个条目中筛出 42 个符合创意交互定义的项目,再分析 2021 至 2025 年五年间累计查询超过 10,000 次的接口客户端,并检索公开代码仓库文档中提及 Freesound 的内容,补入 18 个项目,最终形成 60 个对象的集合。第二步是定轴:定义中心性、交互性、检索与过滤、输入机制、操作类型 5 组分析轴。
第三步是逐项手工分类,把每个应用按统一规则打标,例如交互性分为无、受限、基础、高级四档,操作类型分为获取、增强获取、编排、增强编排、变换 5 类。第 4 步是聚合与对照:统计分布、比较接口日志中的全局使用情况与样本中使用情况的异同,再讨论未被充分使用的能力。
沿一个样本走完全程有助于理解:以鼓机类应用为例,用户输入关键词,系统经文本检索返回候选,用户把声音放入步进网格并循环触发,目标是快速得到可演奏的套鼓,输出是网格加声音的组合状态。 本小节配一张应用拼贴总览,用于建立直观印象:在细读分类数字之前,先看到鼓机网格、2 维声音地图、3 维地球、波形编辑器和现场编码界面确实共存于同一生态。
看图路径: 1. 先扫视拼贴中反复出现的网格鼓机、二维散点和波形列表三类版式;2. 再注意右上 SOURCE 与中部球体等强调空间浏览的界面;3. 最后对比代码型界面与触屏型界面在输入密度上的差异
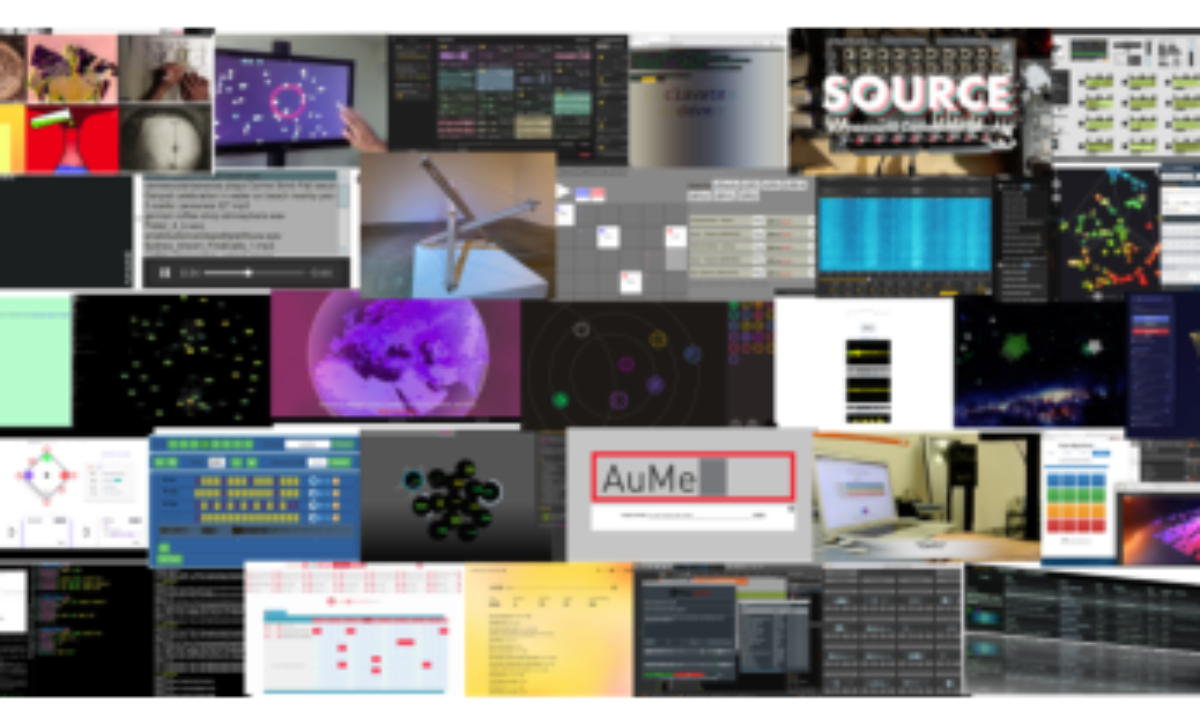
论文图 1。原论文 Figure 1:“Collage of Freesound integration use cases”。
该拼贴报告为创意应用集成用例的合集,像素可见大量界面缩略图紧密拼接,既有深色音频插件式列表,也有彩色散点和地球仪式浏览,右上 SOURCE 字样与中部球体提示空间化探索的存在。这种多样性正是后文分类的动机:如果只看文字描述,会低估界面形态的差异,而拼贴让人先接受一个事实,即同一声库可以支撑鼓机、 soundscape 生成器、硬件采样器和虚拟现实作曲等完全不同的工作流。教学上把它当作例子:看到鼓机就想到编排,看到散点就想到相似检索,看到代码窗口就想到现场编码调用,后文每一组数字都可以回贴到这类版式上。
组件与计算:五个分析轴各自管什么?
第一个组件是中心性。外围意味着没有 Freesound 主任务仍可运转,基础意味着 Freesound 是主要声音来源但不是概念焦点,中央意味着浏览与操作声库就是应用的主目的。第二个组件是交互性。无交互指用户完全不能控制取回过程,例如后台自动抓取;受限指只有极简单的单次查询或后端映射。
基础指至少一种用户可控搜索加至多 4 个元数据过滤;高级指支持两种以上搜索类型。第 3 个组件是检索与过滤。检索分为声学内容、文本语义、相似度 3 类,外加随机作为对照;过滤包括授权、时长、采样数、用户名、声音包、标签、上传日期、声道数、文件类型、文件大小、显式排除和地理位置,排序也被视为影响浏览顺序的机制。
第 4 个组件是输入机制,只统计直接影响声库交互的模态,包括键鼠点选、手势、语音命令、音频输入、硬件控制器和其他模态。第五个组件是操作类型,从轻到重依次为取回即保存、取回即放入工作区、放入结构化网格循环触发、可进一步改变音高裁剪加效果、由系统自动重组或生成。
文本检索 × 内容检索: 文本检索分工是利用标签、标题和描述做概念定位,内容检索分工是利用时长、频谱质心、MFCC、响度等声学特征做声音属性定位,二者搭配理由是语义标签不稳定而声学特征可直接度量,组合意义是同一查询可同时约束想说什么和听起来怎样。
中心性 × 交互性: 中心性分工是刻画声库在工作流中的结构地位,交互性分工是刻画用户能否迭代地检索、过滤和获得反馈,二者搭配理由是重要不等于可探索,组合意义是只有中央且高交互的系统才支持用户驱动的声音发现。
相似检索 × 编排: 相似检索分工是把目标声音映射到声学或语义嵌入空间并返回近邻,编排分工是把取回的声音放入网格或空间并规定触发关系,二者搭配理由是相似性能自动形成可演奏的声音组,组合意义是浏览即作曲,找声音与摆声音在同一动作中完成。
过滤器 × 检索策略: 过滤器分工是收窄结果集如限定授权、时长或声道数,检索策略分工是决定以何种相似性组织候选,二者搭配理由是前者保可用性后者保发现性,组合意义是当过滤足够强时它会实质改变浏览结构,从约束退化为另一种检索。
把组合机制说透很重要。文本加声学不是简单叠加:前者回答找什么概念,后者回答要什么听感,二者结合后可在 1 次查询中同时约束语义与声学。中心加交互不是同义反复:前者决定值不值得探索,后者决定能不能探索,二者结合才能识别伪探索,即高度依赖声库却只给关键词框的系统。相似加编排不是前后无关:前者自动把听感相近的声音聚成一组,后者把这组声音变成可触发的乐器,二者结合让浏览动作直接长成演奏动作。过滤加检索不是主从分明:当过滤条件过强,它会实质主导候选的组织方式,例如只留短采样会把鼓机场景的候选完全改写,此时过滤行使了检索的功能。
有无训练:本研究训练了什么、调用了什么?
本研究没有训练任何神经网络模型,也没有报告梯度路径、参数冻结或优化器配置,因此不存在训练集划分、早停或学习率等事项。必须明确这一点,避免把无训练误读为确定性求解。论文的真实计算过程是调查与测量。第一类计算是日志聚合:取约 3 个月内每周平均的网页与接口搜索量,比较文本搜索端点与原内容搜索、组合搜索端点的请求量,并观察 2025 年接口统一为单一搜索端点后,带内容描述符的请求占比是否提升。
第二类计算是人工分类计数:对 60 个应用按 5 组分析轴逐项标注,再按类别汇总数量与百分比,生成交互性、中心性、操作类型与检索方式的分布。第 3 类计算是接口能力映射:对照文档列出可用的文本查询、时域与频谱描述符、感知属性、高层语义类别、排序与相似检索,以及用户、声音、声音包与合集等结构化端点,再检查样本实际用了其中多少。第 4 类是客户端库盘点:确认存在多种语言的调用封装,论文点名包括 Python、JavaScript、JUCE、SuperCollider、Max/MSP 和 Common Lisp 方向的实现。
缺项也要指出:论文未报告标注者一致性、分类不确定项的裁决流程细节,也未公开逐应用的完整标注表以供重算,所有百分比的聚合口径以正文描述为准。
实验条件:样本从哪来、规模与日志窗口是什么?
要复述方法,先固定 3 个条件。样本条件是 60 个创意应用与声音界面,来源为 Freesound Labs 筛后 42 个加日志与代码仓库补入 18 个,时间跨度覆盖 2008 至 2026 年,排序按年代排列。规模条件是声库侧报告超过 720,000 条声音与超过 1600 万注册用户,访问侧报告网页每周约 12,000,000 次搜索、接口每周约 1,000,000 次搜索,日志聚合窗口约为 11 月至 1 月的 3 个月。
接口条件是 2011 年首版、2014 年第二版增加上传与元数据加描述符组合搜索、2025 年大更新重组元数据检索并引入新的相似空间、描述符与宽泛声音分类体系,原文本、内容、组合 3 个端点合并为统一搜索端点。下表把过滤机制的可用项与出现情况组织起来,比较问题是用户可控过滤与后端预设过滤各偏向哪些字段,公平条件是同一 60 样本集合,指标方向是出现次数越多说明该约束越常被显式处理。
| number samples (n) | 2 | 3.2 |
|---|---|---|
| username (u) | 2 | 3.2 |
| pack name (p) | 1 | 1.6 |
| open | 1 | 1.6 |
| file type (ft) — — | 1 | 1.6 |
| date added (da) — — | 1 | 1.6 |
表后解释需要同时看到收益与代价。原表显示采样数、用户名等字段在用户可控侧仅出现 1 至 2 次,文件类型、上传日期、声道数、文件大小、显式排除、地理位置等在用户侧为零而仅在后端出现 1 次,说明设计者倾向把复杂约束藏在后端,用最低认知负荷给出可直接用的声音。代价是用户失去迭代能力:当后端替用户决定时长或授权,探索的透明度下降,后文交互性偏低的分布与此一致。
未胜出项是地理位置与文件属性类过滤,它们在创意鼓机与插件场景中几乎不暴露给用户,仅在地球歌曲类地理应用中成为主检索,提示过滤的价值高度依赖任务。 输入模态的分布回答另一个公平比较问题:在同一 60 样本下,哪种身体动作真正驱动了声库交互。表前问题是键鼠点选是否因网页化而一家独大,条件是按应用计数与按动作出现次数双口径,指标方向是占比越高说明该模态越主导。
| t | 49 | 77.8 | 68.1 |
|---|---|---|---|
| h | 7 | 11.1 | 9.7 |
| - | 5 | 7.9 | 6.9 |
| a | 5 | 7.9 | 6.9 |
| g | 4 | 6.3 | 5.6 |
| o | 1 | 1.6 | 1.4 |
| v | 1 | 1.6 | 1.4 |
表后解释是,键鼠点选在应用数与出现次数上均占近 70%,硬件、音频输入、手势各占约 10% 或更低,语音与其他模态仅各 1 例。这种集中带来实现收益:文本框加点击最易与网页音频宿主集成;代价是可达性与表现力受限,手势与语音等更具表演性的输入在样本中罕见。未胜出项同样重要:约 7.9% 的应用不提供用户可控输入,它们多为自动生成或后台抓取,提醒读者交互性为零不等于系统无价值,而是任务目标本就不是探索。
主结果:中央多、高交互少、文本搜索一家独大
论文报告的主分布可用三句话概括。中心性上约 57.1% 的应用属于中央,约 22.2% 属于基础,约 20.6% 属于外围,说明多数系统把声库当主角。交互性上基础档占比过半,高级档仅约 9.5%,受限档约 25.4%,无交互档约 7.9%,说明多数系统只给一种可控搜索。检索方式上文本语义出现于 82.5% 的应用,单独只用文本的超过一半,随机、声学、相似各仅出现 6 至 8 次,日期与地理等更少。
操作类型上编排最多,变换次之,获取类合计约占 30% 以上,增强编排最少。作者据此判断 Freesound 兼具基础设施与灵感来源的双重角色,但接口能力远未被用足。 结果小节需要先建立对柱状分布的直读,再谈机制含义。下段先提出导读:左中右 3 组条形分别回答交互是否可控、声库是否重要、拿到声音后做什么,纵轴为应用百分比,横轴为等级或类型。
看图路径: 1. 先看左图交互性柱状在取值为 1 处高达 n 等于 36;2. 再看中图中心性柱状在取值为 1 处同样高达 n 等于 36;3. 最后看右图编排类横条最长而增强编排类最短
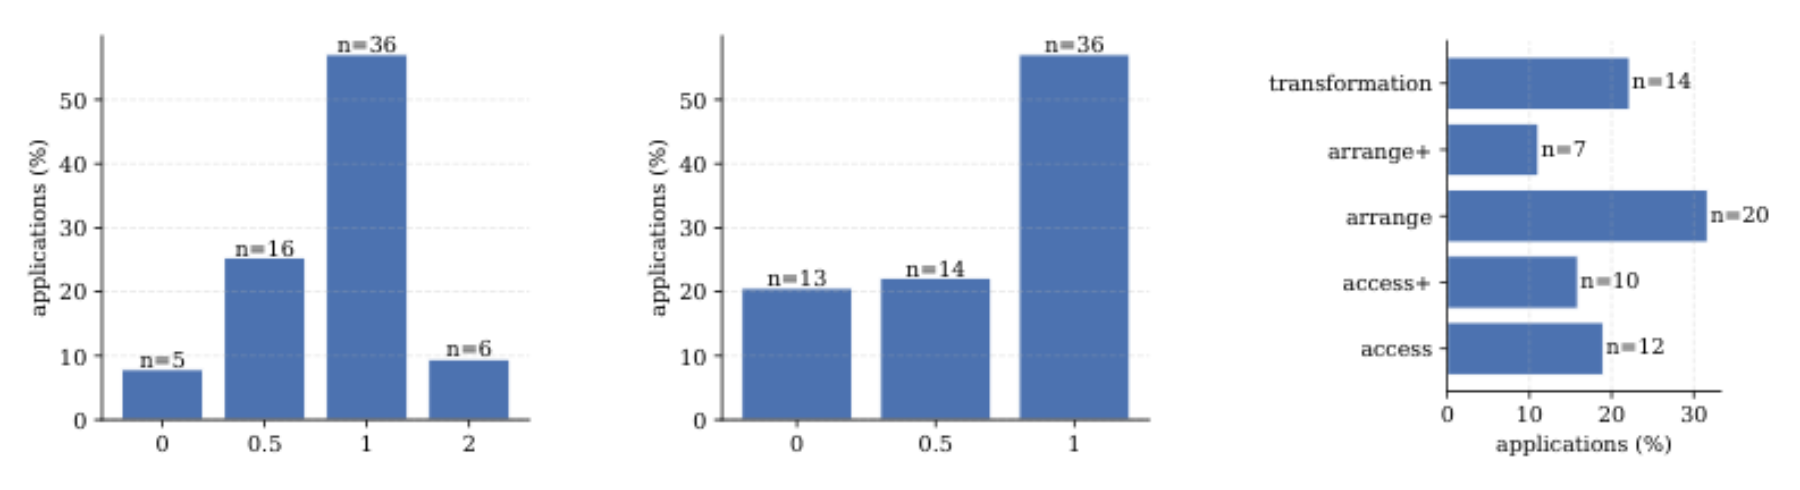
论文图 2。原论文 Figure 2:“Distribution of interactivity, centrality, and type of manipulation across applications.”。
该图报告为交互性、中心性与操作类型的分布,左图可见取值为 1 的柱条显著高于 0、0.5 与 2 并标注 n 等于 36,中图可见取值为 1 的柱条同样最高并标注 n 等于 36,右图可见编排横条最长标注 n 等于 20 而增强编排最短标注 n 等于 7。这种形状支持论文的核心判断:中央常见而高级交互稀缺,编排常见而深度变换与精细编排稀缺。教学上把它当作反证练习:若只看中图会以为探索很繁荣,但左图的高级档很矮,说明重要性不等于可操作性,二者必须联合阅读。
为固定规模印象,下表整理声库与访问量的量级对照,比较问题是网页浏览与程序调用各自承担多大访问压力,公平条件是同一约 3 个月窗口的周平均,指标方向是数值越大说明该通道越是主要入口。
| 条件 | 指标 | 网页侧 | 接口侧 | 比较对象 |
|---|---|---|---|---|
| 同一约 3 个月周平均 | 每周搜索量 | 12 million | 1 million | 网页浏览与程序调用 |
| 声库总体规模 | 声音条数 | over 720,000 sounds | over 720,000 sounds | 全库总量 |
| 声库总体规模 | 注册用户数 | more than 16 million registered users | more than 16 million registered users | 全库用户 |
| 接口细分 | 内容与组合端点月请求 | N≈750/month | N<50/month | 内容端点与组合端点 |
| 新统一端点 | 单描述符峰值月请求 | N≈2,000/month | N≈2,000/month | 带内容描述符的请求 |
表后解释要给出收益与限制。收益是量级对比让基础设施判断可核对:网页仍是主要浏览入口,但接口每周百万量级说明程序化使用已是重要通道。
限制是这些数字覆盖全部接口用途,包括批量下载训练数据,不能直接等同于创意应用的贡献;内容端点月请求仅数百量级、新端点单描述符峰值仅数千量级,提示声学能力的全局使用率极低,但这组全局数字不能替代样本内部分布,后者需看饼图与分类统计。未评测边界是延迟、误检率与授权合规成本,论文未测量这些量,不能从使用率低推出体验差。
反证与消融:拿掉文本搜索会怎样?哪些能力被绕过?
本论文没有模型消融实验,这里的反证指用分布与案例检验检索假设。若拿掉文本搜索,超过一半只依赖文本的应用将无法定位声音,这是文本主导的直接代价。反过来,若只保留文本而不用声学与相似,系统会失去按听感找声音的能力,论文用多个案例说明这种损失已被部分开发者感知:循环生成器与鼓机类应用叠加相似与随机以替换候选,麦克风查询应用用相似匹配输入声音,现场编码扩展用文本加声学组合查询。
但更有力的反证是绕过行为:少数应用取回后在本地计算相似或映射颜色,而不使用接口内置相似;循环应用明明可用声库声学元数据却选择本地分析;三款应用用自定义分析器做后过滤,原因是所需的前背景分类等信息在声库中不存在。这说明未使用不全是观念问题,也有能力缺口与信任问题。 下段先做饼图导读:该图回答每种检索在样本中出现多少次,扇区越大说明依赖越集中,标注同时给出百分比与 n 值。
看图路径: 1. 先确认饼图最大扇区标注为 t 且占比百分之六十五点零;2. 再依次读出 s、a、r 等小扇区的 n 值与百分比;3. 最后观察顶部 da 与 g 等极小扇区几乎只占一条缝
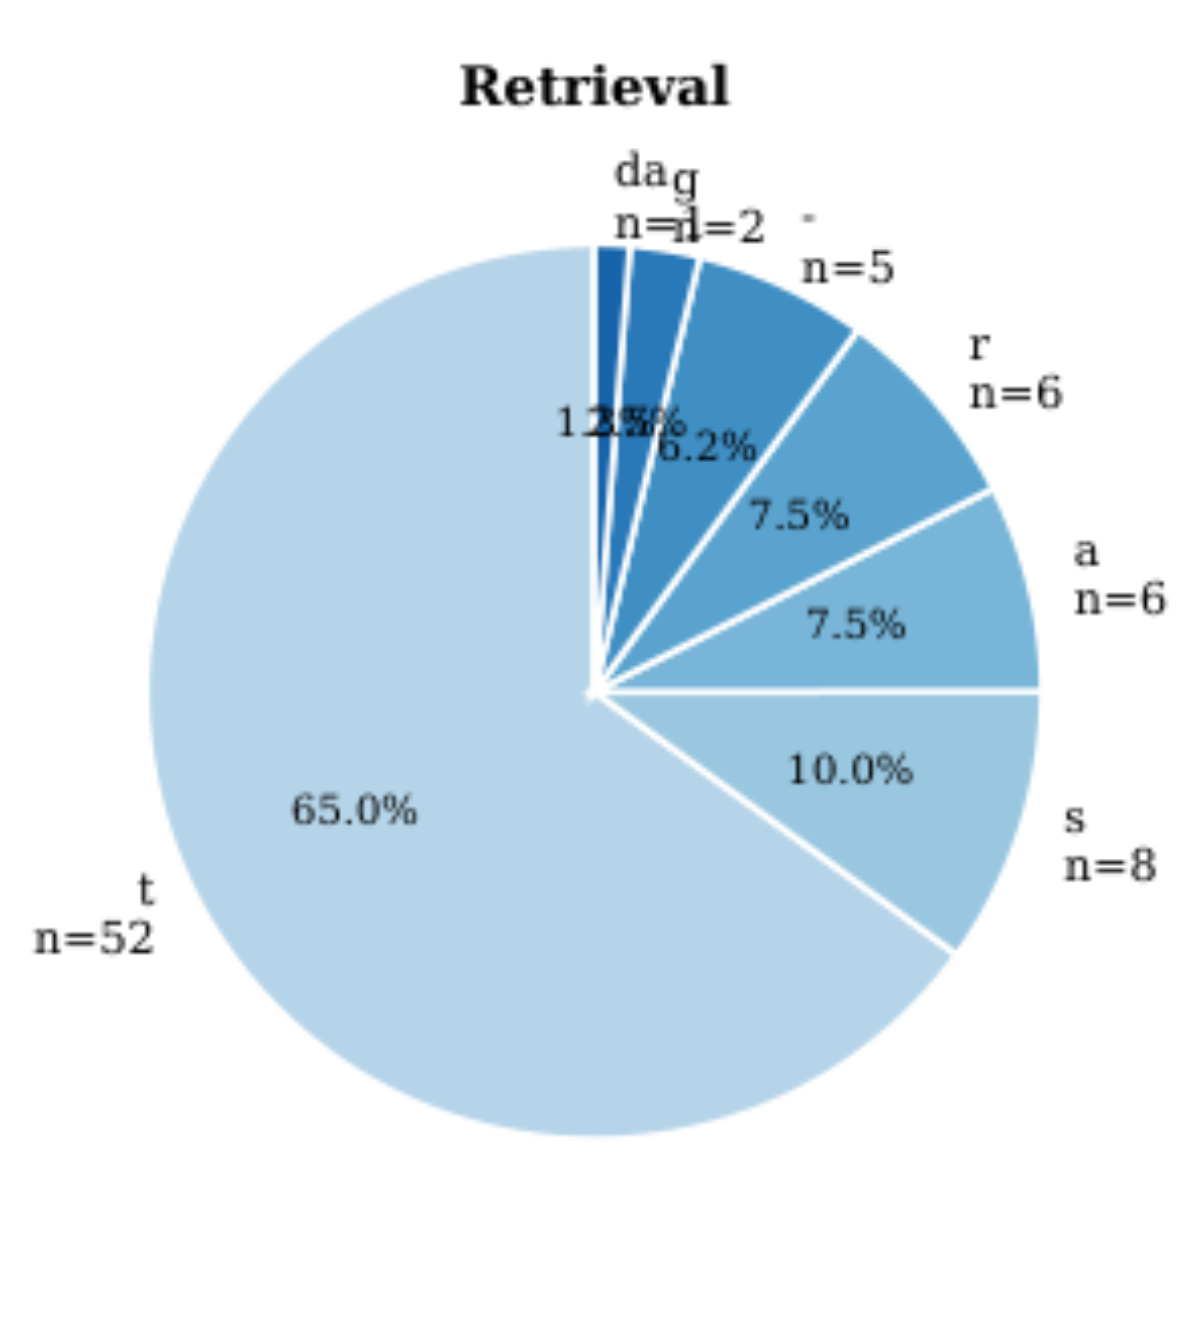
论文图 3。原论文 Figure 3:“Retrieval usage across applications”。
该图报告为检索使用占比,像素可见标 t 的扇区占据约三分之二并标注 65.0% 与 n 等于 52,标 s 的扇区约 10.0% 与 n 等于 8,标 a 与 r 的扇区各约 7.5% 与 n 等于 6,其余极小扇区几乎挤在顶部。这种极不均衡支持论文判断:语义文本是默认路径,声学与相似是例外路径。教学上把它当作条件判断练习:鼓机与音序器场景偏爱短采样,时长过滤因此在后端高频出现;地理应用把地理位置从过滤提升为检索,说明同一字段在不同任务中角色会翻转。
为核对全局日志与样本趋势是否一致,下表整理接口侧的请求结构,比较问题是文本端点是否在全局同样主导,公平条件是同一日志窗口,指标方向是请求数越小说明该能力越少被调用。
| 条件 | 指标 | 文本端点 | 内容端点 | 组合端点 |
|---|---|---|---|---|
| 全部接口用途周平均 | 每周搜索量级 | 1 million | N≈750/month | N<50/month |
| 新统一端点 | 带描述符请求峰值 | N≈2,000/month | N≈2,000/month | N≈2,000/month |
| 样本内应用覆盖 | 使用该检索的应用数 | n=52 | n=6 | n=8 相似作参照 |
| 典型代价 | 可探索性 | 低认知负荷但浅探索 | 需理解描述符但可按听感找 | 需嵌入空间但可发现近邻 |
表后解释需点明两层一致与一层差异。一致的是全局与样本都显示文本主导、内容与组合极少;一致的是新统一端点上线后带描述符请求仍只占极小份额。
差异的是全局数字包含训练批量下载等非创意用途,不能直接推出创意场景的因果;样本中相似检索占比高于全局组合端点,提示创意工具对近邻浏览的需求高于通用调用。未胜出项是日期与地理检索,它们在全局与样本中都极少,说明不是通用解,仅在时间线与地球仪类应用中成立。
限制是什么:样本偏差与未测量的量有哪些?
论文明确承认数据收集受限。第一,Freesound Labs 依赖团队收录与社区提交,个人项目与文档不全的系统易被遗漏。第二,接口日志中大量客户端没有项目链接或源代码,无法纳入分类,高流量早期应用可能因此缺席。第三,未使用接口密钥的调用、未公开仓库的内部工具不在视野内。第四,约 28.6% 的系统缺少预设过滤信息,不确定分类以星号标出,空白表示未知。
因此所有百分比应理解为对可观察生态的估计,而非对全部使用的普查。第二类限制是未测量的量:论文未测量检索延迟、计算开销、输出帧率、授权误判率与用户任务完成度,也未做受控的用户实验比较不同检索的创作效果。于是不能承诺增加声学或相似检索一定提升效率或质量,只能说它们在当前样本中少见且在全局日志中占比极低。
第 3 类限制是异质性本身:录音质量、标签完整度与授权条件差异大,时长与授权在界面中较常被显式处理,而质量与描述缺失较少被缓解,这会收窄实际可探索范围。区分直接报告、有限解释与推测很重要:分布数字是报告,性能优化导致探索受限是有限解释,未来界面会自动用好新相似空间则是待验证的可能。
复现先做什么:拿到 60 名单、重跑分类与日志对照
若要复现这项调查,先做三件事。第一,重建名单:按论文规则抓取 Freesound Labs 条目并筛除工作坊、装置与非创意交互项,再以五年累计超 10,000 次查询为阈值筛接口客户端,并以文档提及为条件检索公开仓库,保留交集为 60 个对象,记录每个对象的日期、关键词与链接。第二,重跑分类:为每个应用按中心性四档、交互性四档、检索 4 类加随机、过滤十二项加排序、输入 6 类、操作 5 类打标,不确定项标星号并保留证据链接,空白留空而不猜测,最后汇总为交互、中心、操作与检索的计数表。
第三,对照日志:在约 3 个月窗口计算网页与接口周平均搜索量,分别统计文本、内容、组合与新统一端点带描述符的请求量,检查文本主导与内容稀少的结论是否复现。关键信息条件是必须区分用户可控过滤与后端预设过滤,同一字段在两列含义不同;必须区分应用覆盖率与请求出现占比,饼图内外两层数字口径不同。
代码与资源状态方面,本次收到的第三方链接经核对均为可用,包括现场编码、鼓机脚本、采样器封装、网页处理场与鼓组生成器等,但可用不等于可一键运行,运行还需接口密钥、授权合规与宿主版本匹配。还需补的验证是补充用户实验:固定同一声音任务,比较纯文本、文本加时长过滤、文本加声学过滤、相似替换 4 种可运行策略的完成时间与满意度,才能把探索更丰富转化为可部署收益。
收束:何时值得尝试声学与相似检索?
综合全部证据,可以给出务实建议。当任务是快速为视频或课堂拼出可用声音,且宿主是数字音频工作站或编辑器,文本搜索加授权与时长过滤仍是最省力的选择,论文点名的多款工作站集成走的正是这条路。当任务是鼓机、循环与现场演出,需要短采样与可替换性,值得在文本基础上叠加相似与随机,并把时长约束放在后端,以换取低认知负荷下的可玩性。
当任务是声音漫步、地图浏览或音色探索,值得尝试声学描述符与相似空间:前者按听感组织候选,后者把浏览变成近邻漫游,地球歌曲类与音色浏览器类应用已验证这种组织的教学价值。当任务是生成式 soundscape 或自动配乐,Freesound 更适合做结构化材料源而非可探索语料,此时应把精力放在生成规则而非检索 richness 上。常见误解需要澄清:接口能力多不等于界面会自动丰富,新端点上线后带描述符请求仍极少,说明文档与示例比功能本身更稀缺。
本地分析不等于接口无用,预计算描述符可省去重复计算,适合对延迟敏感的创意场景。最终判断是,Freesound 已是创意声音系统的基础设施,但其探索潜力只实现了一部分,补齐声学、相似与关系元数据的可用示例,是下一步最值得做的工程与研究工作。
📐 原文公式与排版
以下展示论文原页中的数学表达区域,保留原始上下标、分式和符号排版。区域序号仅用于本文导航,不是论文公式编号。
另有 29 个候选区域因边界不明确或图片数量、尺寸限制未展开;请查看完整论文中的原始排版。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses