英文题目:CamJam: A Modular Collaborative and Accessible Digital Musical Interface.
会议身份:
conference:nime:2026:conference-paper-id:nime2026_150
✅ 来源为官方会议 PDF;表格与 Figure 按原文证据绑定。PDF 公式以原页区域图片展示,未冒称作者原始 TeX。
标签:#用户研究 #音视频 #音乐 #音乐生成
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1.0/1.5 | 实验充分 0.7/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0.0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:系统技术报告
👥 作者与机构
- Frej Lorenzen:机构信息未能从会议 PDF 纯文本可靠映射
- Kevin Hansen:机构信息未能从会议 PDF 纯文本可靠映射
- Emil Zawistowski:机构信息未能从会议 PDF 纯文本可靠映射
- Eirini Liapikou:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
可及合奏要求无训练用户在多人并发演奏中保持音准节奏且不中断参与,而纯相机传感易受光照遮挡与表情误识影响,协作也常退化为各自独奏。CamJam以两台经Ableton Link同步的MacBook为骨干,先由Python结合MediaPipe手部追踪、Mini-Xception表情识别与OpenCV明暗扫描从视频流抽取手部位姿、表情类别与亮度波形特征,再经开放声音控制协议送入Max/MSP与Max for Live进行映射与时钟对齐,最后由Faust物理建模拨弦、C大调量化与8步鼓循环加4拍和弦循环约束生成鼓、贝斯、拨弦与对比度合成声。相对LoopBoxes按钮音序与Sound Forest预置采样的离散触发机制,差异在于以连续具身手势直接控制生成式合成并用和声约束兜底,从而保留表达连续性又避免无失败参与下的失谐失拍。在36名大学生分组轮换加自由即兴的评测设置下,弦乐模块的直观性得分为4.28,高于整体易用性得分的3.4。该结果的适用边界受限于光照良好的实验室短时体验且未在儿童或残障目标群体中直接验证,表情追踪不可靠与协作支架不足仍是主要失败条件。原文未披露训练、推理或部署成本,15 ms延迟仅为设计要求而未实测。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么:给零基础四人组一个能立刻合奏的乐器?
这篇解读的输入是 NIME 2026 论文 CamJam 的正文证据与 4 张官方原图像素,目标是让刚进入音频领域的研究生能复述它做了什么、怎么做的、在什么条件下测的。必须保留的信息包括 4 个模块的输入到声音链路、同步与调性约束、36 人分组轮换流程、音乐家与非音乐家无显著差异的统计结论,以及作者自己承认的协作不足与未覆盖残障儿童直接验证。输出按学习依赖展开,先讲任务与相关路线,再讲全景与组件计算,最后讲实验条件、结果反证与复现要点。
CamJam 要解决的任务不是做一个音质更好的合成器,而是降低合奏门槛。传统数字乐器往往要求用户懂节奏型、和声或键盘分工,非乐手一上手就容易错拍、错音、跟不上别人。CamJam 把问题定义为:在只有普通摄像头和笔记本的条件下,让音乐家与非音乐家 4 人同时操作、各自承担可辨识的乐队角色,并且在短时间内不经训练就能发出协调的声音。为此它选择模块化加循环约束的路线:打击乐、和声节奏、旋律独奏、实验音色 4 个角色并存,时间上用循环锁住拍子,音高上用 C 大调锁住调性。
理解这个选择要先说两个白话概念。第一个是可及数字乐器(Accessible Digital Musical Instrument,简称 ADMI),指为儿童或残障用户降低演奏难度、减少认知负荷的乐器;第二个是协同数字乐器(Collaborative Digital Musical Instrument,简称 CDMI),指多人同时演奏、声部相互影响的系统。CamJam 同时属于两者,它的中心矛盾是表达自由与不出错之间的张力:给的自由越多,新手越容易乱;管得越死,老手又觉得没得玩。论文用循环加调性约束保下限,用手势速度、滤波、波形等连续参数留上限,实验部分正是检验这个折中是否成立。
前人走了哪几条路:样品、按钮、眼动与 tangible?
相关工作按同输入、同目标、同运行阶段来对照,而不是按类别贴标签。第一条路是多感官装置,代表是 Sound Forest。它用 5 条发光弦加触觉平台、镜面森林幻觉与听觉反馈,跨能力参与感强,但依赖预制采样播放,表达自由受限,评估用图片卡匹配作曲家关键词,测的是联想一致而非可用性。CamJam 与它同目标但不同声音手段,改用物理建模与实时参数控制换取更大的音色范围。
第二条路是模块化无失败循环,代表是 LoopBoxes。它给有特殊教育需求的儿童 3 个即插即用模块,支持独奏或合奏循环,教师问卷确认了结实直观、角色清晰的重要性。CamJam 继承了模块结构、循环同步与清晰角色三点,但把按钮交互换成纯摄像头交互,这是它自称的贡献点:多个异构视觉模块集成在一个协同系统里。
第三条路是针对运动障碍的辅助技术,代表是 DuoRhythmo。它用眼动与头控鼠标让肌萎缩侧索硬化症患者实时合奏,可用性量表得 79.5 分,提示低延迟与多模态反馈的重要性。第四条路是面向视觉障碍的实体界面,如 Tangible Signals 与 EyeHarp,用实体旋钮或纯眼动演奏,专家反馈表明具身隐喻能降低认知负荷。CamJam 借用了低延迟与隐喻思路,但坚持无实体控制器,代价是反馈只能靠看与听,缺少触觉。
第 5 条是视觉音乐系统的长 lineage:从 Paine 的实时界面分类、Fraisse 等人对 181 篇交互声音装置的综述,到 Franinovic 与 Visell 用摄像头做环境声音拼贴,再到 Pauline Oliveros 发起的 AUMI 用网络摄像头动作检测服务重度肢体障碍者,以及 MediaPipe 让 commodity 硬件能实时跑手部骨架。CamJam 的位置是把手势追踪、表情识别、视觉对比分析 3 种视觉计算放在一个可搬运的安装里,并用多样音乐背景的被试检验集成效果。
任务到底难在哪:同时要简单、同步、和谐还要分工?
把任务拆成 4 个必须同时满足的子问题会更清楚。第一是输入鲁棒性:普通室内光照、普通摄像头、多人同时在画面里走动,追踪不能频繁丢失。第二是时间同步:4 个人各玩各的,鼓 8 步、和弦 4 拍必须对齐到同一时钟,否则合奏变噪音。第三是和声一致:旋律即兴不能与和弦打架。第四是角色可懂:用户要能说出自己在乐队里是鼓手还是独奏,而不是 4 个都在调同一个滤波器。
论文把功能需求写成纠缠模块加具身交互加旋律与打击乐器俱全,再加音阶、和弦进行能力、循环音序与清晰角色映射。非功能需求包括多人并发、低端到端延迟设计指标、多模态反馈、可搬运、儿童安全坚固、室内光照鲁棒、圆形装置外壳与美观材料,以及合适的注意时长与学习曲线。这里要区分一个关键点:延迟小于等于 15 毫秒是源自具身交互文献的设计要求,不是实测值,原文明确说正式端到端测量是未来工作。初学者常把设计目标误读成已验证性能,这个区分必须记住。
举一个教学例子帮助理解约束的作用,例子不是论文数据。假设 4 人没有约束,1 人把弦乐滑到升 F,1 人把和弦推到降 B,鼓还快半拍,结果是 3 层互斥信息。CamJam 的做法是先把调性焊死在 C 大调,把时钟焊死在 Ableton Link,再把触发做成离散或循环,于是个人探索只在安全围栏内改变密度与色彩。这就是无失败的含义:不是保证好听,而是保证不散架。
系统全景:两台电脑、四站围圈如何锁成一个乐队?
沿一个 4 人合奏样本走完输入到输出,有助于建立全局图。4 个站点围成圆圈,摄像头与屏幕朝外对着用户,用户之间能互相看见。硬件是两台 MacBook Pro 经 Ableton Link 做时钟同步,外加经 Continuity Camera 接入的 iPad 与 iPhone,以及一台 Logitech C920。所有交互模块跑在 Max/MSP 与 Max for Live 里,经开放声音控制协议(Open Sound Control,简称 OSC)通信。Python 加 MediaPipe 负责视觉计算,把手部关键点与表情数据发给 Max。声音一侧是鼓采样加包络、Faust 实现的 Karplus-Strong 弦物理建模、和弦音序器的振荡器合成。
Ableton Link × 无失败循环: Ableton Link 负责在两台电脑之间同步主时钟,无失败循环负责把鼓限定为 8 步、和弦限定为 4 拍并把全部音高约束在 C 大调内,二者搭配是因为协同新手最怕错拍与错音,组合后用户再怎么动都不会脱离拍子与调性,合作的下限被结构托住。
声音角色模仿传统乐队:鼓模块是打击乐,和弦音序器加贝斯是节奏与和声,弦乐是旋律独奏,对比度合成器是实验音色并通过和声结构间接影响全局。时间约束是鼓 8 步、和弦 4 拍,音高约束是 C 大调。纯软件路线是为了可复现与可搬运,作者在非正式开发测试中发现苹果 Continuity Camera 延迟不差于有线摄像头,但这只是开发体感,不是正式测量。
资源状态需要单独交代。阅读器阶段未发现来源绑定且完成验证的资源,因此不得声称代码、模型或数据已公开。论文提到 Max 补丁、Python 脚本与 Faust 代码的存在,但这不等于当前可用或已公开,复现者应按无公开仓库来计划,先准备自行实现。
鼓机怎么做:手举多高对应多密的鼓?
鼓机站的教学任务是把连续手势变成可控的节奏强度。先看界面全貌再理解映射,右侧是实时摄像头与手骨架,左侧是步进格,底部是 3 种鼓的图与参数旋钮,这种布局本身就是视觉可供性:用户知道该往哪里举手。
具体操作是双手在 3 个垂直分区里活动,分别对应底鼓、军鼓与踩镲。手高调制复杂度与音色参数,水平位置在 100 个归一化坐标点上决定路由到哪个鼓参数,包络的起音与衰减、滤波截止频率随手位实时变化,而一个预置 8 步循环一直在后台按主时钟播放。MediaPipe 追踪双手,数据经 OSC 发到 Max for Live,保证动作到声音的低延迟响应。声音合成不是简单放采样:军鼓用脉冲触发包络加频率调制,正弦波做底鼓,滤波噪声做踩镲。映射逻辑刻意弱化精确触发,强调节奏强度,让用户关注用力与高低而非点中某个格子。
具身交互 × 手势鼓机: 具身交互负责给出身体动作与声音含义之间的隐喻,手势鼓机负责把该隐喻落地为手高控制复杂度与滤波的分区操作,二者搭配是因为鼓的敲击强弱本就有高低与用力的身体直觉,组合后用户不必学步进音序器也能通过举手高低改变节奏密度。
看图路径: 1. 先看右侧摄像头画面中双手骨架线,确认两只手同时被追踪;2. 再看左侧 Kick、Hi hat、Snare 三行圆点构成的步进显示;3. 最后看底部三张鼓图片与下方旋钮,理解分区对应不同鼓参数
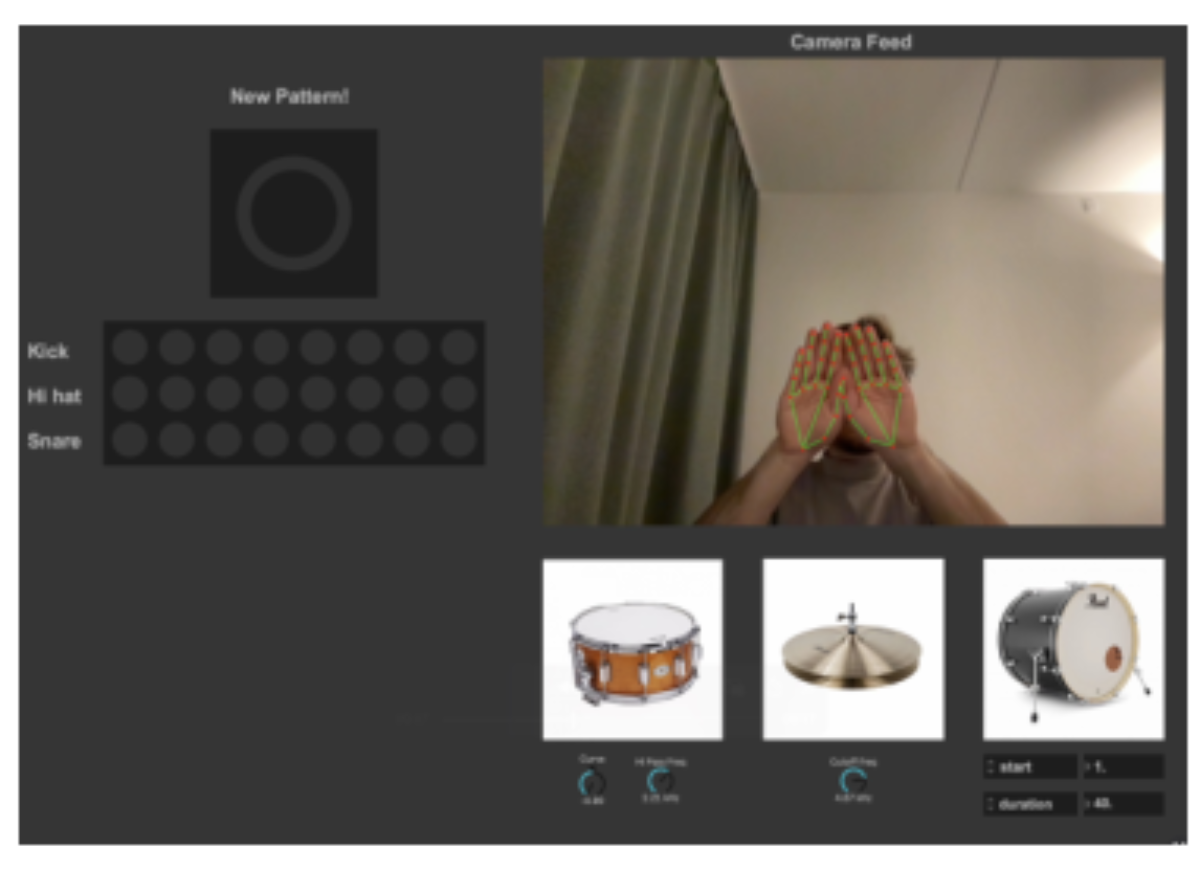
论文图 1。原论文 Figure 1:“Drum machine interaction: hand height in three vertical zones controls kick, snare, and hi-hat parameters in real-time.”。
这张鼓机截图的价值在于把映射具象化。右侧画面显示双手掌心向前、手骨架被绿色连线标出,说明系统确实在逐帧给关节点;左侧 Kick、Hi hat、Snare 三行各 8 个圆点对应 8 步循环的视觉反馈,顶部 New Pattern 提示与圆形触发区暗示 pattern 切换;底部军鼓、镲片、地鼓 3 张实物图不是装饰,而是告诉用户水平分区对应哪种鼓,下方 Curve 与滤波频率旋钮则暴露了手高实际在拧的参数。复述时要能说出输入是双手高度与水平位置,表示是归一化坐标与分区,目标是调制已在播放的循环而非逐个敲出鼓点。
和弦与表情怎么做:皱眉会让全团转调吗?
这一站的教学任务是理解间接控制:一个人不动手也能改变全团和声。输入是面部视频,表示是 Mini-Xception 卷积网络在 FER2013 预训练权重上给出的 8 类情绪,分别是愤怒、厌恶、恐惧、高兴、悲伤、惊讶、中性与轻蔑。系统对分类器输出做 3 帧滑动平均,防止微表情导致声音抖动,然后把情绪映射为 C 大调内的和弦进行,再做四拍琶音并经 Ableton Link 同步,一个贝斯合成器用锯齿波加低通 reinforcing 根音进行。屏幕给出实时置信度分数,让用户有意识地调整表情来影响集体情绪。
表情识别 × 和弦音序器: 表情识别负责把面部状态分类为 8 种情绪,和弦音序器负责把情绪映射为 C 大调内的和弦进行并做四拍琶音,二者搭配是因为需要一个不需动手的全员和声锚点,组合后一个人的表情变化就能牵动全团和声走向,形成技术上的相互依赖。
这张表情站照片只显示了检测框与被试下半脸,看不到完整的情绪到和弦面板,恰好说明评估中发现的问题:面部追踪经常不可靠或让人不适。导读时不要把这张图当成映射成功的证据,它只证明输入是脸、输出框是检测器工作状态。解释时要强调两点:一是 3 帧平均是为稳定性牺牲即时性,二是 C 大调约束保证了情绪切换不会制造调外和弦,但也限制了情绪与和声的表达粒度。论文讨论部分明确建议未来用化身或抽象表示替代直接人脸监测,以改善包容性。
看图路径: 1. 先确认屏幕上蓝色方框只框住下半张脸的检测区域;2. 再观察被试毛衣与背景,理解该模块不依赖手部动作;3. 结合图注思考表情到和弦的间接映射为何难以即时感知
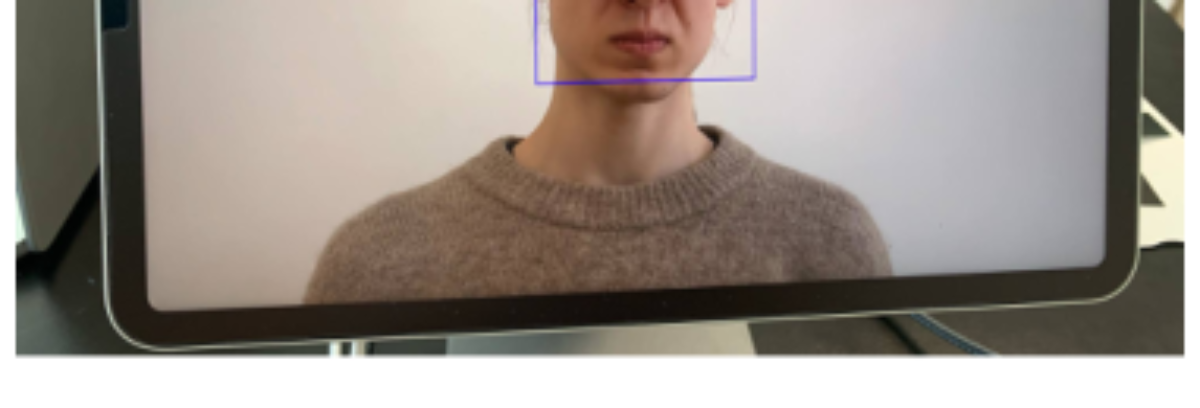
论文图 2。原论文 Figure 2:“Interface mapping facial expressions to chord progressions with on-screen emotion display.”。
从可复现角度看,该模块依赖的不是新训练,而是调用已在 FER2013 上预训练的 Mini-Xception 做推理,未报告针对本装置光照与人种多样性的微调,也未报告分类准确率。复现者若直接复用同一权重,需要补测不同光照与人群下的识别稳定性,否则琶音会频繁跳变或卡在中性上。
纸条合成器怎么做:黑纸形状如何变成波形?
这一站致敬 Iannis Xenakis 的 UPIC 系统,教学任务是把亮度变成音色。俯视摄像头看着一张白纸,用户放上深色纸条、手或纸片,系统用 OpenCV 取一条 100 像素的水平扫描线,把亮度值映射为自定义波表振荡器的波形幅度,纸的形状直接决定谐波内容。另有一条扫描线本想给出四值 ADSR 包络去调滤波截止,但在测试中被简化为更即插即用的体验。物理操作与数字合成的桥接意义在于把抽象合成概念变成看得见抓得着的介质。
视觉波表合成 × 对比度合成器: 视觉波表合成负责把一条 100 像素亮度扫描线直接读成振荡器波形幅度,对比度合成器负责提供白纸加黑纸条的可抓握操作面,二者搭配是因为把抽象频谱变成看得见的纸形,组合后纸条的宽窄遮挡就直接决定音色明暗,给新手一个 tangible 的合成入口。
这张实拍图显示一只手正把一条黑纸条放到白纸上,白纸上已有数条不同角度的纸条,背景是俯视支架与桌面。它证明输入是可抓握的纸形,输出是扫描线波形,而不是旋钮。解释时要指出它的感知不透明性:用户很难预测纸条挪一厘米音色会变多少,加上俯视视角看不清自己在挡哪段扫描线,以及连续参数空间要求精细控制,这些都是它直观性评分最低的原因。复述时要能说出输入是纸形遮挡,表示是 100 像素亮度向量,目标是波表幅度,输出是持续 drone 类音色。
看图路径: 1. 先看白纸上多条黑色纸条的摆放,理解遮挡即波形;2. 再看手捏纸条的动作,确认这是可抓握的物理操作;3. 最后看上方俯视支架上的设备,推测俯视扫描视角
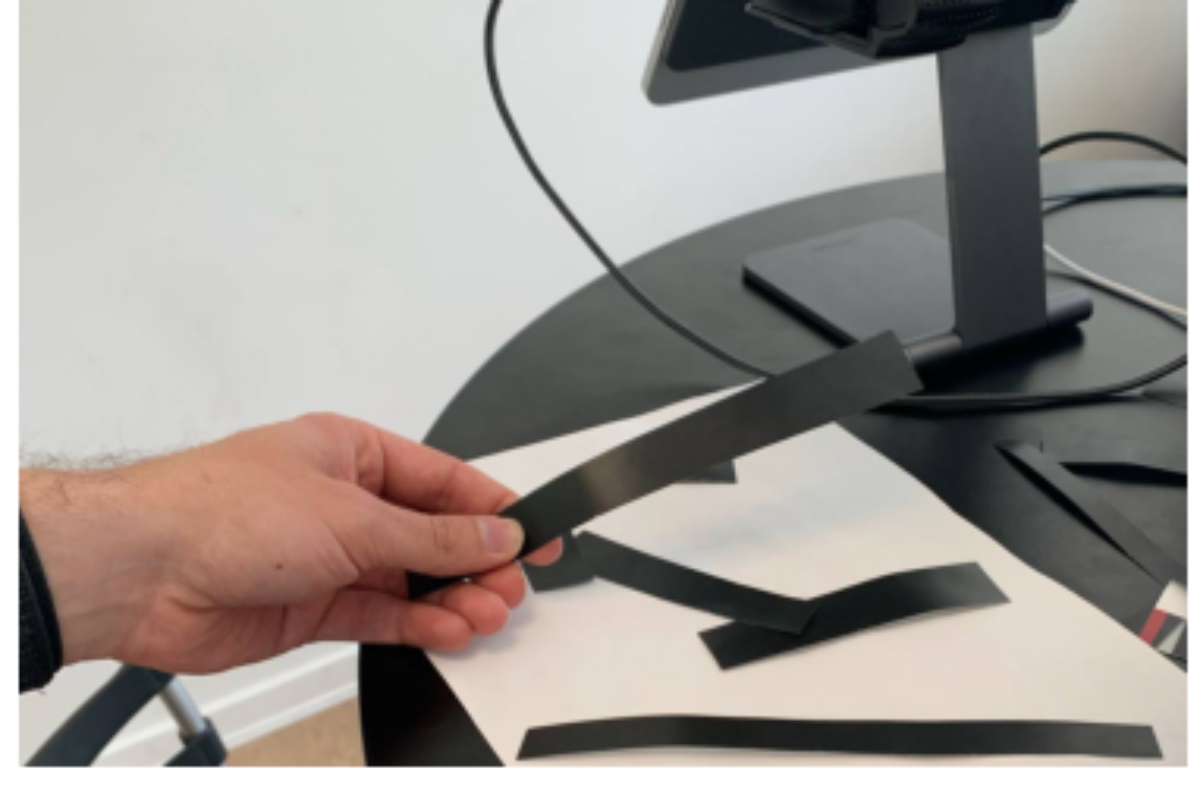
论文图 3。原论文 Figure 3:“Contrast-based synthesizer: dark paper shapes placed on white background modulate oscillator waveform via brightness scanning.”。
与鼓机和弦乐不同,该模块没有节拍离散化,声音变化是连续的,这对新手更难建立因果感。论文讨论明确对比了离散映射与连续抽象映射,认为前者更适合可及乐器,这个判断在结果部分有评分支撑。
弦乐怎么做:过中线为什么算拨了一下?
弦乐站是全系统评分最高的模块,教学任务是讲清 3 维触发如何过滤背景。输入是单手或双手的 MediaPipe 3 维关键点,表示包括垂直位置、食指是否越过画面水平中线、深度轴距离与帧间 3 维位移算出的速度。映射是垂直手位量化到 C 大调 C4 到 B4 的音高,食指越过中线算 1 次拨弦,深度上定义一个 3 维交互盒,只有在特定距离内的手势才激发,有效滤除背景走动。速度映射到拨弦强度与 Karplus-Strong 反馈系数,影响振幅与衰减。
为补偿物理模型固有的轻微失谐,加了按比例放大的 1 到 3 赫兹频率偏移修正,保证与其他模块和谐。双手可同时驱动两个独立弦实例,实现复调。合成用 Faust 函数式语言实现 Karplus-Strong,保证高效信号处理与自然衰减。
物理建模 × 拨弦: 物理建模负责用 Karplus-Strong 算法生成随时间衰减的弦振动音色,拨弦手势负责给出何时激发与多用力激发的离散触发,二者搭配是因为离散拨动比连续调参更易建立因果感,组合后垂直手位选音高加过中线触发就成为可听出吉他感的独奏声部。
这张笔记本屏幕照片显示演奏者站在镜头前,手部关键点被标出,中央一条纵向彩色线从上到下贯穿画面,正是垂直音高轴与中线触发的可视化。它证明交互盒与中线不是抽象描述,而是画在反馈画面里的。解释时要强调 3 个设计细节的因果链:量化到 C 大调保证不错音,离散触发保证因果清晰,交互盒加速度映射保证背景不动、轻重有别。这三点共同解释了它为何在 4 个模块里均值最高且方差最小。
看图路径: 1. 先沿屏幕中央纵向彩色竖线看手位高低与音高的对应;2. 再看食指附近的手部关键点,确认拨弦触发点位置;3. 最后注意人物双手分工,理解双弦复调的可能性
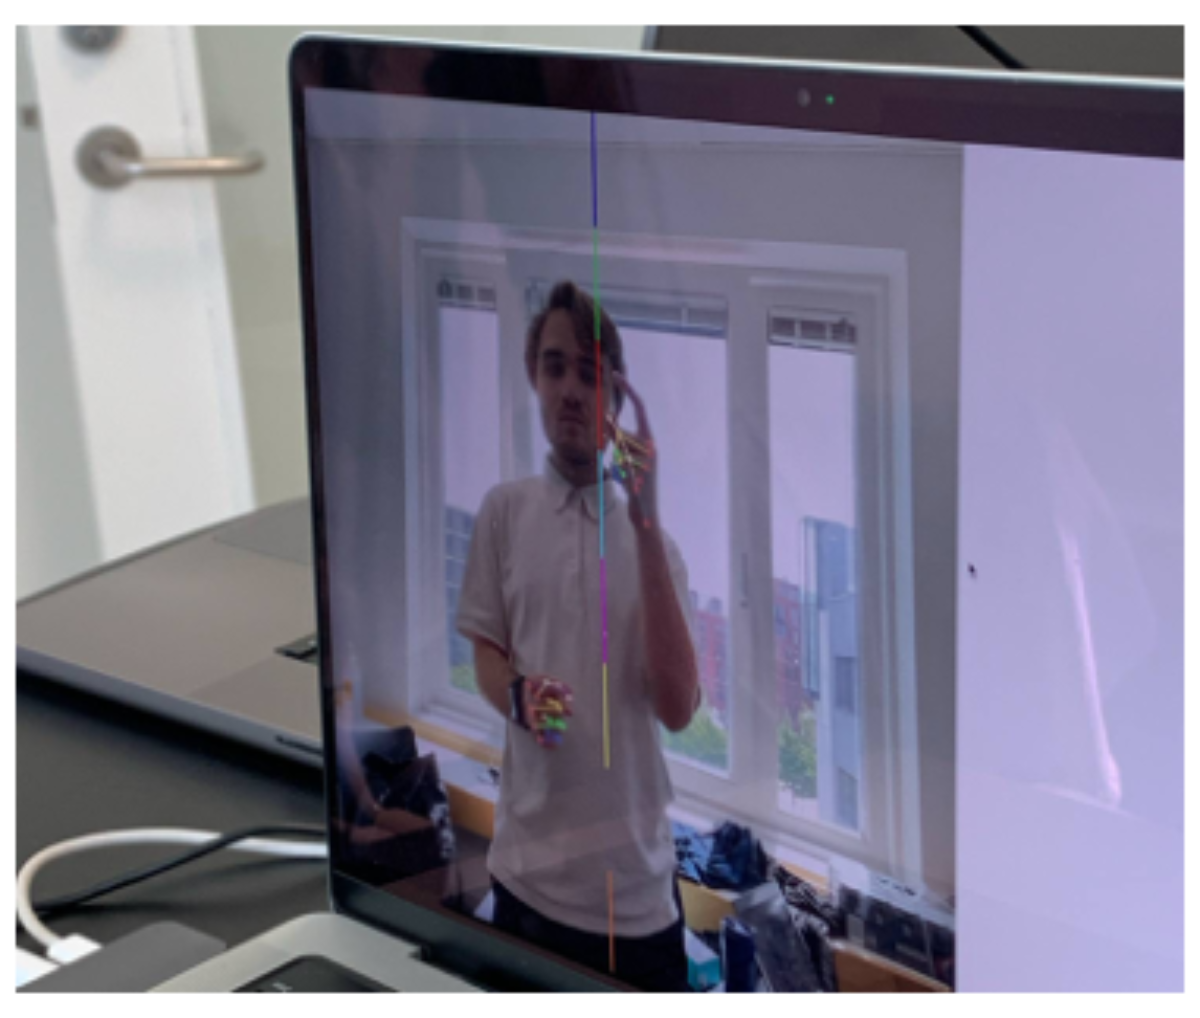
论文图 4。原论文 Figure 4:“Plucked string interaction: vertical hand position maps to pitch, with plucking gestures detected via index finger motion across the frame midpoint.”。
复述时按样本走一遍:手抬高决定唱哪个音,食指快速划过中线决定何时响,离摄像头太远则不响,划得越快声音越亮且衰减越长,底层是延迟反馈弦模型在响。
有没有训练:本研究训练了什么、冻结了什么?
本研究没有为 CamJam 训练新的神经网络,必须明确说明未训练的部分,再讲实际调用的计算。鼓机的手部追踪调用 MediaPipe Hands 的现成关键点,不做重训练;弦乐同样调用现成手部模型,只在应用层做坐标量化、中线穿越检测、交互盒过滤与速度估计;表情模块调用在 FER2013 上预训练的 Mini-Xception 做推理,论文未报告任何针对本装置的微调、数据划分、优化器、学习率或早停,参数可视为冻结推理。对比度合成器是 OpenCV 亮度扫描加波表映射,属于确定性图像到音频查表,没有学习参数。声音侧的 Karplus-Strong、振荡器与包络都是数字信号处理计算,不是梯度优化。
因此不存在梯度路径、监督来源更新或重置时机的描述,缺项就是缺项,不能从模型名字推定实现细节。也不能把冻结参数等同于系统输出确定:同样的冻结权重在不同光照、人种、摄像头角度下会给出不同情绪标签与手部抖动,输出仍是随机的。论文未给出计算机视觉管线的延迟分解与正式端到端测量,只给了小于等于 15 毫秒的设计要求与 Continuity Camera 不差于有线的开发体感,复现者需要把正式测延迟作为第一项补测。
从构造流程看,真正的工作量在 Max 补丁 wiring、OSC 地址设计、Ableton Link 同步、Faust 编译与交互调参,以及为期多轮的稳定性调优。试点测试已暴露注册问卷合并、敏感信息移除、2 维码移动填写、交互稳定性与流程澄清等问题,并在主实验前修复,这部分属于工程迭代而非模型训练。
实验条件:36 人如何在 11 加 3 分钟里轮完四站?
评估是混合方法,36 名北欧大学学生,年龄 18 到 34 岁,按是否上过音乐大学或乐器超过一年划为音乐家 16 人与非音乐家 20 人,其中多数音乐家满足更严标准:过去五年内演奏或演唱且至少一年中每周练习 3 小时以上。可及性只在感知层面评估,没有直接招募儿童或残障用户,原因是联系的相关机构未回复,抽样是便利抽样。伦理按奥尔堡大学学生项目指南执行,丹麦非医疗非欺骗成人研究不要求正式伦理委员会审查,被试签署知情同意,数据匿名化并按通用数据保护条例处理,试点后移除了健康等敏感字段。
流程分试点与主实验。试点 4 人发现问卷与交互问题并修复。主实验每组 4 人围圈,房间明亮有轻微混响,四台相机以 90 度间隔朝外,两台 Mac 内置、一台 iPhone Continuity Camera、一台 Logitech C920 三脚架,4 名实验员各跟 1 名被试做观察。每组先听各模块简介,强调合作与轮换,然后做 8 个 1 分钟块,每人单模块操作并顺时针轮换,两轮走完四站,共 8 分钟结构化演奏,期间需要帮助会给帮助,再加 3 分钟自由即兴并鼓励合作、换站与独奏。问卷有 11 个李克特量表题测直观、易用与协作,加开放题;实验员填观察问卷关注学习速度、交流、偏好与受挫迹象。
分析用 Mann-Whitney U 比较两类人群的易用与协作综合分,用对齐秩变换方差分析检验直观评分中音乐背景的主效应、交互类型主效应与交互作用,题项级再做 Bonferroni 校正的 Mann-Whitney,开放题与观察按 Popping 框架做先验加归纳编码。时间约束只被 2 人提到,说明 11 分钟结构化加 3 分钟即兴对基础探索是够的,但对发展协作关系可能不够,这是理解协作低分的条件背景。
主结果:谁最高、谁最低,音乐家与非音乐家差多少?
比较问题是 4 个模块的直观性是否有差异,公平条件是同一批 36 人、同样的轮换时长与指导,指标方向是分数越高越直观。结果显示交互类型主效应显著而音乐背景无交互作用,弦乐明显领先且最稳定,纸条合成器最低。表后解释要强调收益与代价:离散触发加吉他隐喻带来清晰因果,但代价是音高被量化、自由度受限;连续波表映射概念有趣但感知不透明,这是可及设计的重要反例。
| 来源证据 | 量化值一 | 量化值二 | 量化值三 | 量化值四 |
|---|---|---|---|---|
| 来源句一 | 0.81 | 3.33 | 1.20 | 3.19;1.14 |
该表的主要收益是弦乐以 4.28 领先且标准差仅 0.81,说明不同背景被试一致觉得好懂;具体代价是表情模块标准差达 1.20,反映面部追踪可靠性波动大,有人觉得可用、有人觉得完全不跟手。未胜出项纸条合成器的 2.92 不是偶然低分,后文讨论把它归因于映射不透明与俯视视角难自视,需要记住这个负结果。
| 来源证据 | 量化值一 | 量化值二 | 量化值三 | 量化值四 |
|---|---|---|---|---|
| 来源句二 | 0.10 | — | — | — |
表后解释是核心判断:所有测量的组间差异均不显著,支持具身加约束路线抹平了乐理差距,但协作题是全表最低,音乐家只给 2 分,非音乐家给 3 分,说明系统保住了个人可玩性却没教会合奏。开放题补充了机制线索:控制与可预测性既是最被看重的优点也是最缺的特性,技术精度与响应是最常被提的无障碍促进因素,而缺乏控制与可预测性出现 10 次、复杂难懂出现 9 次。81% 认为适合残障或儿童,非音乐家 90% 比音乐家 69% 更热情,但这只是 18 到 34 岁大学生的代理感知,不是目标人群的直接验证。
反证与失败条件:协作为什么没发生、哪块最脆弱?
把结果当成消融来读:拿掉清晰因果会怎样,拿掉可靠感知会怎样。弦乐保留了离散触发因而最高,纸条拿掉离散性后最低,表情拿掉感知可靠性后方差最大,这组对比支持离散加清晰因果优先于连续抽象映射的设计哲学。协作失败是第二组反证:技术上和弦变化影响全员、鼓提供底座,已经构成纠缠,但社会协作并未自动发生。开放题中 13 人提到只顾自己乐器、16 人提到乐器本身没搞懂,说明个体认知负荷挤掉了倾听与轮换。
| 来源证据 | 量化值一 | 量化值二 | 量化值三 | 量化值四 |
|---|---|---|---|---|
| 来源句一 | 2 | 3 | 38.2% | 5.9% |
| 来源句二 | 32.4% | 23.5% | — | — |
表后必须点出代价与边界:偏好上 41.2% 有明显偏好而 58.8% 无,55.9% 无明显挣扎但 38.2% 有些受挫、5.9% 明显受挫,非音乐家偏爱弦乐的简单,音乐家偏爱鼓机的可控,说明简单与可控是两类用户不同的甜点。未评测边界包括纵向学习、节日展览等生态效度场景、残障儿童直接参与,以及标准化量表与任务制测评,这些都是原文未来工作点名的缺项。
限制:哪些结论只能读成感知、不能读成疗效?
第一个限制是人群错位。可及性结论只能读成报告为大学生感知到的适合度,不能读成对儿童或残障用户有效,因为样本是 18 到 34 岁便利抽样,无目标人群直接参与,联系机构未回复是明确记录的原因。第二个限制是测量缺失:延迟只有小于等于 15 毫秒的设计要求与非正式体感,无正式端到端测量;表情模型无本机准确率、无跨人种与光照分解;协作只有量表与观察,无声音互听、轮换次数等行为声学指标。
第 3 个限制是时间与指导。11 分钟结构化加 3 分钟即兴够个人探索,不够建立合奏默契,且指导强调个人理解而非合奏策略,圆形站位给了视线接触却没有协作可供性,如角色轮换提示、相互制约的可视化、全团声音的共享表示。第 4 个是舒适度:部分被试报告不适于被直接追踪表情、模块响应有限,纸条站俯视难自视、鼓与纸条反馈微妙需额外解释。这些都是论文直接报告的困难,不能用总体趋势掩盖。
表达上要守住三档语气:直接报告用报告与显示,有限解释用支持,可能推测用可能与待验证。例如弦乐高分支持隐喻清晰的作用,但究竟是吉他 resemblance 还是离散映射本身起主要作用仍待验证;无组间差异支持门槛被拉平,但不等于非音乐家获得了同等创造力。相关性不是因果,未测误判率与成本时不承诺这些量得到改善。
复现先做什么:按什么顺序搭才能最快出声?
复现顺序按依赖排,先让时钟与调性跑通,再逐个接输入。第一步搭两机 Ableton Link 同步与 C 大调量化,鼓先用固定 8 步循环出声,和弦先用固定四拍琶音出声,确认四站能同时不跑偏。第二步接 MediaPipe 手部,把垂直位置映射到 C4 到 B4、食指过中线触发、交互盒深度过滤、速度到强度与反馈系数做出来,频率偏移加 1 到 3 赫兹补偿失谐,双手开双实例。第三步接鼓机的三区手高与 100 点水平路由、包络与滤波调制,声音按底鼓正弦、军鼓脉冲加调频、踩镲滤波噪声实现。第四步接纸条的 100 像素扫描线到波表幅度,先不做 ADSR 包络,保持即插即用。最后接 Mini-Xception 表情到和弦进行,3 帧平均防抖,贝斯锯齿波加低通跟根音,并给出置信度显示。
关键超参数与信息条件要保留:鼓 8 步、和弦 4 拍、3 帧平均、100 像素与 100 归一化点、C4 到 B4、C 大调、1 到 3 赫兹修正、小于等于 15 毫秒是设计目标非实测。硬件按两台笔记本加 C920 与手机 Continuity Camera、明亮小房间准备,软件按 Max/MSP 加 Max for Live 经 OSC、Python 加 MediaPipe 与 OpenCV、Faust 编译弦模型准备。由于无验证资源,不得预期开箱即用的仓库,复现者应把正式测延迟、表情跨人群准确率、纸条俯视自视改进作为必补验证。
何时值得尝试:如果你的场景是零基础短时工作坊、展览快闪或课堂合奏,且只有普通摄像头与笔记本,CamJam 的围圈四站加循环约束值得抄;如果目标是精准演奏、舞台级低延迟或服务特定残障群体,则需要先补触觉反馈、正式延迟分解、化身替代表情追踪与目标人群共创,否则不应直接套用结论。
收束:带走哪句可复述的方法、哪两个未解问题?
可复述的方法是一句话:用 Ableton Link 锁拍、用 C 大调锁音,把鼓做成手高调循环强度、把和声做成表情选进行、把独奏做成过线触发的建模弦、把音色做成纸形扫波表,四站围圈同时玩。最强证据是弦乐直观性 4.28 且方差最小、两类人群无显著差异,主要代价是协作分低至 2 到 3 分、表情方差大、纸条映射不透明。
两个未解问题留给后续。第一,协作需要显式脚手架:角色轮换提示、相互制约可视化、成功配合的听觉奖励与共享混音表示,单靠技术纠缠不够。第二,包容性需要直接验证:让残障乐手与儿童参与共创,换更好训练的表情模型或抽象化身,补标准化量表、任务制旋律演奏与非乐器基线对比,并在节日展览做纵向生态测试。记住论文特有的易错点:15 毫秒是要求不是测得值,81% 适合度是大学生感知不是临床结论,Continuity Camera 够用是开发体感不是基准。只有守住这些边界,这篇解读才能真正帮你复述与复现。
📐 原文公式与排版
以下展示论文原页中的数学表达区域,保留原始上下标、分式和符号排版。区域序号仅用于本文导航,不是论文公式编号。
另有 13 个候选区域因边界不明确或图片数量、尺寸限制未展开;请查看完整论文中的原始排版。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses