英文题目:Analyse de la consommation énergétique et des émissions de carbone pour l’entraînement d’un modèle neuronal de vérification du locuteur
会议身份:
conference:jep:2026:conference-paper-id:leguillier26_jep
✅ 来源为官方会议 PDF;表格与 Figure 按原文证据绑定。PDF 公式以原页区域图片展示,未冒称作者原始 TeX。
标签:#CNN #评测协议 #语音 #说话人验证
评分:6.0/10 | 创新 0.8/2 | 技术严谨 1.2/1.5 | 实验充分 0.9/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:应用研究
👥 作者与机构
- Hugo Leguillier:机构信息未能从会议 PDF 纯文本可靠映射
- Driss Matrouf:机构信息未能从会议 PDF 纯文本可靠映射
- Guillaume Lechien:机构信息未能从会议 PDF 纯文本可靠映射
- Mickael Rouvier:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
说话人验证(Speaker Verification,SV)需将变长语音映射为固定维度说话人嵌入(speaker embedding),并在未知说话人与域偏移下保持可分性,而深层网络的训练能耗与碳成本长期缺乏量化。本文以残差网络(Residual Network,ResNet)为载体,在 VoxCeleb2 上训练不同深度、宽度和块分布变体,再用机级传感栈同步采集训练能耗并折算碳排放,最后在域内与域外语料上联合评估错误率与能耗帕累托前沿。与单纯追求精度的已有 SV 研究不同,该工作把能量作为与精度并列的一等优化目标,揭示了中间层集中配置更有效的结构偏好。代表性结果显示 ResNet-419-D 在 5 个测试集平均等错率(Equal Error Rate,EER)上为 3.35%,仅比 ResNet-200-D 的 3.44%相对改善约 2.6%,而训练能耗从 222.53 kWh 增长至 895.67 kWh,达 4 倍以上。结论仅适用于法国低碳电网(19.6 gCO2e/kWh)与 Tesla V100-32GB 单一硬件下的 ResNet 训练阶段,未验证推理成本与其他主流架构的外推性。训练成本最高单模型达 895.67 kWh 与 13.734 kgCO2e,中等模型可降至约 50 kWh 和 1 kgCO2e 量级。
🔗 开源与复现资源
- 第三方资源:https://www.rte-france.com/en/eco2mix — 链接不可用(HTTP 404) 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
要解决的是什么验证问题?输入输出是什么?
本文研究的是说话人验证。先用白话说:给一段语音,判断它是不是声称的那个人说的。英文是 speaker verification,后文简称验证。系统不直接输出人名,而是输出两个语音属于同一人的得分,再与阈值比较做接受或拒绝决定。
输入是一段变长语音波形。论文把输入先变成 80 维滤波器组特征,再切成训练用的语音段。输出是验证得分和按阈值得到的错误率。学习依赖是先要有一个能把变长语音压成定长向量的表示,否则不同时长的试次无法直接比较。
说话人嵌入 × 说话人验证: 说话人嵌入的分工是把变长语音变成固定 256 维向量,保留说话人声学特征并能泛化到未见说话人;说话人验证的分工是用两个嵌入的相似度判定是否为同一人;二者搭配的原因是验证需要可比的定长表示,组合意义是把识别训练学到的分类边界转化为验证阶段可直接比对的距离。
论文交代的应用包括法庭语音分析和语音配音,评价场合包括 NIST SRE 和 VoxCeleb 系列。初学者容易误以为层数越多一定越好,本文正是要检查加层带来的误差下降是否值得付出更多训练电量。目标读者复述时要先说清验证是二元判定任务,指标越低越好,能耗越低越好,二者方向相反才构成折中。
已有路线把模型做大的代价讲清楚了吗?
同输入同目标的一条路线是不断加深说话人嵌入网络。从时延神经网络到 ResNet、ECAPA2、ReDimNet,论文指出隐藏层数从 9 层一路涨到 293 层,性能随之明显提升。直觉是更深的变换能学到更具区分度的嵌入,使不同说话人更可分。
同运行阶段的另一类工作关心训练代价。论文引用语音识别上的能耗与碳足迹研究,以及绿色人工智能的主张,即把能效作为除预测性能之外的补充评价标准。已有工作说明深层训练意味着更多计算操作、更重的显存占用和更长的训练时间,还会被超参数搜索和迁移学习的多轮重训练放大。
但在说话人验证领域,环境代价仍 largely 未被量化。本文的定位不是提出全新主干,而是固定 ResNet 家族,沿深度、宽度、块分布 3 个结构维度做可比测量,并同时在域内和域外数据上报告性能,使结论可以直接指导结构选择。
本文要回答的三个结构问题是什么?
第一个问题是深度是否一直有效。把残差层数从 18 层加到 419 层,平均等错误率和平均最小检测代价还能下降多少,每一步多花的电是否一样。第二个问题是宽度是否和深度等价。把通道数乘以固定系数,例如把 128、128、256、256 翻倍或减半,性能与能耗的变化是否与加层相同。第 3 个问题是块放在哪里更划算。保持总层数 50 层不变,只把残差块在 4 个阶段之间搬家,是否不增加参数也能变好。
教学上把例子标为例子:例如把书架加高相当于加深,把每层隔板加宽相当于加宽,把书从两头搬到中间相当于块重分布。这个例子只帮助理解维度,不代表任何数值效果。真正的判断必须回到 VoxCeleb2 训练、VoxCeleb1 与 CommonBench 和 CN-Celeb 测试的同一套测量下比较。
方法全景:从语音段到能耗数字经过哪些步骤?
沿一个样本走完全程有助于建立依赖顺序。取一条 VoxCeleb2 语音,随机截出 3.5 秒片段,做数据增强后提取 80 维滤波器组,送入 4 个阶段 ResNet 主干,经过全局池化和全连接层得到 256 维说话人嵌入。训练阶段用说话人身份分类监督,测试阶段用嵌入相似度做验证试次评分。并行地,训练任务作为 Slurm 作业运行,机器级传感器记录整任务耗电,再乘以电网碳强度得到碳排放。
能耗 × 碳排放: 能耗的分工是以千瓦时记录训练任务实际消耗的电量,主要来自 GPU 和 CPU 的负载与访存;碳排放的分工是把电量乘以电网碳强度折算为千克二氧化碳当量,反映当地电源结构的影响;二者搭配的原因是同一电量在法国与高化石电网下气候代价不同,组合意义是本文同时报告 kWh 和 kgCO2e,使架构比较与地域电网条件解耦。
论文强调这两个指标不是完整生命周期评价,只用于比较架构的训练能效。能耗以千瓦时为单位,碳排放以千克二氧化碳当量为单位。复述时不要把 1 次训练的电量说成模型推理功耗,也不要把法国电网下的低碳数字直接套用到其他国家。
主干如何组织?残差块和捷径做了什么?
主干是 4 个阶段 ResNet。每个阶段堆叠若干残差块,每个块包含多个卷积层、批量归一化和激活函数。论文还说明在前两个阶段加入了挤压激励模块,通道基线配置为 128、128、256、256。主干之后是全局池化层和全连接输出层,负责把学到的帧级表示聚合成话语级嵌入。
残差块 × 捷径连接: 残差块的分工是用多层卷积加批量归一化和激活学习输入的修正量;捷径连接的分工是把块输入直接加到块输出,保留原始信息并打通梯度回传路径;二者搭配的原因是深层网络直接学完整变换容易退化,组合意义是让网络只学渐进修正,从而把 18 层到 419 层的加深在优化上变得可行。
训练目标是说话人辨认,即把语音段分到已知说话人类别之一。训练完成后取某个隐藏层输出作为嵌入,用于未见说话人的验证。这种先分类后取嵌入的流程是理解监督来源的关键:监督来自训练集说话人标签,而不是验证试次标签。论文选择 ResNet 作为参考基座的理由是 Res2Net、ResNeXt 和 ECAPA2 共享残差、捷径和分层组织思想,因此关于深度与分布的观察有望迁移,但这属于作者的合理外推,尚未在本文逐一验证。
深度、宽度、块分布三个旋钮分别拧哪里?
深度旋钮记为 ResNet-X-D,X 取 18、34、50、101、200、419。拧这个旋钮只改变总层数和块总数,通道配置保持不变。宽度旋钮记为 ResNet-50-Wx,x 是乘在每层通道上的常数。参考的 ResNet-50-D 4 阶段通道为 128、128、256、256,W2 变为 256、256、512、512,W0.5 变为 64、64、128、128。块分布旋钮记为 ResNet-50-D[a,b,c,d],a 到 d 是 4 个阶段各自的残差块数,总层数仍是 50 层。例如早期集中型是 8、2、2、2,中间集中型包括 2、8、2、2 和 2、6、6、2。
深度 × 宽度: 深度的分工是增加层数与非线性变换次数,增强层级抽象能力;宽度的分工是增加每层卷积通道数,扩大单层可表示的特征种类;二者搭配的原因是容量可以沿纵向或横向扩展,组合意义是本文分别用 ResNet-X-D 和 ResNet-50-Wx 控制变量,以区分加层与加通道对误差和能耗的不同代价。
初学者要分清参数量与计算量的不同。加宽往往使参数和计算同时快速膨胀,加深主要增加串行操作和训练时长,而搬块在总参数相近时改变各阶段分辨率下的计算分布。论文表 1 显示参数量不是能耗的精确比例尺,这正是需要实测而不是只数参数的原因。
训练如何组织?哪些更新、哪些固定?
训练数据是 VoxCeleb2。每次迭代随机裁剪 3.5 秒片段,小批量大小为 512,共训练 42 个轮次。输入是 80 维滤波器组,嵌入维度 256。损失函数是加性角度间隔损失,优化器是带动量 0.9 和权重衰减 2×10⁻⁴ 的随机梯度下降。数据增强遵循所引用的 x-vector 增强方法。论文没有报告学习率调度、早停阈值、随机种子数量和多次重复的方差,这些是复现时需要补齐的缺项,不应从模型名推定。
参数更新方面,主干、池化、嵌入层和分类层都在训练中更新,没有说明冻结任何层,也没有说明梯度截断或停止梯度的特殊处理。监督来源是训练话语的说话人身份标签。重置时机方面,论文未说明分类头在验证阶段是否丢弃重训,标准做法是验证只用嵌入相似度,不再训练分类器,但本文未明确写出该步骤的实现细节,复述时应标为未报告而不自行断言。
测量与训练同步进行。训练作业提交到 Slurm,CEEMS 按作业聚合电量。传感器包括面向 CPU 与内存的 RAPL、面向整节点的 IPMI-DCMI,以及面向英伟达 GPU 的 DCGM。碳排放由实测电量乘以实时或静态排放因子得到,实时因子来源包括法国输电网管理机构与 Electricity Maps,静态因子参考 Our World in Data。需要说明本次收到的第三方资源状态:法国电网实时数据链接当前不可用,写作时只能转述论文引用的来源名称,不能声称该链接当前可用或已公开可达。
在哪些数据、指标和硬件下比较?条件一致吗?
评价分为域内和域外。域内是 VoxCeleb1 的 O、E、H 3 个试次表,域外是 CommonBench 和 CN-Celeb。指标是等错误率和最小检测代价,最小检测代价的目标先验为 10−2,漏检与误报代价均为 1。论文还报告所有评价语料上的平均等错误率和平均最小检测代价。指标方向都是越低越好。
等错误率 × 最小检测代价: 等错误率的分工是在误接受与误拒绝相等的工作点报告错误百分比,反映区分能力;最小检测代价的分工是在给定目标先验 Ptar=10−2 和漏检误报代价下报告加权代价,反映实际检测折中;二者搭配的原因是单一阈值不能代表全部应用,组合意义是同时看平均 EER 和平均 minDCF 才能判断省电的改动是否在两种评价下都成立。
硬件一致性方面,所有实验在 Jean Zay 超算上使用同型号 Tesla V100 32 GB,保证架构比较不受显卡代际干扰。能耗与时长由 CEEMS 在机器级采集,按任务报告千瓦时和二氧化碳当量。论文说明法国 2025 年平均电力碳强度为 19.6 克二氧化碳当量每千瓦时,并对比美国 345 克和中国 536 克,以说明同一电量在不同电网下碳含义不同。初学者不要把 19.6 克当成全球通用换算系数。
公平条件是同一训练流程、同一轮次、同一特征与嵌入维度下只改变 3 个结构维度之一。但论文未报告多次随机种子的统计显著性,也未报告推理延迟与显存峰值,因此不能把训练省电直接等同于部署更快。
加深带来多少性能,付出多少电?
比较问题是:在固定其他训练条件时,加深是否持续带来与能耗成比例的性能提升。公平条件是同一 VoxCeleb2 训练流程与同一组域内加域外测试,指标方向是平均等错误率和平均最小检测代价越低越好,能耗越低越好。
下表把深度维度的关键数字放在同一行,便于核对参数量、能耗、碳排放与平均性能的对应关系。表中能耗单位为千瓦时,碳排放为千克二氧化碳当量,误差为百分比,代价为无量纲分数。
| 模型 | 参数量 | 训练能耗 | 碳排放 | 平均 EER | 平均 minDCF |
|---|---|---|---|---|---|
| ResNet-200-D | 61M | 222.53 kWh | 3.091 kg | 3.44% | 0.224 |
表后解释需要同时讲收益与代价。从 ResNet-18-D 到 ResNet-101-D 或 200-D,平均等错误率(%)明显下降,域外 CommonBench 和 CN-Celeb 也同步改善,说明中等深度确实有效。但从 200 层到 419 层,平均等错误率仅从 3.44% 降到 3.35%,能耗却从 222.53 千瓦时涨到 895.67 千瓦时,约 4 倍,碳排放也升到 13.734 千克。论文因此报告收益递减。未胜出项是 ResNet-34-D 能耗反而低于 ResNet-18-D,提醒能耗不与参数量单调成正比,不能只用参数量预估电费。
中等模型为何落在帕累托前沿上?
本节继续回答精度与能耗的折中位置问题,重点读论文图 1 的像素内容。图前导读如下:该图横轴是准确率百分比,纵轴是训练能耗千瓦时,每个标记代表一种 ResNet 配置,标记大小大致对应模型规模,橙色连线是经验帕累托前沿,左下省电但准确率低,右上准确率高但耗电剧增,需要观察曲线在何处由平缓转陡峭。
看图路径: 1. 先看横轴准确率与纵轴能耗的含义,确认右上是更准但更耗电;2. 再沿橙色帕累托前沿从 ResNet-18-D 向 ResNet-200-D 移动,观察斜率何时变陡;3. 对比 ResNet-50-D 附近聚集的中等模型与最右端 ResNet-419-D 的垂直落差;4. 注意最左侧 ResNet-50-W0.25 孤立点的位置,理解其低能耗对应明显准确率损失
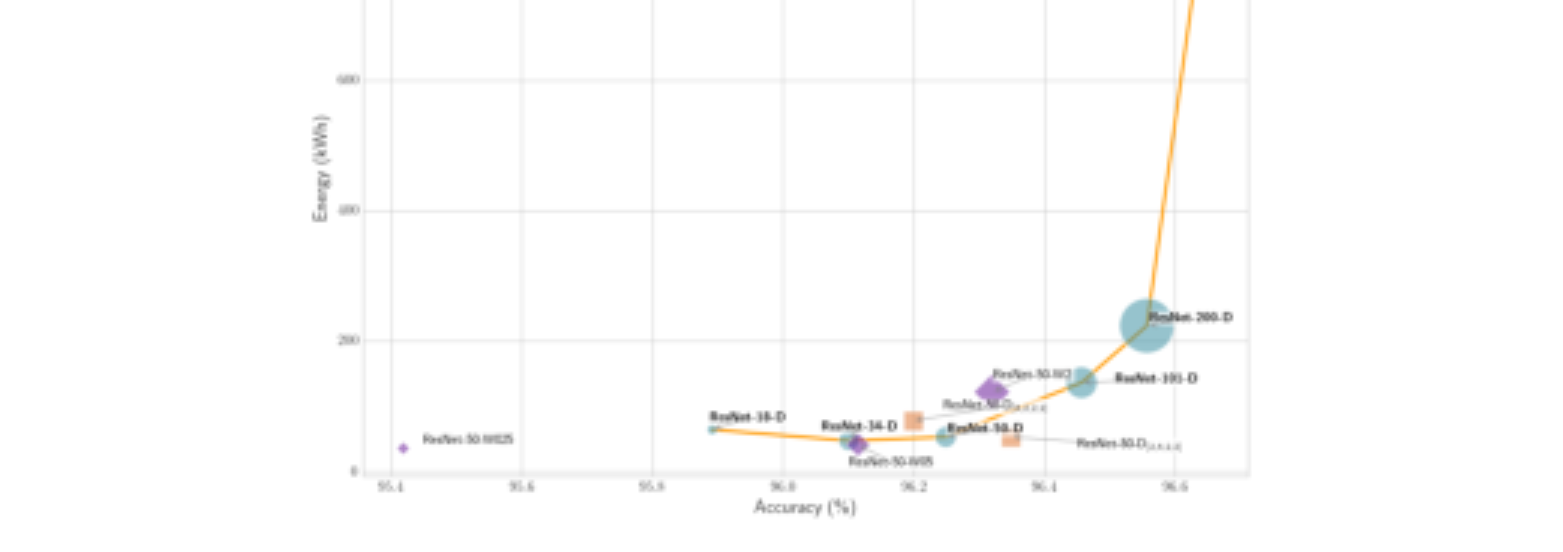
论文图 1。原论文 Figure 1:“Compromis performance-énergie pour les architectures ResNet-X-D.”。
对可见内容的解释是:从左侧 ResNet-50-W0.25 和 ResNet-18-D 出发,前沿先向右平缓延伸,经过 ResNet-34-D 和 ResNet-50-D 附近时以约 50 千瓦时达到约 96.2% 以上准确率,再到 ResNet-101-D 和 ResNet-200-D 时纵轴明显抬升,而最右端 ResNet-419-D 的纵轴几乎垂直拉升到 600 千瓦时以上刻度之外。论文文字确认中等模型以低一个数量级的能耗接近深模型的精度,而超过 101 层或 200 层后加深只换来微小性能提升。复述时不要把横轴准确率与等错误率混为同一指标,二者方向相反,图示趋势仍支持收益递减的判断,但具体数值应以表 1 为准。
加宽与搬块是否比单纯加深更划算?
比较问题分为两组。加宽组问:在 50 层不变时乘大通道是否全域有效;搬块组问:在 50 层与总参数相近时把块集中到中间阶段是否省电又保性能。公平条件仍是同一训练与评价流程,指标方向同前。
下表整理宽度与块分布的关键对照,保留原文的模型命名与数值写法,便于复现时一一对应。
| 模型 | 参数量 | 训练能耗 | 碳排放 | 平均 EER | 平均 minDCF |
|---|---|---|---|---|---|
| ResNet-50-W0.25 | 2M | 34.35 kWh | 0.47 kg | 4.58% | 0.299 |
表后解释要分开讲。宽度方面,W2 在域内好于基线但在 CommonBench 上更差,说明加宽的增益不能稳定泛化到域外;W4 用约 233M 参数和 438 千瓦时只得到 3.77% 平均等错误率,与基线 3.75% 相当,属于论文明确报告的极端加宽低效反例。窄模型 W0.5 以约三分之一参数达到与 ResNet-34-D 相近的 3.89% 对 3.90%,能耗降到 40 千瓦时,是适度变窄的正面折中,但 W0.25 掉到 4.58% 则损失过大。搬块方面,向第二、3 阶段集中可把平均等错误率降到 3.65% 且能耗维持在 52 到 53 千瓦时,而堆到第一阶段或第 4 阶段则退化到 3.80% 和 3.91%,支持中间层更重要的判断。论文结论是在相近电量预算下优先加深而非加宽,该句是基于本组实测的有限解释,不是跨任务的普遍定律。
哪些结论不能推广?还缺什么测量?
论文直接报告的是训练阶段的能耗与碳排放,没有测量推理延迟、吞吐、显存峰值和误判率随阈值的完整曲线,因此不能承诺训练省电的模型在部署时一定更快或更准。相关性也不等于因果,例如块集中到中间层时性能与能耗同时变好,但不能断言某一层单独决定了验证能力。
未评测边界包括:更深模型的多次重复方差、不同 GPU 型号与不同电网下的绝对碳数字、除 ResNet 外的 ECAPA2 等变体的逐项复测。论文提到对 ResNet-101 的加宽趋势与 50 层类似但因篇幅省略,这部分没有数字,不能当作已验证结果引用。总体趋势不等于每组都成立,例如 ResNet-18-D 比 ResNet-34-D 更耗电,说明单点比较仍需实测。
初学者常见误解是把平均指标当成每个测试集都赢。实际上 W2 在 CN-Celeb 上好但在 CommonBench 上差,搬块变体在不同子集上的最小检测代价也有起伏。复述时应说在平均意义上成立,并点名反例,而不是说全面超越。
要复现这组折中,先做什么、记什么?
先固定可运行基线。按论文训练 ResNet-50-D:VoxCeleb2 训练,3.5 秒随机裁剪,批量 512,42 轮次,80 维滤波器组,256 维嵌入,加性角度间隔损失,随机梯度下降动量 0.9、权重衰减 2×10⁻⁴,前 2 阶段加挤压激励,通道按 128、128、256、256 配置。同一硬件型号下跑通后再分别改深度、宽度系数和块分布,避免同时改两个维度。
评价时同时跑域内 VoxCeleb1-O、E、H 和域外 CommonBench、CN-Celeb,记录等错误率、最小检测代价及其平均值。能耗记录要用作业级聚合,区分 GPU、CPU 与整节点传感器的读数,保存千瓦时与按当地碳强度折算的二氧化碳当量,并注明电网年份与地域。若换国家复现,应重新换算碳排放而不是沿用法国 19.6 克每千瓦时的数字。
论文未说明代码与权重是否公开,复述时不能写已开源或可下载。若要补验证,建议补三项:多次种子的均值方差、推理延迟与峰值显存、另一款 GPU 上的能耗相对排序是否保持。这些补项决定了省电结论能否从训练推广到实际部署。
何时值得尝试中等模型与中间集中策略?
当计算预算有限但仍要求接近顶尖验证性能时,值得先尝试 ResNet-34-D 或 ResNet-50-D。论文显示它们以约 46 到 52 千瓦时达到 3.90% 到 3.75% 平均等错误率,而 200 层以上需要数百千瓦时才换来零点几个百分点的改善。当总层数固定为 50 层且不想增加参数时,值得尝试把块向第二、3 阶段集中,例如 2、8、2、2 或 2、6、6、2,它们在本文达到 3.65% 平均等错误率且能耗不增。
当目标是极限压缩时,可尝试适度变窄如 W0.5,但要接受误差回升到 3.89% 左右;不建议直接跳到 W0.25 或 W4,前者误差明显恶化,后者电量与碳排放接近 419 层却无性能回报。当应用包含明显域外数据时,不要只看域内提升就加宽,因为 W2 的域外反例表明加宽可能不泛化。
一句话收束:先用中等深度拿到大部分性能,再用块重分布做无参数代价的微调,最后才考虑加宽,且每次改动都要同时记录平均误差与千瓦时,否则无法判断是否越过收益递减点。
📐 原文公式与排版
以下展示论文原页中的数学表达区域,保留原始上下标、分式和符号排版。区域序号仅用于本文导航,不是论文公式编号。
另有 1 个候选区域因边界不明确或图片数量、尺寸限制未展开;请查看完整论文中的原始排版。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses