英文题目:Extending Xenakis: From Architectural Geometry to Sonification of the Philips Pavilion
会议身份:
conference:icmc:2026:conference-paper-id:paper-410
✅ 来源为官方会议 PDF;表格与 Figure 按原文证据绑定。PDF 公式以原页区域图片展示,未冒称作者原始 TeX。
标签:#开源工具 #信号处理 #音视频 #音乐 #符号音乐生成
评分:4.7/10 | 创新 1.2/2 | 技术严谨 0.8/1.5 | 实验充分 0.3/1.5 | 清晰度 0.7/1 | 影响力 0.6/1.5 | 开源 0.0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.0/1.5
排名:后50% | 文档类型:系统技术报告
👥 作者与机构
- Changda Ma:机构信息未能从会议 PDF 纯文本可靠映射
- Sunshiyu Wang:机构信息未能从会议 PDF 纯文本可靠映射
- Canting Zhu:机构信息未能从会议 PDF 纯文本可靠映射
- Alexandria Smith:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
本文输入为基于档案图纸重建的Philips Pavilion九曲面包络几何,输出为多声部MIDI作品与同步三维可视化,难点在于把静态空间结构转成兼具运动、静滞与事件对比的时间形式。系统先在Rhino与Grasshopper中重建直纹曲面并反求生成性直纹线,再在其间插值结构线并沿线均匀采样空间点集,形成统一几何数据源。接着线段层的长度与垂直落差被映射为弦乐持续滑音的时长与弯音走向,点集按高度分五层统计密度并线性映射为能量块时长,稀疏子集则按水平坐标与G大调量化为铜管与木管离散事件的音高与节拍化触发。在Philips Pavilion参数化重建任务下,弦乐声部中小提琴的数量指标为12,高于中提琴的数量指标的8。相对Parthenios立面参数对应与Torresan桥梁振动响应听觉化,该工作直接以可参数化几何拓扑作为生成控制结构,区分连续线驱动运动与离散点驱动事件两层逻辑,使建筑成为主动生成乐器。结论适用边界受限于该馆特定曲面体系与G调弦乐加管乐编制,尚未验证对其他风格建筑与交互导航的外推,也未做感知有效性检验。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,目标是什么,这篇解读要交付什么?
本文的输入是会议论文的正文文字与官方原图像素,目标是让刚进入语音与音乐与音频领域的研究生能够核对事实并复述方法。必须保留的信息包括九片直纹面的重建来源、每面 20 条插值结构线中选 4 条共 36 条弦乐线、总数为 3357 的空间采样点、5 个按竖向分层的能量块、9 个铜管木管声部、全部用 Python 生成 MIDI 再导入 Ableton Live 编配并用同一全局时间驱动可视化的实现链条。输出是 1 篇按学习依赖展开的中文技术解读,不做营销式判断,不补充证据之外的效果数字。
初学者常把建筑与音乐的关系理解为在厅堂里放音乐,本文要纠正的起点正在这里。论文面对的建筑是 1958 年布鲁塞尔世博会飞利浦馆,其历史逻辑是作曲家雅尼斯·克塞纳基斯先在管弦乐作品中写出大量弦乐滑音,再把滑音的时值与音高轨迹按双曲抛物面一类数学曲面组织为直纹面,最终组合为馆体形态。也就是说声音先有连续的线,建筑后把线变成曲面。本文反转该方向,把已建成的馆体重新视为声音的生成源。理解这一反转是后续所有映射的前提,否则会把线到滑音的对应误读为任意的参数映射。
为避免初学时混淆时间性与空间性,需要先建立白话区分。空间艺术指形态同时铺展,时间艺术指事件先后展开。论文引用莱辛以来的讨论,指出建筑本是静态空间,音乐本是时间过程,克塞纳基斯的突破在于用同一数学直线族同时描述滑音与曲面。本文继承该思想,但不再重复其配器,而是把几何数据重新组织为运动、静止与事件 3 类声音行为。运动对应弦乐滑音的长线条,静止对应滑音到达终点后保持终音并以震音形成的能量块,事件对应稀疏铜管木管的点状触发。3 类行为在同一全局时间轴上先后出现又相互叠加,这是全文时间组织的主线。
同输入同目标的研究在比较什么,为什么本文仍有空位?
把相关工作按同输入、同目标、同运行阶段来对照,才能看清本文的位置。第一类是克塞纳基斯本人的历史路径,输入是滑音记谱中的时间与音高轨迹,目标是生成直纹面与馆体组合,运行阶段是 1 次性的设计生成。论文报告该路径是单向的,建筑是静态结果而非主动的音乐主体。
第二类是帕特尼奥斯一类把建筑立面或城市形态做可听化的工作,输入也是建筑几何,目标也是声音参数,但论文指出其对应关系缺乏对历史结构逻辑的保留,更多是空间维度与表面密度到音乐参数的直接指派。第 3 类是托雷桑等人对桥梁振动数据的可听化,输入是加速度与模态等实测动力响应,目标是反映结构状态的声音,运行阶段是系统响应监测。论文明确区分该工作是基于工程数据的系统响应可听化,而非建筑几何结构本身的可听化。
在同一输入都是建筑几何的条件下,本文与第二类的差别在于是否保留母线生成曲面的因果链。本文先恢复每片曲面的两条控制母线,再做插值与采样,使声音控制结构仍能回指到曲面生成逻辑。在同一目标都是把建筑变成声音的条件下,本文与第 3 类的差别在于数据源是几何形态而非振动响应,因此评价标准不是故障检测准确率,而是运动、聚集与对比是否可被听辨与观看。法语文献中布卢什与索洛莫斯把馆体视为声音与建筑思想持续纠缠的学科交叉点,这为逆转提供了理论动机,但论文并未把文献论述当作实验证据。
对初学者而言,一个常见误解是把任何建筑声音化都视为同一任务。按本文的划分,只有输入为可参数化的直纹面线点数据、目标为可演奏的多层 MIDI 结构、运行阶段为离线生成加实时可视化回放的工作,才与本文同条件可比。若输入换成实测振动或城市噪声,若目标换成混响设计或导航提示,则比较不再公平。保留这一边界,后续复现才不会误用指标。
要解决的具体问题是什么,输入输出如何界定?
本文要解决的具体问题是给定飞利浦馆的建成几何,如何生成一段多层时间性作曲,使听者能感知建筑的运动、静止与结构对比,并能通过同步可视化把声音事件回指到几何位置。输入是基于档案图纸在建模软件中重建的九片直纹面信封体,输出是可在编配软件中渲染的多轨 MIDI 与由同一全局时间驱动的 3 维动画。问题不包含自动作曲的审美评分,也不包含听感偏好实验,它是 1 次构造性验证,证明几何到声音的逆转链条可以完整跑通。
举一个教学例子帮助理解,但例子中的数字仅为示意而不代表论文实测。设想取馆体上一条从低到高的斜线,若其几何长度较长且竖向落差较大,按本文规则它会被唱成一条较长且上行幅度较大的弦乐滑音;若另取一簇在某一高度密集聚集的采样点,按规则它们会形成一个持续较长的能量块。例子说明线的连续性管时长与音高走向,点的密度管静止段的时长与事件稀疏层的触发位置。论文的真实实现把这一思想固定为确定性算法,没有学习式权重,也没有人工逐音作曲。
问题的约束同样重要。几何侧要求每片曲面都能表示为两条母线的线性插值,否则无法提取统一的线结构。声音侧要求沿用作品中的乐器家族以保持历史对照,即弦乐负责连续层,铜管木管负责离散层。时间侧要求滑音段先行、能量块随后、稀疏事件贯穿但受概率稀释约束,以保持层次主次。若任一约束被去掉,例如把全部采样点都转为音符,论文明确指出音乐织体会饱和并遮蔽弦乐连续运动与点状发声的区别,这也是后文稀疏化设计的直接依据。
整体链条如何从馆体走到声音与画面?
整体链条可分为 4 步,每步的输入输出都可复述。第一步是建筑几何处理,输入为档案图纸,输出为九片直纹面、每面的两条控制母线、每面 20 条插值结构线与总数为 3357 的空间采样点。第二步是弦乐可听化,输入为每面均匀选取的 4 条结构线共 36 条,输出为 36 个弦乐声部的滑音段与其后的 5 个能量块段。
第三步是铜管木管子序列,输入为缩减后的点子集,输出为九轨离散 MIDI 事件,其音高按竖向坐标离散到 G 大调音阶,起音按横向坐标映射到全局时间并量化到节奏网格。第 4 步是实时可视化,输入为同样的线点数据与全局时间,输出为 3 维动画与视频文件,动画用低透明度点云与静默线条做背景,再按时间激活滑音游动头、能量块稠密场与离散点触发。
下图是理解反转关系的关键,它把左侧历史过程与右侧本系统并置,中间用反向过程箭头连接,初学时应先看主路径再看分支汇合,右侧 3 类声音的相位关系与底部从馆体提取母线的回路尤其值得停留。
看图路径: 1. 先从左侧黑色历史分支找到从特殊记谱到直纹面再到飞利浦馆的主路径;2. 再看中间从时间音高到顺序密度显著性的坐标转换框;3. 然后沿右侧红色箭头核对从馆体提取母线与点到三类声音的分支;4. 最后确认底部反向过程箭头指向历史分支的闭环含义
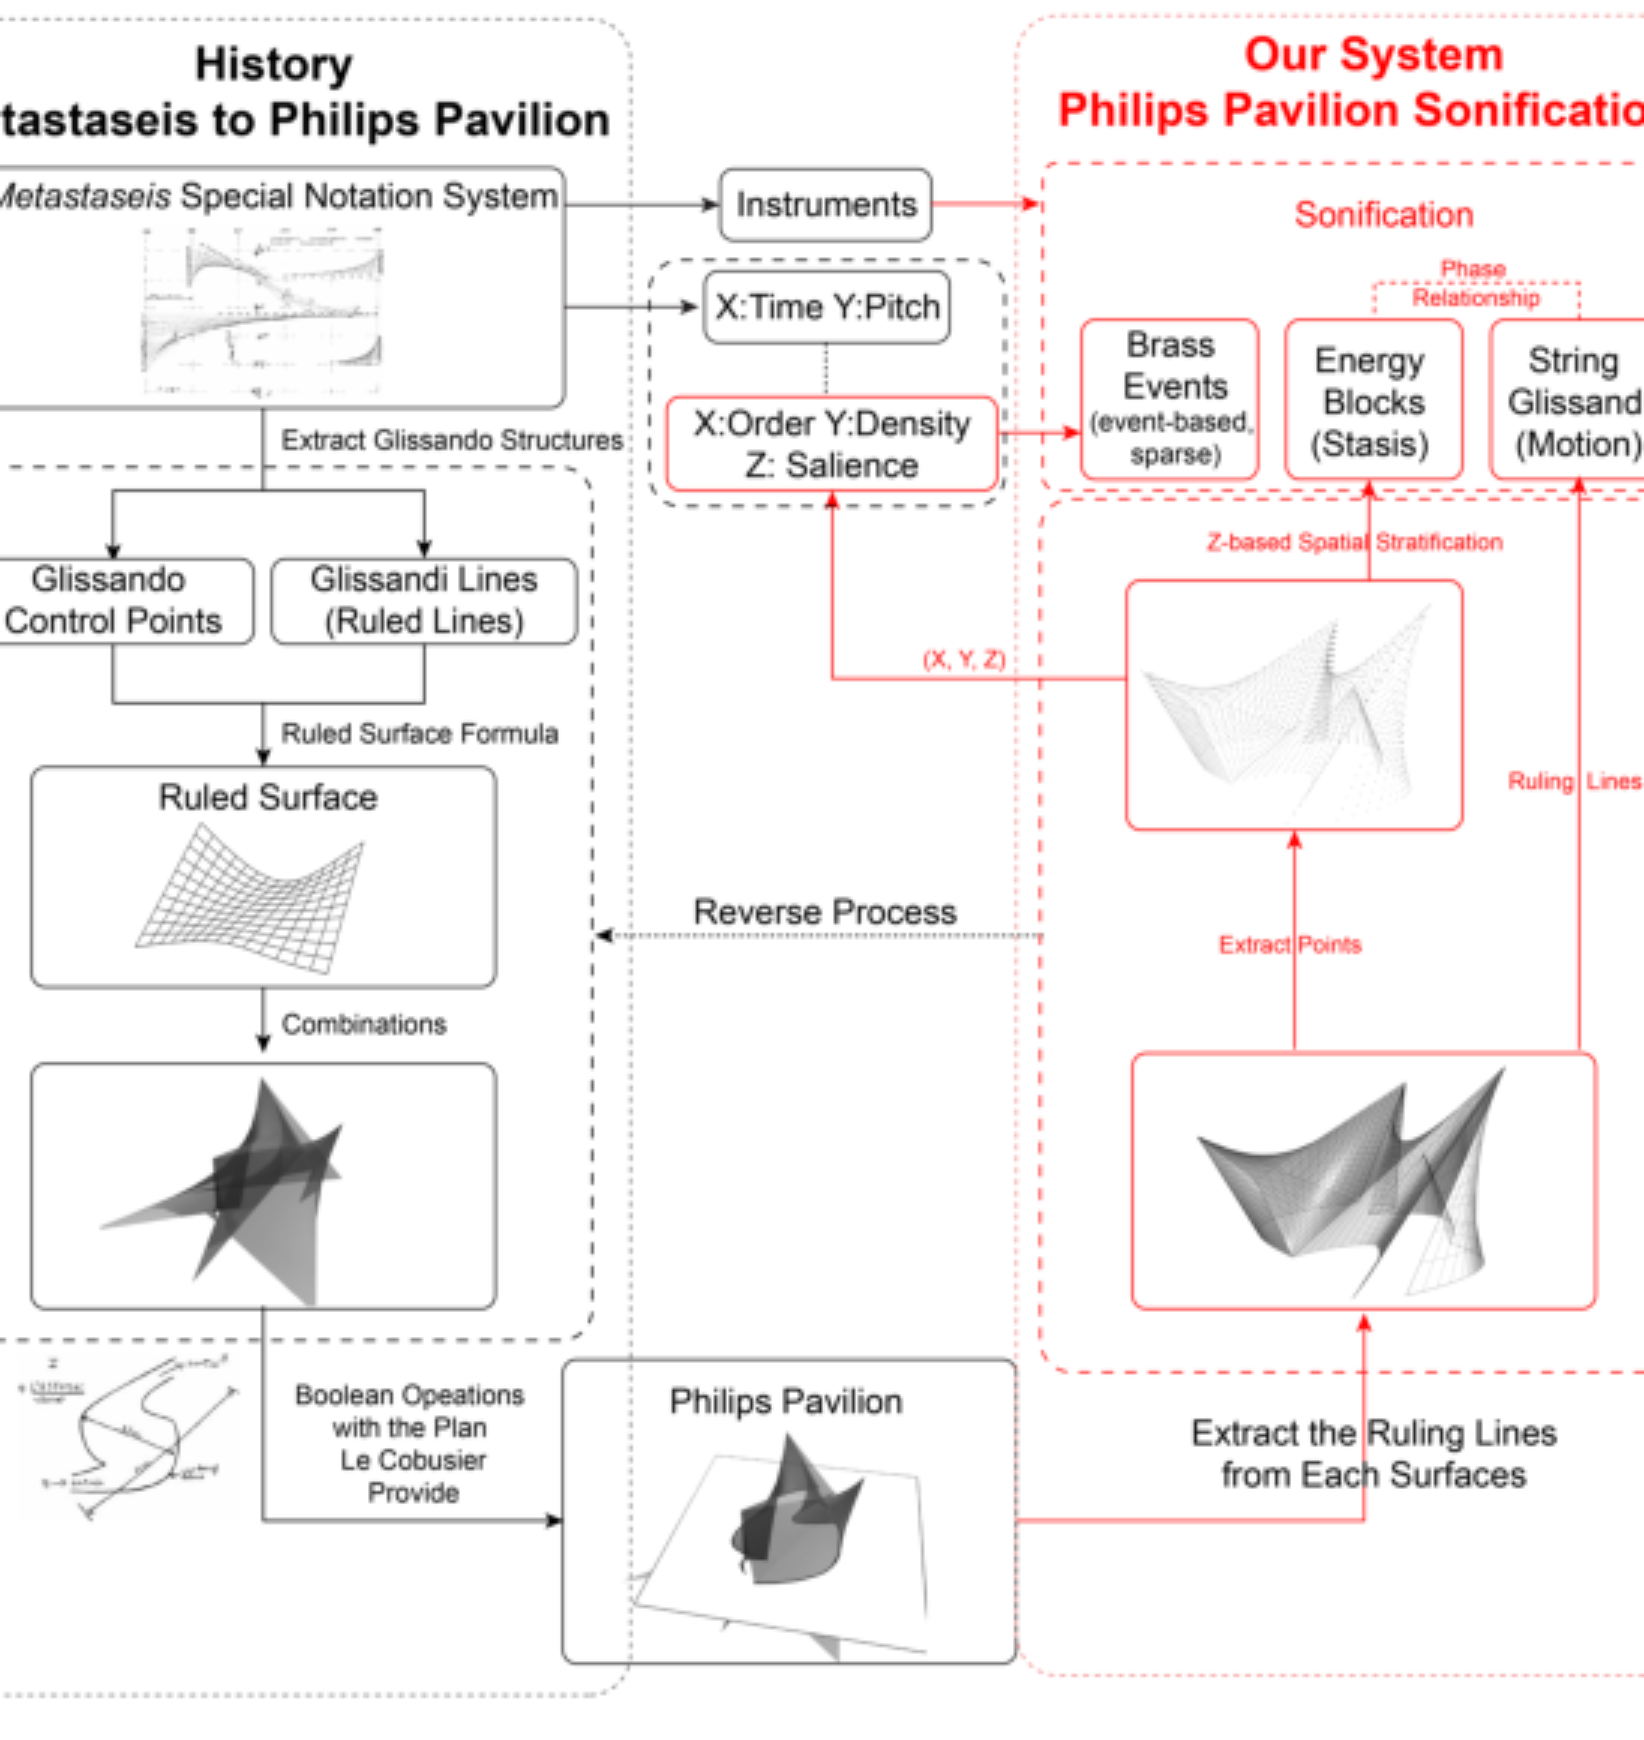
论文图 1。原论文 Figure 1:“System workflow illustrating the inversion of Xenakis’ historical music to architecture process.”。
该图左侧显示从特殊记谱提取滑音控制点与滑音线,经直纹面公式生成曲面再组合并经布尔运算得到飞利浦馆;右侧显示从馆体提取母线与点,再分别走向弦乐滑音的运动、能量块的静止与铜管事件的稀疏触发,中间的顺序密度显著性坐标承接 3 维坐标的输入。读图时要注意历史分支用时间音高坐标,本系统分支用顺序密度显著性坐标,二者不是同一映射,混淆会误解横轴含义。后文将分别展开几何构造与 3 类声音映射的实现细节,可视化部分则强调同一时间基准如何保证声画同步。
几何一侧如何得到线与点,弦乐滑音如何被驱动?
几何构造从重建开始。作者在建模软件中依据档案图纸重建馆体信封,再用参数化建模恢复其直纹面系统并分离出九片曲面。对每片给定曲面,通过取参数两端的边界线恢复两条控制母线,这对应直纹面公式的逆过程。公式思想是曲面由两条母线做线性插值扫成,因此只要恢复两端母线即可解释整片曲面。为捕捉曲率与朝向的连续变化,每面在两条母线之间插值出 20 条结构线,形成高分辨率几何表达。
再从这 20 条中按等距选取 4 条作为弦乐骨架,九面共得 36 条。每条选中线记录起点、终点与总长度,用于定义滑音路径与时长。
直纹面 × 弦乐滑音: 直纹面负责提供可参数化的几何骨架,它由两条母线做线性插值扫出曲面,因而整片曲面可被还原为直线族;弦乐滑音负责提供连续运动的声音载体,它用起点到终点的持续音高滑动对应线的方向与长度;二者搭配的理由是直线与滑音共享连续轨迹这一结构单元,组合后建筑的长度变成时长、竖向落差变成音高走向,使几何运动可被听见。
弦乐滑音的具体计算分时长与音高两路。时长路由每条线的 3 维几何长度经归一化与大于 1 的指数整形压缩极端值,再线性映射到预设的最小时长与最大时长之间,指数偏向短时值以保留感知对比。音高路由线的竖向起点到终点落差按馆体整体竖向范围缩放,决定滑音的方向与幅度,并以连续弯音实现而非离散半音台阶,滑音过程中音高随时间均匀渐变以保持平滑。36 个声部按小提琴十二、中提琴八、大提琴八、低音提琴八分配,初始统一为 G 音级再按乐器音区分八度。滑音结束后各声部保持终点音高,经 1 秒人工休止进入块段,以同步震音组织协调的起止。
下图展示插值线与选中线的关系,淡色密集线为全部插值结果,彩色粗线为选中的滑音骨架,初学时先分清两层线型再看走向才能理解为何只用 4 条驱动声音。
看图路径: 1. 先区分淡色密集插值线与彩色粗选中滑音线的两层线型;2. 再沿同一曲面观察两条边界母线之间插值线的走向变化;3. 最后核对右下图例对插值线与选中线的颜色定义
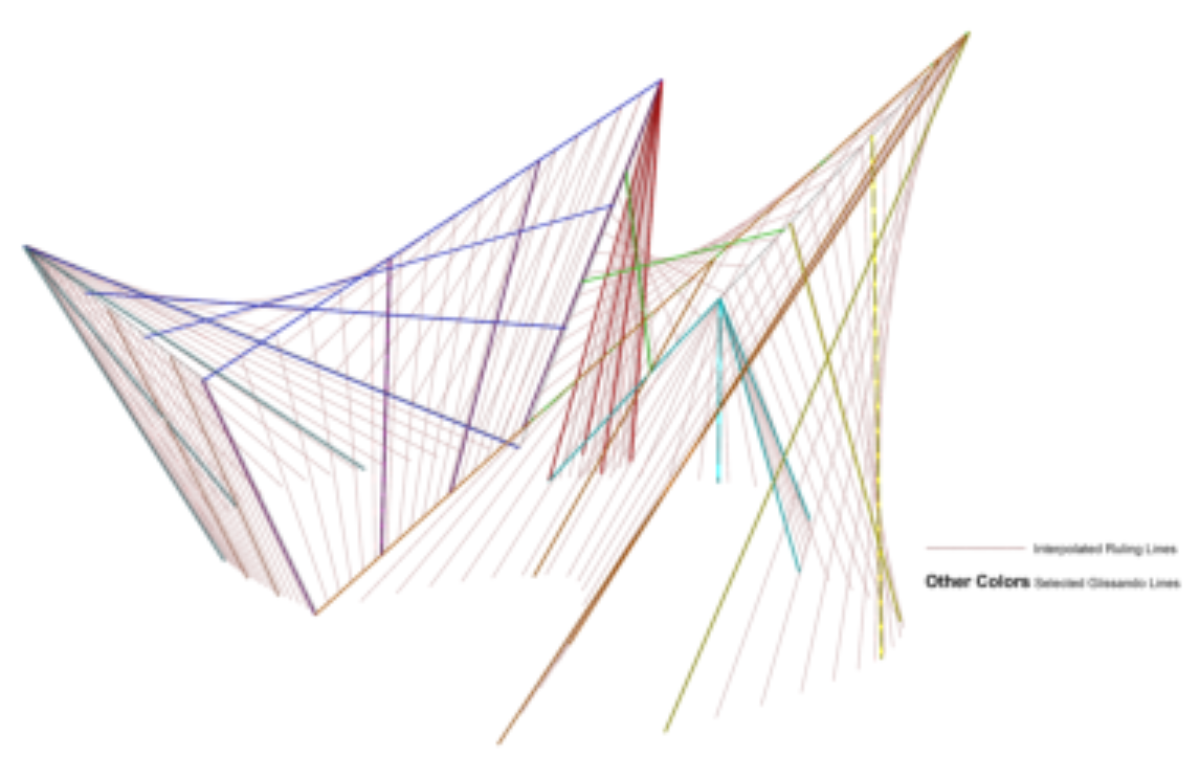
论文图 3。原论文 Figure 3:“Interpolated structural lines generated between the ruling lines of each surface.”。
该图可见同一曲面内插值线在两条边界母线之间逐渐过渡,彩色选中线等距分布以覆盖曲面不同部位,右下图例明确了两类线的定义。需要指出均匀插值与等距选取保证了可听化的连续性,但论文在局限中承认固定密度难以捕捉局部曲率变化,某些几何特征会被弱化。这一点在复现时不应视为可忽略的细节,而是理解均匀采样代价的关键。
下图进一步展示离散采样结果,每个点按所属曲面着色,沿线等距分布形成行列纹理,可用于核对点群分区与密度直觉。
看图路径: 1. 先按颜色区分九组曲面点群在大曲面上的分区;2. 再观察点沿线状结构等距排列形成的行列纹理;3. 最后比较高耸尖顶与低凹鞍部区域的点密度差异
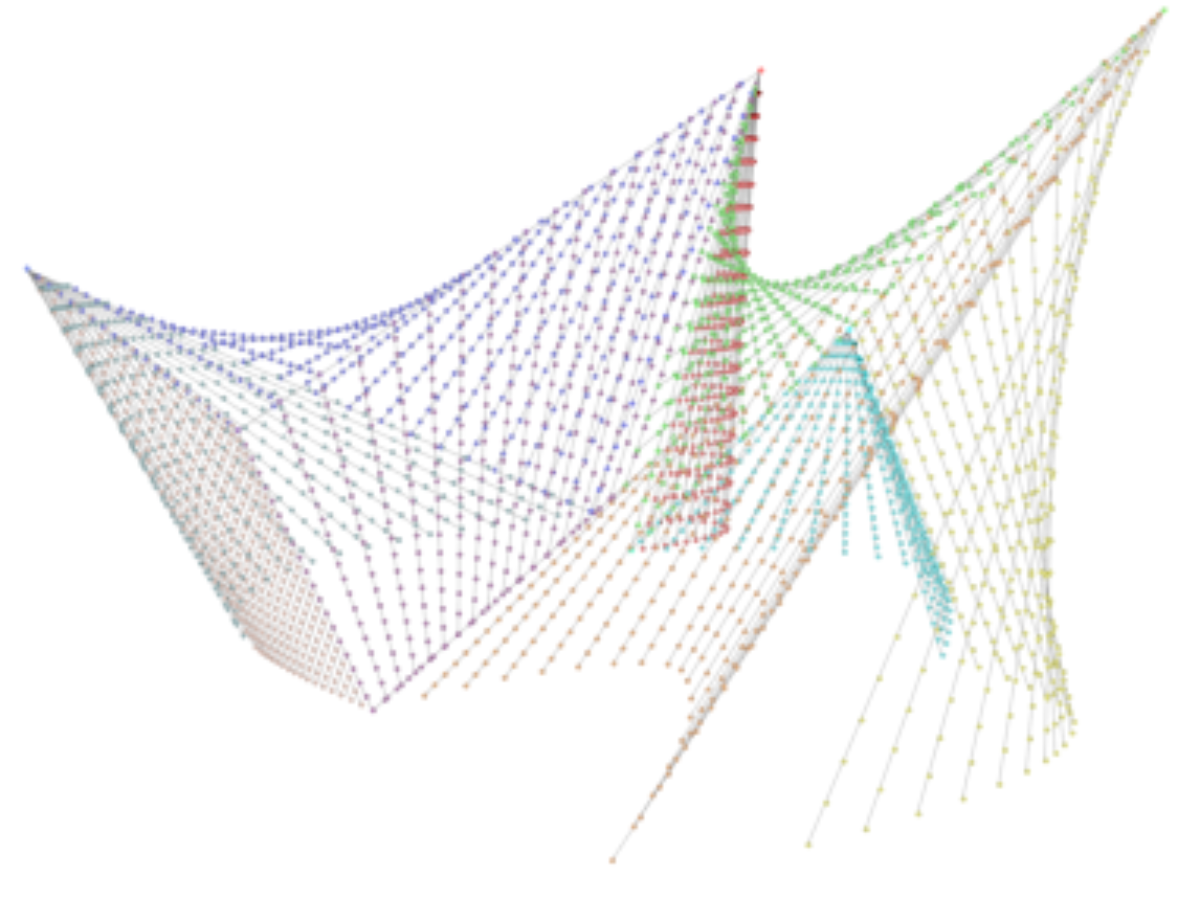
论文图 4。原论文 Figure 4:“Spatial sampling points extracted from the Pavilion’s nine ruled surfaces, colored by surface groups.”。
该图显示 9 组颜色各自成片,尖顶处点线收敛而鞍部相对舒展,颜色身份在后文可视化中保持一致,使线、块与事件 3 阶段仍可回指到同一建筑分组。采样方式是沿每条结构线取 20 个等距点,总数为 3357,该总数是后文块时长与事件映射的输入规模,复现时应先核对该数字再进入声音映射。
点的一侧如何形成能量块与稀疏铜管木管事件?
点的处理分两条互补路径。第一条是能量块路径,把馆体按全局竖向轴等分为 5 个等宽区间,按采样点的高度坐标分配块索引,再统计每块点数作为局部结构密度的代理,点数经线性映射到预设时长范围得到块时长,若各块点数相等则取中间时长,五块按序排列并以固定休止分隔,全部弦乐在块段末同时结束。第二条是铜管木管路径,从全量点集中缩减采样并分配到 9 个乐器,乐器包括长笛、双簧管、单簧管、大管、圆号、小号、长号、大号与英国管。
每个点的竖向坐标经全局归一化映射到有界音高范围再离散量化到 G 大调音阶得到 MIDI 音高,横向坐标线性映射到由弦乐段定义的全局时间并量化到固定节奏网格,纵向另一水平坐标调制事件密度与乐器分布而非直接编码音高或时间。每轨保持最小起音间隔以维持清晰度,弦乐休止段再经概率降采样稀释铜管木管密度以保持全时间线的连续性。
空间采样点 × 能量块: 空间采样点负责记录曲面离散后的密度分布,每个点保留所属曲面与 3 维坐标;能量块负责组织滑音结束后的相对静止,它让全部弦乐保持终点音高并以同步震音形成有起止的段落;搭配理由是点的竖向聚集程度可作为结构密度的代理,组合后把按高度分层的点数线性映射为块时长,使稠密处听感更长、稀疏处更短。
离散层的设计刻意与连续层拉开。弦乐用连续弯音表现线的延续,铜管木管用离散音级表现点的离散,论文称之为线被渲染为连续、点被渲染为离散。若把全部点都转为音符,织体会饱和并遮蔽两层区别,因此缩减采样既是结构控制策略,也是继承自历史配器的乐器逻辑。事件起音遵循节拍量化公式,稀疏触发在滑音与能量块阶段并行出现,形成次要但能加强结构端点的对位层。
离散点事件 × 铜管木管子序列: 离散点事件负责刻画局部结构时刻,它把单个 3 维坐标转为 1 次有明确起音与音高的打击式发声;铜管木管子序列负责承载该离散层,它用 9 个声部与 G 大调离散音高区别于弦乐的连续弯音;搭配理由是若全量点都发声会淹没连续层,因此以缩减采样保持从属与点缀关系,组合后形成连续运动之外的稀疏对位。
为核对几何到声音的规模关系,下表把论文明确报告的构造数字整理为可复述的一览,比较问题是同样的馆体如何被压缩为可演奏的声部与点数,公平条件是全部数字来自同一重建与同一采样规则,指标方向是数量越大则覆盖越密但计算与织体负担越大。
| 条件 | 指标 | 曲面总数 | 弦乐线总数 | 采样点总数与弦乐编制 |
|---|---|---|---|---|
| 同一馆体重建与等距采样 | 几何与编制规模 | 九片直纹面 | 36 条结构线 | 3357 点,12 小提琴、8 中提琴、8 大提琴、8 低音贝斯 |
上表的主要收益是把可听化输入固定为可核对的整数规模,九面每面选 4 条得到 36 条的算术可直接验算,3357 点是块与事件的共同输入,弦乐编制明确到各声部数量。代价是均匀选取与固定编制无法自适应曲率,稠密弯折处可能欠采样而平坦处相对过采样;未胜出项是若改用曲率自适应采样,论文未评测其对块时长与事件密度的具体影响,这构成明确的未评测边界。
第二张表聚焦离散层的组织,比较问题是点如何被分为静止与事件两用,公平条件是同一竖向分层与同一 G 大调量化规则,指标方向是块数与轨数固定而时长与密度随数据变化。
| 条件 | 指标 | 能量块划分 | 铜管木管轨数 | 音高与时间组织 |
|---|---|---|---|---|
| 同一全局时间与竖向范围 | 分层与离散化 | 5 个等宽竖向区间 | 九轨 | 竖向到 G 大调离散音高,横向到全局时间并量化到节奏网格 |
该表显示静止层用 5 个块组织滑音后的保持状态,事件层用九轨承载稀疏触发,离散音高区别于弦乐连续轨迹。代价是等宽分层对非均匀高度分布敏感,某些块可能点数悬殊而时长被线性拉开;反例是若各块点数相等则只能取中间时长,此时密度对比消失,可听化退化为等长段落。论文未报告块时长的具体秒数与事件总数,因此不能据此承诺听感对比的强度。
是否存在模型训练,真实计算过程是什么?
本研究没有神经网络训练阶段,也就没有梯度路径、参数冻结与更新、监督损失或验证早停可报告。该节必须明确说明未训练哪些模型,再讲实际发生的确定性计算。未训练的对象包括任何声学模型、符号音乐生成模型与几何编码器,全文未报告训练集划分、优化器、学习率或轮数,不能从 Python 与 MIDI 等词推定存在学习过程。
真实计算过程是规则式几何到音乐的转换。几何侧在建模软件中完成重建与插值,声音侧在 Python 中执行确定性算法生成 MIDI 文件,再导入编配软件做配器、定位、混音与渲染。可视化侧用 3 维绘图工具与动画函数做实时动画并用视频编码器导出。论文称整个实现完全确定性,这意味着给定相同的重建几何与相同的映射参数应得到相同的 MIDI 事件序列,但确定性不等同于可直接运行,因为块时长范围、滑音时长上下界、指数整形系数与休止长度等关键超参数在正文中未给出具体数值。复现时应把这些缺项逐一记录为待补参数,而不能从乐器名推定实现细节。
另一个需要澄清的误解是把无训练等同于无计算成本。几何重建依赖人工对照档案图纸,插值与采样涉及数千点的坐标运算,可视化涉及逐帧 3 维渲染,这些都是真实成本,只是论文未报告硬件型号与耗时。后续复现应先跑通 36 条线与 3357 点的构造,再补记运行环境与耗时,才能形成可比较的成本记录。
可听化 × 参数化建筑建模: 参数化建筑建模负责把档案图纸重建为可计算的数据,它在 Rhino 与 Grasshopper 中恢复九片直纹面并输出母线与采样点;可听化负责把数据转为非言语声音,它规定线到连续滑音、点到块时长与离散事件的映射;搭配理由是只有几何变为结构化数据后才有稳定的声音控制源,组合后建筑不再是被动容器而是可演奏的生成结构。
数据协议与运行条件如何交代,哪些缺项必须指出?
数据侧的协议是单案例构造而非多集评测。数据集即飞利浦馆九片直纹面的重建几何,划分为 9 个按曲面标记的点群,采样规则为每面 20 条插值线、每线 20 个等距点并选中 4 条做弦乐骨架。论文未报告训练验证测试划分,因为不存在学习任务;未报告采样随机种子,因为采样是等距确定性规则;未报告统计显著性方法,因为没有对照组与重复实验。指标侧没有准确率或 mean opinion score 一类分数,评价维度是结构可听辨性与声画同步性,但均以构造描述而非分数呈现。
运行条件方面,几何处理在建模软件中完成,声音生成在 Python 中完成,渲染在编配软件中完成,可视化用 3 维动画库与视频编码器完成。论文给出代码仓库链接与可视化视频链接,但本次解读依据的资源状态是没有发现来源绑定且完成验证的资源,因此不得声称代码或数据当前可用或已公开,只能说正文记载了链接地址而本次未能确认可达。硬件预算、推理延迟、输出帧率与实际延迟均未报告,不能承诺实时性得到改善。
对初学者最重要的操作是核对聚合对象。块时长按每块点数聚合,事件密度按每轨起音间隔约束,滑音时长按每条线长度聚合,三者聚合对象不同,数值相同也不代表同一含义。百分点与相对百分比的区别在此不适用,因为论文未报告百分比类指标;不同指标的差值更不能混入同一模型列下比较。凡涉及秒数的内容,只有可视化标题中的总时长一类画面信息可参考,正文未给出各段具体秒数,复现时应以自己的全局时间实现为准并明确记录。
主结果显示了什么,支持什么判断又限制什么?
论文直接报告的主结果是系统完整跑通并产出可播放与可观看的 audiovisual 成果。具体包括 36 条弦乐滑音先行、5 个能量块随后组织静止、稀疏铜管木管贯穿加强结构端点,三者共享同一全局时间并在可视化中同步激活。背景始终保留低透明度浅灰点云与静默线条提供馆体上下文,每片曲面组保持一致颜色身份,使线、块与事件 3 阶段仍可回指。滑音阶段用彩色游动头与短拖尾表现方向与连续性,终点在该阶段被视觉抑制以聚焦集体运动。
滑音完成后插入短暂间隙,终点转为暗色稳定标记表示到达并保持;块阶段按竖向 5 层激活稠密彩色场,终点保持高亮脉动表示块在终点锚定状态下展开;离散事件以小而分色的点触发出现,起音遵循节拍量化形成稀疏次层。
当前可视化处于滑音阶段,标题给出全局总时长信息,彩色游动头沿灰色骨架移动,右侧图例区分各声部颜色,初学时应先确认阶段再看运动方向,最后用颜色回指建筑分组。
看图路径: 1. 先读顶部标题确认处于全部线条的滑音阶段与当前秒数;2. 再观察三维空间中带拖尾的彩色运动头与灰色背景骨架;3. 最后对照右侧图例区分弦乐滑音头、终点与各铜管木管点色
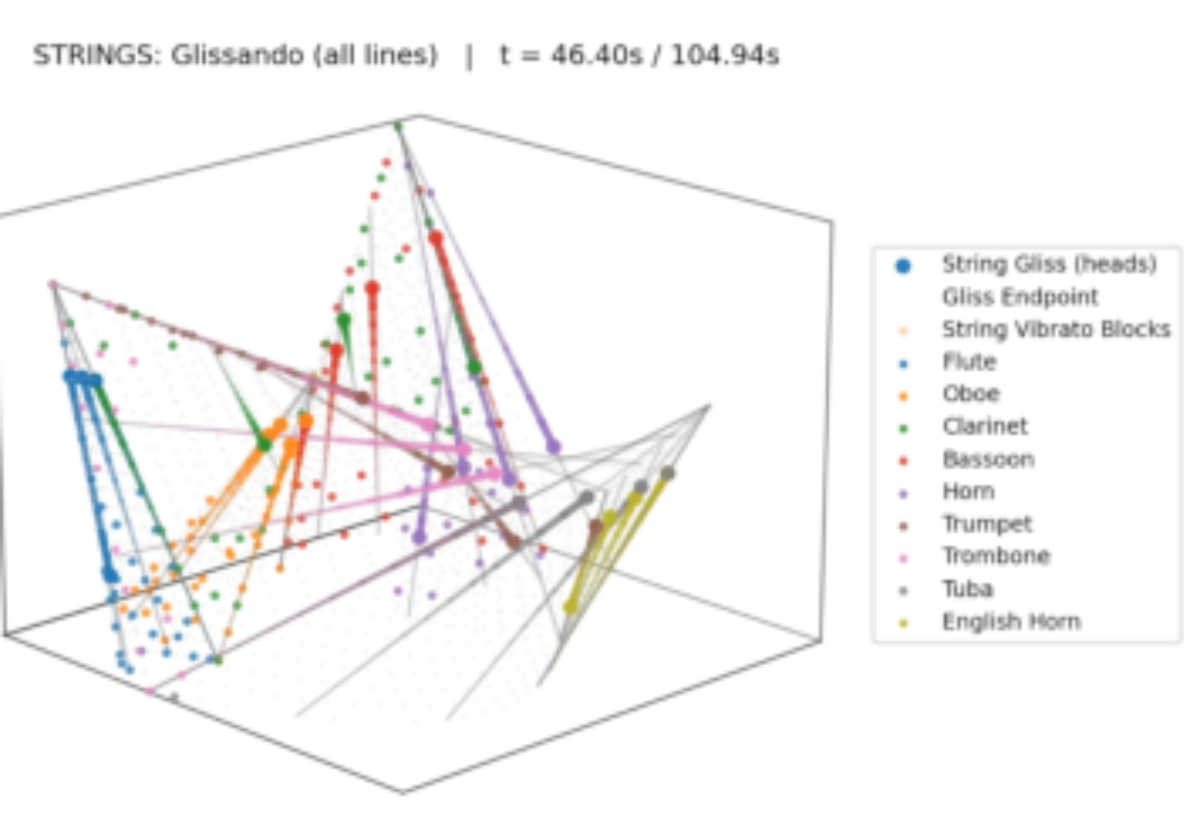
论文图 7。原论文 Figure 7:“Real-time visualization during the string glissando phase.”。
该图可见多个弦乐头的拖尾沿不同朝向延伸,背景点云较淡而前景轨迹较亮,右侧图例把弦乐头、终点、震音块与 9 种铜管木管颜色逐一列出。像素不能精确辨别的数值不应硬写,此处只做阶段与层次判断,不把某 1 帧的构图推广为全程。论文用报告一词描述上述行为,用支持一词描述建筑可作为主动生成乐器的方向性判断,而是否更具审美价值则属于可能待验证的推测,不应写成已证明的结论。
限制同样明确。结果是单馆单实现的构造演示,没有基线对照,没有听众实验,没有可部署收益的数字表。数据配置表不能替代结果表,但原文确实未提供定量主结果表,因此本解读只能用构造规模表承担可核对性,而不能虚构胜负数字。总体趋势是几何结构可被听见与看见,但不等于每组每步都成立,某些曲率细节已被均匀采样弱化。
若拿掉稀疏约束或均匀采样会发生什么,论文给了什么反证?
论文没有正式的消融实验,但给出了两处可用作反证的论述,初学时应把它们当作条件分析而非拿掉后必然怎样的断言。第一处是关于事件密度的约束。论文报告缩减点集是一种结构控制策略,若把全量点集都转为音符事件,音乐织体的密度会饱和并遮蔽弦乐连续运动与点状发声的区别。这支持稀疏化与概率降采样的必要性,但并未给出全量与缩减两种条件下的事件数或响度对比数字,因此只能说方向性支持而不能量化代价。
第二处是关于均匀插值与等距划分的局限。论文报告固定密度的结构线与采样点难以捕捉局部曲率变化,会弱化与简化某些几何特征。这支持均匀采样的代价存在,但同样没有给出曲率误差或听辨混淆率的测量,因此不能推定换用自适应采样必然改善。
从可运行策略的角度,复现者可以自行设计最小对照而不虚构论文数字。例如固定其他映射,仅比较等距选 4 条与随机选 4 条在滑音时长分布上的差异,或比较等宽五分层与等点数五分层在块时长分布上的差异。这类对照的公平条件是同一重建几何与同一归一化范围,指标方向是分布方差越大则对比越强但可能出现极端时长。论文未做此类对照,故本节的表格仍是构造参数表而非胜负表,任何自行跑出的数字都应标注为复现补充而非原文报告。
需要避免的错误是把相关性当因果。点数多与块时长长是映射规则定义的相关,不是听感能量必然更高的因果;线长与滑音时长相关,但最终感知还受配器与混音影响。未测量误判率、延迟或成本时,不承诺这些量得到改善,这是贯穿全文的表达纪律。
哪些边界尚未评测,为什么不是技术错误?
论文在结论中明确列出 3 类局限,应理解为缺失证据而非技术错误。建筑数据侧的局限是均匀插值与等量划分难以保留复杂曲面的局部曲率,固定密度采样会简化几何特征。可听化侧的局限是统一沿用历史配器体系,无法充分表达其他建筑风格的 distinctive 特征,也难以探索更广的音乐可能性。交互侧的局限是系统实现了 audiovisual 呈现但缺乏常见于交互式建筑系统的用户体验功能,例如沉浸式导航中的实时响应。
未评测的边界还包括泛化到其他建筑案例的效果、不同分层数与量化音阶对结构可辨性的影响、以及长时间聆听下的疲劳与混淆情况。论文未报告这些条件,因此不能把单馆成功推广为通用建筑可听化方案。缺失不等于否定,它只是要求后续工作补做验证。
对初学者的提醒是不要用比喻代替性质证明。把建筑说成乐器是有帮助的比喻,但随后必须对应到真实信号与组件,即线到弯音、点数到块时长、离散点到量化 MIDI 事件。若停留在比喻层面,就会误以为任何建筑都能直接发声,而忽略重建精度、归一化范围与稀疏约束这些决定成败的实现条件。
要复现这条逆转链条,先做什么,需要补哪些验证?
复现的第一步是重建几何。按档案图纸在建模软件中恢复九片直纹面,分离信封并为每片恢复两条控制母线,再每面插值 20 条结构线并等距选中 4 条,沿每条结构线等距采样二十点并核对总数是否为 3357 与 9 个曲面分组是否完整。若总数对不上,应先检查插值数与采样数而非直接调声音参数。第二步是实现声音映射。按归一化加指数整形再映射到时长范围实现滑音时长,按竖向落差缩放实现滑音方向与幅度并用连续弯音渲染。
按竖向五等分统计点数并线性映射实现块时长;按竖向到 G 大调离散化与横向到全局时间并量化到节奏网格实现九轨离散事件,同时加入最小起音间隔与休止段概率降采样。第三步是统一全局时间并生成 MIDI,再导入编配软件完成配器与混音,同时用同一时间基准驱动 3 维可视化,背景保留低透明度点云与静默线条,3 阶段按滑音游动、块稠密场、点触发的顺序激活。
必须保留的关键信息条件包括 G 统一起音、G 大调离散集、三十六声部的乐器分配、五块按序加固定休止、九轨乐器名单与同一全局时间。缺失的具体超参数包括滑音最小时长与最大时长、指数系数、块时长范围、固定休止长度、节奏网格尺寸与降采样概率,这些在原文未给出数值,复现时应显式记录自选值并说明选择理由。代码与视频在正文记载了链接,但本次未能确认可达,因此应按上述文字规则独立实现而非等待下载。
还需补的验证至少三项。一是几何保真验证,比较重建曲面与图纸关键尺寸的偏差,说明均匀采样的简化程度。二是映射单调性验证,检查线长到时长与点数到块时长的单调关系是否被归一化与整形保持。三是层次可辨性验证,组织小规模听辨记录滑音方向、块边界与稀疏事件的可辨率,但须把自动计算与人评分别报告,不能把分布方差当作人评分数。
何时值得尝试这条路线,一句话如何带走?
当研究目标是把建筑几何本身作为生成结构而非背景容器,且几何可表示为直线族与可数点集时,这条路线值得尝试。它的价值在于保留从滑音到直纹面的历史因果链,使声音参数仍可回指到建筑生成逻辑,同时用同一时间基准实现声画同步,便于教学与展演。若目标是振动监测、声场仿真或偏好优化,则应选用工程响应可听化或感知实验范式,而非本文的几何可听化。
带走的一句话是先沿一条样本走完输入到输出再展开全系统。取一片曲面的一条选中线,核对其起点终点与长度如何变为一条弦乐滑音的时长与走向,再看同片点群的竖向分布如何变为块时长与稀疏事件,最后把九面三十六线与 3357 点的规模套入同一流程。前置概念先于依赖它的结论,指代保持唯一回指,比喻之后必有信号对应,这是复述本文而不走样的方法。
最后重申证据纪律。本文报告的是构造跑通与同步呈现,支持的是建筑可作为主动生成乐器的方向,待验证的是审美价值、跨风格泛化与交互体验。复现应从几何与映射的整数规模入手,补齐未报告的时长范围与网格参数,再以小规模听辨补足评价缺项。如此既尊重原文的单向逆转思想,也为后续把馆体带入沉浸式空间的听觉导航留下可扩展的接口。
📐 原文公式与排版
以下展示论文原页中的数学表达区域,保留原始上下标、分式和符号排版。区域序号仅用于本文导航,不是论文公式编号。
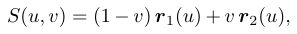
区域 1 · 查看论文原页
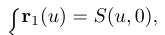
区域 2 · 查看论文原页
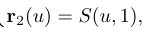
区域 3 · 查看论文原页

区域 4 · 查看论文原页
另有 2 个候选区域因边界不明确或图片数量、尺寸限制未展开;请查看完整论文中的原始排版。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses