英文题目:Guided by the Plan: Enhancing Faithful Autoregressive Text-to-Audio Generation with Guided Decoding
会议身份:
conference:eacl:2026:conference-paper-id:2026.eacl-long.138
✅ 来源为官方会议 PDF;可重放的表格、公式文本与 Figure 像素已按 PDF 抽取结果绑定,未成功恢复的结构不作推断。
标签:#自回归模型 #主观评测 #环境声 #音频生成
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.0/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 1.0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.0/1.5
排名:前25% | 文档类型:方法研究
👥 作者与机构
- Juncheng Wang:机构信息未能从会议 PDF 纯文本可靠映射
- Zhe Hu:机构信息未能从会议 PDF 纯文本可靠映射
- Chao Xu:机构信息未能从会议 PDF 纯文本可靠映射
- Siyue Ren:机构信息未能从会议 PDF 纯文本可靠映射
- Yuxiang Feng:机构信息未能从会议 PDF 纯文本可靠映射
- Yang Liu:机构信息未能从会议 PDF 纯文本可靠映射
- Baigui Sun:机构信息未能从会议 PDF 纯文本可靠映射
- Shujun Wang:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
文本到音频生成以文本提示为输入、以波形解码音频为输出,难点在于严格因果自回归只能从左到右生成,难以全局协调多事件复杂指令,易遗漏或错位关键语义元素。该方法先用前缀隐状态探针验证隐式规划,发现前三十二步前缀表征即可回归事件数并分类发声对象,为早期评估提供依据。接着训练轻量评论家,将前缀词元与文本编码经因果自注意力和交叉注意力映射为标量分,以稀疏监督预测最终指令遵循质量,其输出直接作为下一步前缀打分。推理时采用前缀优先搜索,并行采样一百二十八个短前缀并由评论家打分剪枝,仅保留得分最高的少量高潜力规划种子再补全为完整音频,将算力前移到种子探索。与同词元预算下对完整序列重排的最优重排相比,该机制避免在低潜力轨迹上浪费补全,因而在复杂多事件提示下更高效且语义更忠实。在AudioCaps评测下,Siren+Ours的CLAP为36.47,高于Siren+BoN的26.67。结论适用边界受限于二百八十八词元短音频、Siren分布与CLAP代理奖励下的固定前缀假设,长时多阶段场景与跨生成器迁移尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 代码相关资源:https://github.com/wjc2830/Siren.git → https://github.com/wjc2830/Siren — 链接可访问(HTTP 200) 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,目标是什么,为什么复杂提示最难?
输入是一句文本提示,目标是生成一段波形音频,使其中包含的声音事件与提示一致。论文研究的是文本到音频生成,其中自回归路线先用残差向量量化编码器把波形变成离散 token 序列,再用因果 Transformer 从左到右预测下一时刻的多个量化层编码,最后用解码器变回波形。 评价分两类,一类是音频质量,如 FAD、FD、IS、KL,另一类是指令跟随,用 CLAP 算文本嵌入与音频嵌入的余弦相似度,越高表示越贴合。输出是完整音频,但中间只允许因果可见,这正是后文要补全局控制的原因。必须保留的信息是基线行为随复杂度分化:事件数越多,自回归越容易漏事件。
自回归生成 × 双向扩散生成: 自回归生成负责按时间从左到右逐个预测音频 token,保持严格因果和局部时序连贯;双向扩散生成负责让所有位置互相可见、做全局粗到细协调。论文搭配二者作对照的理由是揭示矛盾:前者时序自然但复杂提示下容易漏事件,后者全局性强但破坏因果流动,组合意义是定位要保留因果、只补全局语义对齐的改进点。
下面这张按事件数分组的 CLAP 柱状对比,把任务难度、基线短板和本文收益放在同一坐标下,读懂它才能理解为什么要动解码而不是重训生成器。
看图路径: 1. 先看横轴 Event@1 到 Event@>=5 表示事件数增加、复杂度上升;2. 再对比每组内蓝色扩散、粉色自回归基线、绿色本方法的柱高变化;3. 注意顶部标注的总体值 31.59、26.67、36.47 三者的相对位置
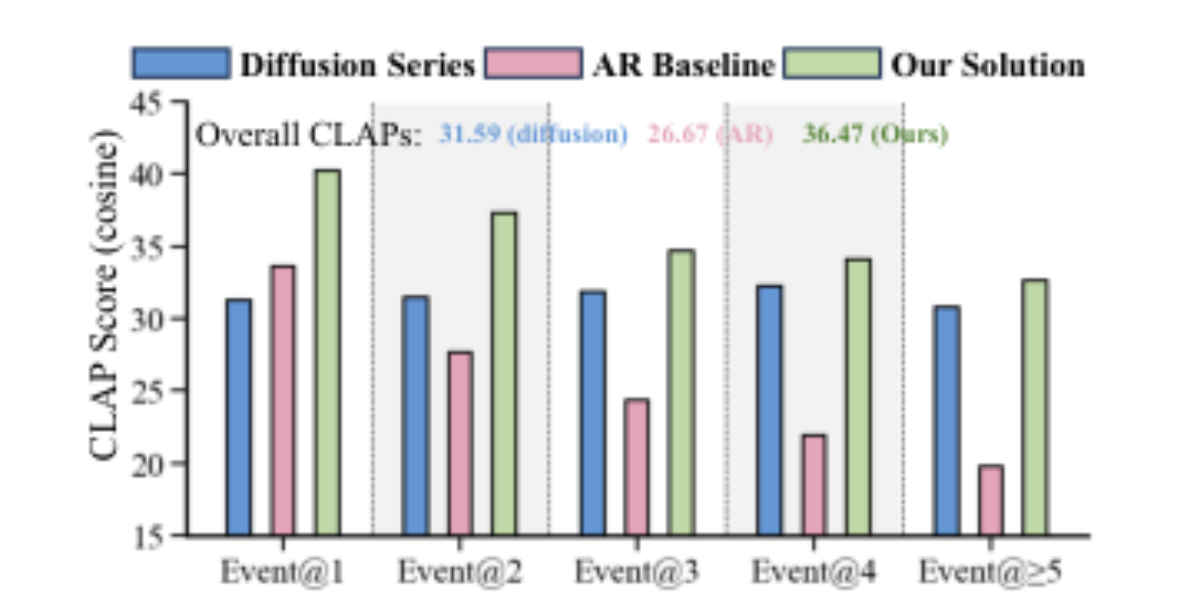
论文图 1。原论文 Figure 1:“Instruction-following performance (y-axis) of different methods, measured by CLAP scores.”。
这张图横轴是 Event@1 到 Event@>=5,纵轴是 CLAP 分数余弦值。每组三根柱从左到右对应扩散系列、自回归基线和本方法。可见粉色自回归柱从 Event@1 的较高位置向右快速变矮,到 Event@>=5 最低。蓝色扩散柱高度变化很小,绿色本方法在所有组都最高,顶部总体标注为扩散 31.59、自回归 26.67、本方法 36.47。教学含义是问题不在单事件生成,而在多事件全局对齐,这直接引出前缀是否提前编码全局属性的探测。
同输入同目标的已有路线如何分工?
同输入同目标的音频生成分两条路线。扩散路线在连续隐空间或梅尔频谱上用 U-Net 或扩散 Transformer 做双向交互,允许每步看到过去和未来,适合全局协调,近期还引入流匹配加速,如 MMAudio、TangoFlux、GenAU 等。另一条是自回归路线,用向量量化或残差向量量化把音频离散化,再用因果 Transformer 逐步生成。 如 AudioGen、MusicGen 的延迟模式,以及基线 Siren 用的并行 Transformer 加残差量化,都属于这一类。测试时计算是另一条相关线,包括多数投票和 Best-of-N,即生成多个完整候选再按奖励选最优,以及过程奖励模型对中间推理步打分。
论文的差别在于把测试时计算搬到音频 token 前缀上,用一个基于隐式计划的部分奖励模型做早期剪枝,而不是等完整音频生成完再选。已有工作的边界要讲清:双向模型类别差异不能直接当同条件胜负。论文在主表中同时列双向和单向两组,但公平的计算量对比只在 Siren 加 Best-of-16 与 Siren 加本方法之间成立,因为两者共享每层 4608 个 token 的预算。
前缀真能预测还没生成的全局属性吗?
论文先做相关性探测来回答这个问题。做法是固定文本提示,用预训练生成器合成完整 token 序列,取出前 32 步对应倒数第二层的隐藏状态作为前缀表征,再训练轻量多层感知机去预测完整序列的全局属性。属性必须满足全局、不能从局部前缀音频直接听出、且分布在全时段。 论文选了两个:事件数和主导发声对象类别。事件数用多模态大语言模型给生成音频写描述再切成原子事件计数;对象类别用大语言模型为 10 个预设对象各生成 2000 条不同描述,共享类别标签。
隐式计划 × 前缀表征: 隐式计划指早期 token 已经编码了整段音频的全局属性,如事件数和发声对象;前缀表征指前 32 步对应倒数第二层隐藏状态的向量集合。前者是待验证的假设,后者是可操作的观测窗口,搭配理由是用轻量 MLP 从后者预测完整序列属性来检验前者是否存在,组合意义是把不可见的计划变成可测量的相关性。
为理解探测强度,先看事件计数回归与对象分类的泛化结果。要求是只用前 32 步的生成 token 表征,在训练集之外仍能预测整段属性,若成立则说明因果前缀里确实有未来信号。
看图路径: 1. 先看上排左右两图横轴真值与纵轴预测值的拟合线与理想线贴合度;2. 再看标题给出的训练与测试的 K、S、P 三组相关系数;3. 转到下排 t-SNE 散点按颜色区分的 10 类对象是否成团
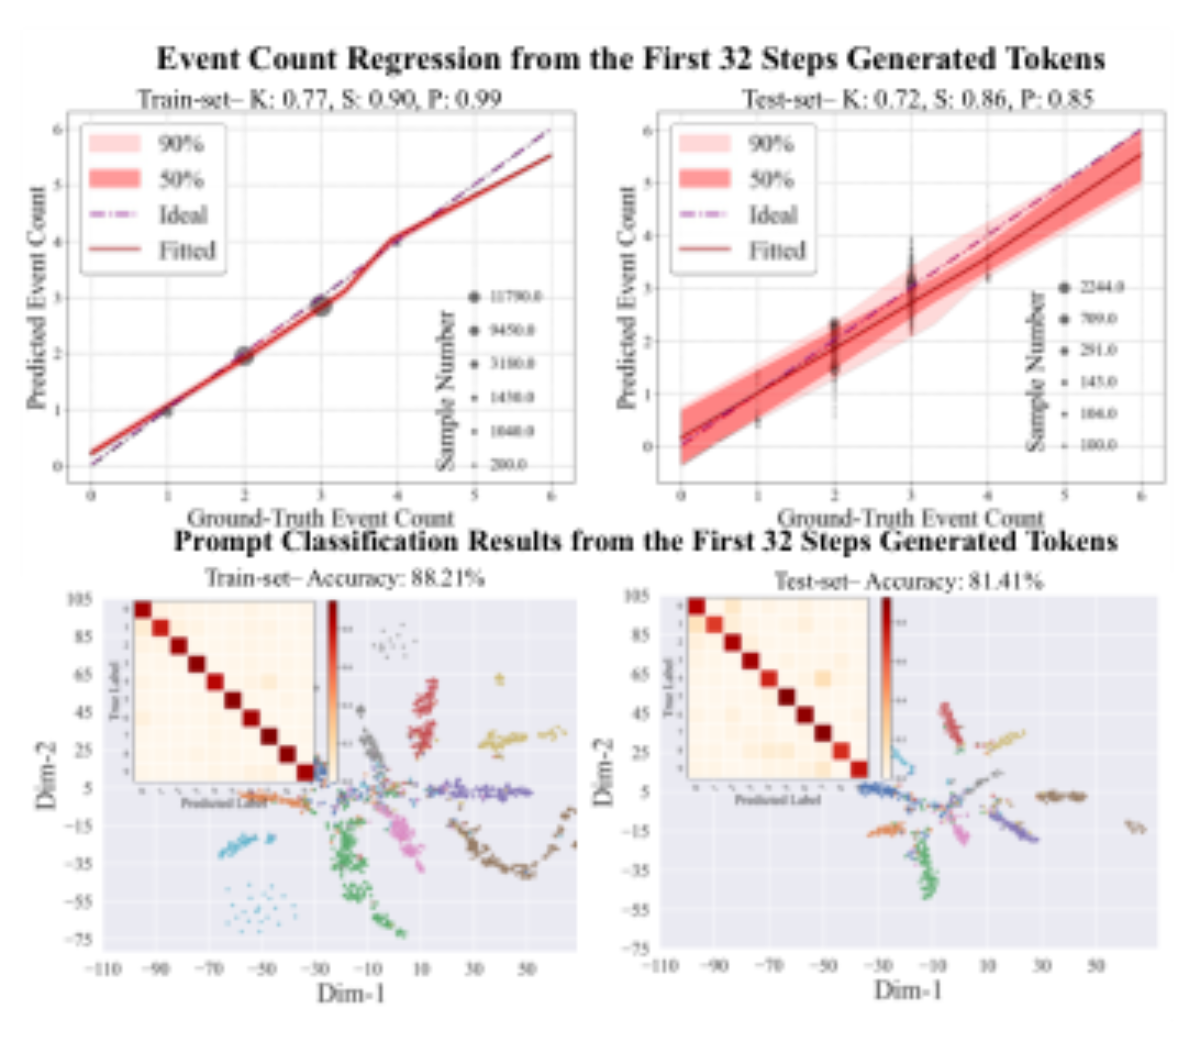
论文图 2。原论文 Figure 2:“Upper row: Event counting regression results, with Kendall (K), Spearman (S), and Pearson (P) correla- tion coefficients reported between predicted and ground- truth counts.”。
上排两图横轴是真值事件数,纵轴是预测事件数,红色拟合线紧贴紫色理想线,标题给出训练集 K 为 0.77、S 为 0.90、P 为 0.99,测试集 K 为 0.72、S 为 0.86、P 为 0.85,说明不是记忆。下排是前缀表征的 t-SNE 散点,按对象类别着色成团,左上角混淆矩阵对角线明显更深,训练准确率 88.21%,测试准确率 81.41%。这组结果报告的是相关性,不是因果证明,但它支持把前缀当作计划种子来打分的后续设计。
不重训大模型,整体链路如何走通?
整体链路分 3 段。第一段是收集打分器数据:用文本提示让冻结的自回归生成器随机采样多条完整 token 序列,再用冻结的 CLAP 模型算每条与提示的相似度作为真值。第二段是训练 Plan-Critic:把生成序列和文本提示送入可训练的打分器,输出沿时间的价值序列,用类 GAE 损失只在终点给真监督、中间靠时序一致往回传。 第 3 段是引导采样:推理时先大量采样短前缀,用打分器在早期打分,只留下高分前缀再补全为完整音频。
这条链路的关键约束是生成器参数冻结,打分器从生成器对应层初始化以对齐表征流形,CLAP 模型也冻结。计算预算固定,保证与 Best-of-N 可比。 下面这张流水线图把 3 段的输入输出和冻结与可训练区分画在一起,是理解数据、训练、推理如何衔接的关键。
看图路径: 1. 沿阶段 1 箭头看文本提示到自回归生成器再到 CLAP 打分的闭环;2. 看阶段 2 中 Plan-Critic 内部自注意力与交叉注意力的输入来源;3. 看阶段 3 中前缀批量到剪枝再到补全的分支如何收窄
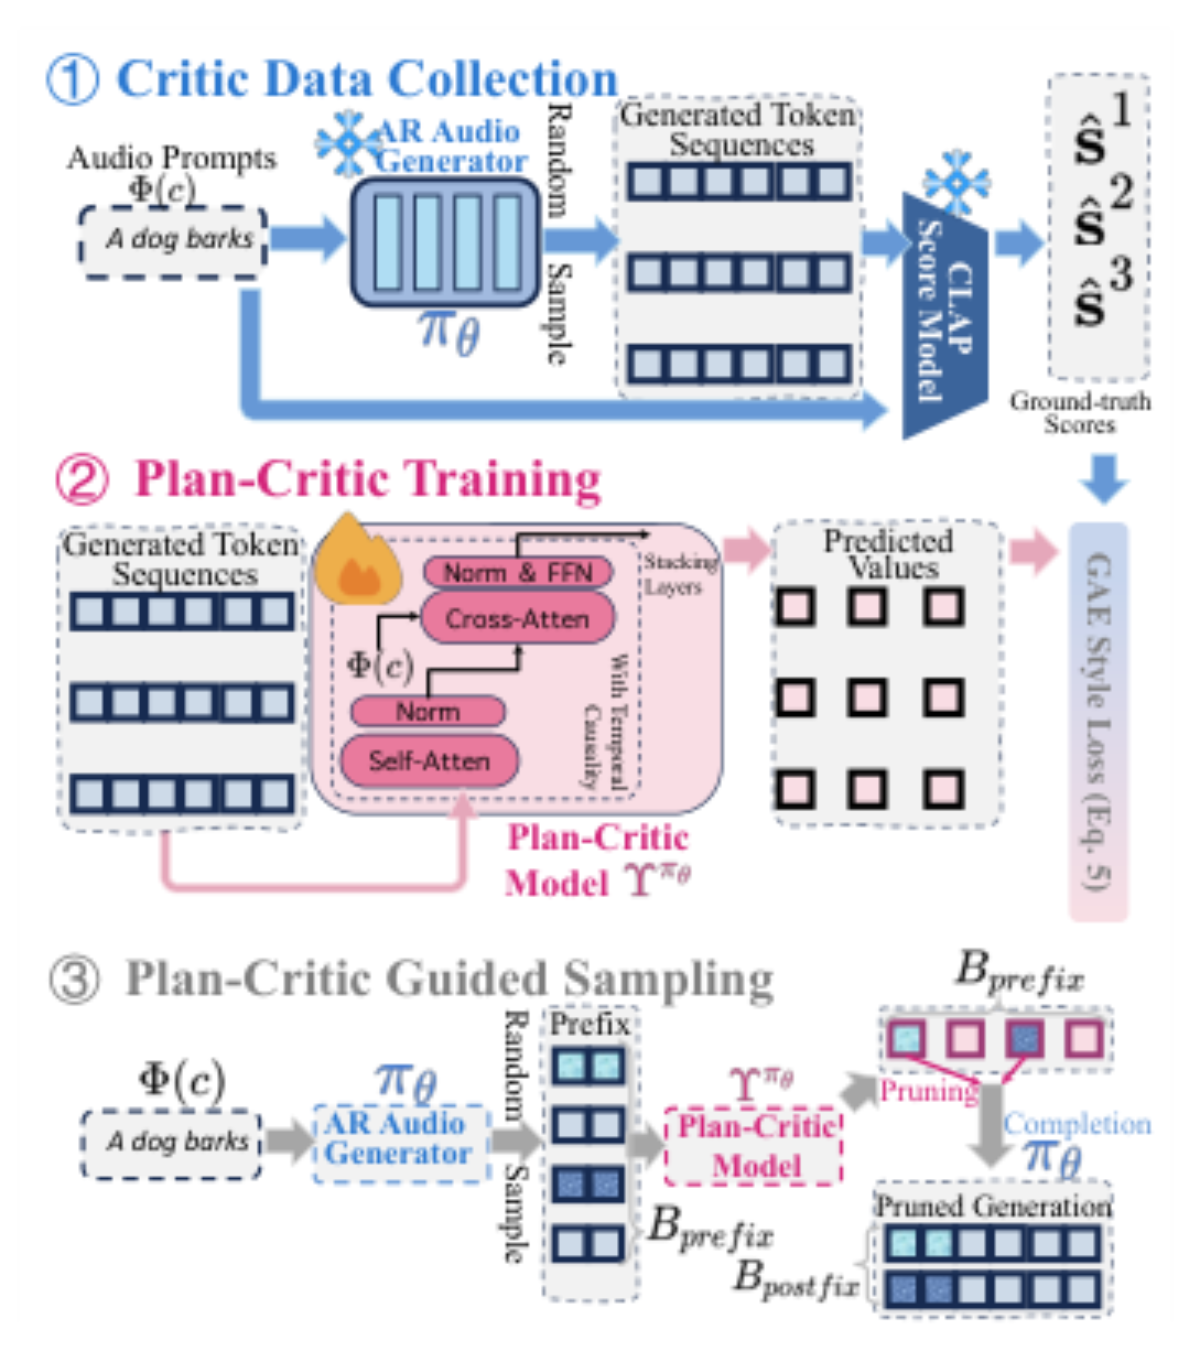
论文图 3。原论文 Figure 3:“Overall pipeline of the proposed plan-critic guided framework.”。
这张流水线图分三行。第一行从 A dog barks 的提示框出发,经自回归生成器随机采样得到多行 token 方块,再与提示一起进入 CLAP 打分得到真值分数。第二行把 token 序列送入 Plan-Critic,其内部画出自注意力、交叉注意力与范数前馈的堆叠,输出预测价值方块,再与真值一起算 GAE 风格损失。第三行推理时先采样多个前缀,经 Plan-Critic 剪枝只留少数再由生成器补全。看图时抓住冻结与可训练的区分:雪花标记为冻结,火焰标记为可训练,剪枝箭头是唯一的计算重分配点。
打分器看到什么,输出什么?
打分器输入是前缀 token 序列与文本提示。先用嵌入层把多个量化层的编码求和压缩成单条时间序列,再与文本嵌入一起送入交错的因果自注意力和交叉注意力。自注意力负责捕捉前缀内部时序动态,交叉注意力负责对齐音频与文本。输出是每步隐藏状态经回归头映射成的标量。
Plan-Critic × CLAP 分数: Plan-Critic 负责从部分序列加文本提示输出标量价值,估计补全后整段音频的指令跟随质量;CLAP 分数负责在完整音频和文本之间算余弦相似度,作为训练时的真实监督。前者分工是早期可执行的预测器,后者分工是事后可计算的代理真值,搭配理由是不重训大生成器、只学一个映射把隐式计划转成可剪枝分数。
符号与计算目标要先说清:记前缀嵌入压缩后为时间序列,记文本编码为条件,记打分器隐藏为上下文表征,记 t 步价值为标量。目标是从 t 步及以前的信息预测补全后整段的 CLAP,t 越小越考验计划能力。原文明确的实现是只在每 32 步输出 1 次分数做稀疏监督,避免长序列梯度难以回传到前缀。
\[st = Υs(hΥ ≤t).\]上式表示 t 步价值由 t 步及以前的上下文表征经回归头得到,不是直接重建音频。它把打分问题变成回归问题,后续 GAE 目标会规定这些价值如何向终值靠拢。初始化来自生成器对应层的选择,目的是让打分器工作在与探测发现相同的表征空间里,未报告具体冻结哪些层时不猜,只按原文说对应层初始化。
只有终点有真值,中间步如何学?
训练数据由 5000 条大语言模型合成的伪音频描述加从 AudioCaps 和 VGGSound 官方测试集中整理的未见提示组成,每个提示用基线 Siren 随机采样 32 条音频,每条配一个 CLAP 真值,形成提示、音频、分数三元组。为缓解合成提示的域偏移,论文混入真实测试集提示但保留 1000 条每库作为保留评估集。
广义优势估计 × 信用分配: 信用分配指判断部分序列中每一步对最终 CLAP 各贡献多少;广义优势估计负责只在最后一步给真值、中间步靠时序一致性把监督向后传播并用折扣和平滑加权。前者是训练难点,后者是解法,搭配理由是避免把终值均匀赋给所有步,组合意义是让前缀打分更可靠。
监督构造是稀疏奖励:长度为 T 的序列只在最后一步放真值 CLAP,之前为 0。打分器输出价值序列,用分离梯度的旧值算时序差,再按折扣与平滑系数向回传播得到每步目标,最小化预测与目标的均方误差。训练时还在 CLAP 真值上加随机高斯噪声防过拟合。 优化器用 AdamW、学习率 1e-4、训练 40k 步。推理细节固定为前缀长度 32、每层全长 288、共 12 层残差量化。原文未给出折扣与平滑系数的具体数值,也不报告打分器层数与回归头宽度,因此复现时只能先按稀疏每 32 步监督与上述优化器设置起步,缺项明确待补,不能从模型名推定。
测什么,和谁比,预算如何对齐?
测量分指令跟随与音频质量两类。指令跟随用总体 CLAP 与按事件数分组的 CLAP@1 到 CLAP@>=5,越高越好;音频质量用 FAD、FD、KL 越低越好,IS 越高越好。FAD 用 VGGish 嵌入,FD、IS、KL 用 PANNs 嵌入,KL 在配对样本级算分布差异再平均。分组依据是大语言模型按提示中事件数分类。
对比对象包括双向的 AudioLDM2、MagNet、AudioX、MMAudio、TangoFlux、GenAU,以及单向的 DelayPattern 加 Best-of-16 和 Siren 加 Best-of-16。公平条件是 Siren 加本方法与 Siren 加 Best-of-16 共享每层 4608 个 token。 本方法用 128 乘 32 加 2 乘 288 减 32 得到 4608,基线用 16 乘 288 得到 4608,12 层因子在讨论中省略。硬件为单节点 AMD MI300X。人类评估另做成对比较,由 30 位领域专家每类约 100 条提示判断哪段更贴合指令、哪段更自然,共 18000 余次比较,用于佐证自动指标。
相同预算下指令跟随提升多少,质量保住吗?
比较问题是在相同 token 预算下,前缀优先加剪枝是否比完整序列重排更能提升语义对齐,且不牺牲音频质量。公平条件是每层 4608 预算,指标方向是 CLAP 与 IS 越高越好,FAD、FD、KL 越低越好。下表比较同一打分器下不同解码策略,都使用已训练的 Plan-Critic。
| BoN | 26.67 | 1.95 | 17.63 | 10.41 | 1.91 |
|---|---|---|---|---|---|
| Importance Sampling | 29.72 | 2.52 | 27.58 | 9.91 | 2.90 |
| TreeBoN | 34.04 | 1.97 | 18.26 | 10.10 | 1.38 |
| Ours | 36.47 | 1.96 | 15.70 | 13.82 | 1.27 |
上表是在同一打分器下比较不同解码策略的结果。Best-of-N 只得 CLAP 26.67,重要性采样 29.72,TreeBoN 到 34.04,本方法到 36.47 且 FD 降到 15.70、IS 升到 13.82、KL 降到 1.27,FAD 保持 1.96 与基线相当。主要收益是语义对齐大幅提升且分布距离与多样性同步改善,代价是需要训练打分器并多采前缀。未胜出项是重要性采样在 FAD 与 FD 上反而变差,说明只靠似然加权不如早期语义剪枝。
前缀优先搜索 × Best-of-N: Best-of-N 负责生成多条完整序列再事后重排,计算花在完整 rollout 上;前缀优先搜索负责先大量采样前缀、用 Plan-Critic 在早期打分剪枝、只补全高分种子。前者是公平基线,后者是省算力的重分配,搭配理由是前缀决定语义、后缀方差小,组合意义是在相同 token 预算下扩大对高质量全局结构的搜索。
主表在 AudioCaps 与 VGGSound 上一致:AudioCaps 上本方法总体 CLAP 36.47 超过基线 26.67 约 10 点,VGGSound 上 35.88 超过 25.62。分组上复杂事件提升更大,但 FAD 在 VGGSound 上为 3.70 仍高于部分扩散方法,说明质量指标并非全胜。自动指标不能当人评,论文另用胜率表补充,但此处不把 CLAP 差值直接读作听感差值。
去掉 GAE 或换打分时机,效果还剩多少?
先问监督信号是否关键。比较问题是朴素稀疏监督与随机猜测能否替代 GAE 风格训练。公平条件是同采样策略只换打分器。论文报告朴素把终值均匀赋给所有步、随机猜测保留采样剪枝流程但打分随机,两者 CLAP 分别掉到 10.67 与 12.86 量级,远低于本方法的 36.47,支持信用分配设计的必要性。 间隔消融显示每 16 步监督 CLAP 为 31.27,每 32 步为 36.47,每 64 步为 37.34 但 token 涨到 8640,说明更大间隔可涨分但超出预算。
打分时机消融把评价点放在前缀 32、64、96 与后缀前 64、32,结果只有前缀 32 保持较高,其余掉到 18 左右,支持计划信息集中在最早窗口。注意该消融为装入单卡统一用小批量,与主结果的大批量不可直接比数值。 下表整理事件计数回归的泛化相关系数,只用前 32 步生成 token 表征预测整段属性。
| 划分 | Kendall K | Spearman S | Pearson P | 样本来源 |
|---|---|---|---|---|
| 训练集 | 0.77 | 0.90 | 0.99 | 前 32 步生成 token |
| 测试集 | 0.72 | 0.86 | 0.85 | 前 32 步生成 token |
上表数字显示即使只看前 32 步,预测与真值的秩相关与线性相关都显著,支持前缀编码全局属性。
代价是该探测用生成 token 表征而非解码后音频,换成音频特征或真实音频前 32 步则相关消失,见原文反证。为检验后缀是否多余,论文固定 10000 个前缀、每个补全 1000 条后缀,统计 CLAP 均值与标准差。 下面这组箱线图对比换前缀与换后缀带来的波动,是理解算力应投向何处的直接证据。
看图路径: 1. 先看左图每个事件条件下 CLAP 均值的箱体跨度是否很大;2. 再看右图同一前缀下后缀标准差的箱体是否集中在低位;3. 对比左右纵轴量级差异以理解前缀决定与后缀扰动的关系
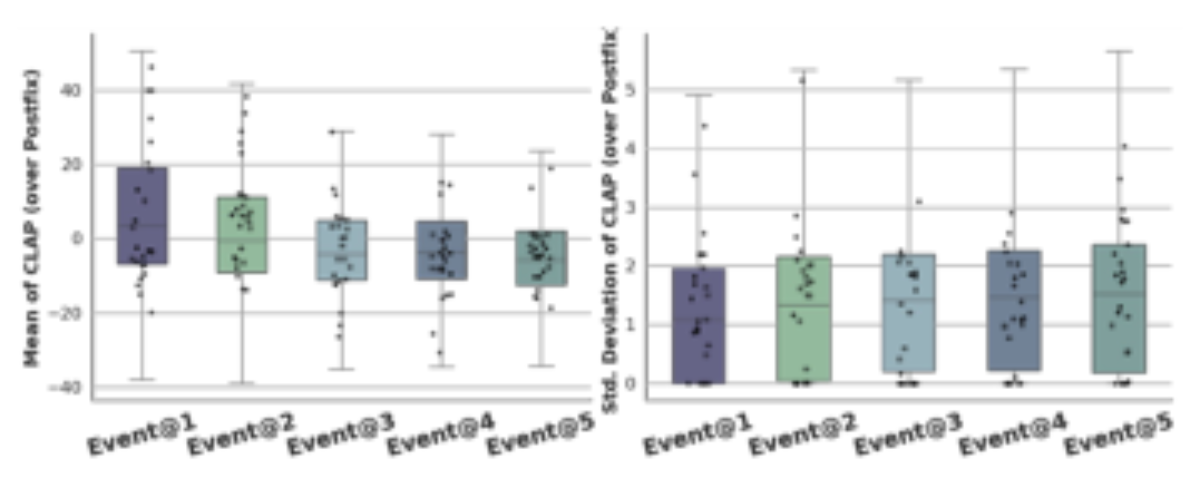
论文图 4。原论文 Figure 4:“Given a set of prefix tokens, each is expanded into 1,000 postfix sequences.”。
左图是均值分布,箱体跨度大,从负到正几十范围,说明换前缀结果差异显著;右图是标准差分布,箱体紧贴低位约 2 到 3,说明同一前缀下换后缀波动小。教学结论是把算力投给前缀探索更划算,但这不等于后缀无用,只是对 CLAP 指令跟随的边际影响小。
哪些结论不能从现有证据推出?
论文明确报告三项局限。第一是依赖 CLAP 作代理,它可能抓不住时序合理性、情感与事件顺序等细粒度听感,未来需做人类偏好对齐的奖励模型。第二是固定前缀长度 32 与全长 288 的假设,对更长多分钟声音场景是否仍是单阶段计划未验证,可能需按比例或分层规划。 第三是训练数据偏置,打分器只在 Siren 生成分布与合成加整理提示上训练,可能过拟合该生成器的失败模式,向其他自回归器或音乐与环境声的迁移待验证。
未测量项不能承诺改善:误判率、延迟、输出帧率与实际推理耗时未系统报告。 总 token 对齐不等于实际时钟对齐,因为打分器前向与大批量前缀采样有额外开销。总体趋势不等于每组每步成立,FAD 等质量指标在个别库上并非最优。相关性不是因果,前缀能预测不等于前缀决定,固定前缀实验支持但未做干预式因果检验。
要复现,先对齐哪些数据与预算?
先做数据与预算对齐。数据上用 5000 条合成描述加 AudioCaps 与 VGGSound 官方测试集整理的未见提示,每个提示采样 32 条并算 CLAP,留各 1000 条作保留评估。训练用 AdamW、1e-4、40k 步,真值加高斯噪声,稀疏每 32 步监督。推理用前缀批量 128、保留 2、前缀 32、全长 288。 下表把总体与预算的关键数放在一起,用于核对复现起点是否一致。
| 方法 | 总体 CLAP | 前缀批量 | 保留数 | 前缀长度 |
|---|---|---|---|---|
| 扩散系列 | 31.59 | — | — | — |
| 自回归基线 | 26.67 | — | — | — |
| 本方法 | 36.47 | 128 | 2 | 32 tokens |
上表把总体与预算的关键数放在一起:扩散总体 31.59、自回归基线 26.67、本方法 36.47,前缀批量 128、保留 2、前缀长 32。表后解释是复现时先重算预算再比 CLAP,若批量改小则参考打分时机消融的小批量数值,不能与主结果混比。 再核对预算算式与分类准确率,确认公平前提与另一路隐式计划证据。
| 核对项 | 数值 1 | 数值 2 | 单位与说明 |
|---|---|---|---|
| token 预算算式 | 128×32 + 2×(288−32) = 4,608 | 16×288 = 4,608 | tokens per RVQ layer |
| 对象分类准确率 | 88.21% | 81.41% | 训练集与测试集 |
上表核对预算算式与分类准确率:128 乘 32 加 2 乘 288 减 32 等于每层 4608,与 16 乘 288 的 4608 对齐;对象分类训练准确率 88.21%、测试 81.41%。表后解释是预算对齐是公平前提,分类数是隐式计划的另一证据;代价是 12 层因子在正文中省略,复现时按每层计数再乘层数估算总量。代码当前可用,地址为开源仓库,状态为 available,但权重与完整数据引擎需按附录补齐。
何时值得尝试,还需补哪项验证?
当自回归音频在单事件尚可、多事件漏事件,且不能重训大模型时,值得尝试前缀多采加轻量打分器剪枝。适用条件是全长较短且计划集中在早期,若音频变长或需分层叙事,应先验证不同前缀长度与多次打分的效果。先做探测复现:只用前 32 步表征预测事件数与对象类别。 确认测试集相关与准确率复现后再训打分器,避免把相关性误当因果直接部署。
还需补的验证是人类听感与时序正确性的专项评估,以及在其他自回归生成器上的迁移,还有实际延迟与显存的测量。 不要把 CLAP 提升 10 点直接读作 10% 相对提升,百分点与相对百分比不同;也不要把自动指标胜率当作每条提示必胜。论文的贡献是证明严格因果模型也能通过引导解码实现全局对齐,路径是发现计划、量化计划、利用计划,复现时按此顺序检查每步的证据是否成立。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses