英文题目:WaveNet-Style Guitar Amplifier Model Pruning for Real-Time iOS Deployment
会议身份:
conference:dafx:2026:conference-paper-id:DAFx26_demo_67
✅ 来源为官方会议 PDF;表格与 Figure 按原文证据绑定。PDF 公式以原页区域图片展示,未冒称作者原始 TeX。
标签:#模型剪枝 #端侧运行 #实时处理 #音频生成
评分:7.0/10 | 创新 1.2/2 | 技术严谨 1.0/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:系统技术报告
👥 作者与机构
- Ryota Sato:机构信息未能从会议 PDF 纯文本可靠映射
- Eli Silverstein:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
本文面向吉他放大器虚拟模拟中从原始吉他干声波形\(x[n]\)到失真染色波形\(\hat{y}[n]\)的波形到波形映射,实际难点在于捕获长时依赖所需的扩张卷积感受野在手机端算力下难以实时运行。方法链第一步训练因果扩张卷积残差网络学习输入到失真输出映射并以预加重均方误差优化,第二步在训练中按指数调度渐进更新二值掩码实现迭代局部幅度剪枝以适应稀疏。第三步将保留非零权重导出为紧凑缓存友好布局的手写稀疏CPU推理引擎并封装为交互应用完成整机验证,上一步的稀疏掩码直接决定下一步只遍历非零权重的计算路径。与依赖稠密推理库的已有方案相比,关键机制差异在于训练期适应稀疏掩码与推理期只遍历非零权重,从而把非结构化稀疏直接转化为计算量下降。在iPhone 16 Pro上256样本块大小的实时评测下,90%剪枝模型的RTF指标为约0.6,低于稠密模型的RTF指标高于1的不可实时水平。该结果的适用边界受限于所采四类设备与有限失真范围,长混响尾音超出感受野时误差增大且与输入无关的噪声无法重建。稀疏引擎的推理开销在默认块大小下仅约5.3毫秒延迟且混响约占3%计算量,尚未验证更大失真与跨代硬件的外推性能。
🔗 开源与复现资源
- 代码相关资源:https://github.com/ryos17/wavenet-imp — 链接可访问(HTTP 200) 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,目标是什么,为什么手机端难做?
本文的输入是电吉他直接录入的原始干声波形,用离散时间记为干声序列,目标是复刻电子管音箱与失真单块的输出波形,也就是对目标录音的估计。这属于黑盒虚拟模拟,不建模电路元件,而是从实测输入输出对中学习非线性映射。
学习对象包括 4 种失真来源,都是作者自有录音采集的设备,分别是清音与过载常用的两款复古音箱、一款复古风格音箱与一块高增益单块。必须保留的信息是输入输出采样一一对应的时间关系,以及失真带来的谐波与压缩特征,输出则是逐采样生成的连续音频流。
难点在于 WaveNet 风格网络虽然保真度高,但空洞卷积栈逐采样计算量大,传统上只能跑在台式机或专用数字信号处理器上。手机端要求在 48 kHz 采样率下以几毫秒为一块持续输出,任何超出块时长的计算都会导致断音。
论文要回答的是如何在不明显损失听感的前提下,把计算量压到纯中央处理器 iPhone 也能实时跟上。本文依据的源代码当前可用,已公开在官方仓库,可用于核对导出权重与引擎实现。
已有路线解决了什么,还缺哪一块?
虚拟模拟长期分为白盒与黑盒两条路线。白盒显式仿真电路,例如波数字仿真真空管放大器,需要精细的元件知识,优点是物理可解释,缺点是每换一台设备都要重新建模。
黑盒直接学习输入输出关系,早期用长短期记忆网络这类循环网络,后来转向 WaveNet 风格的空洞 1 维卷积。Wright 等人的工作是本研究的直接基线,本文沿用其通道与空洞配置以便比较稀疏度。
效率方向上,已有工作把迭代幅度剪枝用于长短期记忆吉他失真模型,证明可以去掉大量权重而保持精度。背后有彩票假设与卷积音频模型上的相关佐证,说明稀疏子网络本身具备表达能力。
但系统性剪枝 WaveNet 风格神经音箱仍少有人做,更少有人为手机做稀疏感知推理。通用实时推理库按稠密核运算,即使权重为零也会计算,因此不能把稀疏变成加速。本文的增量正在于把重度迭代剪枝与手写稀疏空洞卷积栈配对,并在 iPhone 上验证。
要复述的问题定义与成功标准是什么?
形式化地说,给定成对的干声与目标失真录音,学习因果前馈映射,使映射输出逼近目标录音。训练时最小化预加重后的均方误差,评估时用误差信号比衡量相对误差,方向是越小越好。
成功标准有 3 层。第一层是建模质量,在 90% 稀疏度下误差信号比足够低,非正式听感无可感知退化,且与目标波形在时域或时频上对齐。第二层是实时性,定义实时因子为处理时间除以产出音频时长,小于 1 才算跟上播放。
第 3 层是一致性,手机端程序用相同导出权重跑文件输入时,与 Python 参考的差异应只在 16 位整型与浮点转换的量化误差内。举例说明,如果你弹一个和弦,系统应在约 5 毫秒级延迟内输出带失真色彩的对应和弦,而不是先缓存几秒再算。
失败条件也明确,长混响尾音超出感受野会误差增大,高增益下与输入无关的底噪嗡声因确定性模型无法复现。这些边界决定了该方法适合干声失真主体,而不适合依赖长尾与噪声质感的场景。
方法全景:一个采样如何走完全链路?
沿一个输入采样走一遍有助于建立整体图像。吉他信号以 48 kHz 进入,先经过可选的输入衰减,直接送入 WaveNet 风格网络,另有一路卷积混响做空间感补充。网络由多层空洞卷积残差块串联组成,每块对因果历史做可学习的滤波再过非线性,得到中间表示。
各块中间表示经跳接汇总,由线性混合器合成为当前输出采样。训练阶段用二值掩码实现稀疏,推理阶段只存算非零权重。音频按固定块处理,默认 256 采样,块内逐采样推进但块间复用缓存。
非结构化稀疏 × 稀疏感知推理引擎: 非结构化稀疏负责允许任意位置的单个权重被置零而不要求整通道对齐,从而保留最高的剪枝比例,稀疏感知推理引擎负责只存储和遍历非零权重并用紧凑缓存友好布局组织空洞卷积栈。搭配的原因是通用稠密库即使权重为零仍会做乘加,无法把稀疏变成省时,组合后稀疏度下降直接转化为计算量下降,这是手机端实时的关键。
下面先看论文引用的基线架构图,理解主路径从左到右的因果推进与跳接汇总方式,再进入组件细节。
看图路径: 1. 先沿左侧输入信号向右追踪经过多个卷积块的黑色粗箭头主路径;2. 再看每个卷积块向下引出的中间表示如何汇入底部线性混合器;3. 最后确认顶部灰色虚线条件输入在本研究是否实际使用
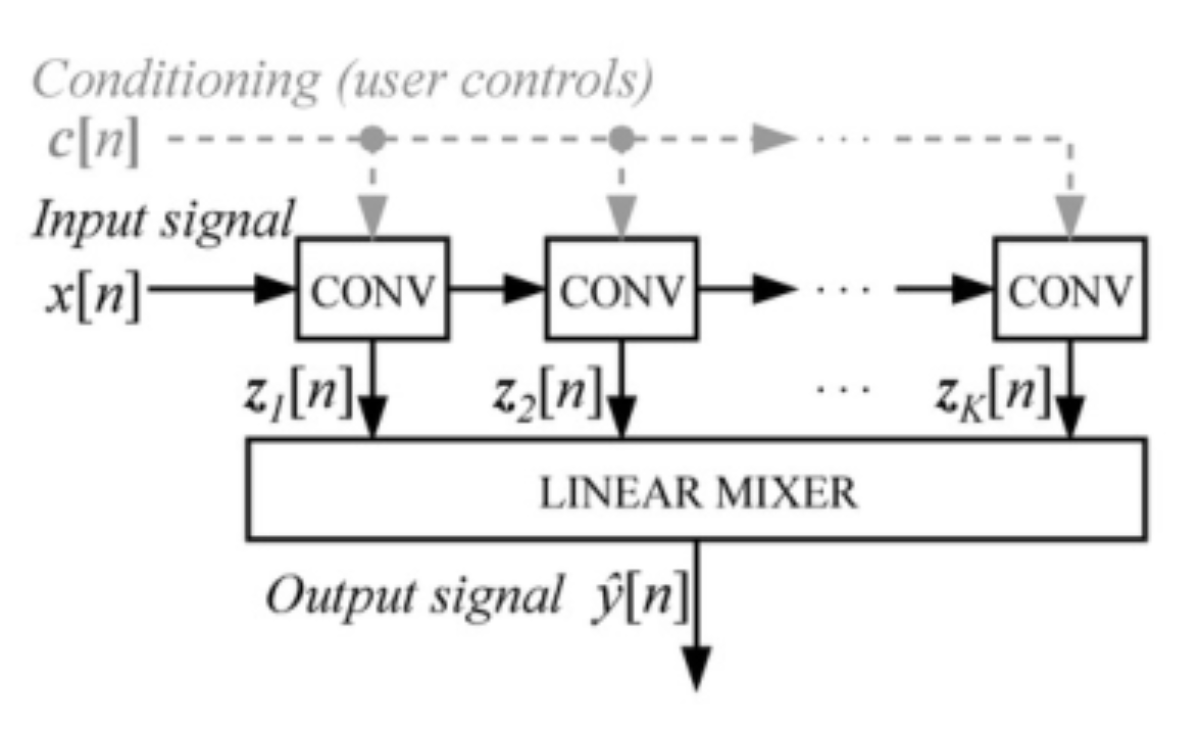
论文图 1。原论文 Figure 1:“WaveNet-style architecture used for neural guitar ampli- fier modeling, reproduced from [5].”。
该图显示输入信号从左侧进入一串卷积块,每个块向下引出一个中间向量汇入底部线性混合器,最终向下输出估计信号。顶部灰色虚线为用户控制条件,在本研究实际配置中并非重点,重点是黑色主路径的因果推进与跳接汇总。标准双曲正切替代门控结构也是为了减少后续部署的计算开销,这为理解剪枝为何选在该基线上提供了上下文。
网络组件各自算什么,为什么这样配?
网络是因果前馈结构,没有循环状态,依赖空洞扩大感受野。空洞为 1 时只看相邻采样,空洞为 256 时跨越更长历史,多层叠加后可覆盖失真与箱体所需的长依赖,而每层参数量不随空洞增大。
每块先做因果滤波,也就是只用当前与过去采样加权求和,再过标准双曲正切产生非线性,这是电子管饱和类失真的主要来源。跳接把各层表示聚合成最终输出,避免深层信息在逐层传递中丢失。
空洞因果卷积 × 残差块堆叠: 空洞因果卷积负责只用当前与过去采样做加权求和并通过空洞间隔扩大时间感受野,残差块堆叠负责让每块变换后的表示既向下一块传递又通过跳接汇总到最终输出。二者搭配的原因是吉他失真需要同时保留短时触弦细节与长时共鸣依赖,组合后网络能用小核与 16 通道学到从干琴波形到失真波形的直接映射。
该配置完全沿用已发表神经音箱设置的通道维度与空洞模式,目的是让报告的稀疏度能相对已知参考来解释。通道维度较小是容量与算力的折中,总参数两万余个,其中可剪枝占绝大部分,偏置等不可剪枝参数被排除在稀疏度定义之外。若改变通道数或层数,稀疏度的难度与实时因子的基线都会变化,因此复现时应先固定该配置再调剪枝。
训练与剪枝如何操作,哪些参数冻结?
训练目标是最小化预加重均方误差。预加重用 1 阶高通滤波器,白话说就是先提升高频再算误差,让拨片触弦与失真谐波等高频细节在梯度中占更大比重。论文报告先期实验发现均方误差比误差信号比收敛更快更稳定,因此训练用前者,评估仍用后者以便在不同响度设备间公平比较。
剪枝不是训完 1 次剪掉,而是每小批量按稀疏度计划更新掩码,稀疏度从 0 斜坡升到目标值,起始轮与结束轮控制斜坡。比较了局部与全局幅度剪枝乘以线性与指数计划共 4 种组合,固定起始轮并在验证集上扫描结束轮,发现其中一个中间值时验证误差信号比最低。
迭代幅度剪枝 × 二值掩码: 迭代幅度剪枝负责在训练过程中按稀疏度计划逐步去掉幅值最小的权重,让剩余权重边稀疏边适应,二值掩码负责记录每个可剪枝权重保留或置零并在前向与反向都执行逐元素相乘。搭配的原因是 1 次剪掉九成连接会破坏已学映射,而随小批量不断更新掩码能让网络接管被剪功能,组合后才能在 90% 稀疏度下仍跟踪目标波形。
预加重均方误差 × 误差信号比: 预加重均方误差负责训练时的优化目标,先经 1 阶高通滤波提升高频再算平方误差,误差信号比负责评估时用信号能量归一化误差以便比较不同响度设备。搭配的原因是训练需要更快更稳定的收敛而评估需要公平比较,组合后即训练用预加重均方误差而报告用误差信号比,二者分工不混用。
总体以迭代局部剪枝加指数计划最优并用于后续实验。单次剪枝在 90% 处会跟不上目标波形,而迭代剪枝能跟踪目标仅有微小偏离。需要指出论文未报告优化器类型、学习率与批量大小等细节,这些是复现时的缺项,只能按基线文献与官方代码补齐,不应从模型名称推定实现。
数据、指标与手机测量条件如何设定?
数据来自自有录音,用测量话筒以结构化 3 分钟激励信号采集 4 种设备,覆盖清音到最大失真。直接录制的单块尽管非线性强仍取得较低误差,而长混响设置因尾音超出感受野误差最大,这提示感受野是长混响的瓶颈。
指标分两类,离线质量用误差信号比,方向越小越好,在线性能用实时因子、中央处理器占用、推理吞吐与内存,实时因子小于 1 为达标。手机测量固定 48 kHz,块长多档可配,默认 256 采样,每种块长测较长时间音频,稀疏度扫描时每点测较短音频并报告均值与最小最大值须线。
实时因子 × 音频块长: 实时因子负责衡量处理一段音频所需时间与该音频时长的比值,小于 1 表示跟得上播放,音频块长负责决定每次送入引擎的采样点数并影响单次调度开销与延迟。搭配的原因是块越小延迟越低但调度越频繁,块越大吞吐越高但延迟越大,组合后需要在 256 采样约 5.3 毫秒这样的默认工作点上同时看实时因子与中央处理器占用,才能判定是否真正可用。
下表把网络规模与训练配置放在一起,便于复现时先对齐容量再调稀疏,表中数字与单位保留原文写法,裸值不擅自添加单位。
| 配置维度 | 通道与核长 | 训练轮数与层数 | 总参数与可剪枝参数 | 90% 稀疏去除量 |
|---|---|---|---|---|
| 基线网络 | C = 16, kernel 3 | 1500 epochs, 18-layer | 21,913 total, 21,152 prunable | 19,074 weights removed |
| 空洞模式 | 1 to 256 repeated | two cycles | dilation pattern 1 to 256 | 90% sparsity |
该表说明模型并不大,两万余参数中绝大部分可剪,90% 稀疏后仅剩约两千非零权重,这是手机端可行的容量基础。通道与核长决定了每层计算模板,层数与双周期空洞决定了感受野长度,复现时任一改动都会同时影响质量与实时因子,因此需要成组记录并固定随机与电平条件。
主结果:90% 稀疏是否保质又实时?
离线质量上,90% 稀疏目标下 4 种采集的误差信号比均低于很小的阈值,非正式听感无可感知退化。跨采集比较支持两点判断,直接录制的单块尽管非线性强仍误差较低,而长混响设置误差最大,原因是尾音超出模型感受野。这说明稀疏本身不是质量瓶颈,瓶颈在感受野与确定性建模假设。
在主流新款手机与默认块长下,实时因子随稀疏度近似线性下降,稠密模型远高于阈值不可行,约七成稀疏进入实时区,九成处留有舒适余量。这正是演示的核心论据,剪枝把否则不可行的模型变为可行。应用层面还带卷积混响,仅占每块处理时间的很小比例,另提供音箱选择与输入衰减以匹配响度。
下面先看稀疏度扫描曲线,确认穿越点与余量,再看块长扫描的设备差异。
看图路径: 1. 先确认横轴为模型稀疏度百分比而纵轴为实时因子并找到 1.0 边界线;2. 再沿蓝色均值曲线从 0% 看到 100% 并观察 70% 附近穿越边界的位置;3. 最后查看 90% 与稠密点的须线范围以判断余量与波动
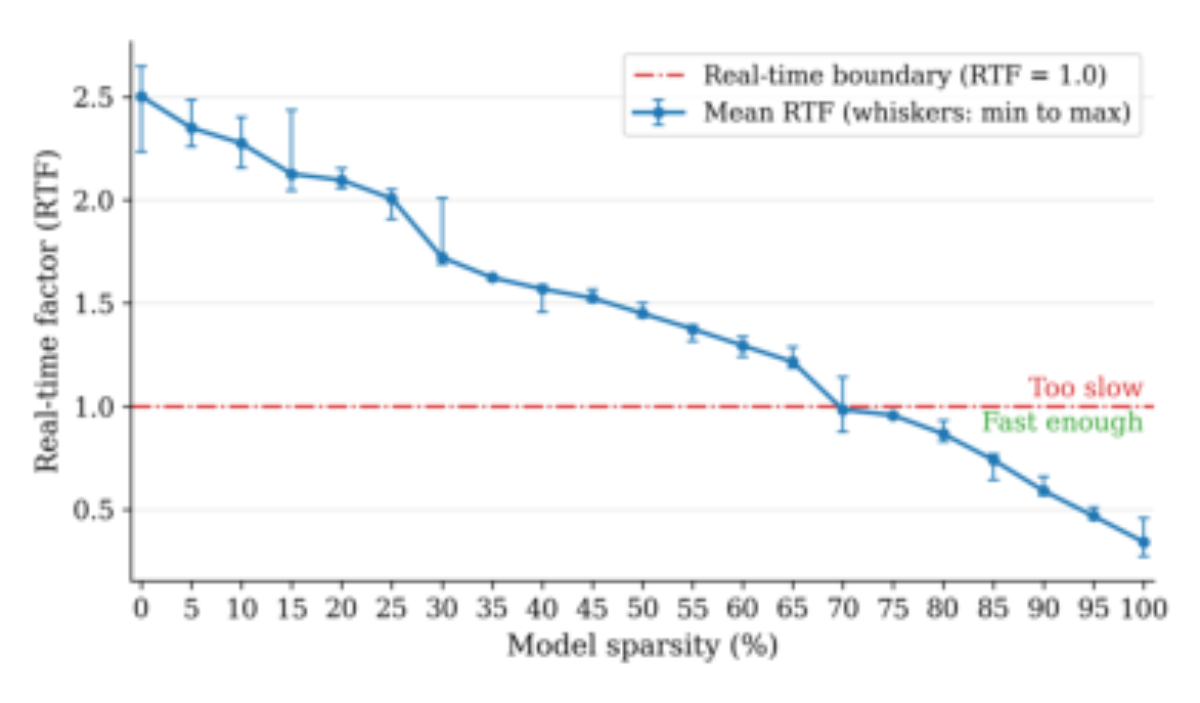
论文图 5。原论文 Figure 5:“Real-time factor versus sparsity on an iPhone 16 Pro (block size 256 samples, 48 kHz).”。
该曲线横轴为稀疏度百分比,纵轴为实时因子,红色虚线为 1.0 边界,上方标注太慢而下方标注足够快。蓝色均值线从稠密端约 2.5 一路下降,在 70% 附近压到边界,90% 明显低于边界,完全稀疏端最低。须线表示短时音频内的最小最大波动,整体趋势支持稀疏越高越快的判断,但个别点波动较大,说明总体趋势不等于每段音频都同样快。
下表汇总剪枝选择与质量阈值,比较问题是迭代与单次在同等高稀疏下谁能跟踪目标,公平条件是同网络同数据,指标方向为误差信号比越小越好。
| 评估对象 | 质量指标 | 稠密与边界状态 | 90% 稀疏结果 | 剪枝计划选择 |
|---|---|---|---|---|
| 4 种失真采集 | ESR below 3.4 x 10⁻⁴ | dense intractable | RTF approx 0.6 at 90% | eend 750 best |
| 实时边界 | RTF 1.0 threshold | 70% boundary | comfortable margin | estart 10 fixed |
表后解释是迭代局部加指数计划在验证中胜出并用于后续,而单次剪枝在同稀疏下波形跟踪失败,这是关键反证。代价是需要设置起始结束轮与计划形态,且结束轮需在验证集上扫描,未胜出项包括全局剪枝与线性计划,论文未给出它们的完整数值,因此不能量化差距,只能记录方向性结论。
消融与对照:计划、块长与设备如何影响结论?
剪枝对照显示 4 种组合中迭代局部加指数最优,结束轮扫描多个候选中中间值最优,单次剪枝远在目标稀疏前崩溃。波形对比显示迭代剪枝紧跟目标,单次剪枝偏离明显,这排除了用更简单的单次方案替代的可能。
块长与设备对照显示 256 采样是在新款手机上维持实时的最小块,更小块因调度开销导致实时因子与占用飙升,更大块吞吐上升但延迟增加。旧款手机在同样稀疏下需要更大块或更高稀疏,说明结论与芯片代际相关。混响占比很小也是一项对照,说明瓶颈确在神经网络而非效果器链。
看图路径: 1. 先对比第一列实时因子面板中两款手机随块长 64 到 512 的变化及是否低于红线;2. 再看第二列中央处理器占用面板中 100% 饱和线与各块长均值须线的关系;3. 最后检查第三列吞吐与第四列内存以确认大块的代价与机型差异
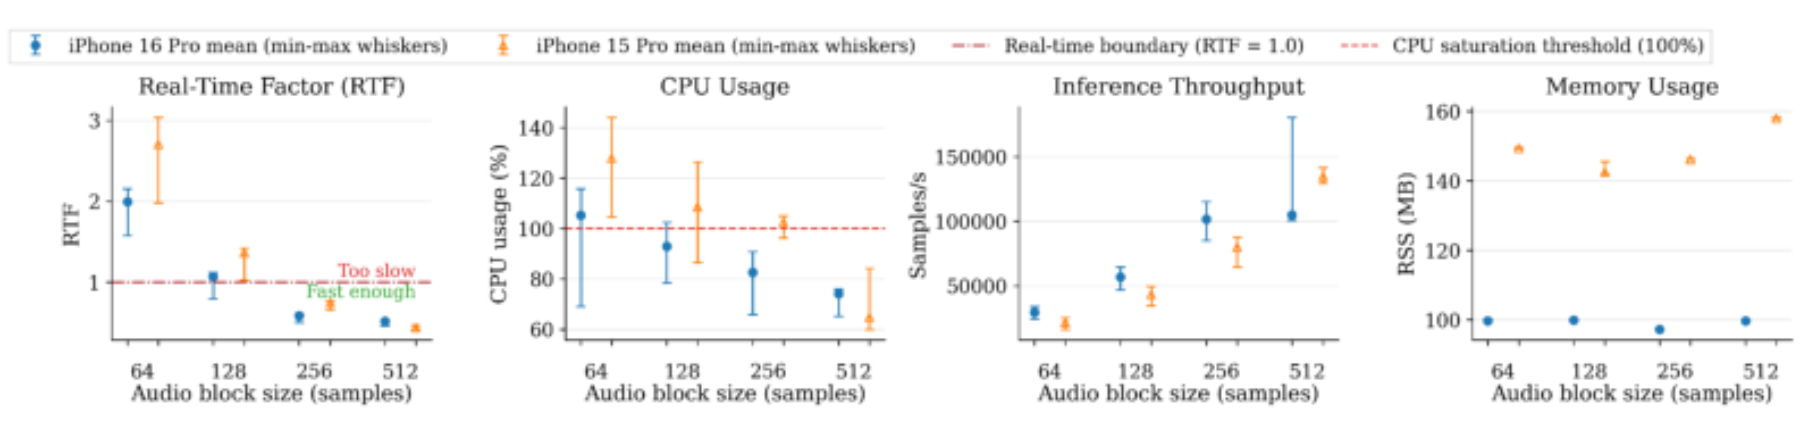
论文图 4。原论文 Figure 4:“Block-size sweep at 90% sparsity: iPhone 16 Pro versus iPhone 15 Pro, showing RTF, CPU usage, inference throughput, and memory usage.”。
该四面板图横轴均为音频块长,纵轴分别为实时因子、中央处理器占用百分比、每秒采样吞吐与常驻内存,蓝色为新款而橙色为旧款,须线为波动。第一面板红色点线为实时边界,可见小块多在边界之上,默认块起进入边界之下。第二面板红色虚线为饱和阈值,可见小块时占用超限。第三面板吞吐随块增大而上升,大块时新款波动显著增大。第四面板内存显示两机型基线差异,旧款显著更高且随块略有起伏。
下表把在线操作点放在一起,便于核对延迟、阈值与设备条件,表中块长与测量时长按原文连续句组织。
| 运行条件 | 块长集合 | 默认工作点 | 测量时长 | 对比设备 |
|---|---|---|---|---|
| 在线推理 | 64 to 512 samples | 256 samples approx 5.3 ms | 60 seconds per block | iPhone 16 Pro vs 15 Pro |
表后需强调代价,90% 稀疏换来余量,但长混响与底噪问题仍在,256 块换来低延迟,但旧设备不达标。若把块增至更大,实时因子继续下降但延迟翻倍,现场演奏体感会变差,因此不能只看实时因子最小。未评测边界包括更广机型、不同采样率与后台负载下的稳定性,复现时应补测这些条件再推广结论。
哪些现象模型复现不了,误差从哪里来?
主要残差限制是确定性模型无法复现与输入无关的噪声与嗡声,高增益单块最明显。时频对比显示模型输出与录制目标的谐波结构对齐,但目标背景中可见的横向底噪线与间隙嗡声在模型输出中缺失。这不是剪枝引入的,而是建模假设所致,网络只学从输入到输出的确定映射,没有噪声源。
第二个限制是长混响尾音超出感受野,误差增大,增大感受野或外挂卷积混响是更对路的解法,论文应用中已用实测脉冲响应的分区卷积混响补足。第三个限制是评估依赖非正式听感与误差信号比,没有正式主观实验,误差信号比低不等于每种演奏技巧下都无差。 下面看单块最大失真下的时频对比,聚焦底噪差异而非谐波主体。
看图路径: 1. 先确认上下两块面板共享横轴时间秒与纵轴赫兹并观察多次拨弦事件;2. 再对比上下谐波条纹的形态一致性与下方背景多出的横向细线噪声;3. 最后聚焦静音间隙比较模型输出与录制目标在底噪上的差别
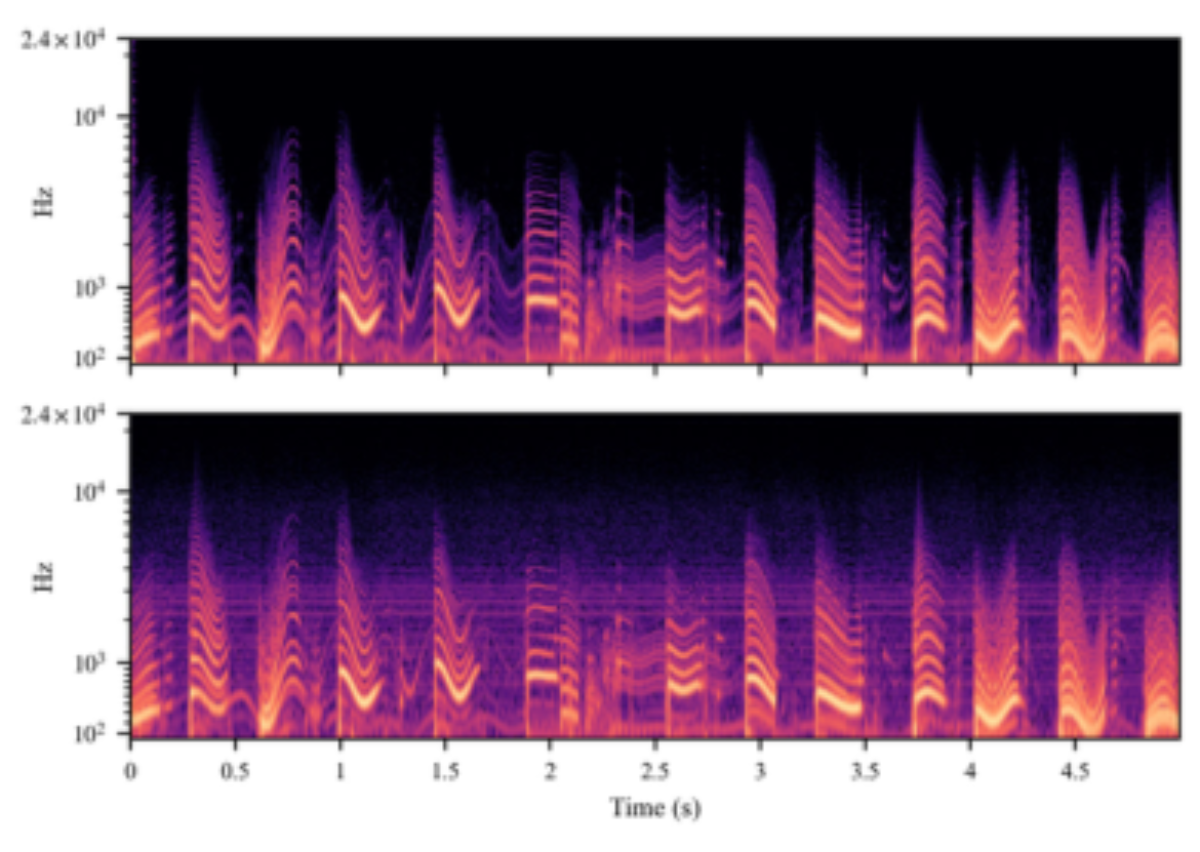
论文图 2。原论文 Figure 2:“Fuzz Face at maximum distortion: 90% pruned model output (top) versus the recorded target (bottom).”。
该图上下两块为频谱图,横轴时间为秒,纵轴为赫兹对数刻度,上为剪枝模型输出,下为录制目标。可见拨弦事件的谐波条纹上下对齐,说明失真音色主体被保留,下方背景更亮且有多条连续横线,代表噪声与嗡声,上方对应位置更干净,支持确定性模型省略无关噪声的判断。像素不能精确读出分贝值,因此只做形态比较,不硬写数值。
第 4 个限制是引擎为中央处理器手写,未用图形处理器与神经引擎,原因是公开接口的每块调度延迟对小块不友好且神经引擎缺乏底层访问。这在更大块或未来接口变化时可能需要重估,复现时不应把中央处理器路线当成唯一最优。
要复现,先做什么,需要补哪些验证?
复现应分 3 步。第一步对齐基线,按通道 16、核长 3、多轮训练与多层双周期空洞搭建网络,用 1 阶高通预加重训练均方误差,评估用误差信号比。数据用结构化 3 分钟激励自采或兼容流程,注意话筒、摆位与电平会影响结论。
第二步复现剪枝,实现可剪枝张量绑二值掩码,前后向均乘掩码,稀疏度从 0 按指数计划斜坡到 90%,固定起始轮并扫描结束轮。论文最优结束轮是在自有验证集上得到,需在自己的验证集上重扫而非照抄。第 3 步部署稀疏引擎,只存算非零权重并做缓存友好布局,手写空洞卷积栈而非调通用稠密库。
音频块默认 256 采样与 48 kHz,文件输入先与 Python 参考对到转换量化误差内,再上真机测实时因子与占用。官方代码与音频示例当前可用,可直接核对导出与引擎。还需补的验证包括正式听感实验、多机型与不同块长的完整扫描、后台负载与发热降频下的稳定性,以及长混响与高增益噪声的专项评估。
超参数缺项如优化器与学习率需在代码中确认,不应臆测。划分比例、随机种子与电平校准也应记录,否则误差信号比的微小差异无法归因是剪枝还是数据处理所致。
何时值得尝试,何时不值得?
当你已有可用的 WaveNet 风格音箱模型但手机端跑不动,且能接受确定性建模不复现底噪时,值得尝试迭代局部幅度剪枝加稀疏引擎的路线。九成稀疏在本研究的 4 个采集中保质且在新款手机上留有余量,约七成是进入实时的粗略门槛,可作为新设备上的起点估计。
当你的音色依赖长混响尾或高增益下的噪声质感时,不值得指望剪枝解决,应先扩大感受野或外挂混响,并明确告知用户噪声不会被复刻。当目标是旧款手机或极小块超低延迟时,需准备更大块或更高稀疏,并重测实时因子与体感延迟的折中。
教学上最易误解的是把稀疏等同于压缩后自然加速,实际上若引擎仍按稠密计算则无加速。其次是把误差信号比低等同于听感无差,正式听感缺失时应谨慎表述。总体上,论文显示重度剪枝配稀疏感知实现能让 WaveNet 风格神经音箱在纯中央处理器手机上实时运行,准确到转换量化误差内,但长尾与无关噪声仍是边界,未来向量化与跨设备剖析值得继续做。
📐 原文公式与排版
以下展示论文原页中的数学表达区域,保留原始上下标、分式和符号排版。区域序号仅用于本文导航,不是论文公式编号。
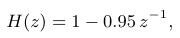
区域 1 · 查看论文原页
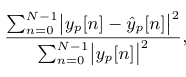
区域 2 · 查看论文原页
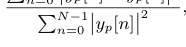
区域 3 · 查看论文原页
另有 5 个候选区域因边界不明确或图片数量、尺寸限制未展开;请查看完整论文中的原始排版。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses