英文题目:BabyVLM-V2: Toward Developmentally Grounded Pretraining and Benchmarking of Vision Foundation Models
会议身份:
conference:cvpr:2026:conference-paper-id:Wang_BabyVLM-V2_Toward_Developmentally_Grounded_Pretraining_and_Benchmarking_of_Vision_Foundation_CVPR_2026_paper
✅ 来源为官方会议 PDF;表格与 Figure 按原文证据绑定。PDF 公式以原页区域图片展示,未冒称作者原始 TeX。
标签:#数据集 #基准设计 #预训练 #音视频理解
评分:6.6/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.0/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 1.0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:数据集与基准
👥 作者与机构
- Shengao Wang:机构信息未能从会议 PDF 纯文本可靠映射
- Wenqi Wang:机构信息未能从会议 PDF 纯文本可靠映射
- Zecheng Wang:机构信息未能从会议 PDF 纯文本可靠映射
- Max Whitton:机构信息未能从会议 PDF 纯文本可靠映射
- Michael Wakeham:机构信息未能从会议 PDF 纯文本可靠映射
- Arjun Chandra:机构信息未能从会议 PDF 纯文本可靠映射
- Joey Huang:机构信息未能从会议 PDF 纯文本可靠映射
- Pengyue Zhu:机构信息未能从会议 PDF 纯文本可靠映射
- Helen Chen:机构信息未能从会议 PDF 纯文本可靠映射
- David Li:机构信息未能从会议 PDF 纯文本可靠映射
- Jeffrey Li:机构信息未能从会议 PDF 纯文本可靠映射
- Shawn Li:机构信息未能从会议 PDF 纯文本可靠映射
- Andrew Zagula:机构信息未能从会议 PDF 纯文本可靠映射
- Amy Zhao:机构信息未能从会议 PDF 纯文本可靠映射
- Andrew Zhu:机构信息未能从会议 PDF 纯文本可靠映射
- Sayaka Nakamura:机构信息未能从会议 PDF 纯文本可靠映射
- Yuki Yamamoto:机构信息未能从会议 PDF 纯文本可靠映射
- Jerry Jun Yokono:机构信息未能从会议 PDF 纯文本可靠映射
- Aaron Mueller:机构信息未能从会议 PDF 纯文本可靠映射
- Bryan A. Plummer:机构信息未能从会议 PDF 纯文本可靠映射
- Kate Saenko:机构信息未能从会议 PDF 纯文本可靠映射
- Venkatesh Saligrama:机构信息未能从会议 PDF 纯文本可靠映射
- Boqing Gong:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
该工作研究以婴儿视角纵向音视频为输入、输出可处理词汇理解、记忆、空间推理与计数的通用视觉语言响应的学习与评测问题,难点在于照护者语音与婴儿视野天然错位、可用时长仅 478 小时且评测需与 6 至 32 月龄能力对齐。预训练语料整理先用 Azure 语音识别转写全部含语音片段并按话语边界切分,再用时长、转写置信度和 X-CLIP 视频文本相似度过滤得到约 181k 视频话语对,从中按 1 FPS 采样并用 CLIP 相似度筛选得到约 768k 图像话语对,再对连续片段取每段最高相似帧并用 4 至 8 滑动窗口拼接得到约 63k 交错图文序列。模型采用视觉编码器 ViT-L-16 约 300M 参数加轻量多层感知机连接器加 LLaMA-1.1B 的结构,视觉特征投影到语言空间后与指令拼接由自回归语言模型解码, entire 模型从零经三阶段预训练再用基准同分布指令数据微调以支持单图、多图、视频与多轮问答。相对 BabyVLM-V1 的关键差异在于预训练覆盖从约三分之一扩展到全部含语音录像并新增视频与交错形态,同时引入指令微调,并以 2025 年 2 月发布的 NIH Baby Toolbox 全部视觉相关测量为锚点构建 10 任务 DevCV Toolbox。在域内 DevCV Toolbox 上婴儿模型总体准确率为 63.9%,持平 Qwen2.5-VL-7B 的 63.7%,在 Left/Right 上达 96.4%、空间细节上达 92.8%、Who Has More 自然子任务上达 99.7%,超过 GPT-4o 的部分数学子任务,但在图片词汇上仅 32.4%、定位上仅 37.8%。该结论仅适用于 SAYCam 同域划分,跨到 Ego4D 兄弟基准时总体降至 41.1%,未参与指令微调的注视听与快速计数任务几乎回到随机猜测。原文未披露训练、推理或部署成本,儿童实测仍在进行中。
🔗 开源与复现资源
- 代码相关资源:https://shawnking98.github.io/BabyVLM-v2/ — 链接可访问(HTTP 200)
- 复现相关资源:https://shawnking98.github.io/BabyVLM-v2/ — 链接可访问(HTTP 200)
- 第三方资源:https://ssrn.com/abstract=4696693 — 暂时无法访问
- 第三方资源:https://childrenhelpingscience.com/ — 链接可访问(HTTP 200) 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
婴儿视角的数据到底长什么样?
这篇论文的输入不是网上爬来的图文对,而是 3 个婴儿从约 6 个月到 32 个月、每周约 2 小时由头戴相机记录的音视频,来源称为 SAYCam。论文强调语料要同时满足纵向与婴儿中心 2 个条件:纵向指覆盖发育时间轴,婴儿中心指相机戴在婴儿头上,看到的是婴儿视野的晃动、遮挡和近距离操作,而不是成人剪辑好的画面。话语几乎全部来自照顾者,多为简单指令和描述,例如吃饭时说食物味道,玩耍时问选择哪一个。
上排示例帧显示桌面餐具、手部特写、黄色水桶与玩具等生活场景,话语与画面常常错位,噪声本身就是研究对象。下排长条图把记录时间与婴儿醒睡时间放在同一月龄轴上对比,说明实际记录只占婴儿总清醒经历的一小部分,论文因此把最大化利用语料、最小化人工编排作为原则。
为帮助刚入门的读者建立直觉,可以做一个教学例子:假设婴儿在餐桌前,相机看到一只手伸过来,同期听到大人说要不要尝一小块,模型需要把这句照顾者话语与当前视觉帧关联起来。例子只是为了说明视角与对齐难度,不代表论文报告了该单例的效果。论文的官方项目页当前可用,地址为项目主页,状态码为 200,可作为复现入口;另有一个第三方社会科学预印本链接本次未能确认可达,不能作为事实依据。
看图路径: 1. 先逐格读上排胶片帧下方的时间与照顾者话语;2. 再对比左右两组场景中手部遮挡与桌面杂物的视角特点;3. 最后看下排长条图中记录 wake 与 sleep 随月龄的覆盖情况
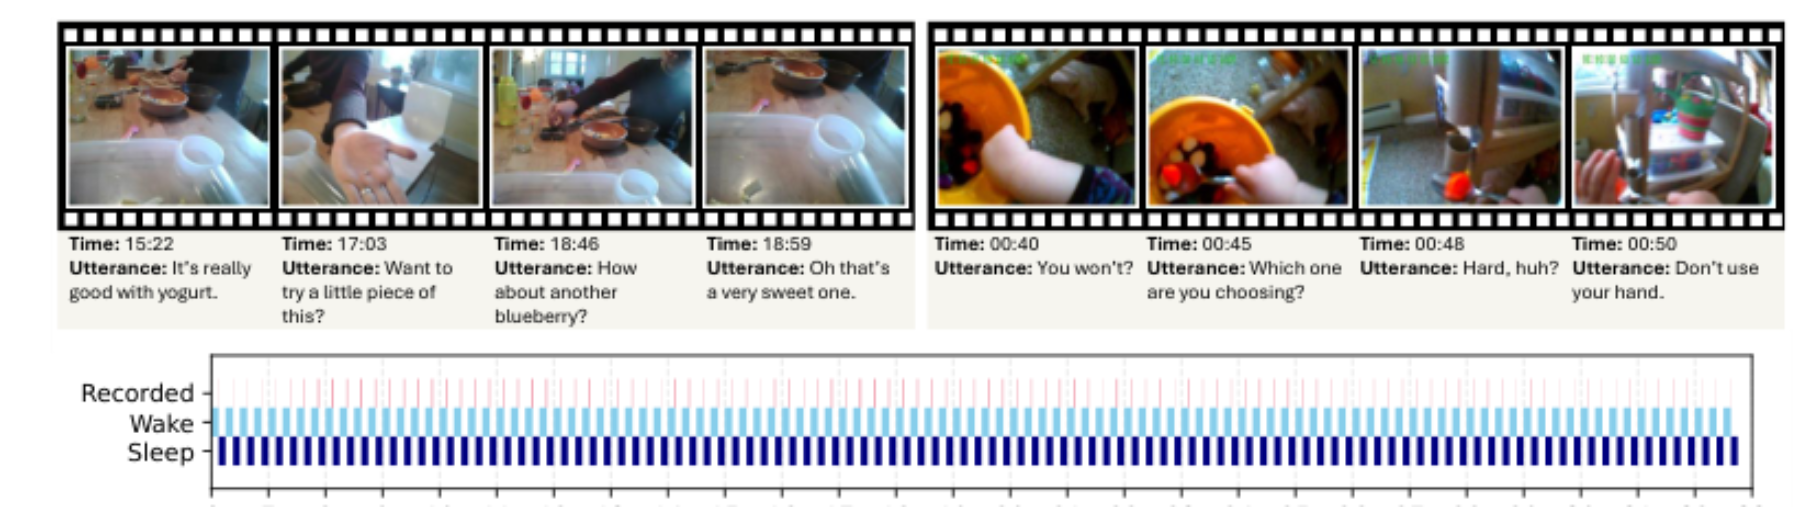
论文图 2。原论文 Figure 2:“Top: Video frames and utterances recorded from the infants’ view. Bottom: Recorded wake time vs. wake/sleep time for the ages of 6 months to 32 months in SAYCam [53].”。
上图上半部分用两组胶片式连续帧展示了婴儿视角的典型输入,每帧下方标注了时刻与同期照顾者话语,可以看到画面抖动、手部遮挡和物体大特写等特点。下半部分用长条图展示了 6 至 32 个月范围内已记录时间与全部醒睡时间的对比,直观说明记录覆盖率很低。结合阅读可以理解为什么论文要保留自然错位而不做强清洗:要研究的就是在这种稀疏且噪声的输入下能学到什么。
已有路线在样本效率与认知评测上缺了哪块?
视觉基础模型通常指能在统一接口下处理多种视觉任务的通用模型,代表做法是在海量视觉数据上预训练再适配下游任务。论文把相关工作分成两条线。第一条是样本高效预训练:语言和医学领域已开始关注不靠规模定律、而用有限且合理的数据训练,视觉领域的前身工作是只用约三分之一 SAYCam 记录训练图像话语对的 BabyVLM 第一版,以及只关注词与指称映射的对比学习工作。第二版要补的是覆盖度、指令微调支持和开放式语言输出。
第二条是认知可信的评测:已有发育启发基准多取材于儿童测试,但要么年龄偏大,要么只覆盖单一能力,要么未基于标准化临床工具。论文用表格对比了多个基准在发育依据、任务多样性、多模态、训练验证测试划分、域内域外、人类数据与模型等方面的差异,指出新基准需要同时满足多项。
论文选择的依据是 2025 年 2 月公开发布的 NIH Baby Toolbox,它被定位为评估婴幼儿神经发育的标准化工具,分为认知、运动、社会情绪等域,其中认知域下含语言、执行功能记忆与数学等子域。相比贝利量表等更早的工具,论文认为它更新、更全面且经过临床可用性验证。需要提醒的是,发育智能本身在心理学内部仍有概念与方法争议,论文为此咨询了 2 位发展与学习方向的心理学家,并把基准设计锚定在该工具上,而不是自行发明 4 个直觉任务。这一选择决定了后文所有任务的年龄标签与能力划分。
论文要解决的具体问题是什么?
论文把目标形式化为:给定一段纵向、婴儿中心的音视频采样,能否学出一个基础模型,使其训练数据与期望能力都接近相应年龄段早期儿童。论文进一步提出两个追问:能否在有限感官摄入约束下实现接近儿童感知的通用模型,能否借鉴发展心理学原理建成评测人工发育智能的基准。所谓发育合理,在文中指训练数据与期望模型表现都贴近早期儿童,而不是指模型结构像大脑。
为实现该目标,论文提出三部分工作:最大化覆盖且最小化编排的预训练集,支持视频、单图、多图与多轮对话的灵活模型,以及把 NIH Baby Toolbox 全部视觉相关量表转写为 10 个多模态任务的 DevCV Toolbox。第一版的不足被明确列出:只用了约三分之一记录,不支持指令微调,评测未基于既定心理测试,模型输出只是 logits 需要后处理且开放集表现接近零。第二版要逐项补齐。理解这一问题定义很重要:后文所有数据划分、任务构造与实验对照都是为了回答在同样发育约束下学到了什么,而不是为了在通用榜单上刷分。
三部分框架如何从数据走到评测?
框架全景可以沿一个样本走一遍。输入是头戴相机的一段含话语视频,先用语音识别转写照顾者话语,再按话语边界切分为短片,丢弃过短或识别置信度过低的片段,再用视频文本相似度过滤,保留的构成视频话语对;从中按每秒 1 帧采样,用图文相似度筛选高相关帧构成图像话语对;再在连续片段上取相似度最高的帧,用滑动窗口组织成长度 4 至 8 的交错图文序列,用于支撑多轮与多图能力。
表示阶段由视觉编码器把图像或视频帧编码为视觉特征,经多层感知机投影到语言空间,与文字指令一起送入语言模型。目标阶段用 3 阶段流程从零预训练整个模型,再用与基准同构的小规模指令集微调,使模型能按指令生成语言回答。输出是语言回答,可直接用准确率评分。评测阶段用同域划分的测试集测域内能力,用成人视角视频构造的平行集测域外泛化,并用两个未参与指令微调的任务测未见任务泛化。
看图路径: 1. 先看左侧预训练数据面板如何从头戴相机指向纵向记录;2. 再看中间模型面板如何把单图视频多图多轮统一送入语言模型;3. 最后看右侧工具箱面板如何列出计数方位空间词汇记忆定位等任务
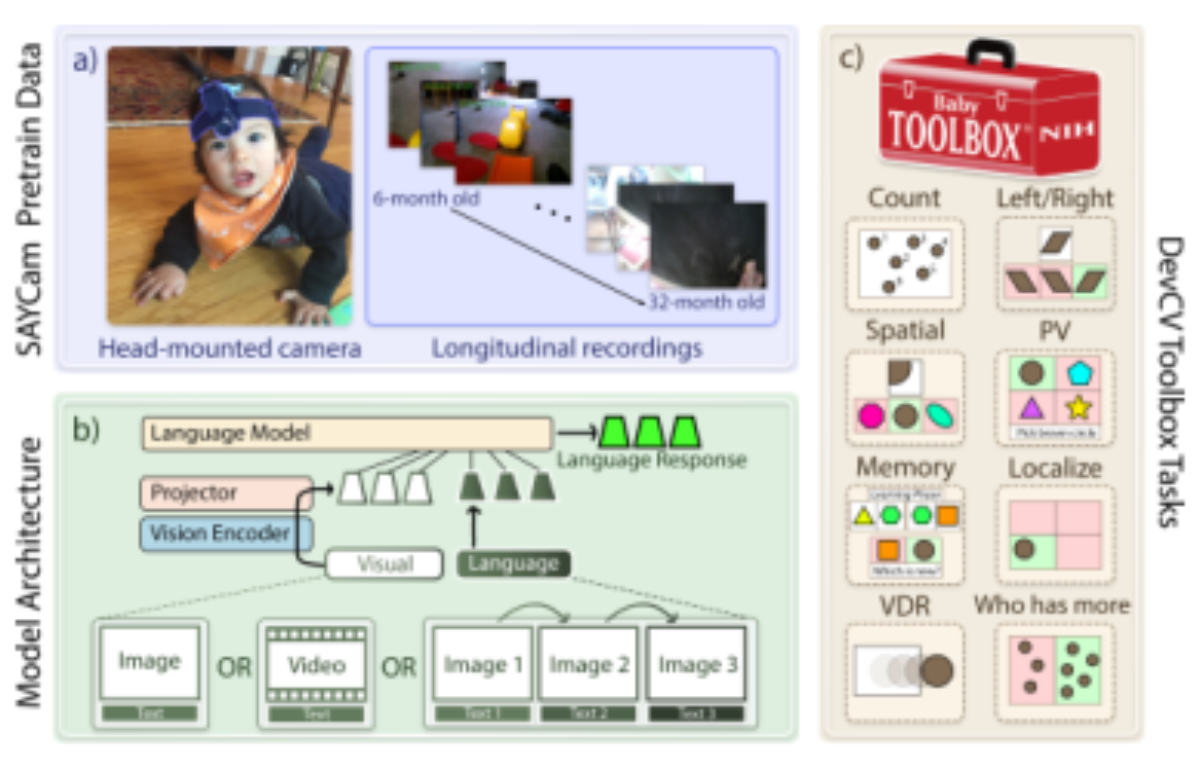
论文图 1。原论文 Figure 1:“BabyVLM-V2: An extensive, versatile, and develop- mentally plausible framework for research in vision foundation models.”。
上图左侧展示了头戴相机与从 6 个月到 32 个月的纵向记录,中间展示了语言模型经投影器接收视觉编码器输出、并统一处理单图视频与多图多轮输入的结构,右侧展示了工具箱中计数方位空间词汇记忆定位等任务图标。三者闭环说明数据格式多样性直接支撑了模型接口的灵活性,而基准的年龄跨度又与数据跨度对齐,这是全文方法安排的核心逻辑。
数据、模型与基准各自承担什么机制?
预训练集包含 3 种格式。视频话语对通过按转写边界切分得到,短于 0.5 秒或转写置信度低于 0.3 的被丢弃,再用视频文本相似度大于 0.1 过滤,最终约 18 万余片段,共 138 小时,来自总计 478 小时记录。处理时在片段两侧各补 1 秒。图像话语对从视频话语对中按每秒 1 帧采样,只保留图文相似度大于 0.2 的帧,共 768,000 对。交错图文序列在连续片段上取每段相似度最高帧,用窗口大小随机取 4 至 8、步长为窗口 1 半的滑动窗口组织,共 6.3 万序列。数据划分上把所有含语音片段划入预训练,其余无语音片段均分为验证与测试,大致比例为 3 比 1 比 1。
纵向婴儿中心语料 × 最小化编排: 纵向婴儿中心语料负责提供从 6 到 32 个月、每周约 2 小时头戴相机记录的所见所闻,保证时间跨度和视角与婴儿一致;最小化编排负责只做转写、切分与相似度过滤等必要加工而不重写内容,保证数据仍接近原始感官摄入;二者搭配是因为要同时满足发育可比性和可训练性,组合后得到可直接用于预训练又保留自然错位和噪声的训练集。
模型沿用第一版的 BabyLLaVA 结构:视觉编码器采用 300M 参数的 ViT,语言模型采用 1,100,000,000 参数的 LLaMA,经轻量多层感知机连接。论文从零预训练整个模型,而不是加载外部权重,以保证发育约束可比。
视觉编码器 × 语言模型: 视觉编码器负责把单图、多图或视频帧转成视觉特征,承担看的职责;语言模型负责接收投影后的视觉特征与文字指令并生成语言回答,承担说和推理的统一接口;二者通过轻量多层感知机连接是因为模态维度不同需要对齐,组合后使同一模型能处理图像、视频与多轮对话多种输入。
基准把 NIH Baby Toolbox 全部视觉相关量表转为 10 个任务,覆盖语言、执行功能记忆与数学三子域。需要转写的原因有二:原量表每个仅有少量测试样例且面向人类不便于模型作答,原卡通刺激与预训练域差异大会混淆能力评测与域差异。因此论文用同源视频构造数千自然样例,并按预训练划分切分指令微调、验证与测试。
NIH Baby Toolbox × DevCV Toolbox: NIH Baby Toolbox 负责提供临床可用的婴儿神经发育量表与年龄划分,承担发育保真度的来源;DevCV Toolbox 负责把其中所有视觉相关量表转写为计算机视觉可评测的任务格式,承担模型可测性的职责;二者搭配是因为原始量表样例极少且多为卡通刺激不适合模型,组合后得到同域自然图像支撑且年龄对齐的十任务基准。
以图片词汇为例,流程是按每秒 1 帧采样,用人工转写与大模型标注存在物体与动作,用开放集检测器裁剪区域,过滤低质量与超出儿童词汇表的标签,再按原工具中语义与语音相似的干扰项分布采样 3 个干扰图,用轮转方式组织多样性样例,最后人工检查。其他任务包括注视听、定位、左右匹配、空间细节、视觉延迟反应、延迟记忆、谁更多与计数等,分别对应不同月龄段。论文明确未覆盖非视觉的语言熟悉化与口头计数算术等量表,留作未来工作。
预训练与指令微调实际做了哪些操作?
训练分为预训练与微调两段。预训练使用上述 3 种数据混合训练整个模型,细节引用的 3 阶段流程在附录中,正文未给出完整超参数与梯度路径,因此不能从模型名称推定哪层冻结或哪步停止梯度。能确认的是模型从零训练,视觉编码器、投影器与语言模型都参与更新,监督来源是照顾者话语转写与交错序列中的上下文,而不是人工标注的类别标签。
微调使用与基准同构的小规模指令集,论文报告了两种策略:按任务分别微调与把所有指令数据合并为单一集合训练,后者被选为婴儿模型的默认设置。论文还用两个大开源模型在每个任务上分别监督微调,以验证指令数据的有效性,观察到一致且显著的提升。
预训练 × 指令微调: 预训练负责在视频话语、图像话语与交错序列上学习视觉与照顾者话语的关联,承担基础感知与词汇 grounding;指令微调负责用与基准同构的小规模指令集教会模型按指令作答,承担消除预训练与下游任务格式失配的职责;二者搭配是因为预训练只见自然共现而不见选择题格式,组合后模型才能把学到的能力表达为可评分的答案。
基准构造本身也是一套可复述的计算流程,仍以图片词汇为例:先采样与标注,再检测与定位,再过滤与生成,最后人工检查。干扰项不是随机采样,而是从原工具估计语音与语义相似分布后采样,以保持发育保真度。其他任务的构造细节在附录中,正文只给出能力描述与年龄标签。
看图路径: 1. 先沿下排主链看从采样帧到目标检测定位再到任务生成的流程;2. 再看左上虚线框内语言模型开放集检测人工检查与过滤的分工;3. 最后看右上虚线框内干扰项分布如何约束示例生成器
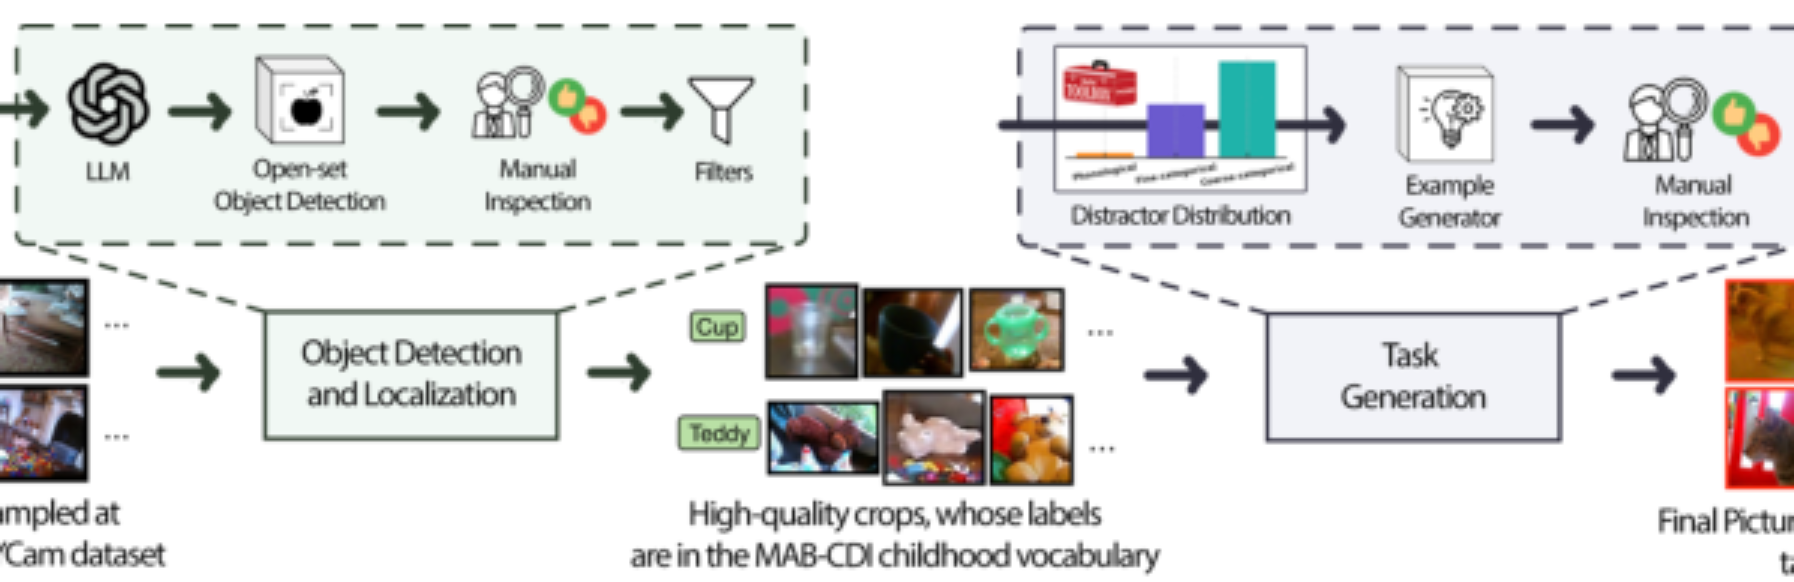
论文图 4。原论文 Figure 4:“Pipeline to adapt the picture vocabulary measure in NIH Baby Toolbox® to DevCV Toolbox.”。
上图展示了图片词汇从原始量表到计算机视觉任务的转写流水线,下排主链从采样帧经目标检测定位到高质量裁剪再到任务生成,上排虚线框分别说明了检测定位阶段的模型与人工检查分工,以及任务生成阶段干扰项分布与示例生成器的约束关系。读图时应把上下两层对应起来,理解每一处人工介入都是为了保真度而非扩大规模。
评测条件、基线与指标如何保证可比?
评测围绕 4 个问题组织:基准质量是否可靠,指令数据是否有效,话语噪声影响多大,婴儿模型泛化如何。基线包括人类志愿者在本机构的调查、随机猜测下界、专有模型、更大尺寸开源模型与同尺寸开源模型。人类调查用于验证任务可解性,报告显示执行功能记忆子域与数学任务接近满分,定位任务略低但延长作答时间可提升。更大规模的儿童调查正在儿童助科学平台上进行,预计需要数年,因此当前人类数据仅为成人志愿者,不能等同于儿童表现。指标统一用准确率,越高越好,但在不同任务上机会水平不同,需要结合随机猜测行解读。
为检验公平性,论文做了两组对照。第一组是指令微调对照,用两个 7B 级开源模型分别在每个任务上微调,观察指令数据是否能把预训练与下游格式对齐。第二组是语言来源对照,把照顾者转写替换为大模型生成的视频描述,训练结构相同的合成版婴儿模型,以检验自然话语错位的影响。域外对照用成人视角视频按同样技术构造平行基准,比较域内与域外总体准确率。未见任务对照把注视听与计数排除在指令微调之外,检验对新格式的泛化。论文未报告训练硬件预算、延迟与统计显著性方法,这些缺项在复现时需要自行记录,不能从结果反推成本改善。
下面第一张表整理预训练集的规模构成,用于核对数据划分与复现时的数据量预期。表前提出的问题是:3 种格式各有多少,视频时长占总记录多少。指标方向是数量越大覆盖越广,但噪声也越多,需要结合过滤阈值理解。
| 数据格式 | 数量规模 | 时长或筛选条件 | 来源与用途 | 与第一版关系 |
|---|---|---|---|---|
| 视频-话语对 | 181k 片段 | 138 小时,来自 478 小时记录 | SAYCam 含语音片段,用于预训练 | 新增格式 |
| 图像-话语对 | 768k 对 | 相似度大于 0.2 保留 | 从视频对按 1 FPS 采样,用于预训练 | 规模扩大 |
| 交错图文序列 | 63k 序列 | 窗口 4 至 8,步长一半 | 连续片段最高相似帧,用于多轮能力 | 新增格式 |
表后解释需要强调:视频与图像对的增长来自最大化利用全部含语音片段,而交错序列专门为多图多轮任务准备。代价是话语仍是自然错位的照顾者语音,相似度阈值只能过滤极低相关,不能保证语义对齐。未胜出项是第一版仅用部分记录的做法,本版用近 3 倍覆盖换来格式多样性,但仍只占婴儿总清醒经历的一小部分,这是发育约束下的固有边界。
主结果显示小模型在哪些任务上接近大模型?
主结果在域内基准上比较了人类上界、专有模型、开源大模型、同尺寸开源模型、婴儿模型与随机下界。人类志愿者在多数任务上接近满分,说明任务可解。专有模型整体占优,更大开源模型居中,同尺寸开源模型与婴儿模型偏低,但婴儿模型在部分任务上突出。论文报告婴儿模型在空间细节与谁更多上可与最新专有模型持平,在物体计数与谁更多上超过部分专有模型,尤其在物体数较多时计数更好。
反例同样明显:婴儿模型在图片词汇与定位上明显偏低,说明词汇 grounding 与精确定位仍是短板。比较时必须注意基线并未在同一发育约束下微调,它们见过远超本研究的数据量,因此婴儿模型的局部胜利不能解读为总体超越。
域内评测 × 域外评测: 域内评测负责用同一来源划分出的验证与测试集检验模型学到了什么,承担能力上限的估计;域外评测负责用成人视角的自我中心视频按同样方法构造平行测试集,承担泛化能力的检验;二者搭配是因为只看域内无法区分记忆与通用认知,组合后才能判断模型是真正获得可迁移能力还是只拟合了特定家庭场景。
下面第二张表聚焦论文用连续正文明确报告的域外泛化数字,用于核对可复述的最强定量证据。表前提出的问题是:在同方法构造的成人视角平行基准上,婴儿模型总体准确率相对随机猜测与域内表现如何。指标方向是准确率越高越好,差距越大说明泛化损失越大。
| 评测条件 | 婴儿模型总体准确率 | 随机猜测总体准确率 | 域内对照准确率 | 结论方向 |
|---|---|---|---|---|
| 域外成人视角平行基准 | 41.1% | 31.8% | 55.2% | 高于随机但明显低于域内 |
| 域内婴儿视角基准 | 55.2% | 31.8% | 55.2% | 作为参照上界 |
| 差值含义 | 高于随机约 9 个百分点 | 基准机会水平 | 域外损失约 14 个百分点 | 支持部分泛化但远未达到婴儿水平 |
表后解释需要同时给出收益与代价:收益是域外仍高于随机猜测,支持模型学到了一定可迁移的视觉语言关联;代价是域外比域内低约 14 个百分点,论文据此判断模型泛化能力远不及人类婴儿。未胜出项是未见任务泛化:被排除在指令微调之外的 2 个任务上模型接近随机猜测,说明格式泛化仍需改进。百分点与相对百分比在此不能混用,论文报告的是准确率差值。
看图路径: 1. 先确认该图是截取自结果表格的计数相关列而非独立曲线图;2. 再逐行对比人类上界专有模型开源模型与婴儿模型的数值走向;3. 最后注意随机猜测行给出的各列机会水平以判断提升幅度
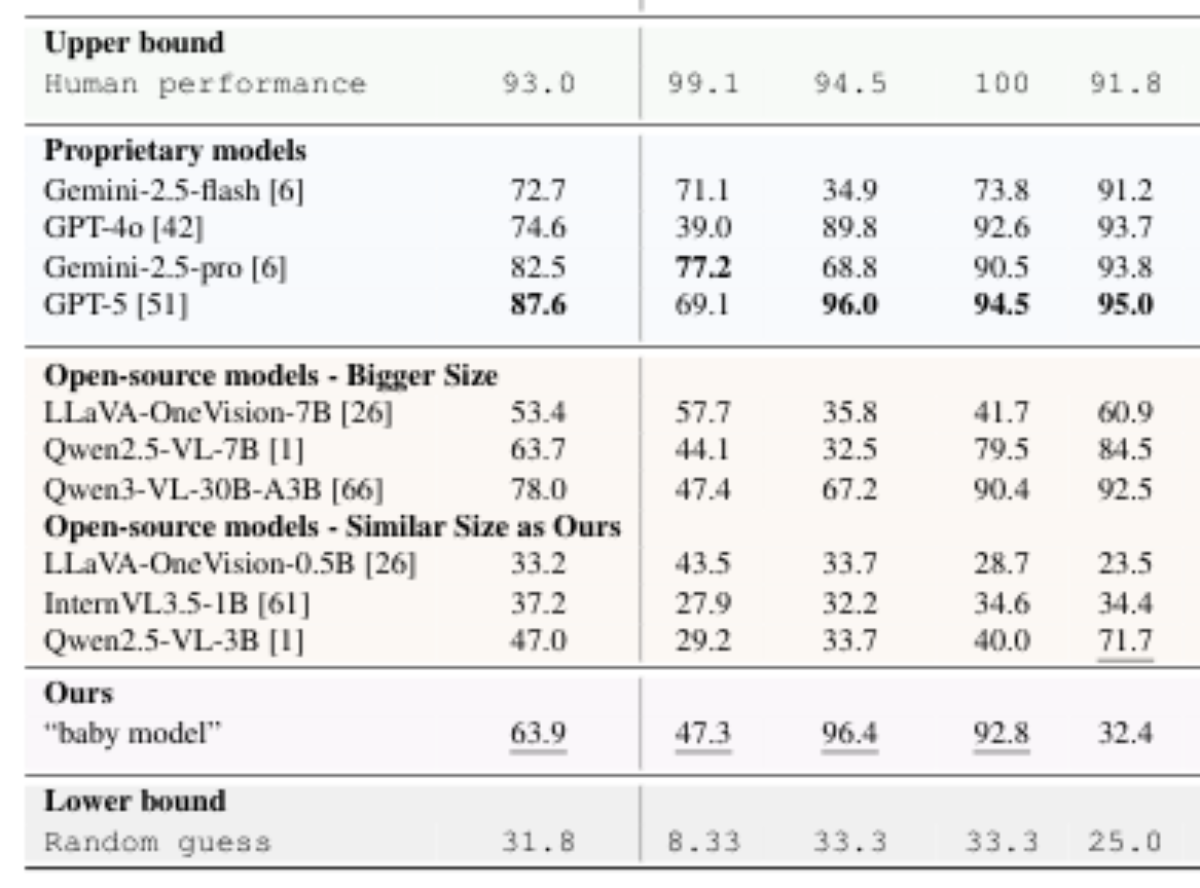
论文图 6。原论文 Figure 6:“GPT-4o and our model’s counting performance by dif- ferent object numbers.”。
上图截取的是结果表格中与计数相关的列,展示了人类、专有模型、开源模型、婴儿模型与随机猜测在不同条件下的准确率数值。阅读时应先确认每列的任务含义与机会水平不同,再逐行比较:人类行接近满分,专有模型行整体较高但在计数上分化,婴儿模型行在部分列突出但在词汇列偏低。结合正文关于大模型难以数到 5 以上、而婴儿模型在 6 个以上物体上更好的描述,可以理解计数能力与训练域中物体分布的关系,但像素本身不能给出随物体数量变化的曲线斜率,不应硬读未显示的数值。
换掉照顾者话语后性能如何变化?
消融研究检验预训练语言来源的影响。原始版用照顾者语音转写,合成版把同一视频的话语替换为大模型生成的描述,其余结构与训练流程保持一致。论文报告合成描述带来总体小幅提升,尤其在需要语义推理的物体计数与需要长注意窗口的记忆任务上更明显,但提升幅度不大。这一结果支持两个判断:一是最小化编排的自然话语已提供较强监督,二是合成描述的干净语义有额外帮助但不能替代发育约束。限制是该对照未报告每任务的完整显著性与方差,也未说明合成描述的提示词细节在正文之外的影响,复现时应固定提示词并记录随机种子。
另一组对照是指令数据有效性:两个 7B 级开源模型在每个任务上分别微调后均有实质提升,图中红色顶栏标示了提升幅度,说明指令集确实缓解了预训练与下游格式失配。论文进一步比较了分任务微调与合并全部指令数据两种策略,合并策略被选为默认,但附录才有详细对比,正文未给出全部数字,解读时不应把单任务最优当作可部署收益。此外,论文提到在原始临床工具上的额外测试在附录中,正文未展开,不能据此声称临床有效性。
哪些边界尚未验证?
论文明确承认多处边界。数据上记录仅占婴儿总经历的一小部分,且仅用 3 个婴儿的 SAYCam,未来才纳入更大规模的 BabyView。任务上未覆盖非视觉量表与部分口头数学,儿童本人的大规模调查尚未完成,当前人类上界只是机构内成人志愿者。模型上域外泛化损失明显,未见任务接近随机猜测,词汇与定位任务偏弱,说明当前指令微调算法与表示能力仍不足。方法上预训练 3 阶段细节、超参数与计算成本在正文中不完整,合成描述的提示词在附录,复现时需要补齐。
区分证据强度很重要:论文直接报告的是域内外准确率与合成对照的定性提升方向;有限解释是小模型在部分任务上可比大模型,支持发育约束预训练的潜力;未验证推测是该框架能推进认知科学与公众理解,这些属于愿景而非已测量效果。缺失训练成本、延迟与误判率测量时,不应承诺效率或安全改善。总体趋势不等于每组都成立,例如合成版在多数任务上更好,但在个别子任务上可能持平或略低,解读时应回到完整表格而非只看总体。
要复现需要准备什么数据与代码?
复现先做三件事。第一,获取数据与代码:SAYCam 面向非营利机构开放,需要申请;官方项目页当前可用,可下载代码与复现说明;儿童助科学平台当前可用,可了解人类调查流程;社会科学预印本链接本次未能确认可达,不应作为依赖。
第二,重建数据流水线:用语音识别转写全部话语,按话语边界切分并执行时长与置信度过滤,再做视频文本相似度过滤并在两侧各补 1 秒;按每秒 1 帧采样并用图文相似度过滤得到图像对;用滑动窗口组织交错序列。划分上把含语音全部用于预训练,其余均分验证与测试,保持 3 比 1 比 1。第三,对齐评测:用同源视频按附录方法构造十任务,注意干扰项分布采样与人工检查不可省略,否则会改变任务难度。
关键信息条件包括:视频相似度阈值 0.1,图像相似度阈值 0.2,视频最短 0.5 秒,转写置信度 0.3,交错窗口 4 至 8 步长一半,模型为 ViT 加 LLaMA 加多层感知机且从零训练。论文未报告完整优化器与训练步数,复现时应先跑小规模冒烟实验并记录硬件与时间。何时值得尝试:如果研究目标是在有限数据下检验发育合理的表示,或需要年龄对齐的认知基准,该框架值得尝试;如果目标是通用榜单最优,则不应在此约束下比较。还需补的验证包括儿童被试数据、统计显著性与域外多源测试。
这项工作改变了什么,又没改变什么?
这项工作改变的是研究起点:把纵向婴儿视角语料、灵活模型接口与临床锚定的十任务基准放在同一框架下,使独立研究者可用大学资源复述从数据到评测的全链路。它用可核对的操作证明,在高度噪声且稀疏的输入下从零训练的紧凑模型,可以在部分空间与数学任务上接近大模型,且域外仍高于随机猜测。这为样本高效预训练提供了具体参照,而不是停留在直觉任务上。
它没有改变的是规模与泛化的基本约束:模型仍远未达到人类婴儿的泛化水平,未见格式接近随机猜测,词汇与定位仍弱,大模型仍在总体上占优。相关工作对照应按同输入、同目标、同监督与同运行阶段理解:与第一版比,本版补齐了覆盖度、指令微调与临床依据;与更大规模通用模型比,本版的局部胜利是在不同数据量下的条件比较,不能当作同条件胜负。初学者复述时应先讲清数据长什么样、模型如何统一多格式输入、基准如何从量表转写而来,再讲实验条件与反例,最后才谈意义,这样才能把方法真正讲清楚。
📐 原文公式与排版
以下展示论文原页中的数学表达区域,保留原始上下标、分式和符号排版。区域序号仅用于本文导航,不是论文公式编号。
另有 2 个候选区域因边界不明确或图片数量、尺寸限制未展开;请查看完整论文中的原始排版。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses