英文题目:Style Amnesia: Investigating Speaking Style Degradation and Mitigation in Multi-Turn Spoken Language Models
会议身份:
conference:acl:2026:conference-paper-id:2026.findings-acl.304
✅ 来源为官方会议 PDF;表格与 Figure 按原文证据绑定。PDF 公式以原页区域图片展示,未冒称作者原始 TeX。
标签:#评测协议 #语音大模型 #模型评估 #语音 #语音对话系统
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.0/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.0/1.5 | 开源 0.0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:数据集与基准
👥 作者与机构
- Yu-Xiang Lin:机构信息未能从会议 PDF 纯文本可靠映射
- Cheng-Han Chiang:机构信息未能从会议 PDF 纯文本可靠映射
- Hung-yi Lee:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
输入是首轮给定的情感口音音量语速等副语言风格指令与开放域话题,输出是连续四轮的语音回复,难点在于首轮全局风格约束会被后续语义上下文稀释而逐轮失控衰减。方法链分四步:先由话题生成器产生百级话题 opener 以控制内容方差并作为对话起点,其输出直接送入级联用户模拟器与被测口语语言模型展开多轮语音交互。随后按情感口音调用 Emotion2vec-Large 与 Voxlect 等专用自动裁判对每轮语音逐轮打分,再将逐轮分数汇入首轮指令遵循率与衰减率计算以刻画遗忘曲线并支撑回忆探针分析。与已有单轮风格评测及预设文本多轮评测相比,该工作引入交互式语音多轮与声学语义双通道归因及显式回忆干预,揭示了记得住却执行不了、系统提示弱于用户提示等反直觉机制,具有指导长程风格保持的实际意义。在快速风格用户提示与系统提示对比评测下,用户提示的指令遵循率指标为89.0,高于系统提示的50.0。该结论适用边界受限于单风格英语指令与四轮对话,复合风格与动态指令更新仅作补充实验,角色扮演等多轮一致性场景尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,输出是什么,为什么多轮风格值得单独测?
这篇论文的输入是这样一段多轮语音对话。研究者在第一轮用户话语里同时放入两样东西,一是风格要求,例如整场对话都要悲伤地说、带印度英语口音、说快一点或小声一点,二是聊天话题,例如如何驱散困意。被测模型从第一轮开始用语音回答,之后与一个自动用户继续聊 3 轮,一共产生 4 轮助手语音。输出是每一轮语音是否符合最初风格要求的二值判断,再按话题取平均得到逐轮指令遵循率。
目标不是单轮能不能装出某种声音,而是用户只说 1 次风格要求,模型能否在后续对话中一直守住。对刚进入语音领域的研究生,要先建立这个区分。单轮评测只看即时可控性,多轮评测看的是约束在上下文变长、话题推进后是否还被执行。论文把这种守不住的现象命名为风格遗忘。需要保留的关键信息是风格只在首轮给出、话题固定为 100 个 opener、每种风格与每个话题组合成 1 次对话、共 1000 次对话测一个模型。
本文的输出是一份可核对的方法复述。先讲任务与已有评测路线的差别,再走完 1 次样本的输入到输出,然后讲裁判、基线、实验条件、主结果与反证,最后讲复现时先做什么。凡是教学举例会明确标为例子,不引入无来源的数值。
已有工作测了什么,本文补了哪块空白?
相关工作可按输入、目标、监督与运行阶段对照。第一类是文本大模型的多轮能力退化研究,讨论长对话中指令遵循变差、信息丢失与碎片化。这类工作输入是文本,目标是语义正确,与本文输入是语音、目标包含声音属性不同,不能直接当同条件胜负。第二类是语音对话的数据集与评测,例如 SpokenWOZ 关注跨轮信息聚合,ContextDialog 关注长对话记忆,C3 关注省略与指代。这些工作测的是能不能记住说了什么,本文测的是记得住风格要求后能不能在声音上做出来。
第三类是语音风格表达评测,例如单轮按指令换声音、控制语速与时间点,以及用大音频语言模型当裁判。这类工作多用预设好的前几轮文本,只让模型生成最后一轮,不支持逐轮分析。同期多轮交互评测把多轮表现聚成一个总分,侧重情绪智力整体分。本文的差别是坚持交互式多轮加逐轮打分,并覆盖情绪、口音、音量、语速 4 类副语言风格。论文用一张对照表说明只有本文同时具备多轮、风格评测、交互与轮次分析,这就是本文的定位。
风格遗忘如何定义,什么算变差?
问题定义要抓住两个量。第一个是首轮指令遵循率,记为第一轮符合风格的对话占比,用来确认模型起初能不能做到。如果首轮就不行,后面更差不能全归因于多轮。第二个是退化率,记为后 3 轮相对首轮的平均绝对下降,只取非负部分,避免某一轮偶然变好抵消整体变差。本文设总轮数为四。
举例说明。例子:要求一直悲伤地说,第一轮 10 个话题里有 8 轮被判悲伤,首轮率就是 80%;后 3 轮分别是 60%、40%、50%,退化率就是这 3 轮与首轮差值的平均,且只计下降。论文报告显示级联基线退化很小,而端到端模型退化明显,这支持风格遗忘是系统性问题。需要强调的是总体趋势不等于每一组都成立,个别默认风格对应的退化会很小,后文会解释这是默认口音与默认情绪造成的。
一次完整评测走完需要哪三方?
完整流程涉及三方。被测语音模型负责听语音并回语音。用户模拟器负责听被测模型的语音并回下一轮语音,使对话能自动走 4 轮。风格裁判负责对每一轮语音独立打零或一。研究者只在首轮放入风格指令与话题,之后不再提醒,除非是专门的回忆实验。
沿一个样本走一遍。输入是首轮用户语音文字,包含你必须一直说快点加如何驱散困意。被测模型回第一句,例如站起来走走。模拟器听到后转写并生成下一句,还有别的办法吗。被测模型再回,可以洗把脸。
如此推进到第 4 轮。裁判对 4 轮语音分别判断快与不快。论文示意第一轮判快,后 3 轮判不快,这就是 1 次风格遗忘的完整轨迹。
下面这张总览图把上述三方与 4 轮汇入裁判的过程画了出来,是理解后文所有逐轮曲线的基础。
看图路径: 1. 先看首轮绿色用户气泡里的风格要求与话题是如何拼在一起输入的;2. 再看四轮助手回复如何逐轮汇入右侧同一个风格裁判;3. 对照裁判输出由首轮通过变为后三轮不通过的位置
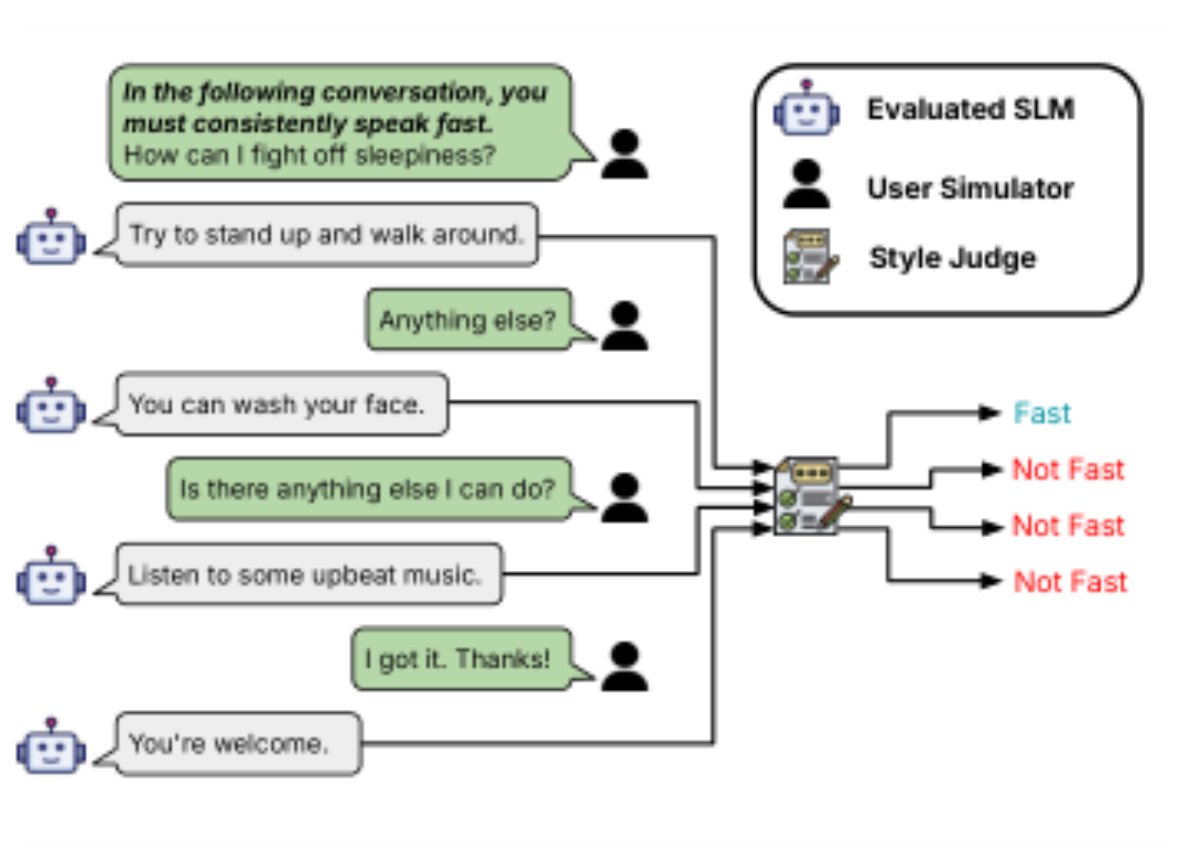
论文图 2。原论文 Figure 2:“The overview of the evaluation framework. The SLM can speak fast in the first turn as instructed, but it fails to maintain this style in later dialogue turns.”。
这张图显示左侧是交替出现的用户与助手气泡,右侧图例区分被测模型、用户模拟器与风格裁判,4 条黑线把 4 轮助手回复都送入同一个裁判节点。教学上要看到两点。一是风格要求只出现在最上方首轮用户气泡,后续用户气泡都是普通追问。二是裁判结论从首轮的快变为后 3 轮的不快,说明内容推进正常但声音约束丢失。这正是后文用数字量化的对象。
风格指令与话题从哪里来,如何拼成输入?
风格指令覆盖 4 类副语言属性。情绪包括悲伤、高兴、生气、中性。口音包括北美英语与印度英语。音量包括大声与小声。语速包括快与慢。
每轮评测只用一种风格,不组合多种,因为论文报告单风格已经守不住。指令默认放在首轮用户消息里,系统消息的对比是后文专门实验。
话题来自 Soda 社会对话数据集。做法是用叙事背景加原始首句,请文本模型改写成更自然、更开放、适合与助手多聊几轮的 opener,并过滤不适合机器聊的个人指向话题。最终保留 100 个 opener,与 10 种风格交叉得到 1000 段对话。语速快慢的例子就是如何驱散困意,话题本身不带风格要求,避免干扰裁判。
口语语言模型 × 级联基线: 口语语言模型负责端到端听懂语音并直接生成语音,承担风格表达的主体;级联基线负责把识别、文本回复与语音合成拆开,每轮都重新读入风格要求,承担可稳定复现的对照作用,二者搭配才能区分是任务本身难还是端到端模型在多轮中丢了约束。
用户模拟器 × 风格裁判: 用户模拟器负责产生下一轮语音输入,维持话题自然推进;风格裁判负责只判断本轮语音是否符合目标风格,不评价内容好坏,二者分工使交互过程与评价标准解耦,组合后才能在真实多轮轨迹上做逐轮打分。
裁判与指标如何计算,信号型与模型裁判有何不同?
指标计算分两步。先对每个风格与每个话题的每轮语音得零或一,再按 100 个话题平均得到该风格该轮的遵循率。首轮率是参照,退化率是后 3 轮与首轮差的平均且截断负值。论文还用文本模型评语义连贯性,确认对话内容没有崩,但这不是主指标。
裁判按风格类型不同。情绪用 Emotion2vec-Large 在高兴、悲伤、生气、中性 4 类中取最大概率。口音用 Voxlect 方言模型在北美与印度英语中取最大概率。音量用量化响度的 LUFS 与中性朗读基线做相对比较,大声要求高于基线、小声要求低于基线。语速用每分钟词数与同一文本的中性合成基线做相对比较,快要求高于基线、慢要求低于基线。前两者是学到的感知模型,后两者是确定性信号比较。
首轮指令遵循率 × 退化率: 首轮指令遵循率负责度量模型在刚听到风格要求时能不能做到,承担能力上限的参照;退化率负责度量后 3 轮相对首轮平均掉了多少,只计变差不计变好,承担多轮保持能力的度量,二者搭配才能区分首轮就不会与首轮会但守不住。
语义风格 × 声学风格: 语义风格指转写文本在用词上是否带情绪,由文本分类器判断;声学风格指声音本身的音色、韵律是否带情绪,由语音情绪模型判断,二者搭配才能检验退化是只丢了声音还是连用词一起丢了。
本研究训练了什么,没有训练什么,真实计算是什么?
本研究没有训练任何被测语音模型,也没有微调裁判模型。所有被测模型都是直接调用。3 个专有模型为 GPT-4o、GPT-4o mini 与 Gemini Live,两个开源端到端模型为 Qwen2.5-Omni 与 Step-Audio 2 mini,另有一个级联基线由语音识别加 GPT-5 mini 加语音合成组成。论文未报告被测模型的训练数据配比与内部梯度路径,因此不能从模型名字推定实现,也不能把无训练等同于输出确定。温度设为一,因为贪心解码在部分模型会出现尾部长时间静音,其余超参数用官方示例默认值。
真实计算是仿真交互与自动打分。用户模拟器内部是识别转写、文本模型续写、语音合成回传的级联。文本续写被要求保持口语、每轮 20 词以内、避免不可朗读的符号。裁判侧是情绪与口音模型推理加响度与语速的信号测量。回忆实验的正确性由 GPT-5 mini 按给定提示判 ABCD 4 类。
人工验证部分是在众包平台抽 720 段、每段 3 人标注,用多数投票得标签,再算 Kappa 与 MCC。资源状态方面,未发现来源绑定且完成验证的资源,不得声称代码、模型或数据已公开。
测了谁,对比是否公平,失败样本怎么算?
被测对象共 6 个。5 个是端到端语音模型,覆盖全双工流式、思考者与说话者分离、音频文本交错等不同架构。第 6 个是级联基线,它的合成器每轮都重新读入风格要求,因此可视为性能上界。话题、轮数、模拟器、裁判对所有被测模型一致。开源模型用官方加速推理实现以加快评测。
公平性细节需要核对。音量与语速用相对基线,避免 loud 与 fast 缺乏绝对定义。情绪与口音裁判经过人工验证,口音裁判与人的一致性更高,情绪主观性更大。GPT-4o 系列偶发只回文本不回语音,论文做法是最多重查 3 次仍失败则只在成功样本上计算,并在附表报告成功数。语义连贯性单独打分,确认退化不是因为对话崩了。注意力分析只在开源的 Step-Audio 2 mini 上做,因为只有它能拿到内部注意力矩阵。
主结果:首轮尚可,多轮守不住吗?
先看悲伤风格的逐轮曲线,这是风格遗忘最直观的证据。论文报告第一轮多数模型尽力遵循,但后 3 轮迅速下滑。专有模型起点较高但下滑明显,开源模型在部分情绪上起点就低。级联基线跨轮稳定,退化在百分之几以内,说明任务可解,端到端模型的下滑不是话题本身导致。
下面这张悲伤风格曲线图把 5 类端到端模型的 4 轮轨迹放在同一坐标下,是复述主结论的关键。
看图路径: 1. 确认横轴为助手轮次 1 到 4,纵轴为指令遵循率百分比;2. 比较首轮位置五条曲线的起点高低与后三轮的斜率;3. 找出下降最陡与起点最低的两类模型轨迹
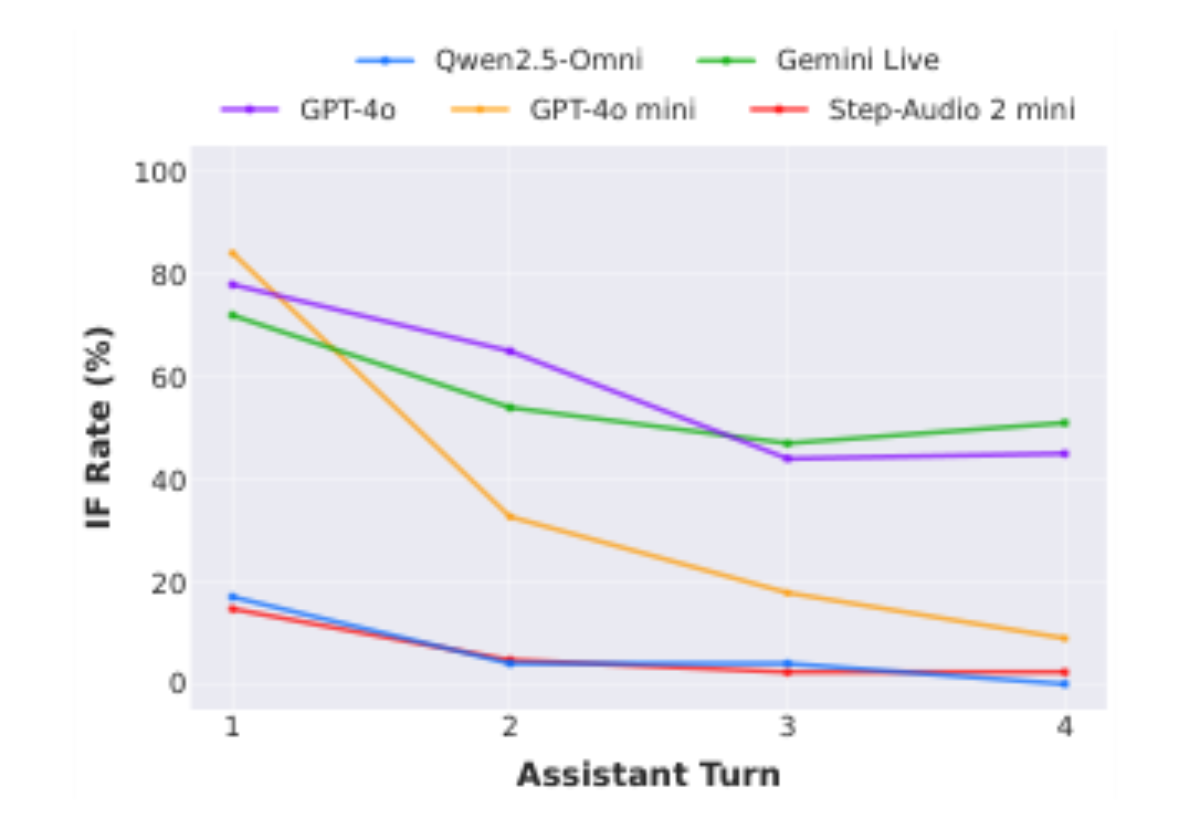
论文图 1。原论文 Figure 1:“When instructed to consistently speak sadly throughout the conversation, SLMs try their best to follow the instruction in the first turn, but the instruction- following rate…”。
这张图像素显示横轴为助手轮次一到四,纵轴为指令遵循率百分比。紫色与绿色等起点较高的曲线在第二轮明显下折,橙色曲线下折最陡,蓝色与红色起点低且全程贴底。读图时不要硬读像素无法精确辨别的数值,关键是起点与斜率的对比。后文柱状图会给出首轮率与退化率的具体配对。
主结果的数字配对显示,情绪中的愤怒与悲伤退化最大,口音中的印度英语在 GPT-4o mini 上退化近半,语速上多数模型首轮合理但随轮次收敛,音量上大声比小声更难。默认风格是重要反例。高兴、中性与北美口音退化小,论文用速度与音量评测中的附带分布验证多数模型默认就是高兴或中性加北美口音,因此不是它们多轮保持好,而是起点就是默认态。Qwen2.5-Omni 在语速首轮低于 50%,接近随机基线,说明它不是遗忘而是首轮就不会。
| Model Style Turn | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| Fast | 100.0 | 61.0 | 51.0 | 46.0 |
| Fast | 88.0 | 69.0 | 70.5 | 64.0 |
上表是原文复合风格实验中逐轮遵循率的原表选择,用于展示即使是相对能守住的组合,后续轮次仍会下滑。表前的问题是固定风格能否在引入第二种风格后继续保持,公平条件是第一轮给印度英语、第二轮再加慢速,指标方向是越高越好。表后需要说明主要收益与代价。单看该表可知快风格从首轮高位逐轮走低,说明多轮保持仍难。但该表宽度有限且只含两行,不能单独证明全部结论,必须结合下表的主结果区间一起读。
同时要记一个未胜出项。开源模型在印度口音首轮仅三十余且北美默认强,说明口音控制本身就不均衡。
退化有多大,基线与可运行策略差多少?
这一节把主结果的量级与缓解策略放在同一框架下比较。比较问题是端到端模型的退化是否显著大于每轮都提醒的级联基线,以及显式回忆这一实际可运行策略能挽回多少。公平条件是同一百话题、4 轮、同一裁判。指标方向是首轮率越高越好,退化率越低越好。回忆策略不需要改权重,只需在每轮用户输入前加问一句该用什么风格并让模型复述,因此是可部署的,但代价是多 1 次交互延迟与额外语音轮次。
下面柱状总览把 10 种风格的首轮率与退化率并排,是定位哪种风格最脆弱的依据。
看图路径: 1. 先按每小格标题确认当前是情绪、口音、音量还是语速;2. 在每组六个模型中对比深蓝色首轮柱与橙色退化柱的搭配;3. 重点看悲伤与印度口音格中橙色柱异常增高的模型
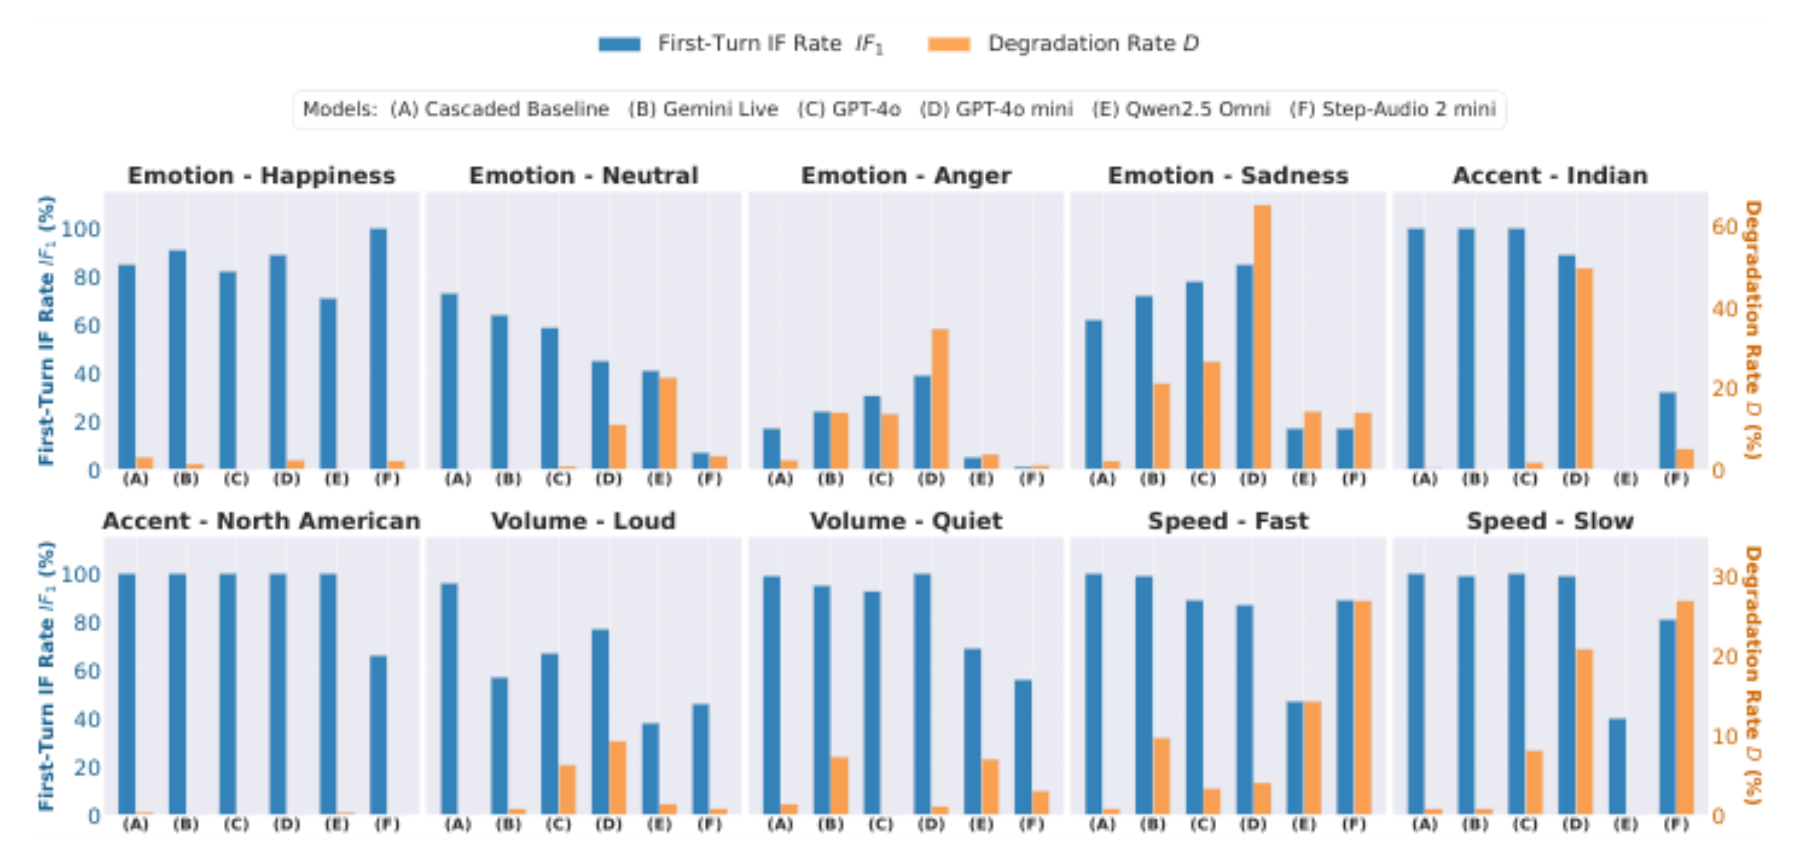
论文图 3。原论文 Figure 3:“The first-turn IF rate IF1 and degradation rate D across different speaking styles.”。
这张图像素为上下两排共十格,每格标题标明情绪、口音、音量或语速的具体取值,每组六根深蓝柱为首轮率、橙色细柱为退化率。观察动作是先看悲伤格中橙色柱远高于其他情绪格,再看印度口音格中个别橙色柱的异常,最后看北美口音格中深蓝柱普遍顶满而橙色几乎为零。结合正文可知悲伤与愤怒、印度口音、语速快慢是重灾区,而北美口音的高分是默认口音所致,不能解读为保持能力强。
| 对比维度 | 风格条件 | 级联基线退化 | 端到端退化区间 | 可运行策略效果 |
|---|---|---|---|---|
| 情绪保持 | 愤怒与悲伤 | degradation within 3.0% | ranging from 13.7% to 26.7% for Anger and Sadness | reaching 34.7% and 65.3% for Anger and Sadness |
| 记忆与表达 | 悲伤与慢速等多轮 | recall rate of 55.0% to 89.0% | roughly a 25% reduction in the average degradation rate | demonstrating the effectiveness of the recall process |
| 未胜出边界 | 默认风格 | degradation within 3.0% | ranging from 13.7% to 26.7% for Anger and Sadness | recall rate of 55.0% to 89.0% |
上表数字全部来自原文连续句的逐字证据,单位保留百分号写法。表后解释主要收益与代价。收益是回忆策略在 GPT-4o mini 这类退化大的模型上平均挽回约 1/4,悲伤与慢速等难风格仍记得住指令,说明遗忘不是记不住而是做不出。代价是开源模型回忆率低至 50% 多,回忆本身也会失败,且每轮多 1 次问答增加成本。未胜出项是 Step-Audio 2 mini 在部分风格上回忆后退化几乎不变,说明仅靠提醒不能解决声学控制弱的问题。统计上论文未报告显著性检验,因此区间比较只能说支持缓解,不能说必然因果。
为什么会忘,放在系统消息里会更好吗?
机制分析有 3 条。第一是注意力稀释。在 Step-Audio 2 mini 上统计风格指令 token 在生成时的平均注意力,首轮约 8%,第 4 轮掉到 0.6% 以下,与遵循率下滑同向。这支持长上下文中全局风格约束被稀释,但只是相关证据,不是因果证明,因为未做干预注意力的对照。
第二是提示位置。文本模型中系统消息本应优先级更高、适合放全局约束,但语音模型结果相反。放在系统消息时 GPT-4o、GPT-4o mini 与 Step-Audio 2 mini 的悲伤首轮掉约 30%、50%、20%,印度口音在 GPT-4o mini 上掉近 80%,语速指令几乎被忽略到随机基线。且两种位置都会随轮次遗忘。因此复现时应把风格放在用户消息,后文回忆实验也如此。
第三是文本与声音是否一起丢。情绪上语义与声学同时退化,说明用词与声音一起变回默认。语速上首轮策略不同,Gemini Live 靠减少词数提速,GPT-4o 与 Step-Audio 靠压缩时长提速,但后 3 轮快慢条件下的每分钟词数差距收敛,说明声学区分能力丢失。
回忆过程的插图把缓解策略的操作讲得很具体,是复现时最值得照抄的部分。
看图路径: 1. 沿从上到下三段看首轮回答、中间回忆问答、下一轮回答的顺序;2. 注意中间提问与模型复述风格要求的具体措辞;3. 对比回忆前后两轮括号标注的风格标记是否重新出现
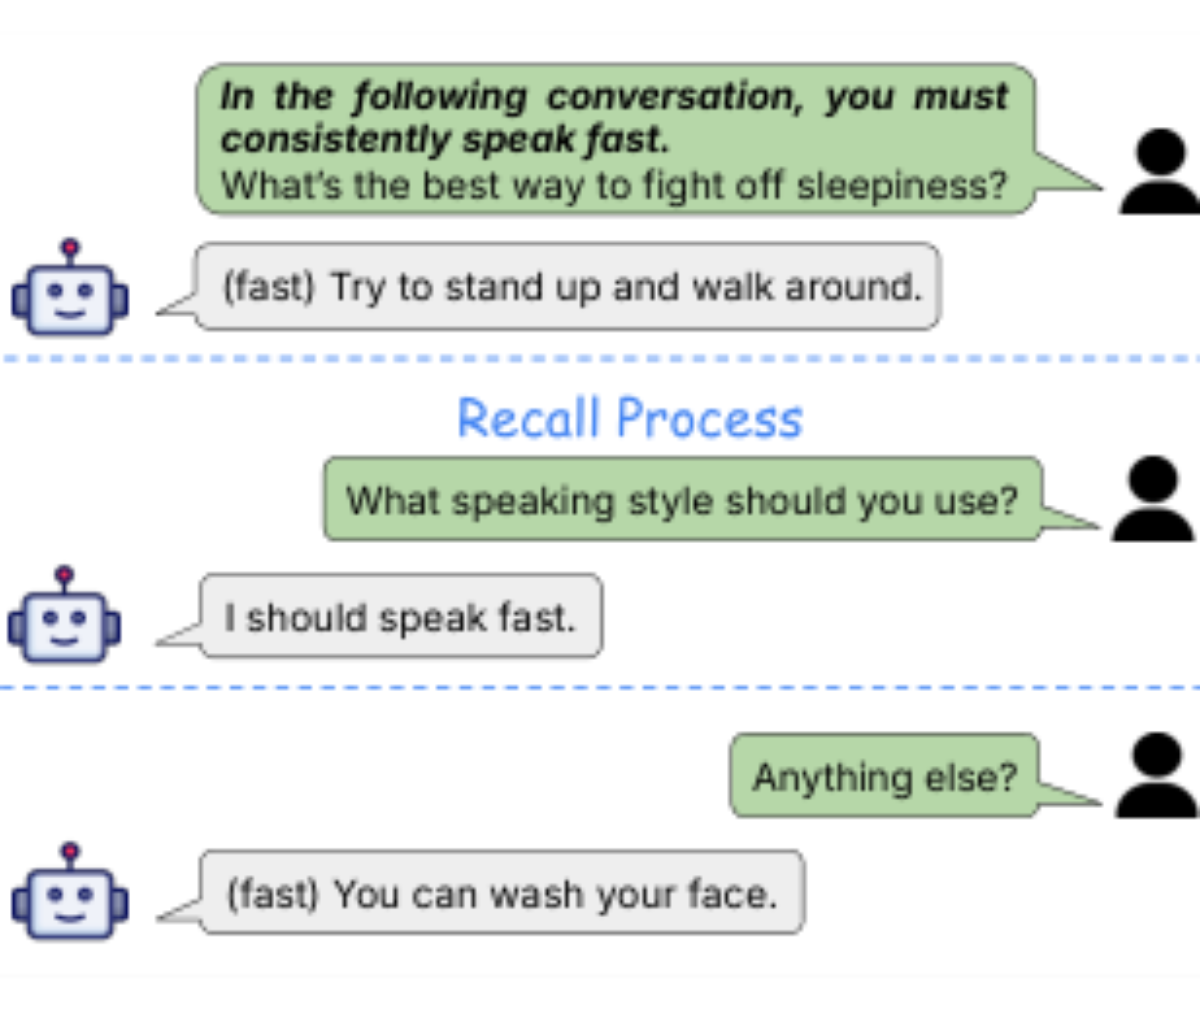
论文图 8。原论文 Figure 8:“The illustration of the recall process.”。
这张图像素自上而下分 3 段。顶段是首轮用户要求一直快说加话题,中段蓝色标题标出回忆过程并插入你该用什么风格的追问与我应该快说的复述,底段是下一轮普通追问与带快标记的回答。读图要抓住回忆问答发生在用户下一问之前,且复述内容就是首轮风格的原文改写。这意味着缓解不是换裁判或换模型,而是把隐式约束显式化。代价是流程变长,附带的组合风格与动态换风格实验显示多风格叠加与中途换情绪仍会大幅下滑,回忆不能包治百病。
哪些结论站得住,哪些还不能说?
站得住的是跨架构的系统性退化。从全双工流式到思考者说话者分离再到音频文本交错,风格遗忘都出现,且级联基线稳定,因此不是单一训练配置的偶然。站得住的还有记得住但做不出。专有模型回忆率近满分却仍退化,开源模型回忆率虽下滑但仍远高于其声学遵循率。
不能说的是因果与成本。注意力下降与遵循率下降只是伴随,未测量误判率、延迟与推理开销,不能承诺回忆策略改善了时延或成本。情绪裁判主观性大,与人的一致性低于口音裁判,不能把自动分当人评。角色扮演等多风格组合缺乏可靠裁判,论文明确未大规模评测。训练数据未公开,不能分析数据配比对遗忘的影响。百分点与相对百分比不同,引用退化率时要说明是相对首轮的绝对差平均,不是相对变化率。
要复现,先准备什么,先跑哪组?
复现先做最小闭环。准备 100 个开放话题,选定一种难风格例如悲伤或快,固定 4 轮。用同一文本模型与同一合成器做用户模拟器,温度与提示按原文口语化约束固定。裁判按风格类型分别实现。情绪与口音用原文指定模型,音量用响度相对基线,语速用每分钟词数相对基线。先跑级联基线确认流程无误,再跑一个专有模型与一个开源模型,画出首轮率与退化率。
再跑两个诊断。一是把风格从用户消息移到系统消息,看首轮是否下降。二是加入回忆问答,看退化是否缩小,同时记录额外轮次与失败复述。注意力分析只在能拿到权重的开源模型上做。资源方面,本次未能确认可达的链接一律写本次未能确认可达,不声称已公开。超参数保留温度为一与官方默认值,失败语音按最多重试 3 次、仅在成功样本上计算并报告成功数。
何时值得尝试显式回忆,还需补哪项验证?
当应用允许用户只说 1 次风格、且能接受每轮多 1 次短问答时,值得尝试显式回忆。它不改模型,只靠复述把约束拉回上下文,对退化大的模型收益更明显。但当模型首轮就不会,例如某些开源模型的愤怒与语速控制接近随机,或回忆率本身很低时,应先补声学控制能力,而不是只加提醒。当系统消息是唯一全局通道时,需先验证语音模型是否真的听系统消息,否则应把风格放在用户消息。
还需补三项验证。一是人评验证情绪与口音的误判方向,避免裁判偏向默认风格。二是延迟与成本测量,把挽回的百分点换算成每轮多花的 tokens 与秒数。三是动态换风格与多风格叠加的逐轮报告,确认回忆在真实需求下的边界。这些补齐后,才能把风格保持从单轮演示推进到多轮可用。
📐 原文公式与排版
以下展示论文原页中的数学表达区域,保留原始上下标、分式和符号排版。区域序号仅用于本文导航,不是论文公式编号。

区域 1 · 查看论文原页
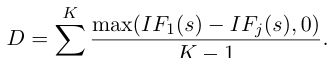
区域 2 · 查看论文原页

区域 3 · 查看论文原页

区域 4 · 查看论文原页
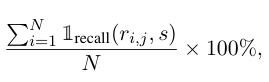
区域 5 · 查看论文原页
另有 3 个候选区域因边界不明确或图片数量、尺寸限制未展开;请查看完整论文中的原始排版。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses