英文题目:WoW-Bench: Evaluating Fine-Grained Acoustic Perception in Audio-Language Models via Marine Mammal Vocalizations
会议身份:
conference:acl:2026:conference-paper-id:2026.findings-acl.1562
✅ 来源为官方会议 PDF;可重放的表格、公式文本与 Figure 像素已按 PDF 抽取结果绑定,未成功恢复的结构不作推断。
标签:#基准测试 #基准设计 #音频大模型 #生物声学 #音频问答
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.0/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:数据集与基准
👥 作者与机构
- Jaeyeon Kim:机构信息未能从会议 PDF 纯文本可靠映射
- Heeseung Yun:机构信息未能从会议 PDF 纯文本可靠映射
- Tony Woo:机构信息未能从会议 PDF 纯文本可靠映射
- Chao-Han Huck Yang:机构信息未能从会议 PDF 纯文本可靠映射
- Gunhee Kim:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
该基准输入为海洋哺乳动物发声片段与四选一文本问题,输出为选项字母,要求模型在陌生声学域中完成物种与发声类型判别及细粒度听觉比较,难点在于剥离语义先验后仍需分辨音高、时长与序列转折等低层细节。方法链先从Watkins数据库筛选音频并用大语言模型结合频谱图与元数据生成感知与认知题干,其输出进入三名标注者交叉听辨的质量控制执行接受、修订或丢弃并改写选项以阻断词汇捷径。质控后的题干再按Bloom分类学的记忆、理解、应用与分析组织常规题与反期望干扰题,使同段音频对应相反正确答案以检验推理迁移的失效。相对覆盖日常声音的AIR-Bench与MMAU等基准,关键机制差异是以分布外海洋哺乳动物声音阻断语义联想,并以相同声音选不可区分等干扰项强制验证真实聆听而非推理迁移。人类与跨基准对比显示MMAU高分并不迁移至WoW-Bench,而非专家仍在时长比较等认知任务上占优,体现了低层听觉评估的实际意义。在物种分类任务评测下,Qwen2-Audio-Instruct在VGGSound条件下的准确率为76%,高于在WoW-Bench条件下的28.3%。该结论适用边界受限于单片段多选题与海洋哺乳动物声学域,尚未验证开放式描述、重叠声景及陆地语音音乐的外推性,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://github.com/bytedance/SALMONN — 链接可访问(HTTP 200)
- 第三方资源:https://github.com/YuanGongND/ltu — 链接可访问(HTTP 200)
- 第三方资源:https://github.com/Sreyan88/GAMA — 链接可访问(HTTP 200)
- 第三方资源:https://github.com/QwenLM/Qwen-Audio — 链接可访问(HTTP 200)
- 第三方资源:https://github.com/QwenLM/Qwen2-Audio — 链接可访问(HTTP 200) 预印本/扩展版链接未在会议页展示;会议版来源见页首官方记录与 PDF。 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,要解决的听觉问题是什么?
本文解读的对象是 WoW-Bench,一个面向音频语言模型的评测基准。输入是海洋哺乳动物叫声录音,全部配成四选一选择题。目标不是测模型会不会讲故事或做常识推理,而是测它在陌生声音面前能不能听出细微声学差别,并基于听到的内容完成判断。
对刚进入语音音频领域的研究生,先要区分两个词。白话说,低层听觉就是听出多高、多长、是哨声还是脉冲声、有没有从一段声变成另一段声。英文是 low-level listening。语义分类就是给声音贴标签,例如这是猪叫、这是引擎声。英文是 semantic categorization。当前很多音频语言模型习惯先贴标签再反推声学性质,遇到没见过的声音就容易错。
论文要保留的关键信息是:评测只用选择题,音频来自 Watkins 海洋哺乳动物声音数据库,题目分感知与认知两大部分,总量为 1777 对问答加音频。输出是模型选出的字母选项,用正则加模型辅助抽取后算正确率。理解这套输入输出后,才能复述后续方法为什么要这样设计。
已有评测在测什么,为什么还缺低层听觉?
已有音频语言模型评测大多围绕高层能力展开。按论文梳理,组合推理、时间推理、文本蕴含、长音频理解、多步推理都有对应基准,覆盖语音、人声、通用声音和音乐。代表性工作包括评估复杂事件组合的 CompA、评估多事件时间推理的工作、评估音频条件文本蕴含的工作,以及面向长音频的工作。
这些工作的共同输入是日常分布内的声音,目标是看模型能否对已经感知到的事件做推理。监督和运行阶段也多是常规问答或字幕式理解。论文指出,这类设计难以分离两种成功:模型是真听见了,还是因为见过同类声音而靠先验猜对。
与之对照,ADIFF 强调比较两段音频的差异,MMAU 强调跨音频类型的信息抽取与推理,相对更靠近感知。但论文认为它们仍未系统控制分布外条件。WoW-Bench 的差异在于明确用罕见海洋哺乳动物叫声构造分布外输入,并把布鲁姆层级的操作化为可评分的听觉任务,从而把低层听觉从语义推理中剥离出来单独检验。
为什么选海洋哺乳动物叫声做分布外输入?
问题定义可以复述为:在模型不熟悉标签和音色的条件下,能否靠听觉细节完成分类、回忆、描述、比较和转折分析。论文选择海洋哺乳动物叫声,理由是常见语料中相关标签极少。原文交代 AudioSet 只有一类相关标签,VGGSound 有两类,ESC-50 和 FSD50K 没有相关标签。
这不是随意换数据源。论文做了一个对照:把物种分类换成 VGGSound 中的常见动物叫声后,Qwen2-Audio-Instruct 的准确率从 WoW-Bench 上的低位显著上升到常见动物上的高位。这说明一旦回到熟悉分布,记忆和语义联想就会介入,测到的就不再是纯听觉。
对初学者要记住一个例子关系:熟悉域好比考见过的单词,分布外好比考没见过的发音。例子仅用于理解,不代表论文报告了单词记忆的具体数值。论文的判断是,只有用真正陌生的声音,才能减少声学先验的影响,让评测更受控。
基准全景:感知与认知如何分工?
WoW-Bench 全景分两块。感知基准测能否把陌生声音映射到陌生标签,包括物种、发声类型、两者组合三项任务。认知基准测能否对听到的细节做加工,包括记忆、理解、应用、分析 4 个层级,共 6 个子任务。所有题目都是选择题,目的是让人类也能通过比较选项完成判断,并实现标准化评分。
拿一个样本走完全流程有助于建立依赖关系。输入是一段叫声。表示可以是波形或声谱图。组件按题型提问:感知题问这是哪个物种或哪种发声,认知题问哪段与参考音相同、哪段音更高或更长、序列中哪里发生转折。目标是从 4 个选项中选出与听觉一致的一项。
输出是字母。先有输入与表示,再有组件提问,最后才有目标与输出,这个顺序不能颠倒。
下图是全文总览,左侧是输入,中间是任务划分,右侧是人与模型的性能包络,阅读时先看结构再看差距。
看图路径: 1. 先从左侧海洋哺乳动物叫声与噪声输入看起,确认两类音频都进入评测;2. 再看中间蓝色感知三任务与绿色认知四层是如何分组排列的;3. 最后看右侧雷达图中人类与音频专家包络是否明显大于模型包络
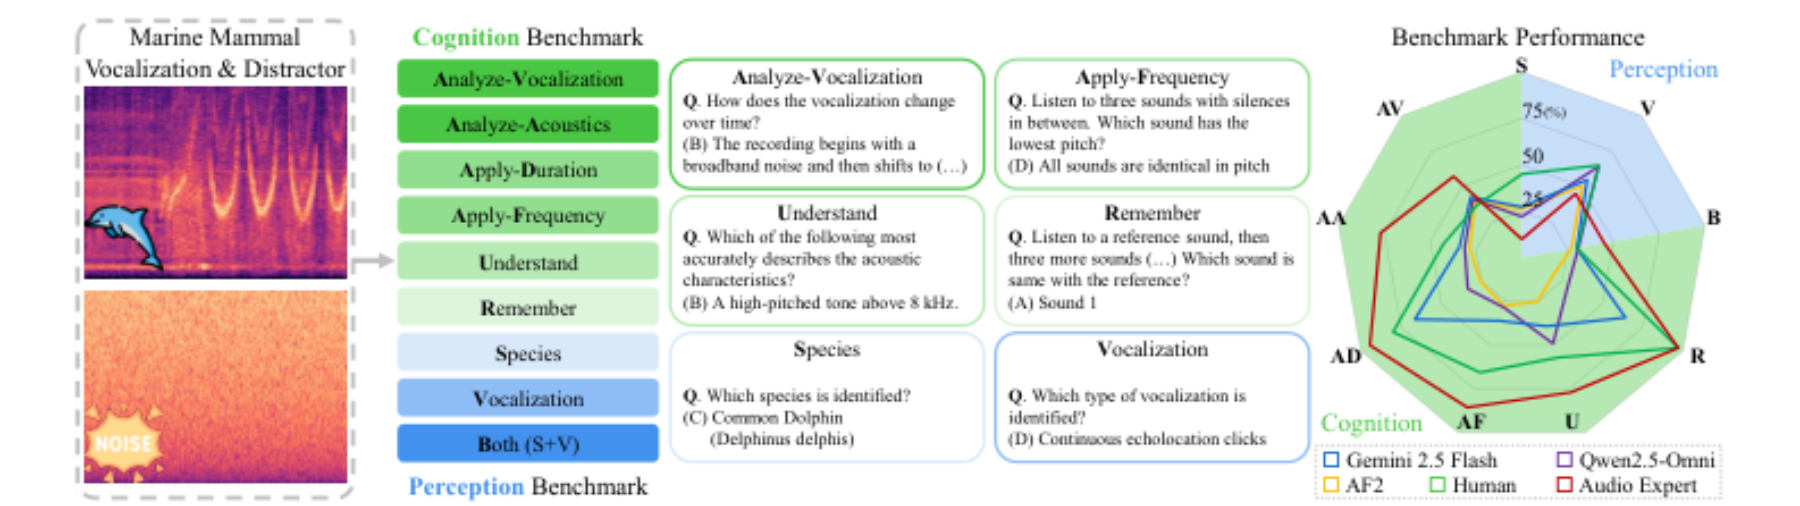
论文图 1。原论文 Figure 1:“World-of-Whale benchmark aims to evaluate low-level listening capabilities of LALMs using marine mammal vocalizations, which are rarely represented in conventional datasets and…”。
从图中可见,左侧同时给出真实叫声声谱图和噪声干扰项示意,中间蓝色块对应感知三任务,绿色块对应认知多任务,右侧雷达图把感知与认知放在同一极坐标下比较。人类与音频专家的包络在认知方向明显外扩,而多个模型的包络向内收缩,这与论文强调的人能听出而模型听不准的主张一致。该图不提供具体数值,数值以后文表格为准。
感知三任务:物种、发声类型与组合在测什么?
感知部分有 3 个任务。物种任务要求把叫声判为座头鲸、虎鲸等具体物种,做法是零样本映射,模型要把细微听觉线索与已有物种知识对齐。发声类型任务要求选择 clicks、whistles、calls 等自然语言描述,有时还带高音、船噪声等声学修饰,标签更直观,更依赖感知匹配而非先验知识。两者组合任务要求同时答对物种加发声类型,例如豹海豹长叫,考察组合听觉。
低层听觉 × 语义分类: 低层听觉负责先听出音高、时长、脉冲还是 tonal、是否转折等声学细节,语义分类负责把声音贴上猪叫、水声、海豚等标签;二者搭配的理由是日常评测中标签先验会掩盖听觉错误,WoW-Bench 用陌生叫声迫使模型先完成低层听觉再谈分类,组合意义是把是否真听见与是否认识类别分开诊断。
分布外 × 感知泛化: 分布外指训练常见语料中几乎没有的海洋哺乳动物叫声,感知泛化指在没见过标签和音色时仍能靠细节完成归类;搭配原因是只有切断记忆捷径才能看出泛化,组合后感知题的零样本物种判断就成为对听觉泛化的直接考验。
沿样本复述:输入一段未知叫声后,模型先要听出是连续调制音还是快速脉冲串,再把该细节对应到选项文字。若物种名从未在训练中与该音色配对,模型只能靠听觉泛化完成映射。这正是论文把感知称为新领域泛化的原因。
认知六题与干扰项:如何把听觉变成可判操作?
认知部分按布鲁姆层级展开。记忆题给参考音加 3 段候选音,中间用静音隔开,问哪段与参考音相同。理解题问哪段文字最准确描述低层声学特征,选项同时给感知标签和频率范围,例如 8 kHz 以上上滑高频 tonal 声,以减少歧义。应用题分音高和时长两组,每组给 3 段音,问最高或最低、 最长或最短,不需要理解语义。分析题给无静音拼接的两段音,问转折是什么,细分为声学转折与发声转折两类,且只听一半序列不足以答对。
干扰项是关键探针。记忆题把全部候选项换成与参考音不同,使正确项变为无一相同。应用题把 3 段音换成完全相同,使正确项变为无法区分。理解题把输入换成合成噪声,考察模型是否幻觉出语义。分析声学题把其中一段换成噪声,分析发声题把跨物种转折换成同种重复,考察是否盲目假设有转折。每类干扰项保留原选项形式,使不听音频就容易掉入语言预期。
布鲁姆认知层级 × 认知基准: 布鲁姆认知层级提供记忆、理解、应用、分析的递进定义,认知基准把每一层翻译成可听可判的选择题操作;搭配原因是空谈认知无法评分,组合后每一层都有明确输入输出和判定标准,使低层处理过程可被逐层检查。
对抗干扰项 × 听觉接地: 对抗干扰项通过反转预期答案迫使模型不能靠语言先验蒙对,听觉接地指答案必须随音频变化而变化;搭配原因是只看正确率无法区分真听与猜测,组合后干扰项成为检验接地的探针,答错模式直接暴露分类优先的捷径。
声谱图 × 问题生成: 声谱图把频率随时间的变化可视化,问题生成指用大语言模型加人工校验写出题干和选项;分工是元数据给不出精细声学描述时由声谱图补足依据,搭配后理解与应用类题目才能写出带频率范围的无歧义选项。
这样,认知题的输入组织、表示需求、组件判定和目标输出形成闭环:多段比较题考跨段记忆,单段描述题考特征接地,转折题考关系分析,干扰项则检验答案是否随音频改变而改变。
没有模型训练时,题目是如何构造与校验的?
本研究没有训练新的音频语言模型,training 节对应的是基准构造流程。真实计算过程是题目生成加人工校验,不是梯度更新。论文明确,除记忆题人工挑选候选音外,其余题目用大语言模型生成,理解与应用题因元数据缺少精细声学信息,还会把声谱图交给视觉语言模型辅助生成,分析声学题复用已验证的理解题描述来构造转折。所用生成模型为 GPT-4o 指定版本。
校验流程分 3 类:直接接受、小改接受、丢弃。每题由 3 名有经验标注者对照元数据和音频交叉检查,约 1900 道初生题目中丢弃 112 道,修订 485 道,修订范围从文字风格统一到事实内容更正。选项顺序除记忆与应用题因 sound1 到 sound3 的顺序有功能意义外,其余做随机化,正确项分布接近均匀,额外打乱实验显示标准差小于 1 个百分点。
下图把每类题的题卡与声谱图并列展示,可据此复述构造产物的形态。
看图路径: 1. 先按左中右三列找到感知三题与认知六题的题卡位置;2. 再对照每张题卡旁的声谱图形态与选项文字描述是否对应;3. 最后观察记忆题多图并列与分析题长序列的不同输入组织方式
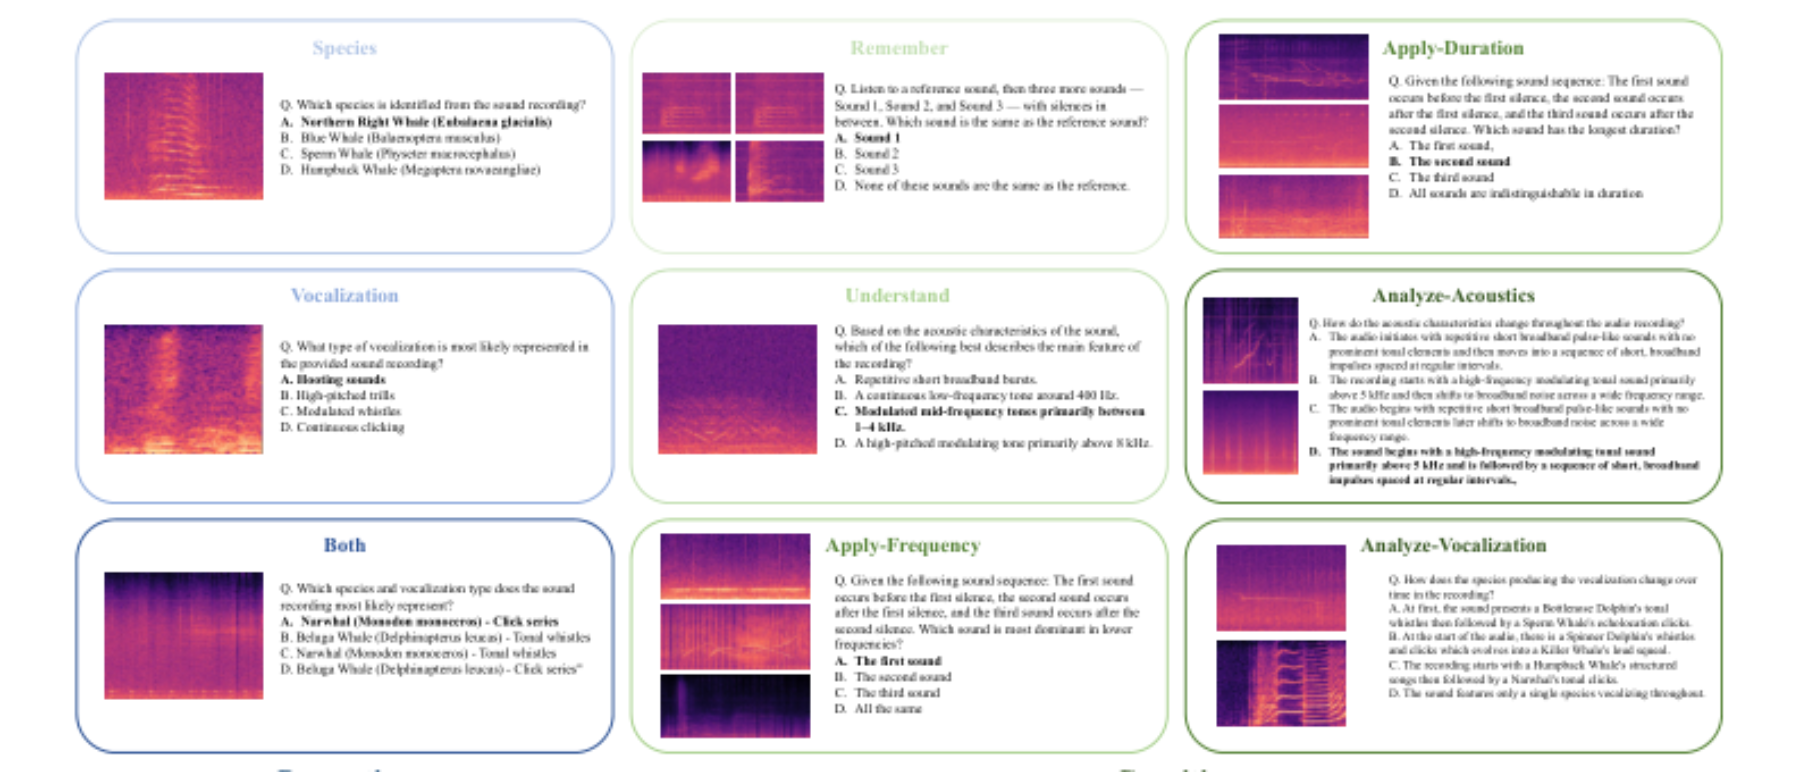
论文图 8。原论文 Figure 8:“Example questions from each task type in WoW-Bench, shown alongside spectrograms of the correspond- ing input audio.”。
图中每张卡包含一段或多段声谱图、题干和 4 个选项。物种与发声卡是单图单问,记忆卡是多图并列,应用与分析卡是序列或拼接形态。观察时注意选项文字是否出现频率范围或时长比较词,这对应生成阶段对声谱图信息的依赖。该图只说明题面形态,不证明模型能力。
测了哪些模型,用什么提示与评分条件?
评测覆盖开源与闭源多类模型,包括 SALMONN、LTU、LTU-AS、GAMA、Qwen-Audio-Chat、Qwen2.5-Omni、Audio Flamingo 2 与 3、Gemini 1.5 Pro、Gemini 2.0 Flash、Gemini 2.5 Flash 与 Pro,附录还补了 GPT-4o-Audio。论文说明刻意排除纯语音模型,因为任务针对非语音听觉。开源推理在一张特定 GPU 与 CPU 条件下单次运行。
提示按任务定制,基本结构是先说明将听到一系列录音,再要求从选项中选最合适者并回传字母。针对不同模型的回答倾向,微调为只回字母或先解释再给字母,取预验证中表现最好的提示。评分用正则抽取字母,对模糊输出用轻量模型做答案映射,无法映射者不计入正确。
人类基线用分层子集完成。从全量中随机抽 5 个小集合,对比 3 个模型在小集合与全量上的差异,选差异最小者作为代表集,共 108 题分两卷,每题 5 人作答,含无经验听众与音频专家。界面提供耳机建议、低中高频与宽带脉冲示例音,禁止搜索引擎,允许字典查词,设不确定选项以减少强迫猜测,并用 Fleiss kappa 评估一致性。资源可用性方面,论文列出的第三方代码与报告链接本次核验为可达,但这只说明链接状态,不代表权重或系统可一键运行。
主结果:人类能听出的,模型差在哪里?
要回答的核心问题是陌生声音下低层听觉是否过关。比较条件是同一选择题协议,指标是正确率,方向是越高越好。论文报告人类在感知上与模型相近,因为都不熟悉海洋哺乳动物,但在认知上人类大幅领先。记忆与比较类任务最能拉开差距。
下表整理记忆任务中最可核对的两组数字,第一组是人类与最强闭源模型的直接对照,第二组是开源模型在记忆与物种上的相对位置及随机基线。阅读时先看任务与指标是否一致,再看差距方向。
| 任务条件 | 指标 | 人类表现 | 模型表现 | 随机基线或对照 |
|---|---|---|---|---|
| Remember 记忆相同音 | 正确率 | 97.1% | Gemini 2.5 Flash 57.1% | 人类大幅领先 |
| Remember 与 Species 对照 | 正确率 | 未报告 | AF2 Remember 19.2%,Species 26.3% | 随机基线 24.8% |
上表显示主要收益与代价。人类记忆题接近满分,说明题目本身可听可判,不是无解题。模型在同题上低约 40 个百分点,说明差距来自听觉而非题面不清。未胜出项是 AF2,其记忆题低于随机基线,也低于自身物种题,说明多段比较与单段分类都未过关。限制是该表只覆盖记忆单点,不能推广到全部认知任务。
下图展示认知各子任务的分布,阅读时注意熟悉域与陌生域的整体下移,以及干扰项下的离散加大。
看图路径: 1. 先对比左侧熟悉声音组与中间陌生声音组的箱体高度与中位线位置;2. 再看右侧干扰项条件下蓝色与黄色箱体的离散范围是否拉大;3. 最后核对叉号均值与中位线的偏离,判断是否存在少数极端值拉动均值
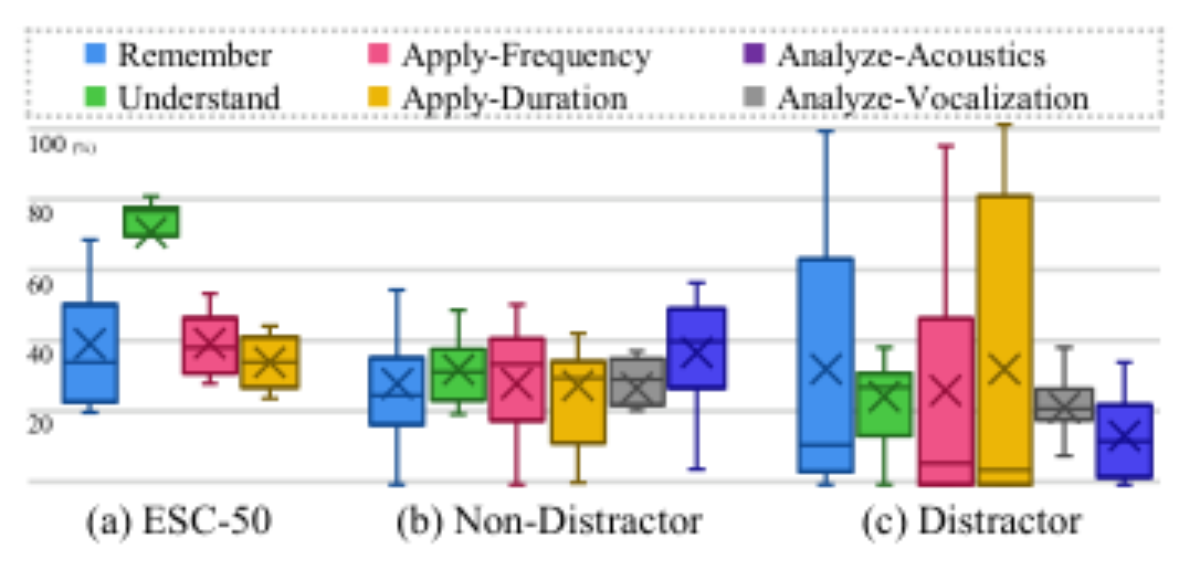
论文图 2。原论文 Figure 2:“Performance distribution across cognition question types, grouped by the presence of dataset and distractor condition.”。
图中左侧熟悉声音组箱体位置较高,中间陌生声音非干扰组整体下移,右侧干扰组部分箱体上下拉长,均值与中位偏离增大。这支持论文判断:挑战主要来自陌生声音本身,而干扰项进一步暴露依赖语言先验的模型。像素不能精确读出的具体数值不硬写,以表格引用的原句为准。
反证:换成熟悉声音与加入干扰项会发生什么?
论文用两类反证分离听与记。第一类把认知题换成 ESC-50 熟悉声音,保持题型不变。若模型真是靠听,换域不应大涨;若靠记忆,熟悉域会显著更好。结果是熟悉域普遍更高,理解题提升尤其明显,采用分类优先策略的模型在频率比较上提升近 20%。这支持陌生域更能测听觉的判断,但也说明应用题结果混杂先验与听觉,不能单看分数就断言听觉好坏。
第二类是干扰项。模型在非干扰与干扰题上出现明显落差,且离散更大。论文报告非干扰与干扰表现呈负相关,意味着在常规题上好的模型未必真听,干扰项下反而可能更差。这与分类优先的定性观察一致:3 段完全相同的音频仍被描述成蝉鸣加蟋蟀,并据此选出最高音。
下表整理分布外与熟悉域的物种分类对照,问题是同为分类任务时记忆是否介入。
| 任务条件 | 指标 | 分布外表现 | 熟悉域表现 | 比较对象 |
|---|---|---|---|---|
| 物种分类 WoW 对 VGGSound | 正确率 | WoW 28.3% | VGGSound 变体 76% | Qwen2-Audio-Instruct,示例含 Baltimore oriole 与 pigeon |
| 物种与组合整体 | 正确率 | 接近随机猜测 | 未报告 | 模型缺知识或抓不住细微差别 |
表后解释:熟悉域大涨的代价是失去分布外受控性,收益是证明低分不是题型太难,而是声音陌生。未胜出项是物种与组合任务本身,多数模型接近随机,说明零样本物种映射仍是短板。未评测边界是重叠声源与强背景噪声,论文在局限中明确未覆盖。
下图是 3 组相关性散点,分别对应基准类型、干扰项存在与单多片段,可据此判断能力是否同源。
看图路径: 1. 先看左图感知分数与认知分数散点是否沿对角线上升;2. 再看中图非干扰项分数越高时干扰项分数是否反而走低;3. 最后看右图单片段与多片段分数是否同向变化
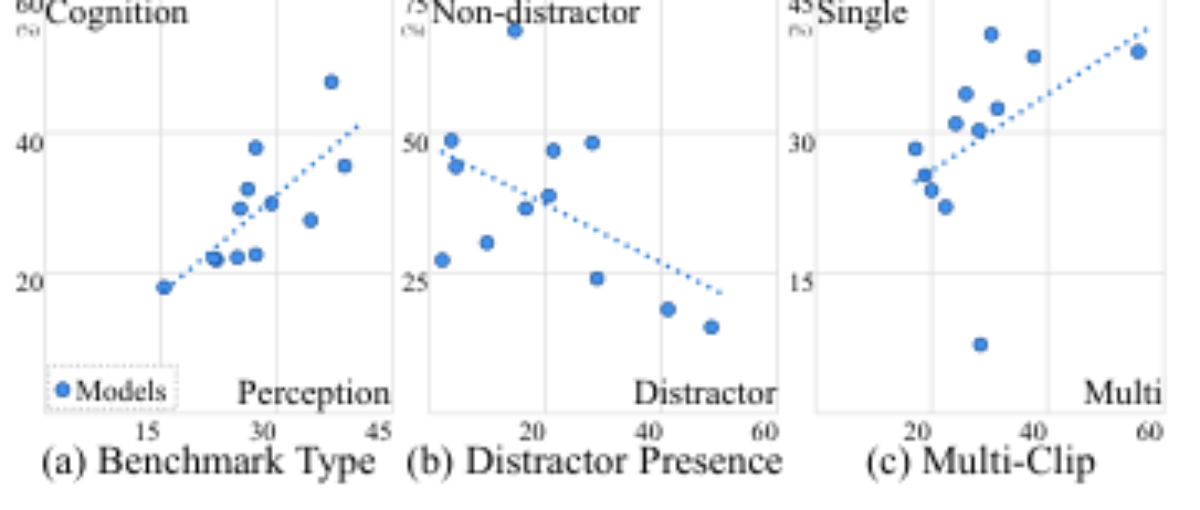
论文图 3。原论文 Figure 3:“Distribution of models’ performance regard- ing (a) benchmark type, (b) distractor presence, and (c) multi-clip, where we observe the Pearson correlation of 0.75, -0.51, and 0.47…”。
左图感知与认知同向上升,相关约 0.75,支持两者共享低层听觉。中图非干扰越高干扰越低,相关为负,支持捷径假说。右图单片段与多片段正相关约 0.47,说明多段比较差不全是架构不支持拼接,多由听觉本身驱动。但总体趋势不等于每模型每题都成立,个别点明显偏离拟合线,复现时应逐任务检查而非只看平均。
哪些结论不能下,缺了哪些验证?
论文明确三项局限。第一,只用海洋哺乳动物叫声,结论不能直接搬到陆地生物声学、人类语音或重叠声场景。第二,只用选择题,测不到开放描述与生成能力,离散评分与真实连续听觉推理仍有距离。第三,部分认知多段题既考听觉也考多音频处理架构,低分不能全归因于听觉。
表达上要区分层次。直接报告的是正确率与分布形态,有限解释是分类优先导致错误,待验证的是如何改进听觉接地与频谱覆盖。未测量误判率、延迟、训练与推理成本时,不承诺这些量得到改善。采样率与时长分析显示无尖锐阈值,开源模型常用 16 kHz 条件下仍有可听信息未被利用,但这只是相关性观察,不是因果证明。
下表是基准规模的构成,用于限定结论适用范围,避免把单点结果推广到全域。
| 基准划分 | 指标 | 感知规模 | 认知规模 | 备注 |
|---|---|---|---|---|
| WoW-Bench 总量与分组 | 问答对数量 | 感知 296 对,含 Species 99,Vocalization 97,Both 100 | 认知非干扰 1477,干扰 300,共 1777 | 每干扰子任务 50 对 |
表后说明:规模收益是认知题更多且可做干扰对照,代价是感知题部分依赖先验知识,当前模型与人类都接近猜测。复现时应把认知分作为听觉主指标,感知分作为泛化参考,不把自动指标当成人评,也不把不同指标的差值混入同一模型列比较。
要复现这套评测,先做什么、用什么条件?
复现先做三件事。第一,准备音频与题面。音频来自 Watkins 数据库,需经许可用于研究,注意无个人身份信息。题面按论文示例组织:记忆题是参考音加 3 段候选音以静音隔开,理解题选项带频率范围,应用题明确最高最低或最长最短,分析题用无静音拼接并保证只听一半不足以答对。
第二,固定提示与抽取。提示写清先听后选并回传字母,对冗长模型允许先解释再给字母,正则抽字母,模糊者用辅助模型映射,无效回答剔除而非算对。选项顺序除记忆与应用的功能顺序外做随机化,并记录打乱种子以检查偏差。
第三,跑对照而非只跑平均。必跑干扰项对照,观察答案是否随音频反转而改变;必跑熟悉域对照,用 ESC-50 同题型验证提升是否来自记忆;必跑人类小集合,用代表性子集校准题目可解性。关键超参数与信息条件是音频采样率与时长分组、干扰音频的时长与采样率匹配、合成噪声类型覆盖。代码开源、权重下载与系统可运行是三回事,论文给出的是方法与题型描述,复现者还需补足音频切分、拼接静音长度与播放电平的具体实现细节。
何时值得尝试这套思路,还需补哪项验证?
当你的模型在日常声音上分数很高,但你怀疑它是靠标签记忆而非真听见时,值得用陌生域加干扰项的思路做 1 次体检。适用条件是任务可转为选择题,且能构造出反转预期的音频,例如全同 3 段音、全异候选、噪声替换一段。若模型在非干扰题上好而干扰题上差,或熟悉域大涨而陌生域低迷,就应优先修听觉接地而非堆高层推理。
常见误解是把低分简单归为模型没见过鲸。论文的人类结果反驳了这一点:没见过也能靠听完成记忆与比较。另一误解是把多段题差归为架构不支持拼接。单多片段正相关说明听觉仍是主因,架构只是叠加因素。
还需补的验证包括重叠声与强噪声下的表现、开放描述的可评分协议、更宽频谱的感知保真度,以及干扰项下错误类型的自动标注。做完这些,才能把从选择题上看到的听觉差距,转化为可部署的音频理解改进。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses