英文题目:MMAC: A Multilingual, Multimodal Alignment Framework for Cultural Grounding Evaluation
会议身份:
conference:acl:2026:conference-paper-id:2026.acl-long.989
✅ 来源为官方会议 PDF;可重放的表格、公式文本与 Figure 像素已按 PDF 抽取结果绑定,未成功恢复的结构不作推断。
标签:#基准设计 #多语言 #音视频 #音频问答
评分:6.8/10 | 创新 1.6/2 | 技术严谨 1.2/1.5 | 实验充分 1.0/1.5 | 清晰度 0.7/1 | 影响力 1.0/1.5 | 开源 0.0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:数据集与基准
👥 作者与机构
- Weihua Zheng:机构信息未能从会议 PDF 纯文本可靠映射
- Zhengyuan Liu:机构信息未能从会议 PDF 纯文本可靠映射
- Tanmoy Chakraborty:机构信息未能从会议 PDF 纯文本可靠映射
- Weiwen Xu:机构信息未能从会议 PDF 纯文本可靠映射
- Xiaoxue Gao:机构信息未能从会议 PDF 纯文本可靠映射
- Bryan Chen Zhengyu Tan:机构信息未能从会议 PDF 纯文本可靠映射
- Bowei Zou:机构信息未能从会议 PDF 纯文本可靠映射
- Chang Liu:机构信息未能从会议 PDF 纯文本可靠映射
- Yujia Hu:机构信息未能从会议 PDF 纯文本可靠映射
- Xing Xie:机构信息未能从会议 PDF 纯文本可靠映射
- Xiaoyuan Yi:机构信息未能从会议 PDF 纯文本可靠映射
- Jing Yao:机构信息未能从会议 PDF 纯文本可靠映射
- Chaojun Wang:机构信息未能从会议 PDF 纯文本可靠映射
- Long Li:机构信息未能从会议 PDF 纯文本可靠映射
- Rui Liu:机构信息未能从会议 PDF 纯文本可靠映射
- Huiyao Liu:机构信息未能从会议 PDF 纯文本可靠映射
- Koji Inoue:机构信息未能从会议 PDF 纯文本可靠映射
- Ryuichi Sumida:机构信息未能从会议 PDF 纯文本可靠映射
- Tatsuya Kawahara:机构信息未能从会议 PDF 纯文本可靠映射
- Fan Xu:机构信息未能从会议 PDF 纯文本可靠映射
- Lingyu Ye:机构信息未能从会议 PDF 纯文本可靠映射
- Wei Tian:机构信息未能从会议 PDF 纯文本可靠映射
- Dongjun Kim:机构信息未能从会议 PDF 纯文本可靠映射
- Jimin Jung:机构信息未能从会议 PDF 纯文本可靠映射
- Jaehyung Seo:机构信息未能从会议 PDF 纯文本可靠映射
- Nadya Yuki Wangsajaya:机构信息未能从会议 PDF 纯文本可靠映射
- Pham Minh Duc:机构信息未能从会议 PDF 纯文本可靠映射
- Ojasva Saxena:机构信息未能从会议 PDF 纯文本可靠映射
- Palash Nandi:机构信息未能从会议 PDF 纯文本可靠映射
- Xiyan Tao:机构信息未能从会议 PDF 纯文本可靠映射
- Wiwik Karlina:机构信息未能从会议 PDF 纯文本可靠映射
- Tuan Luong:机构信息未能从会议 PDF 纯文本可靠映射
- Keertana Arun Vasan:机构信息未能从会议 PDF 纯文本可靠映射
- Roy Ka-Wei Lee:机构信息未能从会议 PDF 纯文本可靠映射
- Nancy F. Chen:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
该任务输入为语义相同的纯文本选择题、图像加问题与语音朗读问题,输出为四选一答案与英文解释,难点在于记忆捷径、低资源语言落差与模态迁移断裂会伪装成文化能力。八国母语者先按九类主题采集文本与图像并撰写知识要点与多步推理题,形成本地语与英语平行题库。随后团队将视觉题改写为等义纯文本题并合成标准与带口音英语语音,使三模态语义对齐以进入统一零样本测试。测试先以贪婪解码单轮评测十四模型的多选准确率与跨语言跨模态一致性,再以三模型多数投票核查解释是否蕴含知识要点并剔除捷径成功。相对既有单模态文化选择题,该机制以一致性与解释忠实性为首要指标,并用视觉依赖消融与泛化分解揭示推理断点,具有更可靠的文化接地测量意义。在MMAC-bench文本问答基准下,GPT-4o在CN-en上的准确率为50.2,高于在CN-zh上的36.0。该结论适用边界限于八国亚洲文化的多选加解释范式,开放式交互与西方外推尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://github.com/coqui-ai/TTS — 链接可访问(HTTP 200) 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,目标是什么,本文要保留什么?
本文解读的对象是 MMAC,一个面向文化落地的多语言多模态对齐评测框架,配套题库是 MMAC-bench。输入是同一文化事实的 3 种呈现:纯文本选择题、图像加问题、语音问干加文本选项。每题还附带本地语言版和英语版,以及 2 到 4 句最小知识要点。
目标不是给模型排名,而是回答一个更难的问题:模型是对某种文化有连贯理解,还是换了模态和语言就换了答案。必须保留的信息包括数据规模与覆盖、5 维评测的定义、零样本调用条件、一致性和忠实度的计算口径,以及失败归因。
输出是一套可复述的构造与评测动作,研究生照着做能重建对照,而不是只记住结论。论文聚焦 8 个亚洲国家,正是因为现有模型被报告有西方偏向,选亚洲长尾文化更容易暴露短板。
按学习依赖展开,先讲任务与相关路线,再讲方法全景,然后走完一个样本从输入到输出。接着讲构造与推理的真实计算、实验条件、结果与反证,最后讲复现与收束。教学用的例子会明确标为例子,不虚构数值。
已有文化评测走了哪三条路,各自缺了什么?
第 1 条路是文本文化选择题,用多选题测特定国家知识,常见发现是英语和高资源表现更好,且对格式敏感。这条路缺的是对齐的多模态对照,无法检验跨模态的文化理解。
第 2 条路是多语言视觉问答,用社区图片和问题测视觉文化感知,能看到视觉语言差距和语言敏感。但通常缺少同一题目的文本和语音平行版,分不清是文化知识不行、视觉 grounding 不行,还是语言处理不行。
第 3 条路是语音与口音鲁棒性,报告口音偏置和扰动影响,但很少直接测文化知识,更少分析 3 模态对齐与一致性。第 4 块相关工作是一致性与 grounding。
原文指出多选题可能靠捷径而非 grounded 推理答对,例如去掉题干仍能选、靠排除法得分,因此需要负控制和跨语言跨模态一致性报告。MMAC 与它们的区别被归纳为 3 点:提供语义对齐的 3 模态条目和本地语言加英语平行版。把跨模态和跨语言一致性作为首要指标,加入针对性消融和负控制。这样的设计把失败归因拆成知识、语言、模态 3 类。
要解决的判断是什么,为什么多选题正确率不够?
要解决的判断是文化能力的真实性。假设一个模型在英语文本上答对一道关于西湖名菜的题,能否认为它懂杭州文化。如果换成西湖图片问同一件事,或换成带口音的英语语音问同一件事,或换成中文问同一件事,它还答对吗。
如果答案来回跳动,说明知识是碎片化的。如果答对但解释与知识要点矛盾或遗漏关键证据,说明正确可能是捷径,例如选项排除、通用启发式、幻觉推理恰好蒙中。
因此 MMAC 把评测拆成 5 个维度。文化感知差异指模型在不同国家文化、语言、模态上的表现差。跨模态一致性指语义等价输入换了表示后答案是否稳定。
跨语言一致性指语义等价输入换了语言后答案是否稳定。文化感知 grounding 指答对是否依赖恰当的文化信号而非可利用捷径。文化感知泛化指给了相关文化知识后,模型能否在该文化语境里完成要求的推理。每维都有独立操作,不是同一正确率的 5 种说法。
MMAC 全景:数据流水线如何托起五维评测?
MMAC 全景可以沿一张总览图读。左侧是数据创建流水线,右侧是同一知识点的多形态样本,中间是 5 个评测维度,底部是草稿数据集到多轮专家评审再到正式数据集的收口。理解顺序应该是先看数据如何保证语义对齐,再看评测如何利用这种对齐做控制比较。
最后看样本如何把知识要点、选项和模态绑定在一起。下图是论文总览,黄色为数据创建,粉色为 5 个评测维度,蓝色为代表性样本,箭头表示从数据集到各维度的支撑关系。
看图路径: 1. 先沿左侧黄色数据创建流水线从标注者选择看到多轮专家评审;2. 再看中间粉色 5 个评测维度如何都指向中间数据集;3. 最后对照右侧蓝色同一知识点的语音文本视觉 3 种问法
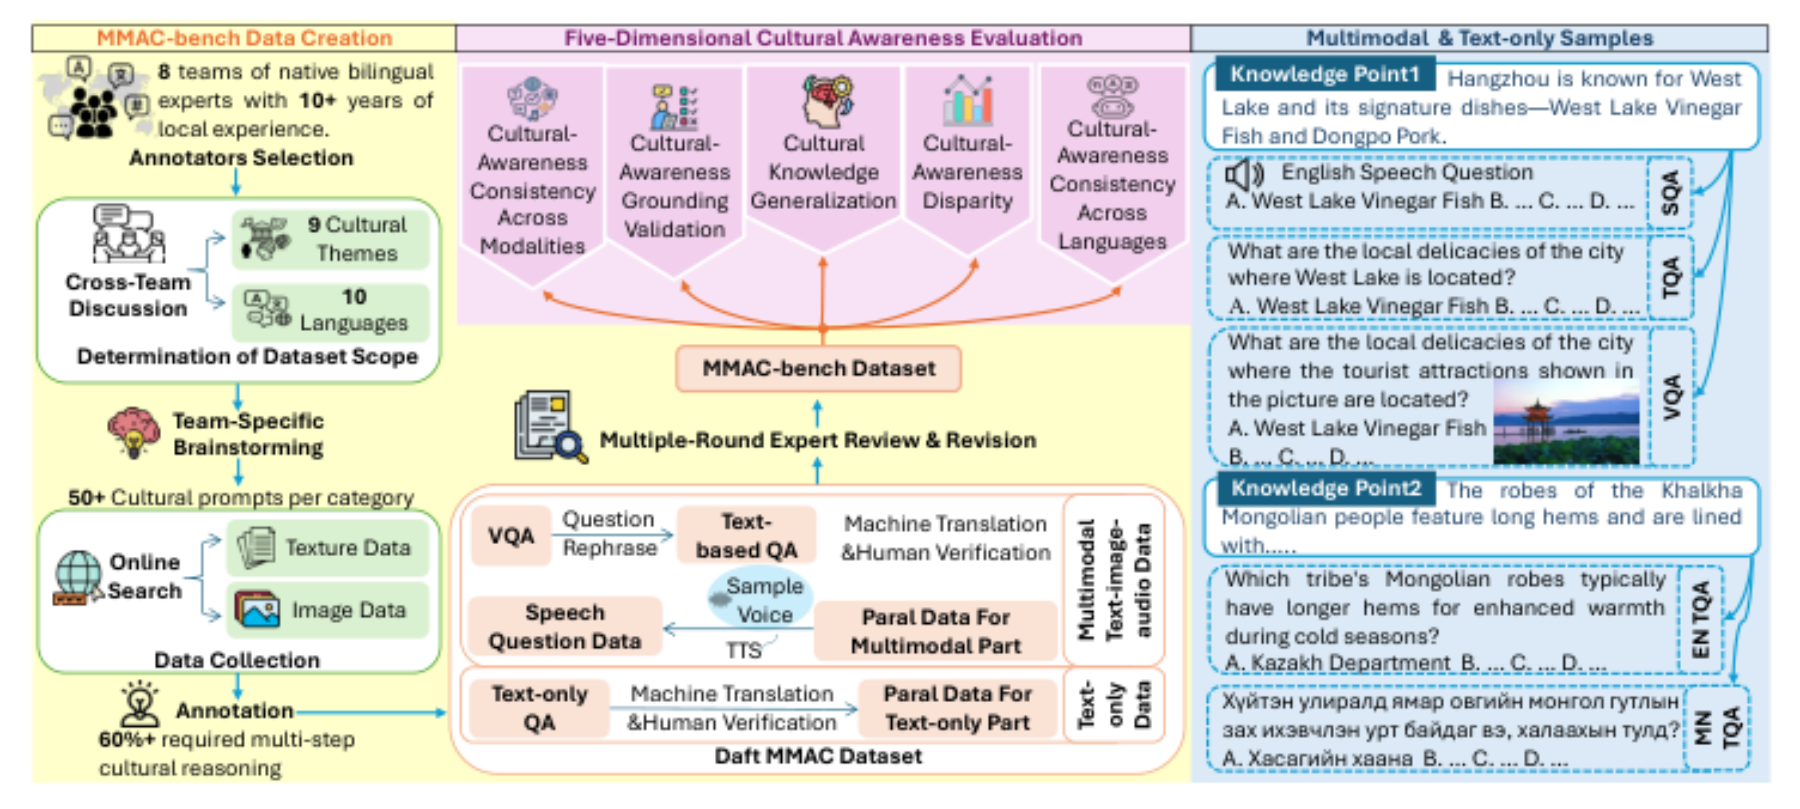
论文图 1。原论文 Figure 1:“An overview of the MMAC evaluation framework: data creation pipeline (yellow), evaluation dimen- sions (pink), and representative dataset samples (blue).”。
这张图值得细读,因为它把后文所有对照的公平性来源讲清了。左侧从 8 组本土双语标注者开始,经过跨组讨论确定 9 个主题和 10 种语言。再经头脑风暴产生每类 50 个以上文化提示,然后联网检索文本和图像,标注时要求 60% 以上多步文化推理。
中间 5 个维度分别是跨模态一致性、grounding 验证、知识泛化、差异、跨语言一致性,都以 MMAC-bench 数据集为输入。右侧用杭州西湖和蒙古族袍服 2 个例子展示知识要点同时约束语音问答、文本问答和视觉问答,以及蒙古语和英语平行版。也就是说,对齐发生在输入层,而不是事后把不同题目的分数平均。
一个样本如何走完输入到输出?
举一个论文右侧的例子帮助理解,不代表新增数据。知识要点是杭州以西湖和西湖醋鱼、东坡肉闻名。同一语义被做成 3 种输入:语音版是英语语音问干加文本选项,文本版是西湖所在城市的地方名菜是什么。
视觉版是根据图中旅游景点所在城市问同样选项。模型都要先返回选项字母,再用英语写解释。评测时先看选项是否命中,再用大模型投票检查解释是否完整包含知识要点且无事实错误。只有两者都对,才在选择加解释指标下记分。
跨模态一致性 × 跨语言一致性: 跨模态一致性分工是固定语义和语言、只切换文本、图像加问题或语音问干是否给出相同选项,用来暴露视觉和语音对齐损失;跨语言一致性分工是固定国家和模态、只切换呈现语言,用来暴露低资源语言的知识缺失与对齐不足;二者搭配的理由是只有同时控制语义等价,才能把失败归因到模态还是语言,组合意义是把文化能力从单点正确率变成可迁移的稳定回答。
这个走查说明 2 个关键控制。第 1,视觉问答题会被改写成语义等价的纯文本题,选项和答案不变,用来在固定语言下比较文本与视觉。第 2,每题都有本地语言和英语 2 版,用来在固定国家和模态下比较语言。
语音主实验采用问干转语音加选项保持文本的配置,以减少全语音选项带来的额外歧义并保持与视觉问答的可比性。全语音结果只在附录供参考。
知识要点 × 理由不忠实率: 知识要点分工是每题附带 2 到 4 句最小充分证据,作为判断解释是否用到应有文化信号的依据;理由不忠实率分工是统计答对但解释遗漏或违背知识要点的比例,用来量化捷径作答;二者搭配是因为没有证据就无法判定解释质量,组合后形成选择加解释才算对的更严格估计。
三组配对机制各自解决什么混淆?
第 1 组是视觉问答与改写视觉问答的配对。视觉问答要求答案必须依赖图像,标注时会做遮图检查,挡住图还能答对就判为视觉依赖不足并打回。改写题保留视觉描述所需信息但去掉对图的依赖。
这样文本好而视觉差,就更可能是视觉理解或图文对齐问题,而不是完全不懂文化。
视觉问答 × 改写视觉问答: 视觉问答分工是必须看图才能回答,检验文化视觉 grounding;改写视觉问答分工是把同一题改写成语义等价的纯文本选择题、选项和答案不变,用作控制视觉输入的对照;二者搭配可以分离不懂图还是不懂文化知识,组合意义是得到文本大于视觉大于语音这一排序的可解释比较。
第 2 组是多步文化推理与文化泛化的配对。多步被定义为需要至少 2 个独立知识成分的顺序推导或综合,而非单事实回忆或改写。泛化实验把多步题拆成子问题,先看子问题能否答对,再看能否综合成最终答案。这样可以区分事实缺失、初期推理错、综合失败 3 类。
多步文化推理 × 文化泛化: 多步文化推理分工是要求从至少 2 个独立知识成分顺序推导或综合,而非单事实回忆,用来提高题目抗记忆性;文化泛化分工是把已给子问题知识用于最终综合,检验事实检索后能否完成逻辑整合;二者搭配是因为只测单步会高估能力,组合后能暴露检索正确但综合失败的整合损失现象。
第 3 组是口音与文化先验的配对。语音不仅有噪声和同音,还有口音。论文生成不带口音的英语和带本地口音的英语 2 版,对照标准英语基线,看口音是干扰还是线索。
口音 × 文化先验: 口音分工是语音中与地域相关的声学实现,被当作可能引入同音和噪声的不确定来源;文化先验分工是口音与特定国家实体在训练中共现后形成的检索线索;二者搭配的理由是英文语音分带口音和不带口音两版可做对照,组合意义是说明口音不总是噪声,在部分国家任务上能激活相关上下文。
本研究训练了什么,没有训练什么,数据如何算出来的?
本研究没有训练任何新模型,也没有微调被测模型。所有 14 个模型都是零样本单轮调用,包括 GPT-4o、Claude Sonnet 4、Gemini 2.5 Flash 等 3 个闭源模型和 Qwen、Llama、GLM 等 11 个开源多语言或多模态模型。所谓训练一节在这里应理解为数据构造与推理计算过程。
真实计算是标注、翻译校验、语音合成、评测推理和法官投票,没有梯度更新,因此不能从参数冻结推定输出确定。闭源模型还通过 API 访问并设温度为 0 以减少随机性。
数据构造的计算起点是 8 国团队:中、新、日、韩、蒙、越、印尼、印度,覆盖 10 种语言。每国每语言每模态 500 题,总计 27,000 题。类别有 9 个:日常生活文化、饮食、交通、建筑、历史、地理气候、教育、服饰、语言民族。
标注者是在当地生活 10 年以上的本地母语者且熟练英语,初稿后由本国语言专家 2 轮评审,组内一致性用 Cohen kappa 报告。翻译挑战被量化为术语错 23%、无直接对应 61%、文化词直译错 16%,处理分别是查词典问专家、音译、先改写再译。语音用多套 TTS 按语言选型,英语还分口音版,输入文本先做数字符号归一化和分句,音频不超过 30 秒、16 kHz 采样。
下图显示多步推理题占比随国家的变化,是理解题目难度的关键背景,纵轴为题目百分比,横轴为国家,深色为多模态,橙色为纯文本。
看图路径: 1. 先确认纵轴多步题占比与横轴 8 个国家的排列;2. 再比较深色多模态折线与橙色纯文本折线的交叉点;3. 最后记下蒙古和韩国多模态端接近顶部的位置
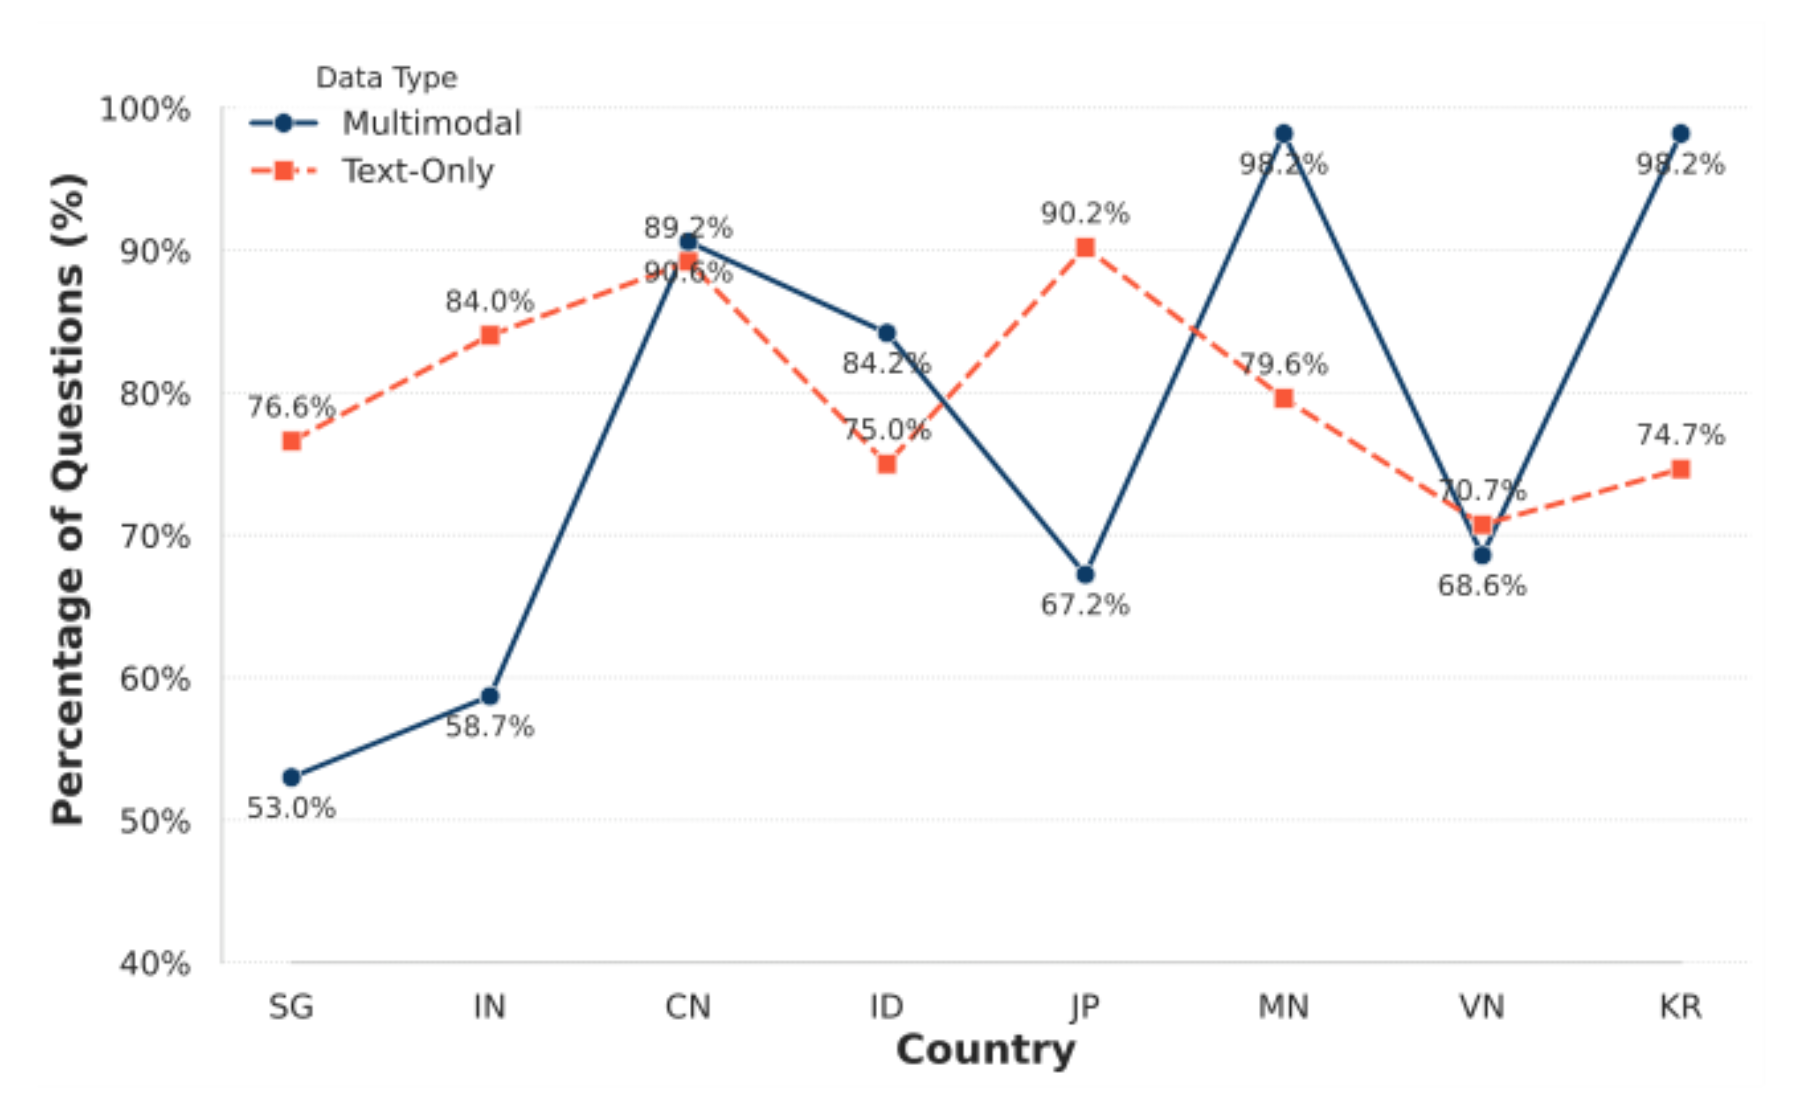
论文图 5。原论文 Figure 5:“Multi-step reasoning question proportions across countries”。
从像素可见,蒙古和韩国多模态端接近 98.2%,中国多模态约 89.2% 而纯文本约 90.6%。新加坡多模态仅 53.0% 而纯文本约 76.6%,日本多模态约 67.2% 而纯文本约 90.2%。这说明多步占比不是均匀的,后文按国家比较正确率时必须考虑难度基线不同。
组内评审一致性细节见下表,表头为维度、两类一致计数、两类不一致计数及观测一致率、期望一致率和 kappa,数值保留原文精度。
| & Modality) | n11 | n22 | n12 | n21 | Po | Pe |
|---|---|---|---|---|---|---|
| 460 | 25 | 8 | 7 | 0.9700 | 0.8784 | |
| 455 | 32 | 6 | 7 | 0.9740 | 0.8573 | |
| VQA) | 440 | 45 | 10 | 5 | 0.9700 | 0.8122 |
| 448 | 42 | 4 | 6 | 0.9800 | 0.8291 |
该表报告各国家和模态的双人交叉验证结果,kappa 多在 0.74 以上,支持标注流程可靠。但要注意这是标注一致性,不是模型性能,也不能直接换算成题目难度。未报告的缺项是每类提示最终留存率和图像许可明细,复现时需按附录的 CC 许可和人工复核要求补齐。
实验条件:测什么、和谁比、条件是否一致?
评测分 2 种模式。多选只看选项命中,用于看跨文化趋势。多选加解释还要求英语解释经多数投票法官判定与知识要点一致,用于去掉侥幸答对。提示模板按问题语言匹配,图像超限则等比缩小到 1 兆像素以下。
解码用贪心无采样,最大输出 2048 token。不支持多语言的模型只报英语分以便可比,语音只测能直接吃语音 token 的模型,需要中间语音识别的模型被排除。
比较的公平条件是共同支撑子集和语义等价。跨国家比较时固定模态,对每国取其可用语言中的最高分,避免把语言能力混入文化能力。跨语言比较时固定国家和模态,用语义等价的多语言提示测答案是否相同,与对错无关。
跨模态比较时固定语言和国家,用语义等价的文本、视觉、改写文本、语音问法测答案是否不变。指标方向是准确率越高越好,一致性越高越稳定,不忠实率越低越可信。硬件是英伟达 H100 80G 单轮推理,闭源经 OpenRouter 或官方 API 调用。
法官机制用 GPT-4o、Gemini 2.5 Flash、Claude Sonnet 4 等 3 个模型多数投票,二分类判定解释与知识要点是否一致。在 100 题人机对照上,3 者与人的一致性分别为 98%、98%、96%,3 者互一致下界为 96%。但在马来语和泰米尔语上,互一致分别掉到 88% 和 72%,改进提示后仍低于可信阈值,因此 grounding 验证只在英语解释下进行。这是一个明确的评测边界,不代表非英语解释不重要,而是现有法官在低资源语言下噪声太大。
主结果:文本大于视觉大于语音,英语不总是最好
主结果覆盖 4 个模态。论文报告几乎所有前沿模型低于 80%,多数低于 50%,说明多样文化细节仍是短板。按模态排序,原文观察到一致的文本大于视觉大于口语问答,数据可用性也是文本远大于图文大于原始语音。
语音多不确定性,架构上多模态常分开编码再融合,会带来对齐压缩损失。按国家取各语言最高分后,韩国平均约 63.98%,越南约 62.96%,两者接近,中国和印度差距更大且内部异质性高,蒙古更低,与低资源和语料稀疏一致。
按语言看,英语常在低资源语言上占优,但在中日等中高资源本地语言上优势缩小或反转。因为特定人名和文化词在本地语料充分而在英语稀疏,例如乌护一词缺少标准英译,音译在英语数据中罕见且歧义。
下图是 4 行柱状总览,第 1 行纯文本,第 2 行视觉,第 3 行改写视觉,第 4 行语音,纵轴为准确率,横轴为国家加语言,每国每模态 500 题。
看图路径: 1. 先按 4 行分别确认文本视觉改写语音的纵轴准确率与横轴国家语言;2. 再比较同一国家内本地语言与英语柱高的相对顺序;3. 最后观察语音行中带口音与不带口音的差异方向
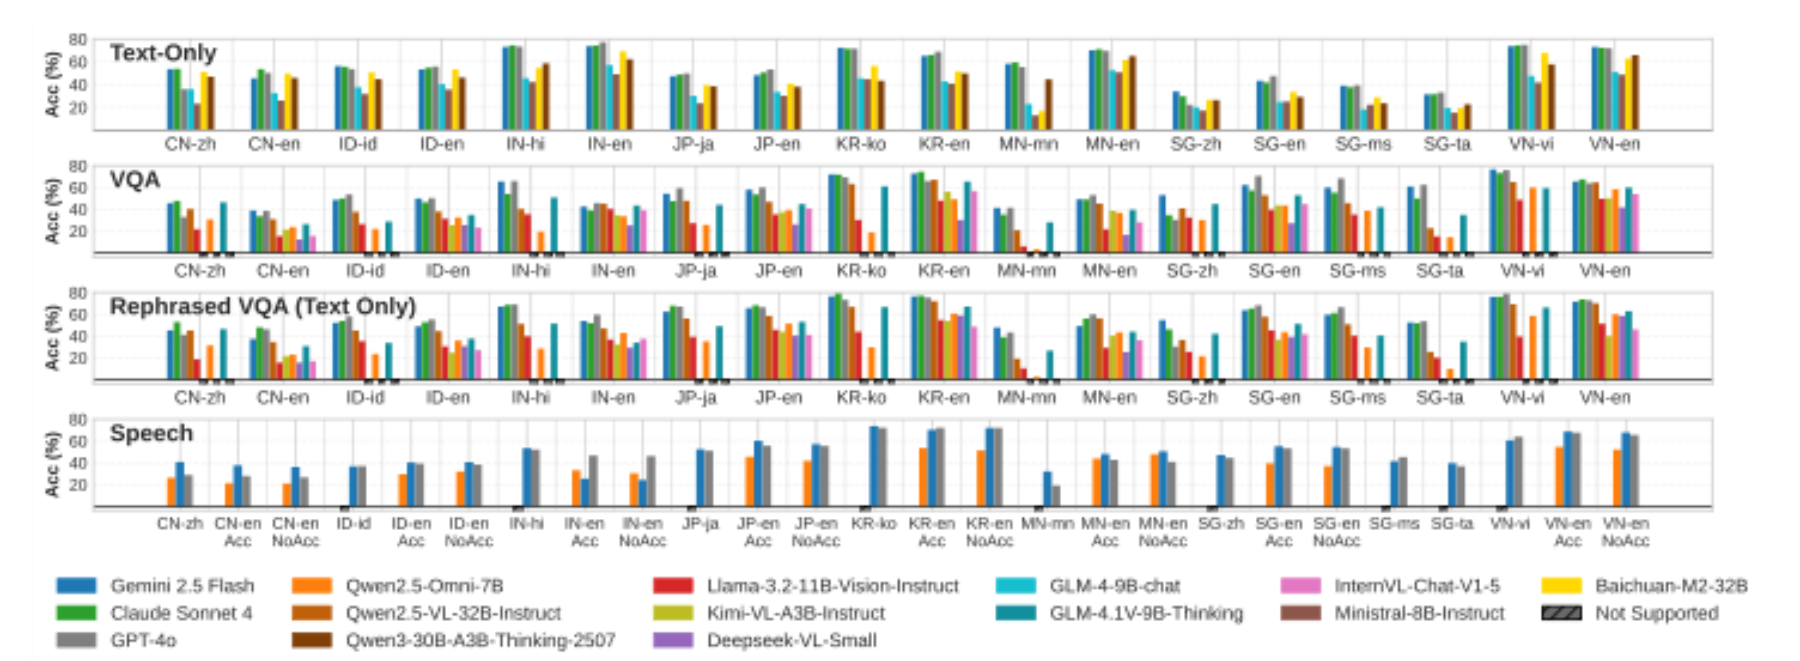
论文图 2。原论文 Figure 2:“Performance of LLMs on MMAC-bench across modalities.”。
从像素可见,韩国和越南各语言柱普遍高于新加坡和中国中文柱,蒙古本地语言柱明显低于其英语柱。而视觉和语音行整体低于纯文本行。语音行还分带口音与不带口音,Qwen 和 Gemini 分别在 6 个和 5 个国家文化上超过其标准英语基线。
Qwen 在印尼和日本口音上分别提升 2.8 和 3.6 个百分点,支持口音可作文化线索的判断,但这只是部分国家的增益,不是全面超越。类别上,纯文本和视觉在服饰与交通更弱、在日常生活与教育更强,语音在饮食与历史稍弱,反映低频专有名词的声学映射更难。
下表是视觉模态下多选加解释的严格准确率,列为 8 国英语呈现,数值为选项与解释双对才记分,单位为百分比,裸值按原文表头理解。
| Model | CN-en | ID-en | IN-en | JP-en |
|---|---|---|---|---|
| GPT-4o | 29.9 | 31.9 | 27.4 | 40.0 |
| Qwen2.5-VL-32B | 25.0 | 22.6 | 26.1 | 34.2 |
| Llama-3.2-11B-Vision | 7.0 | 12.3 | 14.8 | 13.8 |
| Kimi-VL-A3B-instruct | 11.8 | 9.9 | 13.1 | 16.6 |
表后需要强调代价。严格指标大幅低于只看选项的分数,例如 GPT-4o 在视觉英语下多国从 40% 到 60% 区间掉到 20% 到 60% 区间。Llama 视觉多在个位数到 20% 多,说明相当一部分表面胜利是捷径。未胜出项很清楚:开源视觉模型在低资源语言视觉上更不稳定,语音整体最低。因此总体趋势不等于每组都成立,复现时必须按国家语言模态三元组报告,不能只平均。
改写对照与严格指标:视觉损失从哪里来?
改写视觉题的作用是提供同一语义的纯文本对照。如果改写后分数回升,说明视觉输入本身带来损失。论文的误差分析以 Qwen2.5-VL-32B 为例,聚焦文本对而视觉错的实例。
除不懂文化图像语境这一最常见错误外,还发现 2 类:提示引导的选择性注意,即过度关注题干显式对象而忽略文化视觉线索,用多层 Grad-CAM 可视化验证。图像诱发的幻觉,即视觉存在反而增加推理幻觉,用视觉消融前缀重放验证,先让模型描述图像再去掉视觉条件重算前缀表示,比较后续推理是否变稳。
下表是改写视觉在多选加解释下的严格准确率,同样 8 国英语列,百分比裸值,便于与上一表同模型同列直接比较模态效应。
| Model | CN-en | ID-en | IN-en | JP-en |
|---|---|---|---|---|
| GPT-4o | 39.8 | 35.7 | 48.4 | 61.1 |
| Qwen2.5-VL-32B | 28.0 | 27.1 | 30.0 | 47.5 |
| Llama-3.2-11B-Vision | 7.6 | 13.8 | 17.6 | 24.5 |
| Kimi-VL-A3B-Instruct | 12.5 | 12.3 | 15.2 | 26.5 |
比较 2 表可见,同一模型从视觉到改写文本多为上升,例如 GPT-4o 在日本英语从 40.0% 到 61.1%。在新加坡英语从 53.2% 到 62.6%,支持视觉对齐损失的解释。但也有低位徘徊的模型,如 Llama 在中文英语仅 7% 左右到 7.6%,说明知识本身也不足。
改写不能替代视觉能力,只能用于归因。语音的进一步分析留作未来工作,因为噪声口音语调更复杂。类别与语言的交互在附录有更多细节,低资源语言的正式语料偏向教育类会导致该类虚高,复现时应分层看。
反证一:答对了,解释可信吗?
grounding 验证的操作是每题保留知识要点,要求模型先给选项再给英语解释。再用 3 模型多数投票判定解释是否正确完整包含知识要点且无事实错误。理由不忠实率定义为答对中解释矛盾或遗漏所需知识的比例。这个指标方向是越低越好,它不否定多选题的便利,而是说明只看多选会高估。
下图左为纯文本、右为视觉的不忠实率曲线,纵轴为百分比,横轴为国家语言分组,多条折线为不同模型。
看图路径: 1. 先区分左半文本与右半视觉 2 个面板的横轴国家语言分组;2. 再比较闭源模型曲线与开源长解释模型的纵轴不忠实率高度;3. 最后注意低资源语言分组上曲线的抬升位置
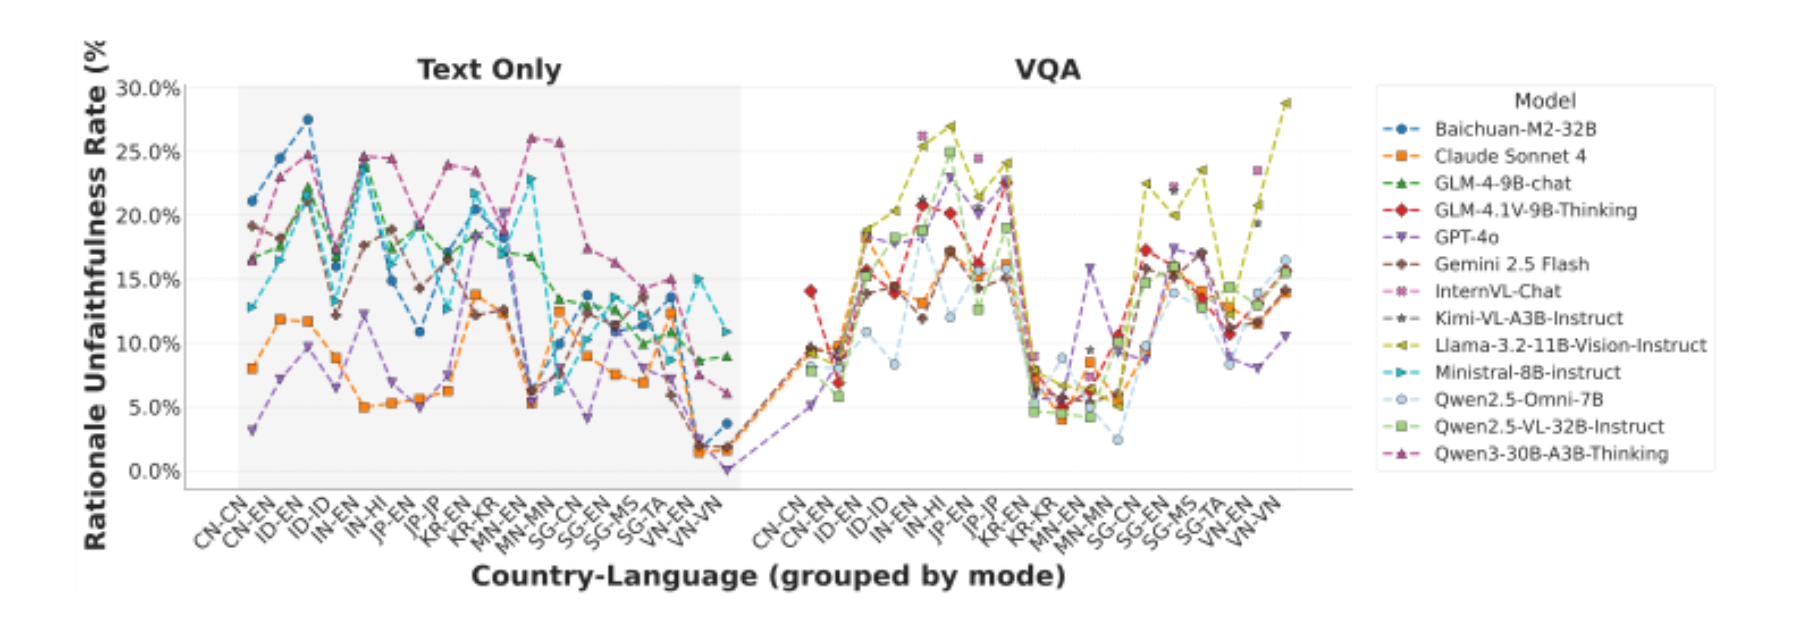
论文图 3。原论文 Figure 3:“Rationale Unfaithfulness Rates (RUR) of LLMs across text-only and VQA. Similar trends are observed for Rephrase VQA and Spoken QA; detailed results are provided in Appendix A.17.”。
像素显示,即使闭源模型也在 5% 到 20% 之间,开源更严重,Llama 在非英语上更高。Qwen 长解释常含幻觉且有用错前提推出正确选项的情况。这支持论文主张:采用多选加解释协议,只有选项和理由都对才记分。
代价是评测成本上升且目前只敢在英语解释下做,因为低资源语言的法官一致性不足。未评测边界是非英语解释的忠实度,待人力扩展。
跨语言一致性的公式按原文定义为对每题所有大小为 s 的语言子集,答案完全相同的子集占比再对题目平均。若某题语言数小于 s 则该题贡献为零。它测稳定而非正确。报告显示,蒙古文化下 Claude 蒙英一致仅 65.2%,开源都低于 50%。新加坡中英泰马 4 语言联合评估时最高一致不超过 45%,而两两值可达 60.60%、64.20%、55.20%,说明两两一致不蕴含全局连贯。
印度文化下 GLM 在印地语视觉跨语言一致为 44.20%,比其改写纯文本对照高 13.2 个点,但绝对值仍低,视觉只能部分弥合。跨模态一致性在 8 国平均低于 67%,低资源下更难维持,中高资源本地语言常高于英语。
反证二:给了知识,还能做对多步综合吗?
泛化实验把多步题拆成子问题,统计 3 类:子问题和最终都对、子问题对但综合错、初期推理就错。前者是真泛化,中者是整合失败,后者是知识或早期推理缺失。比较问题是给了事实后逻辑综合是否先于事实记忆崩溃。
公平条件是同一模型同一语言,指标是 3 类占比。下表汇总关键定量对照,单位为百分比,裸值按原文语境为各类占比,基线包含约 2% 的整合失败背景率与多组实际可运行模型。
| 条件 | 指标 | 韩国文化平均 | 越南文化平均 | 蒙古蒙英一致 | 新加坡 4 语言联合 | 印度视觉增益 | 不忠实率区间 | 口音增益 |
|---|---|---|---|---|---|---|---|---|
| 跨 4 模态取语言最高 | 准确率 | 63.98% | 62.96% | 65.2% | 45% | 44.20% | 5% 到 20% | 2.8% 和 3.6% |
表后解释主要收益与代价。收益是定位了整合瓶颈:Qwen 英语下整合失败 10.7%,Claude 印尼语下 9.2%,远高于约 2% 基线,说明任务变复杂时逻辑整合比事实保持崩得更快。代价是文化泛化整体仍难,高资源下闭源有知识但缺泛化,开源知识与迁移都缺。
低资源下闭源泛化骤降,开源失败多由知识缺失驱动,占比超 88.5%。未胜出项是没有任何模型在所有语言上同时解决知识与整合,复现时应分别报告子问题正确率与综合条件正确率,不能只报最终分。
边界:哪些结论不能推广?
第 1,覆盖边界。当前只测 8 个亚洲国家,西方和其他语组未测,模态也以问干语音加文本选项为主,全语音只在附录参考。把韩国越南的高分推广到所有文化是不当的,把语音口音增益推广到所有口音也是不当的。
第 2,测量边界。grounding 只在英语解释下可信,非英语法官一致性不足。一致性是稳定不是正确,高一致也可能是稳定地错。第 3,数据边界。网络材料偏向主流叙事,图像仅限 CC 许可并做人脸模糊与人工复核。
语音为合成加少量人录,TTS 工具按语言选型,附录报告了各语言词错率、字错率或平均意见分,但合成与真实口音仍有差距。第 4,归因边界。相关性不是因果,数据量、文化复杂度、拉丁字母共享都可能同时作用。
中国汤圆元宵之分、印度 22 种官方语言的地区差异、蒙古西里尔与传统蒙文并用等都会放大长尾效应。论文未测量延迟成本与误判率,不能承诺这些量改善。
复现先做什么,需要哪些信息条件?
复现先做最小闭环。选一个国家一种本地语言加英语,取文本、视觉、改写文本 3 种输入各 50 题,按原文模板零样本调用,贪心解码,最大 2048 token,图像超限等比缩小到 1 兆像素以下。先算选项准确率,再对答对题用 3 模型投票或人力检查英语解释与知识要点的包含关系,算不忠实率。
接着算跨语言和跨模态一致性,注意一致性与正确率分开报告。关键超参数和信息条件是温度 0、单轮、提示语言与问题语言匹配、语音 16 kHz 30 秒内、选项位置随机化、干扰项同类近似、多步题占比 60% 以上。
代码与资源状态按本次收到的官方信息交代。论文给出代码地址,第三方语音工具地址本次可达 200,但这不等于权重可下载或系统可一键运行。模型许可见附录表,开源多为 Apache 或 MIT,Llama 为社区许可,闭源为专有条款,仅研究使用。
复现还需补的验证是遮图可答性检查、改写语义等价检查、跨区域知识完备性检查,以及非英语解释的人力扩展。若要加新文化,需按指南走提示头脑风暴、联网检索多源核验、本地语言起草、闭源翻译加人工校对、知识要点 2 到 4 句、题干不超 300 词、选项各不超 50 词的流程。
何时值得尝试 MMAC,记住什么,忘掉什么?
当你的任务涉及多语言多模态的文化问答,且担心正确率虚高时,值得尝试 MMAC。它的价值不在 27,000 这个数字,而在输入层对齐带来的可控比较:同一语义换模态、换语言、加减图像、换口音,每一步都有对照。
记住 3 个可操作判断:文本大于视觉大于语音提示优先补图文和语音对齐。低资源语言先补知识再谈推理,高资源本地语言可用本地语提问以改善 grounding。任何单点胜利都要过解释关,不忠实率 5% 到 20% 意味着必须报告严格指标。
忘掉 2 个误解。一是英语一定最好,原文显示中日等本地语言在文化专有名词上可反超英语。二是口音一定是噪声,原文显示印尼和日语口音在 Qwen 上有 2.8 和 3.6 个百分点的增益,口音可作文化先验,但只在部分国家成立。
最终收束是方法论建议:用一致性和 grounding 感知的评测跟踪进展,加强跨模态对齐与低资源覆盖。同时承认当前只覆盖亚洲子集,西方扩展与更多模态仍待验证。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses