英文题目:SMILE-Next: Teaching Large Language Models to Detect, Classify, and Reason about Laughter
会议身份:
conference:acl:2026:conference-paper-id:2026.acl-long.2023
✅ 来源为官方会议 PDF;可重放的表格、公式文本与 Figure 像素已按 PDF 抽取结果绑定,未成功恢复的结构不作推断。
标签:#数据集 #混合专家模型 #大语言模型 #音视频 #音视频问答
评分:6.3/10 | 创新 1.3/2 | 技术严谨 1.0/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:数据集与基准
👥 作者与机构
- Lee Jung-Mok:机构信息未能从会议 PDF 纯文本可靠映射
- Kim Sung-Bin:机构信息未能从会议 PDF 纯文本可靠映射
- Joohyun Chang:机构信息未能从会议 PDF 纯文本可靠映射
- Lee Hyun:机构信息未能从会议 PDF 纯文本可靠映射
- Tae-Hyun Oh:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
笑声理解的输入是含语音、表情与对话关系的短视频片段,输出需同时给出是否引笑的二分类、愉悦型、礼貌型与讽刺型三类笑声类型,以及不超过30词的因果解释,难点在于幽默、讽刺与尴尬等动机高度纠缠且依赖跨模态社会语境。该工作先用笑声检测与说话人模型切分片段并将话语、韵律数值、面部动作单元与视频描述转为文本,再由GPT-4生成伪解释并经众包校验形成6386对问答,然后以笑声专用自指令扩展紧张会议与职场层级等社会性笑声场景,最后在冻结大语言模型上训练任务自适应的笑声专家混合。与直接编码原始音视频的Qwen2.5-Omni-7B等基线相比,文本解耦使模型可显式调用常识与因果推理,避免了隐式融合对尴尬与幽默的混淆。在SMILE-Next测试集上Qwen2.5方案的笑声检测准确率达96.52%,显著高于音视频基线的83.44%,人类评估平均排名1.69亦最优。结论限于英语脱口秀与双人对话等公开视频,对文化特定与群体复杂笑声及非英语场景尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
笑声为何难做:输入是什么,目标是什么?
这篇论文的输入是一段包含人际互动的短视频,输出是围绕笑声的问答。研究目标不是简单识别有没有笑声音,而是理解真实社交中的笑声意图。作者在引言中强调,人们会因亲密、吸引注意、缓和紧张而笑,笑声含义超出好笑。对于刚入门的同学,关键是把笑声看成社会信号,声音能量大不等于好笑,尴尬与礼貌也会笑。论文因此设定 3 个递进目标,先判断是否应笑,再判断属于愉悦、礼貌还是讽刺,最后用自然语言解释原因。
方法上的核心选择是先把视频语音转成文本线索,再用大语言模型做推理,而不是把原始音视频直接丢给多模态大模型。论文报告这种显式解耦更适合解释性推理。需要保留的信息是任务 3 分、文本化表示、自指令扩充与混合专家路由。论文正文给出项目页地址,但本次收到的资源状态未验证其可达,不作已公开断言。后续各节按学习依赖展开,先讲任务与路线,再讲组件与计算,最后讲条件与复现。
前人走了哪三条路,各自缺了什么?
第一条路是把笑声或幽默当信号做检测与强度估计,常用文本加多模态线索做分类。原文回顾了脱口秀与情景喜剧中的幽默检测、讽刺检测与强度预测,这类工作能回答有没有笑,但不解释为何笑。第二条路是解释性幽默推理,例如卡通配文、新 Yorker 漫画或短视频幽默解释,但多局限在脚本化或单领域场景,难以覆盖双人亲密对话、访谈与电影等真实互动。第三条路是视频理解中的特征融合与混合专家。
传统做法把视觉、音频与文本投影到共享隐空间,适合识别类任务,但因果与社会线索纠缠在隐向量中,不利于解释。混合专家则用于条件计算与多任务适配,论文借鉴其思想但改为轻量低秩形式。教学上可以这样对照,同输入都是视频,同目标都是理解人,但监督不同,前人多为分类标签,本文还要求自由文本原因;同运行阶段都是离线评测,但本文强调跨场景泛化。类别差异不能当同条件胜负,后文实验会固定训练集比较不同表示路线。
三个任务如何提问,答案长什么样?
论文把全部任务统一为问答形式,模型看到视频片段与任务问题,生成答案。笑声检测是二分类,问题要求判断片段是否引发笑声,答案固定为有笑或无笑。笑声类型分类是多分类,沿用田中与坎贝尔的分类思路,分为愉悦型、礼貌型与讽刺型,愉悦指自发快乐,礼貌指维持流程的社交性笑,讽刺含 sarcastic、尴尬或嘲弄意味。笑声推理是自由生成,要求至多 30 词左右并以特定句式开头,解释笑声诱因。
举例来说,同样是母女谈水上乐园,检测回答有笑,分类回答愉悦型,推理回答因共享亲密回忆而笑,这只是帮助理解格式的例子,不代表论文报告了该样本分数。3 个任务共享同一视频与文本线索,但目标与评价不同,检测与分类用准确率与 F1,推理用生成指标与人工偏好。
笑声检测 × 笑声推理: 笑声检测负责判断片段是否引发笑声,是二分类问答;笑声推理负责用自由文本解释为何发笑,是生成问答,分工是前者定有无、后者给原因,搭配理由是真实社交中光知道笑了不够,还需区分亲昵、尴尬与嘲讽,组合后新增的作用是把类型分类夹在中间,形成从判定到归因的完整理解链。
理解这座桥后,再看数据覆盖,论文强调场景包括脱口秀、情景喜剧、双人对话、访谈与电影,笑声不限于搞笑,还含紧张缓解与社交维系,这直接决定了后文为何需要关系信息与面部动作。
整体链路:一段视频如何走完输入到输出?
沿一个样本走完全程最清楚。假设输入是一段母女对话视频,先用笑声检测模型切出含笑片段,再按话语边界切分为多个 utterance 级小段。对每小段抽取话语转写、声学统计、面部动作单元、视频字幕与人物关系,全部写成文本。然后把这些文本与任务问题拼成提示,送入笑声专家大语言模型,模型按任务输出有无笑、笑声类型或原因句。
训练侧另有两条支线,一是用人工标注做种子,让外部大模型生成更多笑声相关任务与问答,二是在主干大模型每层线性层旁挂 3 个低秩专家并由路由加权。推理侧只用主干加专家权重,不再调用外部大模型。下图把三任务并列,左侧是视频演进,右侧是 3 种答案形态,先看图再读组件会更顺。
本段导读图一的三任务总览,左侧展示视频帧与波形如何随对话推进到笑声发生,右侧展示同一视频对应的检测、分类与推理 3 种标准答案写法,帮你建立输入到输出的整体映射。
看图路径: 1. 先看左侧三段母女对话与波形,确认笑声发生在第三段水上乐园回忆处;2. 再看右侧三行输出,区分检测答有无、分类答愉悦型、推理答亲密回忆;3. 对照左右箭头,理解同一视频如何被改写成三种问答目标
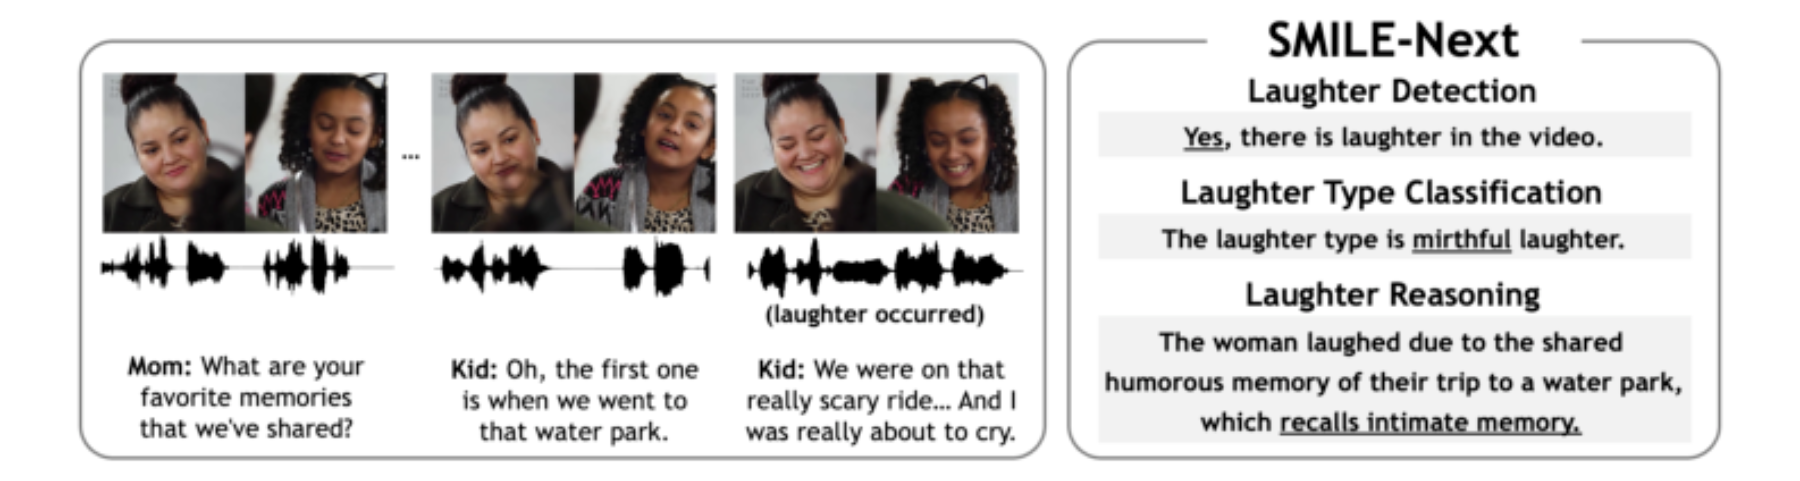
论文图 1。原论文 Figure 1:“Task overview of SMILE-Next. We present SMILE-Next, a comprehensive dataset for laughter understanding.”。
图一的解释是,论文不把笑声当单一分类,而是要求模型同时完成判定、归类与归因。左侧例子中妈妈问最喜欢的共同回忆,孩子提到水上乐园与害怕的游乐设施,随后发生笑声,右侧分别给出有笑、愉悦型与因亲密回忆而笑。这种设计迫使模型利用对话内容与关系,而不仅是音频能量。后续组件分别解决表示、数据覆盖与多任务分工三件事。
文本化线索:把哪些信号写成文字?
文本化的白话含义是,用现成工具把看与听转成句子与数字,再交给语言模型读。英文可记为 textualized multimodal representation。论文对每段抽取话语、声学特征、面部动作单元、视频字幕与说话人关系。话语用语音转写得到,视觉用分段字幕描述场景,面部用动作单元取每人最显著的前三项,声学保留基频均值方差、能量、浊音与清音时长、基频 1 阶 2 阶变化、抖动与闪变等数值,不做高低音的主观分档,而是把原始数值写进提示,让模型用先验知识解读 prosody。关系则从元数据推断,例如主持人与嘉宾、演讲者与观众。公式上论文把任务写成由问题与文本线索集合生成答案的形式,先理解符号再看计算。
文本化多模态表示 × 大语言模型推理: 文本化多模态表示负责把视频语音中的话语、声学统计、面部动作单元、视频字幕与人物关系转成可读文本,解除原始音视频纠缠;大语言模型推理负责利用常识与因果知识对这些文本做联合判断,二者搭配的理由是笑声原因隐含在社会语境中,直接融合特征难以解释,组合后新增的作用是让模型能指出哪类线索触发了笑声。
符号解释是,D 表示大语言模型,Q 是任务问题,t1 到 tk 是从视频抽出的文本线索,y 帽是生成答案。计算目标是给定问题与解耦后的文本,生成符合任务格式的答案。原文明确的实现是沿用前人做法,先离线抽取再拼接提示,不在主模型内端到端学视频编码器。
\[as ˆy = D(Q, {t1, t2, ..., tk}),\]这一节的要点是,文本化不是简单转写,而是把表情、语气与关系显式化,为后文消融中只给转写稿与给全量线索的对比埋下伏笔。
笑声自指令:如何不加人工扩大覆盖?
自指令的白话含义是,用少量种子任务示范,让大模型自己编新任务与新问答。英文可记为 laughter-specific self-instruction。论文先以检测、分类与推理为种子,调用外部大模型生成更广的笑声能力,例如笑声行为预测、反应或强度预测、情绪分类。接着对每个新任务,再让同一模型编出具体问答,刻意加入上下级、朋友等社会关系,以及紧张、勉强、讽刺等非愉悦笑。附录词云与统计显示生成任务常含分析、分类、预测、相关与情感分析,约数百个新任务,例子包括根据不规则语速与音高变化判断紧张笑,或分析好友间先轻笑后大笑的传染模式,这些是论文展示的生成实例,不是人工金标。
笑声专用自指令 × 人工标注: 人工标注负责提供高质量的检测、类型与推理问答种子,笑声专用自指令负责以外部大模型按种子生成新任务与新问答,分工是前者保真、后者扩覆盖,搭配理由是人工无法穷举职场、朋友、访谈等社会关系下的紧张笑、礼貌笑与讽刺笑,组合后新增的作用是在无额外人工时扩展到强度预测、情绪分类与行为预测等派生任务。
操作上论文遵循自指令框架,只是把提示改为笑声专用,鼓励覆盖微妙表情、语调与社会动态。监督来源是外部大模型蒸馏加后续有监督微调,不新增人工标注。缺项是论文未报告生成样本的过滤率与去重细节,也未给出合成数据与人工数据的混合比例对每任务的具体影响,只能从消融中看到加入自指令后多数任务提升。复现时应先复刻种子格式,再检查生成是否偏向搞笑而忽视尴尬笑。
混合笑声专家:冻结什么,训练什么,如何加权?
先看结构再看公式会更清楚。下图展示冻结预训练权重旁挂 3 个可训练专家,底部输入同时送入主干与路由,路由输出权重后加权专家再与主干相加。冻结的是主干大模型的原始权重,训练的是每个任务的低秩适配器与路由矩阵。低秩适配器的白话含义是,用两个小矩阵的乘积近似权重增量,英文为 low-rank adapter。混合笑声专家的英文为 Mixture-of-Laugh-Experts,可简称为 MoLE。论文把 MoLE 接入每层线性层,专家数为三,秩为 8,缩放系数为 16。
本段导读图二的专家结构,底部是输入隐状态,左侧蓝色块是冻结权重,中间 3 个橙色块是任务专家,绿色条是路由门控,顶部是相加后的输出,帮你定位参数更新与梯度路径。
看图路径: 1. 先找底部输入与顶部输出的主干通路,确认冻结预训练权重分支;2. 再看三个橙色专家与绿色路由门控的连接,确认权重动态加权后相加;3. 对比雪花与火焰图标,区分冻结参数与可训练的专家和路由
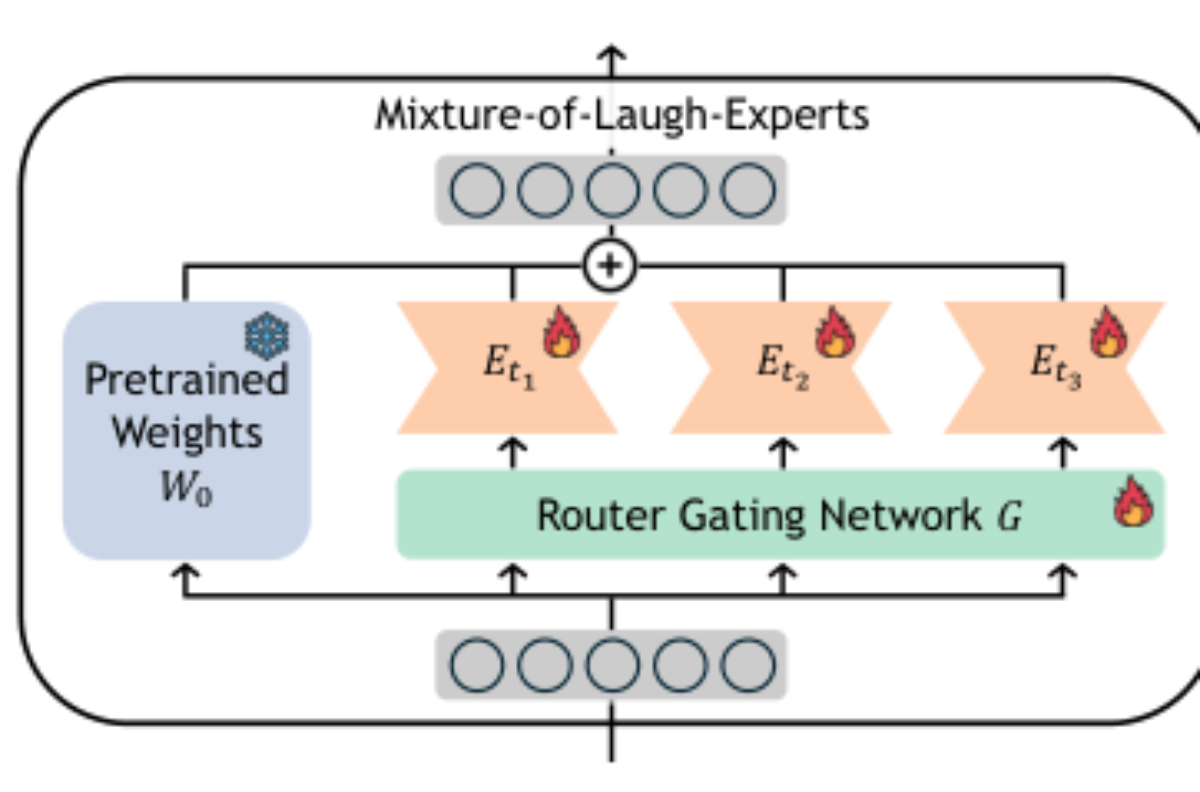
论文图 2。原论文 Figure 2:“Architecture of Mixture-of-Laugh-Experts.”。
图二的解释是,雪花图标对应冻结,火焰图标对应可训练。输入同时走主干与专家,路由按输入算权重,避免硬选单一专家。论文给出的低秩重参数化与混合加权形式如下,先看单专家形式,再看多专家加权。单专家中 W0 冻结,B 与 A 可训,r 控制秩。
混合笑声专家 × 低秩适配器: 低秩适配器负责以小参数量在冻结主干上学习任务偏移,混合笑声专家负责为检测、分类与推理各设一个适配器专家并由路由加权组合,分工是前者省参、后者分工,搭配理由是三任务都需要共享语言能力但判定粒度不同,组合后新增的作用是按输入动态插值专家能力,兼顾共享与特化。
\[Ri = softmax(Wgx)\]公式二的符号是,Wg 为路由可学参数,x 为输入隐状态,Ri 为归一化后的门控权重,Ei 为第 i 个专家的低秩输出。计算目标是对三专家输出做加权求和再加回主干输出,实现按样本的软组合。原文明确的是软路由而非 top-k 硬路由,和为一。缺项是论文未报告负载均衡损失或路由塌缩处理,复现时需监控是否长期只用专家一。
软路由 × 任务自适应: 软路由负责对输入隐状态算出归一化权重并加权全部专家输出,任务自适应负责让检测、分类与推理形成不同的权重分布,分工是前者提供机制、后者体现效果,搭配理由是硬切换会割裂共享知识,组合后新增的作用是同一主干下按任务需求调配专家容量,论文报告分类更偏专家二而检测略偏专家三。
数据与训练:从视频收集到监督微调做了什么?
构造分 4 步。第一步收集含笑视频,来源包括 TED 演讲、情景喜剧与 YouTube 野生视频,如双人对话、脱口秀与电影片段,先用现成笑声检测模型定位含笑片段,再按话语边界切分,聚焦每段末尾的笑声,假设双人场景中笑声具传染性而视为整体笑场。第二步抽文本线索,工具包括语音转写、主动说话人、视频字幕、面部动作与声学统计,关系从标题与描述推断。
第三步用外部大模型按详细提示生成伪推理标签,要求引用话语、韵律、表情、字幕、话题或关系中触发笑声的部分,限 30 词左右。第 4 步人工校验,在众包平台让 3 名标注者按定义标类型并打置信度,多数投票定金标,推理则先审伪标签,对则保留,错则重写。论文报告一致性为 Fleiss Kappa 约 0.42,属中等一致,反映任务主观性。
训练上论文在 3 种纯文本主干上验证方法通用性,包括 Vicuna、LLaMA3 与 Qwen2.5,均使用文本线索,接入 MoLE 后有监督微调 3 轮,批量为四,学习率为十万分之一,丢弃率为零,用深度加速做显存优化。基线音视频模型则用同样秩与缩放的低秩微调以保一致。论文未报告随机种子与多轮方差,这是复现缺项。
评测条件:数据划分、基线与指标方向如何定?
先讲划分再讲对照,比较才公平。论文的问答总数与切分是理解一切数字的前提,下表按任务列出训练、验证、测试与合计,视频总数为三千五百九十,问答总数为六千三百八十六,约为前作 4 倍。检测、分类与推理的测试量分别为数百量级,分类测试仅 114 条,推理测试 188 条,小样本下波动需谨慎。基线分 3 类,音视频大模型直接吃原始视频音频,视觉大模型吃视频加文本化音频,本文方法吃全量文本线索并加自指令与 MoLE。指标方向是检测与分类看精确率、召回率、F1 与准确率,越高越好,推理看 BLEU、METEOR、ROUGE-L 与句向量相似度,越高越好,另有人类偏好排名,越低越好。
下面这张表要回答的问题是各任务有多少可训练与可评测样本,公平条件是同一划分下比较不同表示路线,指标方向是样本量越大估计越稳,分类与推理测试较少需结合人工评判看。
| 任务 | 训练 | 验证 | 测试 | 合计 |
|---|---|---|---|---|
| 笑声检测 | 1565 | 460 | 359 | 2384 |
| 类型分类 | 1636 | 207 | 114 | 1957 |
| 笑声推理 | 1565 | 292 | 188 | 2045 |
| 全部问答 | 4766 | 959 | 661 | 6386 |
表后解释是,总量与分布支持论文覆盖多场景的主张,但也暴露不均衡,分类与推理测试偏少,自动生成指标对解释质量的刻画有限,因此论文补了人类排序。附录还报告话语数多为二到八,视频时长多在 30 到 50 秒,输入提示多为两千到四千字符,输出多在一百五十到二百五十字符,这说明长提示是常态,复现需留足上下文。硬件预算原文未给具体卡型与时长,只提到用 ZeRO 3 级优化,这是成本缺项。
主结果:文本线索加专家是否全面占优?
主比较的问题是,在同一 SMILE-Next 训练集上,不同输入表示谁更懂笑声。论文报告纯文本大模型加自指令与 MoLE 在三任务上均最好,优于音视频与视觉大模型,且在 3 种主干上趋势一致,支持收益主要来自表示与建模而非某一主干。定性例子中,1 对分居多年、男子出狱后重建关系的对话里女子发出尴尬笑,音视频模型误判为亲昵幽默,视觉模型给出模糊的意外幽默解释,而本文模型点出问题尴尬与面部紧张。
人类偏好中,本文模型对视觉与音视频模型的胜率分别为约五成五与六成九,平均排名最低,更贴近人类判断。但需注意未胜出项,视觉模型在个别样本仍能答对愉悦型,音视频模型在显性大笑上并非全错,总体趋势不等于每组都成立。下图展示该尴尬笑案例的 3 模型回答差异,先看图再读消融。
本段导读图三的定性对比,左侧给出对话、表情标注与人物关系,右侧并列 3 种模型的推理回答,帮你直观看到显式关系与表情文本如何纠正幽默误判。
看图路径: 1. 先读左侧人物关系与面部动作标注,确认分居二十五年与出狱后重建关系的尴尬背景;2. 再对比右侧三种模型回答,观察只有文本线索模型点出尴尬而非幽默;3. 注意中间黑色箭头,理解输入条件相同而解释分歧来自表示与推理差异
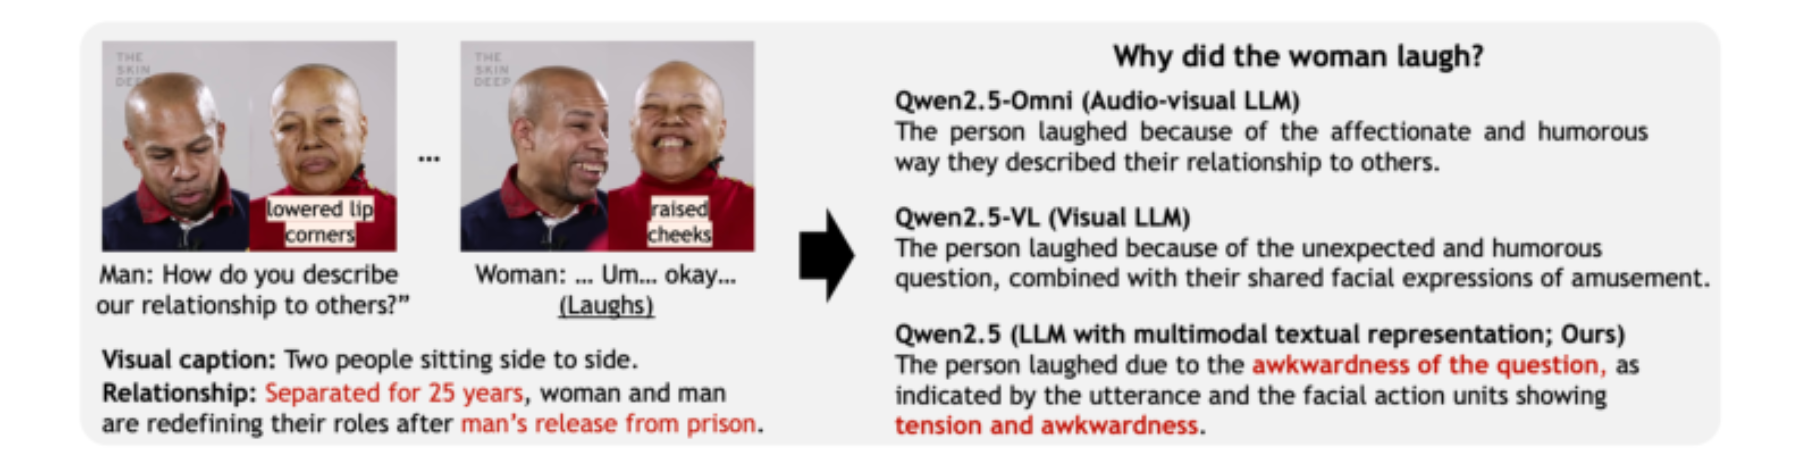
论文图 3。原论文 Figure 3:“Qualitative results. As shown, LLMs trained at SMILE-Next can reason and analyze about the ambiguous and slight laughter, exactly giving the reason and classifying what this…”。
图三的解释是,左侧关键信息是男子问如何向他人描述关系,女子迟疑后笑,关系标注点明分居与出狱背景,面部从嘴角下垂变为抬颊。右侧只有本文模型把笑归因于问题尴尬与紧张,而另 2 模型仍用亲昵或意外幽默解释。这支持文本化能显式利用关系与表情,但也提醒若关系抽取错了,推理可能随之错,像素不能给出数值分数,判断依据是文字归因是否与背景一致。
消融与反证:少了线索、少了组件会怎样?
消融按问题组织,先看表示,再看组件,最后看开销与噪声。第一个问题是只给转写稿够吗。论文在 Qwen2.5 上对比仅转写与转写加声学加视觉加关系,发现全量线索在检测、分类与推理上全面提升,检测 F1 从 0.86 升至 0.96,分类 F1 从 0.40 升至 0.70,推理句向量分也有提升,支持非言语信号不可或缺。但反例是转写本身已能解一部分显性搞笑样本,全量线索的代价是提示更长与依赖多个抽取器。第二个问题是自指令与 MoLE 是否叠加有效。
论文在 Vicuna 与 Qwen 上逐步加入两者,多数指标继续提升,尤其推理的 BLEU 与 ROUGE 在 Vicuna 上增幅明显,但在 Qwen 上增益较小,说明主干与数据匹配度会影响收益。第 3 个问题是路由是否真分工。图四显示专家一主导,分类略偏专家二,检测略偏专家三,推理更依赖专家一,支持动态调配而非均匀激活。第四个是延迟与噪声,论文报告 MoLE 仅增约 1% 到二延迟,面部噪声三成内与声学噪声四到五成内仍稳,超阈则误判音高,这是有限解释而非因果证明。
下面两张表分别回答表示消融与延迟代价,公平条件是同主干同划分,指标方向是分数越高越好、延迟越低越好。
| 条件 | 精确率 | 召回率 | F1 | 准确率 |
|---|---|---|---|---|
| 仅转写检测 | 0.8571 | 0.8669 | 0.8613 | 0.8696 |
| 全线索检测 | 0.9582 | 0.9688 | 0.9629 | 0.9652 |
| 仅转写分类 | 0.6397 | 0.4436 | 0.4019 | 0.5433 |
| 全线索分类 | 0.6828 | 0.7559 | 0.7094 | 0.7559 |
上表后解释是,全线索的主要收益在召回与 F1,代价是更长的输入与更多抽取失败点,未胜出边界是纯搞笑且表情不明显的样本可能仅靠转写已够。下一表看延迟,条件是单专家与多专家在检测、分类与推理上的毫秒耗时。
| 模型 | 检测毫秒 | 分类毫秒 | 推理毫秒 | 全部毫秒 |
|---|---|---|---|---|
| 单专家 | 981 | 790 | 2802 | 1494 |
| 多专家 | 991 | 796 | 2845 | 1513 |
| 差值 | 10 | 6 | 43 | 19 |
表后解释是,多专家每样本多约 0.02 秒,可忽略,但这只是推理延迟,不含离线抽取与训练成本,不能承诺总成本改善。训练资源与输出帧率原文未量化,需补测。
本段导读图四的路由权重,3 张子图分别为专家一到三,每组内含检测、分类与推理三根柱子,纵轴为门控权重,帮你验证分工假设。
看图路径: 1. 先比较三个子图中专家一的橙色柱高度,确认其在三任务上均占主导;2. 再看专家二在分类任务上相对升高,专家三在检测任务上相对升高;3. 结合纵轴门控权重,理解软路由按任务调配而非均匀激活
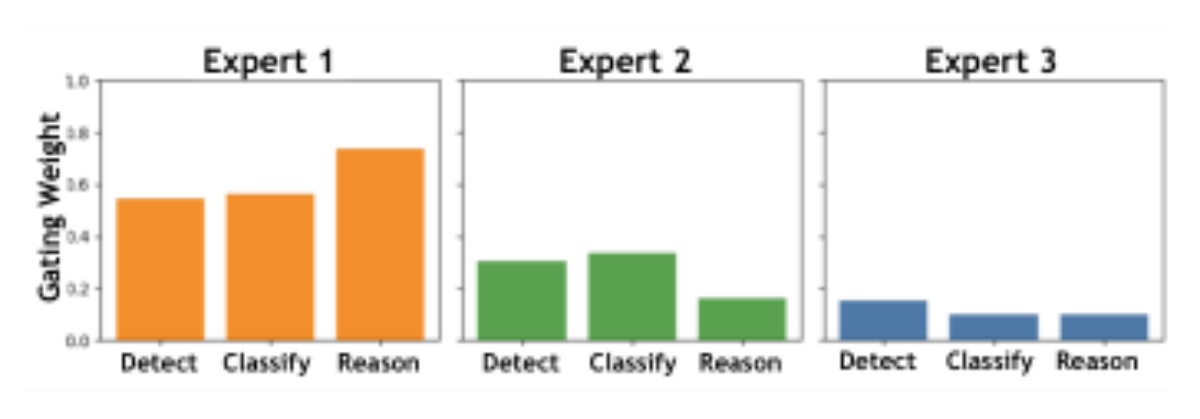
论文图 4。原论文 Figure 4:“Visualization of MoLE’s router weights.”。
图四的解释是,橙色专家一在推理上最高约 0.7 以上,在检测与分类上约 0.5 以上,绿色专家二在分类上高于另两任务,蓝色专家三整体较低但在检测上略高。这种任务相关偏移支持 MoLE 学到分工,但主导专家仍是同一个,说明共享知识占大头,复现时若三专家权重长期均匀或塌缩,应检查路由学习率与初始化。
边界在哪:哪些笑声与语言暂未覆盖?
论文在局限中明确,视频来源虽广,仍难穷举真实笑声,罕见或非典型情形可能欠代表,例如文化特定表达、细微社会规范与复杂群体互动。语言上主要为英语内容,未充分覆盖其他语言与文化语境,跨文化泛化待验证。方法上文本化依赖转写、表情与声学工具,任一抽取错都会向上传导,伪标签虽经人工校验但主观性仍在,一致性仅中等。评价上分类与推理测试量小,自动指标难以衡量解释的因果正确性,人类排序样本与指南细节未充分公开。
伦理上数据仅用公开视频并受平台政策约束,但笑声误读可能带来偏见与社交后果,需负责任使用。缺失证据不是技术错误,相关性也不是因果,论文未测量误判率在不同人群上的分布,也未报告部署延迟与成本,不能从准确率提升推定实际交互体验必然变好。后续应补多语言、跨文化与群体场景,以及按人群分层的误差分析。
复现先做什么,需要哪些配置与检查?
复现分 4 步。第一步按论文切分重建问答,检测、分类与推理的训练验证测试数见前表,问题模板要固定,检测问有无笑并限两句式回答,分类问三选一并带类型定义,推理要求 30 词内并以指定句式开头,否则指标不可比。第二步重建文本线索,对每话语存转写、声学数值、面部前三动作、字幕与关系,声学保留原始数值不做主观分档,关系按主持嘉宾或演讲观众等角色记录,抽取失败要留空标记而非编造。
第三步训练先跑无 MoLE 的纯文本微调做基线,再加自指令合成数据,最后加三专家 MoLE,主干冻结,专家秩 8 缩放十六,学习率十万分之一,训练 3 轮,批量四,丢弃零。第 4 步评测固定同一训练集,检测分类看 F1 与准确率,推理看 BLEU、METEOR、ROUGE-L 与句向量分并补人工排序,注意百分点与相对百分比不同,不同指标差值不放同一列。关键超参数与信息条件已在上文保留,代码与权重方面,本次未验证公开可用,不作可运行断言,需按论文地址自行确认。
还需补的验证是多种子方差、抽取器替换影响与噪声阈值复测。
何时值得尝试,一句话如何复述方法?
当你的任务需要解释笑声而不仅是检出笑声,且能拿到转写、表情与关系等文本线索时,值得尝试先文本化再推理的路线,它把纠缠的音视频转为可读证据,便于语言模型做社会因果判断。当场景多为显性大笑且无关系信息时,传统音视频分类可能已够,不必引入长提示与多专家。
一句话复述是,把视频切分为话语段并抽成文本线索,用人工问答做种子让大模型合成更多笑声问答,再在冻结主干上为三任务各训一个低秩专家并由软路由加权,从而统一检测、分类与推理。重提结果时新增的适用条件是,论文增益在多主干上一致但幅度不一,Vicuna 上推理提升更大,Qwen 上较小,延迟仅增 1% 到二但未含抽取成本。常见误解是把自指令当人工标注替代,实际它是蒸馏扩充仍需人工校验;把 MoLE 当加速结构,实际它是为分工而设,速度基本不变。
把自动指标当人类认同,实际需以人工排序为准。收束时记住,笑声理解的核心矛盾是社会意图隐含而信号纠缠,本文用显式文本与分工专家缓解了它,但跨语言与跨文化的覆盖仍待补全。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses