英文题目:RealTalk-CN: A Realistic Chinese Speech Task-Oriented Dialogue Benchmark with Cross-Modal Analysis
会议身份:
conference:acl:2026:conference-paper-id:2026.acl-long.131
✅ 来源为官方会议 PDF;可重放的表格、公式文本与 Figure 像素已按 PDF 抽取结果绑定,未成功恢复的结构不作推断。
标签:#数据集 #基准设计 #鲁棒性 #语音 #语音对话系统
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 1.2/1.5 | 开源 0.0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:数据集与基准
👥 作者与机构
- Enzhi Wang:机构信息未能从会议 PDF 纯文本可靠映射
- Jiaming Zhou:机构信息未能从会议 PDF 纯文本可靠映射
- Yuhang Jia:机构信息未能从会议 PDF 纯文本可靠映射
- Aobo Kong:机构信息未能从会议 PDF 纯文本可靠映射
- Qicheng Li:机构信息未能从会议 PDF 纯文本可靠映射
- Yong Qin:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
任务型对话 Task-Oriented Dialogue / TOD 要求模型在多轮交互中理解用户意图并抽取槽位以完成订餐问路等目标,中文自发语音场景的难点在于重复犹豫自我修正与语气词拖长等不流利、年龄与地域口音变异,以及语音与文本在轮次间的自然切换。数据建设先按口语语法编写覆盖 58 个域、115 个槽位的多域脚本并预留约 10% 自然不流利,再由真人即兴对读并用专业麦克风与智能手机双路在安静室内录制,随后做话轮级时间戳对齐与意图槽位、不流利类型、说话人属性的多层标注与质检,最后划分出标准对话、跨模态对话与鲁棒性对比三类评测流。与纯文本的 MultiWOZ、CrossWOZ、RiSAWOZ,单轮的 SLURP、CATSLU,以及英文语音的 SpokenWOZ 相比,该链条以真人非合成语音保留韵律与口音,并将逐轮语音文本交替作为显式任务,更贴近车载与客服场景。在 RealTalk-CN 测试集上,流水线 Whisper-large-v3 加 GPT-4o 在多域口语意图分类准确率达 53.56,显著高于 GPT-4o-Audio-mini 的 46.31,而槽位填充联合目标准确率 Joint Goal Accuracy / JGA 方向反转,GPT-4o-Audio-mini 以 31.93 高于流水线的 26.09,表明粗粒度语义理解与细粒度抽取存在分化。结论仅适用于中文客服问询类朗读加即兴混合语音,对强噪声远场全双工打断及未覆盖地区口音的外推尚未验证。数据建设投入约 3.5 万美元,训练推理部署成本未披露。
🔗 开源与复现资源
- 数据相关资源:https://huggingface.co/datasets/BAAI/RealTalk-CN — 暂时无法访问 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么:要复述的任务与目标是什么?
本文输入是论文 RealTalk-CN 全文与本次收到的官方原图像素,目标是为刚进入语音与对话领域的研究生写 1 篇可核对能复述方法的技术解读。必须保留的信息包括数据集规模与采集方式、4 个评测任务的构造、基线与流水线的组成、主要定量结论与作者自述局限。输出是结构化中文解读,不做营销式判断。论文要解决的不是闲聊语音问答,而是中文多轮多域任务导向对话。
用户带着办事目标而来,例如查目的地、问商品折扣、订餐改酱料,系统要在多轮中记住意图与槽位并给出可执行回复。难点在于真实语音带有停顿语气词拖长、重复、自我纠正与犹豫,说话人覆盖不同年龄性别与地域口音,对话还会在语音与文字之间自然切换。已有中文任务对话数据多为文本,英文语音任务对话缺少不流利与说话人标注,中文语音大模型因此缺乏对应基准。
任务导向对话 × 语音大模型: 任务导向对话负责界定用户要办成的事和完成所需的槽位与步骤,语音大模型负责把语音信号听懂并生成回应,二者搭配的理由是真实助手必须在多轮口语中跟踪目标,组合后新增的作用是把语音鲁棒性与任务完成度放在同一基准里检验。
沿一个样本走一遍有助于建立依赖关系。用户先语音问今天中午推荐什么,系统语音回答推荐沙拉与香辣牛肉饭,用户改用文字补充要低脂少油盐并换蜂蜜芥末酱,隔几轮再用语音说再来一份中午推荐的低脂餐但换种酱。模型需要把分散在语音与文字中的菜品名、低脂指代关系与换酱请求整合起来,输出既记住沙拉又执行换酱的回复。这个例子是教学示意,不代表数据集原话,但它对应论文跨模态任务的设计动机。数据集与评测框架在正文声明已公开,链接为 HuggingFace 地址,但本次资源状态为暂时未能确认可达,因此只能写本次未能确认可达,不写已可下载。
相关路线如何划分:文本任务对话与语音理解有何不同?
按同输入同目标同监督来划分,相关工作可分为 3 类。第一类是文本任务对话,例如英文 MultiWOZ 与中文 CrossWOZ 和 RiSAWOZ,它们有多轮多域与对话状态标注,但没有语音信号,无法测口语鲁棒性。第二类是单轮语音理解,例如英文 SLURP 与中文 CATSLU,它们有音频文本对,但只有单轮内容理解,没有多轮状态跟踪与回复生成。第 3 类是语音任务对话,早期 DSTC2 与 DSTC10 规模小或只有识别输出,英文 SpokenWOZ 是首个大规模多轮多域语音文本基准,但缺少不流利标注与说话人特征标注,中文此前没有对应物。
另有非任务导向的语音对话数据如 StyleTalk 与 VoxDialogue,关注风格或副语言信息,多用合成语音,不以办事为目标。与这些路线相比,RealTalk-CN 的定位是中文真人对真人录音的多轮多域任务对话,附带意图槽位、不流利类型与说话人特征标注,并支持训练集划分。理解这一划分可以避免把类别差异当成同条件胜负,例如不能用单轮理解准确率直接对比多轮槽填充联合准确率。
问题如何形式化:测什么、输入输出是什么?
论文把评测形式化为 4 个任务。标准任务包括意图分类、槽填充与端到端聊天。意图分类输入是当前轮语音加历史上下文与候选意图列表,输出是从列表中选择最贴合最后一轮语音目的的标签。槽填充输入是当前语音加上意图分类预测得到的意图与指定槽类型,输出是只与该意图相关的具体取值列表。端到端聊天输入是多轮语音历史,输出是系统语音回复的转写内容。
跨模态聊天任务输入是语音与文字混合的历史,不允许同一轮同时给两种模态,输出仍是连贯回复,构造时把含 4 种不流利标记的轮次固定用语音、其余用文本,以隔离模态切换与不流利的影响。鲁棒性评测用口语化子集与流利子集的性能差衡量对不流利的容忍度,公平性评测按年龄与地域分组比较意图与槽填充差异。论文报告多域更考验意图分类,单域多域划分与口语流利划分共同构成 4 个评测子集。
数据集全景:规模、领域与标注如何组织?
RealTalk-CN 报告包含 5400 段对话、约 60,000 轮、约 150 小时真人对真人录音,覆盖 58 个域与 115 种槽类型,平均每段对话约 12.1 轮。论文称投入约 35000 美元用于采集与标注。录音在安静室内进行,同时使用专业麦克风与智能手机以保留设备多样性,并做时间戳对齐话语边界与轮次。文本脚本按自然口语特点设计,允许录制时即兴发挥以保持真实感,约 10% 数据有意保留重复犹豫自我纠正与语气词拖长等自发不流利。4 种不流利类型在图中有中文实例可直接对照,理解它们是后文 Col 划分的基础。
下面先看 4 种不流利在原图中的具体写法,再回到子集划分与跨模态示例。
看图路径: 1. 逐行看四种不流利类型的中文原句与英文翻译;2. 注意重复行中括号内为被重复片段;3. 注意自我纠正行回与肥同音造成的改口;4. 把四类标记与后文 Col 与 Sys 划分对应起来
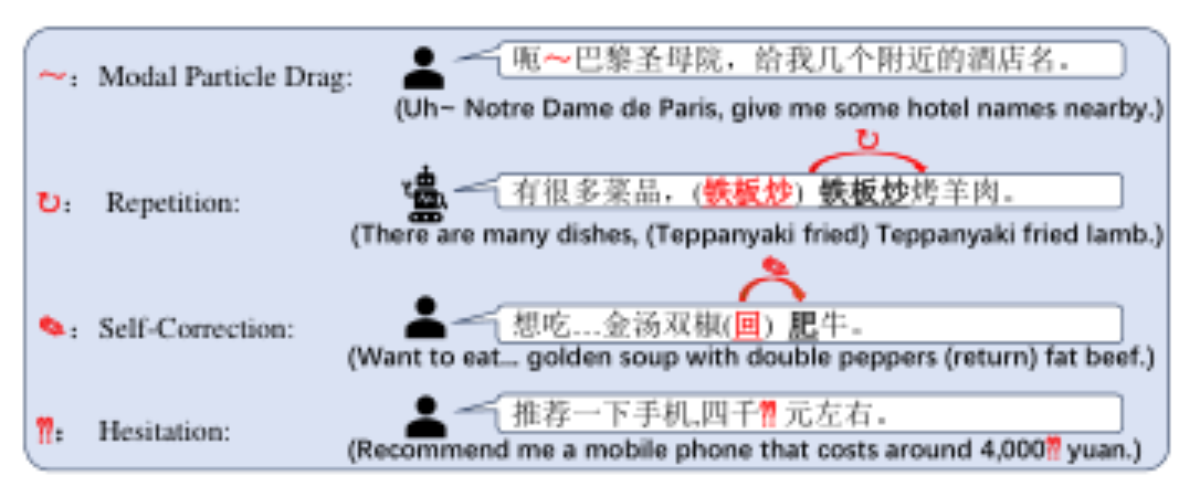
论文图 2。原论文 Figure 2:“Four speech disfluency types in Chinese dia- logues: Modal particle drag, repetition, self-correction, and hesitation.”。
上图把 4 类标记落在真实中文句子上。语气词拖长如嗯拉长后接巴黎圣母院问酒店名,重复如铁板炒被说两遍后接铁板炒烤羊肉,自我纠正如回与肥同音造成的金汤双椒回肥牛改口,犹豫如四千元左右的停顿标记。第三例特别注明回与肥发音相近,这解释了为何转写容易出错。复述时要记住每类标记既是标注字段,也是后文把轮次分入 Col 的依据。跨模态任务则要求模型在语音与文字交替中做指代消解。
下面这张示例图展示 1 次语音文字交替,读图时重点跟踪低脂餐指代与换酱请求的跨轮对应。
看图路径: 1. 沿从上到下四条消息看语音与文字如何交替;2. 找到系统推荐的沙拉与香辣牛肉饭两个实体;3. 跟踪用户文字偏好低脂少油盐换蜂蜜芥末酱;4. 确认最后语音轮次要求换酱仍指同一份低脂餐
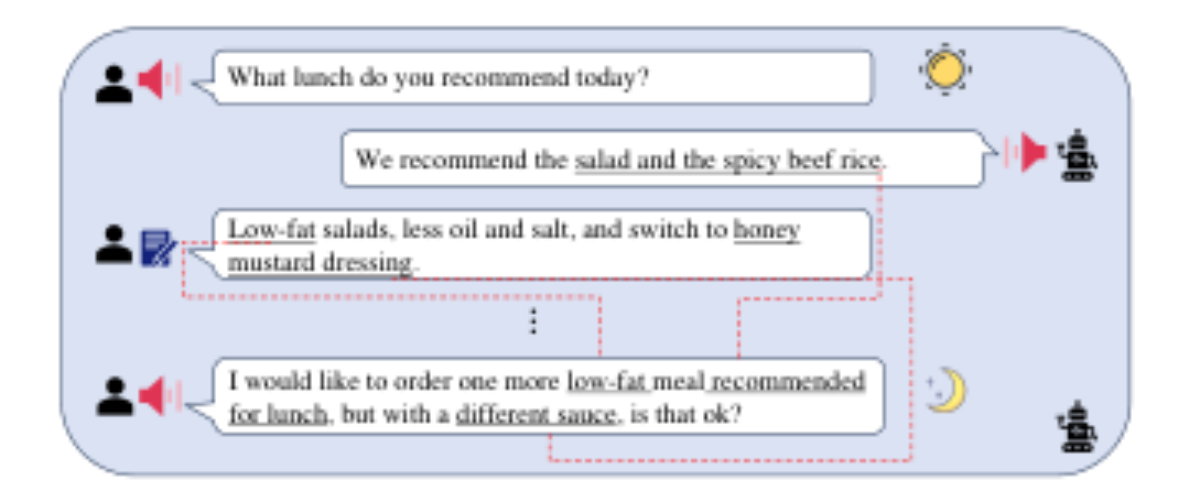
论文图 3。原论文 Figure 3:“An example of dynamically switching speech- text modality dialogue.”。
上图从上到下是语音提问、语音推荐、文字补充偏好、隔段时间再语音追单。系统语音推荐中的沙拉被用户文字表述为低脂沙拉并附加少油少盐换蜂蜜芥末酱,最后语音轮次说再来一份中午推荐的低脂餐但换种酱。模型必须把低脂餐解析为沙拉,并把换酱理解为在已有偏好上的再次修改。红色虚线在图中标出跨轮实体对应关系,说明评测关注的是分散在异构模态中的信息整合,而非单轮听写准确率。
组件一:意图与槽位标注如何支撑评测?
意图与槽位是任务对话的状态表示。意图是目的类别,论文附录列出介绍推荐询问解释等大类及细分,槽是完成任务所需的属性,附录列出人物价格地点时间菜系等上 100 种。标注时每轮语音对应一个意图与若干槽取值,意图分类评测用准确率与 PANDA 判别分,槽填充用 F1 与联合目标准确率。联合目标准确率要求一轮中所有槽都抽对才算对,比单槽 F1 更严格。实现上槽填充以意图分类预测结果作为输入,因此意图错误会向后传播,这是复现时必须保留的级联条件。
教学例子:若用户问大连海洋馆几点开,意图可能是询问时间,槽类型是旅游景点取值为大连海洋馆,模型先选对意图再抽对景点名才算联合正确。该例子仅用于说明机制,不添加效果数值。
意图分类 × 槽填充: 意图分类负责判断整句话的目的类别,槽填充负责抽出时间地点价格等具体取值,二者搭配的理由是只知道意图不够下单,只抽槽位不知下一步动作,组合后才能支撑对话状态跟踪与端到端回复。
组件二:不流利与说话人标注如何分组?
不流利标注把每轮按是否含标记分为口语化与流利两类,标记包括语气词拖长、重复、自我纠正与犹豫。说话人标注记录年龄性别与籍贯地域,地域按附录映射到东北华北华东华中华南西南西北七区。分组时同一段多轮对话的轮次可能分属 Col 与 Sys,因此两子集内容差异被缩小,比较的是同一话题下有无标记的影响,而不是两个独立话题的难度差。作者在局限中明确承认这种非最小对设计,严格因果需要对同一流利句注入不流利再测。
说话人分组则把全数据集按年龄与地域切分后平均性能做雷达图,并用统计检验判断差异是否显著。理解分组方式才能正确解释后文槽填充对老年与方言更敏感的结论。
口语不流利 × 说话人差异: 口语不流利负责描述同一句话里的重复犹豫自我纠正等现象,说话人差异负责描述年龄性别地域口音带来的声学分布变化,二者搭配的理由是真实部署同时遇到内容扰动与声学偏移,组合后才能区分模型是语义不行还是听不清特定人群。
构造与训练说明:本研究训练了什么、没训练什么?
本研究没有训练新的语音大模型,训练一节实际承担的是数据构造与评测调用流程。构造过程包括脚本设计、控制录音环境、多样说话人选择与多层质检,论文称通过标准化脚本、受控环境与详细标注指南保证可靠与生态效度。数据集划分为训练验证测试三部分,测试集在 4 个子集上各有固定样本量,训练集可供后续研究使用,但本文实验采用零样本评测协议,不在 RealTalk-CN 训练集上微调被测模型。实际计算是调用已有模型做推理,包括 Qwen2-Audio、Baichuan-Audio、GLM-4-Voice、MiniCPM-o、Baichuan-Omni、Qwen2.5-Omni、GPT-4o-Audio-mini,以及 Whisper-large-v3 加 GPT-4o 的流水线。
聊天回复质量用 GPT-4o-mini 打分,含无参考与有参考两部分之和,满分 10 分。未报告的内容包括被测模型的冻结参数细节、梯度路径与训练超参数,这些缺项在复述时应明确指出,不从模型名称推定实现。
下面看说话人分布原图,它决定了公平性分析的样本基础,读图时注意各组占比极不均衡。
看图路径: 1. 先看左中右三块饼图分别对应年龄性别地域;2. 核对年龄段以 21-24 与 25-34 为主但覆盖 45-54;3. 核对性别接近一半一半与地域覆盖七大区;4. 把地域不均与后文槽填充公平性分析联系起来
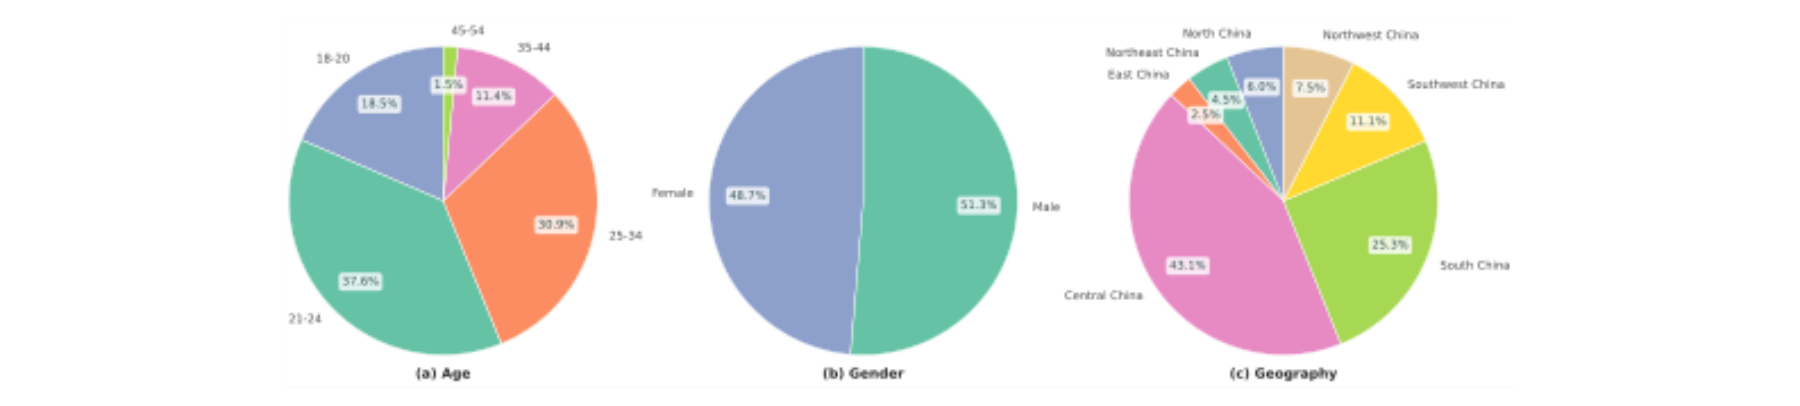
论文图 1。原论文 Figure 1:“The distribution of Speakers. The dataset covers most age groups.”。
上图左中右分别为年龄性别地域分布。年龄以 21-24 占比最高约 37.6%,其次 25-34 约 30.9%,35-44 与 18-20 各约一成多,45-54 仅约 1.5%。性别男性约 51.3% 女性约 48.7% 接近均衡。地域以华中约 43.1% 最多,华南约 25.3% 次之,西南约 11.1%,西北约 7.5%,华北约 6.0%,东北约 4.5%,华东约 2.5%。分布不均意味着老年组与部分地域样本较少,显著性检验需结合效应量一起看,不能只看均值高低。
实验条件:基线、子集与指标方向如何对齐?
比较问题是端到端语音模型与传统流水线在真实中文口语任务中的差距,以及不流利、多域与模态切换各自带来多少损失。公平条件是所有模型走同一零样本流程与同一提示模板,意图分类候选数平均每轮约 25 至 34 个,槽填充以上一步意图预测为输入,聊天任务统一用 GPT-4o-mini 打分。子集记号中 MD 为多域、SD 为单域、Col 为含不流利标记、Sys 为流利。指标方向是意图准确率、PANDA 分、槽 F1、联合目标准确率与聊天分越高越好。被测基线覆盖开源端到端与 Omni 模型、闭源 GPT-4o-Audio-mini 与 Whisper 加 GPT-4o 流水线。
附录还报告 3 模态对照与历史轮数影响,以及年龄地域显著性检验所用的检验方法。复现时需保留候选意图数量、级联输入与打分模型版本,否则分数不可比。
主结果:不流利与多域分别打中了哪个指标?
要回答的核心问题是口语化与多域是否同等影响所有任务。论文报告口语化子集上多数模型槽填充明显下降而意图分类相对稳定,原因是意图靠整句核心语义可容忍重复纠正,槽填充需精确定位取值易被非规范表达打断。聊天任务同样在口语化子集下降,因为它需要抽取关键信息再整合回复。多域主要影响意图分类而槽填充相对稳定,因为跨域语义多样与上下文切换更考验目的判断,而具体槽类型受域变化影响较小。
流水线在意图分类与聊天上总体占优,因其直接利用 GPT-4o 文本语义能力,端到端在槽填充上反而更好,因其保留声学细节更能处理语音变化。平均 across 所有任务时流水线保持领先,GPT-4o-Audio-mini 次之。
流水线方法 × 端到端语音模型: 流水线方法分工是先用 Whisper-large-v3 转写再用 GPT-4o 理解文本,端到端语音模型分工是直接从语音编码到语义与回复,搭配比较的理由是前者文本语义强后者保留声学细节,组合对照新增的作用是定位槽填充与闲聊式回复各自的瓶颈在识别还是理解。
下面这张纯语音与跨模态聊天对照图是理解模态切换代价的关键,读图时先分清颜色再看箭头方向。
看图路径: 1. 先确认蓝色为纯语音聊天橙色为跨模态聊天;2. 对比上排三模型橙色普遍低于蓝色的下降模式;3. 对比下排 Baichuan-Omni 橙色高于蓝色的提升模式;4. 结合 MD-Col 与 SD-Sys 四组看下降是否跨条件稳定
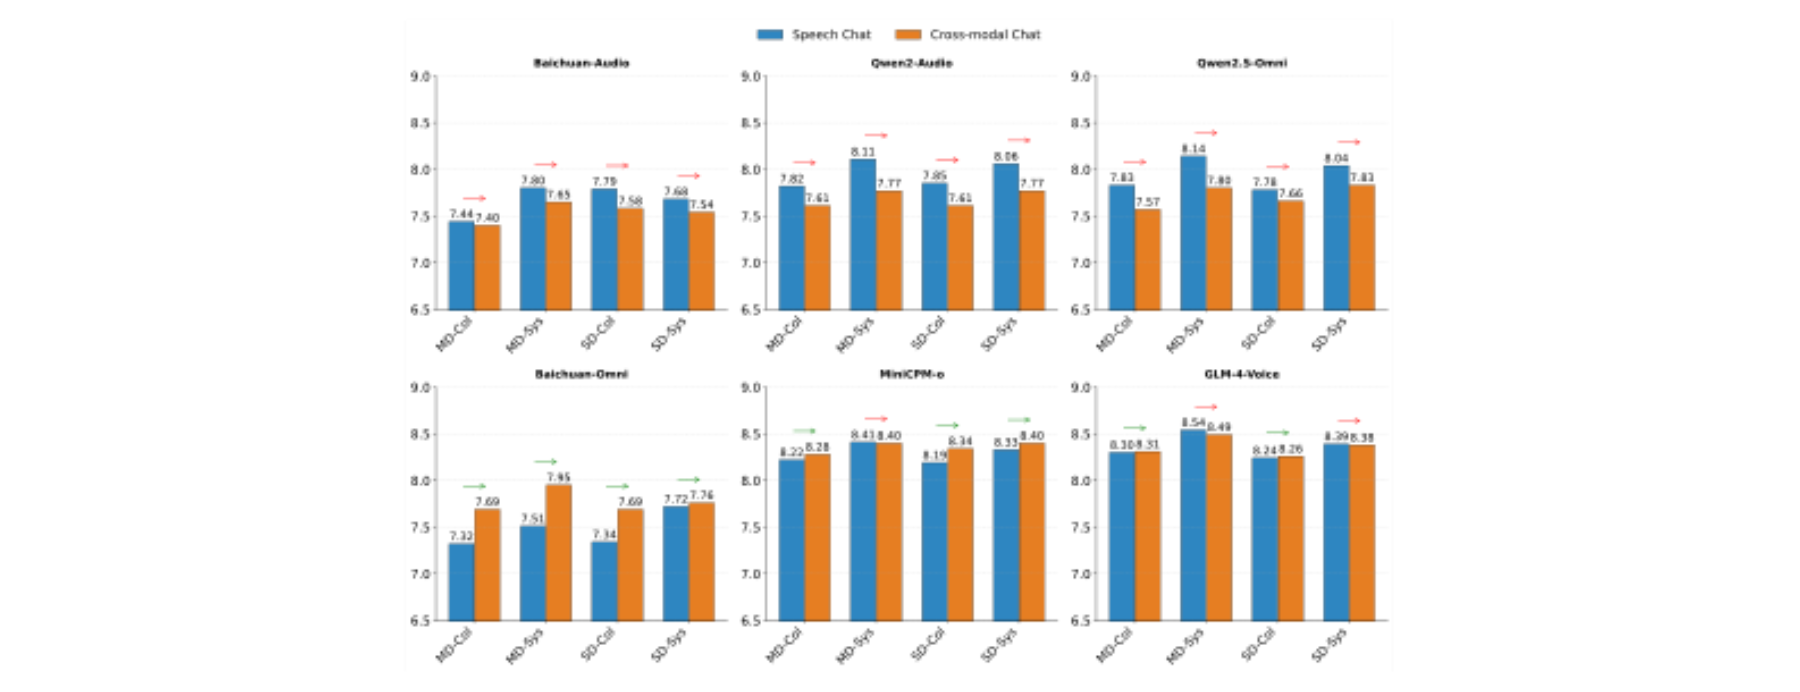
论文图 4。原论文 Figure 4:“Performance comparison between pure speech chat tasks and Cross-modal chat tasks.”。
上图分 6 个子面板对应 6 个开源模型,每个面板内 4 组为 MD-Col、MD-Sys、SD-Col、SD-Sys,蓝色为纯语音聊天,橙色为跨模态聊天。可见 Qwen2-Audio、Baichuan-Audio 与 Qwen2.5-Omni 的橙色多低于蓝色且经配对 t 检验差异显著,MiniCPM-o 与 GLM-4-Voice 差异不显著,Baichuan-Omni 的橙色反而高于蓝色。论文把行为分为下降、稳定与受益 3 类,受益解释为用文本替换历史中的语音后减轻了识别负担。复述时不能把总体趋势推广到每个模型每组都成立。
下面先看聊天任务的数字结果表,比较问题是流水线与各端到端在四子集上的高低与口语化落差。
| Models | MD-Col | MD-Sys | SD-Col | SD-Sys | Avg |
|---|---|---|---|---|---|
| Pipline | 8.92 | 9.12 | 8.84 | 9.12 | 9.00 |
| Baichuan-Audio | 7.44 | 7.80 | 7.79 | 7.68 | 7.67 |
| GLM-4-Voice | 8.30 | 8.54 | 8.24 | 8.39 | 8.37 |
| Qwen2-Audio | 7.82 | 8.11 | 7.85 | 8.06 | 7.96 |
| Baichuan-Omni | 7.32 | 7.51 | 7.34 | 7.72 | 7.47 |
| MiniCPM-o | 8.22 | 8.41 | 8.19 | 8.33 | 8.29 |
| Qwen2.5-Omni | 7.83 | 8.14 | 7.78 | 8.04 | 7.95 |
| Gpt-4o-Audio-mini | 8.66 | 8.79 | 8.71 | 8.77 | 8.73 |
该表为聊天任务得分,满分 10 分,列为 4 个子集与平均值,行覆盖流水线与 7 个语音模型。可见流水线在四列约 8.84 至 9.12 之间居首,GPT-4o-Audio-mini 约 8.66 至 8.79 次之,GLM-4-Voice 与 MiniCPM-o 约 8.2 至 8.5 居中,其余模型约 7.3 至 8.1。多数模型 Col 列低于同域 Sys 列,支持口语化损害聊天质量的判断。代价是该表只反映自动打分,未测人工满意度与延迟,不能把高分直接等同于部署体验好。未胜出项如 Baichuan-Omni 平均约 7.47 最低,说明其纯语音聊天基线偏弱,这也解释了后文它在跨模态下反而提升的起点效应。
反证与边界:跨模态、三模态与说话人差异说明什么?
除主结果,论文还提供 3 类特有细节。第一是跨模态显著性检验,报告部分模型切换模态后显著下降,部分稳定,部分提升,说明异构上下文整合能力因模型而异。第二是 3 模态对照,在单域子集上同时测纯文本、纯语音与跨模态,纯文本并不总是最高,提示语音与文本各有信息损失。第三是说话人差异,意图分类相对稳定而槽填充受年龄地域影响更大,老年与方言较重地区性能更低,部分模型如 GPT-4o-Audio-mini 对老年与强方言区下降更明显。
历史轮数分析显示单域意图在 3 至 5 轮即近峰值,对长上下文依赖有限,而聊天随完整历史稳定受益。这些分析支持公平性与上下文设计的针对性改进,但相关性不等于因果,且 Col 与 Sys 非最小对,地域样本不均。
纯语音对话 × 跨模态对话: 纯语音对话要求全部历史都以语音输入,跨模态对话要求含不流利标记的轮次用语音其余用文本并动态交替,二者搭配的理由是隔离模态切换本身的影响,组合后新增的作用是检验模型能否整合分散在不同模态中的菜品推荐与偏好信息。
下面这张子集统计表用于核对 Col 与 Sys 在文本长度与轮数上的可比性,比较问题是性能差是否可能来自长度而非不流利。
| Statistic | MD- | MD- | SD-Col | SD-Sys |
|---|---|---|---|---|
| Samples | 3,837 | 3,837 | 892 | 892 |
| Avg Utterance Length | 27.42 | 19.27 | 25.61 | 20.76 |
| Avg Dialog Rounds | 8.54 | 7.73 | 8.14 | 7.58 |
该表列出测试集四子集的样本量、平均话语长度与平均对话轮数。样本量上 MD 各 3837 条、SD 各 892 条,平均话语长度 Col 约 25 至 27 字长于 Sys 约 19 至 20 字,平均对话轮数约 7.5 至 8.5 轮接近。这说明 Col 更长更冗余,长度本身可能增加抽取难度,因此不能把 Col 与 Sys 之差全部归因于不流利标记,这是作者自述局限的定量依据。复现时应保留长度差异的交代,不自行构造等长最小对来替代。
下面这张 3 模态小表进一步检验模态替换的影响,比较问题是在单域上文本是否总是最优。
| Model / Setting | Text | Speech | Cross-Modal |
|---|---|---|---|
| Baichuan-Audio | 6.98 | 7.79 | 7.58 |
| GLM-4-Voice | 8.44 | 8.24 | 8.26 |
该表在单域口语化与流利条件下对比纯文本、语音与跨模态聊天分。以所选两行为例,Baichuan-Audio 在 SD-Col 上文本约 6.98 低于语音约 7.79,GLM-4-Voice 在 SD-Col 上文本约 8.44 高于语音约 8.24,说明文本替换并非对所有模型都有利。代价是该表只展示部分模型,完整 7 模型对照需回原文附录。未胜出项的存在提醒我们跨模态受益依赖模型本身的语音与文本能力对比,不能推广为切换模态必然提分。
局限与未验证推测:哪些结论不能外推?
论文明确报告三项局限。第一是地域与年龄覆盖仍不能代表中国全部语言景观,老年样本很少,地域分布高度不均。第二是 Col 与 Sys 来自同一对话而非最小对,内容差异虽被缩小但长度与话题仍不完全可控,更严格的因果需要向同一流利句注入不流利再测。第三是跨模态任务只交替语音与文本,未探索更复杂多模态交互。缺失证据包括误判率延迟成本等部署指标,以及训练资源与推理开销的系统测量,因此不能承诺这些量得到改善。
显著性检验使用 Kruskal-Wallis H 检验与 Mann-Whitney U 检验并报告 Cohen 效应量,但不同指标差值不能混放比较,自动打分不能当成人评。重提结果时应加限定语:报告显示槽填充更怕不流利,支持老年与方言区更难,跨模态下降或提升可能与模型历史利用方式有关,尚待验证。
复现先做什么:数据、划分、提示与统计如何对齐?
复现先做四件事。第一是确认数据版本与划分,测试集四子集样本量与平均长度轮数按上表核对,训练验证测试划分按原文附录执行,不自行重分。第二是固定评测流程,意图分类候选列表替换、槽填充以上一步意图预测为输入、聊天用 GPT-4o-mini 无参考加有参考之和,温度设 0 以减少随机性。第三是保留基线组成,流水线为 Whisper-large-v3 转写加 GPT-4o 理解,端到端按原文模型版本调用,提示模板用附录意图与槽填充示例以及聊天打分模板。
第四是统计方法对齐,跨模态用配对 t 检验,年龄地域用整体检验加两两比较并报告效应量。下面这张显著性摘录表展示部分年龄地域比较的 p 值与效应量方向,复现时用于核对分组口径而非直接对比分数高低。
下面这张表摘录意图分类按地域的显著组,比较问题是哪些地域显著高于或低于总体。
| Model | Region p-value | d-value Comparison |
|---|---|---|
| minicpm Northeast China | 0.00 | 0.34 |
| minicpm Northwest China | 0.00 | 0.46 |
| minicpm Central China | 0.00 | -0.21 |
| gpt4o_mini South China | 0.00 | -0.07 |
| gpt4o_mini North China | 0.00 | 0.13 |
| gpt4o_mini Northeast China | 0.00 | 0.34 |
该表列出部分模型在特定地域的 p 值与 Cohen 效应量及高低方向,例如东北与西北在多个模型上显著偏高,华中在部分模型上显著偏低。但原文同时报告槽填充中西南与西北多显著偏低、华南多偏高,说明意图与槽填充的地域模式并不一致。代价是该摘录只含显著组,非显著组未列出,不能据此计算总体排名。未评测边界包括训练后公平性是否改善与真实部署延迟,复现时应明确标注未测,不把显著性当成因果证明。数据获取方面,原文给出 HuggingFace 地址并声明 CC BY-NC 与门控访问,本次未能确认可达,复现前需先确认可达性与许可。
收束:何时值得尝试这个基准?
当研究目标是中文语音助手办事实用性而非单句听写时,值得尝试 RealTalk-CN。它把多轮目标跟踪、口语不流利、说话人多样性与语音文字切换放在同一基准里,迫使模型同时处理语义、声学与跨模态指代。复现优先级是先跑通意图分类与槽填充级联,再跑聊天打分,最后做 Col 与 Sys 差值与年龄地域分组。若槽填充在 Col 上明显低于 Sys 而意图稳定,可支持不流利主要打中抽取环节的判断;若流水线在聊天上领先而端到端在槽填充上反超,可支持语义强与声学细各有所长的判断。
若跨模态下部分模型下降部分提升,则需结合纯文本对照判断是整合失败还是识别负担减轻。还需补的验证包括等长最小对因果实验、人工评价与延迟成本测量,以及老年与方言样本扩充后的公平性复测。只有补齐这些,才能把基准上的差距转化为可靠部署的改进。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses