英文题目:Phantom Menace: Exploring and Enhancing the Robustness of VLA Models Against Physical Sensor Attacks
会议身份:
conference:aaai:2026:conference-paper-id:40881
✅ 来源为官方会议 PDF;可重放的表格、公式文本与 Figure 像素已按 PDF 抽取结果绑定,未成功恢复的结构不作推断。
标签:#对抗训练 #对抗鲁棒性 #音视频 #语音交互
评分:6.9/10 | 创新 1.3/2 | 技术严谨 1.0/1.5 | 实验充分 1.0/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:应用研究
👥 作者与机构
- Xuancun Lu:机构信息未能从会议 PDF 纯文本可靠映射
- Jiaxiang Chen:机构信息未能从会议 PDF 纯文本可靠映射
- Shilin Xiao:机构信息未能从会议 PDF 纯文本可靠映射
- Zizhi Jin:机构信息未能从会议 PDF 纯文本可靠映射
- Zhangrui Chen:机构信息未能从会议 PDF 纯文本可靠映射
- Hanwen Yu:机构信息未能从会议 PDF 纯文本可靠映射
- Bohan Qian:机构信息未能从会议 PDF 纯文本可靠映射
- Ruochen Zhou:机构信息未能从会议 PDF 纯文本可靠映射
- Xiaoyu Ji:机构信息未能从会议 PDF 纯文本可靠映射
- Wenyuan Xu:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
视觉语言动作模型以双路相机图像与麦克风语音指令为输入,经视觉语言骨干与动作解码器直接输出机械臂位移与夹爪开合,需在长时序闭环中维持感知语言动作一致,在遮挡强光与不可闻干扰下极易误抓碰撞或失控。针对该威胁,本文提出Real-Sim-Real框架并分三步衔接:先在Franka Panda真机平台采集激光致盲、光投影、电磁色带截断、激光色带与超声模糊六类视觉攻击及语音拒绝欺骗两类音频攻击的物理效应,再在Libero仿真器中按弱中强三档参数化复现条纹位置、截断比例与模糊幅度,最后用仿真搜索到的有效参数回放真机块抓放进行验证,形成物理到仿真再到物理的闭环。仿真输出的攻击强度表直接决定真机攻击装置配置,真机成功率又反过来校验仿真参数的真实性。防御阶段将干净轨迹与0.3比例随机攻击样本混合,对OpenVLA、OpenVLA-OFT、pi0与pi0-fast做对抗微调,使模型在保持干净性能的同时适应分布外物理扰动。与聚焦数字对抗补丁、越狱与后门的已有方法不同,该链路强调可开关可隐身的主动物理注入及其闭环行为后果,而非单步数字篡改。在Libero-Long任务设置下,强激光致盲攻击下OpenVLA的Task Success Rate为0.0%,低于无攻击基线的53.7%。该结论适用边界限于四模型、四套Libero任务与八种攻击实现,尚未验证导航、双臂协作与户外动态光照等外推场景。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 代码相关资源:https://github.com/ZJUshine/Phantom-Menace — 链接可访问(HTTP 200)
- 第三方资源:https://github.com/TimSchneider42/franky — 链接可访问(HTTP 200) 预印本/扩展版链接未在会议页展示;会议版来源见页首官方记录与 PDF。 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,目标是什么,本文要解决什么矛盾?
本文的输入是视觉语言动作模型在真实部署中实际吃到的传感器信号:一路是多个相机采集的彩色图像,另一路是麦克风采集的语音指令再经自动语音识别转成的文本。模型根据看到的场景和听到的指令,端到端输出机械臂连续的抓取和移动动作。攻击只发生在物理传感器环节,攻击者仅有黑盒访问权限,不掌握训练数据、模型结构与参数。评估同时覆盖仿真大规模试验和真实机械臂验证,防御要求在不明显损害干净任务的前提下提升鲁棒性。
输出是 1 篇可核对的方法复述:讲清 8 种攻击如何建模、仿真强度如何分档、4 个模型在 4 类任务上如何比较、对抗训练如何组织。中心矛盾在于,这类模型在干净仿真环境下任务成功率很高,但真实传感器链路可被激光、电磁、超声等难察觉的物理信号注入,一旦成像或语音环节失真,下游语言推理也可能输出错误动作。对于刚进入语音音频领域的读者,关键是把麦克风看作一条会饱和、会被超声搬移的声学前端,而不是理想文本输入框。
把相机看作包含光电转换、传输总线、图像信号处理和防抖算法的链路,而不是理想图片数组。
同输入同目标的已有路线差在哪里?
与本文同输入同目标的第一条路线是视觉语言动作模型的数字对抗研究,例如直接改图像像素生成对抗补丁、在文本侧做越狱式指令篡改、或在训练阶段埋后门。这类工作的输入也是图像加文本,目标也是让任务失败或执行指定错动作,但运行阶段停留在数字域修改,没有经过激光照射、电磁耦合、超声共振等物理 transduction 过程,因此不能回答物理信号经过传感器前端后会留下什么样的结构化失真。
第二条路线是通用鲁棒性评估,例如加模糊、高斯噪声、改光照、换相机位姿或加入遮挡。这类工作与本文共享仿真评估的手段,但扰动大多是分布内或场景泛化性质的退化,不是攻击者可主动开关、追求隐蔽的恶意注入。第三条路线是孤立的物理传感器攻击研究,例如针对麦克风的超声指令、针对相机的声学模糊、针对传输接口的电磁干扰。
这些工作在顶级安全会议上有扎实的物理实验,但通常只评估单个传感模块的识别错误,不评估完整具身系统从感知到动作的任务级后果,也不解决大规模可重复比较的问题。本文的定位是把第三条路线的物理真实性与第一二条路线的系统级任务评估结合起来:先把物理攻击模式采集并数字化,再在仿真中大规模比较不同模型和任务的敏感性,最后回到真实机械臂验证参数的有效性。
理解这一分工,就不会把本文误读为又一种数字对抗补丁,也不会把它误读为只做了 1 次真实演示。
威胁模型把攻击者限制在什么能力内?
论文把场景设定为带机械臂的视觉语言动作系统:用户经麦克风下指令,系统经相机看环境,再把两路信号变成动作。攻击目标是让系统执行非预期甚至危险的错误动作导致任务失败。攻击者能力被严格限制为只能向传感器注入物理信号,例如激光、电磁或超声,不能直接做数字域的加噪、压缩、模糊或水印。模型知识是黑盒:不知道训练数据、模型结构、预训练参数,也不知道具体传感器型号和语音识别或防抖算法细节。
这一设定的教学意义在于,所有效果必须能用传感器物理和信号处理解释,不能用知道模型梯度来解释。攻击者可以主动控制攻击的开始和结束,因此比被动摆放的物理对抗样本更隐蔽:平时表现正常,注入瞬间才出错。这也决定了后文仿真必须区分攻击强度弱中强三档,因为物理功率、距离、角度和调制方式不同,残留痕迹的幅度和结构完全不同。
对音频读者而言,要特别注意两类语音攻击的区分:拒止是让系统听不到可用指令,欺骗是让系统听到错误的追加指令,前者考验系统在缺指令时能否靠视觉补救,后者考验语言骨干是否会过度服从恶意后缀。
真实-仿真-真实框架如何组织五步?
论文提出的真实到仿真再到真实框架要解决效率与真实性的两难:纯物理实验做大规模组合太慢,纯数字高斯噪声又不像真实攻击。做法是 5 步闭环。第一步在真实世界采集攻击模式:用激光直射相机记录光斑,用投影仪向白背景投恶意图像并记录反射进入相机的图案,用超声扬声器向麦克风注入高强度超声或调制语音并录下麦克风响应。第二步在仿真环境做大规模评估:把这些模式按物理原理叠加到仿真图像或语音指令上,覆盖 4 个模型和 4 类任务。
第三步在仿真中搜索攻击参数:调节叠加权重、条纹数量与位置、截断比例、模糊幅度等,找到能稳定造成失败的参数。第四步回到真实世界攻击:用搜到的参数在机械臂台架上实际注入信号,检验仿真结论是否成立。第五步做对抗训练防御:把攻击数据按比例混入训练。图中上半部分给出从物理信号到传感器到 2 类模型系列再到 4 种后果的主链,下半部分给出左右两侧真实与仿真的分工与中间防御的桥接。
下面这张总览图先帮初学者建立主路径,再看闭环分工,同一小节内形成导读与解释的闭环。
看图路径: 1. 先从左到右看物理信号到传感器再到两类模型系列最后到四种后果的主链;2. 再看下方蓝色横条标注的真实-仿真-真实框架;3. 对照左下角真实世界的采集与真实攻击编号与右下角仿真评估和参数搜索编号;4. 注意中间对抗训练方块如何连接两侧
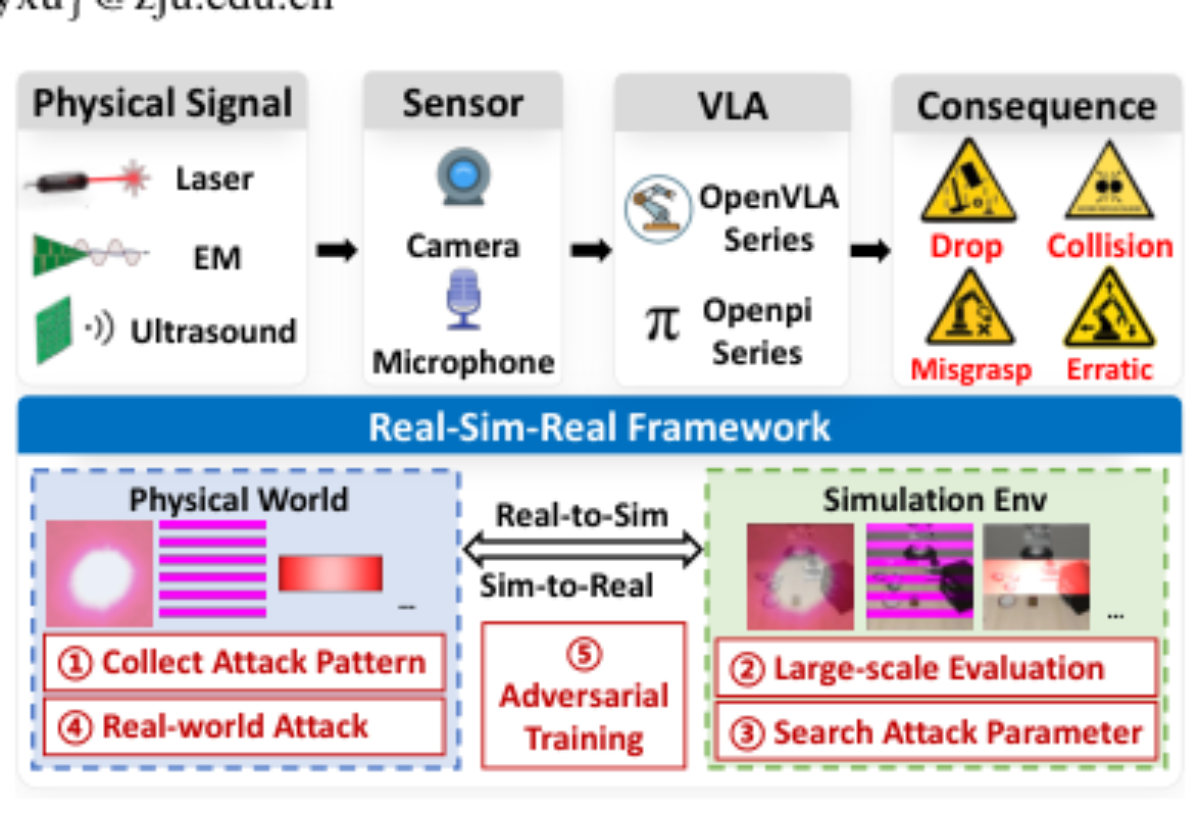
论文图 1。原论文 Figure 1:“Overview of the “Real-Sim-Real” framework.”。
上图可见左侧物理信号只有激光、电磁和超声 3 类,中间传感器只有相机和麦克风 2 类,接着是开放视觉语言动作系列与轻量流水线系列 2 类模型,最右是掉落、碰撞、误抓和失控 4 种后果警示。下半蓝色横条明确把真实世界放在左框、仿真环境放在右框,双向箭头标注真实到仿真与仿真到真实,红色方框按编号标出采集模式、大规模评估、搜索参数、真实攻击与对抗训练 5 步。对学习者的可执行理解是:不要把仿真当作最终证据,仿真的作用是低成本筛选参数,真实复现才是物理可信度的来源;也不要把防御看作独立模块,防御用的攻击混合数据正来自前 4 步沉淀的模式库。
真实到仿真 × 仿真到真实: 真实到仿真的分工是把物理世界采集到的激光光斑、投影图案、麦克风录制的恶意响应变成仿真器可叠加的数字模式;仿真到真实的分工是把仿真中搜到的有效攻击参数拿回真实机械臂上复现。两者搭配的理由是纯物理实验太慢、纯数字扰动不真,组合后形成可大规模评估又能被真实验证的闭环。
模型与攻击组件各自做什么计算?
视觉语言动作模型在本论文中的结构可以沿一个倒茶样本走一遍:输入是多张桌面图像加上请把茶倒入杯子这句话,视觉编码器把每张图像变成视觉嵌入,文本编码器把指令变成文本嵌入,大语言骨干把两类嵌入融合为动作令牌,动作解码器再把令牌变成增量位移、增量旋转和夹爪开合。
论文列出 4 种解码形态:直接把大模型输出文本当作离散动作逐个自回归生成、用多层感知机把隐状态映射为动作、用扩散过程从噪声逐步去噪出动作序列、用流匹配学习速度场从当前分布到目标分布。不同被测模型的差异正在于编码器、语言骨干和解码器的组合不同,这为后文有的模型更怕视觉破坏、有的更怕语音欺骗埋下结构原因。
视觉-语言模型 × 动作解码器: 视觉-语言模型负责把多路相机图像和语音转写的文本指令变成多模态嵌入,再由大语言骨干输出动作令牌;动作解码器负责把这些令牌变成机械臂可执行的位移、旋转和夹爪开合。两者搭配的理由是前者解决看懂场景和听懂指令,后者解决连续平滑的物理执行,组合后形成从传感器感知到物理动作的端到端映射。
麦克风攻击的计算目标是改变麦克风捕到的时域波形。论文用加法模型描述:被攻击信号等于原始语音加恶意信号。拒止攻击先在数字域生成高斯噪声,再经超声扬声器以人耳听不到但能使换能器或放大器饱和的方式注入并录制响应,最后把录制的恶意噪声叠加到原指令上;欺骗攻击先用语音合成生成恶意指令,再经激光或超声注入并录制响应,最后作为后缀追加到原语音之后。仿真时拒止对应指令置空,欺骗对应追加忽略上文不要移动之类的后缀。
对音频读者,这里的关键不是语音识别的词错误率,而是任务级行为:缺指令时模型能否从视觉上下文猜对任务,错指令后缀是否会被语言骨干优先执行。
\[Sattacked(t) = Soriginal(t) + Smalicious(t)\]上式中被攻击信号是麦克风最终波形,原始信号是用户语音,恶意信号是录制的超声或激光响应,时间变量强调这是时域叠加。实现上不是简单的数字加噪,而是先物理注入再录制再叠加,以保留前端非线性和滤波的痕迹。
语音拒止攻击 × 语音欺骗攻击: 语音拒止攻击的分工是用高强度超声噪声使麦克风链路饱和,让自动语音识别得不到可用指令;语音欺骗攻击的分工是用激光或超声注入一段恶意语音后缀,篡改原指令语义。两者搭配的理由是同一麦克风通道既可能可用性丢失也可能完整性被改写,组合起来说明听觉通道需要同时考虑无指令和错指令两种失效。
相机攻击的计算目标是改变像素坐标与时间上的图像。论文区分两类数学形态:一类是环境光加恶意光的线性叠加,另一类是对环境光做变换函数,例如丢行、错位或运动补偿错误。激光致盲属于前者,用真实激光图案按权重叠加并调权重模拟强弱;光投影属于前者,把投影仪投出的图案按权重和位置叠加;激光彩条利用卷帘快门,用不同波长与强度模拟彩色条纹。
电磁彩条与电磁截断针对传输接口,用紫色条纹数量宽度位置和截断比例模拟;超声模糊针对带防抖的相机,用线模糊径向模糊旋转模糊的幅度模拟。图示的八宫格从左到右强度递增,直观展示了从轻微遮挡到完全丢失目标的连续变化。
\[Iattacked(x, y, t) = F(Lambient(x, y, t))\]上式中被攻击图像是最终像素,环境光是正常场景辐射,变换函数代表丢行、截断或模糊等结构化破坏。它与加法模型的区别在于,破坏不再是逐像素加一项,而是改变采样与解码过程,因此残留的是条纹、错位和拖影,而不是均匀噪声。
电磁截断攻击 × 超声模糊攻击: 电磁截断攻击的分工是干扰相机传输总线造成丢行和跨帧拼接错误,直接破坏图像结构;超声模糊攻击的分工是共振惯性单元误触发防抖补偿,造成像素域的线性、径向或旋转模糊。两者搭配的理由是一个破坏数据传输完整性,一个破坏成像稳定假设,组合说明即使环境光正常,相机链路内部仍可被物理信号破坏。
下面这张结构图把上述输入表示组件目标输出串成一条可复述的流水线,同一小节内形成导读与解释闭环。
看图路径: 1. 先看顶部传感器输入分为多图像与一句倒茶文本指令两路;2. 再看中部视觉编码器与文本编码器如何汇入大语言模型骨干;3. 对照底部四种动作解码方式与输出的位移旋转夹爪表示
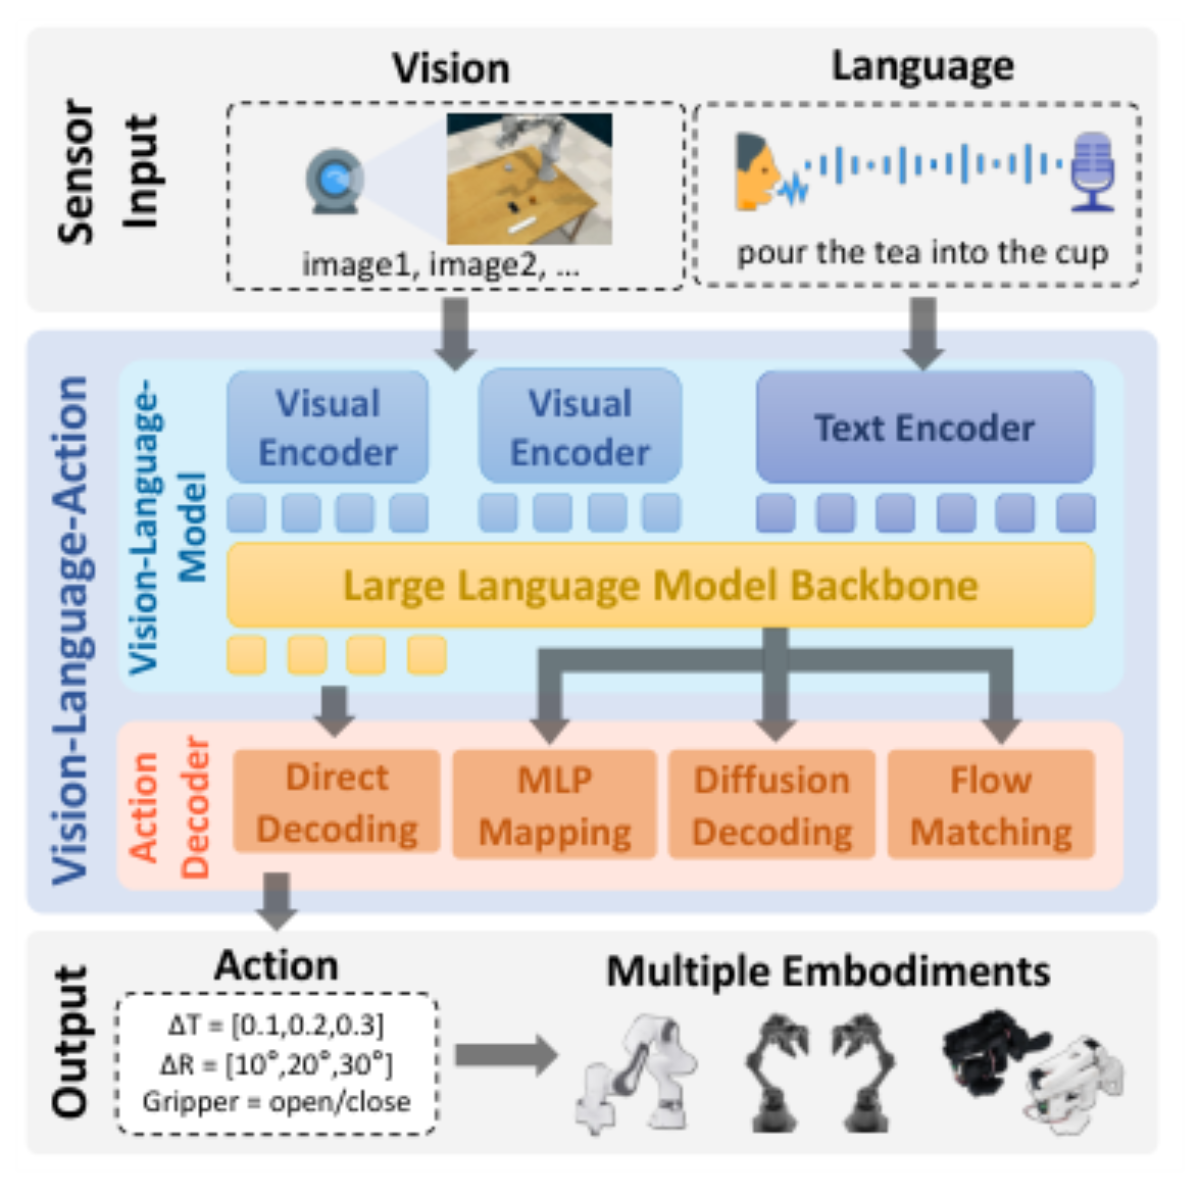
论文图 2。原论文 Figure 2:“Architecture and pipeline of VLA models.”。
上图顶部明确分为视觉与语言两路输入,中部视觉编码器与文本编码器并列汇入大语言模型骨干,底部并列 4 种动作解码分支,最终输出统一的位移旋转夹爪表示并可驱动多种构型。对初学者,可执行动作是先遮住底部只看中部,确认多模态融合点在大语言骨干;再遮住顶部只看底部,确认无论哪种解码都要输出同一物理动作格式;最后思考攻击发生在顶部传感器时,中部嵌入会如何偏移。
没有从零训练时,微调与对抗训练实际做了什么?
本研究没有从零训练视觉语言动作大模型,实际计算是基于已有开源模型的微调与对抗混合训练。论文报告先在干净数据集上微调 4 个被测模型以适应仿真任务,再混入一定比例攻击数据做对抗训练。对抗参数原文明确给出混合比例与选择范围:攻击数据集比例为 0.3,攻击方法从 6 种相机攻击中随机选,强度从弱到强随机选。评估与微调硬件也明确报告:评估在一张 4090 上运行,微调使用显存 80 吉的 H800 并采用低秩适配技术。
监督来源是仿真任务的成功执行轨迹与攻击叠加后的对应样本,优化目标仍是让模型在干净与受扰输入下都能输出正确动作。论文未报告学习率、步数、优化器细节与梯度是否截断,也未说明语言骨干与视觉编码器哪些参数冻结,因此不能从模型名字推定具体冻结策略,只能复述已给的混合比例与随机选择机制。
任务成功率 × 对抗训练: 任务成功率的分工是统计成功回合占总回合的比例,用来量化攻击造成的功能损失;对抗训练的分工是先在干净数据训练再混入一定比例攻击数据继续训练,让模型见过分布外扰动。两者搭配的理由是前者是效果标尺,后者是干预手段,组合后才能判断鲁棒性提升是否以干净性能为代价。
对抗训练的直观理解是让模型在训练时见过攻击造成的分布外扰动,而不是只见过干净图像与清晰指令。论文报告的代价是干净集平均下降约 3%,收益是在中强度攻击下全面回升,对开放视觉语言动作模型提升最大约 60%。这 1 对比说明防御不是免费的:用少量干净性能换取受扰下的任务保持。对于复现者,先要复现干净微调的基线成功率,再按 0.3 比例混入攻击样本;若干净基线本身不稳,对抗阶段的提升数字将不可比。
缺失项是训练时长与计算预算的具体数值,论文只给出硬件型号,没有给出小时数或步数,因此复现成本只能按自有集群实测补记,不能引用原文没有的数字。
仿真与真实实验在什么条件下比较?
仿真侧选用开放的视觉语言机器人仿真器与配套数据集,包含空间布局、物体识别、目标变化和长时程 4 类任务,分别考验不同摆位下的操作、对不同物体的搬运、同一场景不同目标的理解、以及长时程规划执行。被测模型为 4 个代表性模型,覆盖不同结构与训练数据,均先用仿真数据微调以保证基线可用。指标是任务成功率,定义为成功回合数除以总回合数,方向是越高越好。
攻击强度分弱中强 3 档,仿真中语音拒止对应指令置空,语音欺骗对应追加恶意后缀,真实实验直接采用仿真中搜到的参数。真实侧用 1 台带腕部相机和全局相机的机械臂加麦克风,语音经语音识别转文本,用外部控制器实时控制;为适配真实桌面抓放任务,用遥操作采集 1 小时数据微调模型。下面表格把必须对齐的实验要素列出,避免把不同任务或不同阶段的数字混比。
下表提出比较问题:在什么任务划分、什么模型集合、什么指标与硬件下讨论成功率,公平条件是同一仿真器与同一微调后基线。
| 条件 | 指标 | 基线对象 | 运行硬件 | 任务划分 |
|---|---|---|---|---|
| 仿真评估 | 任务成功率 | 4 个代表性模型微调后 | 4090 评估,H800 微调 | 空间,物体,目标,长时程 |
| 真实验证 | 成功次数占比 | 同一 4 个模型真实微调后 | 真实机械臂台架 | 桌面块抓放 |
| 防御对比 | 任务成功率 | 干净基线与对抗训练后 | 同上评估硬件 | 同仿真 4 个任务 |
上表的主要收益是把数据集、模型、阶段、指标与硬件 1 次对齐,代价是它不包含任何成功率数值,不能代替结果表。未胜出项是原文未报告统计显著性与重复次数的聚合口径,因此不能把 1 次高成功率当作稳定优势;未评测边界包括不同光照距离角度下的物理功率变化,这些在仿真中只用权重与条纹数代理。
下面这张实物图展示真实台架的传感器与攻击设备布局,同一小节内形成导读与解释闭环。
看图路径: 1. 先找到中间机械臂与腕部相机和顶部全局相机的相对位置;2. 再看左侧电磁平台与麦克风和右侧投影激光超声平台的摆放;3. 对照桌面上的色块与白色盒子理解抓放任务场景
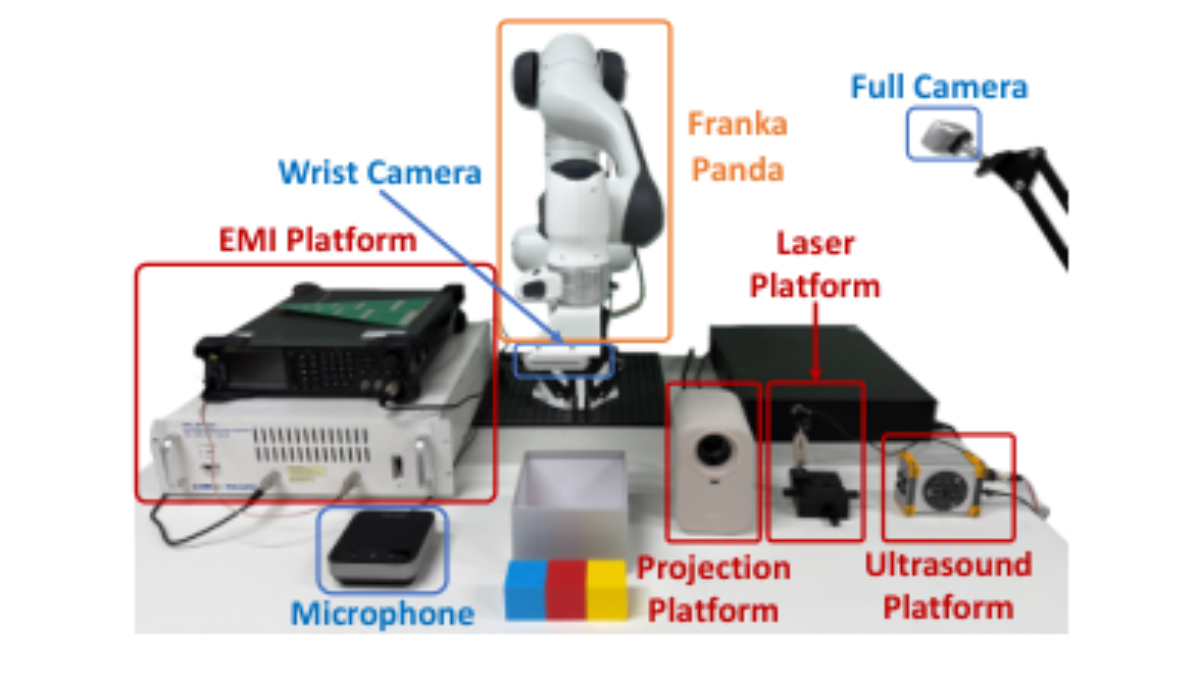
论文图 4。原论文 Figure 4:“Real-world experiment setup. A Franka Panda equipped with a wrist camera, a full camera, and a micro- phone is used as an attack target VLA system.”。
上图可见腕部相机固定在夹爪处,全局相机从侧上方俯视桌面,麦克风放在左侧电磁平台附近;右侧依次是投影平台、激光平台和超声平台,中间是待抓的色块与白色收纳盒。对音频读者,可执行观察是先确认麦克风与超声源的距离和朝向,因为这决定注入强度;再确认 2 个相机的视角互补关系,因为这决定单一相机被致盲后是否还有可用视角;最后注意台面材质与环境反射,这会影响投影与激光图案的实际对比度。
攻击造成多大任务损失,哪些模式最具破坏性?
论文报告的直接结论是所有被测模型都对传感器攻击敏感,但在攻击模态、强度和任务类型上呈现明显分化。相机侧的激光致盲、电磁截断和超声模糊在中强档下破坏最严重,因为它们抹掉目标位置与类别等关键视觉特征,导致意外动作或危险操作;光投影、激光彩条和电磁彩条相对较轻,因为它们更多是注入干扰而非摧毁主体,目标通常仍可辨认。
语音侧的拒止攻击效果取决于任务与指令的对应关系:在目标变化但场景固定的任务中缺指令会使模型无所适从,而在场景与指令一一对应的任务中模型可从视觉上下文猜对意图;欺骗攻击则与语言理解和指令跟随能力正相关,带大语言骨干且用特征调制增强跟随能力的模型反而下降最多。长时程任务在多数强攻击下出现灾难性崩溃,说明误差会沿步骤累积。
真实实验进一步报告 4 种后果:已闭合夹爪意外松开致物体掉落、手臂或夹爪与环境碰撞、抓错物体、以及无规律乱动造成混乱与能量浪费。这些是论文直接观察到的行为类别,不是自动指标的换算。
下表把 8 种攻击按目标传感器、物理信号、仿真做法与强度含义整理成可复述的清单,公平条件是同一仿真叠加流程,比较维度是破坏的是可用性还是完整性。
| 攻击条件 | 目标传感器 | 物理信号 | 仿真叠加做法 | 强度含义 |
|---|---|---|---|---|
| 激光致盲 | 相机 | 激光 | 真实光斑按权重叠加 | 弱到强权重递增 |
| 光投影 | 相机 | 可见光投影 | 投影图案按权重位置叠加 | 弱到强权重递增 |
| 激光彩条 | 相机 | 调制激光 | 卷帘快门彩条仿真 | 波长与权重变化 |
| 电磁彩条 | 相机 | 电磁干扰 | 紫色条纹数宽位置控制 | 条纹数递增 |
| 电磁截断 | 相机 | 电磁干扰 | 截断比例控制拼接错位 | 截断比例递增 |
| 超声模糊 | 相机 | 超声 | 3 类模糊幅度控制 | 模糊幅度递增 |
| 语音拒止 | 麦克风 | 超声噪声 | 指令置空加录制噪声 | 高强度饱和 |
| 语音欺骗 | 麦克风 | 激光或超声载语音 | 追加恶意后缀 | 语义篡改 |
上表的主要收益是把六相机攻击与两麦克风攻击的物理机理 1 次对齐,便于按链路复现;具体代价与反例是轻扰动类攻击在部分多视觉模型上退化较小,不能把所有视觉攻击等同为致盲。未胜出项是光投影与彩条类在强档下仍可能保留主体可辨性;未评测边界是真实距离角度与环境光变化下的功率阈值,仿真只用权重代理。
下表把对抗训练的配置与论文报告的整体变化放在同一行,便于核对代价与收益是否来自同一实验阶段。
| 策略 | 混合比例 | 攻击选择范围 | 干净集报告变化 | 中强度攻击报告变化 |
|---|---|---|---|---|
| 对抗训练 | 0.3 | 6 种相机攻击随机选,弱到强随机选 | 平均下降约 3% | 开放模型最大提升约 60% |
| 干净基线 | 无混合 | 无攻击 | 高达 90% 任务成功率 | 强攻击下大幅下降 |
上表的主要收益是区分可部署策略与基线:对抗训练是实际可运行的混合训练流程,干净基线是无防御对照;代价是干净集约 3% 的平均损失,且提升主要集中在中强度,对强破坏与语音欺骗的覆盖有限。需要提醒的是总体趋势不等于每组每步都成立,长时程与目标变化任务的恢复程度弱于简单抓放,不能把最大提升值当作平均收益。
模型差异与任务差异支持什么机制解释?
论文对模型差异给出有限解释而非因果证明。开放视觉语言动作基础模型对所有攻击都敏感,在中强档下退化明显,支持其鲁棒机制不足的判断;其优化变体通过多相机融合与本体感知增强了视觉鲁棒性,但对语音欺骗几乎归零,支持语言跟随越强越易被恶意后缀劫持的解释,该变体用了任务语言嵌入调制视觉特征的模块。
另 2 个流水线模型对视觉攻击相对更稳,论文推测它们记住了环境指令动作的对应关系,能在受扰下靠记忆补全,但这属于事后解释而非消融证明,因为没有逐模块关闭实验。任务差异方面,空间与物体任务因场景指令对应唯一,缺语音时可靠视觉补救;目标任务因场景固定而指令多变,缺语音则无法决策;长任务因步骤多,任何单步感知错误都会累积为失败。
这些对照的支持强度是相关性而非因果:它们能指导优先加固哪条链路,但不能证明换一个编码器就一定反转排名。若要进一步验证,需要补做遮挡单相机、关闭语言调制、或只扰动腕部与全局其中一路的对照,而原文未报告这类细粒度消融,因此复述时要用支持而不用证明的措辞。
还有哪些未测量与不适用边界?
从证据看,至少四项缺项需要明确。第一,统计口径缺失:成功率的回合数、随机种子、置信区间均未在给定证据中交代,因此不能判断小幅差异是否显著。第二,物理参数覆盖缺失:仿真用叠加权重、条纹数、截断比和模糊幅度代理真实功率距离角度,但真实阈值曲线未给出,不能把仿真弱中强直接换算为米或毫瓦。第三,开销缺失:对抗训练的额外时长、推理延迟、输出帧率均未报告,不能承诺防御不增加延迟,只能说干净任务成功率平均下降约 3%。
第四,攻击覆盖缺失:防御训练只从 6 种相机攻击中随机选,没有混入语音攻击,因此对语音拒止与欺骗的泛化属于待验证,不能把相机防御的效果推广到听觉通道。不适用边界包括:强激光致盲导致整帧过曝时任何视觉补偿都可能失效;电磁截断造成跨帧拼接错误时时序模型也可能错乱;语音欺骗后缀与真实指令冲突时,过度服从语言指令的模型风险更高。这些限制不是技术错误,而是复现与部署前必须补的验证。
复现先做什么,需要哪些代码与数据?
复现的第一步是拿到可运行的仿真基线:按原文选用同一仿真器与 4 类任务数据,先微调出干净基线并记录任务成功率,再引入攻击叠加。第二步是复现攻击模式库:按真实采集再数字叠加的思路,分别准备激光光斑、投影图案、彩条、电磁条纹截断、模糊核,以及麦克风录制的超声噪声与合成恶意后缀,注意保留物理录制环节而非纯数字加噪。第三步是按弱中强搜索参数:从小权重小幅度开始逐步加大,观察任务成功率何时断崖下降,并把有效参数带回真实台架。
真实台架至少需要带腕部与全局双相机和麦克风的机械臂、语音识别、实时控制器,以及激光、投影、电磁与超声 4 类注入设备,实验时注意激光与超声的安全防护。资源状态是正文开源声明的唯一依据:代码当前可用,已公开在官方仓库;扩展版本当前可用;第三方控制器当前可用。按本次收到的官方原图像素,框架总览、模型结构与真实台架图可作为搭建对照。
何时值得尝试对抗训练:当系统已在中强度视觉扰动下频繁误抓或碰撞,且能接受约 3% 的干净损失时,可按 0.3 混合比例先做小规模验证;若主要风险是语音欺骗,则不应直接套用本文的相机混合配方,需要另行构造语音攻击混合集并重新评估。
给新人的收束:记住什么,警惕什么?
记住三句话。第一,视觉语言动作模型的可靠性短板往往不在语言推理,而在传感器前端:麦克风饱和与语音后缀、相机过曝丢行与防抖误补偿,都能把正确的高层计划带偏。第二,评估必须分层:先用仿真大规模筛选哪类攻击哪档强度最致命,再用真实注入验证参数是否有效,最后用同一任务成功率比较防御的代价与收益。
第三,防御是交换而非免费午餐:混入攻击数据的对抗训练能提升中强度下的保持能力,但干净集平均约 3% 的损失与对强攻击和语音攻击的有限覆盖必须如实记录。警惕 3 种误解:把自动任务成功率当作安全证明,忽略缺指令与错指令是两种不同失效;把某次最大提升约 60% 当作平均收益,忽略任务与模型的分化;把仿真权重当作物理功率,忽略距离角度与环境反射的影响。
对语音音频背景的新人,建议把每次失败先定位到波形或像素层面:看麦克风波形是被噪声淹没还是被后缀篡改,看图像是主体丢失还是注意力被干扰,再决定是加固声学前端、增加多视角冗余,还是约束语言模块对可疑后缀的服从。补齐重复试验统计、物理阈值曲线与延迟开销测量后,这套方法才能从论文复述变为可部署的鲁棒性报告。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses