英文题目:WaveEx: Accelerating Flow Matching-based Speech Generation via Wavelet-guided Extrapolation
会议身份:
conference:aaai:2026:conference-paper-id:40490
✅ 来源为官方会议 PDF;可重放的表格、公式文本与 Figure 像素已按 PDF 抽取结果绑定,未成功恢复的结构不作推断。
标签:#流匹配 #时频分析 #高效推理 #音频生成
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.0/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 1.0/1.5 | 开源 0.0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:方法研究
👥 作者与机构
- Xiaoqian Liu:机构信息未能从会议 PDF 纯文本可靠映射
- Xiyan Gui:机构信息未能从会议 PDF 纯文本可靠映射
- Zhengkun Ge:机构信息未能从会议 PDF 纯文本可靠映射
- Yuan Ge:机构信息未能从会议 PDF 纯文本可靠映射
- Chang Zou:机构信息未能从会议 PDF 纯文本可靠映射
- Jiacheng Liu:机构信息未能从会议 PDF 纯文本可靠映射
- Zhikang Niu:机构信息未能从会议 PDF 纯文本可靠映射
- Qixi Zheng:机构信息未能从会议 PDF 纯文本可靠映射
- Chen Xu:机构信息未能从会议 PDF 纯文本可靠映射
- Xie Chen:机构信息未能从会议 PDF 纯文本可靠映射
- Tong Xiao:机构信息未能从会议 PDF 纯文本可靠映射
- Jingbo Zhu:机构信息未能从会议 PDF 纯文本可靠映射
- Linfeng Zhang:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
该工作面向基于流匹配(Flow Matching,FM)的语音生成,输入为文本或退化音频等条件、输出为连续波形或梅尔频谱,难点在于常微分方程(Ordinary Differential Equation,ODE)求解需数十次神经网络评估导致推理缓慢。方法首先对最近 \(K+1\) 个潜状态沿时间轴做离散小波变换(Discrete Wavelet Transform,DWT),分为表征全局趋势的低频系数与刻画局部细节的高频系数。接着对两路系数分别用一阶泰勒(Taylor)外推估计下一时刻值,以适配不同频带的平滑性与波动性。最后经逆小波变换(Inverse DWT,IDWT)重构下一潜状态,并按两阶段调度与 ODE 求解交替执行以跳过多数模型调用。与直接缓存或降步数方法不同,该框架在频率域解耦外推,避免高频噪声污染整体轨迹且无需训练或改架构。在 LibriSpeech-PC test-clean 上的 F5-TTS 评测中,6 次求解加 26 次外推将实时率因子(Real-Time Factor,RTF)从 0.116 降至 0.026,词错率(Word Error Rate,WER)仅由 2.132% 微升至 2.175%。该结论限于所测 4 类任务与 5 个公开模型,在早期高曲率段仍需密集求解,且原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,输出是什么,为什么推理会变慢?
这篇论文的输入是语音生成任务的常规条件,输出是可听的语音或音乐波形中间表示。以文本转语音为例,输入是一段文字加一段参考音色,输出是一段与文字内容一致、音色接近参考人的梅尔频谱或潜变量,再经声码器变成波形。以语音增强为例,输入是带噪语音,输出是干净语音。以声音转换为例,输入是源说话人的内容加目标说话人的音色,输出是保留内容、替换音色后的语音。以音乐生成为例,输入是歌词与风格条件,输出是完整歌曲的潜表示。
目标读者需要先建立一个动作链条:模型先把起点噪声放在潜空间,然后按学到的速度场一步步把状态推向目标语音,推完再解码成声音。这个一步步推进的过程在论文中被写成解常微分方程。白话说,常微分方程求解器(ODE solver)就是把连续运动切成很多小步,每小步都要问 1 次大神经网络下一步往哪走。流匹配(flow matching)就是训练这个速度场的方法,它不算似然,直接学速度方向。
必须保留的关键信息是成本结构。原文指出,对层数为 L、隐藏维度为 d 的 Transformer,每步复杂度约为 O(L·d2),还要重复几十到上 100 次;而 WaveEx 的数值操作复杂度约为 O(T log T),只与序列长度 T 有关,与模型大小无关。这个对比说明瓶颈不在解码器本身,而在反复调用大模型。因此加速的自然想法是少调几次模型,用便宜的数值预测补上缺掉的步数,但前提是潜轨迹足够平滑、可预测。论文的全部设计都围绕这个前提展开,后文的分解、外推、调度都是为了在不调模型时仍跟住真实轨迹。
已有加速路线各省了什么,又缺了什么?
把论文放在 3 条路线里看会更清楚。第一条是流匹配语音生成本身,覆盖文本转语音、声音转换、语音增强和音乐生成,生成都被写成解 ODE,质量好但步数多。第二条是已有加速,分为模型压缩与自适应积分或蒸馏,还有按经验剪步的 EPSS。白话说,压缩是把模型变小,蒸馏是把多步走法教成少步走法,剪步是挑子集时刻只算这些时刻。原文明确指出,这些方法常需要重训练、梯度信息或与结构绑定的改动,通用性受限。
第 3 条是视觉领域的数值外推与特征缓存,例如复用上一步特征的 FORA、按 Token 轨迹做泰勒预测的 TaylorSeer、做细粒度 Token 缓存的 ToCa。它们的操作对象是 latent 空间里的历史特征,动作是复用或预测,从而跳过部分完整计算。论文认为这类方法很少考虑语音的时间频率结构,直接搬到对时间敏感的语音上效果有限。
第四条是语音里长期使用的小波方法,用于去噪、压缩和多分辨率特征提取,强项是把信号按尺度分开。但原文指出,小波此前没有被放进生成模型的推理过程,更没有用来指导潜轨迹外推。WaveEx 的位置因此很明确:训练无关、即插即用,不改结构、不碰内部可缓存表示,只在潜状态序列层面做分频外推。这也解释了为什么后文要与 FORA、TaylorSeer、ToCa 在同一 F5-TTS 上对比,以及为什么要与 EPSS 对比,前者检验是否比通用缓存更适合语音,后者检验是否比经验剪步更保质量。
潜轨迹的平滑性与分频差异从何而来?
论文先用主成分分析(PCA)看潜轨迹。白话说,PCA 是把高维潜状态压到 2 维平面上看走向,横纵轴是第一、第二主成分,只保留变化最大的方向。这里要区分的对象是 3 条投影:全频轨迹、低频分量轨迹、高频分量轨迹,条件是同一段生成过程的不同频带表示,时间范围是从起点到终点的完整采样。
下图把这种差异画了出来,读图时先按图例确认颜色与对象,再看起点终点与弧线长度,不要把颜色深浅当成质量高低。
看图路径: 1. 先看横纵轴都是 PCA 主成分,确认这是潜轨迹投影而非声谱图;2. 比较橙色全频、蓝色低频的长弧线与红色高频的局域小圈;3. 找到每条曲线标注的 Start 与 End,确认低频走出连贯趋势
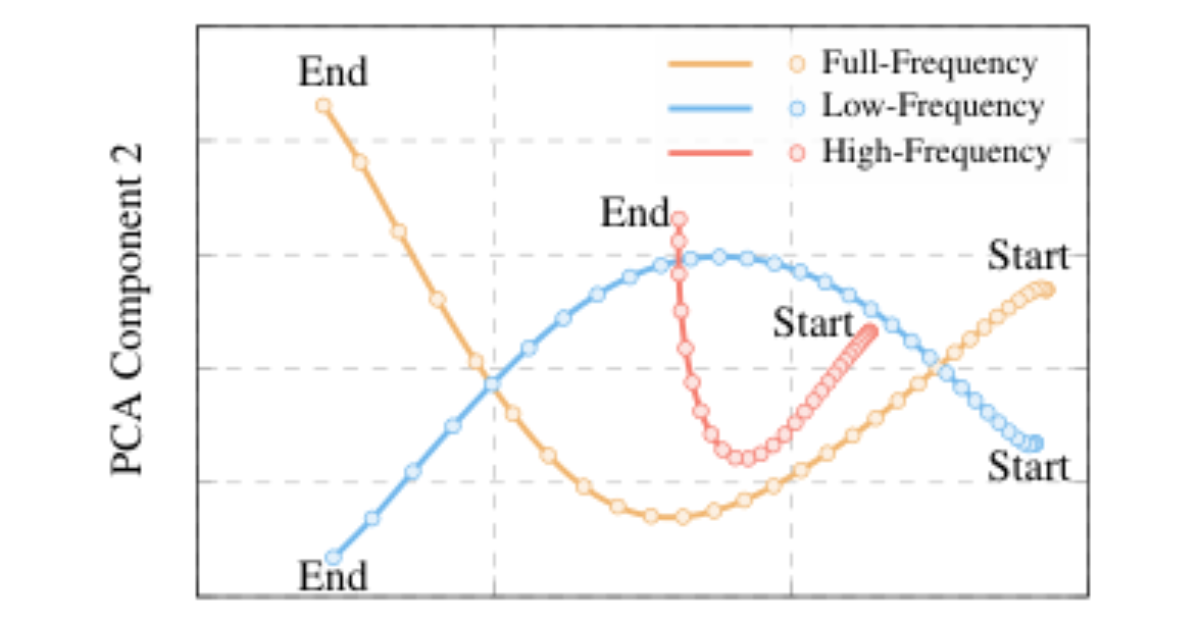
论文图 1。原论文 Figure 1:“Principal Component Analysis (PCA) applied to latent trajectories.”。
这张图可见的内容支持两个判断。第一是全局平滑:橙色全频走出一条长而连续的弧线,说明潜动态不是跳变的,这为外推提供了可行性。第二是频率相关结构:蓝色低频同样走出长弧线、趋势连贯,高频红色则挤在很小的局域里打转。教学上可以这样复述:低频管大方向,高频管小抖动,混在一起建模会让预测被高频噪声带偏。论文据此提出分开外推,低频跟趋势,高频单独处理局部调制。这个观察是后文 3 步法的直接依据,也是理解为什么直接做全频泰勒外推不如分频外推的关键。
WaveEx 如何把一次 ODE 调用换成三次数值操作?
先沿一个样本走完完整动作。假设正在生成一句话,当前潜状态是 zn。标准做法是把 zn 送进 ODE 求解器,调多次大模型得到 zn+1。WaveEx 的做法是在某些步不调模型,而是看最近 K+1 个已算好的状态,用纯数值方法猜出 zn+1,再把这个猜值喂给后续步骤或直接用于生成。整个推理因此是混合轨迹:橙色实线是真实 ODE 步,绿色虚线是外推步,两者交替出现。
下图是全文的方法总览,读的时候先沿输入到输出的主路径看,再对比左右两栏的成本差异,最后定位右栏 3 个编号框的输入输出符号。
看图路径: 1. 从左到右看清三栏:混合流水线、标准 ODE 步、WaveEx 外推步;2. 对照橙色实线箭头与绿色虚线箭头,区分模型调用与免模型预测;3. 在右栏定位分解、外推、重构三个编号框与系数符号
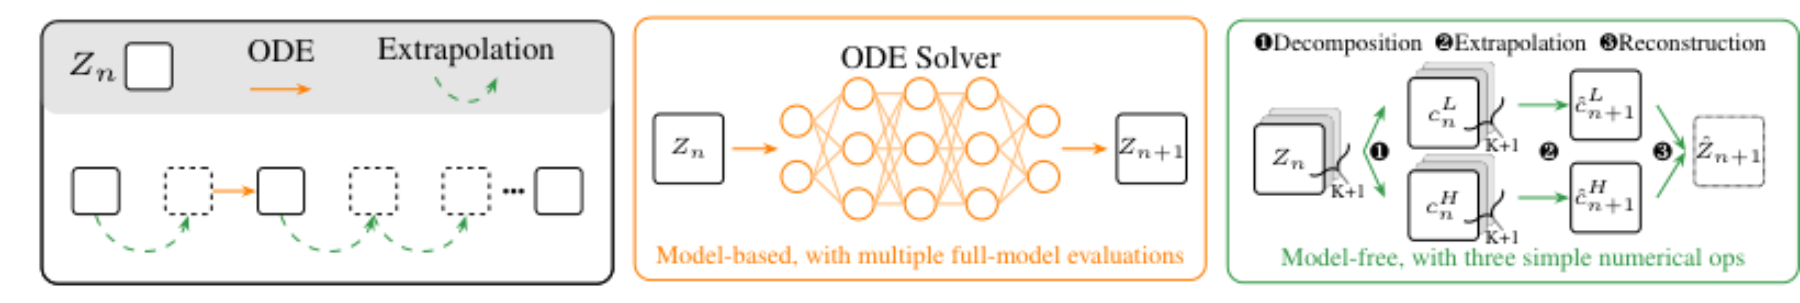
论文图 2。原论文 Figure 2:“Illustration of the WaveEx framework.”。
右栏的 3 个框对应论文明确给出的 3 个阶段。第一步是小波分解(wavelet decomposition),把历史窗口 Hn 沿时间轴做离散小波变换(DWT),得到低频系数 cL 和高频系数 cH。第二步是轨迹外推(trajectory extrapolation),对两个频带各自用后向差分估计时间导数,再用截断泰勒级数向前推一步,得到预测系数。第 3 步是小波重构(wavelet reconstruction),对预测系数做逆离散小波变换(IDWT),合成为预测潜状态。原文默认用 Symlet-6 单层分解、2 分支都用 1 阶泰勒,这是复现时必须照抄的默认配置。
复杂度上的替换关系要讲准:被替换掉的是 1 次或多次前向传播,其成本随模型层数和维度平方增长;换上来的是分解、外推、重构 3 组数值运算,成本只与序列长度的对数线性项有关。论文没有声称外推在数学上等价于 ODE 步,只是报告在平滑段它能跟住轨迹,从而省掉部分调用。早期高曲率段不能全靠猜,因此还需要调度策略,这在训练与调度节细讲。
分解、外推、重构各自算什么,如何配合?
这一节把 3 个组件的输入输出讲死,方便复述。记潜状态维度为 D,历史窗口长度为 K+1。第一步的输入是 Hn,它由 zn-K 到 zn 共 K+1 个向量堆成矩阵,形状为(K+1)×D。DWT 沿时间轴作用,输出是同样形状的低频序列 cL 与高频序列 cH。前者保留平滑演化,后者保留局部调制。这个分解不是特征工程里的声学小波,而是对潜轨迹时间序列的频带拆分,目的是让两种不同曲率的动态分开处理。
流匹配 × 常微分方程求解器: 流匹配负责学出从噪声到语音潜变量的连续速度场,给出每时刻该往哪里走;常微分方程求解器负责在推理时把这个速度场一步步积分成轨迹。两者的分工是前者定方向、后者走路,搭配理由是生成被写成解 ODE 的过程,组合意义在于求解器的调用次数直接决定推理成本,这正是 WaveEx 要用数值外推替换部分调用的原因。
第二步的输入是两个系数序列,输出是下一时刻的预测系数。论文用后向有限差分从过去 K+1 帧估计最高 p 阶导数,权重记为 w,步长记为 h,再按泰勒级数求和得到预测值。默认 p 取 1,即只用 1 阶斜率向前走一小步。分开做的意义在于低频可以用较大的趋势步跟进,高频则被单独约束,避免把局部抖动放大到全局。原文明确说这种分离带来对噪声和不稳定性的选择性抑制,这是分频优于全频外推的机制解释。
离散小波变换 × 泰勒外推: 离散小波变换负责把最近 K+1 个潜状态沿时间轴拆成低频粗趋势和高频细调制;泰勒外推负责在每个频带上用历史估计导数并向前预测一步。搭配理由是低频平滑易预测、高频局域易抖动,混在一起外推会互相干扰,组合意义是分开预测后再逆变换重组,得到更稳的下一潜状态。
第 3 步的输入是两个预测系数,输出是预测潜状态,动作为 IDWT,把多尺度分量拼回统一向量。这个向量不经过模型,直接作为下一步的输入或生成表示。需要强调的边界是,IDWT 本身不创造信息,它只是把分开预测的结果按小波基拼回去,质量上限仍取决于前两步的预测准度。
低频分量 × 高频分量: 低频分量承担全局走向,轨迹长而连贯,对应内容与结构的大趋势;高频分量承担局部起伏,活动范围小但对清晰度和音乐细节敏感。搭配理由是两者曲率和可预测性不同,组合意义是 WaveEx 对两者都做 1 阶外推而不是丢弃高频,从而在保持速度的同时不破坏细节。
组合起来看,一个可运行的单步是:缓存窗口、分解、两路 1 阶泰勒、逆变换、输出预测。若窗口不足 K+1,论文的调度保证早期仍有足够 ODE 步来填满历史,这也是为什么早期不能全部跳过。复现时应先实现这个单步函数,再外层套调度循环,而不是把分解和重构写成可训练层。
本研究训练了什么,没有训练什么?
这是一个必须先说清的点:WaveEx 是训练无关(training-free)的推理加速框架,论文没有训练任何新的语音模型,也没有微调被加速的 5 个模型。所有模型都用原文配置和预训练权重,保证公平可复现。具体包括 F5-TTS 与 E2-TTS 用于文本转语音、DiffRhythm 用于音乐生成、Seed-VC 用于声音转换、FlowSE 用于语音增强。其中 E2-TTS 对应官方 F5-TTS 代码库提供的复现版本,这个细节在复现时要照抄,不能换成其他第三方实现。
真实的计算过程全部发生在推理时。给定已训练好的速度网络 f,生成过程仍由 ODE 定义,WaveEx 只是在推理循环里决定哪些步调用 f、哪些步走数值外推。没有梯度路径,没有损失函数,没有参数更新,也没有重置时机需要报告。论文未报告小波基的学习过程,因为小波基是固定的 Symlet-6,不是从数据学的;也未报告泰勒阶数的搜索梯度,因为阶数是按分析选定的 1 阶默认。
这意味着不能把无训练等同于确定性求解。推理仍受 ODE 初值、调度位置、外推误差累积的影响,不同硬件上的实时率也会变化。复现时要做的不是训练,而是按任务在指定位置插入 ODE 步、其余步调用已实现的分解外推函数,并记录神经函数评估次数与实时率。若缺了某任务的权重或评测脚本,应明确记为缺项,而不是用同名模型替代后声称复现了原文数字。
在哪些数据、模型和指标上测,默认参数是什么?
实验按 4 个任务组织,每个任务的模型、数据、指标都不同,核对数字时必须连同条件一起核对。文本转语音用 F5-TTS 与 E2-TTS,在 LibriSpeech-PC 的 test-clean 上测,指标是词错误率(WER,越低越好)、说话人相似度(SIM,越高越好)、50 人打分的平均意见分(MOS,1 到 10 分,越高越好)。音乐生成用 DiffRhythm,按官方协议自建 100 条评测集,指标是 SongEval 给出的连贯性、歌曲结构清晰度、人声呼吸与乐句自然度,都是越高越好。声音转换用 Seed-VC,在 LibriTTS 上按官方脚本测,指标是字错误率(CER,越低越好)、说话人嵌入余弦相似度(SECS,越高越好)、整体质量(OVRL,越高越好)。语音增强用 FlowSE,在 DNS-Challenge 2023 上测,指标是信号失真、背景干扰、整体质量,都是越高越好。所有实时率都在单张 A100 上测。
WaveEx 的默认参数在原文写得很具体,复现时应整体保留。分解用 Symlet-6 单层,低频高频都用 1 阶泰勒。调度采用 2 个阶段:早期 t 在 0 到 0.25 区间,在第 0、2、4、6、8 步做 ODE,其余外推;后期按任务补少量 ODE 步,文本转语音在第 14 步,声音转换在第 20 步,语音增强在第 24 步,音乐生成在第 12、19、31 步,其余全部外推。论文用(a+b) 记混合配置,a 是 ODE 步数,b 是外推步数,例如 6+26 表示共 32 步里只有 6 步调模型。理解这个记号才能看懂后文表格,否则会把总步数误当成模型调用数。
资源状态需要如实说明。本次未发现来源绑定且完成 HTTPS 验证的代码、模型或数据资源,因此不能声称代码、模型或数据已公开,只能按论文文字复述模型名称与数据集名称。若实际去下载权重或脚本,需自行确认链接可达性,本解读不提供可达性保证。
主结果在相同步数下比了谁,省了多少调用?
比较的问题是:在把模型调用压到个位数后,WaveEx 能否比直接减步更好地保住质量。公平条件是同一基模型、同一测试集、同一指标方向,区别只在推理策略。文本转语音的基线是 32 步全 ODE,直接压到 6 步会明显变差,而 WaveEx 用 6 次模型调用加 26 次外推保持 32 步总长度。音乐、声音转换、语音增强同理,都是先看直接减步的退化,再看 WaveEx 在同样少量调用下回补多少。
| 条件 | 指标与单位方向 | 基线 | 本方法 | 比较对象 |
|---|---|---|---|---|
| F5-TTS 文本转语音 | WER(%,越低越好),SIM(越高越好,原表无单位),加速比(×,越高越好) | NFE 32,WER 2.132,SIM 0.672 | NFE 6 加 26 步外推,WER 2.175,SIM 0.668,加速 4.46× | 直接 6 步基线退化更明显,EPSS 的 WER 与 MOS 不如 WaveEx |
| E2-TTS 文本转语音 | WER(%,越低越好),SIM(越高越好,原表无单位),加速比(×,越高越好) | NFE 32,WER 3.018,SIM 0.703 | NFE 6 加 26 步外推,WER 3.323,SIM 0.702,MOS 6.029,加速 5.73× | 直接 6 步 WER 20.141,SIM 0.396,严重退化 |
上表说明主要收益与具体代价,表中 WER 数值保留原表裸值写法、单位% 以表头为准,SIM 数值保留原表裸值写法、原表无额外单位。F5-TTS 上 WaveEx 把模型调用从 32 压到 6,加速比表头为 Speedup↑、数值为 4.46×,WER 表头单位为%、方向越低越好、数值只从 2.132 升到 2.175,SIM 表头为 SIM↑、原表无额外单位、数值从 0.672 微降到 0.668,基本保持可用。E2-TTS 上收益更典型:直接 6 步的 WER 高达 20.141,SIM 跌到 0.396,已不可用,而 WaveEx 把 WER 拉回 3.323,SIM 回到 0.702,MOS 为 6.029,加速比为 5.73×。代价是 E2-TTS 上 WaveEx 的 WER 为 3.323 对 3.018、表头单位为%、方向越低越好,仍高于 32 步基线,说明加速不是免费,论文报告的是接近而非超越基线。未胜出的项也要点名:F5-TTS 的 MOS 从 7.322 降到 6.868,E2-TTS 的 MOS 从 6.742 降到 6.029,都是为速度付出的可测损失。
神经函数评估次数 × 实时率: 神经函数评估次数记录调用大模型的次数,是计算量的结构性来源;实时率是在单张 A100 上测得的生成时长与音频时长之比,是实际 wall-clock 效果。搭配理由是前者降了后者通常会降,但外推本身也有开销,组合意义是论文同时报告两者,才能区分是真加速还是只减了步数。
另一组任务检验通用性,问题相同但映射更简单或更长程,比较逻辑不变,指标方向仍按越高越好或越低越好区分,单位均以原表表头为准不逐格追加。
| 条件 | 指标与单位方向 | 基线 | 本方法 | 比较对象 |
|---|---|---|---|---|
| DiffRhythm 音乐生成 | 连贯性(越高越好,原表无单位),加速比(×,越高越好) | NFE 32,连贯性 3.805 | NFE 8 加 24 步外推,连贯性 3.804,加速 2.75× | 直接 8 步连贯性跌到 3.316 |
| Seed-VC 声音转换 | CER(越低越好,原表无单位),整体质量 OVRL(越高越好,原表无单位) | NFE 25,CER 2.401,整体质量 2.990 | NFE 6 加 19 步外推,CER 2.338,整体质量 3.040,加速 2.75× | 直接 6 步 CER 2.641,整体质量 2.963 |
| FlowSE 语音增强 | 信号失真(越高越好,原表无单位),整体质量(越高越好,原表无单位) | NFE 32,信号失真 3.295 | NFE 6 加 26 步外推,信号失真 3.283,整体质量 2.868,加速 4.55× | 直接 6 步整体质量 2.774,加速 5.10× |
这张表的后解释要连同反例一起读,所有数值保留原表裸值写法不追加百分号或换算,加速比保留原表×写法。音乐上 WaveEx 基本守住连贯性(越高越好,原表无单位)为 3.804 对 3.805,结构清晰度与自然度还略有提升,但加速比只有 2.75×,低于语音增强的 4.55×,说明长程音乐中外推占比受限。声音转换上 CER(越低越好,原表无单位)从 2.401 变为 2.338、整体质量 OVRL(越高越好,原表无单位)从 2.990 升到 3.040,看似超过基线,但论文只报告单次评测均值,未报告方差与显著性,应表述为恢复并持平而非稳定超越。
语音增强上直接 6 步加速比更高,达 5.10×,但整体质量(越高越好,原表无单位)跌到 2.774,WaveEx 用稍低的 4.55×换回 2.868,更接近全步结果。这组对比支持的判断是省调用的同时保质量,限制是加速倍数随任务和调度位置变化,不能把 5.73×推广到所有任务。
下图从轨迹层面解释为什么能省调用,读图时先确认两条曲线的身份,再看全程贴合度,不要只看尾部差值。
看图路径: 1. 确认图例中橙色为全 ODE、绿色为 WaveEx,纵轴为第一主成分;2. 沿横轴从左向右比较两条曲线的贴合程度与尾部分叉;3. 判断整体结构是否保持连续,而非只看最后一步误差
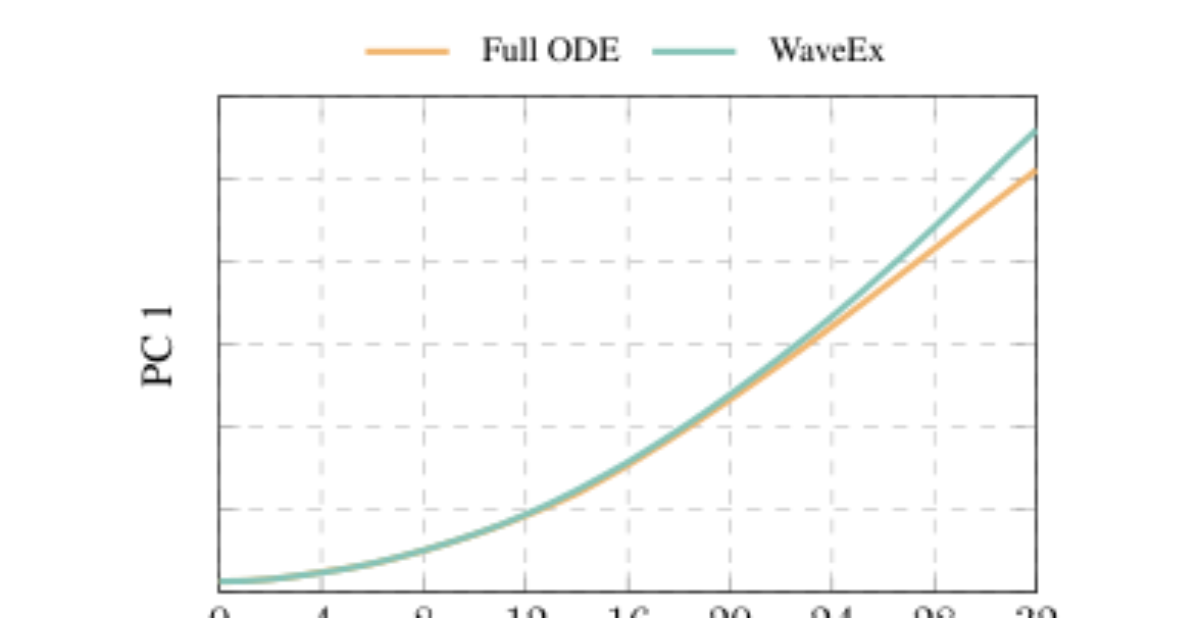
论文图 7。原论文 Figure 7:“Latent trajectory divergence between full ODE de- coding and WaveEx, quantified as the time-wise difference in projections onto the first principal component (PC1).”。
像素可见的是横轴 0 至 32 步、纵轴 PC1 的两条随步数单调上升的第一主成分 PC1 曲线,橙色全 ODE 与青绿色 WaveEx 在前中期几乎重合,后期才出现小幅分叉。这支持论文的说法,即 WaveEx 跟住了 ODE 的全局结构与平滑演化,误差没有在早期发散。但也要看到分叉确实存在,说明外推是近似而非等价,调度中保留后期 ODE 步正是为了压住这种累积偏差。
一阶还是二阶,高频该丢弃、冻结还是外推?
消融要回答 3 个可操作问题:泰勒用几阶,高频怎么处理,何时外推。先看阶数。论文在选定起点后向后预测 8 步,比较 1 阶与 2 阶。原文报告早期预测更难,因残余曲率与瞬态动态大,2 阶常对局部起伏过反应,加速度估计不稳;后期轨迹近似直线,两者相近,1 阶已足够且更稳健。因此默认选 1 阶,这不是通用数学结论,而是针对语音潜轨迹的经验选择。
下图把阶数对比画了出来,读图时先按图例区分真值与两种预测,再对比早期与后期的偏离,最后看放大框里的细节差异。
看图路径: 1. 先确认蓝色实线是真值,红绿虚线分别是一阶与二阶预测;2. 观察早期起点附近二阶虚线的偏离,再看后期两者的重合;3. 结合右下放大框判断后期近似直线时一阶已足够
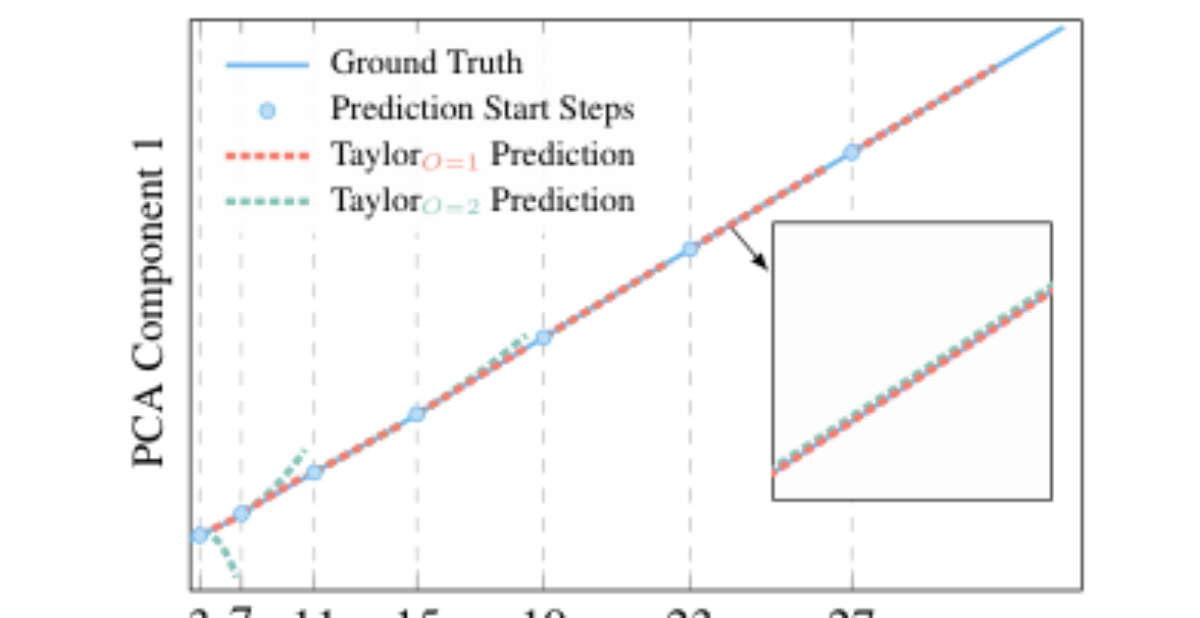
论文图 5。原论文 Figure 5:“Trajectory prediction using first- and second-order Taylor extrapolation.”。
像素可见的是蓝色真值近似直线上升,红色 1 阶虚线全程紧贴真值,绿色 2 阶虚线在早期起点附近明显翘离,后期才与真值重合,放大框显示后期两者几乎无差。这与文字描述一致,支持 1 阶更稳的判断。复现时若换数据集仍应重做这个 8 步前瞻检查,而不是默认 2 阶一定更好。
2 阶段调度 × 外推步: 2 阶段调度负责决定哪些时刻调用 ODE、哪些时刻只做数值预测;外推步负责在不调模型的情况下给出下一状态。分工是调度管资源分配、外推管具体预测,搭配理由是早期音素切换快、曲率大,后期轨迹平直,组合意义是早期密集保留 ODE 步、后期多用外推,从而在质量与速度间取得可控折中。
再看高频处理。论文在音乐任务上比较 3 种做法:置零是重构时丢掉高频,冻结是沿用上一步高频值,外推是对高频也做 1 阶泰勒。原文用小提琴图报告连贯性、清晰度、音乐性、自然度 4 个分布,结论是外推的分布最接近基模型 DiffRhythm,只是两尾稍重、波动稍大;冻结整体下移到 2.0 到 2.5 之间;置零大多低于 2.5,损害最大。
效率上三者实时率都在 0.011 到 0.016 之间,外推的 0.016 略高但可忽略。这个反证很重要:高频虽小但不能丢,丢掉会伤结构,冻结则跟不上节奏变化。
最后看调度。比较的问题是同样只用 6 次模型调用,均匀、2 次与 2 阶段哪种位置更有效,指标仍是 WER 越低越好、SIM 越高越好。
| 条件 | 指标 | 基线 | 本方法 | 比较对象 |
|---|---|---|---|---|
| F5-TTS 调度对比 | WER 越低越好,SIM 越高越好 | 均匀调度 WER 5.697,SIM 0.594 | 2 阶段调度 WER 2.175,SIM 0.664 | 2 次调度 WER 3.138,SIM 0.630,居中 |
| F5-TTS 缓存方法对比 | WER 越低越好,实时率越低越好 | 32 步基线 WER 2.132 | WaveEx 用 6 步 WER 2.175,实时率 0.026 | FORA 与 TaylorSeer 的 WER 更高,ToCa 实时率 0.134 无加速 |
表后解释要给出代价与边界。均匀调度最差,说明关键变化集中在特定区域,等距采样抓不住重点;2 次调度把更多步放在早期有所改善;2 阶段在早期密集建模、后期做结构延续,效果最好。但这组比较只在 F5-TTS 上完成,未在音乐与增强上重做调度搜索,因此不能声称 2 阶段对所有任务最优。
与缓存方法的对比同样只在 F5-TTS 上做,WaveEx 以最少调用拿到最低 WER 与最低实时率,而 ToCa 因细粒度缓存开销反而无加速。这支持频率域外推更适合语音连续建模的解释,但限制是未报告不同硬件下的开销,实时率结论只在 A100 条件下成立。
哪些情况可能不 work,原文没测什么?
先讲已验证的边界。早期轨迹曲率高、音素切换快,外推误差大,必须保留第 0、2、4、6、8 步的 ODE,这是论文用调度保证的。若把早期也全部跳过,按均匀调度的结果会退到 WER 5.697,说明省调用不能省在最需要模型的地方。高频若置零或冻结,音乐任务的质量分布会明显下移,说明高频外推是保细节的必要部分,不是可选装饰。
再讲未验证的推测要用可能、待验证来表达。论文提到梅尔频谱的谱可压缩性为加速提供原理基础,但正文证据主要来自 PCA 投影与外推效果,压缩性本身的定量界没有在给定证据中展开,因此只能说分频思想得到实验支持,不能说已证明最优分解层数或最优小波基。Symlet-6 单层与 1 阶泰勒是默认有效配置,可能存在其他基或自适应阶数更好的情况,待验证。
缺失的测量也要点名。论文报告了神经函数评估次数与实时率,但未报告峰值显存、不同 GPU 或 CPU 上的延迟,也未报告多次随机种子的方差与统计检验。主观 MOS 只有 50 人 1 到 10 分的均值,未交代评分者一致性与成对比较设计,不能把 MOS 小幅差异当成稳定胜负。音乐评测是自建 100 条,无标准测试集,跨论文对比时要谨慎。总体趋势是 2.75 到 5.73 倍加速且质量接近,但不等于每条样本、每一步都成立,尾部分叉与高频波动提示长序列仍需留出纠偏步。
要复现先做什么,关键超参数如何保留?
复现的第一步是按任务准备对应的预训练权重与官方评测脚本,文本转语音用 LibriSpeech-PC test-clean 并沿用 F5-TTS 仓库配置,声音转换与语音增强分别用 LibriTTS 与 DNS-Challenge 2023 的官方脚本,音乐按官方协议构造 100 条评测集。不要替换 E2-TTS 的实现来源,原文明确它是 F5-TTS 代码库提供的复现版本,换实现会改变基线。
第二步是实现单步外推函数。输入是最近 K+1 个潜状态组成的窗口,动作依次是单层 Symlet-6 的 DWT、2 分支各自的 1 阶泰勒、IDWT 重构。差分权重与步长按原文符号实现,低频高频都走 1 阶,不要自行升级到 2 阶。第 3 步是套 2 阶段调度,早期固定在第 0、2、4、6、8 步调用模型,后期按任务补指定步,其余步只调外推函数,并用(a+b) 记录实际调用数与总步数。
关键超参数与信息条件要原样保留:小波为 sym6 单层,1 阶外推,上述调度位置,以及单张 A100 上测实时率的条件。评估时同时记录调用次数、实时率与任务指标,并保留直接减步的基线,才能判断收益来自外推而非单纯减步。若遇到某权重或脚本不可达,应记为本次未能确认可达,不虚构下载状态。本解读的资源状态为未发现可验证的公开资源,因此不提供代码可用性承诺,复现者需自行核对官方仓库当前状态。
何时值得尝试,一句话如何带走?
当你的流匹配语音系统已被压到少量 ODE 步后质量骤降,且剖析发现潜轨迹中后期趋于平滑,就可以尝试 WaveEx 这类分频外推。它值得尝试的信号是直接减步的退化明显、而低频趋势依然连贯,此时用少量早期 ODE 步定住曲率、后期用外推跟进,往往能在不重训练、不改结构的情况下换回可用质量。反之,若你的瓶颈在声码器或自回归解码,而非 ODE 调用,或者早期轨迹本身剧烈抖动,外推的收益会打折,应先做调用占比分析。
带走的动作清单很短:先实现窗口分解与两路 1 阶外推,再配 2 阶段调度,最后在同一模型与同一测试集上对比全步、直接减步与 WaveEx 三者的质量与实时率。记住论文直接报告的是多任务加速与质量接近,有限解释是分频比全频更稳,未验证的是最优基、最佳层数与跨硬件稳定性。把加速倍数与具体调度位置绑定记录,把高频外推与置零冻结的反例一起保留,这样的复述才是可核对、可复现的。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses