英文题目:MIDILM: A Dual-Path Model for Controllable Text-to-MIDI Generation
会议身份:
conference:aaai:2026:conference-paper-id:39483
✅ 来源为官方会议 PDF;可重放的表格、公式文本与 Figure 像素已按 PDF 抽取结果绑定,未成功恢复的结构不作推断。
标签:#混合专家模型 #多模态学习 #主观评测 #符号音乐生成
评分:6.6/10 | 创新 1.4/2 | 技术严谨 1.0/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1.0/1.5 | 开源 0.0/1.5 | 可复现 0.4/0.5 | 工程/实践 1.0/1.5
排名:前50% | 文档类型:方法研究
👥 作者与机构
- Shuyu Li:机构信息未能从会议 PDF 纯文本可靠映射
- Dooho Choi:机构信息未能从会议 PDF 纯文本可靠映射
- Yunsick Sung:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
自由文本到符号音乐生成需将自然语言映射为 REMI+ 事件序列,既要语义可控又要保证速度、调性、拍号与长程结构一致。以往 MuseCoco 属性流水线表达受限,Text2MIDI 系列端到端交叉注意力模型对齐不足。MIDI LM 将预训练 GPT-2 文本词元与 MIDI 词元拼接为前缀条件输入,先经共享掩码自注意力交互,再分流至文本专用多层感知机与 MIDI 专用混合专家模型处理,最终仅用 MIDI 路输出预测。在 MidiCaps 切分测试集上相对最强基线 Text2MIDI-InferAlign 取得全面领先,TB 为 0.9688 对 0.3958,TBT 为 0.9792 对 0.6250,CT 为 0.9167 对 0.7917,同时 CLAP 为 0.3127 超过真值的 0.3063,CLaMP 3 为 0.1564 超过真值的 0.1434。该设计以隔离前馈减少模态干扰,以稀疏路由增强音乐维度分工,深层注意力可视化显示文本前缀约束随层加深而增强。当前结论限于 MidiCaps 英文描述与 4/4 主导分布,CK 仅 0.4688,复杂调性与频繁转调仍弱,自由文本下主观优势收窄。原文披露在 4 张 RTX 3090 上训练约 60 小时,推理复用键值缓存并以温度控制采样,部署成本未系统报告。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,要输出什么,为什么难?
这篇论文研究的是自由文本到 MIDI 的生成任务。输入是一段自然语言描述,例如风格情绪配器速度拍号调性等混合信息,输出是一个可以直接编辑回放的 MIDI 文件,包含音高时值力度速度拍号配器与小节位置等离散事件。目标同时有两个,一是语义可控,也就是生成结果要听得出文本要求,二是结构一致,也就是速度拍号调性与长程重复模式要自洽可演奏。难点首先来自模态差异,文本讲的是高层语义与情感,MIDI 讲的是按时间展开的事件表,两者粒度不同。
其次来自 MIDI 内部的强约束,不同事件类型互相依赖,速度错 1 位全曲就赶,拍号错一处小节就乱,配器错一个声部色彩就变。对于刚入门的读者,可以把任务想象成按文字菜谱做一道多声部大菜,菜谱只说要慢速浪漫的流行摇滚,厨师却要定出每一步的火候配料与上菜顺序,任何一步含糊都会影响整体。论文的输入输出都围绕这个矛盾展开,后续所有设计都是为同时保住语义与结构。
需要保留的关键信息是文本与 MIDI 是异构序列,结构指标与语义指标要分开测量,不能用一个好听就代替全部。
已有路线走了哪两条路,各自卡在哪里?
论文把已有工作归为属性流水线与端到端直接序列两条路线。第一条以 MuseCoco 为代表,先从文本预测一组固定音乐属性,再以属性为条件生成 MIDI。白话说就是先把自由文本压缩成几个选项,再按选项做菜。好处是有显式控制层,坏处是固定词表装不下自由语言的细微差别,一旦属性选定就难以微调,风格多样性受限。
第二条以 Text2MIDI 为代表,用预训练的 FLAN-T5 做文本编码器,用 Transformer 解码器自回归生成 REMI+ 表示的符号音乐,先在 SymphonyNet 上用从 MIDI 属性自动抽取的伪文本做半监督预训练,再在 MidiCaps 成对数据上微调。它的改进版 Text2MIDI-InferAlign 在推理时做奖励整形,优化文本音频一致性的 CLAP 分数与和声符合度的调内惩罚,不再额外训练。白话说就是生成后再用两个打分器 nudging 结果。论文指出,这类方法整体对齐有所提升但仍不足,复杂速度调号拍号线索实现不稳定,因为底层表示没有动,推理后调整难以补上结构细节。
两条路线的对照点是同输入同目标同运行阶段,一个牺牲表达力换可控,一个牺牲结构精度换表达力,这正是新模型要同时突破的位置。
要解决的具体矛盾是什么,不解决会怎样?
论文要解决的具体矛盾是语义可控与结构忠实难以兼得。属性方法把文本先离散化,语义在第一步就丢失,后续再强的生成器也找不回原文的细腻要求。端到端加交叉注意力的方法把文本与音乐特征融合得较浅,解码时容易重复语料中的 dominant 模式,例如默认输出 4/4 拍或常见速度区间,导致文本明明要求 2/4 或慢速,模型仍按惯性输出。如果不解决,文本到 MIDI 就只能做到大致像,而不能按文字精确控制速度拍号配器与调性。
对初学者而言,复述时要抓住两个可检验的现象,一是跨模态对齐分数不高,二是结构命中率在速度拍号调性上系统性偏向众数。论文把成功标准定为两者同时提升,而不是用一个指标掩盖另一个,这决定了后文既要测 CLAP 与 CLaMP 3 这类语义指标,也要测速度分箱含容差分箱调号含重复调号拍号与压缩比这类结构指标。
双路解码器整体如何走完一个样本?
MIDILM 的整体做法可以沿一个样本走一遍。假设输入文本是 C 大调慢速流行摇滚,2/4 拍,领奏为 honky-tonk 钢琴,伴奏有弦乐电贝司与鼓。第一步用 GPT-2 分词器把文本切成词元,用 GPT-2 嵌入得到文本隐藏状态,同时用 miditok 按 REMI+ 把 MIDI 切成 515 词表内的事件词元并嵌入得到音乐隐藏状态。第二步把两段嵌入沿时间轴拼接成一个序列,前面是全部文本前缀,后面是音乐事件,送入 12 层单向 Transformer 解码器。每层先做 RMSNorm,再做共享掩码自注意力,使每个 MIDI 位置能看到全部文本前缀与之前的音乐事件,但看不到未来事件。
第三步进入前馈层时分流,文本侧走专用多层感知机,音乐侧走混合专家路由器加权求和,更新后再拼接回同一隐藏状态。堆叠多层后,只取最后 MIDI 侧隐藏状态做输出归一化与投影,得到下一个 MIDI 词元分布。推理时先编码文本并以特殊起始符开解,用键值缓存自回归采样直到终止符,再把 REMI+ 词元转回标准 MIDI 文件。下面这张结构图把拼接输入、共享注意力与分流前馈画在了一起,读图时重点看主路径与分支汇合点。
看图路径: 1. 先看左下输入端文本经 GPT-2 与 MIDI 经嵌入后拼接为同一序列 h 的位置;2. 再看中间每层掩码自注意力与双路前馈加残差连接的上下顺序;3. 对照右上 MLP 路径与右中混合专家路径各自处理哪一侧颜色块;4. 最后确认顶端只取 MIDI 侧隐藏状态做归一化与输出投影
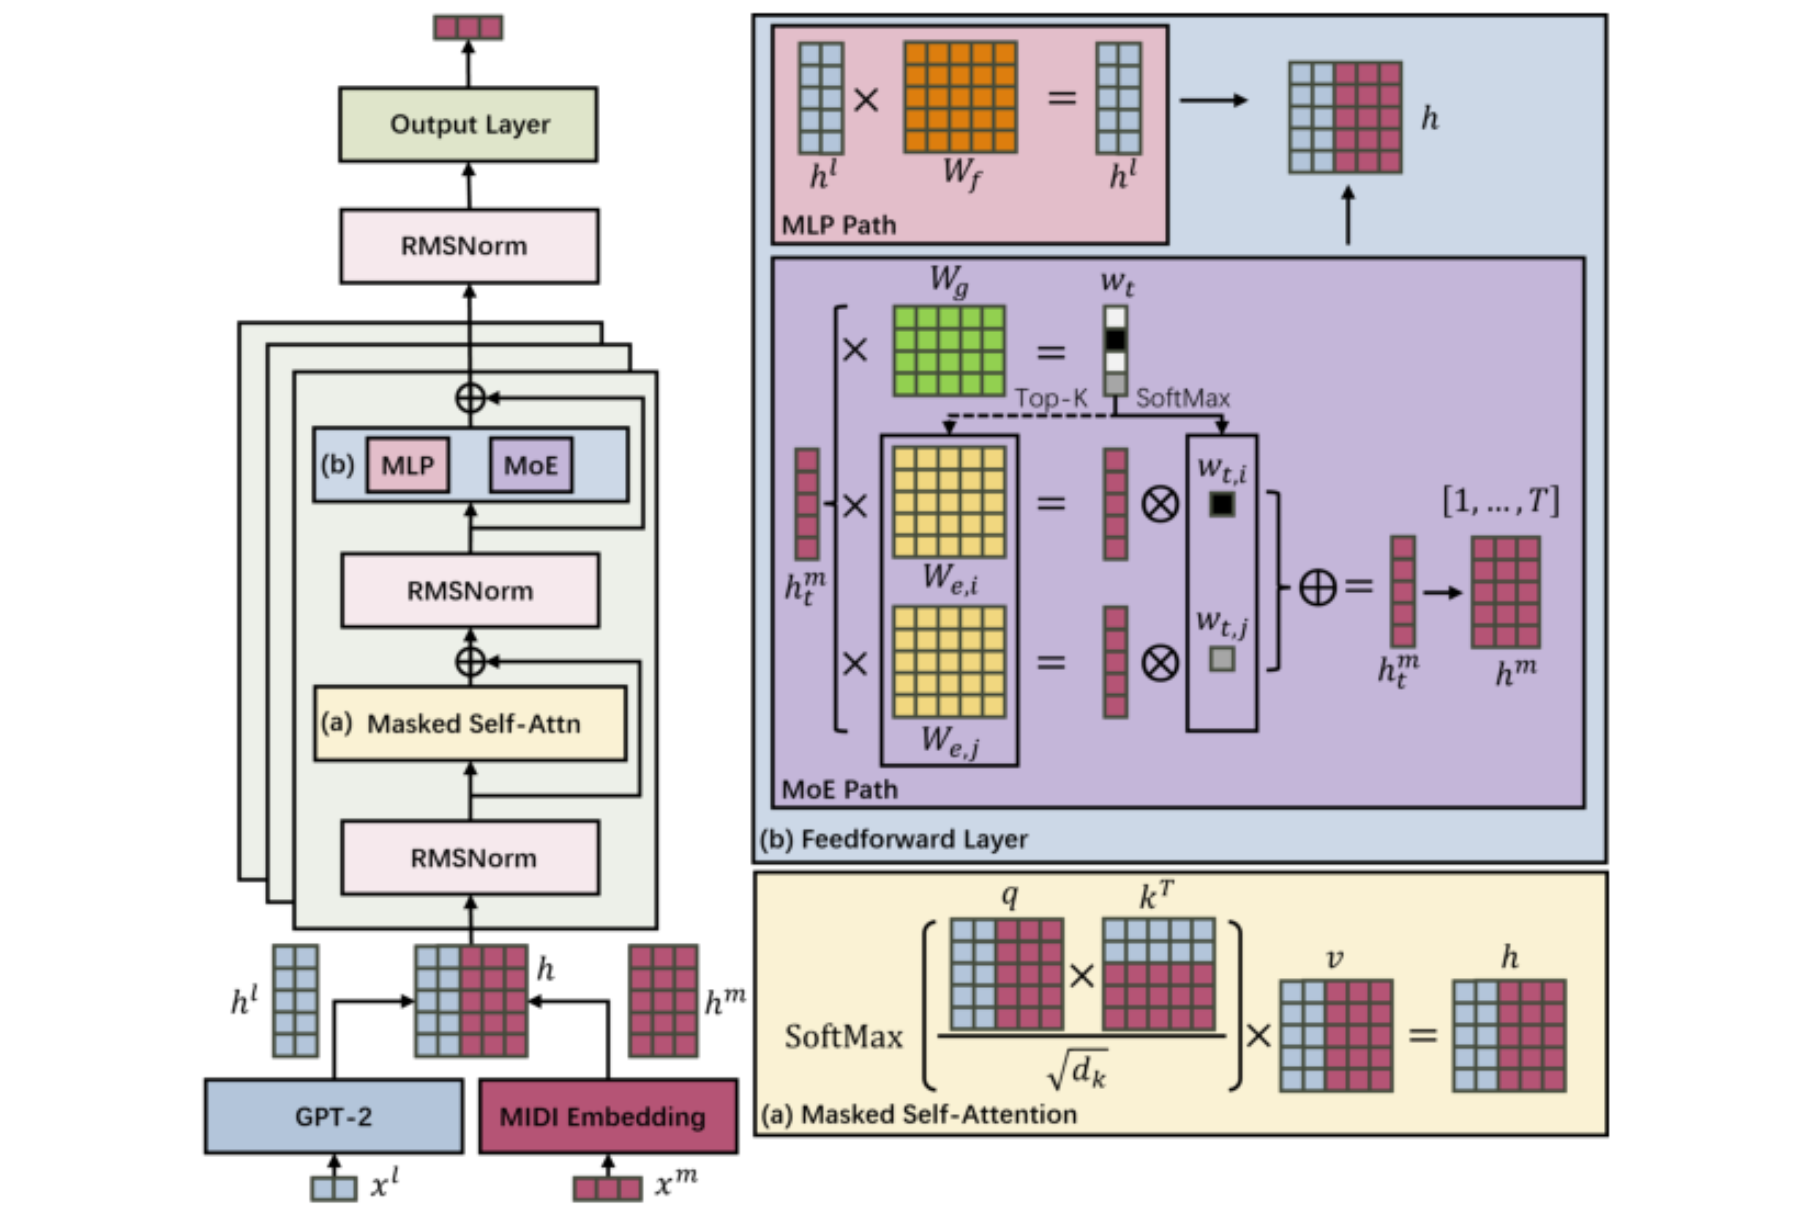
论文图 3。原论文 Figure 3:“Architecture of the proposed MIDILM. (a) The masked self-attention mechanism processes the concatenated text tokens and MIDI tokens.”。
左半部分显示底层两个嵌入源汇成同一解码器堆栈,每层内部都有残差连接与归一化,顶端只有音乐侧进入输出层,这解释了为什么文本只做条件而不被预测。右下子图把共享掩码自注意力的查询键值拼接计算画成矩阵相乘加缩放再加权,右上与右中分别把文本 MLP 变换与音乐混合专家的门控加权画成并排分支。看懂这张图,就能复述方法的核心安排,交互只在注意力发生,变换在前馈分开,这就是后文所说的模态隔离原则。
共享注意力与双路前馈各自算什么?
共享掩码自注意力是唯一的跨模态耦合点。它的输入是拼接后的文本加音乐序列,计算是标准的缩放点积注意力加因果掩码,保证音乐侧自回归,文本前缀全局可见。论文强调所有解码步都能访问全局语义,深层尤其如此。双路前馈是模态专用的变换点。文本路径用矩阵 Wf 对文本隐藏状态做上投影中间层下投影的 3 层变换,音乐路径对每个时间步的音乐隐藏状态先用路由器 Wg 算门控对数,再做 SoftMax 加 Top-K 稀疏选择,得到两个被激活专家的权重,再对各自专家输出加权求和。公式层面先看交叉熵目标,它定义了自回归似然的优化方向。
\[LCE = −\]其中符号含义是 x 上标 l 为输入文本词元序列,x 上标 m 下标 t 为第 t 个 MIDI 词元,x 上标 m 小于 t 为此前全部 MIDI 词元,目标是最大化给定文本与历史下当前词元的对数概率之和。实现上论文只给出似然项与负载均衡项的加权总损失,总损失等于交叉熵加标量系数乘负载均衡项,负载均衡项用一批次内各专家接收词元数的均值与标准差构造变异系数的平方,防止路由坍缩。需要指出,原文未报告该系数的具体取值与梯度是否截断等细节,复述时应标为缺项而不猜测。
前缀条件 × 交叉注意力: 前缀条件负责把文本词元拼在 MIDI 词元前面作为同一解码器输入,让每个 MIDI 位置都能通过自注意力看到全部文本,交叉注意力则负责用独立的编码器加解码器间注意力桥接两种模态;论文选择前缀条件而不用交叉注意力的搭配理由是减少参数与计算并稳定优化,组合意义是交互只发生在共享自注意力中,为后续模态隔离留下单一耦合点。
模态隔离 × 共享掩码自注意力: 模态隔离负责让文本隐藏状态只走 MLP 路径、MIDI 隐藏状态只走混合专家路径,前馈变换互不共享参数,共享掩码自注意力负责在每层先对拼接后的文本加 MIDI 序列做统一交互并保持音乐自回归顺序;二者搭配的原因是既要全局语义可达又要避免前馈层互相干扰,组合意义是耦合只通过注意力发生,分工在前馈层保持独立。
混合专家 × 多层感知机路径: 混合专家路径负责处理 MIDI 隐藏状态,由路由器按词元选通少量专家来分担音高时值力度配器等不同事件类型,多层感知机路径负责处理文本隐藏状态,用更大容量的单一变换保持语言语义;搭配理由是音乐事件类别多且相互牵制需要稀疏容量,文本则需要稳定语义变换,组合意义是在同一前馈层位置按词元类型分流,实现可扩展的音乐结构建模。
3 组桥接放在这里,是为了紧接计算讲清分工,文本分支保语义稳定,音乐分支用稀疏容量保结构表达,注意力保全局条件,前馈保互不干扰。
混合专家路由器如何按词元类型分工?
混合专家部分值得单独走一遍计算。每个解码器层配 8 个专家,每个词元按 Top-2 路由。路由器对当前音乐隐藏状态算 8 维打分,取最大的两个做归一化权重,其余置零。两个被选中专家的各自 3 层前馈分别算出候选表示,再按权重相加得到该步更新。直观例子是力度词元与时值词元可能被送往不同专家,避免动态强度与节奏骨架互相干扰,而音高位置配器等经常协同的词元可能共享相近专家以保持旋律组织连贯。
论文用路由指纹加主成分分析来验证这种分工,把每词元跨层路由概率拼成高维向量,再投影到 2 维平面,距离近表示路由相似。这种可视化不是性能证明,只是机制检查,后文消融会进一步看拿掉混合专家后表达力是否下降。复述时要注意,专家数量与 Top-K 是原文明确给出的配置,专家内部 3 层结构在图中简化显示,不应自行脑补激活函数或维度。
训练目标、数据流与两套适配说法是什么?
训练阶段模型在 MidiCaps 训练集上从零学习成对文本到 MIDI 映射,共训练 100000 步,采用余弦衰减学习率加 10000 步热身,峰值 1 乘 10 的负 4 次方衰减到 1 乘 10 的负 6 次方,批量大小 16,每批 MIDI 长度 2048 文本长度 128,在 4 张 RTX 3090 上约 60 小时完成。优化目标是交叉熵加负载均衡正则,文本路径与音乐路径及共享注意力共同演化,不依赖预训练检查点,这是论文所说的从零设置。
交叉熵损失 × 负载均衡损失: 交叉熵损失负责按自回归条件概率最大化下一个 MIDI 词元的似然,负载均衡损失负责惩罚一批次内送往各专家的词元比例变异系数,防止少数专家垄断路由;搭配原因是纯似然训练会让路由坍缩,组合意义是用标量权重把结构多样性约束与似然目标加权求和,共同决定梯度方向。
讨论部分还提出第二种用法,即把同一双路结构当作微调框架,音乐侧适配时冻结文本路径与共享注意力只更新混合专家路径与输出投影,文本侧适配时冻结音乐路径只更新文本路径与投影层,需要更强跨模态对齐时可在共享注意力插入轻量适配器或低秩更新。需要明确区分,实验部分实际执行的是从零训练,微调与适配器只是论文讨论的灵活性说明,没有给出对应实验数字与冻结更新时的梯度路径细节,复述时应标为未验证的方案而不当作已测结论。
数据划分、表示与评测条件如何保证可比?
实验全部在 MidiCaps 上进行,该数据集含 168385 个 MIDI 文件与自然语言描述,原始 MIDI 来自 Lakh MIDI 数据集。划分沿用官方 9 比 1 的训练测试划分,官方训练集不变,官方测试集随机平分为两半,一半做验证集一半做保留测试集。另手工构造 96 条自由文本评估集,每条 10 到 20 词,覆盖不同流派情绪与配器,例如一句深情流行 ballad 表达渴望,包含钢琴电吉他与柔弦乐。表示上 MIDI 用 REMI+ 并经 miditok 切分,词表 515,文本用 GPT-2 分词器,词表 50257。模型配置为 12 层单向 Transformer 解码器加旋转位置编码,每层 8 专家 Top-2 路由,文本侧配更高容量 MLP。
基线为 MuseCoco 与 Text2MIDI-InferAlign,生成时采样温度均为 1.0。客观指标包括压缩比 CR 用 COSIATEC 算法衡量重复模式与长程结构,CLAP 衡量转音频后文本音频相似度且用统一乐器库与指定检查点,速度分箱 TB 与含邻箱容差 TBT,调号 CK 与含重复调号 CKD,另新增拍号 CT 衡量预测拍号与真值完全一致比例,以及 CLaMP 3 直接衡量生成 MIDI 与文本的跨模态语义对齐。主观评测为盲听平均意见分,15 名评分者含 5 名音乐人与 10 名非音乐人,按音乐性连贯性与文本相关性打 1 到 5 分,每个系统在测试集与自由文本集各评 96 个样本。
REMI+ 表示 × MIDI 词元: REMI+ 表示负责把小节位置拍号速度音高时值力度配器等音乐维度定义为离散事件词汇,MIDI 词元负责成为模型实际预测与评估的单位,经 miditok 切分后词汇量为 515;搭配原因是文本描述的是高级语义而音乐需要显式时间线坐标,组合意义是把结构准确性转化为速度分箱调号拍号等可计算的词元级命中率。
这些条件是后文比较公平性的基础,复现时必须保持同一划分同一采样温度与同一指标方向,方向均为越高越好。
主结果在结构与语义上各赢了多少?
主结果要回答的是在相同 MidiCaps 测试条件下,新模型是否同时赢得结构与语义。论文报告在 10 个随机种子各抽 96 条测试样本的平均下,MIDILM 全面超过基线与消融变体,Welch 检验显著。雷达图把 TB、TBT、CR、CKD、CK、CLAP 与 CLaMP 归一化到 0 到 100% 后比较包络面积,面积越大越好,图中粉色新模型包络在速度与语义轴上明显大于红色推理对齐基线与橙色属性基线,而黄色虚线真值在调性轴上仍外凸,这与后文调性仍是短板的判断一致。读图时不要把归一化后的面积当作原始分数,也不要把某轴领先推广为全曲全程都好。
看图路径: 1. 先确认雷达图外圈七个指标 TB 到 CLaMP 的名称与 25% 到 100% 刻度;2. 再比较粉色 MIDILM 包络与红色基线包络在 TB 与 TBT 轴上的张开幅度;3. 观察黄色虚线真值在 CK 与 CKD 轴上外凸而在语义轴上被反超的位置
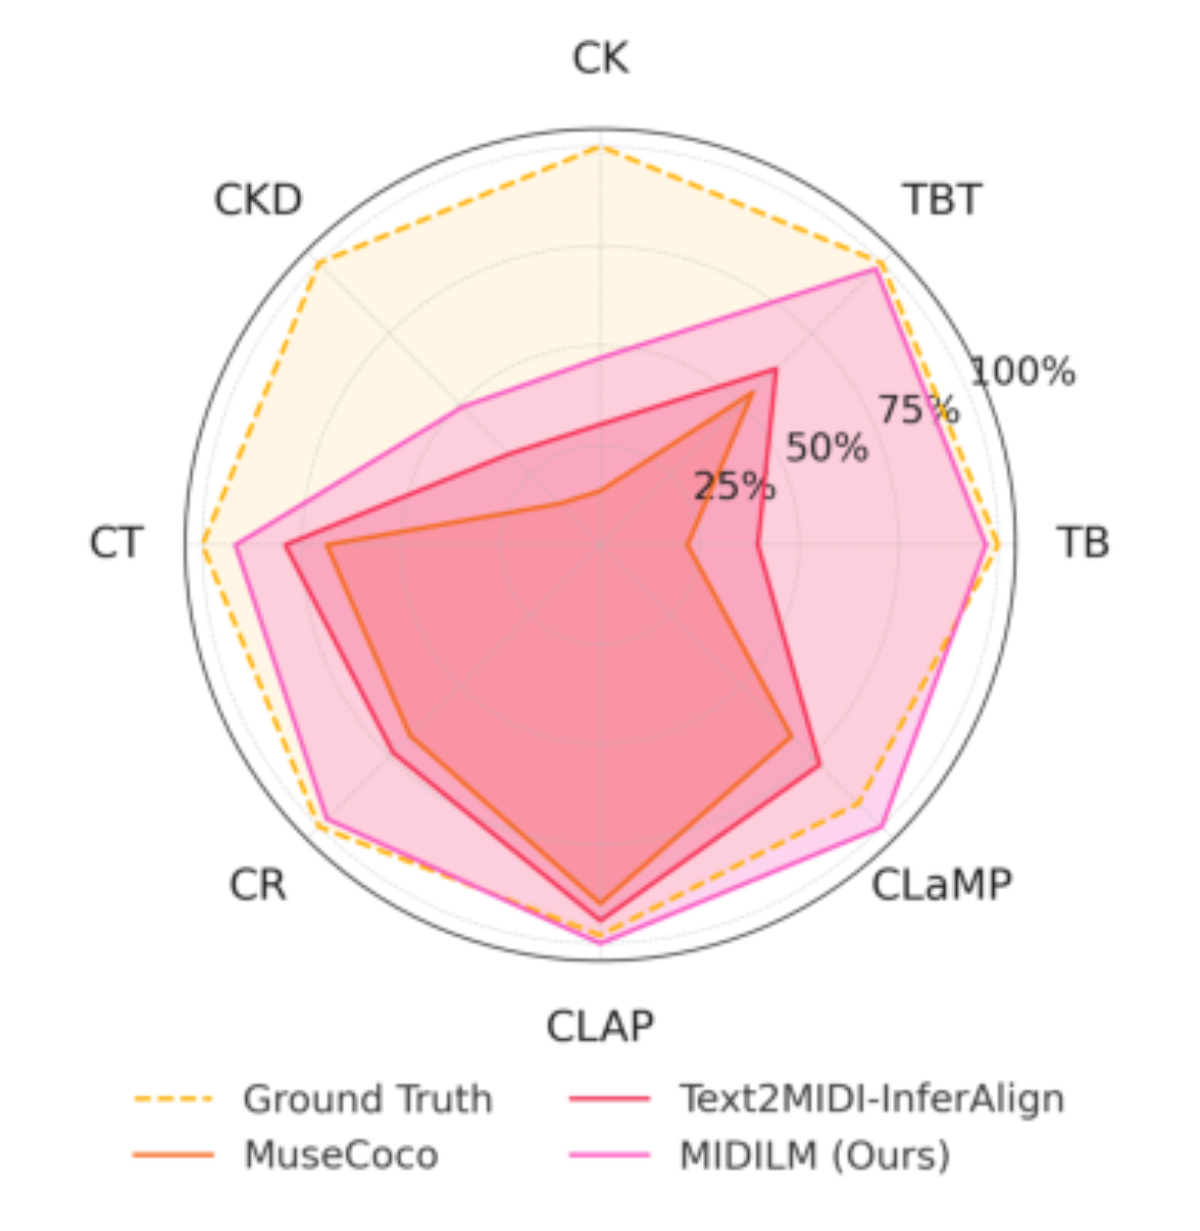
论文图 1。原论文 Figure 1:“Benchmark comparison on the MidiCaps test set for MIDILM, Text2MIDI-InferAlign, and ground truth.”。
从雷达图可见,速度轴上新模型几乎贴近外圈,真值没有速度真值可比故标为不可用,调性轴上所有模型都内缩,语义轴上新模型与真值接近甚至反超。论文解释语义反超的可能原因是模型显式优化语义一致,而部分真值标注存在主观噪声,这属于有限解释而非因果证明。下表把测试集 8 个指标的原始数值放在一起,列为真值、MuseCoco、推理对齐基线、新模型与 3 个消融,行按速度调性拍号压缩比语义排列,便于核对每个数字的归属条件与聚合口径。表前问题是结构命中率与语义相似度是否在同一可运行策略下同时提升,公平条件是同一切分同温度同采样数,指标方向均为越高越好。
| 条件 | 指标 | 真值 | MuseCoco 基线 | 推理对齐基线 | 本方法 | 比较对象 |
|---|---|---|---|---|---|---|
| MidiCaps 保留测试集 | TB 速度分箱命中率 | 不适用 | 0.2188 | 0.3958 | 0.9688 | 推理对齐基线与属性基线 |
| MidiCaps 保留测试集 | TBT 含容差速度命中率 | 不适用 | 0.5417 | 0.6250 | 0.9792 | 推理对齐基线与属性基线 |
| MidiCaps 保留测试集 | CK 调号命中率 | 不适用 | 0.1354 | 0.3021 | 0.4688 | 推理对齐基线与属性基线 |
| MidiCaps 保留测试集 | CKD 含重复调号命中率 | 不适用 | 0.1458 | 0.3229 | 0.4896 | 推理对齐基线与属性基线 |
| MidiCaps 保留测试集 | CT 拍号命中率 | 不适用 | 0.6875 | 0.7917 | 0.9167 | 推理对齐基线与属性基线 |
| MidiCaps 保留测试集 | CR 压缩比 | 2.5327 | 1.7123 | 1.8658 | 2.4617 | 真值与两个基线 |
| MidiCaps 保留测试集 | CLAP 语义相似度 | 0.3063 | 0.2814 | 0.2948 | 0.3127 | 真值与两个基线 |
| MidiCaps 保留测试集 | CLaMP 3 语义对齐 | 0.1434 | 0.1062 | 0.1219 | 0.1564 | 真值与两个基线 |
表后解释需要同时讲收益与代价。收益是速度与拍号提升最大,TB 从 0.3958 到 0.9688,TBT 从 0.6250 到 0.9792,CT 从 0.7917 到 0.9167,论文归因于双路解码器能表示稀有拍号而不只是重复 4/4 众数。语义上 CLAP 从 0.2948 到 0.3127,CLaMP 3 从 0.1219 到 0.1564,且超过真值。代价与反例是调性虽从 0.3021 到 0.4688 仍远未解决,论文明确说标准 MIDI 缺乏显式调号词元,只能从全局音高分布推断。压缩比 2.4617 介于基线与真值 2.5327 之间,论文用此说明增益不是靠冗余填充刷出来的。未胜出项是调性轴,真值在该轴仍领先,这是后文局限的直接证据。
拿掉隔离与专家后哪里掉得最多,自由文本还成立吗?
消融要回答的是两个设计各自贡献多少,以及开放文本下结论是否还成立。论文设 3 个变体,去掉全部、去掉模态隔离、去掉混合专家路由。去掉全部退化最大,说明两者互补。去掉隔离后文本与 MIDI 词元在共享专家内互相干扰,去掉路由后音乐专用容量减弱,表格中对应列从新模型 0.9688 依次掉到 0.9132 到 0.8694 到 0.8269 等趋势支持该判断。
路由可视化把每类词元的跨层专家分配指纹投影到 2 维,力度簇与时值簇各自孤立,音高位置拍号速度配器小节等聚在一起,论文解读为动态与节奏被解耦而旋律配器保持协同。注意力可视化显示 1 到 8 层以对角线局部依赖为主,9 到 12 层在文本前缀区出现纵向亮条纹且随层加深增强,说明深层持续强化文本条件。下面两张图分别对应这两个机制检查,读时只看簇分离与条纹位置,不硬读精确数值。
看图路径: 1. 先看横轴 PC1 纵轴 PC2 与右上八类词元图例的对应颜色;2. 再找左上橙色速度簇与左下深红时值簇与其他簇的分离距离;3. 观察中间紫色音高与绿色配器及粉色位置簇的重叠与过渡带
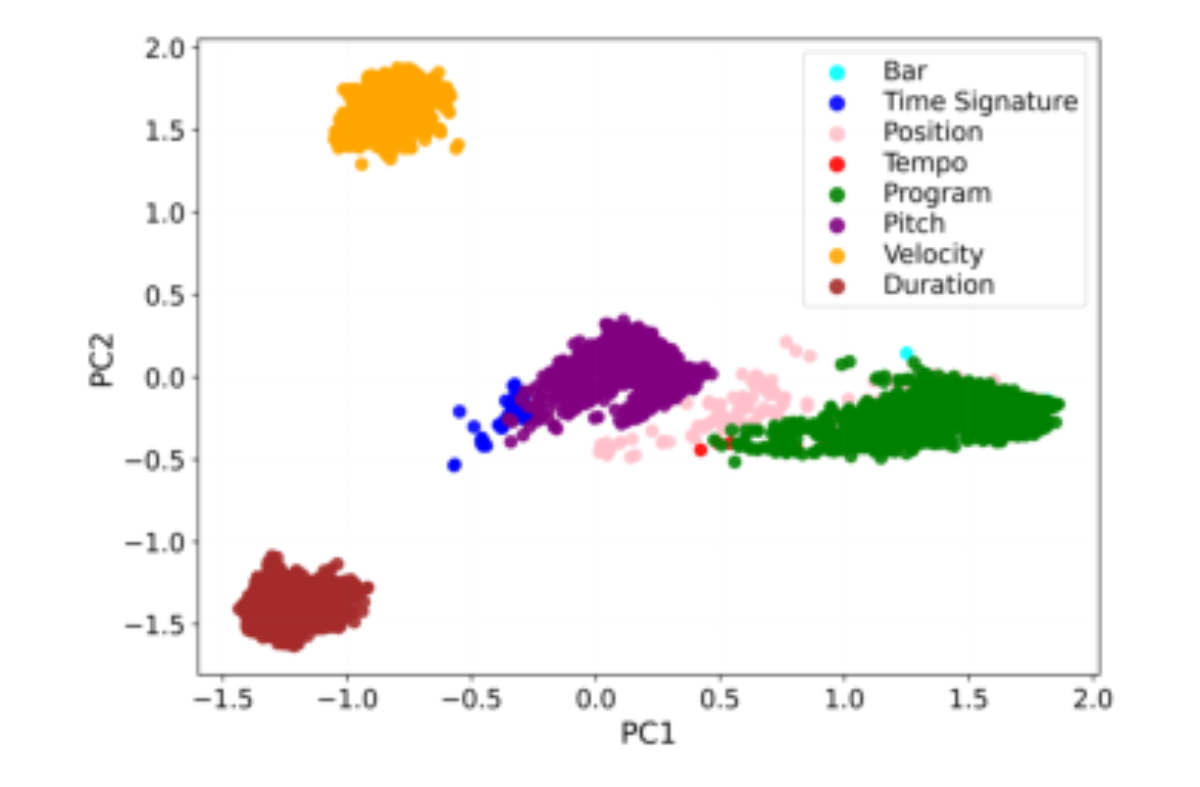
论文图 4。原论文 Figure 4:“PCA projection of MoE expert routing fingerprints for each token type.”。
从路由散点可见,橙色速度点集中在左上,深红时值点集中在左下,二者与其他颜色距离远,而紫色音高绿色配器粉色位置等在中右连成一片,这支持专家按功能分工但非完全独立的判断,取样与投影细节未完全报告时应视为支持性而非因果证据。
看图路径: 1. 先确认每子图横轴源序列纵轴预测位置与中间红色文本分界线;2. 对比第 7 到第 8 层沿对角线的亮线与左侧文本区的暗背景;3. 再看第 9 到第 12 层左侧文本区出现的纵向亮条纹如何随层加深增强
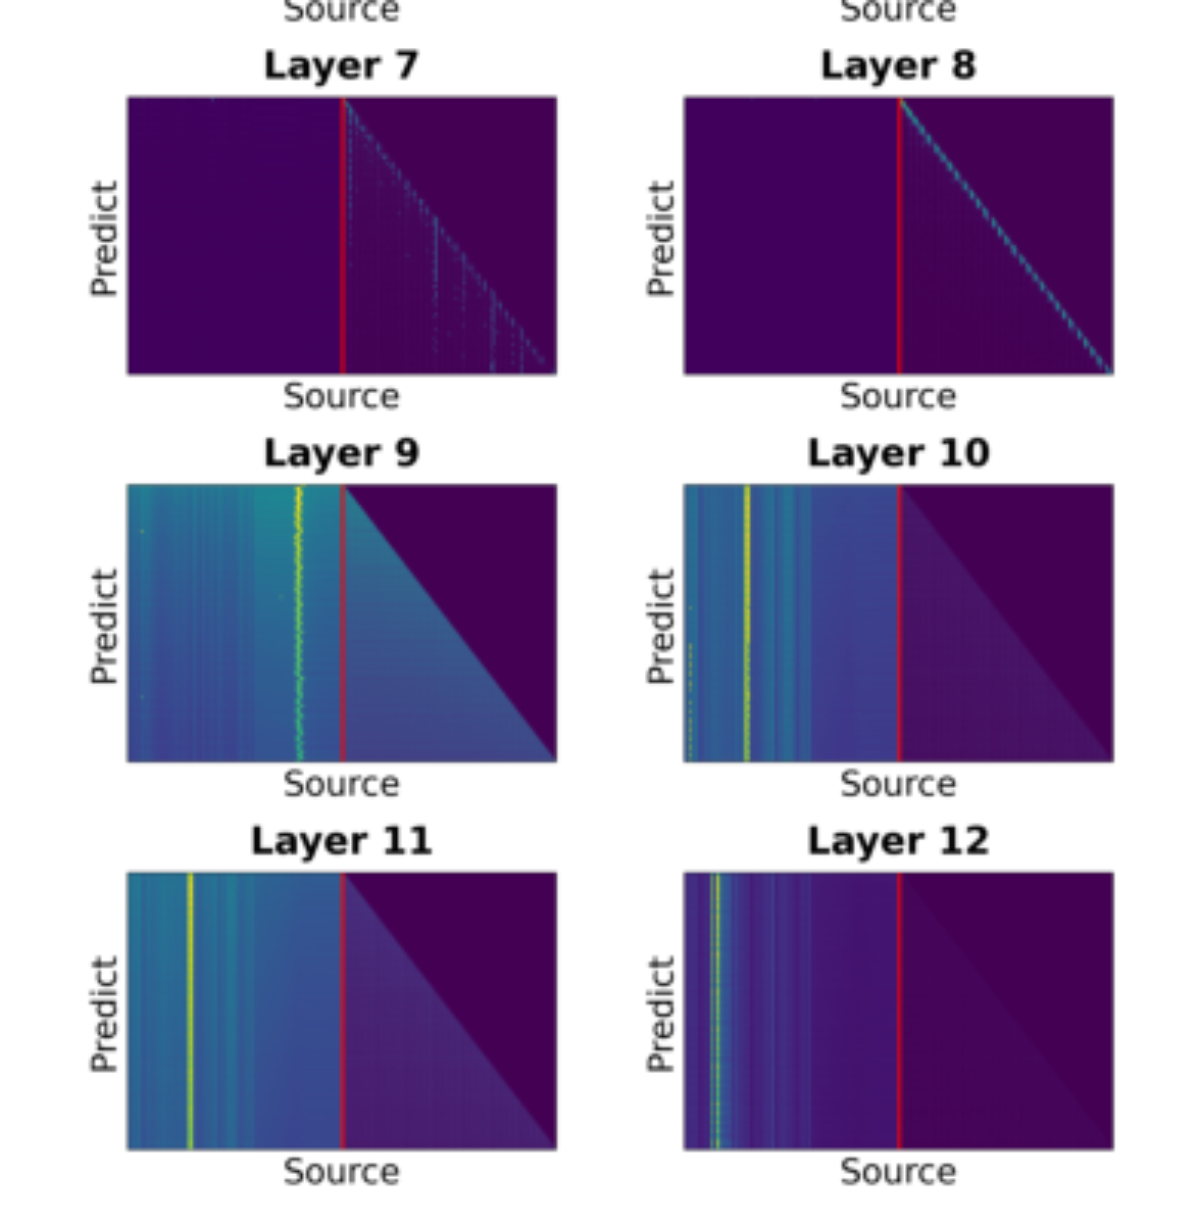
论文图 5。原论文 Figure 5:“Visualization of self-attention weights across 12 decoder layers.”。
从注意力热图可见,第 7 到第 8 层右侧音乐区对角线亮而左侧文本区暗,第 9 到第 12 层左侧文本区出现稳定的纵向亮带,红色分界线左侧为文本右侧为音乐,亮色为强注意力。这与论文所说深层更依赖全局语义一致,但不能证明每一步都如此,总体趋势不等于每组每步成立。自由文本与主观评分放在下表,条件变为 96 条手工开放文本,绝对分数下降且差距收窄,但新模型仍在压缩比语义与主观分上保持领先。表前问题是缺乏显式速度拍号调性约束时模型是否只会背众数,公平条件是同批自由文本同温度,指标方向仍为越高越好。
| 条件 | 指标 | MuseCoco | 推理对齐基线 | 本方法 | 说明 |
|---|---|---|---|---|---|
| 96 条自由文本 | CR 压缩比 | 1.9652 | 2.1414 | 3.1102 | 信息密度更高而非填充 |
| 96 条自由文本 | CLAP 语义 | 0.1767 | 0.1847 | 0.1881 | 差距收窄但仍领先 |
| 96 条自由文本 | CLaMP 3 语义 | 0.1366 | 0.1326 | 0.1390 | 直接符号级对齐领先 |
| 测试集盲听 | MOS 均值 | 2.0854 | 2.4861 | 3.2306 | 15 人盲评接近 1 分差距 |
| 自由文本盲听 | MOS 均值 | 3.0312 | 3.2965 | 3.3417 | 流畅与情感权重上升差距缩小 |
表后解释是开放文本下结构真值不可用,语义绝对值整体走低,新模型压缩比 3.1102 最高,论文解读为生成更长且信息密集的段落而不靠填充。主观分上测试集从 2.4861 到 3.2306 提升近 1 分,自由文本从 3.2965 到 3.3417 差距缩小,论文归因于评分者更看重流畅与情感而非严格结构。未评测边界是自由文本没有真值对照与调性拍号命中率,误判率延迟与成本也未测量,不能承诺这些量得到改善。
哪些地方明确不行,原因交代到哪一步?
论文明确承认的短板集中在调性。CK 与 CKD 虽超过基线但绝对值仍低,复杂调性与频繁转调时质量下降。原文给出的机制原因是标准 MIDI 没有显式调号相关词元,模型只能从全局音高分布推断,这属于直接报告的局限而非猜测。第二个局限是自由文本下绝对对齐分数下降,说明开放措辞泛化仍难。第 3 个是评估本身的局限,CLAP 需要先把 MIDI 转音频再打分,转换用的统一乐器库会引入额外偏差,CLaMP 3 虽直接测符号级对齐但仍是模型打分,不能等同于人评。
论文还提到真值中存在主观标注噪声,这解释了语义反超真值的现象,但未量化噪声比例,应表述为可能与待验证。训练与推理开销方面,论文只报告训练用 4 卡约 60 小时,未报告推理延迟显存与输出帧率,复述时要分开讨论,不能把训练资源当作推理成本。总体上,调性未解决、开放文本泛化减弱、评估依赖模型打分,这三点是后续工作必须补的验证。
要复现应先固定什么,再跑什么?
复现先固定数据与表示。下载 MidiCaps 并保持官方训练集不变,把官方测试集对半分为验证与保留测试,注意原文未给出随机种子与具体切分文件,复现时应记录自己的切分并报告。MIDI 侧用 REMI+ 加 miditok 得到 515 词表,文本侧用 GPT-2 分词器得到 50257 词表,MIDI 长度 2048 文本长度 128,批量 16,12 层解码器加旋转位置编码,每层 8 专家 Top-2。训练按 100000 步余弦衰减加 10000 步热身,峰值与终值按原文设置,采样温度 1.0。
评估先跑客观八指标,注意速度与调性真值不可用时标为不适用,压缩比用 COSIATEC,CLAP 用指定检查点与统一乐器库,拍号用完全一致命中,语义再加 CLaMP 3。主观评估需 15 人盲听,测试与自由文本各 96 样本,1 到 5 分标准按原文定义执行。代码与资源状态需要特别说明,本次收到的资源状态显示没有完成 HTTPS 验证的绑定资源,因此不得声称代码模型或数据已公开,原文虽给出代码链接但应写本次未能确认可达,复现前需自行核对链接有效性。
缺项清单包括负载均衡权重取值、验证集早停规则、路由与注意力可视化的采样细节,这些未报告时不要从模型名称推定实现。
何时值得试这个设计,还需补哪项验证?
当任务同时要求按文字控速度拍号配器,又要求长程结构不散时,这个设计值得尝试。它的可借鉴点是把交互收敛到共享自注意力,把变换按模态分开,音乐侧用稀疏专家分担不同事件类型,避免众数拍号与速度主导输出。何时不值得,如果任务核心是复杂调性与频繁转调,或需要实时交互与严格延迟保证,论文既显示调性仍弱,也未测量延迟成本,此时应先补显式调号节奏编码或检索增强的分层生成。
还需补的验证包括显式调性词元对照、开放文本的结构命中率、不同专家数与 Top-K 的成本曲线,以及把模型打分换成更多人评与误判率统计。对初学者而言,记住一句话复述方法,文本拼前面做前缀, attention 一起看,前馈分开算,音乐用专家分工,最后只预测音乐。这样既能讲清流程,也能对应到原文的消融与可视化证据,而不会把比喻当成性质证明。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses