英文题目:Walk Before You Dance: High-fidelity and Editable Dance Synthesis via Generative Masked Motion Prior
会议身份:
conference:aaai:2026:conference-paper-id:37833
✅ 来源为官方会议 PDF;可重放的表格、公式文本与 Figure 像素已按 PDF 抽取结果绑定,未成功恢复的结构不作推断。
标签:#生成模型 #Transformer #向量量化 #音乐 #音视频生成
评分:7.0/10 | 创新 1.6/2 | 技术严谨 1.2/1.5 | 实验充分 1.0/1.5 | 清晰度 0.7/1 | 影响力 1.0/1.5 | 开源 0.2/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究
👥 作者与机构
- Foram N Shah:机构信息未能从会议 PDF 纯文本可靠映射
- Parshwa N Shah:机构信息未能从会议 PDF 纯文本可靠映射
- Muhammad Usama Saleem:机构信息未能从会议 PDF 纯文本可靠映射
- Ekkasit Pinyoanuntapong:机构信息未能从会议 PDF 纯文本可靠映射
- Pu Wang:机构信息未能从会议 PDF 纯文本可靠映射
- Hongfei Xue:机构信息未能从会议 PDF 纯文本可靠映射
- Ahmed Helmy:机构信息未能从会议 PDF 纯文本可靠映射
📌 核心摘要
音乐驱动舞蹈合成需以音乐信号、体裁文本与稀疏姿态约束为输入联合生成三维人体动作,难点在于同时保证真实感、节拍对齐、多样性、物理合理性与可编辑性且避免多模态梯度冲突。DanceMosaic先用向量量化将连续动作离散为词元并在混合语料上统一表征,为掩码建模提供可学习的类别分布。接着在HumanML3D上预训练文本条件掩码骨干学习通用运动先验,其输出的掩码分布作为后续舞蹈合成的基础。然后冻结骨干并行接入音乐塔与姿态塔,经同步掩码与渐进训练分别注入节奏与空间约束,使各分支以各自损失独立优化同一先验。与单塔掩码或动作空间扩散模型不同,该设计以零初始化线性连接与逐帧词元相加实现模态对齐,并在推理时以多模态分类器无关logits引导与词元优化强化控制。在FineDance基准下,DanceMosaic的运动质量指标FIDk为22.33,低于LODGE的45.56。该结论适用边界受限于FineDance的9秒短片段评测与HumanML3D文本基准,长时编舞仅靠零样本拼接验证,跨风格泛化尚未验证,其在单卡RTX A5000硬件上每9秒片段推理开销为0.8秒。
🔗 开源与复现资源
- 演示资源:https://foram-s1.github.io/DanceMosaic/ — 链接可访问(HTTP 200) 可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
输入是什么,要输出什么,哪些信息必须保留?
这篇论文研究的任务是音乐条件舞蹈生成。输入有 3 类。第一是音乐信号,要求输出动作的节奏与重拍与它对齐。第二是文本提示,论文主要用体裁描述与通用动作描述,要求输出风格与语义受文本控制。第三是姿态约束,是多帧多关节的稀疏 3 维位置,其中只有部分帧与部分关节有效,其余填零表示可编辑。
输出是一个多帧 3 维人体骨骼序列。论文要求它同时满足三点。第一是看起来像真人舞蹈且脚步不打滑。第二是节拍对齐音乐且风格符合文本。第三是不可编辑关节尽量贴合给定位置。
必须保留逐帧时间对应、体裁标签与稀疏姿态的帧号关节号。若打乱音乐顺序,对拍评价即失效。若丢掉体裁标签,即无法区分不同舞种。若丢掉有效指示,即无法区分固定与生成关节。
下面这张总览图先给出直观印象,同一音乐下切换文本提示并在尾段叠加姿态约束,说明 3 路信号是叠加关系。
看图路径: 1. 先看顶部人物长带的颜色分段与下方四段文本标签如何一一对应;2. 再看底部音乐波形全程连续,确认切换体裁时节奏输入不断;3. 最后看右侧红色段下方五个下肢小图,确认姿态只在尾段介入
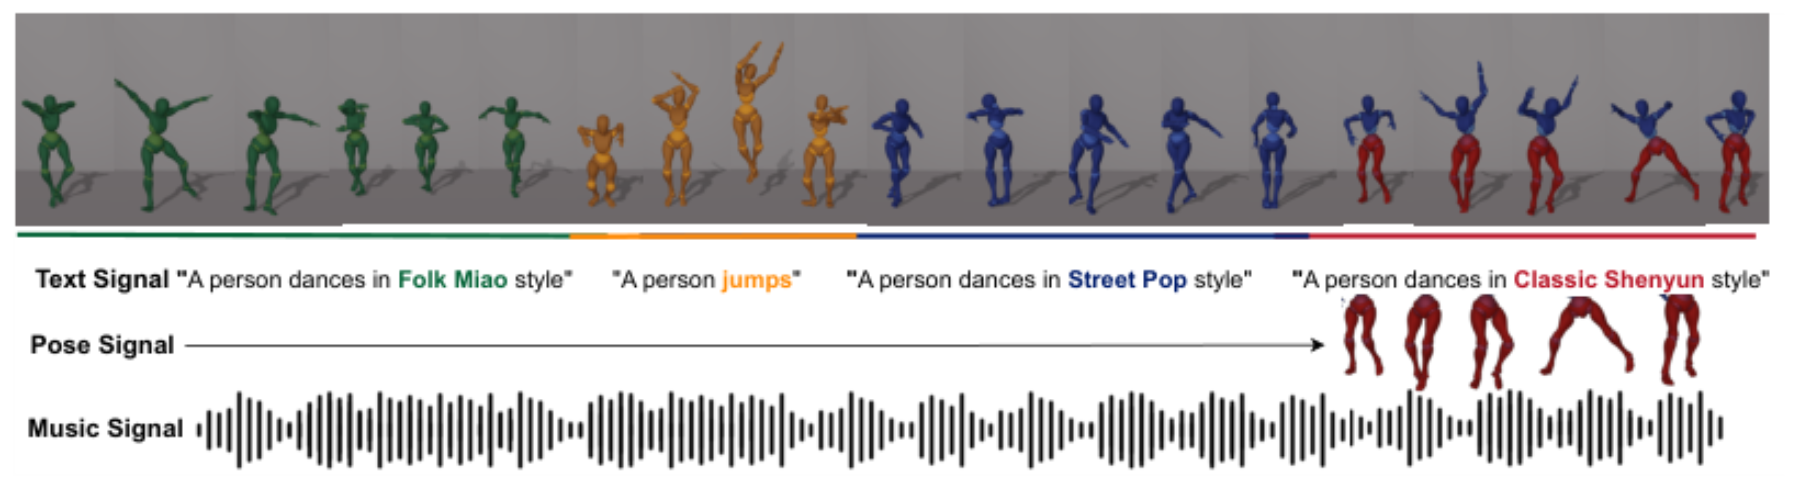
论文图 1。原论文 Figure 1:“DanceMosaic generates 3D dance motions based on multiple guidance signals.”。
这张像素图顶部是一条长的人物运动带,从左到右依次为绿色苗族民间舞、橙色跳跃、蓝色街头流行舞与蓝红混合古典神韵舞。底部是连续音乐波形,右侧红色段下方叠加 5 个红色下肢小图作为姿态信号。可见对象是完整人体网格而非骨骼线,时间覆盖多体裁切换,条件是音乐全程存在而姿态只在尾段介入。这支持后文理解:文本管全局风格,音乐管全程节奏,姿态管局部精修。
自回归、扩散与掩码三条路线各解决了什么?
在相同输入与目标下,此前主要有两条路线。自回归路线以 Bailando 为代表,用类 GPT 逐词元预测保证多样性与连贯,但顺序生成使音乐重拍与动作峰值容易错位。扩散路线以 EDGE 与 LODGE 等为代表,在连续动作空间多步去噪,对拍有所改善,但论文指出其保真度仍不如真实人体自然,且多步去噪导致推理慢。两条路线都缺乏方便的身体部位编辑与插值能力。
在文本到动作领域,MoMask 与 MMM 等掩码建模已显示较好质量与多样性。它们把动作离散化后随机掩码再双向恢复,可以并行解码。但论文明确指出掩码建模在音乐舞蹈中仍未被探索,原因是文本语义与音乐语义差异大,单塔结构难兼顾节拍与语义。DanceMosaic 保留掩码并行与可编辑优点,但把单塔扩展为多塔。
理解对照时不要把类别差异当同条件胜负。扩散慢源于去噪步数多,掩码快源于置信度重掩码只需十几次迭代。自回归多样性来自采样温度,掩码多样性来自掩码模式与引导权重。二者只能在同一数据集与同一指标下比较数值,不宜跨任务直接比大小。
为什么直接把音乐拼给掩码模型还不够?
一个朴素想法是把音乐嵌入与文本嵌入拼接,直接训练一个掩码变换器预测被遮住词元。论文认为这会遇到两个困难。第一是分布差异。文本描述离散语义,音乐是连续声学信号,二者对动作的影响粒度不同,直接拼接难同时学好结构与对拍。第二是梯度冲突。音乐分支运动学损失要求恢复全身,姿态分支差异损失只要求恢复不可编辑关节,一个要全局准确,一个要局部精确。
举例说明如下,这是一个教学例子。假设给定快节奏街舞音乐与下肢固定约束,全局损失希望全身大幅摆动以对重拍,局部损失希望下肢不动,二者在共享参数上更新就会互相拉扯。论文因此提出分塔加渐进安排,先让文本骨干学会合理人体分布,再让音乐塔与姿态塔各自在冻结骨干上学习偏移。这不是论文报告的数值实验,只用于说明分开优化的动机。
形式化地说,目标是建模条件分布。骨干先建模给定被遮挡序列与文本时的词元分布。音乐塔扩展为再给定音乐时的分布。姿态塔扩展为再给定姿态时的分布。推理时三者通过对数加权与词元优化组合,共同决定采样结果。
一个样本如何走完输入到输出?
以一个 9 秒片段为例,输入是一段音乐波形、一句街舞体裁描述与若干帧下肢关节位置。系统先把音乐送入冻结 Jukebox 得到逐帧嵌入,把文本送入冻结 CLIP 得到体裁嵌入,把稀疏姿态送入可学习编码器得到姿态词元。动作侧真实序列先被编码压缩,再经残差量化变为离散词元。训练时随机掩码一部分并依 3 路条件恢复。推理时从全掩码出发经多次采样得到完整词元,再解码为连续骨骼。
文本到动作模型 × 动作先验: 文本到动作模型分工是在 HumanML3D 这类通用描述上学习基础人体运动分布,动作先验分工是把该分布作为舞蹈生成的起点,二者搭配的理由是舞蹈数据少而通用动作数据多,先掌握走跳转等基础模式再调制更稳定,组合意义是音乐塔与姿态塔不必重学人体结构,只学习如何偏移先验分布。
下图是训练阶段总览,左侧为分词器,右侧为多塔掩码模型,顶部为两种监督损失。
看图路径: 1. 先沿左侧舞蹈编码器到残差量化再到码本的纵向路径看离散化;2. 再看中间冻结主干与左右双塔经零线性层汇合的横向连接;3. 最后看顶部经采样后分叉到运动学损失与差异损失的监督
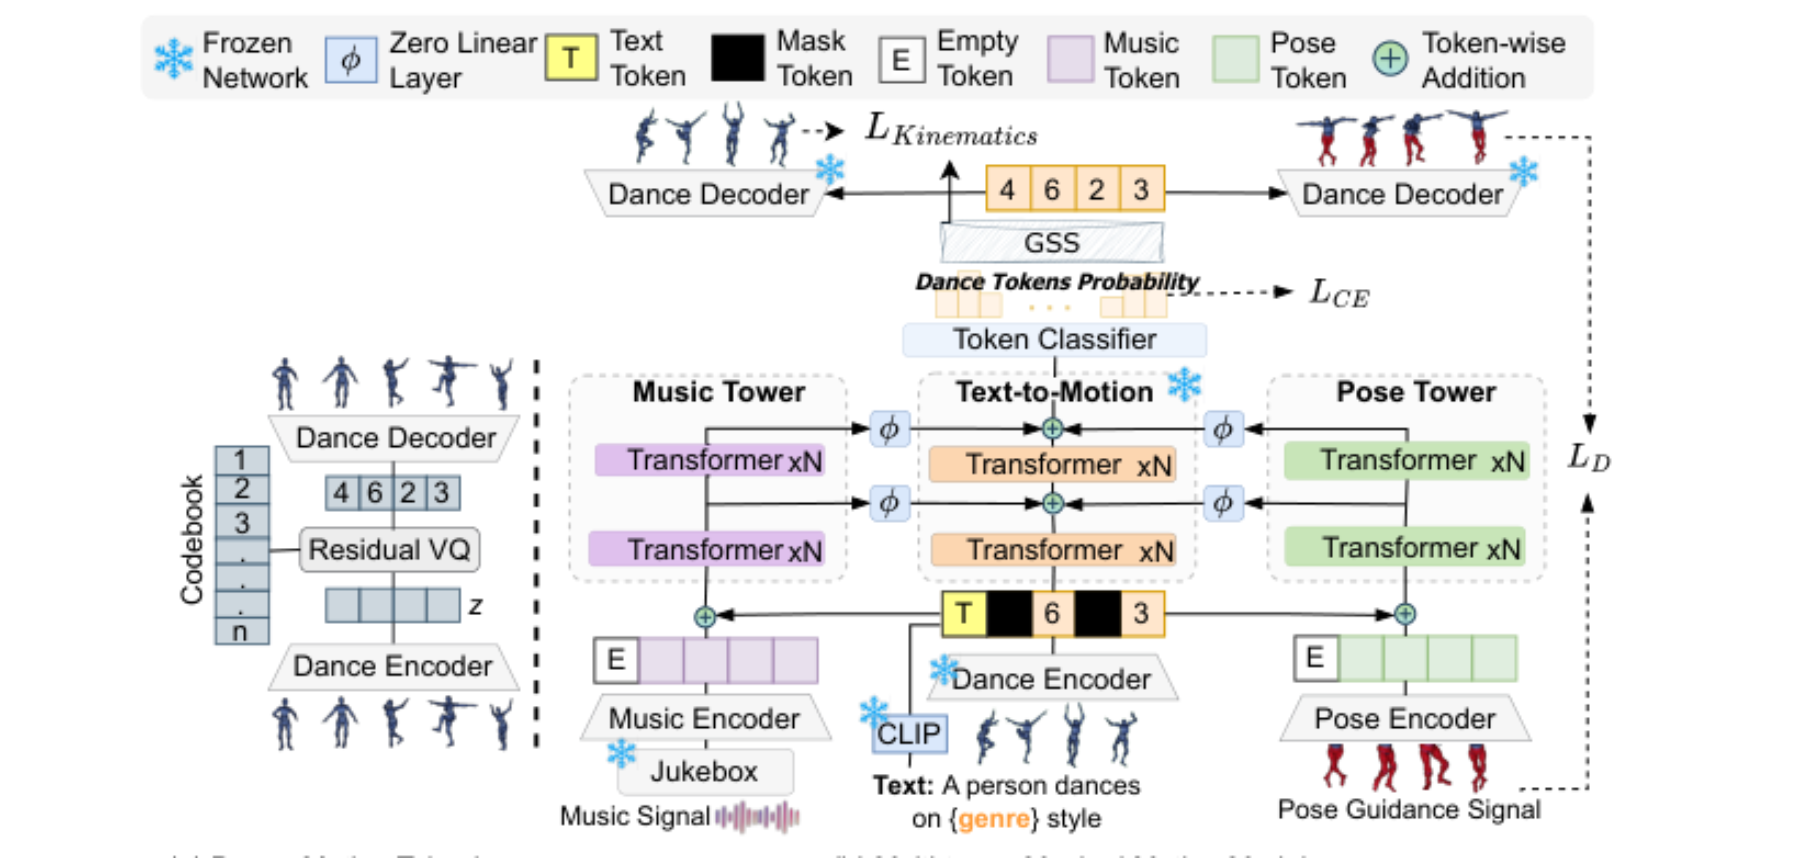
论文图 2。原论文 Figure 2:“Overview of DanceMosaic’s training phase.”。
这张像素图左侧显示舞蹈编码器把小人序列变为隐变量,再经残差量化和码本变为词元并可重建。右侧中间为冻结文本到动作主干,左右分别为音乐塔与姿态塔,每层经零初始化线性层汇入主干。底部音乐经 Jukebox 与音乐编码器、姿态经姿态编码器、文本经 CLIP 分别以逐词元相加逐帧对齐。顶部词元分类器输出概率,经采样后一路算交叉熵,一路经冻结解码器算运动学与姿态差异损失。零线性层初期输出接近零,保证新塔不破坏先验。
分词器、骨干与双塔各自算什么?
动作分词器基于向量量化变分自编码器。给定多帧骨骼序列,编码器以固定下采样率得到隐序列,再对每个隐向量在码本中找欧氏距离最近码项。为减小量化误差,采用残差向量量化,用多个量化器逐级编码前 1 级残差。分词器在 HumanML3D 与 FineDance 并集上训练,使文本动作与舞蹈共享隐空间。损失包括重建误差与码本对齐误差,并用停止梯度隔离更新路径。
文本到动作骨干是标准多层变换器。输入是动作词元与 CLIP 文本嵌入拼接,文本放在序列开头,利用自注意力让所有词元与文本相关。训练目标是最大化被遮住位置的预测似然。音乐塔与姿态塔是与骨干每层配对的可训练副本,每层输出经零初始化线性层加到骨干。音乐嵌入来自冻结 Jukebox,姿态为多帧多关节位置,二者经各自编码器变为同维隐词元,再以逐词元相加逐帧对齐。
掩码建模 × 残差向量量化: 残差向量量化分工是把连续骨骼序列压缩为离散动作词元,使生成变为分类预测,掩码建模分工是随机遮住部分词元并依文本音乐姿态恢复,二者搭配是因为离散词元才能用交叉熵与置信度重掩码并行解码,组合后既能双向利用上下文做插帧补画,又能逐级降低量化重建误差。
音乐塔 × 姿态塔: 音乐塔分工是把冻结 Jukebox 逐帧音乐嵌入对齐到动作帧并学习节奏到全身运动映射,姿态塔分工是把稀疏关节位置编码为约束并补全其余关节,二者并行搭配的理由是全身运动学损失与局部姿态差异损失梯度方向冲突,组合意义是推理时音乐管整体风格节拍而姿态管局部精修,互不覆盖。
需要澄清的误解是逐帧相加不是拼接。它要求音乐、姿态与动作在帧数上严格对应,相加后维度不变,模型靠加法偏移注入条件。若帧率不一致,必须先重采样到同一帧率。论文将序列下采样到 20 帧每秒,音乐嵌入也按此对齐,这是复现必须保留的信息条件。
同步掩码、渐进训练与推理引导如何协同?
训练分为 3 个阶段推进。第一阶段在 HumanML3D 上训练文本到动作骨干,文本包括通用动作描述。第二阶段冻结骨干只训练音乐塔,数据为 FineDance 舞蹈,条件为音乐加体裁文本,损失为交叉熵加位置速度加速度与脚部损失。其中离散采样不可微,用直通 Gumbel-Softmax 近似为连续分布以便回传。第 3 阶段冻结骨干只训练姿态塔,条件为姿态加体裁文本,损失为交叉熵加有效关节差异。
同步掩码训练 × 渐进训练: 同步掩码训练指文本骨干与引导塔看到相同位置的被遮挡词元序列,保证引导塔直接利用骨干分布,渐进训练指先训文本骨干再冻结训音乐塔最后冻结训姿态塔,二者搭配是因为同时更新会让全身恢复与局部固定互相干扰,组合后每阶段只有新塔可训,既注入先验又避免梯度冲突。
推理分为两步相互配合。第一步是多模态分类器无关对数引导,最终对数是无条件与各条件对数的线性组合,经 Softmax 得到采样分布。从全掩码出发共多次迭代,每次按置信度采样并把低置信词元按余弦计划重掩码。第二步是姿态引导词元优化,若提供稀疏姿态则冻结网络,只对输入词元嵌入做梯度下降以减小差异。
分类器无关对数引导 × 推理时词元优化: 分类器无关对数引导分工是在分类器输出层把无条件对数与各条件对数线性加权以放大弱信号,推理时词元优化分工是冻结网络只用梯度下降微调输入词元嵌入以减小姿态差异,前者解决条件被淹没问题而后者解决稀疏约束难 1 次满足问题,组合后先采样得到大体对拍序列再把指定关节拉到目标位置。
下面这张推理图展示左侧迭代重掩码与右侧词元优化回路,左半为运动先验而右半为姿态精修。
看图路径: 1. 先看左半从首步含问号词元经重掩码到第 T 步完整词元的变化;2. 再对比右半冻结解码器与火焰标记可训练词元的位置差异;3. 最后跟踪红色虚线从重建姿态返回词元的梯度更新回路
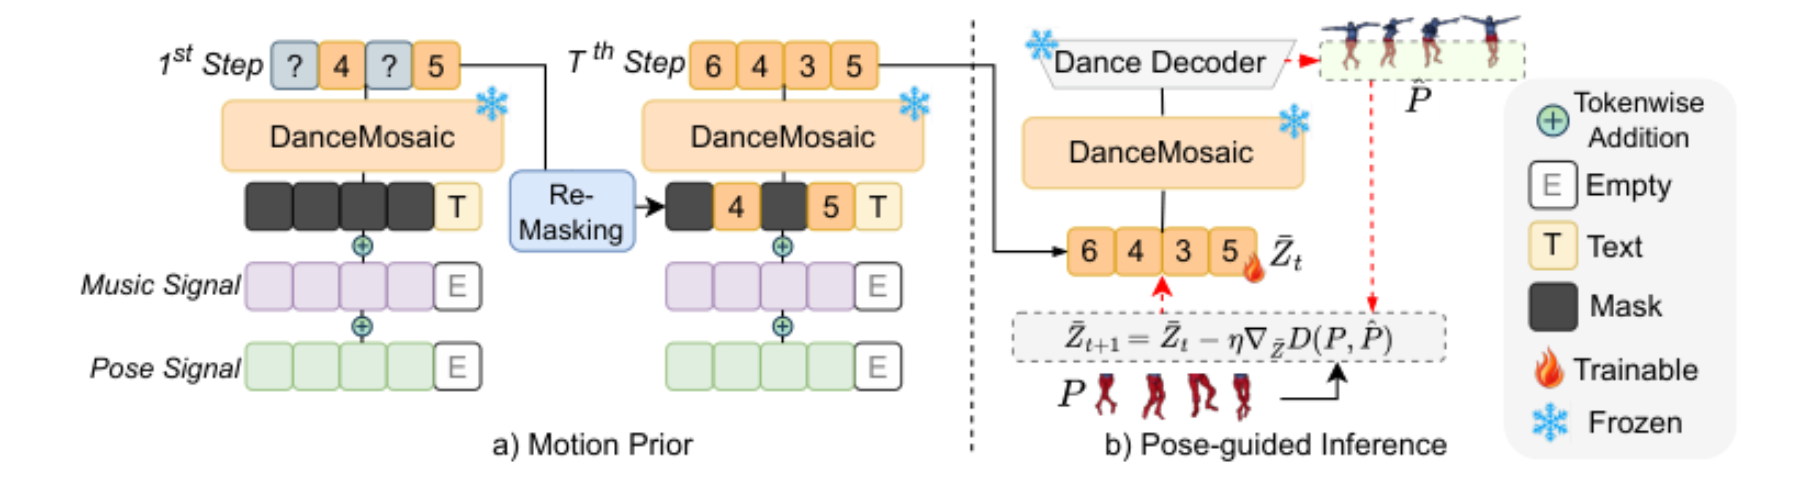
论文图 3。原论文 Figure 3:“Overview of DanceMosaic’s inference phase.”。
这张像素图左半显示首步含问号的未定词元经 DanceMosaic 与重掩码模块,到第 T 步变为完整词元,底部音乐与姿态词元以逐词元相加汇入。右半显示词元经冻结解码器得到重建姿态估计,再与输入姿态比较差异并沿红色虚线回传更新可训练词元。图例区分空词元、掩码块、文本块与可训练火焰标记,时间范围是从全掩码到收敛的多步迭代。原文未报告优化步数与引导权重的完整网格,复现时需记为待补验证。
在什么数据与指标下测量?
预训练用 HumanML3D,论文描述为 14616 个序列与 44970 条描述,用于学习通用文本到动作骨干。舞蹈实验用 FineDance,描述为 7.7 小时、202 个序列、16 种体裁,每段配高质量音频与逐帧音乐特征和体裁标签。所有序列下采样到 20 帧每秒,采用作者原始划分。分词器在两者并集上训练,骨干在 HumanML3D 上预训练,音乐塔与姿态塔只在 FineDance 上训练。项目页当前可用,状态为 200,可查看样例但不能代替定量证据。
评价指标分为 5 组。运动质量用运动学与几何 Frechet 距离,越低越接近真实。多样性用同特征空间成对距离均值,越高越丰富。节拍对齐用 BAS,越高越一致。物理合理用脚步滑动率,越低越好。
效率用每 9 秒片段平均推理秒数,越低越快。舞蹈评价采用 LODGE 协议,所有结果为 20 次运行平均,硬件为单张 RTX A5000。文本评价在 HumanML3D 测试集报告准确率与多样性等。
聚合与单位需要小心。FID 与多样性是分布级指标,不是单样本得分,20 次平均降低随机性但原文未给标准差。百分点与相对百分比不同,脚滑率下降既可用百分点也可用相对比例表述,不宜混用。推理时间是每 9 秒片段耗时,不是帧率也不是端到端延迟,换卡比较需重新测量。
主结果在什么条件下成立?
比较的问题是,在同一 FineDance 测试集与 LODGE 协议下,多塔掩码模型能否在保真多样对拍与速度上同时优于自回归与扩散基线。公平条件是同一划分与同一 20 次平均,指标方向为质量滑动率与时间越低越好,多样性与对拍越高越好。论文报告本方法在质量多样与速度上领先,但节拍对齐并非最高,这是必须保留的未胜出项。
下表整理论文正文连续句报告的关键数字,条件为 FineDance 全测试集,本方法为完整 DanceMosaic。
| 条件 | 指标 | 基线 | 本方法 | 比较对象 |
|---|---|---|---|---|
| FineDance 测试集 | 运动学 FIDk | 45.56 | 22.33 | LODGE |
| FineDance 测试集 | 几何 FIDg | 34.29 | 12.96 | LODGE |
| FineDance 测试集 | 几何多样性 Divg | 6.45 | 8.36 | EDGE |
| FineDance 测试集 | 运动学多样性 Divk | 高 | 8.54 | 多基线 |
| FineDance 测试集 | 脚滑率 FSR | 18.76% | 7.58% | Bailando |
| FineDance 测试集 | 节拍对齐 BAS | 高 | 0.2190 | LODGE 0.2397 |
上表显示质量提升伴随多样性保持,运动学与几何距离大幅下降,几何多样性上升而运动学多样性保持高位,脚滑率明显下降,说明更贴近真实且物理更合理。代价是节拍对齐为 0.2190,低于 LODGE 报告的更高值,支持的判断是真实性提升未完全转化为对拍提升,可能与并行解码对细粒度峰值建模较粗有关,待进一步验证。效率上每 9 秒片段 0.80 秒,论文称超基线数倍,但这是总体趋势且未测量内存。
看图路径: 1. 先看 a 组中间红色跳跃帧与两侧蓝色帧的腾空衔接是否连贯;2. 再看 b 组上蓝下红分色中红色下肢固定而蓝色上身变化;3. 最后看 c 组红蓝交替人偶的体裁过渡是否保持步态自然
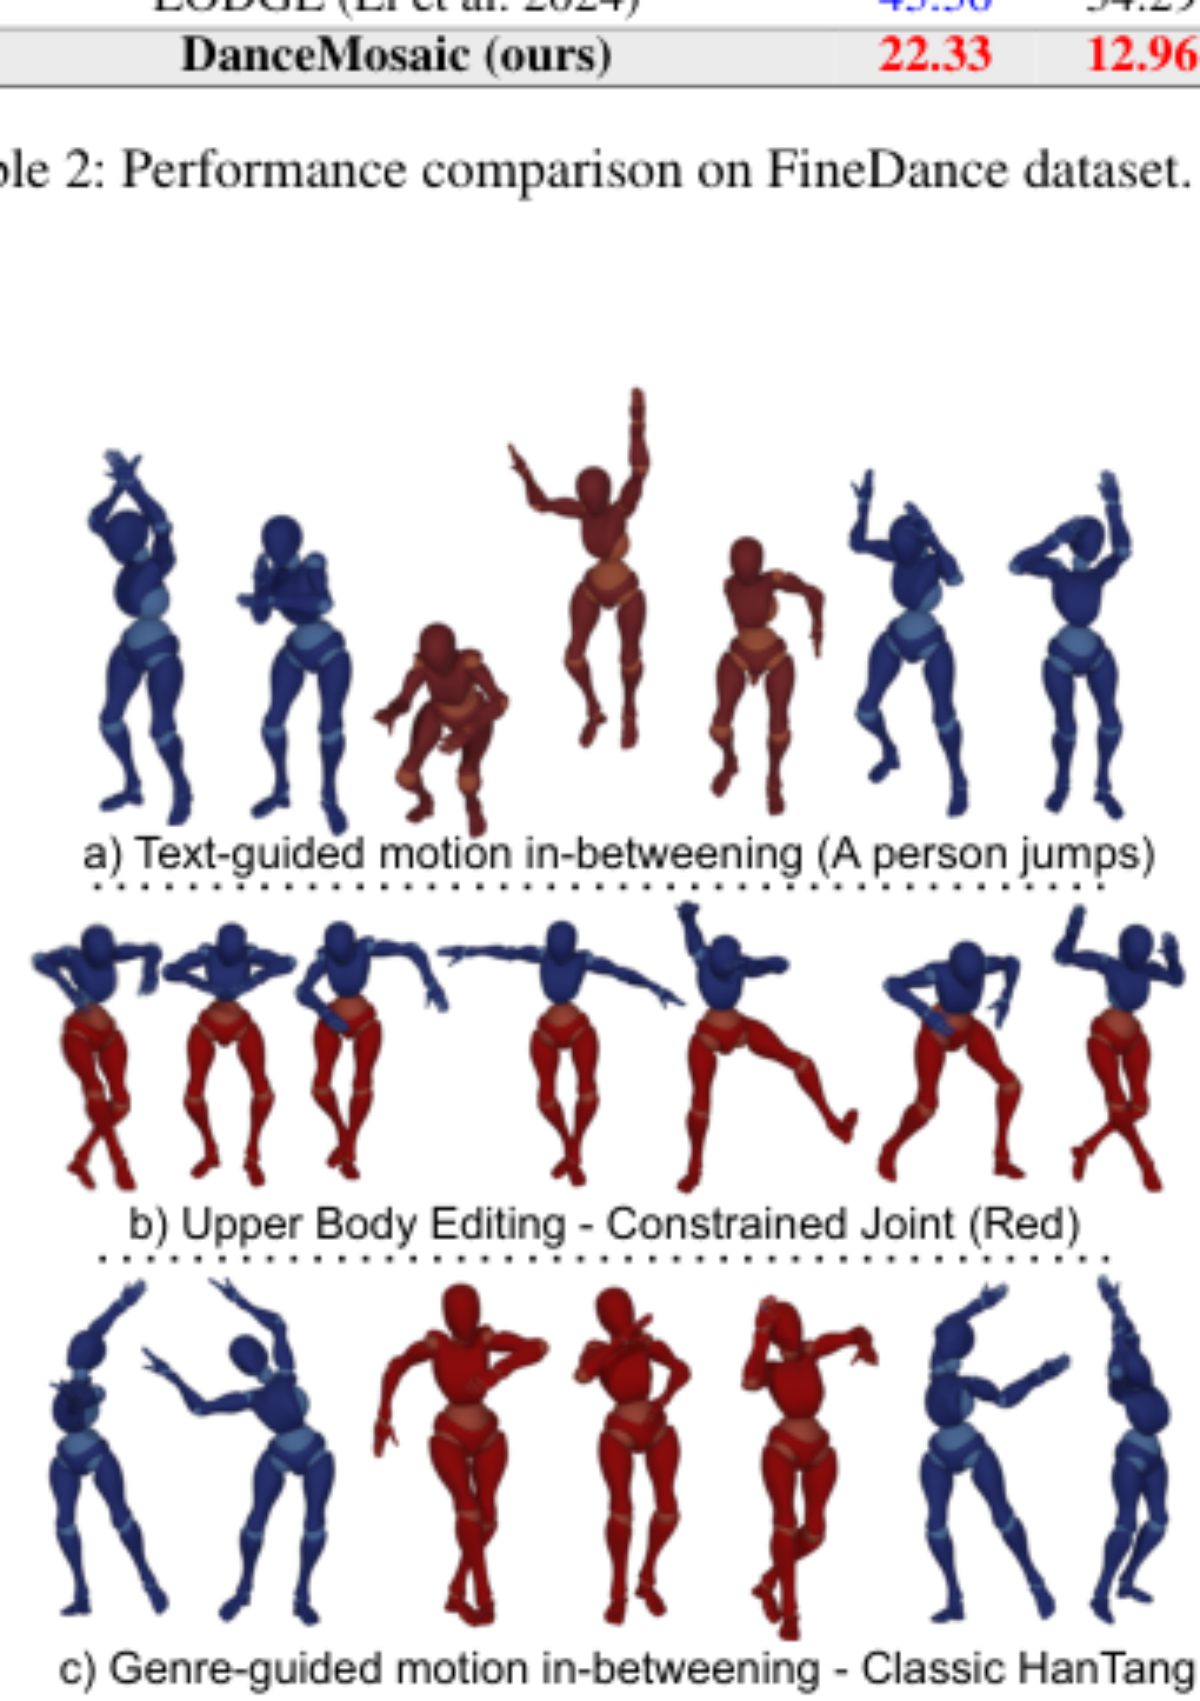
论文图 4。原论文 Figure 4:“Various Applications Using DanceMosaic”。
这张像素图展示 3 种定性编辑而非定量曲线。a 组为文本引导动作间插,中间红色跳跃帧被两侧蓝色帧夹住,说明掩码可补全缺失段。b 组为上身编辑,上蓝下红的分色中红色下肢约束保持相近站姿而蓝色上身各异。c 组为体裁引导间插,红蓝交替仍能过渡。这些是功能示例,不能当作成功率证明,精度证据在消融关节距离中给出。
拿掉每个部件会发生什么?
消融要回答 3 个问题:文本先验是否必要,音乐权重多大合适,姿态塔与推理优化谁更关键。论文组件消融显示去掉文本骨干则质量明显下降,去掉体裁提示则多样性虚高但动作散乱,去掉音乐塔则质量最差且对拍崩塌,支持多塔与同步训练是高质量与语义一致的基础。但原文表格细节摘录不完整,此处只用正文连续句能覆盖的姿态与权重证据整理。
下表整理姿态编辑消融,条件为提供稀疏姿态约束时的重建任务,指标方向为距离越低越好,对拍越高越好。
| 条件 | 指标 | 仅推理优化 | 仅姿态塔 | 联合使用 |
|---|---|---|---|---|
| 姿态编辑 | 运动学 FIDk | 32.37 | 84.56 | 22.89 |
| 姿态编辑 | 几何 FIDg | 48.80 | 49.74 | 39.11 |
| 姿态编辑 | 关节距离 | 0.005 | 0.037 | 0.004 |
| 姿态编辑 | 节拍对齐 BAS | 0.2127 | 0.2263 | 0.2277 |
上表显示单独推理优化已把运动学距离与关节距离大幅降低,说明逐词元梯度精修对稀疏约束最直接。单独姿态塔仅改善几何距离而关节误差仍高,说明结构级条件需要细粒度调整配合。联合使用达到最优,支持两者互补而非替代。限制是该消融口径可能与主表不同,不能直接断言编辑后对拍超越主结果,只能在同一消融内比较相对升降。
音乐权重方面,论文报告固定文本权重并增大音乐权重时,质量距离持续下降而对拍持续上升,在权重为 1 时最优,超过后收益递减。这支持按模态加权以平衡真实性与节奏保真,但原文未给出不同体裁下的最优值是否一致,因此总体最优不等于每首音乐都最优。
哪些边界没有测?
首先是节拍对齐未登顶。主结果中本方法低于 LODGE,论文仍称增强真实性未损害同步,但严格表述应为同步保持较强而非最强。若应用对卡点要求极高,LODGE 可能是更合适基线,本方法优势在质量多样速度与可编辑性。其次是物理评价单一。脚滑率只反映脚部滑动,未测量关节极限穿插或接触力,不能承诺整体物理正确性有同等改善。
其次是统计与成本缺项。所有结果为 20 次平均,但未报告方差置信区间或显著性检验,不能判断小幅差异是否稳定。训练资源未提总时长与显存,推理只给特定显卡上每 9 秒片段耗时,未给首帧延迟内存峰值或长序列拼接累积误差。长舞蹈被描述为零样本分段生成再掩码过渡,但未报告长序列定量连贯性,只能视为功能演示。
最后是条件覆盖不全。姿态塔训练时未显式使用音乐信号,靠共享先验实现同时操控,这种组合在训练分布外的叠加下是否稳定,原文没有系统失败分析。音乐权重最优的结论基于总体平均,不同速度与体裁下的最优值待验证。这些缺项不是技术错误,只是未验证边界,后续需补方差长序列指标与跨体裁搜索。
要复现先做什么?
复现第一步是准备数据与分词器。将 FineDance 与 HumanML3D 都重采样到 20 帧每秒,保留原始划分、逐帧音乐特征与体裁标签,以及文本描述。在两者并集上训练残差量化分词器,固定下采样率与码本大小,验证重建收敛后再冻结,后续掩码训练都基于其离散词元。若只在单一数据集上训练,隐空间不一致会导致先验迁移失效。
第二步是按顺序训练 3 个阶段。先在 HumanML3D 上训练文本骨干,文本经冻结 CLIP 编码,动作为掩码预测。接着冻结骨干与编码解码器,只训练音乐塔,损失为交叉熵加位置速度加速度与脚部损失,需实现直通采样使离散可微。最后冻结骨干只训练姿态塔,损失为交叉熵加有效关节差异。同步掩码要求同一批次看到相同掩码位置,零初始化线性层保证初期不扰动先验。原文未给出学习率批量掩码比例与权重细节,需回附录与代码核对。
第三步是实现推理与评估。实现分类器无关对数加权,分别调文本与音乐权重,论文仅明确音乐权重最优在 1 附近,文本权重需自行搜索。实现置信度重掩码的余弦衰减与多步迭代,再实现冻结网络下的词元梯度优化。评估严格采用 LODGE 协议,20 次平均,单卡计时。论文只给出展示页链接,摘录未声明代码权重开源,不能写已开源,只能写展示页可查看样例。
何时值得尝试先学走再学舞?
当任务同时需要高质量可编辑与实时性时,这条路线值得尝试。例如编舞工具需根据同一音乐快速切换多种风格,并允许固定下肢只改上身,多塔掩码加推理优化提供了直接机制。此时应先复现分词器与骨干,确认文本到动作达到合理水平,再接入音乐塔调对拍,最后接入姿态塔调关节距离,不要一开始就联合训练三者。
当任务只追求极致卡点或严格物理仿真时,需谨慎。若评价以节拍为唯一目标,LODGE 在原文报告中更高,应优先对比。若部署在机器人或物理引擎中,单一下降不能保证不摔倒,需补接触力与关节极限验证,并测量目标硬件真实延迟而非照搬 0.80 秒。
回到中心矛盾:逼真与可控往往互斥,直接加条件容易互相干扰。论文用分布先验隔离通用运动知识,用分塔隔离冲突梯度,用推理计算弥补稀疏约束。报告显示这在 FineDance 上把质量距离大幅降低、多样性保持高位、推理降到 0.80 秒,支持高质量与可编辑可以兼得。但对拍未登顶与缺失的方差长序列证据提醒我们,兼得是有条件的,复现时先做小规模消融确认权重与步数,再扩展到长舞蹈与多体裁。
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
- 评分规则:type-aware-v1
- 评分模型:muse-spark-1.3-contributor
- 评分请求协议:openai_responses