共分析 50 篇论文
⚡ 今日概览
✅ 筛选入选 50 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音合成 | 6 篇 | ██████ |
| 语音识别 | 5 篇 | █████ |
| 病理语音评估 | 3 篇 | ███ |
| 语音交互 | 3 篇 | ███ |
| 音频分离 | 3 篇 | ███ |
| 音频理解 | 3 篇 | ███ |
| 语音属性识别 | 2 篇 | ██ |
| 语音翻译 | 2 篇 | ██ |
📊 论文评分排行榜(50 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 可穿戴双人对话里又要分清谁在说又要播得快:固定角色转写与起始延迟一起练

英文题目:Low-Latency LLM-Based Streaming Multi-Talker ASR with Verifiable Rewards
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jing Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruizhi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Ju Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Jing Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Florian Metze:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
可穿戴设备需要在说话同时转写近场佩戴者与远场对话伙伴的两路语音,输出要按固定语义角色分流到对话界面的两侧,且每轮开头必须先给出角色标记才能路由,后置标记会导致整轮缓冲显示。监督微调只优化词元交叉熵,稀疏的角色标记在损失中占比很小,模型可能漏掉较弱一路或把词归错角色,也可能为确认角色而推迟输出。方法先用监督微调教会流式大语言模型输出以固定角色标记开头的串行格式,模型把24kHz波形按每1920采样点即80ms音频块提取为音频词元送入解码器交错消费音频并生成文本。再把多采样转写送入不允许角色置换的固定角色说话人归属词错率评分器,把转写、归属与删除误差折成有界质量奖励,最后把配对轮次的起始时刻差送入覆盖感知的起始时延因子按提前程度给出有界乘性调节而不压倒质量。训练开销为监督微调使用64块H100、强化学习使用120块H100,模型每词元激活约5.5B骨干参数,推理以贪婪解码做整段对话流式识别并按80ms时钟统计时延。在1181段真实佩戴设备录制的双人跨语言对话上,固定角色说话人归属词错率从监督微调的20.51%降到强化学习的13.14%。相对于仅质量强化学习,叠加时延目标后起始时延p50从0.918 s降到0.320 s且说话人归属词错率保持在12.70%。结论只在脚本化双人对话与四个语言同英语双向组成的八个方向上验证,未覆盖自发对话与更广语言。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 早解码晚验证:让离线语音识别器做流式输出
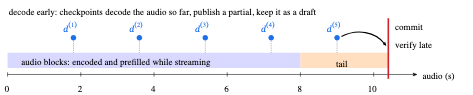
英文题目:Decode Early, Verify Late: Streaming Offline Speech Recognizers Without Accuracy Loss
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.4/1.5
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Doyeob Kim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音助手以用户语音流为输入,需在说话过程中给出中间转写,并在对话结束提交时快速返回终稿转写,难点是离线识别器要等完整语音才整句解码,等待时间长,而固定历史文本或更换小模型会损失精度。先在语音到达时按从流起始计数的固定音频块编码并送入解码器缓存,检查点把已到音频的解码结果输出为中间转写并保留为草稿。再在对话结束提交时把音频尾部与最新草稿放在同一次前向中预填充并比对,输出最长正确前缀并送入解码器只续写未通过部分,若草稿已看全音频且正常结束则直接提升为终稿。最后调度器优先运行终稿并把检查点放在剩余算力上,还按模型结构适配缓存重用,对整段编码模型在提交时重算音频、对循环状态模型重放已接受输入恢复状态,使验证与离线贪心解码一致。单流Qwen3-ASR-1.7B在Pipecat-STT上TTFS中位数从无草稿时的115 ms降至用草稿时的24 ms,在WildASR上从78 ms降至25 ms。在一块A100上承载至多64路并发时两数据集终稿TTFS中位数均为22–26 ms,且是测试中唯一在Pipecat-STT至多80路、WildASR至多64路满足100 ms p99目标的系统。五识别器对比中词错率WER与离线解码差距在0.13个百分点以内,95–100%终稿与离线转写逐字节一致。该结论限于贪心解码、确定性前端与可恢复解码器状态等条件,长于10 s的语音按句切分后不再保证逐字节一致,系统为免训练推理框架,不更新模型权重。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 用归因挑出共享子视图:降低音频视觉对齐中语义噪声的解耦学习

英文题目:Attribution-Guided Shared-Private Decoupling for Noise-Reduced Audio-Visual Representation Learning
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Linge Wang:Foundation Model Research Center, Institute of AutomationChinese Academy of Sciences, Beijing, China;School of Artificial Intelligence, University of Chinese Academy of SciencesBeijing, China
- Yingying Chen:Foundation Model Research Center, Institute of AutomationChinese Academy of Sciences, Beijing, China;School of Artificial Intelligence, University of Chinese Academy of SciencesBeijing, China
- Bingke Zhu:Foundation Model Research Center, Institute of AutomationChinese Academy of Sciences, Beijing, China;School of Artificial Intelligence, University of Chinese Academy of SciencesBeijing, China
- Lu Zhou:Foundation Model Research Center, Institute of AutomationChinese Academy of Sciences, Beijing, China;School of Artificial Intelligence, University of Chinese Academy of SciencesBeijing, China
- Haixin Wang:Foundation Model Research Center, Institute of AutomationChinese Academy of Sciences, Beijing, China;School of Artificial Intelligence, University of Chinese Academy of SciencesBeijing, China
- Zhipiao Liu:Huawei Technologies Ltd., Beijing, China
- Jinqiao Wang:Foundation Model Research Center, Institute of AutomationChinese Academy of Sciences, Beijing, China;School of Artificial Intelligence, University of Chinese Academy of SciencesBeijing, China;Objecteye Inc., Beijing, China
📌 核心摘要
真实音视频对常把可靠的跨模态对应与单模态特有残留混在一起,整段聚合后再做样本级对齐会把无关块也拉入对齐,带来语义噪声。论文把每个模态看成块序列,目标是为音频和视觉各学两个表示,一个保留跨模态共有语义用于对齐,另一个吸收单模态残留。教师先估计每个块对跨模态匹配分数的贡献,只用最后一层注意力图的梯度与权重的乘积排序,取出高相关子视图和低相关互补。再由教师对两类子视图分别前向得到停止梯度目标并送入学生,学生用余弦损失让共享表示靠近高相关目标、私有表示靠近低相关目标,对比损失只加在共享表示上,并用不同掩码比下的一致性约束稳定表示。最后训练后学生直接输出解耦表示,推理不再需要归因和子视图构造。在冻结编码器并训练轻量注意力分类头的探测评测下,VGGSound上本文方法top-1 accuracy为54.4,高于基线TG-DP的52.7;AudioSet-20K上mAP为35.2,高于TG-DP的32.0,方向均为越高越好。私有表示仍保留部分共有信息,学生共享表示未完全达到教师高相关子视图水平,结论目前只在音视频评测中验证。相同88卡NVIDIA A100硬件条件下基线需19.0小时,本方法共需27.1小时,推理无额外开销。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 转录大模型上线时为什么越忙越要换内核

英文题目:High-Throughput Serving of Nemotron 3.5 Transcribe with Regime-Aware Megakernels and Kernel Fusion
评分:7.1/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Aditya Chatterjee:NVIDIA, Bangalore, India
- Sanjay Singh Chauhan:NVIDIA, Pune, India
- Mayank Jain:NVIDIA, Pune, India
- Arushi Dhingra:NVIDIA, Pune, India
- Sahin Chowdhury:NVIDIA, Pune, India
- Rahul Mittal:NVIDIA, Pune, India
📌 核心摘要
语音转写要把最长一小时的长段语音变为带说话人归属的文字,连续批处理使每一轮编码器词元数与解码行数都在变化,固定融合粒度难以兼顾大小负载。Nemotron 3.5 Transcribe先把音频算成128维对数梅尔特征,再让32层Transformer语音识别分支与冻结说话人分支并行提取并相加,经线性适配器投影到语言模型宽度送入混合Mamba-Transformer混合专家语言模型,输出逐词文字与对齐时间戳。本文服务引擎先按单轮工作量度量区域规模,再依据离线测得的交叉点为每次执行选择实现:小负载用一次启动覆盖整个区域的持久化巨内核,大负载用保留独立启动配置的短链融合内核并以程序化依赖启动衔接。最后提示行与解码行在混合步中共享权重一次读入,多步草稿在图形处理器上生成并用CTC提示验证,减少全局内存搬运和启动间隔,这是与以算子为单位启动内核的vLLM基线的关键差异。在英文Bias语料的B200单卡评测中,本文方法的词错误率(WER)为1.92%至1.93%,高于vLLM基线的1.89%至1.91%。在H100 SXM单卡上以英文Bias语料评测端到端RTFx,保精度服务的峰值达4345倍实时,约为调优后vLLM峰值的1.39倍,低并发下最高快4.39倍,在400毫秒p95完成时间预算内可服务并发数为基线8倍,B200上峰值达6367倍实时。结论适用于单卡离线归档转写与在线语音助手转写,允许词错误率上升的可选开关能进一步提速,原文未披露训练成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 把“看” 与“听” 分开导演:Découpage 如何做长对白多镜头音视频生成

英文题目:Découpage: Directorial Audio-Visual Control for Long Multi-Shot Video Generation
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yifan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hao Ouyang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiuyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yihao Meng:机构信息未能在本次解析中与作者逐人可靠绑定
- Wen Wang:The Hong Kong University of Science and Technology Ant Group Zhejiang University
- Zeyue Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Yichong Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanlin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qingyan Bai:机构信息未能在本次解析中与作者逐人可靠绑定
- Zichen Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yujun Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Qifeng Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
该工作处理长对白场景里画面剪辑与声音时间错开的问题,输入是标明每段镜头起止、取景动作与可见人物,以及每段声音起止、台词或环境声与说话人的剧本式时间表,输出是与该时间表对齐的多镜头视频与声轨。难点在于对白常常跨过剪辑点延续,静音段必须保持安静,而离场说话声不应带动在场听话人的嘴部动作,传统联合生成容易把剪辑、语音与唇动绑在同一窗口内。先将剧本式时间表解析为共享同一时钟但边界独立的视觉轨与声学轨,输出人物标识一致的双轨时刻表并送入联合扩散骨干。再用两套时间交叉注意力分别约束视频查询与音频查询的文本可见范围,使对白跨过剪辑点延续,输出与双轨对齐的音视频特征并送入唇动控制。最后为同一视频查询同时计算原生音频与无语音辅助轨的音频到视频残差,并按是否排定语音且说话人不在场加权混合,以决定语音是否驱动画面。与直接联合生成相比,关键差异是剪辑时刻表与声音时刻表可独立寻址,并按可见性决定语音是否驱动画面。在200段15秒多人对白评测里,该方法剪辑F1为0.99,高于基线LTX-2.3 Base的0.26,对白包含率为93.01%且静音泄露为1.12%。结论适用于轮流对白,尚不支持多人同时重叠说话。训练开销是在32张NVIDIA H20上做LoRA微调,推理开销在单张NVIDIA H20上每去噪步约13.01秒,比关闭唇动控制多0.20秒且无需额外训练参数。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 把说什么和谁说的分开:Facto 因式分解语音分词器
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Benjamin Van Niekerk:机构信息未能在本次解析中与作者逐人可靠绑定
- Jean-Philippe Letendre:机构信息未能在本次解析中与作者逐人可靠绑定
- Nicol Visser:机构信息未能在本次解析中与作者逐人可靠绑定
- Hugo Seute:机构信息未能在本次解析中与作者逐人可靠绑定
- Herman Kamper:机构信息未能在本次解析中与作者逐人可靠绑定
- Mirco Ravanelli:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音分词器需要把波形变成紧凑离散单元,供语言模型生成语音,同时保留说话人音色与表达细节。直接把内容、韵律与音色混在一起编码会导致码本冗余,微小噪声也会改变切分结果,增加建模难度。本文提出的Facto把随时间变化的信息与静态信息分开处理,随时间变化部分指内容与韵律,静态部分指说话人身份与录制条件。输入WavLM第六层自监督特征后,先在对齐的多说话人特征上做低秩分解得到共享内容矩阵与说话人变换,再用最小二乘线性估计器把未见说话人映射到内容空间,随后对分块特征做主成分分析与k均值聚类形成单码本,最后由带说话人嵌入与调制层的HiFiGAN解码器重建波形。与需要信息瓶颈或对抗目标的解耦方案不同,该路线只用线性运算完成分解与泛化,并给出随训练说话人数增加的收敛分析。在LibriSpeech test-clean的噪声稳定性评测中,12.5 Hz下8192码本Facto平均单元编辑距离为20.23,低于Kanade的50.45。在Seed-TTS test-en的12.5 Hz文本到语音评测中,8192码本Facto词错率为2.7%,低于Kanade的4.5%与FocalCodec的3.6%。编码器分解与聚类可在中央处理器上于1小时内完成,解码器预训练与微调仍需多日多卡开销。该结论仅在WavLM第六层特征与英语朗读数据上验证,对其他自监督表示尚未验证,采用全局说话人嵌入难以刻画句内时变音色,短语音传输说话人嵌入还会明显抬高码率。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. ProTTS:从合成模型内部发现词重读并实现可控合成

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sai Harshitha Aluru:Speech Processing Lab, LTRC;IIIT Hyderabad;Hyderabad, India
- Chiranjeevi Yarra:Speech Processing Lab, LTRC;IIIT Hyderabad;Hyderabad, India
📌 核心摘要
自然语音需要把重读放在少数词上才能表达纠正、对比或惊讶等意图,读者需要理解的对象是输入文本中哪个词该重读,以及重读在语音中如何实现。困难在于重读标注稀缺,非母语差异大,而已有重读检测与重读可控合成各自独立,外部检测器给出的标签未必对应合成器真正可用的韵律差异。ProTTS 以 FastSpeech 2 为骨架,先由基础方差预测器输出音素级音高、能量和时长,再按词聚合为 521 维词级特征。聚类头在该特征空间中做二类软分配以发现重读词,得到的掩码控制三个重读方差预测器,只对重读词的音素施加韵律增量,非重读词保留原预测。全部模块用重建损失加聚类损失联合优化,每轮更新伪标签和方差目标,形成检测与合成互相促进的循环。与已有方法差异在于重读不是外部输入,而是在合成器内部无监督涌现,并可直接用于合成与用户指定控制。在 35 名听众参与的 LibriTTS 与 VCTK 自然度评测中,ProTTS 平均意见分达到 3.96,基线 FastSpeech 2 为 3.12,听众偏好率为 83.5%。在 ISLE 非母语集的重读检测中,ProTTS 的 F1 为德国口音 0.839 与意大利口音 0.861,超过无监督基线和多数有监督基线,意大利口音略低于 SupraDoRAL 与 WhiStress 的 0.87。结论适用于朗读式英语与短句重读,对话语境重读、渐变重读强度和声调语言母语者尚未验证。原文披露模型总量约 31.5M 参数,在单卡上训练 100k 步,推理时聚类为单次距离计算,开销可忽略。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. VoxMel 只让粗梅尔谱进入历史的自回归语音合成

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wenhao Guan:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaxin Ye:机构信息未能在本次解析中与作者逐人可靠绑定
- Haitao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifan Duan:机构信息未能在本次解析中与作者逐人可靠绑定
- Junxi Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wangjin Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Lin Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Qingyang Hong:机构信息未能在本次解析中与作者逐人可靠绑定
- Xie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
零样本语音合成根据文本和一小段参考语音生成新语音,要求内容读对且音色接近参考人,直接对完整梅尔语谱图逐帧建模时相邻帧高度相关,模型容易依赖声学历史而忽视文本,采样误差也会随反馈累积。VoxMel 把对数梅尔语谱图先沿频率轴做固定哈尔变换,得到频率平均分量和频率残差,再把频率平均分量沿时间轴做第二次变换,得到更短的粗梅尔序列和时间残差,变换可精确求逆。语言模型骨干只自回归生成粗梅尔序列,每步用流匹配头采样输出,两个非自回归层级依次补回时间残差和频率残差,残差不回送历史,最后逆变换加声码器得到波形。这种分工区别于学习型编解码隐变量和全带梅尔直接自回归的做法。在 Seed-TTS-eval test-en 上,GRPO 后模型的词错率为 1.15%,低于监督基线的 1.51%,说话人相似度为 0.753,高于基线的 0.738。在 test-zh 上字错率从 1.29% 降至 1.17%,相似度从 0.755 升至 0.776。结论限于中英短句单人朗读,长句、多人对话和歌唱等未经验证。推理开销集中在粗梅尔循环,每粗帧原来需要 96 次头评估,蒸馏后降至 4 次。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 当语音年龄判断用于儿童保护时会发生什么

英文题目:Three Invisible Failure Modes in Speech-Based Age Estimation for Child Safety
评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Christopher M. Stewart:University of Memphis
- Kelsey Kraus:San José State University
- J. Elliott Casal:University of Memphis
- Geoffrey L. Brown:University of Wisconsin–Madison
📌 核心摘要
儿童与对话式人工智能交互时常用语音而非文字,系统需要从语音判断是否为未成年人,难点在于儿童与成人语音差异微弱且部署链路可能引入无提示失真。论文先从美国英语儿童语音的Kids VA和MyST库中抽取儿童语音片段,再经客户端库传输送入三个可直接处理语音的音频大模型,最后对同一语音重复提问是否超过13岁、是否超过18岁及直接估计年龄,剔除拒绝和错误后以有效回答为分母统计超过13岁误分类率等指标,前一步的语音和传输载荷直接决定后一步模型的输入。为检验部署可靠性,作者进一步核查传输载荷解码、对比模型换代前后拒绝行为、比较阈值回答与数值估计的一致性,发现三类均无告警的隐性失效。在3至5年级课堂自发语音30秒条件上,Gemini的超过13岁误分类率为音频11.6%,低于同一语音逐字转写文本条件的51.7%,说明丢弃声学信息的流程风险更高。受损传输把Kids VA脚本语音的平均年龄估计值推高至36.8岁,高于真实平均年龄7.4岁,同一段7岁儿童录音的年龄估计值从损坏时的48岁降至修复后的7岁。三个模型在音频回答中把儿童判为超过13岁的误分类率分布在2.5%至42.5%之间,且每个给出回答的模型都曾把5至11岁儿童判为超过18岁。结论仅适用于13岁以下美国英语儿童语音误报的超过13岁误分类率测量,未验证对成人和青少年的区分能力,也未估计完整系统的端到端错误,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 不用注册语音,用唤醒词文字找到目标说话人并识别指令

评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuxiang Mei:机构信息未能在本次解析中与作者逐人可靠绑定
- Dongxing Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanhua Long:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
面向共享智能设备的语音交互需要解决一个具体对象:在混叠语音与家电噪声中,只转写说出唤醒词的那个人随后发出的命令,对其他人发出的命令给出拒绝。输入是包含唤醒词与命令的混合录音和已知的唤醒词文本,输出是目标说话人的命令文本或拒绝标记,难点在于没有注册语音可用,唤醒片段短且常被污染,难以做可靠的说话人比对。方法先用文本线索编码器把唤醒词变成上下文表示,再通过跨注意力注入预训练 Conformer 声编码器,使声学帧能够检索词汇线索并累积对应说话人信息。声学表示经投影降采样后送入 Qwen2.5-0.5B 解码器,按统一提示生成包含唤醒词复现、命令或拒绝标记的序列。训练用说话人标签控制唤醒与命令是否同人,并配合在线混叠与噪声增强和四阶段课程学习。与已有注册式、锚定式和级联式做法不同,该框架不要求注册音频、唤醒音频边界、独立验证模块和人工阈值。在 midea-test 真实家居集上,本文模型命令字错率为 16.15%,非目标拒绝率为 91.56%,统一分数为 87.70%,高于最强免注册基线的 71.70%。结论适用于最多 2 人同时说话、含重叠与家电噪声的唤醒加命令结构,对更长上下文、更多说话人和新设备域尚未验证。训练硬件为 4 张 NVIDIA A100 40GB,训练时长与推理时延未说明。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 只用识别数据训练,为什么问答能力会消失:从分布中学习

英文题目:Learning from Distribution: Rethinking One-Hot Supervision for ASR and QA in Speech Language Models
评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yujie Guo:College of Computer Science, Nankai University
- Hongjie Chen:Xingchen AGI Lab, China Telecom Artificial Intelligence Technology Co. Ltd
- Jiaming Zhou:College of Computer Science, Nankai University
- Jian Kang:Xingchen AGI Lab, China Telecom Artificial Intelligence Technology Co. Ltd
- Jie Li:Xingchen AGI Lab, China Telecom Artificial Intelligence Technology Co. Ltd
- Yongxiang Li:Xingchen AGI Lab, China Telecom Artificial Intelligence Technology Co. Ltd
- Yong Qin:College of Computer Science, Nankai University
📌 核心摘要
语音语言模型需要同时完成两类语音条件生成:一是把语音转写为文字,二是依据语音内容回答问题。前者输入与输出接近一一对应,后者允许多个合理回答,但常用训练都只用单条参考答案做独热监督,容易把语音与文本的对齐推向只会转写。本文提出从分布学习(Learning from Distribution,LFD),先让冻结文本教师模型在相同回答轨迹上逐词提取并输出条件词表概率分布,再将该分布送入语音学生模型的训练目标,用前向KL散度对齐其词表概率,最后对教师分布做尾部感知的截断,仅保留高概率词并合并剩余尾部质量以支持离线存储训练。与只学单条转写不同,该方法保留教师更广泛的生成行为,思维链转写则以中间推理拓宽生成空间,全参数微调与不同数据量对比显示类似趋势。在8000小时Emilia训练、LibriSpeech与TELEVAL评测下,仅用自动语音识别数据时从分布学习相对独热交叉熵基线将LibriSpeech总体词错误率从6.89%降到6.57%,同时将TELEVAL总体回答准确率从2.44%提高到40.20%。该结论目前只在Whisper-large-v3编码器加Qwen3-4B的单架构、英文转写与问答评测及适配器对齐与全参数微调下得到验证。即使把自动语音识别训练增至8000小时,独热监督仍不能恢复问答能力,脱离该架构与英文条件的表现可能失败。其他模型族与规模、非英文及其他语音语言任务仍需检验,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 同一句“女声” 能变出多少种声音:指令语音合成的说话人多样性审计

英文题目:Beyond Controllability: Speaker Diversity in Instruction-Guided Text-to-Speech
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yi-Cheng Lin:National Taiwan University
- Jia-Kai Dong:National Taiwan University
- Kuan-Yu Chen:National Taiwan University
- Szu-Chi Chen:National Taiwan University
- Jian-Jiun Ding:National Taiwan University
- Sung-Feng Huang:NVIDIA
- Yusuke Hirota:NVIDIA
- Hung-yi Lee:National Taiwan University;Artificial Intelligence Center of Research Excellence, National Taiwan University
📌 核心摘要
指令引导的文本到语音以自然语言描述为输入生成可听语音,描述仅限定性别、年龄、口音或情绪等粗粒度属性,剩余声学细节需模型补足,同一描述重复请求时应产生多个不同说话人。本文先验证说话人编码器随真实说话人数增加能否拉开分值并剔除三个压缩编码器,再用八个保留编码器提取七个系统与真实录音的嵌入并计算Vendi分值,最后把条件生成语音送入属性分类器以per-class recall衡量可控性,区别于以往只验跟随是否正确。整体比较以Emilia英语语料30000句配对真实录音,在八个编码器上以Vendi分值为多样性指标,真实参考约为68.3,所有系统在默认与最优采样下均低于该水平。属性比较共用3000句文本以固定语言内容,Qwen3-TTS的女性条件Vendi分值为16.6,仅为男性条件28.1的59%,但两性per-class recall均超过0.88,说明正确跟随不等于声音丰富。口音与情绪的条件Vendi分值随请求变化很小,但北美英语在全部系统中per-class recall不低于0.744,多数系统把表情化语音判为中性,表明两者暴露不同偏向。在口音分类器的说话人无关保留测试集上,集成模型的macro-F1为0.876,高于随机猜测水平的0.167,德国口音F1仍达0.887,排除分类器灵敏度不均的解释。结论只适用于所测七个开源系统与英语下性别、年龄、六类口音及四类情绪,未验证其他语言与开放描述,调优采样仍不能弥合与真实语音的差距。推理评估在NVIDIA B200上耗费约901 GPU小时,其中生成约842小时,编码器提特征约59小时。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 让克隆的声音按文本要求去表达:三段式后训练怎么做

英文题目:Rethinking Post-Training for Expressive Zero-Shot Text-to-Speech
评分:6.7/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jingbin Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinfa Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenjie Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Kangxiang Xia:机构信息未能在本次解析中与作者逐人可靠绑定
- Hangrui Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kexin Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jin Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Liumeng Xue:机构信息未能在本次解析中与作者逐人可靠绑定
- Lei Xie:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
零样本语音克隆以目标文本和一段参考音频为输入,生成保留说话人音色的语音,难点是参考韵律平淡或与文本情绪不匹配时直接模仿会导致语气不当。本文把任务定义为保留音色但让韵律服从文本的文本自适应韵律合成,不同于忠实模仿参考风格,并用三阶段后训练改造Qwen3-TTS。先由自动化偏好数据管线生成偏好对,教师模型按目标文本生成优选候选而学生模型多采样生成对照,经转写过滤偏好校验与声纹转换扩充后,输出数据集送入直接偏好优化冷启动以提高同条件下优选语音的相对概率。再把阶段一检查点送入组序列策略优化,对每组上下文采样候选并计算韵律音质可懂度和相似度复合奖励,用组内归一化优势更新,输出阶段二检查点。最后把阶段二检查点送入上下文条件同策略自蒸馏,让弱参考下学生分布向强参考下教师分布靠拢并用全词表JSD匹配,从而降低对参考表现力的依赖。在Seed-TTS-Eval英文集上,最终模型的WER为1.55,高于Qwen3-TTS基线的1.23。该结论在已见与未见说话人上均有表达力增益,但伴随说话人相似度下降,弱参考鲁棒性仅在有限参考条件下验证,更多条件尚未系统验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 喉镜前只听声音能做什么:听觉大模型辅助医生预分类的配对读片研究

评分:6.7/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Siyuan Hou:Department of Electronic Engineering, Tsinghua University, Beijing, 100084, China
- Shuting Yang:Department of Otorhinolaryngology Head and Neck Surgery, Beijing Tongren Hospital, Capital Medical University, Beijing, 100730, China
- Zengrui Jin:Department of Electronic Engineering, Tsinghua University, Beijing, 100084, China
- Liyu Cheng:Department of Otorhinolaryngology Head and Neck Surgery, Beijing Tongren Hospital, Capital Medical University, Beijing, 100730, China
- Siyin Wang:Department of Electronic Engineering, Tsinghua University, Beijing, 100084, China
- Yunhan Shi:Department of Otorhinolaryngology Head and Neck Surgery, Beijing Tongren Hospital, Capital Medical University, Beijing, 100730, China
- Xueyan Li:Department of Otorhinolaryngology Head and Neck Surgery, Beijing Tongren Hospital, Capital Medical University, Beijing, 100730, China
- Rong Hu:Department of Otorhinolaryngology Head and Neck Surgery, Beijing Tongren Hospital, Capital Medical University, Beijing, 100730, China
- Yuhong Lin:Department of Otorhinolaryngology Head and Neck Surgery, Beijing Tongren Hospital, Capital Medical University, Beijing, 100730, China
- Qiyu Chen:Department of Otorhinolaryngology Head and Neck Surgery, Beijing Tongren Hospital, Capital Medical University, Beijing, 100730, China
- Yanru Li:Department of Otorhinolaryngology Head and Neck Surgery, Beijing Tongren Hospital, Capital Medical University, Beijing, 100730, China
- Ji Wu:Department of Electronic Engineering, Tsinghua University, Beijing, 100084, China
- Bowen Zhou:Department of Electronic Engineering, Tsinghua University, Beijing, 100084, China;Shanghai Artificial Intelligence Laboratory, Shanghai, 200030, China
- Mangsuo Zhao:Yuquan Hospital, School of Clinical Medicine, Tsinghua Medicine, Tsinghua University, Beijing, 100040, China
- Wen Xu:Department of Otorhinolaryngology Head and Neck Surgery, Beijing Tongren Hospital, Capital Medical University, Beijing, 100730, China
- Chao Zhang:Department of Electronic Engineering, Tsinghua University, Beijing, 100084, China;Shanghai Artificial Intelligence Laboratory, Shanghai, 200030, China;Department of Human Communication Sciences, University College London, London, WC1E 6BT, United Kingdom
📌 核心摘要
持续性声音嘶哑在喉镜检查前需依据声音形成可能病因的初步判断并识别疑似癌前或恶性病变,声音特征重叠使仅凭听觉的七分类判断难度较大。本文输入是喉镜检查前常规嗓音评估已可获得的持续元音与朗读录音、患者信息和声学测量,输出是患者级评估卡上的暂定分类、嗓音质量评分与文字依据,以及单独计算的恶性风险提示。模型先把同一患者的不同录音及其拼接组合分别判读为分类、嗓音质量评分与文字依据,再把各次判读输出送入投票汇总为患者级暂定分类与均值评分,最后在评估卡上展示各类别得票数与判读间一致比例,恶性提示按另行阈值单独计算而不显示。32名耳鼻喉科临床医生先独立给出七分类,1至2周后对照评估卡复核原结论。在195例留存测试集上产生的800人次配对判读中,复核后分类准确率从49.8%升至56.8%,差值为7.0个百分点。该增益限于单中心普通话队列、七类判读与耳鼻喉科医生读者条件,模型错误时复核准确率更低且43人次由对改错,恶性提示在留存测试中仍漏检5例。顺序复核设计不能排除重测效应,恶性提示仅经独立验证而未与医生联合测试,对外院、非筛选性嘶哑人群与非专科医生的适用性未知,多判读推理仅在服务端图形处理器离线运行而临床延迟与资源需求尚未确定,需随机多中心研究进一步验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 把字符画成图像做关键词检测:PIXEL-KWS 如何应对拼写花招

评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Adarsh Arigala:机构信息未能在本次解析中与作者逐人可靠绑定
- Ramesh Gundluru:机构信息未能在本次解析中与作者逐人可靠绑定
- Srinivasan Umesh:机构信息未能在本次解析中与作者逐人可靠绑定
- Ludovick Lepauloux:机构信息未能在本次解析中与作者逐人可靠绑定
- Hakim Hacid:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
开放词汇关键词检测要求系统根据用户临时给出的文本判断语音中是否出现该词,实际注册文本常混入训练词表之外的符号,例如跨语种形近字、字母数字替换和带重音字符,固定符号查表的文本编码难以表示这些输入。先把注册词每个字符渲染为16×16灰度字形图像,空格用空白图像加序列掩码保留词边界并缓存避免重复渲染,取代字符嵌入查表。再用三层轻量卷积提取字形视觉特征并投影为64维字符表示,输出的字符表示序列送入双向循环编码建模上下文,经注意力加权池化并投影到64维共享匹配空间得到关键词向量。最后音频侧把对数梅尔谱经卷积下采样送入结合卷积与自注意力的序列编码器Conformer编码帧级表示,经注意力池化后映射到同一空间与关键词向量以内积计分,训练以双向对比目标拉近配对嵌入,并辅以音素预测与配对判别损失。与固定词表方法不同,该框架从字形视觉形态泛化到未见符号,同时保留每个关键词一次编码的注册代价。在LibriPhrase困难子集LPH上,中等规模PIXEL-KWS的等错误率EER为9.57%,对应受控字符基线Char-KWS-M为9.55%,均低于已发表基线中最优的PLCL@T的9.96%。容易子集LPE上分别为0.41%和0.43%,低于已发表基线中最优的MM-KWS@T的0.82%,显示无预训练和合成数据仍具竞争力。上述结论仅在英语LibriPhrase与设定的字符扰动范围内验证,多语言泛化尚未检验,中等规模文本与音频侧合计约11.4M参数,论文未披露完整训练时长。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 从声音猜发音动作靠谱吗:用实时磁共振检验声学到发音反演

评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tharinda Piyadasa:机构信息未能在本次解析中与作者逐人可靠绑定
- Michael Proctor:机构信息未能在本次解析中与作者逐人可靠绑定
- Amelia Gully:机构信息未能在本次解析中与作者逐人可靠绑定
- Tuende Szalay:机构信息未能在本次解析中与作者逐人可靠绑定
- Emily Kiff:机构信息未能在本次解析中与作者逐人可靠绑定
- Kirrie Ballard:机构信息未能在本次解析中与作者逐人可靠绑定
- Craig Jin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
要判断的是说话时唇舌软腭收紧程度和位置随时间变化的轨迹能否从语音准确推测,难点是相似语音可来自不同声道形状,仅合成像不足以证明推测即真实动作。先从同一段实时核磁共振录像的成像轮廓直接量出八维声道变量轨迹作为成像轨迹,这种紧凑可解释的关节表示在文中称为声道变量(tract variables, TVs)。再用冻结大规模语音编码器的反演模型加权融合各层表示,经投影和双向长短时记忆网络从语音预测同一八维轨迹,对照几何相关与动态范围压缩。最后把两套轨迹分别送入同一个Transformer编码器加卷积后网络的合成器并固定音源与说话人条件,预测梅尔谱再经声码器成波,以隔离轨迹来源造成的声音差别。在同一批留出说话人的成像语句上,用反演轨迹驱动同一合成器的词错误率WER为35.8%,低于用成像轨迹驱动同一合成器的词错误率WER的39.6%。在留出说话人上反演轨迹与成像轨迹的平均皮尔逊相关为0.643。在同一批留出语句按发音方式分组后,擦音塞擦音的谱差距为2.47 dB,高于近音的谱差距的0.40 dB,说明大致动作可用而精细收紧几何不可靠。相对只做重建或伪标签的已有工作,本文增加独立成像对照和匹配合成探测并按发音方式细分后果,结论只适用于所用成像语料和固定音源的匹配比较,儿童或病理发音等尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 不知道训练用了什么问题,还能判断音频是否被训练过吗

英文题目:AudioTrace: File-Level Membership Detection for Audio Large Language Models
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Guangzhi Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiao Zhan:机构信息未能在本次解析中与作者逐人可靠绑定
- Shuai Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jose Such:机构信息未能在本次解析中与作者逐人可靠绑定
- Phil Woodland:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
该研究处理音频文件级成员判断,输入是一段候选录音与目标音频大模型的问答接口,输出是该录音是否出现在监督微调集合的判定分数。难点是训练时的文字指令与参考答案对审计者不可见,录音常含连续重叠声学事件,时间结构本身难以指示成员身份。AudioTrace先让待审计的目标模型根据录音内容生成30个代理问题,再加1个转写查询与1个字幕查询,共32个问题。然后用同一模型回答这些问题并记录每个回答标记的词概率分布,对每个回答计算低概率标记平均负对数似然与熵类不确定性分数,最后取分数最高的2个问题平均得到文件级分数。与直接在音频对应位置计算困惑度或逆序音频块比较熵变的方法不同,该方法把证据放在模型对相关提问的回答不确定性上,并用目标模型自身偏好逼近未知训练分布。在包含640条成员与645条非成员的AudioTraceBench上,已知训练问答的特权对照合并分数AUROC在Qwen2.5-Omni上为0.8152,高于生成代理问题的0.5515,在SALMONN-2上为0.8234,高于0.5902,表明未知标注带来大幅下降。该结论只适用于受控监督微调与3轮低秩适配条件,0 dB加噪使代理信号接近随机,单模型3轮微调在单张NVIDIA A100上约需20小时,生成并评估多组代理问题约需直接音频级方法5倍的推理计算量。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 三模态对齐为何学不会三元组:诱饵与残差如何补上成对模型漏掉的信息

英文题目:Learning What Pairs Miss for Higher-Order Multimodal Alignment
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kunyu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shenghui Feng:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiangjie Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeqing Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingxu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
三模态对比学习要根据两路输入在候选库中找回第三路,难点在于随机负样本一般同时破坏两对成对关系,单个成对检查就能排除,只有极少数样本真正需要三路联合判断,联合项分到的梯度很小。本文方法CHORD先用成对相似度加权求和建立校准桥,提取目标在记忆库上的条件分布作为成对可信度输出,再从该分布抽取诱饵作为负样本送入残差训练,最后训练零初始化的加权逐元乘积残差只区分正样本与诱饵。校准桥直接用于一路对一路检索,两路对一路检索把桥分与残差分相加,诱饵抽取代价为一次记忆库内积查询,检索保持单次内积量级。与更换打分形式的已有高阶目标不同,该方法保留乘积打分,只改变负样本来源,并把损失解释为以桥为噪声分布的排序噪声对比估计。在M3-Mix中需要三元组判断的测试样本上,本文方法Top-1准确率为89.6%,高于最强基线H-CLIP的68.4%。该结论适用于残差能见到完整三元组而桥只需成对观测的设置,完整三元组稀少时三路增益会收缩。在四模态奇偶任务中三元组残差在需要四路联合时仍接近随机猜测,需另加四路乘积项才能恢复,故四路及以上联合超出当前三路残差的验证范围。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. 让调查员学会派活、让检查员学会看活:WeVisForensics 如何查 AI 视频

英文题目:WeVisForensics: Self-Evolving Agent for Omni AI-Generated Video Detection
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yipeng Du:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Ying Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Chong Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Chen Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jing Lyu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ying Tai:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
待判断对象是一段可能由生成模型合成的视频,输出是真或假的判定以及指向具体时空位置的证据链。难点在于伪影可能只出现在短暂区间或小区域,单次通读容易漏检,固定流程会让无关检查淹没关键证据。系统先由负责规划的主体浏览约 1 帧每秒的全局概览,形成假设并选定要检查的分工与时间窗。被选中的检查器只在指定范围内按自身分工输出带置信度的结构化报告,报告返回后追加到历史,主智能体据此决定继续检查或终止并给出结论。训练采用快慢两种节奏协同进化,主智能体每批都用结果奖励与调用级反馈更新,检查器则在多批中积累与标注区间重合的调用,再用特权教师蒸馏与规则卡修订来改进。相对单次推理与冻结专家方案,差异在于检查范围可变且提供检查的模型本身也会从被调用的样本中学习。为训练与评测配套构建了按角色分解标注的数据与按伪影类别分组的基准。在包含域内、域外与智能体基准的平均准确率上达到 95.2%,超过此前最强检测器 9.0 个百分点。结论适用于所覆盖的生成器与伪影类型,对未见生成方式仍需验证。原文提到完整联合训练约需一天,未说明具体硬件型号与数量,也未披露推理延迟与部署开销。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 电话议价中语音代理的延迟、金额听写与插话处理比较
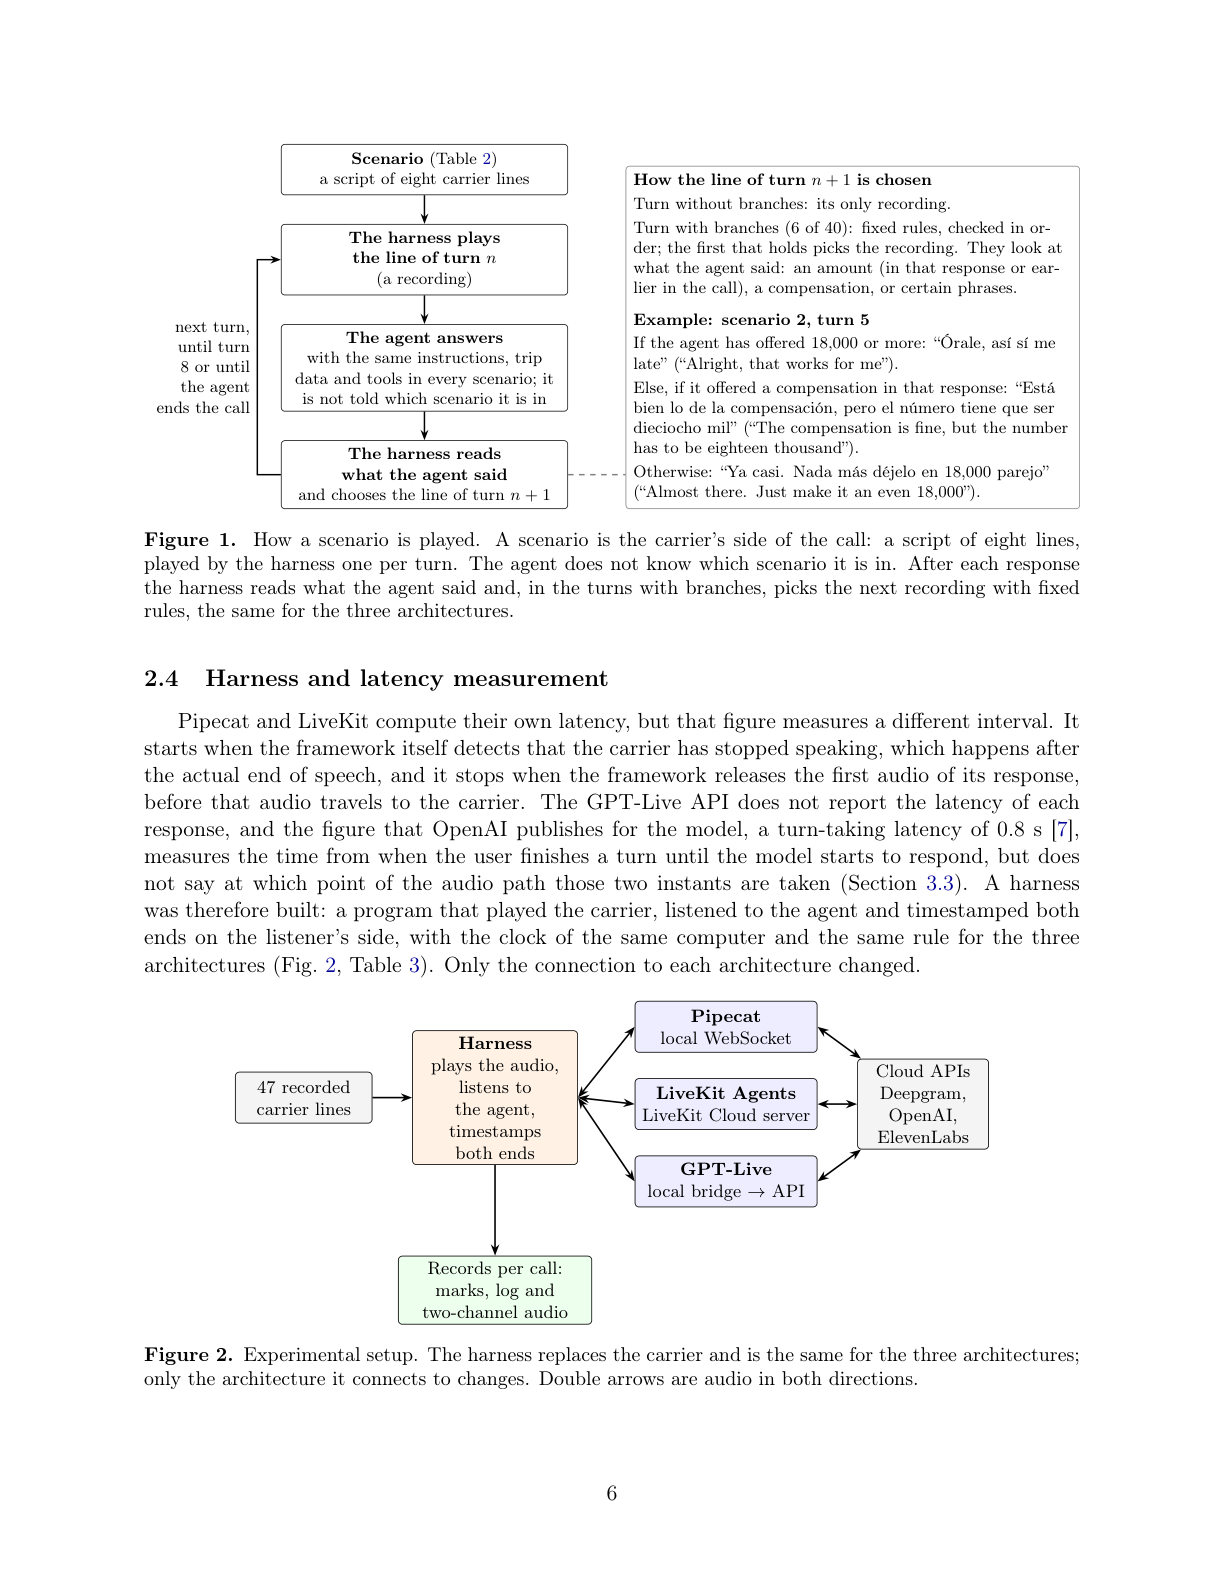
图片来源:原论文 PDF 第 6 页(含图 2)。完整图注与解读见独立文章。
评分:6.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Jovan Popoca Moran:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico
- Eduardo de Avila-Armenta:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico;Tecnológico de Monterrey, School of Engineering and Sciences, Monterrey, N.L., Mexico
- Raúl Alejandro Aquino-Ibarra:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico
- Jorge Octavio Nicolás-Díaz:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico
- Umberto Leon-Dominguez:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico
📌 核心摘要
这项研究处理西班牙语电话货运议价场景下的语音代理,输入是载运方连续说话音频,输出是包含报价验证与协议登记的实时语音答复,难点在于通话间隙短、插话与附和频繁且金额误听直接造成损失。级联通路先由语音识别提取载运方话音转写文本,再把转写输出送入语言模型生成含工具调用的答复文本,最后由语音合成输出语音答复,Pipecat与LiveKit Agents分别编排同一套识别、语言模型与合成提供方,GPT-Live则内部直接听说作答并把工具调用交给同一语言模型。研究用同一套47段单人录音播放载运方话音,在五种议价场景下每架构拨打77通电话,同一计时装置在听者一侧标记话音结束与有效答复开始,并用已知延迟的模拟代理校验各条音频通路。在上述相同录音与通话条件下,听者一侧内容答复等待时间中位数GPT-Live为2444.8 ms,Pipecat为2616.0 ms,两者差值171.2 ms的95%置信区间包含零,无法区分快慢。在相同47段录音、每架构77通电话的条件下,GPT-Live的WER为1.47%,低于Pipecat的6.03%,方向越低越好。结论只适用于单人录音、未经过电话网、默认配置的比较,真实噪声、多说话人与英文切换尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 冻结扩散生成器的谱转向:为改动与保持请求校正方向

英文题目:Spectral Steering: Local Inverse Geometry for Frozen Diffusion Generators
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Angelo Moroncelli:University of Applied Sciences and Arts of Southern Switzerland (SUPSI), IDSIA;Università della Svizzera italiana (USI)
- Alessandro Leanza:University of Applied Sciences and Arts of Southern Switzerland (SUPSI), IDSIA;Università della Svizzera italiana (USI)
- Loris Roveda:University of Applied Sciences and Arts of Southern Switzerland (SUPSI), IDSIA;Politecnico di Milano
📌 核心摘要
冻结扩散生成器需在不重新训练时改变部分输出属性并保持其余属性,难点在于经过剩余采样链后不同属性对干预的敏感度不同,一阶梯度会按敏感度加权请求并扭曲相对方向。本文把干预时刻中间状态到下游属性的映射记为目标相关的剩余采样器雅可比,分析请求在该矩阵奇异向量上的分量如何被放大或压缩,并用阻尼最小二乘求局部逆以补偿增益不均。方法先用该雅可比计算余弦增益预测,输出方向改善估计并送入校正环节以判断逆校正相对一阶拉回的收益,再执行固定时间重线性化,在同一扩散时刻重算雅可比与相对原始目标的残差并更新干预状态。跨视觉音频与机器人多实例的局部线性区间内,预测增益与实测增益呈强正相关,明显高于对数条件数的弱负相关,支撑请求与几何相互作用的解释。在随机掩码修复图像的独立轨迹集上,本文方法四次校正的SNR为12.30 dB,高于Adam的9.05 dB,在相同总导数遍历数下相差3.25 dB。与已有引导相比,关键差异在于按请求分量校正模态增益而非仅依赖条件数或统一引导强度,这意味着对敏感度不均的请求能保持相对方向并兼顾保持属性。结论适用于局部模型有效的结构化编辑,超出线性区间、目标覆盖不全或执行环节衰减时收益下降;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. 话说得好听,脸和声音却在摇头:大模型融合为什么只听文字

英文题目:Words Speak Louder? Exploring the Language Shortcut of LLM-Driven Incomplete Multimodal Learning
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wenhao Li:Shandong University Shenzhen Loop Area Institute
- Chong Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaokun Bai:机构信息未能在本次解析中与作者逐人可靠绑定
- Rundong He:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhuang Qi:The Hong Kong Polytechnic University National University of Singapore
- Xusheng Liang:Shandong University Shenzhen Loop Area Institute;City University of Hong Kong
- Zhibin Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiangchang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
该任务输入一段视频切片的文字、声音和画面特征,输出说话人情感为正或负,难点在于三者含义冲突时模型仍跟随文字而忽视非文字证据。先把各模态特征分别放进语言模型固定位置的token块,缺失模态用可学习占位符代替,再把说明可用情况的提示词与这些token块拼接,送入解码器输出融合情感分数。再让同一模型并行读取完整输入、单个模态和无内容视图,输出各自预测,用文字视图与声音或画面视图的预测分歧定位冲突样本。最后训练时让完整视图与单模态视图一起前向,单模态视图接受各自单模态标签监督,把上一步得到的视图分歧送入门控,当文字判断与非文字判断分歧超过阈值时阻断融合路径的任务梯度,只保留单模态监督。测试时准确模式直接输出完整视图预测,稳健模式允许分歧视图改写结果。与同结构语言模型融合基线相比,在CH-SIMS七种缺失模式平均下二分类准确率从73.8%提高到77.2%,平均相关系数从0.496提高到0.530。结论适用于文字占主导的情感语料,对抗文字捷径时文字误导片段错误率仍为38.3%,单训练轮次耗时约为基线的5.7倍,准确模式单片段推理约4.0毫秒。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 先取证再作答:Think2Listen 如何学会追问音频线索

英文题目:Think2Listen: Evidence-Centric Learning For Agentic Audio Understanding With LALMS
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Liang Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Kaiwen Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiliu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxuan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zengxin Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Gan Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingtong Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yufei Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Kun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
待理解的对象是一段录音搭配任务说明与多个候选答案,系统要输出唯一选项,困难在于能听见声景不等于知道哪条声学线索可以区分候选,模型容易依据文本猜测或被误导性反馈带偏。先由负责重听录音的音频模型生成初始时间线描述,该描述与任务说明、候选答案一同送入承担追问与决策的行动者,行动者结合已有问答历史与剩余查询预算输出追问或作答动作。再由行动者把针对性追问送入音频模型,音频模型重听录音后返回针对性文字观察,该观察被送回行动者用来修订候选判断并决定是否继续查询。最后由承担状态重建的语义提取器在训练时根据行动者可见信息还原追问前后合理的候选集合变化,并把含正确答案却收缩为错误单例的误导性转移转为校准奖励以修正最终对错信号。与直接作答或通用追问相比,该设计学会问什么、如何用证据与何时停止,使查询瞄准可区分候选的声学线索而非泛泛描述。在MMAR多步推理评测中,以总体准确率为指标,Think2Listen达到69.25%,高于最强端到端基线Gemini 2.5 Flash的67.07%,方向为越高越好。结论适用于语音、声音、音乐及其混合的选择题推理,残余失败与重建误差表明误导性观察仍会保留,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 一个笑声标记不够时,能否用咳嗽学会笑
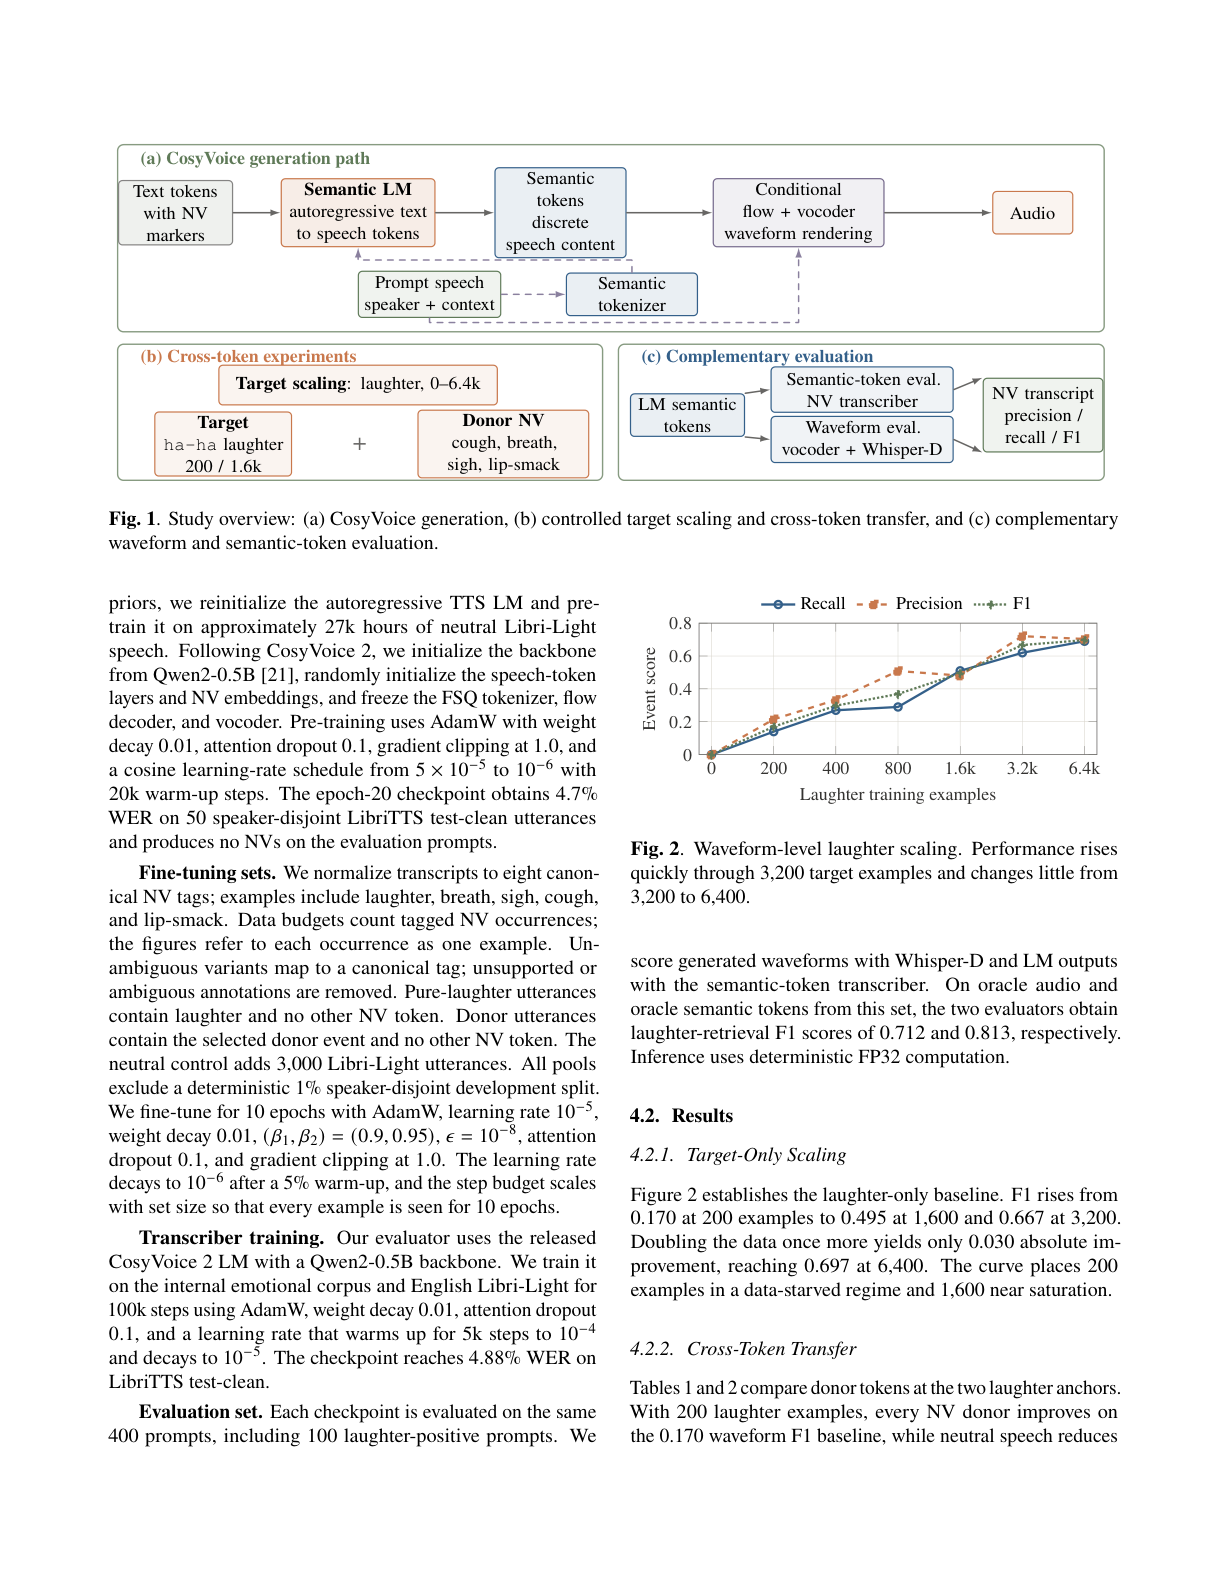
图片来源:原论文 PDF 第 3 页(含图 1)。完整图注与解读见独立文章。
英文题目:A Systematic Study of Cross-Token Transfer for Data-Efficient Non-Verbal Text-to-Speech
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jing Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- Haibin Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Minxue Niu:机构信息未能在本次解析中与作者逐人可靠绑定
- Florian Metze:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuzong Liu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
非言语发声指笑声、呼吸、叹息、咳嗽这类词外声音,携带情感与会话意图,常规转写常漏标导致可训数据稀少。本文以笑声为目标事件,研究供体事件样本能否帮助稀缺目标事件的语音合成。输入是带显式非言语标记的文本与提供音色语境的提示语音,输出是应在指定位置包含目标事件的语音波形,难点在于目标样本极少时模型易漏生成或误生成。方法固定CosyVoice 2结构,先只更新由文本预测语音内容离散单元的语义语言模型,使其读入文本标记与提示表征后自回归预测并输出离散语义token,再将其送入冻结的流解码器与声码器渲染波形,最后同时用波形识别器与直接读取语义token的转写器对齐事件计算精确率、召回率与F1。在200个笑声样本的低资源条件下,增加约3,200个咳嗽样本使波形端笑声F1从0.170升至0.529,超过仅用1,600个笑声样本的0.495。两条评估路径趋势一致,增益定位在语义token生成阶段并在声学后端保留,与已有工作差异在于保持结构与优化流程不变,只改变目标与供体数据配比,因而差异可归因于数据组成。该结论仅在以笑声为目标、CosyVoice 2单基座、事件检索评价下成立,未做听感质量评价与听测验证,其他目标事件与其他基座尚未验证。若供体换成中性语音则波形端F1降至0.032而失效,咳嗽供体较少时增益也不稳定,微调在8张H100上完成,原文未给出耗时与推理开销。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 在多文件工作空间里做完研究报告:Omni-Workspace 在考什么

英文题目:Omni-Workspace: Benchmarking Omni-Modal AI Assistants on Multimodal Workspace Tasks
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yuhao Wang:Shanghai Jiao Tong University
- Yucheng Zhao:Tongyi Lab, Alibaba Group
- Yiran Zhong:Tongyi Lab, Alibaba Group
- Feida Zhu:Tongyi Lab, Alibaba Group
- Hongcheng Liu:Shanghai Jiao Tong University
- Qichao Wang:Nanyang Technological University
- Ming Ma:University of Chinese Academy of SciencesCorresponding author
- Yu Wang:Shanghai Jiao Tong University
📌 核心摘要
读者需要理解的对象是装有多类文件的工作区,任务要求智能体自主发现音视频图像文档并整合成指定产物。困难在于信息分散在多个文件和模态中,线索相互依赖,智能体要在多轮交互中决定查看什么文件和调用什么工具。基准把每项任务形式化为目标、工作区、可用工具和隐藏评分规则,执行结束时收集目标文件打分。先由智能体在工具返回图像音频视频后生成记录来源与任务关联的文字要点并输出给执行框架,再由多模态工作记忆管理把已查看原始媒体替换为占位符并把该文字要点送入后续推理上下文以控制上下文长度,源文件仍保留在工作区以备复查,最后由显式任务状态维护接收该要点与执行结果去更新按用户要求拆分清单的完成条件、已得证据与剩余缺口,并把最新清单送入每轮输入以引导下一步文件选择与检索,与以往直接给齐输入的理解类评测不同。在380项任务上使用Gemini 3 Flash Preview且每任务至多50次模型请求的对照中,允许持续读写工作区设置的任务评分指标Score为55.62分,高于移除文件访问后仅首轮给齐输入设置的33.43分。该结论仅适用于每任务五至十二个初始文件的深度研究型合成产物任务,尚未验证含数百上千噪声文件的更大工作区,以及视频剪辑、多媒体内容创作与游戏开发等非信息合成型流程。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. 把语音先验放进波束形成:PnP-MVDR 如何工作与何时有效

评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chengbo Chang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziye Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要处理的是8通道麦克风阵列收到的双说话人混合语音,难点是非平稳噪声与方向误差会破坏传统空间滤波的能量假设,而纯神经网络又缺少可解释的空间约束。输入是8通道时域混合语音,经短时傅里叶变换得到时频谱,输出是对目标说话人时频的估计,再经逆变换恢复波形。常规最小方差无失真响应(minimum variance distortionless response, MVDR)在保持目标方向增益的条件下最小化输出能量求解权重,但没有利用语音本身的结构特性。本文把期望语音写成波束形成输出减去噪声干扰项,并在目标函数中加入基于去噪的正则项(regularization by denoising, RED),用现成去噪网络输出残差的内积约束解偏向自然语音。求解采用交替迭代,先更新空间权重得到中间估计,再将其送入参数冻结的去噪器做不动点提纯,最后更新对偶变量与噪声项,形成相互修正的循环。数字信号处理模块负责协方差估计与加权,神经网络加速模块负责语音先验提取,以适配端侧部署。在仿真8元线阵、WSJ0混合、白噪声0 dB条件下,接入频率循环卷积循环网络(frequency recurrent convolutional recurrent network, FRCRN)的版本感知语音质量评估(perceptual evaluation of speech quality, PESQ)为1.72,高于同条件MVDR的1.09,方向为越高越好。该结论只在方向向量已知或估计准确、仿真混响时间0 s、声源距离0.5至3米及白噪声等已测噪声在0 dB至20 dB条件下成立,若方向偏离、先用去噪器破坏相位再做波束形成或去掉噪声干扰项,分离性能会明显下降。实采仅覆盖咖啡馆、工厂和街道,高混响与大角度误差尚未验证;去噪器约需每秒4 G乘加操作,与所称5 GOPS至50 GOPS的音频平台能力相当,但未给出实测延迟与功耗。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 普通话语音到美国手语 gloss 的同步级联:何时可以提交下一个 gloss

英文题目:CausalGloss: Multi-Evidence Action Control for a Simultaneous Mandarin Speech-to-ASL Gloss Cascade
评分:6.3/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mingze Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Satoshi Nakamura:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
同时把汉语语音转成美国手语注释要求在话语未结束时逐个决定每个注释能否写出,英语与注释词序错位、否定词后置、重复词易错位以及训练见完整答案而推理只见已写内容构成主要难点。级联先把流动汉语转成增量英语并送入英语前缀动作策略,再由多证据门控为每个注释寻找最早可支持的已见前缀并决定等待写出或结束,最后以补写监督纠正偏离训练状态的落后。词形匹配输出词汇锚点,冻结生成器对各前缀打分输出语义充分性,延迟上限与否定约束防止过早写出,同一前缀允许连续写出多个注释,这与固定等待按固定位置推进形成关键差异,意味着写出时机随证据变化而非固定步调。在冻结弱参考的How2Sign衍生500例锁定评测上,本文方法Token F1为0.7047,低于学习型自适应基线k=5的0.7067,该指标统计预测与参考注释词元多集合重合,LAAL为1.7823个源词元,低于该基线的3.9061个源词元。在ChineseSpeech-ASLGloss-v1合成汉语语音级联锁定评测上,本文方法Token F1为0.3946,高于词汇控制器的0.3941,但输出偏长且计算感知延迟收益较小。该结论仅在冻结弱参考基准与人工注释外部测试范围内成立,合成语音目标同样来自冻结生成器,专家验证与长度控制尚未完成。计算感知延迟计入串行推理时间并报告端到端实时率,训练与推理均在双卡环境下完成。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 不等慢模态的推理:AdaModalX 如何按需触发多模态基础模型

评分:6.3/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Xiangrui Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Sicong Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiwen Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zimu Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Bin Guo:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
分布式移动感知要求多台设备各自采集音频或视觉等单模态数据流,经过无线传输汇总到边缘侧,再由多模态基础模型 MFM 给出事件或行为类别。困难在于各模态数据量差异大且带宽波动,到达边缘的时刻并不一致。等待最慢模态会增加端到端延迟,直接用不完整输入推理又会因跨模态信息不足而降低精度。原文用音频视觉事件检测举例,完整视觉下精度为 83.40 %,只用部分视觉时延迟从 0.486 s 降至 0.149 s,但精度跌至 58.59 %,而 Mandolin 等类别仅用音频仍可保持精度并把延迟从 0.454 s 降至 0.143 s。AdaModalX 引入与模型结构解耦的运行时编排,设备端用蒸馏自边缘模型得到的轻量探针估计语义相似度,并按联合置信规则决定本地退出或继续上传。边缘端把已收齐模态组成候选,用复用冻结编码器的轻量评估器估计其效用,效用不足时对最有信息量的部分到达模态做特征补全后再评估。候选满足对应阈值即触发推理,避免了为完整性盲目等待。在 10 Mbps 事件检测任务上,完整方法把端到端延迟从 462 ms 降至 163 ms,精度为 88.66 %,与基线 89.35 % 接近。该结论适用于受控带宽模拟和短时真实系统,长期大范围部署尚未验证。原文披露设备端推理为 7.02 ms 至 63.72 ms,边缘端评估与补全合计约 6.38 ms,开销相对完整推理可以忽略。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. UbiHearo:把声音的场景含义和行动建议送到听障用户的手机上

英文题目:UbiHearo: Bringing Scenario-Aware Sound Guidance to DHH Users with Mobile Agents
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Fengmin Wu:Northwestern Polytechnical University, China
- Sicong Liu:Northwestern Polytechnical University, China
- Zimu Zhou:City University of Hong Kong, China
- Chenren Xu:Peking University, China
- Wanbing Zhao:Northwestern Polytechnical University, China
- Peiwen Sun:Northwestern Polytechnical University, China
- Zhiwen Yu:Harbin Engineering University, China
📌 核心摘要
听障用户需要的不仅是识别出喇叭声或敲门声,而是结合所处位置、活动状态和声源关系判断危险程度并获得行动建议。现有手机应用多把复杂场景压缩为孤立标签,还常因省电策略漏掉短促、低信噪比或重叠事件。UbiHearo把持续声学与物理上下文信号变成结构化中间表示,再分阶段推理出场景并生成指引,同时用本地反馈做有约束的个性化。先在感知阶段用可感知能量边界做占空比监听,提取短时能量与频带能量比等粗线索并输出可感知事件,仅在触发时送入长时分析以筛查警笛等高优先级声音。再在推理阶段由轻量融合模型推断室内外与静动状态,输出结构化场景槽位并送入压缩后音频语言模型生成指引,最后冻结主干仅更新输出层低秩适配参数并用正则限制偏离。在15dB与25dB信噪比SNR评测设置下,检测器平均精度分别为0.922与0.991,25dB条件高于15dB条件,20dB下为0.954,跨信噪比平均约0.956。用本地AudioSet片段反复触发并保持熄屏测得检测功耗20mW约为YAMNet7836mW的391分之一,内存158KB约为YAMNet57MB的369分之一,按每占空比触发一次测得Pixel9最长续航12.5h,稳态下Pixel8端到端平均延迟1.47s、Pixel9为1.26s。结论适用于日常室内外与车载场景,但在弱卫星与无线信号、强混响与密集语音环境下仍会出现误判,训练超参数与长期偏好漂移尚未充分验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 在保留原唱的基础上按区域施加演唱技巧

英文题目:ProSing: Zero-Shot Fine-Grained Singing Technique Conversion
评分:6.2/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinhao Guan:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingyue Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kangrui Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Julian McAuley:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhong-Qiu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
这项工作研究零样本细粒度演唱技巧转换,输入是一段未按目标技巧演唱的歌声,输出是在指定时间段施加指定技巧且保留歌词、旋律、时序与歌手身份的歌声。难点在于带技巧标注的歌声稀少,模型容易从音色提示与内容表征中利用技巧线索而忽视显式控制,离散标签也难以刻画颤音与滑音的连续音高变化。处理链路从内容-风格分词器开始,它把语音识别特征与色谱特征编码为每秒12.5个离散单元再上采样为每秒50帧的表征,目标是保留语言、旋律与表演风格并抑制音色,音色提示梅尔谱与内容表征经投影相加后送入流匹配变换器预测速度场,再积分并经声码器合成波形。为减少抄近道,训练使用配对的控制录音与技巧录音,共用控制分支的内容表征并经音素对齐后监督技巧分支重建,随机裁剪的同歌手提示进一步削弱对特定录音的依赖。颤音与滑音另用连续音高轨迹逐帧指定调制形态,与从乐谱合成的技巧可控歌声合成和用参考整体迁移风格的参考式转换不同,该方法直接在原录音上做局部多技巧编辑。在未见歌手与录音的对比中,语料级字错率在36个中文单技巧样本上为27.6%,低于技巧可控合成基线的64.1%与整体风格转换基线的39.5%;音高均方根误差在24个音色类技巧样本上为166.7音分,低于对应基线的413.4音分与332.8音分。结论限于六种预定义技巧的转换,尚未验证技巧到技巧的直接转换。原文披露了设备型号与数量、训练步数与推理积分步数,但未披露完整训练时长与部署开销。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 语音信号能去掉中文 AI 味吗:三组否定实验与校准评判器偏好训练
评分:6.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Dongwu Qian:Independent Researcher;Code and data: RA-Eval v0.1, Zenodo DOI 10.5281/zenodo.24237533
📌 核心摘要
中文大模型输出带有可感知的固定句式、书面连接堆叠、重复循环与版式泄漏,输入是约三百字的中文写作提示,输出是完整短文,难点在于自动特征与人类感知经常脱节,而单评委小样本盲测只能检出极端偏好。研究先检验语音接地假设,对同一文本量下拼音交错、韵律计划条件生成与合成语音韵律距离奖励三路干预分别做对照试验。再搭建三层评测并用校准后的大模型评委生成标注,校准评委先过已知答案敏感性把关,再经双评委换位双遍标注,不一致计为平局,其一致认同输出直接构成偏好对。最后把评委一致认同的偏好对直接作为正负例送入直接偏好优化训练,区别于特征距离奖励的间接优化,并附加保留数据分布的锚定项以对抗长度塌缩。为让读者对应原文,承担敏感性把关与双遍标注的流程称为校准评委管线,把无奖励模型的成对偏好训练称为直接偏好优化。语音侧三路干预均未带来可感知的改善,而在8个held-out提示共24对与base模型对比的双遍盲测上,0.6B直接偏好优化的repetition为0.000,低于base模型的0.114,soft win rate为0.833[0.699,0.972],高于base模型,单次训练仅需4.5分钟GPU时间,结论跨语言、大规模与人类一致性尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 零样本语音克隆能否留住性别延展声音:方法、听感与自动评价的分歧

评分:6.2/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.9/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Juliana Francis:机构信息未能在本次解析中与作者逐人可靠绑定
- Robin Netzorg:机构信息未能在本次解析中与作者逐人可靠绑定
- Joakim Gustafson:机构信息未能在本次解析中与作者逐人可靠绑定
- Éva Székely:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
零样本文本到语音指仅用数秒参考音频、不做额外微调就为未见说话人生成语音,本文考察它能否同等复现性别多元与非性别多元声音。性别多元指自我认同为非顺性别者的声音,非性别多元指顺性别者的声音,难点在于前者在公开语料中极少,参考音频短且评价标准易受主流主导。研究先把同一说话人多段录音拼接为约10秒参考音频,再把该参考与Harvard语句送入CosyVoice2等6个合成模型生成语音,最后把输出统一为16 kHz与-20 dB后送入人工与自动评价。人工评价采用类似MUSHRA的并行比较范式,听音者同时听到参考与6个模型输出并给出0-100相似度分,自动评价则提取说话人嵌入计算与参考的余弦相似度复现度、用模型预测平均意见分并用Whisper转写计算词错率,再用组内相关系数比较自动模型间的一致性。在Harvard语句合成的WER上,LinaSpeech对性别多元声音的WER为.141,高于对非性别多元声音的.072。人工结果呈现两极分化,E2TTS等3个模型对性别多元声音打分更高,XTTS与LinaSpeech则明显更低,而自动平均意见分与复现度在模型间与人工判断之间出现分歧。与已有偏见研究多关注合成语音是否保留群体风格不同,本文把合成质量与评价工具的可靠性放在同一框架下检验。结论仅适用于所用14名性别多元说话人与14名非性别多元说话人及所选语句,样本小且训练集性别构成未知,无法推广到所有性别多元群体,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 声音重要吗?已部署临床语音电话中的挫折感检测
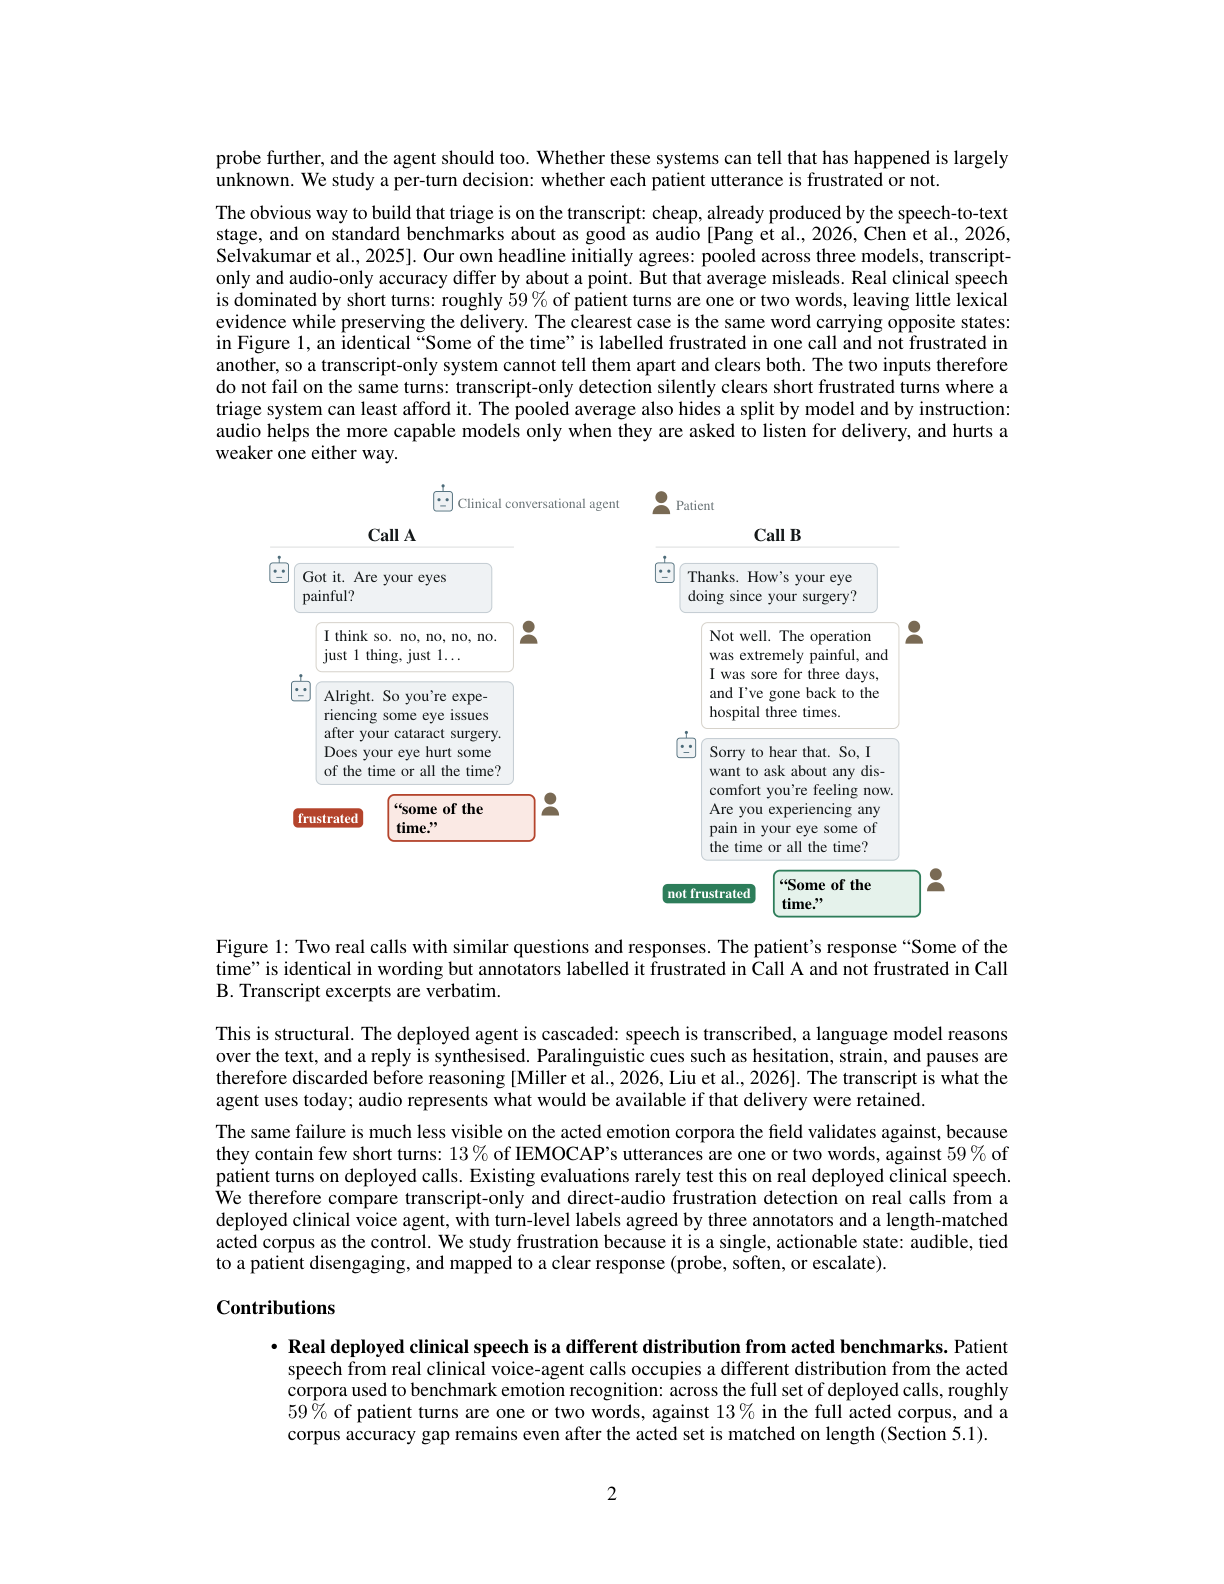
图片来源:原论文 PDF 第 2 页(含图 1)。完整图注与解读见独立文章。
英文题目:Does the Voice Matter? Evaluating Frustration Detection on Deployed Clinical Voice-Agent Calls
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.9/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Annika Michael:Ufonia Limited;London, UK
- Zachary Ellis:Ufonia Limited;London, UK
- Yuxiang Zhou:Ufonia Limited;London, UK
- Samuel Thio:King’s College London;London, UK
- Yajie Vera He:Ufonia Limited;London, UK
- Spencer Hazel:Newcastle University;Newcastle upon Tyne, UK
- Jared Joselowitz:Ufonia Limited;London, UK
📌 核心摘要
这项工作研究已部署临床语音代理通话中的逐轮挫折判断,输入是患者单轮的电话语音或其转写文本,输出为挫折或无挫折的二分类标签。难点在于真实患者轮次很短,词量几乎不携带情感词汇,而可判读的语气、停顿和紧张感只保留在声音中,转写链路会丢弃这部分信息。研究先收集真实通话并由三位标注者独立标注,以多数票确定标签,同时构造长度分布匹配的表演语料作为对照。再在相同轮次上对比仅文本条件和直接音频条件,模型在零样本下分别根据文字措辞或声音表现给出标签和理由,同一组合重复三次,多数票决定最终预测。最后用冻结语音编码器表示训练探针,探针指在冻结表示上训练的轻量分类器,用于检验表示中是否含有可线性读出的挫折信号,以呼叫为单位交叉验证。在150轮临床轮次的对话不相交评测上,冻结WavLM表示加支持向量机探针的ACC为70.0%,高于词数基线的58.0%。在30通共714轮、其中140轮为挫折的临床通话上,前沿模型对文本放行轮中实为挫折的占比为13.0%,高于音频条件的6.9%,单字挫折轮几乎全被文本漏掉。原文未披露训练、推理或部署成本。结论限于单条眼科随访路径的英语电话语音,长轮与多轮对话的推广尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 用物理运动与气流痕迹判断语音是真人还是喇叭回放
英文题目:Lightweight Replay Attack Detection via Interpretable Physical Descriptors
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Saba Nasiri:机构信息未能从 arXiv PDF 文本可靠映射
- Alireza Amirshahi:机构信息未能从 arXiv PDF 文本可靠映射
- Milos Cernak:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
语音验证易受重放攻击影响,攻击者播放合法用户的录音即可绕过身份判断。输入是麦克风阵列采集的1秒多通道短语音,输出是真人或重放的二分类,难点在于录音保留了说话内容与音色,仅靠频谱纹理容易学到环境噪声而非活体线索。先对同一段信号用广义互相关估计通道间到达时间差轨迹,再求速度与加速度的能量与起伏,提取并输出刻画人体姿态微动与扬声器静止差别的声源运动与静态空间描述子。再在语音频带内计算通道间级差与相位差的均值与时变统计并统计相位速度过零率,提取并输出捕捉生物运动平滑变化与数字时钟抖动差别的双耳相干与相位动态描述子,同时用低通能量比捕捉爆破音气流、用谱质心的时间与阵列聚合统计提取空气动力与构音描述子。最后将三组描述子拼接成的物理描述向量送入梯度提升树分类,输出真伪标签,避免深度网络的黑盒谱纹理学习。在ReMASC数据集六通道圆形阵列标准划分下,本文方法等错误率(Equal Error Rate,EER)17.8%,略高于多通道神经网络基线的16.5%,内存0.6 MB,1秒音频推理延迟D3为0.9 s、D4为0.26 s。方法依赖多通道空间信息,在开放大空间与车辆等未见环境下性能下降明显,尚未验证移动阵列与强混响下的稳定性。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 机器同传在什么话语下接近人类:英中同声传译的意义与译语质量比较
评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Yuanyuan Ding:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
该研究比较英语到汉语同声传译中机器系统与人类译员在含义和译语质量上的表现,输入是事先准备的正式演讲和即兴访谈两类话语,输出是中文译文,难点在于输入不断到达、不可回看,译员必须在听辨、记忆和表达之间分配注意力,话语越自发、结构越松散,跟踪意图和衔接上下文的负担越重。研究把同一源语录音分别交给五套商用机器同传产品和二十六名人类译员完成同传,再由两名评分者把每段源语切成二十五个左右承载核心信息与支撑细节的语篇关键信息段。为含义损失设计的主要等价错误计数把不同严重程度的错误折成同一尺度,译语质量则用整体量表打分并辅以三类定性标记。同一文本内的人机混合匿名转写对照用于抑制评分偏倚,事后还对照机器英文识别文本判断大错是否与识别可见错误一致。在事先准备的两段文本中表现最好的系统含义计数均为 7.0,分别超过二十六名人类中的二十二名和二十一名,而在即兴访谈中同一系统计数为 14.4 和 17.4,只超过三名和六名,指标越低越好。结论只适用于标准口音、无密集术语的受控录音,一段录音代表一种话语类型的设计无法分离说话人与语速等因素,也未用真实听众检验理解。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 让语音基础模型的浅层也学会辨别真伪:由深到浅的逐层监督退火

评分:6.1/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hoan My Tran:Université de Rennes, CNRS, IRISA;Lannion, France
- Xin Wang:National Institute of Informatics;Tokyo, Japan
- Xuechen Liu:Xi’an Jiaotong-Liverpool University;Taicang, China
📌 核心摘要
语音伪造检测要判断一段语音是真实录制还是合成或转换生成,难点是训练时只见过少数合成系统,测试时会出现未见过的声码器、扩散模型和网络采集语音,依赖最后一层表示的模型容易随分布变化同时失效。本文在24层语音基础模型上加装所有层共用的线性分类器,训练时对每一层计算二元交叉熵损失,再按层序号加权求和,权重随训练轮数从集中于深层逐渐变为均匀分布,偶数轮只监督最后一层以固定主目标。早期训练让深层先适应伪造检测任务,后期再把直接监督信号分给浅层,使原来没有判别力的浅层逐步获得检测能力,推理时可以在中间层提前退出。相对只监督最后一层的常规微调和全程均匀监督多层的方法,该做法保留预训练由浅到深的表示层次,又避免浅层过早扰动深层。与推理参数量同量级的最强基线相比,所提方法在8个数据集平均等错误率上从6.30%降到6.03%,指标越低越好,第7层退出时平均等错误率为9.25%,推理参数量从315M降到101M。结论适用于以XLS-R-128为主干、在ASVspoof 2019训练集上训练的设置,对小主干和训练阶段剪枝尚未验证,推理可减少约70%参数,训练仍需完整模型,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. 融合之后再精炼:用时间与频率两路处理找准音频片段

英文题目:Post-fusion Event-aware Time-Frequency Refinement for Audio Moment Retrieval
评分:6.1/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Feiyang Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Li’ang Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Kejia Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiaoxi Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Guangjun He:机构信息未能在本次解析中与作者逐人可靠绑定
- Pengming Feng:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Guan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音频时刻检索要求根据自然语言查询在长录音中给出目标事件的起止时间,难点在于查询相关事件稀疏分布并淹没在背景声与声学相似干扰中,边界也常因渐变而模糊。方法先把长音频切成重叠帧序列与查询词序列分别送入对比语言音频预训练 (Contrastive Language-Audio Pretraining, CLAP) 编码器得到帧特征与词特征,再经查询引导的跨模态交互与前馈网络得到融合帧特征。事件感知时频精修随后对融合特征操作,时间帧门控结合全局向量、融合特征与文本特征估计每帧相关度并加权,频率精修把门控后特征经短时傅里叶变换转到时频域并用可学习矩阵加权再经逆变换重构。精修特征送入基于检测变换器 (Detection Transformer, DETR) 的定位模块建模全局依赖并用可学习矩查询解码出候选边界与置信度。在主要基准 CASTELLA 上,ETR-AMR 相对 AM-DETR 的 R1@50% 从 19.30% 提高到 29.40%,mAP 平均值从 6.41% 提高到 12.63%,方向均为越高越好。该结论适用于长录音与高质量人工标注情形,在以短重叠事件为主的 TUT-Sound Events 2017 上不成立。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 直播会议中记住说话人:惊奇门控记忆的在线日志方案
评分:6.1/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 0.9/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Louis Mouchon:机构信息未能从 arXiv PDF 文本可靠映射
- Alexis Lainault:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
直播说话人分离标注需要在音频不断到达时为每段语音指定说话人,输出带时间的标签,难点在于决定必须依据过去信息作出,早先的错误会污染后续判断。系统把会议音频切成数据块,冻结的感知主干在块内完成语音活动检测与说话人嵌入提取,嵌入向量再投影到与聚类器一致的打分空间。嵌入与最近原型的相似分经开发集统计标准化后形成新颖度,门控按三档分别执行归属更新、暂缓输出和新建原型,暂缓片段留待后续统一解决。睡眠巩固阶段用原管线的聚类器对全部累积缓存重新聚类,合并分裂原型并落实暂缓片段,最终输出会议结束时可修订的标签。与单阈值在线基线和离线聚类相比,差异在于显式暂缓加全量回放,而非逐段不可撤销的接受或新建。在开发集冻结标定并跨域直接迁移、会议结束统一修订的测试设置下,以collar为0且计入重叠语音的说话人分离标注错误率衡量,AMI-SDM上本文方法为18.1%,低于在线基线的22.9%,离线目标为13.7%;VoxConverse上本文方法为8.0%,低于在线基线的9.9%,离线目标为7.6%。结论只适用于会议内记忆且检验会议很少,重叠语音漏检仍留在冻结分割环节,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 多无人机群的语音指挥如何做到可依赖

英文题目:Dependable Voice Command for Multi-UAV Swarms Using Small Language Models
评分:6.0/10 | 创新 1.2/2 | 技术严谨 0.9/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Afshin Ameri:机构信息未能在本次解析中与作者逐人可靠绑定
- Luiz Giacomossi:机构信息未能在本次解析中与作者逐人可靠绑定
- Håkan Forsberg:机构信息未能在本次解析中与作者逐人可靠绑定
- Ivan Tomasic:机构信息未能在本次解析中与作者逐人可靠绑定
- Baran Cürüklü:Mälardalen University;Västerås, Sweden;*These authors contributed equally and share co-first authorship.
📌 核心摘要
多人机监督要求操作员在注视画面的同时下达任务,输入是带口音、风噪与旋翼掩蔽的语音,输出是可直接交给规划器的结构化任务,难点是原始转写常把编号、颜色与动作词误转为同音词并引发错误执行。该框架先用自动语音识别 Automatic Speech Recognition (ASR) 把原始音频转写为文本,提取带噪声的自然语言查询作为后续语义处理的输入。再由本地小语言模型 Small Language Model (SLM) 充当语义任务解析器 Semantic Task Parser (STP),对转写文本先做发音归一,把不符合意图与目标闭合词表的声学标记按数字与编队上下文做最小改写映射为合法实体。最后语义任务解析器输出包含意图、目标、参数与置信度的元组并送入阈值判定,若改写过的标记被扣减至少0.10置信度后低于执行阈值则转入澄清而不直接执行。与直接执行原始转写的做法不同,它在语义层拦截不确定输入。与无发音校正的基线相比,在10000次合成指令的噪声评测中意图与目标联合准确率从42.47%提升到62.85%,灾难性误执行率从0.414降到0.153,代价是澄清请求在干净语音中从0.091升到0.135。结论只在合成语音与注入噪声条件下成立,长句自发口语、真实多人同时说话与强非平稳噪声尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. 听着噪声说话:Flow 语音合成如何从听觉反馈里学 Lombard 适应

英文题目:Auditory-Feedback-Conditioned Flow TTS for Implicit Lombard Adaptation
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yunya Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Satoshi Nakamura:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
常规文本到语音在噪声下可懂度下降,原因是合成时无法感知环境变化并调整发音。本文输入为待合成文本与提示语音,输出为干净与含噪下仍可懂的语音,难点在于不依赖显式基频或强度目标完成环境自适应。先将噪声污染语音的对数梅尔表示送入噪声水平分类网络,提取噪声存在得分作为环境线索并送入流匹配条件。再将同一污染语音与参考文本送入冻结的识别模型,计算逐词元交叉熵序列并经卷积与池化提取识别难度表示作为识别线索。最后把两类表示经各自投影加到帧级文本条件上以控制速度场的生成方向,其中静态用完整首遍合成的反馈做精炼,动态按块因果使用最近有效的反馈,这只改变条件输入而不同于显式声学调节或自回归韵律控制。在普通提示下未见动态WHAM噪声+5到-5到-15 dB的评测中,本文联合反馈方法的WER为0.493,低于配对微调基线的0.555,WER越低越好。该结论适用于高斯训练噪声之外的非平稳噪声,但域内动态条件下反馈收益不稳定,且更强的功率跟踪并不保证可懂度提升。推理成本方面,批量为1时单次识别反馈更新含识别与对齐在NVIDIA A800上的中位数耗时为214.3 ms、95分位数耗时为298.9 ms。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 多人对话中何时换人说话:发现与核验分开做的轮替预测
英文题目:Leveraging Dual-Process Theory for Multimodal Multiparty Turn-Taking Prediction
评分:6.0/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Rutherford A. Patamia:机构信息未能从 arXiv PDF 文本可靠映射
- Ming Liu:机构信息未能从 arXiv PDF 文本可靠映射
- Wei Luo:机构信息未能从 arXiv PDF 文本可靠映射
- Favour Ekong:机构信息未能从 arXiv PDF 文本可靠映射
- Rehan Mohammed:机构信息未能从 arXiv PDF 文本可靠映射
- Gang Liu:机构信息未能从 arXiv PDF 文本可靠映射
- Akan Cosgun:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
多人多方对话的连续轮替发现要求系统直接扫描连续交互音频,输出按时间排序的预测交接时刻集合,而不依赖预先给定的决策点,难点在于静音不等于让出说话机会,短暂插话与重叠也不等于抢到主要发言权。论文把这一负担拆成两步,先用高召回的快速扫描提出候选时刻,再只在候选处调用较重的核验做拒绝和定时。快速阶段提取语音自监督表示并用多尺度时序头做0.10秒步长的密集扫描,输出经峰值合并的候选时刻并送入核验阶段,核验阶段再融合声学上下文、转写与语言模型证据、对当前和他人未来活动的预测以及说话人变化线索,最后对邻近候选做排序和时间校正。做法与只在给定边界做分类的研究不同,它把漏检、误报和定位误差分开度量,也与只看静音的基线不同,它允许在重叠中产生候选。在 VoxConverse 规范测试集和正负 0.50 秒匹配容差下,最终双过程系统事件 F1 为 0.552,高于自动静音加说话人变化基线的 0.342。跨组分析显示方法排序随会话组变化,单组保留结果不能当作跨组优劣的定论。速度方面论文只报告了部分组件的测量,快速扫描核心的实时系数为 0.232,缓存后的时序核验每个候选为 0.0113 毫秒,但 diarization、识别、语言模型和嵌入提取等开销未计入,不能当作端到端实时证据。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 多语重叠语音分离:MOUSSE 如何用边界加权与逐帧不确定性做分离

英文题目:MOUSSE: Multilingual Overlapped Speech Separation with Predictive Uncertainty Estimation
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Su Yeon Shim:机构信息未能在本次解析中与作者逐人可靠绑定
- Yejin Jeon:机构信息未能在本次解析中与作者逐人可靠绑定
- David Ifeoluwa Adelani:机构信息未能在本次解析中与作者逐人可靠绑定
- Young-Joo Suh:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多说话人重叠语音分离需要从一段混合录音中恢复每个说话人的干净语音,语言发音差异、说话人数变化和时间重叠都会加重混淆,跨语言重叠还把语言身份与说话人身份纠缠在一起。本文输入为三秒到十五秒的混合语音,输出为对应二到四个说话人的独立波形。混合语音先变成按时间和梅尔频率排列的能量表示即梅尔语谱图,分离器估计从噪声指向目标语谱的速度场,这种学习连续分布之间传输路径的生成方式称为流匹配,边界加权让训练更关注说话人活跃帧及其起止附近帧。不确定性估计器再从混合语音、流动时刻和当前状态预测每帧每个梅尔维度的尺度,用高斯假设下的负对数似然学习该尺度并输出给采样过程,采样时按尺度逐帧调节无分类器引导强度,最后把分离出的梅尔语谱图送入声码器合成波形。与已有判别式方法和固定引导强度的生成式方法不同,该框架把帧级不可靠程度同时用于训练加权和采样控制。在MuSSeD测试集上,本文方法的SI-SDRi为13.18 dB,高于最强基线SR-CorrNet的11.60 dB,ESTOIi为0.175,高于同一基线的0.092,结论目前只在英韩合成混合上验证,未覆盖真实对话噪声和其他语言,训练在单张NVIDIA RTX A6000上进行二万九千次迭代。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. 没有语音编码器时,语言模型解码器在哪一层读出语音信息

英文题目:Layer-wise Linear Probing of an Encoder-free Audio-capable Language Model
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Laishram Rahul:机构信息未能在本次解析中与作者逐人可靠绑定
- Shruthi B. S.:机构信息未能在本次解析中与作者逐人可靠绑定
- Parismita Gogoi:机构信息未能在本次解析中与作者逐人可靠绑定
- Sishir Kalita:机构信息未能在本次解析中与作者逐人可靠绑定
- Deepak KT:机构信息未能在本次解析中与作者逐人可靠绑定
- S R Mahadeva Prasanna:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要理解的对象是去掉独立语音编码器后语言模型解码器自身如何形成语音表征,困难在于前端不再做上下文建模,难以区分声学到音素的变换发生在前端还是解码器。处理过程是把短波形窗直接投影到共享嵌入空间,再由解码器各层完成上下文加工,本文用线性探针逐层测量,线性探针指冻结模型并在每层训练简单的线性分类或回归读出,以可线性解码的程度衡量信息可及性。输入是 TIMIT 读语句及其音素与词标注,输出是每层对浊音、基频对数、能量对数、音素、词首、说话人、性别与方言区的解码分数。方法是先按样本重叠对齐帧与标注并划分说话人不重叠的交叉验证折,再在冻结隐状态上训练线性探针并以打乱标签作对照,最后用峰值层与近峰区间描述可及性随深度的变化。与已有语音自编码器研究的关键差异是被测的上下文加工全部位于解码器内部,不受前置编码器干扰,因而能直接观察解码器是否自发形成由声学到音素的粗排序。在 TIMIT 训练集五折交叉验证下,57 类音素探针以宏平均 F1 为指标在第 11 层取得 0.6458,超出多数类基线 0.0026,宏平均 F1 指对每类 F1 取平均,数值越高越好。同一划分下闭集说话人识别以准确率为指标在第 6 层取得 0.9970,远高于机会水平 0.0022,而性别等粗属性在深层仍保持高可解码性,说明细粒度身份与音素在深层下降而宽泛属性得以保留。结论只描述线性可及性,不证明模型生成时因果使用这些属性,适用范围限于单语料单模型与线性读出,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 说话很少的人为何在说话人日志里整体消失

评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fumiaki Yamaguchi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
说话人分离标注输入整段录音、输出说话人及区间,只说几秒的人即使整段漏掉,错分时间占比仍很小,误差指标几乎不变,但其话语会消失。论文统计八个输出槽位端到端模型的丢失情况,输出槽位指模型最多能输出的说话人数,丢失指标注说话人语音完全未被对应输出覆盖。丢失者按语音构成区分,被他人语音盖住一半以上归为重叠,单人语音一半以上无对应输出归为遗漏,单人语音一半以上归到另一输出名下归为合并,其余归为分裂。丢失者多为不足十秒的低活跃说话人,九人以上录音以槽位不够引起的合并与遗漏为主,八人以下以重叠为主。先整段运行一次模型,仅对占满八个槽位且不足三十分钟的录音切成短窗重跑,使窗内人数回到上限以内,模型冻结且不训练。再把各窗输出的单人语音提取为说话人嵌入并反复合并相近嵌入以连接跨窗同一人,不足十秒短片段暂不参与合并,最后交回首次整段结果中重叠一半以上的说话人做归属,切窗与否由是否占满槽位决定,而非时长。在五十八段九人以上录音的评测子集上,该做法把说话人分离标注误差率从20.10%降到14.99%,丢失人数从228降到101,额外说话人数从5增到50,整体推理速度从96倍实时降到85倍实时。八人以下录音几乎无变化,重叠导致的丢失也未被免训练做法减少,恢复重叠下短语音可能需要训练或建模重叠的方法。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. 方言电话里听错一步就全错:Sada-ASR 怎么做多方言阿拉伯语识别
英文题目:Sada-ASR: A Production Multidialectal Arabic Speech Recognition System
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Mahmoud Khaled:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohammed Abd-Elnaser:机构信息未能在本次解析中与作者逐人可靠绑定
- Mahmoud Mohsen:机构信息未能在本次解析中与作者逐人可靠绑定
- Hazem Ahmed:机构信息未能在本次解析中与作者逐人可靠绑定
- Abdelrahman Hafez:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
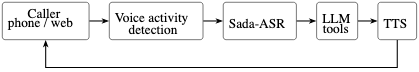
阿拉伯语客服来电多使用各自方言,而识别器长期围绕现代标准阿拉伯语构建,方言缺乏统一拼写并常混入英语单词,首步听错会直接破坏后续对话。输入为客服通话录音,输出为对应文字,难点在于发音、词汇和形态同时偏离标准语且拼写不一致。Sada-ASR 先用自建标注平台组织方言转写,再收集网络弱标注音频,两路去重清洗统一后合并为训练集;训练采用注意力编码器解码器逐词生成目标,阿拉伯语目标做去变音符号与字母归一;推理统一用贪心搜索加防循环与分窗拼接。与已有工作多依赖广播语料或通用多语言模型不同,该工作围绕海湾、埃及和黎凡特方言组织数据与分方言检验。在私有九品种测试集上按语料级微平均计算词错率,Sada-ASR 为 11.69%,低于最强外部系统 Microsoft MAI-Transcribe-2 的 13.51%。结论适用于客服短句方言语音,在黎巴嫩方言上仍落后且未覆盖马格里布等地区,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 做本地语音助手的小模型:对话、工具调用与低延迟如何兼顾

英文题目:Nemotron 3.5 Bolt E4B 4GB: An Open and Efficient Small Language Model for Fast Conversational Agents
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- NVIDIA:机构信息未能在本次解析中与作者逐人可靠绑定
- Adi Margolin:机构信息未能在本次解析中与作者逐人可靠绑定
- Aditya Malte:机构信息未能在本次解析中与作者逐人可靠绑定
- Aishwarya Chhabra:机构信息未能在本次解析中与作者逐人可靠绑定
- Alex Hodson:机构信息未能在本次解析中与作者逐人可靠绑定
- Ameya Sunil Mahabaleshwarkar:机构信息未能在本次解析中与作者逐人可靠绑定
- Ambrish Dantrey:机构信息未能在本次解析中与作者逐人可靠绑定
- Amy Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Andrii Skliar:机构信息未能在本次解析中与作者逐人可靠绑定
- Annamalai Chockalingam:机构信息未能在本次解析中与作者逐人可靠绑定
- Anusha Pant:机构信息未能在本次解析中与作者逐人可靠绑定
- Ashwath Aithal:机构信息未能在本次解析中与作者逐人可靠绑定
- Ashwin Kumar:机构信息未能在本次解析中与作者逐人可靠绑定
- Besmira Nushi:机构信息未能在本次解析中与作者逐人可靠绑定
- Bhavesh Pawar:机构信息未能在本次解析中与作者逐人可靠绑定
- Bryan Catanzaro:机构信息未能在本次解析中与作者逐人可靠绑定
- Bryan Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chantal Hwang:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenhan Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chris Alexiuk:机构信息未能在本次解析中与作者逐人可靠绑定
- Conner Currie:机构信息未能在本次解析中与作者逐人可靠绑定
- Cynthia Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- David Mosallanezhad:机构信息未能在本次解析中与作者逐人可靠绑定
- Dina Yared:机构信息未能在本次解析中与作者逐人可靠绑定
- Ehsan Hosseini Asl:机构信息未能在本次解析中与作者逐人可靠绑定
- Eileen Long:机构信息未能在本次解析中与作者逐人可靠绑定
- Erick Galinkin:机构信息未能在本次解析中与作者逐人可靠绑定
- Felix Friedmann:机构信息未能在本次解析中与作者逐人可靠绑定
- Giedrius Burachas:机构信息未能在本次解析中与作者逐人可靠绑定
- Gorkem Batmaz:机构信息未能在本次解析中与作者逐人可靠绑定
- Grzegorz Chlebus:机构信息未能在本次解析中与作者逐人可靠绑定
- Guillermo Siman:机构信息未能在本次解析中与作者逐人可靠绑定
- Haifeng Qian:机构信息未能在本次解析中与作者逐人可靠绑定
- Hao Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Hayley Ross:机构信息未能在本次解析中与作者逐人可靠绑定
- Hrishith Thadicherla:机构信息未能在本次解析中与作者逐人可靠绑定
- Hui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Huiying Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Ike Nnoli:机构信息未能在本次解析中与作者逐人可靠绑定
- Irina Filatova:机构信息未能在本次解析中与作者逐人可靠绑定
- Iris Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ji-Eun Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Leong:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaqi Zeng:机构信息未能在本次解析中与作者逐人可靠绑定
- Joey Conway:机构信息未能在本次解析中与作者逐人可靠绑定
- Jonathan Cohen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jose Vergara:机构信息未能在本次解析中与作者逐人可靠绑定
- Julien Veron Vialard:机构信息未能在本次解析中与作者逐人可靠绑定
- Kari Briski:机构信息未能在本次解析中与作者逐人可靠绑定
- Katherine Luna:机构信息未能在本次解析中与作者逐人可靠绑定
- Kedar Pandurang Potdar:机构信息未能在本次解析中与作者逐人可靠绑定
- Kevin Ning:机构信息未能在本次解析中与作者逐人可靠绑定
- Khalil Ben Khaled:机构信息未能在本次解析中与作者逐人可靠绑定
- Krzysztof Pawelec:机构信息未能在本次解析中与作者逐人可靠绑定
- Laura Dykes:机构信息未能在本次解析中与作者逐人可靠绑定
- Leili Tavabi:机构信息未能在本次解析中与作者逐人可靠绑定
- Lily Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Linda Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Liwei Ding:机构信息未能在本次解析中与作者逐人可靠绑定
- Maka Dong:机构信息未能在本次解析中与作者逐人可靠绑定
- Manoj Kilaru:机构信息未能在本次解析中与作者逐人可靠绑定
- Maria Bagdasarova:机构信息未能在本次解析中与作者逐人可靠绑定
- Matthew Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Meredith Price:机构信息未能在本次解析中与作者逐人可靠绑定
- Micah Schaffer:机构信息未能在本次解析中与作者逐人可靠绑定
- Michael Boone:机构信息未能在本次解析中与作者逐人可靠绑定
- Michael Fukuyama:机构信息未能在本次解析中与作者逐人可靠绑定
- Michael Hasper:机构信息未能在本次解析中与作者逐人可靠绑定
- Nancy Agarwal:机构信息未能在本次解析中与作者逐人可靠绑定
- Negar Habibi:机构信息未能在本次解析中与作者逐人可靠绑定
- Oleksii Kuchaiev:机构信息未能在本次解析中与作者逐人可靠绑定
- Oluwatobi Olabiyi:机构信息未能在本次解析中与作者逐人可靠绑定
- Pablo Ribalta:机构信息未能在本次解析中与作者逐人可靠绑定
- Payal Motwani:机构信息未能在本次解析中与作者逐人可靠绑定
- Pinky Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Prasoon Varshney:机构信息未能在本次解析中与作者逐人可靠绑定
- Pritam Biswas:机构信息未能在本次解析中与作者逐人可靠绑定
- Puhui Meng:机构信息未能在本次解析中与作者逐人可靠绑定
- Rameshwar Shivbhakta:机构信息未能在本次解析中与作者逐人可靠绑定
- Ran Zilberstein:机构信息未能在本次解析中与作者逐人可靠绑定
- Reka Kovacs:机构信息未能在本次解析中与作者逐人可靠绑定
- Richard Mazzarese:机构信息未能在本次解析中与作者逐人可靠绑定
- Rishabh Garg:机构信息未能在本次解析中与作者逐人可靠绑定
- Rita Fernandes Neves:机构信息未能在本次解析中与作者逐人可靠绑定
- Rochelle Woods:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruby Ye:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruvaid Virk:机构信息未能在本次解析中与作者逐人可靠绑定
- Ryan Hill:机构信息未能在本次解析中与作者逐人可靠绑定
- Saeid Motiian:机构信息未能在本次解析中与作者逐人可靠绑定
- Seph Mard:机构信息未能在本次解析中与作者逐人可靠绑定
- Shai Ben Nun:机构信息未能在本次解析中与作者逐人可靠绑定
- Shaona Ghosh:机构信息未能在本次解析中与作者逐人可靠绑定
- Sharad Yadav:机构信息未能在本次解析中与作者逐人可靠绑定
- Sudeep Sabnis:机构信息未能在本次解析中与作者逐人可靠绑定
- Suhas Hariharapura Sheshadri:机构信息未能在本次解析中与作者逐人可靠绑定
- Terry Kong:机构信息未能在本次解析中与作者逐人可靠绑定
- Thanh Do:机构信息未能在本次解析中与作者逐人可靠绑定
- Thinh Le:机构信息未能在本次解析中与作者逐人可靠绑定
- Udi Karpas:机构信息未能在本次解析中与作者逐人可靠绑定
- Viet Anh Trinh:机构信息未能在本次解析中与作者逐人可靠绑定
- Vinay Raman:机构信息未能在本次解析中与作者逐人可靠绑定
- Vinita Sharma:机构信息未能在本次解析中与作者逐人可靠绑定
- Warren Drones:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenwen Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Whei Hsueh:机构信息未能在本次解析中与作者逐人可靠绑定
- Will Efstratis:机构信息未能在本次解析中与作者逐人可靠绑定
- Yoshi Suhara:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunsheng Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhenming Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zijia Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zuhair Ahmed:机构信息未能在本次解析中与作者逐人可靠绑定
原作者元数据中有 1 项仅为分隔标点,未列为作者;其他作者与机构按原来源记录展示。
📌 核心摘要
本地语音助手要在有限内存和延迟下完成多轮对话,输入混杂对话历史、系统指令、工具定义和工具返回,输出需同时给出可说的简短回应和可执行的准确调用,难点是长期记忆不丢失又不产生冗长思考。先以对话基座Gemma-4-E4B-it为起点跳过监督微调,直接用可验证奖励与人类反馈强化训练优化多轮工具调用、指令层级和输出格式,同一训练样本分别在显式思考开启与关闭两种模式下按2:1配比学习,并以组相对长度惩罚控制推理与回答冗长,输出兼顾准确与简洁的BF16检查点。再把该BF16检查点选定步骤约1M tokens的强化采样轨迹送入重要性矩阵校准,将权重转为Q4_K_M格式以压低显存占用。最后用目标模型在两种思考模式下重生成的3.79M段对话回应蒸馏训练5层并行草稿器DFlash,它一次前向提出7个候选词元供目标模型并行验证以加速解码。与Gemma-4-E4B-it、Qwen3.5-4B和Nemotron-3-Nano-4B相比,模型在推理模式21项基准中有15项准确率最优且平均输出更短,非推理模式有14项最优。在SPEED-Bench的BF16微服务评测中,RTX PRO 6000单并发推理开启时每用户解码速度从无推测解码的124.7 tokens/s提升至DFlash的341.2 tokens/s,达到2.74倍。结论主要适用于英文主导的短时交互,多语言知识推理与视觉理解仍有小幅回落,原文用延迟与吞吐数据报告了部署收益。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. 把辅音拍的偏差画在时间与频谱坐标上

英文题目:An Interpretable Acoustic Coordinate System for Japanese Consonant Morae in Dysarthric Speech
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuma Enomoto:机构信息未能在本次解析中与作者逐人可靠绑定
- Misa Yamaguchi:机构信息未能在本次解析中与作者逐人可靠绑定
- Hiroki Nishikawa:机构信息未能在本次解析中与作者逐人可靠绑定
- Ittetsu Taniguchi:机构信息未能在本次解析中与作者逐人可靠绑定
- Kazuhide Matsunaga:机构信息未能在本次解析中与作者逐人可靠绑定
- Narikazu Uzawa:机构信息未能在本次解析中与作者逐人可靠绑定
- Takao Onoye:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
该研究解决日语辅音莫拉在构音障碍自我训练中缺少细粒度可解释反馈的问题,输入为患者朗读语音与一组健康参考语音,输出为每个目标莫拉在二维平面上的位置,原点为健康均值,距原点距离表示偏离程度,难点在于辅音的闭锁、爆破、摩擦与快速过渡短促且非平稳,易在生成式嵌入中被平滑而丢失物理含义。处理过程保留完整语句语境并利用预先对齐的起止时间定位目标莫拉。先由患者莫拉时长与健康平均时长之比取绝对对数得到时长距离。再用语音预训练编码器中间层提取帧级表示并以余弦距离结合动态时间规整对齐后在健康说话人间平均得到频率距离,最后将两个标量作纵轴与横轴成图。与直接压缩语谱图的映射相比,两个坐标轴分别指向节律与频谱结构差异,便于判断偏离方向。在健康人朗读同一短文并以首次两次朗读为参考集、第三次朗读为评估数据的辅音莫拉聚类评估中,/so/的Silhouette Coefficient本文方法为0.85,高于CNN基线变分自编码器的0.38。在舌次全切除术后患者朗读同一短文并以自动语音识别区分清晰与不清晰莫拉的评估中,平均欧氏距离清晰组为0.407,低于不清晰组的0.709,归一化统一平面上原点距离的ROC-AUC为0.897。结论适用于舌次全切除术后患者的给定短文朗读筛查,对语境依赖的莫拉仍可能把可接受变异判为偏离,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. 局部合理为何不够:用自动和声实验看结构约束何时帮忙、何时帮倒忙

评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Josef Pavlíček:Department of Software Engineering, Faculty of Information Technology, Czech Technical University in Prague, Czech Republic
- Petra Pavlíčková:Department of Software Engineering, Faculty of Information Technology, Czech Technical University in Prague, Czech Republic
- Martin Molhanec:Faculty of Electrical Engineering, Czech Technical University in Prague, Prague 6, Czech Republic
📌 核心摘要
该研究处理旋律到和声序列的映射,输入为切分后的旋律段序列,输出为每个段的和弦选择,难点在于局部合理的选择未必保持跨位置的参考关系,且同一结构偏好在不同上下文中可能起相反作用。先由输入准备把乐谱转成携带相对音高与时值的动机签名并建立非相邻重复之间的链接,输出的签名与链接送入优化以定位远距离依赖。再由候选生成为每段提供可选和弦集合并送入优化组件,优化组件在局部兼容与过渡分数上叠加重复与功能两项软偏好,用迭代维特比近似求解远距离依赖。最后由评估组件对照人工参考比较和弦与动机对关系,相对已有生成架构比较的做法,本文固定同一优化器,只改变结构偏好,从而分离规则含义与适用条件。在VALID划分上,本文组合约束RF的指标Exact Chord Agreement为19.0347%,高于基线B的18.9664%。参考根音音程一致率Reference root-interval agreement在未移调且参考根音相同情境下相对基线提升,而在移调且参考跟随移调情境下下降,说明总体和弦一致变化很小时关系层面仍出现方向相反的变化。结论只在所用语料与和弦词表内成立,回顾性情境标签依赖参考注释,不能直接用于生成时选择约束,也未验证跨语料迁移。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
49. 手机麦克风变化时嗓音障碍检测为何变差及如何稳住

英文题目:Towards Microphone-Invariant Speech Representations for Transformer-Based Voice Disorder Detection
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Iva Ewert:机构信息未能在本次解析中与作者逐人可靠绑定
- Felix Putze:机构信息未能在本次解析中与作者逐人可靠绑定
- Marvin Borsdorf:机构信息未能在本次解析中与作者逐人可靠绑定
- Tanja Schultz:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
嗓音障碍检测根据朗读录音判断发声功能是否异常,输入为原始波形,输出为健康或病理的二分类类别。实际部署中训练多来自受控环境的高质量录音,而应用多使用智能手机,话筒特性差异会改变频响并导致性能波动。对同一说话人,模型需在不同话筒染色下给出稳定判断,这是本文要解决的错配问题。基线流程将语音送入预训练编码器得到帧级表示,经平均池化压缩为定长向量,再经两层分类头输出类别。新增分支在池化向量后接投影头,对原始语音与其话筒变换版本分别编码,计算两组投影的互相关矩阵并施加对角为 1、非对角为 0 的约束,使表示对变换保持一致且各维度去相关。训练时分类损失与该约束损失按权重相加,推理时仅保留编码器与分类分支。为衡量泛化,作者用 20 款手机的脉冲响应与病理语音卷积模拟不同话筒,并划分已见与未见设备。在 Saarbrücken 语音库上,Wav2Vec 基线在原始条件下达到 84.01% 非加权平均召回率,而在最差的 Moto G9 条件下下降 12.53 个百分点,新增模块将已见与未见条件下的差距分别缩小最高 76% 与 62%。结论适用于模拟话筒条件下的两类检测,未经真实多话筒病理录音验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
50. 同一套秩一干预在多模态衍生模型里哪里还管用
英文题目:Where Is Rank-1 DiM Refusal Intervenable in Multimodal LM Derivatives?
评分:5.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chansu Han:NICT
- Seok-Hwan Choi:Yonsei University
- Takeshi Takahashi:NICT
📌 核心摘要
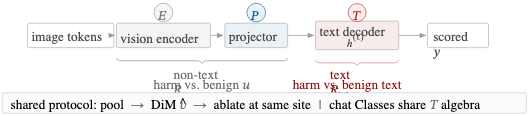
开放权重生态中同一聊天底座会派生出微调、防护、思考、视觉语言、音频封装等变体,审计者难以判断残差流上的拒绝方向在何处仍然可用。本文把任务固定为有害请求到聊天文本回复的映射,难点在于多模态封装改变了可挂钩位置,而文本与感知路径的对比变量和池化方式也随挂钩点变化。先在文本解码器残差上对比有害与良性文本提示,提取有害减良性均值差并归一,输出文本方向向量。再在感知编码器、投影器与融合路径上固定文本探针,对比有害与良性感知输入,输出对应的非文本方向向量。最后把这两类输出的方向向量送入相同位置做秩一消除干预,并以同范数随机方向作对照,用攻击成功率检验因果提升。负责生成回复文字的文本解码器处干预在纯文本与混合输入下提升攻击成功率,而感知编码器、投影器与融合路径处同类干预没有提升。在VLGuard非安全提示200例混合输入评测设置下以Llama-Guard计分,文本解码器干预的攻击成功率为0.150,高于未干预基线的0.030,方向性保持但绝对值较小。结论只适用于该均值秩一提取即干预系列,不主张拒绝特征在感知路径不存在,也不主张位置效应完全隔离,生成式U-Net等另行覆盖尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。