📄 方言电话里听错一步就全错:Sada-ASR 怎么做多方言阿拉伯语识别
英文题目:Sada-ASR: A Production Multidialectal Arabic Speech Recognition System
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Mahmoud Khaled:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohammed Abd-Elnaser:机构信息未能在本次解析中与作者逐人可靠绑定
- Mahmoud Mohsen:机构信息未能在本次解析中与作者逐人可靠绑定
- Hazem Ahmed:机构信息未能在本次解析中与作者逐人可靠绑定
- Abdelrahman Hafez:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
阿拉伯语客服来电多使用各自方言,而识别器长期围绕现代标准阿拉伯语构建,方言缺乏统一拼写并常混入英语单词,首步听错会直接破坏后续对话。输入为客服通话录音,输出为对应文字,难点在于发音、词汇和形态同时偏离标准语且拼写不一致。Sada-ASR 先用自建标注平台组织方言转写,再收集网络弱标注音频,两路去重清洗统一后合并为训练集;训练采用注意力编码器解码器逐词生成目标,阿拉伯语目标做去变音符号与字母归一;推理统一用贪心搜索加防循环与分窗拼接。与已有工作多依赖广播语料或通用多语言模型不同,该工作围绕海湾、埃及和黎凡特方言组织数据与分方言检验。在私有九品种测试集上按语料级微平均计算词错率,Sada-ASR 为 11.69%,低于最强外部系统 Microsoft MAI-Transcribe-2 的 13.51%。结论适用于客服短句方言语音,在黎巴嫩方言上仍落后且未覆盖马格里布等地区,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
客服电话里识别器要处理什么输入和输出
这篇论文面对的是阿拉伯语客服电话里的语音识别。输入是来电人通过电话或网页传来的连续语音,输出是写成文字的转写,后续交给大语言模型用工具处理再由语音合成回答。必须保留的信息是来电人实际说的内容,包括方言词汇、发音差异、夹杂的英语词以及迟疑重复等口语现象,因为电话里对方看不到转写,听错就直接打断通话。
阿拉伯语的难点在于日常口语和书面规范不一致。论文把前者称为各地区方言,后者称为现代标准阿拉伯语。方言之间词汇发音形态也不同,而且没有统一拼写,同一个音可以有多种写法,还常混入英语词。已有识别器主要用标准语建成和评测,遇到方言就在最前端出错,后面语言模型再强也来不及纠正。
对刚入门的读者,可以把任务想象成这样一个例子:一段最多 30 秒的埃及方言录音,里面有数字、英语品牌词和语气词,识别器要逐词写出转写。评价时把预测文本和人工参考文本对齐,数替换删除插入的词数。论文用词错误率衡量词级差异,用字错误率衡量字符级差异,两者都是总编辑距离除以总参考长度,数值越低越好。理解这个输入输出和评价方向,是后面看数据管道和分方言结果的基础。
已有阿拉伯语识别评测走了哪条路
论文把相关工作分成两类。一类是评测和语料:早期多方言广播挑战先测标准语为主的广播,再测方言网络视频,后来有约 2000 小时的多方言广播语料,也有人在原有测试集上比较端到端和模块化识别器与人工转写,还有跨方言评测常见大模型的方言差异。众包和网络规模语料、单地区语料、多方言合集、阿英语码切换语料陆续出现,现在有公开排行榜把其中 6 个测试集放在一起评,另有方言识别比赛新开多方言赛道。
另一类是拼写和打分。方言没有标准拼写,有研究提出标注规范,单参考的词错误率会把合法拼写变体也算错,有研究用多参考打分缓解。工业系统方面,有工作用自动标注语音训练并在排行榜上与开源模型和商业服务比较,还有工作把做法扩展到更多方言,多语大模型常被当作基线。
本文与它们的区别在于比较方式:在同一个未公开过的私有测试集上,由作者自己实测当前商业接口和开源权重模型,给出每个变体的结果,而不是引用各家在不同时间不同打分下的数字。公开六集的部分则是把自己的当前打分结果与已发表数字并列,但明确说明对方未声明用当前打分,所以只是指示性对照。
为什么只看总分会掩盖方言问题
论文要回答的具体问题是:在标准语占大头的测试里,总分好看是否等于方言也好。私有测试共约 120 小时,标准语占音频的约 40%,聚合指标是语料级微平均,也就是把所有错误加总再除,标准语强而方言弱的系统在总分上仍然好看。论文因此把按方言分别的结果当作主要依据,总分只作参考。
第二个问题是打分本身是否公平。方言拼写不统一,数字写成数字还是单词、英语词写拉丁字母还是音译、标点变音符号和字母变体都会影响计数。不同系统的接口还有固定习惯,例如有的系统把数字写成数字且关不掉,比较时若不控制这些,就会把格式习惯误读成听懂能力的差距。
现代标准阿拉伯语 × 方言: 现代标准阿拉伯语是书写和新闻用的规范变体,方言是日常口语,二者词汇发音形态都不同;论文要解决的是用前者建成和评测的识别器去听后者时会先听错,组合起来说明为什么必须按方言分别评测而不是只看被标准语主导的总分。
第三个问题是失败是否集中在某个方言。论文发现在 9 个变体里有 7 个最好、一个持平、一个明确落后,落后恰好是黎巴嫩语。只报平均会藏起这个反例,所以论文单独分析落后方言的错误构成,看是拼写习惯还是漏听口语词导致的,这也是复述时要抓住的关键结构。
识别器在生产语音助手里的位置和分工
论文先交代部署背景,但明确不评价助手整体。助手是级联结构:语音活动检测切出语音段,识别器转成文字,大语言模型带工具做任务,语音合成再说回去,各阶段经实时媒体服务器连接。选择级联而不是端到端语音模型的理由是每个语音阶段可以单独针对阿拉伯方言优化,语言模型可换而不必重训语音模型,中间结果都是可检查的文本。
在这个链条里看识别器的输入输出,有助于理解为什么论文强调逐字性。下面的示意图展示了从用户电话到语音活动检测再到识别器再到大模型工具再到语音合成的顺序,以及从合成回到电话的通话回路,读图时重点看识别器处于语言模型之前的位置。
看图路径: 1. 先从左侧来电沿箭头向右看经过语音活动检测再到识别再到大模型工具再到语音合成的主链;2. 注意底部从合成回到来电的回路,表示多轮通话的闭环;3. 确认识别器的输出是文本,直接交给大模型而不是音频直连
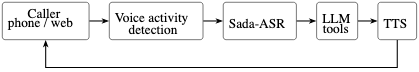
论文图 1。原论文 Figure 1::“Where Sada-ASR sits in the voice agent at call time.”。
从图中可见,识别器是语言模型之前唯一的听写环节,它的输出直接决定后续理解的起点。如果它把方言词改写成标准语形式,或者把重复迟疑和短词省略,后面模型拿到的就是已经走样的文本。论文提到的语音合成模型能发多种海湾埃及标准语和英语声音,但那是使用背景,不在本文评测范围内。方法部分的重点因此是识别器本身的数据和训练解码,而不是助手其他模块。
两路数据如何变成一个训练集
论文说方言逐字转写稀缺,难在每个方言都要会说该方言的人来标,且没有统一拼写可依;网络音频好找但自带标签弱。做法是两条流合并:一条是自建标注平台转写的音频,一条是网上收集的弱标注音频,最后去重清洗统一成一个训练集,其中英语约占总训练时长的三分之一。
自建平台分三层:一百多名来自阿拉伯各地的内部标注员负责转写,审核员持续抽查审计,专家处理最难的专业个案。质量控制用对照样本:同样的评测样本放进每个标注员的队列,给出可比基线;重复样本在标注员不知情下插入,测不同人对同一音频的一致性;所有对照样本在成集前剔除。
下面的示意图把这个过程画成两条支路,读图时先看上支的人工链条,再看下支的网络链条,最后看它们在合并过滤处汇合,理解分支各自解决什么、哪里汇合、共享什么。
看图路径: 1. 先看上支从百人以上标注经审核再到专家处理难例的链条;2. 再看下支从网络音频到弱标签的链条;3. 确认两支在合并去重清洗统一处汇合后再进入训练数据
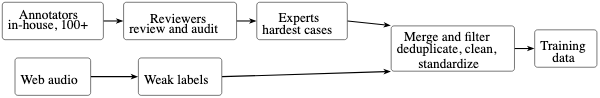
论文图 2。原论文 Figure 2::“The two data streams behind Sada-ASR: audio transcribed on our annotation platform, and weakly labelled web audio, merged into one training set.”。
从图中可见,上支解决标签准确,下支解决数量和真实多样性,汇合处的三步是去重、清理、统一。去重是跨 2 流去掉重复音频,清理是去掉损坏记录、音文不匹配和音频伪影,统一是把格式和元数据拉齐。论文没有给出弱标注如何生成标签的细节,也没有给出 2 流各自的具体小时数,这是复现时需要自己补的缺口,可用相邻已披露的方言比例和英语占比先搭采样框架,再按自有数据补量。
人工标注音频 × 弱标注网络音频: 人工标注音频指自建平台上按方言找人逐字转写的高质量音频,弱标注网络音频指从网上大量收集但原配文字不可靠的音频;前者解决拼写一致性和准确性,后者解决数量和真实多样性,二者去重清洗统一后合并,组合后才有既大又能用的训练集。
模型用什么目标训练又用什么方式解码
模型结构只用一句话交代:基于注意力的编码器解码器识别器,逐词元写出转写。论文没有披露层数维度参数量,注意力形式和训练步数优化器,这些形状和更新细节都缺,讲解时不猜实现,只讲已披露的采样、目标和解码。
训练采样是按比例抽片段:每轮一半片段来自英语,对英语重复采样、对阿拉伯语降采样,阿拉伯语内部按各变体小时占比抽取。论文明确说不做数据增强,不加噪不变速,不模拟编解码和混响,也不用频谱掩蔽,音频只重采样到 16 千赫单声道。目标是转写加结束符的下一词元交叉熵,没有标签平滑,没有辅助连接时序分类损失。阿拉伯目标不带变音符号,保留带哈姆扎的阿利夫形式,数字写成单词,语码切换词保留小写拉丁字母;英语目标保留大小写和数字。
标点和大小写来自自动标点恢复模型。选检查点用 1482 句的留出验证集做贪婪解码的词错误率,每变体至多 100 句,含英语,且与训练和所有测试无重叠。
解码在私有和公开集上完全同一配置:普通贪婪搜索,不用束搜索、重复惩罚和语言模型约束,不做解码时调参。防循环机制是允许 4 到 8 词元单元至多重复三次,每窗输出上限为每秒音频 14 个词元加 16,至少 20。长于 30 秒的音频按 30 秒窗 2 秒重叠解码再拼接,片段逐个解码。训练集里方言标注音频的相对占比如下图所示,读图时注意标准语接近一半而尾部方言极少,这直接影响采样时各方言被抽到的频率。
看图路径: 1. 先看最长的标准语横条占比接近一半;2. 再比较埃及和沙特两条次长条与叙利亚等更短条的落差;3. 注意阿曼黎巴嫩卡塔尔三条最短条都在百分之二以下
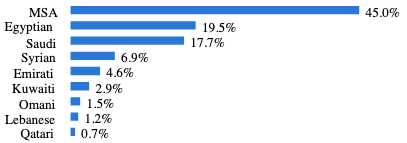
论文图 3。原论文 Figure 3::“Relative share of Sada-ASR’s dialect-labelled Arabic training audio across the nine varieties of our test set.”。
从图中可见,标准语占约 45%,埃及约五分之一,沙特约六分之一,叙利亚、阿联酋、科威特依次下降,阿曼、黎巴嫩、卡塔尔各不足 2%。这种不均衡意味着模型见黎巴嫩和海湾小方言的机会少,后面在黎巴嫩语上把方言拼写写成标准语形式,与训练暴露不足是一致的。缺的是各变体绝对小时数和英语与阿拉伯语的具体总量,复现第一步可用图中比例和约三分之一英语的描述先按自有总量折算,再验证小方言是否欠采样。
贪婪搜索 × 窗口拼接解码: 贪婪搜索指每一步只取当前概率最高的词元往下写,不做束搜索和调参;窗口拼接解码指超过 30 秒的音频切成 30 秒窗加 2 秒重叠分别解码再拼文本,二者搭配保证私有和公开测试都用同一确定性流程,避免解码调参带来不公平。
120 小时私有测试和打分规则如何保证可比
私有测试的测量对象是 12 个系统:自家一个加 11 个外部,外部含 5 个商业接口和 6 个自托管开源权重模型。测试集约 119.9 小时共 53597 个片段,覆盖标准语和埃及沙特叙利亚阿联酋科威特阿曼黎巴嫩卡塔尔 8 种方言,每片段至多 30 秒,来自 14686 个源录音,同一录音的片段共享说话人和信道,置信区间按源录音自助得到。测试集按时长分层,每变体固定小时数,片段数随语速和切分变化。所有系统在 2026 年 10 月 13 日实测,个别系统在 15 至 16 日补测。
接口都设为阿拉伯语、逐字输出、能关的格式选项都关,不用上下文偏置和自定义词表;微软服务指定阿拉伯语通用区域,方言区域在抽查中给出相同转写;开源模型用发布或默认设置在自有硬件运行。
打分在私有集上统一归一化:去标点和变音符号,把带哈姆扎和长音的阿利夫折叠成光杆阿利夫,相关变体字母折叠,独立哈姆扎删除,特定外来音字母映射,不把尾字母折叠,东阿拉伯数字转西阿拉伯数字,常见字母归一,数字不在数字和单词间转换。一到三词单元连续重复超十次截到十次,空白统一;输出词数超参考 5 倍且超 50 词则重跑至多三次。每个系统每片段都存归一化前原始输出,可不重跑识别器而重算错误率。
词错误率 × 字错误率: 词错误率是全部参考词上的总编辑距离除以总词数,字错误率是同样做法算到字符上;词级对整词替换敏感,字符级对拼写形态差异更连续,论文同时报告二者,组合后能看出黎巴嫩语那种整词按标准语改写但字符差异小的错误类型。
公开部分用排行榜的 6 个测试集连接已发表结果:特定语料、通用语音、干净和噪声集、广播新闻和多方言合集。作者用排行榜当前评分代码在 10 月中旬实测自家系统,排行榜在 7 月底修过评分,修了标点去除、独立字母贴词和多余空格,早期已发表行未重打分。理解这个版本差,是判断公开比较只能算指示性的关键。
私有集上谁在哪些方言上更好
要回答的核心问题是:在同一音频同一打分下,自家系统是否在多数方言上更低,以及优势在受控格式下是否还在。指标方向是词错误率和字错误率越低越好,总体是语料级微平均,另报九变体无加权平均。下面的总体表比较自家与最接近的商业和开源系统,公平条件是同批私有音频、同样逐字设置、同样归一化打分,重点看总体和无加权平均以及空输出率。
| System | WER | Macro | CER |
|---|---|---|---|
| Sada-ASR (ours) | 11.69 | 15.52 | 4.76 |
| Microsoft MAI-Transcribe-2 | 13.51 | 16.96 | 6.37 |
| ElevenLabs Scribe v2 | 16.12 | 20.67 | 7.54 |
| IFM Jais-ASR | 16.41 | 21.00 | 6.89 |
上表支撑的判断是总体最低成立,但总分受标准语主导。论文报告自家词错误率最低,字符错误率也最低,对最强外部系统的相对降幅约一成多。空转写已计入错误率但单独报告,因为在通话里是 distinct 失败;自家仅两个空片段且无失控长输出,而个别基线有上百条失控输出。不能从这里推出在所有方言上都好,必须看分方言表。
分方言的比较问题是优势分布是否均匀。论文称 7 个变体最低,叙利亚持平,黎巴嫩落后。下面的受控差距表把各方言相对最强外部系统的领先点数放在一起,正值表示自家更低,条件是原文报告的未受控差距,叙利亚用原文的绝对值表示持平,黎巴嫩表示落后,读者应拿它与总体表对照,防止只记总分。
| 方言 | 相对最强外部系统的差距 |
|---|---|
| 阿曼 | 4.30 points |
| 埃及 | 3.78 |
| 沙特 | 2.19 |
| 阿联酋 | 1.65 |
| 现代标准阿拉伯语 | 1.38 |
| 卡塔尔 | 1.20 |
| 科威特 | 0.53 |
| 叙利亚 | 20.16% against 19.98% 持平 |
| 黎巴嫩 | 落后 1.91 points |
上表说明优势集中在阿曼埃及沙特,其次是阿联酋标准语和卡塔尔,科威特很窄,叙利亚置信区间包含零,黎巴嫩是明确反例。论文还做了受控片段分析,只看参考和双方输出都没有数字数字词和拉丁字母的片段,差距依然为正但变小,去掉迟疑填充词后进一步变小,说明部分总体差距来自对方不可关闭的数字和拉丁写法习惯,但核心听写优势仍在。按字符错误率自家在 9 个变体都是十二系统最低,叙利亚与对方的差异区间包含零。论文明确不声称从标准语到方言的退化更小,因为自家方言平均是标准语的约 3 倍,对方约 2.6 倍。
语料级微平均 × 按方言无加权平均: 语料级微平均是把所有词的错误总数除以总词数,标准语占比大就会主导结果,按方言无加权平均是把九种变体各自的词错误率直接平均;前者反映客服整体流量观感,后者防止强标准语掩盖弱方言,论文把后者当作主要判断依据。
公开六集的比较问题是当前打分下与已发表数字的相对位置。下面的总体表选自家与几个已发表平均值,条件并不完全一致,因为对方未声明用当前打分且多早于 7 月修订,指标方向仍是越低越好。
| System | SADA | Avg |
|---|---|---|
| Sada-ASR (ours) | 25.76 | 17.17 |
| Falcon-ASR [23] | – | 20.92 |
| Audar-ASR-V1-Turbo, leaderboard [24] | 28.92 | 23.17 |
| Jais-ASR | 30.85 | 22.85 |
上表支撑的判断很有限:在当前打分下自家六集无加权平均低于找到的每个已发表数字,但因评分版本和标点处理不明,只能算指示性,不能当同条件胜负。论文同时给出自家在六集上的词和字错误率细节,片段总数四万多,读者应拿它与私有集的分方言结论对照,而不是用公开平均替代方言能力。未胜出项必须记住:黎巴嫩语落后和叙利亚持平,以及未覆盖的马格里布伊拉克苏丹也门,都不在这些平均里。
为什么在黎巴嫩语上输掉
这一节回答失败条件:落后是偶发还是系统性习惯。论文说黎巴嫩语是明显且宽泛的输,71 个源录音里 55 个自家错误更多,且差距在不同片段长度和语速下都成立。错误构成上两系统替换占比接近,自家删除更多、对方插入更多,词错误率高但字错误率反而更低,说明多是整词形式替换而非整句听不懂。
第一个习惯是把黎巴嫩词写成标准语形式。参考按发音拼写共有词,自家按标准语辅音写;功能词也换成标准语对应词;动词前缀脱落会改变人称。这类形式替换在词级算整词错,在字符级只差少量字母,正好解释词错误率高而字错误率低。
诊断是把几组方言与标准语写法视为等同后重新计分,差距从约两点降到约 0.5 且不再显著。第二个习惯是不够逐字:漏掉假启动重复词和参考保留的短词,对方则通过更多插入拿回分数,包括参考没有的迟疑填充词和其他替换如拉丁写的英语词。把填充词从两侧都去掉后差距反而拉大,说明填充词不是输的原因。
下面的受控差距表把总体差距的构成放在一起,比较的是全部片段与去掉格式干扰后的领先点数,公平条件是同一私有集、同一归一化,只是片段子集不同,指标方向仍是点数越大自家越好。
| 比较条件 | 自家相对最强外部系统的领先 |
|---|---|
| 全部片段 | 1.83 points |
| 无数字数字词拉丁字母的受控片段 | 0.74 points |
| 受控再去掉迟疑填充词 | 0.49 |
上表说明去掉对方固定格式习惯后领先变小,但符号仍为正,支持听写本身有优势而非全靠格式占便宜。结合黎巴嫩诊断,读者应把结论限定为:在方言拼写按发音保留、且要求逐字保留口语重复和短词的打分下,自家因偏向标准语形式和偏向干净文本而吃亏。论文计划用更多逐字且拼写一致的黎凡特转写训练来改,这仍是待验证的想法,不是已证明的修复。
结论在什么数据和部署条件下才成立
论文的结论边界首先是方言覆盖。私有集只有标准语和 8 种方言,标准语音频约 40%,马格里布伊拉克苏丹也门没有代表,不能把海湾埃及黎凡特的结论推广到整个阿拉伯语。训练分布里标准语近半而尾部方言各不足 2%,低资源方言的结果更不稳。
其次是打分依赖。单参考词错误率对方言拼写变体敏感,归一化折叠了部分字母和数字形式但没有在数字与单词间转换,也没有多参考,拼写习惯不同就会左右点数。受控分析已经显示格式习惯能移动差距,公开比较更因评分版本不同只能算指示性。
第三是系统与成本缺口。论文没有报告非语音输入的表现、轮次延迟、合成听感和端到端助手效果,也没有给出训练算力推理开销和帧率延迟,训练资源推理开销输出帧率和实际延迟要分开看,不能从词错误率推出通话体验更好。作者受雇于开发该识别器的公司且全部系统由作者实测,论文用报告失败方言、注明每次外部测量日期、存原始输出可重算来缓解,但利益冲突本身仍是阅读时要记住的条件。
要复现和核对需要先准备什么
复现第一步是搭同样的评测协议,而不是先调模型。按论文交代准备每片段至多 30 秒的同音频输入,接口设阿拉伯语逐字且关闭可关的格式选项,不用上下文偏置和自定义词表,开源模型用发布或默认设置;打分按论文的归一化逐项实现,包括去标点变音符号、字母折叠、数字映射和重复截断,并保存归一化前原始输出以便重算。划分上私有集与训练和验证无重叠,验证集 1482 句每变体至多 100 句,置信区间按源录音自助,片段级直接平均会高估显著性。
数据方面论文描述了两路合并和采样比例,但未披露总量、弱标签生成方法和模型超参数,缺的是绝对小时数、优化器步数和网络结构。可用已披露的方言相对占比和约三分之一英语先按自有总量折算采样,再补做小方言的欠采样验证;解码直接用贪婪搜索加防循环和窗口拼接,不加束搜索和调参。论文文内给出了测试子集和评分代码的链接文字,来源未确认当前可达,这里不判断能否下载,复现时以能实际拿到的音频切分和参考文本为准。
核对时重点看 3 组对照:总体与按方言无加权平均是否同时更低,受控片段差距是否仍为正,黎巴嫩诊断中把方言与标准语写法视为等同后差距是否缩小。若只有总体好看而方言平均不好,或受控后符号翻转,就不能复述为方言更好。
什么时候值得尝试还有什么要补
综合来看,值得尝试的场景是客服这类电话方言输入、输出直接进任务模型的级联助手,且测试里标准语占比高、需要分方言看效果时。论文的方法选择是用大量人工转写保拼写一致,用弱标注网络音频补量和多样性,用无增强和统一贪婪解码保可比,这种搭配适合方言转写稀缺但网络语音好找的起点。行动顺序是先按原文协议复现打分和分方言评测,再看受控差距和黎巴嫩这类反例,最后才决定是否在自有方言上加逐字转写。
还需要补的验证是未覆盖方言、非语音输入的稳健性、实际轮次延迟和端到端任务成功率,以及训练与推理成本。关键超参数和信息条件要保留:16 千赫单声道、无增强、下一词元交叉熵无平滑无辅助损失、贪婪解码加防循环和窗口拼接、验证集选检查点。容易产生的误解是把公开平均低于已发表数字当成同条件超越,实际上评分版本不同且对方处理不明,只能算指示性;另一个误解是把字错误率全方言最低当成黎巴嫩也听得更好,实际上词级因标准语改写和省略口语词而落后,字符级差异小才显得低。记住这两个边界,就能准确复述这篇论文做了什么和没证明什么。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses