📄 电话议价中语音代理的延迟、金额听写与插话处理比较
评分:6.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Jovan Popoca Moran:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico
- Eduardo de Avila-Armenta:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico;Tecnológico de Monterrey, School of Engineering and Sciences, Monterrey, N.L., Mexico
- Raúl Alejandro Aquino-Ibarra:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico
- Jorge Octavio Nicolás-Díaz:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico
- Umberto Leon-Dominguez:AI Lab, Freight Technologies Inc., Monterrey, N.L., Mexico
📌 核心摘要
这项研究处理西班牙语电话货运议价场景下的语音代理,输入是载运方连续说话音频,输出是包含报价验证与协议登记的实时语音答复,难点在于通话间隙短、插话与附和频繁且金额误听直接造成损失。级联通路先由语音识别提取载运方话音转写文本,再把转写输出送入语言模型生成含工具调用的答复文本,最后由语音合成输出语音答复,Pipecat与LiveKit Agents分别编排同一套识别、语言模型与合成提供方,GPT-Live则内部直接听说作答并把工具调用交给同一语言模型。研究用同一套47段单人录音播放载运方话音,在五种议价场景下每架构拨打77通电话,同一计时装置在听者一侧标记话音结束与有效答复开始,并用已知延迟的模拟代理校验各条音频通路。在上述相同录音与通话条件下,听者一侧内容答复等待时间中位数GPT-Live为2444.8 ms,Pipecat为2616.0 ms,两者差值171.2 ms的95%置信区间包含零,无法区分快慢。在相同47段录音、每架构77通电话的条件下,GPT-Live的WER为1.47%,低于Pipecat的6.03%,方向越低越好。结论只适用于单人录音、未经过电话网、默认配置的比较,真实噪声、多说话人与英文切换尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
电话议价对语音代理提出了哪些要求
这篇论文的任务不是一般的聊天,而是替货主用西班牙语给承运司机打电话谈运价。输入是电话音质的 carrier 说话音频,目标是在 30 分钟 WhatsApp 文字谈判无果后,由语音代理继承同样的目标价与最高价配置继续谈判,输出是能被 carrier 听到的语音回复,并且在谈判中需要调用工具校验价格、记录补偿或关闭订单。
电话与文字的最大差别是时间压力。人类对话中轮次间隔最常见的是 0 到 200 ms,重叠很频繁,其中大量是 ajá、uh-huh、ok 这类附和性应答,只表示在听而不想拿走话语权。代理必须同时解决 3 个听与说的问题:carrier 说完后等多久才算说完,何时该让位给真正的打断,何时该顶着附和性应答继续说。等待太久会让沉默变得难受,误把附和当回答则会改变谈判结果。
另一个要求是听准花钱的词。论文反复强调,总词错误率低不等于理解对了,金额、地名、单证词错一个就可能赔钱。电话音质比录音室差,金额常以长串西班牙语数字词出现,还带有自我纠正,例如 Diecisiete… no, dieciocho。这决定了评价不能只看整体听写,而要单独看金额,并且要看代理的下一句回复到底用了哪个数字。
论文要比较什么,为什么要在听者一侧测量
论文比较的是 3 种完整架构做同一件事的效果,而不是比较某个识别器或合成器。第一种是 Pipecat 编排的级联,第二种是 LiveKit Agents 编排的级联,两者用同样的底层提供商,第三种是 GPT-Live,它是直接音频进音频出的原生语音模型,没有独立的语音识别与语音合成阶段,工具调用则转交给同样的 gpt-4.1-mini。3 个架构此后就简称为 Pipecat、LiveKit 和 GPT-Live。
要回答的问题是语音技术本身带来的差别:回复延迟、语音识别尤其是金额、轮流发言尤其是 carrier 在代理说话时插话会发生什么。论文明确不评价谁更会谈判,谈判只是载体,用来逼出金额、地点、单证词和频繁的工具调用。所有架构用同一套指令、同一趟行程数据和同一套工具,区别只在语音技术与默认配置。
比较公平的关键是输入相同与测量位置相同。程序用同一人录制的 47 段录音扮演 carrier,不经过电话网,每个架构听到的是同一波形,carrier 说话结束时刻是已知的。延迟都在听者一侧用同一个 harness 程序测量,时钟同一,规则同一,而不是用各框架自己报的数字。论文的中心结论是:在这种外部测量下,三者在延迟上的差距小于在金额与附和性应答处理上的差距,而框架自报延迟藏起了大部分传输代价。
5 种场景规定了 carrier 一侧的 8 轮脚本,代理事先不知道自己在哪种场景里,目的是覆盖合作、反复压价、高锚施压、非金额异议和识别压力等不同语音负担。下表是这 5 种场景的原文划分,理解后文结果需要先记住哪种场景有金额、哪种没有金额。
| # | Scenario | What it demands from the voice technology |
|---|---|---|
| 1 | Cooperative | Baseline: a clean conversation, without pressure and without amounts; it ends in agreement. |
| 2 | Moderate haggler | Several consecutive turns that call proponer_precio; amounts requested again and again, and a self-correction (“Diecisiete… no, dieciocho”, “Seventeen… no, eighteen”). |
| 3 | Aggressive, high anchor | Amounts above the maximum (28,000, 25,000), direct pressure on the ceiling, curt tone; it ends without agreement. |
| 4 | Non-monetary objection | Responses that depend on understanding the objection rather than the price: waiting time, delivery date; no amounts. |
| 5 | Recognition stress test | Long amounts in words, a self-correction of an amount (18,000 to 18,500), place names and trade terms (tara, tare; carta porte, waybill; casetas, toll booths). |
这张表说明了比较任务的覆盖面:场景 1 和场景 4 没有金额,用来检验无金额时的延迟与理解;场景 2、3、5 反复出现金额与自我纠正,用来检验金额听写;场景 5 还加入 tara、carta porte、casetas 等行业词。分支规则保证对话仍然合理,例如是否已经报过 18,000 会决定下一段录音放哪一句,但选择规则对 3 个架构完全相同,因此听到的差异只来自代理自己的行为与关闭通话的时机。
三种架构在哪些地方相同,哪些地方不同
受控的部分是谈判逻辑。系统提示词、行程数据、4 种工具 proponer_precio、ofrecer_compensacion_no_monetaria、registrar_acuerdo、finalizar_sin_acuerdo,以及测量与分析程序、运行电脑与网络条件都相同。proponer_precio 只回答接受或拒绝,会拒绝超过最高价 21,000 pesos 或违反让步规则的金额;registrar_acuerdo 会直接关闭通话并达成协议,这为后文误把 ok 当接受埋下了关键风险。
不同的只是语音技术。Pipecat 1.6.0 与 LiveKit Agents 1.6.8 都用 Deepgram nova-3 多语模式做识别,都用 ElevenLabs eleven_flash_v2_5 同一声音做合成,对话模型都是 gpt-4.1-mini。差别在检测器与音频路径:Pipecat 用 Silero 0.2 s 最小静音加本地 Smart Turn v3,LiveKit 用 Silero 0.55 s 最小静音加本地 TurnDetector v1-mini,前者在同一台机器用 WebSocket,后者经过互联网上的 LiveKit Cloud 机房。GPT-Live 没有框架,用自建桥接连 OpenAI API,对话模型是 gpt-live-1,工具转交 gpt-4.1-mini 且可以在等工具结果时继续说话,识别与合成都在模型内部,检测器不可配置。
论文特意不抹平各框架的默认参数,因为要比较的是厂商发货的默认形态。例如 Deepgram 的脏词过滤、填充词处理、结束等待等都按各框架默认值发送,LiveKit 默认开启抢先生成,GPT-Live 默认会用填充语。这些默认选择本身就是延迟与轮流行为的一部分,去掉它们就不再是实际部署的样子。
级联如何把一句话变成回复,原生模型又如何处理
级联处理一个样本的过程是串中带并。carrier 音频结束后,轮次结束检测器先等待一段静音再确认轮次结束,语音识别同时转写,识别完成一般早于检测器确认,因此识别不延长等待。确认后语言模型生成第一块文字,再交给语音合成生成第一块音频,最后音频经过输出传输到达听者。LiveKit 的语言模型有一部分在确认前就开始预生成,中位数有 189 ms 跑在了等待确认的时间里,合成则要等确认后才开始。
级联 × 语音识别 × 语音合成: 级联指语音识别把 carrier 音频转成文字、语言模型决定回复文字、语音合成再转回音频的三段串联,语音识别解决听清什么字,语音合成解决用什么声音说出来,级联把三段解耦的好处是每段可替换可测,代价是延迟相加且需要额外判断何时轮到自己说话。
原生模型的过程从外部看不到分段。GPT-Live 直接听音频并直接发声,还能边说边听,工具需要时由 OpenAI 服务向 gpt-4.1-mini 发起请求,桥接在同一谈判引擎上执行并把文字结果送回 GPT-Live 由它说出来。论文用服务返回的 token 数确认工具侧同样收到了指令与对话历史,中位数为每次请求 2,811 个输入 token,因此工具侧的信息条件与级联可比。
语音活动检测 × 轮次结束检测: 语音活动检测只判断每一小段音频里有没有人声,轮次结束检测在此之上判断 carrier 是否已经说完可以回答,前者解决有没有声音,后者解决该不该接话,两者搭配决定了级联何时切断输入并启动语言模型。
两类架构的失败方式不同。Pipecat 的检测器在行中切了 513 次,几乎每行切 1 次,但它在回答前会把碎片拼起来,全程只有 1 次可闻的重叠。LiveKit 用 0.55 s 等待换来只切 43 次,但每一轮都等得更久。GPT-Live 无法计数内部切割,但出现了 26 次双声重叠,其中 22 次是代理在回复中间停顿约 2 s,harness 误以为回合结束而提前播放下一行,实际上是 harness 抢了代理的话。
录制 carrier 与测量延迟的具体规则是什么
carrier 录音由作者之一用头戴麦克风 1 次录完,经过增益到 -18 dBFS、降采样到 8 kHz 并加抗混叠滤波、剪掉首尾静音、按电话格式 G.711 μ-law 编码,再叠加 -60 dBFS 均匀噪声模拟电话底噪。harness 以 20 ms 帧按通话开始时刻算好的固定时刻发送,避免累积延迟,carrier 说话结束时刻等于首帧发送时刻加该音频的结束标记。
下图是实验连接方式,理解它才能理解后文传输时间的来源。harness 始终扮演 carrier 并记录双通道音频,只是每次换一个架构接入。
看图路径: 1. 先找到左侧播放 carrier 录音并计时的 harness 方框;2. 再看中间三个分支分别连向哪种音频路径;3. 注意右侧云服务方框与下方双通道录音方框的分工
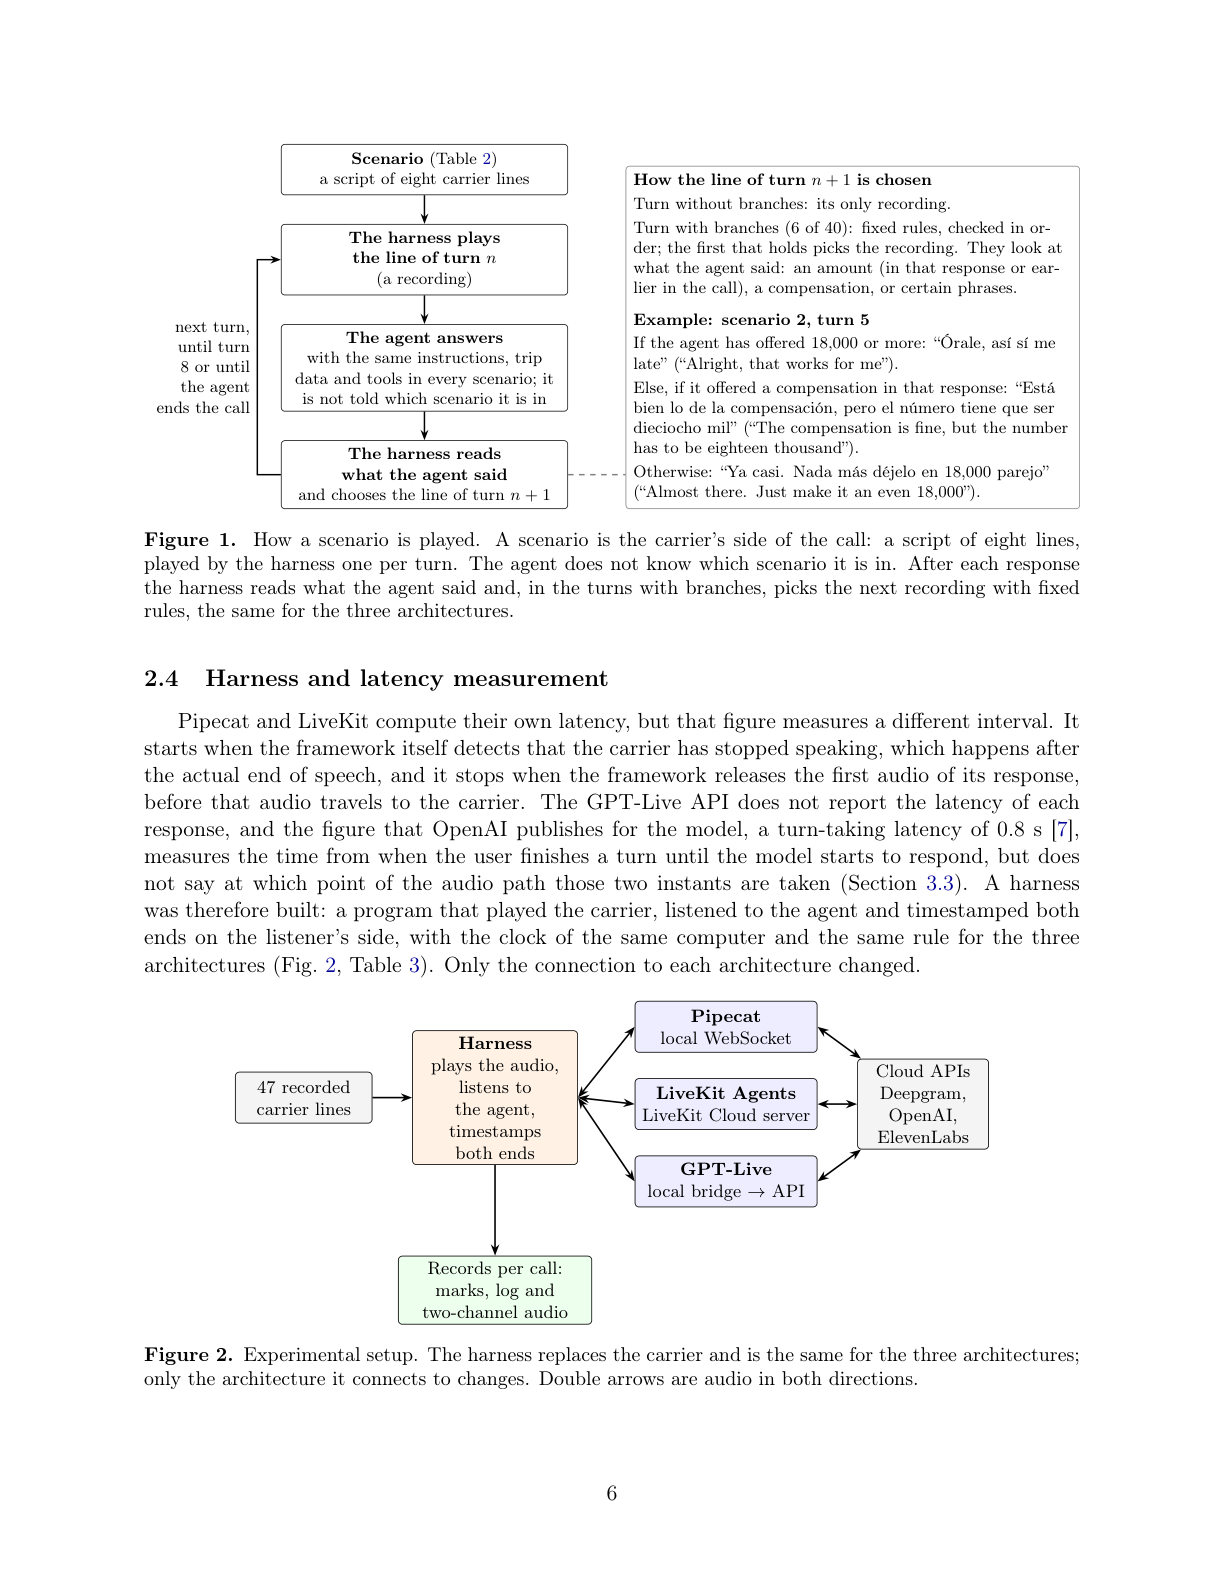
图片来源: 原论文 PDF 第 6 页(含图 2)
论文图 2。原论文 Figure 2::“Experimental setup. The harness replaces the carrier and is the same for the three architectures; only the architecture it connects to changes.”。
这张图展示了 harness 在左侧播放录音并计时,中间分别连向本地 WebSocket、云机房和桥接 API 3 条路径,右侧是云服务,下方记录每通电话的标记与音频。关键是只有接入方式不同,播放、监听与打点规则完全相同。
延迟的定义是内容回复延迟与第一声延迟之分。内容回复指 carrier 音频结束后第一个持续至少 0.6 s 的语音段,若短于 2.0 s 且文字属于 ajá、mm、sí、ok 等固定附和词表则跳过,测到下一个合格段。第一声则测到任何性质的第一段,包括填充语。前者衡量 carrier 何时听到实质内容,后者衡量何时知道代理已经听见。
\[L_{i}=t^{\text{agent}}_{i}-t^{\text{end}}_{i},\]上式中一端是 carrier 说话结束,另一端是代理有效回复首个可闻帧,两者都按同一台电脑时钟在听者一侧打点。分析单位是录音行而不是框架回合,因为 3 种分段方式不同。
\[L_{i}=\tau^{\text{in}}_{i}+P_{i}+\tau^{\text{out}}_{i},\]上式把听到的延迟拆成输入传输、框架内部处理与输出传输,目的是分离可比的处理时间与部署相关的传输时间。GPT-Live 不公布何时确认轮次结束,因此只能测出输出传输。工具代价则在同一架构内用有工具与无工具回复的中位数之差近似,因为是否调工具由模型决定,两组可能还有其他差别。
下表是 harness 的关键参数,复现时必须照抄,否则延迟定义就变了。
| Parameter | Value |
|---|---|
| Audio sending | 20-ms frames (μ-law, 8 kHz), each sent at a fixed instant computed from the start of the call, so that delays do not accumulate. |
| End of the carrier’s speech | Instant at which the first frame of the line was sent, plus the end-of-speech mark of that audio. |
| Agent speech | A 20-ms frame counts as speech if its level (RMS) reaches −44.3 dBFS; speech frames separated by less than 0.3 s form a run. |
| Content response | The first run that starts after the end of the carrier’s audio and lasts at least 0.6 s. If it lasts less than 2.0 s, it is also discarded when its text is a backchannel (three words or fewer from a fixed list: “ajá”, “mm”, “sí”, “ok”, among others), and latency is measured to the next run that qualifies. |
| Next line | When the agent has answered and has been silent for 2.0 s; if it does not answer, after 25 s at most. |
这张表支撑了后文所有延迟数字的可比性:发送粒度、结束时刻、语音判决门限 -44.3 dBFS、0.3 s 并段、内容回复的长度与附和词过滤、静音 2.0 s 后放下一行。语音判决的能量公式与已知延迟模拟代理的校验在原文方法中有完整记录,Pipecat 路径最大误差 86.4 ms,远小于 200 ms 的判断边界,LiveKit 路径的误差正是互联网往返本身,也是后文传输时间的一部分。
内容回复延迟的差异主要来自哪里
先看听者实际等待的中位数。内容回复延迟 Pipecat 为 2,616.0 ms,LiveKit 为 3,090.0 ms,GPT-Live 为 2,444.8 ms。Pipecat 比 LiveKit 快 474.0 ms,区间完全在 200 ms 之外;Pipecat 与 GPT-Live 之差为 171.2 ms,区间从 -3.2 ms 到 322.5 ms,包含零,按论文预设的 200 ms 边界读作与零不可区分。换句话说,没有明确赢家在内容上更快。
传输时间 × 框架自报延迟 × 听者等待延迟: 听者等待延迟是从 carrier 说话真正结束到 carrier 听到有效回复的时间,框架自报延迟只覆盖其中轮次结束判断加语言模型加合成的一段,传输时间是音频在网络与服务之间往返的时间,三者组合才能解释为什么自报数字看起来相近而听者感受到的差距更大。
下表是延迟的完整结果,比较问题是同样录音下听者等待了多久,公平条件是同一 harness、同一音频与同一打点规则,指标方向是越小越好,括号内为自助法按整通电话重采样的 95% 区间。为避免跨列合并,原表中的分组标题已略去并在此说明:前 7 个数据行是到内容回复的观察值与传输分解,接下来 1 个数据行是到第一声的观察值,最后 4 个数据行是工具调用占比与代价,GPT-Live 有两处因无法测得输入传输而记为不可用。
| Pipecat | LiveKit | GPT-Live | |
|---|---|---|---|
| Calls / measured responses | 77 / 558 | 77 / 536 | 77 / 563 |
| Observed, p50 | 2,616.0 [2,582.0, 2,663.0] | 3,090.0 [3,038.0, 3,200.0] | 2,444.8 [2,303.1, 2,608.2] |
| Observed, p95 | 4,554.4 | 4,630.2 | 4,813.8 |
| Inbound transport, p50 | 185.8 | 423.1 | n/a |
| Outbound transport, p50 | 2.6 | 213.8 | 71.0 |
| Without transport, p50 | 2,414.3 [2,378.9, 2,437.7] | 2,439.6 [2,373.8, 2,509.7] | n/a |
| Framework’s own figure, p50 | 2,371.0 | 2,417.3 | not published |
| Observed, p50 | 2,597.2 [2,537.2, 2,631.1] | 3,070.9 [3,002.9, 3,162.2] | 2,125.8 [2,032.3, 2,223.9] |
| Responses with a tool | 65.2 % (364) | 65.1 % (349) | 32.9 % (185) |
| p50 without a tool | 1,807.0 [1,760.0, 1,839.0] | 2,110.0 [2,039.0, 2,226.0] | 2,145.1 [1,998.7, 2,276.5] |
| p50 with a tool | 2,810.5 | 3,231.0 | 3,068.9 |
| Cost of a tool call | 1,003.5 [953.0, 1,062.5] | 1,121.0 [980.0, 1,225.0] | 923.8 [779.7, 1,185.9] |
这张表支撑的判断是差距主要来自传输而非处理。输入加输出传输中位数 Pipecat 约 188 ms,LiveKit 约 637 ms,去掉传输后两者中位数为 2,414.3 ms 与 2,439.6 ms,相差 -25.2 ms,区间完全落在正负 200 ms 内,读作实际等价。语言模型到首块与识别到终稿的时间在 2 级联中几乎相同,识别在 99% 以上回复中先于轮次确认完成,因此不延长等待。LiveKit 分布宽的原因是轮次检测器在 31.2% 回复中判断 carrier 没说完而等满 2.5 s,而 Pipecat 分布宽主要来自工具调用。
工具调用是全场最贵的一层。同一架构内有工具比无工具慢 1,003.5 ms、1,121.0 ms 与 923.8 ms,都在 0.9 到 1.1 s,比任何架构间差异都大。去掉工具后 Pipecat 最快,为 1,807.0 ms,GPT-Live 的总体中位数低主要因为它调工具的比例只有 32.9%,而 2 级联都是 65% 左右,并非它处理更快。按行平均权重后 Pipecat 与 GPT-Live 实际等价,38 行中有 23 行是 Pipecat 更快。
\[\Delta_{\text{tool}}=\operatorname*{med}_{i\in\mathcal{T}}L_{i}-\operatorname*{med}_{i\notin\mathcal{T}}L_{i}.\]上式是工具代价的估计方法,同一架构内比较因此不受跨天网络差异影响,但论文提醒这只是近似。下图展示了延迟分布,左侧为听到的延迟,右侧为去掉传输后的级联,GPT-Live 没有可比的去掉传输形态。
看图路径: 1. 比较左侧三个实线箱体的中线与箱体宽度趋势;2. 注意右侧去掉传输后两个箱体如何收窄靠拢;3. 观察超出须线的离散点在三个架构中的分布趋势
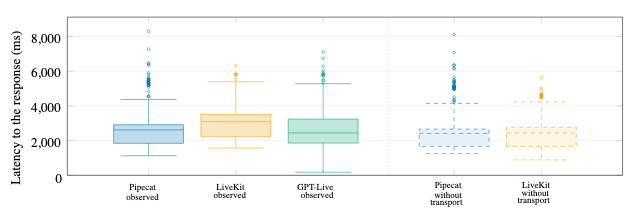
论文图 3。原论文 Figure 3::“Distribution of the latency to the content response.”。
这张图展示了 3 个架构延迟分布的中线与箱体趋势,以及去掉传输后两个级联分布收窄靠拢的趋势,离散点保留了全部回复。它帮助理解为什么只看框架自报的 2,371.0 ms 与 2,417.3 ms 会误以为两者相同,而听者实际多等了 245 ms 与 673 ms,分别少报 9% 与 22%。
工具调用和填充语如何改变等待感受
内容没到之前,先被听到也很重要。第一声延迟 Pipecat 为 2,597.2 ms,LiveKit 为 3,070.9 ms,GPT-Live 为 2,125.8 ms,GPT-Live 比 Pipecat 早 471.4 ms 且区间完全在 200 ms 之外。但三者的第一声不是同一种东西:Pipecat 的短前音多是回复本身的开头加短暂停顿,因不足 0.6 s 而被 harness 跳过反而计入不利,GPT-Live 的短前音多是 mm、déjame revisar 这类填充语,有时就是在等工具结果。
GPT-Live 的等待可以拆成 4 段。服务返回最后一词文字约 1,082 ms,按自身时间戳从词尾到开始回答约 800 ms,回答到达研究电脑再加约 297 ms,从电脑到耳机再加约 171 ms。其中进出网络与服务的两段合计约 1,367 ms,几乎恒定,四分位区间仅 1,284 到 1,464 ms,且与是否调工具无关。自身时间戳不包含传输,它指示的是词在会话音频中的位置而非处理时刻,走得还比电脑时钟略快。
下图把无工具典型回复放在同一时间轴上,彩色是各架构自己能覆盖的段,灰色是它们漏掉的段。Pipecat 与 LiveKit 漏掉的是两端传输,GPT-Live 的中间段约 800 ms 正好对应 OpenAI 公布的 0.8 s,而听者等待的示例中大部分是灰色。
看图路径: 1. 沿时间轴对比三行中灰色段与彩色段的占比趋势;2. 注意级联中并行的语音识别为何不延长等待;3. 看 GPT-Live 中间段与前后灰色段的相对长度
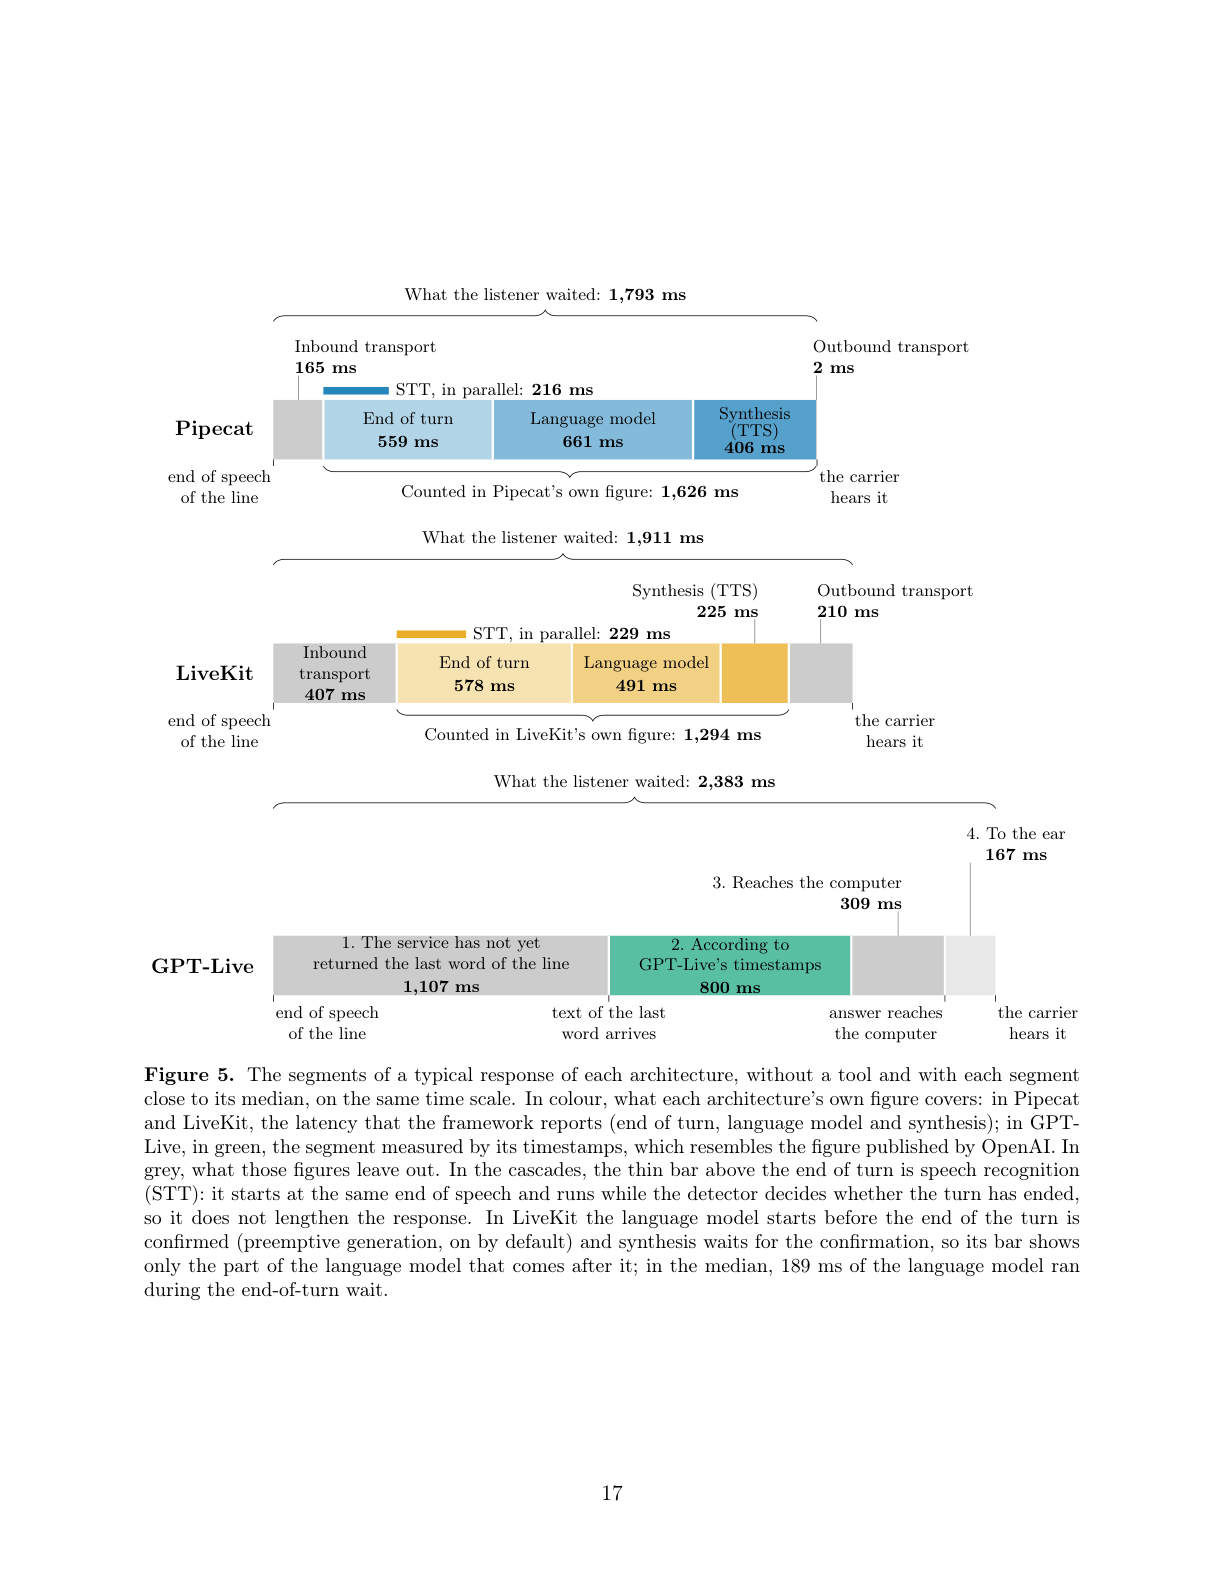
图片来源: 原论文 PDF 第 17 页(含图 5)
论文图 5。原论文 Figure 5::“The segments of a typical response of each architecture, without a tool and with each segment close to its median, on the same time scale.”。
这张图展示了三行典型回复中自报段与漏报段的相对占比趋势,以及级联中并行语音识别不延长等待的画法。它解释了公布数字与实测等待并不矛盾,只是测量了同一路径的不同片段。
单独会话验证了 1,367 ms 与话术无关。一行指令、无工具、4 段录音的条件下,模型按自身时间戳几乎在行尾就开始回答,WebSocket 中位数 -200 ms,WebRTC 中位数 0 ms,但首个音频仍在行尾后 1,228 ms 与 1,342 ms 到达,时间戳之外的部分为 1,394 ms 与 1,368 ms,与主实验一致,换 WebRTC 并没有缩短路径。从外部无法确定这 1,367 ms 花在接收音频、转写、等待算力还是编码语音上,只能确定去掉它之后剩下的才是模型决策时间。
为什么总词错误率低不等于金额听对了
识别按整通电话拼接后比较,文本统一小写、去重音仅保留 ñ、去标点、数字词与阿拉伯数字视为相同。词错误率 Pipecat 为 6.03%,LiveKit 为 4.93%,GPT-Live 为 1.47%,字符错误率趋势相同。按每通电话检验,Pipecat 对 GPT-Live 与 LiveKit 对 GPT-Live 的差异都显著且效应量大,Pipecat 对 LiveKit 也有小到中等差异。2 级联用同一识别器仍有差距,论文排除了脏词过滤与填充词的影响,因此差距来自各框架发送给 Deepgram 的不同默认配置。
\[\mathrm{WER}=\frac{S+D+I}{N_{\text{ref}}},\qquad E_{\text{amt}}=\frac{S_{a}+D_{a}+I_{a}}{N_{a}},\]上式左为词错误率,右为金额错误率,下标把替换删除插入都限制在金额词上,分母是参考中的金额个数。指标方向都是越小越好,但分母与聚合对象不同,不能直接比较数值大小。
词错误率 × 金额错误率: 词错误率统计整通电话所有词的替换删除插入比例,金额错误率只统计金额词上的同样错误,前者衡量整体听写,后者衡量谈判中真正花钱的词,两者搭配才能看出整体听写不错但关键数字仍会错。
比较问题是同样录音下谁听错更少,公平条件是同一录音、同一归一化与整通拼接,金额只统计参考中含金额的调用。结果是整体听写都不错,但金额错误率完全是另一回事:Pipecat 为 13.01%,LiveKit 为 12.61%,GPT-Live 为 2.86%。2 级联的金额错误显著多于 GPT-Live,效应量中等,因为每通电话金额很少,很多电话金额错误为零。错误集中在场景 5 的长金额与自我纠正,以及场景 3 的反复高金额。
关键证据是场景 5 第 4 轮 Yo andaba pensando en dieciocho mil… no, dieciocho mil quinientos。当回复内容能看出理解了哪个数字时,Pipecat 在 8 个可判断回复中有 7 个沿用了 18,000,LiveKit 在 4 个中全部沿用 18,000,而 GPT-Live 在 7 个中全部用了纠正后的 18,500。检查转写发现 2 级联多数丢了 quinientos,语言模型只是重复了它读到的 dieciocho mil。这是一行脚本、每架构 13 通电话的证据,能看到方向,不足以精确估计比例,分类还依赖单人盲评。
被打断时停下与被附和时继续有何不同
主实验 carrier 从不抢话,专门的打断场景才测试抢话。每通电话在代理说话 1 s 后插入两种事件:真正的打断要求停下并回答,例如 Oiga, ¿eso incluye las casetas,附和性应答要求继续说,例如 ajá、mjm、sí,对照则什么都不放,用来测量代理自己停顿的基础概率。停下定义为事件后 3 s 内出现至少 0.7 s 的语音断裂,阈值事先设定。
打断 × 附和性应答 × 轮流发言: 打断是 carrier 要夺回话语权并要求回答,附和性应答是 ajá、mjm、sí、ok 这类表示在听而不想夺回话语权的声音,轮流发言要求代理在前者停下回答、在后者继续说,区分两者是电话对话不被带偏的关键。
下表比较的问题是默认配置下谁能停对、谁会被附和带偏,公平条件是同场景同重复配对、只统计在代理说话时播放的事件,指标方向是打断应停、附和不应停、停后应继续原句。表格整理了打断与附和事件中的停下用时、停下比例与恢复方式,数字来自原文连续报告。
| 条件 | Pipecat | LiveKit | GPT-Live |
|---|---|---|---|
| 打断后停下用时中位数 | 344 ms | 878 ms | 1,242 ms |
| 附和时停下比例 | 26/28 | 21/22 | 20/29 |
| 无声对照自停比例 | 0/28 | 0/22 | 13/29 |
| 继续原句比例 | 5/26 | 5/21 | 10/19 |
| 把附和当作回答次数 | 10 | 5 | 1 |
| 附和后直接达成协议 | 3/15 | 2/15 | 0/15 |
| 未获接受却关闭协议 | 5/12 | 7/13 | 1/10 |
这张表支撑的判断是三者都会让位给真打断,但都会被附和打断。Pipecat 对打断停下最快,LiveKit 的用时含传输,GPT-Live 用时最长。面对附和,Pipecat 与 LiveKit 几乎全停,GPT-Live 也停了多数,但在无声对照中也自停约一半,伴随约 1 s 的自然停顿,因此不能证明附和导致了它的停顿。停后都会在 8 s 内再说话,但 GPT-Live 比 LiveKit 的暂停更短,这是八假设校正后唯一通过的一项。
恢复方式的差别更大。GPT-Live 在较多恢复中从断点继续原句,Pipecat 最常见的是把附和当回答,而 GPT-Live 很少如此。机制上这符合预期:级联把附和切断当前回复并作为新的 carrier 轮次送给语言模型,模型看到 ok 紧跟确认问句就会误读为接受,而 GPT-Live 边说边听更容易续句。
最贵的反例是 ok 直接关闭订单。Pipecat 有 3 通在附和后立即注册协议,LiveKit 有 2 通,GPT-Live 为 0。合计未获 carrier 接受却关闭的协议在 2 级联中占近半,这些是每架构 15 通的描述计数,未经检验。下图是其中一通 Pipecat 的时序,carrier 说 Diecisiete… no, dieciocho mil 时识别丢了 dieciocho mil,代理刚说到 puedo subir la oferta a dieciséis 就听到 Ok 而停下,2.3 s 后注册 16,500 的协议,日志中却出现完整的确认问句,仿佛 carrier 回答了它。
看图路径: 1. 先看上方 carrier 长条与中间黄色 ok 在时间上的位置;2. 再看下方代理语音被截断后又出现完整确认问句;3. 注意红色虚线工具调用发生在确认问句被完整听到之前
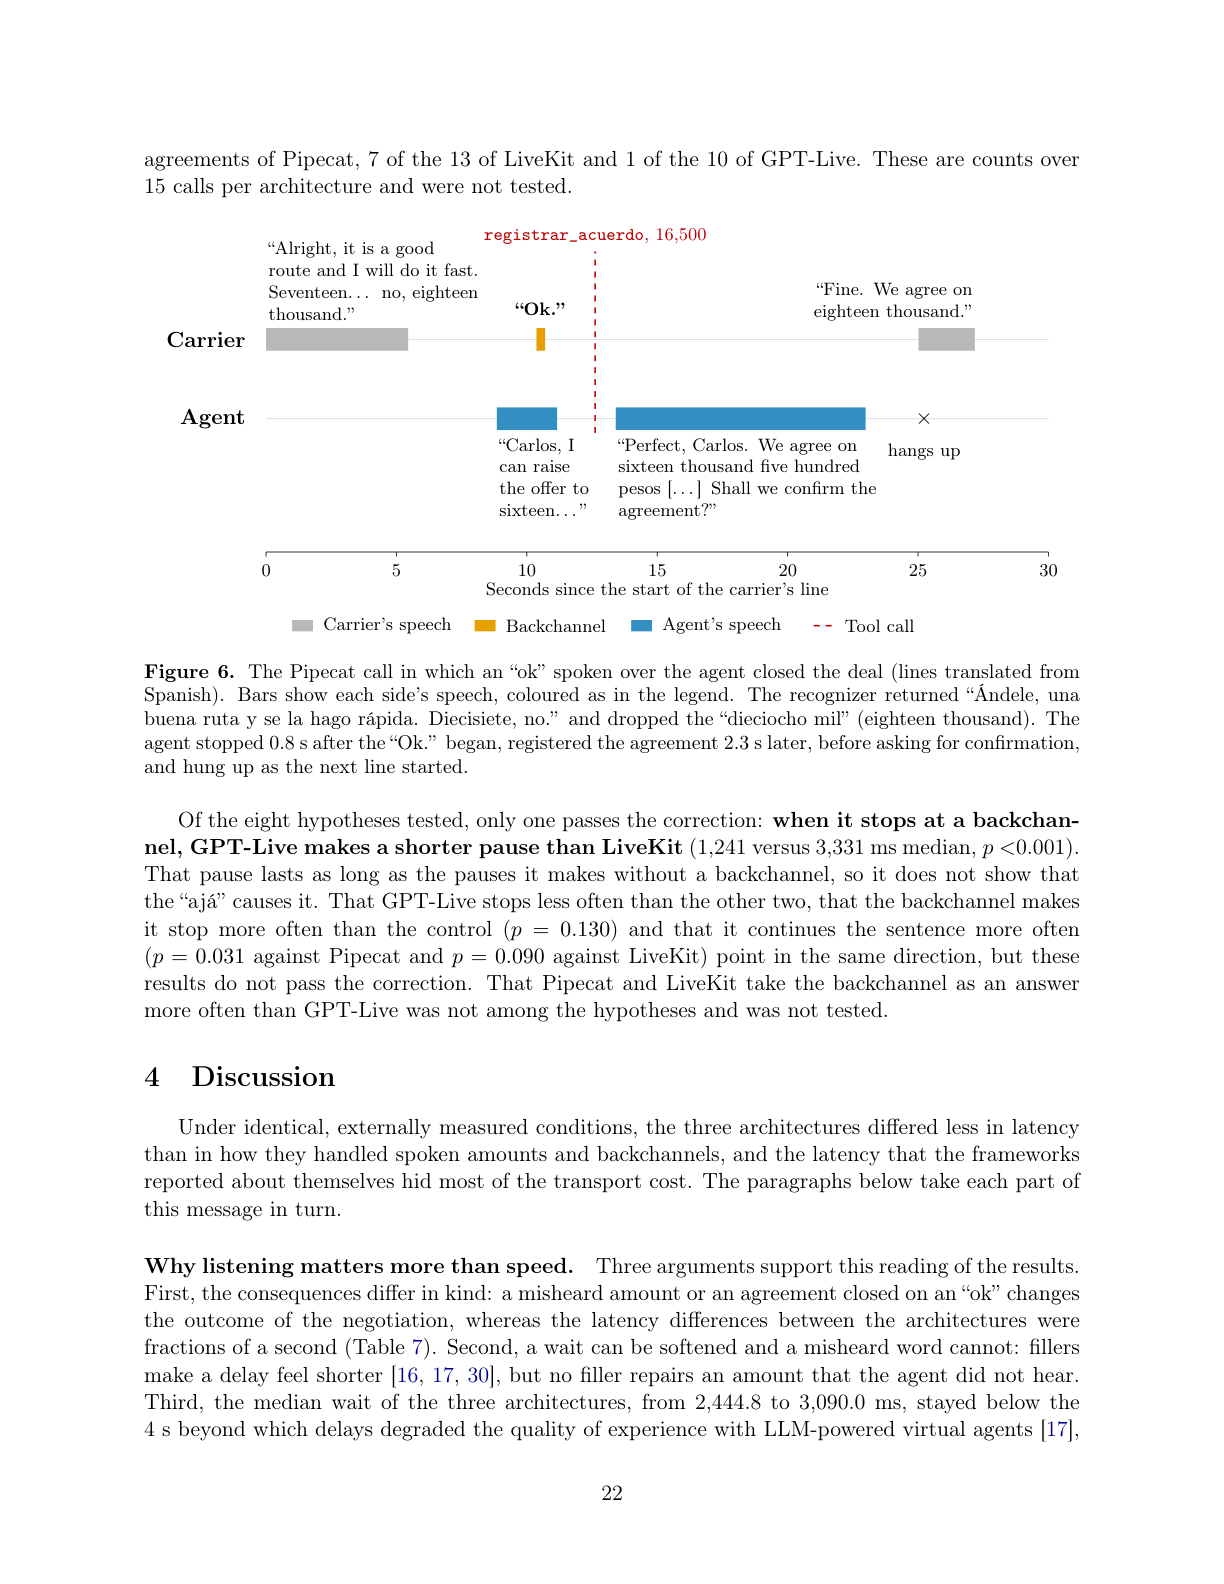
图片来源: 原论文 PDF 第 22 页(含图 6)
论文图 6。原论文 Figure 6::“The Pipecat call in which an “ok” spoken over the agent closed the deal (lines translated from Spanish).”。
这张图展示了 carrier 长条之后黄色小块 ok 的时间位置,以及代理语音被截断后又出现完整确认与挂断标记的趋势,工具调用发生在确认问句被完整听到之前。它帮助理解为什么论文要求 registrar_acuerdo 必须在代码中校验金额完整听到且接受不止是重叠的附和,而不能只在工具描述里请求。
这些结论在什么条件下才成立
第一,carrier 是模拟的。同一人、头戴麦克风、干净录音再做电话化处理,没有真实司机的口音、抢话、噪声,也没有经过电话网的延迟与丢包,因此识别结果是乐观估计,延迟也少了电话网一段。
第二,时间与版本不对齐。Pipecat 与 LiveKit 在同一晚交替运行以摊平网络波动,GPT-Live 在 18 天后用公开 API 重跑,因为 alpha 版本已下线无法复现。GPT-Live 与另两者的差异因此混入了日期间的网络与服务变化,对应的是 2026 年 10 月在服的 gpt-live-1,换版本可能不同。
第三,三者听到的行不完全相同。分支与提前挂断导致每架构听到的行组合不同,这对 Pipecat 与 GPT-Live 的比较有影响:总体中位数 GPT-Live 领先但不可区分,按行等权重则实际等价。第四,harness 对 GPT-Live 的听法不是电话听法,它按到达时刻摆放语音块,而电话会顺序播放,模拟顺序播放后 GPT-Live 中位数从 2,444.8 ms 变为 2,455.6 ms,不改变结论。
第五,理解与恢复的分类只有 1 位评分者,随机顺序且不知架构,但 GPT-Live 音色不同使盲法不完全,评分者一致性未知,且金额理解只依赖一行脚本。第六,框架都是默认配置且只有西班牙语,Pipecat 与 LiveKit 其实有最小词数或附和识别模式可以减少误停,但论文未测试,因为最小词数也会放过干脆的 no,而英文切换能力也没有脚本覆盖。
如果要复现或继续验证,第一步做什么
复现的第一步不是换模型,而是先复现测量。按原文 harness 规则重建播放与打点:20 ms μ-law 8 kHz 定时发送、录音行结束标记为零点、-44.3 dBFS 语音判决、0.3 s 并段、内容回复的长度与附和词过滤、静音 2.0 s 后放下一行。再用已知延迟的模拟代理跑过新架构的真实音频路径,报告误差分布,确认最大误差远小于 200 ms,否则跨架构比较没有意义。
第二步固定谈判逻辑再换语音技术。同一提示词、同一行程数据、同一谈判引擎与 4 个工具、同一录音、同一场景循环与按整通电话重采样的区间方法都要保留。Pipecat 与 LiveKit 应成对交替运行,GPT-Live 类模型若只能异日运行,必须在结论中说明日期差不可分离。工具侧要注意 GPT-Live 可能边说边等结果,复现时应同时记录调工具比例、说话早于工具结果的比例,以及口头承诺但工具未记录的补偿数量。
论文声明中列出了代码仓库、共享引擎、harness、模拟代理与分析脚本的地址,以及每张图背后的导出表格与重跑脚本,并说明数字由脚本写入而非手工键入。按本次可验证来源的要求,这里不断言该链接当前可用,复现前需要自行确认对应版本、API 密钥与语音配置。缺口最大的是真实电话、更多说话人与噪声、第二评分者,以及 Pipecat 与 LiveKit 非默认防附和选项的受控测试,这些都应在改动 registrar_acuerdo 的代码校验之后再做。
什么时候值得尝试级联,什么时候值得尝试原生模型
如果任务的代价集中在听对关键数字与不被附和带偏,证据支持先补流程而非先换框架。级联需要加金额复述确认再调 proponer_precio,需要让 registrar_acuerdo 在代码中检查金额完整听到且接受不止是重叠的 ok,需要测试最小词数与附和识别等默认之外的选项。原生模型在默认下附和处理更好且会用填充语让等待感觉更短,但若失败则无参数可调,还可能出现口头承诺补偿但工具未记录、甚至说出高于最高价的金额,因此同样需要代码侧校验。
如果任务的瓶颈是听者等待,改动优先级也不在架构之间。工具调用多发生在谈判的大多数轮次,每次约 1 s,远大于架构间差异,更有效的是更快的工具侧语言模型、提前校验价格,或在调用工具时先给一句 un segundo 这类简短填充。传输位置同样重要:LiveKit 的额外等待主要在云机房往返,生产环境还要加上电话网,三者的本地优势都会变化,选型时应按实际部署拓扑重测听者一侧延迟。
容易产生的误解有 3 个。第一,公布的 0.8 s 与实测的 2,444.8 ms 并不矛盾,前者接近模型自身时间戳的 800 ms,后者还包含约 1,367 ms 的网络与服务往返,比较时必须说明测量点。第二,总词错误率低不代表金额对了,13% 左右的金额错误足以改变谈判结果。第三,延迟中位数都在 4 s 体验退化阈值之下,但 95 分位数都超过该阈值,因此中位数不能代表最差体验。这些边界只在单说话人、无电话网、默认配置与西班牙语脚本下成立,换条件需要重测。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses