📄 声音重要吗?已部署临床语音电话中的挫折感检测
英文题目:Does the Voice Matter? Evaluating Frustration Detection on Deployed Clinical Voice-Agent Calls
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.9/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Annika Michael:Ufonia Limited;London, UK
- Zachary Ellis:Ufonia Limited;London, UK
- Yuxiang Zhou:Ufonia Limited;London, UK
- Samuel Thio:King’s College London;London, UK
- Yajie Vera He:Ufonia Limited;London, UK
- Spencer Hazel:Newcastle University;Newcastle upon Tyne, UK
- Jared Joselowitz:Ufonia Limited;London, UK
📌 核心摘要
这项工作研究已部署临床语音代理通话中的逐轮挫折判断,输入是患者单轮的电话语音或其转写文本,输出为挫折或无挫折的二分类标签。难点在于真实患者轮次很短,词量几乎不携带情感词汇,而可判读的语气、停顿和紧张感只保留在声音中,转写链路会丢弃这部分信息。研究先收集真实通话并由三位标注者独立标注,以多数票确定标签,同时构造长度分布匹配的表演语料作为对照。再在相同轮次上对比仅文本条件和直接音频条件,模型在零样本下分别根据文字措辞或声音表现给出标签和理由,同一组合重复三次,多数票决定最终预测。最后用冻结语音编码器表示训练探针,探针指在冻结表示上训练的轻量分类器,用于检验表示中是否含有可线性读出的挫折信号,以呼叫为单位交叉验证。在150轮临床轮次的对话不相交评测上,冻结WavLM表示加支持向量机探针的ACC为70.0%,高于词数基线的58.0%。在30通共714轮、其中140轮为挫折的临床通话上,前沿模型对文本放行轮中实为挫折的占比为13.0%,高于音频条件的6.9%,单字挫折轮几乎全被文本漏掉。原文未披露训练、推理或部署成本。结论限于单条眼科随访路径的英语电话语音,长轮与多轮对话的推广尚未验证。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
临床语音电话为什么需要自动分诊挫折感
这类电话由自主语音智能体打出,做的是眼科术后的常规随访。没有人力能逐通复听全部录音,所以必须有自动分诊决定哪些通话需要人再看。挫折感是其中一个可行动的状态:患者可能回答越来越短、直接挂断,关键的病情信息还没说出来。
已有部署是级联式的:先把语音转成文字,再让语言模型只读文字推理,最后合成回复。迟疑、紧绷、停顿这类表达方式在转写一步就被丢掉了。转写文本是今天系统实际在用的东西,声音是如果把表达方式留下来本可以用的东西。本文要回答的不是通用情绪识别,而是这套只读文本的做法在真实临床短对话里会不会漏掉挫折感。
对刚入门的读者,先建立输入输出观:输入是一通电话里切出的每一轮病人说话,可以是音频片段,也可以是它的转写文字;输出是二选一,frustrated 或 not_frustrated;必须保留的信息包括词和语气,丢掉任何一边都可能改变结论。人工标签是 3 位标注者各自独立听上下文后多数投票,另有 inconclusive 留给音质太差或确实无法判断的轮次。
已有研究在哪些条件下比较过文字和声音
语音情绪识别的证据大多来自表演和朗读。IEMOCAP 仍是参考集,加上 RAVDESS、CREMA-D 和 MSP 等,都是在录音室按类别、高唤醒 elicited 的表演语音。WavLM 这类自监督语音编码器本身也是在这类集上测情绪识别。合成和重读的评测把标签体系做大,但与人类评分的一致在高唤醒之外会掉。
另一条线发现音频大模型在词与语气冲突时会退回看词。VoxParadox 和 LISTEN 报告当情感主要由表达方式承载时模型会失败,部署系统也被发现漏掉窘迫和反讽。Hear2Act 说明信号存在但没被用好,先让模型用文字描述状态再行动会明显变好。不同模型对音频的依赖程度也不同。
本文与它们的可比点要对齐输入、目标和运行阶段:同样是判断挫折感、同样是二分类、同样在推理时给单轮。不同的是来源和长度。以往用表演、合成或对抗语音,很少把轮次长度当解释变量,也很少在真实部署的临床通话上同时比较文本和直接音频。最接近的临床邻居各缺一角:有的比较音频文本融合但病人语音是表演的,有的用真实临床音频但是朗读且只做音频预测,有的用真实白内障通话但只研究了转写文本。本文补的是真实部署通话上的同一轮次对照。
要判断的是一轮病人说话是否挫折
任务是逐轮二分类:对每一轮病人发言判为挫折或不挫折。难在临床对话里病人说话极短,词证据很少,但语气还在。一个词可以承载相反状态,文字本身无法区分。
先看一个贯穿全文的最小例子:同样一句关于眼睛疼痛频率的回答,在不同通话里被标成相反结论,读文字只能放行两轮,听语气才可能分开。这正是短轮次下文本系统的结构性盲区。
转写文本 × 直接音频: 转写文本指语音转文字阶段输出的词序列,是当前分诊实际在用的输入,只保留说了什么;直接音频指同一轮次截出的原始通话录音,还保留语气、停顿和紧张程度。两者分工不同:前者便宜且已有,后者是如果保留表达方式本可以用的信息,本文所有比较都是同一轮次在这两种输入下的对照。
下图是两通真实通话的对照,病人末句文字相同但人工结论相反,转写片段为原文逐字引用。
看图路径: 1. 对比左右两通电话中病人最后一句的文字是否完全相同;2. 看左侧红色与右侧绿色标签分别表示哪种人工结论;3. 想一想只看文字的系统会对这两轮给出什么相同判断
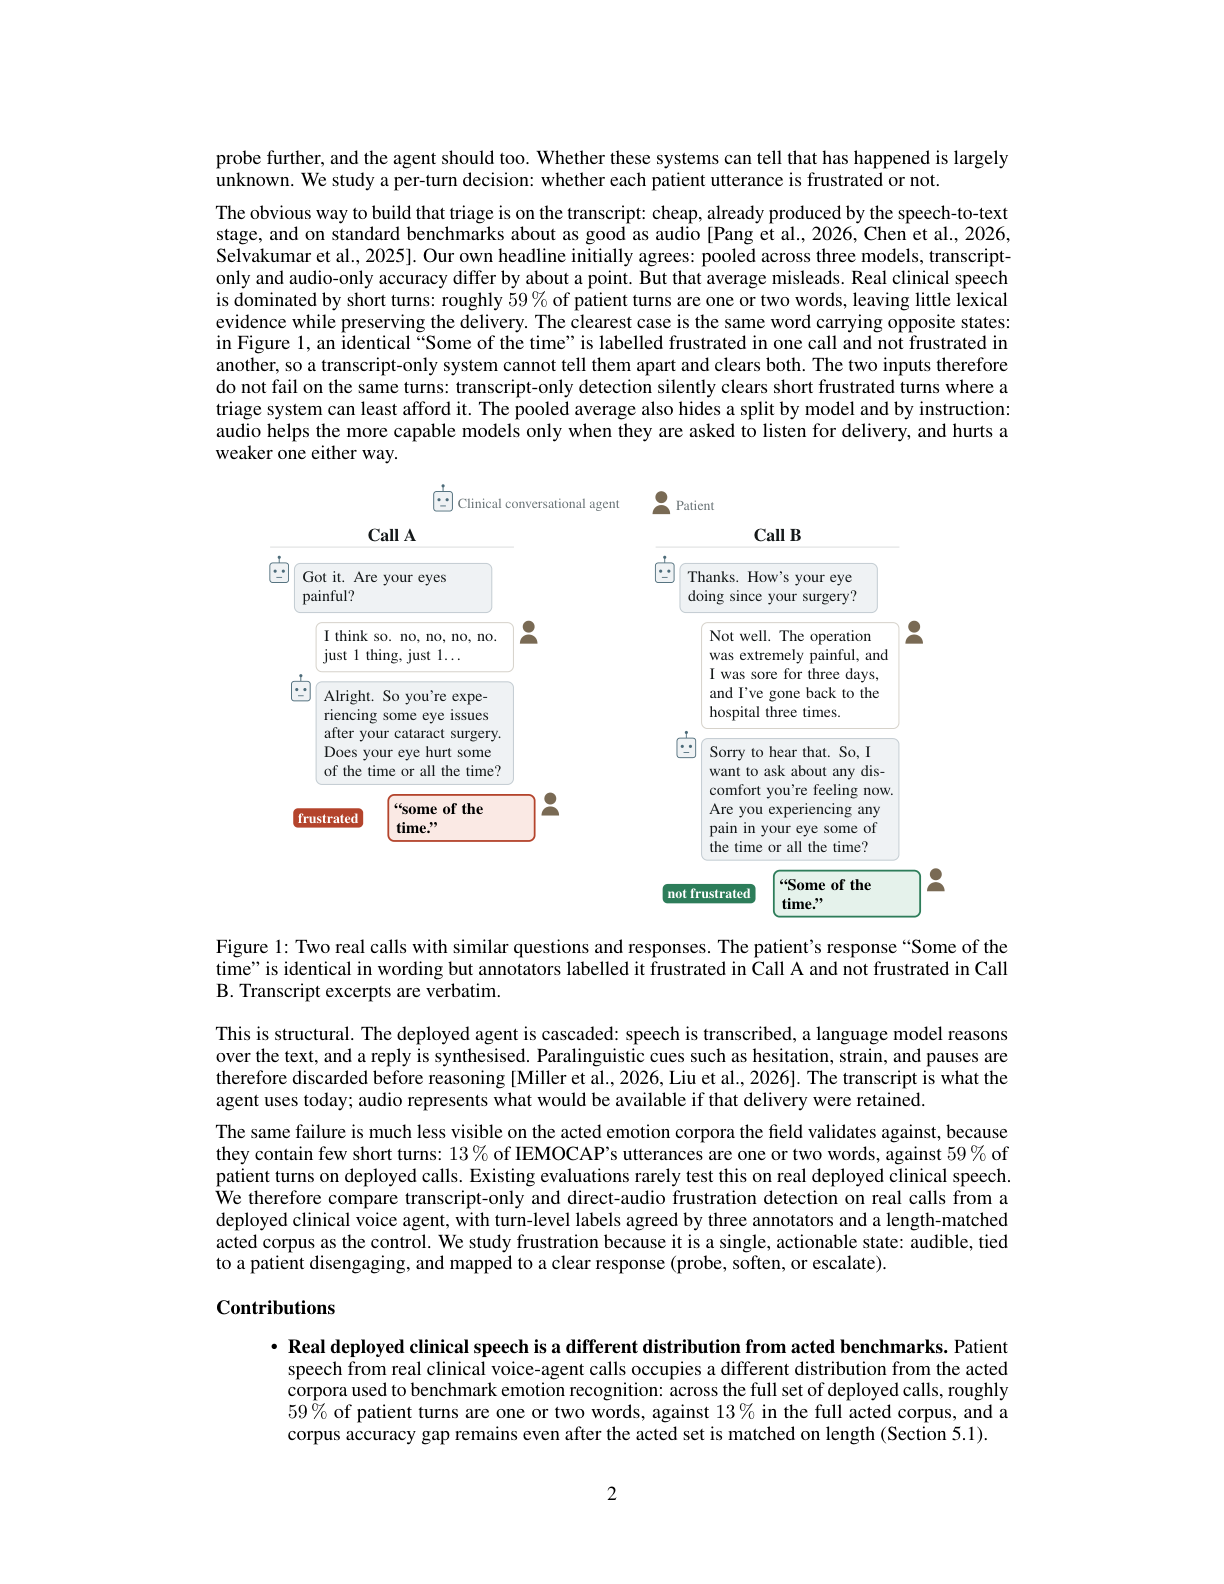
图片来源: 原论文 PDF 第 2 页(含图 1)
论文图 1。原论文 Figure 1::“Two real calls with similar questions and responses.”。
这张图确实可见的是左右两栏各为一通电话,蓝色为智能体问句,病人回答在下,左侧末句标为挫折,右侧末句标为不挫折。它帮助理解后文所有短轮次比较:当文字相同时,差异只能来自声音或上下文,而本文给模型的恰恰是孤立单轮,所以文本条件注定无法区分这类例子。
同一轮次如何被做成两种输入并送入模型
整体流程沿一个样本走一遍更清楚。一通 8 kHz 电话录音先按说话人切出病人轮次,得到音频片段和对应的转写文字。同一轮次被呈现两次:一次只给音频片段,一次只给转写文字。模型每次只看当前轮次,看不到标注者能听到的前后轮,只有加上下文的对照实验才额外给前文。
提示写法是关键变量。输入针对性提示让音频侧听语气语速停顿,让文本侧只看用词;相同指令则两边逐字一样,只在末尾接音频或接文字。每个模型、每种输入、每轮各跑 3 次,取 3 次多数作为该轮预测。评价用平衡准确率为主,另看一词轮次的召回和自信放行的质量。
下图展示为什么必须先看长度分布:左侧 2073 通真实临床通话通篇被 1 到 2 词的浅色条带占据,右侧 151 个 IEMOCAP 对话则深色长轮次密集得多。这说明两类语料不是同一分布的两次采样,基准集的验证不能直接搬到部署长度上。
看图路径: 1. 对比左右两幅热力图中浅色短轮次条带的密度差异;2. 看底部各类长度占比条中 1 词轮次在两类通话中的份额;3. 注意横轴从通话开始到结束短轮次是否贯穿全程

论文图 2。原论文 Figure 2::“Distribution of word counts across over 2000 clinical conversations.”。
这张图确实可见的是左右两幅从通话开始到结束的逐轮长度热力图,底部给出各类长度占比,真实临床 1 到 2 词占 59 %,表演集只占 13 %。它为后文的长度匹配对照提供动机:如果直接比较总体准确率,差异可能只是长度不同,而不是临床与表演的本质差异。
数据、标注、模型调用和统计如何对齐
数据有两块。临床部分来自同一眼科路径的已部署电话,从 2000 多通中按低满意度和明确不想与自动医生说话等筛出可能含挫折的通话,只用已同意研究用途的录音。核心是 6 通电话的 150 轮,3 位标注者全标,75 轮挫折、75 轮不挫折,机会水平就是 50 %。对照是同样 150 轮的表演集,按临床长度轮廓重建并经同样 3 人重标,76 轮挫折、74 轮不挫折。扩展是再加 24 通由标注者 1 单人全标,去掉 inconclusive 后剩 564 轮,其中 65 轮挫折占 11.5 %,与前 150 轮合计 714 轮、140 轮挫折占 19.6 %。
平衡准确率 × 召回率: 平衡准确率是挫折与非挫折两类各自判对比例的平均,方向是越高越好,在类别不平衡的短轮次分桶里比普通准确率更公平;召回率是标为挫折的轮次中被实际标记出来的比例,回答的是有没有发出警报。两者搭配才能看出系统是判得准还是根本不报警。
模型调用方式需要原样交代,否则复现会对不上。下表是 5 种模型的标识、访问方式、权重与采样设置,温度均为 1.0 且不做贪心解码,3 次重复的波动用多数投票吸收。
| Model | Identifier | Access | Weights | Sampling |
|---|---|---|---|---|
| Gemini 2.5 Flash | gemini-2.5-flash | Vertex AI | – | temperature 1.0 |
| Gemini 2.5 Pro | gemini-2.5-pro | Vertex AI | – | temperature 1.0 |
| Gemini 3.8 Flash | gemini-3.8-flash | Vertex AI | – | temperature 1.0 |
| Qwen2.5-Omni 7B | ggml-org/Qwen2.5-Omni-7B-GGUF | llama.cpp | Q8_0 | temperature 1.0 |
| Voxtral Mini 3B | mistralai/Voxtral-Mini-3B-2507 | Transformers | bf16 | temperature 1.0 |
这张表支撑的判断是模型比较的公平条件:3 个 Gemini 经 Vertex AI 调用,两个小开源模型本地运行,采样温度一致,音频均以 WAV 片段不重采样送入。它的限制是只覆盖调用层面,不说明提示词和切轮质量,提示差异的影响要到消融节单独看。读者拿它对照的是后文音频与文本差异究竟来自模型还是来自运行方式。
标注质量的另一面是无法判断的轮次。下表给出 6 通电话 224 轮病人发言中每轮有几票 inconclusive,以及多数投票后如何得到 75 轮挫折、130 轮不挫折并排除其余。
| Inconclusive judgements per turn | |
|---|---|
| None | 183 |
| One | 28 |
| Two | 9 |
| Three | 4 |
这张表说明 183 轮零票无法判断、28 轮一票、9 轮两票、4 轮三票,最终排除 13 轮多数无法判断和 6 轮无多数。它支撑的是 150 轮平衡集不是随意丢弃,而是从有多数结论的轮次中抽出。限制是 24 通扩展集只有单人标注,没有一致性估计,跨集比较时要把标注来源差异记在心里。
统计上 6 通部分用轮次自助,30 通部分改用整通自助,因为同通轮次不独立。单轮平衡准确率给 Wilson 区间,音频减文本给 10000 次自助区间。另有只用词数的逻辑回归基线和 WavLM 冻结编码器探针,前者检验预测是否只是跟长度走,后者检验训练能否替代提示。
短轮次上只看文字为什么会塌到偶然线
先看总体再看短轮。3 个模型在临床通话上都低于表演集,3 个模型平均差 -8.1 个百分点,区间 -15.6 到 -0.8;两个前沿模型平均差 -8.7 个百分点。把表演集音频过一遍 8 kHz、300 Hz 到 3400 Hz 带通加 μ 律电话链,2 个模型的音频准确率只从 83.3 % 到 82.2 %、从 80.0 % 到 83.3 %,方向还相反,所以信道带宽解释不了差距。长度匹配后总体仍差约 8 个点,说明不只是长度问题,但到一词轮次差距消失,两集文本都塌了。
一词轮次是本文证据最集中的桶。临床 47 轮、表演 41 轮里,没有任何文本条件的区间排除 50 %,最强 54.8 %、最弱 47.1 %,召回在 9.5 % 到 22.2 % 之间。音频在同桶为 42.1 % 到 70.3 %,召回 23.8 % 到 66.7 %,但不均匀,开源模型在临床音频上还在机会线下,只有 1 个条件区间排除偶然。下表只取临床一词轮次,把文本与音频的准确率和召回并排放。
| Corpus | Model | Input | Bal. acc. | Recall (count) |
|---|---|---|---|---|
| Clinical | Gemini 2.5 Flash | Text | 54.8 | 9.5 (2/21) |
| Clinical | Gemini 2.5 Pro | Text | 54.8 | 9.5 (2/21) |
| Clinical | Qwen2.5-Omni 7B | Text | 47.1 | 9.5 (2/21) |
| Clinical | Gemini 2.5 Flash | Audio | 60.0 | 23.8 (5/21) |
| Clinical | Gemini 2.5 Pro | Audio | 61.7 | 61.9 (13/21) |
| Clinical | Qwen2.5-Omni 7B | Audio | 42.1 | 38.1 (8/21) |
这张表回答的比较问题是:在词证据最少的同一批一词轮次里,文本与音频到底谁报得出警。文本三行召回都是 2/21,音频三行分别为 5/21、13/21、8/21,准确率也只有音频 Pro 超过 60 %。它的限制是桶很小,区间很宽,且 12 轮挫折一词集中在一通电话,去掉该通后对比会变弱,但平衡准确率的总体结论不受此主导。
下图把预测为挫折的比例随长度画出来,与黑色真值对比。所有文本条件都从远低于真值起步,再以更陡的斜率爬升;部分音频条件爬升更平,真值跨桶走 39.4 个百分点,文本最小走 51 个百分点,最大走 88.1 个百分点。
看图路径: 1. 先看黑色真值线随轮次变长的走向作为基准;2. 再看各虚线文本条件在 1 词处起点有多低、爬升有多陡;3. 对比实线音频条件是否同样起点低或爬升更平缓

论文图 3。原论文 Figure 3::“Predicted-frustration rate against turn length for all three models, against the true rate in black.”。
这张图确实可见的是左右两幅折线,横轴从 1 词到 21 词以上,纵轴为判为挫折的比例,黑色为真值,彩色虚线文本起点低爬升陡。它帮助理解机制:文本预测更像在跟长度走,而不是跟挫折本身走,音频在部分模型上部分打破了这种依赖。
只用词数的逻辑回归在临床集上达到 58.0 %,五折按人划分稳定在 57.9 % 上下 0.3 个百分点;30 通上为 57.3 %。这不是说长度是因果输入,而是说不听声音只数字数已能超过塌掉的文本,模型若连词数都超不过,就没证明用到了声音。eGeMAPS 的 88 个参数在 0.5 秒窗下中位一词长度上,甲状腺共振峰变异类组内相关系数只有 0.17,没有一个到 0.70,说明可解释声学参数在该长度也测不稳,但模型本就不吃这些特征,此节只说明没有现成替代品。
分诊后果比准确率更直接。下图是前沿双模型六票全票放行的轮次:文本放行 87 轮其中 33 轮实际挫折占 37.9 %,音频放行 45 轮其中 8 轮实际挫折占 17.8 %。放宽阈值文本放行更多但错占比一直在 37.5 % 到 40.0 %,音频从 17.8 % 升到 31.7 %,逐通留一法也不改变相对位置。
看图路径: 1. 对比上下两条横条放行的总数谁更多;2. 看深色部分在各自条带中的占比谁更高;3. 把 37.9 % 与 17.8 % 的差异理解为放行质量而非总体准确率

论文图 4。原论文 Figure 4::“Turns each input modality confidently clears, and how many of them were in fact frustrated.”。
这张图确实可见的是两条横条的长度为放行总数,深色为其中实际挫折,文本条更长且深色占比更高。它支撑的判断是文本以更宽松、更错的方式放行,且错的多是短轮:1 到 2 词占挫折轮的 34.7 % 却占静默漏检的 57.6 %,漏检率 73.1 %,随长度拉长而下降。限制是 6 通样本按 75 比 75 平衡且经 dissatisfaction 筛选,绝对比例不能读成部署流行率,只能读文本与音频的对照。
自信放行 × 静默漏检: 自信放行指两个前沿模型在某一输入下三次重复投票全部判为不挫折的轮次,意味着系统会直接不清查也不升级;静默漏检是其中按人工标签实际为挫折的轮次。两者组合把准确率问题转成分诊后果:放行得多且错得多,就是把最需要看的通话藏起来了。
给上下文也救不了文本。补 0 到 6 轮前文病人发言,文本涨约两点后平台,带 6 轮上下文的文本 68.7 % 仍低于无上下文音频 70.7 %;音频在短轮反而掉 14.7 个百分点。补智能体上一句,文本变化 -2.0 到 1.3 个百分点,一词召回只从 21 轮中的 2 轮到 3 到 5 轮,Pro 音频到 15/21。方向是一致的:缺的不是话题,而是当轮的表达方式。
更多通话和更多模型下结论还成立吗
30 通 714 轮上重复同样无上下文比较,并加入 Gemini 3.8 Flash 和 Voxtral Mini 3B。每个模型的文本对 39 轮挫折一词只标出 3 或 4 轮,且五家文本标出的 3 轮完全相同;音频侧 2.5 Flash 标出 9 轮、2.5 Pro 标出 23 轮并伴随 278 轮非挫折一词中的 77 轮误报,3.8 Flash 音频只标出 4 轮。
前沿双模型的放行质量差异保持:文本放行 578 轮其中 75 轮实际挫折占 13.0 %,音频放行 333 轮其中 23 轮实际挫折占 6.9 %,差 6.1 个百分点,区间 2.2 到 10.4。音频平均增益保持正向,约 3.0 个百分点,区间 -1.0 到 7.5,包含零。Qwen 音频差 -8.6 个百分点,区间 -14.1 到 -1.6;Voxtral 差 -10.6 个百分点,区间 -16.5 到 -3.6;3.8 Flash 差 -3.5 个百分点,区间 -6.0 到 0.0。也就是说更强提示下只有 2.5 双模型正向且区间含零,其余三家反向。
下表把预测比例跨长度的摆动幅度量化:真值在临床跨 39.4 个百分点、表演跨 60.8 个百分点,文本条件摆动普遍更大,音频 Pro 和开源在临床摆动更小。这正是长度依赖的数字形状。
| Input | Model | Clinical | Acted |
|---|---|---|---|
| Text | Gemini 2.5 Flash | 72.7 | 74.9 |
| Text | Gemini 2.5 Pro | 88.1 | 77.3 |
| Text | Qwen2.5-Omni 7B | 50.9 | 70.8 |
| Audio | Gemini 2.5 Flash | 66.9 | 78.5 |
| Audio | Gemini 2.5 Pro | 32.9 | 58.5 |
| Audio | Qwen2.5-Omni 7B | 20.8 | 55.8 |
这张表比较的是各条件预测行为随长度漂移的幅度,越大说明越跟着长度走而非跟着挫折走。它支撑的是文本三行在临床分别摆动 72.7、88.1、50.9 个百分点,都超过真值的 39.4,而音频 Pro 只摆动 32.9。限制是摆动幅度不等于准确率,摆动小也可能是双向错开,方向要结合召回和放行质量一起读。
24 通保持自然流行率的子集上,真值跨 21.2 个百分点,四家文本跨 26.3 到 40.4,只有 3.8 Flash 为 17.3;一词中 6.7 % 挫折,除 Qwen 外文本预测挫折不超过 0.7 %,而 Pro 音频预测 28.5 %。训练的 WavLM 探针在 30 通上 SVM 71.6 %,区间 63.2 到 78.2,逻辑回归 70.3 %,与音频最强的 2.5 Flash 70.2 % 持平,远超词数。但一词召回在 6 通里逻辑回归 15/21、SVM 8/21,到另外 24 通里对 18 轮挫折一词都是 0 轮。六通与 24 通在标注来源、类别平衡和难度上都不同,掉落不能归因到某单一因素,结论是探针提高了平均但没解决短轮跨通泛化。
提示模型 × WavLM 探针: 提示模型指不做微调、直接用指令让多模态大模型对音频或文本二分类的做法,依赖模型自己会不会听;WavLM 探针指冻结语音编码器取中间层表示再池化,外接逻辑回归或支持向量机的做法,不需要指令但需要标注训练。前者考通用听的能力,后者考临床语音训练能否补上短轮次。
换一句提示词音频的增益还在吗
把两套输入针对性提示换成逐字相同的单套指令,6 通上前沿增益消失:Flash 从 +4.7 到 -1.3,区间 -7.7 到 4.7,Pro 从 +3.3 到 +0.7,区间 -7.0 到 6.8。音频对 21 轮挫折一词从 5 轮和 13 轮掉到 0 轮和 1 轮,文本仍是 2 轮。前沿放行也收敛:音频放行 81 轮其中 33.3 % 实际挫折,文本放行 94 轮其中 38.3 % 实际挫折。3.8 Flash 从 -4.7 到 -0.7,开源 Qwen 缺口不随提示变,-12.7 到 -12.0,Voxtral 因音频从 52.7 % 升到 62.0 % 而从 -13.3 收窄到 -3.3。
输入针对性提示 × 相同指令: 输入针对性提示指音频侧要求听语气语速停顿、文本侧要求只看用词的两套不同写法;相同指令指逐字完全一样的单套写法,后接音频或文本。搭配比较才能分清音频相对文本的差异来自输入本身还是来自写法引导,本文发现引导决定了增益是否存在。
30 通相同指令下没有一家音频减文本区间排除零:Flash -0.1、Pro +0.9、3.8 Flash -0.7、Qwen -5.7、Voxtral -1.2。Pro 音频对 39 轮挫折一词从 23 轮掉到 4 轮,放行质量优势也基本消失,音频放行 501 轮其中 12.0 % 实际挫折,文本为 13.2 %。这说明短轮的恢复不是给了音频就自动有,而是被明确要求听表达方式时才出现。
互补性真实但难用。音频做对而文本做错与反方向的数量级相当,Flash 为 17 对 10,Pro 为 25 对 20,开源反过来为 19 对 38。按轮选更优输入的 oracle 可到 78.0 %,简单跨模型投票只有 66.0 %,低于任一前沿音频,6 通如此,30 通 oracle 89.8 %、投票 67.1 % 亦然。朴素融合拿不到互补,部署前必须在目标分布和将运行的提示下重测,更换版本也要重测,因为 2.5 到 3.8 的换代保留了文本的 66.6 % 到 67.4 %,却丢掉了短轮的听的能力。
这些结论在什么边界内才成立
数据只来自单一智能体、单一临床路径、一种语言和医疗体系,且只判挫折感二分类。6 通为 3 人全标,一致性 κ 在 0.6 到 0.8 之间,这是模型结果的天花板参照;24 通只有标注者 1 单人,无一致性估计。转写质量也不同:6 通经双系统加人工仲裁,24 通用 Whisper large-v3 未逐轮校对,一词轮次换一个词意思全变。
抽样经 dissatisfaction 筛选,挫折率 50 %、11.5 %、19.6 % 都不能读成部署流行率,流行率敏感的主张原文只放在 24 通上。表演对照、电话链、上下文、智能体上句、最小对子和起点分析都只在 6 通和 3 个原始模型上做,30 通不重复。模型只零样本测五家,其中三家同家族,且只训冻结编码器探针,未端到端微调声学模型。2.5 双模型面临下线,其后继 3.8 的行为已不同,版本替换不能当即插即用。
统计上同通轮次不独立,轮次自助区间偏窄,原文在 30 通改用整通自助,6 通也给了整通对照。逐通方差大,同一条件下跨通标准差 7 到 19 个百分点,大于 10 个模型输入条件间的 5.1 个百分点。起点分析只有 6 个 onset,是形状说明而非发生率估计。
要复现比较第一步该做什么
先按轮切分并统计长度分布,再谈准确率。把每轮病人发言切成音频片段和文字,长度按去标注括号后词数分 1、2 到 3、4 到 5、6 到 10、11 到 20、21 以上桶。报告每桶数量、挫折与非挫折各多少,以及 1 到 2 词占比,否则总体准确率会把短轮稀释掉。
标注沿用 3 人独立听上下文、多数投票,保留 inconclusive 并报告每轮几票无法判断。评价固定 3 次重复多数投票,报告平衡准确率 Wilson 区间、音频减文本的配对自助区间、一词召回和自信放行中实际挫折占比。基线至少保留词数逻辑回归和原提示下的文本条件,音频必须在将运行的提示下测,换模型版本重测。30 通量级改用整通自助,阈值扫描和逐通留一作为稳健性检查。
本篇未提供可下载代码、权重或数据,已部署录音因隐私只报聚合结果,表演集需经官方许可获取。复现只能按上述切分、提示原文和投票规则重做,不能把 oracle 选优当可部署提升,也不能把相对变化读成百分点。
什么时候值得试听声音还需要补什么验证
当部署通话像本文一样被短轮主导,且漏掉挫折的代价是 clinician 永远看不到该通电话,就值得把短轮当候选送给听语气的音频模型或人工,而不是只看文字放行。尝试顺序是先测长度分布和词数基线,再在目标提示下测音频相对文本的配对差异和放行质量,最后看一词召回的误报代价能否承受。
本文证据只支持窄结论:文本在一词轮次不排除偶然,音频在明确要求听表达方式时帮两个 2.5 模型找回部分短轮并降低放行错误,但区间多含零,换提示、换新版、换小模型都可能反转,训练探针平均持平但跨通短轮仍为零。还没验证的是多轮对话建模、端到端微调、其他路径语言和除挫折外的状态,以及误报带来的复听负担。短评估不报告长度分布,就无法证明文本系统在部署长度下成立。
📎 论文与评分元数据
排名:前50% | 文档类型:应用研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses