📄 早解码晚验证:让离线语音识别器做流式输出
英文题目:Decode Early, Verify Late: Streaming Offline Speech Recognizers Without Accuracy Loss
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.4/1.5
👥 作者与机构
- Doyeob Kim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音助手以用户语音流为输入,需在说话过程中给出中间转写,并在对话结束提交时快速返回终稿转写,难点是离线识别器要等完整语音才整句解码,等待时间长,而固定历史文本或更换小模型会损失精度。先在语音到达时按从流起始计数的固定音频块编码并送入解码器缓存,检查点把已到音频的解码结果输出为中间转写并保留为草稿。再在对话结束提交时把音频尾部与最新草稿放在同一次前向中预填充并比对,输出最长正确前缀并送入解码器只续写未通过部分,若草稿已看全音频且正常结束则直接提升为终稿。最后调度器优先运行终稿并把检查点放在剩余算力上,还按模型结构适配缓存重用,对整段编码模型在提交时重算音频、对循环状态模型重放已接受输入恢复状态,使验证与离线贪心解码一致。单流Qwen3-ASR-1.7B在Pipecat-STT上TTFS中位数从无草稿时的115 ms降至用草稿时的24 ms,在WildASR上从78 ms降至25 ms。在一块A100上承载至多64路并发时两数据集终稿TTFS中位数均为22–26 ms,且是测试中唯一在Pipecat-STT至多80路、WildASR至多64路满足100 ms p99目标的系统。五识别器对比中词错率WER与离线解码差距在0.13个百分点以内,95–100%终稿与离线转写逐字节一致。该结论限于贪心解码、确定性前端与可恢复解码器状态等条件,长于10 s的语音按句切分后不再保证逐字节一致,系统为免训练推理框架,不更新模型权重。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
语音助手要的流式识别是什么输入和输出
语音助手面对的输入是一段连续到来的语音,客户端每 100 ms 发一个音频块,助手要在说话过程中不断展示部分转写,在说话结束的提交时刻尽快返回终稿。从提交到拿到终稿的时间被称作终稿时间,原文记为 TTFS,它直接加在用户说完话到智能体开口回答之间的等待里。一块图形处理器能同时服务的流数是在某个终稿时间目标下测出的容量,目标越严,能并的流越少。
初学者容易把部分转写好坏和终稿好坏混在一起。部分转写追求的是边说边看的跟随感,终稿追求的是与离线一次性解码一致的准确性。离线模型平时是对完整一句话编码再解码,精度在公开榜单上靠前,但如果等到提交才从头解码,终稿时间就包含了全部编码和解码。流式方案想提前做功,又不能把提前看到的不完整音频当成完整音频来定稿,这是本文方法要处理的张力。
理解后文需要先固定 3 个对象。音频表示是编码器把波形变成解码器可用的向量,提示是解码器启动时看到的音频向量加固定指令,解码器状态是生成过程中缓存的键值和位置。离线解码的参照动作是贪婪解码,也就是每一步都选当前概率最大的词,直到输出结束符。论文把完整音频 x 按该规则得到的结果写作离线输出,后续所有一致性都以它为基准。
已有草稿和两遍做法与本文有何不同
用草稿加速解码的思路在文本生成里已有对应物。推测解码用小模型提草稿、用目标模型验证,验证通过的部分保留,保证的仍是目标模型的输出规则。离线语音里也有用单独草稿识别器加速的做法,但草稿来自另一个模型。机器翻译里有用历史翻译做增长输入草稿的做法,验证方式有偏置和零偏置之分。全双工语音里也有在假设静音下先起草、再用到达音频验证的做法。
这些做法与本文的输入条件不同。文本推测解码的输入在验证时不变,而流式语音的音频在增长,提示、位置和缓存都随音频变化。两遍语音系统会用完整上下文重解第一遍,但不把第一遍当作可复用前缀来省终稿时间。局部一致做法保留相邻假设相同的文本,但不按原模型在完整音频下的贪婪规则逐词核对。
本文的差异在于维护一组不变量,让流式中算过的表示在提交时等于离线一次性算过的表示。做法包括按流起始计数的固定音频块编码、归一化变化时重建缓存、检查点与终稿用同一条验证规则、调度优先终稿。这些是为流式转离线这个特定转换服务的,而不是提出一种新的通用解码规则。读者在对比时应把任务、数据划分、输入是否完整、推理阶段和并发预算对齐,不能把不同模型或不同解码设置下的差距直接记到方法名下。
离线模型做流式时准确和延迟为什么难兼得
最准的开权重识别器多是离线模型。论文提到截至 2026 年 11 月 10 日的 Open ASR Leaderboard 前三都是离线模型,而最好的流式条目只排在 64 名中的第 38 名。已有的流式做法各有代价。一种是把早先输出固定为前缀,后续只往后解,这省时间但当前缀在完整音频下本不该出现时就把错误锁死了。另一种是另训 1 个流式小模型,部署两套权重,精度通常低于离线大模型。还有一种是保留相邻假设一致的文本,同样没有在完整音频下用原模型再核对一次。
直接在提交时解完整句的引擎则把全部解码放在用户说完之后。论文对比的 SGLang-Omni 和 vLLM 都属于这类,它们在提交时才转写完整语音。vLLM 的实时模式还被单独讨论,它会复述早先 5 s 分段,在两个数据集上分别有 48% 和 58% 的话语出现复述,论文因此把它排除在主比较之外,不把复述文本当终稿用。
论文抓住的一个事实是,最后一份部分转写已经很接近终稿。在 Qwen3-ASR 上,最后部分转写与终稿词序列的前段在中位数上重合度很高,Pipecat-STT 上是 88%,WildASR 上是 82%。这意味着提交时大部分词其实已经算过,缺的只是一次用完整音频确认哪些能留、从哪里续写。若能把确认和补尾部音频放在同一次前向里,终稿就只需要解很短的一段。
早解码晚验证的整体流程是什么
方法名 Decode Early, Verify Late 缩写为 DEVL,不需要训练。服务端在说话过程中不断编码已到的音频并填入缓存,检查点对当前已到音频做一次解码,发布部分转写,同时把这份文本存为草稿。提交到来时,服务端只补填草稿之后没缓存的尾部音频和提示后缀,在同一次前向里验证最后一份草稿,接受其最长正确前缀,回滚到该前缀后只解后面的词。如果最后一次检查点已经看到了全部音频且以结束符结尾,可以直接提升为终稿;若没有可用草稿,则按普通方式解完整句。
部分转写 × 草稿: 部分转写是在说话还没结束时对已到音频的解码结果,草稿是把它留下来供结束时复用的同一份文本;两者是同一对象的两种身份,前者负责让用户和服务端早看到内容,后者负责让终稿少从头算,组合后省掉的是重复解码已正确的词。
下图展示了一条流的时间线,有助于把说话中提前做的编码填入与提交时刻的验证续解放在同一时间轴上理解。读图时先看横轴表示的音频时间推进,再看检查点草稿与提交验证之间的先后关系,图后解释再说明提交时省掉了哪些工作。
看图路径: 1. 先看横轴表示的音频时间推进,再区分说话中已处理部分与提交时才处理的尾部;2. 再看上方草稿标记与提交时刻之间的先后关系;3. 最后看提交时刻回指尾部的弧线表示验证与续解只覆盖最后一段
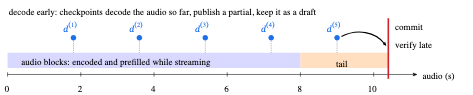
论文图 1。原论文 Figure 1::“One stream in DEVL. Audio is encoded and prefilled into the KV cache as it arrives.”。
图示把一条流按时间展开,左侧并列展示说话过程中已编码填入的部分,右侧并列展示提交时才需处理的尾部,草稿标记与提交验证按先后并列出现。它帮助理解的核心是提交时的工作量被压缩到尾部加一次验证,而不是重走整句编码和解码,尾部越短、草稿越准则残余解码越短。
调度上终稿优先于检查点,一个检查点至多把终稿延迟一个已在执行的图形处理器步骤,检查点只用剩余算力,默认至多 4 个流同时做检查点,超出时按轮次或提交需求再增加。
Qwen3-ASR 上如何保证验证时等于离线
以 Qwen3-ASR 为例,论文用 4 个设计维持验证时的输入与状态和离线一次性处理相同。第一是音频块按流起始计数,与客户端切块边界无关,每个有效块只编码填入一次。若输入归一化发生变化,所有已完成块及其解码器状态重建,提交时只剩最后一个缓存块之后的尾部。这一步解决的是流式分块与归一化漂移会改变特征的问题。
第二是检查点本身也走同样的验证。检查点复制当前流的键值缓存,补填未缓存音频和提示后缀,按与终稿相同的规则检查上一份草稿,再从接受前缀往后解,发布并记录它看到的音频量。这保证每一份草稿都带有明确的已见音频边界,提交时知道它缺了哪段。
检查点 × 提交: 检查点是说话过程中触发的一次对当前音频的解码和发布,提交是客户端宣布说话结束、要求返回终稿的时刻;检查点在提交之前生产草稿,提交时只验证最后一份草稿,两者分工把计算从提交后搬到说话中。
第三是提交时的同遍验证与续解。若草稿在位置 i 之前都与贪婪输出一致,则位置 i 的输入就是离线提示加正确的历史词,其最大概率词也应是贪婪词。用归纳法可得接受前缀加第一个修正词仍是离线输出的前缀。若整份草稿都对,它本身就是前缀,不需要多算 1 位。空草稿则取第 1 位最大概率词。
服务端把缓存截断到保留最后一个已返回词之前,以该词为种子继续解,遇到结束符停止。修正后还可把剩余草稿重新对齐再验,最多 3 轮修复。
验证 × 残余解码: 验证是在补齐尾部音频的同一次前向中逐位置检查草稿是否等于贪婪解码会选的词,残余解码是从第一个不匹配处开始继续向后生成;验证负责确认可复用的最长正确前缀,残余解码只负责补前缀之后的部分,组合后终稿不需要重走已对的部分。
第四是调度与缓存实现。待处理的终稿排在检查点之前,引擎用分页键值缓存和 CUDA 图。论文还对超过 10 s 的话语按句末切分为多个时期以缩短终稿解码,但切分后的终稿不在精确等于离线输出的保证之内。精确相等的条件还包括贪婪解码、确定性前端、可恢复到接受前缀的解码器状态,以及在精确算术下讨论,实际批量带来的浮点舍入仍可能改变极少数终稿。
键值缓存 × 回滚: 键值缓存是解码器已处理过的音频和文本状态的缓存,回滚是把缓存截断到验证通过的前缀之后;缓存负责避免重复计算已对齐的输入,回滚负责丢掉分歧点之后不可复用的状态,两者配合才能从正确前缀无缝续解。
四种模型结构各自复用什么和重算什么
不同模型的编码器视野不同,能复用的东西也不同。Qwen3-ASR 看固定窗口,可以复用编码块和解码器缓存,提交时只补尾部和草稿,回滚靠截断缓存。Whisper 看整段,流式中不缓存,提交时重编码全部音频再填入并验证草稿,回滚靠覆盖缓存。VibeVoice-ASR 用因果分块,可以复用编码器输出,提交时只编码尾部再填入并验证,回滚靠覆盖缓存,且为确定性去掉了输入增益并用平均声学隐变量。Nemotron 看整段且含循环 Mamba-2 状态,提交时重编码全部音频,通过重放已接受输入来恢复循环状态。
下表比较的是同一个问题:在有草稿可用时,提交时还剩多少工作,以及状态如何回到正确前缀。阅读时先看编码器视野决定能否复用音频表示,再看提交工作列理解省掉的部分,最后看回滚列理解不同结构的恢复手段。Qwen3-ASR 是唯一还切分长句时期的引擎,这一点在对比终稿一致性时需要单独记住。
| model | encoder sees | cached in speech | commit work | rollback |
|---|---|---|---|---|
| Qwen3-ASR | fixed windows | encoder blocks, decoder KV | prefill tail and draft | truncate KV |
| Whisper | whole clip | – | encode all; prefill and draft | overwrite KV |
| VibeVoice-ASR | causal chunks | encoder output | encode tail; prefill and draft | overwrite KV |
| Nemotron | whole clip | – | encode all; prefill and draft | replay state |
这张原表支撑的判断是复用程度由编码器结构决定,而不是方法对某个模型特殊优待。窗口或因果编码器能在说话中留下可用表示,整段编码器则要在提交时重算音频,但两者都可以在同一次填入中验证草稿。限制是重算整段的模型在提交时的固定开销更大,草稿只能省解码部分,省不掉编码部分。读者在复现其他模型时应先确认前端是否确定、位置是否按绝对位置、状态能否截断或重放,再决定缓存什么。
数据负载和对比条件是如何设定的
评测用两组英语数据。Pipecat-STT 是 897 个语音助手轮次,参考文本由机器生成而非人工标注。WildASR 是 2 549 个英语片段,6 组播放 FLEURS 句子并改变录音条件,一组为口音语音。负载用闭环保持 C 路流,每路拿到终稿后立刻开始下一句,客户端实时发 100 ms 块并随最后一块提交。终稿时间在客户端测量并给出 95% 自助区间,容量定义为在该目标及所有更低负载下都达标的最大实测负载。一致比例是终稿文本与本引擎离线解码逐字节相同的比例,VibeVoice-ASR 取其 JSON 内容文本拼接后比较,不含时间戳和说话人元数据。
基线包括同一引擎关掉检查点和时期切分的无草稿服务、每句单独解的离线参照、官方流式工具包每 2 s 重解全部已有音频并固定早先输出的做法,以及在提交时转写整句的 SGLang-Omni 和 vLLM。Qwen3-ASR 跑在一块 40 GB 的 A100 上,Whisper 在 A100 上,VibeVoice-ASR 在 80 GB 的 A100 上,Nemotron 在 96 GB 的 RTX PRO 6000 上。跨请求的缓存因客户端重放而关闭。其他模型的单流还在云端 A100 上测,Whisper 每数据集 300 句,VibeVoice-ASR 和 Nemotron 用全部 Pipecat-STT 加 1 000 个 WildASR 片段,批量运行时 WildASR 用全部 2 549 个片段。
这些条件决定了结论的边界。客户端随最后一块提交不同于部署中按静音超时提交,论文另加 300 ms 和 600 ms 静音做了端点实验。参考文本质量、是否切分长句、是否同卡同引擎比较,都会影响词错误率和终稿时间的读数,不能脱离这些条件谈快慢。
五种识别器上终稿准确性和单流速度如何
主比较关心两个问题:在各自引擎内,终稿相对离线解码差多少,以及单流终稿快多少。指标方向是词错误率越低越好,字节一致比例越高越好,终稿时间越低越好。论文报告的总体是终稿与离线非常接近,单流终稿明显提前,但不同模型的加速比和绝对时间不同,且各自的常用流式选项不可直接互比,因为它们有的是单独小模型,有的是默认解码设置差异。
贪婪解码 × 离线输出: 贪婪解码是每一步都取概率最大词直到结束符的解码规则,离线输出是用同一套权重和内核对完整音频一次性按该规则得到的结果;前者是判定对错的标准动作,后者是该动作在完整输入下的参照答案,实验用字节一致比较终稿是否回到了这个参照。
下表整理的是论文正文用连续句子给出的总体范围,比较问题是 5 模型平均意义上的保持程度,而不是某一句的具体词错误率。它回答的是方法是否在多结构上都成立,限制是它把不同模型的绝对精度压成了一个区间,读具体模型仍要看分模型数字。
| 比较范围 | 字节一致比例 | 与离线解码的词错误率差距 | 单流终稿时间变化 |
|---|---|---|---|
| 五识别器比较 | 95–100% | 0.13 points | 1.5–7.3× |
这张小结表支撑的判断是终稿基本回到离线贪婪结果且单流更快,但它不成立的情形在正文另有说明。分模型看,Whisper 两款的终稿词错误率与离线完全持平,一致比例达 99.7% 到 100%,但其常用流式基线差距大,主因是另一后端的默认解码设置,贪婪解码下差距可缩到 0.2 个点以内。VibeVoice-ASR 和 Nemotron 的一致比例在 95% 左右,词错误率差距在 0.13 个点以内,单流终稿从数百毫秒降到 100 ms 到 180 ms 量级。Qwen3-ASR 在 64 路运行下一致比例为 98.0% 和 98.5%,词错误率几乎持平,单流中位终稿从 115 ms 和 78 ms 降到 24 ms 和 25 ms。读者应把总体区间与分模型绝对值对照看,不能用区间代替某一模型的实测值。
并发升高后草稿还有用吗容量如何变化
Qwen3-ASR 在高并发下的表现是第二个关键问题。论文在一块 A100 上从 1 路测到 128 路,报告中位终稿时间和 99 分位目标下的容量。下图展示的是中位终稿时间随并发数的变化,纵轴为毫秒,横轴为并发流数并取对数,越低越好,曲线带 95% 区间。读图前先明确任务是看低并发与高并发区间的走势差异,以及高并发后哪些趋势保持平稳、哪些趋势明显抬升。
看图路径: 1. 先对比两幅子图在不同数据集下随并发数变化的总体走势;2. 再看低并发区间与高并发区间曲线的平稳与抬升差异;3. 最后注意各曲线在高并发附近的分岔趋势
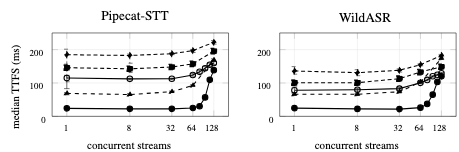
论文图 2。原论文 Figure 2::“Qwen3-ASR TTFS under load, one A100. Median TTFS with 95% intervals against concurrent streams, log scale (lower is better).”。
图示把两个数据集的结果并列展示,横轴为并发流数,纵轴为中位终稿时间,多条曲线在低并发区间总体保持平稳,到高并发区间部分走势明显抬升。它的作用是把单点加速扩展为负载曲线,说明草稿的收益依赖于检查点能否在提交前完成。当图形处理器忙于终稿时,检查点来不及做,草稿就帮不上忙。
下表整理的是 Qwen3-ASR 在 64 路以内的中位终稿和相对加速,比较问题是在该负载上限内终稿提前了多少。表前需要固定条件为同卡、同引擎、客户端计时,终稿时间越低越好,加速倍数越高越好。
| 条件 | 中位终稿时间 | 相对官方流式 | 相对无草稿服务 | 相对提交时转写整句 |
|---|---|---|---|---|
| 至多 64 路双数据集 | 22–26 ms | 2.7–3.9× | 3.2–5.0× | 4.1–8.3× |
这组数字支撑的判断是在 64 路以内草稿能把终稿稳定在 20 ms 量级,但它在更高并发下不成立。在 64 路时至少 98% 的终稿有草稿可验,到 128 路只有 21% 到 29% 能对上草稿。若把同时做检查点的流放宽到 16 路或 32 路,128 路下 95% 以上仍有草稿可验,Pipecat-STT 中位终稿可从 138.5 ms 降到 38.2 ms 和 32.6 ms。在不超过 10 s 从不切分的话语上,无时期切分时中位仍是 20–26 ms 对 58–95 ms,说明加速不全来自切分。
下表整理的是 99 分位 100 ms 目标下的容量,比较问题是谁能在严格尾延迟下撑住多少路。表前固定目标为 100 ms 99 分位,容量越大越好,短横表示在 1 路都未达标。
| 目标 | Pipecat-STT 容量 | WildASR 容量 |
|---|---|---|
| 100 ms p99 | 80 streams | 64 streams |
这张容量表支撑的判断是只有该方法在所测系统中达到该严格目标,其他系统在 1 路就未达标。限制是目标放宽到 300 ms 99 分位时,无草稿服务和 SGLang-Omni 也能到 128 路,严格目标下的胜负不能推广到所有延迟目标。其他识别器中只有 Whisper large-v3-turbo 达到 100 ms 99 分位,分别为 80 路和 32 路对无草稿的 32 路和 8 路。VibeVoice-ASR 从 32 路起有无草稿中位差距在 8% 以内,Nemotron 从 64 路起有草稿中位反而高至 16%,且批量本身可改变多达 6.1% 的终稿。端点处加静音后,从语音结束算起中位仍快 59–108 ms 且词错误率持平,96.7% 到 98.1% 与加长音频的离线解码一致。
哪些条件下结论不再成立
基准的语言和标注是第一个边界。两组数据都是英语,Pipecat-STT 的参考由机器生成,WildASR 含录音条件变化和口音,但都没有覆盖其他语言和更长的多轮对话。词错误率的绝对值依赖参考质量,不能把在机器参考上的 1.78% 或 4.75% 当作人工标注下的精度。
精确相等的保证只在给定输入和解码条件下于精确算术下成立。需要贪婪解码、确定性前端、可恢复到接受前缀的状态,以及音频表示、提示、位置和保留状态与离线一次性处理相同。Qwen3-ASR 对超 10 s 按句末切分时期的终稿不在该保证内。实际批量中图形处理器舍入会改变少数终稿,无草稿时 Qwen3-ASR 在 128 路有 1.9% 的终稿因此不同,论文提到批量不变内核可缓解,但未在本引擎中验证。
负载和模型结构决定草稿是否有用。检查点消耗图形处理器时间,对慢模型主要在低负载下帮忙。一旦图形处理器忙于终稿,检查点很少能赶在提交前完成,草稿就不再降低中位时间。VibeVoice-ASR 有个别片段会让所有臂都循环到输出上限,计入与否可把词错误率从 11.3% 到 12.8% 抬到最高 20.2%,读数时需确认是否剔除该片段。调度偏向终稿,部分延迟的优化仍是未来工作。
什么时候值得试复现第一步做什么还缺什么验证
当服务端已在流式中计算部分转写、用的又是离线精度更高的模型、且终稿时间卡在提交后的完整解码上时,值得尝试把部分转写当草稿复用。最匹配的是编码器可复用、前端可做确定、缓存可截断或重放的模型。若已有流式小模型且精度可接受,或提交后延迟主要来自网络和端点检测而非解码,则收益有限,应先实测提交后各段耗时再决定。
复现第一步不是先调加速比,而是先建出可比的离线参照和计时口径。用同一套权重和内核对完整音频单独贪婪解码作为参照,固定客户端按 100 ms 发块并随最后一块提交,在客户端测终稿时间,记录字节一致比例和词错误率。接着实现按流起始计数的固定块编码与填入,归一化变化时重建,检查点与终稿走同一验证,调度让终稿优先。先在单流关掉长句切分验证一致比例,再加负载看有草稿可验的比例是否随并发下降。
还需要补的验证包括非英语和人工标注下的词错误率、真实静音超时的端点增益、批量不变内核对一致比例的影响,以及部分转写延迟与终稿优先之间的权衡。本文未提供可验证的作者代码与模型资源信息,复现需按论文描述自建引擎,不能把第三方链接当作作者已开源。满足这些验证后,才能把在 64 路到 80 路下 100 ms 99 分位的容量结论搬到自己的部署条件里。
📎 论文与评分元数据
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses