📄 同一句“女声” 能变出多少种声音:指令语音合成的说话人多样性审计
英文题目:Beyond Controllability: Speaker Diversity in Instruction-Guided Text-to-Speech
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Yi-Cheng Lin:National Taiwan University
- Jia-Kai Dong:National Taiwan University
- Kuan-Yu Chen:National Taiwan University
- Szu-Chi Chen:National Taiwan University
- Jian-Jiun Ding:National Taiwan University
- Sung-Feng Huang:NVIDIA
- Yusuke Hirota:NVIDIA
- Hung-yi Lee:National Taiwan University;Artificial Intelligence Center of Research Excellence, National Taiwan University
📌 核心摘要
指令引导的文本到语音以自然语言描述为输入生成可听语音,描述仅限定性别、年龄、口音或情绪等粗粒度属性,剩余声学细节需模型补足,同一描述重复请求时应产生多个不同说话人。本文先验证说话人编码器随真实说话人数增加能否拉开分值并剔除三个压缩编码器,再用八个保留编码器提取七个系统与真实录音的嵌入并计算Vendi分值,最后把条件生成语音送入属性分类器以per-class recall衡量可控性,区别于以往只验跟随是否正确。整体比较以Emilia英语语料30000句配对真实录音,在八个编码器上以Vendi分值为多样性指标,真实参考约为68.3,所有系统在默认与最优采样下均低于该水平。属性比较共用3000句文本以固定语言内容,Qwen3-TTS的女性条件Vendi分值为16.6,仅为男性条件28.1的59%,但两性per-class recall均超过0.88,说明正确跟随不等于声音丰富。口音与情绪的条件Vendi分值随请求变化很小,但北美英语在全部系统中per-class recall不低于0.744,多数系统把表情化语音判为中性,表明两者暴露不同偏向。在口音分类器的说话人无关保留测试集上,集成模型的macro-F1为0.876,高于随机猜测水平的0.167,德国口音F1仍达0.887,排除分类器灵敏度不均的解释。结论只适用于所测七个开源系统与英语下性别、年龄、六类口音及四类情绪,未验证其他语言与开放描述,调优采样仍不能弥合与真实语音的差距。推理评估在NVIDIA B200上耗费约901 GPU小时,其中生成约842小时,编码器提特征约59小时。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
指令语音合成的输入是什么,要保留什么信息
刚接触语音合成的研究生可以先把任务拆成输入、输出和必须保留的信息。传统做法有两条路,一是选一个固定的说话人向量,二是给一段参考音频做声音克隆,前者身份固定,后者需要额外音频。指令引导语音合成走第 3 条路,输入是两部分,一部分是要朗读的文本,另一部分是用自然语言写的声音要求,例如性别、年龄、口音、情绪,输出是波形,不再依赖参考音频或预置音色。
这种设定的难点在于描述是欠定的。文本只写“女性声音”,没有规定基频、共振峰、语速和音质细节,模型必须自己把剩余声学特征补全。下游用法放大了这个难点,会话智能体希望同一类描述能长出多个不同人物,合成训练语料更希望用一句宽泛描述重复请求就得到覆盖面广的说话人集合,而不是每次都回到同一个嗓音。如果模型只会复读少数几种声音,用它造的数据会把偏斜传给下游语音模型。
论文把测量对象限定为描述主导生成的模式。即使有些模型同时支持参考音频,本文全部按无参考、只看文字描述的方式评估,关注的是同一指令条件下输出之间在说话人身份上的变化,而不是单条语音是否清晰自然。
已有多样性和偏差评估在比什么,为什么还缺一块
理解本文位置需要把几类相近评估分开。第一类看训练语料本身,例如 GLOBE 在语音合成训练语料上算 Vendi 分数,它回答的是数据有多散,没有回答模型输出有多散。第二类看分布真实感,例如 TTSDS 量生成分布与真实录音分布的距离,距离大可能是声音种类少,也可能是音质差,两件事混在一起,不能单独读成多样性。第三类看零样本或固定音色系统的全局多样性,例如 MAD-Speech,它不处理“同一句自然语言指令内部” 的多样性。
与本文最接近的是 MINT-Bench 的音色多样性分,它对同一指令和文本生成多条语音,再看其中符合指令者的 WavLM-Large 说话人嵌入差异。但它最后给每个系统和语言一个总分,不展示不同属性取值之间的差异,也不与真人语音做并排比较。偏差评估一侧也有 3 条已有路线,分别是无关属性与声音的错误关联、不同人群的输出质量差距、人口属性可控性,其中 E-VOC 已发现儿童和老年提示不好控制。本文补的是第 4 个维度,即不同请求值之间的说话人多样性差距,并坚持把多样性与可控性并排看。
论文要回答的三个问题是什么
论文把大问题拆成 3 个可操作的提问。第一个问题是测量工具是否合格,即哪些说话人编码器适合量多样性。第二个问题是现实差距,即指令系统在中性通用指令下的整体多样性是否达到真人录音水平。第 3 个问题是条件偏差,即换成女性与男性、儿童到老年、6 种口音分区、4 种情绪以及性别乘年龄组合时,多样性和可控性是否随请求值变化。
指令引导语音合成 × 说话人多样性: 指令引导语音合成指只用自然语言描述决定音色,不给参考音频;说话人多样性指在同一条指令条件下多次生成在说话人身份上的分散程度,二者搭配的意义是描述本身欠定,模型必须自行补足未写明的声学细节,补得是否分散直接决定能否批量造出不同人物和训练语料。
下面这张总览图把 3 个问题画成了三块,读图时不要把它当成模型结构,它是实验逻辑。左上说明动机,中部说明编码器筛选,底部说明两组比较,刚好对应后文的方法与实验顺序。
看图路径: 1. 先看左上同一句女性声音请求重复 N 次的示意,区分高多样性和低多样性两排人像;2. 再看右上同一 utterance 数下 2、4、8 个说话人时,可靠编码器与不可靠编码器的点云和多样性条变化;3. 最后看下方真实录音点云更散、指令系统输出更聚,以及性别与口音两组偏差示意

论文图 1。原论文 Figure 1::“Overview. (a) A broad description should produce many distinct voices.”。
这张图确实可见的内容可以分成三部分。左上用同一个女性声音气泡重复 N 次指向指令系统,下方并排给出高多样性五行不同人像与低多样性 5 张相同人像。右上固定 utterance 数量、增加说话人数,可靠编码器的点云从两团分开到多团分开,多样性条随之变长,不可靠编码器的点云始终挤成一团,条长几乎不动。下方左侧真实录音橙点更铺展、系统输出蓝点更抱团,右侧性别例子显示女性听感区点更密而男性听感区点更散,口音例子显示大洋洲请求的部分蓝点落在北美听感区并标出错误区域。它帮助理解的是全文分工,可靠性先行,现实差距与属性偏差随后。
从一句话指令到多样性分数,完整链条经过哪些步骤
沿着一个样本走一遍最清楚。研究者先准备朗读文本,文本来自 Emilia 英语子集的句子,属性实验中同一组文本会在不同属性值之间共用,以固定语言内容。接着给每条文本套上指令模板,模板按官方提示接口传入系统,采样参数用各系统默认值。每个条件生成数千条语音,通用多样性每个系统生成 30000 条并分成 3 个 10000 条集合,属性条件每个取值生成 3000 条,性别乘年龄每个格生成 6000 条。
可控性 × 多样性: 可控性指生成语音被属性分类器判为所请求类别的比例,多样性指同条件下声音之间有多散,前者回答是否听起来像要求的那类,后者回答这类里面有多少种不同的人,两者互补,单一指标会漏掉另一侧的偏差。
得到波形后有两条并行测量。一条是多样性,把每条语音送入说话人编码器得到 L2 归一化向量,在向量空间算集合内分散度。另一条是可控性,把同一批语音送入性别、年龄、口音、情绪分类器,看被判为所请求类别的比例,即每类召回率。两条线在同一批生成上汇合,1 个条件对应一个多样性分数加一个可控性分数,才能看出“听起来对但种类少” 与“种类不少但经常跑调” 的区别。
下面这张表是评估面板的 7 个开源系统,比较问题是这些结论到底覆盖了哪些结构,阅读时注意它们分属 4 种做法,参数量不含声码器与编解码器,许可证也不同。
| System | Release | Params | License |
|---|---|---|---|
| MOSS-VoiceGenerator | OpenMOSS-Team/MOSS-VoiceGenerator | 1.7B | Apache-2.0 |
| Parler-TTS Mini v1 | parler-tts/parler-tts-mini-v1 | 0.9B | Apache-2.0 |
| Parler-TTS Large v1 | parler-tts/parler-tts-large-v1 | 2.3B | Apache-2.0 |
| Qwen3-TTS Voice Design | Qwen/Qwen3-TTS-12Hz-1.7B-VoiceDesign | 1.7B | Apache-2.0 |
| VoxInstruct | thuhcsi/VoxInstruct | 1.37B | MIT |
| CapSpeech-NAR | OpenSound/CapSpeech-models | 0.9B | CC BY-NC 4.0 |
| VoxCPM2 | openbmb/VoxCPM2 | 2B | Apache-2.0 |
这张表支撑的判断是结论只针对所列开源权重模型与所列结构。4 个编解码自回归语言模型逐词元生成离散音频,VoxInstruct 混合自回归与非自回归处理语义与声学词元,CapSpeech-NAR 用流匹配加扩散变换器非自回归生成,VoxCPM2 逐段生成连续隐变量块。复现时必须按表中的发布名称取权重,CapSpeech-NAR 一侧的非商业限制会传给派生音频与统计,商业闭源平台不在本轮比较内。
多样性分数怎么算,编码器为什么要先筛一遍
多样性计算的对象是 N 个归一化说话人向量组成的集合,先算 N 乘 N 余弦相似矩阵,矩阵元素是两两向量内积。第一个指标是平均成对余弦距离,把所有不同下标对的 1 减相似求平均,值越大表示平均更不相似。第二个指标是 Vendi 分数,把相似矩阵除以 N 后求特征值,再对特征值分布求熵并取指数,直觉是正交模态的有效个数。论文把 Vendi 当主要指标,因为少数几个相距很远的声音也能把平均距离抬高,而 Vendi 会回落到接近声音团数。
\[\mathrm{MPCD}(X)=\tfrac{1}{N(N-1)}\sum_{i\neq j}(1-K_{ij}).\]上式先形成相似矩阵,再对所有 i 不等于 j 的对累加距离并除以对数,得到的是集合内平均不相似度,输入是归一化向量集合,输出是一个标量,越大表示平均更散,但它对团数不敏感。
\[\mathrm{VS}(X)=\exp\!\left(-\sum_{\lambda_{l}>0}\lambda_{l}\log\lambda_{l}\right),\]上式先对相似矩阵归一化后的特征值求分布熵,再取指数,输入是同一相似矩阵的谱,输出可理解为有效声音数,集中在少数团上时分数会被压低。两个公式都不依赖外部参考集,附录的 Chamfer 距离与最大均值差异是另一类跨集合覆盖度量,本文只用它们辅助校验,不做筛选依据。
说话人编码器 × 说话人验证嵌入: 说话人编码器是把一段波形映射为定长向量的模型,说话人验证嵌入是它为区分“是不是同一人” 而训练出的表示,二者搭配后,多样性不再直接比较波形,而是比较这些向量在空间中的散开程度,因此编码器本身是否对人数敏感必须先校验。
编码器筛选的做法是构造已知人数的集合,看分数是否跟随人数。论文用 LibriSpeech train-clean-100 构造 k 取 6 到 240 的集合,每个 k 做 100 个 240 条的子集,每个子集从 k 个说话人各抽 240 除以 k 条,分别算两个指标并画校准曲线。合格要求不只是单调,还要相邻人数的均值差超过子集标准差,在 13 个相邻步中至少 12 步成立,且从 6 人到 240 人均值 Vendi 扩大 2.7 到 6.7 倍。
平均成对余弦距离 × Vendi 分数: 平均成对余弦距离是对所有两两向量先算 1 减余弦相似再平均,Vendi 分数是对相似矩阵除以样本数后的特征值求熵再取指数,前者容易被少数几个相距很远的声音拉高,后者更接近正交模态的有效个数,论文把后者当主要判断、前者当辅助核对。
读这张校准图时先看横轴真实人数与纵轴分数方向都是随 k 增大而增大,再看分组。实线组随人数增加上扬明显,虚线组随人数变化不大,两组之间纵向分离随 k 增大而拉开。论文正文据此做筛选,相邻人数步之间的均值变化常常被子集抽样波动盖住的编码器被排除。
看图路径: 1. 横轴都是真实说话人数 k 从 6 到 240,左纵轴是平均成对余弦距离,右纵轴是 Vendi 分数;2. 对比实线组随 k 明显上扬与虚线组增长平缓、长期处于低位的趋势差异;3. 注意同一 k 下实线组与虚线组的纵向分离,以及虚线组随 k 变化不大的特点
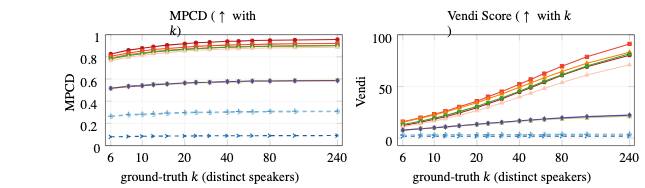
论文图 2。原论文 Figure 2::“Encoder calibration with MPCD and Vendi.”。
这张图确实可见的是左侧平均距离与右侧 Vendi 两块面板中,实线组随横轴稳步爬升,虚线组走势平缓。论文正文指出虚线对应的 3 条是 x-vector、WavLM-base 加说话人验证头、UniSpeech-SAT-base 加说话人验证头,后续主实验只用保留的 8 个编码器。缺口在于原文没有给出这 8 个编码器在其他语种或强情绪、强口音下的校准,读者若换语料应先按同样 k 网格自做 1 次校准再沿用。
指令模板、文本抽样与可控性分类器如何固定条件
提示设计需要固定语义、只变句式。每个单属性值用 5 种模板实现,分别是规范式、所有格式、分词式、角色归因式和属性质量描述式,例如男性用“用男声说”,儿童用“用孩子的声音说”,交叉的性别乘年龄用 5 种句框乘年龄先行与性别先行两种词序,共 10 个模板。模板刻意避开响亮之类的韵律修饰词,避免把目标属性与无关声学变化混在一起。通用多样性用中性指令,不指定说话人属性,只要求自然中性、语速适中、会话清晰。
文本与抽样规则是公平条件的关键。通用部分抽 30000 句分成 3 组不相交 10000 句,每组单独算 Vendi 再报告 3 组均值与标准差,真人参考用配对原始录音走同样流程。属性部分抽 3000 句并在所有属性值之间共用,计算时从每个 3000 条池抽 10000 个 1500 条子集,每个子集取池子一半,8 个编码器在同一子集上算分后先平均再给区间。Vendi 随样本量变化,因此子集大小固定是比较成立的前提。
下面这张表回答可控性判分用的是哪些分类器,比较问题是不同属性的可控性分数是否出自可比的判分器,指标方向都是每类召回率越高表示越听从该请求。
| Attribute | Classifier | Classes |
|---|---|---|
| Gender | Vox-Profile WavLM sex head | 2 |
| Age | Vox-Profile WavLM age regressor, binned at 20/40/6020/40/60 | 4 |
| Emotion | emotion2vec_plus_large, restricted 4-way argmax | 4 |
| Accent | In-house WavLM-Large + Whisper-Large-V3 LoRA ensemble | 6 |
这张表支撑的判断与限制要一起读。性别用 Vox-Profile 的二分类头,年龄用同一模型的回归头按 20、40、60 切 4 段,情绪用 emotion2vec_plus_large 在 4 个请求类内取最大,口音是自训的 WavLM-Large 加 Whisper-Large-V3 集成。它的限制是性别只做二分类听感,年龄是回归切分而非真值,非二元与拟声 voices 没有可用分类器,情绪与口音分类器本身的误差会进入可控性读数,口音分类器的可靠性需要下一张表单独验证。
整体多样性是否达到真人水平,调参能否补上
先看通用中性指令下的整体比较,测量对象是 3 个 10000 条集合上的 Vendi 与平均距离,比较双方是 7 个系统输出与配对 Emilia 原始录音,文本内容一一对应,指标方向都是越大越多散。结论是在 8 个编码器各自看来,所有系统都低于真人参考,两个指标给出的相对排序大体一致,MOSS-VoiceGenerator 最接近真人,VoxCPM2 坍缩最严重,远远落在其他模型之后。
采样温度 × 无分类器引导尺度: 采样温度控制离散音频词元抽样的随机程度,温度越高越随机;无分类器引导尺度控制生成向条件靠拢的强度,取值大于 1 通常更贴合指令而更收敛,两者都是解码阶段调节多样性与贴合度的旋钮,论文用它们检验差距是否只是默认参数偏保守。
读这张总体条形图时注意颜色与误差含义,橙色是真人,蓝色是系统,误差条是 3 个生成批次之间的标准差,不是属性子集的置信区间。左图 Vendi 与右图平均距离都显示橙条明显长于所有蓝条,且系统之间的高低顺序在两图中基本保持。
看图路径: 1. 左为 Vendi、右为平均成对余弦距离,橙色为真实录音,蓝色为七个系统;2. 比较每个蓝色条与橙色条的长度差距,并看 MOSS 与 VoxCPM2 分别处于最接近和最坍缩的位置;3. 注意误差条是三个生成批次之间的标准差,多数系统批次间波动很小
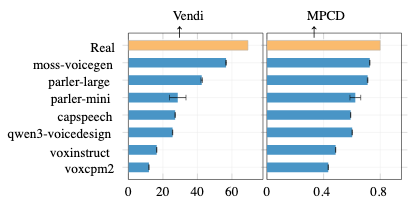
论文图 3。原论文 Figure 3::“Overall speaker diversity under the neutral prompt.”。
这张图确实可见的是没有任何蓝色条追上橙色条,MOSS 的蓝条最高但仍有可见缺口,VoxCPM2 的蓝条最短,Parler 两档与 CapSpeech、Qwen3、VoxInstruct 居中且批次波动很小。它帮助理解的是差距不是某个编码器巧合,而是 8 个编码器一致的方向。
为排除默认解码偏保守的解释,论文对开放解码控制的 3 个系统扫采样参数,MOSS 扫温度 T,VoxInstruct 与 VoxCPM2 扫无分类器引导尺度,取值都是 0.5 到 2.5,温度 1 与引导尺度 1 附近为常规区。MOSS 与 VoxCPM2 的变化符合预期,温度升高 Vendi 上升,引导尺度超过 1 后 Vendi 下降,VoxInstruct 没有一致规律。关键是即使取各自最多散的配置,在 8 个编码器中仍没有系统达到真人线,相对排序也与默认设置一致,因此差距与排序不是默认参数的人为产物。原文在温度子图标出真人参考线为 68.3,引导尺度子图共用同一纵轴与同一参考线,读者复现时应固定八编码器平均与 3 种子的做法再对比。
女性与男性、儿童到老年的请求得到同样多样的声音吗
性别与年龄子图的横轴是每类召回率,纵轴是 Vendi,每个颜色是一个系统,形状区分具体取值,年龄的随机基线是 0.25。性别一侧的可控性大多成功,7 个系统中有 6 个在女性与男性上都超过 0.88,只有 VoxInstruct 的男性召回率低到 0.776。但可控性好不等于多样性对等,7 个系统中有 5 个的女性 Vendi 明显低于男性,极端例子是 Qwen3-TTS 女性 16.6、男性 28.1,女性只相当于男性的 59%。只看是否听得出性别会漏掉种类差距。
年龄一侧 5 个系统随请求年龄变化明显,两个 Parler 模型几乎不变。最低多样性的年龄组随系统而异,但 MOSS、Qwen3 与 VoxInstruct 都是儿童组最低。可控性上所有系统的最低召回都落在儿童或老年,老年组在 4 个系统中掉到随机基线之下。于是出现两种不同失败,老年常是可控性低而多样性不低,儿童在 Qwen3 这类系统是可控性最高但多样性最低,只测一侧都会误判。
下面这张散点图把上述横纵关系 1 次画出,读图前先明确任务是找同色两点纵向落差与横向位置的错位,而不是看哪个系统整体最高。
看图路径: 1. 横轴是分类器召回率代表的可控性,纵轴是 Vendi 代表的多样性,颜色代表系统,空心与实心区分女性与男性或不同年龄;2. 在性别子图中看同色两点纵向落差大而横向都靠右的现象;3. 在年龄子图中看虚线 0.25 右侧与左侧点的分布,以及老年组常靠左、儿童组纵向偏低的例子
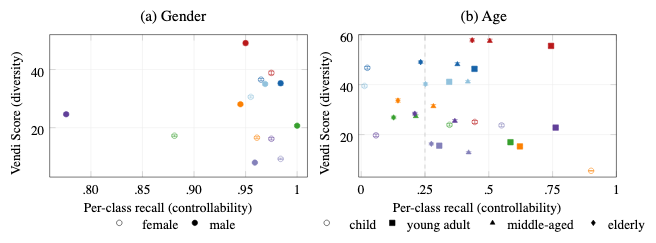
论文图 5。原论文 Figure 5::“Controllability versus diversity across gender and age conditions.”。
这张图确实可见的是性别面板多数同色空心女性点低于实心男性点,但横向都挤在高召回右侧,年龄面板老年与儿童点常偏左而纵向分散,误差条小于标记所以几乎看不见。它帮助理解的是多样性偏差与可控性偏差可以反向出现,高召回的女性与儿童仍可能是最不散的一组。
下面这张表是性别乘年龄交叉的直接证据,比较问题是在固定年龄段内女性是否仍然更不散,以及两个单属性最差值叠加是否造成复合放大,表中数字是八编码器平均后的 Vendi,加粗为每列最低。
| Age | Gender | MOSS-VG | Parler-large | Parler-mini | CapSpeech | Qwen3-TTS | VoxInstruct | VoxCPM2 |
|---|---|---|---|---|---|---|---|---|
| Child | Female | 27.8 | 36.0 | 32.0 | 14.2 | 6.5 | 13.3 | 31.5 |
| Child | Male | 43.3 | 35.8 | 36.1 | 17.1 | 25.2 | 21.2 | 38.4 |
| Young adult | Female | 36.3 | 36.3 | 32.1 | 12.4 | 9.5 | 12.6 | 28.0 |
| Young adult | Male | 46.5 | 36.6 | 35.9 | 13.3 | 19.9 | 17.8 | 19.9 |
| Middle-aged | Female | 40.7 | 35.8 | 32.4 | 19.2 | 24.6 | 12.9 | 23.5 |
| Middle-aged | Male | 47.3 | 35.0 | 35.1 | 21.8 | 27.3 | 18.5 | 21.1 |
| Elderly | Female | 40.4 | 36.2 | 32.3 | 17.5 | 27.7 | 13.9 | 36.5 |
| Elderly | Male | 48.0 | 36.7 | 35.7 | 19.4 | 25.6 | 20.1 | 30.2 |
这张表支撑的判断需要分两层。第一层是性别差距在多数年龄段持续存在,女性整体更不散的 5 个系统中,MOSS、Parler-mini、CapSpeech-NAR、VoxInstruct 在每个年龄段都是女性低于男性,Qwen3 除老年组外也如此,例如 Qwen3 女童 6.5 对男童 25.2。第二层是复合放大只在部分模型成立,只有当某年龄段的性别差距大于其他年龄段才算复合,满足的是 MOSS 与 Qwen3 且都发生在儿童组,Qwen3 女童因此成为全表最低。它的限制是 Parler 两档的最低值在置信区间内重叠,VoxInstruct 与 VoxCPM2 的最低年龄从单属性的儿童或中年漂到交叉的青年组,不能把单属性最差简单相加推广到所有系统,读者应拿它与上一张散点图的单属性结果对照读。
口音与情绪的偏差藏在哪一侧,自训口音分类器可信吗
口音与情绪呈现与性别相反的错位。口音的多样性随请求口音变化很小,但可控性明显偏向北美英语,北美是唯一在所有系统中召回率都不低于 0.744 的口音,英音多数系统排第二但仍落后北美,其余大洋洲、南亚、南非在至少 4 个系统中掉到随机基线之下,日耳曼组在 6 个系统中失败。只看多样性会完全错过口音偏差。
情绪同样是多样性大体持平、可控性偏向中性,中性在所有系统中都超过随机基线并在 5 个系统中排第一,生气、高兴、难过在至少 4 个系统中低于基线,只有 Qwen3 在 3 个 expressive 情绪上都超过基线。混淆矩阵显示 expressive 请求常被判为中性,5 个系统中中性是所有输出里最常见的预测,两个 Parler 模型最常见的是难过,因此中性的高召回混入了系统本身偏平淡的倾向。
在采信口音可控性之前需要先看分类器验证。训练数据以 CommonVoice-17 为主,北美 40000 条 4350 人 58.6 小时,英音 20000 条 1410 人 29.0 小时,南亚加 L2-ARCTIC 印地语 16000 条 1221 人 24.8 小时,大洋洲 14000 条 548 人 20.6 小时,南非加 AfriSpeech 南非部分 8495 条 313 人 15.4 小时,日耳曼加 VoxPopuli 德荷议会英语 1799 条 109 人 3.5 小时,按说话人不重叠切 6 比 2 比二并每人至多 150 条。模型冻结双骨干只训 LoRA 与卷积池化分类头,用逆频率加权与加噪、掩蔽、变速、极性翻转增强,以验证宏平均 F1 选点。
下面这张表回答分类器本身是否对 6 个区域一视同仁,比较问题是跨区域可控性差异能否甩锅给分类器灵敏度不均,指标是说话人独立测试集上的每类 F1 与宏平均,方向越高越好。
| Region | WavLM | Whisper | Ensemble |
|---|---|---|---|
| North America | 0.868 | 0.880 | 0.881 |
| British English | 0.802 | 0.771 | 0.825 |
| South Asia | 0.905 | 0.920 | 0.918 |
| Germanic | 0.842 | 0.906 | 0.887 |
| Oceania | 0.840 | 0.793 | 0.873 |
| South African | 0.832 | 0.869 | 0.871 |
| Macro-F1 | 0.848 | 0.856 | 0.876 |
这张表支撑的判断是分类器可作为评估器。集成宏平均 0.876 远高于 0.167 的随机水平,每类 F1 集中在 0.825 到 0.918 之间,即使最低资源的日耳曼组也有 0.887,与北美 0.881、南非 0.871 相当,因此后文北美远高于其他区域的召回差距不能归因于分类器偏心。它的限制也很具体,南亚与日耳曼的单项上 Whisper 略高于集成,训练量本身仍不均衡,日耳曼只有 3.5 小时,读者在引用老年与口音结论时应同时说明分类器误差与数据不均衡仍是残留不确定性,未胜出的口音与情绪正是需要对照主结果一起读的负结果。
这些结论在什么边界内成立,还有哪些没测
先划定适用范围。生成、提示与文本全是英语,口音分区也是英语内部的区域变体,非英语不在结论内。性别只做到女性与男性的二元听感提示与二元声学分类,非二元或中性化声音因为没有可用的声学分类器与标注语料而未进入定量分析,论文明确这是测量约束而非价值判断。评估面板只有开源权重模型,商业指令平台因访问、成本与服务端不透明更新而未纳入,跨平台推广需要另做标准化协议。
再说明测量本身的约束。多样性分数依赖说话人验证嵌入空间,本文用 8 个通过校准的编码器平均来降低单编码器偏好,但嵌入仍可能对口音、情绪、年龄的声学变化敏感,附录的跨集合距离对编码器筛选力弱,因此不能把 Vendi 读成人数真值。可控性依赖分类器,年龄是回归切分,情绪只在 4 类内取最大,口音是自训集成,它们的误判会直接进入召回率,中性与难过的高召回都混入了系统基线倾向。
关于资源可得性,本次只依据论文正文与本次收到的官方原图写作,未能确认代码、模型或数据的当前可达状态,因此不宣称作者资源已公开或可运行,这只是来源确认状态,不是技术缺陷。环境与数据许可方面,论文报告在 B200 上完整跑通用加属性两组实验约需 842 小时生成加 59 小时嵌入共约 901 小时,Emilia 与部分口音增强语料以及 CapSpeech-NAR 一侧为非商业许可,派生音频与统计只能用于非商业研究。
什么时候值得用这套审计,复现第一步做什么,还缺哪项验证
当你的任务需要用一句宽泛描述批量造人时,这套审计值得先跑。例如要给会话智能体造一批不同人物,或要给下游语音模型合成覆盖面广的训练语料,只看是否听得出性别、年龄、口音是不够的,必须同时看同条件下的 Vendi 是否接近真人参考,以及女性、儿童、少数口音、 expressive 情绪是否系统性更不散或更不可控。论文的互补视角可以直接搬走,可控性高而多样性低对应女性与部分儿童组,多样性持平而可控性低对应口音与情绪组,两类都需要修。
复现第一步不是直接生成,而是先重做编码器校准。按原文 k 网格在 LibriSpeech 上构造已知人数子集,固定子集大小与重复次数,画出平均距离与 Vendi 曲线,只保留动态范围大且相邻步差超过标准差的编码器,再用保留集合去量系统。接着固定文本共用、模板数量、子集大小与八编码器平均的聚合方式,通用部分与属性部分分开跑,分类器用原文指定的头与切分,口音分类器按表中的数据配比与集成方式重训并先验证宏平均与每类 F1,再读生成侧的召回与 Vendi。
还缺的验证集中在三处。一是把校准与分类器扩展到非英语与非二元声音,并补人类听感实验,因为现有分类器覆盖不了这些维度。二是把商业闭源系统纳入同样多种子与同样文本的标准化比较,控制服务端更新带来的不可复现。三是把多样性缺口与下游效果连起来,例如用不同多样性水平的合成语料训练下游说话人或识别模型,看偏斜是否真实传导,只有补了这一环才能把审计分数换成部署决策。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses