共分析 15 篇论文
⚡ 今日概览
✅ 筛选入选 15 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 口语理解 | 2 篇 | ██ |
| 音频理解 | 2 篇 | ██ |
| 刺激到脑响应预测 | 1 篇 | █ |
| 异常声音检测 | 1 篇 | █ |
| 病理语音评估 | 1 篇 | █ |
| 语音交互 | 1 篇 | █ |
| 语音可懂度评估 | 1 篇 | █ |
| 说话人分离标注 | 1 篇 | █ |
📊 论文评分排行榜(15 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 OmniScore-Bench:把乐谱阅读拆成六类操作分别考查

英文题目:OmniScore-Bench: Evaluating Vision-Language Models on Musical Score Reading
评分:7.3/10 | 创新 1.4/2 | 技术严谨 1.5/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Congren Dai:Central Conservatory of Music;Tsinghua University
- Zhancheng Guo:Central Conservatory of Music;Tsinghua University
- Danni Zhao:Central Conservatory of Music
- Wenchu Wang:Central Conservatory of Music;Tsinghua University
- Xiaobing Li:Central Conservatory of Music
- Maosong Sun:Central Conservatory of Music
📌 核心摘要
视觉语言模型能回答乐谱问题,但定位符头、关联声部与解释时值等操作是否可靠仍需分别检验,区别于仅报告转录总分的已有光学乐谱识别评测,单独转录分难以定位瓶颈所在。OmniScore-Bench把一次读谱拆成可单独观测的请求,每题声明可见范围、参考标注与答案格式,输入为乐谱图像及目标标识、结构归属或解释规则等文字条件,输出为符号框、归属判定、关系边、MusicXML转录或带证据的问答答案。构建先按图像与编码对应生成候选题目并输出题面与参考标注,再将这些题目送入自动检查与两名专家独立审核,最后分歧由第三名专家裁定并形成正式评测集。六个方面覆盖渲染、印刷扫描与手写三种来源,每种来源1000题,每子类型125题,共3000题,覆盖24个任务子类型。在多页转录T4.4的125题评测上,Claude Opus 5.5的CER为64.3,低于Qwen 3.8 Max的79.8,数值越低越好。配对去图对照在保持文字条件与输出格式不变下移除全部乐谱图像,显示音高与反复展开依赖图像,而结构归属与片段变换在无图时仍保留部分成功率。结论适用于所选题目与给定条件,不支持跨页数因果推断,残余误差仍大。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 eDIAR:不重训的开放人数流式说话人日志

评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kyudan Jung:KAIST AI
- Jihwan Kim:KAIST AI
- Minwoo Lee:KAIST AI
- Eunji Shin:Ewha W. University
- Jaegul Choo:KAIST AI
📌 核心摘要
会议记录需要从连续音频中标出每段时间由谁说话,输入是整段录音,输出是带说话人编号的时间边界。难点在于事先不知道人数,固定通道模型人多时只能合并,逐帧在线聚类又容易把早期错误延续到最后。eDIAR 保留原有槽位输出对活动与重叠的判断,只把人数超出槽位的问题交给聚类。音频按 80 毫秒分帧,一路经槽位头得到 8 维活动概率,一路经嵌入模型得到 256 维单位向量,两路并行且参数冻结。槽位未用满时每个槽位视为一人,用满后才对槽位内单人帧做球面聚类拆分。流式运行时只重算最近 90 秒,标签在 10 秒内可改,子簇身份挂靠原槽位,跨录音则把全档案帧向量统一聚类后投票定身份。在 20 人的合成会话上,非流式系统的 DER 从 8 槽位头的 66 % 降到 44 %,从 4 槽位头的 81 % 降到 44 %,DER 越低越好,比较在相同合成条件下进行。长会议的单次更新计算量不再随时间增长,百万帧可在数秒内完成,但快速轮替的长多人会议误差仍会随时间上升。原文未披露训练成本,推理成本以浮点运算与实测延迟报告。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 能说出依据的文本生成音频评价器 CoTTAGE

英文题目:CoTTAGE: An Explainable Judge for Text-to-Audio Generation
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yu-Xiang Lin:National Taiwan University
- Yun-Man Hsu:National Taiwan University
- Bo-Ru Lu:Amazon AGI
- Kuan-Po Huang:National Taiwan University
- Wenze Ren:National Taiwan University
- Ming-To Chuang:National Taiwan University
- Chun-Yi Kuan:National Taiwan University
- Jiawei Du:National Taiwan University
- Byeonggeun Kim:Amazon AGI
- Qingming Tang:Amazon AGI
- Chieh-Chi Kao:Amazon AGI
- Ankur Gandhe:Amazon AGI
- Chao Wang:Amazon AGI
- Hung-yi Lee:National Taiwan University;NTU AI-CoRE
📌 核心摘要
文本到音频生成把文字描述转为环境声音,评测要同时回答声音是否贴合描述以及声音本身是否自然清晰,人工听评准确但费时费力,成为迭代瓶颈。本文评估器以音频波形为输入,判断文本贴合性时附加文字指令,判断整体质量时只给音频,不给文字指令,以免按内容猜分。输出顺序是先写自然语言诊断再给出 1.00 到 5.00 的评分。训练先用大模型按真实平均意见分改写推理痕迹做监督微调,使模型学会贴合标注的解释,再用强化学习比较同批样本对的偏好概率来校正排序。与只算余弦相似度的基线不同,该方法显式检查事件有无、顺序与失真等声学证据。在文本相关性的 XACLE 评测上,本方法皮尔逊相关系数为 0.685,高于 CLAPScore 的 0.472 与 Gemini-3.1 Pro 的 0.551,方向为越高越好。结论目前只在 30 秒内英文环境声短片段上验证,音乐、语音与长音频结构尚未覆盖。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 网页智能体如何处理跨应用与音视频任务:WebArena-Pro 解读

英文题目:WebArena-Pro: A Heterogeneous, Multimodal, Reproducible Benchmark for Web Agents
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.9/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Imene Kerboua:机构信息未能在本次解析中与作者逐人可靠绑定
- Fatemeh Pesaran Zadeh:机构信息未能在本次解析中与作者逐人可靠绑定
- Xing Han Lù:机构信息未能在本次解析中与作者逐人可靠绑定
- Weijian Qi:机构信息未能在本次解析中与作者逐人可靠绑定
- Alexander Miller:机构信息未能在本次解析中与作者逐人可靠绑定
- Junyi Song:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunjia Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Dongjin Kang:机构信息未能在本次解析中与作者逐人可靠绑定
- Seyeon Choi:机构信息未能在本次解析中与作者逐人可靠绑定
- Marzia Nouri:McGill University Mila – Quebec AI Institute
- Ewen Gueguen:机构信息未能在本次解析中与作者逐人可靠绑定
- Matteo Boglioni:McGill University Mila – Quebec AI Institute
- Fengyuan Liu:McGill University Mila – Quebec AI Institute
- Zeyi Liao:机构信息未能在本次解析中与作者逐人可靠绑定
- Mengqi Yuan:The Ohio State University University of Hong Kong
- Yue Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Alexandre Lacoste:机构信息未能在本次解析中与作者逐人可靠绑定
- Alexandre Drouin:机构信息未能在本次解析中与作者逐人可靠绑定
- Spandana Gella:机构信息未能在本次解析中与作者逐人可靠绑定
- Huan Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Gunhee Kim:INSA Lyon, LIRIS Esker Seoul National University
- Siva Reddy:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
网页智能体需在接口各异的应用中完成跨文本视觉与时间媒体的浏览器操作,但已有可复现基准仅覆盖少数应用且限于文本与视觉,而真实网站评测又随页面漂移难以复现。WebArena-Pro用20个自托管应用覆盖6类领域,提供300个人工校验任务,任务输入为自然语言意图、起始站点与已登录浏览器状态,输出为浏览器操作序列与最终页面状态,难点在于认证流程与数据模型差异大,且关键证据藏在语音或视频画面中。观测先以可访问性树与截图共同呈现页面元素,媒体来源以节点形式暴露其中供定位。再由转写工具transcribe()把语音段变为文本节点、抽帧工具extract_frames()把视频段变为图像观测送入智能体,原生多模态模型则可用listen()与watch()直接接收音视频。最后每个任务在独立播种容器中隔离运行并在开始前重置,任务经标注界面编写、模型初筛与人工复核后发布,保证并行评测可复现。在300个测试任务、每任务50步预算下,以全部细则通过比例计算的成功率为指标,Codex搭配GPT 6.1 Sol的成功率为62.3%,高于OpenCode搭配Kimi 3.1 Pro的60.7%。在43个必须依赖媒体内容的子集上,以成功率为指标,Claude Code搭配Claude Opus 5.5无媒体工具时成功率为14.0%,低于加入转写与抽帧后的48.8%。跨站协调、视觉计数与时间定位仍是主要失效点,当前仅支持预录片段,未验证实时语音与直播流,原文记录单轮300任务推理开销约为Codex 166美元、Claude Code 386美元,判分不足4美元,未披露训练成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 任意通道数、单一令牌流:SpheraAudio 如何让大音频语言模型听懂空间

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Yuhuan You:Alibaba Group
- Wenxiang Guo:Zhejiang University
- Zhifang Guo:Alibaba Group
- Yuxuan Wang:Alibaba Group
- Jin Xu:Alibaba Group
📌 核心摘要
需要理解的对象是通道数不定的录音,可能是单声道、双声道或声场录音,输出是对声源方向、距离、数量与运动的回答,困难在于方向与距离线索藏在通道间时间与相位差里,单通道模型为保证通用理解稳定常丢掉这些信息。方法先用音频编码器提取语义内容得到音频记号,再用空间编码器从多通道复数频谱提取方向与距离证据得到空间记号,两路经投影对齐到同一语义空间后按时间配对交错排列成单记号流送入语言模型做问答。空间多模态旋转编码让同一时刻的两枚记号共享时间坐标又能区分模态以便在查询时间窗内同时检索内容与几何证据,最后语言模型以逐步几何推理输出答案,训练先做空间编码器几何预训练,再做投影对齐与带推理过程的监督微调,最后用结果奖励做策略优化。与把音频压成单通道内容的已有大音频语言模型不同,该单记号流同时保留内容与几何证据并维持模态内时间关系,意味着细粒度定位可与内容理解并行,且同一接口兼容多种录音格式与立体声问题。在相同多通道录音与问题提示的包含20492个问题的SpheraQA整题正确率评测上,本文方法的ACC为60.18%,高于Spatial-Omni-7B的41.65%。结论适用于静态与运动声源的高精度定位、跟踪和简单推理并保留通用转写与分类能力,对录音设备变化和复杂混响的覆盖仍有限,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 一个编码器回答多种语音判断:Marimba 系统解读

评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Solano Amadori:charcot.ai
📌 核心摘要
语音助手等场景需要在同一音频窗内同时回答术语是否出现、轮次是否结束、是否有人声以及语种,难点在于一次编码要支撑多种类型化问题并对罕见词给出可校准的置信度。先把8秒单声道16 kHz音频送入冻结的语音识别编码器提取帧特征,再把词汇类问题送入解码器做零样本转写打分,最后把非词汇类问题送入按问题调节的预测头或独立的轮次结束读出,语种判断复用识别模型自带的语言分数。词汇打分复用同一窗口的一次贪心转写加四路束搜索假设并做逻辑回归校准,非词汇预测在相同编码上按问题分别输出类型化分布,轮次读出只汇聚有效帧最后两秒。与需要逐问题生成文本的音频大模型不同,该设计一次编码回答多个类型化问题,且词汇判断不需要针对词表再训练。在合成巴西葡萄牙语语音上,个人信息检测的条目级F1为0.904,低于参考转写上同一管线的1.000。同一窗口端到端p95延迟在单卡L4上词汇路径为2.35 s,轮次判断为13 ms,词汇路径依赖自回归解码而难以直接用于流式交互。结论适用于朗读与会议等已测分布,罕见药名仍受转写漏检限制,场景分类等未训练任务停留在机遇水平,原文未披露训练成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 多语自监督语音编码器知道多少句子含义

英文题目:What Do Multilingual Self-Supervised Speech Encoders Know About Sentence Meaning?
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kevin Krahn:机构信息未能在本次解析中与作者逐人可靠绑定
- Eric Fosler-Lussier:Dept. of Computer Science and Engineering;The Ohio State University
📌 核心摘要
该工作要回答大规模多语言自监督语音编码器是否已经组织出可跨语言复用的句子语义。输入是任意语言的整句朗读语音,输出是在冻结多语言文本嵌入空间中的位置并以跨模态检索衡量,难点在于语音表示长期偏向声学和音素相似而非同义接近,且语言资源极不均衡。研究冻结语音编码器输出的帧级向量,先经平均或轻量注意力汇聚压缩为单句向量,再经层归一化和线性映射送入冻结的SONAR英语文本向量空间,用语音到文本的对比损失训练探针。探针训练分单语言、多语言联合和留一语言三种供数方式,分别检验句义可解码量和未见语言上的零样本迁移,并在每个模型的最优层比较。与直接微调语音编码器去对齐文本空间的监督做法不同,该文不更新语音与文本主干,只用线性映射度量已存在的内容。在FLEURS多说话人集上580M参数的w2v-BERT-2.0多语言探针非英语平均top-1准确率为47%,高于其单语言探针的36%,表明一个线性映射可同时服务多语言。同一评测中OmniASR-W2V-7B经CTC与LLM式转写调优后单语言准确率从30%升至76%和82%,但留一差距同步拉大,表明增益集中在语言相关方向。结论适用于中高资源语言的跨说话人检索,对低资源和单说话人圣经语料不再成立,探针训练扫描共耗费约150个NVIDIA H200 GPU小时。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 只用少量观察记住人:多模态人物概念如何应对外观、噪声和说话内容的变化

英文题目:Multimodal Person Concept Model for Person Identification under Varying Observation Conditions
评分:6.6/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 1/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mizuho Okitani:机构信息未能在本次解析中与作者逐人可靠绑定
- Yoshinobu Hagiwara:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
家庭和办公室服务机器人需要从很少的相处中认出使用者,才能提供贴合偏好和过往交互的服务。困难在于学习时的外貌、环境噪声和说话内容与再次见面时常常不同,单一线索容易失效。论文把每人每次10秒的视频帧、整段波形和语音转写文本当作观察,把同属一人的多段观察归为一个人物概念,学习阶段不用身份标签,也不用预先告知人数。先由对比语言图像预训练(Contrastive Language-Image Pre-training, CLIP)提取视觉和语言特征,由对比语言音频预训练(Contrastive Language-Audio Pretraining, CLAP)提取声音特征,三种512维特征各自经主成分分析(Principal Component Analysis, PCA)压缩到4维后输出低维多模态特征。再把低维特征送入基于允许新增人物的中餐馆过程(Chinese Restaurant Process, CRP)先验的生成模型,对每个概念的每维特征用高斯分布建模,用吉布斯采样推断每段观察的概念归属并挑选代表性划分。最后识别时比较新观察在各概念下的对数似然并取最大者作为身份,三模态似然相乘融合使剩余线索补偿受损模态,这与已知人数后聚类的k均值基线不同。八种外观、噪声和转写损坏单独及组合变化下的平均识别准确率为0.89,高于已知人数的k均值基线的0.88,试验在6人各18段共108段的划分上统计正确比例。结论适用于短时录制和小规模人群与合成损坏,更多人数和自然变化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 外呼智能体先听清对面是谁:四类远端检测
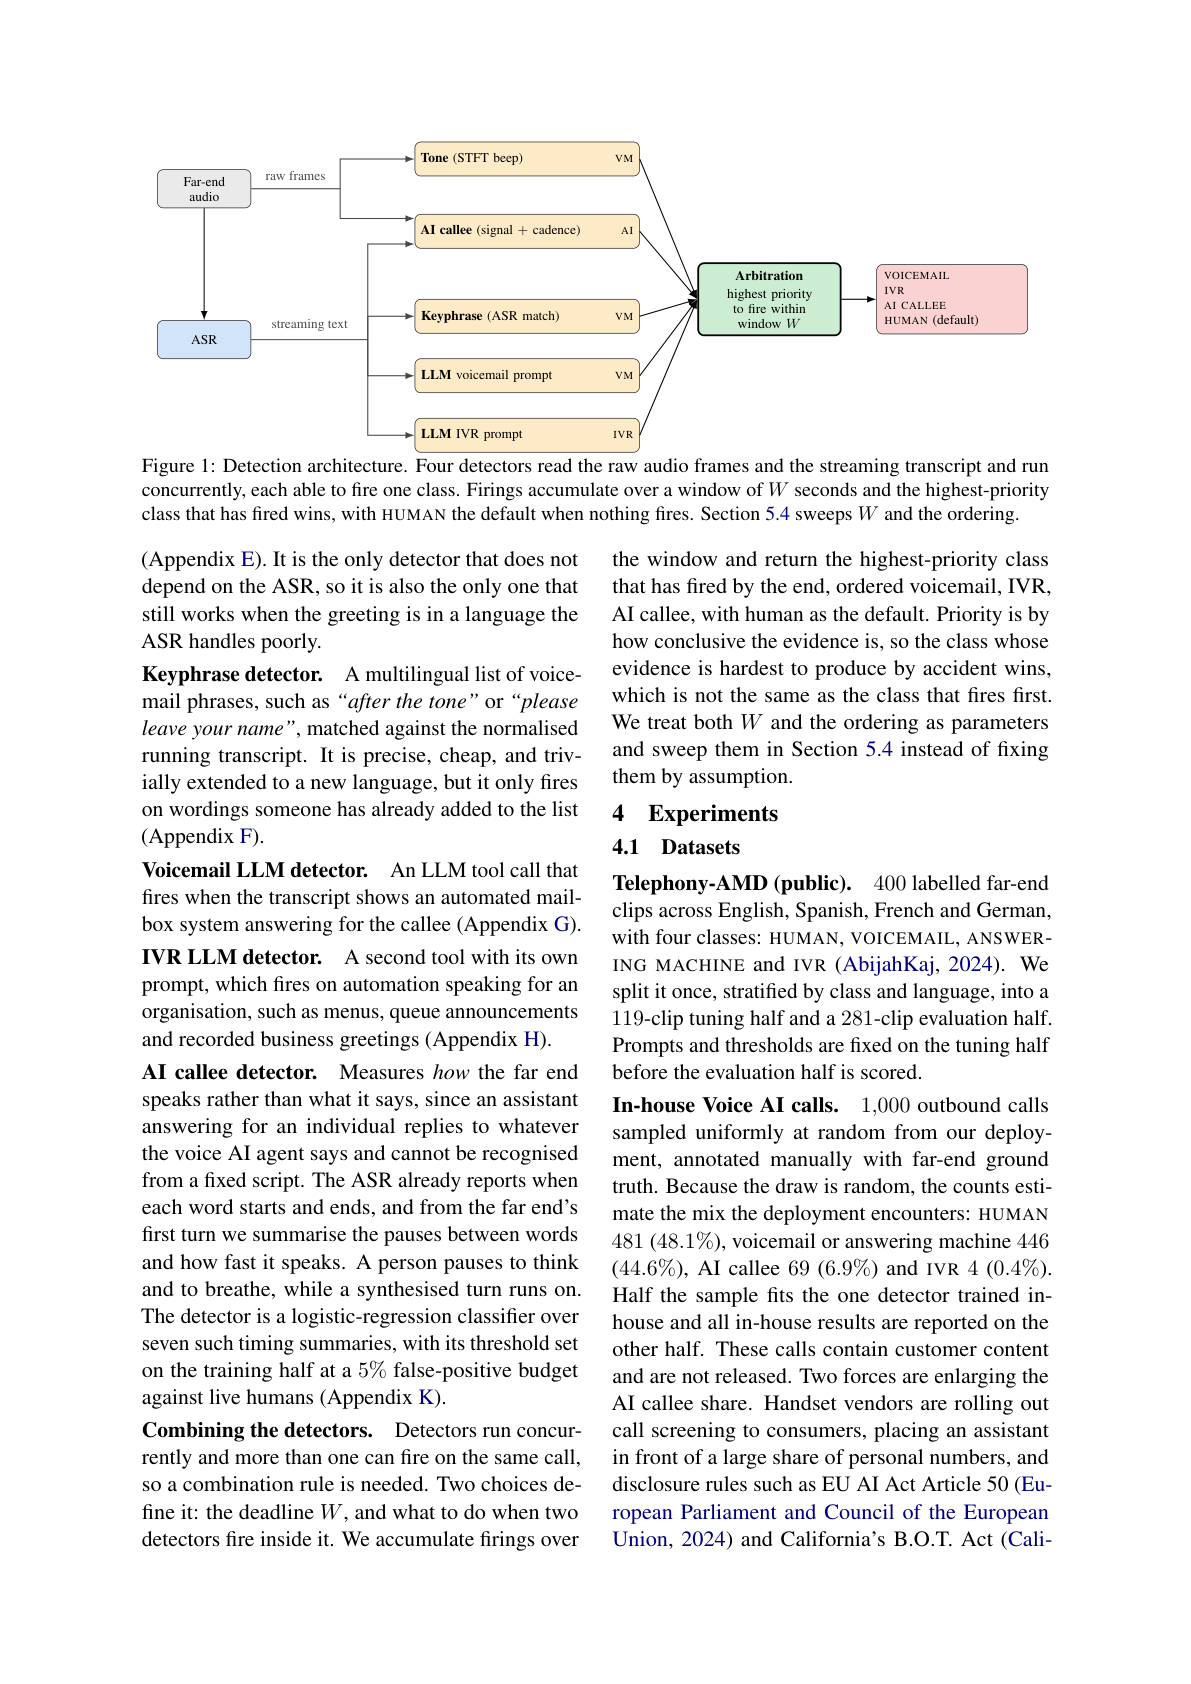
图片来源:原论文 PDF 第 3 页(含图 1)。完整图注与解读见独立文章。
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Abhishek Kumar:机构信息未能在本次解析中与作者逐人可靠绑定
- Suraj Agrawal:机构信息未能在本次解析中与作者逐人可靠绑定
- Aashraya Sachdeva:Observe.AI, India
📌 核心摘要
外呼语音智能体接通后需先判远端身份,输入为远端单通道音频与流式语音识别文本,输出为真人、留言信箱、机构自动语音、代接智能体之一,难点是后三者分别对应留言、导航停留、短暂交谈,传统二值应答机检测无法区分。先由多个检测器并行读取同一通话,音调检测器在频域提取录音提示音输出是否含哔声,关键词检测器从转录文本提取留言常用说法输出命中与否。再由两个语言模型工具分别读取流式转录文本输出信箱留言特征与机构自动应答特征判断,节奏分类器从首轮话语词间停顿提取配速特征输出代接分数,上述证据均送入仲裁。最后在20 s窗口内按证据确凿程度仲裁输出唯一标签,无确凿证据时默认保留真人标签。在公开Telephony-AMD留出评测半区上,留言融合的准确率ACC为1.000,高于同一半区上音调检测器的0.930。在1000通自有生产通话的留出半区上,区分真人与一切自动远端的F1为0.979,留言优先排序的四分类准确率ACC为0.938,高于代接优先逆序的0.796。在该生产留出集上,首轮话语节奏模型区分代接智能体与真人的ROC-AUC为0.952,该判断只适用于开口词数足够多的通话。结论限于所用数据与20 s窗口,留言证据需等待问候语和提示音,部署开销按窗口内触发为条件从接通计时,音调、关键词与节奏检测消耗可忽略,语言模型中位延迟8.91 s且中位消耗604+41词元。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 只用机器类型标注时,分离特征与配对混合如何做异常声音检测

英文题目:Anomalous Sound Detection Using Separation Features and Paired-Mixture Representation Learning
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Seunghyeon Shin:机构信息未能在本次解析中与作者逐人可靠绑定
- Seokjin Lee:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
声学状态监测输入为机器运转录音,输出为录音偏离正常状态的程度,难点在于正常声音随转速、负载与环境变化,而故障样本稀少且缺乏细粒度工况标注。处理过程先用分离器从目标类型与非目标类型混合中估计目标成分,再用聚合网络汇总冻结分离特征,最后用校正后的最近邻比较判定异常。分离器以含噪混合为输入,以目标语谱图与波形为监督目标,输出目标估计。聚合网络把编码器与时频 Conformer 各阶段特征切分为时频区域并学习区域内加权,再经多阶段融合得到段嵌入。配对混合的对比与一致性目标教会它在更换叠加声时保持同一目标段一致。校正用共享目标段在不同叠加下的嵌入差估计干扰协方差,连同正常均值对嵌入做白化,再与正常参考库做余弦最近邻比较。在 DCASE 2022 Task 2 开发测试集上,两块 64 通道代表系统三次运行平均总体调和平均值为 64.56%,高于直接配对混合学习的 62.33%,低于使用外部预训练教师的蒸馏系统的 64.87%,指标越高越好。结论适用于机器类型已知且仅有正常录音的场景,滑块校正后下降与风扇等目标域排序偏弱表明跨域稳定性仍有限。正文未给出训练时长、设备与实测延迟,参数量与推理乘加操作数据称在补充材料中报告。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 链路不可靠时音频智能体去哪算、何时放弃等待

英文题目:A$^3$: Adaptive Audio Agent Framework for Collaborative Edge Computing
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Zexin Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xueyi Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tao Ren:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiming Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
嵌入式音频代理接收用户语音并返回语音答复,链路抖动或中断会使依赖服务器的请求超时无应答,而全量本地执行又受限于内存与算力。论文研究在链路不确定时把哪些流水线阶段放在远端以及何时放弃等待,使常见情况更快且断网时仍可应答。先由链路监测输出通断状态与下行带宽估计并送入服务器路径,服务器路径整体执行识别与语言模型,再按音频下载与本地合成时间比较输出回复音频或只输出回复文本送本地合成。再由截止时刻控制器输出后备启动截止时刻并送入执行器,该时刻结合存活探测与独占运行时延分位估计确定,有别于固定百分位对冲和每步往返的切分解码。最后执行器先启动服务器路径,再在截止时刻启动设备上完整的本地三阶段后备,先完成者播放并取消另一路。在指数中断仿真中按30秒时限统计时,A3的30秒内完成请求份额为0.91,高于百分位对冲的0.87,接近知晓中断时刻的参照的0.92。在LibriSpeech数据集上,0.6B识别模型的词错误率为2.54%,高于1.7B模型的2.14%;在新加坡地铁实测链路回放中,A3的应答请求数为73个,高于仅服务器代理的70个。在全中断24请求测试中服务器路径无应答时,A3在Orin AGX上回答全部24个请求,中位14.0秒;Orin Nano因内存不足无法常驻后备而依赖服务器,周期性中断下文本回传反而变慢,全部请求触发后备时估计会失准。单请求在健康链路上额外耗能7焦耳,周期性中断下19/24请求启动后备时每请求约104焦耳,取消机制可省约30%。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 在计算机里给大脑模型做地形图审计:TRIBE v2 缺了什么、留下了什么

英文题目:An In-Silico Audit of Topographic Organization in a Multimodal Brain-Response Model
评分:6.1/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.6/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Jakub Strawa:StrawAI, Krakow, Poland
📌 核心摘要
要判断脑响应预测模型能否用于仿真实验,需弄清刺激如何变为逐顶点预测响应及位置信息何处丢失,本文审计TRIBE v2,它从自然视频、音频和文本预测皮层表面响应,而视频特征在进入响应头前经空间平均,理论上抹掉视野位置编码。作者先生成旋转楔形与扩张环、左右视野闪烁、动静点阵及对数扫频纯音等映射刺激送入模型输出预测时间序列,再将其送入与真实功能磁共振相同的拟合得到感受野位置与频率调谐,最后用保持空间自相关的球面旋转检验与人类图谱对齐,并先用植入已知图谱的替代模型校验流程,这种真值对照是与原评估仅做类别定位的关键差异。在动静点阵的运动对比评测中,最具运动选择性的1%顶点落入MT+的比例指标M2为22%,高于按MT+仅占皮层0.42%计算的随机期望,说明特征身份类仿真仍可用。在上下行对数扫频纯音评测中,核心与腰带区最佳频率四分位距指标T2为0.141个八度,低于植入已知梯度的替代模型对照的2.0个八度,表明频率位置码缺失。在旋转楔形与左右视野闪烁评测中,落入正确对侧半野的感受野比例指标R2b为0.612,仅略高于随机期望0.5,表明视野位置编码缺失。适用边界是依赖类别或运动特征的仿真可信,依赖视野或频率位置的定位绘图类仿真不受当前模型支持。论文报告全部分析含对照共耗费约8小时H100机时,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 在普通混响房间里用 6 只音箱重放仿真房间的清晰度测试场景
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ali Fallah:机构信息未能从 arXiv PDF 文本可靠映射
- Kirsten C Wagener:机构信息未能从 arXiv PDF 文本可靠映射
- Pascal Pflueger:机构信息未能从 arXiv PDF 文本可靠映射
- Steven van de Par:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
临床测听室往往没有吸声处理,也只能摆放少量扬声器,直接用扬声器播放虚拟声场景会叠加本地房间的反射,使不同诊所的言语测试结果难以比较。本文目标是在有混响的回放房间中用六只扬声器还原两个模拟房间的双耳听感,使测得的可懂度与直接在模拟参考下测得的结果一致。困难在于回放房间本身的混响会抬高整体能量并改变两耳信号的相似程度,干扰声像位置与清晰度。先将模拟参考双耳房间脉冲响应与回放房间的房间套房间响应均按分隔时间切成直达声与混响声,提取听觉滤波器组各频带能量与双耳相干作为待匹配量。再把上述失配量送入优化单元,输出各频带直达声增益、混响声增益与前后扬声器交叉混合系数,最后将直达声送入位于0°与90°的两只专用扬声器重放、混响声送入其余四只扬声器重放,并按输出的增益与系数分别校正能量与空间扩散感、对直达声施加整体增益以对齐按言语可懂度加权的清晰度指标,与此前用两只前方扬声器产生幻像声源重放直达声不同,专用扬声器使声像位置更稳定且音染更小。在混响时间为0.56 s的模拟房间同侧布局下,本文方法的SNR为-12.78 dB,低于未补偿播放的-9.35 dB并接近参考条件的-12.87 dB,以50%正确率为阈值的言语接收阈基本恢复到参考水平。该结论目前只在耳机模拟回放与正常听力人群中验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 喀麦隆两种口语变体上的 spoken NLI 试点:数据、迁移与语音识别检查
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Tiani Pekins Ebika:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
喀麦隆皮钦英语和喀麦朗弗拉语以口语为主,缺少可检验的口语语义推理数据,语音请求难以对应到电工等服务意图,跨变体能否共用模型也缺乏依据。本文构建小规模试探资源,每种变体各收录114个场景配对条目,每条包含前提文本与录音、假设文本、三类标签之一及英语意译。先将参考前提文本与假设文本拼接送入XLM-RoBERTa base微调,输出蕴含矛盾或中立标签预测,作为文本推理基线。再将前提录音送入Whisper输出转写文本,该转写经统一归一化后送入与参考前提文本的比对步骤,输出替代删除插入计数并算出词错误率,两条路径相互独立。同变体五折交叉验证平均准确率为皮钦语44.7%与喀麦朗弗拉语46.2%,均高于33.3%的三分类随机水平,但低于61.1%的英语意译参考。在跨变体非重叠拆分迁移评测中,迁移准确率为皮钦语到喀麦朗弗拉语40.1%与反向45.6%,低于对应条目放入训练后泄露审计的63.7%与60.5%,仅看假设的对照准确率相近说明标签可部分从假设措辞预测。在皮钦语114条前提录音强制英语解码的转写检查中,Whisper Large-v3的WER为66.6%,低于Base的80.3%。该结论仅适用于单说话人单标注人且无独立测试集的种子参考条件,假设偏置与端到端误差传递尚未验证,文本基线训练成本为在Google Colab单块NVIDIA Tesla T4上以批量4和序列长64微调15轮。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 跨语言、跨任务的认知障碍语音声学标记:时间为什么最稳,语速和音高为什么会变

评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Kenyu Ikeuchi:机构信息未能在本次解析中与作者逐人可靠绑定
- Tomoaki Ohtsuki:机构信息未能在本次解析中与作者逐人可靠绑定
- Michelle Cohn:机构信息未能在本次解析中与作者逐人可靠绑定
- Alyssa Weakley:机构信息未能在本次解析中与作者逐人可靠绑定
- Yui Ishihara:机构信息未能在本次解析中与作者逐人可靠绑定
- Joseph Hoang:机构信息未能在本次解析中与作者逐人可靠绑定
- Taishiro Kishimoto:机构信息未能在本次解析中与作者逐人可靠绑定
- Sarah Tomaszewski Farias:机构信息未能在本次解析中与作者逐人可靠绑定
- Jet M. J. Vonk:机构信息未能在本次解析中与作者逐人可靠绑定
- Chen-Nee Chuah:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
认知障碍语音筛查要从老年人语音中区分健康对照与受损者,困难在于不同语言的韵律分工与不同任务的交互结构都会改变声学分布,混用数据时疾病信号容易被内容和录音条件掩盖。本文使用覆盖西班牙语、普通话、英语和日语的五组数据,任务包括图片描述、朗读、自传回忆和自由会话。处理流程先用说话人分离标注剔除访谈者并拼接被试语音,再并行提取时序、韵律与频谱表示,形成单人任务255维、会话任务262维的特征向量。再对上述特征向量用双样本分布差异筛选保留区分度高的特征并由语音学专家剔除不适合整体比较的共振峰与音段特征,最后在训练折内用随机森林递归消除确定紧凑子集并送入分类器在独立测试折上评价。在英语图片描述数据ADReSSo上按二十次重复的百分之八十训练与百分之二十分层测试划分评价,KS加专家加递归消除配置的受试者工作特征曲线下面积(ROC-AUC)为0.76,高于全量特征配置的0.74。与依赖预训练嵌入的黑盒做法不同,该流程保留可解释的特征家族以便比较语言与任务的作用,跨数据集分析显示时序特征最为稳定。结论限于整体层面的声学线索,尚未验证语义句法层面与未见语言的迁移。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。