📄 只用少量观察记住人:多模态人物概念如何应对外观、噪声和说话内容的变化
英文题目:Multimodal Person Concept Model for Person Identification under Varying Observation Conditions
评分:6.6/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 1/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Mizuho Okitani:机构信息未能在本次解析中与作者逐人可靠绑定
- Yoshinobu Hagiwara:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
家庭和办公室服务机器人需要从很少的相处中认出使用者,才能提供贴合偏好和过往交互的服务。困难在于学习时的外貌、环境噪声和说话内容与再次见面时常常不同,单一线索容易失效。论文把每人每次10秒的视频帧、整段波形和语音转写文本当作观察,把同属一人的多段观察归为一个人物概念,学习阶段不用身份标签,也不用预先告知人数。先由对比语言图像预训练(Contrastive Language-Image Pre-training, CLIP)提取视觉和语言特征,由对比语言音频预训练(Contrastive Language-Audio Pretraining, CLAP)提取声音特征,三种512维特征各自经主成分分析(Principal Component Analysis, PCA)压缩到4维后输出低维多模态特征。再把低维特征送入基于允许新增人物的中餐馆过程(Chinese Restaurant Process, CRP)先验的生成模型,对每个概念的每维特征用高斯分布建模,用吉布斯采样推断每段观察的概念归属并挑选代表性划分。最后识别时比较新观察在各概念下的对数似然并取最大者作为身份,三模态似然相乘融合使剩余线索补偿受损模态,这与已知人数后聚类的k均值基线不同。八种外观、噪声和转写损坏单独及组合变化下的平均识别准确率为0.89,高于已知人数的k均值基线的0.88,试验在6人各18段共108段的划分上统计正确比例。结论适用于短时录制和小规模人群与合成损坏,更多人数和自然变化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
家庭机器人为什么认人难
家庭和办公室服务机器人要提供连续个性化服务,先要知道面前是谁,才能调出偏好和上次聊过什么。难点在于机器人刚进场时只能攒到很少几次见面,学习时和再见面时的观察条件却变了。衣服帽子换了、身体转了方向,样子就变了,屋里有厨房噪声,声音就脏了,每次说的话题不同,转写文本也不同。
已有的人脸声纹做法多依赖大规模标注数据,或者注册时就告诉系统哪段是哪个人的参考语音,只用声音一路。这在实验室外不成立,因为机器人是在日常交互里顺手收集少量多模态片段,没有人事先给标签,也不知道屋里到底有几个人。本文就针对这个条件:只用少量无标签的多模态观察,既要把观察按人分堆,又要在条件变化后还能认对人。
已有路线与本文的不同起点
人物辨识一支用深度生物特征,把脸、身体、声音放在大数据集上学跨模态匹配,能处理姿态衣服变化,但要大量标注。另一支做少样本声纹重辨识,只用 3 段参考语音,但参考段与说话人身份是绑定的,属于有监督注册,只用声音。
多模态概念形成另一支原本不做认人,做的是物体、动作和地点。用概率生成模型把视觉听觉触觉观察聚成潜在概念,有时还用分层狄利克雷过程把类别数也推出来。这套做法适合少量无标签观察,但过去聚的是外形稳定的东西。本文的特殊处是人的观察两次见面就不像了,概念形成后还要能被变形的观察再次命中。比较时要注意监督和阶段是否相同:大数据监督模型与本文无标签少样本模型不是同条件胜负,只能看思路差异。
任务的输入输出与必须保留的信息
输入是机器人站在人约 1 米前录的视频,按 10 秒切成片段,每个片段有三样东西:1 帧代表图、整段波形、Whisper 转写的文本。目标是学习阶段把这些片段按人分好,辨识阶段给一个新片段判断是哪个人,同时不知道人数。
必须保留的信息是人的身份可分性:即使衣服变了、加了噪声、文本被改坏,剩下没坏的模态还要能指向同一个人。输出是片段的概念编号,再经训练集多数投票映射到真实人名。评价是每种变化条件下 108 个片段中认对的比例,方向是越高越好。变化被拆成视觉、声学、语言 3 路单独加和组合加,共 8 种辨识条件,训练只用无变化的参考条件。
四步流程如何串起一个片段
拿一个 10 秒片段走完全程最清楚。第一步采集得到图、波形和转写,第二步分别编码压缩成 3 路短向量,第三步把所有训练片段的 3 路向量一起聚成人物概念,第四步用新片段的 3 路向量去比哪个概念最像。分支在第二步分开,在第三步汇合,共享的是同一个片段编号下的 3 路对应关系。
下图把四步画成纵向流水线,左侧是阶段名,右侧是数据形态的变化,底部还画了戴帽子导致视觉变化后仍能选对人的例子,读图时重点看 3 路在哪里分开、在哪里重新合到一个概念上。
看图路径: 1. 先从左栏 1 到 4 看主路径:采集、特征、概念形成、辨识;2. 再看中间三列颜色块如何把同一片段拆成视觉声学语言三路;3. 最后看底部戴帽子的人如何只用变化后观察得到最高柱

论文图 1。原论文 Fig. 1::“Overview of the proposed method. Only the first author is shown.”。
图中第一行是机器人在学习,多格头像里只有一张是真实照片其余是示意。第二行把同一句喜欢牛肉拆成图、语谱图和文本三块,再经不同编码器变成散点。第三行把 3 路散点汇到人物概念模型和图模型。第四行是戴帽子喝饮料的人说喜欢牛丼,机器人仍把柱状最高的那个人选出来。可见的是流程分工,不是精度证明,精度要看后文数字表。
三路特征怎样得到又为何要降维
视觉用 CLIP 图像编码器抽帧特征,语言用 CLIP 文本编码器抽转写特征,声学用 CLAP 音频编码器抽波形特征,每路原来都是 512 维。日语转写直接送进主要用英文图文训练的 CLIP 文本编码器,这是后文语言区分力弱的一个可能原因。然后在训练集上每模态各自做主成分分析,压到 4 维,辨识时用同一投影。主成分分析在这里的作用是去掉高维冗余,让距离更集中到人的差异上,代价是丢掉一些细节,但实验显示不降维反而聚不好。
CLIP × CLAP: CLIP 负责把图像帧和转写文本变成可比较的向量,CLAP 负责把整段波形变成声学向量,二者分工是把视觉、语言和声音统一为同等长度的数值特征,搭配后同一个 10 秒片段就同时拥有三路观察,为后一步按人聚类提供互补依据。
举例说,同一人两次自我介绍,一次说喜欢牛肉,一次说喜欢牛丼,文本向量可能很近,声音和长相向量却能拉开与别人的距离。3 路都保留,就是为了坏一路还有两路可依靠。原文没有报告编码器是否微调,按描述是直接用预训练编码器抽特征,只在 PCA 这一步用训练数据拟合投影。
不用人数先验如何聚类又如何辨识
图模型假设每个片段的 3 路观察来自某个潜在人物编号对应的高斯分布,每维有自己的均值和精度,均值和精度又有正态伽马共轭先验。不同模态在给定编号下条件独立,3 路高斯相乘就是联合似然。先验分配不用固定人数,而是用中国餐馆过程:已有人多的概念更容易分到新片段,浓度参数控制开新概念的概率。
中国餐馆过程 × 人物概念: 中国餐馆过程是不预设人数的先验分配规则,已有概念按人数分得新片段的概率大,新概念按浓度参数分得小概率,人物概念是每人每模态的高斯分布参数组合,二者搭配后聚类数和每类分布一起从数据长出来,一个概念就对应一个人的多模态记忆。
下图是图模型,左侧框是片段数,右侧框是概念数,灰色是观察到的 3 路特征,白色是待推的编号,右边每路各有均值精度和超参数。读图时不要把颜色当成人数,灰白只区分观察与潜在。
看图路径: 1. 先找到左侧浓度参数与片段分配变量的箭头;2. 再看中间三个灰色观察节点各连向右侧哪两行参数
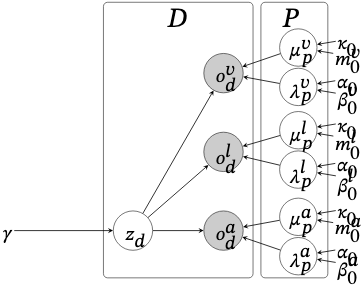
论文图 2。原论文 Fig. 2::“Graphical model of the proposed model.”。
该图确实可见的是变量依赖:编号同时指向 3 路观察,每路观察又连向该概念的均值精度。它帮助理解为何 3 路能互相约束同一个编号,但采样动态要看后文收敛曲线。
先验的具体形式是已有概念按去掉本片段后的人数成正比,新概念按浓度参数成正比。
\[p(z_{d}{=}p\mid{\bf z}_{-d})\propto\left\{\begin{array}[]{ll}D_{p}^{\backslash d}&\mbox{(existing concept \(p\))}\\ \gamma&\mbox{(new concept)},\end{array}\right.\]似然是 3 路高斯的乘积,新概念没有现成参数时从先验抽一组来算,这是 Neal 辅助参数做法。
\[\displaystyle p({\bf o}_{d}\mid z_{d}{=}p,\mu^{c}_{p},\Sigma^{c}_{p})\]推断用吉布斯采样,每次固定分布参数重抽每个片段的编号,再固定编号重抽每概念每维的分布参数。初始化让每个片段自成一类,从 108 类开始合并,空类删掉,迭代 200 次,前 100 次作燃除。最终样本的选择不用真值,用 Dahl 最小二乘准则:先算燃除后样本两两同类的后验概率,再选与该概率矩阵最接近的那个样本。
\[\Pi_{de}=\frac{1}{T-T_{\rm burn}}\sum_{t=T_{\rm burn}+1}^{T}\delta^{(t)}_{de},\]\[t^{*}=\mathop{\rm arg\,min}_{t}\sum_{d原文没有报告超参数搜索过程,给的是固定值,复现时直接沿用即可,缺的是可靠性加权,公式里 3 路等权相加,坏掉的一路会拉低总分。
数据、变化做法与比较条件
实验找了 6 人,每人录参考、相似、变化 3 种约 3 分钟视频,每 10 秒一切,每种条件每人 18 段。训练只用参考条件,辨识在相似和 7 种加变化的条件下测。视觉变化是戴耳机换衣服转身等真实重录,声学变化是在相似集波形上叠加厨房噪声,信噪比主实验为 10 dB,语言变化是把转写按 0.3 概率删词或替换词。8 条件覆盖 3 路单独变和两两组合变以及 3 路全变。
比较分三层:同框架下固定概念数为 6 和 7,看非参数推断人数是否有额外好处;外部用已知人数的 k-means,同特征同数据并按模态标准化,看不告诉人数能否追平告诉人数的传统聚类;再用 Qwen2.5-VL 只看图或只看文本或图文一起,不学参考概念,看不学人专属概念的大模型能否直接认人。指标都是每条件 108 段的正确比例。
下表说明本实验的数据规模与采集设置,比较问题是少量无标签学习是否成立,公平条件是所有方法同特征同参考集,指标方向都是越高越好。
| 项目 | 数量 |
|---|---|
| 参与者 | 6 人 |
| 每人参考条件片段数 | 18 个 |
| 每条件总片段数 | 108 个 |
上表支撑的判断是训练只有 108 段、每人 18 段的少样本条件,限制是只有 6 人且声学语言变化是合成的,不能推广到大人数和自然变化。读者应拿它和后文精度表对照,看少样本下多模态融合是否还稳。
八种变化下精度如何随模态损坏而下降
先看收敛过程。下图横轴是吉布斯迭代,纵轴是对数刻度的概念数,细线是十次试验,粗线是均值,红色虚线是真实 6 人,灰色虚线是燃除结束。起点 108 类快速掉下来,燃除结束前已贴近 6 附近,最终 6 次停在 6 类、4 次停在 7 类,说明人数是从数据推出来的,不是事先给的。
看图路径: 1. 先看横轴迭代次数与纵轴对数刻度的概念数;2. 再对比橙色均值线与红色虚线 6 人基准的贴近过程;3. 注意 100 次燃除线前后曲线的平坦程度

论文图 3。原论文 Fig. 3::“Number of concepts P over the iterations in ten trials.”。
该图确实可见的是下降极快、前 20 次合并最多、之后平坦,燃除后几乎不动。它帮助理解为何固定 6 类反而不如自动推:自动推的划分形状更贴合分布,而硬定 6 类可能卡在不好合并的位置。末步平坦不能推广到全程都稳,数值以表格为准。
概念数估计 × 人物辨识: 概念数估计是看吉布斯采样最后剩几个非空类,人物辨识是看新片段在哪个类的对数似然最大,二者共用同一套分布参数但目标不同,实验显示数对了不一定分对人,数多一个仍可能辨识正确,所以要分开评价。
下表是主结果的精简对照,比较问题是在同特征同数据下,不告诉人数的中国餐馆过程模型能否追平告诉人数的 k-means 和固定类数版本,指标都是精度越高越好。
| 条件 | CRP 模型 | 固定概念数模型 | k-means 已知人数 |
|---|---|---|---|
| 稳定 | 0.98 | — | — |
| 视觉变化 | 0.85 | — | — |
| 声学变化 | 0.97 | — | — |
| 视觉加声学变化 | 0.75 | — | — |
| 3 模态全变 | 0.76 | 0.40, 0.29 | — |
这张表支撑的判断有三层。单模态变化里声学 0.97 和语言 0.98 几乎不掉,稳定 0.98,视觉掉到 0.85,说明视觉损坏影响最大。组合变化里声学加语言仍有 0.97,视觉加声学掉到 0.75,3 路全变 0.76,说明只要视觉坏了就难。3 路全变时固定类数只有 0.40 和 0.29,平均固定类数只有 0.65,而自动推人数平均 0.89 追平 k-means 平均 0.88。限制是 k-means 逐条件数未在正文句中报告,这里只在平均行保留可核验的 0.88,逐条件谁胜只能看原文全表趋势:k-means 在多数组件稳定条件下略好,CRP 在声学、声学加语言和全变下更好。Qwen 3 路都在 0.21 到 0.36 之间,接近猜测,不构成可运行对照,未胜出项已在正文说明。
维度、可用模态与变化强度各自说明什么
维度实验把 PCA 维数从 3 到 6 和不压缩都跑十次,看恢复 6 类的次数、训练划分与真人的一致性,以及全变精度。模态实验分两层:辨识时只用子集,看已学好的概念能否被单路命中;形成时只用子集重训,看哪路对聚类真正有用。强度实验把噪声调到 5、0、负 5 dB,把文本破坏率调到 0.5 和 0.8,还把 noisy 波形重新用 Whisper 转写算字错率,看 3 模态精度是否只是因为变化太弱。
视觉 × 声学 × 语言: 视觉管长相衣服姿态,声学管音色和环境噪声下的残留,语言管转写文本的语义,三者在辨识时是相加的对数似然,在形成概念时是相乘的联合似然,搭配意义是坏掉一路还能靠另两路把片段拉回同一个人。
下表先看维度,比较问题是降维是否影响人数恢复和全变精度,公平条件是同数据同采样同选择规则。
| 设置 | 恢复正确人数的试验数 | 3 模态全变时精度 |
|---|---|---|
| 主实验降维设置 | 6/10 | 0.76 |
这张表支撑的是人数恢复与辨识成功可分离:降维设置恢复 6 类占 6/10,一致性 0.961,全变 0.76 最高;不压缩时一次也没恢复对,一致性只有 0.301,但辨识仍有 0.68。机制是高维下似然差太大,类合并不动,采样诊断里概念数变化次数降到 0。限制是只报告了这两个设置的完整正文句,其余维度的中间值要看原文全表,不要把 0.68 当成高维也够用的证明,它仍低于降维后的 0.76。
主成分分析 × 吉布斯采样: 主成分分析把每模态 512 维压到 4 维,去掉高维下微小距离被放大的影响,吉布斯采样在此低维空间里逐个重分片段并重算分布,搭配后采样链才能从每片段自成一类合并到接近真实人数,否则高维似然差太大类就合并不动。
下表看辨识时模态可用性,比较问题是坏掉一路后剩下的路能否补上,公平条件是复用同一批已学模型只重算似然子集。
| 辨识时可用模态 | 精度 |
|---|---|
| 声学变化下仅声学 | 0.53 |
| 声学变化下 3 模态融合 | 0.97 |
| 3 模态全变下 3 模态融合 | 0.76 |
这张表支撑的是互补而非简单叠加:声学坏时单用声学只有 0.53,加上另两路回到 0.97,全变下 3 路一起仍有 0.76。但等权融合不是总最优,原文指出声学坏时去掉声学反而略好,因为坏路的似然会拖累总和,可靠性加权是未来工作。形成时的对照在正文句中:视觉加声学十次全对且一致性 1.00,加语言反而降到 0.96,单语言一致性接近 0,说明当前英文为主的 CLIP 文本特征对区分人几乎无用,部分因日语与训练语言错位,部分因大家回答内容相似。
强度上声学单路从 10 dB 的 0.53 单调掉到负 5 dB 的 0.34,而 3 模态一直在 0.97 到 0.98 之间;语言单路一直在 0.16 到 0.19 猜测水平,3 模态 0.98 主要靠视觉声学撑住,不能说语言本身鲁棒。端到端重转写下字错率从 0 到 0.53,3 模态仍 0.98,同样只证明融合撑住了退化。
结论在什么边界内才成立
数据边界很窄:只有 6 人二十多岁,录制环境稳定,声学语言变化是人工叠加和删改,不是真实长期交互里的自然变化。人数、环境、会话轮次多了之后,概念数推断和精度都会变,原文也明确说需要更多人和自然变化验证。
表示边界同样窄:语言用英文为主的 CLIP 文本编码器处理日语转写,内容又都是自我介绍和食物偏好,语义区分度低,所以语言对聚类几乎无贡献。这不等于语言无用,而是当前表示不适合做身份区分,换多语言或说话人判别编码器后结论可能变。
方法边界是等权融合与离线 PCA。等权在某路严重损坏时会拖累,PCA 要先攒齐训练集才能拟合投影,增量到来的人无法在线更新。演示用的 512 维无压缩已出现过分割,说明高维下人数会估多。没有测延迟、算力和误判代价,不能承诺实时性改善。
复现第一步做什么与关键参数
先按 10 秒切分,每段取 1 帧、整段波形和 Whisper large-v3 日语转写,再用 CLIP ViT-B/32 和 CLAP htsat-fused 抽 512 维,PCA 每模态各自在参考集上拟合压到 4 维。超参数按原文固定:浓度 0.75,迭代 200 次,前 100 次燃除, kappa0 取 0.01,alpha0 取 2.0,先验均值与比率从训练 PCA 特征定,初始化每段自成一类共 108 类。
推断按吉布斯采样交替更新编号与分布,Dahl 准则选最终划分,再算后验均值用于辨识,辨识取 3 路对数似然和最大者,映射用人名在训练集的多数投票。k-means 对照要先按模态用参考集做标准化,Qwen 对照不学概念只看图或文本。复现时先跑通 4 维主设置拿到平均 0.89 附近,再做维度与模态消融,不要一开始就调浓度或改权重。缺的是在线投影与可靠性加权,增量场景需自行补做。
何时值得尝试与机器人演示说明什么
当机器人只能在几次见面里攒少量无标签观察,又要在换衣服、噪声、换话题后认人,且人数事先未知时,这套做法值得尝试。第一步是把 3 路特征都存下来并保证片段对齐,先用视觉加声学形成概念,语言先只做记忆挂靠不参与聚类,这样最稳。还需要补的验证是更多人、跨天跨房间、自然对话下的重复试验,以及可靠性加权后的提升。
下图是 Toyota HSR 上的定性演示,不是定量评测。配置与前文不同:2 人、每人约 3 分钟、10 秒一段、512 维不降维、ROS 2 采集电脑端计算。上路只给当前图像,下路只给约 5 秒声音,各自算单模态似然选概念,再取出该概念存的代表性话语回答。
看图路径: 1. 先对比上下两路输入:上为相机图像,下为声波;2. 再看中间辨识公式只用单模态似然选概念;3. 最后看右侧记忆库如何取出同一句食物偏好

论文图 4。原论文 Fig. 4::“Proof-of-concept demonstration on the HSR.”。
该图确实可见的是上下两路都选中蓝色实线概念 1,并取出同一句喜欢日本食物,机器人据此回答记得你说过喜欢日本食物。它帮助理解人物概念的用法:概念是跨模态的钩子,任一路命中都能拉出上次交互的语言记忆。即使高维过分割导致人数估多,目标人的概念仍可被命中,这与前文人数与辨识可分离一致。但演示只有两次展示,没有重复精度统计,不能当成部署可获得的效果,是否每次都能命中需另做量化。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses