📄 外呼智能体先听清对面是谁:四类远端检测
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Abhishek Kumar:机构信息未能在本次解析中与作者逐人可靠绑定
- Suraj Agrawal:机构信息未能在本次解析中与作者逐人可靠绑定
- Aashraya Sachdeva:Observe.AI, India
📌 核心摘要
外呼语音智能体接通后需先判远端身份,输入为远端单通道音频与流式语音识别文本,输出为真人、留言信箱、机构自动语音、代接智能体之一,难点是后三者分别对应留言、导航停留、短暂交谈,传统二值应答机检测无法区分。先由多个检测器并行读取同一通话,音调检测器在频域提取录音提示音输出是否含哔声,关键词检测器从转录文本提取留言常用说法输出命中与否。再由两个语言模型工具分别读取流式转录文本输出信箱留言特征与机构自动应答特征判断,节奏分类器从首轮话语词间停顿提取配速特征输出代接分数,上述证据均送入仲裁。最后在20 s窗口内按证据确凿程度仲裁输出唯一标签,无确凿证据时默认保留真人标签。在公开Telephony-AMD留出评测半区上,留言融合的准确率ACC为1.000,高于同一半区上音调检测器的0.930。在1000通自有生产通话的留出半区上,区分真人与一切自动远端的F1为0.979,留言优先排序的四分类准确率ACC为0.938,高于代接优先逆序的0.796。在该生产留出集上,首轮话语节奏模型区分代接智能体与真人的ROC-AUC为0.952,该判断只适用于开口词数足够多的通话。结论限于所用数据与20 s窗口,留言证据需等待问候语和提示音,部署开销按窗口内触发为条件从接通计时,音调、关键词与节奏检测消耗可忽略,语言模型中位延迟8.91 s且中位消耗604+41词元。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
外呼智能体接通后先要回答什么
当一个会话语音智能体主动外呼,接通瞬间它面对的问题是听筒对面是谁。输入是被叫侧单通道的连续音频帧,以及语音识别给出的流式局部转写,输出是一个行动指令:对真人继续对话,对留言信箱留言后释放线路,对组织自动语音留在在线导航,对个人代接智能体做简短自我介绍并争取转接。必须保留的信息是远端行为类型,而不是单纯有没有声音,因为不同自动化要求的后续动作完全不同。
传统电话的应答机检测只给一个人或机器的二值标签,这个设计来自有人值守的呼叫中心,那里机器都意味着跳过、不值得区分。但当呼叫方本身也是智能体,通话时间便宜,昂贵错误变成挂断真人或对着自动化念脚本。论文统计的 1000 通随机生产外呼中,真人占 48.1%,留言系统占 44.6%,代接智能体占 6.9%,组织自动语音占 0.4%,说明超过一半接通不是真人,且已有不可忽略的一类是会对话的筛选助手,二值标签无法表达这一类。
已有二分类与反欺诈工作为何不够用
商用应答机检测多为可配置服务,Twilio 约 4 s 给出人或机器,Sinch 等到哔声再信令,Telnyx 虽为苹果来电筛选加了设置但每通仍只给一类,Asterisk 的 app_amd 则是基于静音与词长阈值的规则机。研究侧从能量与节奏启发式做到卷积与循环模型,也有在 7.7 万通生产通话上用 15 个时域语音活动特征做到 96.1% 准确率的实时留言检测,但目标仍是二分类,没有区分机器种类,而这正是语音智能体需要的区分。
与代接智能体最接近的是反欺诈的 ASVspoof 5 基准及相关结论:近期结果显示多数预训练检测器在当前合成与后处理下接近或低于随机,在野外深度伪造上曲线下面积下降约 48%,论文的声学阴性结果与之一致。另一条线是轮流与端点检测把对话节奏当控制信号,论文转而把节奏当作说话人证据,这在远端分类中此前没有这样用过。比较时要注意任务与输入并不相同:反欺诈多判整段是否为合成,本文是在线流中判远端行为类型,不能把指标直接换算成胜负。
四类如何划分才互不重叠
论文把远端定义为 4 类。human 是真人,应继续对话。voicemail/am 是替被叫录音的信箱问候或答录机,应留言后挂机。ivr 是替机构说话的自动化,无论是否提供可选项,包括菜单、排队公告和录制营业问候,应留在在线。ai callee 是替个人接听、会根据主叫说话内容回应并可能转接真人的自动化,应简短交谈。关键划分在后两类按替谁说话区分,而不是按有无菜单区分,这样 4 类才不交叠。
合并任何两类都会丢掉一个必要动作,其中把代接智能体并入留言代价最大,因为它把本可转接到被叫的对话直接变成挂断。论文也说明类别定义直接影响评测:把无选项的排队与营业问候计入 IVR 后,调参半上召回从 60.7% 升到 96.4%,但若不按主体限定范围,这类宽定义又会与替个人筛选的助手混淆,因此提示词中明确把替个人取名的筛选器排除在 IVR 之外。
voicemail 留言信箱 × answering machine 答录设备: voicemail 留言信箱指运营商或手机上的留言服务,answering machine 答录设备指用户侧录音设备,论文把两者并为 voicemail/am 一类,因为它们都代表替被叫录音、智能体应留言后挂机,分开不改变动作,合并后与后两类自动化的处理动作才互不重叠。
一路音频两路抽头如何得到唯一标签
远端检测器在每次识别更新时都可给出标签,部署在接通后 W s 的决策期限处提交当时成立的标签,human 是默认标签,只有某检测器给出肯定证据才改判其他类。没有单个模型同时看 4 类,因为证据种类与到达时间不同,FEND 在同一通话上开两个抽头:原始音频帧与流式文本,并行跑图中所示的 5 个检测框,每个只对一类做二值触发。每个触发后仍继续运行,因为远端可能在筛选中转人工或问候后出现哔声,其中两个是大语言模型上的工具调用,复用已在跑对话的模型,不新增模型调用。
下面先看总体结构,再理解仲裁为何不按先触发取胜。读图时沿输入到输出的主路径走,注意文本分支与音频分支在哪里汇合,以及默认人类别如何兜底。
看图路径: 1. 先从左侧远端音频分叉看两路输入:原始帧与转写文本分别进了哪些框;2. 再数中间五个黄色框各自标注的判定类别,确认四个检测器如何对应三类自动化;3. 最后看绿色仲裁框到右侧输出的箭头,理解窗口 W 内按证据确凿度而非触发先后取胜
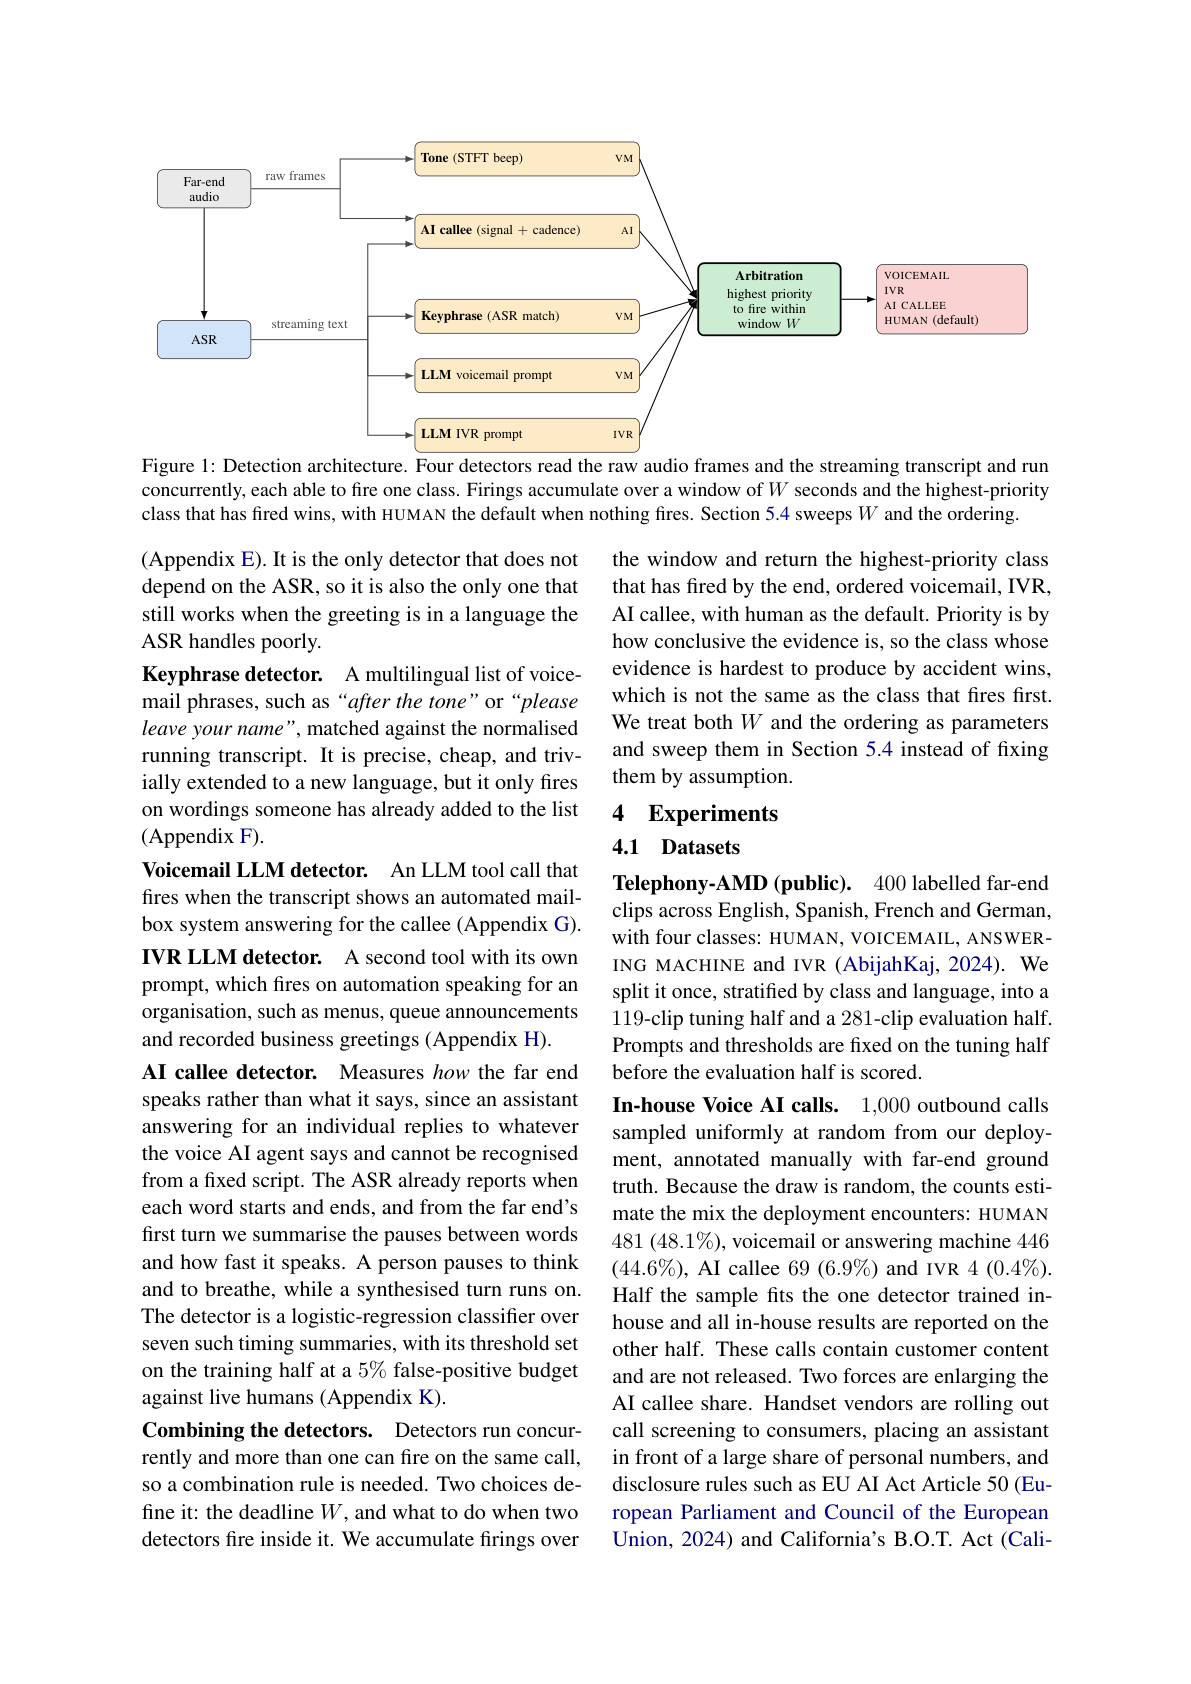
图片来源: 原论文 PDF 第 3 页(含图 1)
论文图 1。原论文 Figure 1::“Detection architecture. Four detectors read the raw audio frames and the streaming transcript and run concurrently, each able to fire one class.”。
原图图注称 4 路检测器,但图中实际并列 5 个检测框,本文按图中模块逐一说明。该图确实可见左侧远端音频分出原始帧与经识别的流式文本两路,中间 5 个框并行触发,右侧绿色仲裁框按窗口 W 内最高优先级取胜并输出四选一,human 为默认。它的作用是把后文所有组件放进同一时间线:音调与节奏读音频,关键词与两个大模型读文本,仲裁解决同一通多触发冲突,第 5.4 节再对 W 与排序做扫描而非事先假定。
IVR 组织自动语音 × AI callee 个人代接智能体: IVR 组织自动语音是替机构说话的菜单、排队或营业时间录音,AI callee 个人代接智能体是替个人接听、会追问来电事由并可能转接真人的助手,两者都可能是自动语音,论文按替谁说话划分,决定智能体是留下等待导航还是做简短对话,避免把能转接的对话当留言挂断。
留言的三路证据各自看什么
留言由 3 路证据共同覆盖。音调检测器用短时傅里叶变换在输入音频帧上找录音提示哔声,它是唯一不依赖识别的检测器,因此在识别处理不好的语言下仍能工作。关键词检测器对归一化累计转写做多语言留言短语匹配,如 after the tone 或 please leave your name,精确便宜且易扩展,但只覆盖词表已有说法。留言大语言模型检测器是工具调用,当转写呈现替被叫应答的自动信箱特征即触发,冻结提示词还区分问候可留言、信箱不可用与号码不可用等状态,供下游区分稍后重试与停止拨打。
哔声判定要求同一频点同时满足 4 个条件:主峰比次峰高 20 dB 以上、上下邻带能量隔离、峰频率高于 350 Hz、连续 4 帧成 streak,前端固定为 8 kHz 电话流、64 ms 窗与 32 ms 跳、512 点傅里叶变换。调参在 293 个哔声正例与 74 个负例的金集上进行,并在约 65,000 个无哔声片段上验误报,目标是金集精度 1.0 且无哔声流误报尽量低。下图是不同主峰裕量下的权衡,星号为最终默认点。
看图路径: 1. 先看横轴误报率对数刻度与纵轴金集召回,确认右下到左上为更好方向;2. 再比较 5 dB 到 25 dB 各圆点位置,理解放宽主峰裕量如何推高误报;3. 最后找到左下星号 20 dB 加能量隔离点,确认它以小幅召回损失换最低误报

论文图 2。原论文 Figure 2::“Beep operating-point selection: recall (golden set) vs.”。
该图横轴是无哔声集误报率对数刻度,纵轴是金集召回,可见 5 dB 点误报约 10% 而召回 1.0,15 dB 仍剩 1.4% 误报,20 dB 加能量隔离把误报压到 0.33% 且精度 1.0、召回 0.942,25 dB 则损失更多召回而无增益。它说明哔声检测的代价不在计算,而在等待问候走到哔声,生产通话上中位触发约 8.86 s,90 分位约 16.25 s,留言大模型中位约 8.91 s,关键词中位约 3.24 s。
短时傅里叶变换 beep 音检测 × 关键词匹配: 短时傅里叶变换 beep 音检测在原始音频帧上找留言后的单频长音,关键词匹配在流式转写文本上找 after the tone 等固定留言用语,前者不依赖识别语言、但要等到哔声出现,后者便宜精确但只能覆盖词表已有说法,两者互补构成不依赖大模型的留言证据。
组织语音与代接智能体为何不能都看内容
IVR 检测器是第二个大模型工具,提示词键控在替机构说话:菜单选项、输号指令、排队保持公告、录制问候、监听录音通知或选语言都算触发,即使无可选项的保持语也算,只要是机构替自己线路应答。明确不触发的是替个人取名的筛选助手、邀留言的信箱、真人寒暄、空或过乱转写以及不确定时,调参只在 119 段调参半上迭代,281 段评估半在冻结后才评分一次。
代接智能体不能靠内容识别,因为它会针对主叫说话做回应,没有固定脚本。检测器只看远端首个话轮的说话方式:识别已给出每词起止时间,从中汇总词间停顿与语速,共 7 个节奏汇总,逻辑回归分类,阈值在训练半按对真人 5% 误报预算设定。话轮不足 4 个有时长词的通话不打分,直接视为无证据而不触发,这是读节奏组件的正确行为,也意味着评估的负例是 481 个真人中较健谈的 62 个。融合前单个特征已有区分力,如发音速率 AI 约 3.68 词每秒、真人约 2.51 词每秒,词间隙变异系数 AI 约 3.50、真人约 1.76。
大语言模型 voicemail 判定 × 大语言模型 IVR 判定: 大语言模型 voicemail 判定看转写是否呈现替被叫录音的信箱特征,大语言模型 IVR 判定看转写是否呈现替机构说话的菜单或排队特征,两者是跑在已负责对话的大模型上的两个工具调用,不新增模型调用,靠各自提示词把留言与组织语音分开,并都要求证据不足时不触发。
在什么数据与约束下比较才公平
公开集是 400 段英西法德四语远端片段,含 human、voicemail、answering machine 与 ivr,按类与语言分层一次切为 119 段调参与 281 段评估,提示词与阈值在调参半冻结后评估半只评一次。生产集是部署中均匀随机抽的 1000 通人工标注外呼,human 481 通、voicemail 或答录机 446 通、AI 代接 69 通、IVR 4 通,随机抽样使其计数可估计部署混合比,按来源通话切半,一半拟合唯一在内部训练的节奏模型,另一半在部署真实分布下报告,200 次重切分给区间。声学分析另组 4 组语音并过同一信道仿真与定长窗:银行真人、14 种英语口音扮演呼叫中心、公开合成语音为正例、公开机器人来电为对照,后者多为预录真人,用来检验检测器是对合成敏感还是仅对非实时双向敏感。
公开片段用 Whisper small 加 SimulStreaming 流式识别以保证可复现,内部通话用部署已跑的商用识别且不能披露,节奏特征读该商用识别的词时间,因此节奏结论与该识别器绑定。两个大模型检测器都用 GPT-4o 且提示词冻结。指标用每类精确率、召回率与 F1,排序检测器加 ROC 曲线下面积与固定真人误报预算下召回。最昂贵错误是把真人标成自动化,因此真人误报率是约束而非普通指标之一,高 ROC 但在预算内无召回的检测器视为不可部署。
声学候选先只在真人数据上校准,排除把语料差异当合成信号的可能。对一个真人语料上的值 S 与另一独立真人语料上的值 R,仅当按参考四分位距缩放的中位差足够小时才允许进入人与机器比较。
\[|g|\leq 1,\qquad g=\frac{\operatorname{med}(S)-\operatorname{med}(R)}{\operatorname{IQR}(R)}.\]该式计算两组真人测量间的中位差除以参考四分位距,绝对值不超过 1 才放行,5 个候选中 4 个未通过,全部与窗内语音占比相关而幸存者无关。阈值拟合与评估都按来源通话切分,避免同一通话同时出现在两半,口音混合也匹配。
四分类主结果与留言对照说明了什么
端到端先看守门决策。在内部保留半 501 通、20 s 窗口、部署真实不均衡分布下,区分真人与任一自动化达到 F1 0.979,精确率 0.987,召回率 0.971,241 个真人中 234 个保持真人标签,7 个被给成自动化。4 路总体准确率 0.938。难处在自动化之间:AI 代接召回 0.457、精确率 0.762,触发后多为正确而错误多为漏检,35 个 AI 代接中有 18 个被判成留言,混淆单向且走向昂贵方向,把能转接的对话当留言丢掉,反向只是浪费一条留言。IVR 行仅基于 2 通,精确率 0.333、召回率 0.500,只为完整而报告。
下表是该保留半的每类结果,比较问题是在真实分布下 4 类各能保住多少,以及错误流向哪里。指标方向是精确率与召回率越高越好,误入列标出被错判成该标签的主要真实来源。
| Class | n | Prec | Rec | F1 | FP into |
|---|---|---|---|---|---|
| human | 241 | 0.987 | 0.971 | 0.979 | IVR 1, AI 1 |
| voicemail/AM | 223 | 0.912 | 0.982 | 0.946 | AI 18, H 3 |
| AI callee | 35 | 0.762 | 0.457 | 0.571 | VM 2, H 3 |
| human vs rest | 241 | 0.987 | 0.971 | 0.979 | 7 humans |
该表支撑的判断是守门已可用而细分仍难:真人行高精确与高召回对应每 100 个真人约数人被误成自动化,留言行召回 0.982 说明信箱很少漏,AI 行低召回说明节奏证据常因话轮太短或仲裁被压制。它在 IVR 样本仅 2 通时不成立,相关行不能推广,读者应拿它与下表的留言专项对照,确认留言高召回并非以误伤真人为代价。
语速与词间隙 × 频谱能量特征: 语速与词间隙指首个话轮中词与词之间的停顿分布和每秒词数,频谱能量特征指窗内共振峰集中度、浊音连续性等信号层统计,论文发现前者在跨语料校准后能区分合成代接与真人,后者多随通话条件漂移而失效,因此代接智能体主要靠说话节奏而非说了什么来判别。
留言专项的比较问题是内容证据能否在不误伤真人下抓全信箱,以及为人工呼叫中心调参的规则基线能否复用。条件是公开集上正例为留言加答录机、IVR 留出,基线是逐行移植并经与 Asterisk 20.6.0 逐段校验的离线 app_amd,含出厂默认与 1152 组网格最优两种。
| 条件 | 指标 | 融合方法 | 基线方法 |
|---|---|---|---|
| 公开评估半,留言加答录为正 | 准确率 | 100% | 出厂 0.731,调优 0.886 |
| 公开评估半,留言加答录为正 | 召回率 | 1.000 | 出厂 0.959,调优 0.995 |
该表支撑的判断是留言已从内容上解决:融合在评估半准确率 100%、召回 1.000 且全程精度 1.000,而基线出厂把 65.8% 真人判成机器,网格调优仍剩 29.8% 并在每段 IVR 上触发。原因是基线阈值按短促 Hello 假设设定,真人多说两句即超问候长度与词数上限。限制是公开片段偏短,可能低估长问候与问候后真人接听,调优基线是事后网格最优而非可部署点,读者应回到生产保留半看真实分布下的表现。
排序与窗口如何改变结论,声学为何判负
仲裁扫描的比较问题是优先级与期限是否只影响自动化细分而不动守门。条件是内部保留半 501 通、20 s 窗口下 6 种自动化排序,以及公开评估半 5 s、15 s 与 30 s 窗口。指标方向仍是 4 路准确率越高越好,真人误报越低越好。结果是真人对自动化在所有排序下完全不变,F1 0.979,7 个真人误标,而自动化内部只与留言是否排在 AI 代接之前有关。
下表是内部保留半的排序扫描,比较问题是哪一个先后关系真正携带结果。
| Priority order | H F1 | VM F1 | AI F1 | Acc |
|---|---|---|---|---|
| vm » ivr » ai | 0.979 | 0.946 | 0.571 | 0.938 |
| vm » ai » ivr | 0.979 | 0.946 | 0.571 | 0.938 |
| ai » vm » ivr | 0.979 | 0.737 | 0.405 | 0.798 |
| ivr » ai » vm | 0.979 | 0.733 | 0.405 | 0.796 |
该表支撑的判断是确凿度排序而非先触发排序:留言排首时 4 路准确率 0.936 到 0.938,倒置后跌到 0.796 到 0.798,因为 88 通留言被读成 AI 代接而非 18 通反向,留言 F1 从 0.946 跌到约 0.73,AI 精确率从 0.762 跌到 0.260。IVR 位置只动 0.2 个百分点,在仅 2 通下无意义。未胜出项是先触发无优先级策略,它在公开集上因同时触发极少而看似等价,不能推广到含代接的生产分布。
节奏与窗口的比较问题是代接证据是否独立于预录,以及证据是否来得及在常用期限内到达。条件是节奏模型只用首话轮 pacing,在训练半按 5% 真人误报定阈,保留半报告,另做留言对照与 AI 对留言区分,窗口在公开评估半从 5 s 拉到 15 s 与 30 s。
| 条件 | 指标 | 本方法 | 对照 |
|---|---|---|---|
| 生产保留半,真人对自动化 | F1 | 0.979 | 精确率 0.987,召回率 0.971 |
| 公开评估半,窗口 | 准确率 | 5 s 时 94.3%,15 s 时 98.2% | 30 s 持平 |
该表支撑的判断是节奏携带代接信号而频谱不携带:融合 ROC 曲线下面积 0.952,AI 对留言 0.895 说明不只是检出预录,而声学五指标四项未过真人与真人校准,幸存者在 1% 预算下召回 0.000。限制同样清楚:节奏只在 67 个 AI 与 62 个真人的可评分话轮上测得,约 13% 真人首轮够长,正例似来自单一筛选产品,且 17 个 AI 通中远端直呼主叫名字证明在线处理语音,但未覆盖接待型助手。窗口从 5 s 到 15 s 涨 3.9 个百分点,说明常用 3 到 5 秒提交是在证据到达前决策,而节奏中位 2.02 s 最先到达却因确凿度排最后,这正是优先级不按到达先后排的理由。
哪些结论不能推广到别的部署
内部混合比只是一家部署。1000 通来自同一外呼项目,其真人、留言、代接与组织语音比例反映该被叫名单、拨打时段与国家组合,不能代表外呼智能体一般情况。IVR 在保留半仅 2 通,只能完整报告而不能据此部署,6.9% 的代接率会随手机厂商筛选开关而快速移动。
所见 AI 代接全是同一亚型,即有脚本开场的守门助手,没有测到 AI 前台、私人助理或第三方代理完整通话,因此类别会扩大的说法来自技术走向而非数据,节奏模型只证明能区分这一个产品。声学阴性只对朗读提示合成测过,会话式合成臂未过信道检查已被排除,窗归一化保留 92% 的一组真人与仅 48% 的合成,类间存在选择差异,0.624 曲线下面积又只基于单一幸存统计。
节奏 0.952 依赖部署商用识别的词边界,且只在首轮至少 4 个有时长词的健谈少数上成立,换识别器可能对齐不同,开源识别上未复现。比较也不对等:公开语料是短片段,可能低估长问候,商业应答机检测跑在运营商媒体路径无法重放,只能引用公开运行点,最接近的学习型先前工作未发检查点而只能比规则系统,大模型检测器用闭源模型而无法审计预训练是否见过公开音频或转写。
要复现应先准备什么
可复现部分是公开 Telephony-AMD 的 400 段切分、119 段调参与 281 段评估的冻结流程,以及用 Whisper small 加流式复现的识别链。论文提供类别定义、语料切分、检测器提示词与 Asterisk app_amd 的独立离线复刻,后者保留阈值测试顺序、首词不计数、语音时长累积与静音重置逻辑,音频重采样到 8 kHz 单声道、20 ms 成帧,不足总分析时长以数字静音补齐,并在出厂默认与 1152 组网格上校验。内部 1000 通因客户内容不能发布,哔声金集 293 正 74 负与约 6.5 万无哔声集同样不能发布,节奏模型的七特征、标准化与 4000 步逻辑回归训练细节在附录 K,信号层训练测试按来源通话 40 比 60 切分并匹配口音。
复现第一步应先跑通公开留言与 IVR 冻结提示词,再跑离线 app_amd 基线确认真人误报量级,最后才在自有生产分布上拟合节奏阈值。不要把公开短片段上的窗口结论直接当生产期限,也不要把网格最优基线当可部署基线。资源可得性方面,现有证据未能确认作者代码、模型或数据资源已公开,本文不声称其已公开,可复现使用的是论文描述的定义、切分、提示词与移植逻辑。
何时值得尝试,还缺哪项验证
当外呼智能体已频繁遇到留言与筛选助手,且二值标签导致把可转接对话当留言挂断时,值得尝试把远端当 4 类处理。行动顺序是先上线哔声加关键词加留言大模型的或融合保住留言高召回与零真人误伤,再用明确替机构说话的 IVR 提示词把排队与营业问候留在在线,最后才在首轮足够长的话轮上加节奏模型处理代接,并把留言排在代接之前仲裁。关键超参数是 20 s 检测窗、节奏阈值的 5% 真人误报预算、哔声 20 dB 主峰裕量加能量隔离与 4 帧 streak,信息条件是流式转写词时间与原始音频帧同时可用。
还缺的验证是真正远端代理接听语料、跨识别器的节奏复现、跨说话人群体的误判差异,以及不确定与短转写下的提示词收紧。伦理上检测不是披露替代,欧盟人工智能法案第 50 条与加州机器人法案要求自动呼叫方主动表明身份,误判代价在口音与差信道上分布不均,部署前须先测分组错误率,并把识别出另一智能体后如何行动留作配置策略。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses