共分析 38 篇论文
⚡ 今日概览
✅ 筛选入选 38 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音识别 | 7 篇 | ███████ |
| 音乐分析 | 4 篇 | ████ |
| 语音交互 | 3 篇 | ███ |
| 语音克隆 | 2 篇 | ██ |
| 音频分离 | 2 篇 | ██ |
| 音频理解 | 2 篇 | ██ |
| 会话抑郁风险筛查 | 1 篇 | █ |
| 声学到构音反演 | 1 篇 | █ |
📊 论文评分排行榜(38 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 球冠辐射阻抗的无源梯形网络:从模态到可仿真电路

评分:8.3/10 | 创新 1.3/2 | 技术严谨 1.4/1.5 | 实验充分 1/1.5 | 清晰度 0.9/1 | 影响力 0.8/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前25% | 文档类型:理论研究 | arXiv 原文
👥 作者与机构
- Ronald M. Aarts:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文把封闭箱扬声器近似为刚性球和沿轴运动的球冠,输入是球半径、球冠张角、流体密度与声速,以及球冠沿轴运动的轴对称速度剖面,输出是可直接接入扬声器机械端的辐射阻抗网络。难点在于每个球谐模态的阻抗随频率变化,既要在给定带宽内准确,又要保持无源以便时域仿真稳定,同时还要把任意轴对称速度剖面与各模态耦合起来。方法先把球冠法向速度分解为 Legendre 模态,输出各阶系数;再为每个保留模态把有理阻抗精确综合成由质量、柔顺和终端阻力构成的有限 Cauer 梯形网络。随后用 Legendre 系数确定理想变压器,把各模态梯形在机械端串联;超过截断阶数 \(N\) 的高阶模态最后合并为一个串联残差质量,以补偿其低频夹带质量。与对均匀脉动帽作低阶参数拟合的实时仿真方法不同,这里每个保留模态的梯形网络是精确综合而非参数拟合,且截断网络对任意 \(N\) 保持无源。完整网络实现全模态阻抗,截断网络在 \(N\) 决定的带宽内近似;若 \(N\) 相对 \(kR\) 过小,残差质量会高估电抗。论文用既有声功率级数核对电阻,用收敛曲线检验截断和残差质量,并用小帽—大球极限检查复阻抗趋近无限障板活塞;没有做实测辐射阻抗验证。原文未提供可核对的关键定量结果;代价是保留模态数 \(N\) 越大,梯形网络和变压器越多,残差质量仅增加一个电抗元件;本文不涉及训练或推理,也未报告数值计时或硬件成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 在真实生活里听歌时,身体发生了什么:BEATS 数据集解读

英文题目:The BEATS Dataset: Towards Understanding Music-Physiology Dynamics in Real-World Scenarios
评分:7.7/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Benjamin Gutierrez Serafin:University of Glasgow, United Kingdom
- Tanaya Guha:University of Glasgow, United Kingdom
- Fahim Kawsar:University of Glasgow, United Kingdom;OmniBuds Ltd, United Kingdom
📌 核心摘要
真实聆听伴随活动环境变化,实验室短片段难复现运动伪影与个体差异,现有同步生理信号数据集多为短片段或单一心率记录。该文以日常连续佩戴腕带采集的多通道生理信号与流媒体播放记录为输入,以与音乐功能关联的主观功能评价及情感变化为输出,其中效价指愉悦不愉悦之分,唤醒度指激活高低,难点是无控下信号质量与因果归因。研究先按情感调节、意义追寻与目标达成三种康养功能提取描述文本嵌入并计算流行度与声学适配度加权评分,输出共享曲库送入专用账号供自由聆听,再以腕带、手机应用与云端同步记录生理与播放时间戳并触发问卷,最后整理输出原始波形、衍生分钟级生物标志物、播放日志、动静态声学特征及人格量表。相比以往实验室曲库,该设计结合共享刺激、连续日常监测与多模态同步,支持跨被试比较与长时行为分析。在BEATS数据集844个会话共262.2小时的对齐聆听记录上,目标达成类总聆听时间为176.4小时,高于情感调节类的54.4小时,三类音乐的稀疏逻辑回归三折验证平均F1为0.785。结论仅适用于30名18至49岁被试佩戴研究级腕带日常活动并听指定歌单的21天记录,运动伪影与体温调节致皮肤电变化等混杂未控、活动环境差异大或聚合到被试层面会掩盖细粒度动态而失效,跨人群跨设备泛化与长期康养干预因果效果尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/gtzben/beats-dataset — 链接可访问(HTTP 200)
第三方资源:https://beats-dataset.github.io/ — 链接可访问(HTTP 200)
第三方资源:https://developer.spotify.com/documentation/web-api — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/sentence-transformers/all-mpnet-base-v2 — 链接可访问(HTTP 200)
第三方资源:https://www.empatica.com/en-gb/embraceplus/ → https://www.empatica.com/embraceplus/ — 链接可访问(HTTP 200)
第三方资源:https://www.empatica.com/embraceplus-compatibility/ → https://www.empatica.com/compatibility/ — 链接可访问(HTTP 200)
第三方资源:https://support.empatica.com/hc/en-us/articles/9843547409821-Download-the-Care-App — 链接不可用(HTTP 403)
第三方资源:https://librosa.org/doc/latest/index.html — 链接可访问(HTTP 200)
第三方资源:https://neuropsychology.github.io/NeuroKit/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/lciti/cvxEDA — 链接可访问(HTTP 200)
第三方资源:https://support.empatica.com/hc/en-us/articles/17405877853981-How-to-access-Avro-files-with-Python — 链接不可用(HTTP 403)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 冻结多模态大模型如何以轻量适配实现词级全双工语音对话

英文题目:An LLM Is All You Need: Data-Efficient Adaptation to Full-Duplex, Word-Level Spoken Dialogue
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.9/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.4/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tairan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Richard Yucheng He:机构信息未能在本次解析中与作者逐人可靠绑定
- Yihang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Baodong Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Chen Xu:AveraLabs
📌 核心摘要
论文处理全双工口语对话:系统每 80 ms 一帧持续听,并逐词决定附和、让话、被打断及下一词;这类行为通常依赖数十万至数百万小时语音训练,逐帧自由生成又可能产生当前状态不允许的停顿、接话或沉默序列。 方法先由冻结的 Mimi 编解码器把用户波形变成每帧 8 个码本索引,再由音频适配器送入冻结的 Qwen3-Omni-30B-A3B 思考部分;新增输入通路以可加、恒等初始化接入,保持可读表示,并每帧输出一个普通子词或 17 个新时间词元之一。 再以四阶段课程训练低秩适配器、音频适配器、通道融合层和这些词元,总可训练参数 97.4M,并从第 3 阶段起以初始化检查点作 KL 参照,依次完成码流读出、停顿学习、单通道到双通道转换、打断与附和训练。 最后,说话部分接收离散词元,输出语音码元并解码为波形;采样前有限状态机把候选限制在当前状态合法集合内,避免非法时序,这种离散耦合使两半可独立训练,区别于端到端的大规模语音训练。 在 Full-Duplex-Bench v1.0 上,本文在暂停处理合成子集的 Synth. TOR(合成暂停接话率)为 0.170,低于 PersonaPlex 的 0.584;同一基准的 Backchannel Freq(附和频率)为 0.073,高于 PersonaPlex 的 0.025;但用户打断 Relevance(回答相关性)为 2.681,低于 PersonaPlex 的 4.210 和 Freeze-Omni 的 3.615。 在 Full-Duplex-Bench v1.5 的用户打断场景,本文响应延迟(Resp. lat.)为 0.64 s,低于 Freeze-Omni 的 1.35 s 和 Moshi 的 1.47 s,回应比例(Resp.)为 0.42,低于 Freeze-Omni 的 0.72 和 Moshi 的 0.50;InteractionBench 上 Spoken task 26%,高于 PersonaPlex 的 18%,Grounded(依据性)53% 高于 Freeze-Omni 的 35%,Coherence(连贯性)47 高于 Freeze-Omni 的 39,Whisper & volume 5% 低于 PersonaPlex 的 35%。 训练成本为思考部分 30.5 GPU 小时、说话部分 2.65 GPU 小时,在单张 B200 上测得且不含数据生成与评测;数据效率结论依赖已大规模预训练的起点,未报告端到端时延、吞吐或尾部延迟,其适用性受此限制。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 语音分词器为何脆弱:迁移语义攻击与鲁棒分词器

英文题目:Speech Tokenizers are Vulnerable: Transferable Semantic Attack and Robust Tokenizer
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 1.1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhisheng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifan Mi:机构信息未能在本次解析中与作者逐人可靠绑定
- Yixuan Zhou:Shenzhen International Graduate School, Tsinghua University
- Haiyun Li:Shenzhen International Graduate School, Tsinghua University
- Shengbo Cai:Shenzhen International Graduate School, Tsinghua University
- Dongfu Song:Shenzhen International Graduate School, Tsinghua University
- Ziang Xu:Shenzhen International Graduate School, Tsinghua University
- Jie Hao:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiyong Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文研究语音分词器把连续语音编码成下游语音识别和大音频语言模型可用的表示或离散单元,而微小波形扰动经编码、量化、解码或下游建模后可能改变语义,造成输出错误。T-SemAttack 接收原始和对抗语音,先并行提取 S3Tokenizer、HuBERT、Whisper 编码器和 MFCC 四种表示,并降低同一样本清洁与扰动表示的余弦相似度;再按原始语音短时频谱计算心理声学掩蔽阈值,只在扰动功率谱密度超过阈值时惩罚;最后在 \(\ell_\infty\) 预算内用投影梯度更新生成对抗波形。ROSETok 接收清洁、含噪或受攻击语音,先编码为 1280 维潜表示,再由九层残差向量量化器和解码器重建波形;训练时冻结 Whisper 教师,把含噪输入的编码表示拉向清洁语音语义表示,并分基础预训练和用 T-SemAttack 样本做攻击感知微调两阶段。在 Seed-TTS (EN) 上,T-SemAttack 的平均词错率为 81.872%,高于 E2E-VGuard 的 23.154%;在 LibriTTS 上,其 RTF 为 21.800,低于 E2E-VGuard 的 26.797,SNR 为 16.319。这些结果支持攻击在多种模型上的迁移性,但主要覆盖 Seed-TTS (EN/ZH)、LibriTTS 等,尚不能证明对其他分词器、语言、任务或未测防御同样成立;作者明确 T-SemAttack 追求音频正常可用而非真正不可感知,且去掉语义攻击损失后对 HuBERT、Whisper 和 VibeVoice-ASR 的攻击成功率仅约 1.556%,说明其依赖语义约束。ROSETok 主要在 Whisper 教师、两阶段训练及含噪和 T-SemAttack 扰动下验证,依赖训练分布和威胁模型;对分布外噪声或未测自适应攻击可能失效,不能视为完整防御,部署还需监控、去噪、对抗评估等防护。训练使用 8 张 H100,原文未披露训练时长、推理延迟、吞吐和部署成本。
🔗 开源资源
代码相关资源:https://wxzyd123.github.io/t-semattack → https://wxzyd123.github.io/t-semattack/ — 链接可访问(HTTP 200)
演示资源:https://wxzyd123.github.io/t-semattack → https://wxzyd123.github.io/t-semattack/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 在重叠与轮替中锁定同一说话人:结构化条件引导的目标语音识别

英文题目:Structured Speaker Conditioning for Diarization-Guided Target-Speaker ASR
评分:7.5/10 | 创新 1.6/2 | 技术严谨 1.3/1.5 | 实验充分 1.4/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ruoyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shutong Niu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jun Du:机构信息未能在本次解析中与作者逐人可靠绑定
- Weixin Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yannan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
会议转写需要从长录音混合语音中为每位说话人生成归属稳定的文字记录,难点在于窗口滑动时局部说话人组合不断变化,重叠与轮次交替频繁,相同活动模式可能对应不同说话人。结构化说话人条件 Structured Speaker Conditioning (SSC) 先用面向目标的关系编码 Target-Centric Relational Encoding (TCRE) 为每条活动轨迹保留因果历史,并聚合成目标与单个干扰者以及目标与不同干扰者对的关系。基于参考的说话人条件 Reference-based Speaker Conditioning (RSC) 再从会话其他区间抽取说话人独占音频并池化为声纹身份,用以区分局部活动相同的目标。条件低秩调制 Conditional Low-Rank Modulation (CLRM) 把联合条件对齐到声学编码器时间网格,并生成通道增益偏置与条件相关的小型混合核心,并行控制通道缩放与跨通道组合。与仅保留四状态的目标条件相比,该设计保留了干扰者数量与交接历史,并让声学身份参与关系计算。在 Qwen3-ASR-0.6B 上使用 oracle 先验时完整 SSC 相对四状态对角条件实现 6.23% 的平均相对降低,完整条件模块在该主干上含 1.46M 可训练参数。在四个领域内会议测试集上使用预测先验时,FireRedAudio 加 SSC 再经目标误差组序列策略优化 Group Sequence Policy Optimization (GSPO) 的文本系统宏平均拼接最小排列误差率 concatenated minimum-permutation error rate (cpER) 为 15.60%,低于 DiCoW 的 19.12% 与 MOSS-TD 的 19.54%,对应各数据集相对降低的等权均值为 17.9% 与 17.3%。结论适用于远场单通道会议与已评测的 MISP-Meeting、AISHELL-5 及 DiPCo 新语料,目标误报等先验错误仍会削弱收益,原文未披露训练时长与推理延迟。
🔗 开源资源
第三方资源:https://github.com/BUTSpeechFIT/mt-asr-data-prep — 链接可访问(HTTP 200)
第三方资源:https://github.com/BUTSpeechFIT/TS-ASR-Whisper — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 用卷积替代沿时间反传:可微分发声合成中的声道响应块卷积

评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.4/1.5 | 实验充分 1.2/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yongyi Zang:机构信息未能在本次解析中与作者逐人可靠绑定
- Debasish Ray Mohapatra:机构信息未能在本次解析中与作者逐人可靠绑定
- Randal Leistikow:机构信息未能在本次解析中与作者逐人可靠绑定
- Perry R. Cook:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文做声学到构音反演:给定语音和由 CREPE 估计后固定的基频,对每条录音做分析合成,优化逐帧舌位、舌径、喉部与唇部收缩及紧张度,使可微的 Pink Trombone 合成器重建目标语音。难点是许多控制要经很长的串行波导才影响波形;VocalTrax 的 Kelly-Lochbaum 波导每采样更新两次,反向传播穿过逐采样循环,GPU 拟合慢。作者先在频域消去波导结点,推导包含半采样更新的传递函数;再由它经逆 FFT 得到截断到 93 ms 的冲激响应,并假设声道在 5.8 ms 块内不变;最后把该响应送入分块因果卷积,使梯度只经过 FFT 和 43 个结点的短递归。与 VocalTrax 逐采样反向传播不同,几何固定时该卷积在忽略截断误差下重建原波导输出;几何移动时误差随运动速度和块长增加,块长选择即速度与近似误差的取舍。在 600 条 AudioMNIST 录音上,仅用真实语音训练的分类器对本文重建的识别准确率为 14.5%,高于 VocalTrax 的 10.0%;同一批重建上,本文的对数梅尔谱距离比 VocalTrax 高 11.3%。在相同 600 条录音和同一分类器下,用原 VocalTrax 渲染本文拟合参数,识别准确率为 13.8%,比 VocalTrax 的 10.0% 高 3.8 个百分点,支持参数可迁移。计时用单块 NVIDIA A100、批量 1、单精度和 1–60 秒输入,本文声道前向加反向传播比 VocalTrax 快 47–63 倍;GPU 上每次拟合需 379 MiB 显存,高于 VocalTrax 的 145 MiB。同一设置下,对三条 AudioMNIST 录音分别做完整 1000 步拟合,本文耗时 3.8–5.8 分钟,短于 VocalTrax 的 12–18 分钟。本文识别准确率高于 VocalTrax 的结果只适用于这 600 条 AudioMNIST 录音的相对识别性,绝对准确率低,不能代表实际可懂度;连续长语音及更多数据、随机种子尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. RSE-TTS:共享文本感知参考编码与生成

英文题目:RSE-TTS: Compact Text-to-Speech through Shared Text-Aware Reference Encoding and Generation
评分:7.4/10 | 创新 1.6/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.9/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ming Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingjie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuanzhong Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Hengyao Bao:机构信息未能在本次解析中与作者逐人可靠绑定
- Hailin Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shijing Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hao Qiu:机构信息未能在本次解析中与作者逐人可靠绑定
- Gongfan Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuemin Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Youhai Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文要解决紧凑 TTS 在新文本上保留参考说话人音色与表达的问题:声学续写保真但需保留完整参考历史、增大上下文,固定长度参考编码更紧凑,却可能在压缩中丢细节。RSE-TTS 以参考语音、其转写和目标文本为输入,输出目标语音;重建式说话人编码器(Reconstructive Speaker Encoder,RSE)与生成器共享 Global Transformer,使参考编码不另设一套生成骨干,并联合编码参考文本与语音;在相同 20k 小时训练下,相对独立预训练编码,共享使编码器与生成器参数减少 48%。编码时先把参考文本嵌入、参考语音帧嵌入、结束标记 EOS 和 8 个可学习查询按序送入共享骨干,得到 8 个连续向量,再逐向量加上冻结 CAM++ 提取并投影的说话人嵌入;生成时以这些向量、目标文本和起始标记 BOS 为前缀,由 Global Transformer 判断继续或停止,单层 Local Transformer 逐帧生成 16 个码本索引,最后经冻结 codec 还原波形。训练采用教师强制,只监督目标语音的自回归交叉熵,梯度经参考向量回传查询读出和共享骨干。在 Seed-TTS、CV3-eval、MiniMax 的英语测试中,RSE-TTS 的参考条件克隆模式相对官方 MOSS-TTS-Nano 参考条件克隆模式,词错率(WER)分别由 3.96%、8.10%、1.58% 降至 1.49%、3.37%、0.72%,说话人相似度(SIM)分别由 0.480、0.431、0.659 升至 0.598、0.540、0.680;RSE-TTS 加声学续写后相对 Nano 续写模式,WER 分别由 3.13%、7.57%、1.77% 降至 1.66%、3.07%、0.74%,SIM 分别由 0.556、0.492、0.730 升至 0.670、0.627、0.758。在 Seed-TTS、CV3-eval、MiniMax 上,RSE 的固定 8 向量条件相对匹配的仅声学续写系统,SIM 为 0.552/0.499/0.615,低于后者的 0.591/0.526/0.684。RSE 需要参考转写,实验仅覆盖英语,论文未披露训练、推理或部署成本;因此跨语言、无转写参考及实际效率未验证。
🔗 开源资源
第三方资源:https://voxnexusai.github.io/RSE-TTS/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/OpenMOSS/MOSS-TTS-Nano — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/FunAudioLLM/Fun-CosyVoice3-0.5B-2512 — 链接可访问(HTTP 200)
第三方资源:https://github.com/OpenMOSS/MOSS-TTS — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-Base — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 小模型如何在端侧做零样本语音克隆:ZONOS3-Mini 的编解码器、主干与评测

评分:7.4/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.4/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Gabriel Clark:机构信息未能在本次解析中与作者逐人可靠绑定
- Sofian Mejjoute:机构信息未能在本次解析中与作者逐人可靠绑定
- George Close:机构信息未能在本次解析中与作者逐人可靠绑定
- Beren Millidge:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
文本到语音(TTS)把文字转成语音;零样本语音克隆还要求系统只凭一段未见说话人的参考音频或说话人嵌入复现音色。难点在于参考音频会带来录音条件和韵律差异,跨语言、跨录音时的词错率(WER,越低越好)与说话人相似度容易同时变差,而端侧部署又限制参数、时延和吞吐。ZONOS3-Mini 先用 ZAC-1 把 44.1 kHz 语音编码为每帧含 1 个语义码和 9 个残差码的离散码;在四语言 ZTTS2-Eval 的编解码比较中,其帧率 15.0 帧/秒,低于 Fish S1–DAC 的 21.5 帧/秒。主干以文本 token 和参考码或说话人嵌入为条件,自回归预测音频码,再由解码器还原波形。训练先预训练,再微调加入嵌入和控制条件,最后用直接偏好优化(DPO)和组相对策略优化(GRPO)后训练;后训练以 ASR 的 WER 与 ReDimNet 说话人相似度评分筛选和奖励候选,抑制无语音、超长生成和克隆不稳。在 ZTTS2-Eval 的 55 个语言部件(35 个干净集、20 个真实场景集,共 74,041 条话语)上,嵌入条件的后训练模型取得 6.71% 宏平均 WER 和 81.2 说话人相似度;主比较表中 8B 总参数、0.9B 激活参数的 ZONOS2 宏平均 WER 为 6.22%、说话人相似度为 68.8,因此本模型 WER 高于 ZONOS2,但相似度高于 ZONOS2。推理侧报告在 H100 上 128 并发、整段解码时吞吐为每秒生成 67 秒音频,高于实时播放速度;首包延迟为 0.25 至 0.36 秒,并在 Pixel 9 与 M3 MacBook Air 上实时运行。这个结论适用于论文新提出的 55 语言部件评测和零样本克隆设置;跨系统比较受参考转写、语言覆盖和自动指标限制,尚未验证主观听感与所有真实场景的领先性。
🔗 开源资源
第三方资源:https://github.com/Zyphra/ZONOS3-Mini — 链接可访问(HTTP 200)
第三方资源:https://zyphra.github.io/ZTTS2-Eval/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 答对不等于听对:对大音频语言模型的声源级反事实审计

评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.4/1.5 | 实验充分 1.2/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yi Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongwei Du:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
大型音频语言模型需要根据包含目标与干扰声的混合录音判断指定声音是否存在,输入为波形与文字问题,输出为存在与否的判定,猫、汽车喇叭与笑声相互重叠时答对有时来自场景本身而目标本身并未被有效登记。目标与竞争者消融反事实证据审计先对同一问题计算存在与缺席答案对数概率之差作为边际分,再分别删除目标与每个竞争者后重算该分得到去除效应并保持其余声源增益与偏移不变,最后仅用冻结模型已有的答案逻辑值组合去除效应成排序统计量检验目标缺席视图是否低于全部目标存在视图。与只检查目标删除或只看答案是否翻转的做法相比,该方法把排序冲突与阈值可修复错误分开,无共享阈值可修复排序冲突因而需不同补救。在8个开放大模型与3456组ESC-50对照混合的评测中,18911个答对里6.3%存在排序冲突,在各级均答对的5466个配对单元上目标SNR从+5 dB降至-5 dB时冲突占比从4.9%升至8.4%,而全部单元的ACC从75.7%降至60.8%。结论仅适用于声源集合已知且可精确删除的合成混合与字母选项判别问法,响度归一化与重配背景对照下趋势仍成立,真实录音与开放作答尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/yikise/TRACE — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. MESH:多接收器空间听觉中的自我中心与全局中心评测
英文题目:MESH: Multi-receiver Evaluation of Spatial Hearing across Egocentric and Allocentric Views
评分:7.2/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.9/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Wen Wen:机构信息未能从 arXiv PDF 文本可靠映射
- Bohan Li:机构信息未能从 arXiv PDF 文本可靠映射
- KwanHo Tam:机构信息未能从 arXiv PDF 文本可靠映射
- Yu Xi:机构信息未能从 arXiv PDF 文本可靠映射
- Jing Peng:机构信息未能从 arXiv PDF 文本可靠映射
- Shuai Wang:机构信息未能从 arXiv PDF 文本可靠映射
- Kai Yu:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
论文考察多接收器能否在自我视角和共享世界视角下持续关联语音、位置与运动,而不只给出单点方向或转写。输入为本机或全部接收器的四通道 FOA 录音、机器人位姿、同伴播放文本与时间段、房间上下文及查询,输出方向、距离、世界坐标、轨迹和目标说话人的完整转写,场景含 1 至 3 人、1 至 3 个可动接收器并同时发声。MESH 先固定语音、机器人播放、噪声与初始几何,构建 800 个 base,派生 800 个静态和 1,600 个动态实现、4,761 个接收器录音及约 40,000 个问题。它再按视角把跨接收器一致的身份与空间标注转为查询和答案,自我视角用局部坐标、本机录音和同伴元数据,世界视角用世界坐标、全部录音与元数据,覆盖 8 个自我视角和 5 个世界视角任务。最后,评分按 20° 方向误差、20% 相对距离误差或 2 m 世界位置误差判对,动态定位在 0.5 s 网格只评语音活动帧,转写用目标说话人的语料级词错率且缺失、无效预测计失败,800 个空区域查询另看空答案正确率,Overall 对定位和转写等权,分数为 0–100。在 MESH 的 19,117 个静态和 20,882 个动态问题上,比较 11 个音频模型配置与工具调用代理 MESH-agent 后,MESH-agent 的自我视角 Overall 为 34.97,高于 Qwen3.8-Omni-Flash 的 30.18。在 MESH 自我视角的 ES-Trans 静态转写任务上,MESH-agent 的词错率为 61.09%,低于 Qwen3.8-Omni-Flash 的 72.09%。结果说明跨接收器关联仍不可靠,研究仅覆盖模拟展厅的英语朗读语料,人工复核有限,代理评测基于冻结缓存回放,不是未接触测试集的完整在线评测,原文未给出端到端在线时延或能耗。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 流式听写不只看词错率:从失败分层理解 ASR 评测
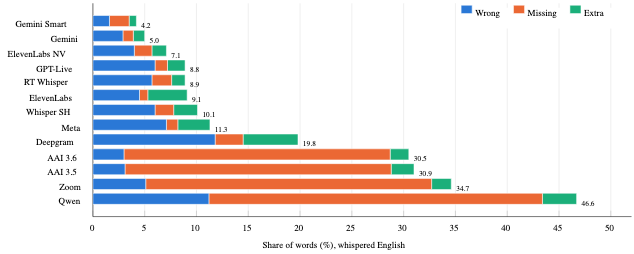
英文题目:Beyond Word Error Rate: A Failure Taxonomy of Streaming Dictation ASR
评分:7.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Harras Mansoor:机构信息未能在本次解析中与作者逐人可靠绑定
- Muhammad Wisal:机构信息未能在本次解析中与作者逐人可靠绑定
- Hassan Bhatti:机构信息未能在本次解析中与作者逐人可靠绑定
- Masood Shakir:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文研究流式口述听写:音频按说话速度实时送入识别系统,文本直接写进消息、邮件或助手指令,最终文本的残留错误仍要用户修正,因此只看词错率(WER)会掩盖错误类型和修正成本。作者将同批语音送入 11 个实时识别系统共 13 种配置,仅评分每片段最终文本;输入覆盖安静、风扇和耳语英语、11 个其他语言与方言集各 20 个片段、400 条双语拼接录音及 10 个无语音片段;在 106 条自采英语听写中,安静英语下 OpenAI GPT-Live-Transcribe(GPT-Live)的 WER 为 7.3%,低于 Zoom Scribe(Zoom)的 7.4%,但耳语英语下 GPT-Live 为 8.8%,低于 Zoom 的 34.7%,表明相近的 WER 并不代表相近的失败方式。研究先将各系统的逐字转写与脚本对齐,按多系统一致听到的增删改提出并人工核定口语参考,再用最少编辑的逐词对齐把最终文本同脚本参考或口语参考比较,输出错误词,最后按识别、输出格式、语言处理和模型前音频路径四层用固定规则归类;两种参考分别检验是否写出用户想发的信息与是否听清实际说出的话。与只报总体 WER 的公开评测相比,这套流程能区分漏词长段、截尾、名称错误、数字格式、错误书写系统、语言缺失和语音活动检测(VAD)丢弃音频等失败。在本客户端上,从音频结束到最终文本的中位等待在流式系统中为 313–760 ms,短于整段上传的 Whisper-1 设置约 1,850 ms,显示出准确率与等待之间的部署取舍。结论主要适用于所测系统在测试时段、默认或指定设置和本客户端下的流式口述场景。
🔗 开源资源
第三方资源:https://github.com/heylemon-ai/streaming-dictation-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/hey-lemon/streaming-dictation-asr — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 用 copula 分数修正组合语音与文本的动作生成

英文题目:CFGComposer: Compositional Audio-Text-to-Motion Generation via Copula Score Correction
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pengyang Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinlu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Chunze Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Yizhou Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Yi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务是在给定语音、文本手势说明和手势窗时,生成 5 秒 300 帧、60 关节的全身动作,使节奏跟随语音、语义手势落在窗口内;难点是三模态配对数据少,直接联合训练容易让运动先验压过语义,而简单融合单模态专家又忽略音频与文本在含噪状态下的相互依赖。论文先分别预训练并冻结语音到动作(A2M)和文本到动作(T2M)扩散专家,在每个去噪步按乘积专家(PoE)方式合成二者经无分类器引导缩放后的噪声预测,得到 \(\epsilon_{\mathrm{PoE}}\)。另一个联合训练的 AT2M 扩散模型从同一含噪动作、音频、文本和手势窗预测 \(x_0\),再换算成 \(\epsilon_{\mathrm{AT2M}}\);两者之差作为省略的 copula score 的 \(\epsilon\) 空间估计。推理时按 \(\epsilon_{\mathrm{total}}=\epsilon_{\mathrm{PoE}}+\lambda(\epsilon_{\mathrm{AT2M}}-\epsilon_{\mathrm{PoE}})\) 修正,\(\lambda\) 控制跨模态交互强度;专家保持冻结,联合模型用 \(x_0\) 预测均方误差训练 50k 步。在 BEAT 上(论文只报告 195 个验证片段,未报告独立测试集),SRGR(语义相关手势召回,越高越好)为 0.9916,高于 DiffSHEG 的 0.7749 和 RoboGesture 的 0.7851;FID(由预训练动作编码器提取特征后的 Fréchet 分布差异,越低越好)为 27.18,低于最佳非 GT 基线的 92.21;G-MSE(手势窗内均方误差)0.0079、F-MSE(整段动作均方误差)0.0116 也是非 GT 最好。BA(节拍对齐分数)为 0.1826,接近 GT 的 0.1743,但按“接近 GT”口径 SemTalk 的 0.1808 更接近,原始 BA 最高的是 DiffSHEG 0.2228。结论主要适用于 BEAT 重定向到 Unitree G1 的数据与动作空间,跨数据集验证未报告;部署时每步约 30 ms,50 步 DDIM 首段约 1.5 s,训练设备和总时长未说明。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 低资源语音识别中的语言迁移:多语模型在小样本微调后学到什么

评分:7.1/10 | 创新 1.2/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Husein Zolkepli:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文研究多语言语音识别模型仅用少量转写微调后,对未见低资源语言能迁移多少知识;输入语音和语言提示,训练附转写,输出目标书写系统字符序列。 Low-Language-TTS 含 50 个低资源语种、11 种书写系统、1,250 段、2.56 小时、514 名说话人,每语种 25 段;训练集剔除测试/开发片段及其句子、相同音频后得 129,236 段、279 小时、27,206 名说话人,主实验每语言最多 1,000 段,共 42,816 段、82 小时。 50 语一起训练,开发集逐轮选检查点,测试集报告结果;主指标为按语言等权宏平均字符错误率(CER),并报告词错误率(WER)。 方法上,先给各模型族补足语言接口,包括语言标记、提示、输出行或缺失字符行,形成能接收语音和语言提示的扩展模型。 再以筛出的语音混合训练;微调模型输出字符序列,最后 CTC 的贪心输出送入按语种的词级 4-gram 语言模型重解码,得到最终转写。 在 Low-Language-TTS 的 50 种语言测试集上,按宏平均 CER 计,MMS 1B 从未微调的 30.6 降至微调后的 11.0,最佳 omniASR CTC 7B 的 9.5 低于 MMS 1B 的 11.0。 同一测试集上,词级 4-gram 重解码使三个 CTC 模型的宏平均 CER 比贪心解码低 1.2 至 1.4 分,MMS 1B 的 WER 由 40.1 降至 34.4。 在 12 个无人列出的语言上,宏平均 CER 从微调前 46 或更差降至最好 11.7;同架构随机权重的宏平均 CER 高于预训练微调 60 到 77 分。 在 FLEURS 与本文语料不共享的录音上,中位模型保留 79% 的 CER 增益;该评估中,微调使中位模型在英、西、法、德上的 CER 比微调前增加 5.7 分。 在同一测试集上,LoRA 训练约 4% 参数,Whisper large-v3 的宏平均 CER 比全量微调高 1.1 分。 结论适用于父语料抽样、少量转写的低资源场景;限制是每语言测试仅 25 段、50 语共享母语料、仅 4 语言外部复核、多数单种子,且未发布代码、权重或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 把一句话编辑意图变成可执行的声波操作:Harmony 的协同规划与执行
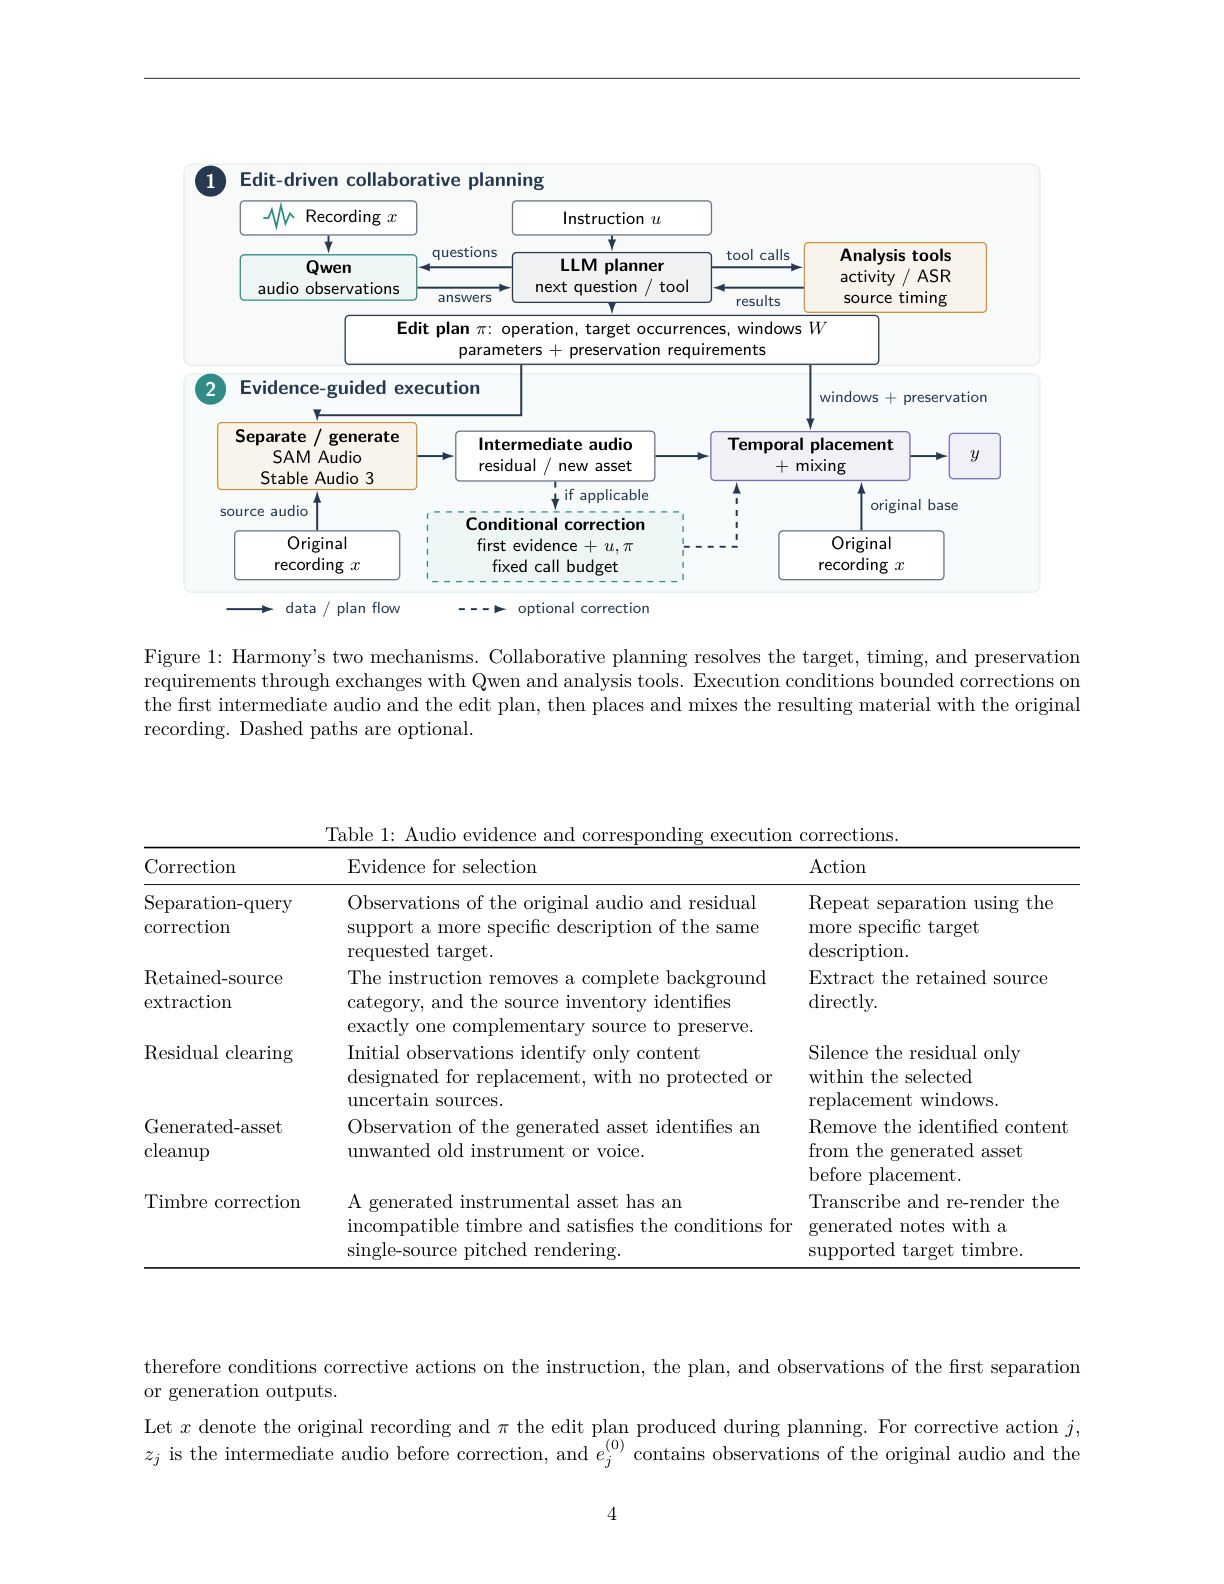
图片来源:原论文 PDF 第 4 页(含图 1)。完整图注与解读见独立文章。
英文题目:Harmony: Bridging Audio Understanding and Editing through Agentic Collaboration
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhongyi Tong:机构信息未能在本次解析中与作者逐人可靠绑定
- Yapeng Tian:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自然语言音频编辑以原始录音和文字指令为输入,输出修改后录音,难点在于把指令中的选择对象、时间关系和保留要求落到具体声源与时间区间,并在重叠声中只改目标而不破坏其余内容。和谐系统(Harmony)先由大语言模型规划器提出待澄清问题,负责听音的音频语言模型Qwen3-Omni给出目标与时间观察,波形能量、分离辅助与语音转写等分析工具提供候选区间和词级时刻,三方交互输出包含操作类型、目标出现、执行窗口与保留要求的可执行计划。再由SAM Audio或Stable Audio 3产出中间音频并送入检查,系统对照计划判断残余声或新素材是否可用,在固定预算内触发有界修正,最后把处理后分层放入执行窗口并与原录音混音。与直接按指令重构整段的扩散编辑器和程序化调用工具但缺少中间检查的智能体相比,该流程把语义决策与波形操作贯穿起来。在420个MMAE样例的pooled混合平均评测上,和谐系统的完全成功率(Exact Match Rate, EMR),即全部编辑与保留细则通过的比例,为22.62%,高于最强基线原始WavCraft的13.57%。结论适用于增加、删除、替换和音量调整四类单步编辑,复杂多步指令、自然衔接以及跨数据集泛化尚未验证。原文报告首次完整执行的平均开销为每条输入105.30秒和4.25次模型调用,替换类耗时与调用最多。
🔗 开源资源
第三方资源:https://christong9.github.io/harmony/ — 链接可访问(HTTP 200)
第三方资源:https://www.schristiancollins.com/generaluser.php — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 用对齐注意力遮罩为 Aligner-Encoder 的自转导搭脚手架

英文题目:Scaffolding Self-Transduction with Alignment Attention Mask for Aligner-Encoder ASR
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jaeyoung Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Masato Mimura:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
Aligner-Encoder 语音识别把 \(T\) 帧声学表示映射到前 \(U\) 个编码器位置,并要求位置 \(u\) 直接预测第 \(u\) 个词元,故编码器自注意力须自行完成帧到词元重排,即 self-transduction。输入是声学特征和训练用参考转写,输出为逐位置词元后验及最终转写;长句中的对齐误差可能造成删除等错误。方法先用预训练 RNN-T 对参考转写作强制对齐,重采样到编码器帧序列后取每帧的后验期望词元索引形成路径带;只用目标长度 \(U\) 与总帧数 \(T\) 的线性关系则形成长度带。训练时,对齐注意力掩码只作用于一个编码器层中的选定自注意力头:带内键不受偏置,带外键受门控压制,门控再按优化步线性升到 1 并移除掩码,推理沿用原架构。oracle 分支始终保留掩码,以参考长度或参考路径显示更大潜力并测量性能上限;它不可部署,也未用参考词元前缀做教师强制。在 LibriSpeech 上,渐隐路径带把 Aligner 基线的 test-clean/test-other WER 从 3.9/6.4 降至 3.5/5.9,而渐隐长度带仍为 3.9/6.4,显示局部对齐信息能部分内化、仅目标长度脚手架不足。这些结论目前限于同语料预训练 RNN-T 对齐和约 115M 参数 Conformer-L 编码器等设置;路径对齐不准时,路径带可能失去可靠中心。实验还覆盖 5 种语言的 Common Voice,但未与已有对齐引导方法直接比较,也未给重复运行统计;上述条件之外的跨语料、跨模型、流式和长幅听写尚未验证。原文报告解码主要是按输出位置调用连接器、避免转导格遍历,但未披露训练时长、硬件和实测推理成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. Hy ASR 3.0:语音、外部上下文与 LLM 解码如何合成一次转写

评分:6.9/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.9/1 | 影响力 1.3/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Aoxiong Yin:机构信息未能在本次解析中与作者逐人可靠绑定
- Auden Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Chao Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Chuanyang Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Eitan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ethan Zou:机构信息未能在本次解析中与作者逐人可靠绑定
- Fangming Feng:机构信息未能在本次解析中与作者逐人可靠绑定
- Guangyu Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Guinan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- He Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiahong Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Meng Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingyu Cui:机构信息未能在本次解析中与作者逐人可靠绑定
- Peng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Rongjie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Steve Yves:机构信息未能在本次解析中与作者逐人可靠绑定
- Teddy Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Tian Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Yixuan Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhennan Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhihang Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhuohao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziqiang Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Anji Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Bang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Caisheng Ouyang:机构信息未能在本次解析中与作者逐人可靠绑定
- Chengqi Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chong Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Conglian Xie:机构信息未能在本次解析中与作者逐人可靠绑定
- Dongdong Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Edward Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Evelynn Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ferman Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Feng Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Gang Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jathon Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jaxl Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiachen Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingxi Gui:机构信息未能在本次解析中与作者逐人可靠绑定
- Kysun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Liang Dong:机构信息未能在本次解析中与作者逐人可靠绑定
- Longsha Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Na Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Rilin Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Yuan:机构信息未能在本次解析中与作者逐人可靠绑定
- Shanshan Sang:机构信息未能在本次解析中与作者逐人可靠绑定
- Siyu Yan:机构信息未能在本次解析中与作者逐人可靠绑定
- Steven Hong:机构信息未能在本次解析中与作者逐人可靠绑定
- Taihui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiwei Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiangyu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaotong Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xue Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xue Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yameng Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifu Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuhuan Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiang Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhibin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
Hy ASR 3.0 要把一段语音连同可选热词表、问答对话或摘要转写成对应语言文字,并处理普通话、英语、粤语、方言、长音频、儿童和老年人语音、低音量与噪声语音等场景。系统先由音频编码器提取声学表示,再经音频适配器映射为 Hy3 语言模型可接收的嵌入;若有候选热词,则用声学表示和候选词表检索相关词条,并把这些词条、摘要或问答上下文编码为放在音频嵌入之前的文本前缀。Hy3 解码器以文本前缀、音频嵌入和已生成词元为条件自回归输出转写,同一句话内部的同音或近音歧义靠整段音频与已生成文本消解,不另设外部上下文输入。与直接把通用、方言、上下文目标混在单一策略中优化不同,训练先做音频编码器自监督预训练,再做大规模 ASR 预训练,随后在 SFT 后用通用、方言、上下文偏置 3 个强化学习专家分别优化,最后以多教师同策略蒸馏把专家行为合并到学生模型,并针对真实困难案例做模型行为强化学习。在公开基准汇总上,Hy ASR 3.0 的中文 CER 为 4.64%,低于 FunASR Flash 的 4.77%;英文 WER 为 5.22%,低于 StepAudio 3 ASR Max 的 5.38%;方言识别合并 CER 为 4.80%,低于 Qwen3 ASR Flash 的 5.45%。但在公开 VoxPopuli-en 口音子集上,Hy ASR 3.0 的 WER 为 15.27%,高于 Preview 的 14.75%,说明口音英语仍有退化。上述结论受评测范围限制:上下文结果是跨系统比较而非同模型有无上下文消融,人工方言评测未说明标注者一致性且只比较 FunASR Flash 和 Doubao ASR 2.0,儿童与老年人合并测试不能证明各年龄组分别改善。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 像真人不等于想多聊:客服电话合成语音的两类评价

评分:6.9/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Jeffrey M. Girard:机构信息未能在本次解析中与作者逐人可靠绑定
- Antony D’Avirro:机构信息未能在本次解析中与作者逐人可靠绑定
- Jason Z. Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Jacqueline R. Vertino:机构信息未能在本次解析中与作者逐人可靠绑定
- Benjamin Peloquin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
客服通话中智能体印象既取决于说什么,也取决于怎么说,相同文字的不同节奏停顿可传达不同意图,而以往听测多问像不像真人,很少问更愿意与谁交谈。论文区分声音有多像真人的类人程度与更愿意与谁交谈的交谈偏好,取一百二十个客服代表轮次的人工核对转录文本为输入,用六个商用文本转语音系统各以八个声音合成相同回复得到合成片段。先保留来电者上一轮录音作语境,再把语境与同轮次两片段配成试次送入配对选择听测,第一项试验比较两个系统合成,第二项试验比较真人演员录音与系统合成,听者随机分入两组对同一试次各按一种提问作答。最后听测选择送入逻辑斯谛混合模型估计系统强度与胜率,并把三个自动自然度分数与七个韵律特征的片段差异加入模型检验关联。两种判断对系统排序不一致,在第二项试验真人演员录音对系统合成的配对选择中,交谈偏好下系统胜过演员的胜率为36%,高于类人程度下同一胜率的19%,最受偏好系统在交谈偏好下的胜率为49%,高于全部系统均值的36%。三个自动自然度分数均不能预测交谈偏好,语速更快与句间停顿更少同时对应两种判断的选择,音高变化更大与末尾音高更下倾只提高交谈偏好选择。结论限于转录文本合成的客服轮次,未验证语言模型撰写回复或完整对话表现,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 用健康下一步预测度量行为偏离来辅助抑郁筛查

评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Changzeng Fu:Northeastern University;The University of Osaka
- Songyang Wang:The University of Osaka
- Chang Gao:Northeastern University
- Xinyi Zhang:Northeastern University
- Peilin Li:Northeastern University
- Mo Meng:Northeastern University
- Jiarui Wu:Northeastern University
- Mingze Li:Northeastern University
- Hongwei Ding:Northeastern University
- Shiqi Zhao:Northeastern University
- Yong Li:Southeast University
- Lang He:Xi’an University of Posts and Telecommunications
📌 核心摘要
抑郁筛查需从长时间语音、面部行为和转写文本估计风险,但一段录音仅一个标签而无逐段情绪标注,且语速慢或少表情可能是习惯而非症状,缺个人可比参照。本文先用冻结多模态骨干对齐音频和视觉并拼成状态序列送入仅在健康训练样本上学习且带上下文条件的下一状态预测器沿历史给出健康参照预测并与真实下一状态比较得逐时刻残差,该参照预测链路称为个体惯性通路(Idiographic Inertia Pathway, IIP)。再把残差平均为参考偏离(Reference Deviation, R)、把残差围绕中位数的波动拟合为残差衰减率(forceAR)、把预测器在平均状态处映射总结为雅可比谱描述子(rho(J)),三者经训练集标准化后由线性头转成对群体分数的个体修正。最后把整段录音映射为群体风险分差的通路称为群体筛查通路(Nomothetic Screening Pathway, NSP),它用低秩适配调同一骨干输出风险词分数并取正负分差作群体边际,最终分数为边际加修正。与只给标签的序列模型不同,该工作把健康条件预测作可检查参照并把偏离幅度与粘性作单独评测证据。在自发独白的D-Vlog测试集上,本文融合方法的F1为98.41%,高于单独群体通路的97.38%;在中文独白的LMVD上,融合F1为84.98%,高于个体惯性通路单独的75.88%。该证据在访谈任务上不稳定,AVEC2014上参照区分力弱且融合低于已有基线最大值,说明参照覆盖决定适用边界。从缓存特征起的描述子提取约需0.23秒每段录音且峰值显存低于11 GiB,修正头在CPU上约需0.2-0.3秒,骨干提取开销未计入。
🔗 开源资源
- 第三方资源:https://hacilab.github.io/InertiaMPDD-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. 细时间分辨率下的可靠说话人表示:FineSpeaker 的方法与证据

英文题目:FineSpeaker: Reliable Speaker Representation Learning at Fine Temporal Resolution
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yongkang Yin:Guangdong Provincial Key Laboratory of Ultra High Definition lmmersive Media Technology, Shenzhen Graduate School, Peking University;ADSPLAB, School of ECE, Peking University, Shenzhen, China
- Wenhao Yang:MiML Plus, Xiaomi Inc., Beijing, China
- Lichun Fan:MiML Plus, Xiaomi Inc., Beijing, China
- Jian Luan:MiML Plus, Xiaomi Inc., Beijing, China
- Hang Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuexian Zou:Guangdong Provincial Key Laboratory of Ultra High Definition lmmersive Media Technology, Shenzhen Graduate School, Peking University
📌 核心摘要
论文研究短时和逐帧说话人表征的可靠性:短片段证据少,扩大上下文又可能混入相邻说话人,因此需权衡时间分辨率与表示可靠性;输入 80 维对数梅尔谱,输出整句嵌入或连续时间位置均值池化后的帧级嵌入,用于说话人验证和零样本说话人分离标注。模型先以步幅 2 卷积将时长降至 \(T/2\),再经四个 stage 多尺度卷积块和 TCN 块,最后由窗口 51 的滑动窗口自注意力产生帧级表示;推理时对连续 \(N\) 个时间位置均值池化,以 \(N\) 控制输出粒度和覆盖时长。训练将 6 s 谱图切成两个不重叠的 3 s 段:前段送入冻结的 Whisper-Tiny 提取语义,后段送入说话人编码器提取说话人特征;变分自编码器(VAE)以说话人类别中心为先验建模帧级说话人潜变量,再与语义特征拼接,由 DiT 速度网络学习流匹配速度,并经 Mel 解码器重建谱图。与仅依赖长上下文聚合不同,其局部时间建模加生成式解耦用 VAE 与流匹配约束联合语义–说话人潜空间;先仅用整句嵌入优化 AAM-Softmax,后联合优化 AAM-Softmax、VAE 和流匹配损失。VoxCeleb1-O 的 0.5 s EER 为 9.1226%,低于 ReDimNet-B4 的 11.2516%,1 s 为本文最低;但 2 s 和整句下 ReDimNet-B4 更好,本文 VoxCeleb1-O/E/H 整句 EER 为 0.6699/0.8561/1.6336%,ReDimNet-B4 为 0.5744/0.8006/1.4571%。CN-Celeb 整句 EER 为 7.6373%,略高于 ReDimNet-B4 的 7.5286%,但 0.5 s 和逐帧条件更好;零样本说话人分离标注中,0.3 s 条件在四个语料上均最低,0.5 s 和逐帧条件则依赖数据集。训练用 SGD、批量 384、8 块 NVIDIA RTX 5090,两阶段为 45 和 40 个 epoch;结论主要适用于短时和逐帧场景,整句和 2 s 验证不优于 ReDimNet-B4,零样本分离的 0.5 s 与逐帧表现随数据集变化;论文未报告延迟、吞吐或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 让少量合成样本覆盖真实分布:漂移式数据蒸馏

评分:6.7/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.4/1.5 | 清晰度 0.9/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- George Cazenavette:机构信息未能在本次解析中与作者逐人可靠绑定
- Angelina Quan:机构信息未能在本次解析中与作者逐人可靠绑定
- Giannis Daras:机构信息未能在本次解析中与作者逐人可靠绑定
- Antonio Torralba:机构信息未能在本次解析中与作者逐人可靠绑定
- Vincent Sitzmann:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
数据集蒸馏要学习的是一小组合成样本,使其在训练下游分类器时替代较大的真实数据集。论文的目标不是让合成样本主要迎合某个分类器的决策边界,而是让它们直接近似每类的真实数据分布。方法把每个类别视为一个分布,在冻结特征提取器的隐空间中同时计算吸引项和排斥项:吸引项把增强后的合成样本拉向真实样本,排斥项把它们与其他合成样本及其增强视图推开,形成漂移场。每个合成图像用多尺度拉普拉斯金字塔参数化,优化时逐步加入更高分辨率层,并使用固定的颜色去相关变换限制不自然颜色;真实样本特征预先计算,梯度只回传到金字塔参数,逐个类别独立优化。
主实验在 ImageNet-1k 上按类别蒸馏,再用 ResNet-18 从零训练。噪声初始化、每类 10 张、硬标签设置下,MoCo-v3 特征空间的漂移数据达到 27.0% 验证集 top-1 准确率,同组最强基线 G-VBSM† 为 11.7%;软标签设置下本文 MoCo-v3 变体在每类 10 张和 50 张时分别为 40.3% 和 52.8%。论文还报告覆盖率、k-NN、线性探针、7 个骨干的跨模型观察、ImageNette/ImageWoof、FMA small 音频、HMDB51 视频和艺术画布。主要不足是音视频证据各只有一个数据集和一个 coreset 基线;逐类优化成本高;与扩散方法的比较显示分类准确率与分布覆盖并不总是一致。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. Kezek:把单声道双人对话拆成逐说话人轨道
英文题目:Kezek: Splitting Mono Two-Person Conversations into Per-Speaker Tracks for Full-Duplex Dialogue Data
评分:6.6/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.9/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.4/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Bagzhan Karl:机构信息未能在本次解析中与作者逐人可靠绑定
- Alizhan Karl:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
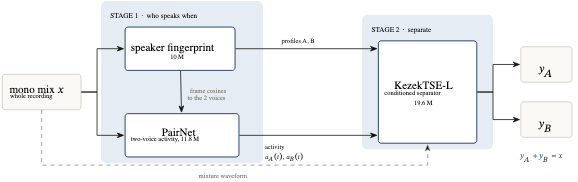
论文把单声道、恰好两人的对话分成与输入等长同时序的两条单轨,重叠和短回应留在原说话人轨;已有“说话人日志→生成式修复”级联会换轨、丢短回应、泄漏或丢弃部分音频。Kezek 先由相位不敏感的说话人指纹提取录音级说话人向量、固定整段录音的两个身份,再由 PairNet 逐帧输出两人活动提示;这些提示与说话人向量送入 KezekTSE-L,最后用混合一致性投影强制两轨相加等于输入。训练时用词边界门控标签减少近讲串音造成的假活动,分离器先学 Libri-Light 合成重叠,再学 Open Yap 混合并扩宽,最后适配自有指纹;说话人指纹以全通滤波增强降低相位依赖。评测用短回应保留率、泄漏、无换轨率和覆盖率,区分有参考轨的 Open Yap 与仅有话语级标注的 CallHome。在 Open Yap test 的 as recorded 条件下,Kezek 的短回应保留率为 0.830、覆盖率为 1.000、无换轨率为 0.934,分别高于 pyannote→DialogueSidon 的 0.687、0.735 和 0.793。在同一 Open Yap test 的 as recorded 条件下,Kezek 的泄漏为 -13.9 dB,低于 pyannote→DialogueSidon 的 -10.1 dB,泄漏更少;单张 RTX PRO 6000 上推理吞吐为 231 音频小时/GPU 小时,高于 pyannote→DialogueSidon 的 51 音频小时/GPU 小时,训练也用该卡,训练耗时原文未披露。在仅有话语级标注、两系统均未见过的 CallHome English 上,Kezek 在他人说话时的短回应保留率为 0.796,高于 pyannote→DialogueSidon 的 0.711;同一数据集的推理吞吐为 232 音频小时/GPU 小时,高于 pyannote→DialogueSidon 的 46 音频小时/GPU 小时。在双方都返回的 Open Yap 音频上,Kezek 的短回应保留率为 0.859,低于 pyannote→DialogueSidon 的 0.865;外部管线主要因丢弃部分输入,另因泄漏和换轨而落后,剩余的主要失败是较响声音下的安静短回应,系统限于恰好两人、离线、无注册且不恢复音质,训练与定量评测仅英语。
🔗 开源资源
第三方资源:https://github.com/Manifestro/kezek — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/manifestro/kezek-v1 — 链接可访问(HTTP 200)
第三方资源:https://manifestro.io/models/kezek — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. qVocalTract:噪声量子硬件上的声道谱编码与共振恢复

英文题目:qVocalTract: Efficient encoding framework of vocal-tract spectra on a quantum computer
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.9/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sheng Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiyi Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
qVocalTract 要解决的问题是把声道传递函数这类结构化声学频谱装入量子态,并在超导硬件噪声下尽量保留谱包络和共振结构。输入是 Dresden Vocal Tract Dataset(DVTD)中按 10 kHz 上限采样、经峰值归一化的对数幅度序列,输出是可重建的包络及检测到的共振频率;困难在于通用量子态制备的门数随频点数增长,而更大的矩阵乘积态(MPS)键维虽降低近似误差,却增加双量子比特门和路由代价。方法先用截断到键维 \(\chi\) 的右规范张量列车奇异值分解(SVD)得到归一化近似态,并以顺序制备作对照;qVocalTract 改用无辅助比特阶梯层,由目标态构造第一层,再以残差态构造后续层,并用局部极分解更新优化门。电路执行后从计算基测量估计各频点概率,按已知符号恢复幅度,再合并相邻频点得到 256 个包络箱,并从中检测前三个共振峰。参考元音在 ibm_kawasaki 上的三层阶梯包络均方根误差(RMSE)为 3.52 dB,低于顺序 \(\chi=2\) 的 6.63 dB,也低于四层阶梯的 4.88 dB;在 44 个 DVTD 配置上,三层平均硬件 RMSE 为 4.74 dB,对照顺序 \(\chi=2\)、\(\chi=4\) 分别为 7.15、9.15 dB。上述门数、近似精度与累积噪声的取舍结论以 ibm_kawasaki 和 44 个 DVTD 配置为界,三层在此较平衡;峰值提取对漏检或虚假共振敏感,论文未报告重复硬件运行的变异性,且读出仅恢复幅度而不验证相对符号和相位。顺序 \(\chi=8\) 只在参考元音上评测、未进入 44 案例扫描,更广泛声道模型仍待验证,模态探针也只检验相干处理而非语音合成;论文未训练神经网络,原文未给出量子电路执行的时延、吞吐或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 多码本 BEST-RQ 的分布鲁棒训练:目标空间、权重更新与 MLS 结果
英文题目:Distributionally Robust BEST-RQ For Speech Representation Learning
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Muhammad Khan:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaodong Cui:机构信息未能在本次解析中与作者逐人可靠绑定
- Brian Kingsbury:机构信息未能在本次解析中与作者逐人可靠绑定
- George Saon:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
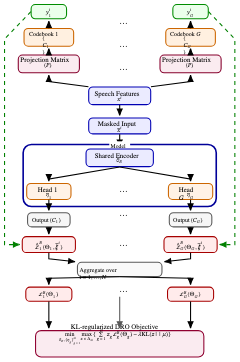
论文针对 BEST-RQ(用固定随机投影和码本构造掩码预测目标的语音自监督预训练)表示可能依赖单一随机量化配置、多码本均匀平均又默认各码本同样可靠且有信息量的问题,提出 KL 正则化的组分布鲁棒优化(DRO)扩展。输入同一批无标签语音:先用固定的共享随机投影降维,再分别经多个固定随机码本做最近邻量化,输出各码本下的离散目标;掩码帧加噪后送入共享 Conformer 编码器,各码本对应的预测头把编码器输出转成该码本词条上的分布,并在被掩码帧上用这些分布与相应目标计算交叉熵,得到各组损失。DRO 按各组损失调整码本权重以突出较难组,KL 散度把权重拉向均匀分布、λ 控制重加权幅度;最后,模型参数按加权损失做小批量随机梯度下降,组权重在概率单纯形内做投影梯度上升。与均匀多码本不同,它不只优化平均损失,而让共享编码器兼顾较不利码本,并保留固定随机量化无需学习码本的计算优势;但 λ=0 时会退化为只针对最困难码本的最坏情况优化。Multilingual LibriSpeech(MLS)五语言实验中,四个码本、λ=1.0 时平均词错率(WER,越低越好)为 8.4%,低于均匀多码本的 8.9%,葡萄牙语从 18.9% 降至 17.7%。证据仅来自该数据集、四码本和一套训练设置,未报告重复随机种子或统计显著性,尚不能确认对其他码本数、语言、模型规模或训练配置同样有效。原文使用 8 块 NVIDIA H100 GPU、预训练和微调各 30 个 epoch,未给出训练总时长、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 冻结骨干、只改技能库:HyperSkill 如何做全模态问答

英文题目:HyperSkill: Training-Free Omnimodal GRPO via Hypergraph-Indexed Skill-Library Evolution
评分:6.4/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.4/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haoran Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Shangkai Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinyang Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinliang Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Luu Anh Tuan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务是让冻结主干大模型完成文本、图像网页证据、长文档与音视频问答推理,难点是参数更新昂贵易遗忘且难审计,而已有免训练技能库多做轨迹级相关收录,缺少单步定位与质量信号。HyperSkill把策略放在外部超图索引技能库中,技能节点带优势值、多技能组合成超边,只改写库而不更新主干参数。样本以问题、参考答案与模态标记三元组连同图像、文档块或关键帧加音频进入带检索的冻结主干,输出写在<answer>标签中的短答案并以词级F1计分。先由技能蒸馏提取同题成功与失败轨迹的步骤分歧并输出反事实探针多数赞成的技能与协议技能送入库,再由门控超图检索按优势加权排序并经相似度下限与容量上限过滤后输出技能提示送入冻结主干,最后由执行协议固定工具标签、预算与作答格式并在需要时投票作答。与轨迹级经验池和平面技能表相比,关键差异是步骤级反事实准入、每技能优势值与多技能超边组合均参与排序与进化。在11个数据集全集均值上,HyperSkill以词级F1 42.0%超过最强基线XSkill的29.0%,绝对提升13.0个百分点,单库训练平均花费0.51美元而全集一次推理花费2.34美元。三数据集实测每题平均延迟为AIME2024上14.98秒对11.75秒、FVQA上12.78秒对14.56秒、DocBench上3.56秒对3.66秒,最多增加约3秒;结论限于同一冻结主干与同一工具栈下单次评测均值,其中5个小差距配对自助置信区间包含零按并列计,跨主干与长期在线进化尚未验证。
🔗 开源资源
- 第三方资源:https://github.com/LHRLAB/HyperSkill — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 跟着歌曲打鼓能找到拍子吗:生成式拍子跟踪解读

英文题目:Can Music Generation Models Tap Along? Evaluating Generative Approaches to Beat Tracking
评分:6.3/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kun Fang:Schulich School of Music, McGill University, Montréal, QC, Canada;Centre for Interdisciplinary Research in Music Media and Technology (CIRMMT), Montréal, Canada
- Ziyu Wang:Courant Institute, New York University, New York, USA;Mohamed bin Zayed University of Artificial Intelligence (MBZUAI), Abu Dhabi, UAE
- Ichiro Fujinaga:Schulich School of Music, McGill University, Montréal, QC, Canada;Centre for Interdisciplinary Research in Music Media and Technology (CIRMMT), Montréal, Canada
📌 核心摘要
传统节拍跟踪直接从歌曲音频估计节拍时刻,容易依赖鼓点等明显线索,在鼓声缺失或弱拍处出错。本文把节拍跟踪转为先生成后提取,输入 30 秒歌曲音频,生成与之同步的打击乐音轨,再用轻量跟踪器从打击乐中读出节拍位置。输入歌曲先变为神经音频编解码器 EnCodec 的离散编码序列,EnCodec 的作用是把波形压缩为可自回归预测的离散记号并能解码回音频,再送入冻结的大尺寸音乐生成模型 MusicGen 提取各层帧级特征,MusicGen 的作用是按帧顺序预测 EnCodec 记号的自回归生成模型,加权融合后经空洞卷积纳入约 5 秒上下文,形成条件。该条件以逐帧相加和门控交叉注意力注入冻结的小尺寸生成模型,自回归生成打击乐编码序列并解码为音频。轻量时域卷积网络从打击乐对数梅尔谱预测帧级节拍概率,时域卷积网络的作用是以扩张卷积捕捉长时节奏依赖,再经动态贝叶斯网络解码为时刻,动态贝叶斯网络的作用是结合 tempo 连续性约束输出时刻序列。在 999 首 GTZAN 全混音前 30 秒评测中,本文 Click 目标模型的 F-measure(70 毫秒容差)为 0.851,低于 Beat This! 的 0.888。在 999 首 GTZAN 全混音前 30 秒评测中,本文 Click 目标模型的 AMLt 为 0.907,高于 Beat This! 的 0.895,表明跟随连续性较好而节拍层级易错。该结论限于 30 秒前段全混音与鼓分离音频的对比条件,鼓分离来自源分离而与自然无鼓录音不同,且未做听感评测,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://kunfang98927.github.io/generative-beat-tracking/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. JEV-VAD:用任务前置条件与浅层解码器做语义端点判定

英文题目:JEV-VAD: Efficient Semantic Endpointing via Task-First Conditioning and Decoder-Prefix Pruning
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jintao Liang:Tianjin University
- Nan Li:Tianjin Normal University
- Longbiao Wang:Tianjin University
- Tubin Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Min Xu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文研究语音代理在对话停顿处判断用户是否说完的语义端点检测:输入为截至当前时刻的音频窗口、完成判断问题 \(q\) 与判定标准 \(c\),输出停止概率 \(p_{\mathrm{stop}}\),再由单独策略转成结束或继续等待。JEV-VAD 与依赖转写或完整生成的端点方法不同,先把 \(q\) 和 \(c\) 置于音频 token 之前,使因果解码器中的音频位置能利用任务条件构造表示;再将最终助手前缀状态经线性头输出标量停止概率,省去转写、答案解码和词表投影。模型先以二值交叉熵拟合端点标签做监督微调,再用 Bernoulli RLCD 按采样动作与标签及彼此的一致性更新 LoRA 和标量头。效率分析物理删除后续解码块、只保留前 \(d\) 个,并在冻结主干和 LoRA 后为各深度以相同预算重新拟合标量头,以区分深度变化与读出头差异。在 EOT-bench 的中文完整模型评测中,JEV-VAD 的 cut@300ms(HOLD 误打断率,越低越好)为 19.57%,低于 DuplexJev-Para 的 cut@300ms 39.14%。在 EOT-bench 的英文评测中,JEV-VAD 的 cut@300ms 为 16.31%,高于 LiveKit TD v1 的 cut@300ms 9.93% 和 Deepgram Flux 的 cut@300ms 12.91%,即误打断率更高。在 EOT-bench 的 14 语言等权宏平均评测中,JEV-VAD 的 AUC 为 91.1%、AP 为 84.2%,低于 LiveKit TD v1 的 AUC 93.9%、AP 89.7%;其 cut@300ms 为 19.09%、lat@5%cut(5% cut 预算下的平均等待,越低越好)为 775.9 ms,高于 LiveKit TD v1 的 cut@300ms 13.99%、lat@5%cut 624.5 ms,即这两项更差。按 Table 5 的 2.56 s 音频、73 token 输入单次前向矩阵计算,L07 的总参数为 453.22M,低于 L28 的 787.01M;L07 的解码矩阵计算量为 16.548 GFLOPs,低于 L28 的 66.191 GFLOPs。原文未披露训练、推理或部署的实测成本,仅报告参数与 FLOP 预算,并注明端到端墙钟时延未测;作者也指出缺少仅监督微调的消融,RLCD 的独立贡献尚未分离。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 如何把 AI 音乐创造力拆成可计算的多维指标

评分:6.2/10 | 创新 1.3/2 | 技术严谨 0.9/1.5 | 实验充分 0.4/1.5 | 清晰度 0.9/1 | 影响力 0.9/1.5 | 开源 1.2/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:理论研究 | arXiv 原文
👥 作者与机构
- Hindy Rossignol:Department of Arts and Sciences, University College London, Malet Place, London, WC1E 7JG, United Kingdom
- Giorgio Franceschelli:Department of Computer Science and Engineering, University of Bologna, Viale del Risorgimento, 2, Bologna, 40136, Italy
- Mirco Musolesi:Department of Computer Science and Engineering, University of Bologna, Viale del Risorgimento, 2, Bologna, 40136, Italy;Centre for Artificial Intelligence, Department of Computer Science, University College London, 66-72 Gower Street, London, WC1E 6EA, United Kingdom
📌 核心摘要
论文要解决如何对生成式人工智能音乐进行可解释、可比较的创造力评估。输入是待评音乐作品的符号或音频表示,输出不是单一“创造力分数”,而是覆盖价值、惊讶度和新颖性的 M-value、M-surprise 与 M-novelty 指标。难点在于音乐创造力依赖听者先验、文化与任务,已有客观指标又常与人的感知弱相关。方法先提取作品的符号或音频特征与嵌入,输出效价—唤醒度、信息量、熵、谱通量、节奏间隔和嵌入距离等中间量;再据此估计 M-value、M-surprise 与 M-novelty;最后保留互补维度,并把惊讶分为概率、隐藏内容和范式转移三类,不规定各维度权重。这与把创造力压成单一目标的思路不同:能保留不同审美和结构来源,但不能直接给出总排序。原文给出表 1 的定性组合解释和表 3 的指标汇总,但贡献被明确限定为概念性,未报告与人类判断对照的实证验证,也未给出本文方法的 MOS 或 CLAP 基线数值比较。原文转述的一项可核对数值来自 Yang et al. (2008):在支持向量回归估计效价—唤醒度的设置中,唤醒度的 R² 为 0.58,高于效价的 0.28,但这不是本文方法的 MOS 或 CLAP 成绩。适用性取决于先验音乐经验、参考语料和嵌入模型等设定;就本文方法而言,原文未提供可核对的关键定量结果,论文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. DeALR:冻结音频语言模型中的声学回溯式测试时推理

英文题目:DeALR: Decoupled Audio-Latent Optimization with Acoustic Backtracking for Test-Time Reasoning
评分:6.2/10 | 创新 1.2/2 | 技术严谨 0.9/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haoyu He:机构信息未能在本次解析中与作者逐人可靠绑定
- Yan Rong:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Liu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文研究冻结大型音频语言模型在测试时的潜在推理:输入文本查询与连续音频嵌入并输出答案,难点是音频通常只编码一次,后续多步推理偏向语言空间,细粒度声学证据易被弱化。DeALR先让若干初始思考向量对音频位置形成注意力,聚合后做滑动平均,再用一维时间非极大值抑制选出连续音频片段,接在对应思考向量之后插入推理序列。随后,DALO在冻结主干LLM参数下,用高斯扰动和奖励加权策略梯度同时搜索思考向量与片段嵌入,以思考token位置的预测分布构造奖励并记录最高奖励状态。最终解码前,方法丢弃搜索更新过的片段嵌入,按最佳锚点从原始音频序列取回未损坏片段,再让语言解码器自回归生成答案,以缓解声学表示漂移。与只优化文本思考向量的LTPO或动态潜在块注入的DMLR相比,DeALR把“关注哪些声学片段”和“形成什么潜在想法”放进同一测试时搜索,但不更新主干参数。实验覆盖Qwen2.5-Omni-7B与Qwen2-Audio-Instruct的MMAR、MMAU、AudioMCQ等基准;在Qwen2.5-Omni-7B的MMAU上,DeALR的Accuracy为73.1%,高于LTPO的71.5%和Vanilla的70.2%,但同一模型CompA-R的Accuracy为91.1%,低于DMLR的95.7%,并非所有数据集列最优。方法每个样本做15步REINFORCE优化,在8块RTX 3090(24GB)上实验,MMAU单查询延迟为3.45 s,高于Vanilla的1.05 s和LTPO的3.07 s,但低于CCoT的10.10 s。该方法只在上述两种音频骨干和这些基准上验证,依赖初始注意力定位关键片段及特殊token初始化思考向量,其他骨干、真实部署和所有音频场景尚未验证;作者称可改善置信度校准,但原文未给出校准指标。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. 现场演唱会曲目单识别中的音乐版本检索评测

英文题目:Evaluation of Music Version Retrieval Methods for Setlist Identification in Live Concerts
评分:6.2/10 | 创新 1/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Andres Ferraro:Nowon AG, Switzerland
- Albin Correya:Nowon AG, Switzerland
📌 核心摘要
现场演出曲目识别要从演唱会录音中判断哪些已知歌曲在何时被演唱,输入是整场音频和参考曲目库,输出是带起止时间的匹配;低音质、现场改编、巨型曲库和连续时间轴是主要难点。方法先把整场录音按 120 秒窗口、30 秒步长切分,得到连续待检索片段;再逐片段与参考曲目库匹配并取最高分,得到带置信度的窗口曲目;最后对窗口曲目做时间后处理,合并连续同曲目、按置信度消除重叠后再合并,输出带起止时间的识别区间。Re-MOVE 用 cremaPCP 色度特征生成 256 维单向量并以余弦距离匹配;CLEWS 用 1024 维片段嵌入;NAVE 用 256 维片段嵌入,recognition 模式以 L2 距离和对角带动态规划匹配,pooled 模式用均值池化,讨论处称其评分使用余弦距离。与 Re-MOVE 的单向量不同,CLEWS 和 NAVE 输出约 20 秒片段序列,更能承受部分重叠和改编;NAVE 的 256 维又比 CLEWS 的 1024 维节省存储和检索开销。评价用 DAP 统计被至少一次正确检出的真实曲目条目比例,用 DLP 统计真阳性覆盖真实曲目时长的比例。在重建的 ASID 评测集(62 场)、上述 120 秒/30 秒窗口、后处理且不使用 SVM 时,NAVE recognition 的 DAP 为 0.903、DLP 为 0.697,CLEWS 为 0.903 和 0.689,均高于复现的 Re-MOVE 的 0.779 和 0.573。片段级系统提高了召回与长度覆盖,NAVE pooled 的 DAP 为 0.910、DLP 为 0.705,但假阳性增至 346 个,多于 recognition 的 280 个。原文未披露训练、推理或部署成本,只按 float32、20 秒片段和 5 秒步长估算存储,NAVE 约为 CLEWS 的四分之一;这些结论限于重建的 ASID 和这三套系统,不能直接外推到所有现场条件,原文还指出指标对边界精度和接近饱和的 DAP 不够敏感。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 全双工音视频交互中的参与决策与同步生成:Duo v1 解读

英文题目:Duo: A Reciprocal World Model for Full-Duplex Interaction
评分:6.1/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 0.6/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Hengyuan Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Biao Gong:机构信息未能在本次解析中与作者逐人可靠绑定
- Guoshan Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiyuan Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Lin Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiding Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Yilei Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxin Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Chengzhang Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kun Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiqian Xie:机构信息未能在本次解析中与作者逐人可靠绑定
- Ting Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Xijun Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianren Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiancheng Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- Chi Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuzhe Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Siyi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhenzhong Lan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文提出 Reciprocal World Model(RWM,互惠世界模型),把智能与物理现实视为世界两个同等基本的方面,并以 Duo v1 作为模块化实例;全双工交互指双方可持续接收并回应,允许打断或沉默。已有世界模型多只预测视觉世界,用户靠键盘、鼠标或文本控制,系统内部不能持续理解并实时回应真实用户。Duo v1 以 17 帧视频块(24 fps 下约 0.71 s)为交互单位,接收用户音频、视频和转写文本,输出助手的语音、视频及发言或等待决策。多模态意图模块先读取截至当前块之前的历史,自回归地产生 <speak> 加文本或 <wait> 并保留隐藏状态,而不是只把语言模型当作扩散模型的指令编码器;随后,因果音视频实现模块以这些隐藏状态、参考图、用户音视频和自身历史为条件,用流匹配生成当前块的音频与视频潜变量。训练分 3 个阶段:块级因果监督微调意图模块,冻结它后训练实现模块,最后用双 rollout 分布匹配蒸馏压缩到 4 步。作者还构建合成双人视频通话和多种录制数据,通过统一时间线与质量检查保证对齐。原文未提供可核对的关键定量结果。评估仅来自小规模人工检查,未与基线或当前最佳系统直接比较;训练成本未披露,长时一致性、误解恢复和实际部署开销仍未充分验证,首帧可见还需初始解码与采样窗口等待。
🔗 开源资源
第三方资源:https://github.com/inclusionAI/Duo — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/collections/inclusionAI/duo-v1 — 链接可访问(HTTP 200)
第三方资源:https://duo-v1.github.io — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 声学特征互补组合如何改变语音隐私与对话分析效用

英文题目:The Unseen Threat: How Complementary Combinations of Acoustic Features Compromise Speech Privacy
评分:6.1/10 | 创新 1.1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jule Pohlhausen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jörg Bitzer:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文研究记录端可计算的低层声学特征与时间平滑、下采样梅尔频谱组合后,是否同时提高会话分析效用并增加隐私泄露。输入为16 kHz语音;先由前端计算宽带RMS电平、YIN基频及80个滤波器、25 ms窗、12.5 ms帧移的梅尔频谱,并以500 ms平滑、40倍下采样梅尔频谱为受保护表示,输出逐帧特征。随后,单独RMS或基频的一维帧序列重复80次以匹配模型输入;组合时,将重复后的序列与平滑梅尔频谱逐帧拼接并逐特征归一化。最后将归一化输入分别送入自动语音识别、说话人验证、语音活动检测和说话人分离模型,由知道提取流程并重新训练的知情攻击者评估。不同于只评估单一特征或只平滑梅尔频谱,拼接让高时间分辨率线索与粗采样频谱互补,检验融合是否重新泄露。词错率高表示内容保护较好,等错误率高表示身份保护较好,Matthews相关系数高和说话人分离错误率低表示效用较好。在LibriSpeech test-clean上,单独RMS的ASR词错率为61.67%,与500 ms平滑下采样梅尔频谱拼接后为23.54%,而此前评估的平滑梅尔单独词错率高于100%,说明拼接使单独特征评估漏掉的内容重新泄露。RMS拼接提高部分VAD效用,但未显著改善说话人验证且略降说话人分离;基频拼接改善ASR,VAD与单独平滑梅尔相近,说话人验证和说话人分离更差。结论限于干净、低混响、知情攻击者条件,自然噪声、混响、重叠语音和其他融合尚未验证;原文未披露训练能耗、推理时延、内存或部署成本。
🔗 开源资源
第三方资源:https://github.com/ol-MEGA/ppca — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/speechbrain/asr-transformer-transformerlm-librispeech — 链接可访问(HTTP 200)
第三方资源:https://github.com/brentspell/torch-yin — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 匈牙利语口语真的低资源吗:语音数据集定量调查的论文解读
英文题目:Is Spoken Hungarian Low-resource?: A Quantitative Survey of Hungarian Speech Data Sets
评分:5.8/10 | 创新 1/2 | 技术严谨 0.9/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Péter Mihajlik:机构信息未能在本次解析中与作者逐人可靠绑定
- Katalin Mády:机构信息未能在本次解析中与作者逐人可靠绑定
- Anna Kohári:机构信息未能在本次解析中与作者逐人可靠绑定
- Fruzsina Sára Vargha:机构信息未能在本次解析中与作者逐人可靠绑定
- Gábor Kiss:机构信息未能在本次解析中与作者逐人可靠绑定
- Tekla Etelka Gráczi:机构信息未能在本次解析中与作者逐人可靠绑定
- A. Seza Doğruöz:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
这篇综述考察:带匈牙利语转写的口语数据在数量与可合并使用性上是否仍使匈牙利语属于低资源。作者先以至少配匈牙利语转写的语音为输入,筛出单语和多语集合的合格记录并送入分类表;多语集合只列时长指标(hours)不少于1小时的子集,短于1小时者不列。再按健康成人单语、多语中的匈牙利语、病理语音、儿童相关语音和方言五类归档,输出名称、小时数、说话人数、关键特征和出处。最后汇总表项形成清单估计,讨论其能否支撑语音识别和统一基础语音模型;不同于资源目录,它区分可用小时数与能否直接合并训练,且转写格式、时间对齐、发音、外来词和噪声标注不一致,访问受隐私限制。在CommonVoice匈牙利语子集上,时长指标(hours)在2023年从20小时增至153小时,153小时高于20小时。汇总全部数据集时,结论报告的时长指标(hours)为3000小时,高于摘要同口径的约2800小时;说话人数指标(speakers)为8000人,高于摘要的约7500人;但表内总计行相加值不完全一致,故只能视为清单估计,不能当作可直接合并训练的统一数据集。原文未披露训练、推理或部署成本。资源分布不均:朗读偏多,自然对话、会议和讲座不足,故就可访问转写数据而言,匈牙利语口语对语音技术仍属资源不足;若直接合并清单记录训练或视作统一基础语音模型,会遇到标注、访问和代表性问题,适用性未验证。
🔗 开源资源
第三方资源:https://catalog.elra.info/ → https://catalog.elra.info/en-us/ — 链接可访问(HTTP 200)
第三方资源:https://catalog.ldc.upenn.edu/ — 链接可访问(HTTP 200)
第三方资源:https://live.european-language-grid.eu/ — 链接可访问(HTTP 200)
第三方资源:https://w3techs.com/technologies/overview/content_language — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 动态块在线如何缓解孟加拉语—英语流式识别中的形态截断

评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kazi Rafat:机构信息未能在本次解析中与作者逐人可靠绑定
- Afifa Imran:机构信息未能在本次解析中与作者逐人可靠绑定
- Md. Ismail Hossain:机构信息未能在本次解析中与作者逐人可靠绑定
- Md. Romzan Ali:机构信息未能在本次解析中与作者逐人可靠绑定
- Fuad Rahman:机构信息未能在本次解析中与作者逐人可靠绑定
- Sifat Momen:机构信息未能在本次解析中与作者逐人可靠绑定
- Shafin Rahman:机构信息未能在本次解析中与作者逐人可靠绑定
- Nabeel Mohammed:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文研究低资源、黏着语 Bangla–English 句内代码转换语音的流式识别,并称其为该场景首个综合性流式 ASR 研究;输入连续语音,输出保留英文词根与孟加拉语词缀边界的转写,但孟加拉文元音符号写在辅音左侧,严格因果流式须先输出辅音,跨切换点词缀或需回看词根时易截断、错配。方法先用 VAD 在远大于 200 ms 的自然停顿处切块、上限 3 s,再把每块作为独立单元送入未掩码离线 Paraformer 编码器,恢复块内全局双向注意力,最后经 CIF 加权帧得到词元声学嵌入并由解码器输出文本;与固定窗口因果流式不同,同块后部帧可参与前部词根表示,代价是等待块边界、最坏约 3 s 延迟,而会话短语通常为 1.5–2.0 s,短于上限,多数对话不会触顶。为缓解代码转换数据不足,Script-Anchored Loanword Injection 用 750 个高频语义等价词根把孟加拉语词根换成英文词根、保留原孟加拉语词缀,使约 20% 的句子成为代码转换句;CS-WER 分别统计切换点、英文词根和“英文词根加孟加拉语后缀”的形态边界错误,按切换点/词根/形态报告。在含 9,392 条话语、脚本注入的 Common Voice 会话测试集上,与同样使用约 750 h 数据、借词注入和噪声增强的 3 s 因果流式 Paraformer 相比,动态分块的 CS-WER 从 0.58/0.35/0.42 降至 0.53/0.29/0.35,全局 WER 则从 37.20% 升至 38.73%。在 5 h 含噪留出测试集上,医学领域微调后 WER 为 27%,与通用数据上的基线表现相当;词根错误由微调前 0.78 降至 0.22。目前结论限于 Bangla–English、脚本注入的会话测试和单一 Paraformer 骨干,且需可靠 VAD、词典只覆盖常见借词;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 手机麦克风中的呼吸相位检测:从帧分类到周期级呼吸率

评分:5.7/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Julian Szymanski:机构信息未能在本次解析中与作者逐人可靠绑定
- Tomasz Sankowski:机构信息未能在本次解析中与作者逐人可靠绑定
- Piotr Sulewski:机构信息未能在本次解析中与作者逐人可靠绑定
- Iwo Czartowski:机构信息未能在本次解析中与作者逐人可靠绑定
- Javier Medina Quero:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文处理普通手机麦克风或耳麦录到的鼻呼吸声,在连续音频中逐帧判断吸气、呼气或静默,并由呼气周期估计呼吸率;呼吸声弱、背景噪声和个体差异使短片段缺少完整周期信息,帧级准确率也可能被类别不平衡掩盖。方法先将单声道波形转成对数Mel频谱,再以三层卷积和只压缩频率轴的非对称池化提取保留时间分辨率的局部频谱特征,最后把序列连同正弦位置编码送入Transformer编码器,由全连接分类头逐帧输出类别概率。训练时随机加入高斯噪声、音量缩放和循环时间平移以模拟不同麦克风、距离与噪声,推理时用短时先进先出窗口提供上下文;与逐帧独立分类或只区分呼气与背景不同,三分类显式建模吸气、呼气、静默,二分类和无时序上下文的前馈网络、纯CNN作为对照。在含13名年龄14–52岁未见参与者、逾1300个呼吸周期的2小时独立集上(模型用3名21–23岁男性组成的完整Foundation Dataset训练),三分类Transformer的帧级准确率76.94%低于二分类Transformer的83.10%。同一独立集上,三分类Transformer的周期级呼气检测效率99.2%高于二分类的92.8%,呼吸率平均绝对误差0.93 BPM(每分钟呼吸次数)低于二分类的1.38 BPM。作者报告ONNX Runtime端到端推理延迟低于20 ms,但未给出与其它部署方案的延迟比较,也未披露测试设备、训练成本、内存和能耗。训练人群仅由年轻男性构成且未按年龄或性别分组报告,病理呼吸声、更大规模数据和实际部署条件的外推仍待验证。
🔗 开源资源
- 第三方资源:https://github.com/peterprospl12/breathing-classification-v2 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 边缘声学持续异常检测:同一轻量原型模型跨两块开发板的表现

英文题目:On-Edge Acoustic Continual Anomaly Detection: A Cross-Platform Comparative Study
评分:5.5/10 | 创新 1/2 | 技术严谨 0.8/1.5 | 实验充分 0.7/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Rami Zewail:机构信息未能在本次解析中与作者逐人可靠绑定
- Yehia Ehab:机构信息未能在本次解析中与作者逐人可靠绑定
- Karim Ali:机构信息未能在本次解析中与作者逐人可靠绑定
- Ahmed Mahrous:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohamed Awad:机构信息未能在本次解析中与作者逐人可靠绑定
- Bassem Mokhtar:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文研究微控制器上的声音异常检测:设备以 16 kHz 采集 1 秒单声道音频,输出正常或异常,并尝试用端侧原型更新适应轻微工况漂移;ESP32-S3(外接 I2S 麦克风)与 Nicla Vision(板载 PDM 麦克风)运行同一模型,而不是按板卡重训。音频先切成 49 帧(480 样本帧长、320 样本帧移),补零到 512 点做 FFT,再把 257 个频率幅度压成 43 个频带并取 log(1+x),将 49×43 语谱图串成 2,107 维并送入 ShallowNet,最后输出 32 维嵌入。训练仅用正常声音,先求正常原型,再最小化嵌入到原型的平方欧氏距离;该原型锚定的对比欧氏目标没有显式负样本,仅拉近正常嵌入与原型,原文未说明原型是否停止梯度。离线阈值取正常距离的 95 百分位,但部署字段写 SIMILARITY_THRESHOLD=0.7,二者对应关系未说明。端侧先用前 30 个正常嵌入以旧、新各半递推建原型,推理时距离超阈值且连续 3 个 1 秒窗口一致才报警;持续学习只在单帧判正常时以 α=0.1 更新冻结编码器后的原型,位于投票前,最终结果是否启用未说明。该共享 8 位量化编码器的 Flash 占用低于 140 KB;在受控扬声器回放 DCASE Task 2 五类机器(每类 34 或 40 个文件,约 38 dBA,距声源 30 cm)的设置下,按分类准确率比较,ESP32-S3 在 ToyCar 为 82.35%,高于 Nicla Vision 的 79.41%(差 2.94 个百分点),而 Nicla Vision 在 Toy Train 为 94.12%、Fan 为 88.24%,分别高于 ESP32-S3 的 91.18% 和 82.35%(分别高 2.94、5.89 个百分点);Gearbox 与 Slider 上两者分别同为 87.50% 和 95.00%。这些结果只覆盖受控回放五类小样本,未验证机壳振动、真实工厂漂移及正式启用持续学习后的效果;原文未报告汇总平均、时延、吞吐、功耗或部署总成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. MusicRWKV:多模态音乐表示学习的主干替换、融合步骤与结论边界
英文题目:MusicRWKV: A Multimodal RWKV Framework for Music Representation Learning
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.6/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Terry Tan:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
论文面向长时音乐录音的多模态自监督表示学习,输入为波形、频谱图和元数据,输出为用于下游音乐信息检索任务的表示或预测。Transformer 自注意力的二次复杂度和随序列增长的键值缓存会带来长序列开销;RWKV 以并行训练和循环推理降低推理复杂度,但不天然提供跨模态注意力。MusicRWKV 先用 Jukebox 把波形转成离散标记,用 MuQ Mel-RVQ 把频谱转成离散标记,并将艺术家、流派和可用歌词等元数据转成文本标记;波形和频谱再经可逆压缩模块缩短后分别送入模态专属 RWKV 编码器,元数据直接编码。三路表示经 FiLM 条件化后拼接,送入共享 RWKV 融合编码器;预训练以三种模态的交叉熵损失加重构正则为目标,Soft ROSA 作为可微检索与聚合模块,对中间隐状态做历史候选匹配,形成增强变体。在 MagnaTagATune(MTT)标注任务上,MusicRWKV 的平均精度(Average Precision, AP)为 46.1,高于表内最高的 MERT2-30s 41.3;GiantSteps 的 refined accuracy 为 70.3,高于 MERT2-FS 的 67.1。但在 MTT ROC-AUC、GTZAN 流派分类和 EMO 情感回归上并不领先。相同数据划分、随机种子和优化设置下的预训练消融显示,Soft ROSA 把验证准确率从 93.30% 提到 94.82%,每样本时间从 3.32 秒增到 9.49 秒,峰值内存从 64.90 GiB 增到 69.80 GiB,其下游普遍收益尚未验证。由于下游模型从零训练而基线可能采用预训练探测,上述跨任务比较并非严格同条件;直接迁移大型预训练模型在标注有限时还出现明显过拟合,因此 MusicRWKV 的广泛适用性和预训练表示的迁移效果仍待验证。
🔗 开源资源
- 第三方资源:https://github.com/tanjiarui/music-rwkv — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. 从音高轨迹到拉格相似度:理论驱动的计算识别

英文题目:Computational Raga Recognition: A Theory-Driven Approach
评分:5.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.6/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.6/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Janay Sukheja:机构信息未能在本次解析中与作者逐人可靠绑定
- Shailaja D. Sharma:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文把拉格识别视为理论驱动的相似度比较问题:拉格不只由所用音高定义,还取决于停音、音区侧重、音间连接和特征乐句;输入先隔离主唱声部的演唱录音,由pYIN提取十毫秒音高轨迹,再以人工确定的Sa归一化并映射到二十二shruti扩展的四十四音位,输出共用音位序列。随后从该序列提取Nyasa停音、Purvang–Uttarang音区比例、Vadi–Samvadi重要音、Alpatva/Varjit少用或避用音及Aarohan–Avrohan上下行转移,持续至少约一秒的稳定音位计为Nyasa,形成分布或转移表示;再把音位序列按二百五十毫秒取样,切成四至七秒重叠片段,用加权编辑距离相似度匹配汇总成Chalan乐句表示。最后与Yaman参考模型比较:停音和音区用角度距离,重要音与少用音以前六个主导音位核对,上下行按参考转移概率匹配,乐句按加权编辑距离比不低于零点九计匹配,再加权合成总相似度分数。与只靠音高分布或端到端学习分类器不同,每个计算特征都对应一个音乐学概念,便于解释和逐项检查。以11段、约6小时的Yaman参考录音建模后,在Yaman及Shuddha Kalyan、Bhoop、Bageshri、Miyan Malhar和Marwa的录音测试中,Yaman的总相似度分数为84.0%,高于同一指标下最接近的Shuddha Kalyan的64.90%,其余已报告拉格均低于Yaman。但该测试没有直接基线比较,测试录音数量和划分未完整报告,Bhoop未报告分数;原文未披露训练、推理或部署成本。结论只适用于其选定Yaman参考模型和有限录音,快板、持续音不足或主音确定与近似不准时,相关特征可能提取不足或受影响。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 话太多听太少:社交机器人为什么接不上话

评分:3.9/10 | 创新 0.8/2 | 技术严谨 0.7/1.5 | 实验充分 0.3/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.8/1.5
排名:后 50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Graham Wilcock:CDM Interact and University of Helsinki, Helsinki, Finland
- Kristiina Jokinen:University of Helsinki and CNRS-AIST Joint Robotics Lab, Tsukuba, Japan
📌 核心摘要
本文关注社交机器人在口头对话中话多而倾听不足的问题,输入是用户说出的问句、插话以及面部表情等现场信号,输出是机器人在讲述中及时停顿并回应,难点在于机器人在发声时听不到插话,也难以察觉交流不畅。早期办法是在机器人朗读维基百科段落时,从当前话题的超链接中预判接下来可能问到的相关话题,把开放词汇识别收窄为有限短语的守候,并在段落结尾停顿,允许轻拍头部按钮打断并切换话题。近期的办法是把识别与回答交给大语言模型和带记忆的智能体框架,机器人能围绕那不勒斯旅行给出推荐并记住用户信息,但在同步轮流机制下仍两次漏听用户的删除请求与确认提问。为此作者主张讲述同时保持收听与观察的双向流式传输,先让音频上行与下行并行、视频流持续送达,再把送达的插话语音和表情画面送入边讲边听的监测,最后输出停讲并回应插话或询问异常的动作。与只能顺序问答的同步接口相比,这种方式把打断与表情监测纳入正常通路,不再依赖固定停顿或头部按钮。原文未提供可核对的关键定量结果。作者依据2段演示视频的文字记录和小摆件文字识别的定性观察得出结论,适用范围限于演示的讲解与问答场景,在噪声、重叠说话与长期部署中的效果尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。