📄 把一句话编辑意图变成可执行的声波操作:Harmony 的协同规划与执行
英文题目:Harmony: Bridging Audio Understanding and Editing through Agentic Collaboration
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
👥 作者与机构
- Zhongyi Tong:机构信息未能在本次解析中与作者逐人可靠绑定
- Yapeng Tian:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自然语言音频编辑以原始录音和文字指令为输入,输出修改后录音,难点在于把指令中的选择对象、时间关系和保留要求落到具体声源与时间区间,并在重叠声中只改目标而不破坏其余内容。和谐系统(Harmony)先由大语言模型规划器提出待澄清问题,负责听音的音频语言模型Qwen3-Omni给出目标与时间观察,波形能量、分离辅助与语音转写等分析工具提供候选区间和词级时刻,三方交互输出包含操作类型、目标出现、执行窗口与保留要求的可执行计划。再由SAM Audio或Stable Audio 3产出中间音频并送入检查,系统对照计划判断残余声或新素材是否可用,在固定预算内触发有界修正,最后把处理后分层放入执行窗口并与原录音混音。与直接按指令重构整段的扩散编辑器和程序化调用工具但缺少中间检查的智能体相比,该流程把语义决策与波形操作贯穿起来。在420个MMAE样例的pooled混合平均评测上,和谐系统的完全成功率(Exact Match Rate, EMR),即全部编辑与保留细则通过的比例,为22.62%,高于最强基线原始WavCraft的13.57%。结论适用于增加、删除、替换和音量调整四类单步编辑,复杂多步指令、自然衔接以及跨数据集泛化尚未验证。原文报告首次完整执行的平均开销为每条输入105.30秒和4.25次模型调用,替换类耗时与调用最多。
🔗 开源与复现资源
第三方资源:https://christong9.github.io/harmony/ — 链接可访问(HTTP 200)
第三方资源:https://www.schristiancollins.com/generaluser.php — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
自然语言音频编辑的输入、目标和必须保留的东西是什么
自然语言音频编辑的起点是一个原始录音与一句自然语言指令,终点是一个编辑后录音。系统要做的不是从头生成一段音频,而是在保留不应改动的内容与时间结构的前提下实现指令要求的改动。论文把操作范围限定为 4 种:添加、删除、替换和音量调整。输入录音里可能包含语音,输出要在改动处发生变化,在其余位置尽量不动。
举一个贯穿全文的例子就能看清任务难度。指令说把每声狗叫换成猫叫同时保持谈话不变,系统需要找到每次犬吠、产生合适的猫叫素材,还要保住与犬吠重叠的语音。论文强调,听起来合理的新声音只是成功的一部分,关键还在于改什么、在哪里动手、如何与现有录音融合。生成能力强不等于保留能力强,重建音频时即使整体内容结构还在,也可能在目标之外引入多余变化。
对刚进入音频领域的研究生来说,可以把这项任务理解成三件事的绑定。第一是语义选择,指令里的第二次、结尾处、在说话之后这类表述要落到具体声事件上。第二是时间定位,每个目标要有起止边界,后续的放置与混音都依赖它。第三是波形装配,分离出的残留与新生成的素材要在时间窗内组合,窗外则从原始录音拷贝。缺少其中任何一环,编辑都可能听起来对了大意却通不过细则检查。
已有两条路线各自解决了什么,又在哪里不够用
第一条路线是指令条件编辑模型,直接学习从输入录音按文本指令变换到输出。论文提到的例子包括用潜在扩散学习指令引导变换的 AUDIT,关注音乐一致性的 InstructME,把 Stable Audio Open 适配到自由形式指令的 SAO-Instruct,用音频语言模型联合表示音频与指令再条件化扩散编辑器的 MMEdit,以及对 MusicGen 做加减与分轨的 Instruct-MusicGen。免训练路线则利用已有扩散模型,如用反演的 ZETA 与操纵交叉注意力做局部编辑的 PPAE。更近的工作开始显式处理事件时间,如用事件滚动表示控制动作、声音类别与时间范围的 Recomposer,以及从文本音频注意力提取目标区域并解耦注意力的 FreeSonic。
第二条路线是智能体框架,把编辑组织成显式操作。WavCraft 把专用音频模型与信号处理操作组合成可执行程序,SmartDJ 把高层请求分解成由扩散编辑器执行的原子编辑,RIME 通过工具包支持迭代音乐后期并让智能体听中间音频更新计划,AVE-Agent 则协调音视频编辑的子任务评估与反馈重规划。这条路线的灵活性在于可以组合生成、分离与直接操作,但论文指出,可靠性还取决于选择与执行这些操作所依据的证据。WavCraft 自身也提到从音频中抽取精确时间关系很困难。
与理解侧工具使用的联系也值得说明。ReAct 研究推理与行动交错的一般语言智能体,AudioToolAgent 用中央大语言模型去问音频语言模型与语音工具并调和输出,Audio-Mind 在前端报告未解决问题时请求外部证据与针对性重听,论文还提到其冷热水例子是先隔离两段倾倒声再比较频谱测量。Harmony 的位置是把这类理解侧的证据获取与编辑侧的波形操作绑在一起,既落定事件与时间戳形成可执行计划,又在混音前对分离或生成材料做有界修正。
为什么选第几次、相对时间和重叠声这么难
复杂请求把意图与具体声音和时间区域的连接变得苛刻。论文归纳了 3 类典型困难。第一是单次出现选择,例如替换第二次犬吠,系统必须在多次同类声中选出正确的 1 次,而不是笼统地检测到有狗叫。第二是时间关系依赖,例如把事件放到某句话之后,系统必须先知道那句话的边界,再由语言上下文决定哪个边界才是落点。第三是重叠源修改,例如犬吠与谈话同时出现,改目标时不能把应保留的语音一起拿掉。
理解难之后还有执行难。即使规划选对了目标与窗口,中间音频也可能不支持预期编辑。替换的例子很典型,它同时依赖拿掉旧声与拿到合适新素材。如果分离在替换窗口里留下了旧声,只是叠加上新声并不算完成编辑。系统因此必须把针对指令的观察连到规划,又把工具实际产出的中间音频纳入执行决策。
这就解释了为什么仅有录音的整体描述不够。活动区间可能给出多个候选边界,语言上下文才能决定哪一个是话语结束;分离出的候选源需要再测量活动区域,转录与词级时间才能锚定相对位置。缺少这种语义解读与测量时间的结合,选出现次数与定边界都容易错 1 位,而错 1 位在细则评估里就是失败。
Harmony 如何把理解和波形操作连成一条流水线
Harmony 把 1 次编辑组织成两个互补机制。编辑驱动的协同规划协调大语言模型规划器、作为音频观察者的 Qwen3-Omni 与外部分析工具,产出编辑计划。计划里写清操作类型、目标出现、时间范围、操作参数与保留要求。证据引导的执行则观察首次分离或生成得到的中间音频,在放置与混音之前选择有界修正。分离由 SAM Audio 提供分离源与残留,生成由 Stable Audio 3 提供添加或替换用新素材,最后按计划放置并混成最终录音。
下面这张总览图把两条机制的主路径与可选路径画在了一起,读的时候先分清实线的数据与计划流,再看虚线的可选修正,这样后面谈规划问答与执行修正时就不会混淆各自的输入输出。
看图路径: 1. 先沿左上原始录音与指令进入中间规划器的实线箭头看主路径;2. 再比较上方问答循环与右侧分析工具调用循环如何交汇成编辑计划;3. 接着看下方分离生成到放置混合的执行链与虚线可选修正分支的位置;4. 最后确认窗口与保留要求如何从规划流向放置混合而原始录音作为基底输入
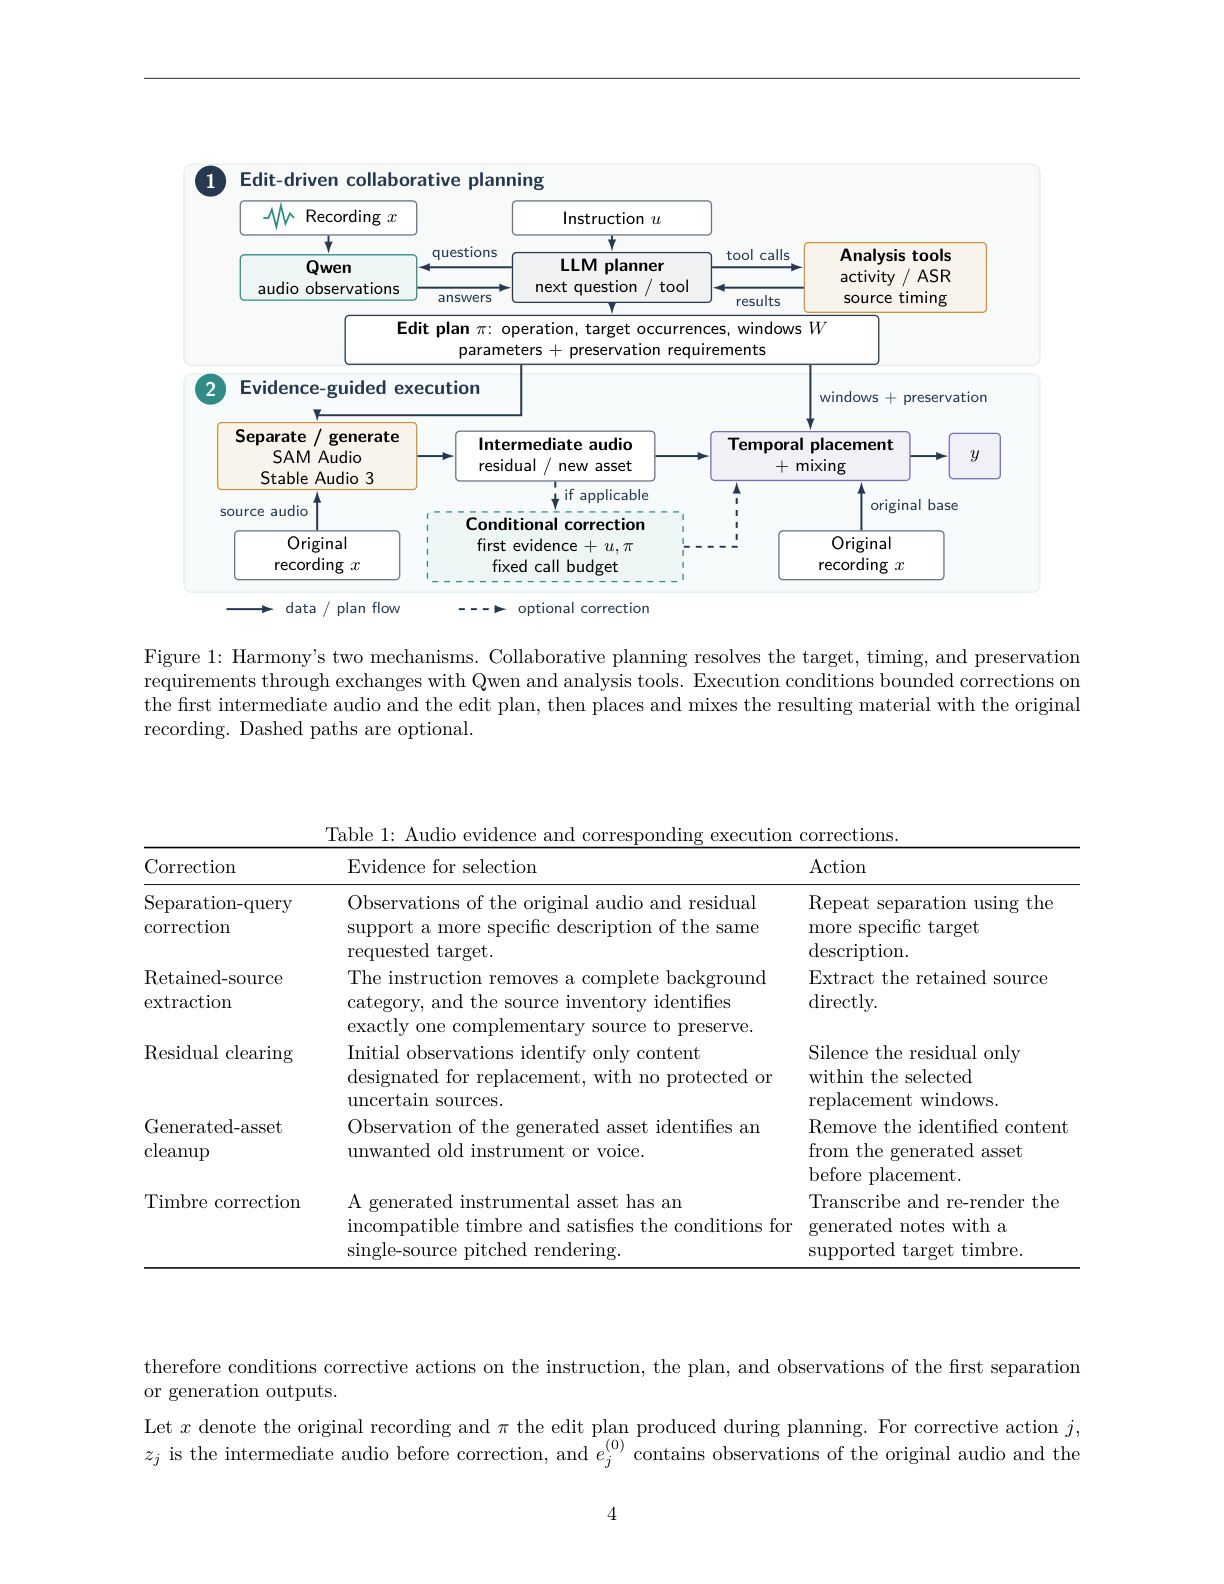
图片来源: 原论文 PDF 第 4 页(含图 1)
论文图 1。原论文 Figure 1::“Harmony’s two mechanisms. Collaborative planning resolves the target, timing, and preservation requirements through exchanges with Qwen and analysis tools.”。
这张图上半部分是协同规划,原始录音的音频观察与规划器之间有提问与回答的循环,规划器与分析工具之间有工具调用与结果返回的循环,两路信息汇成编辑计划,写明操作、目标出现、窗口、参数与保留要求。下半部分是执行,分离或生成先得到残留或新素材的中间音频,再经过以首次证据与指令计划为条件的修正,然后与窗口加保留要求一起进入时间放置与混音,叠加到作为基底的原始录音上得到输出。图注明确虚线路径是可选的,只有观察支持且符合计划的编辑与保留要求时才走那条分支。
协同规划怎样定目标、时间和保留要求
规划从抽取显式编辑需求开始。大语言模型规划器向 Qwen 提出为补齐缺失信息而设计的目标性问题,Qwen 的回答再引导规划器的后续追问与分析工具调用。论文用的规划器推理强度设为低档,音频观察用的是 Qwen3-Omni 的指令版本。长录音是完整给入的,不做切成短片段的外部预分割。
分析工具提供互补的时间证据。波形能量分析定位候选活动区间,分离辅助分析先隔离候选源再测量其活动区域,语音分析给出转录与词级时间。Qwen 把这些测量与请求的声音联系起来。例如活动区间可能提示多个边界,而语言上下文决定哪一个标志着话语结束。规划器把语义解读与测量时间结合,解决事件选择与时间关系。
对于工具导出的时间,程序把选中的区域或词标识解析为已存时间戳,再结合指令的时间约束定义执行窗口。最终计划写明目标声、执行窗口、操作参数与待保留内容。如果初始计划仍有关键信息未定,Harmony 允许在保留指令显式约束的前提下做有界的后续规划。
LLM 规划器 × Qwen3-Omni: LLM 规划器负责从指令中抽取显式编辑需求、决定下一步该追问什么或调用哪种工具;Qwen3-Omni 作为音频观察者负责听原始录音并回答与目标声和时间有关的问题。二者搭配的原因是规划器不直接听波形,而听觉判断又需要被放到编辑目标里解读,问答循环让语义理解去引导测量,测量结果再回过来约束语义选择,组合后才能把第几次出现、在哪段时间这类表述变成可执行的候选。
在调用预算上,论文给了明确限制。每次编辑前控制器调用至多允许 2 次音频观察与 2 次分析工具调用,每种工具类型至多用 1 次且至多做 1 次分离。在此初始预算之外,恢复只允许按添加上下文做 1 次额外规划尝试、按删除计划做 1 次额外定位尝试,以及按未解决的音量动作做 1 次定位尝试。这些预算的意义是让证据获取既有针对性又有上限,避免无限制追问与测量。
看到第一版分离或生成结果后如何做有界修正
规划正确不保证中间音频可用,Harmony 因此把修正动作的选取条件写成对指令、计划与首次分离或生成观察的依赖。记原始录音为输入,规划得到的编辑计划为计划。对每个修正动作,修正前的中间音频是待修对象,初始观察里包含对原始音频与初始分离或生成结果的观察。是否修正由二值决策决定,为真当且仅当该动作适用且观察在计划的编辑与保留要求下支持使用它。适用动作可按执行顺序组合。
这个公式要计算的是修正后的音频,它不是直接重做分离或生成,而是先判断再分支。若决策为真,就用修正工具操作把原始录音、当前中间音频、计划与首次证据结合起来得到修正结果;若决策为假,就保持原中间音频不变。关键符号里原始录音与计划是全局条件,待修对象是中间音频,初始观察是证据,工具操作区分不同修正类型。这种写法把保留计划目标、窗口与保留要求的要求编码进了适用性判断,而不是事后混音时再补救。
\[\tilde{z}_{j}=\begin{cases}T_{j}\!\left(x,z_{j};\pi,e_{j}^{(0)}\right),&c_{j}=1,\\ z_{j},&c_{j}=0.\end{cases}\]这个公式约束的是中间层在进入放置混音之前是否值得动、动哪一步。它先形成首次证据,再合并计划条件,最后把结果交给下一步的放置与混音。下标区分不同修正类型,求和或期望不在这里出现,维度与单位以原文工具输出为准,取值条件就是适用且证据支持。理解时抓住分支含义即可,不必把字母逐个背成孤立定义。
下表比较的是哪种中间音频失配该触发哪种有界动作,每行都是证据支持加动作限定,而不是任意重做,理解时先看证据列再看动作列。
| Correction | Evidence for selection | Action |
|---|---|---|
| Separation-query correction | Observations of the original audio and residual support a more specific description of the same requested target. | Repeat separation using the more specific target description. |
| Retained-source extraction | The instruction removes a complete background category, and the source inventory identifies exactly one complementary source to preserve. | Extract the retained source directly. |
| Residual clearing | Initial observations identify only content designated for replacement, with no protected or uncertain sources. | Silence the residual only within the selected replacement windows. |
| Generated-asset cleanup | Observation of the generated asset identifies an unwanted old instrument or voice. | Remove the identified content from the generated asset before placement. |
| Timbre correction | A generated instrumental asset has an incompatible timbre and satisfies the conditions for single-source pitched rendering. | Transcribe and re-render the generated notes with a supported target timbre. |
从表中可以看到五行的分工。分离查询修正针对同一个请求目标但描述不够具体的情况,用更具体的目标描述再做 1 次分离。保留源抽取针对删除整类背景且源清单里恰好剩一个互补源可保的情况,直接抽取该保留源。残留清零针对初始观察里只有待替换内容而无受保护或不确定源的情况,只在选中替换窗口内把残留静音。生成素材清理针对生成素材里混入不想要的旧乐器或人声的情况,在放置前先把识别出的内容去掉。音色修正针对生成的器乐素材音色不兼容且满足单源有音高渲染条件的情况,先转录音符再用支持的目标音色单次重渲染并保留转录的音乐结构。
修正都有固定上限,分离查询修正只允许 1 次额外分离且限于支持的整轨敲击或噪声去除,生成素材清理每种类型每份素材只允许 1 次,音色修正只做 1 次目标音色渲染。把修正放进流程看,时间放置与混音用的是修正后的层,而不是第 1 次产出。修正保留了计划的目标与窗口,只是把材料修到更可用,这种先观察再小步修正的设计是为了在不推翻规划的前提下处理分离残留与生成杂质。
SAM Audio × Stable Audio 3: SAM Audio 负责分离出现有声音,给出分离出的目标源与分离后剩下的残留;Stable Audio 3 负责生成原本不存在的新素材,用于添加或替换。二者分工正好对应删与加两类波形来源,搭配的理由是替换等操作既要拿掉旧声又要得到合适新声,组合后执行阶段才有残留层与新素材层可供放置与混音。
时间放置与混音如何做到只改窗口内而窗外原样保留
经过适用修正后,Harmony 在执行窗口内组装输出。添加是把新素材叠到原始录音上,删除使用分离残留,替换把残留与新素材结合,音量调整对选中源或混合施加请求增益。对于保留原始时间线的编辑,这些变化被限制在窗口内,窗口边界做平滑过渡,窗口之外的音频从原始录音拷贝。放置时用每份素材的实际时长去落实请求的位置、数量、间隔与覆盖约束,替换在删除与插入之间共享同一窗口,使新素材与选中出现对齐。指令要求时长变化或后续内容移位时才做相应调整。
下面这张局部替换示意图是理解窗口共享的关键,读的时候注意三行分别是什么层,再看窗口内外各自保留了什么。
看图路径: 1. 先看最上方时间轴上第二个犬吠所在选中窗口与两侧未改动段的划分;2. 再比较中间两行窗口内残留与新素材的上下对齐与组合方式;3. 最后看输出行第一个犬吠保留而窗口内变为新声音的对应关系
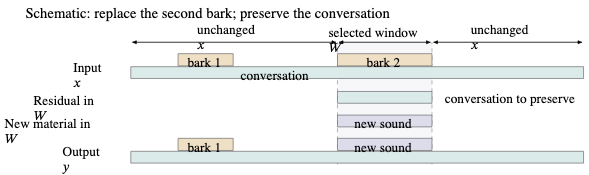
论文图 2。原论文 Figure 2::“Schematic of local replacement. Removal and insertion share the selected window W; the residual and new material are combined within W, while audio outside W is retained.”。
这张图以替换第二次犬吠并保留谈话为例。最上方时间轴标出未改动的输入段与选中的窗口,窗口内是第二次犬吠。中间两行分别是窗口内的残留与新素材,残留行在窗口内保留谈话待保住的部分,新素材行在窗口内放入新声音。输出行在窗口外与输入一致,窗口内是新声音,第一声犬吠仍保留。绿色带在原文中表示谈话保留要求,含义是即使窗口内有重叠语音,混音时也要把该保的谈话成分留下来,而不是把窗口整个静音再贴新声。
执行窗口 W × 保留要求 × 原始录音: 执行窗口 W 是规划落定的时间范围,指明只在哪些区间改动;保留要求指明哪些谈话、背景或时间结构不得改动;原始录音是窗口之外直接拷贝的基准。三者搭配是因为只有限定在哪里动、哪里不动,混音时才能把残留与新素材限制到窗口内而把窗口外原样保留,组合后实现了改动与保留在同一时间轴上的共存。
在增益处理上,添加混音时原始轨道保持单位增益,符合条件的连续上下文层在默认电平下只做局部峰值控制,也就是只在混音需要额外动态余量处衰减添加层。显式增益设置则按指令执行。论文还用一处音量例子说明时间频率结构保留而波形拟合确认均匀增益,这有助于把音量调整理解成结构不变只变电平,而不是重建频谱。
没有训练时系统实际在计算、调用和构造什么
这篇论文没有训练新的神经网络,方法部分的计算是调用、测量、检索时间戳与构造波形的组合。需要明确没有训练哪些模型,再说清实际执行的流程。音频观察、分离、转录、生成都是直接使用的已有模型,音乐渲染用的音符提取或基频轮廓与音色库也是已有工具。系统要学的东西不存在,要做的是按指令与计划去分离、生成、修正、放置与混音。
具体实现上,音频观察用 Qwen3-Omni 的指令版本,分离与生成素材清理用 SAM Audio 的大版本,转录用 Whisper 的大版本,生成用 Stable Audio 3。SAM Audio 保留其内部八候选重排,在缺少显式锚点时预测分离跨度。音乐渲染用 Basic Pitch 音符,或在支持连续音高变换时用 pYIN 轮廓,再经 GeneralUser GS SoundFont 发声。规划器请求不显式设置温度与采样参数。论文脚注给出 GeneralUser GS SoundFont 的页面链接,这里只说明论文提到了该链接,不把它当作作者已开源的证明。
Basic Pitch × pYIN × GeneralUser GS SoundFont: Basic Pitch 负责从生成的器乐素材中提取离散音符序列与时间,用于单音源有音高渲染时的转录重渲染;pYIN 负责在支持连续音高变换时提取基频轮廓;GeneralUser GS SoundFont 提供目标音色的渲染载体。三者搭配是因为音色修正既要保留已生成的音乐结构又要换音色,组合后才能在不重写旋律的前提下只换发声载体。
从可复现角度要记下的信息条件包括:长录音完整给入而不做外部切分,工具调用有上述次数与类型上限,恢复尝试按添加、删除与音量分别限次,执行修正按动作限次,以及当添加时间仍未解决时允许使用显式标记的估计但仍保留原始时间线与基础增益,用户指定约束始终有约束力,替换沿用已建立的执行窗口。这些都是规则控制器的固定行为,不是学习到的策略。
在哪些样本、基线和评分规则下比较
评估用的是 MMAE 中落入 4 类操作的全部评估样本,包括添加、删除、替换和音量调整。输入录音可能包含语音。按时长分,一部分至多 10 秒,另一部分长于 10 秒。开发与调试用的是评估集之外的 MMAE 样本,避免用测试样本调流程。
基线包括 SmartDJ、MMEDIT、WavCraft 与音频编辑挑战智能体赛道基线 AEC Agent。对 WavCraft 同时报告原始配置与匹配主干配置,后者把大语言模型与各分支模型都换成与 Harmony 相同的选择,以便在相同底层模型选择下比较。AEC Agent 用其原始路由加数字信号处理工具、SAM Audio 分离与带提示增强的生成编辑,保留其发布的提示、工具与参数。比较时任务、数据划分与输入条件一致,区别在于各自的工作流与证据使用方式。
评分用 MMAE 基于细则的评估器,以 Qwen3-Omni 为外部裁判。每条细则是关于请求改动或保留要求的单选题,用该细则指定的输入或编辑后音频作判断。每条细则评估 3 次并打乱选项顺序,至少 2 次与标注正确选项一致才算通过。指标有 3 个且方向都是越高越好。指令遵循率是每个样本上通过的跟随指令细则占比再跨样本平均,衡量改动要求平均满足多少。
一致性保持率用同样方式按一致性细则计算,衡量应保留内容保住多少。完全成功率是所有跟随与一致细则全部通过的样本占比,1 次失败即不计入,这里的完全匹配指全部标准通过,不是两段波形逐采样相同。
要判断总体与分组比较是否公平,先看样本构成的比较问题是 4 类操作与两个时长组各占多少,是否都来自同一评估集。
| 样本范围 | 数量 |
|---|---|
| 添加 | 115 |
| 删除 | 149 |
| 替换 | 79 |
| 音量调整 | 77 |
| 至多 10 s | 176 |
| 长于 10 s | 244 |
| 评估合计 | 420 |
这组构成说明评估覆盖了添加、删除、替换与音量调整,且包含短录音与长录音,开发调试用的是评估集之外的样本,避免用测试样本调流程。样本量差异意味着任务宏平均与 pooled 平均会给出不同权重,读总体分数时要同时看两种平均,不能只看其中一种。
总体看,改动满足与保留保住各提高了多少
总体比较问题是,在同一样本集与同一评分下,Harmony 相对可运行基线是否同时改善平均满足与完整成功。总体分数包括任务宏平均与 pooled 平均,任务宏平均给 4 个操作等权,pooled 平均给每个样本等权。时长分组按原始输入帧数确定并复用同一评估分数。
指令遵循率 IFR × 一致性保持率 CR × 完全成功率 EMR: 指令遵循率 IFR 衡量请求的改动有多少被满足,是每个样本上通过的跟随指令细则占比再跨样本平均;一致性保持率 CR 用同样方式衡量不应改动的内容是否被保住;完全成功率 EMR 衡量一个样本所有跟随与保持细则是否同时通过。三者搭配是因为只看平均满足会掩盖顾此失彼,组合后才能区分部分完成与完整编辑成功。
总体比较的公平条件是同一样本集与同一评分,指标方向都是越高越好,读表时先看 pooled 总体,再看时长组是否一致,避免只看平均满足而忽略完整成功。
| 方法 | 评估范围 | 完全成功率 EMR | 全细则通过样本数 |
|---|---|---|---|
| Harmony | pooled 平均,420 例 | 22.62% | 95 |
| 原始 WavCraft(最强基线) | pooled 平均,420 例 | 13.57% | 57 |
从表中可以看到,Harmony 的 pooled 完全成功率为 22.62%,最强基线为 13.57%,对应 420 个样本中有 95 个通过全部编辑与保留标准,而原始 WavCraft 是 57 个。论文同时报告 Harmony 的 pooled 指令遵循率为 62.18%,一致性保持率为 87.71%,在所比方法中三项都是最高。这支持优势同时存在于短录音与长录音,但也要注意绝对值仍然不高,完全成功不到 1/4,说明高平均分不等于多数样本 1 次做对。论文也强调只看高跟随或高保持不能断定完整成功,必须结合完全成功率看改动与保留是否同时过关。
四个操作各自的难点下,优势是否还成立
分操作的比较问题是,不同操作对组件模型与协调的要求不同,总体优势是否在添加、删除、替换与音量调整里都表现为完整成功领先。添加考验新素材生成与事件数量位置的落实,删除考验目标拿掉后背景与语音的保留,替换同时考验拿掉旧声与拿到合适新素材,音量调整考验增益做准且不破坏时间频率结构。
论文报告 Harmony 在 4 个操作都取得最高完全成功率,表明其完整编辑成功的优势延伸到这些不同要求之下。跟随率与保持率的单项最好则分散在不同方法之间,说明平均满足与完整成功并不等价。音量调整的跟随普遍偏低,完全成功在 4 个操作里最低,说明该操作下把增益做准且同时保住其余细则依然困难。
论文用两个听例补充分辨。结尾笑声替换的例子里,有基线把整个输出变成掌声,动了不应改的前段,而 Harmony 只替换结尾笑声并保持前段完整。四拍鼓点添加的例子要求在 2.0、2.5、3.0 与 3.5 秒加 4 个瞬态且四处窗口外样本不变,Harmony 按位置放齐,有匹配主干的基线没能给出请求数量,听感上有的基线鼓声质量也较低。这说明数量、位置与音色合适程度要同时满足,排布对了而素材不对,或素材对了而数量不对,都过不了全部细则。更多例子在论文给出的项目网站上有演示,这里只按正文转述。
外部证据与条件修正各自贡献了什么,合在一起呢
消融用两路开关设计独立控制外部证据获取与条件修正。前者指规划时可用外部活动、边界、源活动与转录工具,启用不等于每个输入都必须调用。后者指执行时按中间音频观察做有界修正。听觉观察与大语言模型规划在关闭外部证据时仍保留,所有配置保留底层分离、生成与混音工作流,并在每个操作完整样本集上评估。
外部证据获取 × 条件修正: 外部证据获取指在规划时启用波形能量、分离辅助与语音转录等测量工具;条件修正指在执行时根据首次中间音频的观察选择有界修正动作。前者负责把时间与目标选准,后者负责把已分离或已生成但不合适的材料修到可用,二者搭配的意义在于选准与修好是前后依赖的,消融正是为了检验缺了哪一环会导致平均满足与完整成功出现怎样的分化。
分任务看,关闭修正时启用外部证据在 4 个操作都提高跟随率,支持用外部分析工具配合听觉观察来改善事件选择与时间规划。但提高不总能变成完整成功,添加出现跟随更高而完全成功未更高的情况,说明满足更多单项标准后仍需过齐其余编辑与保留要求。
有外部证据时启用修正,在每个操作都提高完全成功率,而 pooled 跟随几乎不变,贡献更体现在同时过齐全部要求而非平均满足。没有外部工具时单独加修正反而降低 pooled 完全成功,尤其在添加与替换,说明只加修正动作而不给支撑决策的信息是不够的。联合配置取得最高聚合跟随与完全成功,在添加、替换与音量调整的完全成功上最强。代价是联合配置的保持略低于双关配置,但更高完全成功意味着更多样本同时满足编辑与保留。删除是例外,单独修正最好,说明两机制联合的收益随操作而异。
读消融要避免把相对提升当成部署保证。这些数字是在同一评估集与同一裁判下的对照,关掉证据后修正变差恰好说明修正的有效性依赖支撑编辑决策的信息,而不是修正本身有害。复现时应保留实际可运行策略的全部基线与预算条件,不能只摘最优组合。
一次完整编辑要花多少时间与调用,听感与范围还有哪些不足
成本的比较问题是,不同操作在首次完整执行里平均耗时与大模型调用各是多少,耗时口径是否含评估与排队。论文统计的是全部输入的首次完整执行,含不成功尝试,计时含输入处理、编辑与输出写回,不含评估、排队、服务启动与计时例程之外的初始化,大模型计数覆盖已记录的路由、规划与复核请求,后续离线修复不计入,硬件与服务负载未为速度比较做标准化。
| Operation | nn | Time (s) | LLM calls |
|---|---|---|---|
| Addition | 115 | 52.35 | 3.71 |
| Removal | 149 | 115.36 | 3.69 |
| Replacement | 79 | 173.08 | 7.04 |
| Volume adjustment | 77 | 95.36 | 3.29 |
| Overall | 420 | 105.30 | 4.25 |
从表中可以看到,添加平均 52.35 s 与 3.71 次调用,删除 115.36 s 与 3.69 次,替换 173.08 s 与 7.04 次,音量调整 95.36 s 与 3.29 次,总体按 420 个输入等权为 105.30 s 与 4.25 次。替换最贵,因为既要分离又要生成与修正。耗时与调用是主要代价,论文在局限里也承认复杂编辑常需多次大模型调用,推高运行时间与成本,即使规划成功,编辑音频与原始录音的融合也可能不自然而出现突兀过渡。
听感主观比较上,16 名参与者在 16 个精选例子上对 Harmony、原始 WavCraft 与 AEC Agent 的匿名输出做比较,共 128 个整体编辑判断与 120 个适用保留判断。问题一问哪个结果整体最满足编辑请求并兼顾正确性与听感,问题二问哪个最好地保留了指令未要求改动的声音与时间区域。Harmony 在两项都得票最多。这支持在精选子集上听感偏好与客观指标方向一致,但精选不等于随机全集,不能推广到所有样本。任务范围上,当前只支持单步请求,还不能处理需多步编辑的指令,声音种类、时间约束与操作组合一多,泛化仍需加强,目前只处理音频,未来考虑音视频联合与用强化学习学工具选择与修正决策。
什么时候值得试,第一步做什么,还缺哪项验证
什么时候值得尝试,要看任务是否正好落在这篇论文验证过的范围里。如果指令是添加、删除、替换或音量调整之一,需要选第几次出现、处理相对时间或保住重叠语音,且能接受数十秒到数分钟的单次耗时与多次模型调用,Harmony 的规划加修正思路值得一试。如果是多步编辑、需要自然无缝融合或对延迟敏感的在线场景,论文已明确当前系统不支持或表现有限,就不适合直接照搬结论。
复现第一步是先搭出评估闭环再跑方法。按论文口径准备 MMAE 中 4 类操作的样本划分与时长分组,用基于细则的评估器加外部裁判,每条细则 3 次打乱顺序、至少 2 次一致才算通过,再算跟随率、保持率与完全成功率。方法侧按低推理规划、音频观察、分离、转录、生成、音符或基频轮廓加音色库渲染的链路组织,控制器预算按至多 2 次音频观察加 2 次工具调用、每种工具至多 1 次、至多 1 次分离来限流,恢复与修正按动作限次,添加时间未解决时只用显式标记估计并保留时间线与基础增益。
还需要补的验证集中在三处。一是统计稳健性,论文未报告误判率置信区间与多次运行方差,完全成功率不到 1/4 时更需看分布而非单点。二是成本与延迟的标准化测量,原文明确硬件与负载未标准化,不能把平均秒数当作可比速度承诺,训练资源、推理开销与实际延迟要分开测。三是资源表述要分开说,代码开源、权重可下载、系统可运行是三件事。现有证据只给出项目网站与音色库页面这类第三方可达链接,不证明作者已开源,来源未确认不是技术缺陷,复现时应以论文列出的模型与参数为准,不要把链接可达当成一键可运行。
这篇论文到底证明了什么,在什么条件下才成立
综合起来,Harmony 证明的是工作流层面的连接价值。把语义决策与波形操作分开看,生成再好也可能留旧声,保留再好也可能没改对。协同规划用问答加测量把目标、窗口与保留要求写进可执行计划,证据引导的执行用首次中间音频的观察触发有界修正,两步合在一起才在评估样本上同时改善平均满足与完整成功。最强证据是 pooled 完全成功率从最强基线的 13.57% 到 22.62%,对应 95 对 57 个全过样本,且在 4 个操作与两个时长组都保持完全成功领先。
这些结论成立的条件要一起记住。样本是 MMAE 中 4 类操作的 420 个,含语音,长录音完整给入,开发用集外样本,裁判是外部模型 3 次打乱取多数,指标方向越高越好,完全成功指全细则通过而非波形相同。消融显示外部证据主要提跟随,有证据下的修正主要提完全成功,无证据单加修正反而降完全成功,联合最优但保持略降,删除例外。成本上替换最贵,听感偏好只在精选例子上成立。
还有三点不能夸大。第一,绝对完全成功仍低,音量调整更低,说明方法改善了协调但没解决全部声学难点。第二,没有测量延迟标准化与统计显著性,不能承诺更快或更稳。第三,未验证多步编辑、音视频联合与自适应工具选择,未来工作只是方向。读完能复述的关键步骤是:听与问定目标、测量定窗口、计划写清保留、分离生成给材料、看首版再小步修正、窗口内混音窗外拷贝,缺了证据或修正中的任何一环,完整成功都会打折。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses