📄 如何把 AI 音乐创造力拆成可计算的多维指标
评分:6.2/10 | 创新 1.3/2 | 技术严谨 0.9/1.5 | 实验充分 0.4/1.5 | 清晰度 0.9/1 | 影响力 0.9/1.5 | 开源 1.2/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
👥 作者与机构
- Hindy Rossignol:Department of Arts and Sciences, University College London, Malet Place, London, WC1E 7JG, United Kingdom
- Giorgio Franceschelli:Department of Computer Science and Engineering, University of Bologna, Viale del Risorgimento, 2, Bologna, 40136, Italy
- Mirco Musolesi:Department of Computer Science and Engineering, University of Bologna, Viale del Risorgimento, 2, Bologna, 40136, Italy;Centre for Artificial Intelligence, Department of Computer Science, University College London, 66-72 Gower Street, London, WC1E 6EA, United Kingdom
📌 核心摘要
论文要解决如何对生成式人工智能音乐进行可解释、可比较的创造力评估。输入是待评音乐作品的符号或音频表示,输出不是单一“创造力分数”,而是覆盖价值、惊讶度和新颖性的 M-value、M-surprise 与 M-novelty 指标。难点在于音乐创造力依赖听者先验、文化与任务,已有客观指标又常与人的感知弱相关。方法先提取作品的符号或音频特征与嵌入,输出效价—唤醒度、信息量、熵、谱通量、节奏间隔和嵌入距离等中间量;再据此估计 M-value、M-surprise 与 M-novelty;最后保留互补维度,并把惊讶分为概率、隐藏内容和范式转移三类,不规定各维度权重。这与把创造力压成单一目标的思路不同:能保留不同审美和结构来源,但不能直接给出总排序。原文给出表 1 的定性组合解释和表 3 的指标汇总,但贡献被明确限定为概念性,未报告与人类判断对照的实证验证,也未给出本文方法的 MOS 或 CLAP 基线数值比较。原文转述的一项可核对数值来自 Yang et al. (2008):在支持向量回归估计效价—唤醒度的设置中,唤醒度的 R² 为 0.58,高于效价的 0.28,但这不是本文方法的 MOS 或 CLAP 成绩。适用性取决于先验音乐经验、参考语料和嵌入模型等设定;就本文方法而言,原文未提供可核对的关键定量结果,论文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
音乐生成评测缺的不是另一个音质指标
生成式音乐系统的输入可能是符号序列,如 MIDI、乐谱事件,也可能是音频波形或梅尔频谱;输出同样可能是符号序列或音频。论文关心的是生成物作为音乐作品时,在价值、新颖性和惊奇上的多维表现,而不是只判断它是否像训练数据或音频是否干净。这个任务必须保留旋律、和声、音色、节奏等维度,因为同一首作品完全可能旋律很新、节奏很常规,或者音色变化很大但和声很可预测。
论文指出,AI 音乐生成的研究进展常被评测标准不足拖住:文本、图像和视频领域已有较多基准,而音乐作品没有统一的“创造力” 测量接口。困难有两层。第一,音乐创造力本身没有公认定义,听众又会受文化背景、训练经历和熟悉风格影响;第二,即使接受某种定义,也需要把定义落到可复算的统计量上。论文选择 Margaret Boden 的价值、新颖性、惊奇三分法,并把它们改写成音乐领域的 M-value、M-novelty 和 M-surprise。
在表示层面,论文提到 CLAP、MERT 等音频表示模型可以把音乐作品编码成向量,再用于距离或分布比较。图 1 先给出一个表示示例:左侧是 3 条商业化发行作品的音频波形,右侧是 CLAP 嵌入经过降维后的 3 维坐标。看图时先确认 3 个对象和 3 条箭头,再把它们理解为“作品可以被嵌入到同一空间” 的示意,而不是分数比较。
看图路径: 1. 先看左侧三条音频波形分别标注为 Sandless Summer、2050 和 Saigon;2. 再看右侧三维坐标轴 PC 1、PC 2、PC 3 及三个作品的嵌入箭头;3. 注意图中展示的是降维后的表示示例,不是评测分数或模型排名

论文图 1。原论文 Figure 1::“3D embedding vector representation of three commercially released music pieces (Hindy, 2024a; Hindy, 2024b; Hindy, 2025) from CLAP (Elizalde et al., 2023), after dimensionality…”。
图中右侧 3 个箭头分别标注 Sandless Summer、2050 和 Saigon,坐标轴为 PC 1、PC 2、PC 3,刻度范围大致在 -0.4 到 0.4 之间;3 个箭头方向不同,但图本身没有给出模型名称、听众评分或指标数值。它能帮助读者理解后文为何可以用嵌入距离讨论 M-novelty,也能说明为什么参照语料和编码器必须固定,但仅凭这张图不能判断哪首作品更有创造力。
既有评测路线各自解决了什么
论文把相关路线分成几类。主观评测包括 Turing 式判断和偏好测试:前者让听众辨别作品来自人还是机器,后者让听众按 musicality、coherence、naturalness 等标准打分,常见形式是 Mean Opinion Score(MOS)和 Head-to-Head(HTH)比较。MOS 让参与者对单个音频按 1 到 5 分评价,HTH 则并排给出两个片段让听众选择更好的一方。这些方法直接对听众负责,但评分标准容易重叠,Turing 测试还可能把“像人” 误当成“质量高”。论文提到 Grötschla 等人在 2025 年做了大规模 HTH 研究,涉及 12 个模型、6000 段 AI 生成音乐和超过 15000 次人类成对评价。
客观评测则包括音频质量指标和音乐信息检索描述子。前者如信噪比、PEAQ、ViSQOL,后者从音高、节奏、音色和结构中提取可解释特征,或比较生成数据与训练数据的分布。论文提到 Fréchet Audio Distance 与听众偏好的相关性只在某些嵌入骨干上成立,且不同系统的指标排名可能与人类排名显著分歧。这说明问题不只是“有没有指标”,而是指标测的量是否与要判断的创造力对齐。
第三类是 rubric 评测:专家写出细粒度标准,再由大语言模型按标准判分,聚合成奖励或总分。这种做法在语言模型后训练中常见,但论文指出它在音乐上有 3 个麻烦:音频标准该由音频模型逐条判断还是由信号公式计算并不统一;专家 rubric 成本高且随模型目标变化要重标;优化一个清单式总分不保证真的提高音乐创造力。
在创造力理论方面,论文提到 SPECS、FACE、IDEA 等框架,以及 DeepCreativity 对十九世纪美国诗歌的价值、新颖性、惊奇计算。也有工作把惊奇、新颖性或质量信号用于引导生成,如 surprise search、composer–audience 架构、Chef Watson 和 Creative Preference Optimization。论文认为这些工作没有把价值、新颖性、惊奇同时适配到音乐作品的结构上。另一个重要对照是 Salamanca 等人的听众研究:43 名不同音乐训练背景的听众评价共同创作助手产生的未完成作品,结果价值和新颖性足以预测创造性,而新颖性与惊奇在评分上几乎不可区分。
论文没有否定这个结果,而是主张在完成作品的计算测量中,二者可能分开:作品可以远离参照语料但内部很可预测,也可以留在熟悉风格中却不断违反局部期待。这个分歧在本文中仍是开放问题。
为了把几条外部证据放在同一张表里,比较问题不是哪项工作更接近本文方法,而是每个数字来自什么对象和尺度,能支持哪 1 级结论。
| 证据或例子 | 原文报告的对象与规模 | 能支持什么 | 不能替代什么 |
|---|---|---|---|
| Grötschla et al. (2025) 的 head-to-head 基准 | over 15,000 human pairwise evaluations of 6,000 AI-generated music clips across 12 models | 说明大规模人类偏好比较可以覆盖多模型和多片段 | 它测的是听众偏好排序,不是本文 M-Creativity 三项指标与人类创造判断的相关性 |
| Salamanca et al. (2023) 的听众研究 | 43 listeners of varying musical training judging unfinished pieces | 价值和新颖性足以预测创造性,且新颖性与惊奇在该设置下难以区分 | 该结果来自未完成作品和单一整体评分,不能直接证明完成作品上 M-surprise 与 M-novelty 不可分 |
| PS-surprise 的 2 维/3 维玩具例子 | a model trained only on 2D inputs … 3D musical artifacts … added guitar stream | 说明“既有模型无法有意义表征” 为何是范式转移惊奇的条件之一 | 这是概念示例,不是对听众或模型的实际测量 |
这张表显示,大规模人类偏好数据、未完成作品的听众研究和一个 2 维/3 维玩具例子处在不同证据层级;它们能提示哪些维度值得分开测量,却不能替代本文框架缺少的整体实证验证。
论文要定义什么、量化什么
论文的研究问题可以概括为四层:能否严格定义 AI 音乐创造力;Boden 的价值、新颖性、惊奇框架在多大程度上适用于 AI 生成音乐;可以用哪些指标测量这些组成部分;这些方面能被多客观地量化。作者先定义音乐、创造力和音乐创造力,再给出生成式人工智能音乐创造力(M-Creativity)的定义,随后按 M-value、M-surprise、M-novelty 展开指标。这个顺序不是随意的:先定义对象,再定义测量,最后讨论组合和限制。
M-Creativity 被定义为 3 个成分的互动:M-value 是听众感知到的音乐价值;M-surprise 是作品对听众音乐期待的违反或挑战;M-novelty 是作品相对训练语料或既有规范的偏离程度。论文强调,这 3 个成分高于常态时通常被认为对创造力有正贡献,但并没有给出一个经过标定的总分公式。相反,它提出一组互补指标,承认音乐属性的复杂性和相互依赖,认为把创造力压缩成单一标量会丢掉重要信息。
这篇论文的贡献是概念性的:它提出并论证度量,采用跨学科定义,但没有把度量拿去与人类判断做实证验证。论文在开头和结尾都明确说,实证验证留给未来工作。因此阅读后文时,不能把 M-value、M-surprise、M-novelty 当成已经通过人类实验校准的评分器,也不能把某个子指标当成创造力的充分条件。它们更像是一套待验证的测量语言:说明一个作品在哪个维度上偏离参照、偏离是否可能被感知,以及这种偏离是否可能具有音乐价值。
M-Creativity 的三层分解与参照问题
整体框架先借用 Boden 对创造力的拆分,再把 3 个词改写成音乐领域可讨论的对象。价值不是对象的固有属性,而是相对于某个听众和语境的价值,因此 M-value 被定义为听众感知到的音乐价值;新颖性被拆成相对模型训练集的心理新颖性和相对更大音乐语料的历史新颖性;惊奇被拆成概率惊奇、隐藏内容惊奇和范式转移惊奇。Boden 还区分组合式、探索式和转化式创造力,论文的 M-surprise 分层与这一区分相呼应,但没有把三者都当成可直接计算的量。
框架是模块化的:每个顶层成分可继续拆成子成分,每个子成分对应一组候选指标。论文不建议用一个加权和立即合并三项,因为惊奇常与新颖性共同出现,价值又可能随惊奇呈非线性变化,Wundt 曲线就是文中提到的例子:愉悦价值可能在可预测性与新颖性之间达到峰值。这个说法本身仍是理论动机,不是实验结论;它解释了为什么论文要给出“指标集合”,而不是一个名为 M-Creativity 的单一分数。
Prior Musical Experience (PME) × M-value × M-surprise: Prior Musical Experience (PME) 指一个听众群体在既有聆听与实践历史中形成的期待,它在框架里充当参照分布;M-value 衡量作品被听众认为有多大的音乐价值,M-surprise 衡量作品在多大程度上违反这些期待。PME 让 M-surprise 的条件概率、频谱流和节奏偏差有可比较的参照,也让 M-value 的文化与审美判断有群体条件,但 PME 本身不是价值判断,不能替代 M-value 的主观性;三者组合后,评测才能同时说明“偏离了什么” 和“偏离是否有价值”。
为了让“违反期待” 有参照,论文引入 Prior Musical Experience(PME),即听众先前音乐经验形成的期待框架。PME 被当作一个群体层面的近似:同一社会文化群体中的成员被假设拥有相似的“脑内模型”。论文承认目前只用 Prior Music Listening(PML)作为代理,尚未显式建模 Prior Music Practice(PMP)和其他个体差异。PME 不是某个听众的真实心理测量,而是后续条件概率、频谱 z 分数和节奏偏差比较的共同参照。
3 个成分的高低组合在论文中只用常态 μV、μN、μS 作相对解释:三项都高于常态被视为理想创造力,一项远高于常态可能补偿其他平均项,一项低于常态可能削弱整体,三项都低则是创造力失败。这里的常态是相对量,离开具体语料、听众群体和指标尺度就无法解释;补偿关系和非线性关系也没有经过人类评分验证。因此它更适合作为设计评测报告时的解释框架,不能当作已校准的分类规则。
M-value:审美、情绪与听众条件
M-value 是三项中最主观、也被论文认为可能最重要的一项。Boden 的价值概念本身没有单一含义,论文把它落到“听众感知到的音乐价值”。为了说明价值从哪些方面来,论文引用 Himonides 的审美感知框架,把音乐结构、神经心理生物加工、人的音乐发展、社会文化语境、听众特征、声学信号产生和声学效果列为 7 类相关成分。表 2 比较的是这些审美来源,不是给每一类赋权;它提醒读者,同一种音乐特征在不同听众和语境中可能被赋予不同价值。
| Component | Description |
|---|---|
| Musical Structure (Ockelford, 2009; Scherer and Zentner, 2001) | Formal elements such as motifs, harmony, phrasing, and chord progressions shape emotional arcs and guide listener expectations. The I–V–vi–IV progression is a widely used and emotionally impactful example. |
| Neuropsychobiological Processing (Peretz et al., 2004) | Music perception is rooted in how the brain processes sound. Neural circuits involved in pitch and rhythm overlap with those used in language. Responses vary based on experience, emotion, and training (Sarasso et al., 2019). |
| Human Musical Development (Welch, 2005; Malloch, 1999) | Musical understanding arises from biological predisposition and cultural exposure. Even without training, listeners acquire intuitive knowledge of musical norms. |
| Sociocultural Context (Himonides and Welch, 2005; Durrant, 2017) | Cultural backgrounds shape what is valued in music. Different genres emphasize different features (e.g., timbre in jazz, rhythm in rap), forming genre-specific aesthetic expectations. |
| Listener Characteristics (Sloboda and O’Neill, 2001) | Personal factors such as emotion, personality, and memory shape perception. The same piece may be valued differently depending on the listener’s context. |
| Production of Acoustic Signals (Sundberg, 1987; Juslin, 2001; Gabrielsson, 2003) | Vocal performance is shaped by control of breath, vocal fold tension, and resonance, which affect tone and expressiveness. |
| Effects of Acoustics (Howard and Angus, 2017) | Performance spaces and recording setups (e.g., reverb, mic placement) influence how music is perceived in terms of clarity and impact. |
表 2 显示,音乐结构、文化语境、听众特征和声学效果都可能影响审美判断,论文没有给出把这些成分合成单一 M-value 的公式。这个空缺不是遗漏,而是论文的立场:不同听众会给不同成分不同权重,权重还会随时间和文化变化。因而表 2 更适合用来检查一个 M-value 代理漏掉了哪些方面,而不是当作可直接计算的评分表。
M-value × valence × arousal: M-value 是音乐作品对听众的价值这一上位概念,valence 表示情绪的正负方向,arousal 表示情绪的唤醒高低;论文用 valence 和 arousal 构造二维情绪空间,把作品偏离中性点的距离作为情绪强度的一种可计算代理。valence 和 arousal 只覆盖情绪维度,不能代表 M-value 的全部审美、文化和社会价值,因此它们与 M-value 的关系是可操作化的一部分,不是等价替换;组合后的意义在于把模糊的价值判断至少落到可复算的情绪轨迹上,同时明确这一落点仍受情绪估计误差限制。
论文提出的一个可操作路径是把情绪当作 M-value 的代理。它采用 Russell 的 valence–arousal 模型:valence 表示正负方向,arousal 表示唤醒高低。图 3 用 2 维平面标出高唤醒、低唤醒、高 valence、低 valence 以及 Tense、Excited、Depressed、Relaxed 4 个象限。看图时先确认坐标轴方向,再把象限名称当作情绪区域的标签,不要把象限位置误读成某个作品的实测坐标。
看图路径: 1. 先确认横轴从 Low Valence 到 High Valence;2. 再确认纵轴从 Low Arousal 到 High Arousal;3. 观察 Tense、Excited、Depressed、Relaxed 四个象限的位置
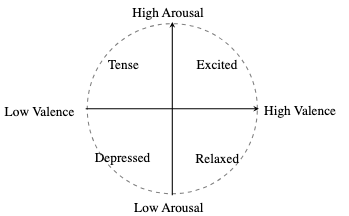
论文图 3。原论文 Figure 3::“Valence–Arousal Model of Emotion, adapted from Russell (1980).”。
图 3 可见的是一个空心圆与两条正交轴,轴上标出 High Arousal、Low Arousal、High Valence、Low Valence,圆内 4 个象限分别放置 Tense、Excited、Depressed、Relaxed。它帮助后文定义情绪中性点 (0,0) 和偏离距离,但图本身没有给出音乐片段、听众评分或估计模型的结果,因此不能据此判断某类音乐更容易被视为高价值。
具体计算时,论文把音轨切成 T 个短时间窗,在每个窗估计 valence v_t 与 arousal a_t,再计算该窗到中性点的欧氏距离,最后对整个音轨取平均。下面这个公式就是平均情绪距离,用来表示作品整体的情绪强度;它不是 M-value 本身,而是 M-value 的情绪代理之一。
\[\mu_{ES}=\frac{1}{T}\sum_{t=1}^{T}\sqrt{v_{t}^{2}+a_{t}^{2}}\]公式中的 T 是时间窗数量,t 从 1 到 T,v_t 和 a_t 是第 t 个窗的 valence 与 arousal 估计值,平方和开根号表示离中性点 (0,0) 的距离。论文还用该距离的标准差表示情绪变化幅度,用相邻窗 valence 与 arousal 的绝对变化之和表示情绪波动,用变化方向的反转次数表示情绪拐点数量。这些量把“情绪有多强”“情绪有多稳定”“情绪弧线有多复杂” 分开,避免只看一个平均强度。限制也很直接:它们依赖 valence 和 arousal 估计器的准确性。论文引用 Yang 等人的结果, arousal 的 R² 为 0.58、valence 的 R² 为 0.28,并指出训练数据来自主观标注,这会反过来削弱“客观评估价值” 的目标。
论文还讨论了两条非情绪路径:一条是用信息论、复杂度、Zipf 律等计算美学量;另一条是歌词的社会验证,用自然语言处理追踪主题、情绪和文化叙事。歌词路径只有在歌词存在且听众关注歌词时才有效,餐厅背景音乐和专注聆听的独立摇滚场景可能给出完全不同的价值判断。论文承认,M-value 很难被完全客观化,个体化推荐系统如 MusicRL、Spotify 和 Deezer 的偏好建模说明:真正的价值判断往往依赖个体反馈,而不是一个群体平均分数。
M-surprise:从概率意外到范式转移
M-surprise 不是“听起来奇怪” 的同义词。论文按 Boden 的 3 种含义拆开:第一种是事件在概率上不熟悉或不 Likely,称为 P-surprise;第二种是事后发现意外材料其实与既有认知框架相合,称为 HC-surprise;第 3 种是作品迫使听者改写音乐规则本身,称为 PS-surprise。三者不是同一量纲上的 3 个等级,而是从事件预测、认知重构到概念空间变化的不同层次。
P-surprise × HC-surprise × PS-surprise: P-surprise 是概率意义上的意外,即某个音乐事件在既有期待下不够可能出现;HC-surprise 是事后才理解到“原来它 fits” 的认知重构;PS-surprise 则是规则或概念空间本身被改写。三者的分工是从事件层、认知层到范式层逐级加深:P-surprise 可直接用条件概率、熵或频谱偏差计算,HC-surprise 需要模拟听众知识如何重组,PS-surprise 需要判断作品是否越出既有音乐规则。把它们并列而不是混成一个数,才能避免把“听起来古怪” 误当成“具有范式转移”,也说明后两层在论文中仍主要是概念性定义。
图 2 的来源图注标为 (a) M-Creativity,但图中顶层节点实际是 M-surprise,而不是 M-Creativity 整体;读图时以像素为准。图中 M-surprise 向下分成 Probabilistic Surprise、Hidden-Content Surprise 和 Paradigm-Shifting Surprise 3 条分支,每条分支下面又列出 Melodic、Harmonic、Timbral、Rhythmic 4 个音乐维度。看图时先确认这是 M-surprise 这一支的结构,不要把图中的 4 个维度当成所有 M-Creativity 成分的唯一维度;图的作用是说明惊奇可以按“层次 × 音乐维度” 展开。
看图路径: 1. 先确认来源图注标为 (a) M-Creativity,但图中最上方的框实际是 M-surprise;2. 再沿箭头看 Probabilistic、Hidden-Content 与 Paradigm-Shifting 三条分支;3. 最后看每条分支下的 Melodic、Harmonic、Timbral、Rhythmic 四个子维度
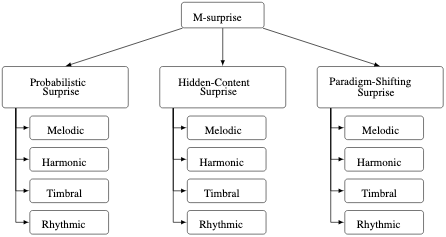
论文图 2。原论文 (a):“(a) M-Creativity (top-level components)”。
图中可见的是 3 层分支和 4 个子维度,而不是一个已经算出的分数。来源图注标为 (a) M-Creativity,但像素显示顶层是 M-surprise,两者不一致,这里按像素说明。它支持论文的组织方式:同一层次的惊奇可以分别落在旋律、和声、音色和节奏上,因此一个作品可能和声很意外而节奏很常规。图没有显示各分支的权重、阈值或实证结果,后文对 HC-surprise 和 PS-surprise 的讨论也主要停留在概念和可计算性分析,不能把这张树状图当成测量已经完成的证据。
P-surprise 的第一种计算对象是旋律与和声事件。给定前文,某个音或和弦出现的信息量越高,说明它越出乎意料。论文用 Shannon 信息量定义事件级惊奇:概率越低,IC 越高。
\[IC\left(x_{t}\right)=-\log{P}\left(x_{t}\mid x_{\lt t}\right)\]公式中 x_t 是第 t 个旋律音或和弦事件,x_<t 是它之前的上下文,P(x_t | x_<t) 是在该上下文下事件的条件概率。IC 越大,表示该事件在参照模型看来越不可预测;它衡量的是已经发生事件的“实现惊奇”,不是整个作品的新颖性。
条件概率可以用 N-gram 频率估计:统计前 n 个事件与当前事件的联合出现次数,再除以前 n 个事件的出现次数。
\[P\left(x_{t}\mid x_{t-n},\ldots,x_{t-1}\right)=\frac{\mathrm{Count}\left(x_{t-n},\ldots,x_{t}\right)}{\mathrm{Count}\left(x_{t-n},\ldots,x_{t-1}\right)}\]公式中的 Count 是语料中的出现次数,x_{t-n},…,x_{t-1} 是长度为 n 的上下文。N-gram 的优点是高效、可解释,缺点是上下文短、数据稀疏;论文也提到 Transformer、LSTM 等序列模型能捕捉更长依赖,但可解释性会下降。这里的关键不是哪个模型绝对更好,而是概率参照必须与听众的 PME 或明确的参照语料一致,否则 IC 的高低无法解释。
除了单个事件的信息量,论文还计算事件分布的熵。熵衡量一个分布本身有多分散:分布越均匀,熵越高,潜在变化空间越大。
\[H\left(X\right)=-\sum_{x}{P\left(x\right)\log{P}\left(x\right)},\]公式中 X 是音乐事件变量,P(x) 是事件 x 的概率。论文区分两种用法:artifact-derived entropy 用单个作品内部的事件频率作为 P(x),反映这首作品自身的内部多样性;model-derived entropy 用生成模型在每个时间步的预测分布并沿序列平均,反映模型可能生成多少不同事件。前者回答“这首作品内部有多不可预测”,后者回答“这个模型有多少潜在变化”;两者都不能替代单个事件的 IC。
论文随后用 mean IC 表示一个片段内事件级惊奇的平均密度。一个重要区分是:新颖的作品未必内部充满 P-surprise。作品可以整体远离训练语料,却在自身结构中高度可预测;反过来,作品可以在熟悉风格内不断违反局部期待。论文正是用这一点回应“新颖性与惊奇是否可分” 的疑问,但也承认二者在听众实验中是否可分仍是开放问题。
音色与节奏的惊奇如何落到信号
音色惊奇面对的是声音的颜色和质地,而不是音符名称。论文用 Mel 频谱作为更接近人耳频率分辨率的表示,并用 Spectral Flux 衡量相邻时间帧之间频谱幅度的变化:对每个频率 bin 取相邻帧梅尔谱幅度之差,平方后求和。频谱流高,表示音色变化尖锐,例如新乐器进入或强烈 attack;频谱流低,表示过渡平滑。论文举了 Bohemian Rhapsody 在一首歌内从无伴奏人声、钢琴叙事、歌剧合唱到硬摇滚切换的例子,用来说明音色惊奇可以是局部的,也可以是全局的。
要把频谱流解释成“惊奇”,还需要 PME 参照。论文先从 PME 语料计算频谱流的均值 μPME 和标准差 σPME,再对目标作品逐帧计算局部 z 分数,或用作品平均频谱流计算全局 z 分数。局部 z 分数回答某 1 帧是否突然偏离参照,全局 z 分数回答整首作品或整个模型输出是否在音色变化上偏离参照。论文也建议按流派划分 PME 后再比较,因为爵士、古典和摇滚的音色规范并不相同。音色熵则从频谱流分布计算:单曲内部熵高表示音色变化杂乱或多样,模型输出熵高表示模型能产生更多不同音色质地。
节奏惊奇的基础是 inter-onset interval(IOI),即相邻节奏事件起点之间的时间差。论文先把音频或符号序列转成 IOI 序列,再估计每个 IOI 在给定上下文下的概率。音频格式没有分轨时,需要先用 Demucs、Spleeter 等源分离方法拆出人声、鼓、贝斯等流,再分别提取 IOI;符号数据如果按通道保存乐器,可以直接分轨。论文明确说,不做分解而直接用 DFT、ACF 分析节律周期性也可行,但会牺牲可解释性和精度,因此框架更偏向分解式方法。
节奏侧还有两个补充量。第一是 IOI 的信息量:在概率密度上给一个微小时长容差 ε,把某个 IOI 邻域内的概率积分出来,再取负对数;这能处理演奏中略微提前或滞后的微时序。第二是 tempo deviation surprise:用节拍跟踪得到瞬时速度 T(t),对时间求导得到速度变化,再用 PME 的均值与标准差做 z 分数,检测突然的加速、减速或 rubato。跨流节奏不协和则比较不同流的 IOI 分布,用 Jensen–Shannon Divergence 衡量人声与鼓、或不同乐器层之间的节奏对齐程度;高散度可能表示有意的节奏张力,也可能只是低价值的不协调。
Information Content × Entropy × Spectral Flux: Information Content 衡量已经发生的单个事件在给定前文下有多意外,Entropy 衡量一个事件分布本身有多分散,Spectral Flux 衡量相邻时间帧之间音色或频谱变化有多强。IC 适合记录“这一次真的被意外到了”,Entropy 适合记录“潜在有多少变化空间”,Spectral Flux 则把同样的惊奇问题带到音色维度。三者搭配后,旋律与和声可用 IC 和熵,音色可用频谱流与熵,节奏可用 IOI 的 IC 和熵;它们共享“相对于期待” 的思想,但不能互相替代,尤其不能把熵直接当作某个具体事件的意外程度。
这些指标的分工可以用一个作品样本说明:对旋律与和声,IC 记录某个音或和弦在当下有多意外,熵记录整段事件分布的多样性;对音色,频谱流记录帧间变化有多强,频谱流熵记录变化是否多样;对节奏,IOI 的 IC 记录某个时间间隔有多反常,IOI 熵记录节奏型本身的变化空间。三者都相对 PME 或参照语料解释,因此同一组数值换一个参照群体就可能改变含义。源分离误差、节拍跟踪误差、ε 的取值和流派划分都会影响结果,论文没有报告这些设置的系统性消融。
HC-surprise 与 PS-surprise:概念上重要,测量上受限
HC-surprise 指一种事后重构:听者最初觉得某段音乐很意外,随后又发现它其实与自己的知识结构相合,产生“原来如此” 的认知重排。论文把它与贝叶斯惊奇联系起来:先看听到输入后信念分布移动了多少,再看第二个模型或第二种推理策略是否能以更小的信念变化重新解释同一输入。图 4 用一个 2 模型玩具例子说明这个思路:Model 1 接收音乐片段后先验与后验分离较大,Model 2 的分布移动较小,二者 KL 的差被解释为 HC-surprise。
看图路径: 1. 先看 Model 1 与 Model 2 两个模块之间的箭头,确认同一输入依次经过两种解释;2. 再比较每个模块下方先验与后验曲线的位移大小;3. 读取图中标注的 KL 数值 1.15、0.01 与差值 1.14;注意图注标注的 KL 数值与分布参数按标准公式计算略有出入,正文只按图内标注引用,不自行改算或断言二者自洽

论文图 4。原论文 Figure 4::“Illustration of HC-surprise computed from Bayesian model divergences.”。
图 4 上方把 Model 1 的 P 与 Q 标为约 N(1.5, 0.6²) 和 N(0, 1²),并标注 KL 约 1.15;Model 2 的对应 KL 约 0.01;下方给出 HC-s 为 1.15 − 0.01 = 1.14。图中还能看到 Model 1 的先验与后验曲线错位明显,而 Model 2 的两条曲线几乎重合。需要明确的是:图注标注的 KL 数值与分布参数按标准公式计算略有出入,正文按图注原值引用。
按正态分布 KL 的标准公式,图中给出的均值与方差并不能得到标注的 1.15 和 0.01;这里不自行改算这些标注,也不断言二者自洽。
更不能据此判断某首作品具有 HC-surprise。图的用途只是说明“先用一个模型记录较大信念更新,再用另一个模型以较小更新重解释同一输入” 的构造。
论文对 HC-surprise 的态度是谨慎的:要真正测量它,需要知道听者如何组织音乐知识、何时发生内部模型重组,以及什么算“连贯的重组”。论文提出用信息量下降来刻画“顿悟”:如果吸收某个意外作品后,听者知识 K 的编码长度反而下降,即 IC(K′) < IC(K),说明作品揭示了潜在结构,而不只是增加噪声。这个定义有理论吸引力,但它预设了一个可显式编码听者音乐知识的编码器,目前并不具备。论文还讨论了多模型加权版本,用不同架构或数据代表不同“思考方式”,但强调现有生成架构缺乏模拟这种高阶认知重构的能力。
PS-surprise 指范式转移:作品不只是违反既有规则,而是扩展了音乐的概念空间。论文举 20 世纪古典音乐从调性走向无调性,以及新乐器带来新调律和音色维度为例,并用“超插值” 描述概念空间的扩展。论文给出 3 个必要但不充分的条件:极高的 M-novelty、极高的 P-surprise、以及既有模型无法有意义地表征该作品。问题在于,判断一个作品是否越出音乐规则,需要知道规则本身;调性音乐的规则较明确,流行摇滚等风格的边界却流动且不断变化。
即使能确认规则被违反,范式转移的接受也不是瞬时的,它更像文化演化中的突变,需要后续传播和采用才能确认。论文因此承认,PS-surprise 无法用当前框架直接测量,只能作为概念上的上限和未来方向。
M-novelty:相对训练集和相对音乐史
M-novelty 被定义为 AI 生成音乐相对参照数据的偏离程度。参照集换成模型训练集时,它更接近心理新颖性:对系统自身而言,作品是否落在已学分布之外;参照集换成更大的音乐语料时,它更接近历史新颖性:作品相对已知音乐作品是否新。论文强调,这种定义把新颖性放在“生成系统知道什么” 与“音乐史已经有什么” 两个尺度上,而不是直接等同于惊奇。
M-novelty × cosine distance × reference corpus: M-novelty 表示生成音乐相对参照数据偏离多少,reference corpus 决定“相对于什么算新”,cosine distance 则把生成作品与参照作品的嵌入向量比较成可计算的差异。参照集换成模型训练集时,M-novelty 更接近系统自身未见过的心理新颖性;换成更大的音乐语料时,才接近历史新颖性。余弦距离只保留向量方向、忽略长度,而且依赖所选编码器,因此三者组合得到的数值是“参照集与编码器条件下的新颖性”,不能脱离这些条件解释为绝对创新程度。
可操作化的第一步是把生成作品和参照作品编码成向量,再计算余弦距离。论文选择余弦距离而不是欧氏距离,理由是嵌入向量的长度不一定有清楚的音乐解释,尤其在高维空间中。
计算时,把生成作品嵌入记为 v_gen,参照集中第 i 个作品嵌入记为 v_i;先算两者余弦相似度,再用 1 减相似度得到余弦距离。对参照集所有作品取平均,得到平均余弦距离,表示整体偏离;取最小值,得到最近邻余弦距离,表示最像参照集中的哪一个。平均距离偏向整体偏离,最小距离偏向是否接近某个近邻,两者回答的问题不同。
这条路线的代价是表示依赖。论文明确指出,没有唯一最优的音乐编码器,新颖性分数只相对于所选 MERT、CLAP 或其他表示空间有意义;跨系统比较时必须固定编码器。余弦距离还忽略向量长度,而长度可能编码强度或显著性;上下文嵌入空间也可能各向异性,使余弦相似度整体偏高、可用动态范围被压缩。
因此,M-novelty 的数值应读作“编码器和参照集条件下的新颖性”,不能当作绝对创新度。论文建议补充非嵌入的新颖性,例如把作品分解成是否转调、是否使用某种拍号、是否出现某类乐器等可解释属性,再按二值属性比较;也建议按旋律、和声、节奏、音色分别计算嵌入新颖性,并同时报告平均和最大值,因为平均奖励各维度都新,最大值奖励某 1 维度突出。
这篇论文没有训练模型,实际计算是什么
论文没有训练新的生成模型,也没有训练一个名为 M-Creativity 的评分器。它提出的是度量定义和计算路线:调用已有的音乐表示模型、情绪估计器、源分离、节拍跟踪或符号分析工具,得到嵌入、valence 与 arousal、频谱流、IOI、速度曲线等中间量,再按各节公式比较参照语料。原文没有报告参数更新、损失函数权重、优化器、训练轮数或硬件预算,因此不能从论文推断某个模型是怎样被训练的。
在没有训练的情况下,仍要区分“计算” 与“求解”。给定同一编码器、同一参照集和同一输入,嵌入距离是确定性的算术结果;但 valence 与 arousal 估计、源分离、节拍跟踪和概率模型都可能引入误差或随机性,所以整套评测不是自动确定的真值。论文把 M-value 的情绪指标称为代理,把 P-surprise 的概率称为相对 PME 的估计,正是为了避免把计算结果当成创造力本身。
论文还提出一个未来方向:把这些指标用作微调生成模型的奖励函数或辅助目标,鼓励新颖性、惊奇或价值。若真这样做,才会出现训练问题,例如多个目标如何加权、奖励是否会被模型钻空子、优化惊奇是否会牺牲音乐价值。论文只提出这种可能性,没有给出训练实验,也没有报告任何用 M-Creativity 指标优化后模型的表现。因此目前能复现的是“评测计算”,不是“按创造力训练”。
没有实测实验,评测需要哪些条件
论文没有报告数据集划分、模型基线、听众招募或统计检验。它是一个概念框架,不是 1 篇跑完 benchmark 的实验论文。要按它的思路做评测,首先需要一个听众群体和目标参照语料。论文用 PME 近似听众期待:对出生年份为 Y、年龄为 A 的听众群体,取发行时间落在 [Y − δ, Y + A] 的音乐集合 I,再并上 Timeless Culturally Significant Music(TCSM),得到 PML = I ∪ TCSM。δ 是回看年限,论文给出 δ=50 年的示例,说明 2000 年出生、25 岁的听众可被假设接触 1950 到 2025 年的音乐;这只是一个说明性默认值,不是实验标定结果。
下面把可核对的 PME 参数和来源放在一起,比较问题不是哪个数字能直接决定创造分,而是这些设置如何改变参照分布;表中保留原文的示例值,不能把它们当成跨研究的通用常量。
| 设置项 | 原文给出的值或示例 | 在评测构造中的作用 | 需要保留的限制 |
|---|---|---|---|
| 回看年限 δ | 50 years(illustrative default) | 用 [Y − δ, Y + A] 定义听众可能接触的历史音乐窗口 | 这是说明性默认,不是跨流派统一常数 |
| 示例听众 | born in 2000 and aged 25 | 在该默认下对应 1950 to 2025 的音乐暴露 | 只是群体级暴露示例,不是个人真实聆听记录 |
| 历史音乐集合 I 的数据来源 | Million Song Dataset 或 Discogs,按发行日期筛选 | 构造听众可能接触的历史音乐窗口 | 需要数据库的发行日期和覆盖范围可靠 |
| 共享文化音乐 TCSM | Spotify’s Essentials of Classical Music | 作为 timeless culturally significant music 的一个近似来源 | 精选列表不等于完整文化共识,且带平台偏差 |
这张表说明,δ=50、2000 年出生/25 岁以及 1950 到 2025 都是说明性默认或示例,不是实验标定;替换语料或流派后,期待分布和后续 z 分数都会改变。
论文建议用 Million Song Dataset、Discogs 等带发行日期的历史数据库构造 I,用 Spotify 的古典音乐 Essentials 等精选列表近似 TCSM。这里要注意,PME 是群体级代理,不是某个听众的真实聆听史;论文明确说目前只用 PML 代理 PME,尚未显式建模 PMP 和其他因素。若研究目标换成非西方音乐或当代快速变化的流派,δ、语料来源和 TCSM 的选择都应重新论证。
指标层面还要确定:用符号还是音频;是否做源分离;用哪个嵌入模型;N-gram 的 n 取多少;节奏微时序容差 ε 取多少。
PME 是否按流派分区;M-value 用哪种情绪估计器或歌词分析。论文没有给出这些超参数的统一值,也没有报告不同设置下的稳定性。更重要的是,任何“M-Creativity 高” 的判断都需要人类评分或行为实验来校验,而论文明确把这类验证留到未来。
没有实测排行榜,能报告的是构造与缺口
论文没有报告自己的实证结果:没有模型基线、数据集划分、听众评分、统计检验,也没有 M-Creativity 与 MOS、HTH 或专家评分的相关系数。表 1 中 Grötschla 等人的大规模 head-to-head 研究、Salamanca 等人的 43 人听众研究,以及 2 维/3 维的玩具例子,都只能作为外部背景或概念说明,不能冒充本文的实验验证。
外部证据中,Bjare 等人在 2025 年报告,基于潜音频表示训练的生成无限词汇 Transformer 的 IC 与听众 EEG 响应相关;这提示事件级信息量可能捕捉到一部分听众反应。Yang 等人在 2008 年用支持向量回归估计 valence 与 arousal, arousal 的 R² 为 0.58、valence 的 R² 为 0.28,说明情绪估计仍有限,且训练标注带有主观性。两项证据都只支持“个别组件有可研究性”,不支持“整套 M-Creativity 指标已经能预测人类创造力判断”。
论文真正给出的结果是一组可分别计算的量及其关系:M-value 可由情绪距离、情绪波动和歌词分析等代理;M-surprise 可从事件条件概率、熵、频谱流、IOI 与速度曲线展开;M-novelty 可从嵌入余弦距离或可解释属性偏离得到。它们支持诊断性比较,例如看一个系统主要在旋律、和声、音色还是节奏上偏离参照,也支持检查某个维度的高分是否以另一个维度的低分为代价。它们不支持模型排行榜,因为没有统一参照集、统一编码器和人类评分校准。
没有消融,哪些选择仍需验证
论文没有做消融实验,也没有给出负结果或未胜出基线。原因是它没有跑统一的实证评测,而不是它做了实验却没有报告。这个空缺对解释结论很关键:读者无法知道换一个嵌入模型、换一个 PME 语料、换一个 N-gram 阶数或换一个 ε 后,M-surprise 和 M-novelty 的排序是否稳定;也无法知道 M-value 的情绪代理与听众真实价值判断的相关性有多高。
从框架设计可以列出需要验证的敏感性来源,但这些是待做实验,不是论文已得结果。第一是表示选择:MERT、CLAP 或联合音频–文本空间会改变嵌入距离;论文自己说跨研究比较必须固定编码器。第二是参照集:训练集、流派内语料和更大历史语料会产生不同的心理/历史新颖性。第三是 PME 构造:δ、TCSM、流派划分和听众年龄都会改变条件概率与 z 分数。
第四是信号处理参数:源分离质量、节拍跟踪、IOI 微时序容差和频谱帧长都会影响节奏与音色指标。第五是组合方式:论文没有规定 M-value、M-novelty、M-surprise 的权重,也没有验证三项高低组合的补偿关系。
这些未验证项限制了结论范围。论文可以主张“这些方面在原则上可被量化”,但不能主张“这些指标已经被证明能稳定预测人类创造力”。在缺少消融的情况下,最稳妥的读法是把它当作评测设计提案:先固定条件做小规模相关性研究,再谈跨模型比较。
适用条件与主要风险
第一个限制来自 PME 假设。论文假设同一社会文化群体拥有相似的“脑内模型”,并用 PML 近似 PME,忽略 PMP 和个体差异。这个假设让群体级评测可操作,但也把文化偏差带进参照分布:同一失真音色在金属乐中被重视,在古典乐中可能被贬低;同一作品对非音乐人和专家的新颖性判断也可能不同。论文承认框架带现代西方视角,跨人群和时间的外推需要重新校准。
第二个限制是 M-value 的主观性。情绪代理只覆盖价值的一部分,valence 与 arousal 估计误差、歌词是否被注意、听众背景和场景都会改变价值判断。论文引用 R² 数据说明情绪估计仍有限,也说 M-value 可能是三项中最难客观化的。把情绪距离高直接当成价值高,会混淆“情绪强” 与“音乐好”。
第 3 个限制是 HC-surprise 和 PS-surprise 的不可直接测量。HC-surprise 需要知道听者知识如何重组,PS-surprise 需要知道音乐规则和概念空间如何变化;论文提出贝叶斯式、信息量下降和不可表征性条件,但自己承认当前架构无法模拟这种高阶重构。M-novelty 则依赖编码器和参照集,余弦距离还受各向异性影响。最后,组合权重没有确定。
三项高于或低于常态的组合解释没有经过人类实验校准。论文的伦理讨论还提醒,开放式生成可能产生有害歌词、令人不适的高频尖峰或版权问题,这些风险不会因为多了一个创造力指标就消失。
复现应先固定参照集与编码器
如果要按这篇论文做复现,第一步不是训练模型,而是把评测条件写成可核对的配置:目标听众群体及其 PME 构造、参照语料是训练集还是更大音乐史语料、输入是符号还是音频、是否做源分离、使用哪个嵌入模型和哪个情绪估计器。论文的贡献是概念性的,并未报告针对人类判断的实证验证;就目前可核验的来源而言,未确认到处于可用状态的作者代码、模型权重或数据资源,但来源未确认不能推断作者未公开,也不应被当作论文的技术缺陷。指标定义本身不等于可运行系统;复现者需要自行实现中间步骤并记录版本。
第二步是选一个最小可运行子集,例如只做旋律/和声 IC 与嵌入余弦距离:用固定编码器把生成作品和参照作品嵌入,计算平均与最小余弦距离;用固定 N-gram 或序列模型估计条件概率,计算 mean IC 和熵。再把同一批作品交给目标听众做 MOS 或 HTH,检查指标与人类判断的相关性。随后再逐步加入音色、节奏和情绪代理,观察新增维度是否带来独立信息,而不是只增加共线性。
复现时不能跳过条件记录:δ 的取值、TCSM 列表、流派划分、N-gram 阶数、ε、频谱帧长、源分离模型和节拍跟踪器都要固定并报告。不同研究若使用不同编码器或参照集,M-novelty 数值不可直接横比;不同听众群体下的 PME 也不可直接互换。原文未报告统计检验、置信区间或硬件预算,这些都需要复现者自行设计,不能从原文补猜。
什么时候值得用,结论边界在哪里
这套框架适合用于诊断性评测:想知道一个生成系统在旋律、和声、音色、节奏上分别偏离参照多少,或者想比较 2 个模型在同一编码器、同一参照集下的多维表现,可以按论文选择子指标。它也适合作为未来奖励设计的候选信号,但必须经过人类验证,否则容易把“惊奇更高” 优化成“更不协调”。它不适合作为通用创造力排行榜,也不适合把 M-value、M-surprise、M-novelty 的未加权分数直接相加后宣称某个模型更有创造力。
与既有工作相比,它的区别在于把 Boden 的三项同时适配到音乐,并把 M-surprise 细分为概率、隐藏内容和范式转移 3 层;DeepCreativity 面向诗歌,FACE、IDEA 更偏理论,rubric 评测在音频上又面临标准和成本问题。它的优势是模块化和可解释,代价是依赖多个外部估计器和参照选择。论文自己说得很清楚:这是一个概念贡献,没有与人类判断做实证验证,M-value 难以客观化,HC-surprise 与 PS-surprise 目前基本不可直接测。
如果要开始验证,最实际的第一步是固定一个听众群体、一个参照语料和一个编码器,选少量作品同时计算 M-surprise 与 M-novelty,并收集同一批听众的评分,先检验两个问题:P-surprise 与 M-novelty 是否真的可分开,M-value 的情绪代理是否与整体价值判断相关。第二个问题是论文明确留待未来验证的关键;在得到这类证据之前,最稳妥的结论是:这篇论文提供了可操作的测量语言和待检验的研究议程,而不是已经证明有效的 AI 音乐创造力评分系统。
📎 论文与评分元数据
排名:前50% | 文档类型:理论研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:deepseek-v4.1-flash
评分请求协议:openai_responses