📄 流式听写不只看词错率:从失败分层理解 ASR 评测
英文题目:Beyond Word Error Rate: A Failure Taxonomy of Streaming Dictation ASR
评分:7.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
👥 作者与机构
- Harras Mansoor:机构信息未能在本次解析中与作者逐人可靠绑定
- Muhammad Wisal:机构信息未能在本次解析中与作者逐人可靠绑定
- Hassan Bhatti:机构信息未能在本次解析中与作者逐人可靠绑定
- Masood Shakir:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文研究流式口述听写:音频按说话速度实时送入识别系统,文本直接写进消息、邮件或助手指令,最终文本的残留错误仍要用户修正,因此只看词错率(WER)会掩盖错误类型和修正成本。作者将同批语音送入 11 个实时识别系统共 13 种配置,仅评分每片段最终文本;输入覆盖安静、风扇和耳语英语、11 个其他语言与方言集各 20 个片段、400 条双语拼接录音及 10 个无语音片段;在 106 条自采英语听写中,安静英语下 OpenAI GPT-Live-Transcribe(GPT-Live)的 WER 为 7.3%,低于 Zoom Scribe(Zoom)的 7.4%,但耳语英语下 GPT-Live 为 8.8%,低于 Zoom 的 34.7%,表明相近的 WER 并不代表相近的失败方式。研究先将各系统的逐字转写与脚本对齐,按多系统一致听到的增删改提出并人工核定口语参考,再用最少编辑的逐词对齐把最终文本同脚本参考或口语参考比较,输出错误词,最后按识别、输出格式、语言处理和模型前音频路径四层用固定规则归类;两种参考分别检验是否写出用户想发的信息与是否听清实际说出的话。与只报总体 WER 的公开评测相比,这套流程能区分漏词长段、截尾、名称错误、数字格式、错误书写系统、语言缺失和语音活动检测(VAD)丢弃音频等失败。在本客户端上,从音频结束到最终文本的中位等待在流式系统中为 313–760 ms,短于整段上传的 Whisper-1 设置约 1,850 ms,显示出准确率与等待之间的部署取舍。结论主要适用于所测系统在测试时段、默认或指定设置和本客户端下的流式口述场景。
🔗 开源与复现资源
第三方资源:https://github.com/heylemon-ai/streaming-dictation-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/hey-lemon/streaming-dictation-asr — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
听写任务的输入、输出与 WER 的盲点
听写(dictation)的输入是用户对麦克风说出的一段消息,输出是要插入聊天框、邮件、笔记或助手指令中的文本。与先把整段录音上传、再比较规范化文本的基准不同,听写中的每个字都会留在消息里;用户若没发现,错误就随消息发送。因此这里评价的对象是流式系统与客户端集成后的最终文本,而不是只评价某个声学模型。
WER 先把系统转写和参考文本按最少编辑操作对齐:一个词被换成另一个词是替换,参考中有而转写中没有是删除,转写中多出参考没有的词是插入。总错误数除以参考词数得到 WER,数值越低越好;因为插入也计入分子,WER 可以超过 100%。它回答“平均错多少”,却不回答“错在哪里” 以及“用户要修什么”。
WER × 替换 × 删除 × 插入: WER 先把系统转写与参考文本按最少编辑操作对齐,再以总错误数除以参考词数;替换是听成另一个词,删除是漏词,插入是多写词,三者相加构成 WER 的分子。单看 WER 只能知道总量,分开报替换、删除、插入后,才能看出同样的 WER 是零散错词、整段漏说还是多写了用户没说过的内容,这正是后文比较听写失败的最小单位。
同一个 WER 可能由零散错词、整句漏掉或大量多写共同造成,听写用户花费的修改时间并不相同。论文因此不只报一个平均分,而是沿着同一个流式输入,把错误分到识别、输出格式、语言处理和模型前音频路径 4 个层次,并观察具有相近总分的系统是否在不同的地方失败。
已有评测做了什么,仍漏掉什么
公开的 ASR 榜单通常把完整音频文件送入系统,先规范化大小写、标点和数字,再用 WER 比较;独立测试商业服务时,也会按说话速度流式发送并同时报告速度。论文引用这些工作后指出,WER 依赖文本规范化方式和测试数据,同一测试集上的排名不一定能迁移到另一个测试集,因此只报一个平均数不足以描述听写。
另一类工作尝试越过 WER:匹配错误率、词信息损失、参考与转写之间的语义距离、按类型拆分幻觉,以及每小时连续插入或删除片段的次数,都能补充不同侧面。误差分析也发现罕见词和靠近不流畅处的词更难识别。对 Whisper 的研究还显示,在代码切换或南亚语言中,提示里的语言设置可能让模型翻译或输出错误文字系统;这些问题主要是在开放模型上测量。
本论文与这些路线的区别在测试对象和评分时点:商业系统按实时速度流式运行,只评最终文本,并保留用户实际看到的数字和格式;同时加入安静、风扇、耳语、多种语言和两语言拼接录音。它没有提出新的 ASR 模型,而是把评测单位扩展到系统与客户端集成的整条路径,观察不同层次上的失败。
论文要回答的具体问题与数据边界
论文研究的不是离线、已经清洗好的完整录音,而是用户对着设备边说边得到文本的听写。它要回答 3 个具体问题:在同样的流式协议下,WER 相近的系统是否会在不同层次犯不同错误;这些错误在耳语、名称、数字、书写系统和双语输入中是否仍然可见;以及应用在模型之前做出的音频切分、静音丢弃和端点判断会不会改变结论。
为此,作者把音频按说话速度分块发给 11 个实时系统,每个片段新开会话,只保存最终文本,并测量音频结束到最终文本的等待时间。英文测试包含 106 条由同一说话人朗读的脚本消息,分为 73 条安静、17 条有风扇声和 16 条耳语;这些条件使用不同消息,所以只能在条件内部比较系统,不能把安静与耳语的差值直接当成同一条消息的配对变化。另有 11 个语言和方言集各 20 条、400 条两语言拼接录音和 10 条无语音片段。
论文的贡献是四部分:一套按输出层次组织的失败分类及检测规则;对 11 个系统在自有数据和外部说话人语料上的逐层比较;同一段语音的脚本参考与口语参考;以及 Whisper 在托管、切分和语音门控上的 9 种运行方式案例。这里的系统名、部署方式和默认设置都属于结论的一部分,因为同一模型换一种集成方式可能得到不同失败。
一条音频如何经过流式客户端变成最终文本
处理一个片段的流程可以按时间顺序说明。客户端从麦克风取得短块音频,按接近说话速度的方式分批发送,每个片段重新建立会话;服务可以边接收边输出临时文本,也可以等检测到停顿或音频结束后再提交。论文不评临时文本,只评系统承诺不再修改的最终文本;等待时间从客户端发出结束信号算到收到最终结果,因此主要衡量收尾和网络路径,而不是说话过程中的端点判断。
流式传输 × 端点检测 × 最终文本: 流式传输决定音频按说话速度分批到达,系统必须在尚未拿到完整录音时产生文本;端点检测决定服务何时把一段话视为结束并提交结果;最终文本是用户实际收到、不再由系统改写的文本,也是本文唯一评分的对象。三者串联后,等待时间、漏词和迟到的补写都会反映在听写体验中,而只看离线整段 WER 看不到这层组合。
这套流程带来一个评测上的限制:缺失词可能来自模型没听清,也可能来自客户端的语音活动检测、服务端内部的语音检测,或者端点判断过早提交。对于托管服务,内部过程不可见,论文只能把缺失算在识别层,并注明它包含服务内部的语音检测;对于自托管 Whisper 和 Qwen,作者能控制自己的音频路径,才把模型前的丢弃单独分出来。因此每个结果应理解为“某个系统加上本文的集成方式”,而不是抽象模型的永久属性。
四级失败分类和可复核的判定规则
失败分类按错误在输出中出现的层次分组。识别层包括替换、删除、插入、近似错词、专名错词、连续漏词、结尾截断、失败片段、困难片段和编造文本;输出格式层包括数字形态、大小写与标点、去口癖设置造成的差异,以及错误文字系统;语言处理层包括两语言录音中一整部分缺失、缺失部分被拉丁字母转写或被英文翻译;模型前层专指应用自己的语音活动检测让模型从未收到音频。
下面的分类表要解决的是“怎样把观察到的输出变成可复核标签”。每个错误类型都配有一条程序可执行的规则,并注明阈值和测量章节;较低层级的规则不必推断原因,只说明输出中的现象。
| Level | Error type | Rule | Section |
|---|---|---|---|
| Recognition | Wrong, missing, extra word (substitution, deletion, insertion) | a word replaced by another, left out, or added, from the word-by-word comparison | 6.1 |
| Near-miss | a wrong word of 4 or more letters that differs from the correct word by 1 or 2 letters | 6.1 | |
| Name error | a word of a name in the correct text is not in the transcript | 6.3 | |
| Missing stretch | 5 or more words in a row are missing (a run of deletions, as in the omission rate of 16), noted by position (first, middle or last third) | 6.2 | |
| Cut-off ending | the last 3 or more words are missing (truncation) | 6.2 | |
| Failed / lost clip | the clip’s WER is at least 50% / at least 90% | 6.2, 6.4 | |
| Hard clip | the clip’s WER is above 30% | 6.4 | |
| Invented text (hallucination) | text written for a clip with no speech, or a short stock phrase written in place of a whole clip’s speech | 9 | |
| Output formatting | Number format (ITN) | a number in digits in the correct text comes out in words, or the other way round | 7.1 |
| Formatting | a wrong capital letter or punctuation mark (formatted error rate, Table 3) | 5 | |
| Clean-up (disfluency removal) | fillers, repeats and self-corrections removed: the difference between WER against the spoken reference and against the script reference | 7.3 | |
| Wrong writing system | most of the letters in the text belong to a different writing system from the chosen language’s | 7.2 | |
| Language handling | Missing part | less than 20% of the words of one language’s part of a two-language recording are heard | 8 |
| Romanised part (transliteration) | a missing part is replaced by Latin-letter text that is not English | 8 | |
| Translated part | a missing part is replaced by English (at least 4 words, at least 15% of them common English function words such as “the” or “of”) | 8 | |
| Before the model | Dropped by the app’s VAD (VAD gating) | audio the app never sent to the system | 9 |
读表时应把阈值看成对用户修复成本的近似:片段 WER 至少 50% 被记为失败,因为一半消息可能都得重打;超过 30% 记为困难片段,因为需要多处修正;两语言录音中某部分听到的词少于 20% 才算缺失,这样少量听错的词不会把整段误判为丢失。层名说的是错误在哪个输出位置出现,不是已证实的因果。例如托管服务中的漏词可能来自模型,也可能来自其内部语音检测。
论文只在自托管 Whisper 和 Qwen 中有条件把模型前丢弃与识别分开。分类规则还会依赖此前的词级对齐和参考选择,因此表中列出的只是第一层判定。
模型之前的音频路径:切分与语音门控
Whisper Large V3 以约 30 秒窗口工作,实时使用时要不断增长缓冲区,或者在检测到的停顿处切段。切段之后,音频可以每个样本都送给模型,也可以由客户端先决定哪些块根本没有语音、直接不发送。后者就是音频门控。服务器内部还可能运行自己的语音检测,决定何时开始或结束一个片段;这一点在托管服务里通常不可见。
语音活动检测 × 音频门控 × 分段: 语音活动检测先对短帧判断是否含语音;音频门控把这个判断变成丢弃静音或低概率音频的动作,使模型根本收不到这些样本;分段则仍把所有样本留在流中,只决定在哪个停顿处结束一段并送入模型。语音活动检测可以和分段搭配,也可以和门控搭配,前者改变上下文边界,后者改变模型看到的输入分布,因此同一个检测器的两种用法会产生不同错误,尤其是在耳语和噪声下。
论文用 9 种 Whisper 运行方式把这条路径拆开:两个自托管 Whisper Large V3 部署,其中一个在客户端用 Silero 只切分,另一个既切分又丢弃;再用 TEN 检测器替换 Silero,分别做切分和丢弃;另有 3 条 OpenAI 托管路径,分别是实时 Whisper、整段上传的 Whisper-1,以及客户端切段后逐段上传的 Whisper-1。比较时保持音频和任务不变,只改变托管位置、切分规则、是否丢弃音频以及端点策略。
这组设计的意义不只是比较模型。切分改变每个片段包含多少上下文,门控改变模型看到的输入分布,服务器端点又决定何时提交。若只看最终 WER,会把 3 种来源混在一起;若把声音丢掉,模型甚至没有机会识别。论文因此在耳语、无语音和两语言录音上同时测量,并把等待时间作为代价一起报告。
没有模型训练:本研究实际构造了哪些参考与标签
这项研究没有训练或微调 ASR 模型。每个系统按提供方接口运行,作者只负责流式发送音频、保存最终文本、对齐参考并进行统计。模型参数在测试中不更新,也没有从测试转写中做梯度下降;因此这里的“方法” 主要是评测协议、参考构造和规则化标注,而不是网络训练过程。
最重要的构造是两套英文参考。脚本参考是说话人拿到的文本,代表他本来想发送的消息;口语参考根据实际录音修正脚本,代表他真正说出的词。制作时,11 个逐字系统的转写先与脚本对齐:如果至少 3 个系统听到同一个新增词,或至少 5 个系统听到同一处缺失或改变,程序就提出编辑建议;1 名听者逐条接受或拒绝,并手工修正 6 条消息。最终,106 条消息中有 85 条与脚本不同,按词计算是 10,776 个词里有 453 个不同,占 4.2%,其中 242 个是新增、88 个是漏掉、123 个是改变,包含重复和自我修正。
这说明口语参考并不是完全独立的人工抄写,而依赖被测系统的共识;论文后来用留一系统重建来检查这一点。名称标签由语言模型按照书面规则标出,重音标签由分类器给出并和朗读者的自述核对。所有这些步骤属于数据构造与规则分析,不涉及模型训练,也没有报告用测试转写训练任何模型。
系统、测试集、评分与统计比较
实验测试 11 个实时转写系统,其中两个是自托管开放模型:Qwen3-ASR 1.7B 和 Whisper Large V3;9 个由服务商运行:Meta Muse Voice Transcribe、Gemini 3.5 Transcribe、Deepgram Nova-3、AssemblyAI Universal-3.6 Pro 与 3.5 Pro、Zoom Scribe、ElevenLabs Scribe v2 Realtime、OpenAI GPT-Live-Transcribe 和 GPT-Realtime-Whisper。Gemini 的 Smart 设置和 ElevenLabs 的 no_verbatim 设置作为额外行出现,因此结果表有 13 行。系统默认设置之外只做了论文列出的少量改动,例如 Deepgram 开启标点与 smart_format、GPT-Live 使用低延迟、Whisper 自托管使用 beam width 5。
英文数据是 106 条为聊天、邮件、笔记和助手指令写的脚本,由 1 名团队成员朗读;73 条安静、17 条附近有风扇、16 条耳语。朗读者有意在一条消息内切换美国、南亚、英国和爱尔兰英语。其他语言和方言集各 20 条,覆盖 7 种语言;两语言测试把不同来源的片段在 300 毫秒停顿处拼接,共 100 条英语加另一语言、300 条两种非英语语言。外部验证使用 EARS 的 107 名说话人、每人正常和耳语各 428 条,以及 VOiCES 的 100 个句子在干净、远场、远场加人声、远场加电视 4 种条件下的录音。
评分时,最终转写先忽略大小写和标点,并合并阿拉伯文、乌尔都文和中文中的等价字形;数字不互转,seven 代替 7 算错。WER 用最少编辑对齐得到替换、删除和插入,再除以参考词数;格式化错误率则保留大小写和标点,每个标点作为单独 token。普通话没有空格,按中文字符以及连续拉丁字母或数字串计数,指标称为混合错误率。
英文 WER 的 95% 区间来自按消息重采样的百分位 bootstrap;两个系统比较时对同一批消息做配对重采样,并在各组内做 Holm 校正。语言集只有 20 条,几个百分点的差异通常在随机范围内;两语言录音重复使用来源片段,区间更宽。
脚本参考 × 口语参考 × 清洗设置: 脚本参考记录说话人本来想发送的文本,口语参考记录他实际说了什么;清洗设置会删除口头填充、重复和自我修正,使转写更接近脚本参考,却会让逐字对口语参考的分数变差。两者配合使用时,脚本参考回答“用户是否得到想发的消息”,口语参考回答“系统是否听见了实际说出的话”,引用时若不说明用了哪一个,清洗设置的优劣就会被误读。
英文结果默认用脚本参考,因为听写用户想要的是自己准备发送的消息;第 7.3 节才用口语参考比较清洗设置。这个选择很关键:同一份转写在两种参考下的 WER 不同,去口癖设置在脚本参考上可能显得更好,却在口语参考上因为删掉实际说出的重复而变差。
相同 WER 在耳语条件下为何分开
下面的表只取论文中最清楚的一组对照,用来说明安静英语几乎相同的总分怎样在耳语英语中分开。WER 是系统最终文本相对脚本参考的词错误率,越低越好;表中数值都来自同一名朗读者朗读、但安静与耳语使用不同消息的条件,因此不能把两列之差理解为同一句话的配对变化。
| 系统 | 安静英语 WER | 耳语英语 WER |
|---|---|---|
| Zoom | 7.4% | 34.7% |
| GPT-Live | 7.3% | 8.8% |
从这组对照可见,Zoom 和 GPT-Live 在安静英语只差 0.1 个百分点,到耳语时却相差 25.9 个百分点;论文报告的成对差是 25.8 个百分点,95% 区间为 10.3 到 51.7,漏词占其中大部分。这个例子支持“总分相近不等于失败方式相近”,但不能单独证明耳语是唯一原因,因为安静和耳语本就使用不同消息,且样本只有 16 条耳语消息。
完整结果还显示,安静英语上 13 行中有 10 行位于 3.9% 到 9.5%,单看排名很接近。Gemini Smart 以 3.9% 最低,默认设置中 Gemini 的 6.9% 最低。AAI 3.6 与 RT Whisper 在安静英语都约 8.2%,耳语时分别为 30.5% 和 8.9%;Qwen 的耳语 WER 为 46.6%,但其中很大一部分来自本文部署自带的语音检测,后文会把这条路径单独拆开。
把大小写和标点也计入后,安静英语的错误率升至 8.8% 到 22.8%;最低的是 Gemini Smart 的 8.8%、ElevenLabs NV 的 9.0% 和 Gemini 的 9.1%。这说明即使总体识别接近,输出是否按用户期望的大小写和标点书写仍会改变可用性。另一方面,语言集上没有哪个系统在每一个集合都清楚领先;许多语言只有 20 条,几个百分点的差距不能当作稳定优势。
错词、漏词、插词与专名的不同代价
把 WER 拆成 3 类后,可以看到相同总分由不同错误组成。安静英语中,13 行里有 9 行的额外词是最大错误来源;其中不少是朗读者确实说出的重复或自我修正。改用口语参考后,额外词成为最大来源的只剩 4 行:Gemini、AAI 3.5、Zoom 和 ElevenLabs。Gemini 的额外词从 3.7% 降到 1.6%,ElevenLabs 只从 8.1% 降到 5.7%,说明后者的额外词大多不是说话人真正说出的。
Whisper SH 和 AAI 3.6 的总 WER 分别是 8.3% 和 8.2%,但 Whisper 多漏约 0.9 个百分点的词、少加约 1.1 个百分点的词;总分接近并不等于修改方式接近。
专名是另一个被平均值掩盖的局部问题。下面的表比较每条系统在 183 个专名词和其余英文词上的正确率,差值为其他词正确率减去专名正确率,因此正值表示专名正确率更低、专名更难。表中还给出按 106 条消息 bootstrap 的区间。
| System | Names | Other words | Gap | 95% CI |
|---|---|---|---|---|
| Whisper SH | 88.0 | 94.5 | 6.5 | [1.1, 12.9] |
| Qwen | 82.0 | 88.4 | 6.5 | [0.1, 14.1] |
| Meta | 90.2 | 95.0 | 4.8 | [0.3, 10.2] |
| Gemini | 93.4 | 96.9 | 3.5 | [−0.3, 8.2] |
| Gemini Smart | 95.1 | 96.8 | 1.7 | [−1.4, 5.6] |
| Deepgram | 81.4 | 91.1 | 9.7 | [3.3, 16.7] |
| AAI 3.6 | 92.3 | 93.0 | 0.7 | [−4.2, 6.0] |
| AAI 3.5 | 92.3 | 92.9 | 0.6 | [−4.2, 6.2] |
| Zoom | 90.7 | 92.7 | 2.0 | [−3.3, 8.0] |
| ElevenLabs | 91.8 | 95.4 | 3.6 | [−0.4, 8.5] |
| ElevenLabs NV | 94.5 | 96.1 | 1.6 | [−1.8, 5.6] |
| GPT-Live | 90.2 | 95.7 | 5.6 | [1.5, 10.8] |
| RT Whisper | 90.7 | 95.6 | 4.9 | [0.6, 10.3] |
所有系统写专名的正确率都低于其他词。Deepgram 的差距最大,为 9.7 个百分点,95% 区间 [3.3, 16.7];在 13 次比较中,原始区间排除零的还有 Whisper SH、Qwen、Meta、GPT-Live 和 RT Whisper,但做 Holm 校正后只有 Deepgram 的差距仍然清楚。只取安静英语时,没有任何系统的专名差距清楚高于零。专名总共只有 183 个词,占 10,776 个英文词的很小一部分,因此即使 Deepgram 的差距接近 10 个百分点,对总 WER 的贡献也只有约 0.2 个百分点;总 WER 很低并不能保证关键人名或产品名可用。
耳语语音:漏词位置与跨说话人复现
16 条耳语英文中,Qwen、Zoom 和两个 AssemblyAI 系统漏掉约 26% 到 32% 的词,其余系统的漏词最多约 3%。这些错误并非均匀分散:Qwen、Zoom 和 AAI 的失败集中在 5 或 6 条片段,其中 2 到 4 条几乎整段丢失。AAI 3.6 还在 4 条耳语片段上截掉最后 3 个或更多词,Zoom 没有这样的截尾;截尾在最终文本中看起来像正常结束,WER 本身不会告诉用户“句子最后一截没了”。
下面的图把每条系统的耳语 WER 拆成替换、删除和插入三部分。读图时先看横轴是错误词占全部正确词的比例,而不是系统数量;蓝色替换、橙色删除和绿色插入 3 段堆叠成的完整柱长就是该系统的总 WER,柱末数字应与完整柱长对应。重点不是找一个最大值,而是比较相同总分是否由同一类错误组成。
看图路径: 1. 先看横轴是错误词占全部正确词的比例;蓝色替换、橙色删除和绿色插入三段的完整堆叠长度就是该系统的总 WER,并应与柱末数字一致。;2. 沿同一系统比较蓝色替换、橙色删除和绿色插入哪一段最长,再对照不同系统的完整柱长。;3. 重点对比 Qwen、Zoom 和两个 AssemblyAI 的长橙色漏词段,以及 GPT-Live、RT Whisper 较短的完整柱长和明显的蓝色错词段。
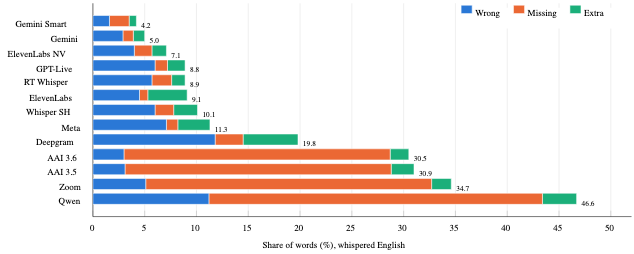
论文图 1。原论文 Figure 1::“Whispered WER split into wrong, missing and extra words, as a share of all words; the number is the WER.”。
图中可以清楚看到两条不同的失败带。Qwen 的完整柱长对应 46.6%、Zoom 的完整柱长对应 34.7%,AAI 3.6/3.5 分别对应 30.5%/30.9%,它们的长柱主要由橙色删除段构成,表示大量词没有被写出;GPT-Live 的 8.8% 和 RT Whisper 的 8.9% 完整柱长短得多,主要蓝色替换段更明显。Gemini Smart 的 4.2% 和 Meta 的 11.3% 则是短柱、不同颜色比例。图只展示 16 条耳语片段的词级构成,不能据此断言某系统在所有说话人或所有耳语音频上都如此。
EARS 的外部复现扩展了说话人数量:107 名说话人朗读同一篇材料,正常语音上所有系统的 WER 为 0.8% 到 2.5%,耳语时 Qwen 为 32.0%、Zoom 为 25.0%、两个 AAI 为 8.1% 和 8.3%,仍有明显漏词;Whisper SH 的耳语 WER 从正常 1.5% 升到 11.5%,其中 10.4% 是漏词,与每个 AAI 的 7.3% 漏词在统计上不能清楚区分。因此,自有英文中“少数系统大量漏词、其余系统几乎不漏” 的整齐分界,跨到 107 名说话人后并不完全成立。
端点设置只解释了一部分漏词。把 AAI 的回合检测关闭后,AAI 3.6 和 3.5 仍分别漏 22.7% 和 25.7%;强制结束最后一回合几乎没有变化。Zoom 把静音结束时间从 600 毫秒延长到 5 秒,漏词从 27.6% 降到 21.2%,仍然很高。Qwen 则不同:放松本文部署自带的语音检测后,漏词从 32.2% 降到 5.7%,而安静和风扇英语没有可测损失,也没有在无语音片段上写文本。因此 Qwen 的耳语损失主要发生在模型前的音频路径,AAI 和 Zoom 的损失则主要归为识别层,包含托管服务内部不可见的语音检测。
多语种、书写系统与双语设置
乌尔都语的失败主要不是“听错词”,而是写成了另一种文字系统。下面的表统计 20 条乌尔都语片段中,有多少条主要写成天城文以及有多少条 WER 至少 50%;表中只列出主要出现另一种文字或没有乌尔都语选项的系统。读表时应把“正确词写对了多少” 和“是否用用户选择的文字写出” 分开看。
| System | Urdu option | Mostly Devanagari | Failed (WER ≥50%) |
|---|---|---|---|
| Qwen | selected | 17 | 19 |
| AAI 3.5 | none | 18 | 18 |
| Meta | none | 17 | 17 |
| Gemini | none | 9 | 9 |
| Gemini Smart | none | 4 | 5 |
| GPT-Live | selected | 1 | 1 |
Qwen 即使用户选择乌尔都语,仍有 17 条主要写成天城文、19 条失败;AAI 3.5 和 Meta 没有乌尔都语选项,分别有 18 条和 17 条写成天城文。Zoom 也没有乌尔都语选项,20 条中有 19 条写成拉丁字母。反过来,两个 Whisper、Deepgram、AAI 3.6 和 ElevenLabs 使用乌尔都文字,失败片段最多 5%;RT Whisper 的乌尔都语 WER 最低,为 12.3%。对用户而言,选乌尔都语却收到天城文或拉丁字母,仍是不可直接使用的输出,即使背后的词听起来相近。
其他语言集的模式和英文不同。欧洲语言和普通话上多数系统接近、通常低于 10%;印地语的范围约 2.6% 到 34.6%,Zoom 的 WER 最高,但它的输出使用正确文字系统,CER 只有 16.3%,不到 WER 的一半,说明许多所谓错词只差少数元音符号或字符。沙特和阿联酋阿拉伯语对每个系统都困难,阿联酋阿拉伯语在默认设置下的 WER 约 48.8% 到 61.8%。220 条非英语片段中有 21 条对全部 11 个系统都困难,其中 14 条是阿联酋阿拉伯语、6 条是沙特阿拉伯语、1 条是西班牙西班牙语。
另有一些片段只对某一个系统困难。前者换系统不会解决,后者才可能通过选型避免。
两语言录音还要区分“语言设置是过滤器还是偏好”。下面的术语说明针对这一区分,不把任何语言丢失都解释成模型不会该语言。
语言设置 × 语言过滤 × 语言偏好: 语言设置是用户或客户端发给系统的语言选项,可能只选英语、同时选两种语言或交给系统自动检测;语言过滤指这种设置直接丢掉另一种语言,具体判定是只选英语时非英语部分缺失超过一半,同时选两种时缺失不到一半;语言偏好则不直接丢掉,只在冲突时倾向于所选语言,只选英语时另一种语言缺失仍不到一半。把设置、过滤和偏好分开后,才能判断某个系统是在做用户想要的筛选,还是把用户想保留的第二语言误删。
只选英语时,Gemini 的两种设置、Deepgram 和 Whisper SH 属于过滤:非英语部分丢失约 86% 到 99%,而同时选两种语言时降到约 33% 到 46%。Qwen、Meta、两个 AAI、GPT-Live 和 RT Whisper 更像偏好:只选英语时丢失非英语部分的录音约 7% 到 38%。GPT-Live 在英语加另一语言的 100 条录音中只丢失 6% 到 7%,RT Whisper 为 10% 到 12%,明显低于其他服务。
Zoom 和 ElevenLabs 的丢失不能只归因于语言选项。Zoom 每个会话只接收一个地区语言,所有设置都像只选英语,因此英语加另一种语言丢失 62%、两种非英语丢失 85%。ElevenLabs 默认整段结束时 1 次性提交;在筛选后的录音上改为每个 300 毫秒停顿提交,英语加另一语言的丢失率从 61% 降到 1%,两种非英语从 92% 降到 36%;no_verbatim 设置则从 80% 降到 2%,从 96% 降到 62%。也就是说,提交方式本身会决定第二语言是否来得及出现。
有些部分并没有留下空白。Deepgram 在 50 条“另一种语言有自己文字系统” 的英语加另一语言录音中,有 34% 把那部分写成拉丁字母;Whisper SH 只选英语时,在同样 50 条中有 18% 把另一部分翻译成英文。只检查“该位置有没有字” 会漏掉这种转写和翻译。论文因此把缺失、罗马化和翻译分开统计。
数字、清洗设置与延迟代价
输出格式层的检查对象是“词已经识别,但写成了用户不想要的形式”。逆文本规范化决定 seven 是否变成 7;格式化错误率再检查大小写和标点;书写系统检查则回答整段文字是否用对了文字。三者侧重点不同,不能用一个 WER 概括。
ITN × 格式化错误率 × 书写系统错误: ITN(逆文本规范化)负责把听写出来的口语句式改成用户想要的书写形式,例如把 seven 写成 7;格式化错误率在评分时保留大小写和标点,并把每个标点当作单独 token,因此能暴露“数字对了但格式不对”;书写系统错误则检查整段文字是否用了所选语言的文字系统。三者分别看数字形态、标点大小写和文字系统,不能用一个 WER 互相替代:前两者是同一语言内部的书写选择,后者会让用户得到完全不同的文字。
英文脚本中有 276 个数字写成阿拉伯数字、193 个写成英文单词。Qwen 把 68% 的数字数字形式写成英文单词,Meta 为 47%,GPT-Live 为 45%;两个 AAI 则把约 41% 到 42% 的英文数字词改写成阿拉伯数字。数字形态切换占 GPT-Live 英文错误的 16.1%、Meta 的 12.9%、Qwen 的 10.4%,而 ElevenLabs、Zoom 和 Whisper SH 只有 4.8% 到 6.1%;由于一个多位数字按一个词计,这些比例还是下限。
数字本身通常听对了,用户仍要在屏幕前改格式。把 Whisper 的英文规范化器同时用于参考和转写后,安静英语 WER 下降 1.0 到 3.8 个百分点,但系统排名几乎没有变化,秩相关为 0.98;数字习惯影响阅读体验,却不是决定安静英语系统排序的主因。
清洗设置的结论依赖参考。对脚本参考,Gemini Smart 把 Gemini 的安静英语 WER 从 6.9% 降到 3.9%,ElevenLabs 的 no_verbatim 把它从 12.8% 降到 5.1%,下降几乎全部来自额外词变少,分别从 3.7% 到 0.7%、从 8.1% 到 1.4%。对口语参考,所有逐字默认设置都改善 2.2 到 4.0 个百分点,因为朗读者实际说的重复和自我修正不再算多写;Gemini Smart 反而变差 0.8 个百分点,区间为 -0.1 到 1.6,说明它删掉了参考中确实存在的口语成分。对脚本参考,Gemini Smart 比 ElevenLabs NV 清楚低 1.2 个百分点,置信区间为 0.6 到 1.9。
对口语参考,没有哪个清洗设置清楚领先。因此,“清洗更好” 只在“用户想收到准备发送的干净消息” 这个前提下成立。
延迟作为成本单独测量。从客户端发出音频结束信号到最终文本的中位等待为 313 到 760 毫秒;Meta、Deepgram、Whisper SH、Qwen 和两个 ElevenLabs 设置低于 400 毫秒,GPT-Live 和 RT Whisper 约 750 毫秒,整段上传的 Whisper-1 约 1,850 毫秒。该测量来自一个客户端位置、每个片段 1 次运行,重复运行可相差约 320 毫秒,部分服务在内容分发网络后端,因此只宜当作指示值。论文没有测用户实际修改文本所需时间,也没有把延迟换算成统一成本。
同一 Whisper 的九种运行方式
Whisper 案例把“模型” 固定到尽可能相同的起点,只改变托管、切段、语音活动检测和提交方式。9 种设置中,前 6 种使用两个自托管 Whisper Large V3 部署:一个部署在客户端侧开 Silero 门控并丢弃音频,关闭门控则发送全部音频;另一个自托管部署由客户端在 Silero 找到的停顿处切段,可选择只切分或同时丢弃。第五、6 种把 Silero 换成 TEN 检测器;第七到第 9 种分别是 OpenAI 实时 Whisper、整段上传的 Whisper-1,以及客户端用 Silero 切段后逐段上传的 Whisper-1。
耳语结果首先说明门控的作用。带客户端 Silero 门控的部署在门控开启时耳语 WER 为 80.7%,关闭门控为 61.1%,而且门控从未发送 16 条耳语中的 2 条;从另一侧看,自托管部署发送全部音频时为 10.1%,让 Silero 丢弃音频后升到 51.4%,其中 44.6% 的词被漏掉。TEN 丢弃音频时,自托管部署的耳语 WER 仍为 10.7%。在 EARS 的 107 名说话人上,全量发送为 11.5%,Silero 丢弃为 38.3%,TEN 丢弃为 14.4%,后者的 2.9 个百分点上升在统计上不能排除随机波动。
下面的图进一步看阈值。左面板是耳语 WER,中间面板是耳语 32 毫秒窗口中被称为语音的比例,右面板是 10 条无语音片段中写出任何文本的条数;3 个面板横轴都是 VAD 丢弃阈值。读图时要留意,右面板越低越好,而左面板和中面板的方向不同。
看图路径: 1. 先确认三个面板的横轴都是 VAD 阈值,而纵轴分别是耳语 WER、被判为语音的耳语窗口比例和无语音片段写入数。;2. 在左图比较 Silero 随阈值下降的有限改善与 TEN 的低而平稳曲线,再与正文给出的全量音频 10.1% 基线对照。;3. 在中图和右图看门控保留语音与写入无语音文本之间的取舍,不要把一次阈值扫描当作所有噪声条件的结论。
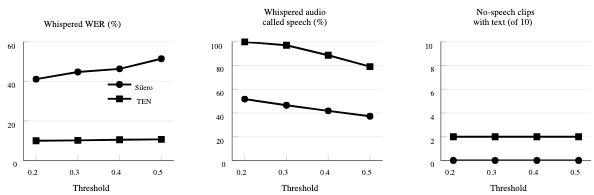
论文图 2。原论文 Figure 2::“Self-hosted Whisper with the VAD dropping audio, at four drop thresholds.”。
图中最明显的现象是:降低 Silero 阈值只能把耳语 WER 从默认附近的约 51% 降到约 41%,不能回到全量发送的 10.1%;TEN 的耳语 WER 在约 10% 到 11% 附近几乎平直。中图显示 TEN 在较低阈值下几乎把所有耳语窗口判为语音,Silero 只判约一半;右图显示 Silero 在 4 个阈值上都没有让无语音片段写出文本,TEN 则有 2 条。论文还报告 Silero 在 0.2 阈值时仍只把 52% 的耳语窗口判为语音,TEN 在默认阈值把 79% 判为语音。
因此差异来自门控是否保留了耳语,而不只是阈值调高调低。该图每个阈值只有 1 次运行,不能外推到所有噪声或所有检测器。
无语音片段上,Whisper-1 在全部 10 条都写出文本,主要是 you 和 Thank you for watching;自托管部署在 6 条写出零散的点号或 so,两条西班牙语片段还被整段替换成 Muchas gracias 之类的固定短语。加门控能减少无语音文本,却以漏掉耳语为代价,这说明“有文本” 和“文本正确” 之间存在取舍。
速度与准确率也互相牵制。Whisper-1 在 9 种设置中安静和耳语英文 WER 最低,分别为 5.5% 和 7.7%,但典型等待约 1,850 毫秒,并且在 10 条无语音片段上都产生了文本。RT Whisper 在其他语言上最低,平均 14.0%,等待约 735 毫秒,但只接受一种语言,在两语言录音中丢失一部分的比例为 11%。自托管全量发送的典型等待约 361 毫秒,却需要对切段和门控负责。关闭客户端门控的 gated 部署仍有 61.1% 的耳语 WER,漏词很多;自托管在停顿处切分时只漏约 1.8% 的耳语词,但两者是不同的部署,论文明确指出这不能单独隔离“切分方式” 的因果。
结论适用的边界与未测项
英文自有数据只有 106 条脚本消息、一个说话人,而且是朗读而非自发听写。固定说话人使系统差异不和嗓音混淆,朗读者也刻意混合了口音,但这仍不能代表多个说话人、自然停顿、犹豫和自我打断。英文置信区间按消息重采样,描述的是消息间变化,不是说话人总体;EARS 和 VOiCES 增加了 107 名和 100 名说话人,但都是公开朗读材料,EARS 还使用同一篇著名文章,系统可能在训练中见过,从而让干净语音分数偏高,也可能帮助耳语版本。
样本量限制也很实际。耳语自有数据只有 16 条,每个语言集只有 20 条,完整矩阵又包含 11 个系统、不同设置和语言,因此论文的表格更适合看模式和置信区间,不宜把每格小数当作稳定排序。论文对主要比较做配对区间和 Holm 校正;在单个语言集上,没有任何系统清楚领先。每个方言集只来自一个公开语料,方言差异和录音源差异无法分开;若要判断某个方言的系统差距,需要每个方言多个来源和未见过文本。
两套参考也不是无误差的真值。口语参考由系统共识提出、听者确认,因此可能偏向逐字系统;论文用留一系统重建检查,任一系统对自身重建参考的 WER 在任何条件下上升不超过 0.3 个百分点,使用更严格的预勾选阈值时最大上升 1.2 个百分点,来自 Meta 的安静英语。但 Gemini、Gemini Smart 和 ElevenLabs NV 的清洗设置排序并不稳定,没有 Gemini 的投票或使用更严格阈值时,领先方向会改变。名称由语言模型按规则标注,重音由分类器标注,自动语法和规则阈值都可复现但不等于人工逐词真值。
测试设置是各系统默认值加上论文列出的少量修改,结果代表开发者第 1 次遇到这些服务时的状态。托管系统会在 2026 年 10 月 1 日到 11 月 5 日之间变化,测试来自一个客户端位置,每个片段每个设置只跑 1 次;一周后重播 42 条时,gated Whisper 和 Gemini 文本相同,Meta 在回答的 41 条上 WER 为 16.5% 和 16.7%,说明短期重复性尚可,但不能保证现在的服务版本。论文只评最终文本和收尾等待,没有测临时文本稳定性、用户修改时间或商业成本。
最后,4 个层次是按输出位置命名的观察类别,不是已证明的内部模块。托管服务内部的语音检测、端点判断和模型不可见,因此漏词只能归到识别层;同一系统换一个客户端 VAD、提交频率或语言选项,结论可能改变。作者在论文中披露自己所在公司开发听写软件并开发自己的 ASR 模型,与部分被测供应商有商业关系,但没有供应商资助这项研究。
复现从哪里开始,哪些材料需要自备
论文声明测试客户端、评分与分析代码、生成各表的脚本以 Apache 2.0 许可发布;自有英文录音、两套参考、每个系统的转写以 CC BY 4.0 发布。外部语料的音频不随包重分发:EARS 和 VOiCES 需要按原许可自行获取,再按仓库脚本用公开片段重建两语言录音。转载或再发布时要分开看代码、录音与外部语料的许可,不能把外部语料当作随代码一起授权。
最小复现路径是先用已发布的英文安静、风扇、耳语和无语音片段跑通客户端,再重算 WER、格式化错误率和分层规则,最后才扩展到多语言和两语言录音。客户端按 32 毫秒块、16 kHz 发送;Meta、GPT-Live 和 RT Whisper 用 24 kHz,两个 AssemblyAI 和 Zoom 用 100 毫秒块。每个片段新会话,结束时等待最多 30 秒的最终文本。Qwen 自托管部署在一个 H100 MIG slice 上,Whisper SH 使用 Whisper Large V3 并让客户端切段。
Whisper SH 的 beam width 为 5,关闭临时文本。GPT-Live 使用低延迟,Deepgram 开启标点和 smart_format,Zoom 关闭文本清洗,ElevenLabs 默认手动提交 1 次。
复现时最重要的一步不是训练模型,而是固定输入和输出边界:确认服务当前版本、语言代码、端点设置、客户端 VAD 和提交频率,保存最终文本,不把临时文本混入评分。先用无语音片段检查是否凭空写文本,再用耳语和名称片段检查漏词与局部错词,最后用两语言录音检查缺失、罗马化和翻译。论文的一周重播检查表明短期文本有重复性,但服务会更新,因此每次比较都应记录日期和实际模型标识。
什么时候值得采用这套失败分类
如果任务只是安静环境下、单语言、内容普通的离线转写,标准 WER 配合基本标点检查可能已经够用,论文的多层分类不会自动带来更好的模型。相反,当系统要嵌入聊天、邮件、笔记或助手输入,用户需要直接发送文本,且错误会留在消息里时,这套分类就有实际价值:它把用户可能遇到的漏句、截尾、数字格式、专名、第二语言和文字系统分别显式化,便于设计验收用例。
耳语、多人说话、名称密集、数字密集和语言混合是优先测试的条件。本文最强的证据是耳语和双语设置:相近的安静 WER 在耳语下可以差出二十多个百分点;同样的语言选项在一部分系统上是过滤,在另一部分系统上只是偏好;应用更改提交频率就能把两语言丢失率大幅降低。这些结论不是“某模型全面更好” 的排名,而是提醒评测者把整个应用路径纳入比较。
如果要从这篇论文开始复现,第一步应是用固定音频和同一客户端重跑少量代表性子集,并把当前服务版本、客户端 VAD、端点和提交策略写入记录,再对照论文的最终文本和错误层。随后需要补充论文尚未覆盖的验证:多名说话人的自发听写、未在训练中出现过的耳语文本、每个方言的多个录音来源、临时文本稳定性,以及用户实际修改文本所需时间。没有这些测量,就不能把本研究的 WER 差异直接换算成真实产品收益,也不能假定更换系统一定修复所有共享错误。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:deepseek-v4.1-flash
评分请求协议:openai_responses