共分析 79 篇论文
⚡ 今日概览
✅ 筛选入选 79 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音识别 | 8 篇 | ████████ |
| 语音合成 | 7 篇 | ███████ |
| 音频理解 | 6 篇 | ██████ |
| 语音交互 | 4 篇 | ████ |
| 音乐分析 | 4 篇 | ████ |
| 音频编码 | 4 篇 | ████ |
| 多模态情感极性分析 | 3 篇 | ███ |
| 语音增强 | 3 篇 | ███ |
📊 论文评分排行榜(79 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 按任务选匿名策略:CASA 如何同时保隐私和保诊断信息

英文题目:Task-adaptive anonymisation enables privacy-preserving sharing of clinical speech data
评分:8.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ziyun Cui:Department of Electronic Engineering, Tsinghua University, Beijing 100084, China
- Haoyu Niu:Department of Electronic Engineering, Tsinghua University, Beijing 100084, China
- Wen Wu:Shanghai Artificial Intelligence Laboratory, Shanghai 200032, China
- Hao Sun:School of Computer and Communication Engineering, University of Science and Technology Beijing, Beijing 100083, China
- Sihan Zhang:Beijing Tsinghua Changgung Hospital, School of Clinical Medicine, Tsinghua Medicine, Tsinghua University, Beijing 100084, China
- Chang Lei:Vanke School of Public Health, Tsinghua University, Beijing 100084, China
- Yun Zhang:Peking Union Medical College Hospital, Beijing 100730, China
- Chunyun Sun:Peking University Huilongguan Clinical Medical School, Beijing 100096, China;Department of Clinical Psychology, Beijing Huilongguan Hospital, Capital Medical University, Beijing 100096, China;WHO Collaborating Center for Research and Training in Suicide Prevention, Beijing 100096, China
- Yang Luo:Peking University Huilongguan Clinical Medical School, Beijing 100096, China;Department of Clinical Psychology, Beijing Huilongguan Hospital, Capital Medical University, Beijing 100096, China;WHO Collaborating Center for Research and Training in Suicide Prevention, Beijing 100096, China
- Liangliang Cao:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong (SAR), China
- Ji Wu:Department of Electronic Engineering, Tsinghua University, Beijing 100084, China
- Runsen Chen:Vanke School of Public Health, Tsinghua University, Beijing 100084, China
- Lian Zhou:Peking Union Medical College Hospital, Beijing 100730, China;Chinese Academy of Medical Sciences, Beijing 100730, China
- Yongsheng Tong:Peking University Huilongguan Clinical Medical School, Beijing 100096, China;Department of Clinical Psychology, Beijing Huilongguan Hospital, Capital Medical University, Beijing 100096, China;WHO Collaborating Center for Research and Training in Suicide Prevention, Beijing 100096, China
- Chao Zhang:Department of Electronic Engineering, Tsinghua University, Beijing 100084, China;Shanghai Artificial Intelligence Laboratory, Shanghai 200032, China;Department of Speech, Hearing and Phonetic Sciences, University College London (UCL), London WC1N 1PF, United Kingdom
📌 核心摘要
临床语音同时携带说话人声纹和话语内容,朗读任务主要暴露声纹,自发交谈还可能暴露姓名、住址和电话等敏感语义信息,不同疾病依赖的声学、韵律和语言线索也不同,固定强度的匿名化难以兼顾隐私与临床可用性。论文提出的临床自适应匿名化智能体 CASA 接收任务描述、范式和隐私效用要求,先由控制器规划声纹与内容处理组合,再调用转写、匿名化和评测工具执行并根据反馈调整,跨任务记忆保留粗粒度的经验总结和细粒度的配置与结果以指导新任务。声纹侧提供音高变换、频谱共振峰缩放、基于线性预测编码的共振峰变换、神经语音转换和转写再合成五种操作,内容侧由本地部署的大语言模型定位敏感片段后做噪声替换或文本遮蔽。相对固定流程的差异在于策略按任务生成并迭代修正,而不是对所有数据套用同一管线。在 14 个任务上,CASA 全部满足等错误率不低于 20% 且疾病分类平衡准确率下降不超过 3 个百分点的联合要求,最强固定单方法只满足 8 个,完整系统基线 SecureSpeech 满足 4 个。结论适用于所测的抑郁、自杀风险、阿尔茨海默病、帕金森病、语言障碍和嗓音疾病等五种语言任务,开放式长对话的内容定位和严重病理语音的转写可靠性仍不充分。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/JaderOx/AnonymiseAgent — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 MUTE:只改音频,让说话人视频的口型对不上声音

英文题目:MUTE: Multi-Level Alignment Uncoupling Against Talking-Head Exploitation for Voice Protection
评分:8.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Donghyun Kim:Soongsil University
- Jin Hong:Chung-Ang University
- Seungmin Kim:Soongsil University;AIM Intelligence
- Dain Kim:Soongsil University
- Junseok Kwon:Chung-Ang University
- Daeseon Choi:Soongsil University
📌 核心摘要
说话人像视频生成以参考人像与语音为输入,输出口型表情与语音同步的视频,难点在于语音与视觉运动存在紧密跨模态对齐,单纯破坏可懂度难以可靠破坏口型同步。MUTE只修改音频波形,先提取代理Hallo的跨模态注意力图并将其推向按敏感度构造的目标分布,输出错位的结构对齐信号。再把该扰动后音频送入wav2vec 2.0编码器得到逐帧嵌入,并逐一推离原表示,得到时间维度偏离的语音表示。最后在短时傅里叶变换域把扰动约束到语音高能量时频区再经投影梯度下降迭代优化,前10%迭代优化对齐层面目标、剩余迭代优化表示层面目标以减少梯度冲突。在TalkingHead-1KH上以Hallo为代理生成对抗音频并评测生成视频时,MUTE的SyncNet得分1.332低于最强音频基线CAF的2.173,同步破坏更强且语音可懂度与感知质量保持最好。结论适用于以Hallo为代理、迁移到Hallo2、Audio2Head、SadTalker和Ditto的黑盒设定,以及下采样、谱滤波、Demucs、WavePurifier和自适应净化后仍有效,可选说话人层面目标能在一定程度上抑制基于文本到语音重合成的绕过,但会削弱一部分对齐破坏效果。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/jindl465/MUTE — 链接可访问(HTTP 200)
第三方资源:https://neurips.cc/public/guides/CodeSubmissionPolicy — 链接可访问(HTTP 200)
第三方资源:https://neurips.cc/public/EthicsGuidelines — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 还没说完就先认出来:Earlybird 如何提前预测单词
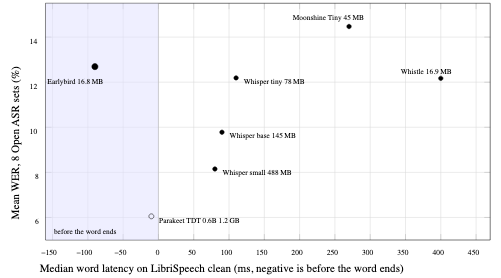
英文题目:Earlybird: Predictive Streaming Speech Recognition in 29M Parameters
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Sahil Mahendrakar:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式语音识别的输入是按80 ms逐段到达的语音,输出是随时间更新的屏幕文字,难点在于常用系统要等到词尾之后数百毫秒才敢确认,而语音助手希望在说话人还在说时就拿到可用的词并知道是否可信。Earlybird先把每条语音在随机80 ms切点截断得到训练音频,把该时刻到期词的完整拼写加结束符和后两词猜测作为目标送入解码器学习,再让Moonshine Tiny教师只在最高概率词块与标签一致的位置输出蒸馏损失来约束该学习,最后让编码器多看由静默算出的三个填充帧以补足收尾信息,切点目标只向后扩展以避免学会收回。置信度直接用产生该词的词块概率连乘得到,未做温度缩放。相对已有做法,该方法不改变架构且不使用未来音频,把预测放进小识别器内部,并同时报告提前量、稳定性和校准情况。在LibriSpeech test-clean的67条子集上,中位词在说话人结束前90 ms即被正确预测,而Moonshine Tiny官方流式运行为结束后270 ms,Whistle为结束后400 ms。在8个英文Open ASR集合的约200条每集评测中,4位Earlybird平均词错率为12.6%,与同尺寸Whistle的12.2%大致相当并在五集上更优。结论适用于英文朗读、演讲和合成语音等已测范围,背景人声和域外命令语音下会失效。训练在单GPU上以批量48分四阶段完成约4万步,单CPU线程每80 ms步平均耗时39 ms,约为两倍实时。
🔗 开源资源
- 模型相关资源:https://huggingface.co/sahilmahendrakar/Earlybird-29M — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. WaveGen:直接从文本生成波形的端到端语音合成

英文题目:WaveGen: Truly End-to-End Waveform Generation via Internal Spectral Trajectory Learning
评分:8.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sang-Hoon Lee:Department of Artificial Intelligence, Ajou University, Suwon, Korea
- Ha-Yeong Choi:Frontier AI Lab, KT Corp., Seoul, Korea
📌 核心摘要
零样本语音合成需由文本与短提示语音直接生成音色一致的输出波形,难点在于24,000 Hz原始波形时间分辨率很高,文本与语音难以在高维波形空间直接对齐。WaveGen为此引入内部频谱轨迹作为辅助生成目标,先将加噪波形和加噪内部频谱表示拼接后送入共享模块学习文本语音对齐,共享模块输出的对齐表示再被两个浅层分支接收并分别精修波形轨迹与频谱轨迹,最后用平均上采样的文本嵌入提供条件以稳定端到端优化。与依赖声码器、神经音频编解码器或隐变量模型及外部时长预测器的级联管线不同,该单模型同时学习波形与频谱轨迹,避免了中间表示约束与级联误差传递。训练时模型先预测干净目标,再换算到速度空间计算波形与频谱损失,并增加多分辨率频谱加权项平衡多分辨率时间频率优化,推理时用欧拉法迭代去噪得到波形。在Seed-en基准上,0.6B的WaveGen取得词错率1.47、说话人相似度0.75,优于表中同量级Qwen3-TTS 0.6B的1.68和0.70。该结论适用于公开Emilia数据和单阶段训练条件,MP3压缩数据的高频细节仍受限。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/sh-lee-prml/WaveGen — 链接可访问(HTTP 200);README 已验证包含安装、推理与微调文档
第三方资源:https://github.com/SparkAudio/Spark-TTS — 链接可访问(HTTP 200)
第三方资源:https://github.com/AmphionTeam/TaDiCodec — 链接可访问(HTTP 200)
第三方资源:https://github.com/SWivid/F5-TTS — 链接可访问(HTTP 200)
第三方资源:https://github.com/k2-fsa/ZipVoice — 链接可访问(HTTP 200)
第三方资源:https://github.com/FunAudioLLM/CosyVoice → https://github.com/QwenAudio/CosyVoice — 链接可访问(HTTP 200)
第三方资源:https://github.com/QwenLM/Qwen3-TTS — 链接可访问(HTTP 200)
第三方资源:https://github.com/OpenMOSS/MOSS-TTS — 链接可访问(HTTP 200)
第三方资源:https://github.com/microsoft/VibeVoice — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/microsoft/VibeVoice-Realtime-0.5B — 链接可访问(HTTP 200)
第三方资源:https://github.com/OpenBMB/VoxCPM — 链接可访问(HTTP 200)
第三方资源:https://github.com/openai/whisper — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 同一批流行歌上同时标注乐句、段落、和弦与节奏:FaiSonic MMD 做了什么

评分:7.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.5/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Tieyao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuke Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaxing Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinda Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Genfang Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音乐时间分析输入完整流行录音,输出乐句边界、段落边界与功能、和弦标签以及节拍与强拍位置,难点在于同一录音内不同维度粒度不同且边界不对齐,分开标注难以直接比较同一时刻的和声、节拍与结构信息。论文组织一位专家完成单曲四维初标,再由另一位专家全曲复听核查并结合自动检查回修,所有事件与区间统一以同一录音起点为零点保存,从而保留各自边界又可在共享时间轴上叠加对比。基线先将录音切分为连续无重叠的30秒窗口,提取冻结的MuQ第6层与MusicFM第7层特征并沿时间拼接为全曲序列,再跨通道拼接后送入线性层与共享卷积,输出256维共享表示。再将该表示经任务门控送入四个分支,分别输出乐句与节奏的高帧率预测以及降采样后上采样恢复的和弦与段落预测。最后各类预测送入结构化解码,节拍与强拍经校准阈值与非极大抑制输出,乐句与段落边界经逻辑回归校准与动态规划输出,段落功能与和弦经维特比解码输出,且和弦解码以预测节拍为软支撑。在400首训练、50首验证、50首测试的固定划分且解码参数在验证集拟合后冻结评测的设置下,与仅用该划分训练相比,将同类专家标注训练扩至2350首而验证与测试集不变后,节拍F1由86.18%升至87.97%、强拍F1由81.40%升至84.48%,和弦Root由80.16%升至83.52%,乐句边界在3秒容差下F1由79.18%升至80.24%。与已有侧重结构加节拍或和弦加边界的组合相比,该工作把独立乐句作为预测目标并同时覆盖四维标注,结论目前仅在中英文流行录音的该固定划分上验证,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/Kreuzter0421/FaiSonic-MMD — 链接可访问(HTTP 200)
数据相关资源:https://github.com/Kreuzter0421/FaiSonic-MMD — 链接可访问(HTTP 200)
第三方资源:https://github.com/Kreuzter0421/FaiSonic-MMD — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. Emilia2:面向可控长时语音生成的大规模数据集

英文题目:Emilia2: A Large-Scale Dataset for Controllable Long-Form Speech Generation
评分:7.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Qinke Ni:机构信息未能在本次解析中与作者逐人可靠绑定
- Dekun Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Junwen Qiu:机构信息未能在本次解析中与作者逐人可靠绑定
- Huan Liao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xu Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xingwen Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Wan Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Kunyu Feng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yusheng Mu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chaoren Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingda Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingjie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Haolong Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Xulin Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Mark A. Hasegawa-Johnson:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhizheng Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
长语音合成要求在数分钟到30分钟内保持文字对齐、说话人身份、轮次顺序、停顿衔接和表现风格稳定,短句拼接常出现音色漂移和韵律断裂,而已有公开训练数据多为30秒以内片段,公开且带每说话人参考音频的长基准最多覆盖两名说话人。Emilia2先从播客、直播、访谈、公共谈话、影视解说、体育和游戏等野外录音经人声分离、说话人日志和端点切分输出带说话人标记的连续区间,再经质量过滤、语言识别和转写送入区间组织,构建可互相定位的短句、单人长语音和多人对话三种视图并保留原始停顿与声学过渡。最后对5分钟以内片段提取感知年龄性别、口音、音高、情感、语速响度等属性送入Qwen3-Omni-30B-A3B-Captioner生成风格说明,并用Multilingual-NVASR把笑声、咳嗽、叹息等非言语发声与文字交错转写为标记。与已有短句语料相比,关键差异是显式建模说话人切换、把指令监督扩展到长上下文和多人对话。在TTSD-Eval评测中,0.6B非自回归模型的中文字符错误率5.27%和英文词错误率9.93%,低于所有参评对比系统。在InstructTTSEval评测中,自回归模型的中英文评分分别为76.2/78.3,与Qwen3-TTS-12Hz-VD的77.1/77.9相当。结论适用于中英文长叙述和对话的内容与风格控制,多语言与更长时长的泛化仍需验证,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://charlesnii.github.io/Emilia2-demo/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/audeering/ → https://huggingface.co/audeering — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/tiantiaf/wavlm-large-age-sex — 链接可访问(HTTP 200)
第三方资源:https://github.com/interactiveaudiolab/penn — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. Alania-2:土耳其语语音合成如何读对数字并克隆声音
英文题目:Alania-2: Turkish text-to-speech with instant and fine-tuned voice cloning
评分:7.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Sezgin Saygili:机构信息未能在本次解析中与作者逐人可靠绑定
- Emre Kaplaner:机构信息未能在本次解析中与作者逐人可靠绑定
- Oncel Ozgul:机构信息未能在本次解析中与作者逐人可靠绑定
- Fikri San Koktas:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
Alania-2处理土耳其语文本到语音合成,输入书写土耳其语文本,输出48 kHz连续音频,用于电话语音助手和长篇朗读。实际难点是数字、金额、日期和外来品牌名读出时须展开并接上符合元音协调的格后缀,带点与不带点i易被按英语设计的大小写转换破坏,且电话场景要求低延迟和稳定音色。先由文本改写模块把数字、金额、日期、缩写和外来名改写为说话人实际会说出的词语序列并调整后缀元音,再把改写后文本送入语言模型主干结合扩散变换器逐块预测声学隐变量,最后由冻结音频变分自编码器解码为音频。与延续参考音频的克隆做法不同,该系统只用参考音频设定音色而不给出其转写文本,从而避免长参考导致的跳词,20–30秒参考效果最好,专业克隆再以低秩适配器微调提升音色相似度。经由应用编程接口,Alania-2在公开的Freya-TR-Eval基准495句上达到1.44%词错率,相对上一代系统的5.99%词错率明显下降。无改写器时96个含数字句无一句关键金额或日期完整保留,有改写器时86句保留;仅以参考音频为条件把跳词从21.9%降至1.7%。原文披露约210 H200小时用于模型训练且不含数据生成,推理侧单流首包音频在工作机上可低至32 ms。适用范围集中在土耳其语固定文本朗读和短参考克隆,尚未经多听众主观听音测试,自然度仅以英语训练的UTMOS22衡量。
🔗 开源资源
第三方资源:https://huggingface.co/cloud0day3/antalia-mini — 链接可访问(HTTP 200)
数据相关资源:https://huggingface.co/datasets/cloud0day3/alania-speech-captions-tr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/cloud0day3/alania-synthetic-speech-tr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/cloud0day3/alania-domain-text-tr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/PatientdeskAI/freya-tr-eval-rerun — 链接可访问(HTTP 200)
第三方资源:https://speech.patientdesk.ai → https://speech.patientdesk.ai/en — 链接可访问(HTTP 200)
第三方资源:https://github.com/SYSTRAN/faster-whisper — 链接可访问(HTTP 200)
第三方资源:https://github.com/cmusphinx/cmudict — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 多人长对话怎么逐人识别:Pandemonium 的条件、交互与长窗解码

英文题目:Pandemonium: Longform Target-Speaker Speech Recognition with Cross-Speaker Interactions
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Alexander Polok:机构信息未能在本次解析中与作者逐人可靠绑定
- Dominik Klement:机构信息未能在本次解析中与作者逐人可靠绑定
- Ivan Medennikov:机构信息未能在本次解析中与作者逐人可靠绑定
- Antoine Laurent:机构信息未能在本次解析中与作者逐人可靠绑定
- Petr Pálka:机构信息未能在本次解析中与作者逐人可靠绑定
- Samuele Cornell:机构信息未能在本次解析中与作者逐人可靠绑定
- Shinji Watanabe:机构信息未能在本次解析中与作者逐人可靠绑定
- Sanjeev Khudanpur:机构信息未能在本次解析中与作者逐人可靠绑定
- Jagadeesh Balam:机构信息未能在本次解析中与作者逐人可靠绑定
- Jan Černocký:机构信息未能在本次解析中与作者逐人可靠绑定
- Lukáš Burget:机构信息未能在本次解析中与作者逐人可靠绑定
- Matthew Wiesner:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入是几分钟到几十分钟含重叠与轮流发言的单麦克风会议音频,输出是按说话人区分的文字记录,难点是重叠帧归属不清且长距离上下文难以一次处理,已有方法把每个说话人孤立解码。论文先把分离标注给出的逐帧说话人活动概率组合成静音/目标/非目标/重叠四类事件掩码,再用帧级条件变换调制编码器,使同一识别器每次只转写一个目标说话人。再把该条件机制从短窗Whisper骨干搬到可一次处理整场会议的Parakeet骨干并把多路说话人流作为批量处理,最后在选定层加入跨说话人注意力让同帧不同说话人表示互相参考,并用掩码精炼器重新估计活动概率以修正模糊条件。训练按合成混合、伪标注野外数据、真实会议三阶段组织,其中伪标注用分离标注加已有系统转写野外多说话人音频得到。与基线DiCoW v3.3相比,在多个会议基准平均、贪婪解码下,Pandemonium串联最小置换词错率在Oracle分离标注下从16.3%降到14.7%,在预测分离标注下从20.0%降到19.2%。结论适用于单麦克风英文会议评测,多麦克风合并需对每个远场麦克风单独解码再合并,长语音贪婪解码下Pandemonium实时率330倍,低于同条件CTC基线的405倍但精度更高。
🔗 开源资源
第三方资源:https://hf.co/BUT-FIT → https://huggingface.co/BUT-FIT — 链接可访问(HTTP 200)
第三方资源:https://www.pyannote.ai/blog/precision-3 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 用三点六五亿条音频文本对做对比学习:LAION-Audio-XL 如何搭数据与测缩放

英文题目:LAION-Audio-XL: A Web-Scale Corpus and Scaling Studies for Contrastive Language-Audio Pretraining
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Gijs Wijngaard:Jülich Supercomputing Center (JSC), Forschungszentrum Jülich (FZJ);LAION
- Felix Förster:Technical University of Munich, MCML
- Ross Wightman:LAION
- Marianna Nezhurina:Jülich Supercomputing Center (JSC), Forschungszentrum Jülich (FZJ);LAION
- Christoph Schuhmann:LAION
- Jenia Jitsev:Jülich Supercomputing Center (JSC), Forschungszentrum Jülich (FZJ);LAION
- A. Sophia Koepke:Technical University of Munich, MCML;University of Tübingen, Tübingen AI Center
📌 核心摘要
对比语言音频预训练要把一段音频和描述它的文字映射到同一向量空间,以便做文本找音频、音频分类和条件生成,难点是音频来源杂、时长差异大、文字缺失多且重复拷贝会污染评测。作者先收集网络与公开集合的原始音频并输出可解码候选,再经过精确去重、声纹与语义去重和评测泄漏筛查输出洁净候选,最后用声音分类体系筛选保持覆盖并对缺文字样本生成长短字幕送入训练。音频编码器用可变长视觉变换结构改成的音频编码器处理对数梅尔谱块,文本编码器用双向变换结构,两者用对称对比目标从零联合训练。相对依赖预训练主干和较小混合来源的已有对比音频文本模型,该工作统一了数据规模、筛选记录和从零训练的缩放分析。在MAEB-30评测下,与同类最强的对比基线GLAP相比,CLAP2-L在MAEB-30平均分指标上以53.6%超过44.1%。在MAEB评测和128M样本训练设置下,短长字幕各半混合训练的模型在MAEB平均分指标上以39.1%高于只用短字幕训练的38.6%。去掉120秒时长桶前后相比,单样本训练成本指标从1.94×10¹² FLOPs降至0.56×10¹² FLOPs。结论适用于30秒截断评测和网络音频分布,声音子域在较大算力后趋于饱和,超过1024M样本和更大模型的趋势尚未验证。
🔗 开源资源
- 第三方资源:https://projects.laion.ai/clap2 → https://projects.laion.ai/clap2/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. Nemotron 3 Diarization:把流式说话人日志推到八人、10 毫秒与更高吞吐
英文题目:Nemotron 3 Diarization: Advancing the Accuracy-Efficiency Frontier in Streaming Speaker Diarization
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Ivan Medennikov:机构信息未能在本次解析中与作者逐人可靠绑定
- Taejin Park:机构信息未能在本次解析中与作者逐人可靠绑定
- Tatiana Timofeeva:机构信息未能在本次解析中与作者逐人可靠绑定
- He Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Alexander Polok:机构信息未能在本次解析中与作者逐人可靠绑定
- Sofia Kostandian:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiqing Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Dongji Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jagadeesh Balam:机构信息未能在本次解析中与作者逐人可靠绑定
- Boris Ginsburg:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是流式说话人分离标注,输入是连续会议录音,输出是谁在何时说话的时间线,难点是在只有有限右侧上下文时保持跨分块的说话人身份一致,同时处理重叠语音和新说话人进入。先把输入特征堆叠到80毫秒步长送入31层Transformer编码器提取粗粒度声学表示,编码器输出的80毫秒表征再送入一维亚像素卷积上采样为10毫秒序列,上采样输出送入输出头产生每个说话人通道的语音活动。到达顺序说话人缓存接收跨分块的说话人证据以固定通道顺序,训练同时用排列无关损失和到达时间排序监督通道分配,并增加整体活动分类和抑制空通道误激活的辅助损失。相对前代四说话人系统,关键差异是取消卷积前端、提高输出分辨率、扩大缓存并引入可变上下文训练,使同一模型支持离线到超低延迟推理。在DIHARD III评测集上,30.4秒输入缓冲时新系统说话人分离标注错误率DER为12.73%,低于前代基线的19.09%。结论适用于1到8人混合、公开会议与电话域,0.32秒延迟下误差会上升0.79到3.53个百分点,训练使用64块A100,推理吞吐最高可达前代6.4倍。
🔗 开源资源
第三方资源:https://github.com/NVIDIA-NeMo/Speech — 链接可访问(HTTP 200)
第三方资源:https://github.com/NVIDIA-NeMo/Speech/blob/main/examples/speaker_tasks/diarization/conf/neural_diarizer/sortforme — 链接不可用(HTTP 404)
第三方资源:https://github.com/NVIDIA-NeMo/Speech/blob/main/examples/speaker_tasks/diarization/conf/neural_diarizer/sortformer_streaming_8spk.yaml — 链接可访问(HTTP 200)
第三方资源:https://hf.co/nvidia/Nemotron-3-Diarization → https://huggingface.co/nvidia/Nemotron-3-Diarization — 链接可访问(HTTP 200)
第三方资源:https://www.withdavid.ai/#datasets — 链接可访问(HTTP 200)
第三方资源:https://github.com/popcornell/FastMSS/blob/master/resources/notsofar1-channels_mfa_rttms.tar.gz — 链接可访问(HTTP 200)
第三方资源:https://github.com/popcornell/FastMSS — 链接可访问(HTTP 200)
第三方资源:https://github.com/nttcslab-sp/diar-forced-alignment — 链接可访问(HTTP 200)
第三方资源:https://hf.co/nvidia/diar_streaming_sortformer_4spk-v2.1 → https://huggingface.co/nvidia/diar_streaming_sortformer_4spk-v2.1 — 暂时无法访问
第三方资源:https://hf.co/BUT-FIT/diarizen-wavlm-large-s80-md-v2 — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 小参数如何同时做好多语多方言合成与流式克隆:M5-TTS 解读

评分:7.2/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Wenhao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingbin Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengming Ling:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaming Ren:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinrui Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanke Xie:机构信息未能在本次解析中与作者逐人可靠绑定
- Qirui Zhan:机构信息未能在本次解析中与作者逐人可靠绑定
- Guobin Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Huakang Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Chunbo Hao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianguo Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenkang Hou:机构信息未能在本次解析中与作者逐人可靠绑定
- Dake Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuepeng Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Linhan Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunxiang Chen:Shenzhen Pimei Technology Co., Ltd.
- Houdun Liu:Shenzhen Pimei Technology Co., Ltd.
- Su Feng:Shenzhen Pimei Technology Co., Ltd.
- Chuang Ding:Moonstep AI
- Pengcheng Zhu:WeNet Open Source Community
- Liumeng Xue:机构信息未能在本次解析中与作者逐人可靠绑定
- Lei Xie:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要解决的是紧凑语音合成:在终端算力下把文字和少量参考语音变成可懂、音色一致、可流式播放的波形,难点是小模型容易丢字错字、韵律生硬、多语言方言覆盖不足。M5-TTS先把波形压缩为每秒12.5帧、每帧16个码本索引的离散表示,时间主干网络按帧预测第0个码本并输出隐状态,再由局部多词元预测模块在帧内逐个生成其余15个码本,最后送入因果声码器增量重建波形以支持流式合成。训练先用约40万小时多语言数据学习文本到语音映射,再用约6.5万小时精选数据加强质量与难发音覆盖,最后用分组相对策略优化把组内分别归一化的整体相似度与停顿奖励加权求和,并叠加字符级错误在子句内反传再投影到码本帧的局部反馈。在Seed-TTS语音克隆评测中,50M语言模型的M5-TTS GRPO版本内容错误率低于100M语言模型的MOSS-TTS-Nano,Seed-ZH字符错误率以1.37%对3.62%更低,Seed-EN词错误率以2.91%对4.50%更低。在MiniMax六语语音克隆中M5-TTS GRPO版本内容错误率在五语上低于MOSS-TTS-Nano,但中文字符错误率以2.05%对1.80%高于后者,在Seed-Hard上也以17.48%对15.77%高于后者。在4核Intel Xeon Gold 6530上流式开销为实时率0.653、热启动首块延迟225毫秒,结论适用于标准中英文与多数参评语言,困难中文与高表现力音频质量仍有限。
🔗 开源资源
第三方资源:https://github.com/ASLP-lab/M5-TTS — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/ASLP-lab/M5-TTS — 链接可访问(HTTP 200)
第三方资源:https://aslp-lab.github.io/M5-TTS-Demo-Page → https://aslp-lab.github.io/M5-TTS-Demo-Page/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/spaces/ASLP-lab/M5-TTS-Space — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 机器听觉:音频大模型能听懂人耳听不到的信号吗

英文题目:Machine Hearing: Can Audio LLMs Generalize Beyond Human Auditory Perception?
评分:7.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Liwei Liu:Shanghai Artificial Intelligence Laboratory;Harbin Institute of Technology
- Jun Tao:Shanghai Artificial Intelligence Laboratory;University of Science and Technology of China
- Xingyuan Li:Shanghai Artificial Intelligence Laboratory;Fudan University
- Xuenan Xu:Shanghai Artificial Intelligence Laboratory
- Chen Zhang:Shanghai Artificial Intelligence Laboratory;Tsinghua University
- Junyi Wang:Shanghai Artificial Intelligence Laboratory;Shanghai Jiao Tong University
- Boya Zhang:Shanghai Artificial Intelligence Laboratory;Shanghai Jiao Tong University
- Xiaoyu Yang:University of Cambridge
- Zhen-Hua Ling:University of Science and Technology of China
- Wen Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chao Zhang:Shanghai Artificial Intelligence Laboratory
📌 核心摘要
本文研究音频大模型能否理解人耳听不到的物理信号,输入是采样率从约十万分之一赫兹到数兆赫兹、长度从几十到上百万采样点、包含单通道与双通道的传感器波形,输出是在每个任务预先给定的类别集合中生成文字类别标签。难点在于现有音频前端按语音音乐设计,对超低采样光变曲线、兆赫兹射频和极短片段经常无法识别输入或违反格式。作者建成包含七个领域十三项分类任务的机器听觉基准,用统一文字指令评测七个开源与闭源音频大模型和五个领域基础模型,再以问答式分类比较零样本、有监督适配与扩展编码器的效果。所提MachEar先用快速傅里叶变换分支提取频谱特征并用一维卷积分支提取时间特征,再把两路特征对齐到固定数量的紧凑token。最后把该紧凑token与原有语音编码器输出及文字指令拼接后送入大语言模型,同一结构用于全部任务而不再按领域修改。在Qwen2.5-Omni-7B上联合微调原编码器与MachEar后,加权平均Macro-F1从67.02%提高到72.30%,提升主要来自原来失败集中的短序列与极端采样率任务。结论适用于该基准的十三项分类任务与所用适配数据量,超长工业振动截断到240000点、多通道展平与部分频段重采样等处理可能影响推广,原文未披露训练、推理或部署成本。
🔗 开源资源
数据相关资源:https://huggingface.co/datasets/OpenTSLab/MachineHearing — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen2.5-Omni-3B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen2.5-Omni-7B — 链接可访问(HTTP 200)
第三方资源:https://github.com/NVIDIA/audio-flamingo — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/nvidia/audio-flamingo-3 — 链接可访问(HTTP 200)
第三方资源:https://ai.google.dev/gemini-api/docs/models/gemini-3-flash-preview → https://aistudio.google.com/docs/models/gemini-3-flash-preview — 链接可访问(HTTP 200)
第三方资源:https://developers.openai.com/api/docs/models/gpt-audio-mini — 链接可访问(HTTP 200)
第三方资源:https://www.volcengine.com/product/doubao/ — 链接可访问(HTTP 200)
第三方资源:https://www.volcengine.com/docs/82379/1795150 → https://docs.volcengine.com/docs/ark/seedream-3-0-prompt-guide?lang=zh — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Maple728/TimeMoE-200M — 链接可访问(HTTP 200)
第三方资源:https://github.com/ChunyuLiu188/SpectrumFM — 链接可访问(HTTP 200)
第三方资源:https://github.com/liutianlin0121/seisLM — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. LongCap:用分块交错生成做小时级带时间戳音频描述

英文题目:LongCap: Hour-Scale Timestamped Audio Captioning via Chunk-wise Processing
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.4/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jinchuan Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Sen Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenbin Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Chao Weng:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhengwei Huang:Independent ResearcherEqual contribution Project lead
- Jiatong Shi:Independent ResearcherEqual contribution Project lead
- Yichen Lu:Independent ResearcherEqual contribution Project lead
- Haoran Wang:Language Technologies Institute, Carnegie Mellon University
- Shinji Watanabe:Language Technologies Institute, Carnegie Mellon University
- Cong Zhou:Independent ResearcherEqual contribution Project lead
📌 核心摘要
读者面对的是一到两小时含说话、音乐和环境声的连续录音,任务要求输出每个声音事件的开始结束时间与内容,整段先编码再一次性生成会让靠后事件依赖远距离检索,短录音训练的模型在更长输入上容易退化。LongCap先把录音切成连续不重叠小块并交错排列音频块与事件标签,每个标签只收录在该块内结束的事件且时间戳写成相对块起点的值,再让历史音频块与已生成标签保留在上下文中供当前块条件生成,最后用相对时间与局部发射减少长度偏置并支持百万词元上下文外推。预训练先用20分钟以内语音识别与说话人分离数据学时间定位,再用30秒以内自然语言描述学声音属性并混入长文本保持长上下文能力。微调先用大模型给15k小时短录音打结构化标签并用事件级重标注补齐块内靠后细节,再可选扩展到40分钟录音与显式事件依赖标注。在LongCapBench-TAC-Long全部4段全量录音评测中,35B-A3B自蒸馏后相比自蒸馏前时间线错误率从44.84%降至41.09%,字幕相似度从50.85%升至51.24%。在LongCapBench-TAC-Short全部1500个短片段评测中,35B-A3B自蒸馏后相比自蒸馏前时间线错误率从13.01%降至12.42%。结论适用于中英文电影与节目混合录音,尾部稀疏窗口覆盖录音减少且音乐颗粒度误差仍高,原文披露了128卡H100、每步约4M词元、10万步预训练与两轮微调的训练规模,未披露推理延迟与单次长录音解码成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. AudioCodex:面向实时交互的流式连续音频自编码器
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Marco Pasini:机构信息未能在本次解析中与作者逐人可靠绑定
- Javier Nistal:机构信息未能在本次解析中与作者逐人可靠绑定
- Cyran Aouameur:机构信息未能在本次解析中与作者逐人可靠绑定
- Stefan Lattner:机构信息未能在本次解析中与作者逐人可靠绑定
- George Fazekas:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
实时生成需要把立体声波形压成低速率连续隐序列再流式还原,难点是保真隐变量难建模、易建模隐变量又丢失细节。AudioCodex先把输入波形转成对数幅度谱并做均值方差归一化,双通道按特征图堆叠,再用时间因果卷积在时间和频率下采样,得到时间分辨率约10 Hz的特征帧。每个特征帧附加的8个可学习概要嵌入被送入沿频率轴独立作用的Transformer,只保留更新后的概要嵌入经瓶颈投影输出连续隐向量,训练时做均方根归一化并约束到超球面附近。解码侧先由上采样器把低速率隐变量升到谱图形状并送入生成器,生成器输入拼接该条件表示与高斯噪声,上采样器中间特征多分辨率注入带跳跃连接的U形结构,最后由因果对抗相位估计器从真实对数幅度谱和噪声输出每频点余弦正弦对并归一化恢复相位。在与基线同协议比较中,256维配置重建Fréchet Audio Distance为0.593,低于Music2Latent的0.943,生成Fréchet Audio Distance为4.168,低于Music2Latent的5.241与Stable Audio Open的9.518,其中该指标越小越好,参考集为四个评测域的真实分布。幅度自编码器约150M参数,以批量72在3块A100上训练500k次,相位估计器约70M参数;在单块A100上用torch.compile测48 kHz立体声,单步流式解码约41.38 ms处理一帧,实现约2.06倍实时,10 s整段解码可达约114.1倍实时。结论适用于44.1 kHz立体声通用音频的流式编码,非因果版本重建仍更好,长时生成能力尚未验证。
🔗 开源资源
- 第三方资源:https://sonycslparis.github.io/audiocodex-companion → https://sonycslparis.github.io/audiocodex-companion/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 统一音频编辑为什么总改错对象:早期轨迹如何决定选择与如何纠偏

英文题目:Steer Unified Audio Editing Toward Reliable Source Selection
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Youquan Fu:机构信息未能在本次解析中与作者逐人可靠绑定
- Dongnuan Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- Henghui Du:机构信息未能在本次解析中与作者逐人可靠绑定
- Yujia Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ping Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Quande Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yake Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Xi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongyuan Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Di Hu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
统一音频编辑的输入是参考音频加文字指令,输出是按指令改写目标来源并保留其余内容的音频,难点在于模型常改错对象、漏改目标或连带改动非目标。论文先把中间带噪状态按当前速度外推到零噪声端并解码,观察到错误选择在前几步已可分辨,再用正确与错误前缀替换验证早期轨迹对最终结果的决定作用。针对这一现象,STEER-Emphasis 让选择性任务更多采样高噪声早期区间以减少错误形成,STEER-Recovery 从自生成 rollout 状态出发学习指向正确目标的修正速度以挽回残余偏离。应用于自研六任务基座得到 SteerSound,在复杂音频编辑测试集上覆盖全部六个任务并在除生成外的五个任务取得最优主指标。在选择性音频编辑基准上,基座总体成功率从 70.42% 升至 85.78%,选择性错误率从 28.48% 降至 8.45%,人类评测总体成功率从 88.50% 经 Emphasis-only 的 92.33% 升至 93.67%。结论适用于所测的类别级移除、替换、音高和音量编辑,以及转录文本条件的话者移除与分离,超出受控双源非重叠布局和所用数据分布的可靠性尚未验证。原文未披露训练、推理或部署成本实测。
🔗 开源资源
第三方资源:https://github.com/GeWu-Lab/SteerSound — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/GeWu-Lab/SteerSound — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/GeWu-Lab/SteerSound — 链接可访问(HTTP 200)
第三方资源:https://gewu-lab.github.io/SteerSound/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 纯噪声上加引导为何在两步语音合成里丢掉音色

英文题目:Guidance at Pure Noise Erodes Speaker Similarity in Few-Step Token-Conditioned Flow-Matching TTS
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jaeho Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Han-Lim Choi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
零样本语音合成先由语言模型输出离散语音口令标记,再由流匹配解码器结合说话人提示合成梅尔频谱图,少到两步欧拉求解时词错率不变而说话人相似度下降约一到六点。困难在于纯噪声起点不携带输出信息,网络只能返回给定口令标记与提示下的条件均值,分类器无关引导把全部轨迹沿同一方向推出均值之外,后续步骤不能消除。论文推导第一步位移与步长成正比,先让首步不引导采样输出无偏移的中间状态,再把该状态送入后续步骤只用条件速度求解,最后用中点变体把两步欧拉换成一次中点步并在中间点恢复引导。与保留首步引导的已有调度相比,该做法去除了首步引导项而保留有用引导。在Seed-TTS-eval英文集上,CosyVoice 2说话人相似度由两步官方引导的68.86恢复到中点变体的74.87,高于十步教师的74.70,网络函数求值由20次降到3次。结论适用于口令标记条件且条件均值离散度小于引导幅度的解码器,文本条件解码器首步仍需建立对齐,蒸馏模型与图像视频生成器尚未验证。原文披露了流式首包延迟与吞吐测量。
🔗 开源资源
- 第三方资源:https://github.com/16jhlee/FSU — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. Walrus:靠数据工程做统一语音音频大模型

评分:7.1/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Alkis Koudounas:机构信息未能在本次解析中与作者逐人可靠绑定
- Osamu Take:机构信息未能在本次解析中与作者逐人可靠绑定
- Hayato Futami:机构信息未能在本次解析中与作者逐人可靠绑定
- Quentin Jodelet:机构信息未能在本次解析中与作者逐人可靠绑定
- Emiru Tsunoo:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
实际应用常在一段音频里同时遇到转写、翻译、说话人区分、情绪与背景声描述,单独训练多个模型会增加部署成本并让误差逐级传递。Walrus 要用同一套权重处理识别、翻译、合成与理解,输入是语音或音频加自然语言提示,输出是文字或离散语音 token,难点在于混合语和重叠说话人稀缺、长输出任务容易压住识别任务、娱乐音频质量差异大。做法上先用大规模多语 clean 数据建立识别核心,再加入重叠说话人、混合语、时间戳与对话上下文数据,最后加入娱乐、低资源语言、更多混合语和翻译数据,全程用任务权重与数据集采样权重控制配比。骨干保持解码器结构不变,语音输入由 USM 编码器转成连续表示,语音输出走 25 Hz 单码本量化加 Vocos 声码器。相对已有语音大模型,差异不在改架构,改进来自转写修复、合成混合语、仿真多说话人、挖掘平行文本与拼接待标注场景等管线。在 FLEURS 多语识别上 Walrus-R 平均词错率 5.33%,优于 4 倍规模 Qwen3-Omni-30B 的约 6.2% 和 Whisper Large-v3;在 CS-FLEURS 朗读混合语上字符错率 7.23%,远低于最强同级基线 Gemma 4 的 32.30%。结论适用于 30 秒以内片段和报告所列语言与评测集,重叠自然对话绝对误差仍高,情绪与字幕任务未领先。训练成本为 128 张 NVIDIA H100 上约 30 天,约 92000 GPU 小时。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. GlobalTap:用众包拍点为多样音乐做节拍标注
英文题目:GlobalTap: Globally Diverse Beat Tracking Benchmark via Crowdsourced Tapping
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- William T. Botticelli-Wells:机构信息未能在本次解析中与作者逐人可靠绑定
- Manuel Anglada-Tort:机构信息未能在本次解析中与作者逐人可靠绑定
- Elif Celen:机构信息未能在本次解析中与作者逐人可靠绑定
- Rena Far:机构信息未能在本次解析中与作者逐人可靠绑定
- Harin Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Peter M. C. Harrison:机构信息未能在本次解析中与作者逐人可靠绑定
- Nori Jacoby:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
节拍跟踪要为一段录音输出随时间排列的拍点时刻,非西方流行音乐常出现拍点位置模糊和节拍层级分歧,传统依赖少数专家手工校准的流程难以扩展到多文化曲目。论文先在线收集听众跟随音乐拍击的音频时间点,再把多人拍点经高斯核密度估计平滑为拍点位置密度并提取峰值,最后把该密度送入网格优化拟合出近等时的共识拍轨,同时由拍点密度离散度和拍轨规整度得到无需参考的可靠性指标。GlobalTap基准包含200段取自59国周榜的流行音乐,由分布在10国的746名参与者提供拍点,另以240段验证集由733名参与者拍击并由130名独立评分者对叠加clicks版本打分。在200段有配对参考的验证片段上,以1–7分平均听感评分为指标比较众包拍轨与参考标注,众包减参考的评分差Δ为-0.01,95% CI [-0.12,+0.10],p=.231,显示两者评分相当而无系统性偏高或偏低。在200段基准片段上,以±70 ms容差下最终拍轨间F值为指标比较两组独立拍击者所得共识拍轨,每组50人时F值为0.918,高于每组20人时的0.893。众包与参考的分歧多为相位偏移与快慢倍节拍等系统性选择而非随机失败,不同招募国在节拍层级选择上存在差异。结论适用于短流行片段的拍点评测,不适用于弹性速度曲目,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/williambotticelli-wells/GlobalTap — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. BARS:能自己变速、跟着伴奏说的说唱合成

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Taemin Cho:机构信息未能在本次解析中与作者逐人可靠绑定
- Hector Martel:机构信息未能在本次解析中与作者逐人可靠绑定
- Enyan Koh:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
说唱人声需要把歌词音节放进伴奏给定的节拍窗格,同时保持语义完整,固定时长模板难以适用,已有自回归方法还把演唱速度与输出时长完全绑在伴奏上。本文输入是伴奏音轨、歌词文本和约3秒参考音色,输出是可混音的说唱干声,难点是在强节拍下保持覆盖不跳词不重复,同时允许同段歌词变速演唱。先模型用共享音频VAE把伴奏、参考音声和干声提取为隐序列,用预训练ByT5加轻量适配器把歌词提取为歌词嵌入,弥合文本音频模态差异。再把声乐隐变量经片段掩蔽替换为流匹配插值子,与伴奏隐变量拼接投影为音频输入,前置参考隐变量与时间步嵌入后送入Transformer做非自回归生成,输出时长跟随伴奏且支持片段重生成。最后交叉注意力仅以音频隐记元作查询、以歌词嵌入作键,并只对歌词键侧做按长度比放缩的位置编码,把歌词位置拉伸到音频时间轴上,引导音频帧按顺序覆盖歌词。在匹配的歌词伴奏对上,完整模型词错率为5.1%,与真实录音转写误差5.1%相当;在每秒字符数偏离训练均值两个标准差的错配条件下,完整模型词错率为15.4%至20.5%,明显低于去掉位置编码的26.9%至33.6%。结论只在最长60秒英文说唱验证,多语言与更长时长尚未系统评测;原文报告单张RTX 4090上实时率为0.027,即10秒音频用0.27秒生成,含编解码与文本编码。
🔗 开源资源
第三方资源:https://bars-ismir2026.github.io/bars → https://bars-ismir2026.github.io/bars/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/google/byt5-base — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 一句话指令选出想要的声音:Textraction 统一文本引导提取与增强

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Aviad Eisenberg:机构信息未能在本次解析中与作者逐人可靠绑定
- Sharon Gannot:机构信息未能在本次解析中与作者逐人可靠绑定
- Shlomo E. Chazan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是包含两个说话人和两个方向性噪声的混响混合,以及只含一个说话人的增强混合。困难在于同一模型要处理单通道和双通道输入,并根据自由文本决定保留哪些实体、去除哪些实体,还要区分语义相近但极性相反的指令。先把混合变换到短时傅里叶变换域,用实部虚部表示,再经单通道或双通道编码器送入共享的时频变换块,文本嵌入和通道配置嵌入在每个块后通过交叉注意力调节特征,最后由解码器一次输出目标波形。文本侧采用轻量检索模型E5,经过三元组微调拉近同义改写、推远极性相反的提示。相对已有方法,该框架不做先分离再选择,不依赖大语言模型做文本嵌入,并把相对位置关系写成自由文本,从而避免分离或选择阶段失误并降低文本编码开销,同时支持语义和空间统一条件。与专用增强网络TF-GridNet相比,在相同多通道增强测试项上,双通道增强达到18.66 dB SI-SDR,超过其18.15 dB。结论适用于仿真混响、固定声源数的条件,单噪声抽取和真实录音仍需验证,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://aviad3189.github.io/Textraction/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 直接用脑信号驱动音频扩散模型:MAAS 如何重建听到的声音

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Matteo Ciferri:机构信息未能在本次解析中与作者逐人可靠绑定
- Tonio Weidler:机构信息未能在本次解析中与作者逐人可靠绑定
- Matteo Ferrante:机构信息未能在本次解析中与作者逐人可靠绑定
- Nicola Toschi:机构信息未能在本次解析中与作者逐人可靠绑定
- Elia Formisano:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
从脑活动重建听到的声音,输入是血氧响应随时间的模糊间接测量,输出是波形,难点在于 1 秒声音的谱时细节会被回归到中间嵌入的瓶颈丢失。论文提出 MAAS,把 6 个双侧听觉感兴趣区的体素响应经分区投影变为共享向量,再经可学习查询聚合成脑令牌,最后经并行交叉注意力注入冻结的 Stable Audio 去噪过程,训练时文本分支给空提示以隔离脑信号作用。与两阶段 fMRI 到隐变量条件相比,MAAS 在 72 个测试声音的四折交叉验证中 CLAP 相似度达到 0.614,配对识别准确率为 85.4%,Mel-SSIM 为 0.297,对数梅尔距离为 0.152,声学与语义指标同时占优。消融显示去掉主干微调或适配器路由都会下降,同一模型在 NSL 听觉皮层模型表示下计算留一区与单区保真度,揭示早期区携带更自足的谱时信息。结论适用于高信噪比 7T 聚类采集与基于体素选择的跨被试合并,5 被试小样本与血氧时间模糊仍限制推广。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://anonymous.4open.science/r/brainSounds_nips-DFC1 — 链接可访问(HTTP 200)
第三方资源:https://fidelioc55.github.io/brainSounds-website/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. FlashMotion:用很少的采样步数生成很长的三维人体动作

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kaixing Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xulong Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ronghui Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiangyue Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziqiao Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingshuang Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenxi Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyu Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ju Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongyan Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Puwei Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zijiao Zeng:机构信息未能在本次解析中与作者逐人可靠绑定
- Jun He:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
从文本、语音或音乐生成长时三维人体动作时,需把条件映射为连贯且物理合理的全身关节轨迹,难点是高质量生成常需数十次采样迭代,而长序列每次迭代的计算和显存开销都很大。先将带噪动作、条件序列与时间区间送入模型,直接预测干净动作估计,再将其换算为区间平均速度供常微分方程求解器做大步长更新,避免学习瞬时速度带来的积分误差。再对该干净动作估计施加重建、正向运动学、速度与加速度约束,稳定少步更新下的关节协调与平滑演化,约束后的速度估计进入采样循环驱动去噪。最后以非自回归双向Mamba主干一次前向预测全部帧,并用条件引导的状态选择调节时间信息流、用基于AdaIN的条件融合做逐帧缩放与平移,实现长序列高效条件对齐。在BABEL长序列文本到动作上,4步版本检索R@1为29.134,超过最强外部基线并把过渡抖动差距大幅缩小。在FineDance上4步版本把动力学特征分布差异指标FIDk降到15.15,相对FlowerDance降低约49.0%。结论适用于三类已评测数据集和短步数采样,1步编辑不受支持,长序列外推和更大规模部署仍需验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 一个通用音频编码器为何也能听出方位:AURA 的统一表示与完整对齐

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Boyan Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoyan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhe Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziqi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yujun Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongli Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiwei Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming-Hsuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Liang An:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是包含两个同时发声目标的双耳录音,困难是既要认出被提问的声音是什么,又要把左和右、前和后、上和下以及距离归属到该声音。处理过程是把左右耳波形送入冻结的通用音频编码器得到表示,再经投影送入冻结的大语言模型生成文字回答。论文先固定声源变换房间脉冲响应、固定响应变换声源,测量残差向量量化各层的相似度,发现浅层对内容敏感、深层对耳间差异和混响敏感。接着发现常规四槽接口在双声源左和右判断上停留在随机水平,且前和后、上和下只读出场景属性而未绑定到被问声源。针对该现象,论文提出音频与文本信息不对称解释,并引入场景监督与显式耳间差分两个干预。AURA 把每耳浅层与深层分别累加为内容取向带与声学取向带,再加入带内左右差分形成六槽表示,同时要求模型先描述全部声源再回答,关系问题再插入几何比较。在 SpatialSoundQA 上,AURA 双声源到达方向准确率为 48.21%,超过最强专用基线 DSpAST-BAT 的 37.90%,差距为 10.31 个百分点,可训练参数为 64.63M,约为专用系统 161M 的 40%。结论适用于该仿真双耳问答语料,真实录音只验证了线性可解码性,未验证完整问答。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 机器人只用一个摄像头和麦克风,怎么猜到下一个是谁说话
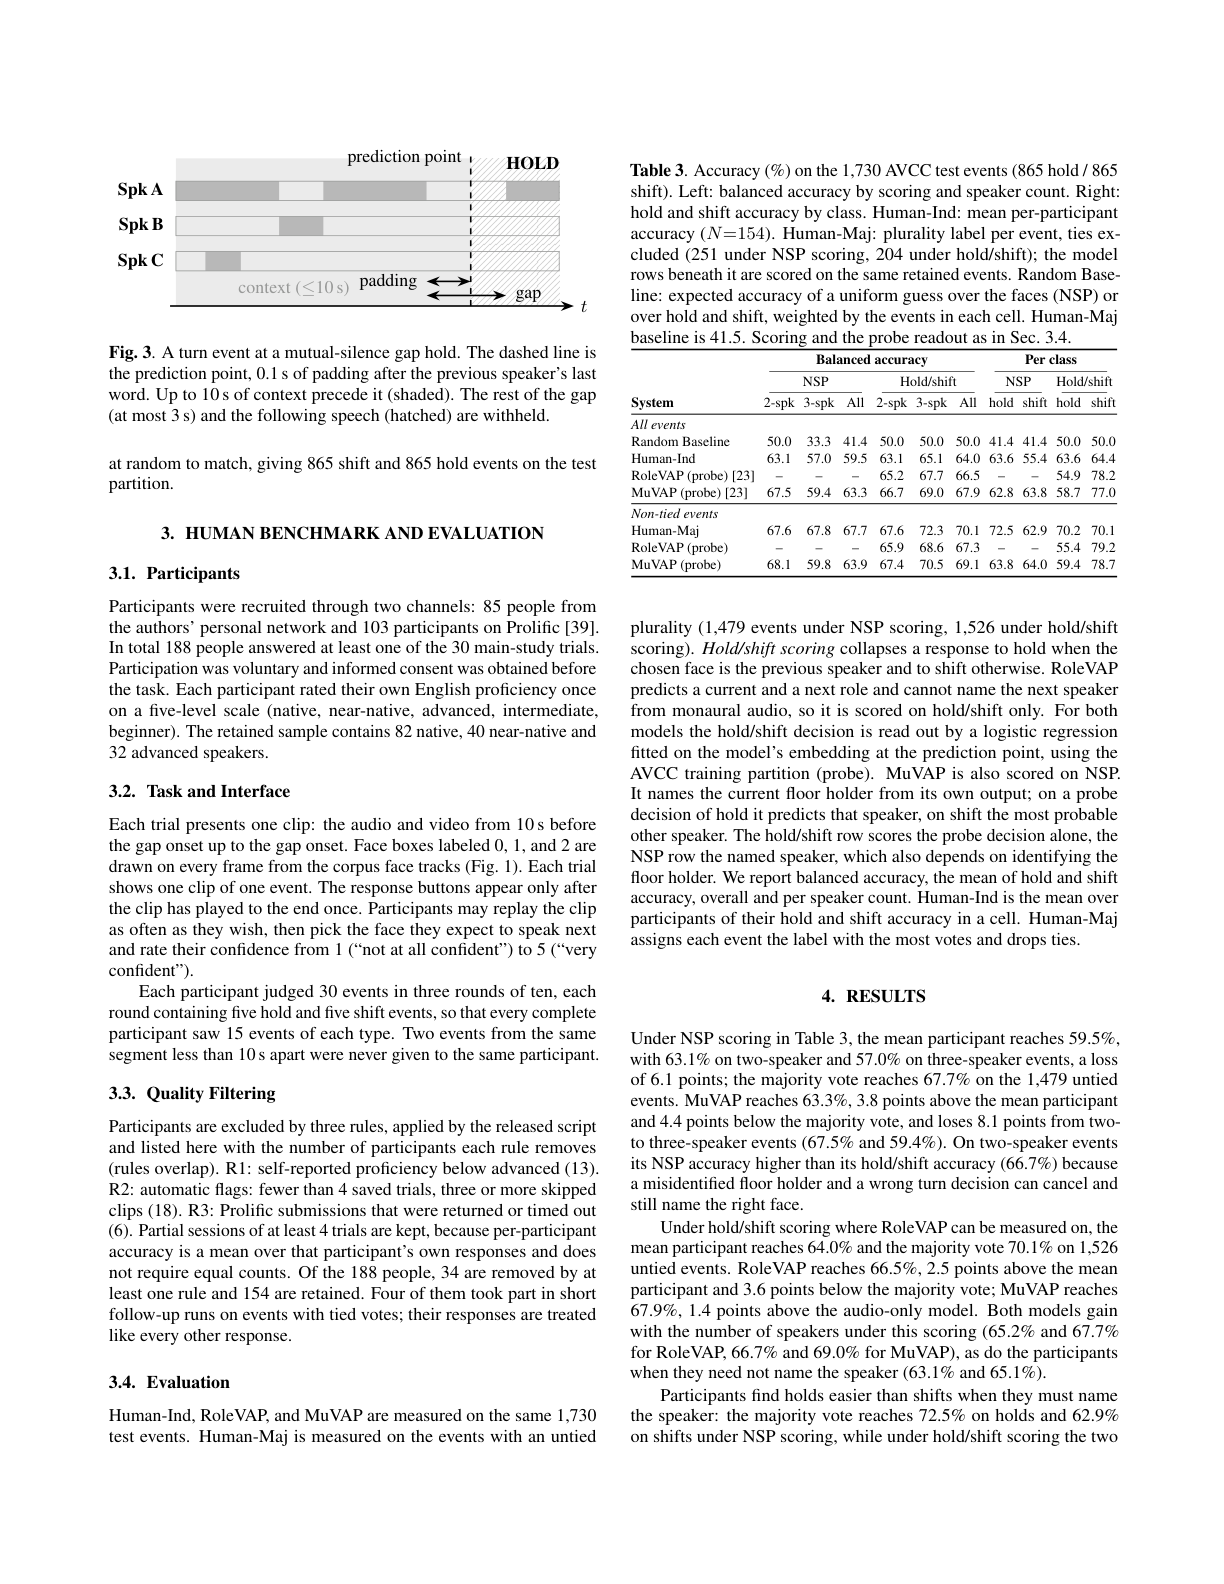
图片来源:原论文 PDF 第 3 页(含图 3)。完整图注与解读见独立文章。
英文题目:AVCC: Audio-Visual Conversation Corpus for Turn-Taking Prediction with a Human Benchmark
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Haotian Qi:机构信息未能在本次解析中与作者逐人可靠绑定
- Gabriel Skantze:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
对话转换平均约200毫秒,机器人需在静默前判断当前说话人是否继续及多人时由谁接话,输入为单静态摄像头和单声道麦克风记录的连续音视频,输出为互静默间隙预测点处的保持或转换及接话人身份,难点是不能等待静默结束而须提前投射转折。先以InsightFace提取逐帧人脸轨迹并人工核对身份,再以TalkNet初标语音活动经人工校正并以Voxtral转写加蒙特利尔强制对齐器输出词级转写,最后按互静默间隙规则提取轮次事件并在训练分区拟合逻辑回归探针读出嵌入,由音频RoleVAP模型输出保持或转换判断、多模态MuVAP模型结合当前说话人识别指名接话人。154名保留被试在相同预测点观看至多10秒上下文后选择下一说话人并给出1到5分信心。在1730个测试事件保持或转换评分的平衡准确率上,音频RoleVAP模型为66.5%,高于被试平均64.0%,低于1526个无平票事件上多数投票的70.1%。在相同1730个事件上多模态MuVAP模型保持或转换平衡准确率为67.9%,高于音频模型的66.5%;在必须指名接话人的次说话人身份评分平衡准确率上,MuVAP为63.3%,高于被试平均59.5%,低于1479个无平票事件上多数投票的67.7%。在次说话人身份评分平衡准确率上,被试平均从二人事件63.1%降至三人事件57.0%,MuVAP从67.5%降至59.4%,而保持或转换判断未变难,即第三人增加指名难度而非变化检测难度。结论仅适用于单摄像头单声道、两到三人在线对话、说话人不重叠的七视频测试划分和至多10秒间隙前上下文,被试为不见间隙本身的第三方观察者,短间隙因更接近下轮线索而更容易,平票多为三人打断或开放提问等情形尚未可靠验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/Haotian-Qi/AVCC — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 超低码率下如何同时保住语义和音质:ESDCodec 的解耦与子带解码

英文题目:ESDCodec: Ultra-Low Bitrate Speech Codec with Enhanced Semantic Disentanglement and Subband Decoding
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Nan Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kecan Mao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhi Gong:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要解决的对象是超低码率下语音压缩重建,输入是连续波形,输出是离散词元再还原的波形,难点是码本容易塌缩、语义丢失和低维特征到波形映射不适定。编码器先把波形压缩为帧级隐表示并提取连续特征,一路送入增强语义量化器输出单个语义词元,另一路再送入残差向量量化层补充声学细节。去量化特征最后同时进入上采样主路和子带条件网络,条件网络预测子带幅度与相位并经逆短时傅里叶变换生成子带波形先验,再与各级上采样特征融合用于波形重建。与DualCodec等双流结构相比,差异是语义码本随机初始化并冻结、只训练线性投影矩阵,以及解码器显式引入子带先验,这意味着语义编码在全码本利用下解耦、重建获得细粒度频谱指导。在LibriSpeech test-clean上以相同码率与DualCodec相比,ESDCodec的PESQ以2.49高于2.32,ViSQOL以2.74高于2.61,WER以4.18%低于4.70%。结论适用于英语朗读语音重建和基于离散词元的语音合成,跨语言和噪声等更复杂条件的表现尚未充分验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/vspeech/ESDCodec — 链接可访问(HTTP 200)
第三方资源:https://github.com/ludlows/python-pesq → https://github.com/ludlows/PESQ — 链接可访问(HTTP 200)
第三方资源:https://github.com/mpariente/pystoi — 链接可访问(HTTP 200)
第三方资源:https://github.com/google/visqol — 链接可访问(HTTP 200)
第三方资源:https://github.com/gemelo-ai/vocos — 链接可访问(HTTP 200)
第三方资源:https://github.com/BytedanceSpeech/seed-tts-eval — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. 在短窗 MDCT 编码里加一个小神经网络预测器
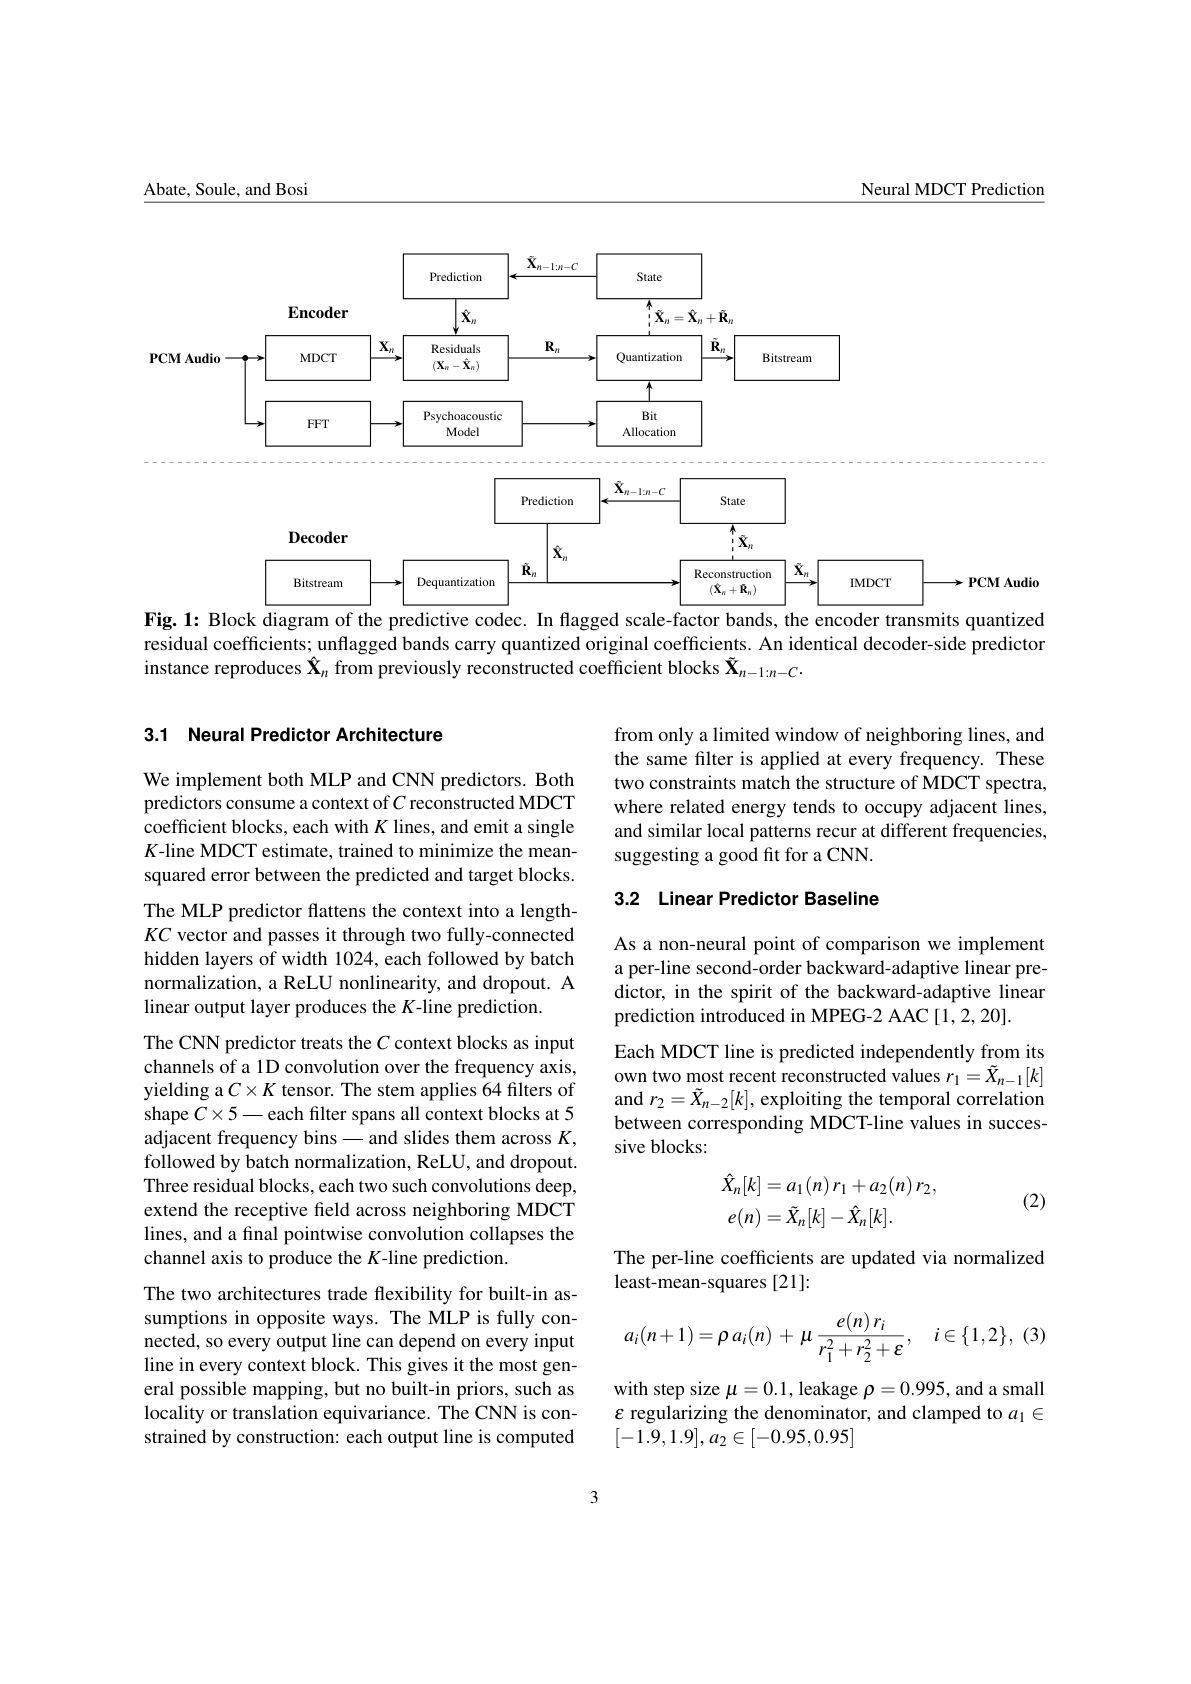
图片来源:原论文 PDF 第 3 页(含图 1)。完整图注与解读见独立文章。
英文题目:Lightweight Neural Prediction for MDCT-Based Perceptual Audio Coding
评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Niccolo Abate:Center for Computer Research in Music and Acoustics (CCRMA), Stanford University, Stanford, CA, USA
- Gabriel Soule:Center for Computer Research in Music and Acoustics (CCRMA), Stanford University, Stanford, CA, USA
- Marina Bosi:Center for Computer Research in Music and Acoustics (CCRMA), Stanford University, Stanford, CA, USA
📌 核心摘要
感知音频编码需以尽量少码字保留听感,音乐信号在相邻变换块间存在时间与频率相关性,短分析窗延迟低但频率分辨率粗,长分析窗分辨率高但延迟大。先将过去5个已重建MDCT系数块作为上下文送入预测器,输出对当前块的单块估计,卷积预测器以一维卷积沿频率轴提取相邻频线的局部相关,多层感知机则将上下文展平后经全连接层映射。再由编码器用该估计作差得到残差,并在比例因子频带尺度上比较残差与原始系数的临时重建误差,输出每带一比特选择标志以决定传输残差还是原始系数,最后解码器仅接收量化候选与标志,并用同样的已重建系数块更新预测器状态,使两端无需传输预测器状态即保持同步。与逐线二阶归一化最小均方线性预测器和多层感知机预测器不同,卷积结构把局部谱结构作为归纳偏置,参数量仅0.13M而泛化更好。在2.0比特每样本、512点分析窗、上下文5块的EBU SQAM 70项集上,卷积预测器平均SNR为23.18 dB,高于无预测基线的18.86 dB,平均NMR为-19.27 dB,低于基线的-15.56 dB。在同一2.0比特每样本的EBU SQAM 70项集上,512点加卷积预测的平均SNR为23.18 dB,超过2048点无预测基线的21.93 dB,同时算法延迟从46.4 ms降至11.6 ms。在约110 kbps、17名受训听众的MUSHRA测试中,512点卷积条件的MUSHRA得分显著超过512点无预测基线约28分,并超过2048点无预测基线约6分。在Apple M4 Pro笔记本CPU上测得解码器实时率为0.10而无需GPU,但瞬态与随机性素材上预测增益收缩,域专用预测器、更大模型与预测感知比特分配仍未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 为一个人定制语音识别:用少量录音让 Whisper 听懂构音障碍语音
英文题目:DIY Customized Speech Recognition for a Person with Speech Disabilities
评分:6.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Paulo A. Condado:CENSE – Center for Environmental and Sustainability Research;& CHANGE - Global Change and Sustainability Institute;NOVA School of Science and Technology, NOVA University Lisbon;Campus de Caparica, 2829-516 Caparica
- Fernando G. Lobo:CENSE – Center for Environmental and Sustainability Research;& CHANGE - Global Change and Sustainability Institute;DEEI-FCT, Universidade do Algarve;Campus de Gambelas, 8005-139 Faro, Portugal
📌 核心摘要
通用语音识别要把麦克风采集的连续声波转写成文字,脑性瘫痪引起的构音障碍会改变发音时长、清晰度和音素实现,使在常态语音上训练的大模型出现系统性失配。本文面对的是第一作者本人的欧洲葡萄牙语朗读语音识别,输出为转写文本,并把文本送入语音合成形成实时传译应用。处理过程是先用消费级设备录制带参考文本的个人语音,再冻结 Whisper 原有权重,只训练加在注意力投影上的低秩增量,推理时把增量合并回原权重使用。测试使用另行撰写的 100 句未见句子,在 large-v3 上词错误率由 30.4% 降至 12.4%,字错误率由 15.6% 降至 5.4%,说明残留错误多为可由上下文恢复的音素级偏差。结论只适用于该说话人在安静朗读条件下的葡萄牙语,作者自述嘈杂环境性能明显变差但未量化。训练和推理在配有 Apple M4 Max 芯片和 64 GB 统一内存的 Mac Studio 本地完成,局域网下从结束说话到播放合成语音平均约 1.85 秒,原文未披露训练时长、显存占用和部署成本。
🔗 开源资源
代码相关资源:https://github.com/pacondado/ASR-for-people-with-speech-disabilities — 链接可访问(HTTP 200)
第三方资源:https://github.com/alphacep/vosk-api — 链接可访问(HTTP 200)
第三方资源:https://github.com/k2-fsa/sherpa-onnx — 链接可访问(HTTP 200)
第三方资源:https://flet.dev/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 录音比文字多提供了什么:音频语言模型声学信息利用的测量与修复

评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Linkai Peng:University of Connecticut
- Baorian Nuchged:The University of Texas at Austin
- Yuyang Yao:University of Oxford
📌 核心摘要
音频语言模型在回答问题时可能只依赖文字内容,论文把92个任务按答案所需证据分为词汇类、整体属性类和录内结构类,输入是录音,输出是选项或标签,难点在于后两类需从整段录音或段间关系中提取说话人、情绪、重音和音高。在6个基准共13,707个条目上以原始录音作答的准确率平均,19个开源模型在属性和结构任务上分别低于Gemini 3.1 Pro 28.6和41.9个百分点,其中约一半以上差距来自录音增益。论文先用原始录音、合成朗读及其与文字转写的组合构造对照,提取保留文字但替换嗓音韵律后的准确率差作为录音增益,其输出的增益缺口指向录音利用不足,再在每层表征上训练线性探针,将读出精度与直接作答准确率对比以定位读出下降层。最后把探针定位的下降层作为训练位置,在该层训练低秩适配器并用内容锚定约束词汇问答分布接近基础模型,使声学利用改进而不损失词汇能力。修复后Gemma-4 12B和Qwen2.5-Omni-7B以原始录音作答的准确率在属性任务上分别从34.7%升至53.6%和从56.7%升至69.5%,在结构任务上分别从35.4%升至66.2%和从34.0%升至78.4%,词汇类平均精度变化在1个百分点以内。该结论仅在与训练同格式的34个任务及两种架构上验证,对无匹配训练格式的会话情绪与讽刺任务迁移不均,且两次增益估计共用同一Whisper转写,受识别错误共同影响。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. 小模型读不懂情绪时,换一套做法能不能帮忙

英文题目:EmoHarness: Boosting Multimodal Emotion Understanding with Meta-Harness Evolving
评分:6.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fenghai Li:University of Illinois Urbana-Champaign
- Bingxuan Li:University of Illinois Urbana-Champaign
- Jiawen Zhang:University of California, Davis
- Yifan Shen:University of Illinois Urbana-Champaign
- Jiateng Liu:University of Illinois Urbana-Champaign
- Yutong Zhang:Stanford University
- Yue Guo:University of Illinois Urbana-Champaign
📌 核心摘要
需要理解的对象是短视频中的情绪标签,输入是视频画面、说话内容和声音的韵律特点,输出是一个或多个允许标签,难点是词语、语调和表情互相矛盾时小模型容易跟随表面线索。先由固定预处理提取带词时间戳的转写文本、参考归一化的韵律描述和帧缓存,再由冻结学生分四次调用完成观察、列候选、复核和写解释,中间只传递带编号的文本证据,最后由固定控制器决定标签。离线时由更强的构造者模型阅读失败聚类和执行轨迹,改写提示词、设置和受限校验代码,再经静态检查与验证门决定是否保留。相对已有做法,权重不变,只改调用程序,且用单独验证集做门控并冻结后再评测。在5507个MME-Emotion评测条目上,以任务宏平均Recognition为指标,演化后程序高于单次视频调用7.61至13.36个百分点,其中转写与韵律描述贡献最大。演化相对人工初始程序的增益较小,且多标签任务的计分方式会影响比较结果,跨模态冲突处的单独效果尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://emo-harness.github.io — 链接可访问(HTTP 200)
代码相关资源:https://github.com/Emo-Harness/EmoHarness — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. ConvLUT:把卷积装进查找表的超低延迟推理

英文题目:ConvLUT: Rethinking Convolutional Architectures for Ultra-Low-Latency LUT-Based Inference
评分:6.7/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Marta Andronic:Imperial College London, London, UK
- Olivia Weng:University of California San Diego, San Diego, CA, USA
- Danial Zuberi:University of California San Diego, San Diego, CA, USA
- Ryan Kastner:University of California San Diego, San Diego, CA, USA
- George A. Constantinides:Imperial College London, London, UK
📌 核心摘要
面向超低延迟 FPGA 推理,论文要解决已有基于查找表网络多为多层感知机结构、难以处理需要空间或谱时间建模的视觉与音频任务的问题。输入为 32×32 RGB 图像、96×96 视觉唤醒图像或单通道梅尔谱图,输出为类别分数,难点是标准卷积感受野维度为 \(k^2c\),远超单个逻辑查找表容许的扇入 \(F\),直接剪枝会丢失大量信息。先把点积卷积核换成以跳连多层感知机为可微代理训练的逻辑查找表单元,推理时枚举为真值表,每个输出通道学习自有稀疏模式并在滑窗间共享,提取稀疏卷积特征输出送入聚合层。再对标准卷积增加逐点聚合层构成查找表树,把多个稀疏视角的并集拼成更大的有效感受野,输出融合特征送入池化替代层。最后用按通道划分的稀疏全连接层代替池化以学习空间聚合函数,并配合分阶段收紧扇入的迭代剪枝保持训练稳定。在 CIFAR-10 上,CNN-L 达到 80.08% 准确率、2 周期实现延迟为 32 ns,论文称相对 FINN 的 283,000 ns 降低约 8844 倍,且高于 DWN 的 57.42% 约 22.66 个百分点。结论适用于全展开、寄存器流水和片外隔离综合的评估条件,代价是查找表占用率高达 25% 至 97%,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 音素、音节和词:谁编码语音内容更省比特

评分:6.7/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:理论研究 | arXiv 原文
👥 作者与机构
- Herman Kamper:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要先理解比较对象:同一段语音内容可以用音素、音节、词或词组合等不同单元序列写出,解码后都能恢复同一串音素,比较的是把哪种序列送给编码器更省比特。困难在于真实概率未知,只能用容量有限的模型估计条件概率,再按交叉熵换算成每秒比特数,模型容量、上下文长度和词表大小都会影响结果。方法上先从LibriSpeech960小时英语有声书强制对齐中提取音素序列并派生音节和词序列,再把各单元序列送入三阶n元模型和约20M参数因果变换器输出条件概率并换算为比特率,最后对未见词和长单元用三阶拼写模型退回拼成音素以保证可解码。其中词级字节对编码是在词序列上合并高频相邻词得到类似of the的长单元,论文检验了200、1000和5000次合并。在LibriSpeech dev-clean评测下,以比特率比特每秒为指标,约20M参数变换器加词单元取得28.07比特每秒,低于音素单元的29.56比特每秒和加5000次词合并的29.27比特每秒。字符对照中正字法词同样最优,大规模Qwen2.5-3B进一步降到25.26比特每秒。结论适用范围限于英语LibriSpeech音素序列和论文设定的两种预算,未验证其他语言和真实感知加工,原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/kamperh/inforate/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 开场建场景、后续接动作:TaoMate-R1 如何按时间角色分配适配参数
英文题目:TaoMate-R1: Temporal Role Specialization for Streaming Multi-Reference Video Generation
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.3/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qijun Gan:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenwei Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinyang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Meiguang Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Junfeng Ma:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式多参考视频生成要先用人物与物品参考图像搭好场景,再按陆续到达的文字指令延续交互,难点在于开场建立的摆位与姿态会成为后续动作的起点。TaoMate-R1在冻结主干上设置开场适配器与延续适配器,开场只在绝对块序号为零时启用,其余块都用延续适配器,每个角色内部统一负责当前块的去噪合成与历史上下文写入。先用无梯度学生rollout逐块生成潜变量并记录历史键值,再用分布匹配损失计算后续块误差,最后经上下文梯度回传把信号写回产生该历史的对应角色,使延续损失能监督开场表示。相对已有按去噪与写入分离参数的做法,差异在于把学习信号按建立场景与延续场景分组。与同预算的操作切分相比,在十条约两分钟、每条含二十条连续指令且沿用缓存教师音频轨迹的长流评测中,指令边界相邻帧平均亮度跳变从1.96降到0.613,相邻边界帧CLIP与DINO特征相似度也更高。在短交互、长流与公开参考组合三组评测中,其CLIP与DINO时间相似度均值同样高于操作切分。结论限于所用H3主干、固定历史保留策略与给定评测流程,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/TaoLiveAIGC/TaoMate-H3 — 链接可访问(HTTP 200)
模型相关资源:https://github.com/TaoLiveAIGC/TaoMate-H3 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 只用四个真麦克风,怎么“变出” 十二个虚拟麦克风来做增强

英文题目:Virtual-Flow: Virtual Microphone-based Speech Enhancement via Semi-supervised Flow Matching
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Dongheon Lee:Korea Advanced Institute of Science and Technology (KAIST);Daejeon, Republic of Korea
- Ashutosh Pandey:Meta Reality Labs Research;Cambridge, Cambridgeshire, UKRedmond, WA, USA,
- Sanjeel Parekh:Meta Reality Labs Research;Cambridge, Cambridgeshire, UKRedmond, WA, USA,
- Zhaoheng Ni:Meta Reality Labs Research;Cambridge, Cambridgeshire, UKRedmond, WA, USA,
- Daniel Wong:Meta Reality Labs Research;Cambridge, Cambridgeshire, UKRedmond, WA, USA,
- Jacob Donley:Meta Reality Labs Research;Cambridge, Cambridgeshire, UKRedmond, WA, USA,
- Buye Xu:Meta Reality Labs Research;Cambridge, Cambridgeshire, UKRedmond, WA, USA,
- Juan Azcarreta:Meta Reality Labs Research;Cambridge, Cambridgeshire, UKRedmond, WA, USA,
📌 核心摘要
多通道语音增强依赖密集空间采样,但在AR眼镜等设备上只能安装少数真实麦克风。论文研究从有限真实含噪信号合成未观测位置的虚拟麦克风含噪信号,再将真实与虚拟通道合并做波束成形,难点是已有方法多只估计单路虚拟信号且依赖各虚拟位置真值与固定阵列。Virtual-Flow以半监督流匹配解决该问题,训练不用虚拟真值,推理仅需真实含噪信号,不需要激励语音与干净参考,这是与已有监督虚拟麦克风估计的关键差异。系统先由轻量引导模型从真实信号提取初始虚拟估计并作为条件送入流匹配模型,再由流匹配模型预测向量场并经单步积分输出虚拟信号,最后将真实加虚拟通道送入增强模型估计掩码并计算自适应波束成形系数。在16通道球阵仿真的虚拟麦克风波束成形对比中,半监督Virtual-Flow的SI-SDR、SNR、PESQ、STOI分别取得10.3 dB、10.8 dB、2.79、90.2%,高于4路基线的5.7 dB、7.0 dB、2.26、80.4%,仍低于16路真实阵列的12.1 dB、12.4 dB、2.82、92.8%。该结论适用于正面视场内仿真目标及纳入RealMAN静态与移动实录的训练条件,长混响、强干扰和延迟估计误差大时以及纯静态训练测移动说话人时性能下降,同一配置下单步推理的神经网络计算量为31.0 G MAC/s,高于4路基线的23.2 G MAC/s。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 层角色不同,干预也要不同:推理时重平衡多模态情感推理

评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pengyu Huang:University of Science and Technology of China, Hefei, China
- Peipei Song:University of Science and Technology of China, Hefei, China
- Beier Zhu:University of Science and Technology of China, Hefei, China
- Zhiyuan Han:University of Science and Technology of China, Hefei, China
- Jinpeng Hu:Hefei University of Technology, Hefei, China
- Xun Yang:University of Science and Technology of China, Hefei, China
📌 核心摘要
多模态情绪推理要求同时读懂文本、视频和音频里的情绪线索,再把互相补充甚至互相矛盾的证据综合成判断,难点是模型容易只听强势模态,跨模态之间也缺少有效的信息交换。该方法先统计每层注意力在三个模态上的分配和跨模态占比,用模态熵衡量分配是否均衡,用跨模态强度衡量跨模态注意力占总注意力的比重,两者取调和平均输出层分数。再把层分数按降序送入拐点算法定位曲率最大处得到划分阈值,将高于阈值的层定为整合层、其余定为稳定层,避免固定浅中深划分,使后一步干预按层角色选择。最后在推理时只改注意力矩阵而不更新参数:稳定层对偏离正常区间的注意力向层内均值收缩以压住个别模态异常峰值,整合层用键向量相似度建语义亲和图并经懒随机游走扩散让查询向量吸收语义相近跨模态邻居的注意力分布。在MER-UniBench上AffectGPT接入该方法后平均得分从71.33提高到73.01,九个子集全部上升。该结论适用于以CMU-MOSEI与CMU-MOSI组成的小验证集估计阈值、并按基线分别设置再平衡超参数后在PandaGPT等三种多模态大模型上推理时使用,若验证集与测试集模态分布差异很大或换到未经验证的模型结构与情绪冲突场景,划分与增益可能不再成立。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://pengyuhuang1.github.io/LAMR/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 只用合成语音训练的土耳其语小模型 Antalia-2 Mini

评分:6.6/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Sezgin Saygili:机构信息未能在本次解析中与作者逐人可靠绑定
- Emre Kaplaner:机构信息未能在本次解析中与作者逐人可靠绑定
- Oncel Ozgul:机构信息未能在本次解析中与作者逐人可靠绑定
- Fikri San Koktas:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
土耳其语文本到语音要把字符序列变成单人可听声音,小模型直接学习易在短句、词首特殊元音和声码器环节出错,而大规模真人录制成本很高。先由文本规范器把数字日期和缩写改写为可读词,再由编码器加时长预测为每字符规划帧数并送入生成器,生成器从噪声出发多步画出梅尔频谱图,最后由声码器把该频谱图变成48 kHz波形并经固定后处理输出。与已有纯合成数据做法的关键差异是发现声码器只见真实频谱图带来失配,因而以0.8概率混入生成频谱图微调声码器纠正,同时用播后切除的隐藏前缀遮住教师在词首ö的缺陷。在495句Freya-TR-Eval公开测试链路上,1.0.1版词错误率为1.09%、字符错误率为0.220%,其中词错误率比EMA Lightning高0.05个百分点但配对自助法下不可区分,而全频带自动质量分以3.18分低于EMA Lightning的3.30分。在训练期自有链路相邻预发布检查点上,用生成频谱图微调使词错误率均值从3.89%降至1.75%,字符错误率从0.984%降至0.385%,每对句子自助95%区间均不含零。原文披露shipped谱系训练链路共114.5 GPU小时,其中声学模型36.4小时、声码器78.0小时,推理在笔记本M5 CPU双线程约41倍实时。结论只适用于该495句上调参后的设置且未经人听评测,因同句调参而偏乐观,全频带质量分是英语训练代理且音色不同需谨慎解读,短输入微调效果与输出均衡器听感选择均未得到验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. MusicFlux:用两种条件方式统一文本生成音乐与局部修复
英文题目:MusicFlux: Flexible Conditioning for Text-Guided Music Generation and Editing
评分:6.6/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Teysir Baoueb:机构信息未能从 arXiv PDF 文本可靠映射
- Leonardo Boulitreau de Menezes Martins Marques:机构信息未能从 arXiv PDF 文本可靠映射
- Paraskevas Stamatiadis:机构信息未能从 arXiv PDF 文本可靠映射
- Gaël Richard:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
音乐编辑需按文字提示变换录音并保留不应改动的原有属性,长音频序列使把源音频直接作上下文拼入注意力的代价很高。本文先把高效文本到通用音频流匹配骨干微调为支持三十秒立体声的文本到音乐生成器,再以同一骨干统一生成、局部补全与效果器退化恢复,用掩码区分重建区与已知上下文。拼接分支把源潜变量与带噪目标沿序列维度拼接并在通道维附加掩码,输出两倍长度特征送入扩散Transformer做联合注意力,直接暴露细粒度上下文。移位分支先把源音频、文本嵌入和掩码送入两个轻量移位网络提取加性偏移,输出移位后起点与终点,再在保持原序列长度的移位空间中训练速度场,最后减去目标偏移恢复生成潜变量,避免序列翻倍并降低注意力计算与内存占用。在SonicMaster-Test修复评测中,以KAD为分布距离指标时拼接版本为0.0489,低于移位版本的0.2680,数值越小分布距离越小。在序列645、批量1、FP32权重的推理测量下,以RTF为速度指标时移位版本为0.1188,低于拼接版本的0.2203,动态内存由150.11 MiB降至75.71 MiB。结论适用于三十秒音乐片段和论文所用退化类型,域外提示与细粒度恢复仍存在差距,原文披露了训练设备与推理步数等成本信息。
🔗 开源资源
- 第三方资源:https://musicflux.onrender.com/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. DialInstruct-TTS:用多轮对话一点点改出想要的语音风格

评分:6.6/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wangzixi Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Bagus Tris Atmaja:机构信息未能在本次解析中与作者逐人可靠绑定
- Sakriani Sakti:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
指令语音合成的输入是待朗读文本加自然语言风格要求,输出是对应风格语音,难点在于用户只想改一小段或一个属性时整句重生成会破坏已满意部分。DialInstruct-TTS把一次生成改为多轮对话,先由冻结Qwen规划器整合对话历史与最新指令,输出含完整全局描述与增量修改的TemporalPlan送入声学控制,再由时间声学控制模块在冻结主干上实现情感、语速、音量与发声方式的区间控制,最后用参考潜变量修订沿用非目标区间上轮潜变量轨迹以保留满意语音。与已有一次整句控制相比,该工作把跨轮记忆与区间级修改引入流程,意味着可只改请求属性或时间段而保留历史音频。在8种全局风格每模型16例的30名日语母语者5分制全局指令跟随评测中,本文方法Match均值4.283,高于Irodori-TTS的2.792、Qwen3-TTS的3.077和CosyVoice3的2.911。在16种全局到局部对比分处句首句中句末共48条件的盲听A/B偏好选择中,本文方法偏好率92.1%,高于Qwen3-TTS的7.9%。在30名日语母语者三轮修订可用性评测的最终偏好选择中,多轮修订获29/30,高于完整重述的1/30;结论仅在日语固定文本、8种目标风格及三轮受控修订下成立,五轮声学修订消融的音量联合成功率中本文方法4/20高于无非目标锁定的1/20但仍较低,非目标区仍有漂移。原文披露在单卡RTX PRO 6000上训练约2万步、新增174M参数、声学791M、全系统约9B,未披露推理延迟与吞吐,定位精度与情感成功率等亦无独立验证。
🔗 开源资源
第三方资源:https://anonymous.4open.science/w/eacl-demo-17C5/ — 链接不可用(HTTP 404)
第三方资源:https://sourceforge.net/projects/sox/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/FunAudioLLM/CosyVoice → https://github.com/QwenAudio/CosyVoice — 链接可访问(HTTP 200)
第三方资源:https://github.com/Aratako/Irodori-TTS — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. MoBiMark:在说话时刻把身体特征绑进语音的水印系统

评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Guodong Liu:Nanjing University, Nanjing, Jiangsu, China
- Lei Wang:Soochow University, Suzhou, Jiangsu, China
- Dongxu Liu:Nanjing University, Nanjing, Jiangsu, China
- Qianran Qiao:Nanjing University, Nanjing, Jiangsu, China
- Haipeng Dai:Nanjing University, Nanjing, Jiangsu, China
- He Huang:Soochow University, Suzhou, Jiangsu, China
- Guihai Chen:Nanjing University, Nanjing, Jiangsu, China
📌 核心摘要
语音交互输入是一段待验证语音,期望输出是其是否来自已注册真人且内容未被改动,难点是克隆语音音色逼真、静态水印可被抹除或复用。手机在通话位置同时录下可听语音和听筒发出的多载频超声回波,前者表征说了什么,后者表征是谁的声道在动,两者须在同一时刻对齐。先由语音编码器和超声编码器分别提取特征并融合验证身份,输出的融合特征送入判决模块,超声与语音不一致则拒绝。再把用户编号与内容相关码组成双层水印嵌入语音,含水印语音送往云端,云端比对重新生成的水印与嵌入水印是否一致。与只做离线水印或只做活体判断的方法不同,该工作把生物证据固定在采集时刻并随语音传播,伪造须同时通过活体一致性和水印内容一致性。在50人、多款手机的评测中,来源级三类攻击平均检测准确率为99.59%,传播级多类攻击平均检测准确率为99.91%,后者高于前者。传播级中仅局部编辑的P1攻击下水印相似度降至76.59%±9.84%,低于真实样本的99.73%±0.84%,整数量化后模型总量约58.83 MB,最小端到端延迟约24.12 ms,结论适用于近距离、正面持机采集,超出有效距离或采集链被绕过时不成立。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 一边干活一边说话:全双工语音助手如何跟上变化的需求

评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Xiangheng He:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingjun Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhehao Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhengjia Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaopeng Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Qingqing Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Haolan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Xu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
全双工语音智能体需在边说边听中完成长程多工具任务,用户可在工具执行时追问进度、增删任务或调整优先级,也可在结果播报中打断提问,智能体须同时跟踪执行中、已完成、已播报与待播报事项。论文提出Joi-Bench-Task,用可控用户模拟器在工具执行窗口和语音播报窗口注入规定干预,检验执行响应、需求变更协同和中断后协同。模拟器先由观察模块汇总对话历史并跟踪工具执行事件与音频播放进度,形成状态观测送入干预控制器,再由控制器按用例规定与共享时钟选定干预行为与触发时刻并输出行为指令,最后由大语言模型据此生成话语经语音合成缓冲后流式发给智能体,增量语音识别回授播放进度以触发基于内容的打断。与同时测对话与任务的已有基准相比,该工作把干预时刻与工具状态和已播内容对齐,并区分是否听从变更和是否补齐全部应报结果。在60个场景、140个用例的需求变更协同评测中,结果完成率指标为Realtime 1.5达55.0%,高于Gemini 3.8 Live的15.0%。在中断后协同评测中,信息遗漏率指标为GPT Live 1.0达3.5%,低于Realtime 2的79.0%。结论适用于受控英文、无背景噪声、模拟工具时长的条件,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. 尼泊尔语英语混读语音识别:数据准备与语音基础模型适配

评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Jeevan Neupane:机构信息未能在本次解析中与作者逐人可靠绑定
- Janardan Bhetwal:机构信息未能在本次解析中与作者逐人可靠绑定
- Kshitiz Paudel:机构信息未能在本次解析中与作者逐人可靠绑定
- Anup Aryal:机构信息未能在本次解析中与作者逐人可靠绑定
- Bipin Bashyal:, Nepal
📌 核心摘要
尼泊尔语日常会话常混入英语词,书面要求尼泊尔语用天城体、英语词用小写拉丁字母,模型即使听对词也可能写错文字,常规词错误率会把文字错误记为识别错误。输入是16 kHz单通道语音,输出是符合上述书写规范的混写文本,难点在于数字与符号没有唯一读法,且基础模型的5000片段词表无法表示数字与常见符号。处理先把音频与文本清洗并按长度与词表兼容性过滤,再对含数字的句子生成尼泊尔语和英语两种读法,用基线模型的发音近似输出做距离选择。接着保留原词表与两个输出头,对449M参数的SraVaani编码器加Token-and-Duration Transducer与CTC联合损失做全参数微调,编码器用较小学习率。相对官方只训练解码器的做法,该工作更新编码器并保留数字样本,相对Whisper大模型微调则用更小参数达到相近内测精度。在同一9.08小时六领域测试集上以词错误率衡量,6轮全参数微调从未适应的48.6%降到17.1%,12轮进一步降到16.3%,低于冻结编码器的25.5%,与微调后Whisper large-v3-turbo在同一测试集上的16.4%接近。结论适用于保留原词表的同类混写适配,未验证说话人无关划分与多书写规范训练,六轮训练约3小时单卡,峰值显存19.1 GiB,原文未披露推理部署成本。
🔗 开源资源
第三方资源:https://github.com/AI-Lab-Pvt-Ltd/nepali-codemixed-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/ailabpvtltd/sravaani-nepali-english-codemix-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/ailabpvtltd/whisper-large-v3-turbo-nepali-english-codemix-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/ailabpvtltd/indicconformer-nepali-english-codemix-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/ailabpvtltd/nepali-english-codemix-asr-test-outputs — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 跨键盘也能听键还原文字:Decker 如何去掉设备染色再靠语言模型纠错
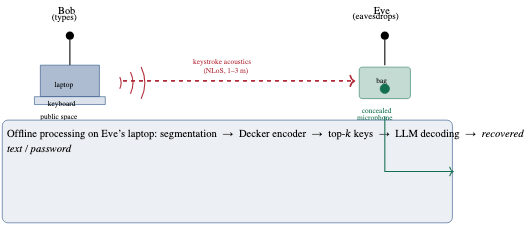
英文题目:Domain-Invariant and Language-Model-Assisted Acoustic Side-Channel Attacks on Keyboards
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Bikrant Bikram Pratap Maurya:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务是从被动录下的敲击声中恢复未见键盘的按键序列乃至句子和口令,难点是录音混入设备房间麦克风染色,换键盘波形分布即变,单设备模型易记住设备指纹而非按键差异。论文提出Decker,先用可学习逆滤波估计去除设备染色并输出去染波形,再用随机滤波合成未见设备风格送入ECAPA-TDNN编码器提取嵌入,最后用分类域对抗与跨键盘对比损失塑造嵌入并送入受限束搜索语言模型选句。在Hear数据集跨用户划分未见端上按Top-1按键准确率比较,Decker为82.7%,高于ECAPA-TDNN基线的60.4%。在同一Hear数据集跨环境划分未见端上按Top-1按键准确率比较,Decker为78.9%,高于ECAPA-TDNN基线的55.1%。在Hear的VoIP子集未见键盘与VoIP通道上按连续字符错误率比较,EvFlow-CTSSM为27.5%,低于Conformer-CTC基线的54.1%。完整Decker训练约需六GPU小时,测量条件为单块NVIDIA A100,结论适用于分段已知、有一定信噪比的近场录音,极端噪声、连续无分段长流和特殊键盘形态尚未充分验证。
🔗 开源资源
- 第三方资源:https://github.com/vikrant-vikram/Hear-Dataset — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 装在车身周围的麦克风阵列如何用气球爆裂声标定空间和时间

英文题目:Spatio-Temporal Calibration of a Vehicle-Mounted Microphone Array for Autonomous Driving
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Marvin Seegert:机构信息未能在本次解析中与作者逐人可靠绑定
- Richard Taupitz:机构信息未能在本次解析中与作者逐人可靠绑定
- Korbinian Moller:机构信息未能在本次解析中与作者逐人可靠绑定
- Johannes Betz:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务是要把车身周围麦克风阵列配准到车辆相机与激光雷达的空间和时间基准上,难点是车体遮挡使部分直达声经绕射变晚,而基于直线传播的到达时间模型对此没有表述项而产生系统性偏差。先用声学起始点检测从每发气球爆裂中提取各麦克风到达时刻并估计其信噪比相关方差,再把时刻与方差连同激光雷达给出的爆裂中心三维坐标一起送入加权非线性最小二乘,同时求解麦克风三维位置和每发爆裂发射时刻,最后把发射时刻与相机记录的气球消失帧时刻残差送入均匀量化与高斯抖动卷积分布做极大似然拟合,单独求解音频流相对相机的延迟。与室内无遮挡小孔径标定不同,该方法不假设无遮挡也不引入车体模型,而是靠方差压低被遮挡观测的权重来隐式处理阴影到达。在80发爆裂室外整车采集、以相同折与相同参考位置在321条直视射线上评分时,以留出距离残差为指标,加权方法为6.37 cm,低于去掉信噪比项的7.75 cm。在同一93窗运动声源方位估计中,以中位方位误差为指标,搭载标定结果为1.9°,低于每麦克风1 cm独立扰动下的5.5°。在孔径4.9 m的8麦克风布局、爆裂仰角-6°至29°且阵列近似平面的条件下,以麦克风位置误差为指标,垂直误差约为水平误差两倍且收敛最慢。留出评分只用直视射线故遮挡引入的偏差尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. 自监督语音模型何时在何处学会音素与韵律:分层与分时探测

评分:6.4/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Masaru Tanibata:机构信息未能在本次解析中与作者逐人可靠绑定
- Shun Takahashi:机构信息未能在本次解析中与作者逐人可靠绑定
- Hiroki Ouchi:机构信息未能在本次解析中与作者逐人可靠绑定
- Sakriani Sakti:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自监督语音模型直接从原始音频学习表示,但切分性的音位信息与超切分性的韵律线索在预训练的哪一层、何时出现并不清楚,尤其缺少同一检查点乘层网格下的直接比较。作者先在LibriSpeech 960小时上从头预训练HuBERT-Base与wav2vec 2.0-Base并保留100步到650k步的对数间隔检查点,再在每个检查点的全部12个Transformer层上冻结编码器提取每帧表示送入单隐层探针,最后按任务输出绝对基频、说话人相对音高、词汇重音、音位边界与38类音位身份五类标签以考察何时何处可解码。结果呈现从声学表面到抽象的梯度:绝对基频与音位边界在早期低层即可解码且随层变化平坦,音位身份则在训练中逐步构建并向中上层集中。在TIMIT上38类音位分类的标准划分下以最佳层宏F1比较,两模型均从100步时约0.18起步,到650k步时wav2vec 2.0-Base达到0.83而高于HuBERT-Base的0.76,且HuBERT峰值从第一阶段结束250k步时的第5层移到第二阶段500k步后的第9层。作者据此否定按切分与超切分划分习得顺序的预测,认为顺序取决于与声学表面的抽象距离,并把重定位归因于HuBERT第二阶段伪标签目标的变化而非更长训练,无目标切换的wav2vec 2.0未出现可比的重定位。结论仅在英语朗读语音单次运行的层组对比上成立,重音集仅600段因而泛化最弱,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/facebookresearch/fairseq/tree/main/examples/hubert — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. CallCleaner:用通用分离基础模型蒸馏轻量动物叫声去噪器

英文题目:CallCleaner: Lightweight Bioacoustic Denoising from an Audio Foundation Model
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Michael Xie:机构信息未能在本次解析中与作者逐人可靠绑定
- Gašper Beguš:机构信息未能在本次解析中与作者逐人可靠绑定
- Morris Alper:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
野外录制的单只显著动物的鸣声常被风雨、车辆、其他动物掩盖,输出要求同时保留鸣声形态并去除鸣声之间与鸣声之下的噪声,难点在于干净训练数据稀少而鸣声结构跨物种差异极大。该文先用简单的动物叫声活动检测给出鸣声出现的时间段,再以此时间段提示通用分离基础模型SAM-Audio生成伪标签,随后把伪标签蒸馏到19M参数的波形到波形小模型CallCleaner,推理时不再需要检测器或文本提示。具体而言,检测输出的时间跨度被送入SAM-Audio以指定分离目标,其输出的目标流作为伪标签、残差流作为噪声估计,并经重混扩充训练对。学生模型直接从含噪波形提取去噪波形,从而摆脱对检测跨度的依赖,并将笨重的基础模型转化为可在本地运行的轻量工具,这与依赖谱门或直接训练的动物去噪方法形成关键差异。该文用鸣声周围能量与鸣声内对数梅尔距离分别度量去噪与保真,避免单一波形指标混淆两者。在47段、最长30秒的混合基准上,CallCleaner在鸣声周围残留噪声Outside指标达到-29.0 dB,中位数比领先的神经动物去噪基线Biodenoising的-17.6 dB低11 dB,同时呼叫内对数梅尔距离为9.6 dB,与后者的10.7 dB相近。适用范围限于鸣声稀疏且单只显著的录音,密集多动物、极低频或极高频与脉冲噪声仍困难,蒸馏与标注在集成显卡上约两小时完成,学生在笔记本电脑中央处理器上约90倍实时运行。
🔗 开源资源
- 第三方资源:https://callcleaner.github.io — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. REAL:把成段语音偏好拆成带时间证据的逼真度评价

英文题目:REAL: Reward Modeling through Evidence-Linked Analysis of Lifelikeness in Generated Speech
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yaodong Song:机构信息未能在本次解析中与作者逐人可靠绑定
- Jie Lian:机构信息未能在本次解析中与作者逐人可靠绑定
- Xusheng Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Genliang Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongjie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Kang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhen-Hua Ling:机构信息未能在本次解析中与作者逐人可靠绑定
- Jie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongxiang Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
面对合成语音已较少出现整句不可懂、更多是停顿、重音、情感是否贴合文本这类局部不自然的问题,单凭听感打分难以指出位置和原因,论文输入同一文本对应的两个候选语音,输出二选一偏好以及从时间区间到现象再到维度的说明。先由协调模型调度两个语音理解模型独立分析并提取候选间差异,再由强制对齐模型输出字符级时间边界形成公共时间轴,最后对分歧处发起追问并将整合后的报告送入过滤,只保留与人工偏好一致的样本用于训练。接着把报告作为目标,用带时间标记的单模型学习从指令加文本加两段语音到结构化报告的映射,推理时不再依赖合议模型和人工标签。与已有成对偏好或单模型生成解释的做法不同,该工作把局部观察和全局判断的对应关系写进监督信号,并把评测分为明显缺陷与强系统间细微差异两层。在REAL-Eval-Standard的400对二选一偏好判断中,该方法偏好准确率为84.43%,高于基座MiMo-Audio-Instruct的68.42%,提升16.01个百分点。在REAL-Eval-Fine的207对二选一偏好判断中,该方法偏好准确率为65.36%,高于同一基座的53.95%,提升11.41个百分点。结论适用于中文朗读类文本和所测的合成系统范围,细粒度场景仍有差距,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://dl.fbaipublicfiles.com/mms/torchaudio/ctc_alignment_mling_uroman/model.pt — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 压缩后还剩什么线索:第一共振峰统计为何更耐编码器

评分:6.3/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yash Sukhdeve:Department of Electrical and Computer Engineering
- Aaron Storey:Department of Computer ScienceClarkson University, Potsdam, NY 13699, USA
- Masudul H. Imtiaz:Department of Electrical and Computer Engineering
📌 核心摘要
伪造语音检测输入是十六千赫语音波形,输出是真实录音还是合成或转换生成的真伪判决,难点是电话与平台压缩会抹掉训练时有效的细微线索。本文先在逻辑访问训练集上提取共振峰、功率归一化倒谱系数、线性频率倒谱系数和韵律四组话语级标量作为候选线索,输出为每个话语的固定维特征向量。再用非参数检验加效应量与自助置信区间筛选具有大实际区分度的描述子,并将其输出送入支持向量机做真伪判决,最后在多信道评测中按编解码条件分别报告等错误率。与堆叠更多特征不同,该方法以效应量区分统计显著与可部署的稳定线索,只保留大幅度且压缩后仍有间隔的线索。与已有方法关键差异在于用稳定性做特征选择,意味着以可解释的物理共振线索换取跨信道可预测性。在ASVspoof 2021逻辑访问评测集7种编解码信道条件下以等错误率跨条件极差比较,36特征模型极差为13.1个百分点,而4特征第一共振峰支持向量机仅波动3.4个百分点、方向为更稳定,且该4特征高度冗余、主成分第一轴解释79%方差。从ASVspoof 2019开发集到ASVspoof 2021评测集以等错误率比较退化幅度,36特征模型从9.5%升至23.5%,而4特征模型仅从17.0%升至22.9%,方向为退化更小。作者把该分支定位为可解释的法医诊断信号、可与高精度神经检测器互补,但其绝对精度低、对窄带电话信道仍不可靠且未验证融合收益。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. 只用平面图加一段混响语音,能画出整间房的声学地图吗

英文题目:Reverberant Speech Conditioning for Material-Aware Acoustic Parameter Mapping
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yi Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Olha Townsend:机构信息未能在本次解析中与作者逐人可靠绑定
- Qianqian Fang:机构信息未能在本次解析中与作者逐人可靠绑定
- Magdalena Fuentes:机构信息未能在本次解析中与作者逐人可靠绑定
- You Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
房间内每处听感不同,要完整描述需要知道每对声源与接收点之间的脉冲响应,论文把每个脉冲响应压缩为六个倍频带上混响时间T30、早期衰变时间EDT、明晰度C50和直达混响比DRR共24张密集分布图,目标是从平面图加一段单点混响语音直接预测整张图,难点是平面图缺少表面吸声等材料信息,而语音只在固定说话人与麦克风处观测。先将同一段混响语音送入冻结的盲估计器,得到频谱基线、盲估计嵌入、标量混响估计或重建脉冲响应四种候选语音派生输入,其中重建脉冲响应经与参考响应相同的谱前端处理为通道图。再把光栅化的平面图与所选语音派生输入在通道维拼接后送入U-Net地图预测器,输出24张图。与已有用场景内参考脉冲响应做条件的方法不同,该工作用语音替代难以获取的参考响应。在MRAS测试集上,以T30比例误差为指标,重建脉冲响应条件将误差从只用平面图的31.5%降到19.9%,低于只用平面图并接近参考响应的17.5%,对应83%的差距闭合。语音带来的改善几乎都表现为整图电平更准,电平校正后空间相对变化的预测没有实质提升。结论适用于几何固定而材料变化的MRAS场景及C4DM教室这类较长混响房间,在dEchorate短混响真实房间T30预测值高于实测值1.9–2.5倍,且多位置语音与带家具三维几何尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Alizeded/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/Audio-WestlakeU/Rec-RIR — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. DASWeave:把四种说话场合的差异织进抑郁焦虑压力筛查

评分:6.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Binyan Chen:University of Science and Technology of China, Hefei, China
- Tong Pan:University of Science and Technology of China, Hefei, China
- Yadong Liu:University of Science and Technology of China, Hefei, China
- Xin Yun:University of Science and Technology of China, Hefei, China
- Shangfei Wang:University of Science and Technology of China, Hefei, China
📌 核心摘要
输入是同一青少年在四种说话条件下的音视频与转写,输出是抑郁、焦虑、压力三个二值筛查标签。难点在于单段行为受个人习惯影响,而条件间变化更能反映心理状态。共享会话编码器把每段音视频与局部文本映射到同一空间的会话表示,再做掩码平均得到参与者表示。两层树融合用有监督提升树从数万维行为统计中学习与标签相关的划分,叶子索引经嵌入后在聚合前后分别残差加入。参与者语言融合用微调语言模型通读全部回答与相对朗读的行为差异描述,再把语言表示残差加入。训练时另有固定多模态大语言模型表示上的辅助分类器提供软目标。在 ACM Multimedia 2026 AdoDAS 挑战赛 Track 1 隐藏测试集上,DASWeave 平均 F1 为 0.5853,相对官方音视频基线 0.4604 提升 27.1%,平均 AUROC 为 0.8019。结论适用于同一协议下未见参与者的量表筛查,跨学校与跨设备迁移尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
49. 谁当老师谁当学生:按能力决定方向的语音理解与生成迭代优化

英文题目:Capability-Guided Iterative Online Optimization of Cascaded Spoken-Dialogue Modules
评分:6.1/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuhang Qiu:机构信息未能在本次解析中与作者逐人可靠绑定
- Bohan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenbin Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhihan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiwei Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Hankun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:X-LANCE Lab, Department of Computer Science and Engineering, Shanghai Jiao Tong University;MoE Key Lab of Artificial Intelligence, Jiangsu Key Lab of Language Computing, China;Corresponding author: Kai Yu
📌 核心摘要
级联语音对话把语音输入转成内容、中间决策模块决定回复、再把回复转成波形,本文只优化两端的外围模块,中间决策保持不变。困难在于两个模块强弱随语言和声学条件变化,固定由谁教谁会把弱模块的错误传给对方,而且训练中模块本身还在变化。
处理分两段:先在保留探针上用同一可懂度指标测出哪一端更可靠,再按可靠方向选用单侧数据在线构造监督并筛选后更新被选学生。语音识别用 Whisper large-v3 实现,语音合成用 CosyVoice2 实现,前者更新用合成语音,后者更新保留真实波形只刷新伪文本。相对官方初始值,在线优化后 Whisper 在中文 MAGICDATA-RAMC 测试集字符错误率从 14.18% 降到 10.77%,CosyVoice2 经 Qwen3-ASR-1.7B 测得中文字符错误率从 4.78% 降到 4.04%。结论适用于日语 Common Voice 和中文 RAMC 上报告的探针与测试划分,合成侧在线方式弱于静态合并,原文披露了 200 步识别更新和 600 步合成更新的预算与保存策略,未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
50. 乡村老年自发语音怎么做识别:对齐打分、两阶段微调与多系统投票

评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Fernando López:机构信息未能在本次解析中与作者逐人可靠绑定
- Jordi Luque:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入是西班牙乡村老年人的自发访谈录音,输出是对应会话的文字转写,难点在于高龄发音、方言变体、打断重叠、西班牙语与加泰罗尼亚语等地方语言混用,以及长录音中转写边界漂移。系统先用已训练的 CTC 模型把参考文本与音频后验概率对齐,得到每条语段的平均对数概率作为匹配质量分数,低于 -2.0 的语段被划为低置信并在第二阶段剔除。接着以 Voxtral-Mini-3B-2507 为基座做两阶段低秩适配,第一阶段用全部约 30 小时数据学习领域声学,第二阶段用约 23 小时高置信子集以更小学习率精修,随后对适配器因子矩阵做按幅度保留的后处理剪枝以抑制过拟合。长录音推理时先用语音活动检测切分成最长 25 秒的窗口分别解码,再用 ROVER 对七个系统的窗口假设投票融合,其中包含两个 Voxtral-Mini-3B 配置和五个其他架构。最终七系统融合在官方评测上达到未归一化词错率 36.25%,相对最佳单系统 38.22% 降低 1.97 个百分点,归一化词错率为 22.17%。结论适用于该赛事划分与评测流程,剪枝最优保留比例和阶段选择随架构变化,长窗口调优在内部预切分片段上不可见。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
51. 不用判别器也能做对抗域适应:语音分类鲁棒性解读

英文题目:Discriminator-free adversarial domain adaptation for robust speech classification
评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yacouba Kaloga:机构信息未能在本次解析中与作者逐人可靠绑定
- Ina Kodrasi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音情感识别和病理语音检测在训练与测试的语料、语言或噪声不同时性能会明显下降,而为每个目标域重新标注数据的代价很高。论文研究无监督域适应,只用有标签源域和无标签目标域来学习对域差异不敏感的表示。先冻结自监督语音编码器提取语音表征,经均值-标准差时序池化输出定长向量并送入可训练轻量多层感知机适配头。再把适配头输出送入任务分类器得到源域和目标域预测矩阵,最后从两类预测矩阵计算核范数Wasserstein差异,经梯度反转让分类器增大该差异而适配头减小该差异,从而省去单独的域判别器。与需要训练额外判别器的DANN和CDAN相比,该做法减少了一个需要调参和平衡容量的对抗分支。在六组英语内部语料适应上,该方法相对未适应基线平均提高目标UAR 7.3%,高于CDAN的2.1%和DANN的-0.1%。在PC-GITA噪声适应上,该方法相对基线平均提高目标说话人准确率14.6%,高于CDAN的10.7%和DANN的10.2%。结论适用于所测的多分类情感任务和二分类病理检测任务中的语料偏移与加性噪声偏移,对未测试的混响、信道或说话方式偏移尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
52. 把译文分组再合成会改变长语音同传的完播比较吗

英文题目:Text Grouping Changes Completion-Time Comparisons in Long-Form Simultaneous Speech Translation
评分:6.1/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hieu Minh Truong:机构信息未能在本次解析中与作者逐人可靠绑定
- Dung D. Le:VinUniversity, Vietnam
📌 核心摘要
长语音同声传译需先产出译文文本再合成为连续播放语音,文本早产出不等于语音早结束。论文固定两种译文策略各自的德语文本内容与可得时刻,只改变把多次文本更新合并后再送入合成的等待规则,以分离分组干预对完成时间差的影响。先保存10段英德MuST-C讲座的StreamAtt与其固定音频历史基线各自的更新文本与可得时刻序列,保持组内文本不变。再按立即发送或等待2秒、4秒等定时规则把待处理更新合并为合成输入,翻译结束时释放剩余文本,输入超限时再切分为多个请求。最后将合并后文本送入XTTS-v2或Piper分别合成,用串行播放时钟累加音频时长与等待空闲,并记录首次播放时刻得到完成时刻。在10段讲座探索集上以StreamAtt相对基线的平均完成领先时间为指标,4秒分组让该领先在XTTS-v2下从106.58秒扩大到229.08秒,在Piper下从169.46秒缩小到146.46秒,音频变短但播放空闲变化不同导致方向相反。两种相反方向在另选20段讲座确认面板上复现,论文因此要求评测同时报告分组与尾部释放规则、实际请求长度、音频总时长、播放空闲和首次播放,而不只写合成器名称。适用范围限于英德讲座、一个检查点和每后端一种声音,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
53. 流式语音增强怎么做成可部署的通道:GigaEdge Spench 解读
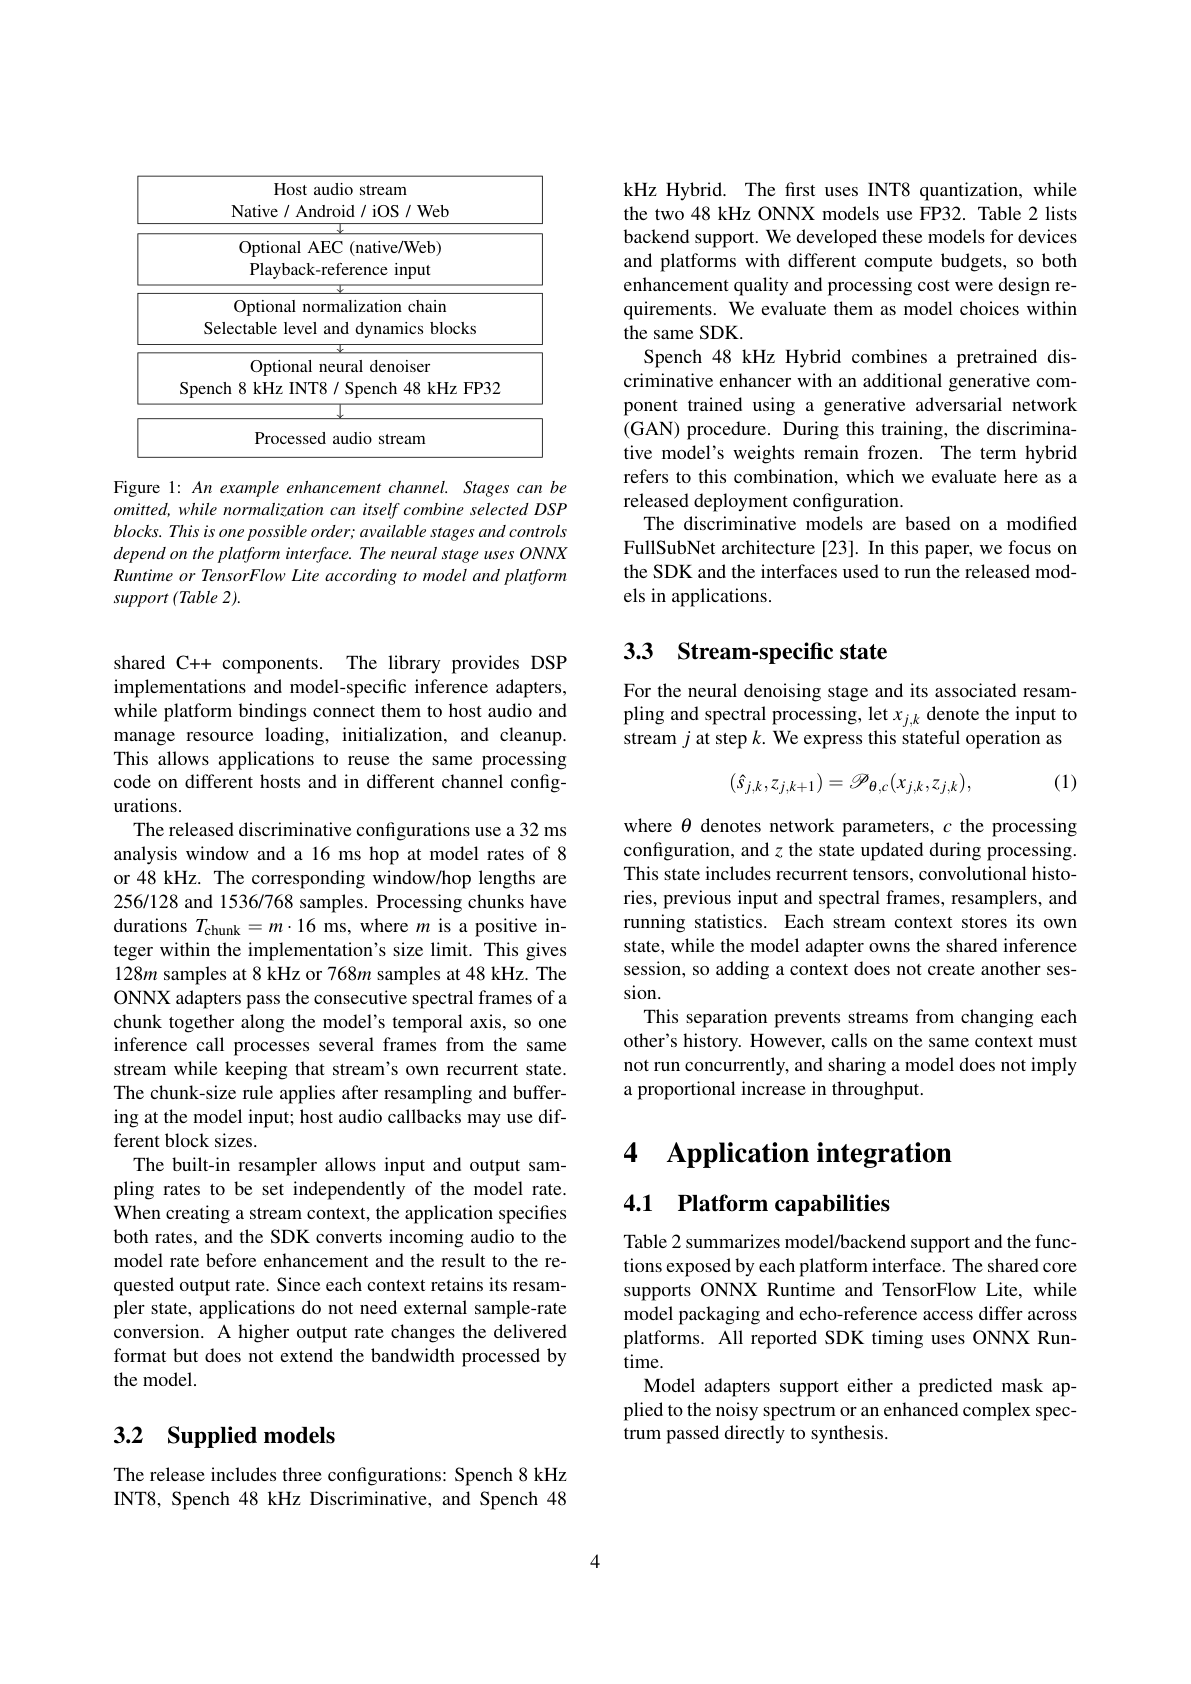
图片来源:原论文 PDF 第 4 页(含图 1)。完整图注与解读见独立文章。
英文题目:GigaEdge Spench: An SDK for Practical Streaming Speech Enhancement
评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Artem Sokolov:Tashkent, Uzbekistan
- Artem Khaidarov:Moscow, Russia
- Yana Lysova:Moscow, Russia
- Alexander Gladkikh:Moscow, Russia
- Vitaliy Yulis:Moscow, Russia
📌 核心摘要
实时语音增强需要把连续到来的音频切成小块逐块去噪并保持跨块状态,同时与音频回调的不同块大小、重采样和电平控制协同,难点在于完整链路的延迟、吞吐和多路并发都要满足应用要求。本文提出的 GigaEdge Spench 把增强通道定义为有序流水线,应用可组合神经去噪、可选的归一化链、重采样和回声消除,共享 C++ 核心通过 ONNX Runtime 和 TensorFlow Lite 在原生、移动和 Web 端运行。先由重采样把输入音频转换到模型采样率,其输出送入按16 ms倍数构成的分块缓冲,再提取同一流的连续若干频谱帧并沿时间轴一起送入一次推理调用,在保留该流自身循环状态下完成神经去噪,最后把增强结果重采样到应用请求的输出采样率交付。发布包括 8 kHz INT8 模型和 48 kHz 判别式与混合式 FP32 模型,其中混合式是在冻结判别式模型权重基础上再结合用生成对抗网络过程训练的生成式成分的组合配置。在 EARS–WHAM v2 共 886 对含噪与干净文件的评测中,48 kHz 混合模型 PESQ-WB 为 1.87、DNSMOS P.808 为 3.45、NISQA MOS 为 3.20,参考的 DPDFNet2 48 kHz HR 对应为 2.21、3.66 和 3.81,混合模型在部分语音保持维度接近但总体预测仍落后。共享模型容量测试显示 48 kHz 混合模型平均通过 56.00 路并发流,为同条件适配后 sherpa-onnx/DPDFNet2 的 3.73 倍,而 8 kHz 模型可达 593.33 路,但带宽条件不同不能直接比较优劣。原文未披露训练、量化和转换工具的完整开销,推理代价以每秒音频的加权乘加数和实测实时率给出,结论适用于所测 WSL2 主机、16 ms 外部块和 10 s 窗口等条件,未验证长期服务和人耳偏好。
🔗 开源资源
- 第三方资源:https://github.com/salute-developers/gigadenoiser — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
54. BAmbiDrop:不换模型如何把任意麦克风阵列变成双耳增强输出

评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Michael Tatarjitzky:机构信息未能在本次解析中与作者逐人可靠绑定
- Vladimir Tourbabin:机构信息未能在本次解析中与作者逐人可靠绑定
- Boaz Rafaely:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是麦克风阵列录制的混响多说话人场景,困难在于增强网络通常只适配一种阵列几何,而双耳回放又要求保留两耳间的强度与相干关系。输入是阵列传声器录制的混响混合信号,输出是双耳语音,处理过程需要同时抑制干扰说话人并保持目标声空间属性。论文冻结只在理想Ambisonics信号上训练过的AmbiDrop网络,Ambisonics在这里指与阵列无关的声场球谐表示,对应原点声压的通道用于估计掩码。先把Ambisonics坐标原点依次移到每个传声器位置并用匹配编码器得到多组通道,再把各组通道送入同一冻结网络估计多个复数掩码并取复数均值形成共享掩码,最后把共享掩码直接作用于原始传声器信号并用固定双耳匹配滤波器渲染输出。相对已有方法,关键差异是训练与阵列无关,推理时不更新网络,只靠原点重定位与掩码融合实现零样本迁移到新阵列。在对21个自由场与刚性球阵列各100个样本取平均的仿真评测中,共享掩码的Fusion在SI-SDR上为-0.30 dB,高于逐通道掩码Per-Mic的-2.51 dB和单中心掩码Center的-0.87 dB,同时在SI-SDR-Dir上为0.69 dB,优于Per-Mic的-3.23 dB。结论适用于仿真混响、目标位置固定的条件,偏轴与运动目标尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
55. 整句错得不多,关键词却丢了:KeyASRBench 如何度量整词短语保留
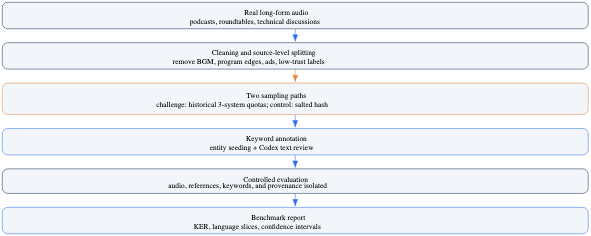
英文题目:KeyASRBench: Measuring Whole-Phrase Keyword Preservation in Real-World ASR
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Guanzheng Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyi Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音识别的整句错误率已经很低,但人名、产品名、技术术语、带版本号的名称以及改变指代的关系短语仍可能被改写或丢失,论文要回答的是转写稿是否保住了这些被选定的整段短语。输入是播客与圆桌讨论等长音频切出的中英文片段及参考转写,系统输出完整转写文本,同音替换和切分变化会破坏整段含义,而逐字平均的序列指标会把这种破坏稀释。先从参考转写出发,用实体与术语规则提取长短语优先的候选跨度并做统一归一化,再将候选送入复核环节保留每段一至三个信息承载短语并冻结边界与允许写法,最后把冻结的关键词表送入同一匹配器,在假设文本中统计选定短语的缺失与多出出现次数并微平均为关键词错误率。与已有做法的差异是只看选定短语出现次数,不计普通词和格式改动,也不要求位置对齐,同时把整句混合错误率放在旁边对照。在十小时挑战集上,StepAudio 3 ASR Max的整体关键词错误率为13.61%,低于Qwen3-ASR-0.6B的33.81%,而七个系统的语言适配序列错误仅为5.31%至12.91%,说明整句指标相近时短语保留仍可分开排序。结论适用于该试点收录的播客与技术讨论语料和冻结的关键词定义,未验证检索或人工可用性收益,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
56. 只见过真话的检测器:多层 WavLM 正态建模与开放世界音频伪造检测

英文题目:When Normality Shifts: Multi-Level WavLM Modeling for Open-World Audio Deepfake Detection
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Daniel Niekurzak:机构信息未能在本次解析中与作者逐人可靠绑定
- Daniel Kozuch:机构信息未能在本次解析中与作者逐人可靠绑定
- Weronika Folwarska:机构信息未能在本次解析中与作者逐人可靠绑定
- Khan Muhammad:机构信息未能在本次解析中与作者逐人可靠绑定
- Rafał Scherer:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
面对合成语音生成器和信道在部署后持续变化,论文研究只用真实语音建立正常语音分布、靠偏离程度发现伪造的检测方式,输入待判定语音波形,输出偏离真实语音分布程度的分数与是否伪造的判定,难点在于真实语音受说话人、内容、环境和编解码影响而分布宽泛且阈值需在未见域保持可用。先冻结大规模预训练语音处理模型WavLM Base+,对第3、6、9、12层隐藏状态做掩码平均池化提取话语向量,再把每层向量送入独立拟合的标准化器与Ledoit-Wolf收缩协方差高斯模型计算马氏距离得到层分数,最后用训练集真实语音的中位数与中位数绝对偏差对层分数做稳健标准化后等权平均得到最终偏离分数,无需训练神经后端。论文同时保留有监督的WavLM-HM-Conformer参考系统做同前端对比,以区分有无伪造标签带来的差异。在ASVspoof 2019 LA评测集上,无攻击的MLN-WavLM-Full达到8.45%等错误率,等错误率指误报率与漏报率相等时的工作点,数值越低排序越好,接近同前端有监督参考系统的7.86%。但在ASVspoof 2021 DF上两者分别退化到22.12%与14.94%,且源域标定的真实语音百分位阈值迁移后误报率升至20.23%。结论适用范围限于该基准家族内的复合域偏移,无标签阈值重估只能在排序未崩溃时恢复误报预算,不能修复低误报区召回的塌陷。原文披露MLN-WavLM可训练参数为零,冻结WavLM Base+约94.7M参数,嵌入提取在单块12 GB显存消费级GPU上完成。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
57. 用相似片段引导扩散模型补全长段缺失音乐

英文题目:Music Inpainting With Similarity-Guided Latent Diffusion
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.6/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sean Turland:机构信息未能在本次解析中与作者逐人可靠绑定
- Eloi Moliner:机构信息未能在本次解析中与作者逐人可靠绑定
- Vesa Välimäki:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要修复的是音乐录音中长达数秒的连续缺失段,输入是保留观测区、缺失区间置零的波形或潜在表示,输出是填补后听感连贯的完整音乐。难点在于缺失区位于掩码算子的零空间,仅靠观测区的似然难以约束旋律、节奏与结构身份,长缺口下易出现身份漂移。方法先在同一首歌缺失区间之外的剩余部分搜索与缺失前后文相似的片段,提取单个最优候选或多个加权候选作为辅助表示送入似然构造。再把候选看作缺失区的含噪观测,与原始观测拼接推导包含观测项和辅助项的修正似然,最后在逆扩散每一步用去噪估计同时拟合观测区和候选区,其中多候选版本仅在早期引导低频结构以衔接边界。在MUSDB18-HQ测试集500个15秒片段中间5秒缺失的评测中,MFCC距离指标上SimDPS-Multi为97.8,低于DPS的105.6和Latent-Sim的112.1。在MUSDB18-HQ测试集500个15秒片段中间5秒缺失的同一评测中,MusicFM距离指标上SimDPS-Multi为14.42,低于DPS的15.19。听感试验显示检索质量较差时多候选引导仍能改善合理性,但在个别曲目上可能不如单候选或无引导采样,效果随曲目变化明显。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://s-turland.github.io/SimDPSInpainting/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
58. 当音频和视频误导判断:对话情感识别的多模态依赖审计

英文题目:When Audio and Video Mislead: Evaluating Multimodal AI for Conversational Emotion Recognition
评分:6.0/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.6/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Youngseok Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Minjae Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Eunsoo Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Jihie Kim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
对话情绪识别要从目标话语文字记录、此前至多十轮文本上下文、目标语音和目标视频共同推断情绪标签,难点是模型能读入音视频不等于有效利用,也可能被不相关音视频带偏。先固定文字侧文字记录与上下文,再构造文字、加真实音频、加真实视频、音视频全加和三种跨对话替换共七种输入,送入三款开源Omni模型输出情绪标签预测。再将预测送入行为比较,统计真实模态成对准确率增益、替换后预测变化率和相对省略基线的干扰,以区分替换惩罚与省略之外的伤害。替换来源取自同一数据集另一对话的完整话语,IEMOCAP还限定同一会话,音频视频同源替换以保持其内部对应。最后在Qwen上屏蔽解码首个情绪词查询到音频键的注意力,对比屏蔽视频边的对照,观察金标准与最强竞争候选的对数似然边距恢复。在主要映射下,加真实音频相对纯文字的成对Accuracy增益在六组模型数据集组合上均为正,其中Baichuan在MELD上高于纯文字+4.10个百分点;同时随机音视频相对全模态的成对Accuracy效应均为负,例如Qwen在MELD上低于全模态、效应为-4.69个百分点且显著,显示增益与误导脆弱性并存。结论限于两个数据集、三款开源Omni模型和目标级整段替换,不分离韵律作用,不估计真实部署失效率。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://doi.org/10.5281/zenodo.23970406 → https://zenodo.org/records/23970406 — 链接可访问(HTTP 200)
复现相关资源:https://doi.org/10.5281/zenodo.23970406 → https://zenodo.org/records/23970406 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
59. 一个大模型搜索器如何同时调结构、超参数和数据配比

英文题目:Large Language Models as a Universal Searcher for Open-World Automated Machine Learning
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuxuan Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jihao Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Weikang Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Xijie Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Linda Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingjie Zhan:机构信息未能在本次解析中与作者逐人可靠绑定
- Aojun Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongsheng Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
要解决的问题是现有自动机器学习按领域定制搜索空间,把模型架构、训练超参数、数据配比孤立优化,换数据集、换架构空间和换模态后性能大幅下降,而为每个新任务采集训练轨迹又需要反复训练评估,代价过高。论文提出统一数值编码NCode,把每组架构、超参数和数据配比映射为离散数字序列,为跨任务搜索提供统一输入。先从NAS-Bench-301在CIFAR-10上的架构与性能记录出发,经随机边剪枝构造多样子空间并采样配对,再切分为已评估历史序列与未评估候选池,形成约228000条排序轨迹。再用这些轨迹对LLaMA-3.1-8B做全参数监督微调,训练搜索器读入历史NCode-奖励对,从候选池中选出期望最好的一个,而不直接生成完整编码。推理时冻结搜索器,最后把选出的编码送入早停代理评估得到替代奖励,再写回最多保留最优200对的历史缓冲继续循环,最优配置进入完整重训,分割、音频说话人验证和文生图均直接复用该搜索器。在GenEval文生图评测上,优化后模型总体得分为0.91,高于同一搜索空间下OptFormer的0.84,论文报告大规模训练耗费896 GPU天。该结论适用于论文给定的代理评估与重训流程,跨全新模态与更大搜索空间的稳定性尚未充分验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
60. 十二种文字的浏览器端语音识别:Swanada 如何拆开编码器与输出头

评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Hemanth HM:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
该工作处理浏览器和手机本地的语音到文字任务,输入是麦克风采集的连续语音,输出是十二种文字体系的本地转写。难点在于多语模型体积过大、浏览器算子缺失、量化后精度漂移以及流式显示闪烁。系统先用共享声学编码器提取语音的高维帧表示,输出送入单语线性映射头得到字符后验。再按用户所选语言切换体积很小的对应映射头,使解码只在当前语种内进行,避免跨文字体系混出。最后面向手机把编码器蒸馏为更浅更窄结构,把相对位置编码改成按当前长度即时合成,把逐点卷积改写成矩阵乘法以适配浏览器加速,再用真实量化特征重新校准映射头。在 480 条隔离录音构成的 held-out 集上,桌面档达到平均字符错误率 5.43%,在 960 条十二语未见公开测试上为 8.87%,在 1280 条十六套全量公开测试上为 12.06%,四线程中央处理器实时率为 0.0264 倍,流式中位首字时延约 30.6 毫秒且已确认前缀零改动。结论适用于相对干净的朗读和单人语音,强混响、多人重叠和自发会议仍是失效区,原文披露了模型体积、线程配置和端侧时延,没有披露完整训练算力开销。
🔗 开源资源
第三方资源:https://github.com/hemanth/swanada — 链接可访问(HTTP 200)
第三方资源:https://h3manth.com — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
61. 从查刀到看执法记录仪:多模态警务 AI 的证据支撑评估
图片来源:原论文 PDF 第 4 页(含图 1)。完整图注与解读见独立文章。
英文题目:From Weapons to Events: Evaluating Evidential Support in Multimodal AI for Policing
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Armin Mustafa:Centre for Vision, Speech and Signal Processing, University of Surrey, Guildford, United Kingdom;AI Fellow, Incubator for AI (i.AI), Department for Digital, Culture, Media and Sport, London, United Kingdom
- Syed Sameed Husain:Centre for Vision, Speech and Signal Processing, University of Surrey, Guildford, United Kingdom
📌 核心摘要
执法中的图像与视频对应两类核验方式不同的任务。一类是根据缴获刀具照片在产品目录中找回同款,输出是带元数据的排序列表,答案客观可查,难点在于刀身细节差异小且拍摄条件多变。另一类是把执法记录仪录像转写为带时间区间的事件与话语记录,输出是对复杂互动的解释,容易出现无录像支撑或说话人归属错误的陈述。方法上先用融合局部与全局特征的KHNet提取刀具描述子送入检索排序,再用混合管线分别生成视觉因果事件描述与音频转写,最后统一映射为事件类型与时间区间并做后处理,与通用全模态模型直接生成事件形成差异。在KnifeHunter含约12.5万张干扰图的最难协议下,以平均精度均值衡量,KHNet为63.4%,高于同骨干GeMNet的57.9%。在27段公开英国执法录像组成的UKBWV-27试点集上,以交并比阈值0.3的事件F1衡量,混合管线为63.1,高于最强通用模型Gemini 3.1 Pro的60.6。在同一试点集上,以无支撑事件率衡量,混合管线为13.6%,低于通用模型最高的29.5%,以说话人准确率衡量,混合管线为72.3%,高于Gemini 3.1 Pro的69.2%,仍有27.7%话语归属错误。结论只适用于该试点集的公开、剪辑和噪声条件,不能视为实战可靠性,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
62. 冻结音频大模型之后再做属性解耦:音乐相似检索的事后拆分研究
英文题目:Exploring Post-Hoc Disentanglement of Audio Foundation Models for Music Similarity
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lucas de Souza Brandão:机构信息未能在本次解析中与作者逐人可靠绑定
- Gabriel da Costa Merlin:机构信息未能在本次解析中与作者逐人可靠绑定
- Diego Furtado Silva:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音乐相似同时涉及流派、乐器、情绪等多个因素,同一对曲目可以在一个因素上相近而在另一个因素上不同。音频基础模型能抓住整体相似,但把不同因素混在同一个向量空间里,难以按指定因素检索,也难以解释检索依据。本文冻结 CLAP、MuQ、MERT 三种骨干,只在输出的嵌入上学习适配和掩码,把完整向量路由到三个属性子空间。处理沿一条样本展开:一段曲目先被切成短窗抽取帧特征,再压缩为固定长度序列并聚合成单个向量,接着经适配模块变换并与属性掩码逐元素相乘,最后在掩码后的子空间里用三元组损失拉近同属性样本、推远不同属性样本。相对从零训练解耦表示的做法,该工作保留预训练知识且训练量小。在 MagnaTagATune 外部测试上,CLAP 的多层感知机配合平均池化和固定掩码在三类三元组平均准确率上达到 76.9%,高于同骨干 74.8% 的未掩码均值池化基线,解耦主要来自压低非匹配属性的得分。结论适用于以这三个属性和这两套数据集定义的曲目级相似检索,尚未验证更多属性、更细粒度和跨风格分布下的稳定性。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
63. 小数据生成模型如何学习波斯书法笔声 sarir
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Arshia Sobhan:机构信息未能从 arXiv PDF 文本可靠映射
- Paul Triana:机构信息未能从 arXiv PDF 文本可靠映射
- Philippe Pasquier:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
读者需要先理解的对象是sarīr,即波斯nastaliq书法中芦苇笔尖经墨在纸面摩擦产生的细碎吱吱声,输入是书写手势的压力、速度和笔宽变化,输出是随之变化的音色和包络,困难在于它在通用大模型训练数据中几乎没有出现,文字提示难以描述其质感。论文先自建220分钟录音并切成6秒单次手势片段提取规范化频谱图,再训练声音合成模型RAVE和图像生成模型StyleGAN2分别学习可实时操作的潜在空间与时频图分布。最后StyleGAN2输出的频谱图经波形重建得到声音,部分样本再送入RAVE的风格迁移模式做滤波,以去掉频谱重建带来的人工染色。在自建sarīr频谱图验证集上,与同期训练的其他检查点相比,所选StyleGAN2检查点以生成图像与参考样本的特征分布差异指标取得最低值9.37。在多组提示的基线评测设置下,与AudioLDM2等三种通用文本到音频模型相比,它们均未产生接近sarīr的声音,缺乏其音色调制与缓慢长手势。相对已有做法的关键差异是把数据采集、筛选和增强当作文化表达手段,而不是依赖英文提示调用通用大模型,实际意义是为高度地方化的声音材料提供了可演奏的生成工具。结论只适用于该自建数据集覆盖的笔宽、压力和行笔范围,未验证跨书体或跨录音环境的泛化,训练成本上原文披露单次RAVE配置在单块H100上约需11小时,而StyleGAN2训练在两块H100上以批量16完成800kimg。
🔗 开源资源
第三方资源:https://www.metacreation.net/sarir — 链接可访问(HTTP 200)
第三方资源:https://github.com/acids-ircam/RAVE — 链接可访问(HTTP 200)
第三方资源:https://forum.ircam.fr/projects/detail/nn/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
64. SCLAP:用单调传输对齐帧与词,改善长音频定位
英文题目:SCLAP: Temporal structural alignment improves localization in long-form audio
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yacouba Kaloga:机构信息未能在本次解析中与作者逐人可靠绑定
- Ina Kodrasi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
长音频里目标事件常只占几十秒到300秒录音中的一小段,整段标题没有给出帧级时间戳,均匀池化容易把短事件淹没在背景中。论文提出序列级对比预训练框架SCLAP,先为音频帧序列和文本词序列分别预测重要性权重并输出音频边际分布与文本边际分布,再把两分布送入保持顺序的一维最优传输求解帧词软对应,最后把传输加权的相似度送入对称对比损失训练。训练完成后检索直接用各自权重加权池化再算余弦相似度,定位则把每帧音频与加权后的文本向量算分,不必再求解传输。在CASTELLA训练划分训练并在测试划分评测的长音频检索中,加权池化读数SCLAP-P的mAP@10为24.80%,高于均匀池化的CLAP的21.47%。在CASTELLA全长录音无时刻监督的零样本时刻检索中,SCLAP在R@1与IoU不小于0.3时为7.60%,高于CLAP的6.10%与注意力变体TAP的4.67%。结论适用于整段标题监督、事件占比较低的长音频,对标题语序与音频顺序明显不一致、多事件并列的情况尚未充分验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
65. 只给答案分不清哪里错:AuDiR 用加规则和加听觉描述来定位音频推理失败

英文题目:AuDiR: Diagnosing Audio Reasoning with Rule and Percept Interventions
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.7/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Chengwei Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Nancy F. Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音频推理需要同时完成三件事:从声音里听出题目要用的量,知道题目依赖的通用规律,再把规律用到听出的量上得出答案,答错本身无法说明哪一步出错。AuDiR为每道选择题同时准备音频、问题、任务通用规则文本和听觉观察文本,观察文本写出解题所需的频率、时刻、数量等具体数值。先让同一模型在只给音频和问题的输入下作答并提取基线答案,再把任务通用规则文本送入同一题目重新作答以检验规则缺失,最后把听觉观察文本与规则一起送入作答以检验感知缺失,首次答对的位置输出该模型与题目组合的操作性分组。另设去掉音频只留问题和规则的对照,用于检验不听音频能否猜对。当前构建包含201道四选一题目,分属18个族,来自9个来源,平均音频时长6.8 s。在Gemini-3.8-flash的初步评测中,无附加信息准确率为29.3%,附加规则后为31.3%,再附加观察文本后达到98.5%,无音频对照为23.9%,95% Wilson区间包含25.0%的随机猜测水平。该结论只适用于单次作答、单模型和当前201题集合的聚合比较,不支持把感知分组增益等同于更换音频编码器的效果;存在16题在附加规则后由对变错等非单调响应、部分分类题可用直接识别绕过所述规则、观察文本准确性未经人类听音验证且答案独立性仍待溯源审计,这些条件下失效归因可能失败。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
66. 生成式产品视频广告如何审改:六个问题、两类评审与定向修复

评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Anoubhav Agarwaal:机构信息未能在本次解析中与作者逐人可靠绑定
- Sukesh Perla:机构信息未能在本次解析中与作者逐人可靠绑定
- Karthikeyan Mohanraj:机构信息未能在本次解析中与作者逐人可靠绑定
- Susmita Ghose:Anoki Inc.
📌 核心摘要
待处理的对象是面向电商目录中每个商品自动生成的短视频广告,输入是商品的listing文本、规格、目录图、脚本、合成旁白、生成画面、字幕和片尾,输出是对每条广告可用与否的判定以及可执行的局部修改。难点在于缺陷细碎且依附于具体商品,生成模型会编造多余部件、错位轮子、读错品牌或虚构功效,人工容易漏检,单一整体打分又无法定位到场景和台词。方法让人工与评审模型共用同一套六问评审,先由评审模型把发现挂到对应场景、台词或字幕上并输出带位置的待确认发现,再由人工逐条接受或拒绝并补充遗漏,最后每条确认问题打开与其种类匹配的修复工具,只改最小单元并送回重审。与只做整体质量打分的做法不同,该框架把问题种类、位置和修复动作绑定,评审问题不随生成模型更换而改变。在同60条广告280个场景上,以产品标错场景占比为指标,看到评审模型提示的多数意见为58%,高于隐藏提示后评审者的平均26%。结论适用于英文旁白和有限品类下的自有管线,跨语言、跨管线和完整修复闭环的效果尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
67. 全双工语音助手何时该听、该说、该打断:Omni-JEV 的五动作决策

评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shengzhou Kong:Merit Interactive Research Institute
📌 核心摘要
读者需要理解的对象是全双工对话中用户话语与助手回应状态共同决定的下一步动作,困难在于话语完结、下一说话人、打断意图等线索含义随回应是否活跃、是否曾被打断而变化,处理过程要求在收集片段端点处结合文本或双路语音证据输出五个交互动作的概率分布。先复用语音到语音对齐的前端与思考模型,用同一编码器分别编码用户与助手参考语音并保留角色分段,将连续帧嵌入与指令、上下文及候选描述拼接后送入同一因果Transformer。再利用原始词表头在最终答案前缀隐状态处取出候选符号对应分量并归一化为动作概率,经交叉熵微调得到监督起点,使文本与语音共用同一读出目标。最后从同一监督起点出发,分别用高斯扰动完整概率向量与分类Choice采样候选位置估计负Brier误差的两种概率敏感决策强化学习延续训练,高斯探索相对分量而Choice探索候选位置。与复现的分类Choice分支音频准确率84.04%、文本准确率96.51%相比,高斯分支在固定测试集上音频准确率为84.08%,文本准确率为96.55%,而分类分支Brier误差与负对数似然更低,这种分类与概率质量的不一致是本文的关键实证结果。结论只适用于该弱标签自然频率划分,作者明确在线历史压缩、声学鲁棒性与多轮效用尚未测量。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
68. 钢琴转谱数据集里的音频与 MIDI 到底对齐得怎么样:一种给对齐打分方法的评测框架
英文题目:Assessing Alignment in Automatic Piano Transcription Datasets: A Benchmark for Scoring Methods
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.6/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Lucas de Souza Brandão:机构信息未能在本次解析中与作者逐人可靠绑定
- Lucas Gris:机构信息未能在本次解析中与作者逐人可靠绑定
- Joaquim Cavalcante:机构信息未能在本次解析中与作者逐人可靠绑定
- Chukwuemeka Nkama:机构信息未能在本次解析中与作者逐人可靠绑定
- Andrea Poltronieri:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自动钢琴转录需要音频和MIDI在音高与时间上对应,输入是一段钢琴录音与一份MIDI,输出是两者对齐程度的分数,难点是常用数据集存在几十毫秒级的起始偏差,而以往靠转录准确率间接判断,容易混入音色和模型能力的影响。本文固定音频、只改写MIDI,再看分数是否随破坏加重而下降,从而比较打分方法。本文新增的STI方法先用转录模型从音频提取预测MIDI,再把预测MIDI与待评MIDI按相同音高组成二部图并送入匈牙利算法求最优匹配,最后把匹配对的起始时间差异和同音音符间隔差异经指数衰减输出为连续权重并算出F值。与已有音符F值只做硬判决不同,STI用连续权重使小偏差仍能拉开分数。在三数据集平均的起始偏移破坏下,STI系列单调性指标为0.95,低于谱方法CS-S与CENS方法CS-C、DTW-C的单调性指标0.97到0.99,但STI敏感性指标为0.93到0.95,高于上述方法的敏感性指标0.16到0.23,说明STI更适合捕捉转录数据集中主要的细小时间错位。结论适用于钢琴独奏的音频与MIDI对齐筛选,对其他乐器和力度错位尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
69. 输出驱动的任意微调重采样:相位连续的流式做法与代价

英文题目:Real-Time Arbitrary Resampling for Phase-Continuous Microtuning in Audio Streams
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.7/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Andreas Falkenberg:QPI Laboratories, Inc.;Escondido, CA, US
📌 核心摘要
读者需要理解的对象是一段已录制的音频波形,困难在于用很小比例改变其整体音高,同时保持输出时钟稳定且不引入断裂,处理过程是按输出时刻计算其在输入时间轴上的小数位置,再从邻近输入样本插值得到输出。先由源参考频率与目标频率或音分偏置算出音高比例p,再结合输入输出采样率换算成小数步长q并初始化输入坐标,该步长与当前位置输出给逐点推进环节。再对每个输出点按累加位置取出k=⌊u⌋处及其后一样本,把小数残差α送入线性插值得到输出并按当前q推进u,变速时只改变后续q而不回置读数以保持相位连续。音乐映射把频率换算为音名与音分残差、正弦合成用相位累加直接发声,两层只向重采样或振荡环节提供目标频率,不做音高估计与复音分离。相对已有任意时刻带限重采样,差异在于每输出点只取两样本做线性插值,把插值算术固定为输出长度的线性规模,代价是频响不平坦并出现镜像混叠。在对44.1 kHz采样的1 kHz纯音施加0至+50音分线性斜坡并观察4410个输出帧、加Hann窗做高分辨率DFT的评测设置下,归一化幅度谱幅度指标显示载波基波为0 dB参考而镜像旁瓣峰值约为-26 dB,低于载波基波,且基波跟随目标移动无可见断裂。该结论只适用于窄带单频仿真,宽带音乐、混响与噪声下的失真尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
70. 调性连续性如何约束贝叶斯调性推断中的证据强度
英文题目:Constraining Evidence Strength in Bayesian Tonal-State Inference: A Posterior-Continuity Diagnostic
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chen-Gia Tsai:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
调性估计需把时值加权音高分布映射为候选调后验,难点是专家标注只给调名而不规定后验应多集中,论文以相邻非重叠窗口后验交叠导出的连续性度量约束证据强度。方法先计算归一化时值加权音高分布与Temperley-Kostka-Payne调轮廓的KL损失,再经证据强度加权得到后验并送入交叠统计,最后输出相邻窗口连续性与跨尺度兼容度,其中证据强度随谐波密度和谐波事件数变化。与单链隐马尔可夫模型用转移概率控制持续不同,本文独立估计各时间跨度的后验,再用调性关系期望筛选信息性调变化,因而持续性排序从独立后验中涌现而非由转移矩阵预设。在相邻非重叠窗口比较中,以连续性度量λ为指标,沿用上一窗口信念相对改用均匀中性先验在λ等于0.50时获得同等预测支持。在26个保留子语料4小节窗口325个大调到平行小调i及ii、iii变化的评测设置下,以指标事件份额G比较,参数0.25和3.65处数值为0.489,高于显示参考点0.30和3.5处的0.449。在同一4小节设置的上述子语料比较中,以连续性度量λ为指标,大调到IV、V、vi变化的中位曲线保持在0.50之上,而到i、ii、iii的变化随证据强度增大由高于0.50降至低于0.50。在莫扎特K.310末乐章第32小节末4小节与16小节嵌套窗口比较中,以跨尺度兼容度λcross为指标,高增益端0.49低于低增益端0.55,同期以4小节C小调后验概率为指标,高增益端0.65高于低增益端0.53。该约束只在所选变化类型和所用轮廓适用条件下成立,阈值感知意义尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://doi.org/10.5281/zenodo.24027370 → https://zenodo.org/records/24027370 — 链接可访问(HTTP 200)
第三方资源:https://dcmlab.github.io/distant_listening_corpus/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
71. 只用一个网络做少步流式视频生成:APEX 的条件偏移与自回放

英文题目:Few-Step Streaming Video Generation via Condition Shifting
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Deyuan Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jungang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Kaiwen Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jintao Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yaole Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Tao Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianfei Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jun Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jintao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式视频生成要为每个新片段重复调用大型扩散或流模型,少步采样能直接降低长序列成本,但要在很少的评估次数下保持外观、人物一致性和对变化指令的响应。本文要解决的困难是分布匹配蒸馏依赖独立的辅助分数模型跟踪生成分布,带来额外显存、计算和双网络协调负担。APEX先沿用自回放强制让共享参数网络在原始文本条件下生成回放片段,输出自身历史条件下的生成样本。再把这些生成样本送入同一参数网络,但切换为取反后的移位文本条件,职责是从生成分布一侧估计速度场,输出对当前生成样本的伪估计。最后将该伪估计与冻结教师的参考预测做差形成分布匹配修正,反传更新少步生成器并保留感知正则;推理时只用原始条件按3次或2次骨干评估加一次空间细化器生成。在StreamAV-Bench共320例上,APEX渐进轨道视频指令履行为3.856,对照S2-Avatar为3.831,视觉美学总体为0.641898,对照为0.632606,方向均为越高越好。匹配训练设置下的单独测量显示峰值已分配显存降低4.4%,平均迭代时间缩短9.2%,但音画同步误差和部分质量指标存在权衡,结论只适用于文中的数据、时长和评估预算。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
72. 从声音判断房间是否有人:兼顾隐私的建筑音频占用感知
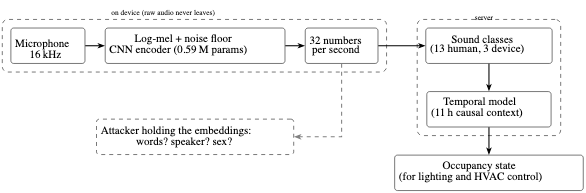
英文题目:From Sound to Occupancy: Privacy-Aware Audio Sensing for Buildings
评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Myeongwon Chae:School of Architecture;University of Illinois Urbana-Champaign
- Seonghyuk Son:School of Architecture;University of Kentucky
📌 核心摘要
楼宇需按是否有人使用控制照明与通风,被动红外传感器在久坐不动时误报空置,声音能补充打字翻页咳嗽等线索,但麦克风会录下谈话内容。论文研究两段式传感,先由设备端编码器把64维对数梅尔能量减去同10秒块内每频带第10百分位数做背景归一化,再经卷积网络把每秒音频压成32维向量并发送,原始音频不出设备;再由服务端多层感知机输出16类声音概率并取13类人声的最大值作为人声得分,最后住宅侧用因果扩张卷积对包络统计量建模约11.4小时上下文并以层次对比损失预训练后做线性探针 occupancy 推断。在LibriSpeech未见说话人的语音重建攻击评测中,直接传送频谱的词语恢复率为94.3%,该每秒单向量设计至多恢复1.0%, intelligibility 指标STOI降至0.37至0.44,但40人闭集说话人仍可识别。在11段真实办公录音DCASE 2013上按秒检测人声的评测中,带背景归一化的编码器人声检出AUC为0.869,高于对数梅尔统计加归一化基线的0.760。在HPDmobile六户留一户评测中,预训练加线性探针平衡准确率为0.678,高于手工特征加逻辑回归基线的0.649,AUC为0.752对0.748,标注稀少时优势更大。结论适用范围限于合成训练加小规模办公测试与只提供包络的住宅数据,静默占用的直接验证与远场语音下的隐私仍未解决。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/AaronChae/occupancy-audio-privacy — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
73. 视听噪声下深度网络与人脑语音表征如何对齐

评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Cheng Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhoujian Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunyi Qi:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Qi:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenhui Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenyuan Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
视听噪声下的语音理解需要同时处理目标语音包络、背景噪声以及词 onset 与可预测性等语言信息,难点在于人脑的声学加工与语言加工交织在同一段脑电信号里,难以直接对应到网络的不同层。论文先用带时滞的神经编码模型拟合脑电,再用该模型单独生成只含语音包络、噪声包络、词 onset、词 surprisal 的模拟响应,随后计算模拟响应与 AV-HuBERT 各层嵌入之间的表征相异矩阵相关。比较发现浅层嵌入更接近声学特征的模拟响应,深层嵌入更接近语言特征的模拟响应,微调把噪声表征提前到浅层并加强中深层的语言表征。与已有直接拿整体脑电与整体嵌入做相关的方法相比,关键差异是先按特征分解脑侧信号,再分特征做跨层对齐,从而能区分声学对齐与语言对齐。在视听一致噪声条件下,微调把自动语音识别准确率从预训练模型的 0% 提升到 77.14%,为微调增强对齐的解释提供了任务侧依据。结论适用于英语材料、0 dB 信噪比和 AV-HuBERT BASE 结构,视听不一致条件、其他架构与语言尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
74. UniOMA:用结构一致性补上多模态对齐缺的一块

英文题目:UniOMA: Unified Optimal-Transport Multi-Modal Structural Alignment for Robot Perception
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinrui Zu:机构信息未能在本次解析中与作者逐人可靠绑定
- Mark Hoogendoorn:机构信息未能在本次解析中与作者逐人可靠绑定
- Kevin Sebastian Luck:机构信息未能在本次解析中与作者逐人可靠绑定
- Shujian Yu:Vrije Universiteit Amsterdam, the Netherlands
📌 核心摘要
机器人感知需把视觉、力、触觉、本体感觉等观测映射到同一表示,要求同一时刻配对样本相近、不同样本分开且样本间远近关系跨模态一致,难点是常用对比目标只区分正负对,不约束模态内距离结构一致。先为每个模态按其信号类型计算输入空间相似矩阵,再以可学习模态权重做迭代优化估计一个Gromov-Wasserstein重心作为批量结构共识。接着训练各模态编码器得到嵌入表示并形成各自嵌入空间相似矩阵,最后以该共识为结构锚点最小化其与各嵌入空间相似矩阵的Gromov-Wasserstein距离,并与对比损失联合优化。相对两两对比、三元组对比和体积相似度等已有目标,该设计把跨模态耦合从两两配对改为各模态对单一共识,支持三模态以上与样本数不等的异步输入。在VFD下一时刻末端执行器朝向回归评测中,Pairwise+GW相对Pairwise基线把均方误差指标从\(1.34 \times 10^{-3}\)降到\(1.26 \times 10^{-3}\)。在VAT视觉、声音和触觉跨模态检索评测的Vis→Aud方向上,GRAM+GW相对GRAM基线把平均精度指标从0.13提高到0.79。该结论适用于轨迹、接触事件等带来共享关系结构的场合,模态信息基本不重叠或基线已饱和时收益变小。训练成本方面,在多模态轨迹一致性分类可扩展性评测中,NVIDIA H100批量32条件下Pairwise+GW每轮训练时间为Pairwise基线的1.59–1.82倍且峰值显存与基线相同。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
75. 用非目标后验质量预判语种分割微调收益

评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhuoyan Tao:Signal and Image Processing Institute, Ming Hsieh Department of Electrical and Computer Engineering, University of Southern California, Los Angeles, California 90089, USA
- Aditya Kommineni:Signal and Image Processing Institute, Ming Hsieh Department of Electrical and Computer Engineering, University of Southern California, Los Angeles, California 90089, USA
- Shrikanth Narayanan:Signal and Image Processing Institute, Ming Hsieh Department of Electrical and Computer Engineering, University of Southern California, Los Angeles, California 90089, USA
📌 核心摘要
口语语言分离标注要对一段录音输出带时间戳的语言标签,难点在于同语系语言声学接近、语码转换边界模糊,以及真实语料中语言分布极不均衡。论文研究的级联流程先把语音切成短窗并用预训练语音模型提取语言识别后验,再对这些窗口向量聚类得到语言段,微调探针则是在冻结模型上学习映射以改善聚类。作者提出非目标后验质量作为免训练免标注的诊断量,它统计每个窗口后验中分配给目标语言集合之外所有语言的概率,并在整段语料上平均。直觉是该比例越高,说明预训练后验偏离目标任务越远,微调把概率质量搬回目标语言的空间就越大。在 19 对未见合成语言对上,该指标与编码器探针增益的 Spearman 相关系数为 0.56,与后验探针增益为 0.68;在真实语料录音级别的平均相关约为 0.23,方向为正但强度明显下降。结论适用于双语合成条件和 Whisper 类后验,对单主导语言加稀疏嵌入的真实会话、目标语言内部混淆严重的情况预测偏高。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
76. DyShip:只用声音判断两个人是熟人还是亲人

评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Kieran Sturges:机构信息未能在本次解析中与作者逐人可靠绑定
- Thomas Thebaud:机构信息未能在本次解析中与作者逐人可靠绑定
- Yaohan Guan:机构信息未能在本次解析中与作者逐人可靠绑定
- Najim Dehak:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是两人的完整双人对话,困难在于关系线索分散在发音、说话方式和互动适应中,处理过程是把长对话切成话语并逐段打分再汇总为整段对话的判断。输入为 Seamless Interaction 语料中的双人对话音频,输出是熟悉相对陌生和亲属相对非亲属两个二分类概率。比较的表示包括语谱图与梅尔频率倒谱系数这类谱表示、冻结的 WavLM-base-plus 自监督表示、SPARC 估计的声道运动和 ECAPA-TDNN 提取的说话人向量。谱表示与自监督表示等逐话语经 ResNet-34 输出话语级概率,再按等权或按话语时长加权平均得到对话级概率,说话人向量则在对话内按说话人平均后直接用支持向量机输出对话级判断。用冻结特征加小分类器代替端到端大模型推理,意义是降低推理代价并保留可比较的表示分析。在测试集对话级评测中,语谱图在熟悉任务上达到准确率 87.81%,WavLM 在亲属任务上达到准确率 85.17%,均高于原文引用的全对话音频大模型熟悉准确率 74.0% 至 75.0% 的范围。结论只适用于该语料的划分与标注体系,跨语料与跨关系类型的表现尚未验证,训练成本原文只说明在单块 Nvidia 1080Ti 上训练 10 个轮次,具体小时数以 X 占位未披露。
🔗 开源资源
- 第三方资源:https://github.com/kierstur/eDartRelationships — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
77. 用公开警用电台看警察在忙什么:百万小时录音怎么做成可比较的研究
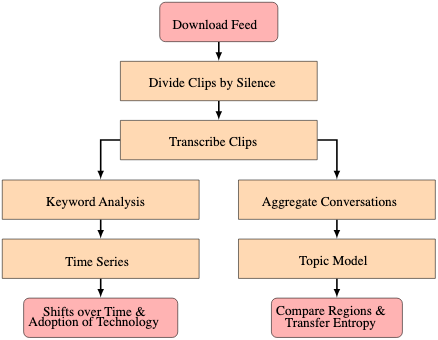
评分:5.4/10 | 创新 1/2 | 技术严谨 0.8/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Milo Z. Trujillo:Vermont Complex Systems Institute, University of Vermont, Burlington, VT, USA;Network Science Institute, Northeastern University, Boston, MA, USA
- Adam Perhala:Network Science Institute, Northeastern University, Boston, MA, USA
- Elaine Zou:Network Science Institute, Northeastern University, Boston, MA, USA
- Tyler Mckenzie:Network Science Institute, Northeastern University, Boston, MA, USA
- Juniper Lovato:Vermont Complex Systems Institute, University of Vermont, Burlington, VT, USA
- Brooke Foucault Welles:Vermont Complex Systems Institute, University of Vermont, Burlington, VT, USA;Network Science Institute, Northeastern University, Boston, MA, USA
- Alyssa Hasegawa Smith:Department of Mathematics and Computer Science, College of the Holy Cross, Worcester, MA, USA
📌 核心摘要
美国多数警局用警用广播实现警员与调度实时语音通信,部分明文播发并经志愿者转播到Broadcastify,以往多为单城市案例或只用通话时长代理活动量。论文输入为2025年7月至2026年7月34个城市67路流的公开直播语音,输出为按静音切分的片段及起止时长、人声转写与按两分钟停顿合并的会话文本及活动描述。先按音量门限和静音间隔切分提取片段并输出片段音频,再将片段输出送入语音活动检测过滤后转写,最后把转写结果按两分钟停顿合并为会话文档送入基于嵌入聚类的BERTopic分析。分析把数字替换为占位符并把命名实体替换为实体类型后送入BERTopic得到50个跨城市可比主题,再用符号转移熵刻画主题驱动关系并以时序分解与关键词检索识别异常与技术词汇。在本文2025年7月至2026年7月34个城市67路流语料按表1以城市汇总的采集量比较中,以记录片段数Clips为指标,芝加哥13路流共3586108个高于洛杉矶6路流的2272166个。与单城市案例或只用时长代理的做法相比,关键差异在于提供一年期多城市语料并把词汇抽象为主题与影响网络。结论仅适用于可公开获取的未加密转播流,志愿者中断、转加密、接收质量与转写误差及转播延迟会导致覆盖缺口与时间近似,不宜做精确时刻分析,转写数据不公开共享。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://broadcastify.com/ → https://www.broadcastify.com/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
78. 把飞机广播变成音乐:Patchbay 如何接线、扫描与发声

英文题目:Patchbay: a block model for the sonification of ADS-B aircraft data
评分:5.4/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.6/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Arquimedes Canedo:Independent Researcher;Sector Labs
📌 核心摘要
小型地面接收机收到的飞机广播数据形状、分辨率、来源与稳定时长差异很大,直接按到达发声会被5秒帧时钟支配,而慢变信号又缺少可发声的变化。先由Sky输出携带全部字段的在视飞机集合,送入Select按范围、高度带与平飞状态筛选并保留整架飞机及其字段。再由Read从集合中提取高度、距离、方位等每架飞机一个数值的读数,送入Map、Scale与Pan分别完成量程转换、音阶量化与声像定位。最后由按方位扫描线或按距离圆环的Radar sweep等节奏触发块决定何时发声,其输出的事件与数值按飞机标识重新汇合,送入Voice合成对应声部的音频与MIDI。与雷达扫掠音序器和距离环声化的关键差异在于飞机集合作为一种连接类型整体传输,数值始终带飞机标识,从而让音高、响度与触发时刻分开处理后仍能对齐。在原始行按气压高度不低于18000英尺且爬升率幅值不大于100英尺/分钟界定平飞行的检查设置下,以落在1000英尺整数倍上下100英尺内的行占比为指标,A数据包8433/8447占比99.8%高于偶然均匀分布下期望值22.5%。同一检查设置下同一指标为B数据包7861/7892占比99.6%,同样高于期望值22.5%。结论只适用于所附两个新泽西接收记录与内置音阶和弦设置,未做听众验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/arquicanedo/patchbay — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
79. 与 AI 反馈乐器一起演奏:关系中的能动性如何被走出来

英文题目:Navigating relational agency in AI feedback musicianship: a diffractive dialogue
评分:5.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.9/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Yichen Wang:The Australian National University, Canberra, ACT, Australia
- Charles Patrick Martin:The Australian National University, Canberra, ACT, Australia
- David Gunawan:Dolby Laboratories, Sydney, NSW, Australia
- David Cooper:Dolby Laboratories, Sydney, NSW, Australia
📌 核心摘要
这篇论文研究演奏者与带有人工智能的反馈乐器长期合奏时,控制感和主动性如何形成。输入是两位演奏者分别使用音频反馈乐器和手势反馈乐器的现场演奏,输出是对演奏中关键时刻的文字反思和对话记录,难点在于同一声音片段会被两人读出相反的意义,常规的主导与回应二分无法解释。方法上先各自回顾录像写反思,再把两份反思放在一起读出差异和重叠,最后从对话记录中提炼共同概念,前一步的文字成为后一步讨论的对象。两件乐器的处理路径不同,一件在声音层面循环,一件在演奏手势层面循环,对比两者让作者看到维护反馈状态的不同手法。原文未提供可核对的关键定量结果。结论只适用于这套装置和这段合作期,作者承认需要更长时间和更大规模的演奏组合来检验。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://doi.org/10.5281/zenodo.19395011 → https://zenodo.org/records/19395012 — 链接可访问(HTTP 200)
第三方资源:https://github.com/smcclab/labscriber — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。