📄 用公开警用电台看警察在忙什么:百万小时录音怎么做成可比较的研究
评分:5.4/10 | 创新 1/2 | 技术严谨 0.8/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Milo Z. Trujillo:Vermont Complex Systems Institute, University of Vermont, Burlington, VT, USA;Network Science Institute, Northeastern University, Boston, MA, USA
- Adam Perhala:Network Science Institute, Northeastern University, Boston, MA, USA
- Elaine Zou:Network Science Institute, Northeastern University, Boston, MA, USA
- Tyler Mckenzie:Network Science Institute, Northeastern University, Boston, MA, USA
- Juniper Lovato:Vermont Complex Systems Institute, University of Vermont, Burlington, VT, USA
- Brooke Foucault Welles:Vermont Complex Systems Institute, University of Vermont, Burlington, VT, USA;Network Science Institute, Northeastern University, Boston, MA, USA
- Alyssa Hasegawa Smith:Department of Mathematics and Computer Science, College of the Holy Cross, Worcester, MA, USA
📌 核心摘要
美国多数警局用警用广播实现警员与调度实时语音通信,部分明文播发并经志愿者转播到Broadcastify,以往多为单城市案例或只用通话时长代理活动量。论文输入为2025年7月至2026年7月34个城市67路流的公开直播语音,输出为按静音切分的片段及起止时长、人声转写与按两分钟停顿合并的会话文本及活动描述。先按音量门限和静音间隔切分提取片段并输出片段音频,再将片段输出送入语音活动检测过滤后转写,最后把转写结果按两分钟停顿合并为会话文档送入基于嵌入聚类的BERTopic分析。分析把数字替换为占位符并把命名实体替换为实体类型后送入BERTopic得到50个跨城市可比主题,再用符号转移熵刻画主题驱动关系并以时序分解与关键词检索识别异常与技术词汇。在本文2025年7月至2026年7月34个城市67路流语料按表1以城市汇总的采集量比较中,以记录片段数Clips为指标,芝加哥13路流共3586108个高于洛杉矶6路流的2272166个。与单城市案例或只用时长代理的做法相比,关键差异在于提供一年期多城市语料并把词汇抽象为主题与影响网络。结论仅适用于可公开获取的未加密转播流,志愿者中断、转加密、接收质量与转写误差及转播延迟会导致覆盖缺口与时间近似,不宜做精确时刻分析,转写数据不公开共享。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://broadcastify.com/ → https://www.broadcastify.com/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
警察电台能回答什么,又不能回答什么
这篇论文研究的对象是美国公开的警察电台通话,原文称为 Broadcast Police Communication,简称 BPC。可以把它理解为警员和调度员用对讲机说的实时工作语言,不依赖手机或 WiFi。有些部门已加密,听不到,但很多仍明文播出,志愿者用扫描器接收后再放到 Broadcastify 这类索引网站上,公众可以收听。
论文想解决的是规模化观察警察行为难的问题。过去常用逮捕和拦截统计、部门报告、跟车观察或随身摄像头。原文指出,自报统计常有误差,随身视频适合个案但很少做系统性分析,跟车成本高且被观察会改变行为。电台的好处是纵向、多城市、非介入,且是工作过程中自然产生的。
但要提醒刚入门的读者,电台也不是执法全貌。它只记录需要上台沟通的部分,大量现场处置、线下协商不会出现;听不到加密频道;志愿者接收质量和延迟各异。所以后文所有高峰和主题差异,都只是电台可观测行为的变化,不能直接等同于犯罪率或出警总量的变化。
Broadcast Police Communication × 警察电台通话: Broadcast Police Communication 就是论文研究的警察电台通话,指警员与调度之间不依赖手机网络的对讲内容;它之所以被选中,是因为它是实时工作语言,比事后新闻稿更少过滤,又能长期跨城市观察,组合起来就把零散通话变成可比较的行为痕迹。
此前对警用电台的研究做到哪一步
原文梳理的已有 BPC 研究多是单城个案。芝加哥 3 个分区的录音被用来看种族和性别提及的地理差异,也被用来测自动语音识别在电台语音上的效果,还有工作用语音情感识别看通话中的层级和支配关系。巴尔的摩的工作只用发射时长做警务活动代理,不分析文本内容。另有研究跟随大学警局看调度和外勤的沟通结构。
和这些路线相比,本文的差别主要在广度和可比性。过去是单城、短时、手工或半自动分析,本文要做 34 个城市、一年、67 路流,并提供从切分、转写到关键词和主题的完整链路。论文明确说分析部分是示意性的,目的是证明数据集能支撑哪些提问,而不是给出稳健结论。这一点决定了读结果时的分寸。
任务的输入、目标和必须保留的信息
输入是 Broadcastify 上的实时 MP3 流,连续、有大量静音、有志愿者转播延迟。目标是把它变成可按时间和地区比较的研究数据:一是每个发射何时开始、持续多久、说了什么;二是能按天和按周看话务量是否异常;三是能按关键词和主题看某类活动何时变多、地区间有何不同。
必须保留的信息包括时间戳、时长和文本。时间只能是录制侧的大致时间,因为志愿者流可能延迟近 1 分钟,警方自供流常有人为延迟 15 分钟以上,还要换算时区。文本要保留原始音频以便以后重转写。输出不是对某次执法的判断,而是聚合后的趋势、异常时段和主题结构,供后续政策、技术采用和协作研究使用。
从在线流到两类分析的总体流程
整条流水线可以沿着一个样本理解。一路芝加哥分区流持续播出,先被录下来,再按静音切成单次发射,每段记下开始时间和时长;有语音的段落被转写成文本;短发射再按间隔拼成会话;之后分两路,一路做关键词检索和时间序列,回答用词随时间的变化和技术采用,另一路做主题模型,回答地区比较和主题间驱动关系。
下图是论文给出的流程总览,先看主干再看分叉,有助于把后文每个组件放回原位。
看图路径: 1. 先从顶部下载流沿箭头走到按静音切分和转写;2. 再看转写后分叉为左侧关键词时间线和右侧聚合会话主题线;3. 对照底部两类目标确认各自承接哪条分支
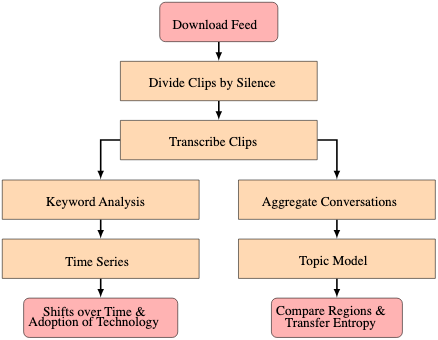
论文图 1。原论文 Figure 1::“Overview of our data collection and preprocessing, culminating in two analysis goals: word usage over time, and topic modeling for regional comparison.”。
从像素看,顶部是下载流,接着是按静音切分和转写,随后左右分叉。左侧是关键词分析和时间序列,底部对应随时间的变化和技术采用;右侧是聚合会话和主题模型,底部对应地区比较和转移熵。这种画法本身就说明,关键词路线不依赖长文档,而主题路线必须先聚合。
流是怎么选出来的,城市覆盖意味着什么
流发现阶段先看 Broadcastify 的公共安全分类,优先芝加哥、纽约、洛杉矶等有多路流的大都市。排除太泛的 police-fire-EMS 合用流和标题未明确警察专用的流,先得到 96 路。再人工排查,去掉交通警察等专用频道和只在大型集会才活跃的流,最后留下 67 路,分布在 34 个城市。附录给出了每路流的明细。
下表截取原城市汇总表的四行,比较问题是不同城市的流数、片段数和小时数是否可以直接比大小。答案是否定的,因为录制时长和频道划分不同,芝加哥分 13 个区自然片段多,小时数也受接收质量和加密切换影响。
| City | Streams | Clips | Hours |
|---|---|---|---|
| Boston, MA | 3 | 349984 | 10613 |
| Chicago, IL | 13 | 3586108 | 19395 |
| Los Angeles, CA | 6 | 2272166 | 14284 |
| Philadelphia, PA | 7 | 1260384 | 14177 |
表中芝加哥 3586108 个片段对应 19395 小时,洛杉矶 2272166 个片段对应 14284 小时,费城 1260384 个片段对应 14177 小时,波士顿 349984 个片段对应 10613 小时。片段多不等于说话多,因为切分阈值、静音和噪声都会影响片段数;小时数是音频时长,不是有效语音时长。后文芝加哥分析多,正是因为它分区细、连续性好,而不是因为它代表全国。
流级别的明细更能看出这种不均。下表截取原流明细的前几行,比较同一城市内不同分区的体量。
| Stream ID | City | Stream Name | Clips | Hours |
|---|---|---|---|---|
| 1 | Boston, MA | Boston Police | 57880 | 352 |
| 5 | Chicago, IL | Chicago PD Citywide Dispatch | 413457 | 2092 |
| 6 | Chicago, IL | Chicago PD Zone 01 | 237910 | 1129 |
| 21 | Los Angeles, CA | LAPD South | 631752 | 1625 |
可见波士顿的 3 路流体量差异很大,芝加哥各区也有差异。有些特殊流如洛杉矶港口警察片段极少但小时数很长,说明频道长期静默或只有底噪,这类流被排除在内容分析之外,但仍被收集以备后用。做跨区比较时必须先问覆盖是否对齐,否则会把缺录当成安静。
按静音切分、语音检测和会话聚合
录制侧把连续流按音量和静音时长切分。阈值是 -50 dB 和前后各 5 秒静音,这是 FFmpeg 给噪声环境的建议值。只要音量超过阈值就起一段,前后留 5 秒间隔。好处是实现简单、可存档,每段有开始时间和时长;代价是对讲机的按键延迟和无视觉线索会拉长停顿,一句话可能被切成多段。
转写分两步。先用 Pyannote 的语音活动检测判断是否有人声,有才调用 faster-whisper 包里的 distil-large-v3 Whisper 模型转写。原文保留了原始音频,明确是为以后用更好的电台专用模型重转写。当前录音常有静电和含糊语音,转写错误不可避免,后文关键词和主题都建立在有噪声文本上。
会话聚合是为主题模型准备长文档。作者统计发射间隔时间的累积分布,发现多数流 50% 到 80% 的间隔在 2 分钟以内,于是把超过 120 秒的停顿定为会话边界。2 分钟内连续的发射拼成一个会话文档。这种做法不做基于说话人或话题的解缠,如果同一频道多组对话交错,就会被拼在一起。作者说实际中少见,于是用最简单的间隔规则。
主题模型 × 会话聚合: 会话聚合负责把被静音切碎的短发射按两分钟间隔拼成较长文档,主题模型负责从这些文档里抽高层活动类别;没有前者,基于词频的模型会因文档太短而失效,有了较长文档,BERTopic 才能跨城市抽象掉本地地名和简语。
本文没有训练新语音模型,实际计算是什么
需要明确,本研究没有训练新的声学或语言模型。语音活动检测和 Whisper 都是直接调用已有模型做推理,没有报告微调、梯度更新或参数冻结细节。主题部分的 BERTopic 也是用默认嵌入、降维和聚类搭标准流水线,再加网格搜索选主题数等超参数,目标是平均主题一致性最高,最终选 50 个主题、最小时文档数为 20。
实际执行的计算包括录制切分、语音检测、转写、词干倒排索引、基于 LOESS 的季节趋势分解、15 分钟粒度的主题计数、符号转移熵和嵌套随机块模型拟合,以及用 Jensen-Shannon 散度比较冬春分布。网格搜索和人工标注主题名是其中唯一类似训练调参的环节,但它优化的是可解释性而非识别准确率。缺的是转写字错率、主题稳定性跨种子验证等环节,原文也没有给出这部分数字,所以不能把主题标签当成稳定真值。
时间范围、缺录和时区如何限制结论
摘要和正文给出的数据规模是 2025 年 7 月到 2026 年 7 月一年间,超过 14,000,000 次发射、超过 100,000 小时语音,覆盖 34 城。流数从 96 筛到 67,城市数始终是 34。不同城市是陆续加入的,有的部门中途加密就中断,有的扫描器因停电维护出现小缺口。附录时间线显示芝加哥、洛杉矶等从 2025 年 10 月起较连续,巴尔的摩等从 2026 年 4 月前后加入,波士顿早期断续。
下表把规模数字整理成可核对的形式,比较问题是总量大是否等于各处可比。表中数字来自原文连续句,只能说明总量和筛选过程,不能推出每个城市各有多少小时有效语音。
| 条件 | 指标 | 筛选前 | 筛选后 | 总量 |
|---|---|---|---|---|
| 34 个城市一年 | 流数 | 96 | 67 | 67 |
| 34 个城市一年 | 音频时长 | — | — | 超过 100,000 小时 |
上表数字的来源是原文摘要和流发现段落,破折号表示原文未按筛选前后拆分该指标。它的限制很直接:总量大不解决覆盖不均,芝加哥 6 个月关键词图和全年可用性不能推广到只录了几个月的城市;时间戳有延迟且涉及时区,适合按天和按周看趋势,不适合精确到分钟的响应速度分析。
话务量分解如何把反常忙找出来
在不看文本之前,先看何时话多。不同城市基数不同,周五晚和周二下午也不同,直接比绝对时长会误判。论文用基于 LOESS 的季节趋势分解,把过去 24 小时话务时长拆成长期趋势、7 天季节模式和残差。趋势吸收冬春等大段变化,季节吸收 1 天内和一周内节律,残差就是比预期多还是少。
读图任务是确认 3 层各解决什么,再看残差尖峰是否对应真实事件。灰色周末条有助于判断季节是否已建模。
看图路径: 1. 对比最上方面板 24 小时话务量尖峰与第二面板趋势隆起的位置;2. 观察第三面板每周季节性波动幅度与周末灰条的关系;3. 看最下面残差在尖峰处是否为正向偏离

论文图 2。原论文 Figure 2::“Time series decomposition. Subplots from top to bottom show: a rolling window of the duration of radio traffic in the past 24 hours, a trend line accounting for typical traffic…”。
从像素看,最上面板是芝加哥话务量,11 月中旬有一个明显隆起;第二面板趋势也在同一位置抬高,说明模型把它部分吸收为趋势;第三面板是每周季节性上下波动;最下面残差在该隆起处仍有正向偏离,左右还有负向缺口。论文的用法是残差超过若干标准差就标记为异常,再去查转写或新闻找原因。
时间序列分解 × 残差: 时间序列分解负责把话务量拆成长期趋势和每周季节性,残差负责记录扣除这两者后还多出或少了多少话务;前者解决不同城市和星期几本就忙闲不均的问题,后者才适合定阈值找异常,二者搭配才能把绝对忙和反常忙分开。
结论成立的条件是趋势和季节拟合得当,且缺录已被排除。如果某天扫描器离线,话务量会骤降,残差负向大,这不是警察变闲,而是观测中断。反之加密切换后流量消失,也不能读成治安好转。
关键词时序能看到节律,也会看到无标注的峰
转写后最直接的用法是搜词并按时间画流行度。论文用 Postgres 的词干向量做广义倒排索引,本质是把每个转写的词干建成快速检索。芝加哥半年图分 3 组:派对醉酒类、天气类、抗议类。周末灰条帮助识别周期。
读图任务是区分季节性小峰、节假日异常和有新闻佐证的大峰,并注意没有佐证的峰。
看图路径: 1. 先看上面板周末灰条处的小峰与寒冷和新年标注的对应;2. 再看中面板冬季风暴处的高窄峰与平时低基线的差别;3. 最后看下面板抗议峰中哪些有标注哪些没有标注

论文图 3。原论文 Figure 3::“Time series plots showing keyword prevalence in Chicago BPC transcripts during a six-month period.”。
从像素看,上面板派对词在周末处反复起伏,寒冷段振幅变小,新年和情人节处有单独标注;中面板平时贴近零线,12 月初和 1 月底各有一个高窄峰,标注为冬季风暴和大雪;下面板 11 月中旬有一个高峰标注为 ICE 抗议,之后 2 月到 3 月有多个无明确大抗议标注的中等峰。论文自己指出,每个大抗议确有对应峰,但很多峰没有对应抗议,说明单靠 deportation 和 immigration 等代理词搜 ICE 相关抗议会有歧义和漏检。
关键词流行度 × 倒排索引: 关键词流行度要回答某类词在何时变多,倒排索引负责把词干后的转写快速定位到时间段;前者是研究问题,后者是工程手段,搭配后才能在半年芝加哥文本里画出派对、天气和抗议三条曲线并对照新闻注释。
所以这节的结论是示意性的:能复述出周末派对随气温下降而减弱、暴风雪带来天气词峰值、大抗议伴随抗议词峰值,但不能反过来把每个峰都当成 1 次抗议。词表选择、转写错误和一词多义都会影响峰的高矮。
主题模型如何从短句到可比较的活动类别
要跨地区比较,直接比词袋会撞上各地简语和地名。主题模型的作用是把词汇抽象成活动类别。预处理很关键:丢掉短于 60 秒或少于 20 词的会话;把数字序列统一换成 NUMBER,因为 10-4 等代码和门牌电话在嵌入模型训练中少见,会拖累一致性;用 spaCy 的 en_core_web_sm 做命名实体识别,把人名地名换成 GPE 等实体类型,避免不同城市的实体互不重叠。
模型用 BERTopic 标准流水线,考虑一元和二元词,用默认嵌入 all-MiniLM-L6-v2,最大 256 token,长文本会被静默截断;用 KeyBERTInspired 做主题表示;网格搜索以平均主题一致性为目标,定为 50 主题、最小主题大小 20,并用此前 hPAM 等尝试得到的词表做种子引导。不存在的种子主题不会被建模,最终由 1 位作者看代表文档起可读标签。附录说 LDA、hLDA、hPAM 等词袋模型试过,对数字和方向词敏感或层次不如预期,最终选 BERTopic。
比较冬春时,同一模型给两季转写打主题,算主题流行度分布,再用 Jensen-Shannon 散度找差异。春季更多鲁莽驾驶、嫌疑人描述、听到枪声、动员指令、闯入威胁等,冬季更多数字导航、遗体转运和数字后勤。
Jensen-Shannon 散度 × 主题流行度分布: 主题流行度分布负责统计冬季和春季各主题各占多少,Jensen-Shannon 散度负责度量两个分布差多远并定位贡献最大的主题;前者是比较对象,后者是比较尺子,搭配后才能说春季更多鲁莽驾驶和枪声而冬季更多导航与遗体转运。
成立条件是预处理和截断已被接受。数字被抹掉意味着 10 代码细节丢失,实体被泛化意味着地点信息丢失,256 截断意味着长会话尾部丢失。这些都是为跨城可比付出的代价,读主题名时要记得它是对截断泛化后文本的聚类,不是原始执法的完整分类。
转移熵网络看到的是驱动链而非同义聚类
拿到主题标签后,论文把每城按 15 分钟切块,数每块每主题出现几次,得到主题量时间序列。再算符号转移熵,理解一种话语是否带动另一种话语。这一步借鉴了已有用转移熵做有向影响网络的做法,再用 graph-tool 拟合嵌套随机块模型,按描述长度最小找模块,得到元主题。
芝加哥图的要点是颜色代表元主题,分支箭头代表嵌套层级。蓝色是事件响应与后勤,含嫌疑人位置信息后勤、数据库后勤、斗殴、烟花或枪声等;粉色是暴力与闯入,含家庭暴力骚乱、闯入袭击和车牌信息。论文强调,同属一元主题不一定因为内容相似,而是因为引发相似的下游链条,例如报闯入者可能引出查逃逸车辆车牌。
符号转移熵 × 嵌套随机块模型: 符号转移熵负责度量一个主题的出现是否在统计上带动另一个主题,嵌套随机块模型负责在由此构成的有向影响网络里找模块结构;前者给出驱动关系,后者把几十个主题收成事件响应与后勤、暴力与闯入等元主题,组合后看到的是因果链条而非单纯词义相近。
初学者易误把驱动读成因果。转移熵是统计上的先导关系,受调度流程和频道规则影响很大,例如呼叫引擎响应后必然跟随位置确认,这种驱动更多是流程规定而非行为发现。要当成因果,需要补干预或对照实验,本文没有做,所以只能说刻画了系统层面的话语动力学示意。
用设备词看技术采用:ShotSpotter 例子
关键词的另一用法是看部门是否使用某种技术。示例是 ShotSpotter 枪声麦克风系统。警员在提到系统报警时会说出这个词。论文统计每天是否有转写包含 ShotSpotter 或 Shot Spotter,按城市画时间线。原文说明作图期间底特律、旧金山、费城有活跃合约,芝加哥、洛杉矶、圣保罗没有。
读图任务是比较有合约和无合约城市的条带密度,而不是读某 1 天的绝对次数。
看图路径: 1. 横向比较底特律与芝加哥和洛杉矶在整段时间条带的密度差异;2. 注意圣保罗顶部只有零星竖线而旧金山和费城条带密集;3. 结合横轴月份看有合约城市是否持续出现而非单日偶发

论文图 4。原论文 Figure 4::“Time series showing on which days each city’s BPC transcripts mention ShotSpotter microphone technologies.”。
从像素看,底特律是近乎连续的宽条带,旧金山和费城是密集竖线,纽约也有密集条带;芝加哥底部是稀疏细线,洛杉矶只有两条短竖线,圣保罗顶部几乎空白。两类在视觉上可分,但论文也承认有偶发误报提及。纽约在正文合约说明之外出现密集提及,解读时不能自行推断其合约状态,只能说该方法提示此处值得查公共记录核实。
代价和限制是词法脆弱。系统可能被简称为其他代号,误转写会漏检,讨论技术争议时提到名字也会被计入采用。时间序列能显示采用是否持续、是否在负面新闻后减少,但证明采用与否仍需合同和采购记录佐证,不能只靠电台提到过几次就定性。
哪些缺口会改变解读
覆盖不全是首要限制。志愿者设备维护停电、部门转加密都会中断,缺口在时间线图上可见。录音质量取决于警员电台和接收机双方,静电和含糊语音使转写困难,作者期待用电台微调模型改进,但当前没有字错率数字。
时间戳只是录制侧 Unix 时间,有转播延迟和人为延迟,不适合精确到秒的响应分析,做昼夜和星期比较时必须先换算时区。会话聚合用 2 分钟硬阈值,多组交错对话会被拼合;数字和实体替换、256 截断都会丢信息。主题数 50 和最小文档 20 是网格搜索在一致性上的最优,不是唯一合理解,换种子和参数可能得到不同划分。
数据伦理是另一限制。电台常出现嫌疑人姓名、罪名、车牌和地址等可识别信息。作者认为聚合趋势研究可以做,但公开原始转写会降低滥用门槛,因此不公开转写,正在探索数据飞地给学界提供聚合访问。复用时不能索要或传播原始文本,只能复现方法链路。
复现第一步做什么,需要补哪些验证
值得尝试的情形是已有连续公开流、问题是按周按季的趋势和异常归因,而不是精确到分钟的调度评估。第一步不是直接跑主题模型,而是复现录制与切分:选一路有明确警察专用标题的 Broadcastify 流,按 -50 dB 和 5 秒静音切分,记录开始时间和时长,再跑语音检测和 Whisper 转写,抽查含噪声片段的字错情况。
接着复现话务量分解和关键词曲线。先画过去 24 小时时长、趋势、周季节和残差,确认周末模式是否被吸收;再用小词表搜天气和节假日词,对照当地新闻看大峰是否对得上,同时数无标注峰占比,评估代理词的精度。主题部分先复现 60 秒和 20 词过滤、NUMBER 替换和实体泛化,再跑 BERTopic 默认流水线,记录截断比例和跨种子稳定性。
还需补的验证包括转写错误对关键词峰的影响、不同间隔阈值对会话长度和主题一致性的影响、转移熵在打乱时间后的基线,以及缺录时段剔除前后的残差对比。资源方面,作者致谢提到佛蒙特高级计算中心和 NSF 支持,说明大规模转写和建库需要计算资源;小规模复现可从单城单流开始。数据获取上,Broadcastify 是第三方公开索引,论文提到该链接不等于作者已开源代码或数据,作者资源是否可用要看官方声明,不能把可收听当成可下载转写全集。
一句话总结与后续可问的问题
把全文收拢,这项工作是把公开电台从难存档的直播变成可检索、可分解、可建模的纵向数据,并用芝加哥等例子展示它能看到周末派对节律、暴风雪和抗议高峰、技术提及差异以及冬春主题漂移。所有结论都附带条件:覆盖不均、转写有噪、时间粗糙、主题是示意聚类。
后续值得问的是政策干预前后活动分布是否即时变化、技术提及在负面报道后是否消退、地方与联邦协作在电台留下多少痕迹、抗议部署的指令和回報如何表述。论文把这些列为行动号召,但都没有在本篇给出稳健答案。刚入门的研究生若要跟进,建议先选一个连续性好的城市复现话务量和关键词两条线,再决定是否投入主题和转移熵,因为后者的预处理和参数选择对结论影响更大。
📎 论文与评分元数据
排名:后50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses