📄 在短窗 MDCT 编码里加一个小神经网络预测器
英文题目:Lightweight Neural Prediction for MDCT-Based Perceptual Audio Coding
评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Niccolo Abate:Center for Computer Research in Music and Acoustics (CCRMA), Stanford University, Stanford, CA, USA
- Gabriel Soule:Center for Computer Research in Music and Acoustics (CCRMA), Stanford University, Stanford, CA, USA
- Marina Bosi:Center for Computer Research in Music and Acoustics (CCRMA), Stanford University, Stanford, CA, USA
📌 核心摘要
感知音频编码需以尽量少码字保留听感,音乐信号在相邻变换块间存在时间与频率相关性,短分析窗延迟低但频率分辨率粗,长分析窗分辨率高但延迟大。先将过去5个已重建MDCT系数块作为上下文送入预测器,输出对当前块的单块估计,卷积预测器以一维卷积沿频率轴提取相邻频线的局部相关,多层感知机则将上下文展平后经全连接层映射。再由编码器用该估计作差得到残差,并在比例因子频带尺度上比较残差与原始系数的临时重建误差,输出每带一比特选择标志以决定传输残差还是原始系数,最后解码器仅接收量化候选与标志,并用同样的已重建系数块更新预测器状态,使两端无需传输预测器状态即保持同步。与逐线二阶归一化最小均方线性预测器和多层感知机预测器不同,卷积结构把局部谱结构作为归纳偏置,参数量仅0.13M而泛化更好。在2.0比特每样本、512点分析窗、上下文5块的EBU SQAM 70项集上,卷积预测器平均SNR为23.18 dB,高于无预测基线的18.86 dB,平均NMR为-19.27 dB,低于基线的-15.56 dB。在同一2.0比特每样本的EBU SQAM 70项集上,512点加卷积预测的平均SNR为23.18 dB,超过2048点无预测基线的21.93 dB,同时算法延迟从46.4 ms降至11.6 ms。在约110 kbps、17名受训听众的MUSHRA测试中,512点卷积条件的MUSHRA得分显著超过512点无预测基线约28分,并超过2048点无预测基线约6分。在Apple M4 Pro笔记本CPU上测得解码器实时率为0.10而无需GPU,但瞬态与随机性素材上预测增益收缩,域专用预测器、更大模型与预测感知比特分配仍未验证。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
感知音频编码要解决什么输入输出问题
输入是连续的脉冲编码调制音频,目标是在给定比特率下让听感尽量接近原声。编码器先把时域信号变换到频域,再根据人耳掩蔽决定哪些频带可以粗量化,最后把量化索引写进码流;解码器反量化并反变换回时域。必须保留的是可听成分,允许丢弃的是被掩蔽的细节。
常用做法是用修正离散余弦变换处理重叠分析窗,每跳一跳产生一个系数块,谱线再按临界频带分成比例因子频带。心理声学分析给出每个频带的信号掩蔽比,比特分配据此在总码率约束下优化听感。短分析窗延迟低但频率分辨率粗,长窗分辨率细但延迟大,这是低延迟编码长期面对的权衡。
MDCT 系数块 × 心理声学模型: MDCT 系数块是把重叠时域窗变换到频域后的一组系数,负责携带可编码的信号能量;心理声学模型用另一路傅里叶分析估计每个临界频带的掩蔽阈值和信号掩蔽比,负责告诉比特分配哪里可以多量化、哪里必须精细,二者组合才把变换增益和人耳掩蔽结合起来。
端到端神经编码与模块式改进有何不同
一条路线是完全端到端神经编码,例如 SoundStream、EnCodec 和 Descript Audio Codec,把编码器、量化器和解码器联合学习,配合残差矢量量化和对抗训练在很低码率下重建音频。这条路线重建能力强,但把传统变换域管线换成黑盒,与现有标准和变换域工具不易对接,且往往需要大模型才能接近经典编码器的效率。
另一条路线保留传统编码器主体,只把其中一个模块换成神经网络。例如在 MDCT 谱上预测系数的生成模型、在固定核心上做带宽扩展,或面向流式的小模型设计。与本文最接近的是先预测再编码残差的思路,但已有工作多作用于学习到的语音特征并绑定神经量化器或声码器。本文的不同在于预测器直接作用于标准 MDCT 系数,变换、心理声学、量化和综合都不动,预测器只是可替换的黑盒模块。
短窗条件下要验证的具体问题是什么
论文要回答的是,能否不改动传统编码器的其他环节,只插入一个小而确定的神经网络预测器来降低残差能量,从而在短窗低延迟条件下恢复长窗的编码质量。具体做法是预测器看过去若干个已重建 MDCT 块,估计当前块,编码器传量化后的残差,解码器用同样的历史复现预测再加回残差。
比较对象必须在相同变换、相同心理声学模型和相同比特分配流程下进行,包括不预测的基线、逐谱线 2 阶后向自适应线性预测器,以及两种神经网络预测器。评价要同时看预测本身的增益、编码后波形误差、相对掩蔽阈值的噪声,以及听音主观分,还要看短窗加预测能否替代直接加长窗口。
预测残差编码的完整信号流程是怎样的
编码端先对重叠加窗音频做 MDCT,得到当前系数块,同时另一路傅里叶变换送心理声学模型和比特分配。预测器用过去已重建块给出当前块的估计,两者相减得到残差。编码器对每个比例因子频带决定传原始系数还是传残差,只在被选中的频带传残差的量化值,并用 1 位标志记录选择。
解码端没有原始信号,只能用已解码历史复现完全相同的预测,再按标志决定是否加回解码后的残差,最后反变换回时域。关键同步机制是预测器状态只从已重建系数更新,编码器看到的已重建块与解码器看到的一致,因此不需要传预测器参数或状态,只要两端预测函数确定且更新规则相同。起始若干块历史不足时回退到不预测路径。
预测器 × 残差: 预测器根据过去已重建块估计当前 MDCT 块,负责去掉时间上的冗余;残差是真实块减去预测值,负责承载预测不到的新信息,预测越准则残差能量越小,量化同样残差所需的比特就越少。
下面这张框图值得对照正文慢慢看,上半是编码端如何分出变换支路和听觉分析支路,下半是解码端如何只靠历史复现预测,读图时先分清上下两条主路径再看预测回路。
看图路径: 1. 先沿上半编码器从 PCM 经 MDCT 到残差、量化、码流的主路径看一遍;2. 再看下半解码器从码流经反量化、重建、反变换回到 PCM 的对应路径;3. 对照上下两处预测与状态框,确认编解码用的是同一已重建历史
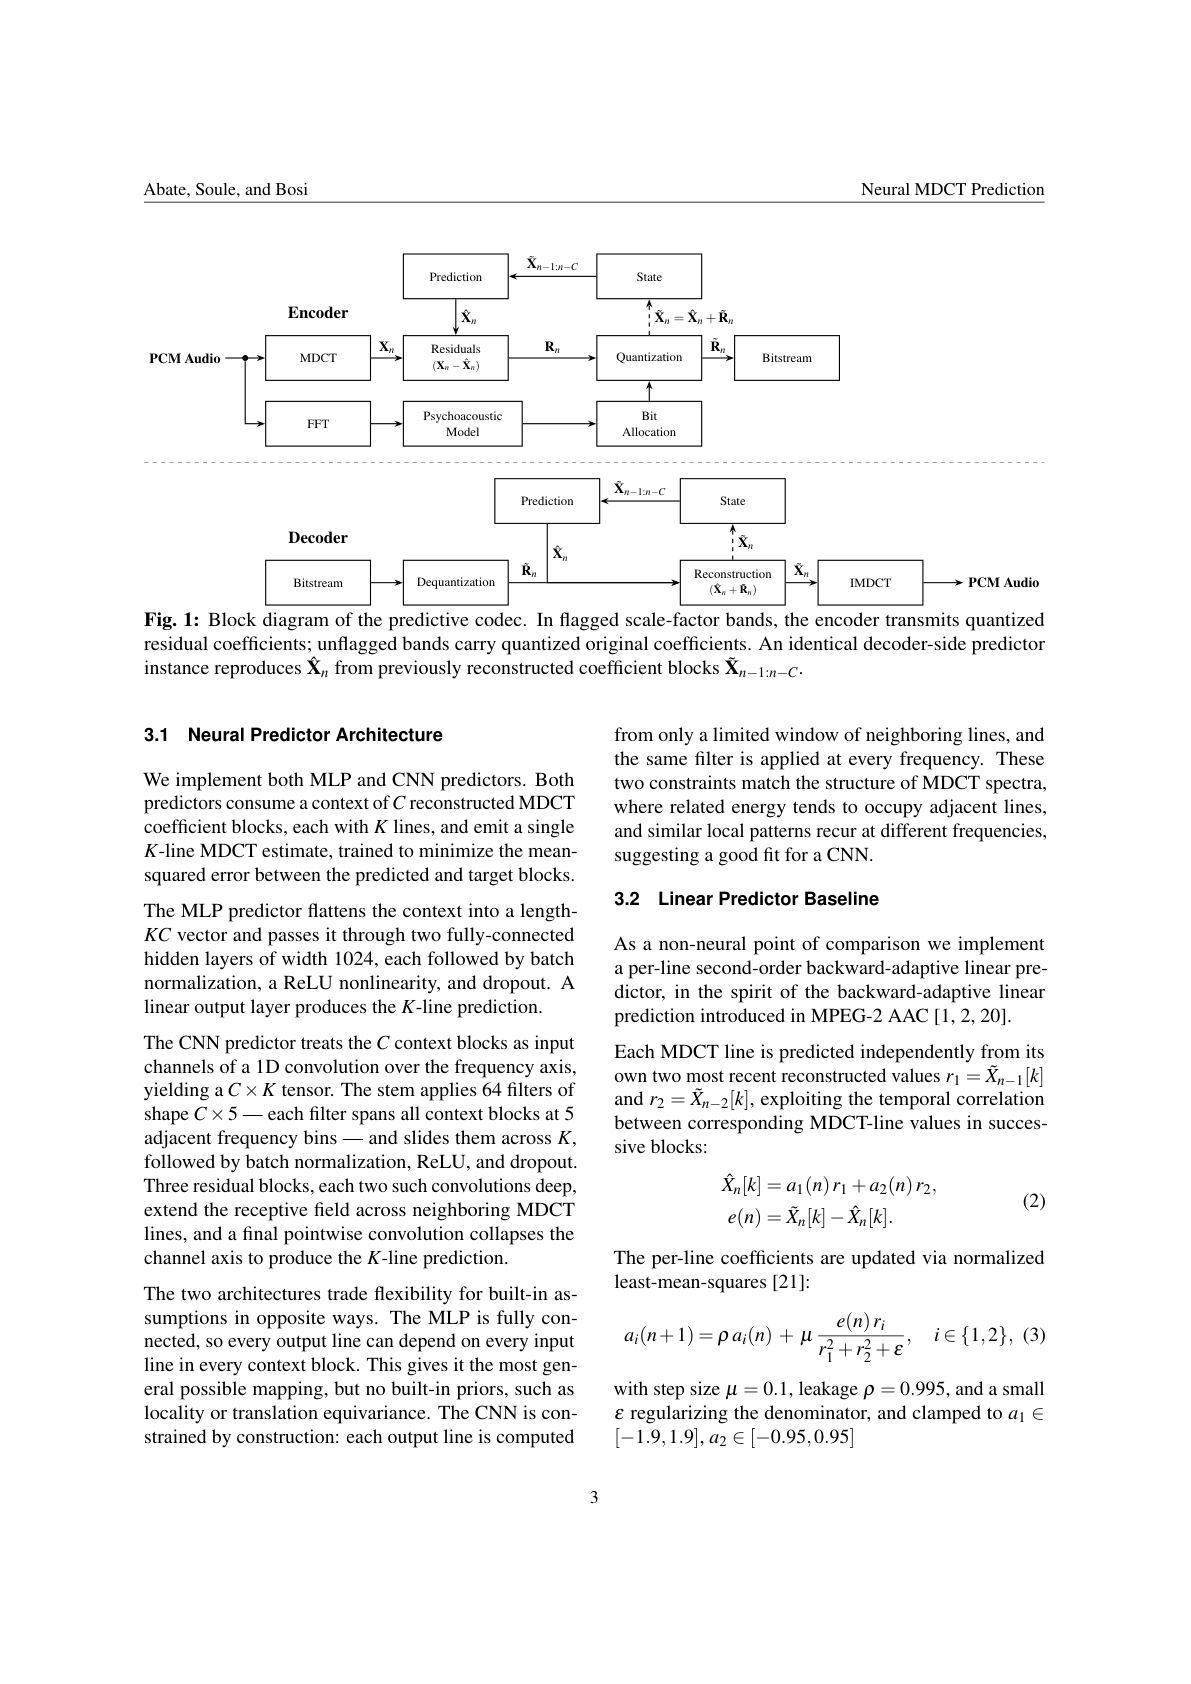
图片来源: 原论文 PDF 第 3 页(含图 1)
论文图 1。原论文 Figure 1::“Block diagram of the predictive codec.”。
从像素上可以直接看到,编码器左侧 PCM 分成 MDCT 支路和快速傅里叶变换支路,前者经残差框到量化再到码流,后者经心理声学模型到比特分配再控制量化;上下各有一个预测框和状态框,编码端预测指向残差计算,解码端预测指向重建框。这种对称布局正是无需传输预测状态也能同步的原因。
两种神经网络预测器各是如何计算的
两种预测器都吃过去 C 个已重建块,每块 K 条谱线,输出一个 K 维的当前块估计,训练目标是与真实下一块的均方误差。实际前向时网络输出的是相对最近一块的增量,再加上最近块得到最终预测,这种残差式参数化让网络专注于学习变化部分。
多层感知机把上下文展平成长度为 K 乘 C 的向量,经过两个宽度 1024 的全连接隐层,每层后接批归一化、修正线性单元和丢弃,最后线性层输出 K 维。卷积模型把 C 个历史块当作通道,构成 C 乘 K 的张量,茎部用 64 个形状为 C 乘 5 的滤波器沿频率轴滑动,每个输出点只看 5 个相邻谱线在全部历史块上的取值,随后 3 个残差块加深感受野,最后逐点卷积把通道压到 1 维。
\[\hat{\mathbf{X}}_{n}=P_{\theta}(\tilde{\mathbf{X}}_{n-C},\ldots,\tilde{\mathbf{X}}_{n-1}).\]上式说明预测是过去 C 个已重建块的确定函数,符号上加波浪线的块表示解码端也能见到的重建值,下标 n 减 C 到 n 减 1 表示时间上下文范围。论文强调这种结构先验的差异:全连接容量大但没有局部性和平移等变假设,卷积受限于邻域和权值共享,反而与 MDCT 能量集中在相邻谱线、局部模式跨频率重复的特点更匹配。
多层感知机预测器 × 卷积神经网络预测器: 多层感知机预测器把上下文展平后全连接映射,任何输出谱线都能看到全部输入,灵活但没有局部先验;卷积神经网络预测器把上下文块当通道沿频率轴做一维卷积并共享滤波器,只看邻近谱线,约束与 MDCT 能量集中在相邻谱线、局部模式跨频率重复的结构相对应,参数也少得多。
作为对照的逐谱线线性预测器如何更新
线性基线模仿 MPEG-2 高级音频编码主档的后向自适应预测,对每条谱线独立做 2 阶预测,只用同一频率前两个已重建值做线性组合,系数随时间自适应。它利用的是同一谱线前后块的时间相关,不跨频率借用信息。
系数更新用带泄漏的归一化最小均方规则,步长为 0.1,泄漏为 0.995,分母加小量防止除零,并把两个系数分别钳位在给定区间内。这种钳位和归一化都是为了在信号能量变化大时保持稳定。
\[a_{i}(n+1)=\rho\,a_{i}(n)\;+\;\mu\,\frac{e(n)\,r_{i}}{r_{1}^{2}+r_{2}^{2}+\epsilon},\quad i\in\{1,2\},\]上式中 e 是当前块该谱线的重建值与预测值之差,r1 和 r2 是前两块同一谱线的重建值,rho 是泄漏,mu 是步长,分母是两历史值的能量加正则项。它表示新系数等于旧系数衰减一点,再沿着使当前误差减小的方向走一步。由于只依赖已重建值,编解码两端同样可以复现,不需要额外传输。
归一化最小均方线性预测器 × 神经网络预测器: 归一化最小均方线性预测器对每条 MDCT 谱线独立做二阶后向自适应线性组合,负责刻画同一频率前后块的线性相关;神经网络预测器跨频率和跨通道联合非线性建模,负责利用谐波结构等跨谱线相关,二者对照可以区分增益来自线性时间相关还是谱结构建模。
为什么预测还要按频带做一次量化感知门控
预测并非在所有时刻和频带都有益,瞬态和噪声类信号上预测可能增大误差,而且误差会通过重建历史反馈到后续预测。因此编码器对每个比例因子频带比较两种候选的重建误差:直接量化和反量化原始块的误差,以及预测加量化残差再相加后的误差,哪边小就选哪边,并用 1 位标志通知解码器。
这个比较是量化感知的,它把当前比特分配下的整块量化和反量化往返都实际走一遍,包括由候选块决定的整体和分频带量化步长,而不只是比较未量化的残差能量。最终码流是混合块,选中的频带放残差,未选中的频带放原始系数,然后再做 1 次包含重新计算步长的最终量化,所以候选误差与最终误差会有微小出入,但论文称实践中差异不大。
标志本身要占用每频带 1 位,与比特分配信息一起传送,因此与完全不预测的编码相比没有严格的等码率保证。门控只影响编码器决策,解码器只需按标志决定是否加预测,换门控规则不需要改码流和解码器。
神经网络预测器用什么数据和过程训练
本研究训练的部分只是两个神经网络预测器,编码器的变换、心理声学和量化都不训练。训练数据是 Medley-solos-DB 独奏乐器录音,采样率 44.1 kHz,用与编码器相同的加窗 MDCT 分析,系数块除以全库估计的全局标准差做归一化,随机留 10% 文件做验证。
训练时没有加量化,用原始 MDCT 块作为上下文,相当于假设完美重建的历史,优化目标是下一块的均方误差,用 Adam 优化器、学习率 0.0001,最多 1000 轮。论文在多个上下文长度上训练,正式编码评价默认用 5 个历史块。需要说明的缺口是训练用干净历史而测试用含量化噪声的历史,这种失配没有在训练中补偿,效果要靠跨库泛化来检验。
评价数据是完全不重叠的 70 条 EBU SQAM 集合,覆盖独奏、声乐、语音、合奏和人工信号,因此报告的是跨库泛化而不是库内拟合。默认评价条件除非另有说明是每采样点 2.0 比特,分析窗分别测 512 点对应 256 线和 2048 点对应 1024 线。
客观指标和主观听音各衡量什么
预测增益是目标块能量与残差能量之比取分贝,只评价预测器本身。重建信噪比是编码解码后波形与原声的误差比,论文承认它不考虑掩蔽所以不是完美的感知指标,但在共享同一感知编码器的条件下适合比较不同预测器。噪声掩蔽比按每比例因子频带用信号掩蔽比减信噪比得到,把量化噪声放到掩蔽阈值下看,越负表示噪声越被掩盖。
主观评价按 ITU-R BS.1534 的 MUSHRA 方法,17 名通过筛选的训练有素听音者参与,每组包含隐藏参考、3.5 kHz 低通锚点和 5 个编码条件,编码在约 110 kbps、单声道复制为立体声、44.1 kHz 下进行。延迟按 50% 重叠实现计算,算法延迟为 2 倍谱线数即窗长。
预测增益 × 重建信噪比 × 噪声掩蔽比: 预测增益只看预测器本身把目标块能量压低多少,不经过量化;重建信噪比看经过量化、比特分配和门控后的解码波形误差,是编码后的比较口径;噪声掩蔽比再把量化噪声放到掩蔽阈值下衡量,负得越多表示噪声越被掩蔽,三者分工是从模块能力、波形保真到感知余量的链条。
短窗下四种模式的客观质量排序是什么
在 2.0 比特每采样点、窗长 512、上下文 5 块的条件下,这里要比较的是同一编码流程下不预测基线、线性、多层感知机和卷积的噪声掩蔽比,指标方向是越负越好,聚合对象是每比例因子频带再按条目平均。
| File | Base. | Linear | MLP | CNN |
|---|---|---|---|---|
| Glockenspiel | −19.1 | −21.8 | −21.0 | −22.6 |
| Harpsichord | −12.1 | −15.6 | −14.9 | −17.3 |
| Organ | −9.3 | −13.2 | −13.3 | −15.0 |
上表是原表前四行的表头与数据,保留了基线、线性和多层感知机等必要对照以及卷积的完整结果。从可见行看,基线最高,线性明显更负,多层感知机与线性接近,论文正文报告完整 70 文件均值上卷积最低约负 19.3 dB,比线性低约 1.1 dB,是唯一在掩蔽感知口径上明显拉开差距的学习模型。分条目看,钟琴与羽管键琴上多层感知机不敌线性,而卷积仍保持最低。
下面这张主观图需要在同一短窗条件下一起读,横轴为各关键条目与总体,纵轴为 MUSHRA 分,图例区分锚点、短窗基线、线性、多层感知机、卷积、长窗基线和参考,误差线为 95% 置信区间。
看图路径: 1. 先看图例区分参考、锚点、短窗基线、线性、多层感知机、卷积和长窗基线;2. 再按横轴逐个乐器与语音条目比较各条件的均值点高低;3. 注意每点上下竖线的 95% 置信区间是否重叠

论文图 2。原论文 Figure 2::“Mean MUSHRA score by item (and overall) per condition, with 95% confidence intervals and N=17 trained listeners.”。
从像素上可以直接看到,粉色参考接近 100 分,红色锚点在 20 分附近,蓝色短窗基线最低约 40 到 65 分,橙色卷积在除男声外的多数条目上最高,长窗基线居中,线性与多层感知机位置接近。总体列上卷积明显高于短窗基线,也高于长窗基线,但男声等条目上各方法差距较小,置信区间也有重叠。
短窗加预测能否替代直接加长窗口
这里比较的是延迟与质量的权衡,短窗用 5 块上下文,长窗用 3 块上下文,因为长窗每跳样本数是短窗的 4 倍,这样回看时长大致可比。指标仍是预测增益、编码信噪比和噪声掩蔽比,关键代价是算法延迟随窗长成比例增长。
| 条件 | 算法延迟 |
|---|---|
| 短窗 w=512 | 11.6 ms |
| 长窗 w=2048 | 46.4 ms |
上表整理了原文连续句中直接报告的两种窗长的算法延迟,采样率 44.1 kHz,50% 重叠实现下延迟等于窗长,长窗约为短窗的 4 倍,这是讨论能否用预测替代长窗的前提。本表数值与单位依据论文 PDF。
| 条件 | 相对长窗不预测基线的编码增益 |
|---|---|
| 长窗 w=2048 加卷积预测 | SNR +3.05 dB,NMR −2.36 dB |
上表整理了原文连续句中长窗内加卷积相对长窗不预测基线的提升,说明预测在长窗下仍有效,但本文更关心的是短窗加预测能否追上长窗基线。正文报告短窗多层感知机和卷积的编码信噪比都超过了长窗基线,卷积高出约 1.2 dB,尽管分析窗只有 1/4。分条目统计上短窗卷积在多数条目上达到或超过长窗基线,但男声语音对所有短窗预测都较难,女高音只有卷积能恢复。本表数值与单位依据论文 PDF。
听音主观分是否支持客观排序
这里比较的是约 110 kbps 下 5 个编码条件的主观差异,听音者为 17 名训练有素人员,指标方向是 MUSHRA 分越高越好,锚点与隐藏参考用于校准量表。
| 比较对象 | 卷积相对提升 |
|---|---|
| 相对短窗基线 | +28 points |
| 相对线性预测器 | +11 points |
| 相对长窗不预测基线 | +6 points |
上表整理了原文连续句中直接报告的卷积在总体上的 3 组主观差值,均为 Holm 校正后 p 小于 0.01 的显著差异,说明卷积不仅在信噪比和噪声掩蔽比上领先,听感上也拉开差距。论文同时报告所有预测器都显著优于短窗基线,但线性与多层感知机之间统计上不可区分,这与客观上两者噪声掩蔽比打平是一致的。
预测带来的计算代价在哪里,能否便宜化
性能讨论只在有用的前提下成立,因此论文在 Apple M4 Pro 笔记本的 Python 研究实现上分别计时编码和解码。神经网络推理用 ONNX Runtime,已接近产品推理成本,但周围编码环节是未优化的 NumPy,所以应看配置间比例而非绝对时长。编码端因为要对原始和残差两种候选各做 1 次整块量化和反量化再做最终混合量化,工作量远大于解码端。
论文报告基线编码约 12.7 s,解码约 2.8 s,解码实时率约 0.05;卷积编码约 24.4 s,解码约 4.8 s,解码实时率约 0.10,仍远快于实时。编码端开启预测几乎翻倍,但解码端只增加约 2.1 s,额外编码开销主要在分频带门控而非网络本身。卷积解码慢于多层感知机,尽管参数仅 0.13M 对 2.63M,说明小而深的卷积算子开销与参数量不成正比。
单通道解码无法跨块并行,每次预测依赖上一块重建,批量只能靠多通道或多文件,此时图形处理器的数据搬运往返可能超过计算本身。原文在两种窗长下比较了中央处理器与图形处理器后端的单次调用延迟,单通道批量为 1 时中央处理器明显更快,批量增大到 32 或窗增大到 2048 时图形处理器才反超。结论的使用条件很明确:顺序单通道解码应留在中央处理器,只有能组大批量时才考虑图形处理器。
门控本身也可以便宜化。频带能量近似只比较残差与原始在该频带的能量,门控耗时从每块约 0.98 ms 降到约 0.07 ms,约 14 倍加速,与参考门控的逐频带一致率约 85.2%,信噪比损失约 0.52 dB;缩放峰值近似损失约 3.63 dB;完全不门控会在个别文件上因误差反馈崩溃,例如钢片琴上到负 74.4 dB。门控只影响编码器,换近似规则不需要改码流和解码器。
这些结论在什么条件下才成立,有何局限
所有客观增益都绑定在特定条件:训练是独奏乐器库,测试是 EBU SQAM 跨库集合,码率多为每采样点 2.0 比特,主观在约 110 kbps 下进行,上下文短窗取 5 块。换码率、换语种语音比例、换打击乐占比或换上下文长度时排序可能变化,不能直接推广到所有音乐和语音。
信噪比和噪声掩蔽比经过了相同的心理声学和比特分配流程才可比,预测增益本身不经过量化,从预测增益到编码增益会有缩水。门控标志占用每频带 1 位,论文明确与无标志基线没有严格等码率保证,因此小幅超越要留有余量理解。
未胜出项和负结果同样重要:多层感知机平均噪声掩蔽比与线性打平,在羽管键琴和钟琴上不敌线性;男声条目上所有短窗预测都难以追上长窗基线;缩放峰值门控和无门控都明显变差。跨库实验还显示加大多层感知机容量主要改善库内验证损失,跨库增益几乎不动,说明容量路线在本任务上容易过拟合训练库的特定模式。
要复现第一步该做什么,需要哪些信息
复现应先搭出不预测的常规 MDCT 感知编码器:Kaiser-Bessel 导出窗、50% 重叠、比例因子频带划分、心理声学模型和比特分配都要与预测模式完全相同,否则无法归因。接着实现逐谱线 2 阶归一化最小均方线性预测器,核对步长、泄漏、钳位和分母正则,再实现 1 位每频带的量化感知门控,确认编解码都只用已重建历史更新状态。
神经网络部分需要用相同 MDCT 和全局标准差处理 Medley-solos-DB,训练 5 块上下文的多层感知机和卷积模型,损失为下一块均方误差,网络输出相对最近块的增量。评价切换到 EBU SQAM,固定 2.0 比特每采样点,分别跑 512 和 2048 窗,对齐预测增益、编码信噪比和分频带平均的噪声掩蔽比。
关于资源,论文正文脚注提到了一个代码链接,但本次可核验的来源清单中没有完成可达性验证的作者资源,因此不能写成代码或模型已公开,复现应按论文文字从头实现。运行时注意起始块历史不足时回退,门控比较要包含步长选择在内的完整量化和反量化往返。
什么时候值得尝试,还缺哪项验证
当系统被延迟卡住而不能加长分析窗时,这篇工作值得尝试:保持 512 点短窗的约 11.6 ms 算法延迟,用一个约 0.13M 参数、在中央处理器上解码实时率约 0.10 的卷积预测器去恢复甚至超过 2048 点长窗基线的质量。调性音乐和有持续谐波的信号预期收益大,瞬态打击乐和宽带噪声预期收益小,应先在目标曲库上做分类型验证。
还需要补的验证包括更宽码率下的曲线、立体声多通道的联合预测、流式丢包下的误差传播界,以及预测感知比特分配能否把更多原始预测增益转化为编码增益。未来方向如按语音、调性、打击乐切换专用预测器、引入更长建模的 Conformer、周期性非预测刷新块,都还停留在建议阶段,没有本篇的实测支撑。总体上这是一个小而自包含的模块式改进,不是替代整个编码器的方案。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses