📄 整句错得不多,关键词却丢了:KeyASRBench 如何度量整词短语保留
英文题目:KeyASRBench: Measuring Whole-Phrase Keyword Preservation in Real-World ASR
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Guanzheng Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyi Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音识别的整句错误率已经很低,但人名、产品名、技术术语、带版本号的名称以及改变指代的关系短语仍可能被改写或丢失,论文要回答的是转写稿是否保住了这些被选定的整段短语。输入是播客与圆桌讨论等长音频切出的中英文片段及参考转写,系统输出完整转写文本,同音替换和切分变化会破坏整段含义,而逐字平均的序列指标会把这种破坏稀释。先从参考转写出发,用实体与术语规则提取长短语优先的候选跨度并做统一归一化,再将候选送入复核环节保留每段一至三个信息承载短语并冻结边界与允许写法,最后把冻结的关键词表送入同一匹配器,在假设文本中统计选定短语的缺失与多出出现次数并微平均为关键词错误率。与已有做法的差异是只看选定短语出现次数,不计普通词和格式改动,也不要求位置对齐,同时把整句混合错误率放在旁边对照。在十小时挑战集上,StepAudio 3 ASR Max的整体关键词错误率为13.61%,低于Qwen3-ASR-0.6B的33.81%,而七个系统的语言适配序列错误仅为5.31%至12.91%,说明整句指标相近时短语保留仍可分开排序。结论适用于该试点收录的播客与技术讨论语料和冻结的关键词定义,未验证检索或人工可用性收益,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
公开榜单分数很低,为什么生产系统还在维护热词表?
这篇论文的起点是一个在语音识别里常见的落差。一方面,Whisper 用了 680,000 小时弱监督数据,Qwen3-ASR 报告支持 52 种语言方言,在公开基准上序列错误率已经很低;另一方面,实际产品仍在维护热词表、联系人偏置、检索增强和转写后改写。作者认为这两件事并不矛盾,因为它们解决的是两类问题。一类是切分、静音检测、标点和说话人归属等格式声学工程,另一类是保护信息承载词,也就是人名、产品名、技术术语、版本号和关系短语。
对刚入门的读者,可以把输入输出先固定下来。输入是一段真实长音频,主要是中文和英文播客、圆桌与技术讨论,带有口吃、自我修正、中英混杂和跨段落上下文。系统要输出完整转写文本。评价者手里有人工参考文本。传统做法是把参考与假设对齐后数替换删除插入,中文按字、英文按词,得到混合错误率或词错误率。
问题在于,它给无实意的语气词和决定检索能否命中的产品名赋予相近的编辑代价。论文举例说,Qwen3-ASR-1.7B 把 Claude Code 写成 Cloud Code,整句词错误率只有 1.69%,但完整产品名已经丢失。整词视角就是要把这种丢失显式记下来。
因此本文不是提出新的识别模型,而是提出一个互补的度量与小规模双语试点。它的目标读者是需要判断转写是否可用的人,而不是只看榜单排名的人。后文会沿着一条样本说明,参考文本如何被标注出必须保留的完整跨度,假设文本如何被归一化后计数,以及挑战集与对照集如何分工证明问题具有普遍性。
已有语料和加权评价各自解决了什么,还缺什么?
在语料一侧,GigaSpeech 提供 10,000 小时多领域英文语音,WenetSpeech 收集网络视频与播客并包含真实会议测试集,SPGISpeech 包含 5000 小时财报电话转写。这些工作扩大了声学与领域覆盖,但没有明确标注哪些内容必须保留。ConEC 与 Contextual Earnings-22 更接近本文动机,它们为财报电话配上幻灯片、新闻稿与参会人名单,研究在提供上下文与不提供上下文时对罕见定制词的识别,要求文本与对齐位置同时正确。这是英文财报域的上下文干预基准。
在评价一侧,早有研究指出统一词错误率不够用。Galibert 等人发现对口语命名实体识别而言,按任务相关度排序的错误重要性与按词错误率频率排序并不一致。Park 等人在客服中心分析中定义过基于领域关键词的关键词错误率。VietMed-NER 也报告关键词错误率,但用对齐且不计插入。本文明确与后者区分:它的设计故意丢掉位置,只惩罚所选关键词的多出次数,不惩罚普通词的插入。AraDiaWER 等语义加权指标则把多个分数加权合并,但权重取 2 还是 10 在字幕会议金融车载等场景难以统一。
上下文偏置 × 转写后纠错: 上下文偏置在解码时注入热词名单联系人或检索到的发音提示,帮助识别长尾实体;转写后纠错在得到初版文本后用多候选重排或语言模型改写来修复品牌名,二者都是生产系统为保护关键短语加的额外工程,也是本文主张单独度量短语保留的现实依据。
本文继承的是二进制纳入思路:重要性通过是否选入关键词集合来表达,边界与别名由标注冻结,而不是通过调权重表达。工业界的例子被用来说明这不是纸面问题,Google 的歌曲应用联系人偏置、Apple 从个人库检索发音相近人名并报告命名实体错误相对下降 73.6%、小米的联系人词汇注入、NIO 结合流式识别与百万级热词检索,都指向同一需求:在端到端错误率之外单独保护关键短语。
什么算关键词?什么算保留住了?
论文把关键词定义为样本内的完整跨度。也就是说,同一个字符串在不同句子里是否算关键词、允不允许缩写,取决于本条样本的任务语境。例如在比较编程智能体的句子里,Claude Code 是必须保留的完整产品名;而在只关心厂商家族的句子里,Claude 可能就是被认可的变体。这种等价关系只在样本内有效,并在评测前冻结。
入选范围包括 4 类加一类兜底。实体如人物组织产品地点,技术教育金融域的术语,带版本的短语如 Kimi 2.7 或 GPT-4o 而不是孤立数字,以及删掉一部分就会改变指称关系或请求动作的关系短语,其余确为任务必需的精确跨度也可入选。关键在于完整性:只写对一半仍然算丢失。
保留与否不是看对齐位置,而是看归一化后的出现次数。参考与假设都先做 Unicode NFKC 与大小写折叠,关键词拼写忽略版式空格下划线连字符,但保留小数点斜杠等其他标点,并用数字版本边界防止 2.7 匹配到 1.2.7 或 2.7.1,也防止 GPT-4 匹配到 GPT-4.1。数字的等价读法必须事先冻结为样本内变体。每个关键词 k 记参考出现次数为 Nk,假设中非重叠归一化出现次数为 Ck,缺失为两者差的非负部分,多出为反向差的非负部分。普通词 filler 格式与非关键词插入不进入分子分母。当所选关键词的插入多于参考出现时,错误率可以超过 100%。
从长音频到分数,整条流水线经过哪些隔离步骤?
理解本文方法最直接的方式是跟着一条长音频走完全程。原始输入是播客圆桌等长录音,先按完整录音切分,去掉非语音音乐节目片头片尾广告赞助口播与低置信参考,并用内部指纹与来源上限做去重与封存。然后进入两条抽样路径,一条是挑战集的配额抽样,另一条是对照集的哈希抽样。抽中片段再做关键词标注,最后在隔离条件下推理评分并输出关键词错误率语言切片与置信区间。
下面的流程图把这种分工画了出来,重点是受控二字:音频参考关键词与来源信息在评测时隔离,系统只能拿到音频与强制语言,不给参考标题热词与检索结果。
看图路径: 1. 先沿从上到下的箭头看音频清洗到报告的主路径;2. 再看中间两条抽样路径在何处分叉又在何处汇入同一标注;3. 注意受控评测把音频参考与关键词隔离的含义
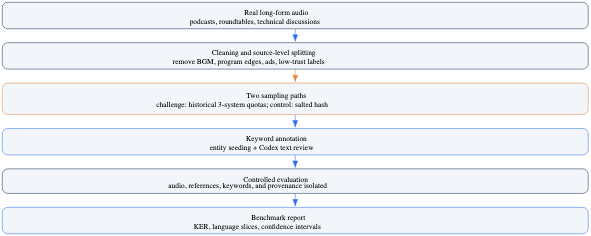
论文图 2。原论文 Figure 2::“Construction and evaluation workflow.”。
这张图确实可见 6 个从上到下排列的框与箭头,从真实长音频开始,经过清洗与按来源切分,再到两条抽样路径、关键词标注、受控评测与基准报告。它帮助理解后文两个集合为何性质不同:挑战集是有意挑难的,标注用实体规则加 Codex 文本评审;对照集是盲抽的,但两者共用同一套文本评审策略、精确跨度校验与修正后的计数器。版本标识也需要 1 次说明,v0.1 指试点版本,hard10_v2 指第二次构建过程,v0.3 指修复后的私有清单模式,它们描述不同层面,不是 3 套不同音频。
关键词错误率具体怎么算?
这一节把计数规则讲到可复述的程度。对每条样本,标注已经给出若干关键词及其参考出现次数。评分器用同一套生产匹配器分别数参考与假设,保证参考对参考的关键词错误率为零。匹配前文本经过前述归一化,关键词内部允许的版式差异被抹平,但语义边界被守住。重复出现分开计数,例如同一产品名出现 2 次,错 1 次记 1 次。
微平均的关键词错误率把所有关键词的缺失加多出求和,再除以所有参考出现总数。公式如下,分子是每个关键词的缺失与多出之和,分母是参考出现总数。
\[\mathrm{KER}=\frac{\sum_{k}(M_{k}+I_{k})}{\sum_{k}N_{k}}.\]这里 Mk 是缺失数,Ik 是所选关键词的多出数,Nk 是参考出现数,求和遍历全部关键词。需要记住 3 个统计含义。第一,分母不是全文词数,而是被选中的短语出现总数,试点中为 4723 次。第二,分子只与所选短语有关,普通词写错不直接推高它,普通词多写也不惩罚。第三,它与序列诊断并列报告,序列诊断捕捉全文错误,关键词错误率捕捉所选短语计数是否守住。论文还要求参考与输出计数调用同一匹配器,并用数字版本扩展反例做回归测试。
序列错误率 × 关键词错误率: 序列错误率统计转写全文每个字词的替换删除插入,反映整体听写干净程度;关键词错误率只统计事先冻结的整词短语在假设中出现次数的缺失与多出,反映关键信息是否被完整保留,二者搭配才能区分全文流畅但名字写错的情况。
关键词是谁选的?如何防止事后改标注?
标注流程是版本化可审计的文本评审流水线。起点是基准参考文本,先用实体与术语规则做精确跨度候选,长短语优先于子短语匹配。然后要求 Codex 命令行工具在每条中保留 1 到 3 个信息承载的名字产品技术词版本或关系短语,同时拒绝普通词节目名与套话。机器校验要求每条保留短语都是归一化后参考文本的精确子串,且每条片段至少有一个关键词,最后经人工复核抽查后冻结关键词、变体、来源分组、内部音频指纹与评分器版本。
冻结的含义是模型评测开始后不再改动。在 v0.1 中,Codex 评审看不到模型输出,别名只在同一参考文本里明确出现过另一种写法时才允许,且全试点只有 38 条挑战集条目与 2 条对照集条目含有认可别名。试点共 3881 条样本内标注条目,对应 4723 次出现,其中产品模型 1530 条、组织 1020 条、领域术语 758 条,关系短语 88 条与版本标识 29 条是探索性类别。每条被选片段在固定 10 小时预算内都含有关键词,中文子集按片段主要语言与话语语境划分,因此中文片段里的 AMD、DeepSeek、Claude Code 等英文混杂词仍算中文片段的词。
整词短语 × 样本内等价形式: 整词短语要求把产品名版本号关系短语作为不可拆分的完整跨度来判定,缺一字即算丢失;样本内等价形式是在同一条参考文本里明确出现过的写法变体,事先冻结后才允许互换,二者组合既守住边界又避免把大小写空格差异误判为错误。
本文训练了模型吗?实际执行的计算是什么?
这是 1 篇没有训练新声学模型的论文,需要明确说明以免误解。5 个本地系统是直接从冻结检查点推理得到,两个是调用官方接口,没有为本基准更新任何参数,也没有用关键词名单做偏置。所谓训练一节在这里对应的是数据集构建与推理执行的实际计算。
构建侧的计算包括清洗切分、历史三系统配额诊断与加盐哈希抽样。3 个预先指定的选择系统是 Qwen3-ASR-0.6B、Qwen3-ASR-1.7B 与 GLM-ASR-Nano-2512,上游版本化诊断标记每条是否达到 5% 序列错误,中文用保留拉丁字符并做数字归一化的紧凑字错误,英文用词错误。然后在每个语言来源格内按时长配给,目标是 55% 来自至少两套系统标错的片段,25% 来自恰一套标错,20% 来自都没标错,再按关键词覆盖标签置信度与冻结诊断排序。Whisper、MOSS、StepAudio 与 Doubao 没有参与选择。
模型条件挑战集 × 模型盲测对照集: 模型条件挑战集用三套预先指定系统的历史错误标签按配额抽取困难片段,用于集中暴露短语丢失;模型盲测对照集用加盐哈希随机抽取且不看任何模型输出,用于检验问题是否超出抽样偏好,二者搭配才能判断高关键词错误是普遍现象还是只因挑了难题。
推理侧的计算是受控调用。3 个选择系统用贪心解码、512 token 上限、无外部上下文。Whisper large-v3-turbo 用 faster-whisper 1.2.1 与 CTranslate2 4.8.4 半精度、束宽为 1、温度为 0、强制清单语言、无语音活动检测、无前文条件。MOSS 用确定性解码半精度、1024 token 上限与语言特定的中性转写提示,机械去掉说话人标签后再评分。StepFun 用 stepaudio-3-asr-max,单声道 16 kHz、强制语言、启用逆文本规范化、关闭时间戳。
火山引擎用 volc.seedasr.auc 展示为 Doubao ASR 2.0。挑战集请求完成于 2026 年 10 月 31 日,对照集为 11 月 7 日,所有输出与请求哈希在评分前冻结。
挑战集与对照集各有多大?序列指标与置信区间怎么定?
试点规模需要 1 次记准。挑战集总时长 9.999 小时,中英文各 5 小时,共 1501 段,其中中文 750 段、英文 751 段,来源分区各 751 与 750 段,录音组 273 个,关键词条目 3881 条、出现 4723 次,含关键词片段占 100%。对照集是不重叠的 77 段、61 个录音组、0.504 小时音频、216 次关键词出现,中英文各约 15 分钟,与挑战集零录音组重叠。它用固定加盐哈希在关键词资格评审后抽取,不读模型预测错误率或难度分。
下表是试点的基本盘,先看总量与语言划分,再看录音组与历史标签,最后一行是关键词覆盖。该表不是系统对比,而是呈现固定预算下每个片段都带有关键词,并列出历史标签与事后审计两种口径下的占比差异。
| Property | Value |
|---|---|
| Total duration | 9.999 h |
| Segments | 1,501 (750 Chinese / 751 English) |
| Selected keyword entries / occurrences | 3,881 / 4,723 |
上表说明挑战集是中英均衡的 10 小时试点,历史至少两套系统标错的占比目标为 55.0%,用报告分词器事后重算则为 64.6%,两者差异来自上游选择时归一器与报告指标不同,论文保留历史标签来描述实际驱动抽样的依据。条目数 3881 是样本内标注数,不是全局词表大小。
序列诊断的口径也要记准。NFKC 大小写折叠后,一个中日韩字符或一段可含内部点加井横线的 ASCII 字母数字串各算一个单元,其他标点分隔单元,例如 lock-in 与 a.b 各算一个单元,而 don’t 中的撇号会切分。中文片段用此混合分词报告混合错误率,英文片段报告词错误率,二者分开报告以保留各自单位。置信区间是对录音组有放回重抽样 10,000 次,保留组内片段与关键词出现,取百分位 95% 区间,描述的是每个系统分数的不确定性,保持组内依赖。
混合错误率 × 词错误率: 混合错误率用于中文片段,把一个汉字或一段英文数字串各算一个单元;词错误率用于英文片段,按空格分词后的词为单元,二者分工是保留各自语言的自然计数单位,并排报告时不能直接跨语言相减比较。
下面的历史标签图解释配额抽样实际长什么样,读图任务是看 4 段错误标记如何构成已选片段,而不是看系统好坏。
看图路径: 1. 先对比中文行与英文行中 0 个到 3 个系统标错的四段占比;2. 再看 2 个与 3 个系统同时标错的合计是否接近配额目标;3. 注意横轴是已选片段占比而非时长或错误率本身

论文图 3。原论文 Figure 3::“Historical labels that drove quota sampling for the challenge set.”。
这张图确实可见中文行与英文行各 4 段堆积条,分别对应 0 个 1 个 2 个 3 个系统标错,中文 3 个全错占 36.1% 共 271 段,英文占 32.6% 共 245 段。它帮助理解挑战集是有意偏难的,也解释为何跨集差值不能唯一归因于模型条件选择,因为对照集来源分区为 76 比 1,与挑战集的 751 比 750 并不匹配,关键词混合与密度也不同。
序列错误很低时,整词短语错了多少?
核心结果要同时读两套数字。7 套冻结配置在 10 小时挑战集上的语言特定常规错误为 5.31% 到 12.91%,而出现次数统计的关键词错误率为 13.61% 到 33.81%。点估计最低的是 StepAudio 的总体关键词错误率与中文混合错误率,英文词错误率最低的是 Qwen3-ASR-1.7B。语言内排名出现分化:StepAudio 与 Qwen3-ASR-1.7B 中文混合错误率只差 0.04 个百分点,但中文关键词错误率差 14.62 个百分点;英文端前者词错误率多 0.32 个百分点,但关键词错误率少 7.36 个百分点。序列准确与所选短语保留给出了不同的系统排序。
下表是主结果表,比较问题是在相同音频强制语言无关键词名单无外部上下文条件下,7 套系统各自的序列诊断与短语保留。指标方向都是越低越好,括号内为总体关键词错误率的 95% 录音组自助区间。
| Model | Chinese MER ↓ | English WER ↓ | Overall KER ↓ | Chinese KER ↓ | English KER ↓ |
|---|---|---|---|---|---|
| Qwen3-ASR-0.6B | 8.19% | 8.52% | 33.81% (29.38–38.14) | 43.81% | 22.20% |
| Qwen3-ASR-1.7B | 5.35% | 5.95% | 24.88% (21.12–28.58) | 33.49% | 14.87% |
| StepAudio 3 ASR Max | 5.31% | 6.27% | 13.61% (10.90–16.27) | 18.87% | 7.51% |
| Doubao ASR 2.0 | 7.47% | 8.88% | 23.78% (20.55–26.97) | 30.61% | 15.84% |
上表显示中文关键词错误率普遍高于英文,论文的解释是中文关键词以技术实体为主,且中文片段含有大量英文产品名缩写与混杂短语。主要收益属于 StepAudio,它在总体与分语言关键词错误率上都是最低点估计,但这不等于它在所有句子上都可靠,下文热力表与案例会给出反例。具体代价是关键词错误率与混合词错误率单位不同、短语更长,数值差距本身不能直接换算为重要性倍数。
读图任务是把柱高差与桶内趋势连起来看,重点观察低序列误差桶里是否仍有短语错误。
看图路径: 1. 先看上面两排柱图中绿色序列误差与橙色短语误差的高度差;2. 再看下面热力表中同一行从左到右随序列误差桶变大的变化;3. 对比 StepAudio 行与其他行在同一列的深浅差异

论文图 1。原论文 Figure 1::“Sequence error and phrase-occurrence error across seven frozen system configurations.”。
这张图确实可见上面两组柱图每套系统都有橙色关键词柱远高于绿色序列柱,中文侧橙色约在 18.9% 到 46.5% 之间,英文侧约在 7.5% 到 22.2% 之间;下面热力表按每套系统自己的序列误差分桶,每格报告该桶内关键词错误率与片段数,随桶右移颜色变深,但即使在小于 2% 的桶内关键词错误率仍有 3.6% 到 7.9%。它支持的判断是短语丢失延伸到低序列误差片段,而 StepAudio 在各桶内普遍更浅则说明差距在不同难度下都存在,但不能推广为自然流量下的排名,因为挑战集是偏难抽样。
换一批不看模型输出抽的片段,问题还存在吗?
对照集回答的是存在性问题,而不是精细排名。7 套系统在模型盲测对照上的关键词错误率为 10.65% 到 27.31%,说明所选短语错误也出现在非挑战集片段中。对照区间很宽,因为只有 77 段与 216 次出现,中英文各约 38 与 39 段,录音组各 27 与 34 个。
下表并列对照与挑战的关键词错误率,比较问题是同一系统换到盲抽小集合时分数是否回落,以及回落幅度在选择系统与非选择系统之间是否不同。最后一列是挑战减对照的百分点差,不是相对百分比。
| System | Model-blind control KER ↓ | 10-hour challenge KER ↓ | Challenge −- control |
|---|---|---|---|
| Qwen3-ASR-1.7B | 15.74% (10.30–21.49) | 24.88% | +9.14 pp |
| GLM-ASR-Nano-2512 | 21.30% (14.56–28.38) | 32.50% | +11.20 pp |
| StepAudio 3 ASR Max | 10.65% (6.79–14.75) | 13.61% | +2.96 pp |
上表显示 3 套选择系统的挑战减对照增量为 9.14 到 11.20 个百分点,其余 4 套为 2.48 到 6.83 个百分点。这与预期一致:挑战集优先纳入了选择系统的错误, disadvantaged 的主要是它们。但论文明确限制,对照不是来源匹配的,挑战集来源分区为 751 比 750,对照为 76 比 1,录音关键词混合密度也不同,且接口 2 次运行相隔 7 天、服务端不可变版本不可得,服务漂移也可能贡献跨集差异,因此跨集差值不能唯一归因于模型条件选择,也不支持自然流量估计。
未胜出项在这里也要点名。Whisper 在对照上为 27.31% 区间 19.07 到 35.81,是七者中点估计最高,但其挑战减对照只有 3.98 个百分点;Doubao 增量最小为 2.48 个百分点,但两套分数仍在 21% 以上。这些数字共同说明,即使离开为 3 套系统定制的难题,短语保留失败依然存在,只是程度与排序都不宜用这个小对照做细粒度断言。
短语越长越容易错吗?实例里错的都是什么?
论文没有做去掉某模块的常规消融,这里展开的是它特有的两类细节:按短语长度的分组与按句的实例诊断。挑战集主分母中,一单元出现 2888 次、二单元 1191 次、三单元及以上 644 次。关键词错误率在这些长度组之间有变化,且模式随系统而异。结合热力表看,长度与序列误差桶是两个正交的切分,前者看短语本身复杂度,后者看整句听写难度。
实例表把机制讲得更具体。4 组案例覆盖中文组织名、中文技术短语、英文产品与英文实体。每组 ground truth 给出 Codex 选定的精确参考跨度,识别形式抄自冻结模型输出,句级混合词错误率与句级关键词错误率只在该例句上计算。表前比较问题是:在整句错误很小的情况下,完整产品名与技术短语是否仍被改写,以及不同系统是否在同一短语上犯不同错误。
| Case type | Ground truth | System | Recognized form(s) | Sent. MER/WER | Sent. KER |
|---|---|---|---|---|---|
| EN-product | Codex; Claude Code | Qwen-0.6B | Codex; Cloud Code | 5.08% WER | 50% |
| EN-product | Codex; Claude Code | Qwen-1.7B | Codex; Cloud Code | 1.69% WER | 50% |
| EN-product | Codex; Claude Code | MOSS-0.9B | Codex; Claude Code | 0.00% WER | 0% |
| EN-product | Codex; Claude Code | StepAudio | Codex; Claude Code | 1.69% WER | 0% |
上表中最有教学价值的是英文产品行,参考为 Codex 与 Claude Code,Qwen-0.6B 与 Qwen-1.7B 都把后者写成 Cloud Code,前者句级词错误率 5.08% 后者仅 1.69%,但句级关键词错误率都是 50%,丢失了一个完整产品名,而 MOSS 与两个官方接口都恢复了完整产品名。中文技术行则相反,只有 StepAudio 同时恢复长程任务与自治智能体且句级关键词错误率为 0%,其余系统把长程写成长城长征、自治写成自制,句级关键词错误率为 100%。中文组织行所有系统都至少错一半,极客公园被写成极公源极工源极光源等同音近形替换。英文实体行三词中 HeyGen 与 Replit 反复被改写为 Hagen 与 Ripples 等,说明长尾产品名对通用识别器仍困难。
限制也要同时说明。该表省略 Whisper 仅为篇幅,聚合结果仍含 7 套系统;每例指标只在单句上计算,不能当作系统总体;红色表示丢失、黑色表示恢复是按精确跨度判定的,大小写空格差异已归一化,判错即意味着归一化后仍不匹配。
哪些结论是有条件的?还有什么没测?
先说统计条件。录音组自助保留了组内依赖,但更高层级的系列相关没有建模,77 段对照的区间很宽,只适合做存在性判断,不支持精细排名。接口挑战与对照相隔 7 天,服务端不可变版本不可得,跨集差异可能含服务漂移。
再说标注与度量条件。标注是 Codex 辅助文本选择加人工复核抽查,不是完整的双人独立听音标注,仍可能残留参考错误、误选关键词与遗漏别名。关键词错误率尚未与检索效果、任务完成度或转写效用的人工判断校准,它与混合词错误率的数值差距也反映了单位与整词长度不同,不能理解为重要性是几倍。中文高于英文的差距受关键词构成与中英混杂影响,不能直接读成中文识别更差。
未评测的范围论文列得很明确。关系短语 88 条与版本标识 29 条目前稀疏,重叠远场口音切片尚未覆盖,把短语保留与检索性能人工效用判断关联的工作还没做,同一系统在纯音频、热词、上下文偏置与检索辅助条件下的对比也没做。这些都是把观察到的失败转化为可修复结论之前需要补的验证。涉及人名会议身份与敏感属性时,任何外部使用前都需要脱敏与授权检查。
要复现这套评测,第一步做什么?能拿到什么?
复现的第一步不是下载音频,因为完整基准数据不在公开包里。计划公开的是技术报告、协议、评分器、聚合统计与单独清理过的示例,而不是完整音频参考与关键词标签。音频参考关键词标签与详细来源留在受控环境,清单带有发布许可要求,未来示例第三方评测访问保留与删除都需要单独文件与许可。报告隐去节目名出版方说话人标题链接时间戳来源编号等可反查信息,任何随报告发布的示例音频必须单独授权且不与受控评测录音重叠。
可执行的部分是协议与计数器。复现者应先固定归一化与匹配器:Unicode NFKC 大小写折叠,关键词拼写忽略版式空格下划线连字符,保留小数点斜杠等标点,数字版本边界防止扩展匹配,数值等价读法事先冻结为样本内变体。参考与假设计数调用同一匹配器,回归测试要求参考对参考关键词错误率为零,并包含数字版本扩展反例。行级模式、遗留到当前清单的迁移审计与聚合结果来源把清单预测匹配器评分器哈希绑定,历史推理标识保持不变。
系统侧需要冻结可运行条件。本地 5 套检查点、后端版本、提示词、清单哈希与解码收据在内部冻结,官方接口用带日期的配置标识运行,StepAudio 为 stepaudio-3-asr-max,Doubao 为 volc.seedasr.auc,所有系统只给音频与强制语言。需要区分三件事:代码公开、权重可下载、系统可运行在本试点中是分离的,本文未发现来源绑定且完成验证的公开资源,不得声称代码模型或数据已公开。预测编号必须与私有清单精确匹配,否则无法对齐到冻结条目。
什么时候值得尝试这套评价,还缺哪项验证?
当你的转写下游依赖名字时值得尝试,例如用转写做检索摘要会议纪要、课程术语表、播客嘉宾与产品盘点,或者你已经在维护热词表却不知道漏了多少。这套评价的增量是把必须保留的完整跨度事先冻结,再用出现次数统计与序列诊断并排报告,让 Cloud Code 这类错误不再淹没在 1.69% 的整句错误里。7 套系统在挑战集上 5.31% 到 12.91% 的常规错误对应 13.61% 到 33.81% 的关键词错误,在盲测对照上仍有 10.65% 到 27.31%,说明问题超出抽样偏好,但具体幅度只在本次中英播客技术讨论分布与冻结标注下成立。
复现第一步是先跑通共享匹配器与回归测试,再在自有授权数据上按同一文本评审策略冻结自己的关键词,而不是直接套用本文的 4723 次分母。还需补的验证是更大且按完整录音组来源匹配的对照,扩充关系与版本类别,覆盖重叠远场口音,并把短语保留与检索效用人工判断关联起来,再测同一系统在热词上下文偏置与检索辅助下能恢复多少。
容易产生的误解需要 1 次澄清。关键词错误率高不等于模型整体更差,它与序列错误单位不同、排序也可能不同;对照增量小不等于系统更好,对照本身很小且来源不匹配;没有测量延迟成本误判率就不能承诺加了热词一定更快更便宜。本文的价值是让整词丢失显式可测,而不是给出通用排名,任何超出本次分布与标注的推广都需要重新冻结关键词并重测。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses