📄 流式语音增强怎么做成可部署的通道:GigaEdge Spench 解读
英文题目:GigaEdge Spench: An SDK for Practical Streaming Speech Enhancement
评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Artem Sokolov:Tashkent, Uzbekistan
- Artem Khaidarov:Moscow, Russia
- Yana Lysova:Moscow, Russia
- Alexander Gladkikh:Moscow, Russia
- Vitaliy Yulis:Moscow, Russia
📌 核心摘要
实时语音增强需要把连续到来的音频切成小块逐块去噪并保持跨块状态,同时与音频回调的不同块大小、重采样和电平控制协同,难点在于完整链路的延迟、吞吐和多路并发都要满足应用要求。本文提出的 GigaEdge Spench 把增强通道定义为有序流水线,应用可组合神经去噪、可选的归一化链、重采样和回声消除,共享 C++ 核心通过 ONNX Runtime 和 TensorFlow Lite 在原生、移动和 Web 端运行。先由重采样把输入音频转换到模型采样率,其输出送入按16 ms倍数构成的分块缓冲,再提取同一流的连续若干频谱帧并沿时间轴一起送入一次推理调用,在保留该流自身循环状态下完成神经去噪,最后把增强结果重采样到应用请求的输出采样率交付。发布包括 8 kHz INT8 模型和 48 kHz 判别式与混合式 FP32 模型,其中混合式是在冻结判别式模型权重基础上再结合用生成对抗网络过程训练的生成式成分的组合配置。在 EARS–WHAM v2 共 886 对含噪与干净文件的评测中,48 kHz 混合模型 PESQ-WB 为 1.87、DNSMOS P.808 为 3.45、NISQA MOS 为 3.20,参考的 DPDFNet2 48 kHz HR 对应为 2.21、3.66 和 3.81,混合模型在部分语音保持维度接近但总体预测仍落后。共享模型容量测试显示 48 kHz 混合模型平均通过 56.00 路并发流,为同条件适配后 sherpa-onnx/DPDFNet2 的 3.73 倍,而 8 kHz 模型可达 593.33 路,但带宽条件不同不能直接比较优劣。原文未披露训练、量化和转换工具的完整开销,推理代价以每秒音频的加权乘加数和实测实时率给出,结论适用于所测 WSL2 主机、16 ms 外部块和 10 s 窗口等条件,未验证长期服务和人耳偏好。
🔗 开源与复现资源
- 第三方资源:https://github.com/salute-developers/gigadenoiser — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决的输入输出问题是什么
输入是一路连续到来的麦克风音频,可能混有噪声、混响和播放回声,采样率和块大小由主机音频回调决定。目标是在中央处理器服务器、手机和浏览器上实时输出更干净的语音,同时不打断音频、不引入明显处理痕迹,还要给视频编解码留出算力。
必须保留的信息是语音内容、音色和连续性,不能为了压噪声而把语音切碎或压低。输出是同路增强后的音频流,可以保持原采样率,也可以经重采样后交付。论文强调,只看质量分数不够,还要看完整链路的计算、为凑大块而等待输入的时间,以及同一模型能同时带多少路流。
论文把应用场景明确为视频会议,设备差异大、麦克风质量不一,增强必须与高要求的视频编解码共享资源。于是评价围绕 3 个可操作的部署选择展开,而不是只报告某个模型的分数高低。
已有路线提供了什么,本文把重点放在哪里
已有研究软件分别解决了模块化架构、可复现流程、与语音识别结合、高效全频带结构和极低算力结构等问题。RNNoise 把神经估计与数字信号处理结合,并分离了共享权重与各流状态;DTLN、DeepFilterNet、GTCRN 和 DPDFNet 提供了流式推理、循环状态缓存和不同采样率的部署格式;WebRTC 音频处理模块和 SpeexDSP 提供了噪声抑制、回声消除和自动增益这类组合式处理;sherpa-onnx 提供了跨平台语音运行时。
本文的重点不是再提出一种孤立网络,而是把模型选择、流管理、平台封装和可配置音频处理包在一起,研究部署时的块大小与共享模型容量。下表摘录原文对几类相关系统的定位,比较的是文档记载的功能侧重,不是对质量或速度排名。
下表说明各系统记载侧重与本文的关系,帮助定位本文的部署研究位置。
| System | Documented focus | Relation to GigaEdge Spench |
|---|---|---|
| RNNoise [1, 7, 8] | DSP/neural enhancement, pretrained weights and training tools; shared weights with separate states; third-party WebAssembly integration. | Our native efficiency reference, evaluated at 48 kHz and after output downsampling to 8 kHz. We study model selection and temporal frame grouping in configurable channels with different sampling rates. |
| WebRTC APM; SpeexDSP [14, 15] | Established integrated audio processing for communication applications. | We combine neural model selection with these types of application components; our AEC reuses SpeexDSP. |
| sherpa-onnx [16, 17] | Cross-platform speech runtime; the inspected upstream streaming denoisers combine a model and one stream state. | We expose model/context separation in the SDK, temporal frame grouping, configurable level control, native/Web AEC, and independent input/output rates. The capacity reference uses a shared-model adaptation of sherpa-onnx. |
| GigaEdge Spench (this work) | Configurable DSP/neural enhancement channels with one C++ core, ONNX/TensorFlow Lite adapters, and native/mobile/Web interfaces. | Processing stages can run alone or together, with selectable normalization blocks. We evaluate the released neural configurations. |
从表中可见,本文把 RNNoise 作为原生效率参照,把 sherpa-onnx 上的 DPDFNet2 作为质量与容量的外部参照。需要特别说明的是,本文检查到的 sherpa-onnx 流式去噪实现是每个去噪器拥有一个模型和一路流状态、每次神经调用处理 1 帧谱,而本文的发布模型允许 1 次调用处理同流的连续多帧,这是后文块大小实验的机制基础。
部署时三个具体问题是什么
第一个问题是模型在质量与计算之间如何取舍。论文发布了 8 千赫兹整数 8 位模型和两个 48 千赫兹浮点 32 位模型,分别面向不同算力预算,需要在同一外部基准上看预测质量与实测开销。
第二个问题是数据块大小如何影响原生与网页端的处理开销。主机回调块与模型内部跳长可能不同,增大 1 次送入的音频量会改变调用次数,也可能改变推理本身的执行方式,但同时需要更长时间收集输入。
第 3 个问题是共享一个模型时能同时处理多少路独立流。每路流要有自己的历史,又不能为每路重复创建推理会话,论文用每路都达标的通过准则来度量容量,而不是用平均吞吐代替。
系统整体是如何组织的
系统分为三部分。共享 C++ 核心负责重采样、谱处理和各流的模型状态,对外提供 C 与 C++ 音频处理接口;平台封装把核心接到安卓、苹果系统和网页音频应用,并用工作线程把音频回调与神经处理分开;发布模型提供 8 千赫兹整数 8 位与 48 千赫兹浮点 32 位的去噪选项。论文称代码在 GitHub 仓库提供,本次核对时该链接返回不可用,这只说明链接当前状态,不影响对技术内容的理解。
应用按需组装增强通道,可以只用归一化而不用神经模型,也可以只用神经去噪而不用归一化,还可以两者结合,并在支持的原生与网页接口上加入回声消除。所有报告的软件开发工具包计时都使用 ONNX Runtime,外部 RNNoise 参照使用其原生 C 核心。
下面这张图是理解通道的关键,请先沿从上到下的箭头看主路径,再注意哪些环节标为可选。
看图路径: 1. 从顶部主机音频流向下看主路径的先后顺序;2. 区分哪些方框标注为可选以及归一化链内部的可选块;3. 确认回声消除的播放参考输入画在何处
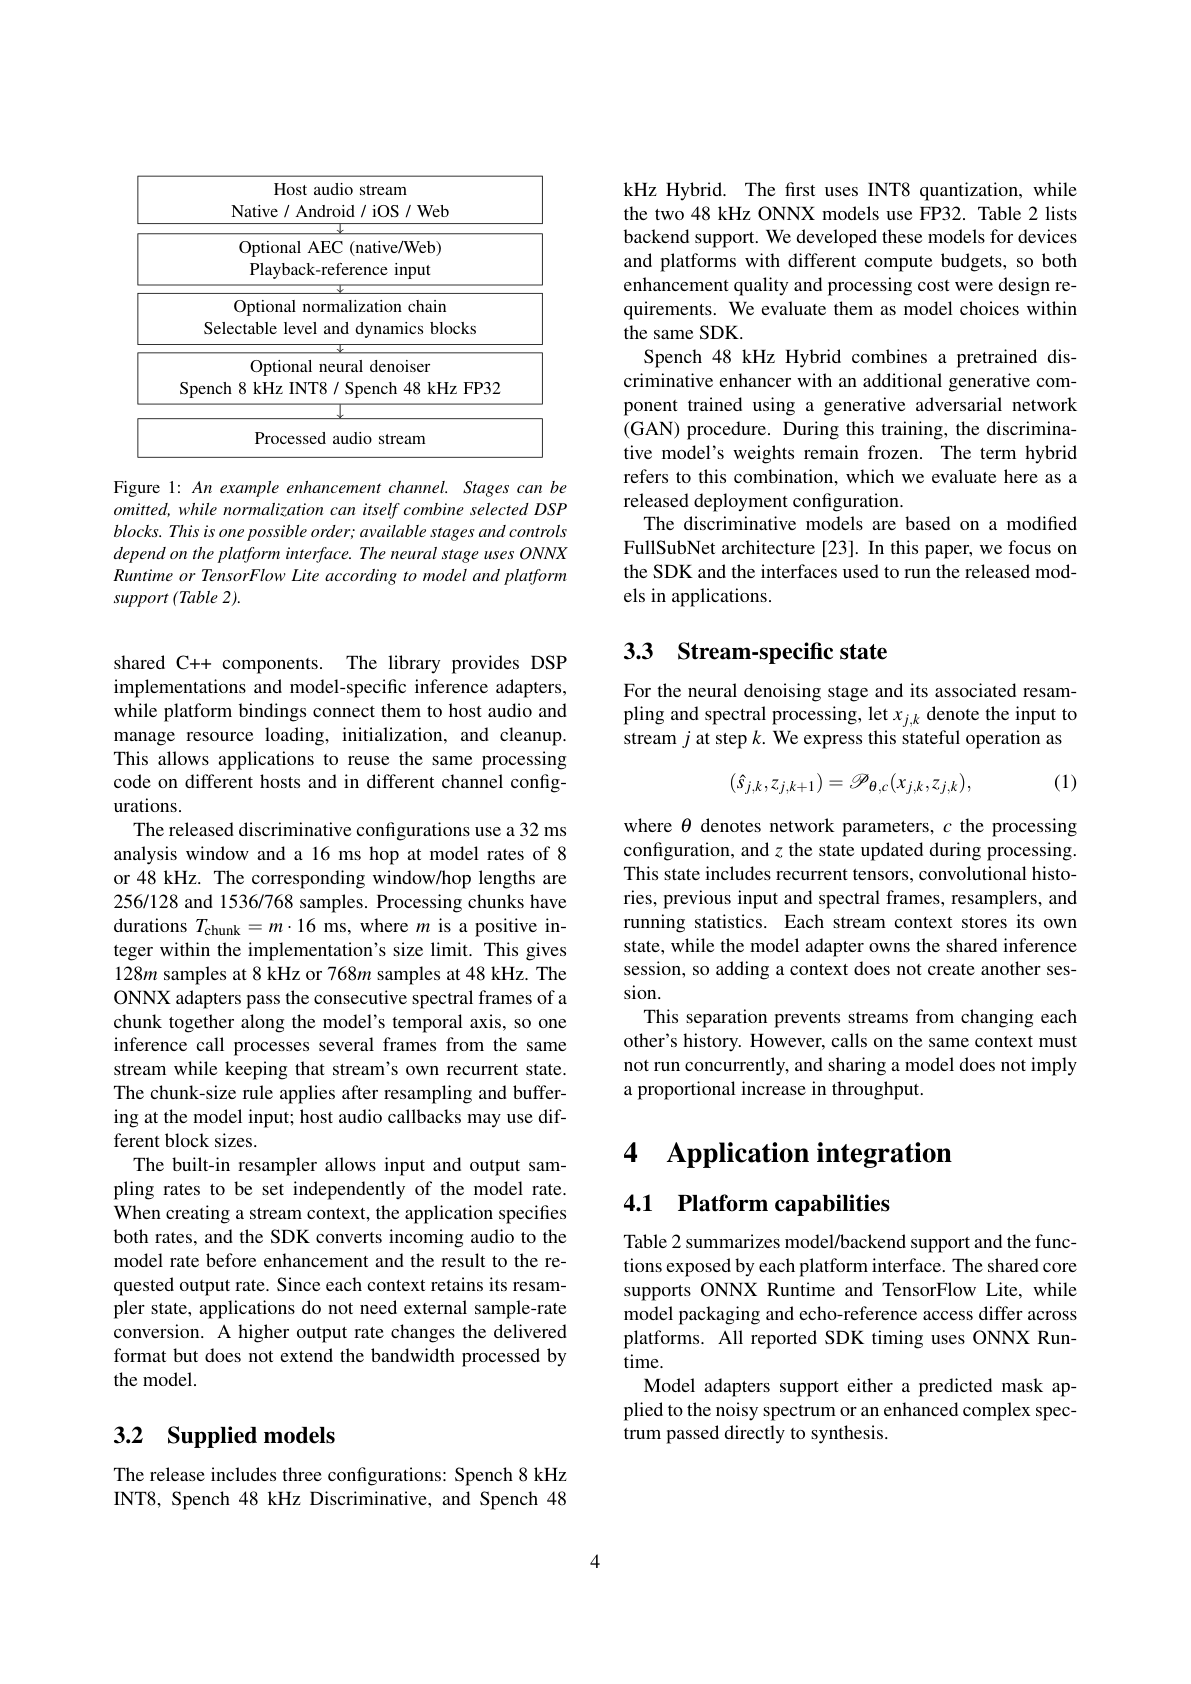
图片来源: 原论文 PDF 第 4 页(含图 1)
论文图 1。原论文 Figure 1::“An example enhancement channel. Stages can be omitted, while normalization can itself combine selected DSP blocks.”。
图中自上而下是主机音频流、可选回声消除、可选归一化链、可选神经去噪器,最后是处理后的音频流。归一化链内部还可以挑选电平与动态块,神经阶段按模型与平台支持选用 ONNX Runtime 或 TensorFlow Lite。这只是一种可能的顺序,可用阶段与控制取决于平台接口,输入输出采样率也可以独立于模型采样率设置。
流状态如何隔离,块与帧如何对应
对第 j 路流在第 k 步的输入,论文把有状态处理写成从当前输入与当前状态得到估计语音与下一状态的映射,其中参数表示网络权重,配置表示处理设置,状态包括循环张量、卷积历史、前一输入与谱帧、重采样器和累计统计量。每路流的上下文保存自己的状态,模型适配器拥有共享的推理会话,因此新增上下文不新建会话。
\[(\hat{s}_{j,k},z_{j,k+1})=\mathcal{P}_{\theta,c}(x_{j,k},z_{j,k}),\]该式的含义是,先用本流保留的历史参与当前块的计算,再把更新后的历史存回同一上下文,不同流不会互相改写历史。但同一上下文的调用不得并发,共享模型也不意味着吞吐按比例增加。
发布的判别式配置采用 32 毫秒分析窗、16 毫秒跳长。8 千赫兹对应 256 点窗、128 点跳,48 千赫兹对应 1536 点窗、768 点跳。处理块时长为 16 毫秒的正整数倍,8 千赫兹每块为 128 乘 m 个样点,48 千赫兹为 768 乘 m 个样点。ONNX 适配器把一块内的连续谱帧沿时间轴一起送入,因此 1 次推理可处理同流的多帧,同时保持该流自己的循环状态。主机回调可以用不同块大小,块大小规则作用于模型输入端的重采样与缓存之后。
增强通道 × 归一化链: 增强通道指对一条音频流依次施加的处理管线,不是左右声道;归一化链是通道中负责电平与动态的可选数字信号处理环节,由多个可挑选、可排序的块组成。通道决定用不用神经模型、要不要归一化,归一化链决定具体用哪些电平块,两者组合后应用可以在只调音量、只去噪或两者叠加之间选择。
流上下文 × 共享模型会话: 流上下文指属于某一路流的私有状态,包括循环张量、卷积历史、重采样器和谱重叠缓存;共享模型会话指多路流共用的同一推理会话与网络参数。分工是参数只加载一次,历史各自保留,组合后新增一路流只需新建上下文而不新建会话,但同上下文的调用不能并发,共享也不保证吞吐线性增长。
数据块 × 连续帧分组: 数据块指每次送入软件开发工具包的音频时长,论文中为 16 毫秒整数倍;连续帧分组指把一块内相邻的多个谱帧沿模型时间轴拼在一起一次推理。数据块解决主机回调与模型步长不一致的衔接问题,分组改变每次推理做多少帧,组合后增大块不仅减少调用次数,还可能提高后端执行效率,但代价是需要更长时间收集输入。
内置重采样器允许输入输出采样率独立于模型采样率。创建流上下文时指定两者,软件开发工具包先把输入转到模型采样率再增强,再转到请求的输出采样率。每路上下文保留自己的重采样状态,提高输出采样率只改变交付格式,不扩展模型实际处理的带宽。
归一化链与回声消除各自做什么
归一化是可配置的电平控制与动态块序列,可以独立处理音频,也可以与神经去噪一起处理。C++ 数字信号处理接口把这些块加入有序序列,每个块的参数可独立设置,例如响度控制之后接限幅器,或压缩器之后再接限幅器。
响度控制把信号调向目标电平,带有平滑增益与最大放大限制,可选的语音感知模式会平滑 RNNoise 的语音激活检测估计并在检测到的语音期间更新响度统计,也可以不用该检测。自动增益把增益调向目标信号功率,基于峰值的范围控制跟踪包络并按起音、释放与保持时间调向目标峰值,动态范围压缩器在阈值以上按压缩比减小大小声差距,噪声门降低阈值以下片段的电平,限幅器在高电平处限制输出峰值。
回声消除使用 1.2.1 版 SpeexDSP,需要播放参考信号来降低麦克风中的播放回声。原生与网页接口暴露该参考输入,安卓与苹果系统的功能接口不暴露。论文明确归一化独立运行与回声消除是软件开发工具包能力,但本次实验不把它们作为增强方法评价。
发布了哪些模型,训练信息交代到哪里
发布包括 3 个配置:Spench 8 千赫兹整数 8 位、Spench 48 千赫兹判别式和 Spench 48 千赫兹混合模型。前者用整数 8 位量化,后两个 ONNX 模型用浮点 32 位。模型适配器支持两种输出形式,一种是把预测掩蔽作用于带噪谱,另一种是把增强复谱直接送去合成。
48 千赫兹混合模型是在冻结判别式权重后,用生成对抗网络过程训练并叠加的生成部分,这里的混合指这种组合,论文把它作为已发布的部署配置来评价。判别式模型基于改进的 FullSubNet 结构,但论文把重点放在运行这些发布模型的软件开发工具包与接口上。
判别式增强器 × 混合模型: 判别式增强器指直接从带噪谱估计干净语音的模型,是本次发布的 48 千赫兹基础配置;混合模型指在冻结该判别式权重后,再用生成对抗网络过程训练并叠加的生成部分。判别部分负责主要去噪映射,生成部分负责改善预测听感,组合后得到计算量更大但部分语音质量预测更好的可部署选项,论文只评价该组合而不展开其结构与训练目标细节。
需要如实说明的缺口是,训练、量化与转换工具不在本次软件开发工具包发布范围内,48 千赫兹混合模型的详细结构与训练目标也不在研究范围内。3 个发布模型用内部数据训练,未使用 EARS 录音、WHAM!录音或 EARS-WHAM v2 混合,因此后文的 EARS-WHAM v2 是外部质量基准。由于各对照检查点的训练历史不同,质量差异不能只归因于结构或训练方法,论文的比较是部署选项比较,不是统一训练下的结构消融。
质量实验如何保证条件可比
质量评价在 EARS-WHAM v2 的 886 对匹配带噪与干净文件上进行,两个 48 千赫兹软件开发工具包模型通过原生命令行以 16 毫秒块处理,输入已在模型采样率,无需重采样,且关闭归一化与回声消除。48 千赫兹比较统一用宽带语音质量感知评价,8 千赫兹条件用窄带模式。RNNoise 多了一个输出降采样到 8 千赫兹的对照,它处理原始 48 千赫兹输入再降采样输出,与直接处理降采样输入的 8 千赫兹模型比较的是交付 8 千赫兹音频的两种做法,不测试 RNNoise 在已限带 8 千赫兹输入上的表现,也不报告该降采样路径的性能。
参考型指标先补偿系统输出延迟:Spench 补偿 16 毫秒,RNNoise 0.2 补偿 20 毫秒,DPDFNet2 高分辨率配置补偿 40 毫秒,带噪基线无需补偿。这只是为了对齐增强信号与干净参考,与应用缓冲或端到端延迟无关。宽带与窄带分数分开存放,不能跨带宽直接排名。
指标方向统一为越高越好。可懂度用扩展短时客观可懂度,感知退化用语音质量感知评价,尺度不变信号失真比度量对参考的重建;非侵入式平均意见分预测只从被评波形估计人类打分,分为 DNSMOS、SIGMOS 和 NISQA 三族,分别看总体与噪音语音平衡、信号损伤维度、通信质量与失真,不把三族平均成一个分数。其中噪声类分数越高表示预测背景越好,响度类分数越高表示响度越合适而非声音更大,这些维度分数是诊断性预测,不是物理伪影的直接测量。
实时因子 × 墙钟实时因子: 实时因子指处理调用时间加收尾时间除以音频时长,只计计算本身;墙钟实时因子指公共测量窗口时长除以某路流实际处理出的音频时长,包含等待与调度。两者分工不同,前者比较单次调用的计算开销,后者判断多路并发时最慢的一路是否跟上实时,组合使用才能区分调用变快与多流仍能达标这两种结论。
运算量按显式规则计数:1 次标量乘累加计 1 次,单位为每秒输入音频的 1000000 次。ONNX 模型计入执行的卷积与矩阵乘形状,包括分组卷积与输入循环乘积,不计偏置、激活、归一化、逐元素门、量化开销与外部数字信号处理;整数 8 位与浮点 32 位的 1 次乘累加都计 1 次,但运行时开销取决于精度。按内部跳长换算,软件开发工具包模型每秒 62.5 步,DPDFNet2 每秒 100 步。RNNoise 按保留的稀疏块与循环对角计数,假设为激活帧,而容量实测保留其在公共录音上的标准行为,包括静音时可能跳过推理。
时间与容量实验在什么机器与规则下测量
测试机为英特尔酷睿 Ultra 5 125H 笔记本,32 吉字节内存,Linux 环境暴露 18 个逻辑中央处理器,系统为 WSL2 下的 Ubuntu 24.04.5,基准驱动用 Python 3.12.3,因此结论描述的是该 WSL2 环境而非直接运行于硬件的 Linux。软件开发工具包实时因子定义为各次调用时间之和加收尾时间除以输入时长,推理实时因子分子只用神经推理时间,加载、解码与初始化另计,调用时间分位数描述调用耗时而非端到端音频延迟。
\[\mathrm{RTF}_{\mathrm{SDK}}=\frac{\sum_{i}t_{i}+t_{\mathrm{final}}}{D},\]并发命令行实验用 16、64 和 128 毫秒块与 1、2、4、8 个并发进程组合,每种配置测 1 次,命令行把波形 1 次性载入内存并在 60 秒区间内循环处理同一上下文,不累积也不保存输出,总吞吐为接受的音频总时长除以整组墙钟时间,包含进程启动与退出。
共享模型容量实验把所有流放在一个进程内共享模型资源,每流有独立上下文与系统工作线程,用 16 毫秒外部块反复处理 20 秒波形,每次测量 10 秒,模型加载与上下文准备在计时前完成,工作线程按轮转绑定并在每次测量前打乱顺序,测量间休息 30 秒,整轮搜索间休息 3 分钟。通过准则要求最慢的一路也在 10 秒内处理至少 10 秒音频,最快的一路不能补偿最慢的一路。
\[R_{j}^{\mathrm{wall}}=\frac{T}{D_{j}},\qquad R_{\max}^{\mathrm{wall}}=\max_{1\leq j\leq P}R_{j}^{\mathrm{wall}}.\]每个配置做 3 次完整自动搜索,每轮在通过的测量中取路数最大的成功测量并记录其中最慢流的墙钟实时因子,报告 3 次路数与 3 次实时因子的均值加样本标准差。由于实时因子来自被选中的通过测量,不是独立确认运行,重试规则只说明曾达到的通过路数,不保证每次重复成功或每块都满足截止期。为做容量对照,sherpa-onnx 也被改成共享一个模型与会话,但不改网络与信号处理算法,RNNoise 则共享权重而每流独立状态,内部仍按 10 毫秒帧处理并跨 768 样点输入块保留残余样点。
混合模型相对判别式模型改善了多少
本节回答 48 千赫兹两个发布配置之间的差异有多大,以及窄带交付条件下 8 千赫兹模型的表现。比较条件是同一 EARS-WHAM v2 基准,48 千赫兹用宽带评价,8 千赫兹用窄带评价,参考型指标已做延迟对齐。指标方向均为越高越好,表格整理的是论文报告的提升量。
| 比较 | 指标 | 提升量 |
|---|---|---|
| 混合相对判别式 | SI-SDR | 0.24 dB |
| 混合相对判别式 | DNSMOS P.808 | 0.26 |
| 混合相对判别式 | SIGMOS OVRL | 0.46 |
| 混合相对判别式 | NISQA MOS | 0.51 |
| 8 千赫兹相对降采样 RNNoise | SI-SDR 优势 | 1.96 dB |
表中混合模型的感知预测提升大于参考重建提升,可懂度与宽带感知评价相近,而 3 个总体预测分别提高上述数值。8 千赫兹整数 8 位模型在可懂度估计与参考重建上都优于带噪输入,也超过降采样后的 RNNoise 输出。需要强调的限制是,两种 8 千赫兹做法的输入带宽不同,比较的是交付结果而非同输入胜负;混合的额外计算有助于保留语音的判断基于预测器,不能等同于听感偏好。
共享模型容量结果支持什么权衡
本节回答共享一个模型时能同时带多少路流,以及质量选择如何转化为容量代价。测量条件是 16 毫秒外部块与 10 秒窗口,要求每路未舍入的墙钟实时因子都不大于 1,每个配置做 3 次完整搜索。表格整理的是论文报告的平均通过路数与相对倍数。
| 配置 | 通过路数 | 与对照的倍数关系 |
|---|---|---|
| Spench 8 千赫兹整数 8 位 | 593.33 | 为判别式的 3.93 倍,为混合的 10.60 倍 |
| Spench 48 千赫兹判别式 | 151.00 | 为共享 sherpa-onnx 对照的 10.07 倍 |
| Spench 48 千赫兹混合 | 56.00 | 为共享 sherpa-onnx 对照的 3.73 倍 |
| RNNoise 0.2 | 1088.67 | 为判别式的 7.21 倍,为混合的 19.44 倍 |
表后解释需要同时看带宽与质量代价。8 千赫兹容量最高但工作在不同带宽,48 千赫兹内部混合的质量提升伴随通过路数明显下降。与共享模型的 sherpa-onnx 对照相比,两个 48 千赫兹发布配置的容量倍数大于运算量倍数,说明只看乘累加比不能描述部署效率。RNNoise 路数最高,其原生稀疏执行是强低成本参照,但质量部分已说明吞吐 alone 不足以选型,且各系统都共享模型资源并独立保存流状态,共享本身不能解释排名。由于搜索用短窗口、重试与固定绑定策略,通过率不是长期服务上限,也不保证每块截止期。
块大小与网页端执行带来什么代价
单流实验用同一 30 分钟单声道 48 千赫兹文件,在原生命令行与无头浏览器中各做 16、32、64 和 128 毫秒块,每种组合重复 3 次,尽速处理整个文件而不保存输出。原生调用含重采样、谱变换、模型执行与重建,浏览器调用还含脚本与 WebAssembly 边界拷贝,总时间含收尾但不含加载、解码与初始化。实时因子列显示的是百分比,数值除以 100 才是实时因子,调用分位数单位为毫秒。
结论是增大块在两种路径下都降低推理与完整实时因子,但单次调用中位数变长,因为 1 次处理更多音频。调用减少可降固定开销,大输入也可能提高后端效率,且推理实时因子同样下降,说明好处不只来自应用封装。网页端在每个匹配配置上都比原生慢,完整处理时间为 1.79 到 3.27 倍,包含后端、封装与 WebAssembly 执行差异,但所有测试配置仍快于实时,且模型排序在两条路径一致。对 8 千赫兹整数 8 位在 128 毫秒时推理约占总处理一半或更少,进一步优化还需处理重采样、谱处理、重建与数据搬运。
下表是初始化与资源范围,先对 3 次重复取中位数,再在 4 种块大小上取最小到最大区间,显示的是配置间差异而非不确定区间。
| Model / path | Initialization (ms) | CPU (%) | RSS (MiB) |
|---|---|---|---|
| Spench 8 kHz INT8 / CLI | 125.75–256.37 | 115.69–156.28 | 443.64–572.26 |
| Spench 48 kHz Discriminative / CLI | 87.43–111.91 | 105.71–106.50 | 448.77–548.29 |
| Spench 48 kHz Hybrid / CLI | 87.72–105.05 | 100.00–103.12 | 591.96–640.96 |
该表比较各模型与路径的初始化时间、处理器占用和常驻内存,资源占用不跟随处理速度。网页端常驻内存各模型相近,因为还包含载入录音与运行时开销,不能从模型大小估计应用总内存;更快模型的中央处理器百分比与初始化时间也不一定最低。尽速处理下的百分比描述该段工作的资源占用,不是直播一路所需的负载。原生判别式 16 毫秒配置的变异系数约 27%,实时因子在 0.04 到 0.06 之间波动,每次仍快于实时,但涉及该配置的比较精度较低。文件基准只量化处理余量,不证明播放连续性或端到端延迟,浏览器缓冲自适应与输出欠载策略也未参与这些文件实验的对比。
结论在什么条件下才成立,还有哪些未验证
质量结论限于 EARS-WHAM v2 上的均值比较,预测器之间训练与校准不同,数值接近不等于听感等价,粗体只表示显示精度下最高而非统计显著。混合在部分语音维度接近 DPDFNet2,但总体与噪声维度仍落后,不能把个别维度接近说成整体相当。8 千赫兹比较的输入带宽不同,只能说明交付 8 千赫兹的两种做法,不能推出同输入下的排名。
开销结论限于给定机器、WSL2 环境、指定 ONNX Runtime 版本与固定绑定、重试和窗口策略。运算量计数有显式口径,包含软件开发工具包图内梅尔投影而不含 RNNoise 特征提取等外部处理,因此跨系统比值不是完整链路比。容量实验的 sherpa-onnx 是共享模型改编,RNNoise 是原生而非 WebAssembly 封装,版本与内部跳长也不同,差异不能归因于单一结构、版本或实现特性。
未验证的范围包括人类听感偏好、长期服务上限、每块截止期保证、不同设备与视频竞争负载下的稳定性,以及归一化链与回声消除作为增强方法的效果。论文的视频会议应用测试与回归测试提供实践背景与块一致性检查,但定量部分仍是单主机文件处理余量。
要复现第一步做什么,需要哪些信息条件
先按论文的平台矩阵确认模型与后端组合:8 千赫兹整数 8 位与两个 48 千赫兹浮点 32 位模型在 C/C++、网页、安卓与苹果系统上的 ONNX Runtime 或 TensorFlow Lite 支持不同,回声消除参考输入只在原生与网页接口暴露。论文称发布在 GitHub 仓库,但本次核对该地址不可用,因此应先核对论文给出的仓库状态与本地依赖锁文件中的 ONNX Runtime 版本,再准备模型文件与命令行工具。
复现质量时,用 EARS-WHAM v2 的 886 对文件,保持 16 毫秒块、关闭归一化与回声消除、输入已在模型采样率,并按 16、20 和 40 毫秒分别补偿 Spench、RNNoise 和 DPDFNet2 的输出延迟,宽带与窄带评价不要混用。复现容量时,保持 16 毫秒外部块、10 秒窗口、重复 20 秒输入、轮转绑定与休息间隔,用未舍入墙钟实时因子判断每路是否通过,并做 3 次完整搜索取最大通过路数。单流网页复现需新建浏览器实例、配置与流上下文,在工作线程中处理而不播放,并分别计时推理与完整调用。
关键参数包括 32 毫秒窗、16 毫秒跳、块为 16 毫秒整数倍、容量窗口 10 秒、重试最多 3 次。代码开源、权重可下载与系统可运行是三件事,需分别确认:论文描述了系统设计与发布模型,但训练与量化转换工具不在本次发布内,混合模型的训练细节也未给出,不能从模型名反推实现。
什么时候值得尝试,代价与下一步验证是什么
当应用需要在同一代码基础上同时支持服务器、手机与浏览器,且要在去噪之外灵活开关响度与动态处理或回声消除时,该通道式设计值得尝试。模型选择上,窄带低算力选 8 千赫兹整数 8 位,48 千赫兹下判别式更省容量,混合在能承受额外计算时改善预测语音质量,DPDFNet2 总体预测更强但实测容量最低,RNNoise 路数最多但总体预测与语音保留较弱。
代价有 3 类:大块换吞吐需要更长的输入收集时间,混合换质量需要更少的并发路数,网页换可移植性需要 1.79 到 3.27 倍的处理时间。所有测试配置在被测主机上仍快于实时,原生完整处理中位数为音频时长的 0.65% 到 9.89%,网页为 1.42% 到 24.38%,这是文件处理余量而非直播延迟保证。
下一步应补人类听音、长时间多流稳定性、弱设备上与视频编解码竞争时的表现,以及归一化与回声消除链路的独立评价。只有在这些条件下,才能把基准上的接近程度转为具体产品的选型结论。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses