📄 从查刀到看执法记录仪:多模态警务 AI 的证据支撑评估
英文题目:From Weapons to Events: Evaluating Evidential Support in Multimodal AI for Policing
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Armin Mustafa:Centre for Vision, Speech and Signal Processing, University of Surrey, Guildford, United Kingdom;AI Fellow, Incubator for AI (i.AI), Department for Digital, Culture, Media and Sport, London, United Kingdom
- Syed Sameed Husain:Centre for Vision, Speech and Signal Processing, University of Surrey, Guildford, United Kingdom
📌 核心摘要
执法中的图像与视频对应两类核验方式不同的任务。一类是根据缴获刀具照片在产品目录中找回同款,输出是带元数据的排序列表,答案客观可查,难点在于刀身细节差异小且拍摄条件多变。另一类是把执法记录仪录像转写为带时间区间的事件与话语记录,输出是对复杂互动的解释,容易出现无录像支撑或说话人归属错误的陈述。方法上先用融合局部与全局特征的KHNet提取刀具描述子送入检索排序,再用混合管线分别生成视觉因果事件描述与音频转写,最后统一映射为事件类型与时间区间并做后处理,与通用全模态模型直接生成事件形成差异。在KnifeHunter含约12.5万张干扰图的最难协议下,以平均精度均值衡量,KHNet为63.4%,高于同骨干GeMNet的57.9%。在27段公开英国执法录像组成的UKBWV-27试点集上,以交并比阈值0.3的事件F1衡量,混合管线为63.1,高于最强通用模型Gemini 3.1 Pro的60.6。在同一试点集上,以无支撑事件率衡量,混合管线为13.6%,低于通用模型最高的29.5%,以说话人准确率衡量,混合管线为72.3%,高于Gemini 3.1 Pro的69.2%,仍有27.7%话语归属错误。结论只适用于该试点集的公开、剪辑和噪声条件,不能视为实战可靠性,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
警察为什么既要查刀又要看录像
这篇论文同时做两件事,因为它们代表警务中两类不同的视觉任务。第一类是物体级任务:警员缴获一把刀,拍一张照片,要在产品目录中找到它是哪个型号,以便登记证物、追查来源和统计趋势。输入是一张待查照片加一个有明确编号的图库,输出是排序后的候选型号及其元数据,正确答案是目录身份,客观可核对。
第二类是事件级任务:执法记录仪拍下几分钟到十几分钟的警民交互,输入是帧序列加原生音频,输出是对发生了什么的文字描述,包括持刀对峙、上铐约束、车辆追逐、路边盘查等行为在何时发生、由什么角色对什么角色做出,以及说了什么话。这类输出没有唯一的正确答案,是对复杂交互的结构化解读。
背景的困难在于录像量远超人工复看能力。论文引用伦敦试验:814 名警员产生 48281 段共 12212 小时录像,检察官和二次调查员经常来不及看。现有进入工作流的 AI 工具只用音频转写或起草报告,没有评估真正看画面的模型。作者因此提出 3 个设计目标:可追溯,即每条主张能回到录像片段;失败可见,即按录像条件分别报告错误而不藏在平均数里。
可质证,即说话人归属等决定记录归属的环节必须可查。但论文明确说明,这 3 个是目标而非已验证的效果,它实际测量的是输出层面的性质,例如不支持比例、定位误差和按条件拆分的结果,而不是人能否真正发现和纠正错误。
已有路线各缺了哪一块
细粒度实例检索路线解决的是第一类问题。从局部描述子聚合到端到端全局描述子,再到可学习的广义均值池化、注意力与局部全局融合,评价一直用平均精度。这条路线任务、指标都成熟,但此前没有公开的刀具基准,缴获刀具常只有简短文字描述而无法系统检索。
密集视频描述和因果时序叙事路线解决的是第二类问题的一部分:在未剪辑视频中定位并描述多个事件,进而说明因果与顺序。NarrativeBridge 和 PAL 分别是论文选用的视觉与音频部件,前者在因果叙事基准上报告过优势,后者在音频分类与描述上报告过优势。但通用视频问答基准考的是答题,语言模型裁判存在系统偏差,问责文献呼吁审计和文档却未规定对警察录像应测什么。
特别是两项已部署的音频工具研究,一个只看采纳率和节省时间,一个随机试验发现起草报告并未减少完成时间,都没有检查每条事件是否在正确时间出现在录像中、话语是否归给正确说话人。本文的差异正在于把事件检测、时间定位、证据支撑、转写与说话人归属拆开测量,并用盲法人工标注验证裁判模型。
论文要回答的三个问题是什么
论文围绕 3 个研究问题展开。第一,如何为警务多模态 AI 评估可追溯、失败可见和可质证;第二,检索结构在 operational 条件下的刀具识别精度如何随查询难度和图库规模变化;第三,当前流水线在试点集上的事件级表现与典型失败模式是什么。对应贡献是 3 个可复用的产物:固定评估流程加 27 段公开英国执法记录仪视频的试点基准。
KnifeHunter 数据集、难度分级协议与 KHNet 检索网络;混合流水线与 3 个 2026 年全模态模型的完整流水线对比。
需要先理解任务边界。刀具部分已在英国警务中部署,但论文只记录使用事实,不测量实战命中率。视频部分是实验性的,从未被警方使用,只用于说明这类分析是否可能帮助复看。两类错误的利害关系不同:刀具错配会把错误的型号元数据带入情报产品;视频的流畅但无支撑或归属错误的陈述则可能进入事件报告、武力审查或披露材料,直接涉及被拍摄的警员与公众。
执法记录仪视频 × 事件 × 证据锚点: 执法记录仪视频是输入的帧与音频;事件是输出中带起止时间的一段可观察行为,是检测与定位的单位;证据锚点指每个事件和每句转写都保留时间区间,使复核人能从文字主张直接跳回录像对应片段,三者组合把自由文本变成可追溯的记录。
两条流水线如何分工
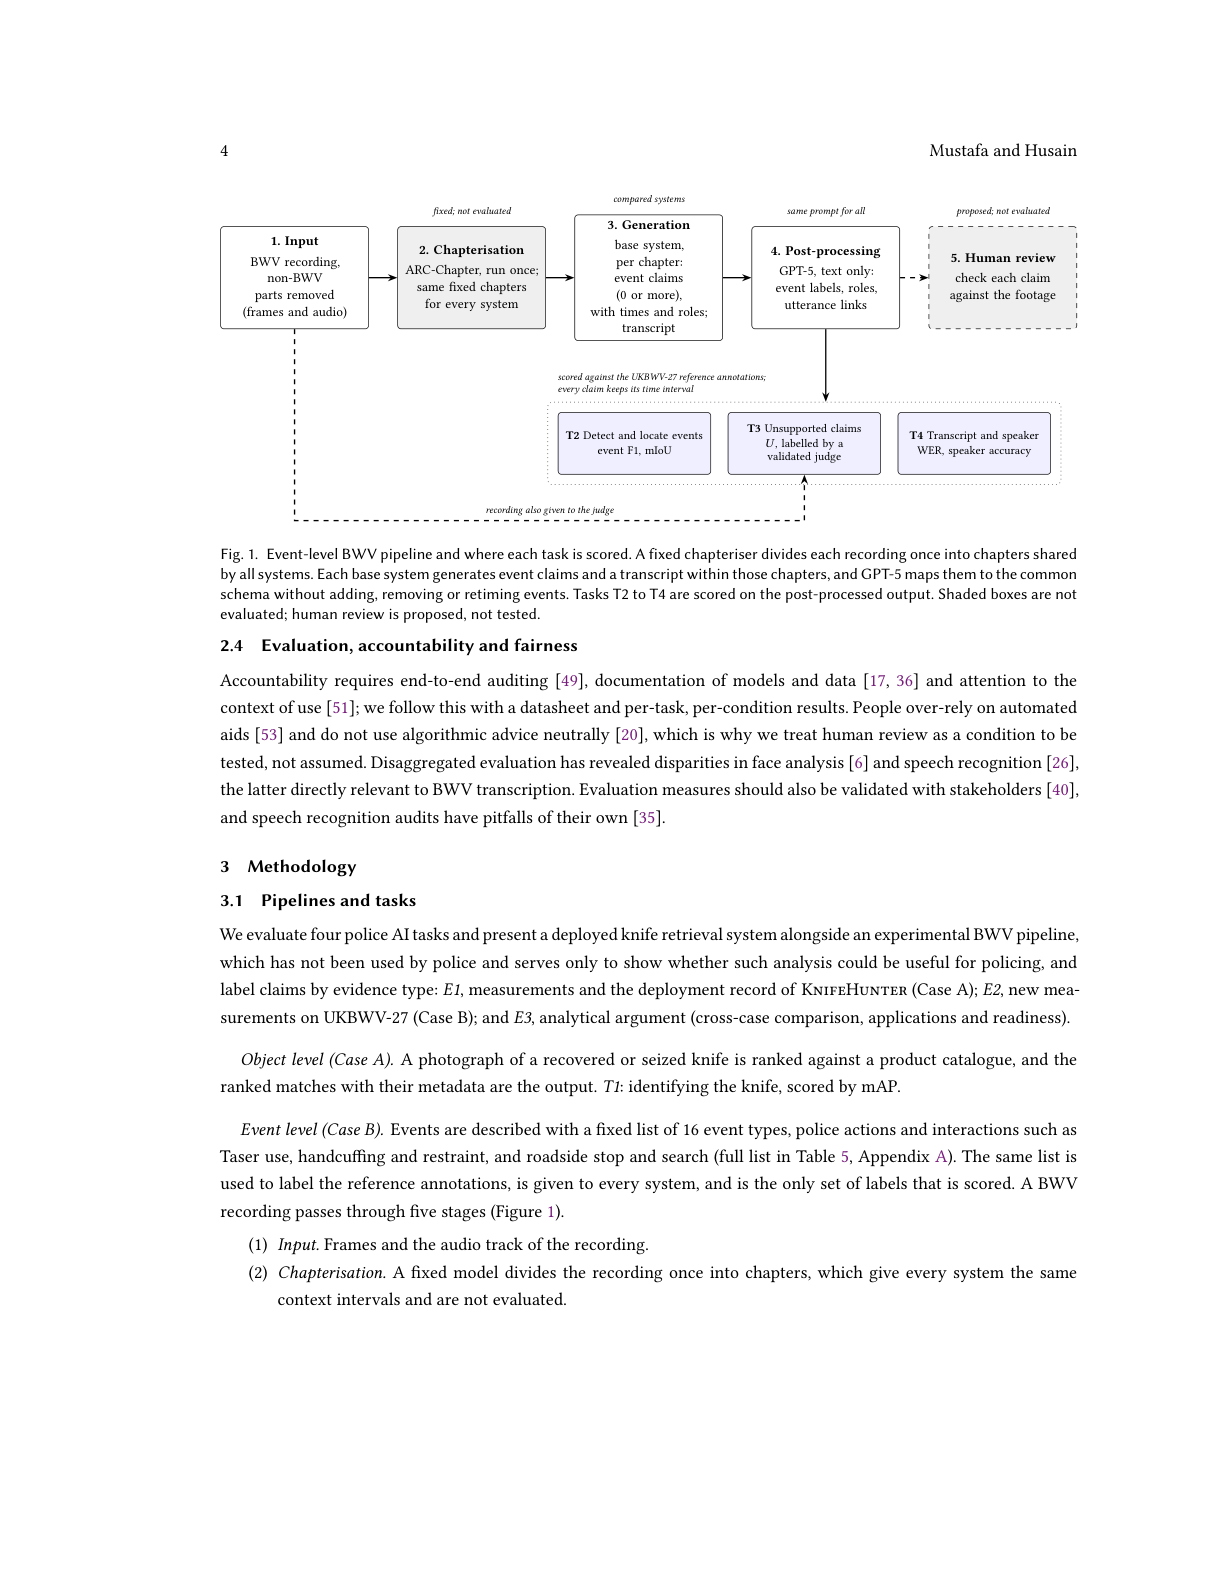
先看整体流程,它决定了后面所有比较的公平条件。物体级流水线很短:上传照片经骨干加聚合头得到 512 维全局描述子,与图库按余弦相似度排序,输出排序与元数据,分析员确认首选匹配。事件级流水线有 5 个阶段,其中只有中间两段参与比较。第一段输入去除非执法记录仪片段后的帧与音频;第二段固定章节化把录像切成共享上下文区间。
第三段各基座系统在每章内独立产生零个或多个事件主张与转写;第四段 GPT-5 只做文本后处理与类型映射;第五段人工复核只是提议而不评分。
下图是理解公平性的关键:所有系统共享同一章节,差异只能来自章节内的事件生成与转写,以及 GPT-5 对不同文本的规范化作用。章节本身不评分,事件才是评分单位。
看图路径: 1. 先从左到右看五个方框的主路径,区分固定、不比较与待验证环节;2. 注意 GPT-5 后处理框的限制说明:不新增、不删除、不改时间;3. 看下方三个评分框各自的指标,以及虚线表示录像同时送给裁判模型
图片来源: 原论文 PDF 第 4 页(含图 1)
论文图 1。原论文 Figure 1.:“Event-level BWV pipeline and where each task is scored.”。
从图中可见,主路径从左到右是输入、固定章节、被比较系统、统一后处理、待验证的人工检查。下方 3 个浅色框是实际评分任务:事件检出与定位、是否有证据支撑、转写与说话人。虚线表示录像同时送给裁判模型,使支撑判断独立于参考标注。后处理被严格限制:可以改事件标签与角色,但不能创建、删除、合并、拆分事件,也不能改时间戳。这意味着报告的数字比较的是完整流水线,而不是基座模型裸性能,且 GPT-5 可能缩小系统间差异。
KHNet 如何融合局部与全局特征
刀具识别的难点是类间差异细小:刃形、锯齿、手柄材质的差别决定型号乃至法律分类,而查询照片常有视角变化、遮挡、杂乱背景和极端光照。KHNet 的输入是 448×448 图像经骨干得到的特征张量,聚合头分两路处理。局部支路在邻域内做区域 Lp 池化再与输入平均,保留刀刃与手柄附近的细节;全局支路经 3×3 卷积、批量归一化、SiLU 与可学习 Weibull 激活后做全局平均池化与幂归一化,得到整体描述。关键一步是正交投影融合:把局部特征投影到全局描述子的正交补空间再拼接后平均池化,目的是去掉与全局重复的分量,保留互补细节,最后经线性层得到描述子。训练是 543 类分类加 sub-center ArcFace,25 轮,Adam 优化。
平均精度的定义是理解表 1 的前提。对每个查询,按排序计算前 i 个的准确率,只在第 i 个与查询同类时累加,除以该类相关总数得到该查询的平均精度,再对所有查询平均。分母是相关总数而非固定截断,因此它同时反映排序靠前与召回完整。
\[\mathrm{AP}(q)=\frac{1}{R_{q}}\sum_{i=1}^{|\mathcal{G}|}P_{q}(i)\,\mathrm{rel}_{q}(i),\qquad\mathrm{mAP}=\frac{1}{|Q|}\sum_{q\in Q}\mathrm{AP}(q).\]混合视频流水线各部件处理什么
事件级混合流水线的两个并行部件处理不同模态。NarrativeBridge 的因果效应网络只看帧,在每章内输出带时间戳的事件描述;PAL 加 Llama 3.2 3B 只听音频,输出转写。两者都在本地运行。它们的文本输出再经 GPT-5 映射到 16 个评分事件类型或不可映射,确定行为者与目标角色并关联话语,全程不改时间。
16 类包括持刃或钝器对峙、枪械事件、泰瑟使用、袭警、3 种逮捕情形、上铐与约束、车辆追逐与战术接触、徒步追逃、路边截停搜查、公共秩序混乱、现场问询、伤者急救、受害者被误认为嫌疑人、车内羁押交换等。第 9 类事后被质疑的武力只是视频级标签,不作为事件评分。
对照组是 3 个 2026 年全模态模型:Qwen3.5-Omni-Plus、Nemotron 3 Nano Omni 与 Gemini 3.1 Pro,都接受视频加原生音频。选择覆盖从可在本地运行的开放权重到托管 API 的不同部署方式。所有系统处理相同的 120 秒窗口与每秒 1 帧采样,视频理解在相同章节内进行。预标注用的 2 个模型与裁判模型都不在被评面板中,避免循环验证。
NarrativeBridge × PAL × GPT-5 后处理: NarrativeBridge 只看帧,负责在固定章节内产生带时间的因果事件描述;PAL 只听音频,负责产生带说话人角色的转写;GPT-5 后处理不看原视频,只收两路文本,把事件映射到 16 类固定类型并统一角色与话语链接,三路分工后汇合成一条带时间戳的记录。
固定章节化 × 事件区间: 固定章节化由 ARC-Chapter 对每段录像运行一次,给所有系统相同的上下文区间且不参与比较;事件区间是各系统在章节内独立生成的起止时间,必须落在所属章节内,章节相同不等于事件定位相同,时间交并比衡量的是后者的重合程度。
哪些模型被训练,视频部分为何没有训练
本节先说清训练与非训练的分界,避免误读。刀具部分是有训练的:4 个骨干加 5 种聚合头都在 KnifeHunter 上端到端训练,图像统一尺寸,ArcFace 边距 0.3,学习率与批量等超参数原文已披露。消融按累加方式报告:从全局平均池化到广义均值池化,再加 Weibull 池化,再加局部支路正交融合,最后加区域 Lp 细化得到完整 KHNet,每一步在难例加干扰条件下都有增益,其中正交融合一步增益最大。
视频部分没有任何在执法记录仪上的训练或微调。27 段视频全部用于基准测试,没有训练划分。ARC-Chapter 章节器在网络视频上预训练后冻结,NarrativeBridge 与 PAL 按原文所述设置直接推理,全模态模型用默认解码设置各运行 1 次,不做无后处理、无 NarrativeBridge 或替换章节的消融。因此视频数字反映的是现成模型加统一后处理在试点集上的开箱表现,运行 1 次意味着波动未被测量。转写初始化用的 Whisper 只用于参考标注的初稿,同样经人工校对,且标注者未记录感知种族性别年龄,组间差异未被测量。
在什么数据和指标下比较
KnifeHunter 数据库有 25250 张 543 类刀具,332 类来自证据室手机与单反多视角拍摄,171 类来自零售商产品图加增强,40 类来自边境查获,每类有刀型、厂商、是否可能构成英国法下攻击性武器等 10 个元数据字段。评估分中等 443 个查询与困难 150 个查询,后者多来自真实案件,常有大角度、重遮挡、极端光照或倒置。再加约 125,000 张干扰图,其中刀具干扰来自未入数据集的 9 个警队供图,另一部分是无标注的日常物体图。加干扰的协议记为+D。
UKBWV-27 是 118 分钟 27 段公开视频的压力测试集,不是代表性抽样。中位时长 2 分 26 秒,3 段由警队发布、24 段由新闻机构发布,22 段为纯净执法记录仪,3 段带台标字幕,2 段混有其他来源。评测前已移除演播室、监控、直升机画面与台标覆盖段,只保留干净执法记录仪片段,但发布时的剪辑与压缩痕迹仍在。参考标注是机器预提加 2 人人工校对,共 53 个事件加逐句说话人角色与时间戳,事件至少持续 1 秒,可重叠嵌套。
事件 F1 在时间交并比阈值 0.3 下经一对一匹配计算,阈值宽松意味着它更偏向检出与分类而非精确定位,因此必须与定位指标一起读。
\[\mathrm{F1}_{E}=\frac{2P_{E}R_{E}}{P_{E}+R_{E}},\qquad\theta=0.3.\]不支持事件比例是预测事件中被裁判模型判为无支撑的占比,分母是全部预测事件,少报会降低分子但也会拉低 F1,故不能单独优化。
\[U=\frac{|\{e\in\hat{\mathcal{E}}:s(e)=\textsc{uns}\}|}{|\hat{\mathcal{E}}|}.\]事件 F1 × 平均时间交并比 × 不支持事件比例: 事件 F1 在时间交并比不小于 0.3 且类型一致、匈牙利一对一匹配下衡量检出加分类;平均时间交并比只在已匹配对上衡量定位有多准;不支持事件比例由观看录像的裁判模型判断每条预测事件是否在画面或声音中成立,三者分开是因为检出好不代表定位准,更不代表内容有证据。
词错误率 × 说话人准确率: 词错误率比较转写文本与人工校对文本的字词差异,越低越好;说话人准确率比较每句参考话语的角色是否归给警员、公众成员或其他,靠时间重叠最大者对齐,无重叠计错,两者分别衡量听清了什么和算到谁头上,后者直接关系记录能否被质证。
刀具检索精度随难度和图库如何变化
先看骨干固定的聚合头比较。问题是:在相同 EVA02-Base 下,不同聚合方式在中难与加干扰条件下差多少,指标越高越好。表前条件一致:同一训练、同一余弦排序、同一平均精度定义。
| Aggregation | Medium | Hard | Medium+D | Hard+D |
|---|---|---|---|---|
| GeMNet (Radenović et al., 2019) | 83.1 | 61.2 | 81.5 | 57.9 |
| KHNet (ours) | 86.5 | 65.3 | 85.7 | 63.4 |
表中 KHNet 在四列均为最高,加干扰的中等协议 85.7%,困难协议 63.4%。主要收益是困难条件下的鲁棒性:同骨干下比 GeMNet 在困难上高 4.1 个百分点,加干扰困难上高 5.5 个百分点,比次优 SENet 高 1.9 个百分点。但代价与限制同样清楚:查询难度主导一切,KHNet 从中等到困难掉 21.2 个百分点;干扰在证据弱时影响更大,中等只掉 0.8 个百分点,困难掉 1.9 个百分点。未胜出项是 GeMNet 等基线在中等协议上差距较小,说明简单查询下复杂融合的收益有限。
类别激活显示注意力多在刀刃或手柄,但失败时会落在斧头、指虎等其他金属物上。论文强调困难查询多来自调查,正是错误代价最高的场景,而部署记录只证明被使用,不证明实战首选命中率,开放集查询与分数校准也未评估。
下表回答骨干本身的影响。问题是:固定 GeMNet 时,换骨干能带来多少,参数量代价如何。
| Backbone | Medium | Hard | Medium+D | Hard+D |
|---|---|---|---|---|
| EfficientNet-B7 (Tan and Le, 2019) | 79.4 | 56.1 | 73.6 | 45.5 |
| EVA02-Base (Fang et al., 2024) | 83.1 | 61.2 | 81.5 | 57.9 |
表中 EVA02-Base 在四列全面领先,困难加干扰达 57.9%,比 EfficientNet-B7 的 45.5% 高 12.4 个百分点,参数量 88M 对 70M。这说明骨干选择在最难条件下的影响甚至大于聚合头改进。但所有骨干都呈现同一趋势:难度与干扰叠加时精度大幅下滑,因此不能用中等协议的数字代表案件查询的表现。
视频流水线在试点集上的总体表现
视频比较的问题是:在 27 段公开视频上,完整流水线的转写、说话人、事件检出、定位与证据支撑各差多少,延迟代价如何。所有行都经过相同 GPT-5 后处理,视觉加音频为 C2,纯视觉 NarrativeBridge 为 C1。词错误率与不支持比例越低越好,其余越高越好,延迟因包含本地与托管的不同网络排队而不可直接比较。
| Model | Speaker %↑ | F1↑ | mIoU↑ | Unsup. %↓ |
|---|---|---|---|---|
| Hybrid pipeline (ours) | 72.3 | 63.1 | 0.44 | 13.6 |
| Gemini 3.1 Pro | 69.2 | 60.6 | 0.35 | 14.2 |
| Qwen3.5-Omni-Plus | 63.8 | 52.0 | 0.41 | 21.7 |
表中混合流水线在六项中五项最优:词错误率 5.7% 对 Gemini 的 7.9%,说话人准确率 72.3% 对 69.2%,事件 F163.1 对 60.6%,定位 0.44 对 Qwen 的 0.41,不支持比例 13.6% 对无音频分支的 13.9%。但限制是结论成立的前提:这是 27 段高曝光、严重与剪辑发布偏多的试点集上的描述性比较,未做显著性检验与置信区间,也未按事件类型拆分。未胜出项很明确:Qwen 延迟最低每分钟 24.1 秒,但延迟口径不同;去掉 PAL 音频分支后 F1 掉到 56.5 低于 Gemini,说明音频对事件与说话人至关重要,但该对比同时改变了映射输入,不能理解为纯音频消融。更重要的是绝对水平:最优仍有 13.6% 事件无支撑、27.7% 话语归属错误,通用模型无支撑最高达 29.5%,没有任何流水线可靠到可替代复看。
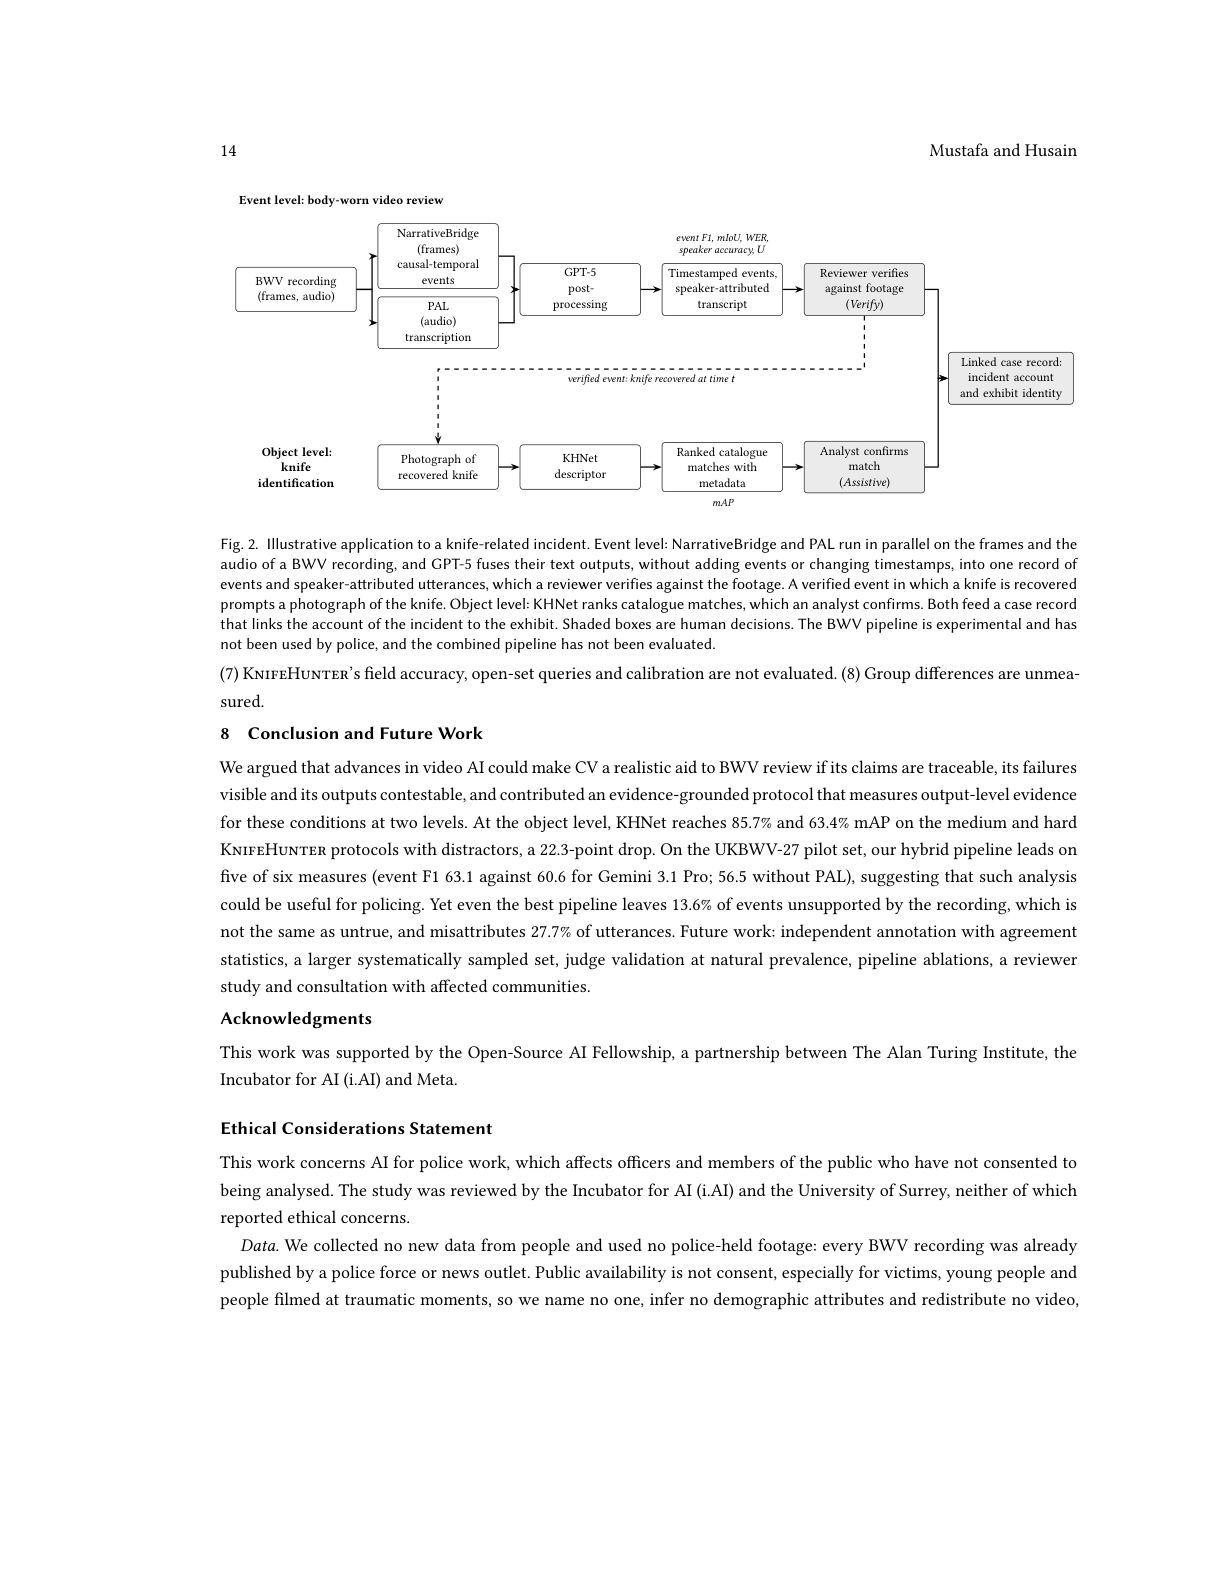
下图是论文设想的应用,但必须按图注理解:上 lane 事件级输出经复核人验证,下 lane 物体级输出经分析员确认,两者才汇入关联案卷。深色框是人的决定,组合流水线本身未经评估。
看图路径: 1. 看上 lane 两路并行再汇合的结构,以及下 lane 从照片到排序的路径;2. 注意深色方框代表人的决定,虚线代表已验证事件触发拍照;3. 确认图注强调组合流水线未经评估,避免当作已验证系统
图片来源: 原论文 PDF 第 14 页(含图 2)
论文图 2。原论文 Figure 2.:“Illustrative application to a knife-related incident.”。
图中确实可见两 lane 结构:上 lane 从录像分出帧路与音频路,经 GPT-5 融合成带时间戳事件与转写,再到验证环节;下 lane 从缴获刀照片到描述子再到排序候选与确认;虚线表示已验证的缴获事件触发拍照。它帮助理解为何论文把刀具定为辅助级、视频定为逐条验证级:前者是排序加确认,后者是每条使用前都要回看录像,验证工作量并未被消除。
两种任务为何不能用同一标准谈问责
跨案例比较要回答:为何刀具可用平均精度谈问责,而视频需要另设支撑与按条件拆分。下表是论文的分析性总结,不是实测胜负,阅读时应把每行当作证据类型说明。
| Property | Case A: knife retrieval | Case B: BWV understanding |
|---|---|---|
| Ground truth | Catalogue identity; objective and verifiable | Structured interpretation of an interaction; partly contestable |
| Field validation | Deployed by UK forces; field accuracy not measured | None; experimental, not used by police; pilot benchmark on public footage only |
| Human role | Analyst confirms top match | Reviewer must verify each event used |
表中分歧集中在真值、输出形式与人的角色。刀具真值是目录身份,输出是排序,指标成熟,部署已发生但实战精度未测,人的角色是确认首选,风险是遮挡下的似是而非错配。视频真值是对交互的结构化解读,部分可争议,输出是带区间的自由文本,指标是本文定义的任务指标加经验证的裁判,实战为零,人的角色是验证每条使用的事件,风险是流畅但无支撑或归属错误的陈述。受影响方也不同:前者主要是关于物体的情报产品,后者是画面中的警员与公众。
这 1 对照解释了论文的就绪度提议:刀具为辅助级,人在使用前确认;视频为验证级,每条进入记录的输出都要回看来源。论文同时提醒,支撑是相对于录像而言,有支撑不等于符合事实全貌,因为录像本身是警员视角、部分剪辑且常有噪声。
去掉音频、换发布条件会发生什么
论文没有做后处理与章节的消融,但提供了两类等价于失败条件的拆分。第一是输入条件:混合流水线去掉 PAL 后,不支持比例几乎不变,但事件 F1 与定位明显下滑,说明音频主要帮助发现与定位事件,而非直接减少无支撑。第二是发布与内容条件:所有流水线在带台标覆盖、长视频与喊叫噪声主导的录像上同步下滑。例如混合流水线在纯净发布上事件 F1 为 64.7,在带覆盖发布上为 55.4,长视频比短视频低约 15 个百分点,喊叫噪声下仅 49.7。通用模型下滑幅度更大,Qwen 在长视频上比短视频低约 17 个百分点。这支持了论文的事前假设方向,但 27 段样本无法在总体上证实。
裁判模型的验证是理解不支持比例可信度的关键。100 条分层抽样中人工判定 75 条有支撑、25 条无支撑,裁判与 adjudicated 标签一致 96 条,Kappa 为 0.90。有支撑类的精确率 98.6% 召回 96.0%,无支撑类召回 96.0% 精确率 88.9%,宏 F1 为 0.95。假阳性率为 4.0%,即 25 条无支撑中 1 条被放行,Wilson 区间上探可达约五分之一。这意味着表中的不支持比例建立在已验证但不完美的工具上,其误差在不同事件类型与条件下未被评估,且样本按模型与条件分层而非自然流行率,不能直接当作实战无支撑率。
结论在哪些边界外不再成立
试点性质是首要边界。27 段公开视频偏向严重与剪辑发布,日常截停等常规交互代表不足,托管模型可能在预训练中见过这些公开报道,数字可能不反映对陌生录像的感知。参考标注是机器预提加人工校对,未做独立双标与一致性统计,预提遗漏的事件可能从未进入参考,转写词错误率可能偏向类似 Whisper 的输出。
测量工具本身有缺口。裁判验证只用 100 条分层样本,未按自然流行率、事件类型与录像条件评估;流水线各运行 1 次,波动未知;章节边界可能限制可达的时间交并比,且对所有系统相同。污染、说话人未知段的排除、重叠语音的对齐规则都会影响绝对值。
更大的缺口在人与制度。没有复核人实验,无法证明带时间锚点真能减少过度依赖;没有受影响群体与辩护方视角,任务选择偏向警方复看需求;未记录人口属性则无法评估差异影响,没有发现差异不等于没有差异;成本与能耗、开放集刀具查询、分数校准、撤稿后重算等维护机制也未进入本次测量。因此论文的数字只支持在该试点与该流程下的描述性排序,不支持推广到 operational 可靠性。
要复现与核查应从哪里动手
复现第一步是固定流程而非调模型。先按附录实现固定章节化:每秒 1 帧、上限 128 帧、超 120 秒按 120 秒窗 30 秒重叠切分,用全局时间戳合并,转写重叠按时间去重;章节标识与时间原样供给所有系统,事件区间必须落在所属章节内。然后用相同提示让全模态基座在每章内输出零个或多个事件与转写,再用同一 GPT-5 提示做类型映射与角色规范,不增删事件与时间,最后用阈值 0.3 的一对一匹配算事件 F1 与定位,用裁判模型加录像判支撑,用归一化后转写算词错误率与说话人准确率。
关键超参数与信息条件要保留:刀具图 448×448、25 轮、ArcFace 边距 0.3 与学习率 schedule、Weibull 与区域池化初值;视频的帧率、窗口、光束宽度 5、API 版本与区域、章节与后处理版本。核查时重点看三处:后处理是否真未改时间,裁判提示是否把部分支撑与不确定判为无支撑,参考中第 9 类是否被排除在事件匹配之外。来源方面,没有发现可验证的公开代码模型数据绑定,不得声称已开源;复现应只用公开视频链接与自带标注,不应重新分发视频文件,被撤稿的录像按版本移除并重算。
什么时候值得尝试,还缺什么验证
值得尝试的场景是分流而非定案。刀具侧适合作为线索:拍照后看排序与元数据,由分析员对照实物确认,尤其在困难查询下应按条件报告精度而不引用中等协议的数字。视频侧适合作为跳转与初稿:用时间戳事件快速定位搜查逮捕或武力片段,用转写起草案卷初稿,但每条进入记录的内容都要回看录像,相关输出不应直接支撑逮捕、武力审查、纪律认定或证据结论。所有系统每分钟处理时间都短于观看时间,但验证时间未被测量,省下的观看可能转为核查负担。
还缺的验证按优先级是:更大且系统抽样的 operational 录像集、独立双标加一致性统计、裁判在自然流行率与分条件下的误差、流水线多次运行的波动与分阶段归因、复核人能否真发现无支撑与归属错误的实验、受影响群体参与的任务验证,以及按条件与群体的错误率披露与救济机制。只有补上这些,才能判断辅助分流是否在具体警队流程中利大于弊。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses