📄 还没说完就先认出来:Earlybird 如何提前预测单词
英文题目:Earlybird: Predictive Streaming Speech Recognition in 29M Parameters
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Sahil Mahendrakar:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式语音识别的输入是按80 ms逐段到达的语音,输出是随时间更新的屏幕文字,难点在于常用系统要等到词尾之后数百毫秒才敢确认,而语音助手希望在说话人还在说时就拿到可用的词并知道是否可信。Earlybird先把每条语音在随机80 ms切点截断得到训练音频,把该时刻到期词的完整拼写加结束符和后两词猜测作为目标送入解码器学习,再让Moonshine Tiny教师只在最高概率词块与标签一致的位置输出蒸馏损失来约束该学习,最后让编码器多看由静默算出的三个填充帧以补足收尾信息,切点目标只向后扩展以避免学会收回。置信度直接用产生该词的词块概率连乘得到,未做温度缩放。相对已有做法,该方法不改变架构且不使用未来音频,把预测放进小识别器内部,并同时报告提前量、稳定性和校准情况。在LibriSpeech test-clean的67条子集上,中位词在说话人结束前90 ms即被正确预测,而Moonshine Tiny官方流式运行为结束后270 ms,Whistle为结束后400 ms。在8个英文Open ASR集合的约200条每集评测中,4位Earlybird平均词错率为12.6%,与同尺寸Whistle的12.2%大致相当并在五集上更优。结论适用于英文朗读、演讲和合成语音等已测范围,背景人声和域外命令语音下会失效。训练在单GPU上以批量48分四阶段完成约4万步,单CPU线程每80 ms步平均耗时39 ms,约为两倍实时。
🔗 开源与复现资源
- 模型相关资源:https://huggingface.co/sahilmahendrakar/Earlybird-29M — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
语音助手为什么等不起单词结束
这篇论文面对的是语音助手的流式语音识别。输入是一段不断变长的音频,目标是边听边把说过的话变成文字,输出要能一块一块更新。必须保留的信息是词序和拼写不能错,输出则是屏幕上此刻的文本。
通常的流式系统要等一个词的声学结束后再等 100 毫秒到 200 毫秒才敢显示,因为要听全尾音才确认。论文摘要给出 released 流式模型一般在词结束后 90 到 400 毫秒才给出。对助手来说,这段时间本可以用来检索或规划回复。
人听话不需要等尾音,结合前几个音素和上下文就能猜到词,也能预判下一个词。论文想让一个 29M 参数、可装进 16.8 MB 的小编码器-解码器模型也做到这一点:从词的前半段预测完整拼写,顺带猜后两个词,并给出每个词的可信程度。
已有提前和加速路线在做什么
论文把相关工作分成 3 类。第一类是词没说完就预测。Zink 等人让离线编码器-解码器预测 utterance 末尾被遮住音频中的词,能提前约 300 毫秒;Yusuf 等人用语言模型跑在流式识别器前面做推测识别;Baumann 等人预测当前词还剩多长。Earlybird 的不同在于预测放在小流式识别器内部,训练用随机截断点而不只用句尾,并同时报告校准和稳定性。
第二类是利用早期部分结果。Chang 等人用部分假设预取下游回复,终稿一致时省约 200 毫秒;Schwarz 等人从部分 utterance 预测完整 utterance 降助手延迟。这两类都依赖部分文本又早又稳,这正是 Earlybird 想改善的。
第 3 类是降低流式延迟。FastEmit 让 transducer 更早发射词元,LocalAgreement 让离线模型靠连续两次通过一致的部分来做流式提交。这些是把延迟压向词尾,而 Earlybird 想在词结束之前就正确给出。
要解决的具体延迟是什么
论文定义的延迟不是计算耗时,而是决策时刻。评测时音频按 80 毫秒一块顺序喂入,记录屏幕文字每次变化相对音频时钟的时刻,硬件处理时间不计入。所以比较的是模型决定输出什么,而不是哪台机器跑得快。
对每个参考词,记录它从何时起被正确预测:词在输出中、拼写正确、位置正确,且直到句末不再改动。该时刻相对该词声学结束时间的差就是单词延迟,负值表示在说话人说完之前已经正确显示。
举例说明:若一个词在音频第 2.000 秒结束,模型在第 1.910 秒就正确显示且之后不改,延迟就是负 90 毫秒。论文在 LibriSpeech 干净有声书上报告中位词提前 90 毫秒,而对比的流式模型在结束后 90 到 400 毫秒才对。这就是要解决的差距。
Earlybird 的整体训练与解码流程
起点是已发布的 Moonshine streaming Tiny,34M 参数,按 80 毫秒音频块消费音频。作者把词表裁到 19007 个词元,只保留训练 transcript 大规模英文文本中出现过的词元加上所有单字符词元,任何词仍能逐字母拼出。参数降到 29M,裁后模型在各测试集与原模型差距在 0.4 个词错误率点以内。
训练时每条 utterance 在随机 80 毫秒步长处切断,只给切点之前的音频,要求输出此刻到期的所有词的完整拼写,再加结束符和后两个词的猜测。解码时每个步骤解出完整 transcript,不做官方运行时的约 300 毫秒滞留。若在结束符处停就是 transcript,继续往后解才得到猜测。
每个显示词的置信度是产生它的那次解码中其词元概率的乘积,猜测词同样计算,不做温度缩放等校准步骤。4 比特量化后权重文件 16.8 MB,加上裁剪后分词器和配置为 17.6 MB。
什么词算到期:只听前半段也要写全词
到期是这套方法的核心约定。一个词即使只听到开头,一旦过了到期时刻,训练目标就要求写出它的完整拼写,而不是写出半个词或等听完再写。标点要等到下一个词到期才出现,避免逗号出现又消失。
到期时刻由词的起止时间和两个常数决定:提前量 300 毫秒和最少已听 50 毫秒。普通长度词按结束前 300 毫秒到期,短词则至少听到一点才到期。切点之后的切点目标永远是之前目标的延长,模型因此不会被训练去写出以后要删掉的内容。
流式识别 × 截断音频 × 到期单词: 流式识别指音频按 80 毫秒一块顺序到来、每来一块就更新屏幕文字的方式;截断音频指训练时把一整句话在随机时刻切断,只给模型切点之前的声音;到期单词指按公式算出此刻应该写出的单词,即使它的尾音还没听到。截断模拟了流式运行时每一步的位置,到期规则告诉模型哪怕只听到前半个词也要写完整,三者组合才让预测发生在流式过程中而不是事后补猜。
\[\tau_{i}=\max\bigl(s_{i}+\min(0.5\,(e_{i}-s_{i}),\,h),\;e_{i}-\ell\bigr),\]这个公式计算第 i 个词的到期时间。其中 s_i 和 e_i 是强制对齐给出的词起止,l 是 300 毫秒提前量,h 是 50 毫秒最少已听。括号里先取词长一半和 h 的较小值,加上起点得到至少听到一点的时刻,再与词尾减 l 取较大值,保证普通词提前 300 毫秒、短词不会早到没听到声音。
结束符后的猜测与词元概率乘积
目标序列的结构是到期词拼写、文本结束符、后两个词。结束符把必须显示的 transcript 和仅供参考的猜测隔开。应用若只想要稳定 transcript,解码到结束符就停;若想往前看,才继续解出猜测。
置信度直接用原始词元概率乘积。一个词可能被切成多个词元,解码器对每个词元给出概率,乘起来就是词置信度。比如一个词由 3 个词元组成,概率分别为 0.9、0.95、0.9,置信度就是三者相乘。这种做法没有额外拟合,因此论文后面能检验原始概率是否本身就校准。
论文指出猜测很少:在置信度不低于 0.5 时,约七分之一的词即 12% 到 16% 是在结束前猜对的,大多数提前词来自 transcript 本身。这说明猜测是添头,提前主要靠把当前词写全。
文本结束符 × 猜测词 × 置信度: 文本结束符是 transcript 之后的一个停止标记,猜测词是放在该标记之后的下两个词,置信度是组成一个词的解码器词元概率连乘。解码到结束符就停只得到已到期 transcript,继续往后解码才得到猜测,置信度则给调用方判断该信 transcript 中的提前词还是该信猜测词,三者分工把能直接显示的内容和仅供参考的猜测分开。
用什么数据分几阶段训练
训练用 LibriSpeech 960 小时加已发表的 Montreal 强制对齐词时间,约 300 小时 People’s Speech 干净子集用 wav2vec 2.0 CTC 对齐给词时间,约 25 小时合成 Kokoro 语音用音素时长给精确词时间。采样权重为 1:3:3:3:1,对应 LibriSpeech clean-100、clean-360、other-500、People’s Speech、Kokoro;第一阶段只用 4 个真实集按 1:3:3:3。真实 transcript 只保留教师 Moonshine Medium 转写与参考词完全一致的句子,不用非商业语料。
训练分 4 段在单卡上 batch 48,都带蒸馏项:词表裁剪后流式截断训练 10k 步,学习率 5×10⁻⁵;带两个猜测词的前缀训练 20k 步;加填充帧 5k 步,学习率 2×10⁻⁵;4 比特量化感知训练 5k 步,前端保持 8 比特。蒸馏只在教师首选与标签一致的词元位置施加,因为在教师错误或不确定处其概率分散在多个词上,全位置模仿会让猜测词变得不果断。
填充帧指编码器在已听音频后还看到 3 帧由静音算出的特征,不用未来音频,让模型像说话人可能停了那样把词收尾。消融显示加填充帧把 LibriSpeech test-clean 中位词从负 50 毫秒推到负 90 毫秒。
蒸馏损失 × 教师模型 × 词表裁剪: 教师模型指原来的 Moonshine Tiny,用来提供蒸馏损失即让学生模仿教师词元分布的额外监督;词表裁剪指只保留训练文本中出现过的词元加全部单字符,参数从 34M 降到 29M。蒸馏只在教师首选与标签一致的位置施加,避免在教师也不确定的位置把概率抹平,词表裁剪则在几乎不损失准确率的前提下减小体积,两者组合兼顾学得像和放得下。
在什么语音上按什么规则计时和比对
测试分 6 组计时集:LibriSpeech test-clean 和 test-other、TED-LIUM 3、留出的 People’s Speech 集、Earnings-22,以及 500 句留出 WikiText 用训练未见的两个声音合成的 Kokoro 语音。词尾来自 Montreal 对齐、Kokoro 时长或自建 wav2vec 2.0 对齐器,后者词尾与 Kokoro 中位差 4 到 8 毫秒,与 Montreal 差 26 毫秒。
基线都用各自官方代码跑:Moonshine Tiny 官方流式运行时量化版;Whistle 55M 参数 16.9 MB 在 Cactus 引擎 live 模式;Whisper base.en 74M 每 0.48 秒对至今全部音频重解码并显示原始输出。准确率还跑 Whisper tiny.en 39M 和 small.en 244M。同一集合内所有模型跑相同 utterance。
除注明外 Earlybird 结果为全精度,4 比特发布版在标准准确率表和消融表单独列出。标准准确率 8 个英文集用 Open ASR Leaderboard 代码和归一器打分,Whisper base 在该处得分与已发表条目一致,说明打分链条是对的。
提前多少:六个集合的中位词延迟
要回答早不早,看同一 utterance 上中位词延迟和最终词错误率。指标方向是延迟越负越早,词错误率越低越好,修改次数越低越稳。表前比较的问题是:在相同音频、相同计时规则下,Earlybird 是否比已发布流式模型更早且最终文本不更差。
| Test set | Earlybird | Moonshine Tiny | Whistle | Whisper base |
|---|---|---|---|---|
| LibriSpeech clean (67) | −𝟗𝟎 / 2.3 | +270 / 3.9 | +400 / 3.1 | +90 / 2.3 |
| LibriSpeech other (150) | −𝟔𝟎 / 9.7 | +300 / 13.2 | +460 / 10.1 | +140 / 8.7 |
| TED-LIUM (150) | −𝟔𝟖 / 5.4 | +298 / 6.8 | +505 / 7.3 | +125 / 4.8 |
| People’s Speech (150) | −𝟔𝟔 / 14.5 | +290 / 16.7 | +477 / 14.2 | +127 / 10.5 |
| Earnings-22 (150) | −𝟒𝟔 / 18.4 | +309 / 21.6 | +535 / 17.8 | +142 / 13.3 |
| Synthetic (67) | −𝟕𝟑 / 5.6 | +292 / 7.0 | +424 / 7.5 | +90 / 4.8 |
| Revisions per word (LS clean) | 1.29 | 2.07 | 0.16 | 0.39 |
表中 Earlybird 在 6 组上中位延迟为负 73 到负 46 毫秒之间,最好的干净集到负 90 毫秒,而 Moonshine Tiny 运行时在正 270 到正 309 毫秒,Whistle 在正 400 到正 535 毫秒,Whisper base 在正 90 到正 142 毫秒。换算下来比 Moonshine 快约 360 毫秒,比 Whistle 快 490 到 580 毫秒,比 Whisper base 快 160 到 200 毫秒。最终词错误率上 Earlybird 在每组都低于 Moonshine Tiny,Whistle 只在两组领先至多 0.6 个点,Whisper base 除干净集打平外在其余组最准。
代价在最后一行:在 LibriSpeech 干净集 Earlybird 平均每个说出的词收回 1.29 个词,少于 Moonshine 运行时的 2.07,但多于 Whistle 的 0.16 和 Whisper base 的 0.39,在自发或 noisy 语音上到 2 到 6 个。子集虽小,全量集结论保持:LibriSpeech 干净全部 2620 句中位负 90 毫秒,TED-LIUM 全部 1155 句负 67 毫秒,500 句 People’s Speech 负 63 毫秒,1000 句 Earnings-22 负 43 毫秒。p95 延迟 Earlybird 为正 80 毫秒,对 Moonshine 正 520 毫秒、Whistle 正 925 毫秒。
单词延迟 × 修改次数 × 词错误率: 单词延迟指从单词声学结束时刻到它被正确且不再改动地显示出来的时间差,负值表示提前;修改次数指平均每个说出的词被拿回去几个词;词错误率指最终文本与参考相比的出错比例。延迟衡量早不早,修改衡量稳不稳,词错误率衡量最终对不对,三者必须一起看才能判断提前显示是否可用。
读图说明:下图横轴是同一 67 句干净有声书上的中位词延迟,负值在左表示提前;纵轴是 8 个标准集平均词错误率,越低越好,左下最好。注意 Earlybird 处在左侧浅色提前区,Whistle 处在最右侧,Parakeet 虽低但 utterance 与横轴其他模型不同。
看图路径: 1. 先看横轴单词延迟,负值在左,正值在右,找到 Earlybird 与 Whistle 的左右位置;2. 再看纵轴 8 个集合平均词错误率,比较 Earlybird、Whisper tiny 和 Parakeet 的上下位置;3. 注意浅色提前区域里只有哪些点,再看右下大模型是否靠提前取胜;4. 对照图注中 Parakeet 与其他模型 utterance 数量不同的说明
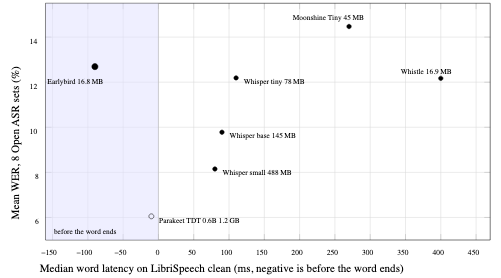
论文图 1。原论文 Figure 1::“Word latency against accuracy; lower left is better.”。
该图确实可见 Earlybird 16.8 MB 的点孤立在左侧提前区,纵轴约 12% 到 13%;Moonshine Tiny 45 MB 在横轴约 270 毫秒、纵轴约 14% 以上;Whistle 16.9 MB 在横轴约 400 毫秒;Whisper tiny 78 MB、base 145 MB、small 488 MB 自左向右延迟略降但都在正 100 毫秒附近;Parakeet 0.6B 1.2 GB 纵轴最低但横轴接近零。说明同体积下只有 Earlybird 进入提前区,更大模型主要降错误率而不买提前。
提前的词有多少:结束前猜对的比例
中位延迟只说中间那个词,表 2 回答有多少词真正有用地提前。统计的是在结束前正确预测且之后不改的参考词比例,只计置信度不低于 0.5 的 transcript 词和猜测词。分母是参考词,方向越高越好。比较条件是 4 个模型都有输出的 utterance,数量在 50、38、100、50 句。
| Test set | Earlybird | Moonshine Tiny | Whistle | Whisper base |
|---|---|---|---|---|
| LibriSpeech clean | 68.8 | 3.4 | 9.1 | 25.4 |
| TED-LIUM | 52.1 | 1.0 | 2.6 | 17.6 |
| People’s Speech | 31.8 | 1.0 | 2.9 | 11.3 |
| Synthetic | 56.9 | 2.2 | 6.8 | 22.0 |
Earlybird 在干净集 68.8% 词提前正确,TED-LIUM 52.1%,合成语音 56.9%,People’s Speech 31.8%。Moonshine Tiny 和 Whistle 因设计上等词结束,只有 1.0% 到 9.1%,Whisper base 因每次重跑多听到一点音频,能到 11.3% 到 25.4%。论文摘要称同有声书上 69% 词提前正确对 3% 到 25%,与此一致。
限制是 People’s Speech 这类自发语音提前比例明显掉到 30%,且这是置信度过滤后的数字。若把阈值降低,提前比例会升但误报也升。论文没有给出阈值扫全曲线,只能按 0.5 这个点理解。
最终文本准不准:八个标准集词错误率
提前不能以最终文本变差为代价,表 3 看最终 transcript 的词错误率。这里不是流式计时,而是同一 clips 上的终稿打分,越低越好。比较包含 Earlybird 4 比特、全精度、Moonshine 运行时、Whistle、Whisper tiny、base、small。
| System | TED | VoxP | LS-c | LS-o | Earn | AMI | Giga | SPGI | Mean |
|---|---|---|---|---|---|---|---|---|---|
| Earlybird 4-bit (16.8 MB) | 6.1 | 13.6 | 3.7 | 14.2 | 21.7 | 21.8 | 13.1 | 6.8 | 12.6 |
| Earlybird full precision | 5.6 | 12.9 | 3.4 | 12.0 | 20.0 | 19.4 | 11.7 | 6.1 | 11.4 |
| Moonshine Tiny runtime | 7.9 | 15.4 | 5.4 | 16.0 | 23.3 | 24.9 | 14.5 | 7.3 | 14.4 |
| Whistle | 7.7 | 10.8 | 4.1 | 11.3 | 17.9 | 24.0 | 14.6 | 7.1 | 12.2 |
| Whisper tiny.en | 5.9 | 13.7 | 5.2 | 14.0 | 17.5 | 22.2 | 11.8 | 5.3 | 12.0 |
| Whisper base.en | 4.9 | 9.8 | 3.8 | 10.2 | 14.4 | 18.5 | 11.6 | 4.0 | 9.7 |
| Whisper small.en | 4.0 | 8.3 | 2.7 | 7.8 | 11.9 | 16.9 | 8.7 | 3.6 | 8.0 |
4 比特 Earlybird 平均 12.6%,全精度 11.4%;Moonshine 运行时 14.4%,Whistle 12.2%,Whisper tiny.en 12.0%,base.en 9.7%,small.en 8.0%。Earlybird 在八集上都优于 Moonshine 运行时,4 比特版与同体积 Whistle 大致打平,五胜三负,输在 VoxPopuli、LibriSpeech other 和 Earnings-22。量化代价平均 1.2 个点,大于自有测试集上的差距。全量集上 Earlybird 全精度平均 11.7,4 比特 12.7,Whisper tiny 全量 12.2。
这意味着同尺寸下 Earlybird 准确率与 Whistle、Whisper tiny 相当,好于 Moonshine Tiny,但 Whisper base 以 2.5 倍参数在除干净集外每集都更准。图 1 纵轴用的就是这类平均值,Earlybird 的位置反映的是终稿相当、延迟大幅提前。
提前给出的概率能不能信
提前的词只有知道何时可信才有用。论文用期望校准误差检验原始置信度,按 10 个等宽箱算平均置信与实际正确率差距,越低越好。对象是每 80 毫秒步屏幕上参考词还没结束、且之前词都对的 transcript 词,每集 200 句。图前导读:横轴是声明置信度,纵轴是实际正确率,对角虚线为完美校准,重点看 4 条集曲线贴对角线的程度和高置信段高度。
看图路径: 1. 先看横轴声明置信度与纵轴实际正确率,对角虚线为完全校准;2. 比较 LibriSpeech、TED-LIUM、People’s Speech、合成语音四条曲线与对角线的贴合程度;3. 注意低置信段和高置信段分别偏离方向是否一致;4. 观察 90% 以上高置信段各集正确率大概落在什么高度
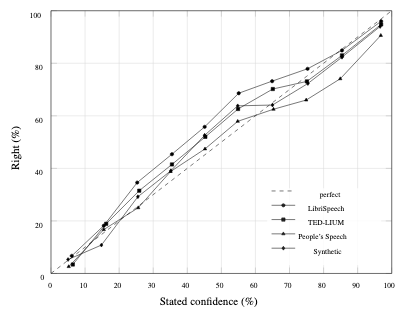
论文图 3。原论文 Figure 3::“Reliability of the confidence on words still being spoken: every transcript word on screen whose reference word has not ended, with all words before it right, at every 80 ms step…”。
图中 4 条曲线大致沿对角上升,低置信段接近零,高置信段到 90% 以上。LibriSpeech 与 TED-LIUM 更贴对角,People’s Speech 在中段略低,合成语音在高端略低,但都没有大偏离。论文给出正在说话词的期望校准误差在 3.7 到 5.5 之间,置信度不低于 0.9 的词正确率 91% 到 96%,第一猜测词误差 0.8 到 3.7,第二猜测词 2.0 到 4.4。域外 SLURP 命令集上正在说话词误差升到 8.8,说明校准在域外会变差。
这支持在同分布语音上可用原始乘积做阈值,比如自动助手只在高置信才预取搜索。但不能推广到命令语音或强噪声,因为那些条件下没有同等校准证据。
噪声、填充帧和量化各带来什么变化
先看噪声下的保持程度。表 4 在 150 句干净集上加白噪声和背景人声,信噪比 10 dB 和 5 dB,报告中位延迟和词错误率。问题是提前是否在噪声下仍成立,代价是错误率升多快。
| Condition | Earlybird | Moonshine Tiny | Whisper base |
|---|---|---|---|
| White noise, 10 dB | −𝟕𝟎 / 8.7 | +290 / 15.3 | +140 / 6.5 |
| White noise, 5 dB | −𝟓𝟎 / 19.5 | +320 / 29.1 | +170 / 13.4 |
| Chatter, 10 dB | −𝟐𝟎 / 32.0 | +350 / 41.5 | +150 / 8.9 |
| Chatter, 5 dB | +𝟏𝟑𝟎 / 65.4 | +490 / 79.0 | +230 / 29.0 |
Earlybird 在各级噪声仍最早:白噪声 10 dB 负 70 毫秒 8.7%,5 dB 负 50 毫秒 19.5%;背景人声 10 dB 负 20 毫秒 32.0%,5 dB 转正 130 毫秒 65.4%。全程比 Moonshine 更早更准,但背景人声 10 dB 下 Whisper base 词错误率仅 8.9%,Earlybird 已到 32.0%,说明抗人声干扰弱。
再看填充帧和量化的消融,同一 67 句干净集。表前问题是:3 帧静音填充是否真带来提前,4 比特是否丢提前。
| Variant (LibriSpeech clean, 67 utt.) | Median word latency | Revisions / word | WER |
|---|---|---|---|
| Earlybird (padding frames) | −90 | 1.29 | 2.3 |
| Earlybird, no padding frames | −50 | 1.10 | 2.0 |
| Earlybird 4-bit | −90 | 1.18 | 1.7 |
有填充帧中位负 90 毫秒、修改 1.29、词错误率 2.3%;去填充帧退到负 50 毫秒、修改 1.10、词错误率 2.0%;4 比特保持负 90 毫秒、修改 1.18、词错误率 1.7%。填充以多一点修改和错误换更早,量化在此小集上不丢提前。计算开销上单 CPU 线程每 80 毫秒步平均 39 毫秒,p95 为 64 毫秒,约 2 倍实时,Moonshine 同解码方式为 47 毫秒;3 次不同种子训练中位延迟差 3 毫秒内、词错误率差 0.5 点内。
填充帧 × 量化感知训练 × 校准误差: 填充帧指编码器在已听音频后额外看到的三帧由静音算出的特征,不用任何未来语音;量化感知训练指在训练中就把权重量化到 4 比特以适应小体积;校准误差指按置信度分箱后平均置信与实际正确率的差距。填充让模型敢于把话说完,量化决定体积和精度代价,校准误差检验提前给出的概率能不能信,三者分别回答敢不敢早说、能不能放下、敢不敢用。
哪些情况下结论不再成立
第一是准确率上限。Whisper base 参数约 2.5 倍,在除 LibriSpeech 干净集打平外每集都更准,尤其背景人声下差距拉大。Earlybird 同尺寸相当,但跨尺寸比仍是更大模型终稿更好。
第二是稳定性代价。提前显示必然带来更多收回,在自发和 noisy 语音上每词收回 2 到 6 个。若下游不能容忍闪烁,就不能直接显示,只能内部预取。论文没有测用户观感,只能从修改次数推断。
第三是猜测贡献小、语言单一、时间基准有误差。猜测在阈值 0.5 下只占提前正确词的一小部分;论文只做英文,域外命令校准变差;词尾来自对齐器,有数十毫秒自身误差,合成集给精确时间且结论一致,但不能把毫秒数读到个位数精度。
复现第一步做什么与需要什么
复现计时需要三样:音频、每词起止、按 80 毫秒喂入并记录屏幕变化的 harness。词起止可用 Montreal 对齐或论文自建 wav2vec 2.0 对齐,合成语音可用音素时长。喂入时不加处理耗时,只记决策时刻,再按正确且不再改的标准算延迟、修改次数和终稿词错误率。
权重与加载器按论文结论在 Hugging Face 发布,地址为 sahilmahendrakar/Earlybird-29M,本次收到的作者资源显示该模型链接当前可用。这证明权重可下载,不等于代码已开源或系统可一键运行,三者要分开确认。训练复现还需要 LibriSpeech、People’s Speech、Kokoro 合成及教师过滤、4 个阶段学习率与量化设置,单卡 batch 48。
值得尝试的场景是同分布英文、干净或轻噪声、能容忍闪烁或只做内部预取的助手。若是强背景人声、命令域或要求零闪烁显示,需要先补测校准和修改,否则不能沿用提前数字。
一句话总结与还有什么待验证
Earlybird 证明小流式识别器经随机截断加完整词目标训练,能在词结束前正确显示多数词并给出可用的原始置信度,同体积终稿与 Whistle 相当、远早于 Moonshine 运行时。成立条件是英文、同分布、允许一定修改,且猜测只是小头。
还有三项待验证:更强噪声和远场下的提前与校准曲线,阈值与下游预取收益的端到端计时,以及多语言和长尾词上的提前比例。若补上这些,才能知道提前的毫秒数在真实助手链路里能兑现多少。
📎 论文与评分元数据
排名:前25% | 文档类型:模型报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses