📄 跨键盘也能听键还原文字:Decker 如何去掉设备染色再靠语言模型纠错
英文题目:Domain-Invariant and Language-Model-Assisted Acoustic Side-Channel Attacks on Keyboards
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Bikrant Bikram Pratap Maurya:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务是从被动录下的敲击声中恢复未见键盘的按键序列乃至句子和口令,难点是录音混入设备房间麦克风染色,换键盘波形分布即变,单设备模型易记住设备指纹而非按键差异。论文提出Decker,先用可学习逆滤波估计去除设备染色并输出去染波形,再用随机滤波合成未见设备风格送入ECAPA-TDNN编码器提取嵌入,最后用分类域对抗与跨键盘对比损失塑造嵌入并送入受限束搜索语言模型选句。在Hear数据集跨用户划分未见端上按Top-1按键准确率比较,Decker为82.7%,高于ECAPA-TDNN基线的60.4%。在同一Hear数据集跨环境划分未见端上按Top-1按键准确率比较,Decker为78.9%,高于ECAPA-TDNN基线的55.1%。在Hear的VoIP子集未见键盘与VoIP通道上按连续字符错误率比较,EvFlow-CTSSM为27.5%,低于Conformer-CTC基线的54.1%。完整Decker训练约需六GPU小时,测量条件为单块NVIDIA A100,结论适用于分段已知、有一定信噪比的近场录音,极端噪声、连续无分段长流和特殊键盘形态尚未充分验证。
🔗 开源与复现资源
- 第三方资源:https://github.com/vikrant-vikram/Hear-Dataset — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
要从敲键声里恢复什么,难在哪里
任务的输入是一段被动录到的环境音频,目标是还原受害者 typed 的按键序列乃至句子或密码。必须保留的信息是哪个键被敲的瞬态特征,敲击的机械脉冲经键帽、开关、机壳共振和麦克风房间响应形成短促宽带声音,同一台设备上同一键多次敲击相对一致,相邻键因振动路径重叠而相似。
输出分两层:按键级给出每个切分窗的键标签,序列级给出整句或整串密码。论文把难点定位为设备染色:训练和测试键盘不同时,强模型学到的其实是键盘的身份而非按键身份,换设备就把自信的预测变成系统性错误。VoIP 压缩、环境噪声、多径反射和切分抖动进一步扭曲观测,使实验室单设备高准确率无法直接搬到开放世界。
已有路线为何停在实验室高准确率
最早的工作用频谱特征加神经网络证明单设备上每键声音可分,随后出现无标注聚类加拼写语法约束的管线,这已是语言先验纠错的雏形。深度学习时代用卷积、残差、ConvMixer 和 Wav2Vec2 等语音预训练模型处理频谱图或波形,在 Zoom 等压缩信道上也报出很高的实验室数字。
另一支放宽几何假设,利用屏幕反射等多径实现非视距恢复,把无直接视线也变成可用信号。但这些工作大多仍在目标设备或近似设备上训练测试,没有解决跨键盘泛化。语言模型此前多作为键盘专用声学模型后的松耦合纠错滤波器,没有配上真正跨键盘稳定的声学分布。本文的比较口径是同一任务、同一划分和同一运行阶段下的跨设备条件,而不是把单设备数字与跨设备数字直接对比。
威胁模型规定了攻击者能做什么和不能做什么
论文固定一个保守的被动窃听设定:Bob 在图书馆、咖啡馆等公共空间用笔记本打字,Eve 坐在 1-3 米外另一桌,把手机或小型麦克风藏在包或书堆中,无需视线,依靠直达与屏幕桌面反射的多径拾取声音。Eve 不接触受害设备、不装软件、不看屏幕,只做离线计算,允许用笔记本级机器运行声学编码器和 GPT-2、FLAN-T5 等语言模型。
为理解该场景,先看论文的威胁示意图,它把被动距离、隐蔽放置、非视距和离线 2 阶段处理画在一条链上。
看图路径: 1. 先看左侧 Bob 的笔记本与右侧 Eve 的手提包隐蔽麦克风及 1-3 米虚线;2. 再看底部离线处理链:切分到 Decker 编码再到 top-k 与语言模型解码;3. 确认非视距与被动录音的约束在图中如何体现
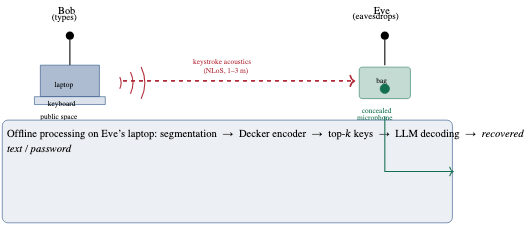
论文图 1。原论文 Figure 4.1::“1: Threat scenario. Bob types on a laptop in a public area while Eve, seated at a separate table (1–3 m away), passively captures keystroke acoustics from a concealed microphone…”。
该图确实可见左侧笔记本键盘与右侧手提包隐蔽麦克风之间用虚线标出 1-3 米的敲键声传播,底部方框标出切分到 Decker 编码再到 top-k 与语言模型解码的离线流程。它帮助理解后文所有数字的前提:只要脱离该距离、噪声、多径和未见键盘条件,结论不再直接适用。
Decker 的五段流水线如何分工
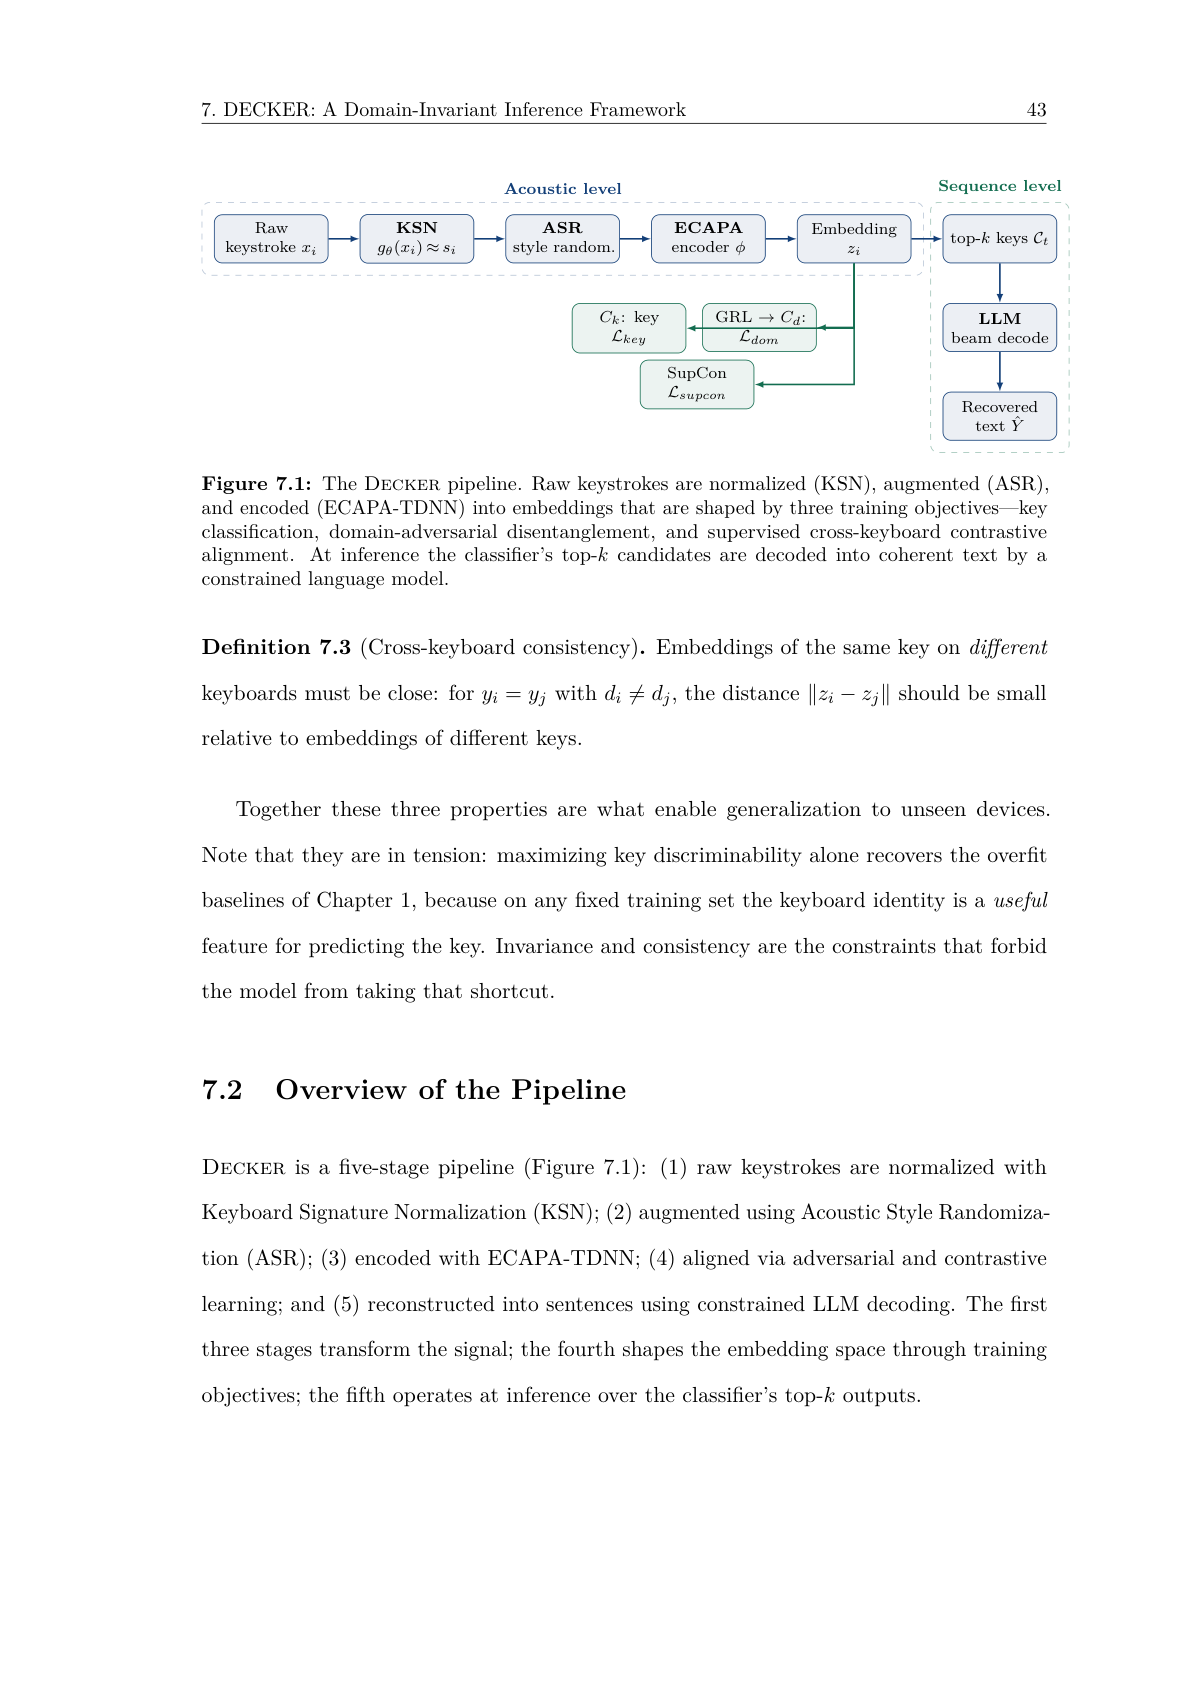
Decker 全称是跨键盘提取与识别的域不变嵌入框架,输入是按固定非对称窗切出的按键波形,输出是受限语言模型解码后的文本。流水线按一个样本的旅程展开:原始波形先经键盘签名归一化做逆滤波,再经声学风格随机化做伪造染色增强,然后由 ECAPA-TDNN 编成嵌入,训练时用 3 个损失共同塑造嵌入空间,推理时分类头给出 top-k 候选再交语言模型做受限束搜索。
下图是理解分工的总览,先沿主路径看变换,再看 3 个训练分支在何处汇合。
看图路径: 1. 沿顶部声学级主链看从原始波形到嵌入的变换顺序;2. 再看下方按键损失、梯度反转域分支与对比分支如何共同塑造嵌入;3. 最后看右侧序列级如何从 top-k 进入语言模型束解码
图片来源: 原论文 PDF 第 62 页(含图 7)
论文图 3。原论文 Figure 7.1::“1: The Decker pipeline. Raw keystrokes are normalized (KSN), augmented (ASR), and encoded (ECAPA-TDNN) into embeddings that are shaped by three training objectives—key…”。
图中顶部声学级从原始波形经归一化、风格随机到编码器再到嵌入,下方两个分支分别是按键损失与经梯度反转的域损失以及对比损失,右侧序列级从 top-k 进入束解码得到恢复文本。这张图把信号变换、嵌入约束和序列纠错三层放在一起,后文逐段展开每个盒子的计算。
信号先做归一化再做伪造染色是什么操作
论文把观测建模为设备无关隐源与设备脉冲响应的卷积,键身份在隐源里,但模型看到的是被设备滤波器涂抹后的波形。键盘签名归一化就是可学习的近似逆滤波,结构是 4 个 1 维卷积加批归一化和 ReLU,核尺寸与扩张率覆盖局部到宽语境,再经线性投影加残差连接与频率归一化层,频域上相当于乘一个估计的逆滤波响应。消融显示它去掉强共振带而保留区分键的瞬态结构。
\[x_{i}\;=\;h_{d_{i}}*s_{i},\]该式说明观测等于设备响应与隐源的卷积,正是归一化要反演的对象。声学风格随机化则做相反方向的增强,对归一化输出施加随机无限脉冲响应滤波、平滑谱包络扭曲和指数衰减扰动,模拟没录过的键盘。两者互补为收缩已见域到公共隐空间,再扩张覆盖未见域周围的连续体。
键盘签名归一化 × 声学风格随机化: 键盘签名归一化负责收缩,把已见键盘各自的共振染色通过可学习逆滤波向公共隐源靠拢;声学风格随机化负责扩张,用随机滤波器、频谱包络扭曲和衰减扰动伪造没录过的键盘染色。两者搭配使编码器既不依赖训练集里某台设备的固定染色,又见过足够宽的伪造染色分布,因而对真正未见的键盘更稳定。
编码器和三个损失如何塑造嵌入空间
编码器先取对数梅尔谱,再用多尺度 1 维时域卷积加通道注意力重标定提取帧特征,最后用均值方差统计池化把变长帧序列压成固定维向量,兼顾锐利起始与较长混响尾。按键分类头在此嵌入上做交叉熵,单独用它就是过拟合基线。
域分支在嵌入后接梯度反转层与键盘分类器,前向恒等、反向把梯度取负,迫使编码器让键盘不可分。
\[\text{GRL}_{\lambda}(z)=z,\hskip 20.00003pt\frac{\partial\,\text{GRL}_{\lambda}}{\partial z}=-\lambda I.\]该式规定了反转层的双向行为,是实现键盘不变性的关键。对比分支只把不同键盘上的同键当正样本、同批不同键当负样本,用温度系数的监督对比损失把同键跨设备拉近。序列级则把每步声学分布截断为 top-k 候选集,再最大化声学似然加语言先验权重的融合目标,用束宽 8-16 的受限束搜索实现。
\[\hat{Y}=\arg\max_{Y\in\mathcal{C}_{1:T}}\left[\sum_{t=1}^{T}\log P_{\theta}(y_{t}\mid x_{t})+\lambda_{\text{LM}}\log P_{\text{LM}}(Y)\right],\]该式是浅融合解码的写法,声学项保真,语言项保通顺。
梯度反转层 × 域分类器 × 按键分类器: 按键分类器要求嵌入能分清按的是哪个键,域分类器则试图从同一嵌入猜出是哪台键盘,梯度反转层在前向恒等、反向把域分类器的梯度乘以负系数传给编码器。组合后编码器被推向让按键可分而键盘不可分,形成鞍点均衡,这正是键盘不变性的操作定义。
监督跨键盘对比对齐 × 梯度反转: 梯度反转只负责删除键盘身份信息,并不强制同键跨设备靠拢;监督跨键盘对比对齐补上这一块,它只把不同键盘上的同键作为正样本拉近、把不同键推远。两者分工为先去设备线索、再对齐按键身份,合起来同时满足可分性、不变性和跨设备一致性。
ECAPA-TDNN 编码器 × top-k 候选集 × 受限束搜索语言模型解码: ECAPA-TDNN 编码器把归一化和增强后的对数梅尔谱变成固定维嵌入并给出每时刻的按键分布,top-k 候选集把每步限制为声学上最可能的几个键,受限束搜索语言模型解码只在这 k 个候选中搜索声学似然加语言先验最优的序列。这样语言模型能纠正相邻键混淆,又不能幻觉出声学已排除的键,保证忠实于所听到的声音。
训练按什么目标和顺序更新哪些参数
总目标是按键损失加域损失加对比损失的加权和,权重分别为 0.5 和 0.1,对比温度 0.07。优化器用 AdamW,学习率 2×10⁻⁴,权重衰减 10-3,批量 64,共 60 轮。归一化模块先用 l1 谱损失预训练 5 轮再与编码器联合优化,所有模型用 3 个随机种子报告均值与标准差,并在第 10 轮内把梯度反转强度从 0 热身到目标值。
训练循环按小批量依次做归一化、风格随机增强、编码、算 3 个损失再经 AdamW 更新编码器、按键头、域头与归一化参数,其中域梯度经反转层反向。冻结与更新分工明确:VoIP 部分的语音预训练主干全程冻结只训轻量头,而 Decker 主干与归一化是联合训练的。原文没有给出逐层梯度范数或停止准则之外的细节,缺口如实保留,不从模型名猜测实现。
Hear 数据集提供了什么样的对照条件
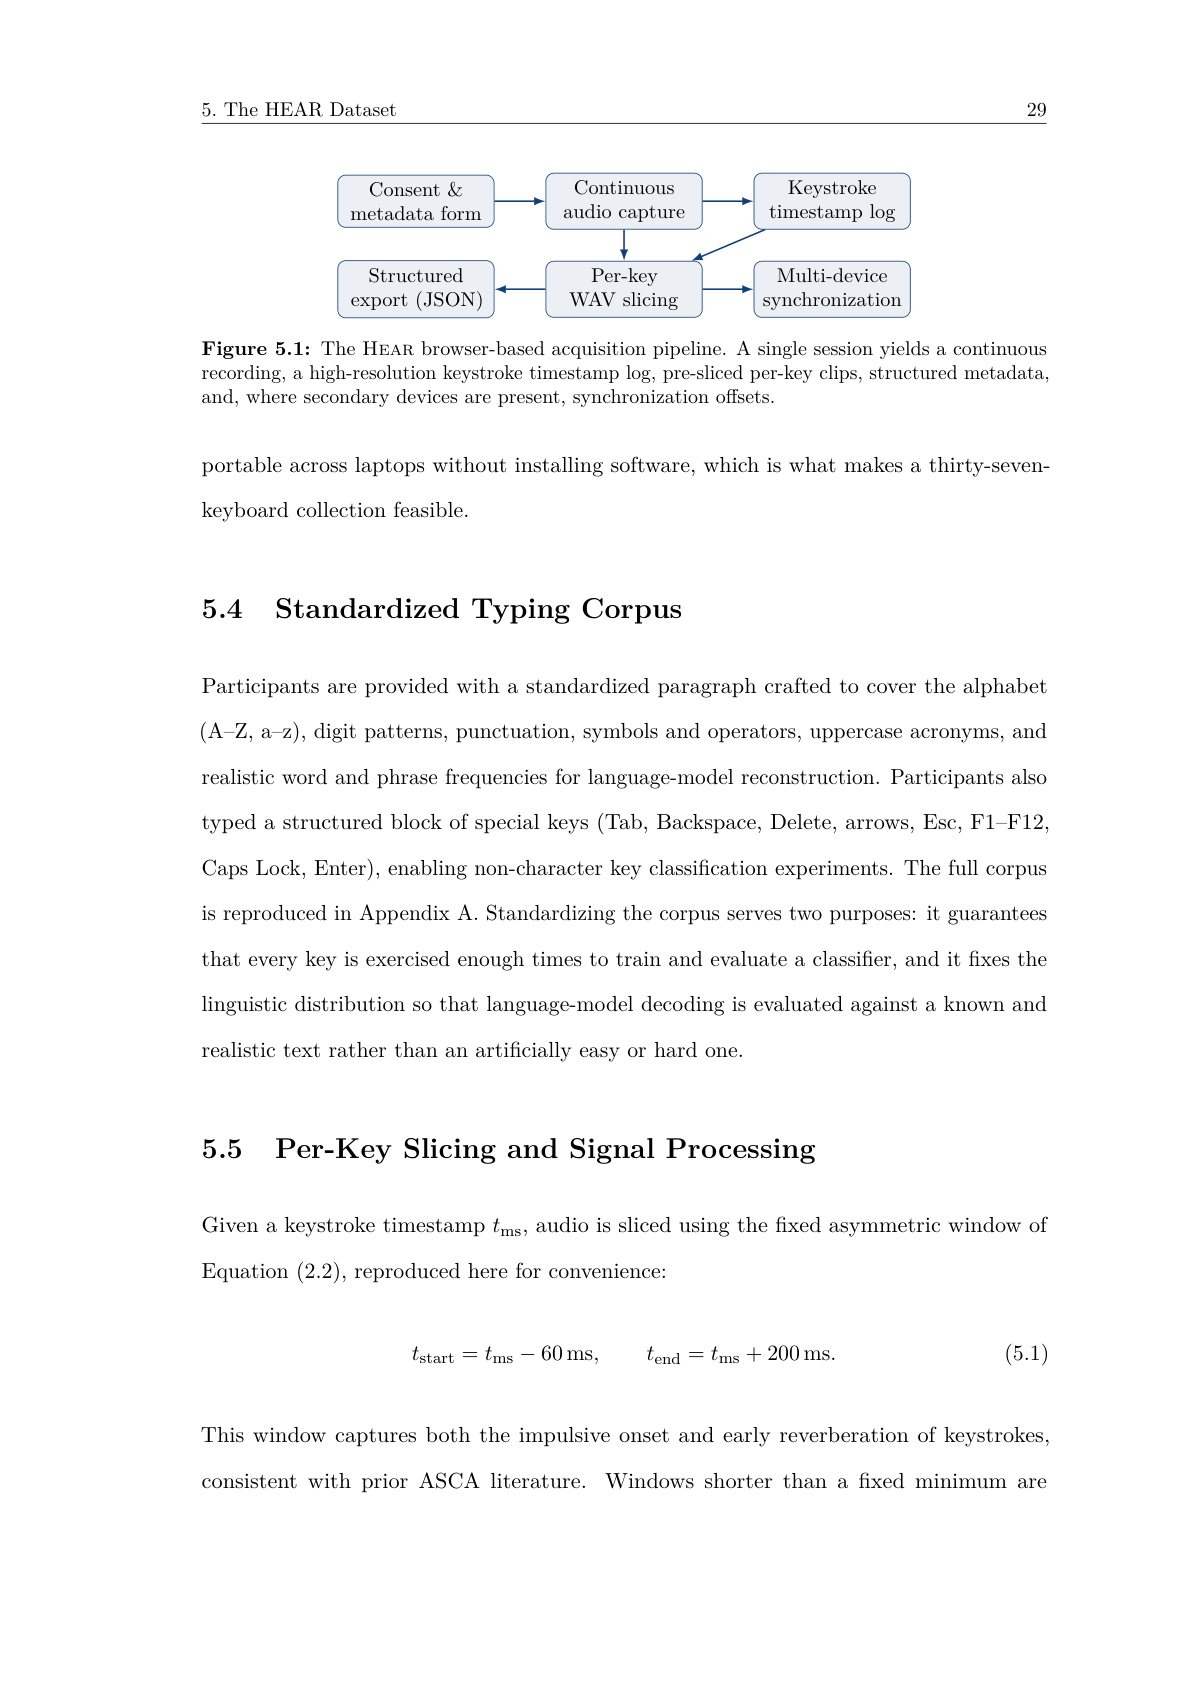
Hear 是全文唯一的底层数据集,采集用浏览器工具同时记录连续音频、高分辨率按键时间戳、预切分单键波形、结构化元数据及多设备同步偏移。切分窗固定为起始前 60 ms 到结束后 200 ms,保留快速连击的重叠以贴近被动攻击。同步在有时钟信号时估计偏移与漂移,无标记时用互相关估计延迟,残差在毫秒量级。
采集流水线本身说明了多通道配对从何而来,下面按像素中的箭头走向来读这张流程图。
看图路径: 1. 沿从知情同意到连续录音再到时间戳与切分的箭头看主路径;2. 看单键切分层分出的左右两条去向:向左到结构化导出,向右到多设备同步;3. 对照正文理解同一敲击被多通道同时观测的含义
图片来源: 原论文 PDF 第 48 页(含图 5)
论文图 2。原论文 Figure 5.1::“1: The Hear browser-based acquisition pipeline.”。
图中可见顶部主链为同意与元数据表单指向连续音频采集再指向按键时间戳日志,连续采集还向下指向单键波形切分,时间戳日志也斜向汇入该切分层;关键是切分层之后分出并列的两条去向:向左指向结构化导出,向右指向多设备同步,并不是同步再汇入导出。这一结构说明一次会话同时产出连续录音、切分波形、时间戳与元数据,且同一敲击可被多通道同时观测。 headline 统计需要保留原表写法以便复现划分。
下表比较的不是模型好坏,而是数据集覆盖的维度,用于判断后文跨键盘、跨用户、跨环境与跨设备划分是否成立。
| Attribute | Value |
|---|---|
| Participants | 53 (near gender-balanced) |
| Laptop keyboards | 37 (scissor, membrane, mechanical) |
| Recording channels | external microphone, on-device microphone, VoIP stream |
| Environments | quiet (library), moderate (office), high-noise (café/outdoor) |
该表说明参与者 53 人近性别平衡、键盘 37 台覆盖剪刀脚、薄膜与机械、通道 3 路平衡、环境分安静、中等与高噪,标注事件每主通道超 10000,字符 94 类加特殊键,采样 48 kHz 并为预训练特征重采样到 16 kHz,切分窗为 -60 到 +200 ms。它的限制是仍为受控段落与固定特殊键块,而非完全野生的自由打字,因此后文数字应读作给定协议下的威胁刻画。4 个典型划分为跨键盘、跨用户、跨环境与跨设备,指标含 top-k 准确率、宏平均 F1、字符准确率、整句全对率、归一化编辑距离与切分鲁棒性。
基线为何在未见键盘上掉约四十个点
单模态基线在已见键盘上均超 88%,到未见键盘跌至 47.9%-58.1%,这是全文危机的经验证据。测量对象是 top-1 按键准确率,比较条件是同一模型在留域外键盘上的表现,指标方向越高越好,差距为绝对百分点。
下表要回答强单模态模型能否跨键盘,条件是已见与未见键盘划分一致,指标为 top-1 准确率及跌幅。
| Model | Seen-KB | Unseen-KB | Drop |
|---|---|---|---|
| wav2vec2 (audio) | 92.4% | 51.8% | −40.6 |
| ECAPA-TDNN (audio) | 95.3% | 58.1% | −37.2 |
| CoAtNet-S (spec) | 90.7% | 49.6% | −41.1 |
| ResNet-34 (spec) | 88.5% | 47.9% | −40.6 |
表中 wav2vec2 从 92.4% 跌到 51.8%,ECAPA-TDNN 从 95.3% 跌到 58.1%,CoAtNet-S 从 90.7% 跌到 49.6%,ResNet-34 从 88.5% 跌到 47.9%,跌幅约 37-41 个点。论文的解释是波形模型吸收低频机壳模态,频谱图模型编码键盘特有纹理,嵌入按设备聚类而非按键聚类。多模态欧氏融合用 ECAPA 加 CoAtNet-S 的 8 种早中晚融合,最优双向交叉注意力也只到未见 66.2%,说明两塔带同一种设备染色时,加容量与注意力无法消除失配。未胜出的细节是即使最强融合仍比 Decker 低约十五个点,且晚融合平均与加权均未反超。
Decker 把差距收到十八个点以内靠哪几项
Decker 完整版在域偏移评估下已见 98.9%、未见 81.3%,差距 17.6 个点,相对单模态 47%-58% 的未见水平大幅提升。比较条件与上节相同,仍是 top-1,3 个随机种子均值加自助置信区间,显著性用配对自助检验。
下表要回答域不变框架的每块贡献,公平条件是同一划分与同一指标,指标方向为未见准确率越高越好、差距越小越好。
| Model variant | Seen-KB | Unseen-KB | Gap |
|---|---|---|---|
| Decker (full) | 98.9% | 81.3% | −17.6 |
| w/o GRL | 97.8% | 68.1% | −29.7 |
| w/o ASR | 97.5% | 75.2% | −22.3 |
| w/o KSN | 96.9% | 63.7% | −33.2 |
| ECAPA + GRL (DANN-only) | 97.9% | 71.6% | −26.3 |
表中去掉梯度反转跌到 68.1%,去掉声学风格随机化跌到 75.2%,去掉归一化跌到 63.7%,仅 ECAPA 加梯度反转的对抗基线为 71.6%,说明对抗 alone 不足以完全抑制键盘偏置。探针实验进一步显示冻结嵌入上键盘分类从 94.2% 降到 21.7%,t-SNE 从按键盘聚类转为按按键涌现组织但相似键仍重叠。限制是已见仍略高于未见,且残余错误集中在空间相邻键,这恰为语言模型纠错留下可利用的结构。
VoIP 信道失真 × KAN 适配头 × 隐流规范化: VoIP 的自动增益、回声消除和压缩对脉冲式敲键声造成非线性扭曲,冻结语音预训练表示后线性头难以恢复;KAN 适配头用可学习样条单变量函数建模这种非线性映射,而隐流规范化则在隐空间把失真嵌入沿直线概率路径输运回干净流形。两者都是处理信道漂移,只是分别作用在切分分类和连续无切分转导两条路线上。
语言模型把句子和密码恢复推高多少,何时失效
句子级用 Decker 的 top-k 候选做受限解码,字符准确率、整句全对率与归一化编辑距离分别衡量位置一致、全句无错与需改动量,后者越低越好。Decker 原始字符 81.3%、整句 42.6%、距离 0.124,语言模型逐级提升,小 GPT-2 已把整句拉高 16 个点。
下表比较不同规模语言模型在同一声学 top-k 上的序列收益,条件是同一跨设备声学输出,指标方向为前两列越高越好、距离越低越好。
| LLM | Char Acc. | Sent. Match | Norm. Lev. Dist. |
|---|---|---|---|
| Decker (raw) | 81.3% | 42.6% | 0.124 |
| GPT-2 Small | 86.9% | 58.7% | 0.092 |
| FLAN-T5 Base | 89.4% | 62.1% | 0.078 |
| LLaMA-2 7B | 91.6% | 66.5% | 0.056 |
| GPT-4 | 93.2% | 72.8% | 0.041 |
表中 GPT-2 Small 到 86.9% 与 58.7% 与 0.092,FLAN-T5 Base 到 89.4% 与 62.1% 与 0.078,LLaMA-2 7B 到 91.6% 与 66.5% 与 0.056,GPT-4 到 93.2% 与 72.8% 与 0.041,显示即使轻量模型也有实质增益。密码分 3 类进一步限定适用条件:人类风格密码熵 28-34 比特获 8-12 个点的全对提升,均匀字母数字 52-75 比特与可打印随机 70-92 比特几乎无增益,仅 2-3 个点。也就是说语言先验只在人类选择偏置降低熵时放大威胁,对高熵随机串不构成倍增器,这是复现时必须保留的边界。
VoIP 压缩下语音表示与连续转导的表现
VoIP 子集含 12480 个同步微声事件,同一敲击有本地与 VoIP 帧对齐视图,划分保证测试为未见用户与键盘。第一部分冻结 6 种语音表示只训全连接、卷积与 KAN 3 种头,场景分标准键盘泛化、VoIP 键盘泛化与编解码泛化,指标为准确率与宏平均 F1。WavLM 因去噪预训练对瞬态更匹配而最强,VoIP 使各模型再掉约 8-10 个点。
下表聚焦 KAN 头的跨主干优势,条件是 VoIP 子集上的键盘与编解码划分,指标为准确率与宏平均 F1 越高越好。
| KAN Downstream (Proposed) | ||||
|---|---|---|---|---|
| WavLM | 68.47 | 67.12 | 61.73 | 60.34 |
| Whisper | 65.74 | 64.39 | 59.12 | 57.83 |
表中 KAN 下 WavLM 标准域内 68.47% 与 67.12%、域外 61.73% 与 60.34%,Whisper 的 KAN 对应 65.74% 与 64.39% 及 59.12% 与 57.83%,均明显高于同主干的卷积与全连接头,说明编解码非线性扭曲需要样条头的表达力。第二部分把无切分长流直接转导为稀疏事件序列,用隐整流规范化在隐空间单步欧拉求解把失真拉回干净流形,再用事件触发门控连续状态空间模型只在脉冲处更新状态并以 CTC 加浅融合解码。连续字符错误率越低越好,基线未见域退化 28-33 个点,EvFlow-CTSSM 仅从 16.4% 到 27.5% 退化 11.1 个点,纯声学无语言权重时乱串仍 31.2% 而结构文本随权重升至 8.1%,证明增益来自物理分辨而非语言记忆。限制是该路线仍需配对干净与失真隐向量做弱监督训练,且推理只在 Hear 的 3 种会议软件链路上验证。
切分抖动与虚假触发下系统退化有多快
被动攻击拿不到真值时间戳,论文以均匀抖动加虚假切分做敏感性分析。抖动幅度取 10、20、30 ms,虚假段按每 100 键 3% 与 5% 插入,指标为 top-1 与原始整句及加 FLAN-T5 后的整句。无抖动时 81.3% 与 42.6% 与 62.1%,10 ms 抖动仅掉 2.8 个点到 78.5%,20 ms 掉到 75.4%,30 ms 仍保 69.6%,加 5% 虚假段掉到 71.2%。
序列级更敏感但语言解码明显缓冲,20 ms 抖动下加 FLAN-T5 仅从 62.1% 到 58.1% 掉 4 个点以内。未胜出项是即使有语言模型,30 ms 与 5% 虚假段仍把整句拉到 52%-53%,说明连续无切分仍是短板,论文也指出联合切分分类与流式语言模型是后续方向。该结论只在毫秒级残差与上述插入率下成立,强脉冲重叠噪声不在此表覆盖范围内。
这些结论在什么边界外不再成立
首先评估聚焦已切分窗,连续音频的漏检与边界大抖动会同时伤害声学与语言 2 级,EvFlow 路线虽展示潜力但未与 Decker 全链路联合评测。其次极端脉冲或重叠噪声、触屏与超薄柔性键盘等非典型脉冲响应不在 Hear 覆盖内,个人指力与击键角度等生物力学漂移仍可能残留。
再者部分结果依赖标准段落与已知密码分布,野生自由文本的词汇与熵分布不同,语言增益会变化。防御上仅改变染色不足以对抗已建模去染色的攻击,必须破坏按键可分结构或降低语言可预测性,而高熵口令与口令管理器是用户侧最直接的杠杆。这些不是技术缺陷的指控,而是如实标出过度外推会失效的位置。
复现第一步做什么,需要哪些配置与成本
复现从 Hear 的浏览器采集工具与元数据模式入手,按附录语料与 JSON 字段重采或申请数据,注意 3 通道同步与 -60 到 +200 ms 切分保持一致,再按跨键盘留域外划分而非随机划分,否则会因设备泄露得到虚高数字。Decker 训练用 AdamW、学习率 2×10⁻⁴、权重衰减 10-3、批量 64、60 轮、域权重 0.5、对比权重 0.1、温度 0.07、对数梅尔 80 维、嵌入 192 维、top-k 为 5、语言融合权重 0.4、束宽 8-16、种子 13、42、101。
成本上完整 Decker 约单张 A100 6 小时,VoIP 冻结主干实验只训轻量头便宜得多。推理在 M1 上每键约 2.3 ms、每句 GPT-2 约 180-220 ms、FLAN-T5 约 200-240 ms,峰值内存 340-380 MB 加语言模型 780 MB 到 1.4 GB,日吞吐约每秒 430 键与 4.5 句,x86 i7 上更快。数据含人类受试者录音,需知情同意、去标识并仅限学术申请,密码实验均为合成分布抽样。公开文档在第三方链接可查,是否已开源或可下载需以该页面当前可用状态为准,不把链接存在当作作者已开源的保证。
什么时候值得尝试,还缺哪项验证
当研究问题是未见设备、未见用户或 VoIP 压缩下的敲键声推断,且能拿到多键盘配对数据做域不变训练并允许用语言模型做受限纠错时,这套路线值得尝试;若只有单键盘数据或目标是高熵随机串,预期增益会大打折扣。复现第一步是重建留域外划分与 top-5 评估,因为 top-5 在跨域仍高达 91%-96%,它是语言解码有效的直接前提。
还缺的验证包括完全无切分的端到端联合评测、更广硬件与强噪声下的外推、以及针对语言层的对抗填充与系统层麦克风管控的攻防对照。记住关键超参与信息条件:多键盘标签与同步多通道是监督来源,top-k 约束是保真条件,熵是语言倍增器起效的条件。误解常出在把单设备数字当开放世界能力,或把搜索选优与已知答案的上界当可部署提升,论文的跨域表与密码分层正是为纠正这两点而设。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses