📄 机器人只用一个摄像头和麦克风,怎么猜到下一个是谁说话
英文题目:AVCC: Audio-Visual Conversation Corpus for Turn-Taking Prediction with a Human Benchmark
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Haotian Qi:机构信息未能在本次解析中与作者逐人可靠绑定
- Gabriel Skantze:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
对话转换平均约200毫秒,机器人需在静默前判断当前说话人是否继续及多人时由谁接话,输入为单静态摄像头和单声道麦克风记录的连续音视频,输出为互静默间隙预测点处的保持或转换及接话人身份,难点是不能等待静默结束而须提前投射转折。先以InsightFace提取逐帧人脸轨迹并人工核对身份,再以TalkNet初标语音活动经人工校正并以Voxtral转写加蒙特利尔强制对齐器输出词级转写,最后按互静默间隙规则提取轮次事件并在训练分区拟合逻辑回归探针读出嵌入,由音频RoleVAP模型输出保持或转换判断、多模态MuVAP模型结合当前说话人识别指名接话人。154名保留被试在相同预测点观看至多10秒上下文后选择下一说话人并给出1到5分信心。在1730个测试事件保持或转换评分的平衡准确率上,音频RoleVAP模型为66.5%,高于被试平均64.0%,低于1526个无平票事件上多数投票的70.1%。在相同1730个事件上多模态MuVAP模型保持或转换平衡准确率为67.9%,高于音频模型的66.5%;在必须指名接话人的次说话人身份评分平衡准确率上,MuVAP为63.3%,高于被试平均59.5%,低于1479个无平票事件上多数投票的67.7%。在次说话人身份评分平衡准确率上,被试平均从二人事件63.1%降至三人事件57.0%,MuVAP从67.5%降至59.4%,而保持或转换判断未变难,即第三人增加指名难度而非变化检测难度。结论仅适用于单摄像头单声道、两到三人在线对话、说话人不重叠的七视频测试划分和至多10秒间隙前上下文,被试为不见间隙本身的第三方观察者,短间隙因更接近下轮线索而更容易,平票多为三人打断或开放提问等情形尚未可靠验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://github.com/Haotian-Qi/AVCC — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
为什么机器人不能等到安静了再决定谁说话
日常对话中 1 次换人平均只有约 200 毫秒,比完整准备一句话所需的时间还短,听者必须提前感知边界甚至预判当前话轮何时结束。线索分散在韵律、句法和用词,以及注视、嘴部和头部动作里。双人对话只需判断当前人会不会停,3 人以上还多一层:在多个候选人里会是谁接。对话智能体和社交机器人如果要跟上人类节奏,就不能等静音出现再反应,必须在声音到来之前同时回答会不会换和换成谁。
论文把这两个问题分开命名。粗粒度的问题叫保持或转换判断:静音间隙之后是同一人继续还是换人。更细的问题叫下 1 位说话人预测:在 2 人或 3 人中点出具体下 1 位是谁。前者是二选一,后者 2 人时是二选一、3 人时是三选一。理解这个难度差别,是读懂后面所有按人数拆分结果的前提。
已有语料为什么对不上机器人的机位
此前轮流建模有两条路线。一条用注视、头姿、嘴动、呼吸等预测多人中的下 1 位,常在会议或实验室语料上做,依赖眼动仪、近讲麦克风或每人一个摄像头,且各自定义自己的轮次事件。另一条把轮流看作从语音信号出发的连续预测,从静音处的结束检测、声学和词汇模型,一直做到语音活动预测,即在每 1 帧预测每个说话人未来的有声状态,这条路线多在 Switchboard、Fisher 这类每人一路干净电话语音上训练和评测。
两条路线开始交汇:语音活动预测被扩展到 3 人、结合头戴传感器的注视,并被改写为只映射当前和下一话轮持有者,从而适用于任意人数。但论文指出,社交机器人最常见的是全组共用一个固定摄像头和一个单声道麦克风,这一设置下既没有公开基准,也没有统一的预测点,更没有人类在同样预测点上的表现作为参照。没有人类参照,就无法判断 65% 的正确率是接近信号上限还是远未达标。
论文要补的缺口:在相同事件上比较人与模型
论文要解决的具体问题是:给单摄像头加单麦克风的多人对话,提供可复现的下 1 位说话人预测基准,并给出人类在完全相同事件上的参照。输入是间隙出现之前的最多 10 秒音视频,输出是在间隙后的语音被 withheld 的条件下,判断保持还是转换,并在需要时点名。必须保留的信息是预测点之前的话语内容、韵律和可见的人脸动态,必须 withheld 的是间隙剩余部分和之后的话语,否则就变成事后识别而非预测。
保持 × 转换 × 下一位说话人预测: 保持指静音间隙之后还是上一位说话人继续说,转换指换人说,两者合起来是粗粒度的保持/转换判断;下一位说话人预测要求进一步在两人或三人中点出具体是谁,三人时它比只判断换不换人更难,因为还要在两个候选人之间二选一。
已有语料和同类语料的格局
论文用一张语料对比表说明位置。多数相关语料要么每人一路麦克风或多摄像头,要么只有主动说话人检测而没有在间隙边界上的保持或转换事件,要么只有音频双人或没有人类参照。例如会议语料有每人近讲麦克风和摄像头阵列,自中心视角语料每人一个摄像头且只给片段级说话标签,视频通话语料每人一路视频流,纯音频基准只有双人且无视频无多人。只有本文的 AVCC 同时满足单摄像头单声道、多人、文字转写、边界事件标签和同点人类参照。
下表摘录原表中的代表性行,比较问题是传感器设置与标注是否支撑机器人的预测任务,列含义与原文一致,传感器中 S 表示至多一个摄像头加一个音频通道,M 表示每人麦克风或多摄像头。
| Name | Spk | Sns. | Trans. | NSP | Hum. |
|---|---|---|---|---|---|
| AMI [4] | 3–5 | M | ✓ | – | – |
| EgoCom [29] | 3 | M | ✓ | ∼ | – |
| TurnBench [19] | 2 | S | ✓ | ✓ | – |
| AVCC (ours) | 2–3 | S | ✓ | ✓ | ✓ |
表中可见,满足 S 类传感器的已有语料在转写、事件标签和人类参照上都有缺失,而 AVCC 一行三项齐全。这张表不是同条件下的性能胜负,而是说明为什么需要新基准:输入条件和评测目标不同,直接比较正确率没有意义。
AVCC 语料是什么样的对话
AVCC 共 31 小时,来自 29 个公开在线视频,要求一镜到底、无剪辑、固定机位、所有说话人通常都在画面内、只有一条单声道。类型包括播客访谈、圆桌讨论和游戏解说。按每段视频中说话占比至少 5% 计为说话人,18 个视频为双人,11 个为 3 人。另有一个视频中第 3 人只说约 1%,9 个视频中有只闻其声不见其人的旁观者,标为 B 且不计入人数。长视频存为多个连续文件,事件的上下文窗口不跨文件边界。
从修正后的话音活动标签看,双人视频每分钟换人 14.3 次,3 人视频 16.4 次。最健谈者在双人视频中位占用 58% 的说话时间,3 人视频中位占用 50%。测试集按视频划分保证说话人不重叠,共 7 个视频,4 个双人 3 个 3 人,覆盖 3 种类型,但事件分布不均:一个双人视频贡献了 417 对中的 283 对,一个 3 人视频贡献了 448 对中的 229 对。这一点决定了总体数字受个别视频影响较大。
下表为语料划分与时长,时长按视频文件计量并四舍五入到分钟,比较问题是训练、验证和测试的数据量与视频数是否足以支撑划分。
| Subset | Videos | Duration |
|---|---|---|
| Training | 17 | 20h39m |
| Validation | 5 | 2h41m |
| Test | 7 | 7h41m |
| Total | 29 | 31h00m |
表中训练 17 个视频 20 小时 39 分,验证 5 个视频 2 小时 41 分,测试 7 个视频 7 小时 41 分,总计 29 个视频 31 小时。测试集说话人与训练和验证不重叠,这是评估泛化到新人能力的关键条件。
从人脸、语音到文字:标注流水线做了什么
人脸跟踪先用 InsightFace 做每帧检测和身份嵌入,再用匈牙利匹配分配到每视频的说话人身份,之后人工检查重叠人脸的身份交换、跨文件丢失和误检到照片上的框。语音活动先用 TalkNet 按默认阈值初始化,再用自研工具逐段手工修正。转写先对每个说话轮次用 Voxtral 转写并人工检查,非英语标为[foreign]、不可懂标为[unk],笑声不转写,再用蒙特利尔强制对齐器在限定片段内做词级对齐并手工纠错。
轮次事件的构造是理解评测的关键。同一说话人间隔至多 0.1 秒的词先合并为停顿间单元,再组成话语。候选事件必须是满足全部条件的共同静音间隙:原始间隙短于 3.0 秒,加 0.1 秒填充后仍剩至少 0.1 秒静音,间隙后 2.0 秒内下 1 位说话人至少说 1.0 秒且前 1.0 秒只有他 1 人活动,间隙内无笑声等杂音。保持事件多于转换事件,因此随机下采样保持事件至数量相等,测试集最终为 865 个保持和 865 个转换。
共同静音间隙 × 预测点 × 上下文窗口: 共同静音间隙指前后两段语音之间所有人都不说话的空隙,预测点设在上一位说话人最后一个词之后加 0.1 秒处,上下文窗口指预测点之前最多 10 秒的音视频;三者组合把预测固定在说话内容出现之前,只允许看间隙之前的线索,避免用未来的声音作弊。
读图说明:下面这张示意图把 1 次保持事件的时间结构画了出来,重点是预测点与被 withheld 部分的边界,读懂它才能明白人与模型看到的信息完全一致。
看图路径: 1. 找到上一位说话人最后一个词后 0.1 秒处的虚线预测点;2. 区分预测点之前最多 10 秒的阴影上下文和之后被 withheld 的间隙与语音;3. 确认这是一个保持事件的示意
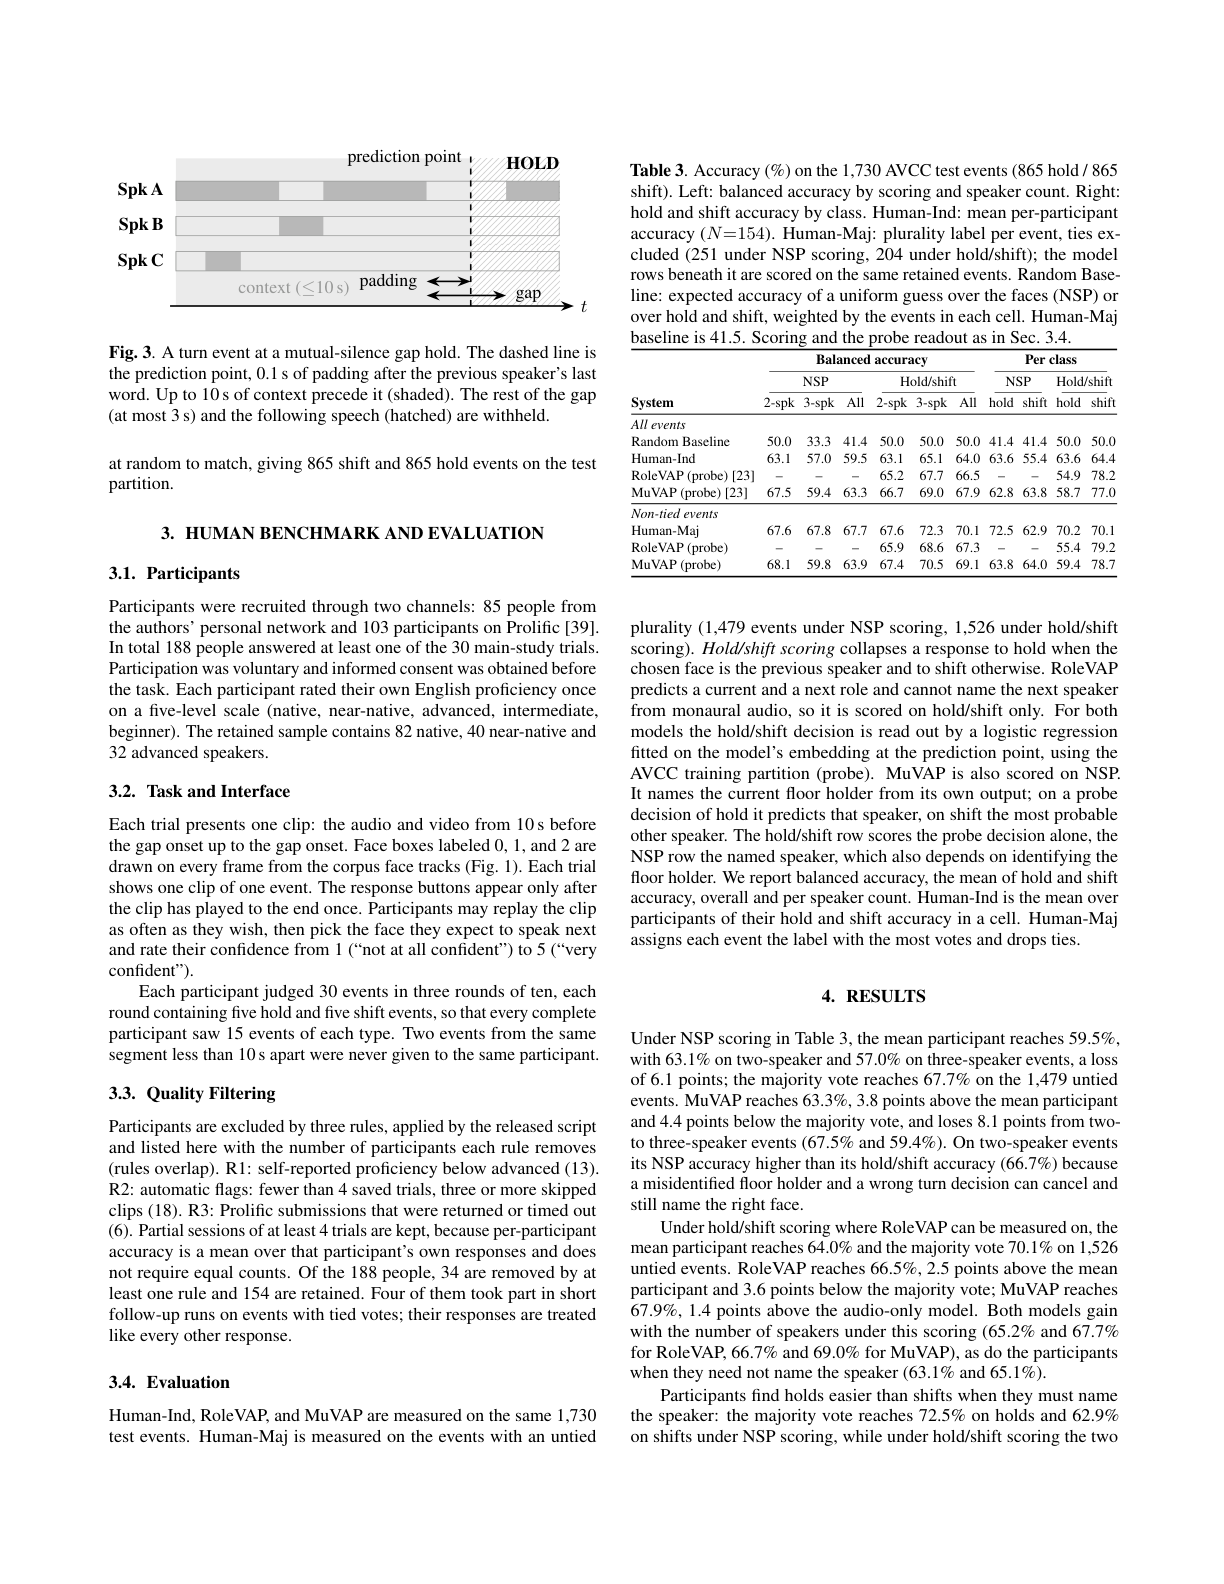
图片来源: 原论文 PDF 第 3 页(含图 3)
论文图 3。原论文 Figure 3::“A turn event at a mutual-silence gap hold.”。
图中虚线是预测点,位于上 1 位说话人最后一个词后 0.1 秒。虚线左侧最多 10 秒为上下文,是人与模型唯一可见的输入。虚线右侧的剩余间隙和之后的话语被 withheld,不给预测用。这种设计把任务固定为间隙起始时刻的前瞻预测,而不是听到下一个人开口后的识别。
两个基线模型各自吃什么输入、输出什么
纯音频基线是 RoleVAP,即角色相对的语音活动预测。它不再为每个具体人设输出,而是只输出当前角色和下一角色的未来语音活动,因此人数可变时同一模型可用。但在单声道下它无法点出下 1 位具体是谁,只能做保持或转换判断。它的保持或转换读出靠一个逻辑回归探针实现:在预测点的模型嵌入上拟合,用 AVCC 训练集训练。
多模态基线是 MuVAP,在 RoleVAP 基础上加入视频。它用语料的人脸轨迹等视觉信息,与音频一起预测。它既能做保持或转换,也能做点名:先用自身输出判断当前话轮持有者是谁,若探针判保持就预测此人,若判转换就选其他人中概率最高者。因此点名正确率同时依赖探针判断和当前人识别,论文报告当前人识别在 93.4% 的事件上正确,点名损失主要不在认错当前人。
语音活动预测 × RoleVAP × MuVAP: 语音活动预测指在每一帧预测每个说话人未来是否会出声,RoleVAP 把它改写为只预测当前角色和下一角色,适用于任意人数但在单声道下点不出具体人名,MuVAP 在此基础上加入视频的人脸轨迹等视觉线索,既能做保持/转换判断也能点名下一位说话人。
本研究训练了什么、冻结了什么、探针怎么拟合
本研究没有从零训练新的大规模预测网络,而是沿用已有 RoleVAP 和 MuVAP 主体,并为评测拟合读出层。论文明确说明保持或转换决策由逻辑回归在预测点嵌入上读出,用 AVCC 训练集拟合得到探针。原文没有披露该探针之外的梯度路径、冻结细节、学习率或优化步数,因此不能从模型名称推测训练实现。
探针 × 当前话轮持有者识别: 探针指冻结模型主体,只在预测点的嵌入表示上拟合一个逻辑回归来读出保持还是转换;当前话轮持有者识别指 MuVAP 先用自身输出判断现在是谁在拿话轮,探针说保持就沿用此人,说转换就选概率最高的另一人,点名错误可能来自探针也可能来自认错当前说话人。
复现意义在于:主体沿用公开模型,探针拟合脚本随论文发布,任何人在同一训练划分上运行脚本应得到同一读出。这也意味着模型比较的是在相同读出协议下的表示能力,而不是端到端重训后的最优性能。若更换探针形式或训练数据,结果会变化,论文数字只在该探针协议下成立。
人类基准怎么做才能和模型看到同一时刻
人类试验共 188 人至少回答一题,来自作者熟人网络 85 人和 Prolific 平台 103 人。每人看 30 个事件,分 3 轮每轮 10 个,保持和转换各半,同一人的两个相隔不足 10 秒的同片段事件不会分给同一人。每题只给间隙起始之前的最多 10 秒音视频,画面每帧画出来自语料人脸轨迹的 0、1、2 编号框。按钮在完整播放一遍后才出现,可反复回放,然后选择预期下 1 位并按 1 到 5 评价自信度,1 为完全不自信,5 为非常自信。
质量过滤由发布脚本执行且规则重叠:自评英语低于高级去掉 13 人,保存试验少于 4 个或跳过 3 个以上去掉 18 人,Prolific 退回或超时去掉 6 人,共去掉 34 人保留 154 人。保留样本中 82 母语、40 近母语、32 高级。保留不少于 4 题的部分会话,因为逐人平均是每人自己回答上的平均,不要求题数相等。另有 4 人参加了平票事件的短补测,回答与其他回答同等对待。
读图说明:下面是被试实际看到的作答界面,观察编号框与作答按钮的对应关系,有助于理解点名任务对 3 人视频意味着什么。
看图路径: 1. 先看左侧视频区三张人脸上的 0、1、2 编号框;2. 再看右侧先选下一位说话人、再选 1 到 5 自信度的两步作答;3. 注意顶部 10 秒上下文和结束于预测点的提示

论文图 1。原论文 Figure 1::“The study interface. Participants watch a clip of up to 10 s with face labels (0, 1, 2 for three-speaker clips) drawn on every frame, then choose the next speaker and rate their…”。
图中左侧 3 人同桌吃饭,每张脸上有绿色编号框 0、1、2,顶部提示 10 秒上下文并结束于预测点。右侧先点 3 位中的 1 位,再点 1 到 5 自信度,最后保存。像素可见的细节是编号直接画在人脸上,被试不需要记忆人名,只需把视觉身份与按钮对应。这种设计使人类与 MuVAP 使用同一套人脸身份,避免因认人方式不同引入额外差异。
逐人平均 × 多人投票: 逐人平均指先算每个人在自己看到的事件上的保持与转换平均正确率,再对 154 人取平均,反映一个普通观察者的水平;多人投票指每个事件取票数最多的答案并去掉平票事件,反映群体智慧的上限;两者对比可以看出模型是超过了个人还是接近了群体。
总体正确率:模型落在个人与群体之间
评测指标是平衡正确率,即保持正确率与转换正确率的平均,方向是越高越好。随机猜测在双人点名下期望 50%,3 人点名下 33.3%,保持或转换二选一为 50%。人类逐人平均在 1730 个事件上计算,多人投票去掉平票后计算,点名下去掉 251 个平票剩 1479 个,保持或转换下去掉 204 个剩 1526 个,模型与投票比较时在相同保留事件上重算。
下表整理原文报告的总体平衡正确率,比较问题是在相同事件和相同计分下,纯音频、音视频与人类个人、群体各处什么位置。单位为%。
| 系统 | 点名全部 | 保持/转换全部 |
|---|---|---|
| 逐人平均 | 59.5% | 64.0% |
| RoleVAP 探针 | – | 66.5% |
| MuVAP 探针 | 63.3% | 67.9% |
| 多人投票 | 67.7% | 70.1% |
点名计分下逐人平均 59.5%,MuVAP 为 63.3%,高出平均 3.8 个百分点,低于投票 4.4 个百分点。保持或转换计分下逐人平均 64.0%,RoleVAP 为 66.5%,MuVAP 为 67.9%,视频相对纯音频带来 1.4 个百分点的提升。多人投票分别为 67.7% 和 70.1%。结论成立条件是测试集保持与转换各 865 个且平衡平均,探针在训练集上拟合,投票只在未平票事件上计算。若改用非平衡总体或纳入平票,数字会变化。
人数与类别拆分:难在三人中选出具体是谁
按人数看,点名时逐人平均双人 63.1%、3 人 57.0%,下降 6.1 个百分点,MuVAP 双人 67.5%、3 人 59.4%,下降 8.1 个百分点。但保持或转换计分下两者都随人数上升:逐人平均双人 63.1% 到 3 人 65.1%,RoleVAP 双人 65.2% 到 3 人 67.7%,MuVAP 双人 66.7% 到 3 人 69.0%。这说明多一个人并没有让换不换更难判断,而是让具体点名更难。MuVAP 在 3 人转换中点对 incoming 者为 57.4%,且当前人识别已达 93.4%,仅靠认对当前人点名只从 63.3% 升到 64.4%,损失集中在两个候选人之间的选择。
按类别看,点名时投票保持 72.5%、转换 62.9%,人更擅长保持。保持或转换计分下模型相反:RoleVAP 保持 54.9%、转换 78.2%,MuVAP 保持 58.7%、转换 77.0%,模型偏向预测转换,靠人们漏掉的转换领先,却在人们做对的保持上落后。MuVAP 点名下保持 62.8%、转换 63.8% 则基本持平。双人点名下 MuVAP 为 67.5% 反而高于其保持或转换的 66.7%,因为认错当前人与判错轮转可能相互抵消仍点对人脸。
读图说明:下面按自信度拆分逐人正确率,左图看保持与转换曲线形状是否相同,右图重点核对自信度 1 分时双人折线与 50% 虚线的相对位置,以及柱子代表的人数。
看图路径: 1. 左图对比保持曲线随自信度上升、转换曲线平坦的差异;2. 右图对比自信度为 1 时双人绿色折线位置与 50% 虚线的距离;3. 注意柱子表示每个自信度档位实际贡献的人数

论文图 4。原论文 Figure 4::“Per-participant accuracy by self-reported confidence.”。
左图保持随自信度从 1 分的 43.2% 升到 5 分的 85.0%,转换在 2 到 5 分只在 51.5% 到 60.1% 之间且峰值在 4 分而非 5 分。右图需要指出一处正文与像素的不一致:正文文字报告自信度 1 分时双人 52.8%、3 人 35.6% 并称两者都接近各自随机线,但在本次收到的右图像素中,绿色双人折线在自信度 1 处约为 61%,明显高于 50% 虚线,并不接近随机水平,而紫色 3 人折线在 1 处约 32%,才接近 33% 虚线。5 分时两者都超 75% 则与像素一致。可见被试对保持的自信度有指示意义,但对转换的自信度几乎不携带信息,低自信标出了人们自己也无法决定的事件,而那些多为转换。未胜出项是模型在保持上的落后和 3 人点名的选择困难,这正是基准最有用的区间。
哪些结论出不了这个评测条件
被试是只看至多 10 秒片段的第三方观察者,在间隙起始处作答,看不到也听不到间隙内部。任何出现在间隙内的线索都对人不可用,包括 incoming 者开口前瞬间的快速视觉动作。这使短间隙相对容易,因为预测点离下一轮更近,更多下 1 位说话人的线索落在可见上下文里。
投票在点名下 251 个事件平票,其中 151 个是转换、145 个来自 3 人视频,多为抢话或向群体抛出的开放问题,音频和前文都不指定人选,唯一线索是间隙前瞬间 incoming 者的起动,而该线索常在被 withheld 的间隙里。因此人类数字是无间隙内部信息条件下的参照,不能直接推广到能看到间隙的在线系统。
此外测试事件集中在少数视频,一个双人视频占双人对中 283 对,一个 3 人视频占 3 人对中 229 对,总体数字受这两个视频主导。保持经下采样至与转换相等,真实对话中保持多于转换,非平衡下的应用表现需要重新加权评估。
要复现数字第一步做什么
复现第一步是按视频划分取到 7 个测试视频的 1730 个事件,并用发布脚本重走标注到事件筛选的全部阈值:词间隔 0.1 秒合并、间隙短于 3.0 秒、填充 0.1 秒后仍剩 0.1 秒静音、后 2.0 秒内至少 1.0 秒语音且前 1.0 秒单人活动、无笑声杂音。文字转写和强制对齐脚本、事件抽取脚本和人类数据及重算脚本随论文发布,原文称标签、转写、逐题人类数据和复现每个数字的脚本已发布。
模型侧用训练集拟合逻辑回归探针,在预测点嵌入上读出保持或转换,MuVAP 再按保持沿用当前人、转换选最高概率他人完成点名。人类侧按保留 154 人、去掉平票的规则分别计算逐人平均和投票。来源方面,本次仅确认论文提到的代码链接可达,第三方托管不证明作者已开源,是否作者资源当前可用需以作者声明和可用性为准。核对时注意平衡正确率是两类平均,百分点差值不是相对百分比,点名与保持或转换是两种计分,不能混用。
什么时候值得用这个基准、还缺什么验证
当你的系统也是单固定摄像头加单麦克风、面向双人或 3 人自然对话,且需要在间隙出现前预判时,这个基准值得尝试。它提供了说话人不重叠的测试集、词级转写和同点人类参照,适合检验声学、词汇和视觉线索的增量。已有证据支持的结论是:当前模型已超过单个观察者,距群体投票还有 1 到 4 个百分点,差距主要在保持上;3 人难在点名而非检测变化;视频相对纯音频在保持或转换上带来约 1.4 个百分点的提升。
还需补的验证包括:非平衡自然分布下的表现、跨视频稳定性和长间隙下利用间隙内部视觉线索的在线预测。若你的场景允许看到间隙内部或有多摄像头多麦克风,本文数字不直接适用,需要在对应输入条件下重测。下一步可聚焦 3 人转换中二选一的候选人区分,以及减少对转换的过度预测,同时不损失在转换上的优势。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses