📄 Alania-2:土耳其语语音合成如何读对数字并克隆声音
英文题目:Alania-2: Turkish text-to-speech with instant and fine-tuned voice cloning
评分:7.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
👥 作者与机构
- Sezgin Saygili:机构信息未能在本次解析中与作者逐人可靠绑定
- Emre Kaplaner:机构信息未能在本次解析中与作者逐人可靠绑定
- Oncel Ozgul:机构信息未能在本次解析中与作者逐人可靠绑定
- Fikri San Koktas:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
Alania-2处理土耳其语文本到语音合成,输入书写土耳其语文本,输出48 kHz连续音频,用于电话语音助手和长篇朗读。实际难点是数字、金额、日期和外来品牌名读出时须展开并接上符合元音协调的格后缀,带点与不带点i易被按英语设计的大小写转换破坏,且电话场景要求低延迟和稳定音色。先由文本改写模块把数字、金额、日期、缩写和外来名改写为说话人实际会说出的词语序列并调整后缀元音,再把改写后文本送入语言模型主干结合扩散变换器逐块预测声学隐变量,最后由冻结音频变分自编码器解码为音频。与延续参考音频的克隆做法不同,该系统只用参考音频设定音色而不给出其转写文本,从而避免长参考导致的跳词,20–30秒参考效果最好,专业克隆再以低秩适配器微调提升音色相似度。经由应用编程接口,Alania-2在公开的Freya-TR-Eval基准495句上达到1.44%词错率,相对上一代系统的5.99%词错率明显下降。无改写器时96个含数字句无一句关键金额或日期完整保留,有改写器时86句保留;仅以参考音频为条件把跳词从21.9%降至1.7%。原文披露约210 H200小时用于模型训练且不含数据生成,推理侧单流首包音频在工作机上可低至32 ms。适用范围集中在土耳其语固定文本朗读和短参考克隆,尚未经多听众主观听音测试,自然度仅以英语训练的UTMOS22衡量。
🔗 开源与复现资源
第三方资源:https://huggingface.co/cloud0day3/antalia-mini — 链接可访问(HTTP 200)
数据相关资源:https://huggingface.co/datasets/cloud0day3/alania-speech-captions-tr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/cloud0day3/alania-synthetic-speech-tr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/cloud0day3/alania-domain-text-tr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/PatientdeskAI/freya-tr-eval-rerun — 链接可访问(HTTP 200)
第三方资源:https://speech.patientdesk.ai → https://speech.patientdesk.ai/en — 链接可访问(HTTP 200)
第三方资源:https://github.com/SYSTRAN/faster-whisper — 链接可访问(HTTP 200)
第三方资源:https://github.com/cmusphinx/cmudict — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
土耳其语语音合成要解决什么输入和输出问题
这篇论文做的是土耳其语文本转语音,输入是一句土耳其书面语,输出是 48 kHz 的语音波形,目标是电话语音助手和长篇 narration。必须保留的信息不只是字面发音,还包括金额、剂量、日期、电话号码和人名品牌名等关键片段,一个数字读错就可能误事。
土耳其语的难点在于写法和说法差距大。数字、日期、货币、百分比后面还要接符合元音和谐的土耳其后缀,比如 750 TL’dir 要变成 yedi yüz elli liradır;大写转换若按英语规则会把 Iğdır 中的 dotted 和 dotless i 搞混;一些英文品牌名若按土耳其拼读规则硬读会含糊不清。论文还指出,土耳其语在近年以英语中文为主的零样本合成模型里只是多语言中的一种,可懂度差异可达一个数量级。
读者可以这样理解任务边界:模型要读对普通句子,也要在流式电话场景下低延迟出声,还要提供稳定的内置音色和用户可自助使用的声音克隆。前代 Alania-1 在 Freya-TR-Eval 上约十七个词错一个,说明只靠大语言模型加音频编码器并不能自动解决土耳其语的朗读问题。
已有路线为什么没有直接解决土耳其语朗读
论文把相关工作分成 3 条线来定位自己。第一条是零样本合成与克隆:编解码器语言模型靠延续一段短音频提示来克隆,CosyVoice 结合语义 token 与流匹配,F5-TTS 去掉显式对齐,VoxCPM 则不用离散语音分词器,直接用语言模型主干加扩散解码器预测音频变分自编码器的连续隐变量。Alania-2 沿用的是 VoxCPM2 的架构、分词器和音频变分自编码器,但权重是自己从随机初始化训练的。
第二条是土耳其语专用系统:有用哈萨克语 Tacotron 2 经国际音标映射到土耳其语的,也有 183M 参数的 FreyaTTS 及其 Freya-TR-Eval 基准。第 3 条是数据与评测工具:真实语音来自 YouTube 多语言语料 YODAS,用 VoxLingua107 训练的语言分类器、AST 音频标签器、DNSMOS 质量预测和 Whisper 识别来过滤;评测沿用 Whisper 测可懂度、UTMOS 测自然度、ECAPA-TDNN 声纹向量测说话人相似度。
这样对比的条件是相同的:都是把文字变成可听语音,都要在土耳其语句子上测可懂度。区别在于输入处理和运行阶段不同,有的系统依赖英语式文本,有的需要音素输入,有的只做单音色。论文没有把类别差异直接说成同条件胜负,而是先在 120 个土耳其提示上比较架构,再在同一评测协议下重跑 15 个系统。
论文把大问题拆成哪几个可验证的小问题
论文要回答的不是一句做好土耳其语合成,而是 6 个可测的问题。第一,中资源语言缺高质量、大覆盖的土耳其语音时,能否用 90% 合成语音训练出可用的 488M 参数模型。第二,数字缩写外来词必须的改写规则怎么做,是否真能保住金额日期等关键片段。
第三,在同一识别器和同一评分规则下,Alania-2 与另外 14 个系统相比可懂度排在哪里。第四,模型参数量是否决定可懂度,为此同时试了继续训练 2.3B 参数大模型和只用 7.6M 参数的单音色小模型。第五,即时克隆为什么会跳词,参考音频多长合适,低秩适配器微调能否快速提升相似度。第六,推理引擎如何把首包音频压到几十毫秒,并让多个微调音色共用一个基座模型。
每个问题都有明确的测量对象:关键片段保留率、词错误率和字错误率、说话人余弦相似度、首包延迟和实时率。这种拆分让读者能逐项复述步骤和条件,而不是只记住一个总分。
从一句话到一段语音要经过哪两大步
整个流程分两大步,先改写文字,再生成音频。举例来说,输入 750 TL’dir 不会直接送模型,而是先被文本正则化器改成 yedi yüz elli liradır 这样的说话词,包括数字展开、货币单位换算和后缀元音调整;然后模型按请求的音色生成 48 kHz 音频,可以是内置音色、文字描述设计的音色、即时克隆或专业克隆。
下面的总览图把这个顺序画得很直接,左边是书面输入,中间是改写和生成,右边是波形,理解时先看主路径再看音色条件从哪里进入。
看图路径: 1. 先从左到右看文字到音频的主路径;2. 注意第一个方框是改写步骤,中间大框是生成模型;3. 看输入例子 750 TL’dir 如何变成口语再变成波形
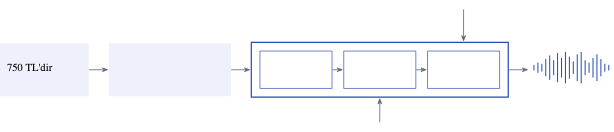
论文图 1。原论文 Figure 1::“Overview of Alania-2. Text is first rewritten into the words a speaker would say (Section 4); the model then generates 48 kHz audio in the requested voice (Sections 5 and 8).”。
这张图确实可见的是从左向右的 3 个阶段:最左浅色框写着 750 TL’dir,中间经过改写框和一个包含 3 个子块的大框,最右是声波形状。它帮助理解论文的分工:可懂度的很多功夫在第一步改写,音质音色和延迟的功夫在第二步生成与 serving,模型本身只读改写后的口语词。
文本正则化器把写法变成说法的具体规则
Alania-2 本身只读土耳其拼写,没有音素输入,所以数字、货币、日期、时间、区间、电话号码、剂量、单位、头衔、地址和符号都要先改写。规则展开数字后再把原来跟在后面的土耳其后缀接回去,并按元音和谐调整元音。缩写一般按土耳其字母名连读,少数借词用英语字母名;全大写词先按土耳其规则转小写,再把残留的 I 变成ı、İ变成 i,避免把 Iğdır 读成 iğdir。
外来词处理有一个词频门槛:在 220,000 词土耳其词表背后文本中出现至少 1000 次的词保持原样,否则若有内部大写或是纯 ASCII 且出现在 CMU 发音词典中又不在词表里,就按词典发音用土耳其字母重拼。这些自动重拼没有经过母语者逐条审核,但 100 个品牌英文词中经试听建了一个 17 个重拼、77 个不变的词表,用户也可自加词条。
文本正则化 × 语言模型主干: 文本正则化负责把 750 TL’dir 这类写法改成 yedi yüz elli liradır 这样的口语词,解决语言模型主干只认识土耳其拼写、不认识数字符号的问题;主干只接收改写后的词序列,再去预测音频,两者搭配让数字金额日期能被读出来,而不是跳过或读错。
下面这张原表给出了改写实例,比较问题是同一书面形式在送模型前应该变成哪串口语词,公平条件是都按当前正则化器版本改写。
| Case | Written | Spoken form given to the model |
|---|---|---|
| Money with a suffix | 750 TL’dir | yedi yüz elli liradır |
| Decimal amount | 12,50 TL | on iki lira elli kuruş |
| Percentage with a suffix | %2,5’lik | yüzde iki buçukluk |
| Borrowed initialism | CEO | siio |
这张表说明改写不是简单的数字转文字,还包括金额后缀、百分比后缀和品牌重拼,比如 CEO 变成 siio、ChatGPT 变成Çet Ci Pi Ti。它的限制是论文明说大部分预期说法的母语审核只覆盖了 134 个书面形式中的一部分,长尾品牌和地址仍可能不准,实验结论只在所测的诊所客服风格句子上成立。
语言模型主干加扩散头如何一次生成 0.16 秒音频
模型沿用 VoxCPM2 的分词器和冻结的音频变分自编码器,该编码器把 16 kHz 音频编码成每秒 25 帧、每帧 64 维的隐变量,再解码到 48 kHz。语言模型主干读入文本和已生成的隐变量,扩散变换器每次预测接下来一个包含 4 帧隐变量的块,对应 0.16 秒音频,用 10 步流匹配加无分类器引导生成。论文选择该架构的依据是在 120 个土耳其提示、每提示两种子共 240 次生成上,零样本 VoxCPM2 可懂度最高、UTMOS 自然度最高、同一音色多次生成之间最一致,且不像 Alania-1 那样在 7.5% 的生成中读到文本结束后还不停。
语言模型主干 × 扩散解码头: 语言模型主干负责读文本和已生成的音频隐变量,理解读到哪里和用什么声音;扩散解码头负责在主干给出的条件下,用 10 步流匹配一次生成 4 帧音频隐变量,两者分工是主干定方向、扩散头画波形,组合后才能从离散文字得到连续 48 kHz 声音。
参数分布上主干占大头,残差语言模型、特征编码器和扩散解码器分担对齐与声学细节,总量 488M,不含冻结的音频编解码器。论文同时试过 1.24B 参数从零训练的变体,在 54k 步内始终没有学会文本音频对齐,字错误率停在 0.84 到 0.88,而 488M 模型学会了,这说明在此数据配方下盲目放大并不自动带来对齐。
内置音色是设计的、不是真人录音,每个音色存一段参考音频、平均声纹向量和基频区间,女声 199.6 到 238.6 Hz,男声 109.1 到 131.6 Hz, serving 时用基频区间剔除漂移的生成。风格控制来自带标题的训练行,初期模型会把土耳其语指令直接朗读出来,后来把每条指令用小语言模型改写成短英文标签,54 次测试全部干净。
18195 小时训练数据和三阶段训练是怎么搭的
训练数据分两层。真实语音从 YODAS 土耳其部分的 38494 个录音、9216 小时起步,先切分、做语言鉴别和 Whisper 校验,用 AST 去掉音乐 singing,剔除削波和窄带,保留 DNSMOS 至少 2.4 的片段,再用自研土耳其识别器 Duyu 重转写,最后剩 2398 小时、835267 段,中位长 9.9 秒;训练时再加严过滤,去掉低分、与 YouTube 字幕不一致和语速不合理的,剩 1772 小时、598213 段,来自 19969 个说话人聚类。每段用 Qwen3-32B 写一句风格标题,描述说话人和表达。
合成语音用 VoxCPM2 以 10 步扩散、引导系数 2.0 生成,一张 H100 每秒产 83 秒音频。文本来自 FineWeb2 占 40%、Qwen3 写的领域句占 25%、维基占 22.5%、YODAS 转写占 12.5%,去重后 565 万剩 518 万单元。说话人是两个内置音色加 2752 个设计音色库,77% 是延续参考生成,20% 是参考加英文风格指令,3% 是纯文字设计,约 22.5% 再过模拟房间麦克风噪声编解码器。每段合成都要过可懂度、语速、音色匹配、自然度和基频五道关,人工抽查 681 段通过率 79.2%。
训练分 3 段:先在早期 8904 小时混合上约 64k 步,再在 18195 小时基混合上 70k 步,批量每卡 32、梯度累积 2、学习率 1e-4、权重衰减 0.05,最后在设计与风格数据上以 5e-5 学到 4000 步停,总计约 210 个 H200 GPU 小时,不含数据生成。第二阶段混合有 1,400,000 行,含设计描述、改写短描述、风格指令行和 40 万保持基行为的普通行。
用什么句子、识别器和指标来比 15 个系统
主评测是公开的 Freya-TR-Eval,495 句土耳其书面语,每句 3 到 13 词,文件本身不含数字符号缩写和大小写混杂品牌名,所以不考察文本正则化。论文重跑了 15 个系统统一协议:每句读三遍,音频限带到 8 kHz 再重采样到 16 kHz,用 faster-whisper large-v3 以束宽 5 转写,再用基准自带的文本正则化评分,同时在全频带音频上报 UTMOS22,在单张 L4 上测实时率。还单独放了不带 serving 检查的裸 Alania-2 做参照。
词错误率 × 说话人相似度: 词错误率是用 Whisper 把合成音频转写后再和原文比错了多少词,衡量是否读对;说话人相似度是用 ECAPA-TDNN 提取合成音频和保留录音的声纹向量再算余弦相似,衡量是否像同一个人,前者管内容保真,后者管音色保真,克隆实验必须同时看两者。
可懂度看词错误率和字错误率,越低越好;自然度看 UTMOS22,越高越好,但它是在英语上训练的预测器,只能参考;说话人相似度看 ECAPA 向量余弦,越高越像。论文每次报可懂度都点名识别器,因为换识别器或换评分正则化结果会变。正则化器本身的测试是另一套 150 句诊所客服风格构造句,含数字日期单位电话缩写品牌地址,用 Duyu 转写,看词错误率和关键片段保留率,没有做多人听音。
下面是合成数据质检的原表,比较问题是每段合成音频在入库前必须同时满足哪些门槛,条件是对每段都全检。
| Check | Measured with | Threshold |
|---|---|---|
| Intelligibility | CER, faster-whisper large-v3 | ≤ 0.05 |
| Speaking rate | characters per second | 7–25 |
| Naturalness | UTMOS22 | ≥ 2.5 |
| Pitch | median F0 | consistent with the voice’s gender |
这组门槛相当严:用 faster-whisper large-v3 算字错误率不超过 0.05,每秒 7 到 25 字符,ECAPA 与参考的相似度至少 0.45、有风格指令时至少 0.35,UTMOS22 至少 2.5,基频中值与性别一致。代价是约两成生成被丢掉,好处是留下的 16423 小时合成语音加 1772 小时真实语音构成 90% 合成的基混合。限制是同一批识别器既参与建数据又参与评测,可能带来乐观偏差,论文在局限中承认了这一点。
在公开基准上 Alania-2 读对了多少词
先看读图任务:下图是 15 个系统的词错误率条形,越短越好,蓝色是作者自己的模型。观察时先找最短的两根,再找第七位的 Alania-2 API 版,最后看裸模型与带重试 serving 之间的微小差距。
看图路径: 1. 从上到下看 15 个系统的词错误率条形由短到长;2. 找到深色标注的 Alania-2 和 Antalia-2 Mini 的位置;3. 比较第七名与前两名之间十分之几点差距的含义
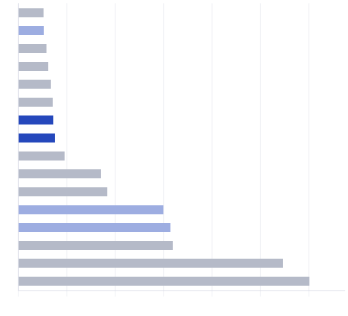
论文图 5。原论文 Figure 5::“Freya-TR-Eval word error rate (495 sentences, three readings each, faster-whisper large-v3).”。
这张像素图确实可见的是一列从上到下逐渐变长的横条,顶部几条最短,底部两条明显更长,深色条中有一条位于中上部,对应图注所说的第 7 名。它帮助理解的不是谁绝对第一,而是差距量级:前几名之间只有零点几个百分点的摆动,而这在三遍朗读的波动范围内。
数字上,经 API 的 Alania-2 词错误率为 1.44%,裸模型 1.51%, serving 检查和重试带来 0.07 个百分点的改善;前 2 名是 8.6M 参数的 EMA Lightning 的 1.04% 和 7.62M 的 Antalia-2 Mini 的 1.05%,论文未跑的 ElevenLabs v4 作者报告 1.43%。与 Alania-1 相比,词错误率从 5.99% 降到 1.44%,约 4 倍,字错误率从 1.81% 降到 0.28%,约 6 倍,UTMOS 从 3.19 升到 3.67,实时率在 L4 上从 2.49 降到 0.151。结论成立的条件很明确:495 句无数字无缩写的 plain 句、三遍、用 Whisper large-v3 评分;一旦进入含数字的 150 句测试,不用正则化器时词错误率高达 66.7%,用后降到 6.4%,含数字的 96 句中关键片段全保留的从 0 句升到 86 句。
参数量大三百倍是否更懂土耳其语
论文用两组对照说明参数量不是可懂度的决定因素。第一组是自己训的:继续训练 2.3B 参数 VoxCPM2 只比 488M 的 Alania-2 在内置音色上好 0.3 到 0.5 个百分点字错误率,但在风格指令、自然度和英语参考克隆上仍有优势;1.24B 从零训练则根本没对齐。第二组是跨系统:在 13 个有公开参数量的系统中,词错误率与参数量在双对数图上没有趋势,最懂的三家横跨 7.6M 到 2.4B,而 3.3B 的 Alania-1 反而比 488M 多错 4 倍多词。
下表是 292 段自测集上的对照,比较问题是在相同提示、单种子、Whisper large-v3 下,不同尺寸和训练方式的字错误率与吞吐如何权衡,指标方向是字错误率越低越好、每秒请求数越高越好。
| Model | Training | Female | Male | UTMOS ↑ |
|---|---|---|---|---|
| VoxCPM2, zero-shot | released | 2.7 | 2.9 | 3.77 |
| Track 1, round 2 | continued | 2.4 | 2.3 | 3.73 |
| Alania-2 | scratch | 2.7 | 2.8 | 3.57 |
结果上 488M 在女声 2.7%、男声 2.8%,与 2.3B 的 2.4% 和 2.3% 只差半个点以内,但单卡 H200 上约 99% 流能跟上实时请求的速率是 12 对 8,多 50%。更小的 Antalia-2 Mini 只有 7.62M 参数,声学模型 3.69M 加声码器 3.93M,用约 1790 小时单音色合成语音加同一正则化器,在 Freya 上做到 1.05% 词错误率、0.20% 字错误率,接近其教师 VoxCPM2 同音色的 0.92% 和 0.20%。代价是小模型只有一个音色、无克隆设计和风格控制,自然度 3.25 低于 3.67。论文的推断是数据配方决定下限读对,额外参数买的是灵活性而非准确率,但该推断只在 plain 句基准上验证过。
即时克隆 × 专业克隆: 即时克隆是在请求时用 3 到 30 秒参考音频设定音色,不改模型权重,方便但相似度有限;专业克隆是在 80 秒到 5 分钟语音上为该说话人训练一个 rank-32 低秩适配器,只改小量外挂权重,相似度更高但需要两三分钟训练,两者共用同一个基座模型,按需选择速度还是像真度。
克隆时参考音频应该怎么给、给多长
即时克隆的失败模式很具体:延续参考模式在 20 秒以上参考时跳过约一半文本,常整块丢失,错误的参考转写在任意长度都有同样效果。改成仅参考条件加分块检查后,200 条 121 到 249 字符的流中跳词从 21.9% 降到 1.7%,干净参考上降到 0.18%,说话人相似度在干净参考上 0.569 对 0.568 基本不变,近静音块从 45 个降到 0,块间最长停顿从 1.04 秒降到 0.37 秒。
下图对比修复前后,越低越好,观察时先看灰色高柱再看深色矮柱,注意困难参考下仍有残留。
看图路径: 1. 对比每组中修复前灰色高柱与修复后深色矮柱;2. 注意跳词、静音块和拼接停顿三类指标都下降;3. 区分干净参考和困难参考下的剩余误差
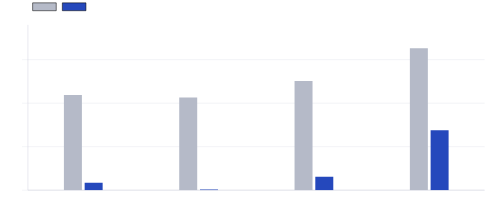
论文图 7。原论文 Figure 7::“Streamed instant clones before and after the fix; lower is better.”。
像素上可见的是 4 组柱状,每组左侧灰柱很高、右侧深柱很矮,最后一组深柱略高,说明专业场景的噪声混响仍会留一些误差。它支持的判断是跳词主要来自延续前文的机制,而非音色条件本身。
参考时长上,仅参考模式在 5 秒相似度 0.56,20 到 30 秒升到 0.64 到 0.67,60 秒字错误率 0.47、120 秒 0.90 而崩坏;延续模式 20 秒已不可用。选录音中最干净的 20 秒比取前 20 秒好,相似度 0.672 对 0.637。论文因此只收 3 到 30 秒、推荐 20 到 30 秒,长上传自动选最干净的 20 秒窗。另一张曲线图把随参考增长的稳定性画了出来,30 秒是分界。
看图路径: 1. 看左图错误率随参考时长在 30 秒后如何抬升;2. 看右图相似度在 20 到 30 秒附近达到高点;3. 对比两种使用参考方式的曲线分叉位置
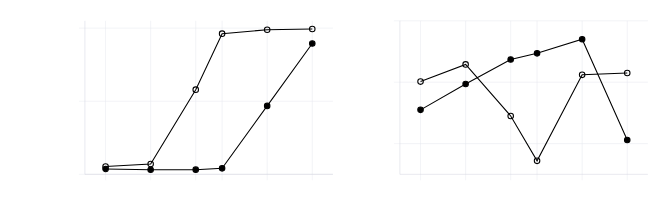
论文图 8。原论文 Figure 8::“Instant clones as the reference grows, using the first N seconds of each recording. Reference-only mode is stable up to 30 s.”。
这张双面板折线确实可见左图两条线在 30 秒后上扬,右图相似度先升后在长参考处分化,它帮助记住不要贪长。专业克隆用 rank-32 低秩适配器同时作用于主干和扩散解码器,80 秒语音训 200 步、5 分钟线性加到 400 步,单张 A100 上 84 到 126 秒训完,整 job 3 到 4.5 分钟;上线条件是保留 10% 语音上相似度至少涨 0.02 且字错误率不超过 max(0.05,1.5c)。引擎端四说话人乘五文本乘 3 种子的对照如下,比较问题是同一批克隆在参考实现与自研引擎上是否一致。
| Path | Instant clone | Professional clone |
|---|---|---|
| Reference implementation | 0.651 / 0.019 | 0.770 / 0.026 |
| Our engine | 0.659 / 0.019 | 0.772 / 0.028 |
| Our engine, mixed batches | 0.676 / 0.023 | 0.780 / 0.026 |
结果上自研引擎与参考实现几乎一致,即时约 0.65、专业约 0.77,混合批量下专业到 0.78,字错误率都在 0.02 上下。限制是英语录音克隆到土耳其仍弱,第二阶段前 Alania-2 只有 0.41,Track 1 有 0.64;且 580 秒大训练量反而不如 78 秒同人,说明录音 session 一致比时长更重要。
延续参考 × 仅参考条件: 延续参考是把参考音频加文字转写放在新文本前面让模型往下接,模型容易把长参考当成要继续的故事而跳过新文本;仅参考条件是只用参考音频定音色、不给转写,模型只管读新文本,两者对比说明去掉转写前文能大幅减少跳词而不损失说话人相似度。
哪些结论还没有多人听音和独立验证
论文自己列了 4 类缺口。第一,自然度只有英语上训练的 UTMOS22 和 1 位母语者的盲听,架构选择和内置音色选择都依赖这 1 位听音,没有多听音者测试。第二,可懂度依赖识别器和评分正则化,而同一批识别器也参与了数据构建,存在循环乐观的可能。
第三,ECAPA 相似度在 0.05 以下的差异不应过度解读,因为一条风格指令就能把与 plain 音色的相似度从 0.91 拉到 0.64 到 0.80。第四,多数结果是单种子或单次运行。模型层面,90% 训练音频来自 VoxCPM2,继承了教师的韵律和伪影,包括某些音色窄带高频音,数据端过滤了但 serving 端还没压住;基训练文本是在母语审核前版本正则化的,所以模型没见过现在的全部读法,包括所有品牌重拼。
这些缺口不是说技术不行,而是说结论的适用域要收窄:可懂度结论只在所用识别器和评分规则下成立,自然度结论只是预测器分数,相似度的小数点后第二位比较意义有限。
要复现需要先准备什么数据和代码
复现第一步不是训模型,而是搭评测。论文公开了 Freya-TR-Eval 重跑 harness 和分系统结果,以及 3 个土耳其数据集:2398 小时真实段的转写加风格标题不含音频、3411 小时设计音色合成语音 48 kHz、144 万领域文本;论文的数据与代码可用性声明列出了 Antalia-2 Mini 的 Hugging Face 页面链接,并写明 Alania-2 和 Duyu 的权重与 serving 代码不提供,两者可通过 speech API 调用。做对比时要锁定识别器为 Whisper large-v3 经 faster-whisper 束宽 5、限带 8 kHz 重采样 16 kHz,并用基准自带正则化评分,否则数字对不上。
若要复现正则化器效果,需用 150 句诊所客服风格构造句,分别送原文和正则化后文本,单音色单种子生成后用 Duyu 转写,统计词错误率和关键片段保留率。复现克隆时,参考音频先转单声道 48 kHz 并归一到 -20 dBFS,检查噪声回声削波,只用 3 到 30 秒,优先选最干净 20 秒窗,用仅参考条件而非延续模式。
还需补的验证包括多听音者自然度、换识别器后的排名稳定性、以及用现版正则化文本重训 1 次以消除训练 serving 不一致。引擎侧若要 serve 多个低秩适配器,必须把适配器名加权重摘要加入前缀缓存键,否则微调请求会复用普通请求算好的键值块,论文观测到 9 个提示块中 8 个被误复用。
什么时候值得试 Alania-2 路线,还缺哪项验证
当任务是土耳其语电话助手或长 narration,需要读对金额剂量日期人名、首包几十毫秒、固定内置音色可长期 serving,且用户能自助克隆时,这条先改写后生成的路线值得试。它的强证据是 plain 句基准上 488M 做到 1.44% 词错误率、7.6M 单音色做到 1.05%,以及含数字句上正则化把关键片段全保留从 0/96 提到 86/96;主要代价是 90% 依赖教师合成的数据准备、风格耳语慢速仍做不好、英语跨语克隆弱。
复现时先从公开 harness 和 Antalia-2 Mini 起步,确认 plain 句流程能跑通,再接入正则化器测含数字句。仍需补的验证是多人听音、不同识别器下的排名、以及长参考和噪声下的跳词率。权重未公开、只有 API 和部分数据集公开,这三件事要分开看:能调用不等于能复训,能下载小模型不等于能拿到大模型。
容易误解的是小模型胜出等于大模型无用:论文的原意是可懂度上尺寸不敏感,但多音色、克隆、设计和风格控制仍需要 488M 量级的容量;另一个误解是正则化无用,因为 Freya 本身不含数字,测不出它的价值,必须用含数字的构造集才能看到差距。
📎 论文与评分元数据
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses