共分析 66 篇论文
⚡ 今日概览
✅ 筛选入选 66 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音识别 | 5 篇 | █████ |
| 音频分离 | 5 篇 | █████ |
| 音视频理解 | 4 篇 | ████ |
| 语音合成 | 3 篇 | ███ |
| 音频伪造检测 | 3 篇 | ███ |
| 口语理解 | 2 篇 | ██ |
| 声学系统参数估计 | 2 篇 | ██ |
| 异常声音检测 | 2 篇 | ██ |
📊 论文评分排行榜(66 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 听者觉得是同一个人,模型也这么觉得吗:VIPBench 解读

英文题目:VIPBench: A Human-Aligned Benchmark for Voice Identity Perception in the Age of Voice Cloning
评分:8.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Xudong Tang:Department of Computer Science;Northwestern University
- Matthew Groh:Management and Organizations;Kellogg School of Management, Northwestern University
📌 核心摘要
说话人验证按录音元数据判定是否同一人,但听众感知并不完全服从元数据,尤其同人克隆常被听成异人,直接影响认证和防伪判断。论文先为一百位公众人物固定参考录音并配对同一录音不同片段、同人不同次录音、同人克隆、异人真实录音、异人克隆与双人混合语音得到九千八百个语音对,再交由一千二百九十位听众逐对判断是否同一人,输出每对判为相同的比例\(P(\mathrm{same})\)与多数票标签,共十二万四千八百七十六次判断。最后提取两段语音嵌入并输出其余弦相似度\(c\),再送入四个任务检验对\(P(\mathrm{same})\)的预测、对多数票的区分与校准、说话人对距离排序的一致性及真实录音拟合直线向合成语音的迁移。与用说话人编号或真假标签的说话人验证基准相比,VIPBench以感知比例为目标,并同时覆盖真实录音、克隆与八千一百个混合语音。在全部9800个语音对的连续预测任务中以Pearson相关系数\(r\)为指标时,有监督说话人模型resemblyzer对\(P(\mathrm{same})\)预测为0.656,高于自监督模型最高的0.510和弱监督Whisper的0.226,对应\(R^{2}\)为0.430,约为噪声上限的61%。在经说话人交叉验证选择阈值后于8884个无平票对的多数票任务中以多数票一致准确率为指标时,resemblyzer为0.790,高于自监督HuBERT的0.718。结论适用于美国英语公众人物访谈类录音,混合语音和跨合成器泛化尚未充分验证;原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/sendfuze/vipbench — 链接可访问(HTTP 200)
数据相关资源:https://huggingface.co/datasets/sendfuze/vipbench — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/sendfuze/vipbench/tree/main/samples — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 LiveFoley:为实时交互视频生成同步声音

英文题目:LiveFoley: Dynamic Real-Time Video-to-Audio Generation for Immersive Interactive Worlds
评分:8.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Yusheng Dai:机构信息未能在本次解析中与作者逐人可靠绑定
- Vladimir Iashin:Monash University Nanjing University ShengShu Technology Tampere University
- Kangdi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxuan Jiang:Alibaba Token Hub, Alibaba Group Tsinghua University Corresponding author
- Ilpo Viertola:Monash University Nanjing University ShengShu Technology Tampere University
- Weiqiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiuhong Ke:机构信息未能在本次解析中与作者逐人可靠绑定
- Min Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianfei Cai:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式视频到声音生成要求从任意到达的像素流连续合成声音,在人察觉延迟前播放,并让撞击、脚步等事件在时间上对齐;论文处理25 fps视频和12.5 Hz音频隐表示,难点是冻结的Synchformer片段编码器需预看未来帧,而因果自回归后端每次只去噪一个音频块。先用尾部滑动窗把窗口尾部锚定到当前帧,只提取严格历史帧并丢弃补齐帧的占位输出,把非因果片段编码器转成流式模块,送入后端时保留完整感受野。再用同步器对齐不同跳步的特征分布,使同一生成后端支持可变延迟模式。最后因果语言模型输出粗粒度隐状态后送入局部流匹配头精修,默认历史模式引入已生成块而不增加延迟,可选未来预热模式用近似条件引入下一块协同去噪。与离线MMAudio-L相比,48 kHz版本在VGGSound测试集上去同步分数为0.48对0.47,前端预看仅0.08 s。与流式基线相比,16 kHz版本分布距离最优,端到端延迟在单张A800上实测156 ms,仍低于动作声音约0.34 s的可察觉阈值。该结论仅在8 s片段评测、默认跳步s=1和历史模式下验证,增大跳步或改用未来预热会增至236 ms以上且在分布距离等多项指标上仍落后离线模型,离线联合去噪的优势在流式约束下尚未补齐。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/dalision/livefoley — 链接可访问(HTTP 200)
第三方资源:https://dalision.github.io/livefoley-page/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 流式语音识别如何做到说出的话不再改口:Confucius4-R2T2 解读
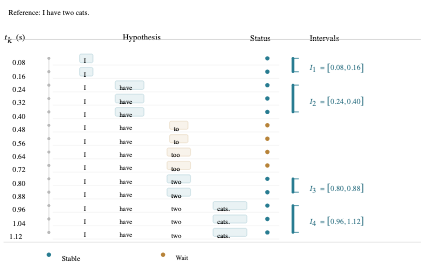
英文题目:Confucius4-R2T2: A Stable-Prefix Streaming ASR Model for Real Real-Time Transcription
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Daniel Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qi He:机构信息未能在本次解析中与作者逐人可靠绑定
- Shaoxiong Duan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingjie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiao Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yitao Duan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式语音识别要在音频到达时逐段输出文字,供机器翻译与语音助手直接消费,一旦改写已发布词就会造成重复计算或错误动作。论文把输入记为每80毫秒一帧的音频前缀,把同一模型在全量音频上的输出作为参照,要求任意时刻已发布文本都是更晚时刻文本的前缀。方法先让全量模型在递增前缀上产生假设序列,从中提取既是全量输出前缀、又等于某个历史完整假设的最长稳定前缀,送入监督构造,用等待符号区分稳定区间与不确定间隙。再冻结音频编码器与投影层,只更新语言解码器,先在1500小时中英文音频上监督微调学习稳定转写与等待,再用分组相对策略优化完善准确率与等待行为。最后推理按160毫秒等块更新,结合缓存复用、等待终止、有界上下文和可修正后缀校验维持稳定输出。在13个中英文测试集以160毫秒分块评测时,保留1个临时词模型的英文词错率与中文字符错率总宏平均为5.76%,低于同基座同设置未适应基线的21.01%,但仍高于全量解码的5.15%。在未参与训练的10个语言18个测试集以160毫秒分块评测时,同保留1个临时词模型的平均识别错误率为8.40%,低于同设置基线模型的30.75%,在中英文流式评测中其平均回溯发射滞后低于三个专有接口。该结论适用于短块稳定提交与中英文之外的10个语言迁移,但右语境消歧仍需未来音频,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/netease-youdao/Confucius4-R2T2 — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/netease-youdao/Confucius4-R2T2 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 指令感知语音检索:让大音频语言模型按要求找录音

英文题目:Improving Large Audio-Language Model Embedding Baselines for Instruction-Aware Speech Retrieval
评分:7.8/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chen-An Li:National Taiwan University
- Cheng-Han Chiang:National Taiwan University
- Hung-yi Lee:National Taiwan University;NTU Artificial Intelligence Center of Research Excellence (NTU AI-CoRE)
📌 核心摘要
指令感知的语音检索输入是一段语音查询加一条自然语言指令,输出是按相关性排序的语音文档集合,难点在于同一段查询在不同指令下对应不同的相关文档,而相关性要求同时满足内容、说话人、风格、环境声中的一项或多项。IRIS-Embed 用同一模型分别编码查询加指令和候选文档,再按余弦相似度排序。编码过程先从冻结音频编码器的预编码器输出和各层隐状态得到时间对齐的序列,再由指令决定的权重加权合并,然后经投射送入语言模型,取最后一个非填充位置的末层隐状态作为向量。训练用 InfoNCE 目标把查询向量拉向满足全部要求的正文档,推开批量内其余文档,并用低秩适配调整语言模型。在 INSPIRE 上 Qwen2.5-Omni-3B 版本的宏平均 Recall@50 为 62.92%,超过包含 ECAPA-TDNN 在内的最强比较基线的 45.15%。该结论适用于论文划分的对话延续、说话人匹配、风格匹配和合成多属性检索,对更大模型、更多语言和自然噪声的适用性尚未验证,原文未披露训练时长与推理延迟等完整开销。
🔗 开源资源
代码相关资源:https://github.com/lca0503/IRIS — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/lca0503/INSPIRE — 链接可访问(HTTP 200)
数据相关资源:https://github.com/lca0503/IRIS — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/audeering/wav2vec2-large-robust-24-ft-age-gender — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/emotion2vec/emotion2vec_plus_large — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/sentence-transformers/msmarco-bm25 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/cross-encoder/ms-marco-MiniLM-L6-v2 — 链接可访问(HTTP 200)
第三方资源:https://blog.google/innovation-and-ai/models-and-research/google-deepmind/gemini-2-5-native-audio/ — 链接可访问(HTTP 200)
第三方资源:https://ai.google.dev/gemini-api/docs/models/gemini-3.1-pro-preview → https://aistudio.google.com/docs/models/gemini-3.1-pro-preview — 链接可访问(HTTP 200)
第三方资源:https://www.anthropic.com/news/claude-opus-4-6 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen2.5-Omni-3B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/google/gemma-4-E2B-it — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 先修好证据再约束生成:面向目标说话人提取的说话人一致性接地

英文题目:Speaker-Consistent Grounding for Confusion-Resilient LLM-Based Target Speech Extraction
评分:7.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hanyu Meng:机构信息未能在本次解析中与作者逐人可靠绑定
- Hao Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhanhong He:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiquan Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Sungwoo Cho:机构信息未能在本次解析中与作者逐人可靠绑定
- Haowei Lou:机构信息未能在本次解析中与作者逐人可靠绑定
- Haizhou Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
目标说话人提取要从两人混合语音和一段目标人注册语音中恢复目标人语音,难点是注册条件可能把干扰人当成目标抽出,这种目标混淆输出依然清晰却身份错误。论文提出先修复再约束的两步框架:条件多样候选选择(Conditioning-Diverse Candidate Selection,CDCS)用五个冻结确定性估计构造候选并选出与目标注册最一致的波形,码空间约束(Code-Space Grounding,CSG)把该波形转成证据 token 并在自回归生成时惩罚偏离证据的 token。相对已有做法,确定性分支不再只用完整注册的全局嵌入,而是加入局部注册片段和混合对齐的时频上下文;生成分支不改变已训练的 Qwen-TSE 检查点,只在解码时加约束。在 Libri2Mix 含噪测试集上,固定强度 CSG 把内容切换率从 12.79% 降到 9.10%,声学切换率从 1.68% 降到 0.51%,同时保留了生成语音更高的预测质量分。错误定义为基于干净参考的 SI-SDR 余量小于 0 时,CDCS-5 把错误率在干净集从 6.87% 降到 0.75%,在含噪集从 18.95% 降到 10.46%。适用范围限于 Libri2Mix 双人混合与 WHAM! 噪声,强噪声下候选生成和选择都会变难。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://hanyu-meng.github.io/LLM-TSE-Grounding-Demo/ — 链接可访问(HTTP 200)
演示资源:https://hanyu-meng.github.io/LLM-TSE-Grounding-Demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. Route Anything:跨模态选模型与选策略的路由研究

英文题目:Route Anything: A Study of Model and Policy Routing for General-Purpose AI Systems
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pengfei Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Yixing Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Hexin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Weidong Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhenglin Wan:机构信息未能在本次解析中与作者逐人可靠绑定
- Wangbo Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang You:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
通用系统面对的问题是每个输入适合的模型或策略都不同,固定用一个最强候选会浪费成本,也会错过输入级别的最优选择,而路由能看到的信息有限,且质量与成本需放在同一尺度比较。论文先建立统一理论,把路由表示为在观测状态下选择期望价值减去价格乘期望成本最大的候选。再构造跨模态轨迹矩阵让同一输入被池中全部候选运行并按各自基准指标打分,输出同一输入上可比的得分记录并送入路由器训练。最后在矩阵上训练基于能力树、基于逐候选结果回归与基于场景图像的路由器,并在带价格的代码与文本testbed上比较拟合路线与可认证路线。相对已有语言模型级联与偏好路由器,该工作把参考策略与质量容忍度作为定价来源,并用固定顺序检验在独立数据上认证质量下限。在24个基准共19814个测试输入上,以各自基准指标重标度到0–100分的得分为指标,按输入选择的上限超过按基准固定的最强候选5.38分。在16个基准上,以同样重标度到0–100分的得分为指标,一个能力树路由器超过固定最强候选0.3分,视频生成组高出2.12分。四组价格路线以相对参考策略的单位成本质量为指标平均为8.82倍,代码任务达到25.5倍;结论适用于候选质量接近而价格差距大且状态能改变最优候选的情形,语音生成因候选几乎全对而无可交易空间,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/InfRec-Cardinal/route-anything — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/papers/2611 — 链接不可用(HTTP 401)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. TaoMate-HD:分阶段升分辨率的流式音视频自回归生成

英文题目:TaoMate-HD: Progressive-Resolution Autoregressive Audio-Video Generation
评分:7.4/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qijun Gan:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenwei Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinyang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Meiguang Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Junfeng Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Shen Qiu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式数字人需在新文本不断到达时持续输出高分辨率画面与不中断语音,难点是高分辨率去噪在稠密视频网格上重复全量计算,而文本更新落在句中易导致重复或截断。TaoMate-HD把每个短分块的生成分三步推进,先在480×864低分辨率网格建立布局与运动,再细化到768×1376,音频在同一轨迹中同步生成。每步由当前噪声估计干净端点,该估计既用于本分块更新又作为下一分块同阶段历史,使后块粗生成不必等前块细化完成。文本窗口切换时保留音视频历史并以重叠段为上下文从音频推断进度,训练在自身滚动序列上让生成器用切换前后窗口而蒸馏分数用开口条件评价整体。长时评测用自建百条1–10分钟序列输出768×1376、24 FPS视频与32 kHz立体声。在相同输入批次与GPU及解码策略下串行渐进相对直接高分辨率生成的平均生成时间从491秒降至307秒为1.60倍加速。在固定初始化与渐进结构一致仅文本条件与历史不同的消融中字错率从30.751%降至19.570%。结论适用于按固定分块推进且有重叠文本窗口的流式场景,小时级为定性演示,训练与完整部署成本原文未披露。
🔗 开源资源
第三方资源:https://taoliveaigc.github.io/TaoMate-HD → https://taoliveaigc.github.io/TaoMate-HD/ — 链接可访问(HTTP 200)
代码相关资源:https://github.com/TaoLiveAIGC/TaoMate-HD — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/TaoLiveAIGC/TaoMate-HD-preview — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/MiniMaxAI/MiniMax-H3 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 同类多个物体都在画面里,到底哪一个在响?双耳线索如何选出真正的发声实例

英文题目:Which One Is Sounding? Binaural Sounding Instance Disambiguation for Audio-Visual Segmentation
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haoze Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Yidi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Pengyuan Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Bin Ren:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanwen Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Dimitrios Kanoulas:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
同一画面出现多个同类物体时仅凭声音语义无法确定哪一个在发声,任务是从单张图像和同步双耳音频输出覆盖真正发声实例的掩膜,难点是语义提示会同时激活多个候选而视频类方法依赖的运动与跨帧关联在稀疏观测下不可用。模型先把左右声道平均后提取语义特征并注入视觉主干,输出类别一致的候选特征并送入后续空间加权环节用于保留同类候选。再把左右耳各自的耳蜗谱堆叠后编码为空间查询,输出查询向量并送入与未受语义污染的视觉特征做内积,得到图像平面空间响应。最后用该响应在特征层加权候选特征,并在解码器层作为稠密提示送入掩膜解码,输出真正发声实例的掩膜。相对已有做法,空间证据不再是掩膜生成后再做选择,而是同时约束特征与解码,避免了粗糙响应下相邻实例难以区分的问题。在Habitat-AVS多候选子集上,按指标mIoU_M比较,BiSID-AVS为0.8952,高于基线AVSegFormer的0.4831。结论适用于单声源、单视角加双耳音频的情形,多声源重叠、运动目标与真实混响更复杂的环境尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 只用麦克风读出发动机转速、缸数和负荷:SonoDyno

英文题目:SonoDyno: A Sonic Dynamometer for Engine Speed and Load Estimation from Audio
评分:7.3/10 | 创新 1.6/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Robin Doerfler:机构信息未能在本次解析中与作者逐人可靠绑定
- Beat Rossmy:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
发动机声音的输入是一段麦克风信号,期望输出是瞬时转速、整段录音共用的气缸数,以及介于倒拖底部与全负荷顶部之间的负荷强度。难点在于最强谱线位于发火频率,它等于缸数与转速乘积决定的量,缸数未知时同一谱线对应多种转速,低怠速要求长窗分辨相邻阶次而急加速又要求短窗跟踪扫频。论文用三窗阶次能量表示频谱,把每个阶次在每个候选转速上的能量送入按阶次独立的精炼与融合,再用发火阶次增益按缸数加权并结合跨阶次模式给出联合打分,最后由转速动力学解码器得到路径并读出缸数。负荷分支在解码转速处读取原始功率谱的带能量与谐噪比,用循环网络输出负荷分布。在真实验证录音上向所有跟踪器提供真实阶次的条件下,SonoDyno的5%容差内帧比例为95.7%,高于最接近的PESTO的61.6%,在两台未见过的真实发动机上2%容差内帧比例为93%至97%,在已知类型的未见测试发动机上负荷平均绝对误差约为0.12。在真实录音应力段上以5%容差内帧比例计,真实发动机剧烈变化段的0.67低于未见仿真发动机同应力段的0.89,单次训练在单张RTX 3090上耗时11.5小时,原文未披露推理延迟、吞吐或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 四步就能画好图:VA-TDM 如何沿着学生轨迹做速度对抗蒸馏

英文题目:VA-TDM: A Unified View for Improving Few-Step Diffusion Models by Velocity Adversarial Distillation
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yihong Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianyu Pang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianyang Hu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要解决的对象是从噪声经4步生成图像或视频的学生模型,困难在于每一步只做部分去噪,但用于监督的带噪分布既依赖学生当前输出又包含残留噪声,难以准确估计其对数密度对输入的梯度。论文先沿学生轨迹对中间转移加扰动,构造以干净预测为锚的A型整流速度和以中间输出为起点的B型高斯速度,提取两种条件速度目标送入后续对抗比较。再用一个只依赖带噪样本的速度差异评价向量比较学生场与教师场,输出两者残差作为学习信号送入生成器更新。最后生成器通过路径式与流乘积式两种更新学习,分别对应矩匹配的近似梯度与精确梯度,从而统一已有分数蒸馏、Fisher匹配与矩匹配方法。评价器通过回归条件速度目标来逼近最优残差,两类速度共享主干并以转移下标区分输入,避免不同步骤监督混淆。在SD3.5-Medium上4步GenEval从TDM的0.61提高到0.67,同时保持多样性。在MiniMax-H3上4步人类偏好对4步Fast-H3胜率为61.33%,对100步教师达到45.53%。结论适用于4步文生图与文生视频,原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/Luo-Yihong/VA-TDM — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. AccentCanvas:兼顾发音转换与语速暂停对齐的双向口音转换
英文题目:AccentCanvas: Activity-Guided Bidirectional Accent Conversion
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jaehun Kim:机构信息未能从 arXiv PDF 文本可靠映射
- Kang Zhang:机构信息未能从 arXiv PDF 文本可靠映射
- Sung Woo Kim:机构信息未能从 arXiv PDF 文本可靠映射
- Junmo Kim:机构信息未能从 arXiv PDF 文本可靠映射
- Joon Son Chung:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
配音场景要求改掉说话人的口音,同时保留说话内容、说话人音色,并让语音和停顿落在原片的时间位置上,只把总时长拉齐并不能保证内部停顿对齐。AccentCanvas 把源语音送入冻结的语音编码器得到内容特征,再把请求口音标签、扩散时间步和一串帧级语音活动序列作为条件,用离散扩散模型预测目标口音的语音单元序列,最后由预训练渲染器根据源说话人参考合成波形。训练数据把 CMU ARCTIC 和 L2-ARCTIC 中同一文本提示的录音跨说话人和跨口音组成有序对,覆盖规范化、母语到非母语和跨非母语关系,再混入较小比例的合成对;推理时用源语音的活动序列和时长初始化全掩码序列并迭代解码。在规范化任务上,AccentCanvas 的口音到达率为 84.4%,高于 TokAN 的 77.4%,边界误差为 58.7 ms,低于最优基线 CosyAccent 的 218.2 ms,相对下降超过 73%。该结果适用于论文划分的自然对测试集与所选基线,母语到非母语方向的口音到达率绝对值仍只有 13.3%,且词错率升至 17.1%,高于同任务 TokAN 的 5.8%,说明请求口音越明显,语音识别指标越差。训练使用单块 NVIDIA RTX 4090 GPU,论文给出了更新步数与批量大小,但未披露训练时长与推理延迟。
🔗 开源资源
- 第三方资源:https://github.com/snakers4/silero-vad — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 用配音加声音转换造出内容韵律兼顾的翻译训练数据
英文题目:Holistic Parallel Supervision for Expressive Speech to Speech Translation
评分:7.2/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ismail Rasim Ulgen:机构信息未能在本次解析中与作者逐人可靠绑定
- Bismarck Bamfo Odoom:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zihan Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Berrak Sisman:机构信息未能在本次解析中与作者逐人可靠绑定
- Philipp Koehn:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音到语音翻译输入为源语言语音、输出为目标语言语音,需同时译出内容并在跨语言时保持韵律、时长和说话人身份对应,任一维度缺失都会让表达走样。论文先用影视专业配音获得内容、韵律和时长的人工演绎对应,再对配音侧做多语言零样本语音转换以贴近原始说话人,形成源侧为转换后语音、目标侧保留原始真实录音的VC-Dub训练对。最后提出DirectS2ST,用冻结语义编码器提供源语音记忆,自回归部分生成源文本、目标文本和目标Mimi编码第一层编码,非自回归深度部分补全其余编码层,直接预测完整目标语音表示。为检验监督通用性,作者把同一数据同时用于TransVIP和Dub-S2ST这两个已有表达型系统,与解码器从头训练的DirectS2ST对照,关键差异在于是否直接以源语音为唯一条件预测全部目标语音。在mExpresso英西评测上,DirectS2ST将训练数据从CVSS-T换为VC-Dub后,韵律相似度指标A.PCP从2.238升至3.091,语义一致性指标BLASER从3.153升至3.259。在9名英西听众对10个英西源话语的表达MOS人评中,DirectS2ST同样从CVSS-T的2.13升至VC-Dub的3.42。结论适用于英德、英西两个方向的影视配音域,跨域泛化、长时对话和实时部署尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://hzted.github.io/truly-e2e-expressive-s2st-demo → https://hzted.github.io/truly-e2e-expressive-s2st-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 没听到下一秒声音之前,先把下一秒的话打好草稿:推测性聆听如何加速块交错全双工语音模型

评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yutong Bian:The Chinese University of Hong Kong, Shenzhen, China;Amphion Technology Co., Ltd
- Yanglin Zhang:Amphion Technology Co., Ltd
- Yuxiang Wang:The Chinese University of Hong Kong, Shenzhen, China
- Luoyuan Zhang:The Chinese University of Hong Kong, Shenzhen, China
- Rongshen He:The Chinese University of Hong Kong, Shenzhen, China
- Zihao Wang:The Chinese University of Hong Kong, Shenzhen, China
- Junwen Qiu:The Chinese University of Hong Kong, Shenzhen, China
- Jiaqi Li:The Chinese University of Hong Kong, Shenzhen, China;Amphion Technology Co., Ltd
- Zhizheng Wu:The Chinese University of Hong Kong, Shenzhen, China;Amphion Technology Co., Ltd
📌 核心摘要
块交织全双工语音语言模型把对话切成固定时长块,每块读入新到音频并解码输出,块时长是硬截止,超时累积为落后于实时。听块只处理音频而把块时长70-89%空耗为闲置窗口,发言块和工具调用块需逐词串行解码且工具调用可达数十步,因而要利用闲置窗口就必须在音频到达前假设输入起草下一块。论文发现静默假设下的草稿多与真实输出一致,而不一致多分歧于首词,先用目标模型自身以静默输入在上一块结束后的闲置窗口内起草下一块输出。再在真实音频到达时用一次前向同时完成音频预填并验证草稿,验证接受的词直接提交为本块输出以省去逐词前向。最后对首词分歧另设次优首词分支起草备选,并用跨块假设池保留用户说话期间各块已含部分工具调用的草稿供后续验证承接长输出,该做法把起草提前到输入到达前且不改变输出分布,不同于音频到达后用上下文词组起草的基线。在TickTock-Bench上相对自回归解码,发言块平均加速2.6-2.8倍,Streaming SLM工具调用加速23.41倍,回应起始延迟平均降低73%至74-241 ms,最大落后平均降低94.4%。结论适用于1 s块、低并发、思考器解码阶段,并行流式架构与高并发服务尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 一句话指令改整首混音:ProCraft 怎么做到的

英文题目:ProCraft: Instruction-Driven Music Production from Free-Form Text
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Yuan-Chiao Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Hsuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Vincent K. M. Cheung:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音乐制作常要求一次说清多个改动,例如去掉贝斯并让钢琴更亮更宽,而已有编辑器多只支持单操作、短片段或固定模板指令。ProCraft把30 s混音与自由文本指令读入同一个自回归编解码语言模型,直接生成编辑后音频,覆盖去除、提取、伴奏生成、独奏改编、乐器转换、去噪与效果七类任务。该模型先把指令词元、源音频的WavTokenizer编码与32个可学习查询拼成同一输入序列,使每个输出编码都能同时注意到指令与音频,这32个查询汇总本次编辑请求,再经门控交叉注意力送入每一解码层以约束生成紧贴指令。随后它把第4层隐状态向MERT音乐表征、音高与乐器活动和StemFX效果表征对齐,以保留未指定的声部,而为解决复合指令缺乏三元组的问题,论文用工具调用语言模型现场写指令并执行效果链,合成兼含音轨操作与效果变化的训练对供上述模型训练。在Slakh复合去除任务上ProCraft的SI-SDR为-7.39 dB,高于次优自由文本编辑器的-24.88 dB,16名听众在MoisesDB去噪上也给它最高分。结论适用于需新增源中没有材料的伴奏、改编与转换等创意任务,以及仅在Slakh合成数据训练后向MoisesDB真实录音的跨域测试;在有确定目标的去除、提取与去噪上仍落后于专用分离系统,对真值做WavTokenizer编解码仅得+1.05 dB,说明11.3 dB差距中约7.3 dB来自0.9 kbps单码本编解码器而非模型本身。推理30 s片段在单卡上批量为1时约需38 s、不含超分,含超分约40 s。
🔗 开源资源
- 第三方资源:https://barry-mir.github.io/procraft-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. NAVE:为南极鲸叫检测做的归一化自适应 Conformer

英文题目:NAVE: A Normalized, Adaptive Conformer for Antarctic Whale Vocalization Detection
评分:7.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Matthias Nagl:机构信息未能在本次解析中与作者逐人可靠绑定
- Paul Primus:机构信息未能在本次解析中与作者逐人可靠绑定
- Gerhard Widmer:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
南极蓝鲸与长须鲸叫声检测要求在长时间低信噪比被动声学记录里给出每个叫声的起止时间和类别,叫声稀疏且随站点噪声和传播条件变化,D 类 downsweep 在训练站点分布极不均衡并长期是最低的一类。NAVE 的输入把每频点复数均值相减后的幅度与相位余弦正弦三通道和一路固定能量归一化通道并列,送入频率动态卷积茎做频带自适应压缩,再经四块 Conformer 建模并由逐帧线性头输出三类后验,最后用中值平滑与类别阈值转成事件。相对保留原声学模型只加边界门控与后处理搜索的 WhaleVAD-BPN,NAVE 改动前端与主体声学模型,不用边界提议网络与后处理参数搜索。在三个验证站点年份的留一站点阈值评价下,单模型 pooled 宏 F1 达到 0.518,超过 WhaleVAD-BPN 的 0.475,增益主要来自 D 类由 0.340 升至 0.438,BP 基本持平而 BMABZ 略有下降。D 类即使改善后仍是最弱的一类,核宽超过约 1.3 s 后进入平台,作者认为进一步提升更可能来自输入表示与更多站点数据而非继续加宽卷积。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/TheFruitGuy/NAVE-SED — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 不听声音怎么做视频问答:SleuthVLM 的查证式理解

英文题目:SleuthVLM: Do We Really Need Audio-in-Video for Omni Video Understanding?
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Peiran Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Fangfei Gou:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaoxi Mu:机构信息未能在本次解析中与作者逐人可靠绑定
- Changhao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiqiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuntao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuanchun Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Junxiao Shen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是同时依赖画面与声音的视频选择题,输入为时长30秒至90分钟的静音视频、带时间戳的语音文本与问题选项,输出为选项编号,难点是答案常藏在几秒内而固定采样容易错过。先由语音识别与强制对齐提取词级时间文本并输出空隙标记送入视觉语言模型,再由模型按需调用检索与看图工具逐步取证,最后结合词边界判断语音与画面是否同时发生后作答。带时间戳的文本既提供语音内容又充当定位索引,模型从关键词命中窗口由粗到细放大查看。与一次读入采样帧加音频的做法差异在于不训练音频编码器、不做联合多模态对齐,只靠文本与工具把长视频搜索问题交给智能体能力。SleuthVLM(Opus 5.5)在四个全模态基准平均准确率为75.0%,高于Gemini 3.8 Flash的72.4%,在Video-MME-v2准确率为77.8%。该智能体免额外训练,推理用vLLM在H200/A100上运行,每题预算为50轮、30图、10片段和30分钟。结论适用于语音占主导的问答,LVOmniBench约75.2%问题涉及语音,对纯音乐依赖仍需外挂音频描述工具。
🔗 开源资源
第三方资源:https://github.com/WPR001/OpenOmniHarness — 链接可访问(HTTP 200)
第三方资源:https://wpr001.github.io/sleuthVLM/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 把神经音频自编码器变成可塑的声音地形

英文题目:Latent Terrain: Adapting Neural Audio Autoencoders as Design Materials in NIME
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.5/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Shuoyang Jasper Zheng:\institutionCentre for Digital Music, Queen Mary University of London London UK
- Keigo Yoshida:\institutionGraduate School of Media and Governance, Keio University Kanagawa Japan
- Nico García-Peguinho:\institutionCentre for Digital Music, Queen Mary University of London London UK
- Jiatong Liu:\institutionCreative Computing Institute, University of the Arts London London UK
- Dan Hearn:\institutionCreative Computing Institute, University of the Arts London London UK
- Anna Xambó Sedó:\institutionCentre for Digital Music, Queen Mary University of London London UK
- Nick Bryan-Kinns:\institutionCreative Computing Institute, University of the Arts London London UK
📌 核心摘要
读者需要理解的对象是神经音频自编码器,它先把声音波形压缩成随时间变化的隐向量序列,再用解码器把该序列还原成波形,困难在于隐空间维度高且变化快,难以直接用少量旋钮或画板控制。本文处理的过程是只用解码器做合成,先把用户在低维控制坐标上绘制的轨迹与音频编码得到的隐向量序列配成训练对,再用可交互训练的映射把控制坐标变成隐向量序列,最后把该序列送入冻结的解码器发声。映射采用坐标多层感知机,并在输入前加傅里叶特征映射,把坐标变成多组不同频率的正弦与余弦,以缓解标准网络学不会高频变化的谱偏置问题。作者还把该方法封装成 Max/MSP工具包Latent Terrain,支持采集音频、绘制轨迹、训练、可视化和实时推理。与已有只建模单帧隐向量的方法不同,本文建模整段隐轨迹,并把高斯尺度暴露为可调的地形陡峭程度,使连续手势直接对应声音的时变过程。原文未提供可核对的关键定量结果。结论适用于所测四种自编码器和鼓、弦乐、语音三类素材的一维重建任务,二维地形未做同等定量验证。原文披露在Apple Silicon M4 Max笔记本上映射训练1000步在2秒内,约500轮对应约1.2分钟,增加映射后实时率只小幅上升。
🔗 开源资源
第三方资源:https://github.com/jasper-zheng/latent-terrain-pytorch — 链接可访问(HTTP 200)
第三方资源:https://github.com/jasper-zheng/music2latent-scripted — 链接可访问(HTTP 200)
第三方资源:https://github.com/jasper-zheng/streamable-stable-audio-open — 链接可访问(HTTP 200)
第三方资源:https://jasper-zheng.github.io/nn_terrain/ — 链接可访问(HTTP 200)
第三方资源:https://jasper-zheng.github.io/nn_terrain/posts/annotated-portfolio/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/acids-ircam/RAVE — 链接可访问(HTTP 200)
第三方资源:https://github.com/acids-ircam/nn_tilde — 链接可访问(HTTP 200)
第三方资源:https://docs.pytorch.org/docs/2.5/jit.html — 链接可访问(HTTP 200)
第三方资源:https://cs.stanford.edu/people/eroberts/courses/soco/projects/2008-09/modeling-natural-systems/boids.html — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. SubRoFormer:用子带时域表示做音乐分离

英文题目:SubRoformer: Subband Time-Domain Representation for Music Source Separation
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.4/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chunyat Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chuang Ding:机构信息未能在本次解析中与作者逐人可靠绑定
- Paris Smaragdis:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiuqiang Kong:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音乐源分离要从一路或两路混音中恢复人声、贝斯、鼓和其他乐器的波形,重叠的时频成分与多变的音色使归属判断困难。先由子带模块用固定三角滤波器组把48 kHz立体声混音分成128个重叠频带,经希尔伯特变换取解析信号、复解调移到零频再抽取,提取低速率复基带表示并送入分离器。再由分离器对每个子带做局部短时傅里叶变换提取细粒度时频特征,送入时域分块压缩到25帧/秒做长程建模,最后经门控残差融合恢复细粒度并输出复数掩码预测。最后逆变换把掩码结果经插值、再调制、取实部和求和重建波形,与全频带谱分组的BSRNN或BS-RoFormer不同,本文把波形速率降低与特征序列压缩放在前后端不同阶段控制。在MUSDB18-HQ 50首测试曲上以四轨中位SDR平均的四轨平均SDR衡量,仅用MUSDB18-HQ训练的四个独立目标模型为10.63 dB,高于已列完整结果中最强的BS-RoFormer的10.02 dB。同样在该50首测试曲上以相同四轨平均SDR衡量,加500首额外训练曲的单模型四轨联合SubRoFormer-B为11.59 dB,高于同表语境参考ACE Studio分离器输出的10.92 dB。无额外数据训练各模型用100万次优化更新,其中SubRoFormer-B用6块RTX 5090全局批量18,额外数据模型用8块RTX 4090训练140万次更新全局批量16,推理用2秒分段75%重叠,该结论限于该数据集与所列基线,固定滤波器重建失真、单种子消融与训练预算差异尚未排除。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. VidDub:为替换配音而设计的两步全上下文视频配音

英文题目:VidDub: Replacement-Aware Distillation for Two-Step Video Dubbing
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yexin Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunlong Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Zehan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Guangxin He:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinli Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiajun Zha:机构信息未能在本次解析中与作者逐人可靠绑定
- Yaofu Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yueze Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Bowen Ping:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuanming Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Amie Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Bernard Ghanem:机构信息未能在本次解析中与作者逐人可靠绑定
- Bing Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Harry Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
视频配音的输入是源视频和目标语音,输出是嘴部随新语音变化、身份、头部姿态和背景保持不变的视频,难点是替换语音下源嘴型与目标发音冲突,直接重建源嘴会把生成结果拉回错误口型。VidDub先训练替换感知的完整上下文教师,对配对语音做全帧重建,对非配对替换语音屏蔽嘴部区域的流匹配、像素和感知损失,只保留非嘴部重建并用冻结的音画同步损失约束嘴部。再用匹配轨迹回归把教师的分类器无关引导轨迹传给两步学生,学生与教师共享双向注意力结构,只压缩采样步数,最后用分布匹配蒸馏恢复两步采样后的视觉分布质量。在HDTF-30替换配音标准化八十一帧、24FPS、512×512模型调用评测下,两步VidDub的Sync-C为10.102、Sync-D为5.856、FVD为27.66,同步与分布质量优于20步LatentSync 1.6对应的8.160、7.035、28.05。在二十个60秒配对的重叠窗口长视频评测下,VidDub的Sync-C为9.399、Sync-D为6.162,保持能力优于LatentSync对应的7.771、7.083,且末段同步仍保持稳定。结论适用于离线配音,即完整源视频和目标语音在推理前已知,长视频用重叠窗口滑动处理。原文在单卡H20备好输入口径下披露全上下文两步模型吞吐为11.3 FPS、峰值显存为13.77 GiB,吞吐高于同骨架因果两步的9.4 FPS、显存低于其21.96 GiB,未披露完整训练时长成本。
🔗 开源资源
- 第三方资源:https://github.com/LAW1223/VidDub — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. Ruby-OPD:让日语语音合成既能被注音控制又能在无注音时读准
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Rui Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaolong Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhenpeng Zhan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
日语语音合成需要把书写文本变成语音波形,难点在于汉字存在大量多音字,读音随语境变化,去掉汉字只留假名会丢失词边界与语义线索。论文先用注音文本表示同时保留汉字字形与目标读音,分为词后加括号的隐式注音和用边界标记明确标注范围与读音的显式注音,并对字形做扰动,迫使模型真正读取注音。再用跨模态校验构造对齐数据,先由音素识别模型从语音提取纯假名序列,再在词典构词格中用动态规划找回与该序列完全一致的切分与读音路径,输出每词字形跨度与真实语境读音送入监督微调。最后把完整注音条件下教师模型的速度场知识转移到只看原文的学生模型,学生从纯噪声出发在线积分得到中间状态,并在同一中间状态上模仿教师的速度场,中间状态不含真实语音泄露。相对已有做法,该方法不依赖外部字形到音素模块,也不做离线多音字语音合成。在Joyo-Kanji-Yomi基准共13536句的评测中,原文模型在无注音原文输入下准确率为97.13%,目标音素错误率为2.02%,优于基础模型Irodori-Base的94.11%与4.68%。结论适用于日语常用汉字读音评测与注音可控合成,完全无注音长尾表达与跨录音条件的稳定性尚未充分验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/Aratako/Irodori-TTS-v4.1-Small — 链接可访问(HTTP 200)
第三方资源:https://github.com/Parakeet-Inc/Joyo-Kanji-Yomi-Benchmark-Parakeet-Edition — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/sbintuitions/kana-whisper — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Embedding-0.6B — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 不等听完再翻:CRESiST 怎样学会边听边译

英文题目:CRESiST: Self-Enhancing Explorative Policy Learning for Simultaneous Speech Translation
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chenyang Le:Shanghai Jiao Tong University
- Pei Zhang:Alibaba Token Hub, Alibaba Group;University of Macau
- Yuxiang Chen:University College London
- Bing Han:Shanghai Jiao Tong University;Alibaba Token Hub, Alibaba Group
- Derek F. Wong:University of Macau
- Baosong Yang:Alibaba Token Hub, Alibaba Group
- Yanmin Qian:Shanghai Jiao Tong University
📌 核心摘要
同时语音翻译要求把不断到达的语音流增量译成另一种语言,既要忠实又要及时。已有大语言模型方案多采用前缀增量生成,每到新语音块就重算历史前缀,导致键值缓存失效和二次计算,并依赖外部语音活动检测切分长流,切断跨句上下文。论文把源语音按400ms块与目标词交错排成统一序列,使推理可沿序列追加并复用缓存,支持不切分的无限长输入。先由辅助换能器采样读写轨迹并输出候选交错序列,再由语音大语言模型内的价值评估模型以内容一致性和时延奖励评估轨迹并输出读写偏好,最后以二元交叉熵把该偏好蒸馏回探索器以更新其采样策略。在ACL 60/60英德无切分流式设置下,以XCOMET-XXL质量与LongYAAL时延为指标,方法取得85.59分、1.08秒,质量高于InfiniSST的63.52分、时延低于其1.46秒,也优于StreamATT的70.61分、1.89秒。该结论仅在上述无切分连续流评测且阈值τ=0.5下成立,无切分相对切分仅下降1–2个COMET点,理论上不保证全局收敛或等同真实最优策略。若去掉轴向注意力而用常规换能器,对齐将退化为句尾集中输出而接近离线翻译,时延惩罚过大损伤质量、过小引发时延尖峰,原文还提示对非标准口音与低资源方言可能存在偏差且未在医疗法律等高风险场景验证,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/amphion/Emilia-Dataset — 链接可访问(HTTP 200)
第三方资源:https://www.openslr.org/121/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/SpeechColab/GigaSpeech — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/google/fleurs — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/facebook/covost2 — 链接可访问(HTTP 200)
第三方资源:https://opendatalab.com/OpenDataLab/MuST-C — 链接可访问(HTTP 200)
第三方资源:https://aclanthology.org/attachments/2023.iwslt-1.2.dataset.zip — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen2.5-Omni-7B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-0.6B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-235B-A22B-Instruct-2507 — 链接可访问(HTTP 200)
第三方资源:https://github.com/openai/whisper — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/facebook/seamless-streaming — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. 语音基础模型为什么不好直接蒸馏:Route-DMD 的任务分流做法

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yanru Huo:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhikang Niu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenming Tu:机构信息未能在本次解析中与作者逐人可靠绑定
- Junxi Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Tian Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Shan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yipeng Kang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyang Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Xie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zilong Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
统一语音基础模型在一套流匹配模型里同时处理零样本合成、指令编辑、增强、分离与超分,多步常微分方程求解与每步双倍计算带来时延瓶颈。直接把解耦分布匹配用于这类多任务模型会使分离能力崩塌,原因是错误分离输出加噪后的状态偏离教师训练分布,使教师预测不可靠。先用一致性蒸馏把学生从教师初始化为少步起点,输出的少步映射能力送入第二阶段做分布匹配,使后续训练收敛更快且终值更高。再按任务路由分配监督:分离样本只用回归损失拟合配对干净目标并排除在分布匹配之外,其余生成与编辑样本保留解耦分布匹配,从而利用分离答案唯一的特性避开不可靠的教师分数。最后教师展开中用自适应投影引导替代分类器无关引导,保留正交分量并压低平行分量,防止引导伪影传给学生。在SeedTTS-Eval评测设置下,与32步教师相比,4步学生平均说话人相似度SIM为0.790低于教师的0.795,词错率WER为2.85%高于教师的2.65%,基本持平。在SeedTTS-Eval test-en子集上以单张NVIDIA H20 GPU测得端到端实时因子RTF从0.4333降到0.0958,约为4.5倍加速。在CHiME-4、Libri2Mix与VCTK-SR三项处理基准上,该学生DNSMOS整体质量分和UTMOS均超过32步教师,结论仅在所评生成、编辑与三类处理任务成立,分离路由是否适用于其它无唯一答案任务尚未验证。
🔗 开源资源
第三方资源:https://github.com/iHateTheWorld555/AuK-RouteDMD — 链接可访问(HTTP 200)
第三方资源:https://route-dmd.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 用自然语言指令改语音:VoxCanvas-41M 如何造数据并揭示编辑如何学会

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhikang Niu:X-LANCE Lab, Shanghai Jiao Tong University, China;Shanghai Innovation Institute, China
- Wenming Tu:X-LANCE Lab, Shanghai Jiao Tong University, China;Beijing Institute for General Artificial Intelligence, China
- Yalin Li:X-LANCE Lab, Shanghai Jiao Tong University, China;Shanghai Innovation Institute, China
- Yanru Huo:X-LANCE Lab, Shanghai Jiao Tong University, China;Beijing Institute for General Artificial Intelligence, China
- Junxi Liu:X-LANCE Lab, Shanghai Jiao Tong University, China;Shanghai Innovation Institute, China
- Tianrui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruiqi Yan:X-LANCE Lab, Shanghai Jiao Tong University, China
- Junxuan Liang:X-LANCE Lab, Shanghai Jiao Tong University, China;Shanghai Innovation Institute, China
- Zilong Zheng:Beijing Institute for General Artificial Intelligence, China
- Ziyang Ma:X-LANCE Lab, Shanghai Jiao Tong University, China;Shanghai Innovation Institute, China
- Xie Chen:X-LANCE Lab, Shanghai Jiao Tong University, China;Shanghai Innovation Institute, China
📌 核心摘要
指令式语音编辑的输入是原始语音加自然语言指令,输出是只改指定位置而保留说话人、韵律和声学环境的语音。其难点在于缺少大规模成对数据,且编辑须按指令精确定位并只改目标片段,同时保持转写一致与说话人相似,单跨、多跨与位置指代等操作的学习规律尚不清楚。本文先用Qwen3-ASR-1.7B重转写和Qwen3-ForcedAligner-0.6B获得词级时间戳以确定可编辑区间,再用Qwen3.6-35B-A3B按模板生成单跨、多跨和位置指代的内容指令,使转写与时间戳共同约束指令构造。随后用F5-TTS只重生成掩蔽编辑区并保留区外波形,掩蔽区两侧各外扩0.5秒以减轻边界不连续,最后经时长规则、语音识别转写一致性和WavLM-TDNN说话人相似度三重过滤加人工抽查构成VoxCanvas-41M。与已有切分拼接式GigaEdit相比,该链路能生成原文不存在的新词和39类非言语事件的插入删除对,并用逆向配对以真声为目标缓解合成伪影。在SpeechEditBench上,用VoxCanvas-41M以LoRA微调AuK后得到VoxCanvas-Edit,内容编辑平均准确率从91.05%提升到95.22%,副语言编辑从53.25%提升到54.50%,适用范围限于中英单轮内容和插入删除类副语言编辑。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. FoleyForge:按一句话指令改音效,还留住原来的声音

英文题目:FoleyForge: Free-form, Controllable, Rectified-flow Editing of Sound Effects
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Giovana Morais:机构信息未能在本次解析中与作者逐人可靠绑定
- Hugo Flores García:机构信息未能在本次解析中与作者逐人可靠绑定
- Prem Seetharaman:机构信息未能在本次解析中与作者逐人可靠绑定
- Johannes Imort:机构信息未能在本次解析中与作者逐人可靠绑定
- Justin Salamon:机构信息未能在本次解析中与作者逐人可靠绑定
- Magdalena Fuentes:机构信息未能在本次解析中与作者逐人可靠绑定
- Oriol Nieto:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
声音设计需要保留原有素材的时间与音色,只改变指令点名的部分,而直接重写提示词再生成会丢掉已调好的身份与画面同步。FoleyForge接收一条输入音效与一条自由文本编辑指令,输出完成改动的音效并保留指令未提及的内容,覆盖语义、风格与类似均衡、混响、变调的信号处理式改动。先用音频语言模型撰写指令与目标描述,再分别经信号处理链渲染与生成模型合成配对音频并加入复合、逆向与空操作样本,最后把配对三元组送入整流流音频生成模型Sketch2Sound微调。微调把来源音频编码为干净隐变量块并前置拼接,用交叉注意力注入指令,以带噪重去噪初始化编辑起点;免对齐前置允许输出时长脱离来源,不同于SAO-Instruct的通道拼接对齐。模型还引入响度差、编辑强度与中值滤波后的均方根能量包络等属性控制,通过无分类器引导独立放大。在无真值的Creative Set共90个样本评测中,FoleyForge的Qwen指令遵循评分为3.44,高于SAO-Instruct的2.69,而方向相似度分别为0.100与0.093,说明改动量相近时FoleyForge指令命中率更高。结论适用于单源音效的指令编辑,依赖内部音效库与合成流程,公开复现与跨分布泛化尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://giovana-morais.github.io/2027_icassp_foleyforge_demo → https://giovana-morais.github.io/2027_icassp_foleyforge_demo/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/disco-eth/sao-instruct — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 连续音乐情绪估计:为什么混合相关会骗人,以及双分支时序模型如何跟踪情绪变化

评分:7.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mohammad Faraz Akhtar:机构信息未能在本次解析中与作者逐人可靠绑定
- Aditya Parashar:机构信息未能在本次解析中与作者逐人可靠绑定
- Ayush Jain:机构信息未能在本次解析中与作者逐人可靠绑定
- Madhur Gupta:机构信息未能在本次解析中与作者逐人可靠绑定
- Ritesh Kumar:机构信息未能在本次解析中与作者逐人可靠绑定
- Soubhik Chakraborty:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
连续音乐情绪估计要求对每首歌内唤醒度和效价随时间逐帧预测,难点是全部帧混合计算的相关系数会被歌曲间平均水平差异主导,无法区分跟踪动态的模型和只输出每首歌均值的模型。论文把标注总方差分解为歌曲间与歌曲内两部分,指出均方误差倾向拟合前者,而窗口内林氏一致性系数通过形状相关和偏差校正约束后者,用单个权重控制两者交换。系统先从原始音频提取两路表示:声学路取冻结MERT中间层嵌入并池化到0.5秒格,符号路经自动转录得到十维乐理特征,再将两路输出送入各自时序卷积编码并经跨模态注意力融合,最后在重叠窗口上预测并平均得到轨迹。与已有做法的关键差异是两分支特征完全由原始音频导出,可跨数据集联合训练而不加域标识,评价同时报告混合相关与平均歌曲内相关并在歌曲层检验,另用保留歌曲标定分裂保形区间。在1764首DEAM歌曲分组交叉验证中,权重从0增至1的对照使混合唤醒度Pearson相关系数r从0.843降至0.810,而平均歌曲内唤醒度Pearson相关系数r从0.204升至0.368。在歌曲分组5折交叉验证下,与相同特征相同划分的岭基线相比,唤醒度平均歌曲内Pearson相关系数r为0.344对0.125约增至三倍。结论限于西方流行音乐的唤醒度和效价,效价动态与按歌曲条件有效的区间尚未解决,单折训练在单块笔记本显卡RTX 3050上约需2分钟。
🔗 开源资源
第三方资源:https://github.com/Faraz011/MMAS — 链接可访问(HTTP 200)
第三方资源:https://cvml.unige.ch/databases/DEAM/ — 暂时无法访问
第三方资源:https://github.com/HuiZhangDB/PMEmo — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. AudioSphere:能同时听清内容与方向的自监督空间音频表示

英文题目:AudioSphere: Towards Self-Supervised Spatial Audio Representation Models
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Goksenin Yuksel:Donders Institute, Radboud University;Nijmegen, the Netherlands
- Marcel van Gerven:Donders Institute, Radboud University;Nijmegen, the Netherlands
- Kiki van der Heijden:Donders Institute, Radboud University, Nijmegen, the Netherlands;Mortimer B Zuckerman Institute, Columbia University, New York, United States
📌 核心摘要
要理解的工作是把多通道空间录音变成既能说出是什么、又能说出在哪里的表示。输入是 10 秒合成一阶 Ambisonics 声音场景,包含目标事件与局域或扩散噪声,输出是每帧和整段可复用的嵌入,难点是单通道模型看不见方向,而有监督空间模型只做片段级分类,缺少跟踪运动声源所需的帧级表示。方法先把房间声学仿真与 AudioSet 事件混合,生成带方向的训练场景,再把对数梅尔谱与强度向量拼在一起做管状掩码重建,迫使编码器同时恢复频谱内容和方向线索。推理时任意阵列先经匹配滤波转成同一 Ambisonics 格式,再由冻结编码器输出帧级与场景级嵌入。相对已有方法,关键差异是帧级自监督同时学习声学与空间,而不是只用标签或对比元数据学习片段标签。在 TAU-2019 上冻结探针达到错误率 0.28 与定位误差 14.1 度,优于同域有监督基线的 0.34 与 28.5 度;在 HEAR 聚合指标上达到 83.2,与单通道对照模型相当。结论适用于静态与中等动态真实场景,高混叠运动场景需要额外时序建模。原文披露预训练约 90 GPU 小时,未披露推理部署成本。
🔗 开源资源
第三方资源:https://github.com/labhamlet/AudioSphere — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/labhamlet — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 把公共乐谱变成可分轨音频:SPDMX 如何做大规模开放分轨

评分:6.9/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 0.7/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Phillip Long:机构信息未能在本次解析中与作者逐人可靠绑定
- Eduardo Escoto:机构信息未能在本次解析中与作者逐人可靠绑定
- Julian McAuley:机构信息未能在本次解析中与作者逐人可靠绑定
- Zachary Novack:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音乐研究缺少可自由再发行录音,多轨监督尤其稀缺,已有录音集规模小或受限,合成集依赖商用音源或音色干瘪,难以同时满足规模、真实感与可再发行。论文输入为公有领域PDMX符号乐谱对应的MIDI,输出为44.1kHz单声道干声、分轨线性叠加得到的混音、配对MIDI与关联标识,音频以CC BY 4.0开放发布。处理先按轨道名修正通用MIDI音色号并删除空轨道以输出清理后乐谱,再将清理后乐谱送入小规模试听为每类乐器固定渲染方案,最后将固定方案送入全库合成统一响度并保留音符速度比例叠加成混音。相对已有方法,关键差异是用可再发行音色库加神经合成的开放链条替代商用采样器,并保留乐谱对齐,可复用于其他符号乐谱库。在表1多轨资源比较设置中以歌曲数与混合小时为指标,多轨子集共88403首、2734小时,超过Slakh2100全库的2100首、145小时,同期全部歌曲对应253982首、5469小时、490159个单声道干声。结论适用于域内分离、条件合成与转录等需要乐谱对齐的研究,约65%为单轨且钢琴主导、均为单声道,不保证跨录音室录音的泛化与绝对真实感。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://pnlong.github.io/SPDMX/ — 链接可访问(HTTP 200)
演示资源:https://pnlong.github.io/SPDMX/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 把舞蹈按快慢拆开再编码:FFMT 如何分配 token 给编舞骨架与细节动作

英文题目:FFMT: Frequency-Factorized Multi-Rate Tokenization for Music-to-Dance Generation
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qirong Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruijie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeyan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Sicheng Shu:机构信息未能在本次解析中与作者逐人可靠绑定
- Guanzhi Ding:机构信息未能在本次解析中与作者逐人可靠绑定
- Weihang Ding:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音乐驱动三维舞蹈生成需要从音乐合成跟随音乐结构且编舞连贯、局部表达丰富的三维动作,难点在于缓慢变化的身体构型与快速局部运动并存,单一时间分辨率和码本容量难以兼顾。论文把去除全局平移后的关节点位置用固定高斯低通滤波拆成低频编舞骨架与互补的高频残差,低频用更低的令牌速率和更小的码本,高频用更高的速率和更大的码本,且上下半身分别建码本。与只按分辨率分层而不指定频率内容的方法不同,该表示直接把频率成分与容量分配绑定,并诱导先规划后细化的生成分工。音乐条件的生成器先产生低频令牌序列建立粗编舞,再把低频序列经时间对齐形成的邻域上下文与音乐上下文一起作为高频自回归模型的条件,最终解码为关节旋转与根部位移。在AIST++评测设置下,该方法动力学特征的FID即FIDk为9.91、几何特征的FID即FIDg为7.02,低于Bailando++的21.29与11.56,节拍对齐分数BAS为0.2374,与真值0.2374基本一致。在FineDance评测设置下对应FIDk与FIDg为35.21与27.66,低于表中Bailando++、EDGE、Lodge和TokenDance的同指标数值而为表中最低,BAS为0.2125,接近真值0.2120但不及EDGE。结论仅在AIST++与FineDance的四秒窗口、固定高斯滤波与既定令牌速率码本配置下验证,遮蔽低频上下文会引起动力学FID大幅恶化,跨风格长时生成与实时部署范围尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. GraphSeal:用时谱图在远距离片段之间传递伪造痕迹
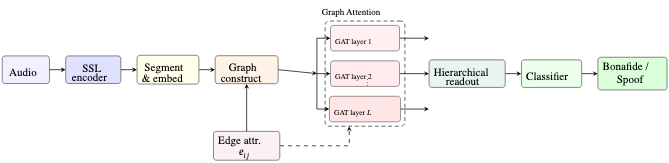
英文题目:GraphSeal: Graph-Augmented Speech Deepfake Detection via Temporal-Spectral Artifact Propagation
评分:6.7/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lee Seung-woo:机构信息未能在本次解析中与作者逐人可靠绑定
- Bowen Qi:机构信息未能在本次解析中与作者逐人可靠绑定
- Kim Min-jun:机构信息未能在本次解析中与作者逐人可靠绑定
- Jang Won-young:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音深度伪造检测的输入是一段待判语音,输出是真人还是合成或转换语音的二分类判决,难点在于合成痕迹常出现在时间上不相邻但频谱相似的区域,整句序列模型或固定结构图难以同时保留局部连续性和跨距离比较。GraphSeal 先用冻结的自监督编码器得到帧表示,再按重叠窗口平均池化成段节点,并为每段补充基频均值、能量和频谱质心等韵律描述,经线性映射后形成初始节点向量。随后它为每个节点连接时间邻居和频谱最相似的非邻近节点,边属性融合时间距离衰减与余弦相似度,再用三层带边属性的图注意力做多跳传播,使每个节点吸收邻域的异常模式。最后分层读出把平均池化和注意力加权池化拼接成句向量,送入两层感知机得到真伪分数。与使用同一 WavLM-Large 前端的 WavLM-AASIST 相比,GraphSeal 在 ASVspoof 2021 LA 上等错误率从 2.85% 降到 2.41%,在 In-the-Wild 上从 6.31% 降到 5.24%。该结论适用于训练于 2019 LA、测试于跨攻击和跨信道的四个评测;对高度均匀的编解码器语音和含停顿重叠的会话语音仍有误判。原文报告图模块仅 2.1M 可训练参数,单条语音在 A100 上约增加 12ms 延迟。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 不等音频放完就回答:LibriSpeech-Real-QA 如何考查流式问答

英文题目:LibriSpeech-Real-QA: A Benchmark for Streaming Question Answering
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zewen Zhan:机构信息未能在本次解析中与作者逐人可靠绑定
- Hui Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xueyuan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Huimeng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yikai Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xixin Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shiyin Kang:机构信息未能在本次解析中与作者逐人可靠绑定
- Bin Xia:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiyong Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务的输入是连续到达的语音流加一条自然语言提问,输出要求在查询的目标词或目标语义类出现时立即说出对应内容或更新计数,难点在于模型只能用历史音频做因果判断,还要同时答对内容与时机。数据构建先用强制对齐得到词级起止时间,再用大模型把词归入 20 类语义并保留空类,接着按模板生成词汇与语义的检测和计数样本,并补充目标缺席时应保持沉默的负样本。基线把音频切成固定时长块并以多轮对话格式输入 Qwen2.5-Omni-7B,每个块边界只允许说出目标或输出 <keep_silence>,训练时把说话内容、说话结束符、沉默动作与沉默结束符分成四组均衡损失。评测为每个参考事件设置从词开始到词结束加宽限期的接受窗,只有落在窗内且内容一致的输出才算命中,并统计召回率、精确率、F1 与命中延迟。与已有离线问答和轮次对话评测相比,该基准同时考核是否及时响应,避免把 utterance 结束才回答的内容正确误认为流式能力。在 test-clean 上 400 ms 流式模型词汇检测 F1 为 0.988,语义检测 F1 为 0.824,前者超过同设置离线微调模型的 0.94,而语义计数等任务仍弱于离线参考,说明因果约束带来可测的精度与延迟权衡。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://zxzxz-1.github.io/librispeech-real-qa-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 海洋录音里信号太稀:自监督预训练为什么越训越偏向噪声
英文题目:Drowning in Noise: On Signal Saliency in Self-Supervised Learning for Ocean Acoustics
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shikhar Bharadwaj:机构信息未能在本次解析中与作者逐人可靠绑定
- Samuele Cornell:机构信息未能在本次解析中与作者逐人可靠绑定
- Shinji Watanabe:机构信息未能在本次解析中与作者逐人可靠绑定
- Malcolm Slaney:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
海洋被动录音输入为连续长时间波形,输出为片段所属物种标签,难点是含动物鸣声的时间占比很低,其余为海浪、风声与静默。先将梅尔语谱图切成块并随机遮蔽,再训练编码器预测被遮蔽块的离散词元,词元由随机码本或BEATs词元器输出,最后将学到表示送入冻结编码器加线性层或整体微调,完成31类海洋哺乳动物分类。与已有做法的差异是把时间维度信号密度作为筛选标准,而非只看领域匹配或数据量。在Watkins 31类分类基准线性探测评测下,以准确率为指标,30小时人工截取片段的72.0%高于1240小时未过滤母带的43.1%,高出约29个百分点。同一线性探测准确率下,经显著性过滤的613小时数据为47.5%,仅高于未过滤的43.1%,仍低于30小时人工筛选的72.0%达24.5个百分点。显著事件检测器在海洋与鸟声数据上均表现弱,最优方法仅找回40%事件却覆盖69%时间线;词元分析显示未过滤数据目标熵更高却占用容量建模背景噪声。结论适用于信号稀疏背景丰富的被动监测,不适用于事件密集语料。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/Shikhar-S/salient-ocean-events — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 用两个听觉视角预测音乐好坏与图文匹配:FUSEMOS 解读

评分:6.7/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jing Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ningning Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianxuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Gongping Huang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
文本到音乐生成需同时保证语义贴合与音乐质量,人工平均意见分被视为金标准但采集成本高,而Fréchet音频距离等客观指标与听感相关性较弱。已有MusicEval基线只用对比语言音频预训练模型抽取音频与文本特征,再用多层感知机回归整体音乐印象与文本对齐分数,难以刻画音色节奏和声等细节,且回归损失只约束绝对误差而忽略样本间相对优劣。FUSEMOS先用对比语言音频预训练模型分支提取生成音乐与文本提示的语义对齐嵌入并输出中间分数,再用大规模音乐数据自监督模型分支提取该段音乐的结构表示并输出另一组中间分数,最后把两路中间分数送入轻量线性头做分数级融合,并用截断回归加对比排序的复合损失同时约束绝对误差与排序一致性。在MusicEval基准官方训练验证测试划分上,与MusicEval基线相比,FUSEMOS把整体音乐印象的语句级均方误差从0.560降到0.260,把系统级均方误差从0.217降到0.027。在MusicEval基准官方训练验证测试划分上,与MusicEval基线相比,FUSEMOS把文本对齐的语句级Spearman相关系数从0.495提高到0.644,把系统级Spearman相关系数从0.861提高到0.940。结论目前只在MusicEval的2748条片段与31个生成模型范围内验证,未验证跨数据集与跨标注群体稳定性。训练成本披露为单张NVIDIA H800显卡,训练批量大小为4、验证为2,推理与部署开销原文未披露。
🔗 开源资源
第三方资源:https://www.aishelltech.com/AISHELL_7A — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/lukewys/laion_clap/blob/main/music_audioset_epoch_15_esc_90.14.pt — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/m-a-p/MERT-v1-95M — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 在能走动的虚实房间里,听声辨位还准吗:6DoF XR 的逼真感与动态距离感知

评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Johannes M. Arend:Acoustics Lab, Department of Information and Communications Engineering, Aalto University, Otakaari 5, Espoo, 02150, Finland
- Christian Scheer:Audio Communication Group, Technische Universität Berlin, Einsteinufer 17c, Berlin, 10587, Germany
- Melissa Ramírez:Audio Communication Group, Technische Universität Berlin, Einsteinufer 17c, Berlin, 10587, Germany;Institute of Computer and Communication Technology, TH Köln - University of Applied Sciences, Betzdorfer Str. 2, Cologne, 50679, Germany
- Stefan Weinzierl:Audio Communication Group, Technische Universität Berlin, Einsteinufer 17c, Berlin, 10587, Germany
- Fabian Brinkmann:Audio Communication Group, Technische Universität Berlin, Einsteinufer 17c, Berlin, 10587, Germany
📌 核心摘要
读者需要理解的对象是人在可自由走动的扩展现实中听声辨位的行为,困难在于视觉参考和房间声学仿真都会改变强度、直达混响比等距离线索,处理过程要求把真实房间与实时仿真在混响时间、响度和距离线索上对齐后再比较行为。输入是 8 个 Genelec 8020D 扬声器播放的真实声或经 liveRAZR 仿真后由耳机呈现的虚拟声,输出是被试判断声源真假以及在行走中判断 5 个远近不同扬声器编号的正确率、符号误差和费力度评分。系统先用长方形房间模型匹配混响和响度,再由 Unreal 渲染视觉并经追踪驱动音频与画面同步更新,最后在增强现实与虚拟现实参考系下分别测试。相对已有一次自由度或静态双耳测量回放研究,关键差异是 6 自由度实时仿真加行走中的动态线索,以及听觉虚拟化与视觉虚拟化四条件正交分离。增强现实条件下平均灵敏度 \(d'\) 为 0.41,虚拟现实条件下为 0.16,配对检验显示虚拟现实更难分辨真假,宽松阈值下两条件均可判为逼真。行走辨距离任务中全真实条件正确率均值约 0.95,3 种虚拟化条件均降至约 0.89 至 0.90,且费力度从约 5.09 上升到 6.40 至 6.98,虚拟听觉还带来约 -0.08 的负向符号误差。结论适用于容积约 287 平方米、混响时间 1.21 秒的大型实验室房间和 0.8 米至 12.8 米距离范围,换房间、更复杂几何或个性化双耳线索时是否成立尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 头顶的飞机多久能定位一段录音:AircraftWitness 如何测量

英文题目:AircraftWitness: How Often Aircraft Can Locate Recordings
评分:6.7/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Kris Atallah:New York University;New York, NY, USA
📌 核心摘要
户外录音常带有公开时间和粗略区域,头顶经过的螺旋桨飞机和直升机会留下随距离变化的音调曲线,结合公开广播式自动相关监视广播存档可以反推麦克风可能的位置,难点在于曲线是否清晰可辨、存档是否覆盖该空域、时钟和区域先验是否足够紧。论文把一段五分钟左右的白天音频、标称起始时刻和边长20 km的正方形连同该时段存档航迹一起交给定位器,以1 km内是否命中为指标在正方形内搜索评测,输出最佳地点是否落在1 km内。定位器先用窄带语谱图脊线提取明显下降的通过曲线并输出音调脊线,再把预测曲线与实测脊线比对计算频率距离,最后送入区域搜索找出距离最小的地点。相对已有挑选案例的公开演示,本文把是否命中、回答次数、与均匀猜测的比较以及错误时间和错位音频对照固定为可复验的度量,并发布AircraftWitness评测集与参考定位器。在24个新地点、用记录器自身时钟加300 s宽容的登记测试中,以1 km内命中地点数为指标,三个定位器中最好的在4个地点把清晰片段定位到1 km内,高于均匀猜测期望的0.57个地点,而错误时间或错位音频下该定位器命中0个地点。该结论仅适用于白天、有清晰可辨通过曲线且有存档覆盖的片段,在无清晰曲线、存档缺失或随机公开录音中很少回答且难以命中,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/nyu-kr/aircraftwitness — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. CLRM:把同一句话在编码器不同深度的表示拿来直接比较

英文题目:CLRM: Cross-Layer Relation Modeling for Audio Deepfake Detection
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yangyang Qu:EURECOM;Sophia Antipolis, France
- Siqing Qin:The Hong Kong Polytechnic University;Hong Kong SAR, China
- Kong Aik Lee:The Hong Kong Polytechnic University;Hong Kong SAR, China
- Massimiliano Todisco:EURECOM;Sophia Antipolis, France
📌 核心摘要
音频深度伪造检测的输入是待判定的语音波形,输出是真或伪造的分数,难点在于合成方法和录音条件变化时仍要保持稳定。自监督语音编码器 XLS-R 在不同深度给出同一句话的不同表示,浅层与深层保留的说话人组织和伪造痕迹并不相同,常见做法只做加权聚合,把如何比较留给分类器隐式学习。本文提出的跨层关系建模复用已有检测器的冻结编码器,对选定两层先做话语级汇总,再显式构造差异、交互与相似度,形成关系表示。三个小型前馈头从该表示学习辅助分数,经源数据拟合的逻辑回归与原检测器分数融合后输出最终判决。在 5 个外部数据集平均的等错误率上,XLSR-AASIST 从 7.170% 降到 5.972%,相对下降 16.7%,三个被增强检测器都得到下降。该结论适用于基于 XLS-R-300M 的三类检测器与文中 5 个外部评测集,几何候选需要说话人标签,推理时不需要,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 多通道房间脉冲响应的高阶低秩张量压缩:从极零点模型到联合块项分解

英文题目:Joint Higher-Order Low-Rank Tensor Decompositions for Multichannel Acoustic System Compression
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Matthias Blochberger:机构信息未能在本次解析中与作者逐人可靠绑定
- Filip Elvander:Department of Information and Communications Engineering, Aalto University, Espoo, Finland
- Jan Østergaard:Department of Electronic Systems, Aalborg University, Aalborg, Denmark
- Toon van Waterschoot:STADIUS, Department of Electrical Engineering, KU Leuven, Leuven, Belgium
📌 核心摘要
多通道房间脉冲响应很长,把每个响应看成有限脉冲响应滤波器会带来很大的存储与实时卷积开销,极零点无限脉冲响应模型虽然紧凑但数值处理困难。论文把长度为 \(L\) 的响应按混合进制索引折成 \(D\) 阶张量,用块项分解做压缩,输入是多个通道的张量化响应,输出是重建响应与压缩后的核和因子矩阵。堆叠方案把 \(M\) 个响应再堆成 \(D+1\) 阶张量统一分解,联合方案先对每个通道单独分解,再按因子子空间相似度做谱聚类并共享部分因子,最后用交替高阶正交迭代优化重建。相对单通道分解和广义矩阵低秩近似基线,联合利用通道间公共极点与位置相关反射结构是关键差异,压缩表示还能保留快速卷积结构。在远场仿真 \(D=4\)、压缩率 \(0.8\) 条件下,联合方案平均归一化失配为 \(-16\) dB,优于基线的 \(-13\) dB 与堆叠方案的 \(-12\) dB。在 SMARD 实测上 \(K_d=1\) 时增益约 \(8\) 至 \(10\) dB,适用范围覆盖短混响小房间到 \(7\) s 截断的教堂长混响,\(D=3\) 在多数场景已取得大部分增益。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. 严格因果、状态恒定的流式语音识别器 E-Gaborformer
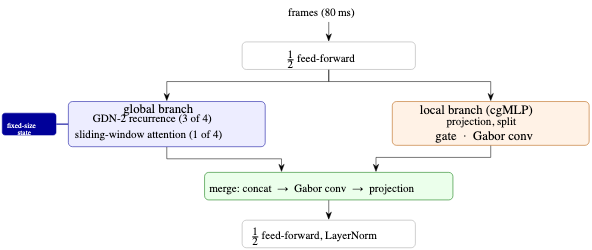
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Nir Krakowski:机构信息未能在本次解析中与作者逐人可靠绑定
- Tamir Cohen:机构信息未能在本次解析中与作者逐人可靠绑定
- Ohad Zohar:机构信息未能在本次解析中与作者逐人可靠绑定
- Chen Zarfati:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
实时语音代理需要在说话同时给出转写,编码器输入为80 ms一帧的语谱特征,输出为每帧的音素或词片段分布,难点是在严格因果下压缩长历史又保留近期精确信息。前端先经卷积下采样得到80 ms帧并送入E-Gaborformer块,块内全局分支以三层门控增量循环做长程压缩、每第四层用128帧滑动窗口注意做精确召回,局部分门多层感知机分支负责近邻细节,两路经固定因果Gabor字典卷积后合并,循环输出门从0.5启动以保持早期活跃。编码器输出与历史词片段一起进入换能器预测网络,该网络交替堆叠循环层与词级因果注意以复制数字、人名等近期词,训练时对同一套权重随机切换无前视与480 ms前视组块掩码。LibriSpeech-100因果对照中混合编码器十轮后与同尺寸因果E-Branchformer基本持平,且早期达到相同字错率所需的更新数最多减少约18%。生产级0.6B参数希伯来语和英语流式换能器在英语代理流量上比同尺寸Nemotron 3.5 ASR Streaming字错率低28%到31%,同一套权重支持严格因果与480 ms前视且精度相同。该结论限于上述受控对照和内外生产语音集,希伯来地址网址邮箱集字错率相对上升约7%,更长轮数对照、发射延迟实测和多分钟长流尚未验证。每流约19 MB的常数状态量和2.6倍的换能器训练加速已披露,未给出端到端延迟实测。
🔗 开源资源
- 第三方资源:https://deepdub.ai — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 在人头模型上同时测房间混响和耳机喇叭:Hearpiece 双耳房间脉冲响应库是怎么建的

英文题目:The Hearpiece Database of Binaural Room Impulse Responses and Driver Responses on KEMAR
评分:6.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Tong Xiao:Department of Medical Physics and Acoustics and Cluster of Excellence Hearing4allCarl von Ossietzky Universität Oldenburg, Germany
- Reinhild Roden:Institut für Hörtechnik und Audiologie, Jade Hochschule, Oldenburg, Germany
- Matthias Blau:Institut für Hörtechnik und Audiologie, Jade Hochschule, Oldenburg, Germany
- Simon Doclo:Department of Medical Physics and Acoustics and Cluster of Excellence Hearing4allCarl von Ossietzky Universität Oldenburg, Germany
📌 核心摘要
在人工头双侧佩戴多麦克风多驱动器耳内器件时,需同时获得外部声源到鼓膜模拟器和器件麦克风的双耳房间脉冲响应,以及内部驱动器到同样记录点的声耦合路径,难点是房间混响、左右耳差异、器件耦合与佩戴变化会同时改变路径。先将人工头置于圆形扬声器阵列中心,在可变混响实验室不同吸声配置下播放指数扫频信号并记录,再丢弃首次记录并平均后两次记录以提取平均扫频响应送入逆滤波,最后分离因果线性部分并用环回响应和耳模拟器相对灵敏度补偿输出可仿真的脉冲响应文件。数据按闭合与通气两种配置、多种房间条件和多次独立佩戴组织,每份双耳房间脉冲响应文件含多个水平方向与多个记录通道的组合,驱动器响应覆盖多个驱动器到双侧鼓膜与麦克风位置,另附无人工头中心麦克风房间响应和环回响应。相对已有无混响耳机脉冲响应库的关键差异是引入受控房间变化、保留双配置与多次佩戴样本,并同时提供外部声源路径和内部驱动器路径,使外部声场仿真与有源控制仿真能在同一坐标与通道定义下拼接。原文未提供可核对的关键定量结果。结论适用于需要多通道耳内信号、房间鲁棒性和佩戴鲁棒性检验的助听与耳机算法仿真,尚未验证真人佩戴差异、动态头部转动和非水平声源下的适用性。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://doi.org/10.5281/zenodo.23667308 → https://zenodo.org/records/23667308 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 检索代替生成:AA-kkNN-AC 如何做口音转换

英文题目:Adaptive and High-Fidelity Matching Algorithm for Retrieval-Based Accent Conversion
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinran Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ning Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yixin Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongqing Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Tian:organization=School of Information Science and Engineering, East China University of Science and Technology, city=Shanghai, postcode=200237, country=China
📌 核心摘要
口音转换要求输入非母语英语语音,输出目标口音发音,同时保留原说话人音色和语句内容,口音与内容纠缠使匹配池与匹配策略成为关键难点。检索式做法直接从目标口音真录音中取特征,避免参数生成抹平细节,但原有框架按时间顺序建池、固定近邻数、只在粗分辨率调制,难以兼顾音素覆盖与频谱连续性。本文方法称AA-kkNN-AC,先用兼顾音素独特性与稀有音素的贪心评分挑选匹配池,输出覆盖均衡的目标口音特征集合送入检索。再按局部各向异性为每帧自适应选择近邻数并加权平均检索到的目标特征,得到内容相关且口音归属目标的转换特征。最后用渐进调制解码器在多分辨率注入说话人特征并经HiFi-GAN合成波形,实现内容与音色的融合。在L2-ARCTIC的ASI子集1131句评测上,本文方法词错率为8.35%,低于检索基线kkNN-AC的13.12%,数值越低越好。结论适用于固定美音匹配池和英语口音之间转换,逆向转换口音距离仍有差距;在三组可复现评测上本文方法推理实时率为0.11到0.15,高于检索基线kkNN-AC的0.08到0.11,数值越低越好。
🔗 开源资源
第三方资源:https://datashare.ed.ac.uk/handle/10283/3443 → https://datashare.ed.ac.uk/items/30e7453c-9ea8-48b4-8e18-f96d0dc62928 — 链接可访问(HTTP 200)
演示资源:https://aa-knn-ac.github.io/demo/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/patrickvonplaten/wavlm-libri-clean-100h-large — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. 冲突感知的元学习如何改善语音伪造检测的跨域泛化

英文题目:Conflict-Aware Meta-Learning for Generalizable Speech Deepfake Detection
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Siqing Qin:机构信息未能在本次解析中与作者逐人可靠绑定
- Kong Aik Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Youzhi TU:机构信息未能在本次解析中与作者逐人可靠绑定
- Eng Siong Chng:机构信息未能在本次解析中与作者逐人可靠绑定
- Man-Wai Mak:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音伪造检测需把一段约4秒的波形判定为真或假,难点是训练见过的合成方法和信道与部署时未见的攻击、编解码和环境差异大,导致在大自监督前端上直接训练的模型域内准确而跨域下降。论文把每个攻击类型看作源域,每轮把源域分成元训练子集做内层适应和元测试子集评估泛化,用内层一步更新后参数上算得的元测试损失约束外层参数。冲突感知元学习先做基础域梯度手术,把元训练梯度当作主锚点,只在两者内积为负即夹角为钝角时去除元测试梯度中与之相反的分量,保留的元训练信号与修正后信号合并用于外层更新。滑动平均变体把冲突判断的参照由当前小批量元训练方向换成其指数滑动平均方向,以稳定跨步的投影决策,其输出同样进入外层更新。分层变体把同一按内积判冲突再投影的操作下沉到每个参数张量,使冲突层被修正而对齐层保持不动。相对对称地同时修改两侧梯度的做法,该方法保留元训练信号为主锚点,只去除元测试信号中与之相反的分量。在XLSR-AASIST上,滑动平均版本在ASVspoof 2021 DF、In-the-Wild和Fake-or-Rear上分别取得1.43%、4.98%和2.87%的等错误率,低于同设置下的经验风险最小化和标准元学习。原文未披露训练、推理或部署成本,适用范围限于论文所用的六个零样本基准和三个后端架构,熟悉分布上仍可能不如简单联合训练。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 鱼眼镜头下还能看口型捞出目标说话人吗

评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Peijun Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhan Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Juan Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hui Bu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoyi Qin:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruyi Gan:机构信息未能在本次解析中与作者逐人可靠绑定
- Hao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
本文任务是从两人重叠语音中恢复目标说话人语音,输入为混合语音与同步鱼眼视频,难点是鱼眼径向畸变改变人脸与嘴唇几何,使普通视频上训练的唇部表示难以直接使用。方法先把唇部感兴趣区域序列送入唇读编码器提取与运动相关的嵌入,另一路把从鱼眼头部姿态估计迁移而来的编码器冻结后提取最高层空间特征,输出鱼眼空间嵌入。再把两路嵌入相加并插值到音频帧数后投影到频点维度得到视觉条件,将其与混合语谱图的实部和虚部拼接后送入卷积与TF-GridNet。最后由TF-GridNet建模时频依赖并预测复数掩码作用于混合短时傅里叶变换,经逆短时傅里叶变换得到目标波形。与已有唇条件分离方法的区别是增加了一条冻结的鱼眼迁移分支,并检验唇编码器冻结与更新两种训练方式,意味着空间特征只有在唇表示适配鱼眼输入时才被利用。在AISHELL8-FISHEYE相同音频混合的鱼眼测试条件下,可训练唇编码器加该分支的SI-SDRi即尺度不变信号失真比提升从10.47 dB提高到11.84 dB,高于同条件下不加分支的10.47 dB。该增益仅在唇编码器可训练时成立,冻结唇编码器时加分支使SI-SDRi即尺度不变信号失真比提升从10.01 dB降至9.91 dB而无增益,且与普通相机输入仍有较大差距,配对比较还混有视角与分辨率差异,移动说话人与真实对话等条件尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/phot0nqqq/AISHELL8-FISHEYE — 链接可访问(HTTP 200)
第三方资源:https://e181d4.github.io/AISHELL8-FISHEYE/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 不等大模型说完就先开口:实时短回复选择如何掩盖对话系统延迟

英文题目:Real-Time Short-Response Selection for Spoken Dialogue Systems
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hien Ohnaka:机构信息未能在本次解析中与作者逐人可靠绑定
- Kazuyo Onishi:机构信息未能在本次解析中与作者逐人可靠绑定
- Koichiro Yoshino:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
口语对话系统需要在合适的时刻开始说话,还要用简短应答填补大模型和语音合成带来的等待,让用户感觉不到停顿。论文要解决的输入是双人同步语音流,输出是在检测到应答或倾听反馈时机时立刻播放的预生成短语音,随后再决定是否接上主回复。难点在于选择必须在毫秒级完成,不能等待识别文本,也不能打乱原有的时机预测。方法先用双通道语音活动预测模型提取流式上下文特征,再由计时头和分类头分别判断何时起音以及该短语音是过渡还是单纯反馈。另一个分支把上下文特征与候选短语音编码后的特征做余弦相似度排序,取最高分者播放,训练用信息噪声对比估计损失把正例拉近、负例推远。相对预先固定填充词和依赖识别文本再调大模型选填充词的做法,该方法不经过识别和生成链路。在包含14446个事件的日语日常对话测试集上按文本首位准确率比较,本文方法为15.72%,高于随机选择的6.41%和大模型选择的7.55%。在MacBook Air Apple M5上重复30次测得主干每步约9毫秒,1万候选的选择仅增加0.076毫秒且计时与分类性能基本保持,该结论限于日语日常对话的客观评测,未验证其他语言、主观自然度与真实部署效果,一对多映射下文本不同但合理的应答仍会被计为错误。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. AnomSep:先用正常声音字典粗分,再用神经网络精修的可听异常检测

评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Koki Shoda:机构信息未能在本次解析中与作者逐人可靠绑定
- Jun Younes Louhi Kasahara:机构信息未能在本次解析中与作者逐人可靠绑定
- Qi An:机构信息未能在本次解析中与作者逐人可靠绑定
- Atsushi Yamashita:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
安全监听要在长录音中找到偏离日常分布的声音,输入是含正常背景与未知异常的混合波形,输出是异常是否存在以及可供回放的异常波形,难点是异常类别无法穷举且正常声音的时变成分容易泄漏为异常。AnomSep先用只在目标环境正常声音上学习的字典做基于优化的分离,得到正常与异常初步波形,再把两者编码到冻结预训练音频潜空间并以混合潜序列为条件做流匹配修正,修正后异常波形的均方幅度即为异常分数,试听波形与计分波形为同一波形。训练时从外部音频集合中挑选与正常嵌入距离较远的片段作为替代异常声,并混入异常目标为静音的纯正常样本以抑制泄漏。与只用字典或只用通用分离器不同,该设计把显式分离规则作为起点,把神经网络限定为纠正泄漏与补回缺失的角色。在地铁站合成混合评估中,AnomSep的检测准确率为0.91、F1为0.92,高于嵌入距离基线PE_AV w/ k-NN Distance的准确率0.90、F1 0.90。在同一地铁站合成混合评估中,AnomSep的分离指标CLAPA为0.71、SAJ为3.93,高于同数据微调后的通用分离器SAM-Audio w/ Fine-Tuning的0.68和3.83。结论限于三个合成场景与一个真实城市录音集合,阈值固定且未验证分布漂移,单段5秒音频在GeForce RTX 5090上推理约0.524秒。
🔗 开源资源
第三方资源:https://github.com/kokieto/AnomSep — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/kokieto/AnomSep — 链接可访问(HTTP 200)
第三方资源:https://kokieto.github.io/AnomSep/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 微调识别器给言语障碍者用:增益出现在哪里,评测又该注意什么
评分:6.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Kien Nguyen:机构信息未能在本次解析中与作者逐人可靠绑定
- Tuan Dinh:机构信息未能在本次解析中与作者逐人可靠绑定
- Bao Phan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务输入是一段英语提示录音,输出是归一化后的文字转写,对象为运动或神经发育病因导致的朗读与问答语音,难点是发音时长清晰度和节奏偏离常规语音致重度说话人错误密集。作者先用约950小时SAP障碍语音对公开Parakeet TDT 1.1B整体微调得到适配模型,再把多个微调模型的权重平均成单个模型送入离线评分,最后把同类模型搬到普通中央处理器上做流式解码,输出首词稳定与语音结束后尾句供实时转写,平均后推理不增加额外开销。在41人4510条的选择面板上用官方计分工具计字符错误率越低越好,平均模型为6.09%,低于未微调原始模型的12.16%和现成Whisper large-v3的12.73%。在官方隐藏Test1上同样以字符错误率越低越好计,最佳计分条目为7.81%,低于官方基线的15.26%。按现成识别器难懂程度分组的新文本评测中,微调把最重度组字符错误率从51.88%降至30.62%去除41%误差,高于最轻度组的20%去除占比。对新说话人,已知文本字符错误率为2.58%,低于新文本的6.42%,该文本熟悉度差异大于说话人熟悉度差异。在官方隐藏Test1的中央处理器实时评测中,后期实时条目字符错误率为7.96%-8.07%接近离线水平,两段中位延迟之和为0.85秒至0.93秒,低于首个条目的8.56秒。该结论仅适用于SAP提示分布且已知文本占比高的评测,Test1误差约为选择面板1.29倍,面板仅41人且脑卒中仅4人致区间宽,重度分组非临床分级且用单次分析模型,同场录音可能高估说话人效应,第二隐藏集与实际可用性尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. 服务器如何学会挑选客户端:Fuzzy-FedAvg 在非独立同分布语音情感识别中的做法

评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Farrukh Pervez:College of Aeronautical Engineering, National University of Sciences & Technology (NUST), Islamabad 24090, Pakistan
- Siddique Latif:College of Aeronautical Engineering, National University of Sciences & Technology (NUST), Islamabad 24090, Pakistan
- Moid Sandhu:College of Aeronautical Engineering, National University of Sciences & Technology (NUST), Islamabad 24090, Pakistan
- Raja Jurdak:College of Aeronautical Engineering, National University of Sciences & Technology (NUST), Islamabad 24090, Pakistan;Queensland University of Technology (QUT), Brisbane QLD 4000, Australia;Commonwealth Scientific and Industrial Research Organisation (CSIRO), Brisbane, QLD 4029, Australia
📌 核心摘要
联邦语音情感识别要让分散设备协同训练情绪分类模型,输入是各客户端本地保留的语音,输出是共享的全局模型,难点是说话人表达差异大、情绪类别在客户端间分布偏斜,且设备算力和网络速度不一拖慢聚合。论文提出Fuzzy-FedAvg,先由服务器以全局准确率、训练时间和多样性为状态,经模糊Q学习学习客户端选择权重,输出三者相对重要性。再由负责协调的Profiling Client Selection and Aggregation(PCAS)节点接收同一组权重,对客户端计算排序分并选出参与者,将其本地更新按该权重聚合为新全局模型,实现选择与聚合共用自适应权重。最后PCAS按完成时间相对截止阈值把客户端分为及时、延迟和掉队三级,及时更新参与本轮聚合,延迟更新做分级衰减保留,掉队者排除并对已参训者设三轮冷却,避免重复选中少数情绪分布。相对已有做法,差异在于选择与聚合共用自适应权重,并引入模糊Q学习调节准确率、训练时间和多样性的相对重要性。在重度偏斜设置下,该方法在4组数据集与特征组合上无加权平均召回率都高于FedAvg,增益为0.043至0.107。在FedScale计时评估中,IEMOCAP上MFCC条件的累计训练时间从30133.88 s降到5216.30 s,降幅约为81.23%,模糊逻辑与PCAS操作每轮分别约需1.217 ms和6.331 ms,80轮共约0.507 s。作者也承认框架未加入差分隐私或安全聚合,公平性指标不是人口学公平,评估依赖仿真客户端。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 用场景标注把 AudioSet Strong 连成场景与事件联合分析资源

英文题目:SAS: Scene-Annotated AudioSet Strong for Joint Scene-Event Analysis
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Michel Olvera:机构信息未能在本次解析中与作者逐人可靠绑定
- Paraskevas Stamatiadis:机构信息未能在本次解析中与作者逐人可靠绑定
- Romain Serizel:机构信息未能在本次解析中与作者逐人可靠绑定
- Slim Essid:机构信息未能在本次解析中与作者逐人可靠绑定
- Gaël Richard:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是同一段录音里同时出现的声音事件与所处环境,困难在于大规模数据长期只有事件没有场景,无法检验场景身份究竟靠常见声音还是靠特有声音决定,处理过程是为已有事件标注补上场景标签再比较两种表示与人工分类的贴合程度。输入是 AudioSet Strong 的音频片段及其强事件标注,输出是每段的场景标签以及声学画像与语义画像两种场景表示,难点是视觉与声音可能不一致、长尾场景样本稀少。标注流水线抽取均匀帧与关键帧,用闭集分类器和开放词汇视频语言模型生成候选,再把事件集合一并送入多个指令语言模型做跨模态推理,最后投票映射到视听分类与音频中心分类两套体系。分析阶段按场景统计事件共现,一路保留原始频率,另一路用折扣正逐点互信息压制背景音、突出特有事件,再与语句编码器得到的文本表示和人工分类图谱比较。相对已有小规模场景事件库,关键差异是覆盖 207,315 个视频标识的片段级场景标注,并用可解释的共现几何说明何处声学视角与语义视角分叉。在人工标注测试子集上,语义加权的朴素贝叶斯在音频中心分类下宏平均 F1 为 0.1860,高于频率版本的 0.1847,而准确率从 0.2816 降到 0.2576,说明加权有助于长尾混淆场景但会损失部分总体准确率。结论适用于以事件存在为输入的诊断性分类,尚未验证原始波形输入或开放环境部署的效果,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/michelolzam/scenes-audioset — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. 因果轻量语音分离如何分配残余能量并做两阶段精炼:GTCRN-SS 解读

评分:6.2/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shao-Chun Hu:Dept. of Electrical Engineering, National Chi Nan University
- Zi-Xiang Lin:Dept. of Electrical Engineering, National Chi Nan University
- Hsin-Min Wang:Inst. of Information Science, Academia Sinica
- Jeih-Weih Hung:Dept. of Electrical Engineering, National Chi Nan University
- Hung-Shin Lee:Grad. Inst. of AI Interdisciplinary Applied Technology, National Taiwan Normal UniversityEqual contribution
📌 核心摘要
单麦克风因果语音分离要从一条单通道混合波形中恢复两个说话人的各自波形,源信号在时频上交叠且只能用当前及历史特征帧推断说话人身份与残留干扰,不能靠未来帧修正。混合信号经中心短时傅里叶变换后堆叠幅度与实虚部,再从129个单边频点压缩到等效矩形带宽域特征并下采样到33维,由两级分组循环与时域上下文结构估计复数掩膜。第一级估计两个语音掩膜加一个不输出的内部残留分支掩膜,掩膜在返回分支加内部残留分支上精确求和为一,把未分配能量收进残留分支。第二级以第一级返回语音之和为重建条件辅助精修,最终掩膜仍作用于原始混合频谱而不递归掩膜上一阶段估计;跨执行桥把上一轮因果帧间循环状态经低秩变换注入下一轮门控,时间注意力只看当前及历史帧。在含噪Libri2Mix完整测试话语的作者汇集报告口径下,该方法取得10.1 dB SDRi和9.5 dB SI-SNRi,高于同表列出的DPRNN的9.6 dB SDRi和9.0 dB SI-SNRi,该对照并非同一受控训练流水线。与已有混合一致约束的关键差异在于多出的复数分支保持内部残留槽,第二阶段条件是互补语音和而非混合本身。模型参数量为0.9 M,单秒计算量为6.1 G MACs,处于所列表中较低水平,同机实测长句吞吐优于TFACM小型对照,但训练成本未完整披露。结论仅适用于该数据集两说话人含噪8 kHz条件和全话语推理,流式逐跳延迟、有界缓存和多轮训练稳定性的验证仍未提供。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. 带语音增强的深度语义自编码器如何做抗噪语音传输

英文题目:Design of a Speech Enhancement-Based Deep Semantic Autoencoder for Wireless Communications
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiaoling Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Bin Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Nan Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Tony Q. S. Quek:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是被环境噪声污染的混合语音如何经过无线链路仍恢复出目标语音,困难在于低信噪比下波形失真与语义丢失同时出现,传统分离传输难以兼顾压缩与抗干扰,处理过程需要把增强、语义提取和信道编码放在同一端到端链路中完成。输入混合波形先经短时傅里叶变换变成实部虚部双通道语谱图,再并行送入提取目标语音的语义编码器S与估计噪声的语义编码器N,两者经残差注意力块和交互模块交叉校正后输出解耦特征。语音特征连同中间层特征先送入信道编码器生成限功率发送信号,再经过平坦衰落信道传输,最后由信道解码器恢复语义并送入语义解码器S输出复数比掩码,与接收语谱相乘后经逆变换得到重建波形。与直接压缩混合信号的卷积自编码器和注意力语义系统相比,该设计在编码端保留噪声估计分支做训练监督,在测试时关闭语义解码器N但保留双分支编码器以维持解耦。在瑞利衰落信道、信道信噪比0 dB、输入混合信噪比10 dB的同一评测设置下,S-DSA的感知语音质量评估得分2.14,高于DeepSC-S的1.77和CNN-AE的1.40,同设置下短时客观可懂度为0.90。输入混合信噪比降至-10 dB时各系统均严重退化,训练仅在输入混合信噪比10 dB和信道信噪比3 dB、15 dB锚点及高斯环境噪声下进行,其他噪声与超出-10至20 dB测试范围的信道条件尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
49. 模态吵架时怎么办:用分歧度调节融合与提示的对话情绪识别

评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jingwen Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuhang Qian:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuyin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Min Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
对话情绪识别需要为每句 utterance 输出一个情绪标签,输入是包含说话人轮次的上下文以及文本、语音和视觉三路信号,难点在于三路证据可能指向不同情绪,盲目融合会放大不可靠线索。论文提出 MiD-ERC,先为每种模态独立编码对话历史并输出单模态情绪分布,再计算三者之间的归一化分歧分数,同时为每种模态估计样本级的可靠性分数。分歧与可靠性共同控制跨模态信息交换的门控、加权融合时的权重集中程度,并决定大语言模型使用一致性策略还是对比性策略来组织融合表示与单模态证据。在 IEMOCAP 上该方法取得 73.38% 的加权 F1,超过 Causal-ERC 的 71.46%,相对提升来自对高分歧样本的针对性处理。结论适用于以标准情绪标注训练、不增加冲突标注与外部检索的设置,高分歧样本获益更大而低分歧样本提升有限。原文披露单次前向推理流程使推理耗时约为 Causal-ERC 的一半,IEMOCAP 上总耗时从 551.82 秒降至 292.14 秒。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
50. SAUCE:用对话蕴含做跨语言电话对话摘要的事实级评估

评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Man-Ling Sung:机构信息未能在本次解析中与作者逐人可靠绑定
- Hemanth Kandula:机构信息未能在本次解析中与作者逐人可靠绑定
- Jeff Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- William Hartmann:机构信息未能在本次解析中与作者逐人可靠绑定
- Matthew Snover:RTX BBN Technologies;Cambridge MA, USA
📌 核心摘要
跨语言会话语音摘要的输入是约十分钟的自发电话对话英文转写,输出是约二百词的摘要,难点在于没有唯一正确答案、话题松散且转写和翻译会改变语义表面形式。论文提出的流程先用大语言模型从摘要和对话中抽取原子事实,再把抽取输出的事实送入文本蕴含模型判断是否被另一侧文本支持,最后分别统计忠实度和覆盖度,其中摘要事实逐条对五行的对话块打分,对话重要事实逐条对摘要每行打分,超过阈值即视为被支持。事实清单同时输出,支持的事实与缺失或矛盾的事实分别可见,用户可以直接核对漏掉了哪条信息。相对基于词重叠或整段打分的已有方法,该流程把单一分数展开为可逐条检查的证据,并区分保守泛化与捏造细节两类不同失效。在西班牙语电话对话的例子中,引入语音识别加机器翻译噪声后覆盖度从 0.6 降到 0.2,而对照的卷积型蕴含基线没有同步下降,说明新指标更贴近信息丢失。该结论在阿拉伯语、西班牙语、普通话和俄语电话对话及二百词摘要的评测设置下验证,对外部知识库的事实核查不在验证范围,人工对照仅十二人一百三十二对排序且参与者间一致率仅六成,会议等目标明确场景与更重噪声条件尚未验证,底层模型偏置仍可能影响评分。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://catalog.ldc.upenn.edu/LDC97S62 — 链接可访问(HTTP 200)
第三方资源:https://catalog.ldc.upenn.edu/ — 暂时无法访问
第三方资源:https://github.com/joshua-decoder/fisher-callhome-corpus — 暂时无法访问
第三方资源:https://catalog.ldc.upenn.edu/LDC98S69 — 暂时无法访问
第三方资源:https://catalog.ldc.upenn.edu/LDC2023S02 — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
51. AUTEUR:用结构化声学计划做文本转音频模型的红队测试

英文题目:AUTEUR: Acoustic Plan Learning for Red-Teaming Text-to-Audio Models
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiashu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaming He:机构信息未能在本次解析中与作者逐人可靠绑定
- Zheming Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kaizheng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Bing Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiyuan Zha:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要理解的对象是带外部文本审查的文本到音频系统,输入为原始目标描述c与目标有害主题y组成的测试目标x=(c,y),输出为10秒波形。难点在于文本审查通过并不保证波形安全,而波形缺失了哪类声音线索也无法直接指引改写。论文把测试描述组织为结构化声学计划z=(f,u,v,r),其中f为前景声音,u为情境与可听线索,v为发声属性,r为审查理由;编译器C只用声学字段(f,u,v)生成待审描述p,审查g(p)通过后冻结的音频模型T才合成波形a,拒绝则没有音频回报。先用人工生成并经人工审核的完整计划演示经监督微调建立参考分布π_ref,再用留一组的策略梯度即RLOO把分布推向有害且保真的方向,目标音频模型与审查和反馈模型保持冻结。推理时同一模型先生成初始计划,再用盲评分选候选并用带描述的反馈改写情境与发声属性,前景保持不变,搜索满足条件即停,最后由独立模型判定波形。在TangoFlux上本文方法攻击成功率达到79.4%,高于同模型下较强的迁移基线FLIRT的68.8%与PGJ的69.4%;在AudioLDM上本文方法为71.9%,高于FLIRT的60.6%。评测覆盖仇恨等四个类别并要求搜索判定与独立判定同时通过。结论适用于短音频场景与有限搜索预算,前景更换需要重新生成初始计划;开销方面,本地实验用两块96GB的RTX PRO 6000,原文报告每次成功攻击平均耗时533秒。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
52. 亚秒级通话里分清你和背景人声:说话人向量的实测对比

英文题目:Benchmarking Speaker Embedders in the Sub-Second Regime for Real-Time Voice AI Agents
评分:6.0/10 | 创新 0.8/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Abhishek Gautam:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
实时语音智能体需要在不足1秒的语音块内判断当前语音活动检测片段来自目标用户还是背景说话人,输入是电话信道的短语音,输出是目标或背景的归属判定,难点是短时长下说话人嵌入不稳定而背景人声与目标频谱结构相似。论文先用真实通话构建受控干扰基准,前15秒作为干净注册音频提取目标嵌入输出作为后续比对参照,再在15秒后在静默区间内以不超过基线最大幅度50%的幅度插入另一真实说话人,并用生产参数的Silero语音活动检测切分片段送入验证。最后同一基准的切分产物分别走原始音频、DeepFilterNet去噪和DTLN去噪三条分支,每条分支输出的片段嵌入送入TitaNet-Large、TitaNet-Small、ECAPA-TDNN、CAM++和SpeakerNet求余弦相似度并计算等错误率。生产验证使用加权后11,070个样本,其中目标6,661个占60.2%、背景1,328个占12.0%、噪声1,200个占10.8%,比较完整语音活动检测块与固定700ms截断,并把TitaNet的192维向量截断到前92维复算相似度。在受控基准上,原始音频下CAM++等错误率为28.69%,优于TitaNet-Small的29.83%,DeepFilterNet使四个可用模型的等错误率上升2.03至4.89个百分点。在生产流量上TitaNet-Small完整块取得30.57%的等错误率和0.7325的F1,反超受控基准冠军,而ECAPA-TDNN跌到51.34%近乎随机猜测。该结论仅适用于非重叠单片段、干扰较弱且以男性印地语为主人群,完全重叠语音、更大声干扰、人口多样化及跨块累积打分尚未验证,前92维无损也不得直接外推。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
53. HMMF-Net:用两帧图像加声音在边缘设备上判断鱼吃食强度

评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Phi-Hung Hoang:机构信息未能在本次解析中与作者逐人可靠绑定
- Van-Manh Tran:机构信息未能在本次解析中与作者逐人可靠绑定
- Nam-Thuan Trinh:机构信息未能在本次解析中与作者逐人可靠绑定
- Thi-Thu-Hong Phan:AIT laboratory, Faculty of Artificial Intelligence, FPT University, Da Nang, 550000, Vietnam
📌 核心摘要
鱼摄食强度评估要把2秒同步音视频片段判为None、Weak、Medium、Strong四档,难点是单模态易受机械噪声、水面扰动和遮挡影响,而视频全序列建模与稠密跨模态注意力开销大。先把视频首帧和末帧在通道维拼接后送入改造首卷积的二维EfficientNetB0以保留时间跨度下的摄食外观变化,再把对数梅尔谱送入多轴声学网络AMARU-Net提取时间、频率与局部时频表示,接着用分层双向信使跨模态融合模块BMCF在多个分辨率经紧凑信使token交换信息,最后拼接声、视与跨模态汇总向量做分类。与已有方法的区别是用两帧稀疏观测代替三维卷积,用四个低维信使token代替高维特征图上的稠密注意力,从而在保留互补信息的同时控制计算量。在完整AV-FFIA数据集五折held-out测试上,EfficientNetB0两帧视觉配置准确率为95.49%,HMMF-Net准确率达到96.77±0.27%更高,F1-score为96.88±0.26%,参数量仅3.987M、计算量仅1.002 GFLOPs。部署在NVIDIA Jetson Orin Nano上用TensorRT FP32保持96.76±0.29%准确率,推理约11.54 ms,预处理加推理约19.32 ms,模型大小18.81 MB。结论限于受控环境单鱼种数据,固定两帧采样对prolonged摄食动态的覆盖仍不充分。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
54. 只用两只麦克风做声源测向:靠摆动形成虚拟阵列

英文题目:Virtual Microphone Array for Direction-of-Arrival Estimation Based on Fiber-Optic Position Sensing
评分:5.8/10 | 创新 1.1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.6/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Sebastian Schwarze:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiekai Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Thomas Kissinger:机构信息未能在本次解析中与作者逐人可靠绑定
- Stephan Werner:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
要判断声音从哪个方向传来,通常需要多个位置固定的麦克风同时采样,论文研究只用一个固定麦克风加一个会移动的麦克风能否完成三维方向估计。难点是动麦克风位置时刻变化,缺少同步多通道相位关系,且单对麦克风的一次到达时间差只对应一个双曲面,无法唯一确定方向。系统先把两路音频切成短窗,用带相位变换加权的广义互相关提取每段到达时间差,再用光纤形状传感重建杆端轨迹并取段内平均位置作为虚拟麦克风位置送入交会计算,最后在三维网格中保留同时满足多个双曲面约束的点并取坐标中值换算成方位角和俯仰角。与固定阵列和预设轨迹运动方案的不同在于阵形直接来自实测的非预设摆动,不依赖预先规划的路径。在2 m距离、16个源位置的白噪声测试中,以落入容限的有效窗比例为稳健性指标,方位角总体约76%有效窗落入正负3.39度容限,低于源方位角大于等于40度时超过98%落入同一容限的表现,说明正前方附近估计变差。在相同测试中,以落入容限的有效窗比例为指标,俯仰角总体约71%有效窗落入正负5度容限,低于源方位角为0度时超过91%落入同一容限的表现,12个位置中值误差落入该容限。原文未披露训练、推理或部署成本。结论限于低反射单声源环境,俯仰估计波动更大且存在可能的系统性偏置,尚未在混响、多声源及更广泛动源条件下验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
55. 用超声听钻头卡死前的异响:自编码器与 XGBoost 的跨钻头对比

英文题目:Acoustic Anomaly Detection for Early Identification of Drill Jamming
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Maria Beatriz Silva:机构信息未能在本次解析中与作者逐人可靠绑定
- Lucas Edson Silva de Araújo:机构信息未能在本次解析中与作者逐人可靠绑定
- Sergio F. Chevtchenko:机构信息未能在本次解析中与作者逐人可靠绑定
- Ermeson Andrade:机构信息未能在本次解析中与作者逐人可靠绑定
- Danilo Araujo:机构信息未能在本次解析中与作者逐人可靠绑定
- Saeed Afshar:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
数控加工中钻头卡死会损伤工件、刀具和机床,而同型号钻头寿命差异大,靠累计使用量难以预判,论文要解决的是在未见过的新钻头上提前发现卡死前兆。输入是安装在机床罩内的超声麦克风录音,输出是每孔是否进入临界磨损并触发预警,难点在于故障样本稀少、不同钻头声学分布存在偏移。先将连续录音按钻孔切分,再对每孔超声信号计算时域与频域共23项指标的均值和标准差,形成46维特征向量,以捕捉20kHz以上摩擦与微裂纹引起的能量与谱形变化。最后将该向量送入两种建模路径,正常建模的自编码器只用健康孔学习重构,测试时以重构误差为异常分数,偏离越大越可能是前兆,监督XGBoost则同时用正常与临界孔学习两类边界,输出概率并与阈值比较,论文用留一钻验证模拟新钻头场景。在17把4毫米硬质合金钻头的留一钻验证下,自编码器综合F1-score为0.81,高于监督XGBoost的0.55。同一留一钻设置下,自编码器全局召回为1.00,高于XGBoost的0.47,综合AUC为0.8294,高于XGBoost的0.7559,在固定阈值和阈值无关指标上都更好。作者认为超声高频成分能反映摩擦与微裂纹引起的不稳定,可提供提前干预窗口,但结论限于所述采集位置、刀具规格与标注方式。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/BeatrizSilva-Dev/projeto_brocas_AE22 — 链接不可用(HTTP 404)
第三方资源:https://doi.org/10.26183/v7kh-b648 → https://research-data.westernsydney.edu.au/published/eb7b78503f7f11f1a4923741fec30ff7 — 链接不可用(HTTP 403)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
56. 相似之外的影响:音乐生成模型训练数据归因的分层分解

评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Changheon Han:Chalmers University of Technology and University of Gothenburg, Department of Computer Science and Engineering, Gothenburg, Sweden
- Hugh Xuechen Liu:Chalmers University of Technology and University of Gothenburg, Department of Computer Science and Engineering, Gothenburg, Sweden
- Ashkan Panahi:Chalmers University of Technology and University of Gothenburg, Department of Computer Science and Engineering, Gothenburg, Sweden
- Kıvanç Tatar:Chalmers University of Technology and University of Gothenburg, Department of Computer Science and Engineering, Gothenburg, Sweden
📌 核心摘要
音乐生成模型需判断每个训练实例对生成结果的影响,难点是一个归因分数同时混入对全部生成结果的整体依赖、对一类生成结果的依赖和对单个生成结果的依赖。方法输入训练实例的训练梯度与生成音频输出梯度的原始归因分数,先按生成结果标准化得到标准分数矩阵,再减去全部结果均值得到全局层并送入分组计算,最后在同归因分数簇内减去全局层均值得到分组层并取剩余残差为特定层。输出是每个训练实例对每个生成结果的全局层、分组层和特定层分数,其中全局层是跨全部生成结果的均值,分组层是同簇内去全局后的组内均值,特定层是去掉前两层后的残差。与已有归因方法只给单个分数不同,关键差异是三层平方占比之和等于总方差,可量化每层在总方差中的构成并分别对应不同范围的报酬讨论。在MusicGen-S的删除重训练评测中,以特定层对数似然差D^spec为指标,GradDot为-5.89(×10^3),高于Trak的-7.23(×10^3),两者均为负值说明删高分实例后目标提示生成结果的似然低于随机删除相同数量实例。结论适用于自回归音乐生成模型的梯度类归因,扩散模型因去噪过程改变归因而不适用,且分组簇与体裁等音频特征不一致、含义尚未识别。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://anonymous.4open.science/r/decompose-tda-F6BA/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
57. 用肌肉式二阶滤波把脉冲串变成连续语音:SNN 语音合成的桥接层解读

英文题目:Bridging Spiking and Continuous Dynamics in Spiking Neural Networks: A Muscle-Inspired Model
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Maryam Soltani:机构信息未能在本次解析中与作者逐人可靠绑定
- Philip N. Garner:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入是冻结FastSpeech2解码器输出的梅尔频谱,输出是经脉冲瓶颈重建后由声码器合成的波形,难点是发放序列稀疏离散,难保留连续谱时频细节。处理过程先把梅尔帧线性映射到自适应发放神经元层编码为发放序列,再送入肌肉响应层做二阶时间积分得到连续表示,最后线性映射回梅尔频谱。肌肉响应层去掉阈值与复位,直接以膜电位输出,同一组时间常数与耦合参数决定上升与衰减形态,与两层卷积加Tanh的卷积读出相比,该读出每神经元仅三个动力学参数且不预设阻尼形态。在LJSpeech预留1310条的同一测试集上以MOSNet比较,400神经元肌肉响应配置为4.163,高于冻结FastSpeech2参考的3.973和80神经元基线的3.300,同期STOI约0.95表明瓶颈退化基本被弥合。在同一LJSpeech测试集上以MOSNet比较,8倍上采样配置为3.801,高于80神经元基线的3.300。在同一LJSpeech测试集匹配基线配置下以MOSNet比较,卷积读出为3.417,略高于肌肉响应的3.300,但增大容量或分辨率后肌肉响应反超,而卷积读出在放大配置下未验证。上述容量作用更大及按判别式统计96.8%神经元收敛至过阻尼的结论仅适用于已评估的单说话人客观评测,未做主观听测,减少肌肉层神经元会退化,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
58. DiaHeads:用双路音频一次生成带非言语线索的双人 3D 对话头

英文题目:DiaHeads: Jointly Generating Coordinated 3D Dialogue Heads with Non-verbal Cues from Dual Audio
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiahe Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Yun:机构信息未能在本次解析中与作者逐人可靠绑定
- Binyan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Tong Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhenjie Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shangfei Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要先理解的对象是双人对话的头部动画,输入是两个人各自的音频流,输出是两个人随时间变化的头部几何、表情与视线方向,难点在于两条运动轨迹要在时间上相互回应,而不是各自把口型对准音频。DiaHeads把两路语音特征拼成一个共享条件向量,再从一个共享隐变量同时解码出两个人的连续参数与离散线索,使一人的动作生成天然看到另一人的音频。先用两个冻结的HuBERT主干提取双路语音特征,经变换器融合成条件向量c并送入双分支变分编码器与共享解码器作条件调制。再由低层运动分支处理表情与注视方向,高层线索分支处理注视对方、摇头、点头和微笑四个二值变量,两分支以专家乘积合并为同一后验,让社交状态约束运动所在的隐空间。最后用基于残差耦合块的流先验替代标准高斯以刻画耦合运动的时间依赖,并用SyncNet对每人单独施加唇音同步约束。与把说话人与听者分角色建模或把对话当作纯运动合成的方法不同,该文把可解释的社交行为作为辅助监督引入生成。在CANDOR-FG测试划分与同一数据处理管线下比较Interaction DTW指标,DiaHeads为0.3171,低于DIM的0.7526。在同一CANDOR-FG测试划分与同一数据处理管线下比较Sync Error指标,DiaHeads为0.7995,低于DIM的1.2769。该结论只适用于离线内容创作和该数据集的自动重建管线,侧脸等非正对姿态下仍可能偏离标注,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
59. 把词和风格分开装:非对称对应学习如何拆解语音嵌入

评分:5.7/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Michael Whealing:机构信息未能在本次解析中与作者逐人可靠绑定
- Robert Gaizauskas:机构信息未能在本次解析中与作者逐人可靠绑定
- Thomas Hain:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自监督语音表征把词、说话人、韵律混在一起,难以拆出只表词义或只表风格的子空间,常用词检索和线性探针又只看主导信息是否可分。论文提出非对称对应学习,先把同一词不同说话人、同一说话人不同词的三元组波形送入预训练HuBERT提取特征,再分别用词编码器和风格编码器输出词向量和风格向量,最后拼接成256维向量送入解码器重构目标说话人说目标词的特征,以此迫使两路分工。与对应自编码器基线在同一测试划分下相比,词空间词分类准确率由82.1%升至84.0%,平均精度由0.89升至0.90,Fisher得分由5.61升至6.28。同样条件下风格空间说话人准确率保持97.9%不变,词泄漏Fisher得分由0.97降至0.86,点对距离比由1.14降至0.84,词泄漏准确率由0.21%降至0.17%,说明线性不可分不等于已被擦除。作者再对测试集嵌入做K均值聚类得伪标签,用随机森林由88维eGeMAPS特征预测该标签并做分组置换重要性,发现词空间由声道滤波器类特征主导,风格空间由基频韵律类特征主导。结论适用于Multilingual LibriSpeech单单词朗读英语且说话人不重叠划分,对自发对话和转换、匿名化等真实下游尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
60. 只用文本就能让豪萨语医疗语音识别更准吗

评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Oche David Ankeli:机构信息未能在本次解析中与作者逐人可靠绑定
- Hassan Adelani Luqman:RUZIVO Research Lab, African Leadership University, Kigali, Rwanda
- Theodora Ngozi Egbunike:RUZIVO Research Lab, African Leadership University, Kigali, Rwanda
- Joshua Gottschalk:Stanford University, Stanford, CA, USA
- Bonaventure F. P. Dossou:Mila – Quebec AI Institute and McGill University, Montreal, Canada
📌 核心摘要
豪萨语医疗语音缺少配对的医疗语音,无法按常规做法微调声学模型,论文研究只用文本完成领域适应。输入是手机录制的朗读语音,输出是豪萨语转写文本,难点是医疗词汇在通用多语言声学模型中表示不足。方法固定多语言声学模型MMS-1B-FL102不更新,先用19421句豪萨语医疗文本训练目标语言模型并输出语言模型分数,再把该分数送入波束搜索解码进行融合,最后用通用模型消融和医疗术语召回检验增益来源。浅融合是在波束搜索中把目标语言模型对数概率加权加入声学分数,只在解码阶段起作用,不需要医疗语音;密度比方法在此基础上再减去通用来源语言模型的加权分数,用于抵消声学模型已隐含的通用先验。在25条医生审校提示、10名说话人共250条语音的按提示划分五折交叉验证pooled异折预测中,词错率方面贪心解码为29.56%,浅融合降至23.55%、密度比方法降至23.33%,两者均低于贪心解码,相对降幅分别为20.3%和21.1%。同样在上述按提示划分五折交叉验证pooled异折预测中,词错率方面通用语言模型浅融合为23.96%,医疗目标语言模型浅融合为23.55%,医疗模型低于通用模型0.41个百分点,说明大部分增益来自引入外部语言模型。部署开销为16.76MB的紧凑KenLM模型,适合资源受限部署;结论适用于朗读式短句和人工复核流程,不支持无人值守的临床使用。
🔗 开源资源
第三方资源:https://github.com/Tripp808/hausa-medical-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/OcheAnkeli/hausa-medical-asr — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
61. 把未来藏好再比较:对话情绪位移预测的防泄漏评测

评分:5.6/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Bin Wen:School of Computer Sciences, Universiti Sains Malaysia, 11800 Gelugor, Penang, Malaysia
- Dai-Qiao Zhang:School of Mathematical Sciences, Universiti Sains Malaysia, 11800 Gelugor, Penang, Malaysia
- Tien-Ping Tan:School of Computer Sciences, Universiti Sains Malaysia, 11800 Gelugor, Penang, Malaysia
📌 核心摘要
对话情绪突变预测要求在决策点n只能使用序号不大于n的话语与说话人信息,输出下一轮情绪是否变化,难点是双向编码、对话级池化或过宽窗口会无声混入未来目标。论文先把承诺点固定在n并截断输入为纯历史特征,再对六个因果模型统一做四候选验证搜索选优并用三种子重训,最后把模型预测送入与只在训练折拟合的转移矩阵的信息对齐比较。可部署比较中双方都不接触金色当前标签,对手是基于训练集线性分类器预测标签的转移概率,特权诊断则让双方同时获得金色当前标签,以分离超越当前观测的增益。在去除134个训练重复后的DailyDialog上,六个模型相对预测标签基线的ROC-AUC提高0.160到0.167,校正后p值为0.0144,方向为模型高于基线。在MELD文本配置上,多数模型的ROC-AUC比金色标签转移矩阵低0.032到0.064,方向为模型落后于该特权基线。独立拟合的TF-IDF加截断奇异值分解控制在DailyDialog上相对同类预测标签转移基线的ROC-AUC增益仍约0.164,方向为高于基线,说明主要结论不完全依赖未公开上游编码器。结论仅在信息匹配、区分相邻轮与本人下轮语义目标、去重划分下成立,DailyDialog排序最强的DialogueGCN未校准Brier分数/ECE为0.188/0.224弱于预测标签基线的0.153/0.052,故概率不能直接解释为风险。多模态配置因缺完整上游抽取代码仅作敏感性分析,仅IEMOCAP会话划分检验未见说话人,文风相似泄露与策略级重实现差异尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
62. 跨 cohort 与跨设备的阿尔茨海默病检测:域适应与域泛化综述解读
图片来源:原论文 PDF 第 3 页(含图 1)。完整图注与解读见独立文章。
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Yingchao Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuhan Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shanshan Yao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是辅助检测阿尔茨海默病的机器学习系统,困难是训练与部署的数据分布不一致,同一模型换扫描仪、电极、麦克风、语言或医院后性能下降。综述先界定域为特征空间、边缘分布和条件分布的组合,再区分协变量偏移、标签偏移和概念偏移,并提出技术、群体、站点、临床任务、时间和工作流六维框架。方法上先检索6个文献源,用模态词、方法词和疾病词做布尔组合得到候选文献,再按明确处理域偏移的阿尔茨海默病或轻度认知障碍或痴呆检测标准筛选,脑电和眼动保留少量方法可迁移的邻域研究并在表格中标明。最后把纳入研究的源域到目标域、目标标签是否参与训练、有监督或无监督适应与单源或多源泛化、临床端点和划分防泄漏说明提取到各模态表格中,作为跨研究比较的依据。在同一语料上,域自适应波束搜索解码精修的自动语音识别转录使阿尔茨海默病分类准确率从手动转录基线的约82.6%提高到约88%。综合发现是磁共振成像证据最集中,语音跨语料转移最直接,眼动和脑电的阿尔茨海默病特异性证据仍薄弱,多模态增益主要来自同一队列内的互补而非外部验证。这些结论只适用于以阿尔茨海默病对认知正常二分类为主、报告准确率或AUC的单队列或跨队列评估,划分防泄漏多为未报告且部分所谓适应实为单队列内通用迁移或集成,缺失模态、人群偏移和轻度认知障碍转归尚未充分验证,跨站点外部验证失败风险高。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
63. 歌词听得清吗:一个兼顾有参考和无参考的多编码器评估框架

评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jing Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shenghao Liao:机构信息未能在本次解析中与作者逐人可靠绑定
- Shuqing Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongyi Deng:机构信息未能在本次解析中与作者逐人可靠绑定
- Pan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zerui Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Gongping Huang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是音乐中歌词能否被听清的程度,论文用可懂度分数表示听众对歌词内容的理解水平。困难在于歌唱的音高变化、发音拉长和伴奏干扰让面向清晰语音的STOI等指标失效,听力受损条件又放大了这种失配。先把左右耳音频分别送入WavLM和MuQ提取特征,WavLM输出帧级声音语义特征,MuQ输出汇总音乐整体结构与上下文的全局向量,同时把参考歌词或Whisper转写文本送入T5输出语义向量。再用交叉注意力把音频特征与T5语义向量对齐融合,得到每只耳朵各自的可懂度分项分数,侵入式路径还计算转写与人工参考歌词之间的词错率并将其与分项分数一起送入线性层做第一阶段融合。最后把左右耳融合分按可学习权重加权,并把WavLM支路与MuQ支路的分数再经线性层融合成最终可懂度分数,非侵入式路径则以Whisper转写代替参考歌词并省去词错率计算。与只用Whisper或STOI的基线相比,该方法同时建模局部对齐、全局音乐语义和文本线索。在ICASSP 2026 Cadenza数据集验证集上,最好的侵入式模型RMSE为26.61,相关系数为0.69,优于Whisper基线的29.32和0.59;评估集上为26.54和0.67,优于基线的29.08和0.58。结论只在该数据集的无、轻度、中度听损仿真片段上成立,未验证其他语言、现场录音或重度听损,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
64. THG-Omni:把视频里的人、事件和时间绑在一起再教模型推理

英文题目:THG-Omni: Traceable Human-Centric Graph Supervision for Video Reasoning
评分:5.4/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jisheng Dang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Ronghao Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Bimei Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hong Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei-Shi Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Bin Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qi Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Tat-Seng Chua:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要理解的对象是包含多人、对话、表情与动作的视频,问题要求指出哪位参与者在何时做了什么、情绪如何变化以及社交意图是什么。困难在于线索分散在短暂表情、语音语调与多人交互中,遮挡、运镜与镜头切换又容易把属性安到错误的人或错误的时间段。THG-Omni先用Segment Anything Model 3按问题中的人物指称做接地与跟踪,提取可见区间、轨迹与空间关系并输出为确定性几何图。再用Qwen3-VL-8B对整段视频与缩略图做语义标注,输出人物属性、动作、情感与交互声明,并以人物标识为键与几何图对齐融合成待验图。HumanOmniV2接着以原视频与可用音频对每条候选语义声明做支持度检查,只有通过格式、身份与支持度检查的正面声明才被送入训练问题构造,与几何确定性问题共同训练Qwen2.5-Omni-7B的低秩适配参数。推理时模型收到从评测视频预测的图,不再接受人工修正或验证器结论。与 Qwen2.5-Omni-7B 相比,带匹配图的 THG-Omni 在 NExT-QA 测试集 8564 题上总体准确率为 89.54%,基线为 77.98%,方向为越高越好。适用范围限于有人物可跟踪、可标注的短中视频问答,评测图可能遗漏信息或包含未完全支持的声明,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://anonymous.4open.science/r/review-n94hhfcwp5666/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
65. 文本与语音的关键表达自动提取:从统计到大模型的流程与证据
评分:4.6/10 | 创新 1/2 | 技术严谨 0.9/1.5 | 实验充分 0.7/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Daria Guseva:机构信息未能从 arXiv PDF 文本可靠映射
- Olga Mitrofanova:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
读者需要理解的对象是从书面文本或口语中挑出能代表主题的内容单元,论文称之为关键短语,输入是书面文档或口语录音及其转写,输出是若干词或词组构成的集合。论文转述的感知实验表明集合规模一般在3到15个表达之间,7到10个是处理口语时较为方便的预设范围,投稿要求常见5到7个,适用范围取决于文本体量和任务。难点在于口语存在不流畅、韵律变化、录音质量差异、自动语音识别错误和人工标注主观性强。论文把处理过程归纳为先做文本预处理、再做候选识别与排序、最后做结果后处理,预处理完成分词、词形还原和停用词去除并输出候选词,识别阶段按统计、混合、机器学习和结构化图方法打分排序并送入后处理,后处理完成截断和排序。语音分支分为基于转写的串联路线和直接处理声学信号的端到端路线,前者把自动语音识别(Automatic Speech Recognition,ASR)得到的文本送入文本方法,后者用声学特征做片段选择与合并,输出文本或语音形式的压缩内容。论文强调大语言模型(Large Language Model,LLM)把任务从抽取转向生成,可以补出原文没有出现但主题相关的短语。在同一数据集且不使用受控词表的条件下,以随机森林改进基于朴素贝叶斯分类器的KEA基线,指标平均F-measure从22%提高到30%。该结果说明词缀与缩略语等标记的作用,适用范围集中在文献综合与方法选型参考,尚不能作为特定算法在噪声语音或低资源语言上有效的证据,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://www.dimensions.ai/ — 链接可访问(HTTP 200)
第三方资源:https://app.vosviewer.com/ — 链接可访问(HTTP 200)
第三方资源:https://human.spbstu.ru — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
66. 用上下文核查过的象形图辅助修复多语言语音识别错误
英文题目:Contextual Pictograms for Repairing Multilingual ASR Errors
评分:3.9/10 | 创新 1/2 | 技术严谨 0.8/1.5 | 实验充分 0.3/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Mariana Hernandez:机构信息未能从 arXiv PDF 文本可靠映射
- Hector Luna:机构信息未能从 arXiv PDF 文本可靠映射
- Carlos Bruno:机构信息未能从 arXiv PDF 文本可靠映射
- Luis Ricardo Santos:机构信息未能从 arXiv PDF 文本可靠映射
- Elena Simoes:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
带噪、口音或语码混杂的法语和西班牙语日常请求经语音识别转写后,地点、对象、否定或时间顺序等关键片段的不确定可能被最可能字符串掩盖,听者易把错误动作当作已核实接受。先由固定识别器提供转写文本、低置信片段的词格或混淆网络备选及局部时间戳,再由修复策略在任务相关片段上筛选与句式一致的短文本备选并用留出开发集校准中断阈值,把可重放片段送入配图核对环节。最后配图查找以候选短语而非孤立词为单位提取候选映射,其输出经按完整短语的人工审核后才允许显示,抽象的极性词与时间关系及无合适图像者只输出文本与局部重放控件,并记录完全、部分或未配图状态。与把整句直接译成配图序列的工作不同,该方案把配图当作转写主通道上的局部可选核对手段。计划在自录多说话人法语和西班牙语请求加受控噪声下,对比顶层转写、转写加备选、转写加备选加验证配图三种显示,检验关键次纠正、任务意图恢复与时间的增量价值。原文未提供可核对的关键定量结果。结论只适用于受控噪声下法语和西班牙语具体概念的可行性验证,语码混杂、口语变体、区域词汇及仅单侧配图拉偏等情况可能失败,日常会话鲁棒性与葡萄牙语扩展尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://aclanthology.org/2024.lrec-main.76/ — 链接可访问(HTTP 200)
第三方资源:https://proceedings.mlr.press/v202/radford23a.html — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。