📄 流式语音识别如何做到说出的话不再改口:Confucius4-R2T2 解读
英文题目:Confucius4-R2T2: A Stable-Prefix Streaming ASR Model for Real Real-Time Transcription
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Daniel Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qi He:机构信息未能在本次解析中与作者逐人可靠绑定
- Shaoxiong Duan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingjie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiao Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yitao Duan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式语音识别要在音频到达时逐段输出文字,供机器翻译与语音助手直接消费,一旦改写已发布词就会造成重复计算或错误动作。论文把输入记为每80毫秒一帧的音频前缀,把同一模型在全量音频上的输出作为参照,要求任意时刻已发布文本都是更晚时刻文本的前缀。方法先让全量模型在递增前缀上产生假设序列,从中提取既是全量输出前缀、又等于某个历史完整假设的最长稳定前缀,送入监督构造,用等待符号区分稳定区间与不确定间隙。再冻结音频编码器与投影层,只更新语言解码器,先在1500小时中英文音频上监督微调学习稳定转写与等待,再用分组相对策略优化完善准确率与等待行为。最后推理按160毫秒等块更新,结合缓存复用、等待终止、有界上下文和可修正后缀校验维持稳定输出。在13个中英文测试集以160毫秒分块评测时,保留1个临时词模型的英文词错率与中文字符错率总宏平均为5.76%,低于同基座同设置未适应基线的21.01%,但仍高于全量解码的5.15%。在未参与训练的10个语言18个测试集以160毫秒分块评测时,同保留1个临时词模型的平均识别错误率为8.40%,低于同设置基线模型的30.75%,在中英文流式评测中其平均回溯发射滞后低于三个专有接口。该结论适用于短块稳定提交与中英文之外的10个语言迁移,但右语境消歧仍需未来音频,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
代码相关资源:https://github.com/netease-youdao/Confucius4-R2T2 — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/netease-youdao/Confucius4-R2T2 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
流式识别的输入输出是什么
这篇论文处理的是语音到文本的流式转写。输入是一段随时间到达的音频,记为从头到时刻 t 的前缀;输出是随时间增长的文本前缀。读者可以想象直播字幕或语音助手:音频每到 160 毫秒就问 1 次模型,现在能确定哪些字。
与离线识别不同,流式系统不能等整句说完再 1 次输出。下游的翻译或智能体往往在 token 出现时就开始行动,如果识别器随后修改已输出的词,下游已做的工作就要作废,屏幕上的字也会闪烁。因此论文把准确、延迟之外的第三个要求单独提出来:已发布文本只能增长,不能回改。
已有方法为什么还留着改口问题
已有工作大致分 3 类。第一类是结构改造,用单调注意力、分块或双模式编码器限制声学上下文,让编码器只看过去。它们决定了能看到多少音频,但不能保证解码器不改已输出的词。
第二类是推理时修补,例如只提交连续两次假设的最长公共前缀,或扣住最后几个 token 不发布。这类规则配上不回退的缓存可以对外不改字,但底层识别器本身仍在反复修改,只是被规则盖住了,模型并没有学会何时该等。第 3 类是训练时接触截断样本,例如随机截断训练对或自训练,能降低修改频率,但不提供永不修改的保证。论文的出发点是把不修改作为行为约束直接建模,再去优化准确和延迟。
论文要解决的具体困难是什么
困难来自上下文该给多少。论文指出,一个词自身的声学片段往往不足以确定它,后续音频才能消除歧义;如果要求模型在词音结束时立刻输出,就等于逼它猜。另一方面,更多上下文不总是更好:把音频逐段喂给全量模型时,正确 token 数不是单调增长的,新加的尾部会扰动前面的词,论文称之为残余干扰。
所以需要的不是强制对齐时间戳,而是一个提交时机标签:在当前音频下,哪些前缀已经可以安全提交,哪些还必须等。标签必须能大规模自动构造,且不能用未来音频的证据去要求当前时刻做出承诺,否则就是标签泄漏。
整体思路是怎样把全量模型变成流式模型
方法起点是 Qwen3-ASR-1.7B 这个全量模型,包含 AuT 音频编码器、投影层和语言解码器。做法是冻结编码器和投影,只训练语言解码器。编码器在推理时仍对已到达的音频做双向处理,没有因果化,也没有加注意力掩码。
训练数据约 1500 小时中英文专有音频,约 600,000 条。标注时用同一模型自己产生监督:把音频从短到长每 80 毫秒解码 1 次,得到一系列历史假设,再从中提取最长稳定前缀作为该时刻应提交的内容,不稳定时则监督输出等待标记。这样全量模型自己当老师,避免跨模型分布失配。推理时按固定块长查询,预测到等待就停止本次解码,预测到文本就追加到已提交历史,历史永不修改。
最长稳定前缀如何定义和计算
记完整音频输出为完整转写,时刻 t 的截断音频输出为 yt,其长度为 nt。最长稳定前缀 Lt 定义为完整输出的前 mt 个 token,其中 mt 是在所有不超过 t 的历史输出中,那些整体都是完整输出前缀的输出的最大长度。如果此前没有任何输出整体符合,就取空。
\[m_{t}\;=\;\max_{j\leq t}\;n_{j}\cdot\mathbf{1}\!\left[\,y_{j}\preceq\bar{y}\,\right],\]这个公式的关键是全或无:只奖励整个输出都符合的情况,一个 token 对不上就把该步计零,而不是取部分公共前缀。论文证明它随时间单调不减、以完整输出结尾,且是在同时满足是完整输出前缀、等于某个历史输出这 2 个条件下最长的目标。
稳定前缀 × 最长稳定前缀: 稳定前缀指模型随音频增长只追加、不修改已发布文本的行为约束;最长稳定前缀是在该约束下,从同一模型在不同音频前缀上的历史输出里挑出的、整体都是完整音频输出前缀的最长一个,它把行为要求变成了可标注、可学习的监督目标。
它与另外两种稳定前缀有何不同
论文对比了 3 种事后定义。全部未来一致要求当前前缀被同一轮解码的所有未来输出共享,它最严格,但会被中间某次偏离拉短,即使后来又回来。全锚定最长公共前缀取历史每个输出与完整输出的公共长度的最大值,它允许用一个尾部被模型自己推翻的输出的头部来计分,可能给出没有任何 1 次输出真正产生过的字符串。
本文定义是两者的交集:既锚定完整输出,又要求等于某个真实历史输出。代价是更保守,标签不会比全锚定版本更长,模型倾向于更晚提交。论文用小例子说明三者在非追加链上会分开,只在输出本身已是追加链时才重合,这正是需要学习信号的位置。
推理时如何做到又快又不回改
推理按块长更新,例如 160 毫秒一块。每次更新要处理增长的音频和已保留文本。论文用四项优化把每步工作量封顶:已完成的 8 秒窗口编码结果和解码器键值缓存复用;预测到等待就结束本次解码,不做多余串行步;只保留最近一个完整窗口加当前窗口,把上下文限制在约 16 秒音频及其转写;对暂缓的尾部后缀在预填充阶段做验证,而不是像基线那样重生成。
下面这张表比较 3 种设计的每步工作量,重点看编码器与解码器预填充的分工。R2T2 保留了原架构,因此每步仍要重填活动窗口和保留文本,但这些都被封顶;理论上的因果交错设计每步只处理新块,但需要重训编码器且不能修正尾部,所以论文没有采用。
| Design | Encoder | Decoder pre-fill | Serial steps |
|---|---|---|---|
| QS† | all audio | all audio + text | 5+5,+ new |
| R2T2 | active window | active window + text | new |
从表可见,R2T2 每步新增串行步只取决于新生成的 token 数,等待时为零;可修改部分被限制在 U 个 token 内,已提交部分永不修改,只验证后缀是否仍成立。这种设计把稳定保证留给训练出的提交行为,把效率留给缓存和截断。
等待标记与暂缓预算如何分工
等待标记是词汇表中的普通 token,不是额外输出头。训练时它出现在不稳定间隙的标签尾部,推理时它就是停止信号:预填充最后一个位置若预测为等待,本次更新不做任何串行解码。这把何时输出与输出什么分开,前者由等待决定,后者由文本决定。
暂缓预算 U 是推理时的旋钮。U 为 0 表示模型生成什么就提交什么,延迟最低;U 为 1 表示最后生成的 1 个 token 先留在内部,用下一步音频验证后再决定是否提交,对外仍只放已提交文本。论文强调固定 token 数不等于固定毫秒数,因为同样一个 token 在不同语速和分词下对应时长不同。
Wait × 稳定区间: 稳定区间是标注过程中模型输出与最长稳定前缀一致的时间段,落在区间内就监督转写该前缀;Wait 是落在区间外时监督的等待标记,它让解码器学会在证据不足时先不提交,而不是猜一个以后要改的尾巴。
冻结编码器 × 解码器后训练: 冻结编码器指保留 Qwen3-ASR-1.7B 的音频编码器和投影参数不变,继续使用其双向表示;解码器后训练指只更新语言解码器来学习何时输出、何时等待,两者搭配是为了保留预训练声学能力,同时只在解码侧解决截断音频与完整音频的表示失配。
暂缓 token 预算 × 已提交文本: 已提交文本是推理时对外可见且永不修改的部分;暂缓 token 预算 U 是允许在内部多保留几个尾部 token、等更多音频到达再决定的数量,它不进入已提交历史,因此可以在不破坏稳定前缀的前提下用少量延迟换取准确率。
训练标签和两阶段训练如何进行
标注时把音频每 80 毫秒切 1 次,记录模型输出何时等于其最长稳定前缀,把连续一致的检查点合并为稳定区间。训练时随机切一个时刻 t,若 t 落在稳定区间内,标签就是该时刻的最长稳定前缀;若落在间隙,标签是该前缀再拼接一个等待标记。在音频开头尚无稳定前缀时标签只有等待,在完整音频处用完整转写保留离线能力。
\[y_{t}^{*}=\begin{cases}\mathrm{LSP}(\mathcal{M},x,t),&\exists i:\ s_{i}\leq t\leq e_{i},\\[2.0pt] \mathrm{LSP}(\mathcal{M},x,t)\oplus\textnormal{{Wait}}{},&\text{otherwise}.\end{cases}\]下面这张图的读图任务是理解区间如何从逐行假设中提炼出来:先看横轴时间与每一行的完整假设,区分蓝色稳定词与橙色不确定延续,再看右侧区间如何合并连续稳定检查点,最后看间隙检查点为何对应等待。
看图路径: 1. 先看横轴时间与每一行的完整假设,区分蓝色稳定词与橙色不确定延续;2. 再看右侧区间如何把连续稳定的检查点合并为一段;3. 最后看落在区间空隙的检查点为何对应等待监督
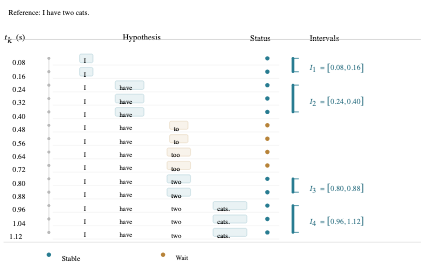
论文图 2。原论文 Figure 2::“Stable-prefix interval extraction. A teacher ASR model decodes progressively longer audio prefixes every 80 ms.”。
该图确实可见从 0.08 秒到 1.12 秒的多行假设:早期只有 I 稳定,随后 have、two、cats 依次进入稳定区间,中间对 to 与 two 的犹豫段被标为等待。这帮助理解监督如何把识别内容与提交时机分开,模型既要记住已认准的词,又要对未定延续输出等待。
训练分 2 个阶段。先做监督微调,用交叉熵学习上述标签,编码器和投影冻结,只更新语言解码器;10% 样本用完整音频保持离线能力,90% 用前缀切分,其中一半落在稳定区间、一半落在间隙,并做噪声、混响和语言标签翻转增强。再做 GRPO 强化学习,从监督模型出发采样多轮流式轨迹,用 8 个奖励分量细化识别与等待行为,最终奖励经双曲正切压缩。
\[R(y_{t},y_{t}^{\ast})=\tanh\!\left(3R_{\mathrm{raw}}(y_{t},y_{t}^{\ast})\right),\]监督与奖励的具体配置是什么
下表是监督微调的关键设置,比较问题是只动解码器能否学会转写与等待。表中初始化、目标、优化器和可训练模块说明冻结编码器既保留预训练表示,也减少梯度和优化器状态开销;动态 1 到 8 秒注意力窗口让模型在不同声学上下文量下学习提交行为。
| Setting | SFT run |
|---|---|
| Initialization | Qwen3-ASR-1.7B |
| Objective | Cross-entropy on LSP transcription and Wait targets |
| LR schedule | Linear decay after 2% warmup |
| Effective global batch | 64 examples |
该表说明训练只动语言解码器,不加新层或新头,流式能力来自对残余干扰的鲁棒性和等待决策,而不是结构改造。学习率与批量等数值按原文保留,复现时应直接沿用。
下表是强化学习 8 个奖励的权重与职责,比较问题是识别保真与行为克制如何加权。字错率权重最高,其余分别约束冗余长度、重复、语言一致性、区间内多余尾巴、局部词准确率和等待标记位置。权重本身不证明各分量独立有效,论文也指出分量级消融需要另做对照。
| Component | Weight | Role |
|---|---|---|
| CER | 0.300 | Normalized character-level recognition accuracy |
| Precision | 0.150 | Edit-distance precision surrogate |
| Language Consistency | 0.150 | Chinese/Latin character composition |
| Cut Marker | 0.025 | Required Wait presence and placement |
从职责列可见,奖励同时管内容保真与行为克制:既要写对,也要在不确定边界不抢跑。尾部与切分标记两个分量直接对应等待监督,其余分量压制幻觉、重复和语言混杂。
评测在什么数据和指标下进行
主评测用 8 个英文测试集和 5 个中文测试集,包括 AMI、Giga-clean、LibriSpeech 干净与其他集、VoxPopuli、Earnings22、TED-LIUM、WenetSpeech 网络与会议集、SPEECHIO 两集,以及中英 RealSI。RealSI 是来自真实同传场景的长语音,更接近持续使用的情况。另有 10 个未参与后训练的语言、18 个测试集做跨语言迁移。
指标分两类。英文用词错率、中文用字错率,经标准文本归一化,越低越好;总平均给每个数据集等权重。延迟用回溯发射延迟:对经编辑对齐匹配上的词或字,用其所在前缀永久稳定的音频时刻减去参考词结束时刻,只在识别正确的位置上计算,高错误样本会被排除,因此必须结合错误率一起解读。
字错率 × 回溯发射延迟: 字错率与词错率衡量最终文本与参考转写的编辑距离,方向是越低越好;回溯发射延迟衡量每个正确词从参考音频结束时刻到其所在前缀永久稳定的时间差,它只在识别正确的位置上计算,因此必须和准确率一起看,不能单独证明系统更快更好。
下图的读图任务是理解延迟如何在音频时间轴上度量:先看圆圈表示的参考词结束时刻与方块表示的前缀固定时刻,再比较 3 条箭头的延迟长短差异,最后注意顶部流式假设如何随时间追加而不修改已固定部分。
看图路径: 1. 先看圆圈表示的参考词结束时刻与方块表示的前缀固定时刻;2. 再比较 a、blue、cat 三条箭头的延迟长短差异;3. 最后注意顶部流式假设如何随时间追加而不修改已固定部分
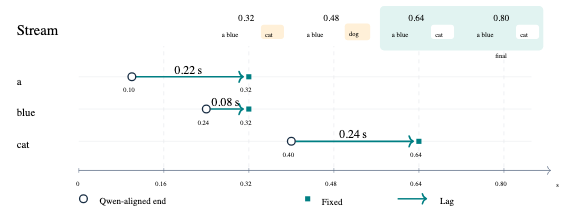
论文图 4。原论文 Figure 4::“Retrospective lag from Qwen-aligned reference word ends (circles) to the end times when the corresponding transcript prefixes become permanently stable (squares).”。
该图确实可见 3 条延迟箭头:a 约 0.22 秒、blue 约 0.08 秒、cat 约 0.24 秒,顶部流式假设随时间从 a blue 扩展到完整句,固定点单调右移。这说明延迟是对每个正确单位回溯计算的,显示改写会推迟固定时刻,而未改的暂缓词可从首次出现计分。它刻画的是文本响应性,不含执行、排队、传输与渲染开销,论文明确这不是实测服务延迟。
主结果在相同块长下说明了什么
主比较统一用 160 毫秒块长,比较问题是在相同音频块与输出政策下稳定模型能否接近全量质量。R2T2 分 U 为 1 和 U 为 0 两档,基线包括 Qwen3-ASR-1.7B 的离线全量解码、2 秒块长回退 5 个 token 的版本、160 毫秒基线,以及开源与商用流式系统。星号表示中间假设可修改,非稳定前缀;R2T2 两档只放已提交文本。英文用词错率、中文用字错率,单位均为百分比,越低越好。
| Dataset | Base Offline | Base 2s U=5 | Base 160 ms U=1 | R2T2 160 ms U=1 | R2T2 160 ms U=0 | X-ASR 160 ms | WhisperRT 200 ms | Nemotron 160 ms | Voxtral 160 ms | AssemblyAI | Comm. A | Comm. B |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| AMI | 9.18 | 9.25 | 24.79 | 10.07 | 10.40 | 14.41 | 24.19 | 18.11 | 17.58 | 12.00 | 13.27 | 8.44 |
| Giga-clean | 8.60 | 8.61 | 24.37 | 8.81 | 9.04 | 10.26 | 13.81 | 12.67 | 12.16 | 9.21 | 8.84 | 9.46 |
| LS-clean | 1.62 | 1.67 | 18.37 | 1.91 | 2.12 | 3.86 | 4.70 | 3.71 | 3.05 | 1.89 | 1.73 | 1.25 |
| LS-other | 3.39 | 3.54 | 25.74 | 4.12 | 4.55 | 9.64 | 9.86 | 8.27 | 8.70 | 3.37 | 3.57 | 2.48 |
| VoxPopuli | 3.12 | 3.02 | 20.71 | 2.29 | 3.54 | 5.68 | 8.28 | 5.69 | 8.00 | 4.75 | 3.17 | 3.14 |
| Earnings22 | 6.26 | 6.68 | 29.72 | 7.61 | 9.06 | 15.95 | 35.08 | 17.22 | 12.12 | 7.47 | 10.32 | 8.96 |
| TED-LIUM | 2.26 | 2.33 | 19.18 | 2.46 | 2.77 | 3.75 | 6.67 | 5.11 | 5.89 | 3.23 | 3.08 | 3.30 |
| EN-RealSI | 6.84 | 6.54 | 13.76 | 7.33 | 8.84 | 8.97 | 35.36 | 10.69 | 18.08 | 9.73 | 8.73 | 17.05 |
| Wenet-net | 4.87 | 4.94 | 19.79 | 5.75 | 6.17 | 8.81 | N/A | 24.70 | 27.36 | 12.91 | 5.13 | 4.79 |
| Wenet-meeting | 5.85 | 5.97 | 20.38 | 6.74 | 7.34 | 11.33 | N/A | 20.18 | 66.50 | 11.84 | 7.07 | 3.75 |
| SPEECHIO-06 | 5.90 | 6.10 | 24.47 | 7.19 | 7.43 | 7.86 | N/A | 22.52 | 35.33 | 15.08 | 5.67 | 5.34 |
| SPEECHIO-07 | 6.15 | 6.19 | 21.16 | 7.29 | 7.94 | 11.22 | N/A | 24.28 | 26.84 | 10.84 | 6.45 | 6.46 |
| CN-RealSI | 2.91 | 3.34 | 10.72 | 3.27 | 3.98 | 4.92 | N/A | 11.52 | 9.92 | 5.15 | 3.99 | 3.64 |
| Total macro average | 5.15 | 5.25 | 21.01 | 5.76 | 6.40 | 8.97 | N/A | 14.21 | 19.35 | 8.27 | 6.23 | 6.01 |
该表覆盖英文词错率、中文字错率与总平均,单位均为百分比,数值与单位以原表为准。关键读数是 R2T2 在 160 毫秒、U 为 1 时总平均最低,且在所列全部中英集上优于同块长基线;未适配的基线在 160 毫秒、U 为 0 时出现严重幻觉与不可靠终止,无法给出可用评分,因此主表只保留其 U 为 1 一档。R2T2 与全量离线解码仍差约 0.6 个百分点,论文解释部分歧义需要未来上下文,提交时无法消除,在 VoxPopuli 上甚至超过全量参考。结果成立的条件很具体:同一 160 毫秒设置、只看已提交文本、总平均为数据集等权重而非字数加权。商用系统在中文准确率上有单项优势,但稳定时刻更晚。
块长与暂缓预算如何权衡准确与延迟
论文用块长扫描与 U 的对照说明权衡。固定 checkpoint 不变,只改推理块长与暂缓预算:在 160 毫秒下,扣住 1 个 token 约降总错误十分之一,但平均延迟增加零点几秒;U 为 0 对块长更敏感,从 160 毫秒加到 320 毫秒仍有收益,而 U 为 1 时再加块长收益很小,因为后缀已提供了额外上下文。到 2 秒大块时,准确略升但延迟大幅上升,说明块长本身不决定响应性,语音中的停顿与词边界同样影响提交时机。
80 毫秒、U 为 0 是延迟优先档,可把双语平均回溯延迟压到半秒以下,但错误率回升。基线侧也有类似规律:更多音频可改善最终文本,但会推迟前缀固定;可修改假设的最终错误可能更好看,但其回溯延迟因改写而偏大,且闪烁频率本身未被测量。复现权衡时应同时报告错误率与延迟分布的首尾情况,而不是只看平均。跨语言迁移在同一 checkpoint、160 毫秒、U 为 1 下覆盖 10 个未训练语言的 18 个测试集,R2T2 均低于基线同块长设置,但仍高于全量解码,支持等待与抗干扰能力部分迁移,但不能推广到未测语言。
哪些结论还不能下,误解在哪里
首先,稳定保证是行为级的:已发布文本不改,不等于内容一定对。标签锚定的是模型自己的全量输出,不是人工参考,准确差距仍由词错率衡量。把稳定误读为准确会夸大价值。
其次,流式潜力指标与延迟指标都有适用边界。归一化流式潜力曲线在尾段超过人工时间戳参考,只说明相对自身全量转写的进度,不能直接推出对应词在声学结束前就被正确预测,需词级对齐才能断言。回溯延迟只统计匹配正确的单位并排除高错误语音,且不含真实服务开销,低于半秒不等于端到端低于半秒。
第三,比较公平性依赖输出政策。非稳定系统的最终文本允许事后修正,其最终错误与 R2T2 的已提交错误不是同一口径;论文为此同时给出 2 秒基线的可修改与只放已提交两版,说明要求稳定本身会带来延迟代价。忽略该区别会把不同政策下的数字直接排名。
复现第一步做什么,需要什么资源
复现从基座与数据准备开始:获取 Qwen3-ASR-1.7B 权重,准备约 1500 小时中英音频并按 80 毫秒步长做自标注,生成最长稳定前缀与稳定区间。训练时冻结音频编码器与投影,只训练语言解码器,先做一轮监督微调学习转写与等待,再做 GRPO 细化等待与幻觉控制。作者资源当前可用,模型与代码分别在 Hugging Face 与 GitHub 公开,但训练用的 1500 小时专有音频未公开,完整复现需自备同等规模数据。
推理复现要注意与训练一致的评估构成与归一化:中英主集与跨语言集分开平均,跨语言集不计入中英总平均;延迟用强制对齐的参考词结束时刻做回溯计算,高错误语音按原文规则排除。块长、保留窗口数与 U 需如实记录,因为它们同时改变错误率与延迟。未提供像素的曲线图只能引用图注结论,不能臆测坐标数值。
什么时候值得尝试,还缺哪项验证
当下游需要把流式文本当作不可撤销动作时值得尝试,例如同传翻译、语音智能体工具调用或直播字幕,且能接受为稳定性付出少量延迟。这时可从 160 毫秒、U 为 1 的质量优先档起步,若延迟超标再试 U 为 0 或 80 毫秒块长,每次只动一个旋钮并同时记录双语错误率与首尾延迟。
还缺的验证包括真实服务延迟与长流下的内存行为:论文的延迟是音频时间轴上的回溯值,未验证推理实时率之外的排队与渲染;有界上下文每 8 秒重建 1 次缓存,其在数小时直播中的稳定性需另测。此外,奖励各分量的独立贡献、更强教师是否更好、流式潜力能否推广到同传翻译,都还是开放问题,不宜把单次总平均领先直接当作全面超越。
📎 论文与评分元数据
排名:前25% | 文档类型:模型报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses