共分析 28 篇论文
⚡ 今日概览
✅ 筛选入选 28 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 音频理解 | 5 篇 | █████ |
| 音频分类 | 3 篇 | ███ |
| 音频水印 | 3 篇 | ███ |
| 语音合成 | 2 篇 | ██ |
| 语音识别 | 2 篇 | ██ |
| 互动亲和度估计 | 1 篇 | █ |
| 多模态情感极性分析 | 1 篇 | █ |
| 多模态语义传输 | 1 篇 | █ |
📊 论文评分排行榜(28 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 把两份带水印音频平均一下,溯源为什么就失效了

英文题目:Averaging Collusion Breaks Traceability in Personalized Neural Audio Watermarking
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yangming Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Haiyun Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Dongfu Song:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziang Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiehui Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Yining Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiyong Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
个性化神经音频水印要解决的问题是为每份分发音频嵌入不同用户载荷,泄露后通过解码载荷找回责任用户。难点在于已有评测只考虑单副本失真,多个合法副本共享语音内容而载荷残差不同,直接逐样本平均即可保留内容并混合残差,使学习型解码器的映射偏离所有参与者。论文先用均匀波形平均验证该威胁,再用目标比特裕量优化加权平均测试可控归因,最后用解码器置信度统计筛选不可靠输出。与经典指纹码分析不同,这项工作直接观察学习型解码器对混合波形的端到端响应。在300条录音、每种联盟规模300次试验的条件下,两副本均匀平均在五种系统上的追踪失败率为87.7%至99.7%,混合音频相对首个合法副本的PESQ为4.20至4.60、STOI为0.983至0.999。在K=8的每目标300×10次尝试中,TimbreWM的目标成功率为92.3%,高于同条件下VoiceMark的0.6%,两者均采用各自原生采样率下的嵌入、平均与解码流程。置信度筛选使AudioSeal在K=8下的目标成功率从43.6%降至2.4%,同时保留94.7%有效单副本输出并拒收100%均匀平均混合输出。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/Silwan5z/neural-audio-watermark-collusion-attack — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 只看俯视键盘视频如何转写钢琴:KeyWise 的逐键设计

英文题目:KeyWise: Efficient Video-Only Piano Transcription with a Lightweight Per-Key Architecture
评分:7.6/10 | 创新 1.4/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Anastasios Chatzigiannis:Department of Informatics and Telecommunications, University of Thessaly, Lamia, Greece
- Natalia Panagou:Department of Informatics and Telecommunications, University of Thessaly, Lamia, Greece
- Maria Koziri:Department of Informatics and Telecommunications, University of Thessaly, Lamia, Greece
📌 核心摘要
钢琴音频转录难以从声音恢复手指何时松键,延音踏板会让琴弦在松键后继续发声,噪声、混音缺失声轨也会破坏音频,而俯视视频直接显示琴键的按下与松开,可以绕开这三类困难。论文的输入是经过透视校正的彩色键盘长条,输出是每帧每个琴键的起始概率、持续状态概率与力度值,再经阈值解码为带起始、结束和力度的音符。处理过程先把长条切成与琴键对应的固定区域,卷积编码器为每个区域产生一列特征,同一双向门控循环网络在时间上分别跟踪全部琴键并给出三种预测。与把整张键盘压缩成全局向量再预测全部琴键的做法不同,该设计不需要同时学习琴键在哪里和按下长什么样,只需在已知邻域内判断状态,并让少见音区的琴键共享常见音区的训练信号。在PianoVAM测试集上,同一份评分代码下KeyWise在100 ms容差的起始F1以97.8%高于V2N的97.0%,同时要求偏移时以97.0%高于95.5%,同时要求力度时以89.4%高于84.5%,参数量以1.3 M低于28.2 M,同卡推理快约4.7倍。结论适用于键盘完全可见且角点已知的俯视录制,在PianoYT这类录制条件变化且标签来自音频转录的数据上需要先预训练再微调,原文报告了编码器为主的计算量与实测耗时。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 VeriSpoof:用一个音频大模型做检测、溯源与可核查说理
评分:7.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Yang Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Ting Dang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
可疑语音会同时引出多个问题:是否为合成语音,由哪类系统产生,是否与另一段录音同源,以及结论依据什么证据。已有检测器通常一次只回答一个问题,附加解释多为自由文本,无法逐句核查,也没有检验解释是否决定结论。VeriSpoof把每个取证问题写成带候选答案句子的提问,用肯定答案与否定答案的对数似然差作为分数,以同一组权重完成检测、产生器与声学模型和声码器归属、录制条件分析、合成片段定位和同源验证。输入为8秒波形或两段波形拼接,编码器表征经切分进入大语言模型,模型输出一步答案或先写固定字段论证再给结论,观测、定位和来源描述分别由波形测量、标注区间和产生器元数据核查;反事实样本把标注区间取反后只训练其后结论,使结论跟随所述证据。在14个集合的Speech-DF-Arena评测上,按汇总等错误率越低越好比较,VeriSpoof-Plus以2.14%低于VeriSpoof-Base的4.43%,在28个系统中排第3,在开放权重系统中排第1。同一权重在训练未见产生器的同源验证中以等错误率衡量,MLAAD未见模型配对上Plus为6.17%低于Base的13.80%;在PartialEdit上按准确率越高越好比较,论证后决策为99.6%高于一步答案的78.4%。训练只更新29.7M参数,单卡24GB显存可完成全流程,推理约需6-7GiB显存;降质录音的同源判断与新条件阈值迁移仍难,降质配对等错误率处在23-30%区间。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 让冻结的音频语言模型自己找证据:ReListen 在小时级录音中的做法
英文题目:ReListen: Training-Free Evidence Localization in Hour-Long Audio with Frozen Audio Language Models
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ming-Hao Hsu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shujie Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxuan Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingda Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinyu Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhizheng Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
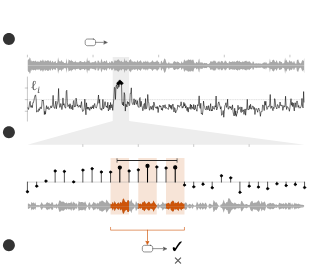
冻结的音频语言模型要直接从整小时录音中作答往往装不下上下文,而先转写整段录音又会丢掉音色、语气、背景声和时间信息,且作答依据常只有几秒。ReListen把录音切成20秒短窗,让同一个冻结的回答模型以首个回答位置上肯定回答相对否定回答的对数几率打分,不生成文本。问答时选出得分最高的1分钟按时间排序并标注起止时间后再听一遍作答;定位则从最高分窗向两侧扩展到连续正分窗,直接输出时间区间。在VoiceGiraffe的1499个问题上,选中60秒与标注证据重叠的比例达到88.5%,高于文本检索的58.8%;相对同一模型的整段转写,准确率领先9.2个百分点。该结论只适用于证据局部集中的问题,当LongAudioSpan中标注证据范围达到录音一半以上时,60秒作答准确率仅为55.7%,明显低于听完整录音的73.8%,需放宽到180至600秒才接近。在LAT-Bench上扩展区间的平均交并比与训练过的定位模型相当,但高精度阈值下召回更低,边界不够精确。推理开销随录音时长线性增长、单卡峰值显存保持在68GiB以下,在两基准上比转写后再答的流程快七到八倍。
🔗 开源资源
- 第三方资源:https://huggingface.co/datasets/distil-whisper/rev16 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 换一个编解码器重编一次,水印还在吗:跨编解码器鲁棒的语音水印解读
评分:7.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Olli-Pekka Pauna:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Lauri Juvela:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
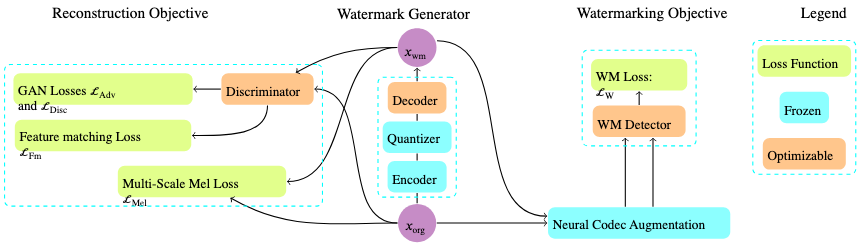
需要解决的问题是合成语音难以与真人录音区分,嵌入隐藏信息的水印常在经过神经音频编解码器重合成后失效,而已有工作多只针对传统失真或单个编解码器训练,换一种未见过的编解码器就容易被擦除。论文把输入语音送入水印生成器嵌入零比特水印,这里的零比特水印指只判断水印存在与否、不携带多比特信息的二值检测方式,处理难点是水印能量要藏在听感不敏感但编解码后仍保留的成分里,同时抵抗压缩、滤波、加噪和混响。方法上先用 Descript Audio Codec(一种采用残差向量量化的神经音频编解码器,简称 DAC)微调出生成器,把原始音频经冻结的编码器和量化器再经可训练解码器重建为含水印音频,再让检测器在经过某种编解码器增强后的信号上区分原始与含水印样本,两者协同训练使生成器帮助检测。关键差异是系统比较 EnCodec、DAC、SpeechTokenizer、Mimi、SNAC 单独或联合作为训练时信道增强,并修改官方代码实现冻结模型下的端到端反向传播。与已有局部水印模型 AudioSeal 和 WavMark 相比,本文模型对整段录音施加全局水印,训练增强种类更少但覆盖更新的低码率编解码器。在 LibriTTS-R 测试集 1000 个样本上,以 1% 误报率下的检出率(数值越高越好)为指标,Mimi 与 SNAC 联合增强在 MP3 32kbps 攻击下达到 87.20%,而无增强模型仅为 40.60%,同时主观对比平均意见分接近自然语音。结论适用于单次神经重合成与常见传统编解码失真,对混响、连续多次随机神经串联以及部分语义蒸馏类编解码器仍效果有限。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/ljuvela/DAREA — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. ScrambleMark:不擦除水印,只打乱谐波结构来逃避语音水印检测

英文题目:ScrambleMark: Zero-Query Watermark-Agnostic Black-Box Evasion of Modern Speech Watermarking
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Binhao Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Weikang Ding:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanqing Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenwei Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaowen Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Leah Ding:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhuo Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Duan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音水印把多比特信息展成时频表示上的结构化图案,检测端按比特匹配分数判断是否存在,攻击者通常拿不到检测反馈,也不知道音频是否含水印以及属于哪种方案。已有擦除思路依赖查询、白盒管线或配对干净音频,在商用平台的账户隔离与无反馈策略下难以成立。ScrambleMark接收单条可能含水印的语音,输出扰动后语音,目标是让目标检测器的比特匹配分数低于阈值,同时保持听感接近原音频。做法沿一条样本展开:先在音高、节奏、音色、响度等感知特征上试探逃避与质量折中,找到谐波轴扰动最有效,再用替代水印模型优化分带频移参数生成训练数据,最后把确定性规则提炼为条件扩散模型的随机化谐波扰动分布。在LJ Speech训练、在英语、中文、韩语、法语、德语无说话人重叠且每语种500段的评测上与七个学术方案比较,ScrambleMark平均ASR为0.97、STOI为0.91,STOI高于无监督生成基线DiffErase-M的STOI 0.72。在商用平台上同样保持高逃避与高听感评分,但恢复实验与多水印实验仍受限于论文设定的恢复算子与嵌入顺序,真实部署中的更强检测端反馈与未知后处理尚未覆盖。原文披露了扩散推理的采样步数、候选数量与单样本耗时等成本信息。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 把多次采样的分歧变成可靠性:面向音频问答的置信度加权聚合
英文题目:Confidence-Aware Aggregation for Multimodal Audio Reasoning
评分:7.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Michel Olvera:机构信息未能从 arXiv PDF 文本可靠映射
- Paraskevas Stamatiadis:机构信息未能从 arXiv PDF 文本可靠映射
- Gaël Richard:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
音频问答的输入是一段音频和一个自然语言问题,输出是从给定选项中选出的简短答案,难点在于音频信号在时间上交叠、定位模糊,感知错误会进入推理链并导致同一次提问多次解码结果不同。论文对同一个输入独立采样多条包含推理过程和最终答案的序列,用整条序列在给定音频和问题下的对数似然除以长度作为自置信分数,再按五种规则聚合得到最终答案。多数投票只计票数,最高置信选择只取分数最高者,而 Borda 投票按置信排序加权、Log-Sum-Exp 投票对同答案分数做平滑累加,从而兼顾分歧覆盖和可靠加权。与只做多数投票的已有音频链式思考做法相比,关键差异是不再把每条样本看作等权,而是让模型似然参与聚合且无需额外训练。在 MMAR 基准上采样数从 3 增加到 16 时,Borda 投票平均准确率提升 3.50 个百分点,期望校准误差平均下降 7.76 个百分点,多数投票的对应变化为准确率提升 2.77 个百分点和误差下降 7.69 个百分点。结论适用于多选题形式的推理型音频问答,在高度一致样本上增益很小,且原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/michelolzam/lalm-self-consistency — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2602.14224 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2509.17765 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 声音能帮视频修好嘴型吗:TaoMate-FVSR 的做法

评分:7.1/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinyang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeran Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qijun Gan:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenwei Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Meiguang Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Junfeng Ma:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要处理的对象是说话人脸视频,输入是经过模糊、压缩或生成错误污染的低质量视频和目标语音,输出是清晰且口型与语音对齐的高质量视频,难点是嘴部牙齿结构在小脸、低分辨率下证据不足,直接增强会固化错误,大幅重生成又容易改变身份。方法先把输入经冻结因果视频自编码器编码为隐变量,再按比例混入高斯噪声作为重建起点,视频扩散变换器沿流匹配路径预测由噪声源指向干净目标的速度场,冻结的 HuBERT 编码目标语音并经可训练投影对齐到重建窗口,独立编码的固定外观参考与序列编码的历史占据不同的条件槽位。训练分两阶段,先用退化图像和视频学习视觉重建,再用退化配音源与目标语音的错位配对学习跟随语音而非复制源口型,推理时以重叠窗口和固定参考保持长视频连续。与已有超分和参考修复方法的关键差异是同时处理缺失细节重建与错误口型改写,并支持原音修复与换音配音同模型运行。在 150 个视频的原音修复基准上,该方法 LPIPS 为 0.0793、DISTS 为 0.0858,优于表中所有修复基线,同步分数 Sync-C / Sync-D 为 7.413 / 7.561,优于最强的修复基线 SparkVSR 的 6.545 / 8.170。结论适用于合成退化与给定参考帧的说话头像场景,原生生成视频、强遮挡和无参考条件尚未定量验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://taoliveaigc.github.io/TaoMate-FVSR/ — 链接可访问(HTTP 200)
代码相关资源:https://github.com/TaoLiveAIGC/TaoMate-FVSR — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/TaoLiveAIGC/TaoMate-FVSR — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/Wan-AI/Wan2 — 链接不可用(HTTP 401)
模型相关资源:https://huggingface.co/facebook/hubert-large-ll60k — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/docs/hub → https://huggingface.co/docs/hub/index — 链接可访问(HTTP 200)
模型相关资源:https://modelscope.cn/models/damo/cv_gpen_image-portrait-enhancement-hires — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. TTSonic:用同一组模块组合出多种语音生成任务

英文题目:TTSonic: A Unified Framework for Composable and Controllable Speech Generation
评分:6.7/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Zhedong Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kaiwen Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Junyan Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengqiang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuran Chi:机构信息未能在本次解析中与作者逐人可靠绑定
- Xingui Zeng:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Yan:机构信息未能在本次解析中与作者逐人可靠绑定
- Xu Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
待解决的困难是同一模型要同时决定说什么内容、用什么风格说、由谁的声音说,还要在参考语音含噪、只有文字描述音色或只有源语音内容时保持稳定质量和可控性。TTSonic先用语音切分器把波形变为离散语义韵律标记,再用自回归语言模型由文本和可选指令预测该标记,最后由声学流匹配模型按说话人条件渲染为梅尔谱并经声码器输出波形。切分器经两阶段训练,先用语音识别监督学习语义表示,再冻结编码器并用重建与语义理解信号优化离散映射;指令控制引入思维链风格规划,音色设计由独立文本到说话人嵌入模块提供条件。在Seed-TTS-Eval的中文test-zh上,TTSonic的字符错误率0.78%低于统一模型VoxCPM2的0.97%,说话人相似度0.784低于Auk的0.814,内容准确性占优而音色保持接近。在VoiceBank-DEMAND-16k含噪参考克隆中,TTSonic的WavLM说话人相似度0.369高于CosyVoice 3的0.299,字错率1.45%低于后者的1.90%,感知质量UTMOS 4.37高于后者的4.23。该结论适用于论文所用中英文零样本、跨语言、指令跟随和转换评测划分,不意味着任意噪声、任意开放指令或未评测语言同样成立。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://bytedance.github.io/TTSonic/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 听得见和看得懂之间:PianoBench 如何区分音乐感知与推理

英文题目:PianoBench: Evaluating Musical Perception and Reasoning in Language Models
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Louis Bradshaw:机构信息未能在本次解析中与作者逐人可靠绑定
- Irmak Bukey:机构信息未能在本次解析中与作者逐人可靠绑定
- Daniel Chenyu Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- John Thickstun:机构信息未能在本次解析中与作者逐人可靠绑定
- Chris Donahue:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文要判断语言模型究竟能从声音中听出哪些音乐特征,又能在音符事件直接给定时推理出哪些,任务是针对短钢琴片段回答从局部音符、和弦细节到伴奏与风格的选择题,难点是声音中这些特征交织难分离,而符号转录又直接给出音高与时值。方法先爬取教学钢琴视频,用声源分离得到钢琴演奏并转写讲解语音与钢琴MIDI,形成带时间戳的交错文档PianoTalk。再从其测试集构造250道人工核验选择题PianoBench,同一乐段可呈现为分离后钢琴录音、转录重合成声音或文本音符表,另设无音乐对照以检验仅靠题面猜答的程度。在PianoBench上,开放音频语言模型加音频相对无音乐对照最多提高6.0个百分点,而前沿模型用思维链在文本音符表条件下的准确率为93.2%,高于最佳音频结果的80.4%。对Qwen 3.5 9B基座无思维链零样本评测中,交错训练在文本音符表上的准确率为56.0%,高于仅指令微调基线的42.8%。这说明保留讲解与演奏时间对应关系的交错优于内容相同但分开存放的对照,不同于仅用曲目级标注监督的已有做法。结论仅适用于短独奏钢琴选择题,尚不能推广到多乐器、长结构或真实音频编码器训练,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://gclef-cmu.org/pianobench → https://gclef-cmu.org/pianobench/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/zfturbo/music-source-separation-training/releases#release-v1.0.21 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3.5-9B — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 文字上能记住的多轮对话,换成语音还记得住吗

评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jiaming Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Pei Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shiwan Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhijun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Baosong Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yong Qin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多轮语音交互要求模型记住早前轮次的信息,遵守持续有效的指令,并跟踪被修正的对话状态,难点在于这些要求在文字转写上成立时,换成直接语音输入是否仍然成立。论文先对来源对话做平行筛选与本地化,保留相同对话、轮次结构、跨轮依赖和评分标准,再为英语保留人工录音并另设英语合成对照、其余九种语言用固定声音合成用户语音,得到354组对话和1404个评分条目的Omnilingua-AudioMC,当前轮之前的助手回复统一固定为文字以隔离用户输入表示的影响。评测在指定轮次只生成一次回复,用二值条目判定是否满足记忆、指令保持、自我一致和语音编辑四类要求,再比较同一条目在文字和语音下的成对结果,并进一步把历史用户语音或当前轮语音替换为文字以定位可恢复的退化。六个主要语音语言模型的对照显示,Muse-Spark文字实例成功率为64.0%,直接语音降至32.4%,下降31.6个百分点,而Qwen3.8 Omni文字为60.9%,语音为60.2%,基本持平,说明转移程度与模型和语言都有关。把历史用户语音替换为被测模型自己生成的文字后,Muse-Spark回升20.1个百分点,明显大于只替换当前轮的6.2个百分点,同一数值顺序在十种语言中都成立。该结论只适用于固定上下文单次生成的诊断性评测,不覆盖在线误差累积、延迟与轮流发言;历史替换涉及多轮语音而当前轮只替换一轮,无法区分历史内容与替换音频量的作用,非英语语音均为合成且英语合成对照不能证明各语言合成效应等价,交互区间跨越或接近零,成对转移仍是观察到的成败而非稳定能力。原文未披露训练、推理或部署成本。
🔗 开源资源
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 治疗师回应得好不好,机器能从脸、声音和文字里看出来吗

英文题目:Therapy-FIS: A Dataset for Assessing Facilitative Interpersonal Skills in Psychotherapeutic Setting
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Qijian Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Wanqing Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuanfang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yijun Ge:机构信息未能在本次解析中与作者逐人可靠绑定
- Jordan Bate:机构信息未能在本次解析中与作者逐人可靠绑定
- Katie Aafjes-van Doorn:机构信息未能在本次解析中与作者逐人可靠绑定
- Feng Liu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
治疗师人际技能评估要判断治疗师对困难临床情境的回应是否具有共情、情绪表达、希望传递、说服、言语流畅、联盟破裂修复、联盟联结、温暖接纳理解等能力,人工观察评分费时且难以扩展,而已有计算研究缺少公开的标准化治疗数据。论文收集78名心理健康从业者对8个模拟患者情境的890段回应,连同8段患者刺激片段,提取面部行为描述子、声学表示与文本表示,并给出8个分量表与总分的平均专家评分。基线方法DyadicFIS先对每个模态做时序编码,再用门控交叉注意力做模态融合,在双人任务中进一步交换治疗师与模拟患者的压缩表示,最后输出9维评分向量。与已有时序与多模态融合基线相比,该方法差异在于显式建模治疗师对患者刺激的情境依存,而非仅对治疗师单侧行为回归。结论只适用于标准角色扮演与去标识特征条件,不能直接等同真实诊疗效果,原文未披露训练、推理或部署成本。在Therapy-FIS治疗师单独评估任务按治疗师不相交5折评估下,DyadicFIS以宏平均一致性系数macro CCC计为0.2807,超过最强外部基线MDF的0.2200。在加入患者情境的联合评估任务同协议下,DyadicFIS以宏平均一致性系数macro CCC计为0.3299,超过MDF的0.2934。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. SciPhi-Chat:能听方向、能对话、能调工具的空间音频智能体
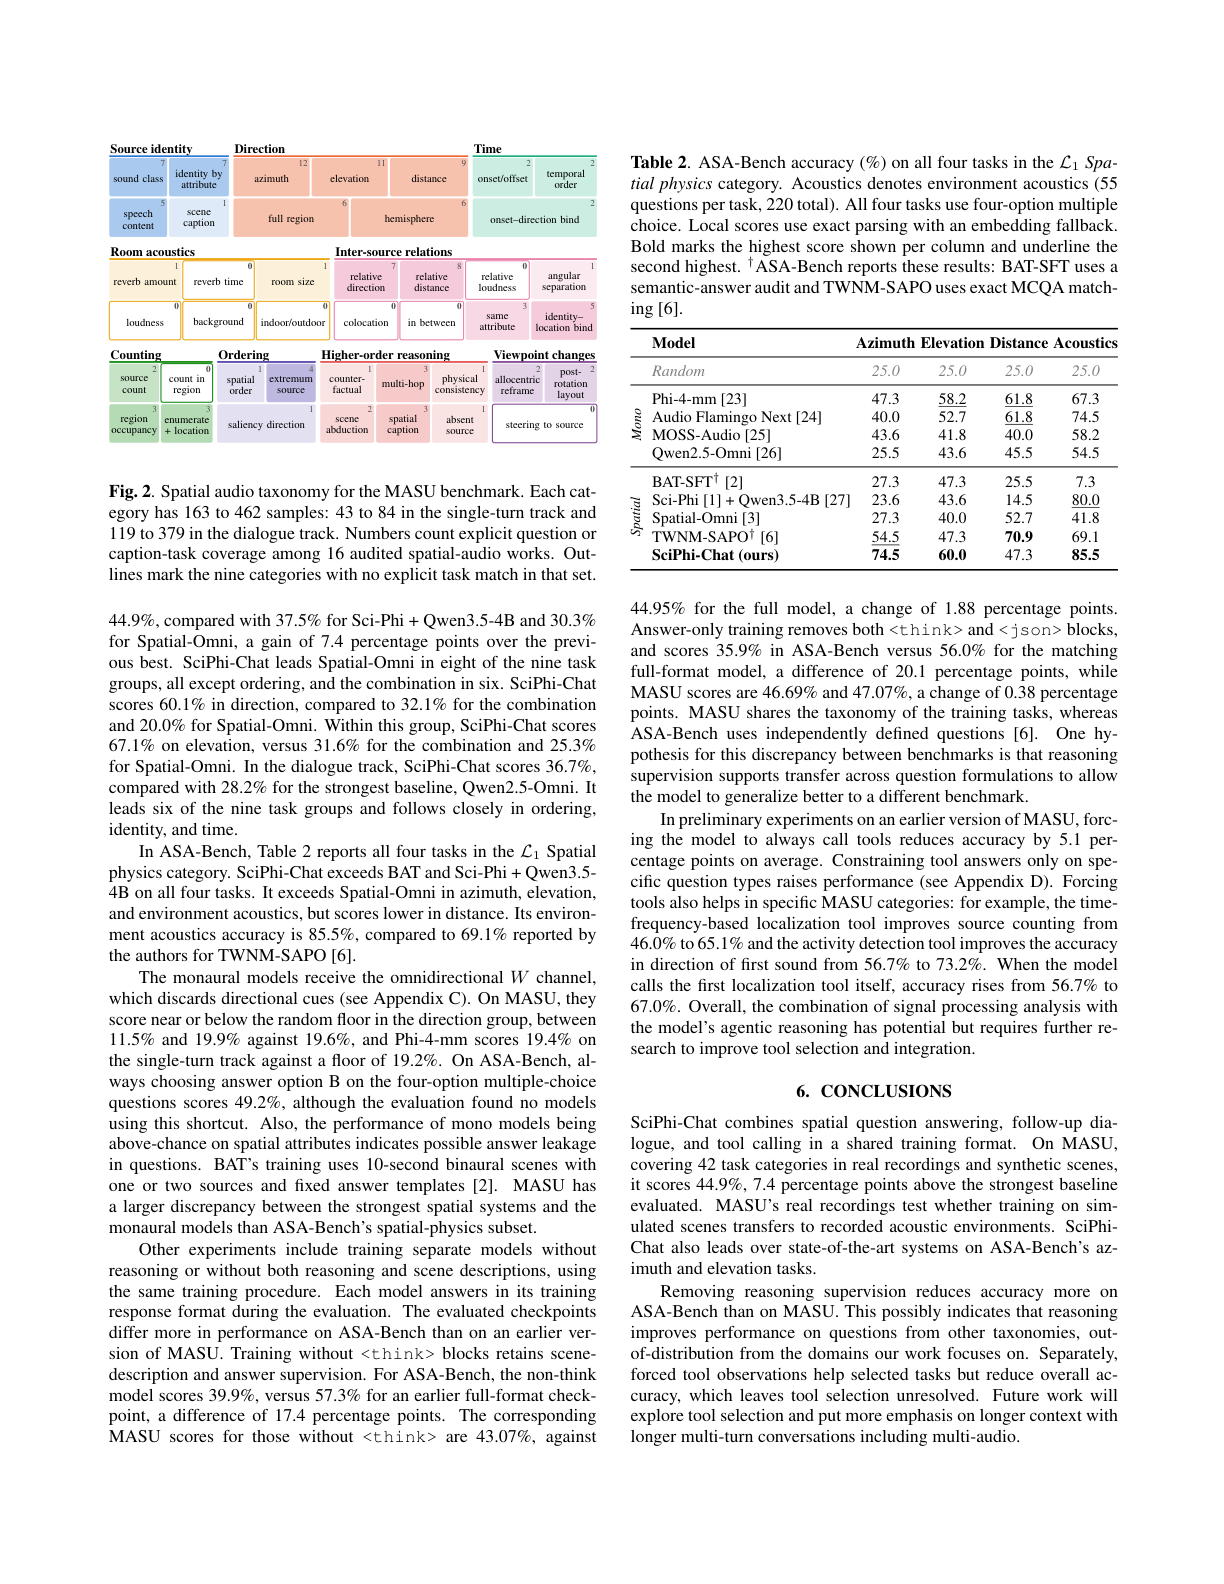
图片来源:原论文 PDF 第 4 页(含图 2)。完整图注与解读见独立文章。
英文题目:SciPhi-Chat: Training a Spatial Audio Agent for Question Answering, Dialogue, and Tool Use
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Gijs Wijngaard:机构信息未能在本次解析中与作者逐人可靠绑定
- Hannes Gamper:机构信息未能在本次解析中与作者逐人可靠绑定
- Sebastian Braun:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务输入是一段一阶Ambisonics录音,即以全向分量加三个正交方向分量记录的三维声场,需要说出其中出现了哪些声音、它们在方向距离上的位置、发生先后和相互关系并回答追问。难点在于声音身份与空间位置需绑定,指代需跨轮次解析,数值型答案还需测量支撑。模型把四通道频谱送入冻结的空间编码器得到空间嵌入,把全向通道送入冻结的语音编码器得到音频标记,再与文本一起送入语言解码器。解码器首轮生成思考过程、结构化场景描述和最终答案,该描述保留在对话历史中供后续轮次引用,需要测量时生成工具调用并在收到环境观测后继续作答。与已有空间模型的关键差异是以同一格式同时训练问答、对话、思考过程和工具调用。在MASU单轮轨道按九组平均的平均分指标上SciPhi-Chat为44.9%,高于最强对照Sci-Phi加Qwen3.5-4B的37.5%,高出7.4个百分点;在外部ASA-Bench上方位角准确率为74.5%、仰角准确率为60.0%,均为本地评测模型中最高。在早期版MASU的初步实验中强制每次调用工具平均准确率降低5.1个百分点,结论适用于最长30秒、最多10个方向声源加弥散背景的片段,原文披露了约4天的8卡B200训练开销。
🔗 开源资源
- 第三方资源:https://github.com/microsoft/sciphi-chat — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 把检测器放进声码器训练:内生对抗语音合成解读

英文题目:Detector-Guided Vocoder Training for Adversarial Text-to-Speech Synthesis
评分:6.4/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiayan Cui:机构信息未能在本次解析中与作者逐人可靠绑定
- Davide Salvi:机构信息未能在本次解析中与作者逐人可靠绑定
- Paolo Bestagini:机构信息未能在本次解析中与作者逐人可靠绑定
- Stefano Tubaro:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音伪造检测要区分合成语音与真实语音,攻击者希望合成语音保持自然的同时被判为真实,已有加噪式后处理需额外计算,还可能留下可利用痕迹。该方法把文本转语音拆成声学模型和声码器,文本先经固定的声学模型生成梅尔谱,梅尔谱再送入待微调的声码器生成波形,从而把对抗优化位置固定在波形生成环节。微调时合成波形同时送入冻结的检测器,检测器对波形的预测构成指向真实类的检测损失,其梯度只回传更新声码器参数,以抑制检测器依赖的线索而不改变声学模型。训练目标由原始声码器损失与该检测损失按权重相加,多检测器时对多个检测损失加权求和,离线微调一次后推理不再调用检测器或后处理,对抗能力来自声码器参数本身。在LibriTTS训练并以相同真实语音对照合成变体的评测中,以等错误率为指标,基线声码器下RawNet2、TSSD、AASIST分别为5.8%、3.40%、0.85%,单检测器引导后分别高于基线升至39.05%、38.33%、21.09%,双检测器联合引导后进一步高于单检测器升至43.87%、43.31%、23.26%。对应平衡准确率降至接近随机判别的水平,结论适用于受控合成与相同采样条件的检测器评估,未验证跨声码器、跨语种与传输失真情形。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/polimi-ispl/adversarial-tts — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 记住不等于用对:语音大模型多轮记忆中的历史干扰

英文题目:The Right Source Is Not Enough: Understanding History Interference in Speech-LLM Memory
评分:6.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- HongJin Song:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiqiao Shan:机构信息未能在本次解析中与作者逐人可靠绑定
- Runwu Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifei Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yujin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiale Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiasheng Kuang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinyu Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaoqi Cui:机构信息未能在本次解析中与作者逐人可靠绑定
- Chuizheng Kong:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyu Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Guowu Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiuyu Fang:机构信息未能在本次解析中与作者逐人可靠绑定
- Chunxiang Jin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音大模型保留多轮历史音频后,当前问题需从多段录音中选定目标来源作答,难点是目标内容仍被记住时无关历史中的值仍会把答案带偏。论文用自然朗读与可控合成语音构造目标固定而历史值变化的配对条件,对比中性历史与竞争历史下的选择变化。先保留历史但让解码器0–17层正常处理历史,在18–35层屏蔽后续位置对无关来源片段的直接注意力,开放式生成词在所有层也被屏蔽,以检验残留影响是否需要继续直接读取。再在同样的后期屏蔽下,把问题–候选项状态在完全访问运行与早期屏蔽运行之间双向转移,移除或恢复错误以检验早期历史影响是否由这些状态携带。最后在各层拟合四维来源角色基与经角色正交化后的价值基,把跨内容供体的投影差加入受体,区分角色信号与历史值信号在不同深度的因果作用。开放式生成中屏蔽后期直接读取几乎消除了历史值错误,而多项选择中大量错误在屏蔽后仍然存在,把早期历史影响转移走可以消除错误,恢复则能重建错误。在自然录音构成的3000个多项选择问题评测中,竞争历史相对中性历史使准确率MOSS-Audio从84.23%下降到78.73%,MiMo-Audio从48.23%下降到39.67%,且在目标单独可答的子集上下降仍然存在。结论适用于两款模型的诊断性干预范围,未验证训练来源,也没有提供无需oracle信息的在线修正方法,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 输入没说清时,不确定性从哪里来:规格、残余与模型的三项分解

英文题目:Specification-Aware Predictive Uncertainty Decomposition
评分:6.2/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Roman Vashurin:MBZUAI
- Mikhail Seleznyov:AXXX;S-NLP
- Assel Yermekova:Huawei Technologies Ltd.
- Fedor Chernogorskii:MBZUAI
- Danila Zykov:HSE
- Elena Tutubalina:HSE
- Alexander Panchenko:AXXX;S-NLP
- Preslav Nakov:MBZUAI
- Nikita Kotelevskii:MBZUAI
- Maxim Panov:MBZUAI
📌 核心摘要
读者面对的是观测输入 x 只部分描述用户真实意图的问题,输出是答案的概率分布,难点在于原有偶然与认知二分无法判断补充信息能否降低风险。论文设定未观测意图 z 与答案 y 的联合过程,用期望损失度量风险,把贝叶斯风险再拆成澄清带来的期望下降与澄清后剩余风险,加上模型与真分布差距的超额风险。估计时用意图生成模型提供可能的 z 样本,用集成成员代表参数后验样本,经跨打分与语义聚类得到三个分量。相对已有澄清集成工作,新分解保留了意图已知时结果仍随机的剩余风险,并把认知项单独保留。文本问答错误检测中剩余项在 Gemma E2B 上达到 AUROC 0.7285,超过规格项 0.5627;视觉问答欠明确检测中规格项在 VQS 上达到 0.6614,超过总量 0.5486。结论适用于输出空间在澄清前后不变、且 x 在给定 z 后不再提供额外信息的任务,意图生成器偏差与集成成本是主要限制。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 只做土耳其语的小模型怎样从零学会听写
英文题目:ufakzeka-kulak: Building and Evaluating a 31.6M-Parameter Turkish Speech Recognizer from Scratch
评分:6.2/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Sait Furkan Teke:ufak AI
📌 核心摘要
土耳其语离线识别需要体积小、可商用、可在普通电脑和浏览器运行的模型,而现有大模型多为多语言且体积大。输入是 16,000 Hz 单声道语音,输出是带大小写、句号、逗号、问号、撇号和词内连字符的土耳其语文本,数字写成单词,难点在于可商用人工标注只有约 281 小时,其余近 4,696 小时需从上传者字幕或机器转写中提炼可靠文本。做法是先用较快的开放识别器写初稿,再用另一家机构的模型独立复核,只保留两者一致程度达标的句子;训练采用 16 层 FastConformer 编码器同时接转导解码器和辅助分类头,并用事先固定的试点规则决定增强与配方。发布门限要求在两个未见过的测试集上都超过 Whisper base,贪心解码的归一化词错率在 FLEURS 土耳其语测试集为 0.0921,低于 Whisper small 的对应成绩,而 Whisper large-v3 为 0.0604。会话语音上词错率为 0.3807,约为朗读语音的四倍,模型尚不适合对话场景。从试点起点到冷却结束共用 52.3 个 A100 80 GB 图形处理器会话小时,含验证与存档开销。
🔗 开源资源
第三方资源:https://github.com/ufakai/ufakzeka-kulak — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/ufakai/ufakzeka-kulak — 链接可访问(HTTP 200)
第三方资源:https://kulak.ufakzeka.com — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 靠参会名单给回头客找到注册语音:跨会议的出席引导注册

评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Minjae Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Hee-Soo Heo:机构信息未能在本次解析中与作者逐人可靠绑定
- Youngki Kwon:机构信息未能在本次解析中与作者逐人可靠绑定
- Bong-Jin Lee:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
会议存档中同一批人反复出现,每次录音经说话人分离得到匿名单说话人簇,每次会议附带预期出席名单给出名字集合,任务是为跨会话重复出现的声音找到对应名字并挑出可信注册语音。难点在于名单只是事前预期,列出者可能未说话,说话者可能未被列出,且单会话内名单与簇均为无序集合,无法直接对应。参考方法先以每个匿名簇为种子跨所有会话各选最相似簇组成跨会话链条,再以名单内会话与名单外会话平均相似度之差打分,经匈牙利算法全局一对一指派并用阈值筛选,出席模式相同者直接弃权。指派后只保留该名字在名单内会话中的链条簇,将片段嵌入池化为均值嵌入并取余弦最靠近的代表性片段作为注册语音,名单外会话证据不再恢复。评测用校准到自有会议统计的合成基准分开发集选阈、评测集报告强成功—污染曲线,真实会议只作阈值平移诊断。在合成评测集10%污染预算下,以强成功率计,仅含遗漏噪声条件为39.62%,高于含两类噪声的主要条件的35.16%。结论仅适用于会内说话人簇正确、无重叠且出席模式可区分的情形,出席模式相同与名单证据不足者按设计不可达,真实验证仅限单一私有语料且声学失配与实际分离误差会进一步拉低成功率,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. 给视频选输入:多模态大模型做视频标注时表示为何重要

英文题目:What Does the Model See? Representation Validity in Multimodal LLM-Based Video Analysis
评分:6.1/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Christian Pipal:机构信息未能在本次解析中与作者逐人可靠绑定
- Eva-Maria Vogel:机构信息未能在本次解析中与作者逐人可靠绑定
- Morgan Wack:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
社会科学研究需要把短视频转成多模态大语言模型可读的输入,难点在于语音、字幕、画面和声音携带不同信息,删减或转写会改变待测构念的证据。论文把原视频记为 X,表示过程记为 R,模型输入记为 X_R,模型输出记为 Y_hat,用固定模型和提示改变 R 来分离表示的影响,并提出充分性、利用、整合与推论有效性四项检查。研究比较元数据、自动转写、提取文本、16 帧加音频、原生视频、原始文件、图文混合与模型先描述再编码等路径,覆盖六个开放权重音视频模型与德语新闻、英语仇恨言论、英语情景喜剧讽刺三个数据集。在七个言语新闻构念上,原生视频宏平均 F1 为 0.70-0.77,提取文本为 0.52-0.80,方向随模型反转;选择宏平均 F1 最高的路径只能在 42 次比较中的 17 次同时取得最小回归系数误差,即使选用最优可部署路径,仍有 45% 的样本占比估计偏离人工标注基准超过 10 个百分点。结论适用于所测模型与取样方式,原始文件在部分模型上无法处理,更多帧数与更高分辨率在本应用中增益有限。论文披露了单卡推理耗时与换算成本,未披露训练成本。
🔗 开源资源
第三方资源:https://doi.org/10.7802/2863 — 暂时无法访问
第三方资源:https://doi.org/10.5281/zenodo.7799469 → https://zenodo.org/records/7799469 — 链接可访问(HTTP 200)
第三方资源:https://github.com/soujanyaporia/MUStARD — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 用干净语音锚定输出长度:竞争语音下 CTC 适配的多余发射控制

英文题目:Clean-anchored excess-emission control for CTC adaptation under competing speech
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuanbo Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Junjie Xiong:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
单输出连接时序分类识别器在目标语音混入另一说话人时,常把干扰语音词元也解码出来而产生多余词,而干净语音对应的正确输出长度是已知的。冻结教师先对每条干净波形按帧后验计算期望折叠词元数,该期望统计首帧非空概率与后帧与前帧采样标签不同且非空的概率之和,并把每条语音的一个标量锚点缓存下来。加噪学生接收合成混合语音和目标转录,用同一公式计算自身期望折叠词元数,其中普通连接时序分类损失负责学习词元身份,计数值负责度量输出长度。超出量进入单侧约束:学生计数不超锚点时惩罚为零,超出时按相对锚点的比例做平方惩罚再与连接时序分类损失相加,适配只更新编码器0、1层查询和值投影上的秩24低秩增量。相对已有教师匹配后验或空白正则做法,该方法的差异是只传递一个utterance级标量,不匹配整套后验分布,也不奖励越短越好。在锁定LibriSpeech测试上,语音干扰词错误率从45.198%降到44.323%,干净条件只变化0.004个百分点。未见过的VCTK干扰人声下总体从42.967%降到42.660%。结论只适用于目标能量不弱于干扰的合成混合和早期层适配,延长训练会让说话人条件继续变好但噪声和音乐变差,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 用采集信息调节听诊模型的呼吸音分类解读
英文题目:Metadata-Conditioned Audio Transformers for Adaptive Respiratory Sound Classification
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- George Kontogiannis:机构信息未能在本次解析中与作者逐人可靠绑定
- Pantelis Tzamalis:机构信息未能在本次解析中与作者逐人可靠绑定
- Sotiris Nikoletseas:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
呼吸音分类的输入是听诊录音的对数梅尔声谱图,输出是啰音、哮鸣音及其共存的类别判断,难点在于四种录音设备频响、七个胸部采集部位和年龄体重时长等个体差异会系统改变声学分布,容易被模型误当作病理线索。声学主干采用音频频谱Transformer,将声谱图切块投影后与[CLS]和[DIST]词元一起送入Transformer层,平均两个特殊词元得到音频表示用于啰音与哮鸣音双标签分类。元数据侧把设备编号、部位编号映射为可学习嵌入,年龄体重时长组成标准化连续向量,先编码为调节嵌入,再经层专属投影生成缩放和平移参数,在归一化后、前馈子层前对特征做逐维缩放和平移。四种做法按作用范围递进:门控残差融合只在最终表示上加权叠加元数据投影,标准特征调制把同一组参数广播到所有词元,词元感知调制为分类词元与块词元生成独立参数,软掩码调制则为设备、部位、连续因素各设编码器并学习特征维软掩码加权组合,以交叠与覆盖正则形成划分的子空间。在ICBHI官方60%-40%划分下,软掩码版本四分类任务的Score为64.11%,高于基线60.17%。在同一划分下,该版本二分类任务的Score为72.40%,高于此前最佳70.08%。结论只在该数据集和该划分下成立,对训练集中完全缺失的设备和部位偏移没有测试。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/kontogiannisg/Metadata-Conditioned_Audio_Transformers — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. 方向统计怎么做信号建模:从不变性到分布、学习与两个案例

评分:5.8/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Anders S. Olsen:机构信息未能在本次解析中与作者逐人可靠绑定
- Kanti V. Mardia:机构信息未能在本次解析中与作者逐人可靠绑定
- Dimitri Van De Ville:机构信息未能在本次解析中与作者逐人可靠绑定
- Morten Mørup:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要处理的对象是相位、归一化向量、特征向量、子空间和协方差这类信号表示,它们的数值会因周期包裹、符号翻转、全局相位旋转、基旋转或尺度变化而改变,但物理含义不变,直接用欧氏平均和欧氏聚类会出现包裹断裂、符号割裂和质心不在样本空间的问题。论文把不变性抽象为圆、环面、球面、实与复投影空间、旋转群、Stiefel流形、Grassmann流形和正定矩阵锥等样本空间,再为每个空间配套单峰、各项异性、径向投影、环面包络和协方差生成五类分布,并给出几何感知K均值、混合模型和隐马尔可夫模型的学习流程。输入的多通道相位先去掉幅度并决定是否去掉公共载波相位,得到环面商空间或复投影向量,再经外积得到复相干、余弦相干、低秩子空间或主特征向量,分别交给环面模型、复角中心高斯分布、矩阵角中心高斯分布或投影空间模型估计状态。相对已有分散的定向统计用法,论文的差异在于按构造方式统一比较归一化常数代价,并引入低秩加各向同性结构和商环面聚类以兼顾高维可行性。在车内三说话人留存语音的留存场景评测中,以归一化互信息为指标,四个定向混合模型在K≥2时均高于复高斯模型,定向模型在K=3处取峰值而复高斯模型在K=4处取峰值,K=3时仅复高斯模型未能分辨位置2。结论适用于周期、对称和基不变明显的同步与阵列问题,但车内实验仅为单一固定几何与单个训练—留存场景,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/anders-s-olsen/PCMM — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 听到无人机:手工声学特征与预训练嵌入如何分工、融合与防泄漏评测

评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Zahid Iqbal:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务是对1秒单通道16 kHz波形判断是否含有小型多旋翼无人机声音,输出无人机概率与二值判定。难点在于无人机片段切自少数长录音,非无人机片段大量切自已有环境声音库,随机划分会让同一来源的片段同时出现在训练和测试中,测得的准确率会把记住录音误当成检出无人机。每个片段先表示成两路向量,一路是对57个描述频谱包络与谐波结构的统计量做混合筛选,另一路是冻结的预训练音频网络给出的1024维嵌入向量。随后随机森林与梯度提升树分别在两路上训练,得到每个片段的四路无人机概率。在训练池内用分组交叉验证产生样本外概率,再以逻辑回归元学习器学习四路概率的加权综合,基学习器在全训练池重拟合后用于测试,阈值0.5判定为无人机。相对只用手工特征的堆叠模型,两路融合在分组评测下把平均准确率从94.18%提高到95.29%,召回率提升是主要来源,未见过来源的环境声音识别为非无人机的比例为98.78%。结论只在该数据集的分组划分内成立,随机划分会把四个模型的准确率高估1.89至3.22个百分点。开销方面,原文在配有两个AMD EPYC 7513处理器的工作站上,以单CPU线程按100个片段取中位数测得处理一个片段需51.0 ms,可在一秒内完成。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. DGC-Net:用跨模态证据选局部线索、再以全局为主做补偿的多模态情感分析

评分:5.8/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Linan Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Huaijing Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiao Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuhao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是带有说话文本、声音和面部画面的短视频,任务是预测说话人情感的正负与强度,输出为连续分数或离散类别。难点在于三个模态的线索常常互相冲突,而且细粒度的局部表情或语气片段是否可信会随样本变化。论文提出的网络先为每个模态分别提取整体语义表示和保留区域细节的局部表示,再用跨模态的整体语义指导当前模态选择哪些局部专家进行提炼,提炼后的局部表示只保留本模态内容而不直接混入其他模态特征。随后共享变换器对全局与提炼后局部表示做跨模态上下文建模,每个模态用一个受约束的比例系数决定全局为主、局部为补偿的融合权重,并保留非线性交互与两条融合路径做最终预测。与同特征和同划分的全局局部基线相比,该方法在 CMU-MOSI 上把平均绝对误差从 0.718 降到 0.698,方向为越低越好,同时相关系数从 0.782 升到 0.800,方向为越高越好。结论适用于已对齐特征的英文情感基准,对中性边界和部分幽默讽刺与中文情绪任务的泛化有限。原文未披露训练时长、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. CrowdForge:当观众同时指挥 AI 音乐与混合现实舞台时会发生什么

评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.9/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Torin Hopkins:机构信息未能在本次解析中与作者逐人可靠绑定
- Shih-Yu Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Zander Trafton-Hancock:机构信息未能在本次解析中与作者逐人可靠绑定
- Ellen Yi-Luen Do:机构信息未能在本次解析中与作者逐人可靠绑定
- Luca Turchet:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
现场演出常是单向的,观众缺少易懂又能保持音乐连贯的多人协作方式,难点在于让高层偏好变成可感知的演出变化。CrowdForge让观众在每套演出前用手机网页为音频、视觉或两者投票,聚合看板汇总结果后再驱动音乐与场景生成,使观众选择成为可听可见的演出成分。网页界面负责收集滑块与下拉投票并聚合成目标流派与配器等请求,再以OSC消息同时发给音乐生成、Ableton Live控制与Unity渲染,完成后一步的聚合参数成为后一步生成的输入。Llama-Z语言模型按该请求自回归生成多声部MIDI,经控制器拷入Ableton Live的Session轨道,由DJ控制速度、调式与效果并与吉他手即兴合演,实现从投票到可演奏乐曲的转换。Unity按聚合服务器的OSC更新环境、角色外观与舞步,并由佩戴Meta Quest头显的演示者投屏呈现,使同一投票同时落到声音与画面。两场共19名观众、每条件约7分钟演出后的1-9分自评问卷中,结合条件在效价指标上效应量r为0.80(p=0.003)显著高于5分中性基线,而纯视觉条件未显著超过该基线。同一问卷设置中,结合条件在唤醒度指标上效应量r为0.76(p=0.004)显著高于中性基线,纯音频条件效应量r为0.84亦高于该基线而纯视觉未超过基线,结论适用于小规模共位演出与回合开始时投票的设置,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://www.youtube.com/watch?v=nbGJMI_i9CU — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. 只帮一个类别:人声二分类加人工核验如何省下森林音频标注时间
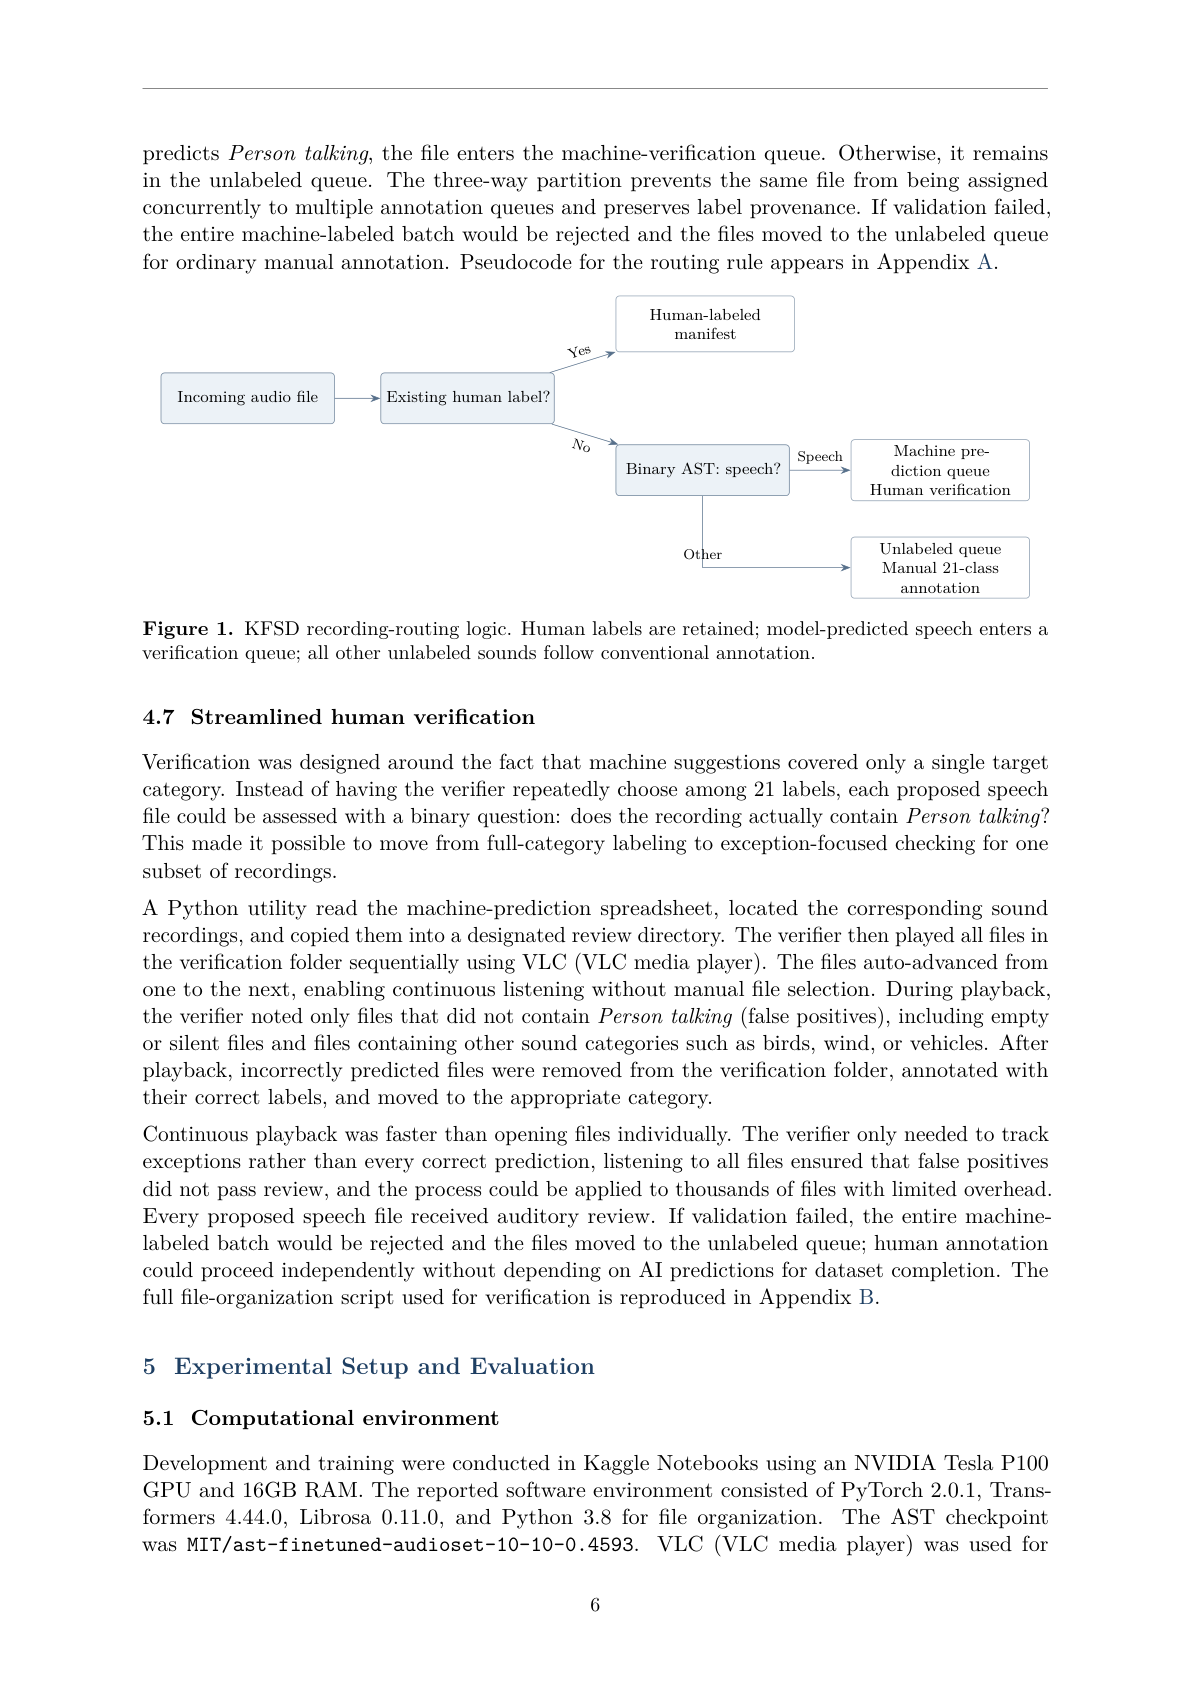
图片来源:原论文 PDF 第 6 页(含图 1)。完整图注与解读见独立文章。
英文题目:A Human-Verified AI Workflow for Annotating Environmental Sound Data
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Michael Barasa Murunga:机构信息未能在本次解析中与作者逐人可靠绑定
- Allan Vikiru:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
肯尼亚森林声音工作集包含 7531 条时长 0.11 秒至 5.02 秒的环境录音,共 21 个声音类别,建模开始时仅 2505 条有人审标注,剩余 5026 条待标,且类别极不均衡,困难在于以有限人力保证一致性,又不让机器建议覆盖已有人审结论。工作流程先尝试文本音频对照模型做零样本划分,再用音频集预训练的频谱变换器做直接映射,接着加入过零率等常规描述量做加权组合,最后把该变换器微调为区分人声说话与其他类别的二分类器,前一步的输出只决定后一步处理哪一个队列,核验通过才转为可用标注。微调后的二分类器在保留测试集上准确率为 89.36%,而直接映射基线为 59.00%,差距为 30.36 个百分点,但仍低于作者预设的 95% 自主标注门限,因此 2337 条判为说话的录音全部进入单问题听辨复核。与剩余队列全人工处理约需 48.9 人时相比,混合流程耗时约 28.9 人时,节省约 20.0 小时即 41%,复核平均每条约 4.2 秒,人工逐条标注平均每条 35 秒。结论仅适用于该工作集与该录音环境,作者承认对其他类别、其他声场与更大规模的适用性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/SCES-Makerspace-Lab/Auto-Sound-Annotation-2026 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 视频生成背后:Kling 如何把多模态理解变成可控生成

英文题目:Behind Video Generation: Observations and Insights on Multimodal Understanding from Kling
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Kling Team:机构信息未能在本次解析中与作者逐人可靠绑定
- Dong Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jialu Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinlong Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifan Dai:机构信息未能在本次解析中与作者逐人可靠绑定
- Haotian Dong:机构信息未能在本次解析中与作者逐人可靠绑定
- Binzong Geng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yushuo Guan:机构信息未能在本次解析中与作者逐人可靠绑定
- Minghui Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Guanlin He:机构信息未能在本次解析中与作者逐人可靠绑定
- Guanxiao He:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingyun Hua:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanwei Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiyan Ji:机构信息未能在本次解析中与作者逐人可靠绑定
- Xueping Jia:机构信息未能在本次解析中与作者逐人可靠绑定
- Yizhuo Jia:机构信息未能在本次解析中与作者逐人可靠绑定
- Bozhou Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaze Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Min Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Shihao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Shujie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengyi Liao:机构信息未能在本次解析中与作者逐人可靠绑定
- Weihong Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Shiyuan Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinyu Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Siyang Mao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoru Qu:机构信息未能在本次解析中与作者逐人可靠绑定
- Dianmo Sheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiafu Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Longxiang Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuqi Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Chengzhuo Tong:机构信息未能在本次解析中与作者逐人可靠绑定
- Kuo Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qixun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianduo Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuran Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zekun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zihao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Boyang Xia:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifan Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Liu Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhenlong Yuan:机构信息未能在本次解析中与作者逐人可靠绑定
- Bohan Zeng:机构信息未能在本次解析中与作者逐人可靠绑定
- Mujin Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuanxing Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhicheng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhuoran Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuanhong Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Kun Gai:机构信息未能在本次解析中与作者逐人可靠绑定
- Chengru Song:机构信息未能在本次解析中与作者逐人可靠绑定
- Pengfei Wan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
视频生成要解决的输入是混杂的文字要求、人物肖像、源视频和声音,输出是多镜头连贯且声画对齐的短片,难点是局部正确不等于整体可用,错误会随时间累积并在镜头之间传递。论文先用 Kling-MLLM 统一处理图像、视频、音频、同步音视频和交错输入,为各模块提供共享感知基础。接着用稠密的生成导向字幕和带引用绑定的字幕把视频事实写成训练监督,再用提示词增强把用户请求翻译回这种字幕分布。文本编码器负责把文字转成扩散模型可用的连续条件,奖励模型提供可解释的定位 critique 和快速多维打分,任务专用的自动评测负责暴露走捷径的打分并回溯故障来源。与直接复用现成编码器或通用改写器的做法相比,关键差异是强调描述密度、感知适配和多层条件稳定,并把大量增益放在进入生成器之前的文本层面解决。在内部累计消融中,提示词增强从随机来源基线到加入检索的完整流程,StoryEval 从 65.42 提高到 77.72,MultiRef-Compass 从 4.6137 提高到 4.7158,决策奖励模型在内部成对偏好上达到 77.86% 的宏平均准确率。结论适用于以稠密字幕训练的扩散视频模型,对长视频时空一致性和开放域泛化仍未充分验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 音乐何时需要意义:面向音乐元宇宙的语义通信框架解读

评分:4.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.8/1.5
排名:后 50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Ali Al Housseini:机构信息未能在本次解析中与作者逐人可靠绑定
- Jaime Llorca:机构信息未能在本次解析中与作者逐人可靠绑定
- Cristina Rottondi:机构信息未能在本次解析中与作者逐人可靠绑定
- Luca Turchet:机构信息未能在本次解析中与作者逐人可靠绑定
- Tiziano Leidi:机构信息未能在本次解析中与作者逐人可靠绑定
- Omran Ayoub:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音乐元宇宙要求分布在多地的演奏者、观众、调音师与智能体围绕同一音乐时间互动,输入是音频、动作、触觉、视觉与语义元数据等多模态流,输出是各接收端按时对齐的监听、提示或渲染结果,难点在于不同数据对协调的价值不同,而传统按流量类别调度无法识别单个事件的音乐功能。论文把要解决的问题定义为传输并执行与音乐意义有关的信息,提出三个分工:语义提取负责从原始采样算出任务需要的描述子,语义编排负责按接收方请求与网络计算状态选择内容与策略,跨模态语义同步负责把同一事件在各端的输出时刻关联起来。沿一个吉他乐句的示例,设备端编码器给出音高与起音等字段并附带置信度,边缘路由器为鼓手保留起音细节、为歌手保留音高轮廓并在带宽不足时削减音色细节,同步服务再把节拍位置、表情偏移与输出余量映射为本地时钟目标。相对已有工作,差异在于把节拍、声部角色与输出残差等音乐量显式写入通信契约,而不是只做通用沉浸媒体传输。原文未提供可核对的关键定量结果。原文未披露训练、推理或部署成本,适用范围限于框架与接口设计,事件级同步与感知收益尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。