📄 SciPhi-Chat:能听方向、能对话、能调工具的空间音频智能体
英文题目:SciPhi-Chat: Training a Spatial Audio Agent for Question Answering, Dialogue, and Tool Use
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Gijs Wijngaard:机构信息未能在本次解析中与作者逐人可靠绑定
- Hannes Gamper:机构信息未能在本次解析中与作者逐人可靠绑定
- Sebastian Braun:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务输入是一段一阶Ambisonics录音,即以全向分量加三个正交方向分量记录的三维声场,需要说出其中出现了哪些声音、它们在方向距离上的位置、发生先后和相互关系并回答追问。难点在于声音身份与空间位置需绑定,指代需跨轮次解析,数值型答案还需测量支撑。模型把四通道频谱送入冻结的空间编码器得到空间嵌入,把全向通道送入冻结的语音编码器得到音频标记,再与文本一起送入语言解码器。解码器首轮生成思考过程、结构化场景描述和最终答案,该描述保留在对话历史中供后续轮次引用,需要测量时生成工具调用并在收到环境观测后继续作答。与已有空间模型的关键差异是以同一格式同时训练问答、对话、思考过程和工具调用。在MASU单轮轨道按九组平均的平均分指标上SciPhi-Chat为44.9%,高于最强对照Sci-Phi加Qwen3.5-4B的37.5%,高出7.4个百分点;在外部ASA-Bench上方位角准确率为74.5%、仰角准确率为60.0%,均为本地评测模型中最高。在早期版MASU的初步实验中强制每次调用工具平均准确率降低5.1个百分点,结论适用于最长30秒、最多10个方向声源加弥散背景的片段,原文披露了约4天的8卡B200训练开销。
🔗 开源与复现资源
- 第三方资源:https://github.com/microsoft/sciphi-chat — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
人能听到的空间信息是什么
人即使看不见声源,也能同时判断有几个声音、分别是什么、在哪个方向、多远、多响、何时开始结束,以及它们之间的相对关系。机器要做到这一点,只给单声道录音是不够的,因为单声道把左右前后的差异压成了一个波形。
空间音频用多通道保留到达差异。1 阶 Ambisonic 用 4 个通道记录声音,其中全向分量 W 类似单声道,另外 3 个分量分别记录前后、左右、上下方向的声压梯度信息。论文的输入就是这种 4 通道录音,最长 30 秒,一个片段里最多有 10 个有方向的声源再加弥散背景声。模型的目标是把这段录音变成可问可答的对象:既能做开放与选择问答和描述,也能承接追问,还能在需要测量时请求工具。
已有路线各解决了哪一块
空间问答此前有两条输入路线。BAT 等用双耳音频,SPUR、ASA-Bench 相关工作、Spatial-Omni 和 Sci-Phi 用 1 阶 Ambisonic。Sci-Phi 能做场景描述并经微调回答指定方向是什么声等问题,但按原文的比较,它没有把指代上文声源的多轮对话和可执行的工具调用放进训练。
单声道方面有多轮对话、中间推理和工具调用的各自进展,例如 Audio Flamingo 做多轮音频对话,一些工作训练中间推理,另一些工作做工具调用。空间模型中也有引入推理的尝试。论文把比较限定在相同输入和任务下:空间能力要在空间音频输入上比,单声道模型只能作为检验方向信息是否必要的对照,而不能把类别不同、输入不同的分数直接当成同条件胜负。本文的定位是第一个把多轮问答、思考过程和工具调用放在同一空间音频训练格式里的模型。
论文要解决的具体问题
具体问题是空间音频问答中的身份与位置绑定和关系推理。例如哪个声源先开始、吉他在哪个区域、3 个声源如何计数、转动假设视角后水龙头会在哪里、去掉某个声源后哪个最响。这类问题要求先把每个声音是什么和它在哪里对应起来,再做比较、排序、反事实和多跳推理。
难点在于录音是混合的、声源可能在时间上重叠,还会出现缺席声源和反事实提问。缺席声源如问没有出现的小号在哪里,模型不能编造位置。反事实如问如果去掉另一个声源会怎样,要求在给定场景元数据下做假设推理。对话还带来指代,例如上文提到警报后追问它有多远,模型必须把代词链接到同一声源。
整体流程如何串起来
沿一个样本走一遍更容易理解。输入是一段 4 通道录音和用户问题。音频先走两条编码支路,一路读全部 4 通道得到空间向量,一路只读 W 通道得到内容向量,两路经投影后与文本一起进入解码器。
首轮回答分成 3 段:先在 <think> 里整理线索,再在 <json> 里输出结构化场景描述,最后在 <answer> 里给出答案。这份场景描述列出声源的内容、方位角、仰角、距离、响度、起止时间,以及房间混响、音量和背景,只在每段对话出现一次并保留在历史里。后续追问不再重写完整描述,而是带着历史描述和前面的答案继续生成。如果模型生成 <tool_call>,运行环境在原录音上执行对应的信号处理并把 <tool_response> 送回,模型再继续回答。训练只对助手侧的词计算损失,用户提示和工具返回只作为上下文而不计入损失。
音频两条支路各管什么
1 阶 Ambisonic 在本文采用 AmbiX 格式,通道顺序为 W、Y、Z、X 并用 SN3D 归一化。W 是全向分量,X、Y、Z 分别对应前后、左右、上下方向分量。只用 W 就退化为类似单声道的输入,方向线索主要藏在方向分量与 W 的组合关系里。
一阶 Ambisonic × 全向分量 W: 一阶 Ambisonic 是用四个通道保存方向线索的录音格式,全向分量 W 只保留类似单声道的总声压而丢掉方向,三个方向分量记录前后、左右、上下差异,二者搭配后模型既能听到是什么声,又能判断声从哪里来。
空间支路是一个 29.6M 参数的卷积变分自编码器,称为 FOA-VAE,处理 4 通道复数谱图信息,以 7.8 Hz 输出 512 维向量,预训练用谱重建、空间损失和判别器,智能体训练时保持冻结。内容支路是 Phi-4-multimodal 自带的 441M 参数 Conformer 语音编码器,只读 W 通道,同样冻结。训练把音频补齐到 30 秒以保持批量内长度一致。三层投影器把编码器后验统计量映射为空间嵌入,再与音频词元和文本一起作为解码条件。
FOA-VAE × Conformer 语音编码器: FOA-VAE 负责读四通道复数谱图并输出携带空间信息的向量,Conformer 语音编码器只读 W 通道并输出擅长内容与语音的声学表征,两路并行汇合后同时给解码器提供位置线索和内容线索。
推理、描述与工具接口如何分工
首轮的 3 段式输出不是装饰。推理先把时间、方向和身份线索排好,例如电吉他在 0.2 秒开始、位于后上方左侧。结构化描述再把这些判断固定为机器可复用的字段,后续的它、刚才问过的声音可以直接引用描述中的那一项,而不必重新从波形里找一遍。
<think> 推理 × <json> 场景描述: <think> 推理是回答前用自然语言整理线索的中间过程,<json> 场景描述是列出声源数量、类别、方向、距离、响度、起止时间和房间混响的结构化清单,前者负责组织思路,后者留下可被后续追问引用的显式上下文。
工具是 4 种固定的信号处理程序。计数与第一种定位工具利用时间平均的互谱 q 与声强向量 I 成反比的关系,选择低扩散度的时间窗并对方向聚类,分别估计声源数或多个方向。第二种定位工具在通过直达声主导检验的时频格上估计单个方向。活动检测工具对 W 通道能量取阈值,返回活跃时间区间。模型在对话中自主决定是否调用,调用后把观测结果用于下一步生成。
多轮对话 × 工具调用: 多轮对话让它、刚才问过的声音这类指代可以链接到历史中已识别的声源,工具调用让模型在需要测量时请求声强定位或活跃区间等信号处理结果再继续回答,前者解决上下文关联,后者补充可计算的测量依据。
5.50M 对话数据与两阶段训练
仿真负责造录音。用 pyroomacoustics 生成鞋盒房间,采样房间尺寸、表面吸收、声源和接收位置,再把单声道片段与 4 通道房间脉冲响应卷积,按随机响度混合并加入弥散背景。录音时长 5 到 30 秒,单场景最多 10 个可能重叠的声源。单声道素材来自 Freesound、BBC 音效、Sonniss、BigSoundBank、内部音效库、8 语种 Common Voice 语音,以及 FMA 和 MTG-Jamendo 音乐,字幕经清理和过滤。
对话由大模型根据场景元数据生成。42 类任务每类至少占总量 0.5%,6 个不同的大模型根据元数据、问题和目标答案生成 <think> 轨迹,再用正则检查不支持的数字、编造引用、答案泄露和非法工具引用,不合格重生成,六次仍失败则丢弃该场景。最终得到 1.93M 场景上的 5.50M 对话,每场景 1 到 8 段对话。
训练分两段。先用 1000 万音频与 JSON 对做场景描述预训练,把冻结 FOA-VAE 适配到 Phi-4-multimodal。再用对话轨迹微调,只更新空间投影器 12.6M 参数和解码器注意力与前馈上的 16 秩低秩适配器 6.9M 参数,其余冻结。学习率采用预热稳定衰减调度,稳定段为 1e-5 并在 900,000 样本后把批量从 40 增至 256,稳定段再跑 5,530,000 样本后进入 1,500,000 样本的线性衰减,发布用的是进入衰减约 300,000 样本处的检查点。原文报告微调约用 8 块 B200 花约 4 天。
MASU 测什么、怎么计分
理解评测要先看任务分类。下图是 MASU 的 42 类分类,数字表示在 16 篇已有工作中显式覆盖该任务的数量,描边表示 9 个无显式对应的类别。单轮轨有 3000 条,对话轨是 3000 段 3 轮对话共 9000 轮,其中 6000 个追问里有 4023 个只回指上文某一个声源而不重提名字。
读图时注意横向分组从依赖方向与布局的组过渡到依赖身份与时间的组,纵向再看计数、排序、高阶推理与视角变换等需要组合信息的类别。
看图路径: 1. 先看九个任务组如何覆盖方向、关系、计数、推理与视角变换;2. 再找数字为 0 的类别,理解哪些任务在已有文献中缺少显式对应;3. 对照单轮与对话轨迹的样本量,理解追问主要考什么
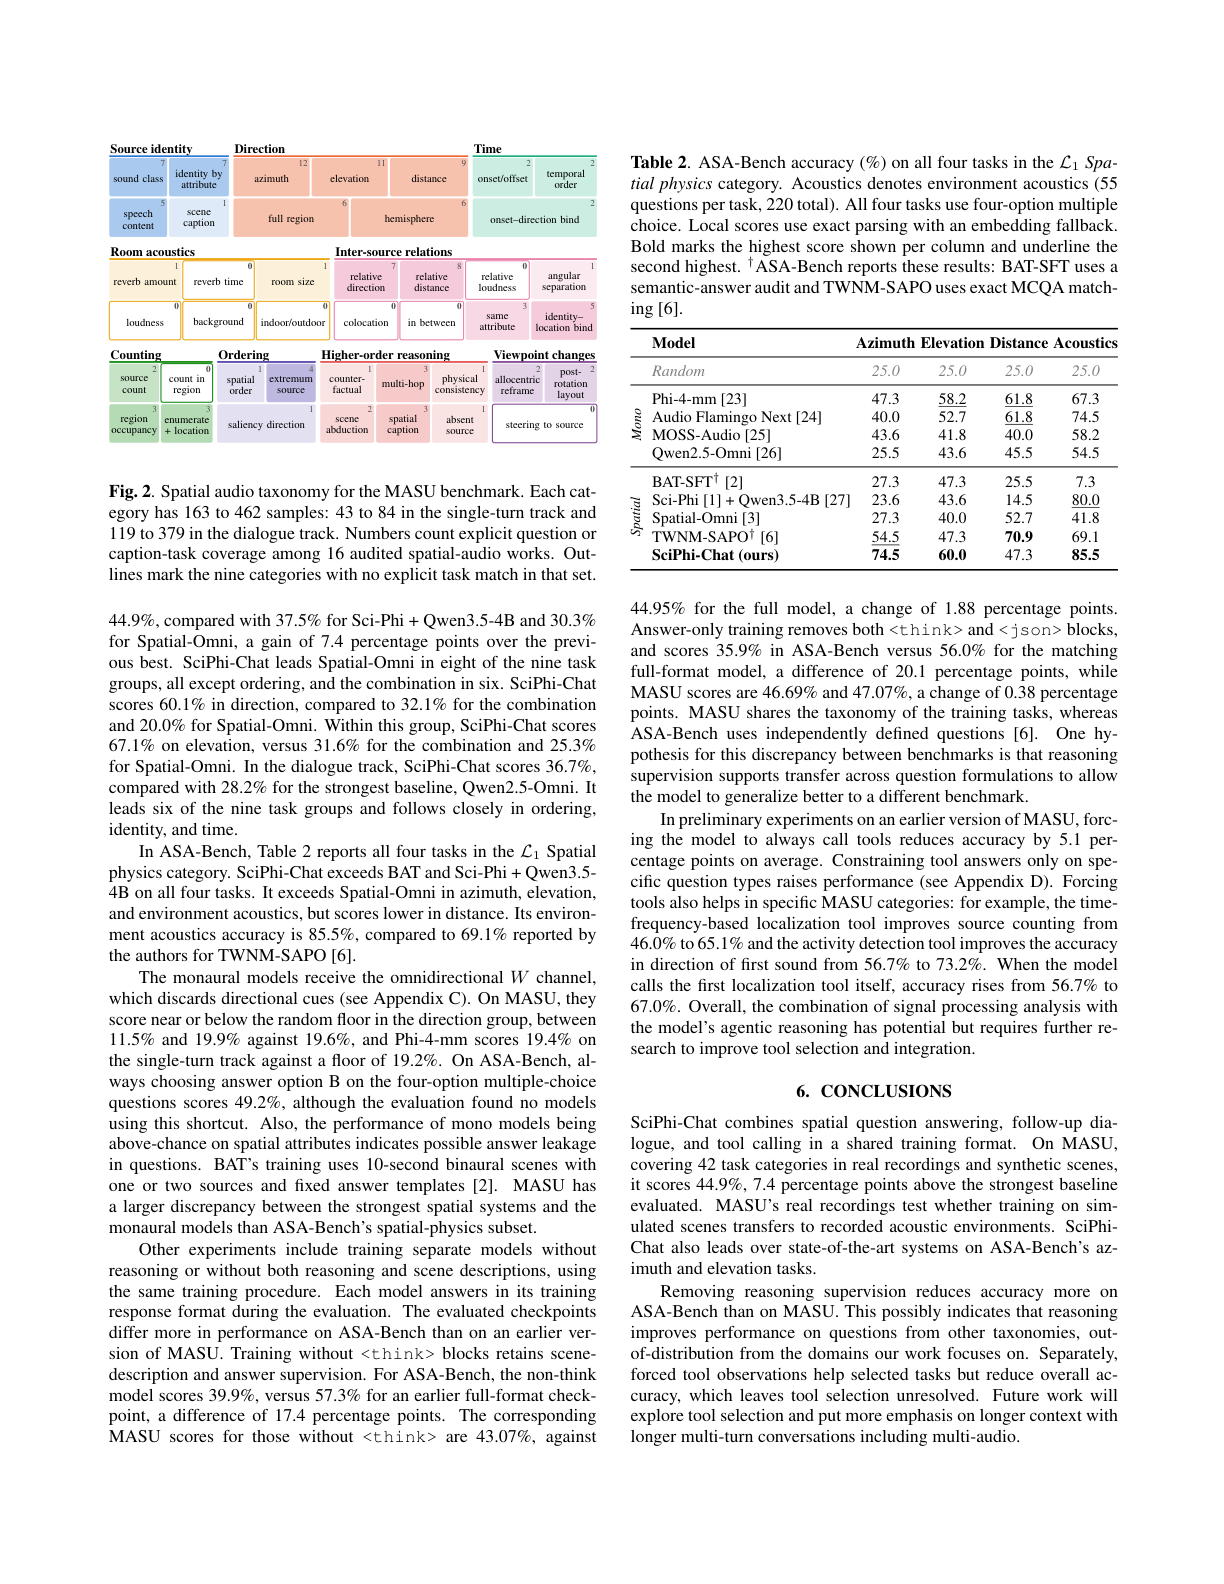
图片来源: 原论文 PDF 第 4 页(含图 2)
论文图 2。原论文 Figure 2::“Spatial audio taxonomy for the MASU benchmark.”。
该图确实展示了九大组下的 42 个细类,包括方位角、仰角、距离、区域、半球、起止与顺序、混响与房间大小、相对方向与距离、计数与区域占用、空间排序与极值、反事实与多跳、缺席声源、旋转后布局等。样本量上每类 163 到 462 条,单轮每类 43 到 84 条,对话每类 119 到 379 条。它帮助读者把后文按组报告的分数对应到具体提问方式,而不是只看一个总分。
计分按题型分别处理。MASU 共 12000 条,其中真实录音 2005 条占 16.7%,来自 STARSS23 的 78 个录音组,其余 9995 条是 2948 个仿真场景,仿真声源来自 SoundBible 并用另外 109 个仿真房间,12 类只用仿真音频。题型包括 5633 条多选、2349 条分类、728 条数值、2793 条需语言模型按量表打分的开放回答、497 条描述。每组内平均条目分,每条轨迹平均 9 组分。单声道对照只给 W 通道,BAT 给双耳渲染且只取前 10 秒,Spatial-Omni 与 Sci-Phi 组合给 FOA。
MASU × ASA-Bench: MASU 是本文按 42 类任务组织的评测,包含真实录音和留出房间的仿真场景并分单轮与三轮对话两轨,ASA-Bench 是独立定义的外部四选一评测,前者检验训练任务覆盖下的能力,后者检验换一套提问方式后能否迁移。
MASU 主结果在什么条件下成立
下表比较的是同一 MASU 划分、同一计分规则下的单轮 9 组分与总分,以及对话轨迹在模型各自历史回答条件下的平均分。表头方向从左到右按依赖方向与布局的组排到依赖身份与时间的组,随机基线按题型取均匀猜测的期望,多选按选项数倒数,分类按词表大小倒数,数值与需评判的开放回答及描述记零。
| Task group, single-turn (%) | Task group, single-turn (%) | Task group, single-turn (%) | Task group, single-turn (%) | Task group, single-turn (%) | Task group, single-turn (%) | Task group, single-turn (%) | Task group, single-turn (%) | Task group, single-turn (%) | Single Total | Dialogue Total | ||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Model | Direction | Ordering | Viewpoint | Relations | Counting | Reasoning | Room | Identity | Time | Single Total | Dialogue Total | |
| Random | 19.6 | 25.5 | 29.2 | 21.0 | 17.3 | 5.4 | 14.9 | 13.5 | 26.2 | 19.2 | 18.9 | |
| Mono | Phi-4-mm [1] | 11.5 | 22.9 | 21.6 | 30.7 | 24.7 | 5.2 | 23.7 | 14.3 | 19.6 | 19.4 | 22.6 |
| Mono | Audio Flamingo Next [12] | 15.1 | 25.9 | 29.4 | 44.5 | 27.4 | 25.5 | 35.9 | 38.2 | 23.3 | 29.5 | 26.4 |
| Mono | MOSS-Audio [44] | 19.9 | 30.3 | 29.4 | 36.6 | 32.1 | 25.7 | 40.2 | 41.5 | 32.4 | 32.0 | 25.1 |
| Mono | Qwen2.5-Omni [41] | 18.6 | 32.4 | 33.5 | 45.5 | 34.9 | 24.3 | 20.1 | 39.7 | 33.4 | 31.4 | 28.2 |
| Spatial | BAT† [46] | 8.5 | 13.3 | 3.1 | 32.2 | 17.1 | 6.1 | 7.0 | 11.4 | 3.6 | 11.4 | 8.6 |
| Spatial | Spatial-Omni [47] | 20.0 | 34.6 | 19.2 | 44.6 | 32.9 | 23.5 | 34.3 | 35.4 | 28.8 | 30.3 | 24.9 |
| Spatial | Sci-Phi [18] + Qwen3.5-4B [43] | 32.1 | 38.0 | 31.8 | 37.4 | 48.2 | 42.1 | 35.0 | 38.6 | 34.1 | 37.5 | 27.9 |
| Spatial | SciPhi-Chat (ours) | 60.1 | 28.0 | 55.1 | 49.7 | 47.9 | 45.3 | 37.8 | 48.0 | 32.1 | 44.9 | 36.7 |
表中 SciPhi-Chat 单轮总分 44.9%,高于 Sci-Phi 加 Qwen3.5-4B 组合的 37.5% 和 Spatial-Omni 的 30.3%,差距 7.4 个百分点只在该划分、该聚合方式和上述输入条件下成立。分组上它在方向组达 60.1%,组合为 32.1%,Spatial-Omni 为 20.0%,其中仰角小项为 67.1% 对 31.6% 对 25.3%。例外是排序组它为 28.0%,低于组合的 38.0% 和 Spatial-Omni 的 34.6%。对话轨迹它为 36.7%,高于最强基线 Qwen2.5-Omni 的 28.2%,在 9 组中领先 6 组,在排序、身份与时间 3 组紧随其后。单声道模型在方向组接近或低于随机基线,说明只给 W 通道时方向确实不可解,这也反衬空间通道的必要性。
外部 ASA-Bench 能否复现优势
下表是 ASA-Bench 空间物理类别全部四项,每项 55 题共 220 题,均为四选一。本地分数用精确解析加嵌入回退,BAT-SFT 与 TWNM-SAPO 两行引用基准作者报告的分数,两种计分方式并不完全相同,比较时要留出该差异。
| Model | Azimuth | Elevation | Distance | Acoustics | |
|---|---|---|---|---|---|
| Random | 25.0 | 25.0 | 25.0 | 25.0 | |
| Mono | Phi-4-mm [1] | 47.3 | 58.2 | 61.8 | 67.3 |
| Mono | Audio Flamingo Next [12] | 40.0 | 52.7 | 61.8 | 74.5 |
| Mono | MOSS-Audio [44] | 43.6 | 41.8 | 40.0 | 58.2 |
| Mono | Qwen2.5-Omni [41] | 25.5 | 43.6 | 45.5 | 54.5 |
| Spatial | BAT-SFT† [46] | 27.3 | 47.3 | 25.5 | 7.3 |
| Spatial | Sci-Phi [18] + Qwen3.5-4B [43] | 23.6 | 43.6 | 14.5 | 80.0 |
| Spatial | Spatial-Omni [47] | 27.3 | 40.0 | 52.7 | 41.8 |
| Spatial | TWNM-SAPO† [45] | 54.5 | 47.3 | 70.9 | 69.1 |
| Spatial | SciPhi-Chat (ours) | 74.5 | 60.0 | 47.3 | 85.5 |
表中 SciPhi-Chat 方位角 74.5%、仰角 60.0%、环境声学 85.5%,均为本地评测模型中最高,距离 47.3% 则低于 Spatial-Omni 的 52.7% 和 TWNM-SAPO 报告的 70.9%。环境声学一项高于 TWNM-SAPO 报告的 69.1%。它超过 BAT 与 Sci-Phi 组合的全部四项,但在距离上不占优,说明方位与仰角的增益不能直接推广到距离估计。原文还提醒该基准选项 B 占比达 49.2%,单声道模型在空间属性上高于 chance 暗示题目可能存在答案泄露,因此外部高分仍要在该题库分布下理解。
去掉推理监督会发生什么
消融用相同训练流程分别训练去掉 <think> 但保留场景描述与答案的模型,以及同时去掉 <think> 和 <json> 的纯答案模型,评测时按各自训练格式作答。比较的关键是 MASU 与 ASA-Bench 的变化幅度不同。
去掉推理后,ASA-Bench 从 57.3% 降到 39.9%,下降 17.4 个百分点,而同期 MASU 从 44.95% 变到 43.07%,只变化 1.88 个百分点。同时去掉推理与描述后,ASA-Bench 从 56.0% 降到 35.9%,下降 20.1 个百分点,而 MASU 从 47.07% 变到 46.69%,只变化 0.38 个百分点。注意这两组用的是早期 MASU 版本与匹配的完整格式检查点,绝对值与主表的 44.9% 不直接对应。
论文的解释是假设性的:MASU 与训练共享分类体系,推理监督在同分布下增益小,而在独立定义的 ASA 提问方式下帮助迁移。该假设尚未被直接证明,只能说证据支持推理有助于跨题库泛化,仍待验证。误读是把 MASU 上的小变化当成推理无用,实际上结论依赖评测是否与训练同分布。
工具在何时帮忙、何时拖累
工具分析先在早期模型上用 19 个候选工具按任务类别算 Shapley 值。下图横轴是相对仅模型回答的增益,正为工具更好,负为仅模型更好,线条为 95% 自助区间,实心点表示区间不含零。
只在适用至少 1/2 条目的工具中选每类最优者,这是理解该图的前提,否则会误把偶发增益当通用结论。
看图路径: 1. 先区分横轴左侧代表仅模型更好、右侧代表工具更好;2. 再看哪些类别的置信区间不包含零;3. 对照 ASA 与 STARSS23 两行,理解工具增益与录音条件的关系
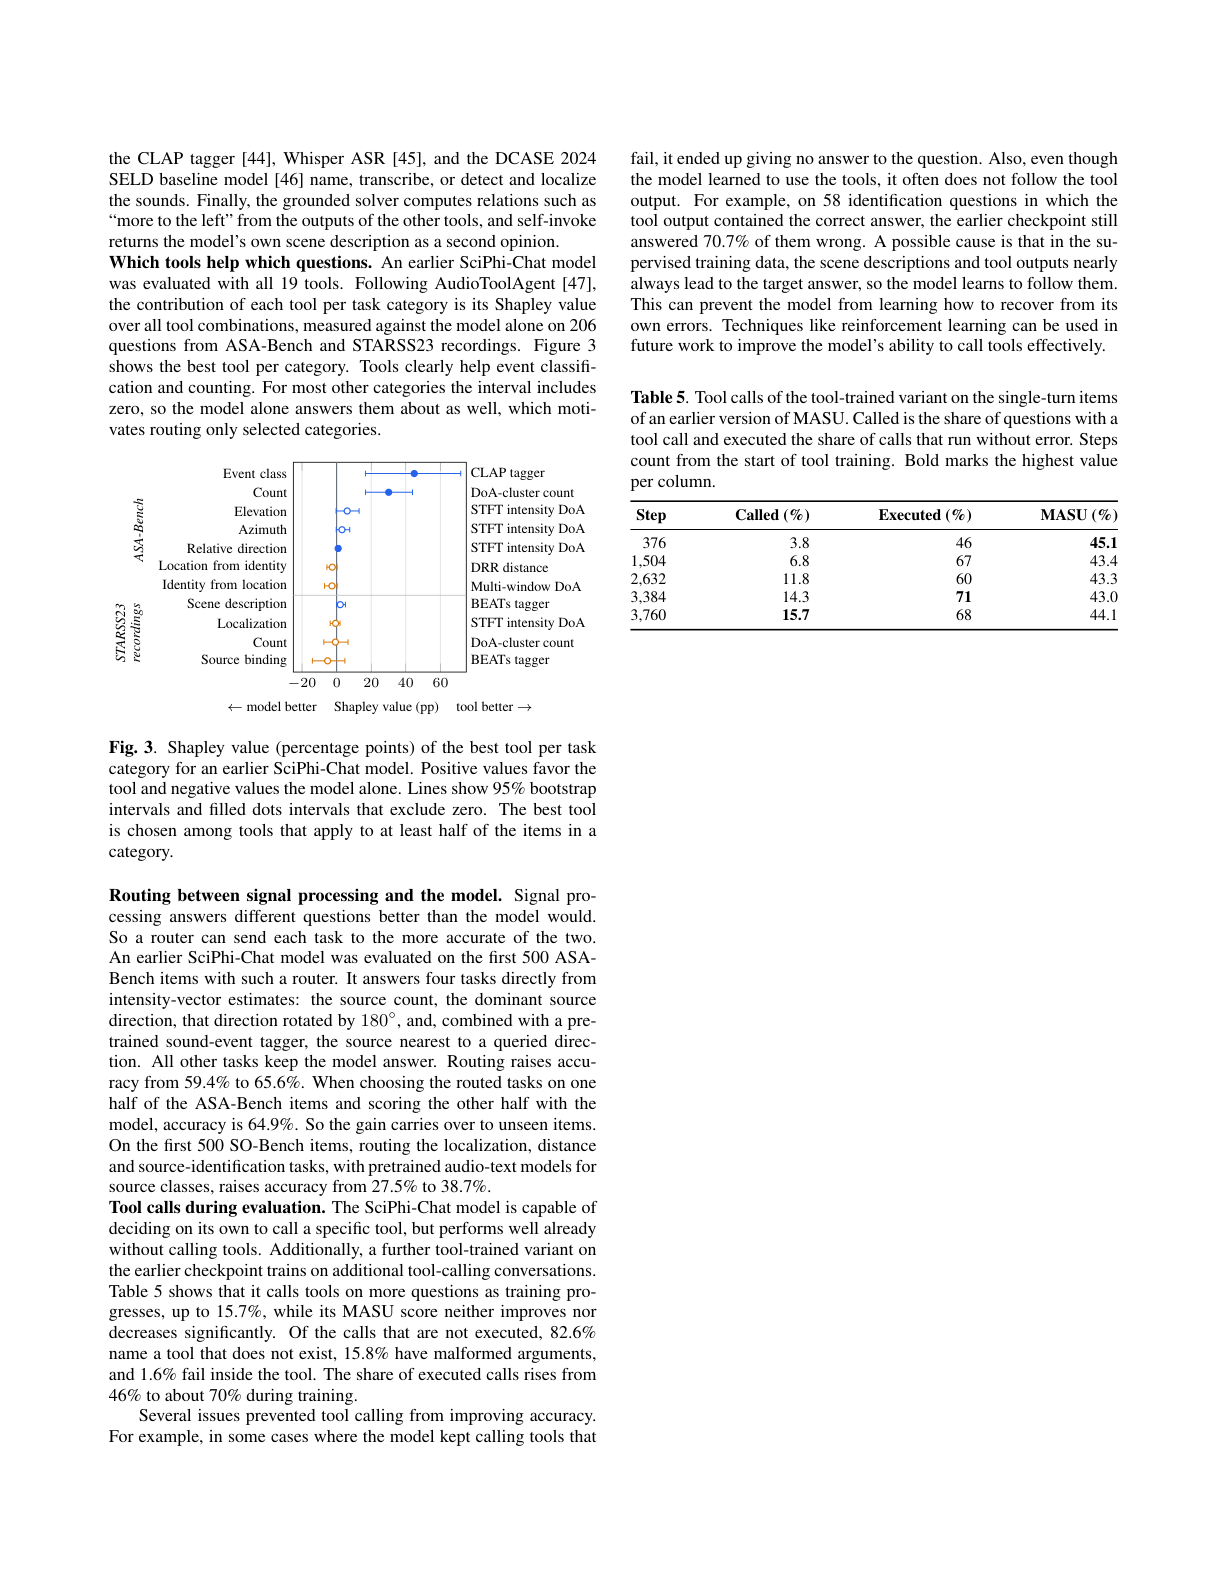
图片来源: 原论文 PDF 第 7 页(含图 3)
论文图 3。原论文 Figure 3::“Shapley value (percentage points) of the best tool per task category for an earlier SciPhi-Chat model.”。
该图确实显示事件类别与计数两类偏向右侧,CLAP 标注器与聚类计数等工具增益明显且区间排除零,多数其他类别的区间包含零,意味着与仅模型回答大致相当。这支持只在部分类别路由给信号处理,而不是每题强制调工具。
强制调工具的代价在正文有量化。早期版本上每题强制调工具平均降低 5.1 个百分点,但在特定类别有正例:时频定位工具把计数从 46.0% 提到 65.1%,活动检测把首声方向从 56.7% 提到 73.2%,模型自主调用第一种定位工具时从 56.7% 提到 67.0%。用强度向量估计计数、主导方向、旋转 180 度后方向等四项直接回答、其余保留模型答案的路由器,在 ASA 前 500 题上从 59.4% 提到 65.6%,换一半选题再测另一半为 64.9%,在 SO-Bench 前 500 题上从 27.5% 提到 38.7%。这些是事后选任务的路由结果,不能当成部署时自动选工具就能拿到的提升。
下表是工具训练变体在早期 MASU 单轮上的调用率与分数,比较工具训练起点与训练后期,调用增多但分数未显著提升。表头 Step 为工具训练步数,Called 为有工具调用的问题占比,Executed 为可执行占比,MASU 为同期分数,单位均为 %。
| Step | Called (%) | Executed (%) | MASU (%) |
|---|---|---|---|
| 376 | 3.8 | 46 | 45.1 |
| 3,760 | 15.7 | 68 | 44.1 |
该表比较工具训练变体在不同训练步数下的调用率、可执行占比与 MASU 分数,调用占比从 3.8% 升到 15.7%,可执行占比从 46% 升到约 68%,但 MASU 分数在 45.1% 到 44.1% 间波动,未见显著提升,主要受调用失败与未有效利用工具输出限制。未执行调用中 82.6% 是调用了不存在的工具,15.8% 参数格式错误,1.6% 工具内部失败。另有 58 道识别题中工具输出已含正确答案但模型仍有 70.7% 答错。论文推测监督数据里描述与工具输出几乎总是指向目标答案,模型没学会从自身错误中恢复,未来需强化学习改进工具选择与整合。该段讨论的是早期检查点,不能直接套用到最终 SciPhi-Chat 的工具行为。
方向信息真的来自方向通道吗
下表用 48 道单声源方向题检验,每轴 16 题,比较完整录音与音频对照。对照固定 W 通道,只动方向通道:打乱 X、Y、Z,仅留 W,用反方向的通道,以及静音。表头 Left/right 为左右轴准确率,All 为三轴总准确率,单位均为 %。
| Audio | Left/right | All |
|---|---|---|
| Full FOA | 93.8 | 79.2 |
| WW only | 50.0 | 18.8 |
表中完整 FOA 总准确率为 79.2%,左右轴为 93.8%,仅 W 时总准确率为 18.8%,左右轴为 50.0%。原文还报告打乱后总准确率 39.6%,反方向为 12.5%,静音为 16.7%,前后轴完整时 87.5%,上下轴完整时 56.3%,说明上下本身更难。打乱与反向后大幅下降而仅 W 接近猜测,支持答案确实依赖方向通道,而非只从 W 的内容或语言先验猜出。该结论只在 48 题单声源、早期模型的条件下成立,不能推广到多声源重叠与混响更重的场景。
哪些结论还不能推广
排序组是明确的反例,SciPhi-Chat 单轮 28.0% 低于组合与 Spatial-Omni,距离项也弱于外部最优,说明方向优势不等于所有空间关系都强。对话轨迹虽然总分领先,但在排序、身份与时间 3 组只是紧随,追问的误差会随历史累积,因为对话评测用的是模型自己的前轮答案作为上下文。
工具部分尚未解决选择问题。强制调用总体降分,自主调用率上升也不带来 MASU 提升,且存在调用不存在工具、不跟工具输出、调用失败后无答案等问题。附录的路由增益是按类别事后指定的,自动路由仍待研究。
评测本身也有局限。MASU 真实录音只占 16.7% 且 12 类只有仿真音频,仿真到真实的迁移只在这部分得到检验。ASA-Bench 选项分布偏斜且单声道模型高于 chance,STARSS23-QA 全答否则在是否题上可达 83.4%,都提示题库偏差可能抬高或扭曲分数。先描述再提问的增益 43.1% 到 49.2% 来自 2000 道仿真多选题的早期模型,不能当成最终模型的通用提升。
复现第一步做什么
复现先对齐输入与评测条件。音频要用 AmbiX 4 通道,通道顺序与归一化与原文一致,单声道对照只取 W 通道,BAT 对照需双耳渲染并截到 10 秒。对话评测要把模型自己的结构化描述和前轮答案保留在历史里,而不是用标准答案做历史,否则对话分会被高估。计分要按题型分开:多选与分类做匹配,数值按容差,开放回答用同一量表与同一裁判模型,描述按声源方向对的 F1。
训练复现需要仿真管线与对话生成管线。仿真要能采样房间尺寸、吸收、位置并混合至多 10 源,对话生成要保证 42 类每类不低于 0.5% 并做正则校验。2 阶段缺一不可:先做音频与 JSON 的预训练,再做对话微调,且只更新投影器与低秩适配器。关键超参数是稳定段学习率 1e-5、批量 40 到 256 的切换点、衰减起点与检查点位置,错开检查点会改变绝对分数。
关于获取,原文写所有材料将经指定链接发布,但本次核验的两个同址链接当前不可用,只能说来源未确认,不能当成作者已开源或可运行。代码、权重与可运行系统是三件事,需分别确认。
什么时候值得尝试
当任务同时需要听清是什么和在哪里,并且有追问指代时,这套先推理后结构化描述的格式值得借鉴。它把可复用的场景清单留在上下文里,后续问题可以直接引用,比每轮重新听一遍更稳。方位与仰角要求高的场景更可能受益,而距离估计与排序类问题要额外验证,因为本文在这两处并未全面领先。
需要补的验证有三项。一是在更多真实房间与更长多音频对话上测追问的累积误差,二是在独立题库上重复推理消融以确认迁移增益是否稳定,三是把工具路由从人工指定类别改为模型自主选择后再看总体分是否还能为正。只有这三项补齐,才能判断该智能体在真实部署中是否可靠。
📎 论文与评分元数据
排名:前50% | 文档类型:模型报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses