📄 让冻结的音频语言模型自己找证据:ReListen 在小时级录音中的做法
英文题目:ReListen: Training-Free Evidence Localization in Hour-Long Audio with Frozen Audio Language Models
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Ming-Hao Hsu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shujie Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxuan Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingda Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinyu Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhizheng Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
冻结的音频语言模型要直接从整小时录音中作答往往装不下上下文,而先转写整段录音又会丢掉音色、语气、背景声和时间信息,且作答依据常只有几秒。ReListen把录音切成20秒短窗,让同一个冻结的回答模型以首个回答位置上肯定回答相对否定回答的对数几率打分,不生成文本。问答时选出得分最高的1分钟按时间排序并标注起止时间后再听一遍作答;定位则从最高分窗向两侧扩展到连续正分窗,直接输出时间区间。在VoiceGiraffe的1499个问题上,选中60秒与标注证据重叠的比例达到88.5%,高于文本检索的58.8%;相对同一模型的整段转写,准确率领先9.2个百分点。该结论只适用于证据局部集中的问题,当LongAudioSpan中标注证据范围达到录音一半以上时,60秒作答准确率仅为55.7%,明显低于听完整录音的73.8%,需放宽到180至600秒才接近。在LAT-Bench上扩展区间的平均交并比与训练过的定位模型相当,但高精度阈值下召回更低,边界不够精确。推理开销随录音时长线性增长、单卡峰值显存保持在68GiB以下,在两基准上比转写后再答的流程快七到八倍。
🔗 开源与复现资源
- 第三方资源:https://huggingface.co/datasets/distil-whisper/rev16 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
小时级音频问答难在哪里
这篇论文处理的是很长的录音,比如 1 小时左右的会议、讲座、播客和广播。输入是一整段波形加一个自然语言问题,目标是给出正确选项或定位出问题描述的那段时间。困难在于 1 小时录音放不进音频语言模型的上下文,而且答案往往只依赖其中几秒钟。
如果先把录音转写成文字,文本长度可以放进模型,但转写会丢掉非语音的声音、说话人的嗓音特点和时间信息。很多问题恰恰问的是背景声、情绪、音色或事件发生时刻,读文字就回答不了。另一条路是训练模型学会回到音频中取片段,但这需要为每个新模型重复训练。
因此论文希望不训练、不转写全文,让同一个冻结模型自己决定听哪里。理解这个任务时要抓住输入是长波形加问题,输出是答案或时间区间,必须保留声音细节,评价要看是否找对证据以及回答是否正确。
已有三条路线各解决了什么
第一条路线是压缩长音频,例如剪掉音频词元、建音频或文本索引再检索,或者把短窗口先描述成文字。它们能让小时级输入变得可处理,问说话内容时有效,但决定模型能看到什么的是另一个前端,回答模型本身没有选择权。
第二条路线是把是非回答的概率当作相关性分数,这在文本排序和图文打分中常见。视频问答中也有用同样问句对帧打分的做法,但那里的定位器是另行训练的小模块。论文的不同在于打分器就是冻结的回答模型本身,处理的是长达 1 小时、目标只占不到十分之一的录音。
第三条路线是让模型重新听音频,例如先做全局时间线再用音频片段细化,或在推理中生成时间戳去取音频。这些都需要微调或强化学习,且时间戳是模型生成的。ReListen 不训练,不生成时间戳,输出时间直接来自被选中窗口的位置。
论文把问题分成哪两种
论文区分普通问题和发生次数问题。普通问题关心录音的自然内容,例如某段讲解说了什么、背景里有什么声音、说话人情绪如何。评价时看选项准确率,以及选出的音频是否与标注的证据区间重叠。
发生次数问题则问某类事件的第 k 次出现,例如插入的鸟叫声第几次在哪里,随后还追问该位置说了什么以及与后文的关系。这类问题要求找全所有出现并数对次序,只按相关性选一段是不够的,因为每次出现都同样符合描述。
这种区分决定了方法分支。普通问题走无训练的相关性选择,发生次数问题走有监督的扩展路径。读者读到后文的检测器和次序概率时,要记得它们只为解决数次序这个额外困难。
ReListen 的整体流程是什么
ReListen 只有一个冻结的读者模型,先搜索再回答。搜索阶段把长录音切成很多短窗口,对每个窗口问一个是非问题并读出概率作为分数。回答阶段按分数取最高的约 1 分钟音频,再听这 1 分钟回答原问题。
下面这张图用一个 84 分钟录音的真实运行展示了这个想法,先看分数如何起伏,再看选中的 3 段与证据的关系,最后看回答对错,这样能建立先找后答的直观印象。
看图路径: 1. 先看上方长波形与下方分数曲线的对应关系;2. 再看三个被选中的橙色片段与标注证据的重叠;3. 最后比较从选中片段作答与从均匀片段作答的对错
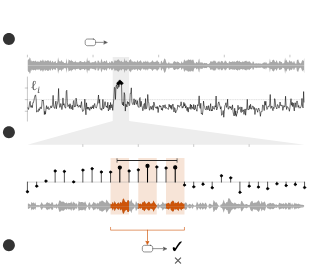
论文图 1。原论文 Figure 1::“ReListen on a test question about an 84-minute recording.”。
图中上方是整段录音的波形和每个窗口的分数曲线,下方放大显示选中的 3 个片段正好落在标注证据上,从它们出发模型答对,而从均匀取的 3 段出发模型答错。这说明搜索决定了回答能看到什么。
整体结构还包括两条选择路径,下一张图把它们放在一张架构里,先看主路径,再看分支在哪里分开、在哪里汇合。
看图路径: 1. 先沿左侧窗口到中间分数再到右侧回答的主路径看;2. 再区分上方普通问题分支与下方发生次数分支的输入输出
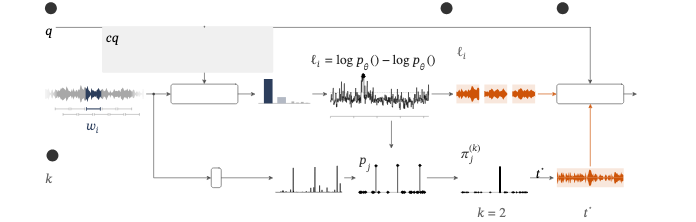
论文图 2。原论文 Figure 2::“Architecture of ReListen. One frozen reader scores every window in a Jev-style scan (1).”。
图中左侧是窗口和问题组成的提示,中间是分数序列,右侧是回答。普通问题分支直接按分数选窗口,有监督的发生扩展分支则加入检测器和校准后的次序概率,最后都回到同一个读者模型来听选出的音频并作答。
每个窗口的分数具体怎么算
扫描把录音切成 20 秒窗口,相邻窗口间隔 10 秒,因此每小时录音约有数百个窗口。每个窗口配上同一个提示,普通问题问这段摘录是否有助于回答问题,事件问题问这段是否包含目标事件。提示中会带上问题和选项,中文用直接翻译的版本。
关键是不让模型生成是或否的文字,而是看下一个词位置上是与否的概率。分数是两者的对数概率之差,是为正表示模型更倾向于是。所有窗口共享提示和长度,可以组成批量一次处理,每个窗口 1 次前向计算,扫描时间随录音变长线性增长,内存保持恒定,窗口之间还能分到多个显卡并行。
\[\ell_{i}=\log p_{\theta}(\text{yes}\mid w_{i},c)-\log p_{\theta}(\text{no}\mid w_{i},c),\]公式中 w 表示第 i 个音频窗口,c 表示由问题构造的是非提示,p 表示冻结模型给出的下一个词概率,l 为该窗口的分数。分数越高表示越值得听,后续选择只按这个排序,不再训练任何参数。
冻结的读者模型 × Jev 式扫描: 冻结的读者模型指参数不更新、只做推理的问答模型,负责理解问题和听音频;Jev 式扫描指把每个窗口的是非判断读成概率分数的搜索方式,不生成文字。两者搭配的意义是把大范围搜索拆成模型本来就会做的小判断,搜索和回答共用同一个模型,不引入转写器或检索器。
普通问题如何从分数变成一分钟答案
对普通问题,方法按分数从高到低取窗口,但跳过与已选窗口重叠的窗口,直到取满 3 个窗口即 60 秒。相邻被选窗口会合并,并按在原录音中的起止时间标注后交给读者模型,因为很多选项本身就是时刻,时间标签对定位类问题很重要。
读者模型随后按时间顺序一次听完这些片段并回答原问题。整个问答只用 1 分钟音频加一次回答,没有转写全文。对于定位查询,则不固定 1 分钟,而是从最高分窗口向两侧扩展,把连续为正分的窗口连成一个区间作为预测,其长度由分数决定。
这种做法的代价是预算固定为 1 分钟,证据分散在全录音或需要计数时可能不够。论文后文用更大预算和标注证据做了对照,说明在什么情况下加音频有帮助、在什么情况下没有帮助。
相关性选择 × 时间区间扩展: 相关性选择指按扫描分数取最相关的若干窗口来回答普通问题;时间区间扩展指从最高分窗口向两侧连通的正分窗口生长出一段连续区间来回答定位查询。前者解决问什么内容,后者解决发生在何时,两者共用同一套分数,只是输出形式不同。
第几次事件为什么需要另一条路径
普通选择按相关性排序,但第 k 次出现要求找全前面所有出现并排除误报,漏掉一个或多出一个都会错位一次。而且变速和音量变化这类编辑不是音频里有什么声音,而是播放方式的变化,读者模型的分数在这两类上几乎没有区分力。
因此扩展路径先用两个小的卷积声学检测器提出候选,再加上扫描分数最高的窗口。一个逻辑回归在标注的开发集录音上把读者分数和检测器特征融合成每个候选为真的概率 p。然后把候选按时间排序,计算每个候选恰好是第 k 个真事件的概率。
\[\pi_{j}^{(k)}=p_{j}\cdot\Pr\Big[\textstyle\sum_{i声学检测器 × 出现次序估计: 声学检测器指针对变速、音量、静音和噪声等小模型,补充读者模型听不出的变化;出现次序估计指把每个候选为真的概率结合成第 k 次出现的概率。两者搭配是因为相关性分数分不清多次相同的事件,需要先提出候选再用概率算次序,才能回答第几次在哪里。
哪些部分不训练,哪些部分训练了什么
普通问题路径完全不训练。扫描和回答都用冻结的 Qwen3-Omni-30B-A3B-Instruct,贪心解码,权重不变。所谓搜索只是多次调用同一个模型读概率,不是更新参数,也不是确定性求解,输出仍受模型本身能力限制。
训练只出现在发生次数扩展里。两个声学检测器分别处理变速音量和插入声音与掩盖,参数量都不到一百万,用与评测无关的会议、朗读、播客和演讲加上公开的编辑算子合成训练数据,包含增益、变速、插入声、静音和噪声掩盖等,并做了背景多样化和难负例处理。校准用的逻辑回归在开发集录音上用交叉拟合得到,附录还显示少量标注录音就能拟合。
因此主结论的无训练只针对普通问答和定位,发生次数链的分数不能说成无训练。复现时要分开看这两部分,不要把检测器的训练开销算到主方法上,也不要把主方法的免训练推广到所有问题类型。
无训练 × 有监督的发生扩展: 无训练指普通问题路径不更新任何参数,直接用冻结模型的概率打分和回答;有监督的发生扩展指只在判断第几次事件时训练小的检测器和校准模型。区分的意义是主方法的通用性不依赖训练,而处理变速音量等难例时才付出小规模训练代价。
在什么数据和条件下比较
评测用 3 套长录音基准。LongAudioSpan 有 360 段 10 到 164 分钟录音,分成开发和测试各一半,准确率模式问自然内容,链模式在编辑过的副本上问第几次事件及后继内容。VoiceGiraffe 有 123 段 35 到 79 分钟录音,本文用 1499 道选择题,其中声音类 549 道,内容类 950 道。LAT-Bench 有 247 段最长 30 分钟录音共 1002 条定位查询,报告平均时间交并比和不同阈值下的召回。
读者模型固定为同一个,比较的只是它收到什么输入。选择基线给同样 60 秒但用均匀取样、学习式检索器或文本检索选段,输入基线给无音频、完整录音或全文转写,参考项给标注证据。命中率指选出的 60 秒与标注证据有任何重叠的比例,准确率是选择题答对比例,时间选项指至少 3 个选项是时刻的题目。
配置在 LongAudioSpan 开发集上选定后冻结,再到测试集和另两套基准上不变地评测。计时按每录音一问,从解码音频到给出答案,包含转写全文的时间,区间用按录音自助得到的 95% 置信区间。
扫描找证据的效果如何
要回答的比较问题是,在同样 60 秒预算下,模型自己打分选段是否比文本检索更能命中标注证据,指标是命中率,越高越好。下面这张定位表直接比较了均匀取样、学习式检索、词匹配和稠密检索与本文扫描。
| Method | mIoU | R@0.3 | R@0.5 | R@0.7 |
|---|---|---|---|---|
| Gemini-2.5-Pro† | 42.8 | 63.3 | 51.3 | 26.9 |
| LAT-Audio | 46.3 | 62.0 | 48.4 | 32.5 |
表中训练过的定位模型与本文扫描的平均交并比接近,但本文在较宽松阈值下的召回更高,在严格阈值下的召回更低。这说明扫描能找到大致区域,但边界不如训练过的专用模型精确。均匀取样和文本检索的分数明显更低,文本检索在声音问题上掉得更多,因为声音没有可匹配的词。
另一组分数沿录音展开的曲线进一步显示,选中的峰值落在标注带附近,而其余位置多为低分噪声,说明分数不是均匀随机,而是在证据处形成可辨的峰。
看图路径: 1. 先看横轴长时间上的分数起伏与基线噪声;2. 再看三个圆圈峰值与灰色标注带的位置关系
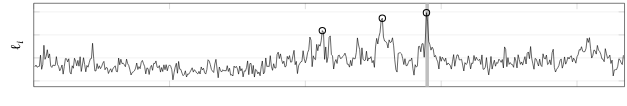
论文图 6。原论文 Figure 6::“Scan scores along a recording. The scan of an 87-minute development recording for the question “According to the lecture, what is the direct mechanical cause of the lens…”。
图中横轴是 87 分钟录音的时间,纵轴是扫描分数,3 个圆圈是被选的窗口,灰带是标注的证据范围。可见峰值与灰带对齐,周围分数较低,这种对齐是后文回答提升的前提,但峰的宽度和边界误差也解释了定位边界不够精确的原因。
听音频作答 × 读转写文本作答: 听音频作答指把选出的波形直接送入读者模型的音频编码器;读转写文本作答指先把同一段音频转成文字再读文字。两者对比能分离选得准和听得好的贡献,在内容问题上两者接近,在声音和嗓音问题上听音频保留了文字丢掉的信息。
用选出的一分钟回答能好到什么程度
要回答的比较问题是,同样只听 60 秒时,扫描选段是否比均匀选段和全文输入更准确,指标是选择题准确率,越高越好。下面这张按题型和语言拆分的表比较了转写文本、全文音频与本文方法。
| Method | All | Semantic | Temp. Loc. |
|---|---|---|---|
| Transcript by the reader | 52.8 | 85.5 | 38.4 |
| ReListen, 60 s | 62.0 | 87.5 | 78.0 |
表中在全部问题上本文扫描选段明显高于均匀选段和无音频,在时间定位和语义内容题上优势集中,而在因果和事件跟踪题上优势较小。全文音频和全文转写在某些内容题上仍有竞争力,说明 1 分钟不是在所有题型上都占优。
论文正文还报告,在同样 60 秒预算下,本文在 LongAudioSpan 和 VoiceGiraffe 上分别超过均匀音频 8.5 和 21.3 个百分点,在 VoiceGiraffe 上超过完整录音 10.6 个百分点并超过全文转写 9.2 个百分点,在 LongAudioSpan 上与听完整录音基本持平。这些数字的条件是同一冻结读者、同一预算和冻结配置,不能理解成任意模型或任意预算下都成立。
未胜出的情况也要看到,在 LongAudioSpan 上以说话内容为主且无时间选项的题目中,全文转写更好;在需要计数的普通问题上,1 分钟选择甚至低于无音频,因为计数需要找全所有出现,而相关性选择不保证覆盖。
听选出的音频和读它的文字有何不同
要回答的比较问题是,固定为同一段摘录时,直接听波形与读其转写文字哪个更准,由此判断选出的证据是否值得听。比较条件是同一读者、同一选段,转写来自读者自己对该选段的转写,指标仍是准确率。
论文报告,在内容问题上听与读只差约两个百分点以内,无论用扫描选段还是标注证据。这说明全文转写在内容题上的领先主要来自覆盖了全录音,而不是文字本身更好。
在 VoiceGiraffe 声音问题上,听比读高 8.6 个百分点,用标注证据时差距扩大到 19.5 个百分点,其中音频事件和副语言题上差距明显。这支持了论文的动机,即转写丢掉了声音和嗓音,而这些正是声音问题所问的。附带文字描述嗓音和背景声的备注能追回一部分,但仍不及直接听标注证据。
效率方面,扫描加 1 分钟回答在约 1 小时录音上比全文转写管线快 7 到 8 倍,内存恒定在 68 吉字节以下,4 卡并行约快 3 倍。完整录音在 30 分钟以下更快,但随长度增长更快且超过约 62 分钟需要 2 卡。这些比较假设每录音只问一题,若多题复用同一份转写,结论会不同。
第几次事件的链式问题表现如何
要回答的比较问题是,在需要数次序的链上,本文扩展是否优于直接听、读转写或逐个验证候选,指标是每问准确率和链得分,链得分要求从第一问起连续答对。
| Locating without the Q1 options | |||
|---|---|---|---|
| Uniform 60 s | 22.8 | 28.9 | 10.0 |
| ReListen | 78.3 | 75.6 | 60.7 |
表中无音频、均匀 60 秒和转写文本的链得分都在 10 分左右,接近随机猜测,完整录音加时间标记也只有 17.2 分,而本文扩展在测试集达到 60.7 分,明显高于逐个验证候选的 37.4 分。按编辑类型看,插入声、噪声和静音主要靠读者分数就能找到,变速和音量则依赖检测器。
限制同样清楚,34 条答错时间的链中多数是把不同真出现搞错次序或误报,而第三问即使给正确时间也只有 56.1%,说明除定位外,对长上下文的推理仍是瓶颈。自然咳嗽声的小实验显示扫描能远高于随机找到目标,但校准和次序概率在小样本上没有可测增益,因此该扩展对人工植入事件最有效,对自然事件仍待验证。
哪些改动会让效果下降或不变
要回答的比较问题是,定位规则和读者规模是否关键,指标是平均交并比和各阈值召回。下面这张消融表比较了只取最高窗口与扩展正分区间的差别,以及换用更小读者模型的影响。
| Variant | mIoU | R@0.3 | R@0.5 | R@0.7 |
|---|---|---|---|---|
| Best window only | 41.8 | 67.3 | 35.7 | 13.8 |
| ReListen | 47.7 | 77.2 | 50.0 | 19.2 |
表中只取最佳窗口比扩展区间低约 5.9 个点,说明向两侧生长能补回边界。换用较小读者后仍能保持相近分数,说明扫描不完全依赖最大规模的读者,但这只验证了 2 个模型,不能推广到所有模型家族。
发生次数路径的消融显示,去掉检测器时间准确率掉约 31 个点,去掉读者扫描掉约 14 个点,去掉校准标签掉约 21 个点,把次序概率换成硬阈值计数在时间上接近但在第一问上低 4 到 6 个点。把步长放到 20 秒或只扫检索器选出的少量窗口,能省一半计算但会损失数个点。
下面这张图解释了为什么需要检测器,先看两排信号的含义,再比较两类事件下的响应。
看图路径: 1. 先比较上下两排分别表示的读者分数与检测器概率;2. 再看插入声音与音量变化两类事件下两排响应的差别
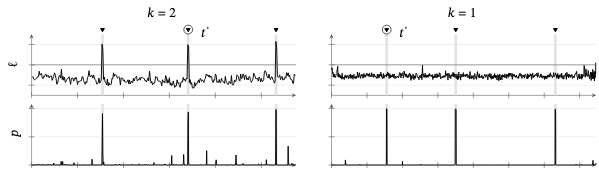
论文图 7。原论文 Figure 7::“Reader and detector evidence on planted events.”。
图中上排是读者分数,下排是检测器概率,左为插入声音的第 2 次,右为音量变化的第 1 次。可见读者分数在插入声处有尖峰而在音量变化处平坦,检测器在两类处都有响应。这种分工直接对应消融中检测器对变速音量必不可少、而对插入声两者可互补的结论。
结论在什么边界内成立
证据只来自一个主要读者模型和 3 套以英语和普通话 speech 为主的基准,向音乐、声景或其他语言和模型家族的迁移没有验证。普通问题的预算固定为 1 分钟,没有按问题自适应选择预算,证据分散超过半个录音时 1 分钟不够,需要 10 分钟才能接近完整录音。
成本比较假设每录音只问一题,此时扫描每次重跑而转写可被多题复用,多题场景下全文转写的平均成本会被摊薄。标注证据的上界比本文高十多个点,其中约一半来自未命中,另一半来自命中后仍用不好证据,加音频并不能闭合后一半差距。
容易误解的是把搜索选出的最优值或已知答案时的上界当成可部署的提升。标注证据和 10 分钟扫描都是事后分析工具,不能当作实际只能听 1 分钟时的增益。无训练也不等于输出确定,冻结参数只表示不更新,不保证同一输入每次生成完全一致。
复现第一步要做什么
先准备冻结的读者模型与长录音,按 20 秒窗、10 秒步长切分,构造带问题和选项的是非提示,对每个窗口取是与否的对数概率差作为分数。同一录音内批量打分,按不重叠规则取前三窗,合并相邻窗并标注起止时间,再让同一模型听这 1 分钟回答。
关键超参数是窗口 20 秒、步长 10 秒、预算 3 窗,以及定位时扩展连续正分区间的规则。发生次数扩展需要另行训练小检测器并在开发集上拟合校准,不能跳过。作者资源方面,本次收到的证据中只有第三方数据集链接可用,论文代码与模型权重是否公开没有归属明确的可用证据,因此不要写成已开源。
复现时注意转写与音频的输入条件、时间标签格式和批量大小对分数的微小影响,以及长于约 62 分钟的完整录音基线需要 2 卡。先在小规模开发集上核对命中率,再看准确率,避免直接用测试集调参。
什么时候值得尝试还缺什么验证
当录音长到放不进模型、问题只依赖局部几秒且涉及声音或嗓音时,值得尝试先扫描再听 1 分钟的办法。它省去全文转写,速度更快且内存恒定,在声音问题上比读文字更准。问的是全录音摘要或需要计数和大范围综合时,则应加大预算或改用覆盖更全的输入。
还需要补的验证包括换模型家族后的扫描稳定性、音乐与其他语言上的命中率、多题复用转写时的真实成本比较,以及按问题自适应预算的方法。发生次数路径还需在自然事件和更多噪声条件下验证检测器与校准的泛化。
总体看,论文显示冻结模型能自己找到证据并从中作答,但剩余到标注证据的差距指向更精确的选择和更好地利用已听证据,这正是下一步最值得做的工作。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses