📄 换一个编解码器重编一次,水印还在吗:跨编解码器鲁棒的语音水印解读
评分:7.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Olli-Pekka Pauna:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Lauri Juvela:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要解决的问题是合成语音难以与真人录音区分,嵌入隐藏信息的水印常在经过神经音频编解码器重合成后失效,而已有工作多只针对传统失真或单个编解码器训练,换一种未见过的编解码器就容易被擦除。论文把输入语音送入水印生成器嵌入零比特水印,这里的零比特水印指只判断水印存在与否、不携带多比特信息的二值检测方式,处理难点是水印能量要藏在听感不敏感但编解码后仍保留的成分里,同时抵抗压缩、滤波、加噪和混响。方法上先用 Descript Audio Codec(一种采用残差向量量化的神经音频编解码器,简称 DAC)微调出生成器,把原始音频经冻结的编码器和量化器再经可训练解码器重建为含水印音频,再让检测器在经过某种编解码器增强后的信号上区分原始与含水印样本,两者协同训练使生成器帮助检测。关键差异是系统比较 EnCodec、DAC、SpeechTokenizer、Mimi、SNAC 单独或联合作为训练时信道增强,并修改官方代码实现冻结模型下的端到端反向传播。与已有局部水印模型 AudioSeal 和 WavMark 相比,本文模型对整段录音施加全局水印,训练增强种类更少但覆盖更新的低码率编解码器。在 LibriTTS-R 测试集 1000 个样本上,以 1% 误报率下的检出率(数值越高越好)为指标,Mimi 与 SNAC 联合增强在 MP3 32kbps 攻击下达到 87.20%,而无增强模型仅为 40.60%,同时主观对比平均意见分接近自然语音。结论适用于单次神经重合成与常见传统编解码失真,对混响、连续多次随机神经串联以及部分语义蒸馏类编解码器仍效果有限。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 代码相关资源:https://github.com/ljuvela/DAREA — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决什么实际风险
生成式语音已经能零样本模仿真人录音,开源预训练模型让声音克隆变得易得。论文面对的风险是合成语音难以分辨,需要主动披露,例如在音频里嵌入人耳不易察觉但算法可读的水印。按原文,水印可以是携带多比特身份信息,也可以是本文采用的零比特水印,只回答是否带水印,用于二元检测。
水印要同时满足两件事:不影响正常使用时的听感,又能在去除攻击后仍被检出。传统数字信号处理攻击包括压缩、滤波、加噪和混响,近年更突出的是神经音频编解码器重编码攻击。这类编解码器端到端学习压缩、量化和重建,重建质量高、模型轻量且常开源,攻击者容易拿来把水印洗掉。论文要回答的是训练时用哪一种神经编解码器做增强,才能泛化到训练时没见过的编解码器和传统攻击。论文的三点贡献是提出以 DAC 为生成器的高质量新系统,证明增强编解码器的选择显著影响泛化,并表明 Mimi 与 SNAC 联合增强在有限音质影响下对未见攻击有前景,同时开源增强实现。
已有水印和神经编解码器各是什么路线
论文把相关工作分成两条线。第一条是基于深度学习的水印,训练时加入信道增强,让生成器在滤波或编解码器重编码后仍能被检测器识别。AudioSeal 和 WavMark 是本文用作基线的已有模型,AudioSeal 对音频每个采样点做局部水印,WavMark 按 1 秒一段处理三十二比特信息,两者都针对特定数字信号处理攻击做过鲁棒训练。原文指出它们能抗多种经典失真,但对未见过的神经编解码器、声码器和降噪仍脆弱。
第二条是神经音频编解码器本身。SoundStream、EnCodec 和 DAC 使用残差向量量化实现向量量化变分自编码器结构,SpeechTokenizer 在第一码本加语义蒸馏,Mimi 同样用语义蒸馏但丢掉重建损失只靠对抗目标,SNAC 让不同量化器工作在不同时间分辨率并在上采样后加入随机噪声块,NanoCodec 则用有限标量量化免去学习码本。Mimi、SNAC 和 NanoCodec 在极低比特率下仍保持高重建质量。近期有 Latent-Mark 试图针对不同编解码器共享的隐空间,本文的假设是,用极高效的低容量编解码器做增强,可能因瓶颈更窄而间接迫使水印进入更共享、更本质的信号成分,从而隐式对准共享隐子空间。
为什么不能把神经编解码器当成一种通用增强
一个容易产生的误解是,只要训练时见过一种神经编解码器,就能泛化到其他编解码器。论文明确反对这种看法。不同编解码器结构和训练细节不同,重建行为不同,对信号的损伤位置也不同。用 EnCodec 或 DAC 增强训练出的模型,可能只学会抵抗这一种量化噪声,而换成 Mimi、SNAC、SpeechTokenizer 或 NanoCodec 就失效。即使对传统数字编解码器有泛化,也已观察到对未见神经编解码器仍脆弱。
因此论文把问题定义为增强配方选择问题:在相同的 DAC 水印基座和相同的 AASIST 检测器下,只改变训练时经过的信道增强编解码器,比较对未见攻击的泛化差异。评估覆盖训练时见过与没见过的神经编解码器、不同比特率、传统有损压缩、加噪、混响、滤波,以及随机多个神经编解码器连续重编码。目标不是证明一种模型处处最优,而是找出泛化更广且音质代价有限的增强选择,并承认仍有失效情形。
整个系统让一个样本经历什么
沿着一个 1 秒训练样本看完整流程。原始音频 x_org 先进入水印生成器,也就是 DAC 的冻结编码器和冻结量化器,得到离散编码,再经过可微调的解码器重建为加水印音频 x_wm。训练时,x_org 和 x_wm 会同时经过同一个信道增强模块,也就是一个参数冻结的神经编解码器,做 1 次压缩重建,模拟攻击,再送入水印检测器打分。测试时,参考音频和加水印音频同样先经过指定的攻击,再送入检测器比较。
系统有两类目标。左侧是重建目标,保证 x_wm 听起来像 x_org,包括多尺度梅尔谱损失、最小二乘生成对抗损失和判别器特征匹配损失,判别器是标准的 DAC 对抗判别器,仍在微调。右侧是水印目标,保证检测器能区分增强后的两类音频。图 1 把这种分工画得很清楚,左边是重建约束,中间是生成器通路,右边是增强加检测的水印约束。生成器与检测器是协作训练关系,生成器要帮助检测器完成判别,而非相互对抗。
水印生成器 × 水印检测器: 水印生成器负责把原始语音变成加了水印的语音,它是本文被微调的 DAC 解码器通路;水印检测器负责判断输入语音是否带水印,它是去掉批归一化和丢弃层的 AASIST 二分类器;两者协作训练,生成器要让检测器在经过编解码器重编码后仍能区分原始与加水印语音。
下面这段先交代读图任务,再把训练结构图放在同一小节内供对照查看。
看图路径: 1. 先沿底部原始音频到顶部水印音频的主通路看编码器量化和解码器的上下顺序;2. 再对比左侧重建目标虚线框与右侧水印目标虚线框各自连接了哪些损失和模型;3. 对照最右侧图例区分损失函数与冻结模块和可优化模块的对应关系
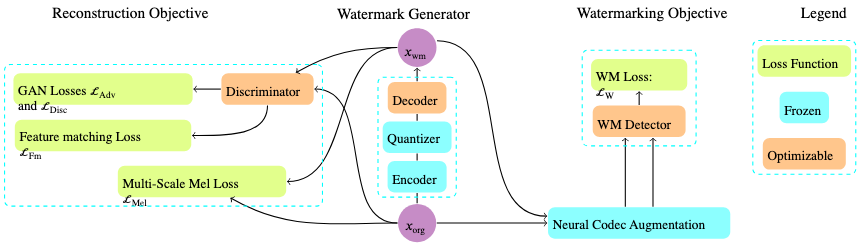
论文图 1。原论文 Figure 1::“Training setup.”。
从图中可见的布局可以确认监督来源的分工:底部是原始音频,上方是水印音频,中间是编码器量化和解码器的主通路,左侧虚线框集中了重建相关的 3 个损失和判别器,右侧虚线框集中了水印损失和水印检测器,底部横条是同时接收两路音频的神经编解码器增强模块,箭头走向说明了听感约束与水印约束分别来自哪里。
生成器、检测器和判别器各自负责什么
水印生成器是 DAC,采样率 24 kHz,步长 320 个采样点,32 个码本每个 1024 表项,比特率 24 kbps。编码器和量化器冻结,解码器可训练。冻结的用意按原文是保持码本向后兼容,如果离散编码已用于下游的音频编解码器语言模型,不必推倒重来。实际效果是生成器只能改变解码器把编码还原成波形的方式,把水印藏在重建细节里。
DAC × 残差向量量化: DAC 指 Descript Audio Codec,是本文水印生成器的基座模型;残差向量量化是 DAC 等编解码器用的多级量化方式,编码器输出先被第一级量化,残差再被后级量化;本文冻结 DAC 的编码器和量化器,只微调解码器,是为了保持码本向后兼容。
水印检测器是 AASIST,原本用于伪造检测,本文关闭批归一化和丢弃层,因为先前研究发现去掉批归一化有助于对抗训练。检测器输出分数,训练目标让它对增强后的原始音频输出接近一,对增强后的加水印音频输出接近零,这与 AASIST 原本把自然样本当正类的习惯有关,但在计算检出率时论文把加水印样本当正类。判别器是 DAC 自带的对抗判别器,负责判断重建是否逼真,与生成器做最小二乘对抗博弈,并提供特征匹配约束,防止为藏水印而引入明显失真。检测前两路音频都要先过冻结的信道增强编解码器,再进入检测器。
训练损失如何把听感和可检出拼在一起
水印检测损失是对增强后两类音频的最小二乘约束。记 C 为信道增强,D 为检测器,x_org 为原始音频,x_wm 为加水印音频,期望是对小批量样本求平均。该损失要求检测器对 C(x_org) 输出接近一,对 C(x_wm) 输出接近零,生成器则要帮助检测器做到这一点,属于协作训练,不是攻防对抗。公式原文如下。
\[\mathcal{L}_{\text{W}}=\mathbb{E}[(1-D(C(x_{\text{org}})))^{2}+D(C(x_{\text{wm}}))^{2}].\]生成器总损失是四项加权求和,分别是多尺度梅尔谱损失、生成对抗损失、特征匹配损失和上面的水印损失,权重按 DAC 官方实现继承为 15、1、2 和 1。判别器另用最小二乘目标微调。公式原文如下。
\[\mathcal{L}_{\text{G}}=\lambda_{\text{Mel}}\mathcal{L}_{\text{Mel}}+\lambda_{\text{Adv}}\mathcal{L}_{\text{Adv}}+\lambda_{\text{Fm}}\mathcal{L}_{\text{Fm}}+\lambda_{\text{W}}\mathcal{L}_{\text{W}}.\]信道增强 × 神经音频编解码器重编码: 信道增强指训练时在检测器之前对原始和加水印语音施加失真,模拟攻击;神经音频编解码器重编码是其中一种增强,即用冻结的 EnCodec、DAC、SpeechTokenizer、Mimi 或 SNAC 先压缩再重建;它迫使生成器把水印藏到重编码后仍保留的信号成分里。
梯度路径需要说清。增强中的量化不可微,EnCodec、SpeechTokenizer 和 Mimi 官方代码只在训练模式实现直通估计,会同时打开码本更新或量化器丢弃,不符合冻结攻击的设定,作者修改了这三者的代码以支持冻结下的端到端反向传播,SNAC 和 DAC 本身已支持。优化器用 AdamW,贝塔一为 0.8,贝塔二为 0.99,每个模型在预训练权重初始化后重置优化器和学习率调度器状态。水印微调 40000 次,批量 8,每样本裁剪或补齐到 1 秒,验证批量 4,长度 5 秒,用开发集 250 个样本按等错误率选最优版本,验证时同样让两路音频过相同的训练用增强。
数据、增强版本与评价条件是什么
基座 DAC 判别器权重官方检查点没有提供,作者先在 LJSpeech、VCTK 和 LibriTTS-R 的 clean-train-100 上按默认配方训练 1000000 次、批量 4,放在单张 A100 上,再用该权重初始化各水印模型。数据集用神经修复版 LibriTTS,采样率本身 24 kHz,与模型一致。水印微调只用 train-clean-100,验证用 dev-clean,测试用 test-clean 的 1000 个样本子集,最长裁到 10 秒。
共训练 7 个相同结构的水印模型:一个无增强,5 个单编解码器增强,一个双编解码器增强。单增强分别是 EnCodec 6 kbps、DAC 8 kbps、SpeechTokenizer 4 kbps、Mimi 1.1 kbps、SNAC 0.98 kbps,双增强是 Mimi 与 SNAC 按小批量随机二选一。EnCodec、DAC、SNAC 和 Mimi 本身 24 kHz,SpeechTokenizer 需经 Torchaudio 重采样到 16 kHz 再重采样回 24 kHz。双版本是看完单版本结果后选的,因为两者泛化有互补,单增强时每批都过同一信道,双增强时每小批量在两者之间随机选择。
零比特水印 × TPR@1%FPR: 零比特水印指只做二元判断,回答音频是否带水印,不传输多比特信息;TPR@1%FPR 指在误报率为百分之一时的真正例率,本文把加水印样本当正类,该值越高表示在严格控制误报下检出越多,是鲁棒性的主指标。
评价时参考音频和加水印音频都经过同一种攻击再进检测器。神经攻击还扩展到 EnCodec 12 kbps 和 NanoCodec 1.89 kbps,后者需重采样到 22.050 kHz 再返回。传统攻击包括不同比特率的 MP3、Ogg Vorbis 和 Opus,以及 Musan 加噪、MIT 房间脉冲混响、低通 4 kHz 和高通 500 Hz,还有从多个神经编解码器随机排列连续重编码 2 次或 3 次。基线 AudioSeal 和 WavMark 需降采样到 16 kHz 评测,听感对比时再把丢失高频与升采样回 24 kHz 的信号组合,WavMark 按 1 秒一段已知位置平均比特概率,AudioSeal 按超过 0.5 的采样点比例打分。
哪种增强泛化更广,数字说明什么
下面的表要回答的核心比较问题是:在相同的 DAC 水印基座下,训练增强用不同编解码器时,对未见神经重编码和传统失真的检出率如何变化。公平条件是 7 个模型结构和数据相同,只换增强,评价统一用 TPR@1%FPR,数值越高越好,基线 AudioSeal 和 WavMark 同条件走相同攻击。
| Augmentations | Augmentations | Augmentations | Augmentations | Augmentations | Augmentations | Augmentations | Baselines | Baselines | |
|---|---|---|---|---|---|---|---|---|---|
| Attacks ↓ | No Codec | EnCodec | DAC | SpeechTokenizer | Mimi | SNAC | Mimi and SNAC | AudioSeal | WavMark |
| No Codec | 100.00 | 21.00 | 89.20 | 95.80 | 92.10 | 89.30 | 96.80 | 100.00 | 100.00 |
| EnCodec 6kbps | 1.40 | 99.70 | 5.70 | 22.40 | 98.10 | 88.90 | 97.90 | 62.70 | 0.52 |
| EnCodec 12kbps | 0.50 | 99.70 | 24.80 | 54.20 | 98.70 | 93.10 | 97.90 | 99.20 | 2.51 |
| DAC 8kbps | 1.40 | 6.80 | 99.80 | 63.60 | 95.60 | 86.70 | 98.00 | 100.00 | 99.37 |
| SpeechTokenizer 4kbps | 1.20 | 2.20 | 2.00 | 98.90 | 28.10 | 57.00 | 62.60 | 2.20 | 2.20 |
| Mimi 1.1kbps | 0.90 | 1.10 | 0.90 | 1.70 | 96.70 | 45.00 | 83.60 | 1.30 | 0.21 |
| SNAC 0.98kbps | 0.50 | 0.90 | 1.10 | 1.70 | 2.30 | 96.80 | 80.00 | 1.00 | 1.05 |
| NanoCodec 1.89kbps | 1.80 | 1.90 | 1.90 | 2.40 | 73.70 | 70.90 | 77.20 | 0.90 | 0.42 |
| MP3 32kbps | 40.60 | 8.60 | 33.50 | 49.20 | 57.10 | 60.20 | 87.20 | 100.00 | 100.00 |
| OGG Vorbis Q2 | 8.80 | 5.30 | 8.10 | 21.50 | 61.70 | 42.70 | 80.00 | 100.00 | 83.04 |
| OGG Opus 32kbps | 59.30 | 8.60 | 50.20 | 55.60 | 69.00 | 73.50 | 92.40 | 100.00 | 100.00 |
| MP3 64kbps | 98.90 | 9.40 | 83.00 | 85.90 | 86.40 | 86.90 | 96.90 | 100.00 | 100.00 |
| OGG Vorbis Q3 | 33.00 | 5.30 | 15.80 | 63.40 | 88.40 | 57.20 | 88.00 | 100.00 | 98.32 |
| OGG Opus 64kbps | 99.00 | 10.50 | 81.30 | 81.80 | 85.10 | 78.20 | 95.50 | 100.00 | 100.00 |
| MIT RIR Reverb | 12.70 | 3.00 | 23.30 | 7.70 | 8.10 | 4.70 | 25.40 | 81.70 | 100.00 |
| Musan Noise | 85.90 | 20.70 | 65.40 | 49.40 | 94.10 | 74.60 | 88.50 | 99.90 | 98.32 |
| Lowpass 4kHz | 98.80 | 3.60 | 56.50 | 91.60 | 40.60 | 34.10 | 69.40 | 100.00 | 100.00 |
| Highpass 500Hz | 100.00 | 27.40 | 88.60 | 97.70 | 91.80 | 87.30 | 97.90 | 100.00 | 100.00 |
| Two Random Neural Codecs | 1.00 | 14.40 | 6.50 | 6.90 | 32.70 | 44.30 | 50.90 | 7.20 | 1.05 |
| Three Random Neural Codecs | 1.50 | 5.00 | 1.50 | 2.20 | 15.90 | 24.40 | 21.90 | 1.80 | 0.11 |
表后解释要抓住三层结论与反例。无增强模型在无攻击时表现好,但遇到多数神经重编码迅速下降,说明水印本身不具备跨编解码器鲁棒性。用单一编解码器增强的模型只在自己见过的攻击上好,对其他神经编解码器泛化差。Mimi 和 SNAC 单独增强泛化明显更好,双增强覆盖最广,对多种传统压缩保持高位,但对混响和连续 2 到 3 次随机重编码仍然偏低,且两者互相泛化差,提示两种增强可能给出矛盾梯度。基线在多数传统失真上很强,但对部分未见神经编解码器失败,与先前研究一致。
Mimi × SNAC: Mimi 和 SNAC 都是本文试验的低比特率高重建质量编解码器,Mimi 在第一码本用语义蒸馏并依赖对抗目标,SNAC 用量化器分多时间分辨率工作且解码器含随机噪声块;本文发现单独用它们增强已比 EnCodec 和 DAC 泛化更好,两者按小批量随机二选一联合增强则覆盖更广。
音质是否付出了明显代价
下面的表要回答的第二个比较问题是:不同增强的水印语音相对自然语音的听感差异有多大。评价用比较平均意见分,以原始 LibriTTS-R 为参考,同时报告整集 PESQ。公平条件是全部 29 条语音做等响度归一化,每位众包听众随机评 5 条,每系统每人取均值再用学生 t 统计和多重比较校正,28 人中 26 人通过注意力检查。
机制分工上,生成器沿用 DAC 并冻结编码器和量化器只微调解码器以保持码本向后兼容,判别器沿用 DAC 对抗判别器,检测器用去批量归一化和丢弃的 AASIST,水印目标与重建目标协同训练;执行过程是原始与水印音频先经过同一冻结神经编解码信道增强再进入检测器计算水印损失,验证与测试时水印与参考音频同样经过指定攻击后再打分,从而把增强选择与泛化效果直接对应起来。
| Generator | Augmentation | CMOS x¯±CI | PESQ |
|---|---|---|---|
| DAC | No Codec | 0.231 ± 0.269 | 4.429 |
| DAC | SNAC | 0.154 ± 0.338 | 4.398 |
| DAC | Pretrained | 0.100 ± 0.245 | 4.423 |
| DAC | EnCodec | 0.077 ± 0.227 | 4.409 |
| DAC | DAC | 0.000 ± 0.354 | 4.420 |
| DAC | SpeechTokenizer | −0.008 ± 0.243 | 4.408 |
| DAC | Mimi | −0.023 ± 0.319 | 4.395 |
| DAC | Mimi + SNAC | −0.092 ± 0.300 | 4.385 |
| AudioSeal | See [25] | −0.138 ± 0.464 | 4.339 |
| WavMark | See [4] | −0.292 ± 0.432 | 4.133 |
所有系统 CMOS 都靠近零,置信区间多覆盖零,PESQ 多在 4.3 以上,说明在该测试条件下水印语音很难与自然样本区分。部分正值表示听众给水印版略高于原版,论文解释为随机波动加生成对抗目标的作用,不能读成水印改善音质。作者也明确不声称优于 AudioSeal 或 WavMark,因为采样率和局部与全局水印假设不同,只能说音质可比且影响有限。双增强 Mimi 加 SNAC 的 CMOS 为负但绝对值仍小,PESQ 仍保持高位,说明为换取跨编解码器鲁棒性所付出的听感代价有限,这与低码率高重建质量迫使水印嵌入信号更本质成分的解释一致。本表数值与单位依据论文 PDF。
单增强与双增强的取舍在哪里
把单增强看作 1 次对照实验最清楚。Mimi 1.1 kbps 增强的模型在 Mimi 攻击下为 96.70,但在 SNAC 攻击下仅 45.00;SNAC 0.98 kbps 增强的模型在 SNAC 攻击下为 96.80,但在 Mimi 攻击下仅 2.30。两者各自对 EnCodec、DAC 和 NanoCodec 的泛化也不对称,例如 Mimi 增强对 NanoCodec 为 73.70,SNAC 增强为 70.90,双增强为 77.20。双增强把 Mimi 攻击保持在 83.60,把 SNAC 攻击保持在 80.00,把传统压缩多项推到 80 以上到 90 多,但没有在任一单项上都超过单增强的最优值。
传统失真侧同样有代价。双增强在 MP3 32 kbps 为 87.20,在 Opus 32 kbps 为 92.40,明显好于多数单增强,但在混响下仅 25.40,在低通 4 kHz 下仅 69.40,仍低于 AudioSeal 和 WavMark 在这些传统攻击上的高位。这说明双增强是用有限音质代价换更广的神经泛化,而不是在所有攻击上都取胜。论文的解释是极低比特率加高重建质量迫使水印进入信号更本质的部分,但这只是假设,不是因果证明。
哪些攻击仍然有效,结论在什么条件下才成立
先说未胜出项。混响对本文所有模型都难,双增强仅 25.40,而 WavMark 在该项为 100.00。连续 2 次和 3 次随机神经重编码下双增强分别仅 50.90 和 21.90,说明多次洗涤仍是有效去除手段。低通 4 kHz 下双增强 69.40,也明显弱于两个基线。Mimi 与 SNAC 互相泛化差,双模型对 NanoCodec 和 SpeechTokenizer 也弱于对 EnCodec 和 DAC,意味着其他同样高效的编解码器仍可能是有效攻击,论文把这列为当前工作的局限。
结论成立的条件必须讲清。所有数字都基于 LibriTTS-R 干净集、24 kHz 全局水印、AASIST 检测器和 TPR@1%FPR 口径,改变数据集、采样率、检测器或误报约束都可能改变排序。论文未评估神经降噪器和声码器攻击,而这些在先前研究中被认为是强攻击,因此不能把本文结果推广为抗一切神经攻击。低比特率高重建质量导致更好泛化的说法只是可能解释,相关不等于因果。
要复现第一步做什么,需要哪些资源
复现第一步是准备基座与增强代码,而不是直接下载一个成品水印。需要按官方 DAC 配方在 LJSpeech、VCTK 和 LibriTTS-R 上训练基座以获得判别器权重,再冻结编码器和量化器微调解码器,同时准备冻结的增强编解码器并处理重采样。EnCodec、SpeechTokenizer 和 Mimi 需要按论文修改以支持冻结下的直通估计反向传播,SNAC 和 DAC 可直接用。作者资源方面,论文给出信道增强实现链接,经本次来源校验该代码链接当前可用,但这只证明该链接可达,不等于全部权重和训练脚本都已开箱即用,代码可用、权重可下载、系统可运行是三件不同的事,需分别确认。
关键超参数和信息条件要保留:基座训练 1000000 次批量 4,水印微调 40000 次批量 8,训练 1 秒裁剪,验证 5 秒,测试最长 10 秒,AdamW 贝塔一 0.8 贝塔二 0.99,损失权重 15、1、2、1,验证用开发集 250 样本按等错误率选模型。听感复现需等响度归一化、随机顺序、注意力检查和按人聚合的多重比较校正,否则 CMOS 置信区间不可比。
什么时候值得尝试这种做法,还缺哪项验证
如果应用场景的主要威胁是单次神经编解码器重编码或传统有损压缩,且能接受全局水印和 24 kHz 链路,那么 Mimi 加 SNAC 联合增强是值得尝试的起点,因为它在本文条件下对未见的 EnCodec、DAC 和多种传统压缩保持较高检出,且听感代价有限。如果威胁包括混响、强滤波、多次连续重编码、神经降噪或声码器,则不应直接部署,还需补充这些攻击的评估。
下一步验证应补三项。第一,把 Mimi 与 SNAC 增强搬到 AudioSeal 这类局部水印模型上,看结论是否跨结构成立,论文已提出该方向。第二,补充降噪器、声码器和更多低比特率编解码器的攻击矩阵,并报告不同误报率下的曲线,而不只看 1% 误报单点。第三,报告训练与推理开销、延迟和多次攻击下的误判分布,因为本文未测量这些成本,不能承诺它们会改善。总体上,论文的价值在于证明增强用哪个编解码器很重要,而不是给出一个已解决所有去除攻击的终极水印。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses