📄 只帮一个类别:人声二分类加人工核验如何省下森林音频标注时间
英文题目:A Human-Verified AI Workflow for Annotating Environmental Sound Data
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Michael Barasa Murunga:机构信息未能在本次解析中与作者逐人可靠绑定
- Allan Vikiru:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
肯尼亚森林声音工作集包含 7531 条时长 0.11 秒至 5.02 秒的环境录音,共 21 个声音类别,建模开始时仅 2505 条有人审标注,剩余 5026 条待标,且类别极不均衡,困难在于以有限人力保证一致性,又不让机器建议覆盖已有人审结论。工作流程先尝试文本音频对照模型做零样本划分,再用音频集预训练的频谱变换器做直接映射,接着加入过零率等常规描述量做加权组合,最后把该变换器微调为区分人声说话与其他类别的二分类器,前一步的输出只决定后一步处理哪一个队列,核验通过才转为可用标注。微调后的二分类器在保留测试集上准确率为 89.36%,而直接映射基线为 59.00%,差距为 30.36 个百分点,但仍低于作者预设的 95% 自主标注门限,因此 2337 条判为说话的录音全部进入单问题听辨复核。与剩余队列全人工处理约需 48.9 人时相比,混合流程耗时约 28.9 人时,节省约 20.0 小时即 41%,复核平均每条约 4.2 秒,人工逐条标注平均每条 35 秒。结论仅适用于该工作集与该录音环境,作者承认对其他类别、其他声场与更大规模的适用性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://github.com/SCES-Makerspace-Lab/Auto-Sound-Annotation-2026 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
环境录音变多了,为什么标注还是瓶颈
这篇论文处理的对象是肯尼亚森林声音数据集在项目阶段的工作集合,一共 7,531 段录音,约 10 小时音频,采样率 16 kHz,每段时长 0.11–5.02 秒,平均约 4.2 秒,词汇表有 21 个环境声音类别。输入是野外采集的短音频,目标是给每段一个可靠的类别标签,必须保留的信息是声音本身的类别归属和已有人工作业的权威性,输出是可用于训练和评估的带标签数据集。
困难在于录音容易、听辨难:野外有背景噪声、距离远近不同、偶有声音重叠,有的类别听起来相近,有的类别样本极少。论文开始做模型时,已有 2,505 个文件有了人工标签,占 33.3%,还有 5,026 个文件待标注,占 66.7%。按每个文件平均 35 秒计算,标完整体约需 73 人时,剩余队列也需要约 48.9 人时。在这种时间和人力约束下,问题不是能不能训练一个 21 类全自动分类器,而是二值模型在只做建议、不做最终真值时,能帮上多少忙。
已有路线提供了起点,但不能直接解决 21 类不均衡标注
论文回顾了两条线。第一条是环境声音分类与迁移学习:早期用频谱时域描述子加卷积结构,后来出现可在大语料上预训练再迁移到小数据集的模型。Audio Spectrogram Transformer,简称 AST,把音频频谱图切块后用 Transformer 结构处理,在大规模音频事件分类上被评估过,论文使用的 AudioSet 微调检查点就是迁移起点。对比语言音频预训练,即 CLAP,把声音和文字描述映射到共享表示,理论上可用自然语言提示做零样本推理,适合某些类别几乎没有训练样本的情况。
第二条是机器辅助标注与质量控制:例如 INCEpTION 这类交互式标注平台把预测和人工修改放在同一流程,众包质量控制研究强调当人和机器标签混合时需要核验机制。本文与它们比较的前提不同:本文不是提出新的通用识别结构,而是在一个正在进行中的标注项目里,记录 1 次受约束的预训练分类器应用,包括模型不够好到免检时在操作上如何安排。分类器评测和经人工复核的部署效果在本文是两件分开报告的事,不能混为一谈。
工作集有多大、多偏,剩余工作如何计算
要理解后文的取舍,先看工作集的结构和偏斜程度。下表是项目阶段工作集的总体情况和标注启动点,它决定了哪些类别值得做监督训练,哪些只能先放回人工队列。
下表展示工作集规模、音频条件与已标注和待标注的划分,罕见类与常见类的对比说明了不均衡的严重程度。
| Characteristic | Value |
|---|---|
| Working-collection recordings | 7,531 |
| Sound categories | 21 |
| Initially human labeled | 2,505 (33.3%) |
| Initially unlabeled | 5,026 (66.7%) |
| Frequent labeled category | Person talking: 1,056 examples |
| Rare labeled categories | Steel banging; Person laughing: 2 examples each |
从表中可见,人声说话即 Person talking 在已标注子集中有 1,056 例,占 42.2%,而 Steel banging 和 Person laughing 各只有 2 例,占 0.08%。这种差异直接影响监督目标的选择:如果一开始就训练 21 分类,大量类别几乎没有可学样本。论文还特别说明,本文的 7,531 工作集合与公开 KFSD 记录的 5,500 条范围不同,前者是本次标注实验用的工作集合,后者是项目仓库记录的公开发布,不宜把两个数字混用。
总体流程:人工优先,模型只负责挑出疑似人声
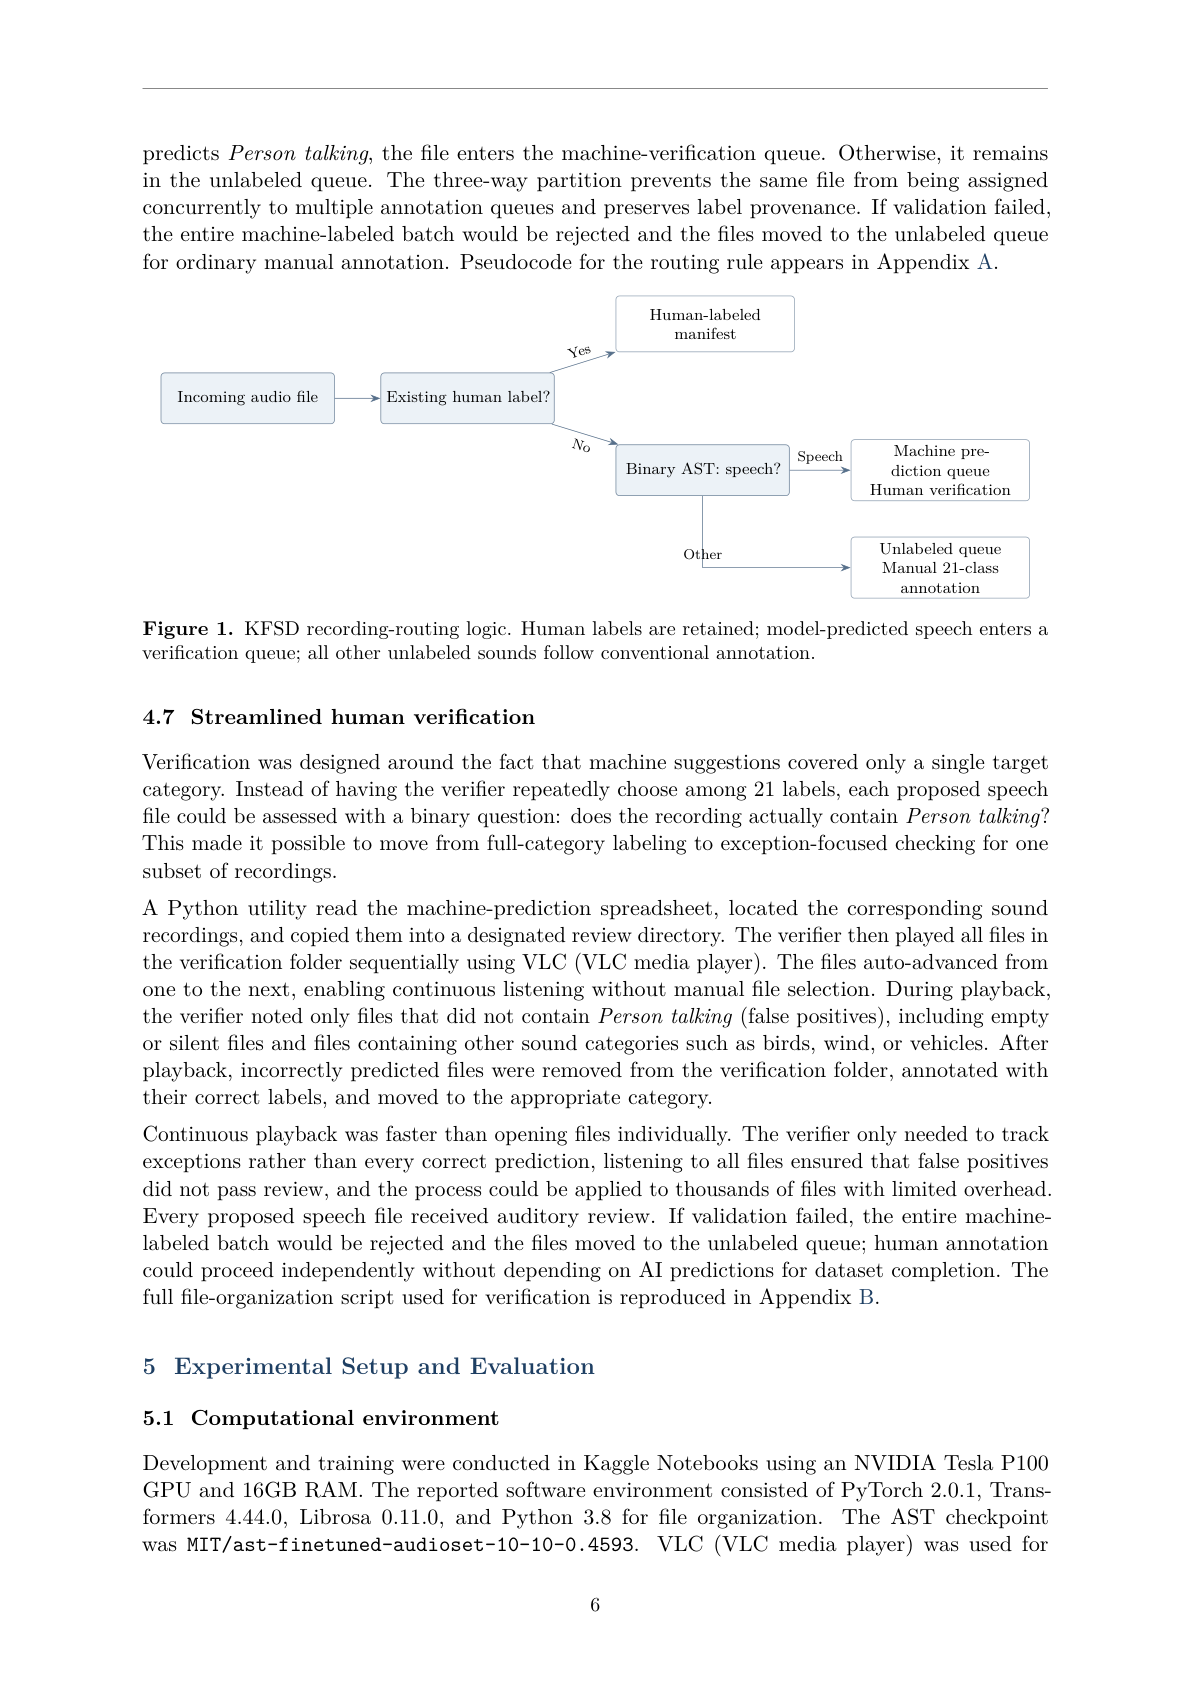
方法整体可以沿一个新进来文件的旅程理解。文件先查有没有已有人工标签,有则进入人工标注清单,人工结论优先,模型不得覆盖;没有人工标签则交给二值 AST 判断是否为人声说话,判为说话进入机器预测待核验队列,必须经人听审后才能接受,判为其它则留在未标注队列,按 21 类做常规人工标注。若核验失败,整批机器标注退回未标注队列,人工标注仍可独立完成,不依赖模型。
三份清单的含义和下一步动作需要严格区分,否则容易把待审建议误当最终标签。
| Manifest | Interpretation and next action |
|---|---|
| human_labeled_files.xlsx | Human-annotated files; accepted human labels take precedence over model outputs. |
| machine_labeled_files.xlsx | Previously unlabeled files predicted as Person talking; each must be reviewed before acceptance. |
| unlabeled_files.xlsx | Files with no human label and no positive model speech suggestion; assign one of the 21 classes manually. |
人工标注清单 × 机器标注清单 × 未标注清单: 人工标注清单保存已有人工标签并优先于模型输出,机器标注清单保存被模型判为人声但尚未核验的待审文件,未标注清单保存无人工标签且无肯定人声建议的文件,三份清单分工是为了防止同一文件同时进入多个队列,并让已完成的人工工作不受后来模型预测覆盖。
下图是论文给出的分流逻辑,读图时重点看分支条件和终点性质,不要把机器预测队列当成已完成标注。图中从左到右依次是新音频、是否存在人工标签的判断、二值 AST 判断,以及 3 类去向,箭头上的 Yes、No、Speech、Other 就是分流条件。
看图路径: 1. 先从左侧 incoming audio file 沿箭头看第一个分支点是否存在人工标签;2. 再看无人工标签时二值模型按 Speech 与 Other 分出两条去向;3. 对照三类终点框确认哪一类需要人工核验、哪一类回到 21 类人工标注
图片来源: 原论文 PDF 第 6 页(含图 1)
论文图 1。原论文 Figure 1::“KFSD recording-routing logic. Human labels are retained; model-predicted speech enters a verification queue; all other unlabeled sounds follow conventional annotation.”。
图中确实可见左侧两个判断框串联,右上终点是人工标注清单,中间终点是机器预测加人工核验,右下终点是未标注队列做 21 类人工标注。这种画法帮助理解并发保护:人工和机器两条线同时推进,但靠清单隔离和优先规则避免互相覆盖,也为后文连续播放加只记例外的高效核验留出了单一类别的前提。
先试不训练的两条路:映射和加特征能走多远
最初目标是看预训练分类器能否减轻 21 类的剩余人工量,考虑过 4 种策略。第一种是基于 CLAP 的零样本分类,想用文字描述覆盖缺少样本的类别,但在 Kaggle 环境中因 NumPy、SciPy 和 Transformers 版本依赖冲突未能完成安装调试,论文没有花大量时间修环境,而是转向可运行的 AST 方案,因此 CLAP 没有进入后文的结果表。
第二种是直接使用 AudioSet 预训练 AST 检查点 MIT/ast-finetuned-audioset-10-10-0.4593,它输出 632 个 AudioSet 类别概率,再把 Speech、Male speech、Female speech 等合并到 Person talking,把其它相关 AudioSet 标签映射到 21 类。在 300 个有标签样本上该方法得到 59% 准确率,错误有明显声学相似性:鸟叫被判为说话,高频声音混淆;电锯被判为牲畜,低频轰鸣相似;风被判为安静或门声,低幅度环境声相似。按此错误率推算,5,026 个剩余文件约产生 2,060 个错误标签,不可用于自动赋值。
第 3 种是在映射基础上加传统特征的加权集成,权重为 AudioSet 预测 60%、过零率 15%、频谱质心 15%、梅尔倒谱系数方差 10%,希望补上预训练映射抓不住的信号特性。该集成在所用测试集上达到 68% 准确率,比映射基线高 9 个百分点,但 32% 错误率对应约 1,608 个错误标签,仍不足以写最终标签。
零样本分类 × AudioSet 映射 × 传统声学特征: 零样本分类指不经本项目训练直接用预训练模型加文字或标签映射做判断,AudioSet 映射是把 632 个 AudioSet 类别概率合并到 21 个目标类别,传统声学特征是过零率、频谱质心和梅尔倒谱系数方差等信号描述,三者组合成加权集成是为了检验不微调时能否靠外部知识加信号特征补足领域差异。
为什么最后只做人声说话对其它这一个二分类
转向监督微调后,任务被有意收窄为 Person talking 对 Other 的二值检测。理由是现实的:人声说话有 1,056 个已标注样本,是各类别中最多的;人声相对 Wind、Plastic wrapper 等类别声学特征更清晰;把鸟误判为风这类多类错误被认为比说话非说话的二值错误更麻烦;在有限开发时间内训练 21 个二分类器或一个 21 分类器成本更高;先在 1 个类别上试点保守验证,再考虑扩展。
代价也要说清:被判为 Other 的文件不能自动归入其余 20 类中的某一类,只能退回常规人工标注。这意味着模型帮助的上限就是疑似人声那部分,其它声音仍是完整 21 选 1 的人工工作。这种收窄不是偷懒,而是把有限样本和有限时间换成一个可核验的任务。
Audio Spectrogram Transformer × 微调 × 二分类: Audio Spectrogram Transformer 是把音频频谱图切块后用 Transformer 处理的声音分类模型,微调是指在 AudioSet 预训练检查点上再用本项目已标注数据更新参数,二分类是指只区分人声说话与其它,二者搭配是因为 21 类数据极不均衡,只有缩小到样本较多的人声任务,微调才能学到本采集环境的混响、距离和背景噪声特征。
微调 AST 时数据、损失和停止规则是怎样定的
本研究确实训练了一个模型,就是二值 AST,其它零样本和集成方案没有做目标数据的参数更新。训练数据来自已有的 2,505 个人工标注样本,按分层 70% 训练、15% 验证、15% 测试划分,保持人声与其它比例。损失用类别加权交叉熵,以缓解正负不均衡;优化器为 Adam,学习率 3×10⁻⁵,批量大小 8,共训练 15 轮,早停观察验证 F1,耐心为 10 轮,最好验证准确率在第 11 轮达到 92.82%。
需要指出原文未披露的缺口:论文没有给出频谱图参数、切块尺寸、数据增强、冻结层数等细节,也没有比较 PANNs 或 wav2vec 2.0 等替代方案,未尝试音高偏移、时间拉伸、噪声注入等增强。选择 AST 部分是因为有稳定的检查点和文档。训练中把其余 20 类压成一个 Other 标签,简化了训练,但也丢掉了非语音内部的声学区分,这为后文的假阳性和假阴性埋下原因。人声本身包含耳语、喊叫、对话和单个词,录音距离、背景噪声和混响变化大,1,056 例仍覆盖不了全部多样性。
训练前定下的规则很关键:95% 准确率才考虑自主标注。微调模型在保持测试集上为 89.36% 准确率、85.98% 精确率、89.24% 召回率、87.58% F1,未达阈值,因此只做建议,必须人工核验。这是人工辅助的半自动标注,不是全自动标注。
评测分几层:分类指标、核验作业和工时如何分开算
实验环境为 Kaggle Notebook,NVIDIA Tesla P100 GPU,16 GB 内存,软件为 PyTorch 2.0.1、Transformers 4.44.0、Librosa 0.11.0,文件整理用 Python 3.8,核验播放用 VLC 连续播放。分类指标沿用常规定义:准确率是分类正确比例,精确率是预测为说话中真正是说话的比例,召回率是说话样本被找回的比例,F1 是精确率与召回率的平衡。本文特别看重精确率,因为误报会把非说话送进人声核验队列,增加核验负担,尽管最终接受仍由复核决定。
3 层评估要分开:映射零样本 AST 在 300 个有标签样本上评估;微调二值 AST 用分层划分,验证集用于开发,早停看验证 F1,保持集用于报告测试性能;生产核验是把模型用于 5,026 个无标签文件后,对 2,337 个机器判为人声文件逐个听审,分类性能与人工核验结果是 2 次独立测量。工时计算只针对剩余 5,026 队列,不重算已标的 2,505 个:人工按每文件 35 秒,核验按实测每文件约 4.2 秒,即点开并听完音频长度上下浮动 1–2 秒。时间线为第 1–4 周人工标注初始样本,第 5 周模型开发训练,第 6 周流程验证实现,第 7 周复核机器预测。
三种可评方案的分类成绩差在哪里
核心比较问题是:在同一 KFSD 标注任务下,不训练的映射、加特征的集成和微调后的二值模型,在准确率、精确率、召回率和 F1 上各达到多少,是否达到可免检的水平。比较条件并不完全相同,映射用 300 例评估,微调有完整划分,但论文把它们并列为已完成评估的可选项,CLAP 因未完成而不列入。指标方向都是越高越好。
下表比较 3 种实际跑通方案的报告成绩,重点看微调相对映射的提升幅度和是否跨过 95% 门槛。
| Method | Accuracy | Precision | Recall | F1 |
|---|---|---|---|---|
| Zero-shot AST | 59.00% | 59.04% | 98.00% | 73.69% |
| AST + audio features | 68.00% | 75.40% | 95.00% | 84.07% |
| Fine-tuned AST | 89.36% | 85.98% | 89.24% | 87.58% |
表中可见映射零样本 AST 为 59.00% 准确率,加音频特征后到 68.00%,微调 AST 到 89.36%,相对映射基线提高 30.36 个百分点。精确率从 59.04% 经 75.40% 到 85.98%,召回率从 98.00% 经 95.00% 到 89.24%,F1 从 73.69% 经 84.07% 到 87.58%。微调以部分召回换来精确率和整体准确率的明显改善,但仍低于 95% 自主标注阈值,因此只能做选择性辅助复核。未胜出的两项并非无用,它们证明了不做领域适配时错误量级过大,也为后文只保留微调模型做建议提供了依据。
测试集准确率 × 核验准确率 × 置信度筛选: 测试集准确率是在分层抽出的有标注保持集上同时考核正负例的分类指标,核验准确率是核验员逐个听完 2337 个机器判为人声文件后发现零误报的作业结果,置信度筛选指只把高置信度的人声预测送入待审,三者搭配解释了为何 89.36% 的测试准确率与 100% 的核验准确率可以并存而不互相替代。
2337 个机器建议逐个听完后省了多少时间
生产阶段把微调模型用于 5,026 个无标签文件,2,337 个被送入人声核验队列,2,689 个回常规 21 类人工标注。核验员听完全部 2,337 个机器肯定文件,发现零误报,核验准确率 100%,超出预期。论文强调这是作业结果,与保持集上的二值分类评估不同,保持集同时考核正负例,生产核验只复核被选中的人声建议,且只纳入高置信度预测,加之生产文件采集条件较一致、疑似人声信号较强。
工时比较问题是:剩余队列若全人工需要多少,若 2,337 个走核验加 2,689 个走人工又需要多少,节省是否依赖核验全对。人工按每文件 35 秒,核验按实测每文件 4.2 秒。下表保留原文的记录数、每文件秒数和小时数,方向是小时数越小越省。
| Activity | Recordings | Sec/file | Hours |
|---|---|---|---|
| Manual-only baseline | 5,026 | 35.00 | 48.86 |
| Hybrid: verify model positives | 2,337 | 4.20 | 2.73 |
| Hybrid: annotate remaining files | 2,689 | 35.00 | 26.14 |
| Hybrid total | 5,026 | — | 28.87 |
| Effort saved | — | — | 19.99 |
表后解释需要完整:人工基线 5,026 个文件需 48.86 小时,混合流程中核验 2,337 个需 2.73 小时,人工标注剩余 2,689 个需 26.14 小时,合计 28.87 小时,节省 19.99 小时约 20.0 小时,即 41%。节省只覆盖人声类别,其余 20 类仍是人工;且节省成立依赖于本次全部预测核验正确,若核验准确率下降,节省会缩小乃至消失。论文还提到若逐个打开文件加表格切换,约需每文件 39.2 秒,而连续播放加只记例外降到 4.2 秒,这就是核验设计带来的具体收益。
人工标注耗时 × 核验耗时 × 自主标注阈值: 人工标注耗时按每个文件平均 35 秒计算完整 21 选 1 的听辨加选择成本,核验耗时按每个文件平均 4.2 秒计算只需回答是否含人声的连续听音成本,自主标注阈值是事先定下的 95% 准确率门槛,三者组合决定了工作流形态:未达阈值就不能免检,只能用低成本核验替换部分高成本标注。
模型在哪些声音上容易错,测试集数字对应多少个文件
零样本映射的错误与声学相似有关,已在上文列举。微调二值模型的假阳性包括节奏性脚步、鸟叫和部分气息感强的风声,假阴性包括远距离说话、低信噪比录音和说话与其它声音重叠的情况。论文进一步按 15% 测试划分对应 376 个文件、其中 158 个人声片断,结合报告指标推算混淆矩阵为 141 真阳性、23 假阳性、17 假阴性、195 真阴性。脚步的节奏被误认为语音节律,鸟的高频啼叫类似人声,风的 breathy 噪声模式也易混;远而轻、重叠、口音或非标准发音则容易漏检。
这组细节说明二值化的代价:正类内部多样,负类把 20 个异质类别压成一个标签,模型在有限样本下难以学到跨距离、风格和背景的鲁棒边界。理解这些模式才能明白为何测试集特意包含难例,以及为何生产核验会出现不同结果。它们不是事后找补,而是限定结论适用条件的证据。
哪些结论不能推广,哪些开销仍在
适用边界首先是范围:机器辅助只针对 21 类中的 1 类,影响 7,531 工作集中的 2,337 个文件约 31%,其余 2,689 个待标注文件仍需多类标注,因此这是试点,不是端到端自动标注。把 20 类压成 Other 简化了训练,但丢掉了通用环境声识别可能需要的区分;样本少于 100 的类别不用少样本学习等方法无法可靠自动化,而本文未探索这些方法。
操作上,并发的人工与机器流程需要仔细的文件同步和来源管理,连续播放加例外记录依赖音频复核功能,换平台实现可能不同。核验耗时约 4.2 秒是本次录音环境和 VLC 工具下的实测,不是通用常数。更重要的是,本次核验零误报、真实准确率高于测试集的现象,不应默认搬到声学条件差异大的场景;类别、数据源和更大评估才能确定更广适用性。若验证失败整批退回未标注队列的设计,保证了最坏情况下仍可人工完成,但也意味着节省不是 guaranteed。
论文对何时用、何时不用的建议值得复述:至少有 1,000 个目标类样本、目标声学较独特、有高效核验流程、验证准确率超 85% 且接受大部分仍人工时可尝试;样本少于 500、类别高度相似如说话与唱歌、无核验工具、对质量要求极高的医疗法律场景、或想以有限数据 1 次自动化多类时应避免。
要复现这条流程第一步做什么,需要哪些材料
复现不是直接跑一个脚本得到同一节省数字,而是重建分流加核验的作业闭环。第一步是按论文恢复三清单路由:已有人工标签优先,无标签且模型判为人声进待审,否则进未标注,伪代码在附录 A,文件整理脚本在附录 B,训练参数与时间线在附录 C,核验规则与经验在附录 D。检查点、软件版本与播放工具在上文实验设置中已列出,论文给出代码仓库链接为第三方资源,地址为 SCES-Makerspace-Lab 的 Auto-Sound-Annotation-2026,KFSD 公开记录与文档分别指向 Zenodo 与项目仓库。是否可用需自行按链接确认,本文不把链接可达等同于作者已开源或系统可一键运行。
关键超参数和信息条件要保留:基检查点、Adam、学习率、批量 8、15 轮、早停看验证 F1 耐心 10、类别加权交叉熵、分层 70/15/15、95% 自主阈值、人工 35 秒与核验 4.2 秒的计量口径。复现时应先固定阈值和计量方式,再跑模型,最后逐个听审全部机器肯定文件,不能只抽查。若换数据集,需重估类别样本量、声学可分性和核验工具,否则工时对比不成立。
什么时候值得试这套人声筛选加核验
综合来看,这篇论文回答的是一个很具体的问题:在类别不均衡、只有部分标注、模型达不到免检线时,二值模型做建议加人工全检能否省时间。答案是有条件成立:选样本最多且声学较清晰的人声说话做二值微调,用清单隔离保护人工标签,用连续播放加只记例外把核验成本压到每文件约 4.2 秒,在本次 2,337 个建议全对的条件下,剩余队列节省约 20 小时即 41%。
容易产生的误解要澄清:89.36% 测试准确率不等于生产准确率,100% 核验准确率不等于模型已达 95% 免检水平,更不等于其它 20 类也能同样省时;节省数字只针对剩余 5,026 队列,不是整个 7,531 集合,更不是任意森林录音的通用比例。还需要补的验证包括多类别扩展时的错误与工时变化、置信度校准在不同条件下的稳定性、少样本类别的 few-shot 效果,以及专用核验界面能否进一步降本。对于预算有限、类别极偏、想先在 1 个类别上试点的小团队,这份记录的价值在于给出了可照做的分流、核验与回退方案,以及诚实记录的有限成功。
📎 论文与评分元数据
排名:前50% | 文档类型:应用研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses