共分析 48 篇论文
⚡ 今日概览
✅ 筛选入选 48 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音交互 | 5 篇 | █████ |
| 语音识别 | 5 篇 | █████ |
| 空间音频渲染 | 3 篇 | ███ |
| 音乐分析 | 3 篇 | ███ |
| 音频分离 | 3 篇 | ███ |
| 多模态情感极性分析 | 2 篇 | ██ |
| 音乐生成 | 2 篇 | ██ |
| 音频伪造检测 | 2 篇 | ██ |
📊 论文评分排行榜(48 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 GSLM2:多层语音单元与多流建模如何缩小语音与文本的语言能力差距
英文题目:GSLM2: Multi-Stream Speech Representation Learning and Generative Spoken Language Modeling
评分:8.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yosuke Higuchi:Meta Superintelligence Labs
- Tom Fizycki:Meta Superintelligence Labs;Université Paris Dauphine-PSL
- Mahi Luthra:Meta Superintelligence Labs
- Charles-Éric Saint-James:Meta Superintelligence Labs
- Azeez Syed:Meta Superintelligence Labs
- Angel Villar-Corrales:Meta Superintelligence Labs
- Mido Assran:AMI Labs
- Nicolas Ballas:AMI Labs
- Jiayi Shen:Meta Superintelligence Labs
- Dongyan Lin:Meta Superintelligence Labs
- Phillip Rust:Meta Superintelligence Labs
- Surya Parimi:Meta Superintelligence Labs
- Vanessa Stark:Meta Superintelligence Labs
- Alexandre Allauzen:Université Paris Dauphine-PSL
- Balázs Kegl:Doctolib
- Juan Pino:Meta Superintelligence Labs
- Emmanuel Dupoux:Meta Superintelligence Labs;Ecole des Hautes Études en Sciences Sociales
📌 核心摘要
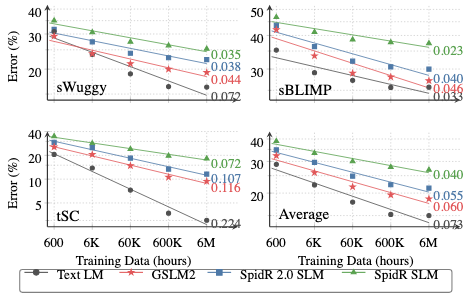
读者需要理解的对象是不依赖文本、直接从连续语音学习语言结构的生成式口语语言模型,困难在于语音采样率高而信息密度低,单层单流离散单元要在紧凑性和语音细节之间取舍,处理过程是先把波形变成离散单元序列,再做自回归预测。SpidR二代编码器在学生-教师框架下用层相关的共享预测头学习多层离散单元空间,输出互补抽象层次的并行单元流,避免单层均值量化的后处理取舍。多流语言模型接收上述多层单元序列,用共享时序主干加流内预测和元组内自回归生成头联合建模,把互补层次分布到并行流中保留。在Libri-Light 60K小时、1.2B参数设置下,GSLM2的sWuggy、sBLIMP和tSC准确率分别为79.3%、71.8%和84.5%,分别高于同规模SpidR单流模型5.4、9.4和9.4个百分点。在最高达6M小时互联网对话语音的扩展实验中,以追平文本模型平均指标所需的额外数据量衡量,GSLM2的差距低于SpidR单流的大约四个数量级,降至大约两个数量级。结论适用于朗读和会话英语的词汇句法语义评测,sSC等更难的篇章推理和韵律重建尚未解决。原文披露多流训练计算量约为单流的三倍,未披露部署成本。
🔗 开源资源
代码相关资源:https://github.com/facebookresearch/gslm2 — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/spoken-lm — 链接可访问(HTTP 200)
模型相关资源:https://github.com/facebookresearch/gslm2 — 链接可访问(HTTP 200)
第三方资源:https://github.com/Alexander-H-Liu/dinosr — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/spidr — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/fairseq/tree/main/examples/speech_synthesis — 链接可访问(HTTP 200)
第三方资源:https://github.com/jik876/hifi-gan — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/lt-swap — 链接可访问(HTTP 200)
第三方资源:https://github.com/OHF-Voice/piper1-gpl — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 SPATEX:用方向线索做阵列可变的“多进多出” 目标语音提取

英文题目:SPATEX: Array-Flexible Multichannel-to-Multichannel Target Speech Extraction using Direction Clue
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wen Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Changda Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Xi:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyu Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiang Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Guanyu Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoyu Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Bohan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Shuai Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要理解的对象是每个麦克风处目标说话人的混响声像,困难在于麦克风数量和阵列几何变化时既要提取目标内容,又要保留各通道之间的空间关系。输入是多通道混合波形、麦克风三维坐标和目标方位角,输出是每个有效麦克风处的目标波形。共享编码器先把各通道短时傅里叶变换的实部虚部变成特征流,六级分离模块依次做方向调制、按麦克风的频率建模、跨麦克风共享的时间协同和带几何条件的通道信息交换,最后由共享解码器恢复各通道目标频谱。方向调制把同一调制向量乘到所有麦克风流以指定提取谁,几何嵌入把相对阵列中心的偏移和阵列半径送入通道交换以适应不同阵列。与固定阵列的多通道输出方法和只输出参考通道的阵列可变方法不同,该框架保持对麦克风排序的置换等变性。在非匹配几何9-10麦克风外推测试中,参考通道SI-SNRi指标上SPATEX以15.98 dB高于FlexIO-DOA的15.39 dB。在固定4麦克风线性阵列测试中,可变阵列训练的SPATEX在SI-SNRi上以12.90 dB高于SoundCompass的11.68 dB,在通道间相位误差ΔIPD上以0.614 rad低于SoundCompass的0.773 rad。结论适用于合成混响、无加性噪声、声源夹角至少15度的条件,方向线索存在10度以内误差时仍保持优势。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/Wenanzhi/SPATEX — 链接可访问(HTTP 200)
数据相关资源:https://github.com/Wenanzhi/SPATEX — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 EZ-Ar-VC:面向方言与语码切换的阿拉伯语语音匿名化
英文题目:EZ-Ar-VC: Robust Arabic Voice Anonymization with Generalization across Dialects and Code-Switching
评分:7.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Injy Hamed:机构信息未能在本次解析中与作者逐人可靠绑定
- Adarsh Arigala:机构信息未能在本次解析中与作者逐人可靠绑定
- Rufael Marew:机构信息未能在本次解析中与作者逐人可靠绑定
- Arjun Gangwar:机构信息未能在本次解析中与作者逐人可靠绑定
- Atharva Kulkarni:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanan Aldarmaki:机构信息未能在本次解析中与作者逐人可靠绑定
- Srinivasan Umesh:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音匿名化的输入是一段需保留内容、口音和风格的源语音,输出是听感为另一说话人且难以被自动说话人验证系统关联回源说话人的语音。难点在于阿拉伯语方言差异大,存在与英语和法语的语码混合,且部分咽音、强调音和软腭小舌音在已有模型训练数据中代表不足。论文先评测 Diff-HierVC、Seed-VC、EZ-VC、kNN-VC、YourTTS 和 Vec2Wav 2.0 六个零样本系统,再以 EZ-VC 为骨干构建面向阿拉伯语的模型。离散语音单元来自 XEUS 第 14 层输出的聚类结果,单元序列进入由 F5-TTS 改造的单元到语音主干,生成目标说话人音色的波形;另一条 kNN-VC 路线检索目标说话人 WavLM 特征并经 HiFi-GAN 声码器合成。相对已有零样本做法,关键差异是用约 300 小时阿拉伯语加英语和法语数据的 2K 类聚类中心重建离散单元,并从 10 万小时预训练的 F5-TTS 出发微调 15 万步,使模型直接学习阿拉伯语音素分布。客观评测中 EZ-VC(AR+EN+FR)在测试集上词错误率为 16.8%,字符错误率为 7.1%,优于 EZ-VC 基线的 30.0% 和 14.9%,同时目标说话人相似度为 0.57,自动说话人验证等错误率为 44.54%,兼顾可懂度与匿名性。结论适用于现代标准阿拉伯语、埃及、阿联酋、突尼斯等方言及埃英和突法混合,对也门、阿尔及利亚和巴勒斯坦等训练代表不足的方言仍有主观评测支撑。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/EZ-AR-VC/EZ-AR-VC — 链接可访问(HTTP 200)
模型相关资源:https://github.com/EZ-AR-VC/EZ-AR-VC — 链接可访问(HTTP 200)
演示资源:https://github.com/EZ-AR-VC/EZ-AR-VC — 链接可访问(HTTP 200)
第三方资源:https://github.com/EZ-AR-VC/EZ-AR-VC — 链接可访问(HTTP 200)
第三方资源:https://github.com/Voice-Privacy-Challenge/Voice-Privacy-Challenge-2024 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/oddadmix/Whisperv3-tunisian-codeswitch — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/CohereLabs/cohere-transcribe-arabic-07-2026 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 不调参数也能适应新环境:用被丢掉的残差做语音增强

英文题目:Continual Residual Memory for Gradient-Free Test-Time Adaptation in Speech Enhancement
评分:7.6/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yijia Shan:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianrui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zixiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Sheng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
离线训练的语音增强模型在说话人、噪声和声学条件变化时会出现过抑制,把有用语音也当作噪声去掉,测试时没有干净参考可用,难以纠正这类损失。本文把带噪输入与冻结增强输出之差定义为丢弃残差,把问题转为在时频格点上判断哪些残差应捡回、捡回多少。持续残差记忆(Continual Residual Memory,CRM)先只用当前句的增强估计和残差预测有界恢复增益,直接加权加回到增强谱上得到无记忆估计。再用之前句子积累的残差原型对该增益做加减修正,记忆为空时修正关闭并退回无记忆估计,测试时骨干和网络参数保持冻结,只有记忆状态随句子演进。训练分两阶段进行,先优化恢复投影器和增益头,再冻结它们优化记忆条件精修分支,并用匹配、打乱和空记忆条件保护无记忆回退。在以CMGAN为骨干的对照中,DNS集上CRM的PESQ为3.11,高于冻结基线的3.00和MPol的3.00,同时CSIG为4.36、COVL为3.75,均为同组最好。该方法部署时只增加37.09K参数和约2.20%的计算量,在RTX 4090上推理实时系数(real-time factor,RTF)从0.0340升至0.0387,仍远小于1.0,无需在线参数优化。结论适用于论文评测的合成无混响、需求噪声和音乐干扰条件,未验证长时漂移或强混响下的稳定性。
🔗 开源资源
- 代码相关资源:https://github.com/Ada312/continual-residual-memory — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 长语音推理为何变慢变错:C3 如何只取一小部分音频 KV 还能跟住转写

英文题目:C3: Speech-Guided KV Retrieval for Long-Context SpeechLLM Inference
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Dancheng Liu:University at Buffalo, USA
- Markus Müller:Amazon AGI, USA
- Rupak Vignesh Swaminathan:Amazon AGI, USA
- Jing Liu:Amazon AGI, USA
- Srikanth Ronanki:Amazon AGI, USA
- Aram Galstyan:Amazon AGI, USA
📌 核心摘要
语音大模型把音频编码为高时间分辨率的键值序列,输入变长时缓存迅速膨胀,解码需要在全部音频键值上计算注意力。论文研究只保留完整缓存但每步按查询取回少量音频键值的检索推理,输入是长语音与文本提示,输出是转写、翻译或摘要文本,难点是检索选错会改变隐藏状态并影响后续检索。C3在预填充阶段对每个键值头用递归二分k均值建立二叉层次索引,用质心代表所含键,前沿面划分全部音频且大小固定。解码时共享同一键值头的查询头用最大余弦相似度对同一前沿面竞争同一预算,胜出簇的键值被取回并计算精确注意力。随后按指数滑动平均跟踪簇与近期查询的相关性,把高优先级节点分裂为两个子节点,把低优先级兄弟对合并为父节点,使细粒度持续跟随相关区域。相对固定时间分块和静态键空间聚类,该方法同时引入非连续键空间单元、组内共享竞争和持久分辨率重分配。在Qwen3-Omni上,在LS-Long长语音识别评测中128键值预算下词错率从ClusterKV的180.94%降至7.07%,在LongSpeech语音翻译评测中256键值预算下chrF从25.91升至55.79。作者承认混合架构、硬件实现和超过32K音频标记的生成质量尚未验证。原文未披露训练成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 用探测器看清弱模态:PGGB 如何只放大弱者而不压制强者

英文题目:Probe-Guided Gradient Balancing for Multimodal Learning
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.5/0.5 | 工程/实践 0.8/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Vu Vo:School of Science, Engineering & Technology;RMIT University
- Haytham M. Fayek:School of Computing Technologies;RMIT University
- Thuy Nguyen:School of Science, Engineering & Technology;RMIT University
📌 核心摘要
联合训练的多模态网络常出现模态懒惰,学得快的模态主导共享融合目标,使公共损失的梯度偏向强模态,弱模态编码器收到的梯度被抑制。方法先为每个模态在停止梯度的编码器特征上接轻量线性探针,用独立优化器训练探针以估计各模态表征质量分数,使监测信号在结构上脱离融合目标。然后计算跨模态探针精度的极差作为利用率差距,经平滑后映射为有界放大系数,该系数在优化器更新前只乘到弱模态编码器梯度上,并可与抑制强模态的方法相乘组合。在CREMA-D 3帧、5随机种子的同协议准确率比较中,PGGB与OGM-GE组合为71.45%±1.71%,高于同管线OGM-GE的69.14%±1.13%。在CREMA-D冻结特征的事后线性探针准确率比较中,该组合的强弱模态探针精度差距为2.31个百分点,小于基线的12.53个百分点。结论限于有足够数据流和可训练编码器的情形,在文本占优的情感基准上弱模态表示几乎不变,在Adam下放大作用多被二阶矩归一化吸收。探针每20次迭代在半个小批量上训练一次并做梯度放缩,作者报告相对基线约1%的每轮耗时增加。
🔗 开源资源
代码相关资源:https://github.com/VuVoCodes/PGGB — 链接可访问(HTTP 200)
第三方资源:https://github.com/CheyneyComputerScience/CREMA-D — 链接可访问(HTTP 200)
第三方资源:https://sites.google.com/view/audiovisualresearch — 链接可访问(HTTP 200)
第三方资源:https://github.com/cvdfoundation/kinetics-dataset — 链接可访问(HTTP 200)
第三方资源:https://github.com/thuiar/MMSA — 链接可访问(HTTP 200)
第三方资源:https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK — 链接可访问(HTTP 200)
第三方资源:https://github.com/jefferyYu/TomBERT — 链接可访问(HTTP 200)
第三方资源:https://github.com/headacheboy/data-of-multimodal-sarcasm-detection — 链接可访问(HTTP 200)
第三方资源:https://www.synapse.org/brats2021 → https://www.synapse.org/Synapse:syn25829067 — 链接可访问(HTTP 200)
第三方资源:https://visiir.lip6.fr/explore — 暂时无法访问
第三方资源:https://github.com/VuVoCodes/PGGB — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 相对位置注意力为什么慢?一种保持精确的分块核如何消除稠密偏置

英文题目:Fast and Exact Relative-Position Attention via Structure-Aware Kernels
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Delyan Boychev:机构信息未能在本次解析中与作者逐人可靠绑定
- Ivo Petrov:机构信息未能在本次解析中与作者逐人可靠绑定
- Dimitar I. Dimitrov:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是语音和文本Transformer中常用的相对位置注意力,它的输入是查询、键、值矩阵和相对距离表,输出是加权后的表示,难点是分数中与距离有关的三项需要按查询键对查表或逐点计算,朴素实现要物化\(N \times N\)矩阵,显存和带宽随长度二次增长。方法先把查询键向量投影到关系表得到每个词元对每个距离行的标量响应,再在片上把响应加到内容点积分数上,前向只投影每个查询组可达的连续偏移区间,反向按偏移而不是按行累积梯度。饱和区域整块共用同一行,只读一次再广播,桶形映射先展开为截断映射再把拷贝列求和折回原桶。相对已有可编程框架逐点回调和原子累加的做法,差异是利用偏移在块内的常量结构减少索引和重复访存,并让每个查询块独占写入消除原子竞争。在8K词元、12头、头维64、FP16的H200单层评测中,相对每种机制的最强生产基线,Shaw、DeBERTa与T5的吞吐量前向提升1.8–6.4倍、反向提升2.0–21倍,峰值显存前向降低最高达128倍、反向最高达54倍,其中DeBERTa前向是例外,推理专用的GLiNER4j因在每块内重算而不存投影,峰值显存更小但吞吐量慢3.7倍。结论适用于截断、桶形和恒等三类偏移映射,恒等映射仍保留二次投影量,端到端语音增益取决于注意力在总时间中的占比,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 结构化字幕如何改变文本生成音乐的训练、补全与评价
英文题目:Text-to-music Generation via Structured Captions AND Interpretable Evaluation
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Junkai Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhepei Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ge Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Sarah Hye-yeon Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Mari Ostendorf:机构信息未能在本次解析中与作者逐人可靠绑定
- Nicholas J. Bryan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
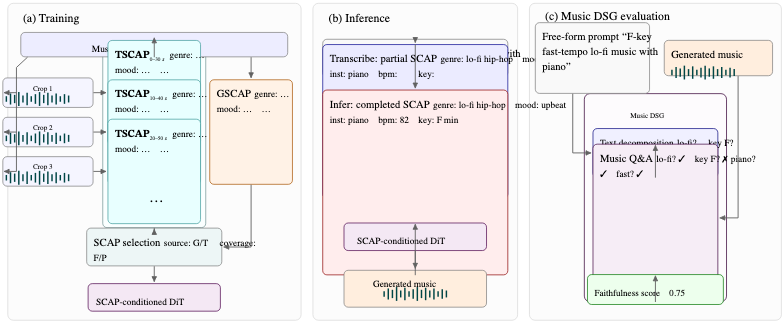
文本到音乐生成需要根据文字提示合成符合描述且听感良好的音乐,难点在于训练配对文本信息量不足、格式不统一,以及缺乏可解释的文本符合度度量。论文把自由文本替换为结构化标题,即用固定字段记录流派、情绪、能量、调性、速度、拍号、乐器、人声和关键词的文本条件,并比较全局整轨标注与局部时变标注,以及完整保留字段与训练时随机丢弃字段的设置。推理时用两阶段改写器把自由提示先抽取为部分结构化标题,再补全缺失字段,然后送入微调后的流匹配扩散变换器生成音乐。评价侧把提示拆成原子是非问题,再用音乐问答系统打分并按问题类型加权聚合,得到可解释的符合度分数。与已有方法的区别在于分离了忠实抽取用户意图和补全音乐相容信息两个步骤,并建立了依赖感知的问答聚合。在 Song Describer 子集上,全量全局结构化条件配合补全改写器在对齐指标上达到 CLAP 0.344 和 Music DSG 0.738,相对自由文本基线的 0.320 和 0.689 有同步提升,音频质量指标 FAD 从 7.63 降至 6.68。结论适用于 32 秒短片段生成和所用内部训练分布,长时结构、开放提示和跨库泛化尚未充分验证,训练成本仅披露了在 32 块 A100 上微调 150k 步,未披露完整时长与推理开销。
🔗 开源资源
- 第三方资源:https://mu-scap.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 本地答还是上交专家?冻结双工语音模型的开讲时刻分流

英文题目:Local or Escalate? Post-Training Expert Routing for Real-Time Duplex Speech Models
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Ruoyu He:University of California, Los Angeles
- Jisen Li:University of Illinois at Urbana-Champaign
- Anthony Ji:University of British Columbia
- Changyi Yang:Carnegie Mellon University
- Zetian Li:Stanford University
- Runduo Ma:University of Wisconsin–Madison
- Zhen Zhang:University of California, Santa Barbara
- Zhongzhu Zhou:University of Sydney
📌 核心摘要
实时全双工语音交互要求本地模型边听边决定何时开口,输入是连续语音流,输出是即时语音,开口早容易把没有把握的回答说死,等强模型又会拖慢简单轮次。论文冻结 MiniCPM-o 4.5,只用其语音输入和语音输出,在模型从听转说的原生边界上缓存已算好的隐状态,用正则逻辑回归拟合本地回答会失败的风险分数,分数超过按语言设定的阈值就升级。低风险轮次本地直接说,高风险轮次由本地发话人先说一句固定等待语,再转写问题交给可联网的 gpt-5.5,拿到文字答案后由本地发话人配音播出。相对已有在对话模型内生成特殊令牌来学轮次和思考调用的做法,该门控不增加语言模型前向计算,不改双工检查点,阈值可在部署时重调。在 240 条内部测试上,积极策略用 50.0% 升级率把内容准确率从 42.1% 提高到 69.2%,平均服务器首音等待从 8.68 s 降到 5.95 s。结论适用于问答类信息请求,对执行类多步推理失误几乎无区分力,现场偏好证据仍是初步的。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. Rel2Traj:让文字描述变成多声源相对运动都成立的空间音频

英文题目:Rel2Traj: Inter-Source Relation-Aware Trajectory Generation for Text-To-Spatial-Audio
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yihang Bao:机构信息未能在本次解析中与作者逐人可靠绑定
- Lingfeng Yao:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengyao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Junpei Xun:机构信息未能在本次解析中与作者逐人可靠绑定
- Miao Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
文字描述的多声源空间音频不指定每条轨迹的具体形状,只要求多个运动声源的联合运动在每一帧都满足相对关系,需生成并验证有效的轨迹集合。处理过程是先把文字转成结构化条件,再一次生成全部声源的轨迹,最后沿轨迹渲染双耳音频。经微调的解析器从描述中抽出声源及其运动类型、声源间关系和每声源粗略位置锚点,输出经图编码器做类型化消息传递后形成每声源条件向量。关系条件扩散模型在该条件和跨声源注意力下联合生成全部声源的16个关键帧轨迹,每帧关系几何裕量既定义评测也作为训练辅助损失,镜像等变结构对应左右对称的空间语言。双耳渲染器把预训练文本到音频模型的声音沿插值后轨迹放置,经多普勒频移、头部相关传输函数插值和房间反射后输出音频。在仅含训练未见运动—关系组合的组合测试集上,以关系满足率RSR衡量,Rel2Traj为0.983,高于独立逐声源基线的0.869,其抖动更高说明优势来自联合协调而非更平滑。适用范围限于受控语言、至多三声源、每场景至多一个声源间关系和有限关系词表,held-out的behind单元以0.780为最低点,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://echo-sculpture.github.io/Rel2TrajSA/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 用计数密度同时估计平板混响的模态个数与参数

英文题目:Count-Density Networks for Modal Plate Parameter Estimation
评分:7.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Rodrigo Diaz:机构信息未能在本次解析中与作者逐人可靠绑定
- Pablo Tablas De Paula:机构信息未能在本次解析中与作者逐人可靠绑定
- David Marttila:机构信息未能在本次解析中与作者逐人可靠绑定
- Ilias Ibnyahya:机构信息未能在本次解析中与作者逐人可靠绑定
- Chin-Yun Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
DAFx参数估计挑战Task B要求从一条实测位移脉冲响应恢复无序的模态集合,每个模态由频率、衰减率和增益组成,难点是模态数量未知、密度随频率变化可达数量级差异、相邻模态互相遮掩。输入先做峰值归一化并保留峰值幅度,降采样到22.05 kHz后取20 Hz到10 kHz频段,目标是在1/20倍频程网格上统计每格模态数并在固定槽位内存放衰减和增益。方法B1用实数U-Net融合池化后的幅度相位特征、0.75秒时域编码和对数幅度条件,同时预测总计数、密度分布和属性槽;方法B2用复数卷积加复数Transformer直接处理全分辨率复频谱,输出单值有符号增益。推理时共享解码器把总计数取整、把密度按比例分配为整数格计数并取对应槽位的前若干项,再乘回峰值幅度得到增益。与已有逐频带子空间和自回归方法逐带定阶拟合不同,计数密度网络一次前向同时给出数量和属性。在同一100条5秒独立比较集上以总相对误差为指标,B1为0.3180,B2为0.3301,均低于最强的被测经典基线Fast Burg的1.0984,频率和衰减误差明显小于增益误差。结论只适用于合成平板模型及其默认参数范围,增益恢复仍不可靠。训练各用单张NVIDIA A100约24小时和27小时,单条推理延迟为毫秒量级。
🔗 开源资源
- 模型相关资源:https://huggingface.co/ptablasdepaula/complex-valued-modal-plate-transformer — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 从听懂空间场景到生成与编辑:Spatial Transfusion 解读

英文题目:Spatial Transfusion: From Structured Spatial Scene Understanding to Generation and Editing
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Jaeyeon Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Sebastian Braun:机构信息未能在本次解析中与作者逐人可靠绑定
- Hannes Gamper:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是四通道一阶 Ambisonics录音,它同时记录声音内容、声源三维方向与距离、房间混响和弥散背景,理解、生成、编辑长期由不同专用模型承担,多声源逐源控制尤其困难。理解以四通道录音与可选指令为输入,自回归输出列出房间、弥散背景和最多多个定向源语义、声学、空间、时间属性的结构化场景描述,该描述直接作为生成的条件输入。生成以上述场景描述为条件,在连续编解码器隐变量上学习由噪声指向目标隐变量的速度场,推理时积分该速度场采样目标隐变量,再由FOA-VAE解码器还原波形。编辑以源场景音频与原子编辑指令为输入,一路经理解通路提供场景条件,另一路把干净源隐变量与加噪目标隐变量沿通道拼接,共同预测指向编辑后场景隐变量的速度场,从而保留未改内容。训练冻结原有理解主干,只更新按模态区分的音频与文本低秩适配器及新增的隐变量投影、时间步嵌入和速度预测头,并按单源理解生成、单源编辑、多源扩展、自然语言指令四个阶段逐步增加能力。与同数据全量微调相比,该方法在 FOA-MEIR 合成测试集上把生成的 FAD-PSELD 从 3.82 降到 0.964,编辑的 EditFLAM 从 15.5 提高到 17.8,同时元组分数保持在 0.812 左右,基本没有损失理解能力。结论适用于仿真房间与最多 5 个定向源的场景,未在真实录音验证,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://microsoft.github.io/spatial-transfusion/ → https://github.com/login?return_to=https%3A%2F%2Fgithub.com%2Fpages%2Fauth%3Fnonce%3Df4c06a28-d9e9-4f58-b82c-f600f5403646%26page_id%3D88221267%26path%3DLw — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 让译语说在原时间线上:时间线保持的语音到语音翻译

英文题目:Learning Timeline-Preserving Speech-to-Speech Translation
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhisheng Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- David Harwath:The University of Texas at Austin
📌 核心摘要
读者需要理解的对象是配音场景下的语音到语音翻译,输入是一段英语语音,输出是汉语语音,难点在于译文不仅要意思正确,还要在同一条绝对时间轴上与源片的说话段、静默段和结束时刻对齐。常规做法只保证总时长接近,内部停顿仍可能错位,观众会感到台词抢了本该沉默的间隙。作者先从每条源语音中提取语音与停顿构成的支架,在局部时长预算下逐段翻译并合成汉语,再把合成段放回原时间窗口,得到与源时长完全一致的目标波形。在此数据上模型先学会带停顿标记的识别与翻译,再学会自然语速的语音生成,再学会贴着源时间线生成,最后用验证器给出的质量与时间反馈做强化学习细化。相对已有方法的区别是推理时不再依赖帧级发音控制或整体拉伸等后处理,时间结构由自回归生成直接产生。在4353条CoVoST2与GigaSpeech朗读和自发语音组成的英汉语音到语音翻译测试集上,与最强基线UniSS相比,Dur@2%从25.6%提高到61.5%,pause F1从0.118提高到0.550,COMET从0.784提高到0.788,保持在可比水平。结论只适用于短句英汉配音这类要求跟随源时间线的应用,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 小模型如何纠正色度模板的调性判断:DSP 引导的重排序器

英文题目:Deployment-constrained key estimation with a DSP-guided transformer reranker
评分:7.1/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Pardis Noorzad:Cue Labs
📌 核心摘要
本地音乐应用需在用户进程内随曲库导入分析整首歌曲音频并输出全局调性标签,流行与电子音色多变而安装体积与耗时预算极紧。两种色度前端分别以固定窗Goertzel滤波器组与常量Q变换提取帧级音高分布,经归一化平均为聚合色度后与24个大小调模板做皮尔逊相关并平均,得到24维相关分数向量。该向量与帧级色度序列共同进入小型编码器后端,序列经循环卷积与单层变换池化为24维序列对数几率,分数向量经单位矩阵初始化投影保留原始排序后相加,取最大值即为最终调性,使学习部分只做残差修正。循环卷积跨音高共享权重以保持移调结构,单位矩阵初始化使训练前对数几率已含原始打分,与取代分析器的做法不同。在密封的1000首FMAKv2子集上以三种子平均计,KL-FMAK的MIREX从KL-DSP的61.08提高到73.55±0.46,方向为高于基线。在同一密封的1000首FMAKv2子集上以三种子平均计,KL-FMAK的exact准确率从KL-DSP的52.30提高到67.07±0.65,方向为高于基线,同期同文件本地madmom参考的MIREX为74.16,KL-FMAK平均低0.61。该结论限于流行与电子训练域,古典声乐等更广语料尚未充分验证;在含ONNX Runtime口径下模型文件为115 KB、安装体积为76.7 MB、单曲增加延迟约0.32 ms。
🔗 开源资源
第三方资源:https://github.com/djpardis/trailmix/releases/tag/key-lime-paper-v1 — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.5281/zenodo.23866516 → https://zenodo.org/records/23866516 — 链接可访问(HTTP 200)
第三方资源:https://usecueport.com — 链接可访问(HTTP 200)
第三方资源:https://github.com/mixxxdj/libkeyfinder — 链接可访问(HTTP 200)
第三方资源:https://crates.io/crates/stratum-dsp — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 同一段音频里,话语与环境声打架时模型听谁的

英文题目:One Waveform, Two Stories: Benchmarking Speech-Acoustic Conflict in Audio-Language Models
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Wenbin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuheng Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Koichiro Yoshino:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段同时包含环境事件声和口语断言的录音,模型须依据环境证据回答语义、时间与空间问题,困难在于相容条件下答对可能只是复述口语,因此处理过程要求把环境证据、口语内容和提问分开衡量。论文构建的语音声学冲突评测集合先挑选环境录音并合成相容或冲突的口语断言,再将二者混合渲染为最终音频并保留无语音对照,该混合音频直接作为评测输入,以中性等提示提问后按声学正确率与跟随口语比例联合评分。语义部分判断事件是否存在或是什么事件,时间部分判断事件相对口语的前后关系与两个事件的先后顺序,空间部分判断声源方向与运动轨迹。评估引入跟随口语比例,它统计冲突题中选择口语暗示选项的比例,需要与声学正确率一起解读。在中性提示下,Qwen3-Omni的事件身份声学准确率在无语音条件下为84.6%,在冲突语音条件下仅为39.8%,冲突条件比相容条件低43.2个百分点;时间顺序无语音声学准确率为98.2%,冲突条件下为58.4%,冲突条件低于无语音条件。结论仅适用于合成断言与自由场无噪渲染及所测五款开源模型,空间结论限于Spatial-Omni的四通道输入,提示干预可能只降低跟随而不提升正确率甚至使时间状态任务下降,真实自发语音与实际环境尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. GigaSpeech 3:用弱标注把五种阿拉伯方言语音做成可训练的大语料
英文题目:GigaSpeech 3: Scaling Multi-Dialect Arabic Speech Recognition with Weakly Labeled Data
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Junzhe Liu:机构信息未能从 arXiv PDF 文本可靠映射
- Yujie Tu:机构信息未能从 arXiv PDF 文本可靠映射
- Yifan Yang:机构信息未能从 arXiv PDF 文本可靠映射
- Peng Wang:机构信息未能从 arXiv PDF 文本可靠映射
- Haoran Wang:机构信息未能从 arXiv PDF 文本可靠映射
- Guodong Lin:机构信息未能从 arXiv PDF 文本可靠映射
- Leyan Liao:机构信息未能从 arXiv PDF 文本可靠映射
- Chengquan Zhang:机构信息未能从 arXiv PDF 文本可靠映射
- Zhifu Gao:机构信息未能从 arXiv PDF 文本可靠映射
- Xiangang Li:机构信息未能从 arXiv PDF 文本可靠映射
- Qinyuan Cheng:机构信息未能从 arXiv PDF 文本可靠映射
- Xipeng Qiu:机构信息未能从 arXiv PDF 文本可靠映射
- Wei-Qiang Zhang:机构信息未能从 arXiv PDF 文本可靠映射
- Guoguo Chen:机构信息未能从 arXiv PDF 文本可靠映射
- Kai Yu:机构信息未能从 arXiv PDF 文本可靠映射
- Xie Chen:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
方言阿拉伯语语音识别要把日常口语转写成文字,输入是设备、话题和口音混杂的网络音频,输出是对应方言的文字,困难在于每种目标方言只有51.1小时至63.2小时人工转写,远不足以训练稳健识别器。论文先按频道收集并隔离方言匹配的网络语音,再为每种方言训练带识别偏置的自监督标注模型,用它转写未标注音频并经筛选形成初始弱标注库。沙特和叙利亚两个分区再经过四轮噪声学生训练提炼,得到过滤后的发布库,独立初始化的Zipformer只用弱标注音频文本对训练,多方言模型则拼合五种方言库加标准语数据并预测方言标识解码。与已有方法相比,工作把覆盖单位从语言下沉到国家层方言,并把自监督主要用于制造可复用的语料而非只改进单个模型。在GigaSpeechBench五种方言评测下,最终分方言模型宏平均词错误率为23.86%,相对覆盖五种方言的最强第三方完整系统28.62%降低16.6%。结论适用于论文划分的五个国家代表点和所用归一化条件,不保证更细地域变体或无方言标识的开放音频,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Antares-97/GigaSpeech3 — 链接不可用(HTTP 404)
第三方资源:https://huggingface.co/datasets/speechcolab/gigaspeech3 — 链接可访问(HTTP 200)
第三方资源:https://chenxie95-gigaspeech3-arabic-asr.hf.space — 链接可访问(HTTP 200)
第三方资源:https://open-ai-eval.com/ → https://open-ai-eval.com/voxlabel/login?next=/voxlabel/? — 链接可访问(HTTP 200)
第三方资源:https://github.com/MohammedAly22/qwencleo-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/MohamedRashad/Arabic-Whisper-CodeSwitching — 链接不可用(HTTP 401)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. VioTech:不用先切音符的小提琴演奏技法逐帧检测

英文题目:VioTech: Frame-Level Violin Playing Technique Detection with Multi-Scale Mixture-of-Experts
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ting-Kang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Vincent K. M. Cheung:机构信息未能在本次解析中与作者逐人可靠绑定
- Nan-Tien Lai:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Su:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
小提琴演奏需要识别拨弦、跳弓、泛音、连弓换弓等技法,输入是独奏录音波形,输出是每一帧对应的技法标签,困难在于起音柔和、运弓连续导致音符边界难以切准,而不同技法需要的时间范围从几十毫秒到数秒不等。系统先用转录分支从对数梅尔语谱图估计帧、起音和偏移活动,得到音符感知线索,再把冻结的 MERT 编码器多层表示交给多个时间尺度专家分别建模,最后按音色、发音和连弓三个任务分别加权合并专家并输出预测。数据集 VioTech120 提供 120 首真实独奏的音符级多标签标注,训练时与合成数据 MOSA-VPT 按 8 比 2 混合,弥补稀有技法样本不足。与已有方法相比的关键差异是不再先切分音符,并让路由按任务选择不同时长窗口。在 RWC 小提琴测试集上,VioTech 宏观准确率达到 90.49%,高于 VioPTT 的 80.04% 和 MERTech 的 52.27%。结论适用于跨数据集的瞬态技法检测,换弓点等稀疏长时事件表现下降,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 用两个高频专用判别器管住带宽扩展的上频段:HFSWO 解读

英文题目:High Frequency Safeguard and Weighted Objective Scoring Bandwidth Extension
评分:6.9/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tarikul Islam Tamiti:机构信息未能在本次解析中与作者逐人可靠绑定
- Sajid Fardin Dipto:机构信息未能在本次解析中与作者逐人可靠绑定
- Anomadarshi Barua:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音带宽扩展的输入是被截去高频的窄带语音,输出是补全高频后的宽带语音,缺失部分不可直接观测而呈一对多映射,浊音元音高频能量弱而清擦音突发集中,短时高频事件易被全局平均抹平,盲目放大则导致嘶声与过亮元音。HFSWO用复数谱双流生成器先恢复幅度与相位,生成波形经短时傅里叶变换分帧计算帧级高频能量占比,再送入高频保护判别器以软约束惩罚持续过高占比而放行短时突发。加权目标评分判别器接着对重建高频计算频谱平坦度、归一化质心与85%滚降,并学习凸组合评分以监督噪声感、亮度与频谱扩展形态,与前者互补约束高频出现位置与形态。与AP-BWE等只做全局真假判别不同,该设计显式区分短时合法高频与持续过增益。在VCTK英语4→16 kHz干净评测下,HFSWO的NISQA-MOS为4.32,高于AP-BWE的3.86,该指标越高越好。该优势覆盖多说话人与英法多语言干净及带噪评测,但在7人说话人层配对检验中p=0.469未达显著,超参数尚未做数据驱动标定。原文披露训练推理成本,在4→16 kHz复杂度统计下HFSWO参数量18.30 M低于AP-BWE的72.07 M约74.6%,MAC与FLOPs减少约63.6%,实时因子远小于1,但单轮训练时间由17分钟增至20分钟。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. ASR 编码器已经知道多少韵律:轮流结束检测的三重检验

评分:6.8/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Rini Sharon:机构信息未能在本次解析中与作者逐人可靠绑定
- Kadri Hacioglu:机构信息未能在本次解析中与作者逐人可靠绑定
- Andreas Stolcke:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
对话系统需在用户真正讲完时回应,研究判断每帧是否为轮次结束的检测器,输入为电话对话音频、输出为每帧结束概率,轮内停顿与轮末静默难分使固定阈值易误判。论文把同一音频送入两条支路,一路提取41个手算韵律特征,一路读取流式Zipformer四个深度表示,两路单独与拼接送入同一固定检测器,以拼接相对编码器单独的增量衡量韵律价值。在内部电话数据collar W=10逻辑回归评测下,以交叉熵增益Δbits为指标,拼接相对编码器单独的增量在原始滤波器组上为+0.053比特每帧,进入第一层堆栈后降至+0.021比特每帧并在深层保持低位。在同一内部数据的短窗重建评测下,以决定系数R2为指标,中层达0.53,高于最终层的0.20,与增量价值曲线反向对应。在collar W=10逻辑回归90%召回的操作点上,以误报率为指标,原始输入拼接韵律从0.71降至0.60,而最终层仅从0.356降至0.330且校正后真实增益只剩0.011。与把韵律当编码器外独立补充的做法不同,论文表明增益进第一层堆栈后塌缩且残余多为说话人信息,该模式在wav2vec2、Whisper与公开CASPER数据上复现。结论只适用于英语电话带宽和collar边界帧评测,未验证完整流式端点延迟,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 多语 TASU:只用文本先对齐,再用少量语音校准

评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chenghao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jing Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Xi:机构信息未能在本次解析中与作者逐人可靠绑定
- Shuai Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多语言语音识别需要把语音信号转写为对应语言文字,困难在于配对语音文本稀少且语言间极不均衡,难以为每种语言单独训练对齐模块。论文沿用冻结的OWSM-CTC编码器输出的50002维后验分布作为八种语言共享的接口,后验分布指编码器在每一帧对词表符号和空白符的概率分布,经空白帧过滤和重复合并后交给投影层和Qwen2.5-1.5B-Instruct完成识别。训练比较真实语音提取的后验、按规则扰动文本的启发式模拟后验、多语言模拟器从文本预测的后验,推理统一用真实语音后验,两种文本路径都不需要训练阶段语音输入。结合低秩适配后,真实后验训练把八语言混合词错率从独立OWSM-CTC基线的10.08%降到8.21%,八种语言全部改善;学习型模拟达到10.51%,明显好于启发式模拟,但仍落后于真实后验。文本初始化再用约九分之一完整配对数据做一轮适配,可以达到9.19%,为低资源语言提供了可行的训练范式。该范式要求模拟器训练覆盖目标语言,把波兰语排除在模拟器训练外后其词错率从16.38%恶化到80.47%,其余七语基本不变,仅训练投影层时波兰语也会退化,说明模拟与真实后验失配是主要失败来源。结论目前仅在八种Multilingual LibriSpeech语言上验证,未验证更多语言和完全未见语种的迁移;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 不用报方位也能挑出目标说话人:相对位置提示的目标语音提取

英文题目:Spatially-Guided Speaker Extraction Based on Relative Position Cues
评分:6.7/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Aviad Eisenberg:机构信息未能在本次解析中与作者逐人可靠绑定
- Shlomo E. Chazan:机构信息未能在本次解析中与作者逐人可靠绑定
- Sharon Gannot:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多人同时说话时只需要取出其中一人,难点在于用一段可靠又好获得的提示告诉系统取哪一个。注册语音可能没有或与环境不匹配,精确到达方向在混响、噪声和移动下难以估计,固定房间分区在两人同处一区时无法区分。论文引入相对位置提示(Relative Position Cue,RPC),把目标描述为与干扰说话人之间的离散关系,例如更远、更近、偏左、偏右及其组合,两人时8种,三人时按远近与左右组合成9种。处理上多通道混合先经短时傅里叶变换得到时频表示,该表示作为声学特征送入分离网络。整数提示索引查可学习嵌入表得到条件向量,该向量再注入分离网络调制其逐层处理,使网络只重构指令指定的说话人在参考话筒处的混响成分。与已有做法的关键差异在于分界面不固定,完全由混合中各声源位置决定,不需要绝对方向或距离数值。在四话筒双人仿真集的大角度大距离测试集(i)上,基于SpatialNet的RPC模型SI-SDR为14.2 dB,超过同架构分离模型SpatialNet的13.2 dB。结论适用于说话人相对关系在句内保持、且角度差超过10度或距离差超过0.5 m的重叠段,不覆盖两者都过近的情形,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://aviad3189.github.io/RPC-extraction/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. 静音时省算力、听人说话时并行算:ReFrame 如何复用全双工对话的沉默结构

英文题目:ReFrame: Silence-Aware Compute Reclamation for Full-Duplex Speech Models
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zheng Zhou:Tsinghua University
- Guanyi Chen:The Hong Kong University of Science and Technology (Guangzhou);ScaleX-IO
- Jing Wei:Sun Yat-sen University;ScaleX-IO
- Haoyuan Liang:Tsinghua University
- Jian Zhang:The Hong Kong University of Science and Technology (Guangzhou);ScaleX-IO
- Haohuan Fu:Tsinghua University
📌 核心摘要
全双工语音模型需要在固定帧率下同时接收用户音频并生成智能体音频,每帧都要执行完整的跨帧与帧内生成,静默期间也持续占用计算。论文把输入表示为逐帧到达的用户音频帧、上一帧智能体反馈和循环状态,输出是当前帧的文本预测与多层音频记号,难点在于未来用户输入不可预知且多路音频记号之间存在依赖。互静默推测负责在双方持续静默时提出多帧静默延续并做块验证,只提交通过文本与表示稳定性检查的前缀。聆听帧折叠负责把已经到达的多帧用户输入折叠为一次带掩码的跨帧运算,并用一次成帧的帧内生成产生候选音频,再保留与原有反馈一致的前缀并修复后缀。帧预算再投资把省出的帧内时间切分为可恢复的块,用于推进检索与语言模型查询并在条件满足时注入引用,其与已有推测解码的区别在于验证对象是状态特定的静默延续而非任意文本延续,且输出顺序由持久队列维持。在NVIDIA A100-40GB上运行完整1225段交互FDBench的配对比较中,联合执行相对逐帧稠密执行的Time saved指标对应GPU执行时间减少18.80%至31.01%,Text指标的全位置文本一致性在三个Moshi检查点为99.328%至99.446%、另两个模型为100%轨迹一致。在采用Moshika-RAG并搭配相同外部参考编码服务的500个HaluEval问题评测中,联合执行相对逐帧稠密执行的Correct generated spoken answers指标从86个提高到205个。结论适用于静默占比高且静默表示稳定的全双工交互,在打断密集时收益下降;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 同一段用户录音考四种本事:实时语音系统的抢话、答题、耳语与记性
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Richard Yucheng He:机构信息未能在本次解析中与作者逐人可靠绑定
- Chen Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yihang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Tairan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Baodong Cao:AveraLabs
📌 核心摘要
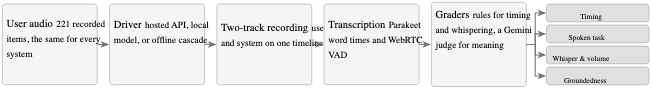
实时语音系统需边听边说,难点在于何时等待、插话、应答与让出话轮,以及所说内容是否与对话已建立的事实一致。InteractionBench先以各系统专属驱动实时播放同一批合成用户录音,使各系统听到相同的用户侧输入,其输出与用户轨在客户端同一时间轴上双轨录制,保留可对齐的对话过程。双轨录音再经Parakeet词级转写与WebRTC端点检测得到词时间戳,时间戳与录音一同进入评分器:口头任务的话轮控制动作按规则预先固定、预期答案取自脚本对话,timing与低声按时序与声学规则打分,语义与超20轮对话的groundedness交由Gemini judge判定,并保留录音、时间轴与判定理由。评测共13个场景、每系统221条、七系统合计1519次可评分运行。在同一录音与同一双轨计时评测下,离线级联的口头任务准确率为38/50,高于六个全双工系统中最高的Gemini Live的36/50。在同一计时口径下,GPT-Live的会话timing总分为86%,高于离线级联的49%,六个全双工系统内部timing总分与口头任务总分呈正向秩相关,Spearman相关系数为0.83。在低声产生10项评测中,Gemini Live以8/10高于其余系统至多2/10,且所有系统在要求窗口内的语法纠正均为0/10。结论仅适用于合成英语、无噪声混响与少数预设音色的录制条件,托管系统计时包含网络延迟,语义判定依赖与被测同族的模型且部分阈值为规范性选择;原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/avera-labs/InteractionBench — 链接可访问(HTTP 200)
第三方资源:https://drive.google.com/drive/folders/1C7huPcVMAiF8GFN6cg76in0dN8yYWk_w — 链接可访问(HTTP 200)
第三方资源:https://avera-labs.github.io/InteractionBench/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 分布麦克风网络如何在弱 GNSS 大面积区域实时检测并定位枪声

评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.5/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Dengke Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Bodhibrata Mukhopadhyay:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohamed-Slim Alouini:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
反盗猎需在全球导航信号受限的大面积野外连续监听枪声并给出位置,难点是设备便宜省电、误报少、混响和低信噪比下时延估计稳、野外部署存在朝向偏差。每个部署点为含6个麦克风的阵列单元,单元内先筛出脉冲事件,筛出的事件段送入TinyML分类器确认是否为枪声,确认后的枪声帧再经改进互相关加权与功率加权平均估计单元内到达时间差。各单元经LoRa只传时延类紧凑信息,网关端由到达时间差估计各单元到达方向并融合得全局坐标,部署校准修正旋转偏差。在248米距离60秒录音的声音检测评测中,两种方法均检出32个事件,以误报数和检出准确率为指标,所提方法全部事件仅1次误报、准确率约96.9%,误报低于参考文献[17]方法的每事件最多3次。在扬声器回放枪口波主导的外场独立连续音频流评测设置下,138个枪声与140个非枪声事件上端到端事件识别链准确率为84.9%、Matthews相关系数为0.70。在用录制枪声加0.01秒延迟并在不同信噪比加噪的时延估计仿真中,以延迟均方根误差小于2×10⁻⁵秒为门限,所提eGCC在1分贝达标,所需信噪比低于GCC-PHAT-ργ的5分贝和加权GCC-PHAT的6分贝。在4,985至49,063平方米多覆盖面积定位评测中,以估计与真值间均方根误差为指标,所提方法平均比SUM-LSS低21.9%,结论报告约25,000平方米上误差为6.34米,只适用于扬声器回放枪口波主导录音;端侧识别在Spresense上以3秒窗口实测90毫秒加45毫秒,归一化到每1秒为45毫秒,角估计在Intel i5-12600k处理器32GB内存PC上MATLAB 2024b实现约需8.6毫秒,与SCO相同。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 共享编码器的序列到序列修正如何改善 EEND-VC 的说话人归属

英文题目:Sequence-to-Sequence Refinement for EEND-VC Diarization with a Shared Encoder
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ruoyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jun Du:机构信息未能在本次解析中与作者逐人可靠绑定
- Weixin Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yannan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要理解的对象是一段长录音中谁在何时说话,困难是局部窗口内切分正确但跨窗口聚类后全局身份仍会张冠李戴,重叠和说话人数变化使问题更难。处理过程是先用局部模型给出匿名说话人活动并聚类成全局先验,再用说话人条件解码重新判断每个候选人在每帧是否说话,最后用先验约束的排序修正身份和重叠人数。局部切分头与精修头共用一个自监督声学编码器,各自学习不同的层混合权重,冻结编码器时只训练精修分支,联合训练时同时更新编码器和两个头。在包含八个领域的评测中,w2v-BERT 2.0 前端下冻结特征精修把宏观说话人分离标注错误率从 12.35% 降到 12.08%,主要来自说话人混淆下降,联合系统进一步降到 11.90%,增量主要来自检出误差下降。结论适用于会议、访谈和多说话人评测集合,但在无标注重叠的 RAMC 上精修曾使指标变差,在 AIS 上联合系统也变差。冻结特征精修使系统实时率增加约 15%,联合训练的额外成本原文未披露为可核对数字。
🔗 开源资源
- 第三方资源:https://github.com/liyunlongaaa/NSD-MS2S — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. 能听见却没听进去:语音大模型如何处理用户的不耐烦

英文题目:Voice-Native LLMs Hear Frustration but Do Not Listen to It
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Hanjun Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuhan Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanan Salam:New York University Abu Dhabi
📌 核心摘要
读者需要理解的对象是直接听语音的语音原生大模型,输入是用户读出的题目音频,输出是解题答案,困难是用户沮丧可能藏在措辞里也可能藏在语气里,只看答案不变无法区分模型是真正包容还是根本没有听出语气。论文把同一道题做成四种录音,分别是中性措辞加中性语气、中性措辞加沮丧语气、沮丧措辞加中性语气、沮丧措辞加沮丧语气,固定题目答案和说话人,只改变两个通道。处理过程先用独立的情感识别器和听众检验沮丧语气确实存在,再用语气探针问模型听出中性还是沮丧,最后在同一批录音上计任务准确度变化。相对已有只看输出不变的方法,关键差异是引入表达、感知和利用三段划分和四个象限。与已有方法的差异带来实际意义,即把措辞通道的真正稳健和语气通道的未感知不变分开。在VoxAffect共353题中抽取50题的中性与沮丧语气15秒片段的同一组二选语气判断上,10名听众综合判断正确率为65.3%,高于8个模型48%到50%的正确率,模型至多把任一语气中4%的片段标为沮丧。结论只适用于温和合成沮丧和单轮客观题,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/Astarojth/hear-not-listen — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. Ananas:用低成本单片机网络做分布式空间音频
英文题目:Ananas: A Networked Audio System for Distributed Spatial Audio Applications
评分:6.4/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.5/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Thomas Rushton:机构信息未能从 arXiv PDF 文本可靠映射
- Romain Michon:机构信息未能从 arXiv PDF 文本可靠映射
- Tanguy Risset:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
大型空间音频装置难以普及的原因是多通道声卡昂贵、同步与部署需要专门知识。该任务输入是工作站产生的多个单声道声源或高阶Ambisonics编码通道,输出是分布在房间各处的扬声器信号,难点是在廉价硬件上让所有节点采样时刻对齐并按时发声。系统先由音频服务器把输入写入先进先出队列并打包成组播数据包发往网络,再由作为时间基准的开发板统一计算机声卡时钟与网络精确时钟,然后由各节点根据精确时钟微调音频锁相环实现采样率一致,最后由各节点按包内时间戳等待到预定时刻再播放并执行局部分布式渲染。与侧重低延迟合奏的JackTrip、Sonobus等系统不同,该工作把同步精度作为首要目标,并用开源硬件与熟悉的工具降低使用门槛。在4个节点播放每秒脉冲并用逻辑分析仪测量I2S输出上升沿的1小时测试中,以组内瞬时极差均值为同步指标测得约为80ns,低于AES指南对48kHz下约1μs参考帧5%的要求,该结论限于以太网局域网内16帧小包、44通道以内波场合成与五阶以内Ambisonics设置,包乱序、网络拥塞和更大阵列下的表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://sonobus.net — 链接可访问(HTTP 200)
第三方资源:https://juce.com — 暂时无法访问
第三方资源:https://reaper.fm → https://www.reaper.fm/ — 链接可访问(HTTP 200)
第三方资源:https://www.audinate.com/meet-dante/what-is-dante → https://www.getdante.com/meet-dante/what-is-dante/ — 链接可访问(HTTP 200)
第三方资源:https://hal.archives-ouvertes.fr/hal-03153709 → https://hal.science/hal-03153709 — 链接可访问(HTTP 200)
第三方资源:https://asa.scitation.org/doi/abs/10.1121/1.405852 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 双耳语音既要听得清,也要定位稳:SPHERE 如何把九个听感一次评完
英文题目:SPHERE: A Multi-Attribute No-Reference metric for Binaural Speech Quality And Spatial Fidelity
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Bala Manikya Prasad Puram:机构信息未能在本次解析中与作者逐人可靠绑定
- Chandan K A Reddy:机构信息未能在本次解析中与作者逐人可靠绑定
- Artem Dementyev:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
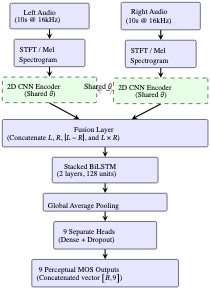
双耳语音要同时保留语音清晰度和声像方向,左右耳信号很小的时延与级差变化就会引起声像漂移或听感劣化,单通道语音指标无法反映这类空间失真。论文输入10秒立体声片段,输出语音失真等九个1.0到5.0分的主观维度预测,覆盖总体质量、听声努力、响度舒适、声像定位、空间稳定、干扰性杂音和背景噪声行为。处理过程是把左右声道变为时频表示后送入卷积编码器提取谱与空间线索,再用双向循环结构建模时间上下文并汇聚成固定向量,最后由九个独立回归头同时输出各维度分数。孪生结构对左右声道使用参数共享的编码器并显式拼接差值与乘积项,用对称约束强调耳间一致性,还可用预训练空间向量增强梅尔谱基线。在2119片段防泄漏验证集上,非孪生梅尔谱加空间向量配置的九属性平均片段级皮尔逊相关系数为0.706,高于纯梅尔非孪生的0.702。在同一验证集按六个增强条件取均值后的系统级比较中,纯梅尔孪生的九属性平均系统级皮尔逊相关系数为0.770,高于纯梅尔非孪生的0.715。在同一2119片段验证集的总体质量片段级皮尔逊相关系数上,梅尔谱加空间向量两种编码器均为0.773,高于单通道基线按声道打分平均的0.284。结论适用于耳机回放和语音增强后的双耳语音横向比较,对瞬态局部缺陷和未见房间与设备的泛化仍需谨慎。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. ResMamba:用双路卷积加状态空间模型做音乐流派分类

英文题目:ResMamba: A Dual-Path Convolution-Mamba Model for Music Genre Classification
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yingyu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Pu Qu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音乐流派分类要把约30 s音频判为blues、classical等10类之一,输入是128×1292梅尔语谱图,难点是同时保留局部纹理和谐波细节,并关联相隔数十秒的段落变化。论文把完整语谱图送入ResNet风格四阶段骨干,每阶段用可替换残差块处理,输出经多尺度融合头分类。MambaWrapper先用1×1卷积映射通道并展平为序列,送入单向MambaVision混合器做全局建模后再恢复空间形状,高分辨率阶段用8×8软窗口限制扫描长度,低分辨率阶段做全图扫描。双路径ConvMamba块让选择性状态空间分支与两层3×3卷积分支并行计算,再用可学习的1×1卷积拼接融合,多尺度头聚合四个阶段特征,该设计区分时间轴长程叙事和频率轴局部谐波并保留卷积局部先验。在GTZAN曲目级5折交叉验证上,以平均准确率计完整模型为88.99%±1.58%,超过同表最强已发表方法的88.64%。在FMA-Small曲目级分层10折交叉验证上,以平均准确率计ResMamba为64.52%±1.88%,高于同协议从零训练ResNet-18基线的59.95%±1.81%。在FMA-Medium官方艺术家级划分上,以准确率计ResMamba为65.75%,超过同划分手工特征SVM基线的63%。三处结果均从零训练且无预训练、外部数据与数据增强,原文未披露训练、推理或部署成本,结论目前只在GTZAN、FMA-Small和FMA-Medium的音频内容内验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 用可重复的任务检验音乐期望模型:MEX 基准套件解读

评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Mathias Rose Bjare:机构信息未能在本次解析中与作者逐人可靠绑定
- Augustin Bouquillard:机构信息未能在本次解析中与作者逐人可靠绑定
- Giorgia Cantisani:机构信息未能在本次解析中与作者逐人可靠绑定
- Seung-Goo Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Stefan Lattner:机构信息未能在本次解析中与作者逐人可靠绑定
- Gerhard Widmer:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文要检验的对象是听众对音乐后续发展的预期,难点在于预期不可直接观测,只能看重复后信息量是否下降、指标峰值是否对齐结构边界、音频估计与符号估计是否一致以及能否预测脑电反应。论文把上述检验整理为 Musical Expectation(MEX)基准套件,输入为音频算出的随时间变化的一维信息动力学指标,输出为每个任务的聚合分数。处理过程是先用自回归音频模型逐帧估计瞬时惊奇与不确定性对应的信息量与熵,再按任务元数据做对齐与统计,基线先把音频压缩为 Music2Latent 表示再用 Transformer 预测下一帧分布。与只看保留集预测误差的传统做法相比,MEX 要求同一指标同时通过感知与神经证据检验。在合成民谣数据集上的 IDyOM 一致性任务 SY 跨音色综合设置下,以与 IDyOM 估计的相关为指标,扩散模型 DIF 在噪声水平 0.3 时的瞬时惊奇相关为 0.523,高于 GIVT 基线的 0.390。在 SALAMI 标注上的重复降低任务 RE 小写层级首次重复设置下,以片段平均信息动力学差值为指标,DIF 在噪声水平 0.5 时熵平均下降 -0.134,低于 GIVT 的 -0.068,方向均为重复后下降且在 5% 水平显著。结论适用于所用合成民谣、SALAMI 结构标注和 18 首人声旋律脑电数据,SALAMI 音频获取不便限制了完全复现。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/musicperceptmodeling/mex — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/musicperceptmodeling/mex → https://huggingface.co/datasets/MusicPerceptModeling/mex — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 回放合成语音为什么难检:ReplayFactor 的双属性检测解读

英文题目:ReplayFactor: Replay-Aware Dual-Attribute Learning for Practical Speech Deepfake Detection
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Miao He:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiayi Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhongjie Ba:机构信息未能在本次解析中与作者逐人可靠绑定
- Peng Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxi Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Junjie Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Changhao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Liu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要判断的输入是一段可能经过扬声器播放再被麦克风录制的语音,输出是该语音属于真实、合成、回放真实、回放合成中的哪一类,难点是回放引入的设备与环境失真会改变或掩盖合成痕迹,且合成模型与回放组合变化大。方法把四分类标签拆成来源属性与回放属性,来源属性区分人声与生成语音,回放属性区分是否经过物理回放,使同一属性在另一属性变化下仍能对齐。输入先经自监督编码器与图后端得到共享表示,再分出两个分支,来源分支直接用于人声与生成语音判别,回放分支额外融合声学先验以补充高频与通道失真线索。训练同时优化四分类主任务、两个二分类辅助任务和两个空间上的监督对比目标,对比目标把相同属性的样本拉近。相对已有工作,差异是不只做数据增强或回放仿真,而是显式增强回放证据并约束属性一致性。在 EchoFake 开集上,相对 EchoFake 报告的基线,宏平均 F1 从 60.99% 提升到 76.44%,等错误率从 11.86% 降到 3.05%。结论适用于英文开集与中文多设备评测中的相对提升,但跨数据集到 ReplayDF 的绝对分数仍然偏低。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://huggingface.co/datasets/Ahola/ReplayFake-CN — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. Spatial DJ:在任意音箱布局上现场校准与实时空间混音

英文题目:Spatial DJ: Spatial Audio Control for Arbitrary Loudspeaker Layouts
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Anastasia Geleta:机构信息未能在本次解析中与作者逐人可靠绑定
- Margarita Geleta:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
待解决的输入是事先未知、非对称且文档不全的演出场地扬声器布局,期望的输出是能直接在该场地下发声的空间混音。难点在于场景描述、房间坐标与渲染路由往往脱节,创作者只能在屏幕或耳机代理上制作,无法在真实扬声器前迭代。系统先用头戴式增强现实把虚拟扬声器标记对齐到实体扬声器,得到房间坐标系下的三维布局并持久保存,桌面与头戴界面把每个声音对象的位置与扩展半径等轻量状态发往后台。后台按距离计算每只扬声器的高斯权重并做恒定功率归一化,区分点声源对象与均匀分布的环境对象后混成多通道输出,同一套对象表示与增益规则复用于不同场地,相对固定对称布局的幅度摇移把布局当作可变输入。在18只扬声器房间18名参与者的试听中,运动清晰度指标下双环绕条件估计均值6.61±0.48高于全漫射基线4.44±0.48,相差2.18点,为控制乐曲与试次顺序后七点量表上的估计均值。结论限于该房间与短时试听,双对象同转相对单对象环绕未带来显著额外优势,长时间聆听是否引起不适尚未验证。在块大小256、44.1千赫兹的6164次更新基准中,控制延迟指标中位值为8.07毫秒,四分位区间5.07至11.00毫秒。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 麦克风位置变了还能按角度区域提取说话人吗
英文题目:Microphone Geometry Aware Regional Target Speaker Extraction
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shitong Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Niki Trigoni:机构信息未能在本次解析中与作者逐人可靠绑定
- Andrew Markham:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
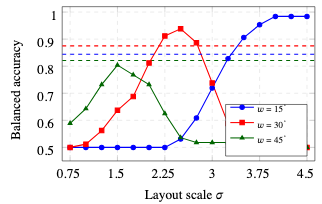
区域目标说话人提取要求从多通道混响混合声中取出方位角落在给定区间内的全部说话人,区间外说话人与噪声应当被抑制。难点在于麦克风数量与几何变化会改变通道间相位关系,固定阵列训练的模型难以迁移,区间边界附近的保留与去除也容易混淆。该工作输入任意数量紧凑阵列的短时傅里叶变换、麦克风坐标与目标方位区间,输出目标区间内混响语音。编码前端先对每通道做二维卷积得到时频特征,再把阵列中心化坐标编码后相加形成几何感知特征。同一频率与时间点的多通道特征作为麦克风词元做自注意力交互,随后由每频率可学习查询做注意力池化,得到与通道数无关的聚合表示。聚合表示连同区域中心与宽度编码进入提取主干,输出复数谱并经逆变换重波形,训练时另有一路重建以输入几何中心为基准的参考四通道信号。在四通道阵列的仿真评测中,所提方法以SI-SDRi计超过几何感知基线5.1 dB,在四面体阵列的仿真评测中以同一指标低于四面体专用模型0.57 dB。结论适用于仿真训练的紧凑阵列与两种实测阵列,边界分辨在小孔径下仍然偏弱,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 音频少、视频多时怎样把两个专家教师一起蒸馏给同一个音视频学生

英文题目:OmniOPD: Stable On-Policy Distillation for Joint Audio-Video Generation
评分:6.2/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zihao Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jie Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hexin Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xueyang Fu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zheng-Jun Zha:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
联合音频视频生成要求同一模型输出时间对齐的声音与画面,难点是两种模态占用词元数量差异大,音频获得的监督稀疏,优化过程波动大,还会通过共享参数干扰视频质量。OmniOPD 让学生沿自身生成的联合轨迹接受两个冻结的专用教师的指导,音频教师提供音频目标,视频教师提供视频目标,学生同时拟合两类目标以继承两种能力。与直接加大音频奖励权重不同,该方法用更干净的视频上下文改善音频目标质量,用多组采样扩大音频覆盖,再按局部失配程度降低不可靠步骤的权重。附录把一步转移分布差异转化为干净样本预测误差,说明两者只差一个随时间变化的系数,实际回归目标省略该系数后成为一种替代目标。在 JavisBench 上,以 LTX-2.3 为基线时,OmniOPD 视频质量得分为 3.347,基线为 2.714,音频质量得分为 5.449,基线为 5.252,同步指标 DeSync 从 0.584 降至 0.457,数值越低表示同步越好。结论适用于以 LTX-2 双流联合模型为底座、已有音频与视频专用教师的蒸馏场景,跨架构与长时生成的稳定性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 互补才有意义时,如何分配发送符号:SC-DJSCC 解读

英文题目:Synergy-Aware Symbol Allocation for Distributed Semantic Communication
评分:6.1/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fan Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Youzheng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhijin Qin:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoming Tao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
分布式语义通信要让空间分离的两个终端各自独立编码、再由融合接收端完成同一推理任务,每个终端只看到局部视图,完整语义只有在两侧消息同时到达接收端后才出现。在上行符号预算收紧时,按终端单独计算率失真代价的压缩会优先保留单端已有判别力的坐标,而把必须联合才有效的互补坐标提前关闭。论文提出的SC-DJSCC在训练目标中增加一项作用在均衡后消息上的协同奖励,用它补偿同时保留一对互补符号的代价,并把奖励梯度回传到本地符号门控。均衡后消息构造高斯Gram矩阵,再用二阶矩阵Rényi熵计算联合相对边缘与标签的交互超额,得到0到1的有界奖励;符号门控用hard-concrete松弛计入率代价,部署时冻结为二进制掩码并移除奖励分支。与按终端压缩的可变长深度联合信源信道编码和分布式信息瓶颈方法不同,该奖励在均衡后计算并直接作用于占用信道使用的门控,因而与链路可靠性耦合。在AWGN 0 dB下,以92%准确率为目标时AV-MNIST所需负载符号从对照的54.1降到38.7,节省28.4%,以82%宏F1为目标时PAMAP2从45.8降到30.7,节省32.9%;在40个负载符号且不重训的3GPP TDL-C衰落下,相对门控对照的增益从9 dB的3.0个百分点扩大到-6 dB的6.2个百分点。该结论只在两终端上述信道设置下实测成立,单类别批次奖励置零且链路恶化拉低保留阈值时互补符号仍可能被剪除,三端以上只有阈值公式而无实验;部署成本与门控基线相同,原文报告为0.42 M参数、12.8 MMACs和RTX 4090上0.41 ms的单样本延迟。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 同一组滤波器如何留下可学习的相位痕迹:GDBack 群延迟后门解读

英文题目:GDBack: A Group-Delay Backdoor Attack on Speaker Identification via Analytic All-Pass Filtering
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Bicheng Xiong:机构信息未能在本次解析中与作者逐人可靠绑定
- Tao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenhui Cui:机构信息未能在本次解析中与作者逐人可靠绑定
- Zedong Xing:机构信息未能在本次解析中与作者逐人可靠绑定
- Qien Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiping Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Rubing Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tsong Yueh Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是封闭集说话人辨认,输入为一段语音,输出为登记说话人中的身份编号,困难在于后门触发既要跨样本稳定可学,又不能明显改变音质与语义。论文提出的方法先用同一组解析全通滤波器对选中的训练语音做滤波,再把滤波后语音改标为目标说话人,victim 按常规流程训练后,推理时对非目标语音施加相同滤波即触发目标判定。与 PhaseBack 直接改写选定时频相位值、StealthPhase 粘贴参考语音相位模板不同,该方法只叠加相同的随频率变化的相位响应和群时延,输出相位仍随原语音变化。在 LibriSpeech 与 VoxCeleb1 上对 ECAPA-TDNN、x-vector 和 RawNet3 的六组评测中,同一组参数的平均攻击成功率达到 97.00%,高于 PhaseBack 的 90.58% 与 StealthPhase 的 76.09%,且良性准确率与干净模型相差至多 1.54 个百分点。结论适用于 5% 投毒率与数字域评测,强混响、强背景干扰与空中播放后效果下降且与架构有关。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. 用一个量子混沌判别器做语音带宽扩展:Q-BWE 解读

英文题目:Q-BWE: Quantum Chaos-Informed Speech Bandwidth Extension
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tarikul Islam Tamiti:机构信息未能在本次解析中与作者逐人可靠绑定
- Sajid Fardin Dipto:机构信息未能在本次解析中与作者逐人可靠绑定
- David Vergano:机构信息未能在本次解析中与作者逐人可靠绑定
- Luke Baja-Ricketts:机构信息未能在本次解析中与作者逐人可靠绑定
- Anomadarshi Barua:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
带宽扩展要从带限窄带语音恢复缺失的高频内容,难点在于同一个低频内容可以对应多种合理的高频细节,只用平均谱误差训练容易生成过平滑、丢失瞬态和谐波结构的波形。本文方法先用双流 Lattice-ConformerNeXt 生成器同时预测对数幅度残差和相位向量,再用多分辨率幅度判别器、多分辨率相位判别器和一个五量子比特混沌判别器在训练时提供对抗与特征匹配反馈,推理时只保留生成器和窄带条件模块。混沌判别器从 26 维语音动力学特征库中自动选出 5 个互补特征,经过归一化和有界角度编码后送入两层数据重上传电路,用正反受控非门环产生纠缠,再输出 31 维测量图和一个分散度统计量用于打分和匹配。生成器另有特征调制条件器和升余弦掩膜,前者按输入的能量、质心、平坦度、通量和相位组织调整通道,后者把可信低频、过渡带和缺失高频分开处理。在干净 VCTK 英语 8 到 16 kHz 任务上,本文方法感知语音质量评估得分 3.93,优于 CIS-BWE 基线的 3.72,训练参数总量从 33.5M 降到 19.4M,约为 1.72 倍压缩。结论适用于所测的英语与法语多说话人干净和受损条件,量子电路宽度增大时仿真代价按指数增长,本文未验证量子硬件优势,推理延迟反而略高于基线。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. Omni-Life:日常实时助手何时该说话、何时该沉默

英文题目:Omni-Life: Benchmarking Omnimodal Real-Time AI Assistants in People’s Daily Lives
评分:6.1/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Mengze Hong:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziwei Shang:机构信息未能在本次解析中与作者逐人可靠绑定
- Di Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zijian Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Liang Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongyu Shan:机构信息未能在本次解析中与作者逐人可靠绑定
- Robin Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Minlong Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiqiang Kou:机构信息未能在本次解析中与作者逐人可靠绑定
- Jia Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Di Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Chen Jason Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
日常实时助手面对连续视听流,输入为站在固定或移动设备视角的视频与环境声加一条常驻任务说明,输出为是否在当前时刻发声以及发声内容,难点是干预条件散落在时间中且多数时间要求保持静默。论文先把求助需要整理为感知、认知、行动、交流相关四类,再为每个生活场景指定判断依据与五种期望行为,依据是否可从画面证据得出决定标注干预或静默。随后用受控合成复现危险与边界情形并配对改变关键条件,用真实视频补充自然变化,两类来源共用同一时间标注协议。流式评测要求模型边看边决定开口时机,问答评测则在给定截断点考查内容与时机选择,两者分离知道答案与持续履职的差距。相对只测流式问答或原子交互能力的已有基准,关键差异是把人群、场景、设备与时间窗口绑在一起,并把完全静默视频作为必测项。与12组主流实时全模态配置比较,在400个视频流式评测的290个需干预视频上,流式评测指标Full Correct方面MOSS-VL为4.48%,高于Gemini 3.8 Live的3.79%。结论只适用于所收录的任务分布与标注窗口,合成显性事件、单次短时评测与客户端接收时间计量都限制向长期部署的推广。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/todayai-labs/omni-life — 暂时无法访问
第三方资源:https://seed.bytedance.com/en/models — 暂时无法访问
第三方资源:https://deepmind.google/models/model-cards/gemini-3-8-audio — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 把 32 位浮点音频无损装进 FLAC:对齐、拆分与回退是如何分工的
英文题目:8 Bits to End the Loudness War: Lossless Floating-Point Compression for Audio Streams
评分:6.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Ali Heydari:Department of Computer Engineering, Sharif University of Technology
📌 核心摘要
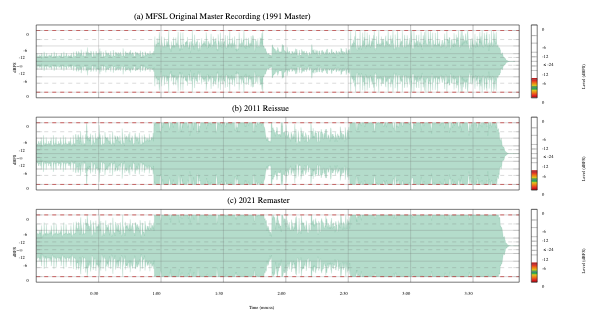
输入是 IEEE 754 单精度浮点表示的音频流,输出是可无损还原的 FLAC 压缩文件,难点在于直接对浮点比特做线性预测会放大尾数噪声并破坏残差分布。论文先把一帧内样本按指数轨迹对齐到统一整数寄存器,再按高低位切分为两个子帧,分别处理相关声学成分和不相关噪声成分,最后在帧级别决定保留对齐模式还是回退到指数与尾数分开编码。编码端上子帧走常规线性预测与 Rice 编码,下子帧直接按位存放,解码端按帧头参数重组整数并恢复浮点指数。相对直接把浮点比特送入整数编码器的做法,该方法避免了跨 2 的幂边界时的突变残差,也避免把均匀噪声送入 Rice 编码器导致参数膨胀。在 Tier 3、24 位、高于 48 kHz 的高分辨率音乐条件下,双级 ADC 采集素材的压缩率为 44.1%,复杂工作站母带的压缩率为 60.2%,指标方向均为越低越好,前者与常规 24 位整数 FLAC 的文件体积相当。结论适用于包络连续、帧内动态范围有限的音乐素材,极端动态、大量离群值或非有限浮点值会触发回退,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. 有人说话也有人插话时,大脑究竟在跟谁:注意与竞争语音的权重如何随场景变化

评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Johanna Wilroth:机构信息未能在本次解析中与作者逐人可靠绑定
- Martin A. Skoglund:机构信息未能在本次解析中与作者逐人可靠绑定
- Emina Alickovic:机构信息未能在本次解析中与作者逐人可靠绑定
- Martin Enqvist:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
在两名说话人同时说话的场景中,研究要解释头皮脑电如何同时跟踪注意语音与竞争语音,以及这一平衡是否随听音条件变化。第一步先从注意语音与竞争语音提取包络,再按不同权重合成混合包络,把它作为后向时间响应函数的训练目标,并以多通道脑电作为输入。第二步用训练得到的解码器重建混合包络,计算重建输出与对应目标的皮尔逊相关,并把每个权重的相关系数汇总成一条曲线。第三步从曲线提取等权混合相对纯注意语音的跟踪差值、峰值增益和最优权重,用这些指标比较声学退化和注意任务的影响。在图4的脑电评测中,仅用注意包络训练解码器并控制注意包络,相对于零相关基线,重建包络与竞争语音的包络相关性按偏相关系数衡量,在19种听音条件中的14种显著高于零,多重比较校正后p<0.05。随着声学条件变难,等权混合相对纯注意语音的优势总体增大,最优权重向竞争语音移动,但注意切换的三个指标低于持续注意与对话注意,固定信噪比下助听器降噪开关之间未发现显著差异。结论只适用于已测听音条件,不能推广到未验证的听力组直接比较,难度排序也只在同一数据集内成立,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 想要多像就多像:用相似度标签控制游戏音乐续写

英文题目:How Close to the Theme? Similarity-Label Conditioning for Game Music Generation
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shangxuan Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Zixun Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinjie Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Joshua Reiss:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
游戏音乐需要在长时间游玩中重复同一素材又避免单调,作曲者希望指定新段落与给定段落有多贴近,已有符号音乐模型只会流畅续写而缺少这种分级控制。论文把任务定为给定上下文段落和相似度要求,输出一段长度受限的新段落,难点是相似度没有公认定义且旋律、音高、节奏、时值需要分别衡量。方法先把同一首超级马里奥钢琴谱内的段落两两配对,用自设的复合相似度(compound similarity,CS)算分并按三分位切成高、中、低三档标签;再把上下文音符、分隔符、标签词、目标音符串成一个序列训练,只在目标音符上算损失;同时把主干网络对上下文的隐层平均后经线性映射得到上下文向量,在目标每小节边界以特殊词嵌入送入。相对已有变奏学习只在固定相似度区间内学习,本文标签覆盖全部配对范围并区分程度,还分离了标签与上下文向量的作用。在157个测试上下文、每种标签6次抽样平均的条件下,高相似度输出在Melody上比低相似度输出平均高于0.0080,12个指标方向均偏向高相似度一侧。听测以20名听众对30组单次抽样的10秒片段打分,高相似度输出仅比低相似度输出高2.9分(95%区间-2.0至+7.7,p=0.24),未检出标签效应,且中档标签未居中、单次波动大。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 乐器指向性如何用几个统计参数概括:vMF 混合的压缩与比较

英文题目:A Compact Statistical View of Musical-Instrument Directivity
评分:5.8/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Gioele Greco:机构信息未能在本次解析中与作者逐人可靠绑定
- Mirco Pezzoli:机构信息未能在本次解析中与作者逐人可靠绑定
- Raffaele Malvermi:机构信息未能在本次解析中与作者逐人可靠绑定
- Gian Marco Ricci:机构信息未能在本次解析中与作者逐人可靠绑定
- Fabio Antonacci:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是乐器向不同方向辐射声音能量的频变分布,困难在于完整球面图在每个频带都需要大量系数,浏览和反复比较代价高,且多瓣辐射难以用单一主方向概括。论文输入为球谐函数表达的复指向性函数导出的频带能量图,输出为每个频带的von Mises-Fisher(球面上的方向分布,以平均方向和集中度描述瓣的位置与尖锐程度)混合参数及跨乐器可比的描述子。处理过程是先把频带能量归一化为球面上的概率型分布,再用加权期望最大化拟合少量混合分量,并按球面Pearson相似度选择满足目标保真度的最小分量数,最后用Jensen-Shannon距离比较乐器间关系。相对已有稀疏重建、球面相关检索和混响场方向建模工作,差异在于把源指向性本身作为可压缩可比较的对象,并保留瓣方向、尖锐度和权重。实验在41件管弦乐器的公开指向性语料上,在70%目标相似度下把完整四阶语料的双精度存储从约492 kB减少到约100 kB、明显低于压缩前,且压缩后与压缩前乐器间Jensen-Shannon距离矩阵的上三角元素Pearson相关为0.961、均方根误差为0.093,呈高度正相关并保持低偏差。结论适用于该语料的分析、聚类和检索等关系型任务,高频精细结构仍需更多分量,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. 只用短参考音频克隆童声来扩充儿童语音识别训练数据
英文题目:Zero-Shot Voice Cloning for Synthetic Data Augmentation in Children’s ASR
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Mohammad Mohsen Goodarzi:机构信息未能在本次解析中与作者逐人可靠绑定
- Stefan Wabnik:机构信息未能在本次解析中与作者逐人可靠绑定
- Matthias Stennes:机构信息未能在本次解析中与作者逐人可靠绑定
- Stephanus Volke:机构信息未能在本次解析中与作者逐人可靠绑定
- Alexander Schwarz:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
儿童语音识别的输入是声学波形,输出是文字转写,难点在于儿童基频更高、共振峰和语速与成人不同,加上口齿清晰度低和标注语料稀少,成人模型直接使用误差很高。本文用现成的多语言语音合成系统OmniVoice做零样本声音克隆,只需每个儿童一段数秒的参考音频作为声音条件,把语料中的文本转成该儿童音色的新语音,再用这些合成语音微调Whisper-small。处理链是抽取人物参考片段并做文本规范化与过滤,再按人物批量合成并做语速与重复词检查,最后把合成与真实数据按不同组合微调同一识别模型。与需要为每个测试儿童注册并训练个性化模型的做法不同,本文只克隆训练集儿童,用于提升对未见儿童的通用识别。在ENNI真实测试集上以词错率衡量,零样本基线为19.8%,只用合成数据微调降到16.4%,低于基线但高于真实数据微调的8.8%,而合成加真实为9.2%,略高于真实数据微调且基本持平。结论适用范围限于7-12岁叙事和3-5年级科学对话两类英语儿童语音。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 听完 30 秒再打分,和边听边打分是一回事吗

评分:5.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Yuanbo Hou:Department of Engineering Science, University of Oxford, Oxford OX1 3PJ, United Kingdom
- Kening Guo:UCL Institute for Environmental Design and Engineering, The Bartlett, University College London, London WC1H 0NN, United Kingdom
- Francesco Aletta:UCL Institute for Environmental Design and Engineering, The Bartlett, University College London, London WC1H 0NN, United Kingdom
- Woon-Seng Gan:School of Electrical and Electronic Engineering, Nanyang Technological University, Singapore 639798, Singapore
- Dick Botteldooren:Department of Information Technology, Faculty of Engineering and Architecture, Ghent University, 9052 Ghent, Belgium
- Jian Kang:UCL Institute for Environmental Design and Engineering, The Bartlett, University College London, London WC1H 0NN, United Kingdom
📌 核心摘要
需要理解的是同一段声景暴露的两种评价:一种是听后对八个感知情感质量属性打分再换算成愉悦度和事件度坐标,另一种是在听的过程中用光标直接连续报告愉悦度和事件度。难点在于前者是事后总结,后者是过程记录,量表、时间覆盖和几何含义不同,不能直接比较。论文先把连续记录按时间平均为每试次坐标,把事后评分按国际标准化组织规则换算为坐标,再比较属性夹角结构、直接坐标轴朝向以及不同时段平均的对应误差。在此基础上,经验映射利用配对数据估计从八个事后评分预测听音期间平均坐标的关系,其与固定相对权重的经仿射校准的ISO 2025换算的关键差异在于重新估计属性贡献而不沿用规定几何。与经仿射校准的ISO 2025投影相比,经验映射在按参与者留一验证下对照持有直接愉悦度和事件度均值的联合二维均方根误差从0.3481降至0.3311、降低4.9%,其中愉悦度均方根误差从0.2458降至0.2263、降低7.9%,大于事件度从0.2401降至0.2350、降低2.1%的幅度。结论只适用于本次三十秒街道视听刺激的配对试验,跨时长、视觉条件与新听众的泛化尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. 从碎片到融合:全模态嵌入的统一路线图

英文题目:From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
评分:5.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Ziyin Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuyu Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Ying Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Siqiao Xue:机构信息未能在本次解析中与作者逐人可靠绑定
- Zihan Liao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jin Qin:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenjie Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Siyuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shijie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Cheng Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Hao Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaoyang Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruipeng Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaokun Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Lei Lei:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hang Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
这篇综述要回答的输入是各模态嵌入研究彼此隔离、原理被掩盖的问题,输出是一个能同时处理、比对和组合多种原始输入的通用嵌入空间设想,难点在于各模态的数据单元、评价协议和结构先验差异大而共享的损失与编码器原理又趋同。作者先给出可复用的解剖结构,把原始输入切分、编码、池化读出与训练目标分开,再用对比学习通用化、Transformer 默认化与表示粒度上移三条收敛线解释为何不同空间可以拼接或修正,随后按交互由浅到深比较转换、对齐和联合嵌入三条路径,并用覆盖、可比性和组合性检验每条路径实际达到了什么。相对已有单模态综述,关键差异在于不按模态罗列模型,而是把机制归属为可迁移的共性还是不可丢弃的模态特性。原文报告的一项可核对定量结果是,在含文本、图像与图文混合文档的混合语料检索中,按模态中心化处理相对 CLIP 双塔基线将 NDCG@10 提高至多 26 个点,指标越高越好,说明模态间隙会直接扭曲排序。这一结论适用于混合语料排序修正,尚未在覆盖全部模态的统一基准上验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/codefuse-ai/Awesome-Omnimodal-Embeddings — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 把爆破音处的气流声做进合成语音:一次针对活体检测的数据投毒

英文题目:Pop Goes the Verifier: Phoneme-Targeted Data Poisoning of Voice Liveness Detection
评分:5.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Eshaq Jamdar:机构信息未能在本次解析中与作者逐人可靠绑定
- Amith Kamath Belman:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需应对的检测器是自动说话人验证中依据爆破音气流突发判断活体的VoicePop,它输入语音波形并经短时傅里叶变换取低频能量窗、提取伽马通频率倒谱系数后由支持向量机输出真伪判决。其难点在于模型把低频突发视为真人证据,投毒者可在训练集中混入带伪突发却标为真的样本,使分界面向真类偏移而误收伪造语音。方法先用Whisper转写部分真样本得到文本,再用非自回归语音合成模型FastSpeech 2生成梅尔语谱图并经HiFi-GAN声码器合成波形。合成时在最多15个音素位置注入按时长、幅度和偏移随机化的80赫兹以下低频突发,并叠加低水平高斯噪声以掩盖合成痕迹。投毒样本以20%比例混入VoicePop训练流程,复用与SyntheticPop相同的均衡训练与评测设置以便对照。与均衡训练基线相比,在ASVSpoof 2019均衡评测设置下Pop Goes the Verifier使准确率从37.52%降至25.66%,弱于全局正弦的SyntheticPop的14.01%,但波形和语谱图检查更难发现。结论只适用于受控白盒、单系统和高投毒比例范围,未做显著性检验和跨系统验证;原文提到全量训练评测约需1天,未披露合成与训练的设备与算力细节。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. 不先转写也能找证据吗:MedAstra 的语音检索与医学问答 grounding

英文题目:MedAstra: ASR-less Speech Retrieval with Diagnostic Grounding for Medical QA
评分:5.1/10 | 创新 1.2/2 | 技术严谨 0.8/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.7/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Elahe Khatibi:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Amir M. Rahmani:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段英文医学口语提问,输出是可供选择的答案或简短回答,困难在于转写可能把罕见实体改写为常见词,使后续检索证据偏离原意。论文采用的适配器是连接冻结语音编码器与冻结文本编码器的轻量映射模块,把 8 秒语音的平均池化特征投影到文本嵌入空间,再用内积检索语音条目和文本段落。检索到的语音条目通过其附带的文本描述进入生成器,词法检索、文本重排和字符串校正仍需显式文本查询,诊断图与关系启发提供备选实体和对比上下文。生成器在至多两轮内用生成词反馈修正查询并重新检索,输入为文本问题、选项、可见证据和启发上下文。与单次转写后稠密检索相比,论文保留的混合配置在 SpokenSQuAD 上的 Recall@10 为 90.4%,转写后稠密检索为 81.0%。结论只适用于受控的合成语音与加性噪声测试,不支持临床泛化,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. 多模态不一致不等于藏起了情绪:这篇提案想如何识别隐藏情绪

评分:3.2/10 | 创新 1/2 | 技术严谨 0.5/1.5 | 实验充分 0/1.5 | 清晰度 0.6/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yonghao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaxin Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
隐藏情绪指外表平静但内心恐惧这类外显与内在不一致,难点是语音、面部和文字的不一致既可能来自隐藏,也可能来自混合情绪、表达习惯或情境,需先判断是否存在隐藏,再在证据充分时推断内在情绪。本文设想以外显情绪标签、独立获得的内在情绪标签和隐藏条件标签共同描述样本,视觉、语音和文字分别编码后做跨模态融合,再交多模态大语言模型做多任务判断。融合网络用交叉注意交互并设想用对比学习放大可疑模态与其他模态的差异,输出融合表示作为大语言模型的输入嵌入,先预训练融合网络再微调大语言模型。模型沿用情感大语言模型EmoLLMs的五个子任务,先找出包含的多种情绪,再估计每种情绪强度和整体情感倾向,最后综合得出隐藏情绪分析,其中面部动作单元标注刻画细微面部动态并结合前后时序语境。在背景引用的日常交互情绪传达统计设置下,以情绪传达占比为指标,面部表情为55%高于语音的38%,语音的38%又高于文字的7%。相对已有冲突感知工作CA-MER、MoSEAR、EmoMM和CHASE,本文不只做加权选择或注意力转向,而是要求区分隐藏与一般不一致。该区分仅在具有独立内在情绪依据与隐藏条件标注时成立,以编辑模态制造的冲突样本只能检验冲突鲁棒性,不能视为真正隐藏,缺乏独立依据或仅凭单时刻静态线索时可能误判,长时序建模亦尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。