📄 双耳语音既要听得清,也要定位稳:SPHERE 如何把九个听感一次评完
英文题目:SPHERE: A Multi-Attribute No-Reference metric for Binaural Speech Quality And Spatial Fidelity
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Bala Manikya Prasad Puram:机构信息未能在本次解析中与作者逐人可靠绑定
- Chandan K A Reddy:机构信息未能在本次解析中与作者逐人可靠绑定
- Artem Dementyev:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
双耳语音要同时保留语音清晰度和声像方向,左右耳信号很小的时延与级差变化就会引起声像漂移或听感劣化,单通道语音指标无法反映这类空间失真。论文输入10秒立体声片段,输出语音失真等九个1.0到5.0分的主观维度预测,覆盖总体质量、听声努力、响度舒适、声像定位、空间稳定、干扰性杂音和背景噪声行为。处理过程是把左右声道变为时频表示后送入卷积编码器提取谱与空间线索,再用双向循环结构建模时间上下文并汇聚成固定向量,最后由九个独立回归头同时输出各维度分数。孪生结构对左右声道使用参数共享的编码器并显式拼接差值与乘积项,用对称约束强调耳间一致性,还可用预训练空间向量增强梅尔谱基线。在2119片段防泄漏验证集上,非孪生梅尔谱加空间向量配置的九属性平均片段级皮尔逊相关系数为0.706,高于纯梅尔非孪生的0.702。在同一验证集按六个增强条件取均值后的系统级比较中,纯梅尔孪生的九属性平均系统级皮尔逊相关系数为0.770,高于纯梅尔非孪生的0.715。在同一2119片段验证集的总体质量片段级皮尔逊相关系数上,梅尔谱加空间向量两种编码器均为0.773,高于单通道基线按声道打分平均的0.284。结论适用于耳机回放和语音增强后的双耳语音横向比较,对瞬态局部缺陷和未见房间与设备的泛化仍需谨慎。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决的双耳语音问题是什么
论文处理的对象是经过耳机、智能眼镜或增强现实设备播放的双耳语音,输入是左右两个通道各 10 秒的 16 kHz 立体声,目标是在没有干净参考信号的情况下,1 次预测听音人会在 9 个维度上给出的分数。必须保留的信息有两类,一是语音本身是否失真、背景吵不吵、整体好不好、听起来费不费力,二是空间线索对不对,包括响度是否舒适、方向感是否准确、声源是否来回漂、毛刺和背景起伏是否烦人。
困难在于常见的单通道降噪做得越激进,越容易破坏左右耳之间的细微差别。原文指出,保留准确的耳间时间差和耳间强度差对定位和沉浸感很关键,而双通道神经降噪常带来声源游移、局部伪影和听音努力上升。传统电话语音指标只看单通道,空间音乐指标又需要完整参考信号且不评语音失真和听音努力,所以双耳语音缺少一个同时覆盖质量和空间的无参考工具。
双耳信号 × 耳间时间差 × 耳间强度差: 双耳信号指左右耳两个通道同时录到或处理后的立体声语音,耳间时间差是同一声波到达两耳的时间先后,耳间强度差是两耳接收到的响度差异,两者共同决定人对声源方向和距离的感觉,SPHERE 要评的定位与稳定正是检查这组线索有没有被降噪和渲染破坏。
举例来说,同一段街头对话,左耳和右耳录到的噪声到达时间差一点点,人就能感到说话人在左侧;如果降噪把 2 通道相位各自改乱,方向感就会塌掉。论文就是要把这种听得清和定得稳放在同一套主观模板和同一组模型输出里。
属性与线索对照表说明结构增益落在哪里
这张表要回答的比较问题是 9 个属性各自依赖什么声学线索,以及在耳机产品中对应哪类工程检查,公平条件是同出自原文表 1 的同一套定义,指标方向不适用,作用是解释为什么定位和稳定更吃对称结构。表前这段先把问题和来源说清,表后一段再把定义对照与后文数字分开。
| Perceptual Metric | Underlying Acoustic/Psychoacoustic Cues | Engineering & Product Significance in Wearables |
|---|---|---|
| Speech Quality (MOS-SIG) | Speech distortion, timbral coloration, phase mismatch | Evaluates the impact of voice processing on speaker naturalness and clarity |
| Noise Intrusiveness (MOS-BAK) | Signal-to-Noise Ratio (SNR), background noise levels | Measures the effectiveness of ambient noise suppression for user comfort |
| Overall Quality (MOS-OVRL) | Integrates speech quality, noise suppression, and spatial naturalness | Primary metric for product benchmarking and competitor comparison |
| Listening Effort | Intelligibility, cognitive fatigue, acoustic clarity | Critical KPI for conversation boost and hearing assistance features |
| Loudness Comfort | Volume appropriateness, dynamic range compression | Evaluates comfort of automatic volume leveling under varying environments |
| Sound Localization | Interaural Time/Level Differences (ITD/ILD), HRTFs | Ensures spatial rendering preserves accurate sound source direction |
上表摘自原文表 1,保留属性名、线索与产品意义三列,摘录语音、噪声、整体、努力、响度、定位等七行以对照主要结果,完整九行以原文为准。定位依赖耳间时间差、强度差和头相关传输函数,稳定依赖它们随时间的漂移,孪生融合显式保留差值与乘积项,因而在系统级排序上占优,而伪影与噪声行为依赖瞬态毛刺与门限起伏,受滑窗标签噪声影响更大,所以片段级偏低。这种对照只是定义层面的对应,不能据此推断某结构必然在某属性上最好,具体仍以后文结果表数字为准。
已有路线为什么不够用
论文把已有工作分成 3 条路线来对照。第一条是电话语音的客观指标,如 PESQ、POLQA、ViSQOL,输入是单通道语音加参考信号,目标是估计通话质量,它们在原文的任务里输入就不匹配,因为双耳任务的输入是立体声且不允许用参考。第二条是深度学习的无参考多维语音质量模型,如 NISQA、DNSMOS、SESQA,输入也是单通道或分别看单通道,目标含语音失真和噪声,但看不到耳间线索。第 3 条是多通道空间相似度指标,如 PEAQ 和 AMBIQUAL,输入需要干净多通道参考,目标是感知相似性,不评听音努力、语音失真和神经增强特有的伪影。
比较的公平点在于输入、目标和运行阶段都要一致。论文在实验里真正同条件比较的是单声道 DNSMOS,把它分别作用于左通道和右通道再平均,或者先把左右时域平均成单声道再送入。原文报告时域下混会因耳间时延和头相关传输函数带来相位抵消与梳状滤波,在 MOS-SIG 上片段级 Pearson 相关只有 0.039,MOS-OVRL 为 0.256,而逐通道打分再平均能避开抵消,MOS-OVRL 为 0.284、MOS-BAK 为 0.460、MOS-SIG 为 0.054,但仍远低于双耳原生模型。类别不同不能直接说谁更先进,论文的结论是单声道路线在输入上就丢了双耳解掩蔽和耳间线索,且只能预测 9 个维度中的 3 个。
九个分数具体指什么
论文把沉浸式听感拆成 9 个可打分的属性。核心质量与努力有 4 个,语音质量看失真和音色变化,噪声侵扰看信噪比和残留噪声,整体质量是综合,听音努力看可懂度和疲劳感。空间沉浸有两个,响度舒适看音量和动态压缩是否合适,声源定位看方向准确性。烦恼与处理伪影有 3 个,分散注意力的伪影指咔哒声、爆音、丢帧和高频毛刺,空间稳定指声源是否不自然游移,背景噪声行为指噪声抽吸或门限起伏。
每个属性背后都有对应的声学或心理声学线索,例如定位对应耳间时间差、强度差和头相关传输函数,稳定对应这些线索随时间的漂移,伪影对应低时延处理错误,噪声行为对应动态语音检测带来的调制。工程意义也被写明,例如定位关系到空间渲染是否保真,稳定关系到头动跟踪抖动,伪影关系到编解码与处理错误。阅读时以后文统一的中文称呼为准,完整定义以原文表 1 为准。
从立体声到九个分数的总体流程
方法总体是多任务回归。输入是一段 10 秒立体声,先做特征提取得到时频表示,再经卷积编码器抽局部谱和空间模式,接着用两层双向长短时记忆网络看前后文,全局平均池化压成定长向量,最后分给 9 个独立头各自输出一个 1.0 到 5.0 的分数。训练监督来自众包听音的均值,损失是 9 个属性等权的均方误差。
论文评估了 6 种基线配置,覆盖单分支与孪生两种结构,输入有对数幅度 Mel 频谱、短时傅里叶变换幅度或复数形式,以及 Mel 加 PhaseCoder 空间嵌入。单分支把左右特征堆成 2 通道直接卷积,孪生用共享参数的编码器分别处理左右再融合,容量都控制在 320,000 到 350,000 参数量级,保证比较主要反映结构和输入差异。
读这张结构图时,先看左右两路如何对称处理,再看融合后如何进入时序主干,最后看九头如何分开,这是复述关键步骤的主线。
看图路径: 1. 先沿左右两路输入箭头看各自经过的编码器是否为共享参数;2. 再看融合层把哪四部分表示拼在一起送入双向长短时记忆网络;3. 最后看池化后如何分成 9 个独立头输出 9 个分数
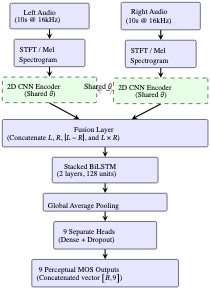
论文图 3。原论文 Figure 3::“Detailed architecture of the two-branch Siamese network evaluated in SPHERE.”。
图 3 展示的是双分支孪生网络的细节,像素可见左右各一个输入框,分别经特征框和共享编码器框汇入融合层,再依次经过堆叠双向长短时记忆网络、全局平均池化、9 个独立头并输出拼接向量。它帮助理解分支在哪里分开、在哪里汇合,以及共享的是卷积编码器参数,而不是后面的时序层。
主观模板的四个部分如何保证分数可用
真值采集用一个四部分模板。第一部分按 ITU-T P.835 评语音失真和背景侵扰,按 P.800 与 P.835 评整体质量,并按 P.810 改编评听音努力,均为 5 点量表。第二部分评空间沉浸,含响度舒适和声源定位。第三部分评烦恼因素,含分散注意力的伪影、空间稳定和背景噪声行为。第四部分是低分溯因,当整体质量打到 2 分及以下时,必须选择主要原因,如背景太吵、语音失真、响度不平衡或空间不稳,用来交叉验证整体分与分项分的关系。
无参考评价 × 平均意见分 × 众包听音: 无参考评价指只看待测的双耳片段本身、不依赖干净参考信号就给出分数,平均意见分是多个听音人打分的均值,用作训练目标,众包听音是在线招募大量听音人按统一模板打分的过程,三者组合是先用众包得到可学习的平均意见分,再训练模型在无参考条件下模仿它。
这套模板的意义是让 9 个分数互相可解释,避免随意打分。例如整体很低却分项都不低,就会被第四部分暴露出来。论文把这套流程作为自动化目标的依据,模型要 1 次学会全部 9 个输出。
听音人筛选为什么对双耳评价格外严格
双耳评价对播放设备很敏感,扬声器串音会直接破坏耳间时间差和强度差。论文因此做了多层前置过滤。首先是硬件申报与排除,听音人先申报播放设备类别,包括有线包耳式、贴耳式、入耳式耳塞或内置扬声器等,严格排除的是笔记本、手机和外接扬声器外放,同时记录硬件型号与蓝牙降噪状态,防止受控外数字信号处理污染空间评分。把这一点写准很重要,不能说成把 3 类耳机也排除。
其次是双耳通道校验,用只在一侧耳朵播放的语音和纯音,以及双耳相位抵消检查来验证真立体声和左右方向正确,未通过者不得参与研究。再次是音量校准,用带噪数字样本调到舒适响度后要求中途不再改动。最后是听力与防作弊,包括听力筛查、带噪转写数字、音频算术验证,每个任务含 10 个待评片段、1 个隐藏的干净金标准和 1 个退化陷阱,整体每个片段至少保留 5 个筛后评分。
原文给出每个片段筛后均值的标准误约 0.35,而按条件聚合上 100 个片段后条件均值的标准误可降到 0.04 以下,这是用大数平均压住单条偶然性的做法,也是后文系统级相关的统计基础。
单分支与孪生分支各做了什么
单分支基线把左右通道的特征沿通道维堆成形状为批次、时间、频率、2 的张量,直接送入 2 维卷积编码器。输出重排为批次、时间、特征维,Mel 下特征维为 1024,再走时序主干和池化。9 个头各是一个 64 单元全连接加 ReLU、0.5 丢弃和 1 单元线性输出,总量约 321,000 参数。
孪生分支用同一组参数的编码器分别处理左和右,复数短时傅里叶变换时把实部虚部堆成 2 通道。融合层把左表示、右表示、两者差的绝对值和逐元乘积拼接,再投影到与基线相同的时序输入维度,总量约 330,000 参数。加空间嵌入的 Mel 配置总量约 353,000 参数。
Mel 频谱 × 复数短时傅里叶变换 × PhaseCoder 空间嵌入: Mel 频谱是对幅度谱按听觉尺度压缩后的时频表示,擅长刻画音色和噪声响度,复数短时傅里叶变换同时保留幅度和相位因而保留更多耳间相位结构,PhaseCoder 空间嵌入是预训练模型抽出的 256 维向量,专门概括与麦克风几何无关的耳间相位关系,三者在 SPHERE 基线里作为不同输入或附加特征,分别提供听感线索和空间线索。
单分支网络 × 孪生网络 × 融合层: 单分支网络把左右通道特征沿通道维堆叠后用同一组卷积直接处理,孪生网络先用参数共享的编码器分别处理左通道和右通道再合并,融合层把左表示、右表示、两者差的绝对值和逐元乘积拼接起来,孪生加融合的意义是用对称结构显式保留耳间差异,便于后面比较定位和稳定这类空间属性。
沿一个样本走一遍,左 10 秒和右 10 秒先各自变成时频图,孪生编码器各自压成隐表示,融合层显式算出差异和乘积项,时序层再看 10 秒内的起伏,池化压成一句话向量,9 个头各自给出一个分数。分支分工是编码器管对称的局部模式,融合管耳间关系,时序层管随时间的变化。输入处理过程是波形先按 16 位整数除以 32768.0 归一到负 1 到 1,再取 Mel 或短时傅里叶变换特征。Mel 基线经 5 组卷积块抽取,滤波器数为 32、32、64、64、128,含批归一化和最大池化。加空间嵌入的配置把 256 维 PhaseCoder 向量做 z 分数归一,经 64 单元全连接加 SiLU 后与 256 维主干拼接成 320 维再分头。
数据怎样扩增和划分才不泄漏
原始库约 9000 个 10 到 20 秒的双耳片段,包括商用耳塞实时采集、实验室头模模拟器在不同距离方位和噪声下的录音,以及野外移动录音,语音含多种神经增强配置与未处理基线。每个片段有 5 个人评,经模板得到 9 个属性真值。
训练用 2 阶段扩增。第一是滑窗切块,对每个 20 秒源用 10 秒窗、2 秒步长切出 6 块并继承父标签,这是一种弱监督假设。作者解释整体质量在 20 秒内较平稳,但瞬态局部缺陷会给未受影响的块带来标签噪声,这被用来解释缺陷类指标相关偏低,但实验没有单独验证它是直接原因,只能当作作者的解释。第二是感知不变变换,含至多正负 50 毫秒时移、正负 2.5 分贝增益和极性反转,认为不改变主观分。未改动的首个 0 到 10 秒块组成干净集,滑窗块及其不变增广组成训练语料。
划分在切块和增广前按干净基文件名做,先剥掉增广与切块后缀得到基名,再按基名 8 比 2 随机分,保证同一源的所有房间、位置、增益和切块变体只进同一侧,防止说话人和环境泄漏。训练集为 433396 条,验证集经确定性欠采样保留干净块并各抽 2 个滑窗块和 2 个增益档。优化用 Adam,学习率 2 乘 10 的负 4 次方,批量 128,L2 为 10 的负 4 次方,目标为九属性等权均方误差,每 500 步按验证集 Pearson 相关选最优。
人评分数长什么样,三个相关指标各看什么
在看模型结果前,先看人评本身的分布与冗余。图注与第 3.1 节把图 1 解释为 5 次人评均值在 9 个属性上的分布,覆盖 1.0 到 5.0 全程。需要区分的是图内像素文字,大标题写的是跨硬件配置的分布,各子图名含 Spread 字样,图中没有硬件分组图例,直方柱和计数轴可直接读取,但不能把图内 Spread 自行定义成另一种测量,也不能说图测量了模型误差。计数不同只说明样本在各分数段有多有少,不能从图直接推出模型在稀疏区间误差天然更大,误差要看结果表独立说明。
看图路径: 1. 对照每个子图横轴 1.0 到 5.0 与纵轴计数,确认分布覆盖范围;2. 比较语音、噪声、整体等子图峰的位置和高低差异;3. 注意图内大标题与小图名中的 Spread 字样,不要直接当作另一种测量

论文图 1。原论文 Figure 1::“Distribution of human subjective Mean Opinion Scores (MOS) across the 9 evaluated attributes of the binaural speech dataset.”。
图 1 像素可见 3 乘 3 共 9 个子图,横轴均为 1.0 到 5.0,纵轴为计数,每个子图有直方柱和一条平滑曲线,语音子图在 3.5 附近柱最高,噪声子图在低分段也有明显堆积,整体与努力等子图形态各异。它帮助确认训练目标覆盖了从差到好的完整谱,而不是只集中在高分。
评价用 5 类统计。片段级 Pearson 看线性对齐,片段级 Spearman 看排序对错且不受非线性压缩影响,RMSE 与 MAE 看在 1.0 到 5.0 量表上的绝对偏差,方向都是越小越好,系统级 Pearson 先按 6 种系统取条件均值再算相关,质量层级 Pearson 按 5 个主观区间分层取均值再看校准。验证集片段数为 2119,条件举例包括未处理、经典波束成形与 4 种神经增强基线。
六种基线在关键指标上表现如何
下面这张整理表要回答的比较问题是双耳基线与单声道基线在同一防泄漏验证集上孰优孰劣,公平条件是同批 2119 个验证片段、同套九头多任务结构,单声道 DNSMOS 只支持 3 个 P.835 维度并采用逐通道打分再平均报告,指标方向为 Pearson 越高越好。这是跨输入配置的表 2 摘录,请分列阅读双耳对照的最后两项:片段级 PCC 采用 MEL 加空间特征,非孪生与孪生分别为 0.706 和 0.702;系统级 PCC 采用纯 MEL,分别为 0.715 和 0.770。同一行的两格来自不同输入配置,不能当作同一个模型设置的配对结果。
| 方法条件 | MOS-OVRL 片段级 PCC | MOS-BAK 片段级 PCC | MOS-SIG 片段级 PCC | 平均片段级 PCC | 平均系统级 PCC |
|---|---|---|---|---|---|
| DNSMOS 逐通道平均 | 0.284 | 0.460 | 0.054 | — | — |
| 非孪生对照 | — | — | — | 0.706 | 0.715 |
| 孪生对照 | — | — | — | 0.702 | 0.770 |
上表数字均来自原文连续句,其中 DNSMOS 三格核对值为整体质量 0.284、背景噪声 0.460、语音质量 0.054,其余以—表示不支持。已核对的总体读数是所有双耳配置的平均片段级 Pearson 约 0.70、Spearman 约 0.66、RMSE 约 0.73、MAE 约 0.58,质量层级 Pearson 超过 0.99,说明跨退化范围的单调校准很好。区分 PhaseCoder 效果时要分开说,非孪生 MEL 加空间特征的片段级平均 Pearson 最高为 0.706,孪生 MEL 加空间特征的误差最低,平均 RMSE 为 0.726、MAE 为 0.582,这些基线对照没有量化信息来源占比。属性层面,背景噪声、整体质量和听音努力较高,语音质量、空间稳定、伪影和噪声行为偏低,作者把后者与滑窗继承标签带来的噪声联系起来,但这仍是解释而非单独验证。
片段级相关 × 系统级相关 × 质量层级相关: 片段级相关是对每个 10 秒片段的预测与人评直接算 Pearson 或 Spearman 相关,反映逐条跟踪能力,系统级相关是先把同一增强系统下的所有片段取均值再算相关,过滤掉单条的偶然起伏,质量层级相关是按主观分区间分层取均值再看线性,组合起来才能同时回答跟得准不准、排系统稳不稳、跨退化范围校准直不直。
图 2 进一步看人评之间的冗余,导读是先找整体与努力的高相关格,再看语音与噪声的相对低相关,这与模型为何在某些属性上更难拉开直接相关。
看图路径: 1. 先看对角线为 1.00,再找整体与听音努力交叉格的深色高值;2. 比较语音与噪声交叉格 0.53 与其他格的相对深浅;3. 结合右侧色条判断颜色深浅对应的相关强弱

论文图 2。原论文 Figure 2::“Pearson correlation matrix between the 9 subjective spatial audio metrics, illustrating high redundancy between overall quality and listening effort, and moderate correlation…”。
图 2 像素为 9 乘 9 热力图,对角线为 1.00,整体与努力交叉格为 0.93 呈深色,语音与噪声交叉格为 0.53 颜色明显更浅,定位与稳定等空间格多在 0.7 到 0.8 之间。它确实可见整体与努力高度冗余、语音与噪声相对独立,原文也报告整体与努力为 0.93,整体与定位和响度舒适在 0.81 到 0.82 之间,说明空间属性已深度融入整体判断。
孪生对称和单声道基线带来什么代价与收益
第二个比较问题是结构对称是否值得,以及双耳建模是否必要。原论文表 2 的纯 MEL 对照保持输入特征相同:非孪生与孪生的片段级平均 Pearson 相关分别为 0.702 和 0.695,系统级平均 Pearson 相关分别为 0.715 和 0.770。原文的系统级属性比较还报告,定位从 0.793 升至 0.910,空间稳定从 0.786 升至 0.867,背景噪声从 0.665 升至 0.715,伪影从 0.768 升至 0.822。这组验证显示,纯 MEL 孪生模型在系统级排序上的相关性更高,同时片段级相关略低。
与单声道 DNSMOS 的对照在同验证集上进行,逐通道平均已避开下混抵消,仍落后双耳模型 0.347 到 0.615 个 Pearson 点,且无法预测努力与空间 6 维。代价是双耳模型需要立体声输入和九头训练,而单声道模型可直接复用但输入就不对齐。未胜出项也要写明,孪生 STFT 在多个缺陷属性上反而低于非孪生,Mel 加空间特征并非在每个属性都最好,说明对称和附加嵌入不是处处增益。
结论在什么条件下才成立,还有哪些没测
证据只支持在同类采集与同模板下的结论。数据来自耳塞实时采集、实验室头模拟器与野外录音,时长 10 到 20 秒,验证经说话人与会话级防泄漏划分,听音经严格硬件与双耳校验,因此 0.706 的片段级平均相关和 0.770 的系统级相关不能直接推广到其他耳机、其他语言、更长通话或完全不同的增强系统。
未测范围包括推理延迟与算力、跨设备泛化、单条低分的可解释归因精度,以及标签噪声假设的消融验证。质量层级超过 0.99 只说明分层均值校准直,不能推出每条误差小。相关高也不等于因果,不能说加了 PhaseCoder 就一定是因为空间信息才涨,原文也没有给出信息来源占比。来源未确认不是技术缺陷,本文依据的官方材料中没有完成验证的代码与数据资源,因此不声称已开源可用。
要复现第一步做什么,需要哪些超参数
复现先从数据与划分做起。按干净基文件名剥掉切块与增广后缀后再 8 比 2 分,同一基名的所有变体只进同一侧,波形除以 32768.0 归一,验证集保留干净块并欠采样。特征按 Mel 或短时傅里叶变换二选一,孪生用共享编码器,融合拼左、右、差绝对值与乘积,时序用两层各 128 单元双向长短时记忆网络,池化后九头输出。
关键超参数保留原文写法,Adam 学习率 2 乘 10 的负 4 次方,批量 128,L2 为 10 的负 4 次方,九属性等权均方误差,每 500 步按验证 Pearson 选点。PhaseCoder 向量先 z 分数归一,经 64 单元全连接加 SiLU 后与 256 维主干拼成 320 维。评测同时算片段级 Pearson、Spearman、RMSE、MAE、系统级 Pearson 与层级 Pearson,验证片段数为 2119,系统数为 6,层级区间为 1 到 2、2 到 3、3 到 3.5、3.5 到 4、4 到 5。还需补的验证是换新说话人与新系统重测系统级排序,并对滑窗标签噪声做单独消融。
什么时候值得尝试这个方法
当任务是双耳语音的无参考批量评估,且输入确为立体声、关心定位与稳定是否被降噪破坏时,值得尝试 SPHERE 的 9 维模板与基线。它的价值在于 1 次给出质量、努力与空间的可比分数,便于在 6 类系统间排序。若只有单通道电话语音,或已有干净参考可做全参考比较,则不必套用这套重型模板。
容易产生的误解有三。一是把图 1 当模型误差图,实际上图注与第 3.1 节明确它是 5 次人评均值在九属性上的分布,图内 Spread 只是子图名的一部分。二是把 3 类耳机也当成排除对象,实际上排除的是笔记本、手机和外接扬声器外放,未通过双耳校验者是不得参与。三是把 0.706 与 0.726 记混,前者是非孪生 MEL 加空间特征的片段级平均相关最高值,后者是孪生 MEL 加空间特征的平均 RMSE 最低值,两者来自不同配置。记住这些条件,才能把论文的强相关读成有限条件下的可行性证据,而不是通用质量承诺。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses